在 Jetson AGX Orin 上部署 TensorRT-Model-Connect
本 wiki 展示如何在由 Jetson AGX Orin 驱动的 Seeed reComputer 上运行 NVIDIA TensorRT-Model-Connect(TRTMC)。在构建好原生运行时时,路径非常短:从 Hugging Face checkpoint 开始,在设备上生成一个 TensorRT .bundle,然后运行文本生成。无需单独的 x86 主机,也没有 ONNX 导出步骤。
本教程使用 FP16 的 Qwen3-4B-Instruct-2507。该模型是稠密 transformer,因此 TensorRT 可以使用批量 prefill 引擎。同一页面还记录了在 AGX Orin 64GB 上的转换内存占用,以及两个 TRTMC 比 llama.cpp CUDA 更快的工作负载:Qwen3-4B 的长 prefill,以及 Qwen3-0.6B 的贪心解码。
TensorRT-Model-Connect 目前是公开预览版。API、模型覆盖范围和构建流程仍可能变化。NVIDIA 自身的建议是:当你想快速尝试受支持的模型时使用 TRTMC,而当你需要在 Jetson 上进行面向生产的 LLM/VLM 运行时时,从 TensorRT Edge-LLM 入手。
什么是 TensorRT-Model-Connect?
TensorRT-Model-Connect 是一组基于 NVIDIA TensorRT 的模型家族参考实现。一个针对特定家族的构建器会读取 Hugging Face 快照,构建 TensorRT 引擎,并写出带版本的 .bundle。同一个 bundle 可以通过 trtmc CLI 执行,也可以通过原生 C++ 任务 API(例如文本生成)执行。
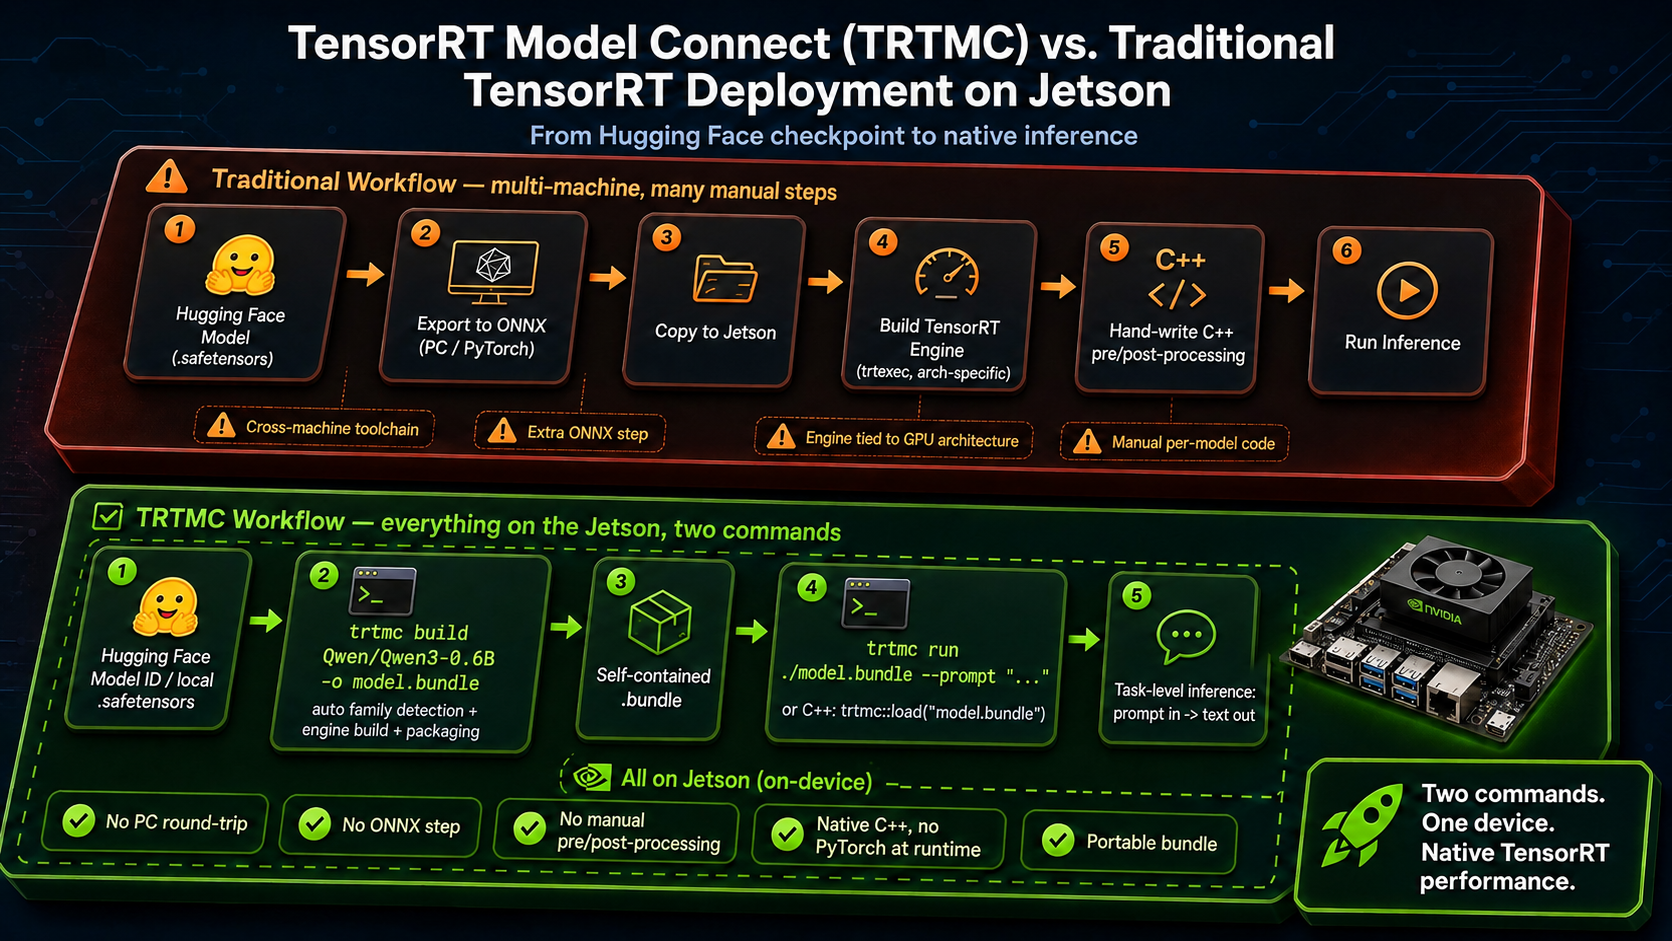
在 Jetson 上,实际差异体现在转换路径上。TensorRT Edge-LLM 仍然期望你在带有独立 GPU 的 x86 Linux 机器上进行量化并导出 ONNX,然后将这些 ONNX 文件复制到设备上生成引擎。TRTMC 则是在 Jetson 本机上构建引擎 bundle。
flowchart LR
  subgraph EdgeLLM["TensorRT Edge-LLM"]
    A1["Hugging Face checkpoint"] --> A2["Quantize + ONNX export on x86 GPU"]
    A2 --> A3["Copy ONNX to Jetson"]
    A3 --> A4["Build engine on Jetson"]
    A4 --> A5["llm_inference"]
  end
  subgraph TRTMC["TensorRT-Model-Connect"]
    B1["Hugging Face checkpoint"] --> B2["python -m tensorrt_model_connect build"]
    B2 --> B3[".bundle on Jetson"]
    B3 --> B4["trtmc run"]
  end
为什么这条路径在 Jetson 上更简单
| 主题 | TensorRT Edge-LLM | TensorRT-Model-Connect |
|---|---|---|
| 转换在何处运行 | 在带 NVIDIA GPU 的 x86 Linux 主机上导出 ONNX,然后在 Jetson 上构建引擎 | 在 Jetson 上从 Hugging Face 快照直接生成 .bundle |
| 中间文件 | ONNX 计算图,通常有数十 GB,需要复制到设备 | 无。.bundle 就是最终产物 |
| 完成环境准备后的命令 | 导出、复制、构建引擎,然后运行 llm_inference | python -m tensorrt_model_connect build 和 trtmc run |
| 转换期间的主机内存 | 厂商文档:FP8 ONNX 导出在 x86 机器上可能需要约 18–20× 模型大小的 CPU 内存 | 在 AGX Orin 64GB 上测得的 Qwen3-4B FP16:主机使用约 30.6 GB,容器峰值 41 GB |
| 最佳适用场景 | 在 Jetson 上进行生产级 LLM/VLM 部署 | 在将要运行模型的同一设备上快速尝试受支持的模型 |
表中的内存行并不是同一模型的正面对比。Edge-LLM 已发布的 ONNX 导出数据解释了为什么该流水线通常会离开 Jetson,转而占用一台高内存工作站。TRTMC 的数据则是我们在 AGX Orin 64GB 上构建 Qwen3-4B FP16 时实际观测到的。
硬件
本教程在搭载 Jetson AGX Orin 64GB 的 reComputer Classic J5012 上复现。Qwen3-4B FP16 转换在容器内峰值约 41 GB,因此 64 GB 统一内存是实际目标。J5011(32GB)属于同一产品家族,但在其上进行此转换很可能会频繁换页或失败。


前置条件
在 Jetson 上准备以下内容:
- reComputer Classic J5012,或其他 Jetson AGX Orin 64GB 系统
- JetPack 7.2 / Ubuntu 24.04 / L4T R39.2
- 带 NVIDIA runtime 的 Docker(
docker info应该在 Runtimes 下列出nvidia) - 约 40 GB 的可用磁盘空间,用于开发镜像、Hugging Face 快照和
.bundle - 可访问 GitHub、Hugging Face 和
nvcr.io的网络 - 基准测试章节的可选项:
nvpmodelMAXN 和jetson_clocks
已验证的软件栈如下:
| 项目 | 版本 |
|---|---|
| 设备 | Jetson AGX Orin 64GB |
| 操作系统 | Ubuntu 24.04.4 LTS,内核 6.8.12-tegra |
| L4T | R39.2 |
| TRTMC 镜像中的 CUDA | 13.3.1 |
| TRTMC 镜像中的 TensorRT | 11.1.0.106(TensorRT 26.07) |
| GPU SM | 87(Orin) |
| 功耗模式 | MAXN,GPU 1300 MHz |
如果 docker ps 返回 permission denied,请将你的用户加入 docker 组并重新登录:
sudo usermod -aG docker $USER
1. 克隆 TensorRT-Model-Connect
git clone https://github.com/NVIDIA/TensorRT-Model-Connect.git
cd TensorRT-Model-Connect
官方的入门路径是 Build from Source 加上 Quick Start。下面的命令就是这条路径,并补充了 Jetson 特定的参数。
2. 构建开发容器
在 AGX Orin 上,计算能力是 8.7,因此 TRTMC_SM=87。Jetson 的 Docker 镜像还需要 --runtime nvidia。
GPU=0
SM="$(
  nvidia-smi -i "$GPU" \
    --query-gpu=compute_cap \
    --format=csv,noheader,nounits |
  tr -d '.[:space:]'
)"
IMAGE="trtmc-quickstart"

docker build \
  -f Dockerfile.dev.aarch64 \
  -t "$IMAGE" \
  requirements

SOURCE_DIR="$(git rev-parse --show-toplevel)"

docker run --rm -it \
  --runtime nvidia \
  --gpus "device=${GPU}" \
  --ipc=host \
  --network host \
  --mount "type=bind,source=${SOURCE_DIR},target=/src" \
  --workdir /src \
  --env TRTMC_SM="$SM" \
  "$IMAGE" \
  bash
请在该容器内完成后续命令。镜像已经固定了 TensorRT 11.1、Python 3.12 venv,以及 Qwen 家族构建所需的原生头文件。如果你的 Jetson 上没有 nvidia-smi,请手动将 SM 设为 87。
如果 Hugging Face 快照和 bundle 将存放在外置 SSD 上,也请将该磁盘进行绑定挂载,例如使用 -v /path/to/data:/out。
3. 构建原生运行时
在容器内运行以下命令:
python -m pip install --no-deps -e . -C py-only=true

TRTMC_BUILD_DIR="build-sm${TRTMC_SM}"

cmake -S . -B "$TRTMC_BUILD_DIR" -G Ninja \
  -DCMAKE_BUILD_TYPE=Release \
  -DCMAKE_CUDA_ARCHITECTURES="${TRTMC_SM}-real" \
  -DTRTMC_BUILD_BACKEND_RTX=OFF \
  -DTRTMC_BUILD_TESTS=OFF \
  -DTRTMC_BUILD_EXAMPLES=OFF

cmake --build "$TRTMC_BUILD_DIR" --parallel "$(nproc)" --target \
  trtmc \
  trtmc_backend_trt \
  trtmc_model_qwen

export PATH="$PWD/$TRTMC_BUILD_DIR:$PATH"
trtmc 会从 --runtime-root 查找本地库。请将该参数指向 CMake 构建目录,该目录中必须包含 libtrtmc_core.so、libtrtmc_runtime.so、libtrtmc_backend_trt.so 和 libtrtmc_model_qwen.so。
4. 在 Jetson 上构建 Qwen3-4B bundle
这是以前需要 x86 GPU 机器才能完成的转换步骤。固定 --max-sequence-length。该 checkpoint 的 Hugging Face 配置宣称支持 262,144 token 的上下文,如果保持这个默认值不变,在生成引擎时会耗尽内存。
python -m tensorrt_model_connect build Qwen/Qwen3-4B-Instruct-2507 \
  --precision fp16 \
  --backend trt \
  --max-sequence-length 2048 \
  --max-batch-size 1 \
  --tensor-parallel-size 1 \
  --output qwen3-4b-instruct-2507.bundle \
  --verbose
本地快照目录可以替代模型 ID。构建器会下载 checkpoint,让 Qwen 系列模型接管它,并写出一个已经包含 TensorRT 引擎的 .bundle。
在经过验证的 J5012 设备上,Qwen3-4B FP16 且 max_sequence_length=2048 时,得到如下转换占用情况。公开的 Qwen 单设备 FP16 路径会写出拆分的引擎(engine.plan + prefill.plan);下面的数值来自一个双 profile 构建,其中 prefill 和 decode 共享一个 plan,包含两个优化 profile。
| 指标 | 实测数值 |
|---|---|
| 精度 / 布局 | FP16,双 profile |
| 最大序列长度 | 2048 |
| 引擎生成时间 | 128.1 s |
| TensorRT 权重 | 7.49 GiB |
| Prefill 激活内存 | 633 MiB |
| Decode 激活内存 | 12 MiB |
| TensorRT 分配器 GPU 峰值 | 7,674 MiB |
| 主机使用内存峰值 | 30,640 MB |
| 容器内存峰值 | 41.09 GiB |
| Python RSS 峰值 | 24.7 GB |
最终 .bundle | 7.6 GiB |
这些主机 / 容器内存峰值就是本 wiki 推荐使用 AGX Orin 64GB 的原因。你是在边缘设备上进行转换,但仍然需要足够的统一内存让 TensorRT 构建引擎。
在运行之前检查 bundle:
trtmc inspect ./qwen3-4b-instruct-2507.bundle
trtmc inspect 会打印 JSON。请确认其中包含 family: qwen、task: text_generation,以及一个包含 engine.plan 和 tokenizer 文件的 sections 列表。拆分的 FP16 构建还会列出 prefill.plan。bundle 中依然不会包含 ONNX 计算图。
5. 运行推理
trtmc run ./qwen3-4b-instruct-2507.bundle \
  --runtime-root "$PWD/build-sm${TRTMC_SM}" \
  --prompt "What is the capital of France? Answer in one word." \
  --use-chat-template true \
  --enable-thinking false \
  --max-new-tokens 32
成功运行后会打印一个简短的补全结果,例如 Paris。同一个 bundle 也可以在 C++ 中通过 trtmc::load_task(bundle, runtime_root) 和 ITextGeneration 接口加载;参见 C++ Task API。
推理性能对比 llama.cpp
转换的便利性只是故事的一半。在同一块 J5012 上,我们对比了上下文 2048 时的 TRTMC FP16 与 llama.cpp CUDA + flash-attention FP16。下方图表和表格只保留了 TRTMC 更快的工作负载。
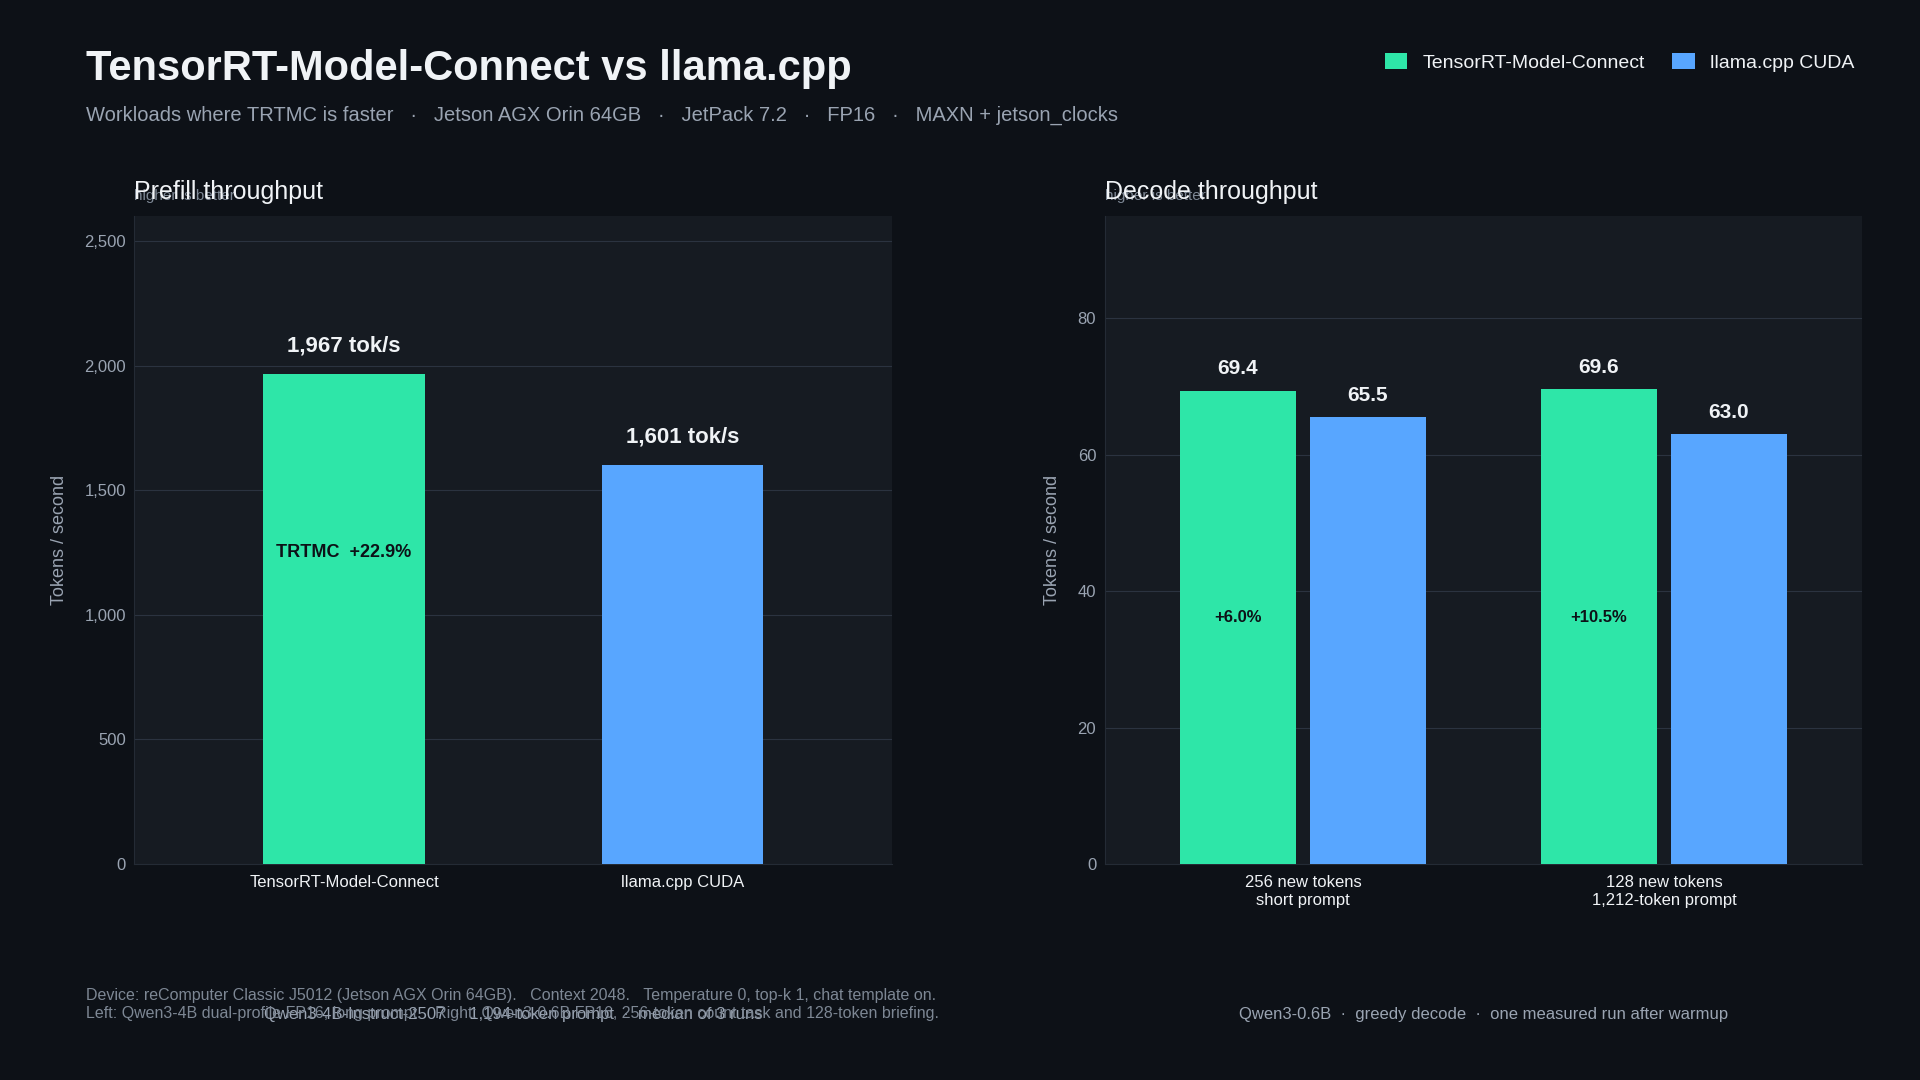
| 工作负载 | TensorRT-Model-Connect | llama.cpp CUDA | TRTMC 优势 |
|---|---|---|---|
| Qwen3-4B-Instruct-2507 长 prefill | 1,967 tok/s · 606.9 ms / 1,194 tok | 1,601 tok/s · 743.2 ms / 1,190 tok | +22.9% |
| Qwen3-0.6B decode,256 个新 token | 69.4 tok/s | 65.5 tok/s | +6.0% |
| Qwen3-0.6B decode,在 1,212-token 提示之后 | 69.6 tok/s | 63.0 tok/s | +10.5% |
4B prefill 结果是一次预热后三次实测运行的中位数。0.6B decode 结果是一次预热后的一次实测运行,在整个请求期间保持模型常驻内存,这样 KV cache 只填充一次,然后生成大量 token。
进行这项对比时请使用稠密的 Qwen3 transformer。像 NVIDIA Nano-9B 这样的混合 Mamba 模型目前在 TRTMC 中是按 token 逐个 prefill,因此不适合作为评估 TensorRT 吞吐量的方式。
复现更快的工作负载
先锁定频率,然后在整个请求期间保持模型常驻内存。请报告引擎计时行,而不是进程墙钟时间。进程墙钟时间包含 TensorRT 反序列化 / GGUF 加载,会掩盖差距。
sudo nvpmodel -m 0   # MAXN; confirm with nvpmodel -q
sudo jetson_clocks
本板上的 llama.cpp 是使用 CUDA 和 flash-attention 构建的,然后在运行时将所有层放在 GPU 上:
cmake -S llama.cpp -B llama.cpp/build-cuda \
  -DGGML_CUDA=ON -DGGML_CUDA_FA=ON -DGGML_NATIVE=ON \
  -DCMAKE_BUILD_TYPE=Release -DCMAKE_CUDA_ARCHITECTURES=87-real
cmake --build llama.cpp/build-cuda -j
1. Qwen3-4B 长 prefill
这是一个能体现批量 TensorRT prefill 引擎优势的工作负载。使用来自第 4 节的 FP16 bundle,并设置 --max-sequence-length 2048,将同一个快照转换为 GGUF F16,然后向两个运行时提供相同的长提示。
本行的共享设置如下:
- 模型:
Qwen/Qwen3-4B-Instruct-2507,FP16,上下文 2048 - 提示:约 6,000 个背景字符加一个 70 词的巴黎问题(应用聊天模板后为 1,190–1,194 个 token)
- 解码:64 个新 token,贪心(
temperature=0,top-k=1) - TRTMC:双 profile bundle,开启聊天模板,关闭思维链
- llama.cpp:
GGML_CUDA=ON、GGML_CUDA_FA=ON、-ngl 99 -c 2048 -b 512 -ub 512 -fa on --jinja - 预热 1 次 + 实测 3 次;取中位数
将同一个 Hugging Face 快照转换为 llama.cpp 使用的 GGUF F16:
python3 convert_hf_to_gguf.py Qwen3-4B-Instruct-2507 \
  --outfile Qwen3-4B-Instruct-2507-F16.gguf \
  --outtype f16
写出长提示,然后运行 TRTMC。读取 [trtmc-perf] Prefill(或 qwen prefill 引擎计时)。
python3 - <<'PY'
from pathlib import Path
filler = (
    "Transit planners track on-time performance, bus bunching, depot energy use, "
    "and spare-ratio policy across a dense coastal city. Housing staff compare "
    "permit latency, vacancy, and school-capacity constraints. Emergency managers "
    "rehearse flood gates, hospital diversion, and radio fallback. "
)
question = (
    "Write a 70-word factual paragraph about Paris. Include the Seine, the Louvre, "
    "and why it became the capital of France. Do not use bullet points. "
    "Do not stop after one word."
)
body = "Use the background notes only as context. Ignore them if they are not needed.\n\n"
while len(body) < 6000:
    body += filler
Path("qwen3-4b-long-prompt.txt").write_text(body[:6000] + "\n\n" + question)
print("wrote qwen3-4b-long-prompt.txt", 6000 + 2 + len(question), "chars")
PY

PROMPT="$(cat qwen3-4b-long-prompt.txt)"

trtmc run ./qwen3-4b-instruct-2507.bundle \
  --runtime-root "$PWD/build-sm${TRTMC_SM}" \
  --prompt "$PROMPT" \
  --use-chat-template true \
  --enable-thinking false \
  --temperature 0 \
  --top-k 1 \
  --max-new-tokens 64
在 llama.cpp 上使用相同的提示。读取 prompt eval time / Prompt: 的 tok/s 行,而不是整个进程生命周期。
llama-completion \
  -m Qwen3-4B-Instruct-2507-F16.gguf \
  -ngl 99 -c 2048 -b 512 -ub 512 -fa on \
  --jinja --temp 0 --top-k 1 -n 64 \
  --no-warmup --simple-io --no-display-prompt \
  --prompt "$PROMPT"
在经过验证的 J5012 上,该 prefill 为 1,967 tok/s 对 1,601 tok/s。
2. Qwen3-0.6B 贪心解码
当你在一次请求中要求较长补全时,decode 是 TRTMC 领先的第二个场景。以与 Qwen3-4B 相同的方式构建 0.6B FP16 bundle,仍然固定 --max-sequence-length 2048。实测使用的 bundle 是一个拆分的 prefill/decode 引擎,KV cache 的 rows=2048。
python -m tensorrt_model_connect build Qwen/Qwen3-0.6B \
  --precision fp16 \
  --backend trt \
  --max-sequence-length 2048 \
  --max-batch-size 1 \
  --tensor-parallel-size 1 \
  --output qwen3-0.6b.bundle \
  --verbose
将同一个快照转换为 llama.cpp 使用的 GGUF F16,然后运行两个 decode 用例。本板上的 llama-cli 需要 -st(单轮),且不接受 --prompt-file;请改用 --prompt 传入。
python3 convert_hf_to_gguf.py Qwen3-0.6B \
  --outfile Qwen3-0.6B-F16.gguf \
  --outtype f16
短提示,256 个新 token:
COUNT_PROMPT='Count from 1 to 220. Write only integers separated by spaces. Do not add commentary. Continue until 220.'

trtmc run ./qwen3-0.6b.bundle \
  --runtime-root "$PWD/build-sm${TRTMC_SM}" \
  --prompt "$COUNT_PROMPT" \
  --use-chat-template true \
  --enable-thinking false \
  --temperature 0 \
  --top-k 1 \
  --max-new-tokens 256

llama-cli -st --simple-io \
  -m Qwen3-0.6B-F16.gguf \
  -ngl 99 -c 2048 \
  --temp 0 --top-k 1 -n 256 \
  --prompt "$COUNT_PROMPT"
长提示,128 个新 token。实测提示在应用聊天模板后为 1,212 个 token:内容是关于进入轨道的说明,然后请求一份 180 词的简报。
python3 - <<'PY'
from pathlib import Path
note = (
    "Low Earth orbit is a crowded working neighborhood for satellites, space stations, "
    "and visiting spacecraft. Reaching it requires a launcher that can fight gravity, "
    "thinning air, and the need for horizontal speed of about 7.8 kilometers per second. "
    "A typical rocket uses staged chemical propulsion. The first stage produces high "
    "thrust to clear the dense atmosphere. Upper stages ignite in thinner air to add "
    "delta-v. Guidance computers fly a gravity turn, then a circularization burn. "
)
text = "Read the notes below. Then write a detailed 180-word briefing on how rockets reach orbit. Keep writing until the briefing is complete.\n\n"
while text.count(" ") < 900:
    text += note
Path("qwen3-06b-long-prompt.txt").write_text(text)
print("wrote", len(text), "chars")
PY

LONG_PROMPT="$(cat qwen3-06b-long-prompt.txt)"

trtmc run ./qwen3-0.6b.bundle \
  --runtime-root "$PWD/build-sm${TRTMC_SM}" \
  --prompt "$LONG_PROMPT" \
  --use-chat-template true \
  --enable-thinking false \
  --temperature 0 \
  --top-k 1 \
  --max-new-tokens 128

llama-cli -st --simple-io \
  -m Qwen3-0.6B-F16.gguf \
  -ngl 99 -c 2048 \
  --temp 0 --top-k 1 -n 128 \
  --prompt "$LONG_PROMPT"
阅读 TRTMC qwen decoder / [trtmc-perf] Decode,以及 llama.cpp eval time / Generation: tok/s。在经过验证的 J5012 上,对于 256 个新 token,这是 69.4 vs 65.5 tok/s,在 1,212 个 token 的提示词之后则是 69.6 vs 63.0 tok/s。
数字代表的含义
- 更少的机器。 你不需要一台带 GPU 的 x86 工作站仅仅为了导出 ONNX。用于服务模型的 Jetson 也可以用来构建模型。
- 相比 Edge-LLM FP8 ONNX 路径,更低的转换主机内存占用。 Edge-LLM 文档中提到,FP8 ONNX 导出时 CPU 内存最高可达模型大小的约 20 倍。Qwen3-4B FP16 TRTMC 构建过程中,在 Orin 64GB 上主机使用约 31 GB / 容器 41 GB。
- 在 Qwen3-4B 上更快的长 prefill,优于 llama.cpp FP16,这正是批处理 TensorRT 引擎发挥作用的负载场景。
- 在 Qwen3-0.6B 上更快的贪心解码,当前后整个补全过程在一次请求中完成时(256 个新 token,或长提示词之后的 128 个新 token)。
- 可复用的制品。
.bundle就是你复制、检查和运行的对象。无需维护一棵需要保持同步的平行 ONNX 树。
故障排查
| 问题 | 检查内容 |
|---|---|
| 容器看不到 GPU | 使用 --runtime nvidia,并确认 docker info 中列出了 nvidia runtime |
| 引擎构建内存不足 | 固定 --max-sequence-length 2048,使用 AGX Orin 64GB,并关闭其他 GPU 使用者 |
trtmc run 无法加载库 | 将 --runtime-root 指向 CMake 构建目录;CLI 不会在 PATH 或当前目录中搜索 DSO |
| Hugging Face 下载失败 | 在磁盘上放置本地快照,并将该目录传给 build,而不是传模型 ID |
| 解码看起来正常但 prefill 很慢 | 确认你使用的是带双配置 / 批处理 prefill 引擎的稠密 transformer,而不是混合 Mamba 计算图 |
| TRTMC 看起来比 llama.cpp 慢 | 比较引擎计时([trtmc-perf]、qwen decoder、llama.cpp eval time),而不是进程墙钟时间。保持模型常驻内存,并在一次请求中生成大量 token |
llama-cli 在 --prompt-file 上报错或等待 stdin | 使用 -st --simple-io --prompt "..." |
Jetson 上缺少 nvidia-smi | 为 AGX Orin 设置 SM=87 |
资源
- TensorRT-Model-Connect repository
- TensorRT-Model-Connect documentation
- Deploy TensorRT Edge-LLM on JetPack 6.2
- reComputer Classic J501 入门指南
- Qwen3-4B-Instruct-2507
- Qwen3-0.6B
技术支持与产品讨论
感谢你选择我们的产品!我们将为你提供多种支持,确保你在使用我们产品的过程中尽可能顺畅。我们提供多种沟通渠道,以满足不同的偏好和需求。