在 Seeed reComputer Jetson 设备上使用预构建 DEB 软件包部署 PREEMPT_RT 实时内核
实时内核(也称为 PREEMPT_RT 内核)是一种具备增强实时调度能力的 Linux 内核变体。它可以降低调度延迟并提升任务执行的确定性,这对于机器人、工业自动化和边缘计算场景中的电机控制、传感器数据采集以及工业总线通信(CAN、EtherCAT)等负载至关重要。
如果你更倾向于从源码构建 PREEMPT_RT 内核,请参考这篇文档。本指南采用了一条更简单的路径:通过一个预构建的 DEB 软件包,在大约一分钟内完成实时内核的安装,同时保留原有标准内核作为回退选项,并允许你在任意时间在两种内核之间切换。
本指南适用于基于 NVIDIA Orin (T234) 模块、运行 JetPack 7.2(Jetson Linux R39.2.0)标准内核的 Seeed reComputer 和 reServer Jetson 设备。单个 DEB 软件包覆盖所有基于 T234 的载板。本文档已在 reComputer Super 上完成测试与验证。
前置条件
- 一台运行标准 JetPack 7.2 系统的 reComputer Super(或其他基于 Orin T234 模块的 Seeed reComputer/reServer Jetson 设备)
- 实时内核 DEB 软件包:nvidia-l4t-kernel-rt-7.2.0-39.2.0-2026-08-26.deb
- 一台用于将 DEB 软件包传输到设备上的主机 PC
对于仍在运行 JetPack 6.2(Jetson Linux R36.4.3)的设备,请改用匹配的软件包 nvidia-l4t-kernel-rt-6.2-36.4.3-2026-08-26.deb。本指南中的操作步骤完全相同,仅内核版本字符串不同(5.15.148-tegra / 5.15.148-rt-tegra)。
如果你的设备尚未刷写标准系统,请先参考 reComputer Super 入门指南文档。
检查标准内核版本
DEB 软件包要求设备当前运行的标准内核版本与软件包匹配。在设备上打开终端并运行:
uname -r
你应当看到类似如下的输出:
6.8.12-1021-tegra
如果输出为其他版本(例如来自旧 JetPack 版本的 5.15.148-tegra,或来自实时内核的 6.8.12-1021-rt-tegra),请先刷写匹配的标准系统镜像,然后再继续本指南的操作。
安装实时内核 DEB 软件包
步骤 1. 将 DEB 软件包传输到设备上(可以使用 U 盘或 scp 等方式):
scp nvidia-l4t-kernel-rt-7.2.0-39.2.0-2026-08-26.deb <username>@<device-ip>:~
步骤 2. 登录到设备并安装该软件包:
sudo dpkg -i ~/nvidia-l4t-kernel-rt-7.2.0-39.2.0-2026-08-26.deb
安装过程大约需要一分钟,且完全自动完成。它会将实时内核镜像放置在 /boot/Image.real-time,在 /lib/modules/6.8.12-1021-rt-tegra/ 下安装匹配的模块,重建 initrd,并将默认启动项切换为实时内核。原有位于 /boot/Image 的标准内核不会被修改,因此始终可以作为回退选项使用。
步骤 3. 重启设备:
sudo reboot
验证实时内核
重启后,确认当前正在运行的是实时内核:
uname -r
cat /sys/kernel/realtime
zcat /proc/config.gz | grep PREEMPT
你应当看到类似如下的输出:
6.8.12-1021-rt-tegra
1
CONFIG_PREEMPT_RT=y
该软件包提供的内核已经预先集成了 Seeed 载板补丁,因此所有外设的行为应当与标准系统完全一致。你可以对其中的一些外设做快速检查:
lsmod | grep nvgpu
ip -br addr
systemctl --failed
systemctl --failed 不应报告任何失败的服务。
在实时内核与标准内核之间切换
你可以在任意时间在两种内核之间切换。要切换回标准内核:
sudo nv-update-extlinux generic && sudo reboot
要再次切换到实时内核:
sudo nv-update-extlinux real-time && sudo reboot
在启动过程中,在启动菜单中于 3 秒内按下 0(标准内核)或 1(实时内核),可以仅对本次启动选择内核,而不会更改默认启动项。
卸载实时内核
在卸载软件包之前,请确保设备已经切换回标准内核。
sudo nv-update-extlinux generic && sudo reboot
sudo apt remove nvidia-l4t-kernel-rt
性能对比:实时内核 vs 标准内核
为了展示实时内核实际带来的改进,我们在三种负载下对两种内核进行了对比:调度器延迟(cyclictest)、GPIO 输出抖动以及 EtherCAT 伺服电机控制——所有测试均在同一台设备上进行,在相同干扰条件下,并保持 CPU 处于满负载状态。
以下所有结果均在一台运行 JetPack 7.2 的 Seeed reComputer Super(Orin Nano Super)上测得,测试期间 CPU 处于满负载。
原理
实验使用了一个名为 spinlock_holder 的内核模块:一个绑定到单个 CPU 核心的内核线程,它反复获取 spin_lock() 并保持锁定指定时长。
- 在标准内核上,
spin_lock()会禁用内核抢占。该 CPU 上的所有任务——包括最高优先级的SCHED_FIFO实时任务——都会在锁释放前被完全冻结。 - 在 PREEMPT_RT 内核上,
spinlock_t被替换为由 rt_mutex 支持的可睡眠锁,因此更高优先级的任务可以在任意时刻抢占持锁线程。
这正是实验要展示的差异:在标准内核上,1 秒的锁持有时间意味着实时任务被卡住 1 秒;而在实时内核上,同样的干扰对实时任务几乎是“隐形”的。
为什么要使用内核线程,而不是用户态忙等进程?用户态负载始终是可调度的——在两种内核上,SCHED_FIFO 任务的优先级都高于它,因此不会出现有趣的现象。只有不可抢占的内核临界区才能真正区分这两种内核。下面的对照组用数据证明了这一点。
测试环境
| 项目 | 数值 |
|---|---|
| 设备 | Seeed reComputer Super(Orin Nano Super,6 核) |
| 系统 | JetPack 7.2(Jetson Linux R39.2.0) |
| 标准内核 | 6.8.12-1021-tegra |
| 实时内核 | 6.8.12-1021-rt-tegra(通过 DEB 软件包部署) |
| 干扰源 | spinlock_holder 内核模块,kthread 绑定到 CPU3 |
| 工作负载 | cyclictest、GPIO 方波(SCHED_FIFO)、IgH EtherCAT master 1 kHz(SCHED_FIFO 89,同一核心) |
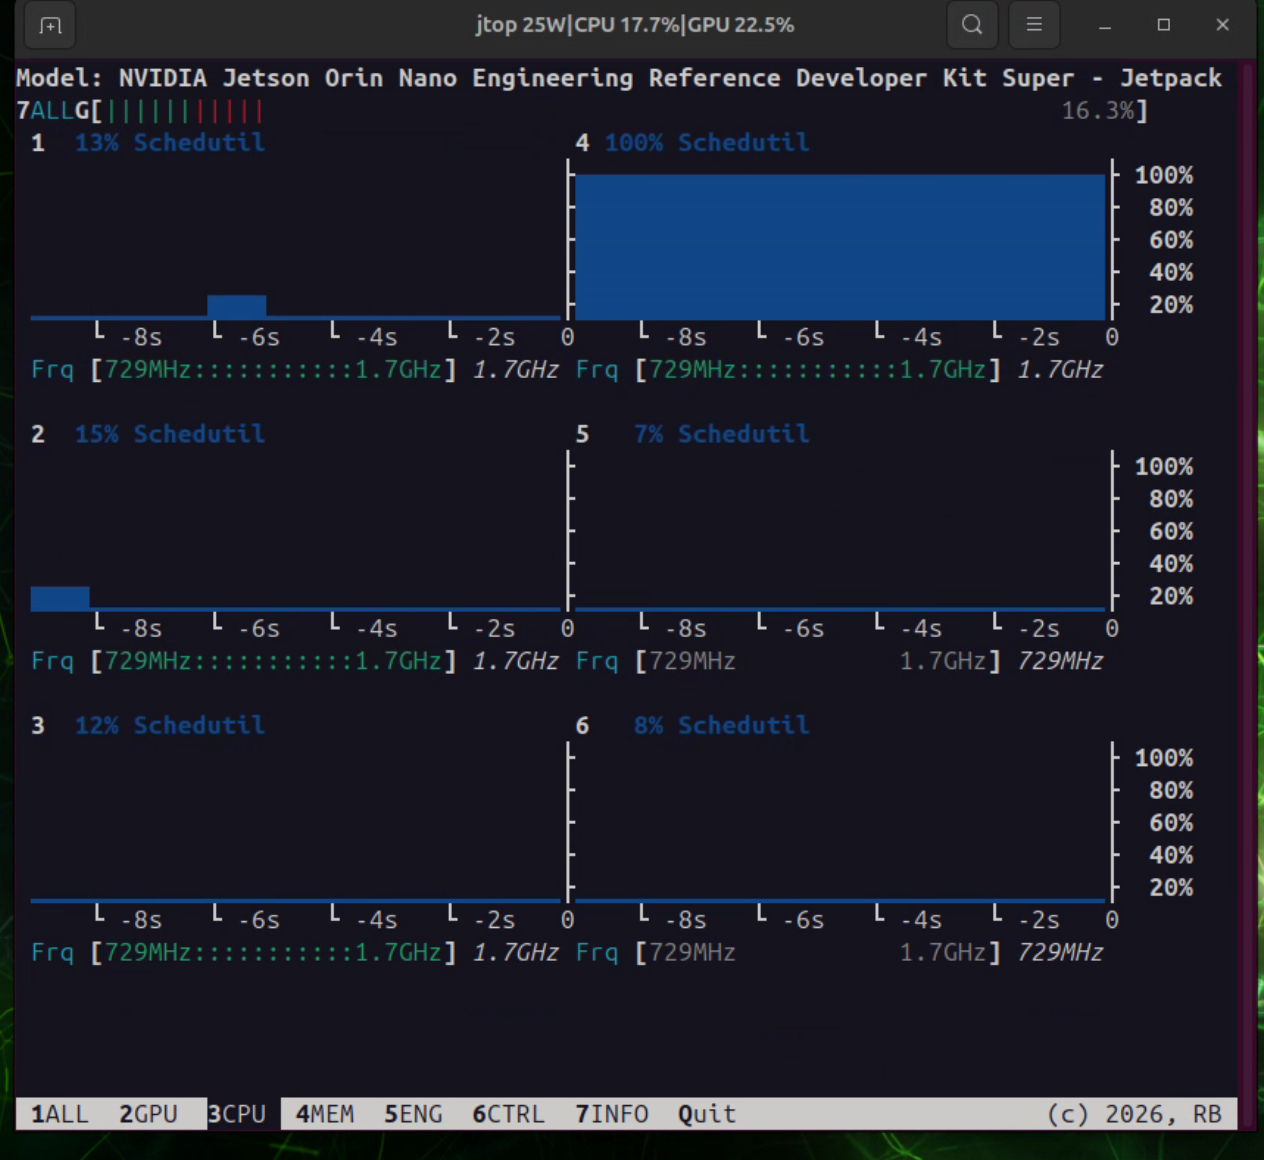
在实验过程中,干扰线程会让目标核心在 jtop 中始终保持 100% 占用,而其他核心则大多处于空闲状态:
Cyclictest 延迟
首先安装 rt-tests:
sudo apt update && sudo apt install -y rt-tests
在一个终端中生成全系统负载:
stress --cpu 6 --io 4 --vm 2 --vm-bytes 64M &
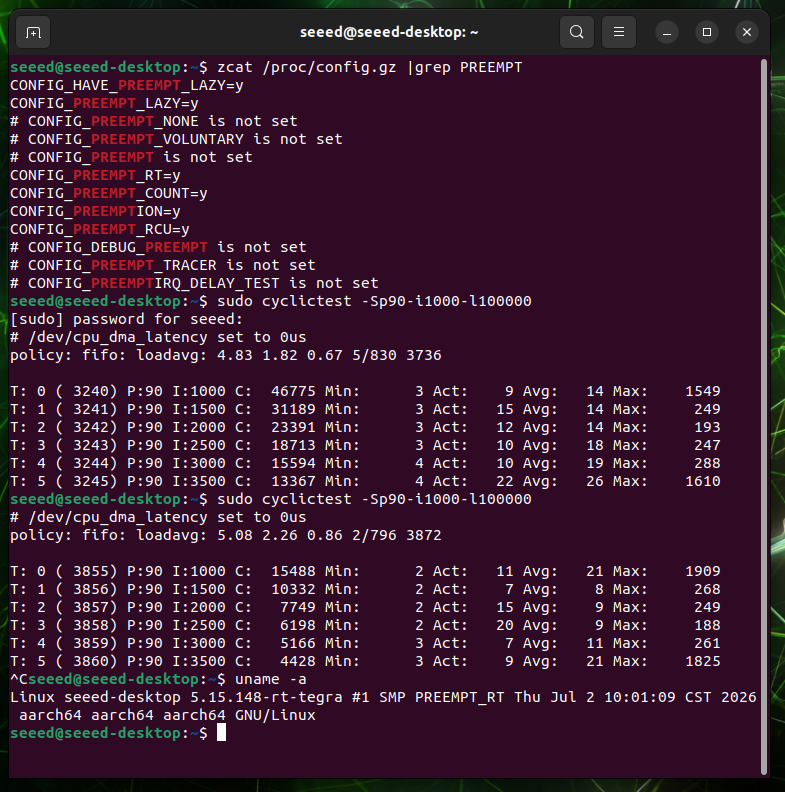
然后在第二个终端中运行 cyclictest,持续 30 秒(-S 选项会在每个 CPU 核心上启动一个测量线程,各线程的测量间隔依次增加 500 µs):
sudo cyclictest -m -S -p90 -i1000 -D30s
下图展示了在标准内核上的一次示例运行:每个线程的平均延迟保持在 8 到 21 µs 之间——看起来与实时内核“迷之接近”——但最大延迟会飙升到 1,909 µs,比实时内核的上限高出 60 倍以上,且无法预测何时会发生:
实时内核对最大延迟有一个硬上限:无论负载多重,它都不会失控。这种确定性正是实时内核存在的意义。
GPIO 方波抖动
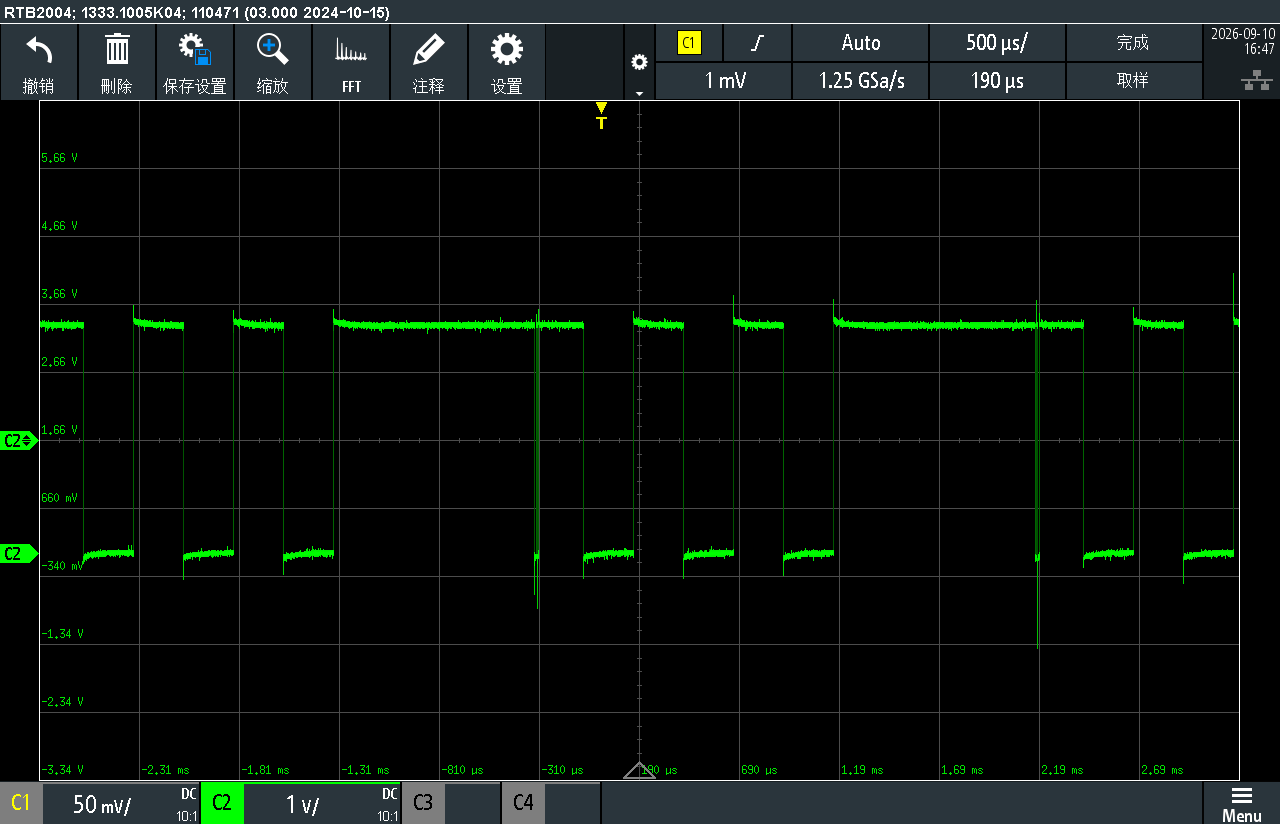
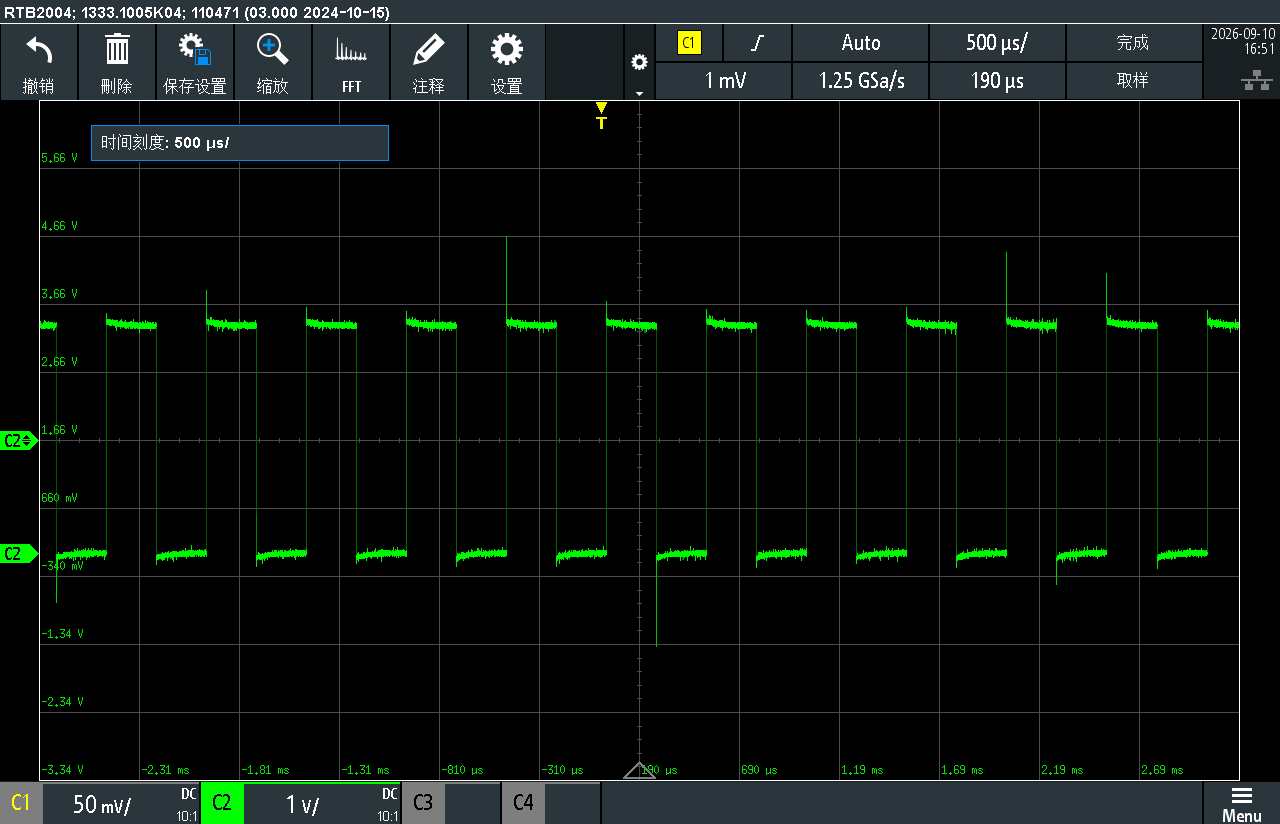
该测试同样在 CPU 满载条件下进行。一个内核线程周期性地在某个 CPU 核心上持有自旋锁,而同一核心上的一个 SCHED_FIFO 任务则以 2 kHz 频率翻转 GPIO 引脚输出方波。边沿时间戳会记录在环形缓冲区中,并在退出时写入日志文件,因此日志记录本身不会引入抖动。边沿间隔统计和示波器波形可以直接展示差异(每 1 ms 持锁 300 µs):
| 锁持有时间 / 周期 | 指标 | 标准内核 | 实时内核 |
|---|---|---|---|
| 300 µs / 1 ms | p99 / max / σ | 306 / 325~547 / 40 µs | 251 / 257 / 0.56 µs |
| 500 µs / 1 ms | 丢失边沿 / 合并对数 | 25% / 25% | 0 / 0 |
| 500 µs / 1 ms | p99 / max | 506 / 529 µs | ~251 µs |
在标准内核上,落在自旋锁窗口内的边沿会被延迟甚至吞掉,因此波形会出现明显畸变。而在实时内核上,波形始终保持干净。
标准内核——每当持有自旋锁时,方波会畸变甚至停顿:
实时内核——连续的方波(时间基准 500 µs/div):
EtherCAT 伺服电机控制
该测试同样在 CPU 满载条件下进行:目标核心在所有阶段都保持高负载。Jetson 设备运行 IgH EtherCAT master(1 kHz 周期,SCHED_FIFO 89),驱动一台 EtherCAT 伺服电机。EtherCAT 驱动器具有约 100 ms 的通信看门狗:如果过程数据帧中断超过该时间,驱动器会切断输出、电机停止。干扰模块在 master 所在核心上每 3 秒持有一次自旋锁,每次 1,000 ms——因此任何超过看门狗时间的停顿,在标准内核上都应该、并且确实会导致总线中断。
一个三阶段的演示在一次运行中展示了完整过程:
| 阶段 | 干扰 | 标准内核 | 实时内核 |
|---|---|---|---|
| 1(10 秒) | 仅 CPU 负载 | 电机平稳旋转 | 电机平稳旋转 |
| 2(15 秒) | + 自旋锁(1,000 ms / 3 s) | CYCLE BROKEN — SAFE STOP,总线掉出 OP,电机停止 | 电机持续旋转,无告警 |
| 3(15 秒) | 移除自旋锁,负载保留 | 主站在约 4 秒内自恢复,电机重新启动 | 无变化 |
在相同运行条件下的核心指标:
| 指标 | 标准内核 | 实时内核 |
|---|---|---|
| 触发安全停机 | 在第一个锁定窗口内 | 从未 |
| 从 OP 掉线的从站 | 每 25 秒 1~3 次 | 0 次 |
| 主站唤醒 p50 / p99 / 最大值 | 7 / ~994,000 / ~1,018,000 µs | 2 / 3 / 12 µs |
| 超过 1 ms 的周期数(每 5,000 个) | ~2,000 | 0 |
| 电机行为 | 锁定期间停止,在释放后约 4 秒恢复 | 连续正弦运动 |
标准内核在锁命中时的输出(主站整整冻结 1 秒,在锁释放后才恢复):
############ Phase 2: LOADING spinlock interference ############
*** CYCLE BROKEN (frozen >500ms) — SAFE STOP: disabling motor ***
!!! BUS DROPPED: slave left OP (AL 0x08 -> 0x4) — comm watchdog/error !!!
[STAT] cycles=15000 WKC0=2255 late>1ms=2084 drops(total)=1
       wake_us p50/p99/max=7/994615/1018037
############ Phase 3: REMOVING interference ############
+++ cycle restored — re-enabling motor +++
在相同干扰下,实时内核在整个运行过程中的输出:
[STAT] cycles=5000  WKC0=131  late>1ms=0 drops(total)=0 wake_us p50/p99/max=2/3/8
[STAT] cycles=10000 WKC0=0    late>1ms=0 drops(total)=0 wake_us p50/p99/max=2/3/9
[STAT] cycles=15000 WKC0=0    late>1ms=0 drops(total)=0 wake_us p50/p99/max=2/3/8
Running: Act=41268 Vel=29970 TgtV=29630 md=9 SW=1237
主站内置了周期健康监控:唤醒延迟超过 500 ms 会被视为“冻结”,并触发受控安全停机(工业协议栈的标准做法);在没有冻结的情况下,电机会在 4 秒后重新使能。在标准内核上,干扰每 3 秒出现一次,因此恢复窗口从未打开。
在标准内核上,主站会停顿整整几秒——超过 EtherCAT 驱动看门狗(约 100 ms)的 10 倍——因此总线掉出 OP 状态,电机被禁用。在实时内核上,主站唤醒抖动始终保持在几微秒范围内,总线和电机都不会受到干扰的影响。
在实时内核上,EtherCAT 伺服电机平稳旋转 30 秒:
在标准内核上,只要锁被持有电机就会停止(旋转 10 秒,停转 15 秒,再旋转 15 秒):
对照组:CPU 负载不是“杀手”
为了证明损害来自不可抢占的临界区而不是 CPU 利用率,用一个普通的 SCHED_OTHER 用户进程(忙 1 s / 空闲 2 s,峰值 100%)替代自旋锁模块对同一个核心施加负载——同一核心,同一节奏:
| 指标 | 标准 + CPU 负载 | 实时 + CPU 负载 | 标准 + 自旋锁 |
|---|---|---|---|
| 电机 | 旋转 | 旋转 | 停止 |
| 总线掉线 / 安全停机 | 0 / 0 | 0 / 0 | 1~3 / 触发 |
| 唤醒 p99 | 最高 1,879 µs | 11 µs | ~994,000 µs |
| 唤醒最大值 | ~8,200 µs | 32 µs | ~1,018,000 µs |
| 超过 1 ms 的周期数(每 5,000 个) | 28~56 | 0 | ~2,000 |
在两个内核上,用户态负载都不会压过 SCHED_FIFO 任务,因此电机在两列中都保持转动——但标准内核仍然被拖入毫秒级抖动(p99 大约比实时内核差 170 倍)。真正把抖动变成长达一秒中断的是内核自旋锁。“杀手”不是 CPU 使用率,而是不可抢占的内核临界区。
复现实验
GPIO 实验的完整源代码(干扰模块、方波任务和 Makefile)已嵌入在下方,可直接使用。EtherCAT 演示基于开源项目 ethercat-myctor,并使用了自定义设备控制器;完整演示包(控制器覆盖、运行脚本和 CPU 负载生成器)可在此处获取:rt_ethercat_demo.zip。
在两个内核之间切换的方法见 Switch Between the Real-Time and Standard Kernels。每次切换后,用 uname -v 进行验证——输出中应分别包含 SMP PREEMPT_RT 或 SMP PREEMPT。
准备实时内核源码树(一次性)
实时 DEB 包只包含内核镜像和模块,不包含头文件包。内核模块必须在实时内核运行时,针对已准备好的源码树进行构建,否则 insmod 会因 module_layout disagrees 而失败。
curl -sL -o ~/public_sources.tbz2 \
  https://developer.download.nvidia.cn/embedded/L4T/r39_Release_v2.0/sources/public_sources.tbz2
mkdir -p ~/nvsrc ~/rt-kernel-src
tar xf ~/public_sources.tbz2 -C ~/nvsrc Linux_for_Tegra/source/kernel_src.tbz2
tar xf ~/nvsrc/Linux_for_Tegra/source/kernel_src.tbz2 -C ~/rt-kernel-src --strip-components=1

cd ~/rt-kernel-src/kernel-noble
zcat /proc/config.gz > .config
sed -i 's/^CONFIG_LOCALVERSION=".*"/CONFIG_LOCALVERSION="-1021-rt-tegra"/' .config
make ARCH=arm64 olddefconfig
make ARCH=arm64 -j6 prepare modules_prepare
CONFIG_LOCALVERSION 必须等于 uname -r 中 6.8.12 之后的后缀(此处为 -1021-rt-tegra),否则模块的 vermagic 将不匹配。对于标准内核,请使用 -1021-tegra 并以相同方式准备源码树。
演示源代码(GPIO 实验)
创建一个工作目录,并将以下三个文件放入其中:
mkdir -p ~/rt_demo && cd ~/rt_demo
spinlock_holder.c —— 干扰模块:
// spinlock_holder: PREEMPT_RT demo module (ms and us granularity)
//
// One-shot mode (period = 0): sysfs trigger makes the bound kthread hold a
// spinlock for the configured hold time, once. On a normal kernel
// spin_lock() disables preemption so every task on that CPU freezes for
// the duration; on PREEMPT_RT spinlock_t is a sleepable rt_mutex-backed
// lock and higher priority tasks preempt the holder instead.
//
// Periodic mode (period > 0): the kthread repeats hold/idle cycles.
// Writing any *_us parameter (or period) via sysfs wakes the kthread so
// changes take effect immediately.
#include <linux/module.h>
#include <linux/kernel.h>
#include <linux/slab.h>
#include <linux/kthread.h>
#include <linux/delay.h>
#include <linux/spinlock.h>
#include <linux/wait.h>
#include <linux/sysfs.h>
#include <linux/kobject.h>
#include <linux/sched.h>
#include <linux/ktime.h>

static int demo_cpu = 3;
module_param(demo_cpu, int, 0644);
MODULE_PARM_DESC(demo_cpu, "CPU to bind the holder kthread to (default 3)");

static int hold_ms = 3000;
module_param(hold_ms, int, 0644);
MODULE_PARM_DESC(hold_ms, "critical section length in ms (one-shot default 3000)");

static int period_ms = 0;
MODULE_PARM_DESC(period_ms, "0 = one-shot trigger; >0 = repeat every period_ms (ms mode)");

static int idle_ms = 400;
module_param(idle_ms, int, 0644);
MODULE_PARM_DESC(idle_ms, "ms mode: ms to idle between critical sections");

static int hold_us = 500;
MODULE_PARM_DESC(hold_us, "us mode: critical section length in us");

static int period_us = 1000;
MODULE_PARM_DESC(period_us, "us mode: full period in us (hold_us + idle). >0 selects us mode");

static int idle_us = 700;
module_param(idle_us, int, 0644);
MODULE_PARM_DESC(idle_us, "us mode: idle part of the period in us");

static DEFINE_SPINLOCK(test_lock);
static DECLARE_WAIT_QUEUE_HEAD(trigger_wq);
static atomic_t triggered = ATOMIC_INIT(0);

static struct task_struct *holder_task;
static u64 hold_count;

static void spin_for_ns(u64 ns)
{
	u64 end = ktime_get_ns() + ns;
	while (ktime_get_ns() < end)
		cpu_relax();
}

static void spin_for_ns_periodic(u64 ns)
{
	if (ns > (u64)50 * 1000)         /* > 50 us left: udelay in chunks */
		udelay(ns / 1000);
	else if (ns > 0)
		spin_for_ns(ns);
}

static void run_critical_section_us(void)
{
	u64 t0_ns = ktime_get_ns();
	u64 t1_ns;

	spin_lock(&test_lock);
	spin_for_ns((u64)hold_us * 1000);
	spin_unlock(&test_lock);

	t1_ns = ktime_get_ns();
	hold_count++;

	/* log only every 2000 holds to keep dmesg quiet at kHz rates */
	if (hold_count % 2000 == 1)
		pr_info("spinlock_holder: cpu %d hold #%llu wall %llu us (%s)\n",
			smp_processor_id(), hold_count,
			div_u64(t1_ns - t0_ns, 1000),
			(t1_ns - t0_ns) > (u64)hold_us * 1200
				? "stretched by preemption" : "clean");
}

static void run_critical_section_ms(void)
{
	u64 t0_ns = ktime_get_ns();
	u64 t1_ns;

	spin_lock(&test_lock);
	mdelay(hold_ms);
	spin_unlock(&test_lock);

	t1_ns = ktime_get_ns();
	hold_count++;

	pr_info("spinlock_holder: cpu %d hold #%llu wall %llu ms (%s)\n",
		smp_processor_id(), hold_count,
		div_u64(t1_ns - t0_ns, 1000000),
		(t1_ns - t0_ns) > (u64)hold_ms * 1200000 / 1000
			? "stretched by preemption" : "clean");
}

static int holder_fn(void *unused)
{
	while (!kthread_should_stop()) {
		if (period_us > 0) {
			u64 cycle_start = ktime_get_ns();
			s64 spent_ns;

			run_critical_section_us();
			/* busy-wait the remainder of the period for exact rate.
			 * s64: if hold overran the period, remainder clamps to 0
			 * instead of wrapping to ~2^64 ns (which would udelay forever). */
			spent_ns = (s64)(ktime_get_ns() - cycle_start);
			if (spent_ns < (s64)period_us * 1000)
				spin_for_ns_periodic((u64)period_us * 1000 - (u64)spent_ns);
		} else if (period_ms > 0) {
			run_critical_section_ms();
			msleep(max(idle_ms, 1));
		} else {
			wait_event_interruptible(trigger_wq,
						 atomic_read(&triggered) || kthread_should_stop());
			if (kthread_should_stop())
				break;
			if (atomic_read(&triggered)) {
				run_critical_section_ms();
				atomic_set(&triggered, 0);
			}
		}
	}
	return 0;
}

static int wake_holder(const char *val, const struct kernel_param *kp)
{
	int ret = param_set_int(val, kp);
	if (ret)
		return ret;
	atomic_set(&triggered, 1);
	wake_up(&trigger_wq);
	if (holder_task)
		wake_up_process(holder_task);
	return 0;
}

static const struct kernel_param_ops wake_ops = { .set = wake_holder, .get = param_get_int };
module_param_cb(period_ms, &wake_ops, &period_ms, 0644);
module_param_cb(period_us, &wake_ops, &period_us, 0644);
module_param_cb(hold_us, &wake_ops, &hold_us, 0644);

static ssize_t trigger_store(struct kobject *kobj, struct kobj_attribute *attr,
			     const char *buf, size_t count)
{
	if (period_us > 0 || period_ms > 0)
		return -EBUSY;
	atomic_set(&triggered, 1);
	wake_up(&trigger_wq);
	return count;
}

static struct kobj_attribute trigger_attribute =
	__ATTR(trigger, 0220, NULL, trigger_store);

static struct kobject *demo_kobj;

static int __init spinlock_holder_init(void)
{
	struct task_struct *t;
	int ret;

	/* create parked, bind while parked, then start — kthread_run()+bind()
	 * races and the bind gets rejected with a WARNING in dmesg */
	t = kthread_create(holder_fn, NULL, "spinlock_holder");
	if (IS_ERR(t))
		return PTR_ERR(t);
	kthread_bind(t, demo_cpu);
	wake_up_process(t);
	holder_task = t;

	demo_kobj = kobject_create_and_add("spinlock_holder", kernel_kobj);
	if (!demo_kobj) {
		kthread_stop(t);
		return -ENOMEM;
	}

	ret = sysfs_create_file(demo_kobj, &trigger_attribute.attr);
	if (ret) {
		kobject_put(demo_kobj);
		kthread_stop(t);
		return ret;
	}

	pr_info("spinlock_holder: loaded, cpu %d, us-mode: hold %d us / period %d us%s\n",
		demo_cpu, hold_us, period_us,
		period_us > 0 ? " [ACTIVE]" : " (inactive; set period_us>0)");
	return 0;
}

static void __exit spinlock_holder_exit(void)
{
	kthread_stop(holder_task);
	kobject_put(demo_kobj);
	pr_info("spinlock_holder: unloaded after %llu holds\n", hold_count);
}

module_init(spinlock_holder_init);
module_exit(spinlock_holder_exit);

MODULE_LICENSE("GPL");
MODULE_DESCRIPTION("PREEMPT_RT demo: spinlock critical section vs schedulable tasks (ms/us modes)");
gpio_pwm.c — SCHED_FIFO 方波任务(需要 sudo apt install -y libgpiod-dev):
// gpio_pwm: toggle a GPIO line every half-period from a SCHED_FIFO task.
// Half period is configurable in microseconds (default 500000 = 1s square
// wave). Edges are timestamped (CLOCK_MONOTONIC) into a ring buffer and
// flushed to edges.log so logging itself never adds jitter.
#define _GNU_SOURCE
#define _DEFAULT_SOURCE
#include <gpiod.h>
#include <sys/mman.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <time.h>
#include <sched.h>
#include <unistd.h>
#include <errno.h>
#include <signal.h>

#define CHIP    "gpiochip0"
#define LINE    41
#define NBUF    (1 << 20)                      /* 1M edges ring buffer */

static volatile sig_atomic_t stop = 0;
static void on_sigint(int s) { (void)s; stop = 1; }

static double now_sec(void)
{
	struct timespec ts;
	clock_gettime(CLOCK_MONOTONIC, &ts);
	return ts.tv_sec + ts.tv_nsec / 1e9;
}

struct edge { int level; double t; };
static struct edge ring[NBUF];
static size_t nring;

int main(int argc, char **argv)
{
	int cpu = argc > 1 ? atoi(argv[1]) : 3;
	long half_us = argc > 2 ? atol(argv[2]) : 500000;
	struct gpiod_chip *chip;
	struct gpiod_line *line;
	struct sched_param sp = { .sched_priority = 80 };
	cpu_set_t set;
	FILE *log;
	double t0, target;
	int level = 0;
	struct sigaction sa = { .sa_handler = on_sigint };
	struct timespec req;

	sigaction(SIGINT, &sa, NULL);

	CPU_ZERO(&set);
	CPU_SET(cpu, &set);
	if (sched_setaffinity(0, sizeof(set), &set)) { perror("setaffinity"); return 1; }
	if (sched_setscheduler(0, SCHED_FIFO, &sp)) { perror("SCHED_FIFO (run as root)"); }
	mlockall(MCL_CURRENT | MCL_FUTURE);

	chip = gpiod_chip_open_by_name(CHIP);
	if (!chip) { perror("gpiod_chip_open"); return 1; }
	line = gpiod_chip_get_line(chip, LINE);
	if (!line) { perror("gpiod_chip_get_line"); return 1; }
	if (gpiod_line_request_output(line, "gpio_pwm", 0)) { perror("request_output"); return 1; }

	fprintf(stderr, "gpio_pwm: toggling %s line %d every %ld us on cpu %d (fifo %d). Ctrl-C to stop.\n",
		CHIP, LINE, half_us, cpu, sp.sched_priority);

	t0 = now_sec();
	target = t0;

	while (!stop) {
		level = !level;
		gpiod_line_set_value(line, level);

		if (nring < NBUF) {
			ring[nring].level = level;
			ring[nring].t = now_sec() - t0;
			nring++;
		} else {
			fprintf(stderr, "ring full, stopping\n");
			break;
		}

		target += half_us / 1e6;
		req.tv_sec = (time_t)target;
		req.tv_nsec = (long)((target - (time_t)target) * 1e9);
		clock_nanosleep(CLOCK_MONOTONIC, TIMER_ABSTIME, &req, NULL);
	}

	gpiod_line_release(line);
	gpiod_chip_close(chip);

	log = fopen("edges.log", "w");
	if (!log) { perror("fopen edges.log"); return 1; }
	for (size_t i = 0; i < nring; i++)
		fprintf(log, "%d %.6f\n", ring[i].level, ring[i].t);
	fclose(log);
	fprintf(stderr, "gpio_pwm: stopped, %zu edges written to edges.log\n", nring);
	return 0;
}
Makefile:
# Normal kernel:            make
# RT kernel (JP7.2, no headers pkg): make KDIR=~/rt-kernel-src/kernel-noble
obj-m += spinlock_holder.o

KDIR ?= /lib/modules/$(shell uname -r)/build

all: spinlock_holder.ko gpio_pwm

spinlock_holder.ko:
	KBUILD_MODPOST_WARN=1 $(MAKE) -C $(KDIR) M=$(CURDIR) modules

gpio_pwm: gpio_pwm.c
	$(CC) -O2 -Wall -o $@ $< $(shell pkg-config --cflags --libs libgpiod)

clean:
	$(MAKE) -C $(KDIR) M=$(CURDIR) clean
	rm -f gpio_pwm

.PHONY: all clean
要使用不同的 GPIO 引脚,请修改 gpio_pwm.c 中的 CHIP / LINE 宏。使用 gpioinfo gpiochip0 列出载板上可用的 line,然后在 40 针排针上选择一个未被占用且支持输出的 line。
为两个内核构建干扰模块
# Standard kernel
make
# Real-time kernel
KBUILD_MODPOST_WARN=1 make KDIR=~/rt-kernel-src/kernel-noble
实时构建需要 KBUILD_MODPOST_WARN=1:只运行过 modules_prepare 的源码树没有 Module.symvers,因此 modpost 会把每个内核符号都报告为未定义——这些都是误报。
运行演示
GPIO 演示(在 GPIO 引脚上接示波器),在满负载 CPU 下运行:
stress --cpu 6 --io 4 --vm 2 --vm-bytes 64M &
sudo insmod spinlock_holder.ko demo_cpu=3 hold_us=300 period_us=1000
sudo ./gpio_pwm 3 250
EtherCAT 演示(三个阶段:仅负载、负载 + 自旋锁、仅负载):
sudo ./run_demo.sh 10 15 15
该脚本会启动 EtherCAT 主站,等待总线就绪,启动 CPU 负载,按计划加载和卸载自旋锁模块(根据内核版本选择正确的 .ko),并在结束时进行清理。
已知陷阱
| 现象 | 原因 | 解决方法 |
|---|---|---|
修改参数后出现 insmod: File exists | 模块参数只在首次加载时生效 | 通过 /sys/module/spinlock_holder/parameters/ 修改,或先 rmmod 再重新 insmod |
| 干扰模块看起来已加载但波形很干净 | holder 线程在没有报错的情况下停止(“假运行”) | 检查 dmesg 中的 hold # 计数是否持续增加;如果没有,rmmod 并重新加载 |
insmod: Invalid module format | 模块是针对另一个内核构建的 | 针对当前正在运行的内核源码树重新构建 |
modpost: "kfree" ... undefined | 预处理过的源码树没有 Module.symvers | 使用 KBUILD_MODPOST_WARN=1 构建 |
openssl/opensslv.h: No such file | 缺少 libssl-dev | sudo apt install libssl-dev |
EtherCAT 端口显示 Link: DOWN | 端口被 NetworkManager 占用 | sudo nmcli dev set <interface> managed no |
| 多次看门狗触发后执行器拒绝激活 | 多次总线掉线后驱动固件锁死 | 对执行器断电重启 |
| 中断演示脚本后所有东西都出问题 | 自旋锁模块仍然处于加载状态 | 执行 sudo rmmod spinlock_holder,然后视情况对执行器断电重启 |
总结
在标准内核上,一个被持有 1 秒的内核自旋锁会让该 CPU 上的所有任务冻结 1 秒——包括最高优先级的 SCHED_FIFO EtherCAT 主站。1 秒的帧丢失是驱动看门狗时间的 10 倍,因此总线会从 OP 状态掉线、电机停止,而反复的干扰会阻止其恢复。在 PREEMPT_RT 内核上,同样的干扰只会让实时任务付出个位数微秒的代价。对于硬实时现场总线来说,实时内核并不是“更快”——而是不会被内核内部活动饿死,这一点是标准内核无论如何调优都无法保证的。
参考资料
- https://wiki.seeedstudio.com/cn/flash_preempt_rt_kernel_on_recomputer_jetson_jetpack_6_2_1/
- https://gitlab.com/etherlab.org/ethercat
技术支持与产品讨论
感谢您选择我们的产品!我们将为您提供多种支持,确保您在使用我们产品的过程中尽可能顺畅。我们提供多种沟通渠道,以满足不同的偏好和需求。