JetPack 7.2 内存优化
Jetson 使用统一内存,因此操作系统、GPU 负载、相机和显示固件、模型权重、TensorRT 引擎、KV 缓存以及应用服务都会竞争同一片物理 DRAM。内存优化因此需要同时覆盖平台和推理工作负载。
本指南整合了本合集中已有的 JetPack 7.2 资料:
- JetPack 7.2 深度解析,包括加载 27B 模型后测得的内存下降;
- 用于设备诊断、内存审计和无头部署的 NVIDIA Skills 工作流;
- 面向 JetPack 7.2 上 FP16、INT8 和 INT4 推理的 TensorRT Edge-LLM 指南。
BSP 级别的内存回收会更改启动固件、设备树和内核命令行设置。仅将已验证的 headless、no-camera 或 SWIOTLB 配方应用到可恢复的测试设备上。保留原始 BSP,并在进行这些更改前确认设备可以重新刷写。
想了解这些步骤背后的“原因”吗?配套的 JetPack 7.2 内存优化深度解析 解释了可用空间从何而来:相对于 JetPack 6.2 的平台基线、LLM 内存预算、运行时机制以及现场观测。
优化层级
使用能解决问题的侵入性最低的层级。
| 层级 | 典型操作 | 风险 | 是否需要重启或重刷 |
|---|---|---|---|
| 测量 | 记录可用内存和每个进程的使用情况 | 低 | 否 |
| 推理配置 | 量化、更短上下文、批大小为 1、更低并发度 | 低 | 否 |
| 服务配置 | 无头目标、停止重复的模型服务器、禁用未使用的用户服务 | 中 | 通常需要重启 |
| BSP 内存回收 | 禁用未使用的显示或相机固件和保留内存 | 高 | 重新构建并重刷 |
| SWIOTLB 调优 | 在测量实际使用后缩小 DMA 跳转缓冲池 | 高 | 重新构建并重刷 |
1. 记录可复现的基线
在启动应用之前确认软件版本并捕获内存状态:
cat /etc/nv_tegra_release
free -h
grep -E 'MemTotal|MemAvailable|SwapTotal|SwapFree|CmaTotal|CmaFree' /proc/meminfo
在加载和运行模型时监控统一内存、GPU 使用率、温度和功耗:
sudo tegrastats --interval 1000
在另一个终端中,识别占用最大的进程和控制组:
ps -eo pid,comm,rss,vsz,%mem --sort=-rss | head -20
systemd-cgtop
至少记录以下四种状态:
- 启动后且应用启动之前;
- 模型或 TensorRT 引擎加载之后;
- 提示预填充期间或视觉预处理峰值期间;
- 稳态生成 token 或应用运行期间。
不要只比较 free 中的 used 值。要同时使用 MemAvailable、进程 RSS 列表以及 tegrastats 报告的峰值。
2. 在编辑 BSP 之前使用 Skills 进行审计
基于技能驱动的工作流应从观测开始,而不是立刻修改配置。
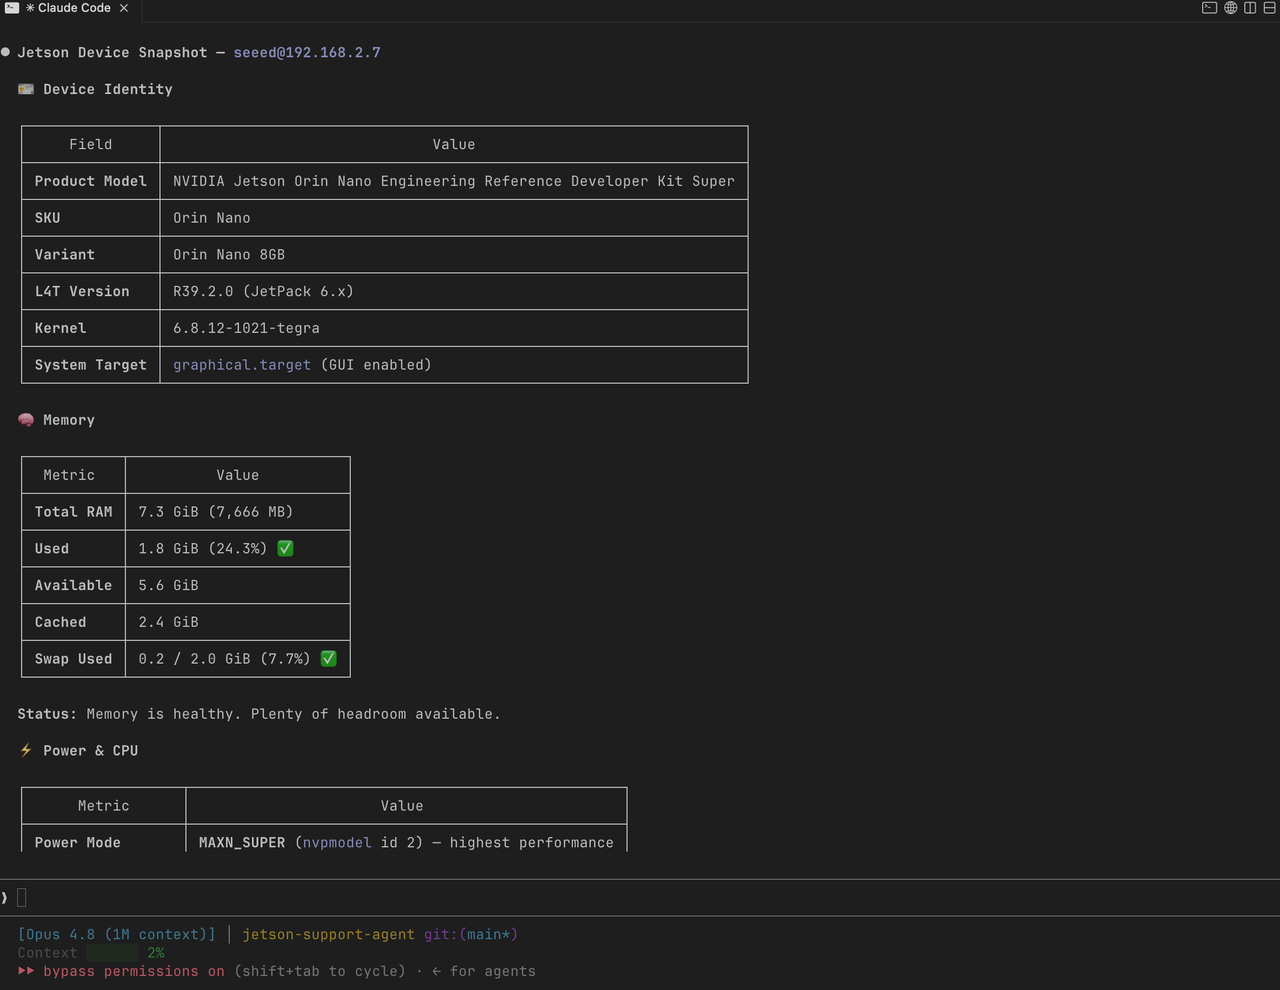
诊断设备
使用 jetson-diagnostic 收集模组、JetPack/L4T 版本、内存状态、存储、热状态、服务以及可见硬件端点。
示例提示:
/jetson-diagnostic Confirm that this device is running JetPack 7.2 / L4T 39.2,
capture its idle memory baseline, and identify services or hardware subsystems
that consume memory before the inference application starts.
审计内存压力
当模型加载失败、OOM killer 终止进程或内存使用异常增长时,使用 jetson-memory-audit。
/jetson-memory-audit Compare idle, engine-load, prefill, and decode memory use.
Separate model weights, KV cache, application processes, filesystem cache,
desktop services, and reserved platform memory where possible.
审计应在给出修改建议之前产出证据。不要仅因为某个服务出现在进程列表顶部就将其禁用。
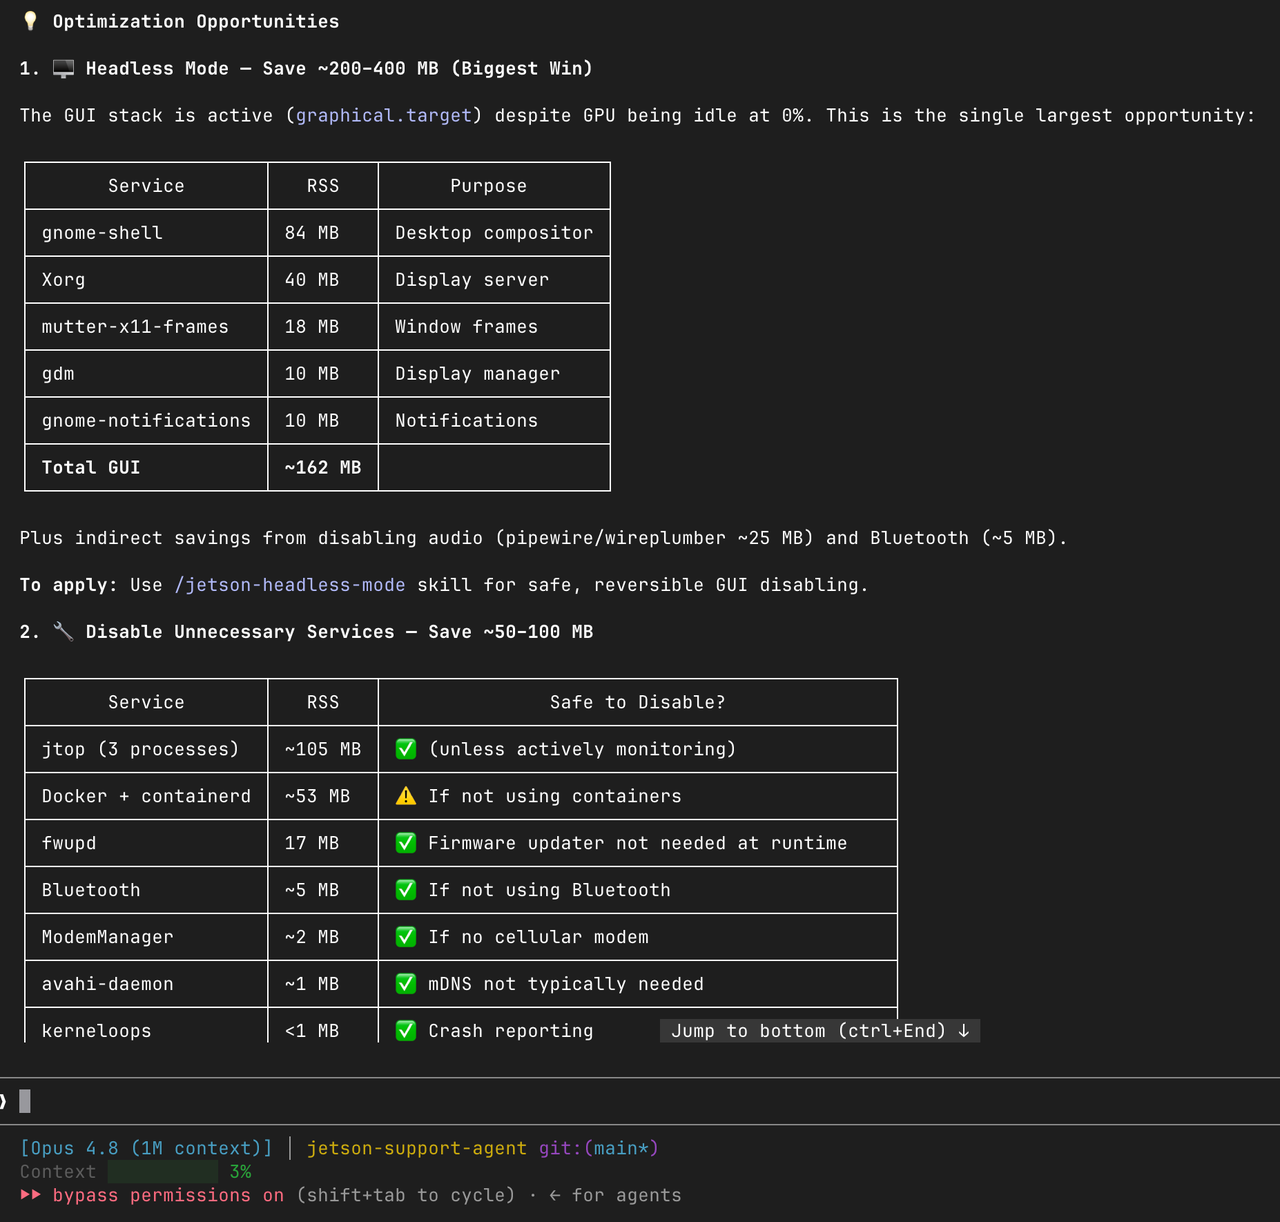
将设备化部署转换为无头模式
如果 Jetson 在没有本地显示的情况下运行,使用 jetson-headless-mode 在服务层面移除桌面开销。
标准的 systemd target 为:
sudo systemctl set-default multi-user.target
sudo reboot
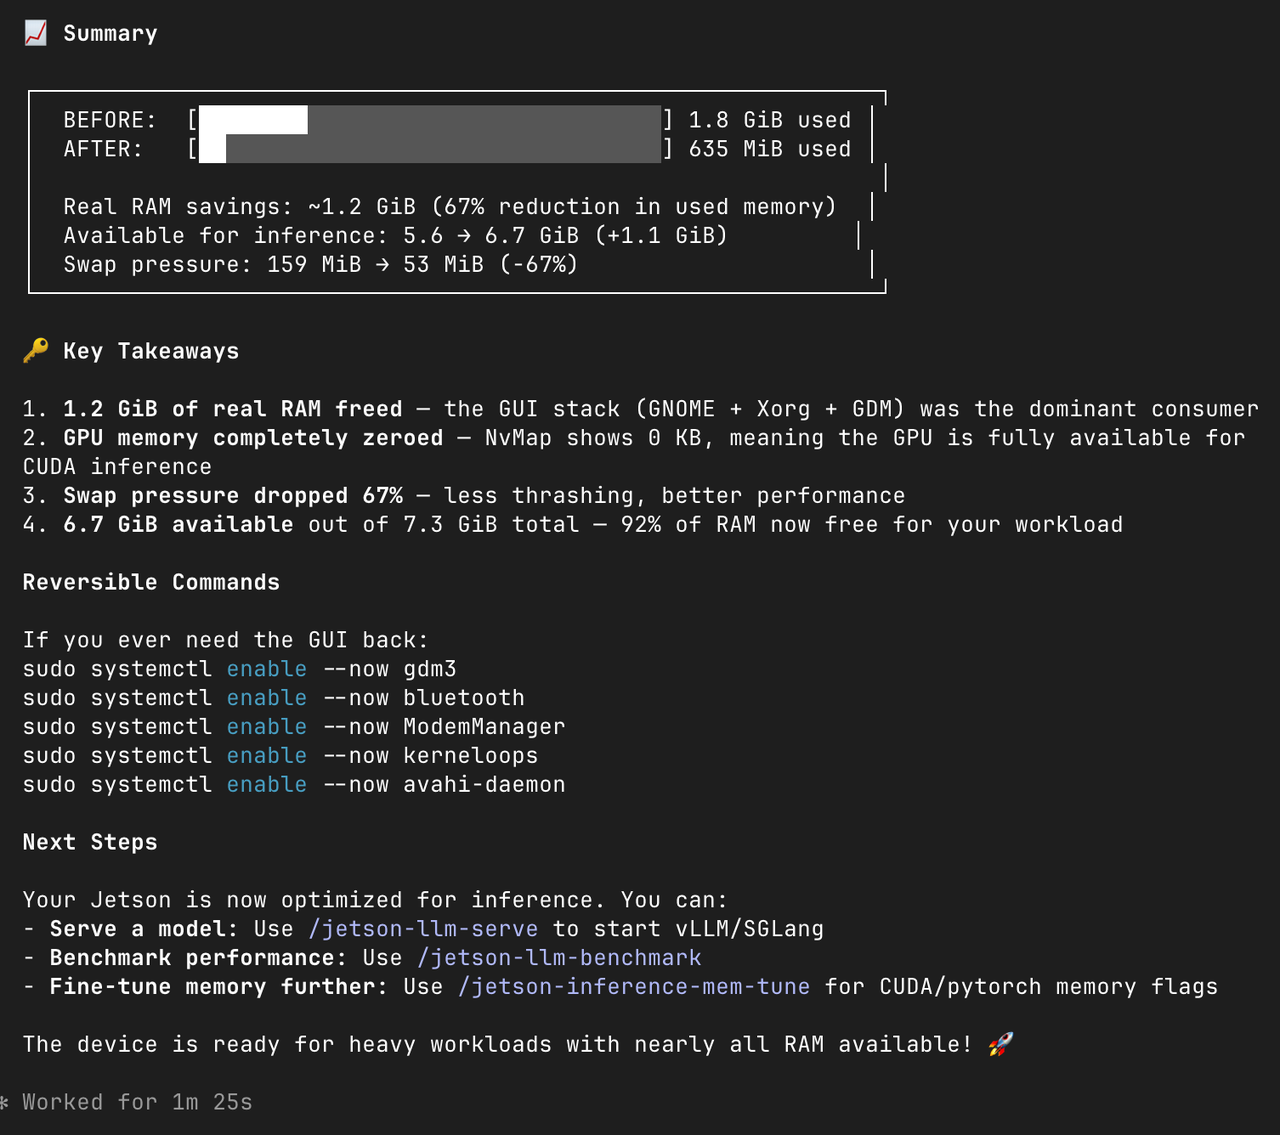
在重启前确认 SSH 访问。此服务级别的更改与在 BSP 中回收显示固件 carveout 是分开的。
仅在已验证的 BSP 场景中使用 jetson-optimize-memory
BSP 级别的 skill 支持三个有边界的工作流:
| 场景 | 预期部署 | 回收的平台区域 |
|---|---|---|
headless | 无本地显示输出 | DCE/显示固件、早期帧缓冲以及匹配的内核节点 |
no-camera | 无 CSI、GMSL 或其他相机管线 | RCE、VI、ISP、NVCSI 以及匹配的固件 carveout |
swiotlb | 实测 DMA 跳转缓冲池使用远低于保留池 | 更小但非零的 SWIOTLB 分配 |
示例请求:
/jetson-optimize-memory headless
/jetson-optimize-memory no-camera
/jetson-optimize-memory swiotlb
对于 carveout 更改,MB1 BCT、MB2 加载控制、MB2 AST 引用以及内核设备树节点必须保持一致。仅将某个 carveout 条目清零并不是有效的优化。对于 SWIOTLB,切勿配置为零大小的池,并且如果 io_tlb_used 接近 io_tlb_nslabs,要立即回退。
3. 降低 LLM 和 VLM 的内存使用
选择支持的最小精度
JetPack 7.2 上的 TensorRT Edge-LLM 在 Jetson Orin 上支持 FP16、INT8 和 INT4。先从 FP16 开始以验证正确性,然后评估所选模型支持的 INT8 或 INT4 checkpoint。
| 精度 | 内存趋势 | 推荐用途 |
|---|---|---|
| FP16 | 支持的 Orin 路径中内存占用最高 | 功能基线和对精度敏感的工作负载 |
| INT8 | 权重内存更低,精度折中适中 | 平衡的生产评估 |
| INT4 | 支持路径中权重内存最低 | DRAM 有限的大模型或多服务部署 |
不要假设仅更改引擎标志就能正确量化 FP16 checkpoint。请使用模型支持的 checkpoint 和导出路径,然后在 JetPack 7.2 上重新构建 TensorRT 引擎。
控制上下文、KV 缓存和并发度
LLM 内存并不只由模型权重决定。KV 缓存会随上下文长度、批大小、生成 token 数量以及并发请求数而增长。
从保守的请求开始:
{
  "batch_size": 1,
  "max_generate_length": 128,
  "requests": [
    {
      "messages": [
        {
          "role": "user",
          "content": "Summarize the current device status."
        }
      ]
    }
  ]
}
然后一次只增加一个维度:
- 输入上下文长度;
- 生成长度;
- 批大小;
- 并发请求数;
- 额外的视觉或机器人服务。
如果在预填充期间内存急剧上升,缩短提示或上下文窗口。如果随着会话保持活动而上升,检查 KV 缓存保留策略和并发请求处理。
避免重复加载模型
当多个应用需要同一模型时,使用一个长时间运行的模型服务器。独立的 Python 脚本、notebook、测试服务器和生产服务都可能各自再加载一份权重或引擎。
在启动推理之前,检查是否已有模型进程在运行:
ps -ef | grep -E 'llm|triton|python|ollama' | grep -v grep
只停止已确认是重复的进程。不要仅凭名称匹配就终止系统服务。
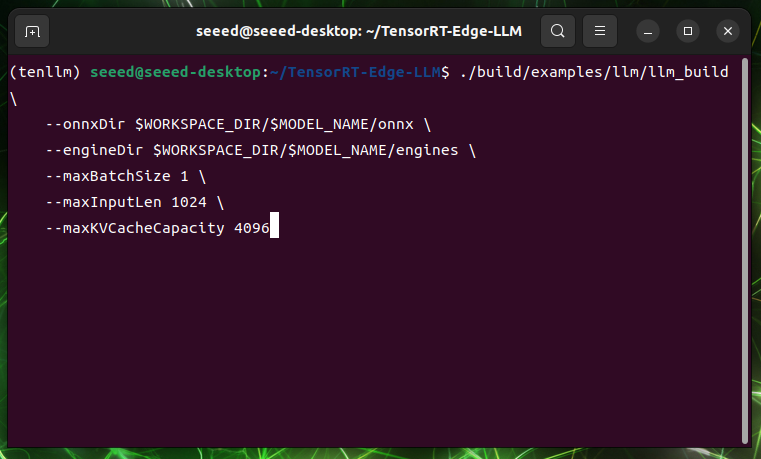
尽可能将导出和引擎构建放在目标设备之外
TensorRT Edge-LLM 使用 x86 GPU 主机进行 checkpoint 导出,并使用 Jetson 进行目标引擎构建。导出可能需要数倍于 checkpoint 大小的 RAM 和 VRAM,因此将导出保留在主机上,可以为 Jetson 上的验证和推理保留内存。
在引擎构建期间,关闭无关的模型服务器,并将峰值内存与运行时内存分开记录。构建时的内存压力不一定代表稳态部署需求。
将 Swap 视为恢复工具,而不是免费的 DRAM
Swap 可以帮助一次性的模型转换或引擎构建完成,但持续的交换会增加延迟并可能加剧存储磨损。对于实时推理,在依赖 swap 之前,更应优先选择更小或已量化的模型、更短上下文、更低并发度以及更少的重复服务。
4. 验证结果
在每次更改前后使用相同的提示、输入、电源模式和应用拓扑。
| 指标 | 重要原因 |
|---|---|
空闲时的 MemAvailable | 衡量系统和服务开销 |
| 引擎加载后的内存 | 显示模型和运行时占用 |
| 预填充峰值内存 | 暴露上下文和临时工作区压力 |
| 稳态解码内存 | 显示 KV 缓存和会话保留情况 |
| 首 token 时间 | 发现由交换或受限工作区导致的回退 |
| 解码吞吐量 | 确认更低内存没有让推理慢到不可用 |
| 温度和板级功耗 | 确认结果是稳定的,而不是短暂突发 |
在 Seeed 的对比测试中,JetPack 7.2 Deep Dive 记录到在加载一个 27B 模型后,内存占用从 JetPack 6.2 上的大约 24.6 GB 降低到 JetPack 7.2 上的大约 14.7 GB。请将该结果视为特定工作负载下的参考值,而不是对所有模型都适用的保证性降幅。
推荐顺序
- 测量空闲、引擎加载、预填充和解码阶段的内存占用。
- 移除重复的模型进程和不必要的应用服务。
- 减少上下文长度、生成长度、批大小和并发度。
- 评估由 TensorRT Edge-LLM 支持的 INT8 或 INT4 checkpoint。
- 对于无显示的设备部署,使用
jetson-headless-mode。 - 仅在硬件场景完全匹配时,使用
jetson-optimize-memory headless或no-camera。 - 仅在测量了实际 DMA 跳转缓冲池使用情况后,再考虑减少 SWIOTLB。
- 每次更改后,重新运行正确性、延迟、吞吐、散热和稳定性测试。
回滚
- 如果再次需要图形桌面,请恢复原始的服务目标。
- 如果 carveout 或设备树更改导致启动或外设故障,请恢复干净的 BSP 源码并重新刷机。
- 如果出现 DMA 错误或使用量接近配置的池大小,请回退 SWIOTLB 更改。
- 在优化配置通过验收测试之前,保留最后一个已知可用的 TensorRT 引擎和模型配置。
技术支持与产品讨论
感谢您选择 Seeed Studio 的产品!如需技术支持和产品讨论,请通过以下渠道联系我们: