基于 Jetson Orin Nano 和 Orin NX 的 4K 工业视觉基准测试
在单张图像上运行 YOLO 只衡量了工业视频系统的一小部分。实际部署的应用必须解码多路视频流、搬运和缩放帧、运行推理、编码录像,并在共享内存和功耗预算的前提下提供可用的预览。
本项目在 Jetson Orin Nano 8GB 和 Jetson Orin NX 16GB 上对这一完整工作负载进行监测。四路原生 4K H.264 工业视频片段同时馈送到 TensorRT FP16 YOLOv8n 检测器、H.264 录像分支和浏览器仪表盘。测量结果展示了 CPU 编码、帧调度和散热对结果的影响。
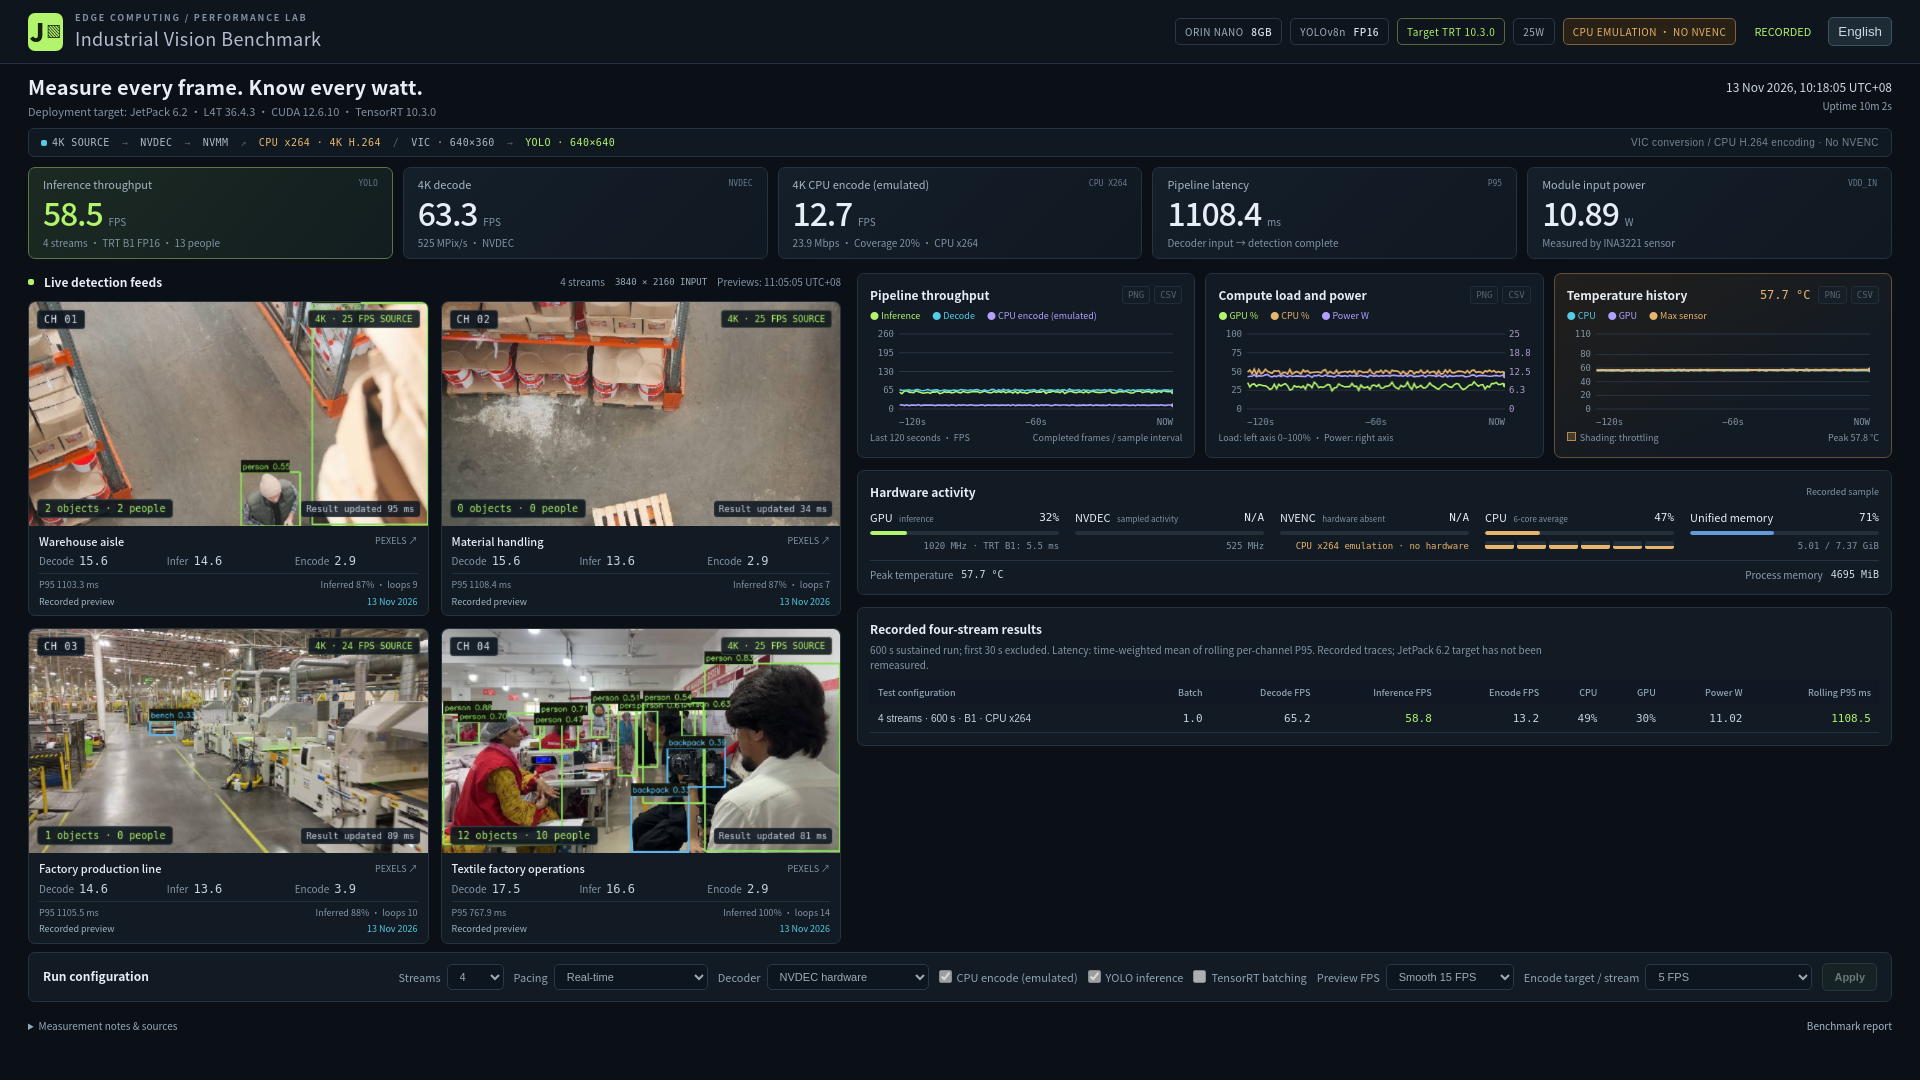
Orin Nano 不具备 NVENC 硬件。 它的录像分支使用 CPU x264 仿真,生成真实的 H.264 帧来替代 NVENC 功能。性能数据基于已完成的工作进行测量。Orin NX 则使用其硬件 NVENC 编码器。
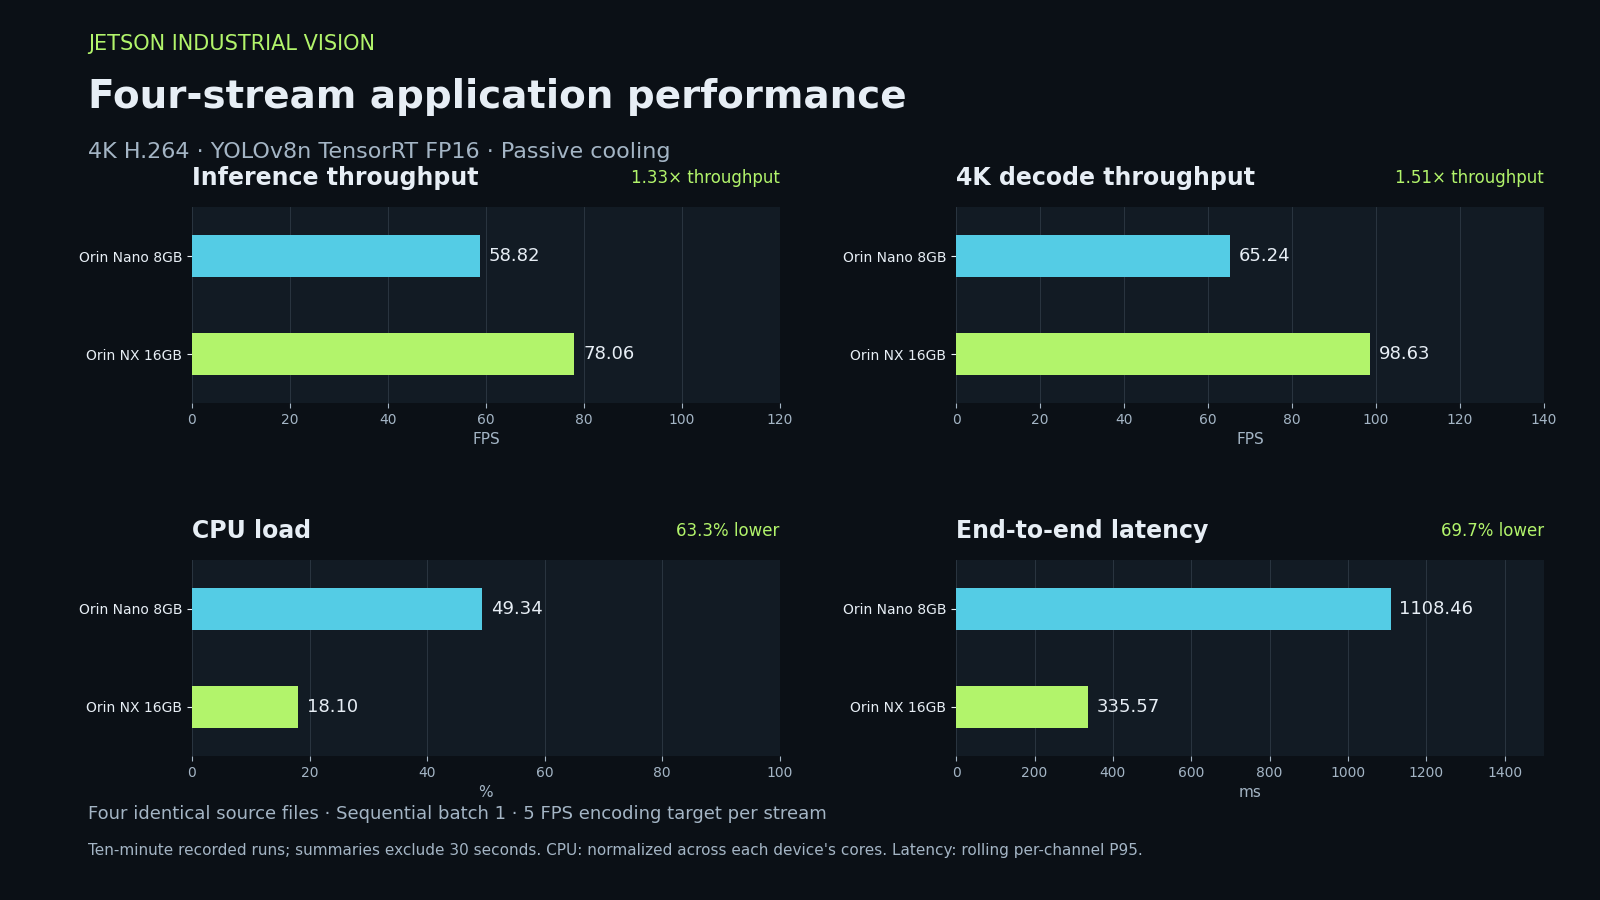
在相同的四路源文件、顺序推理和录像目标下,Orin NX 在这些记录的应用运行中提供了 1.33× 的推理吞吐量、63.3% 更低的归一化 CPU 负载,以及 69.7% 更低的端到端时延。
Jetson Orin Nano 8GB — CPU x264 仿真
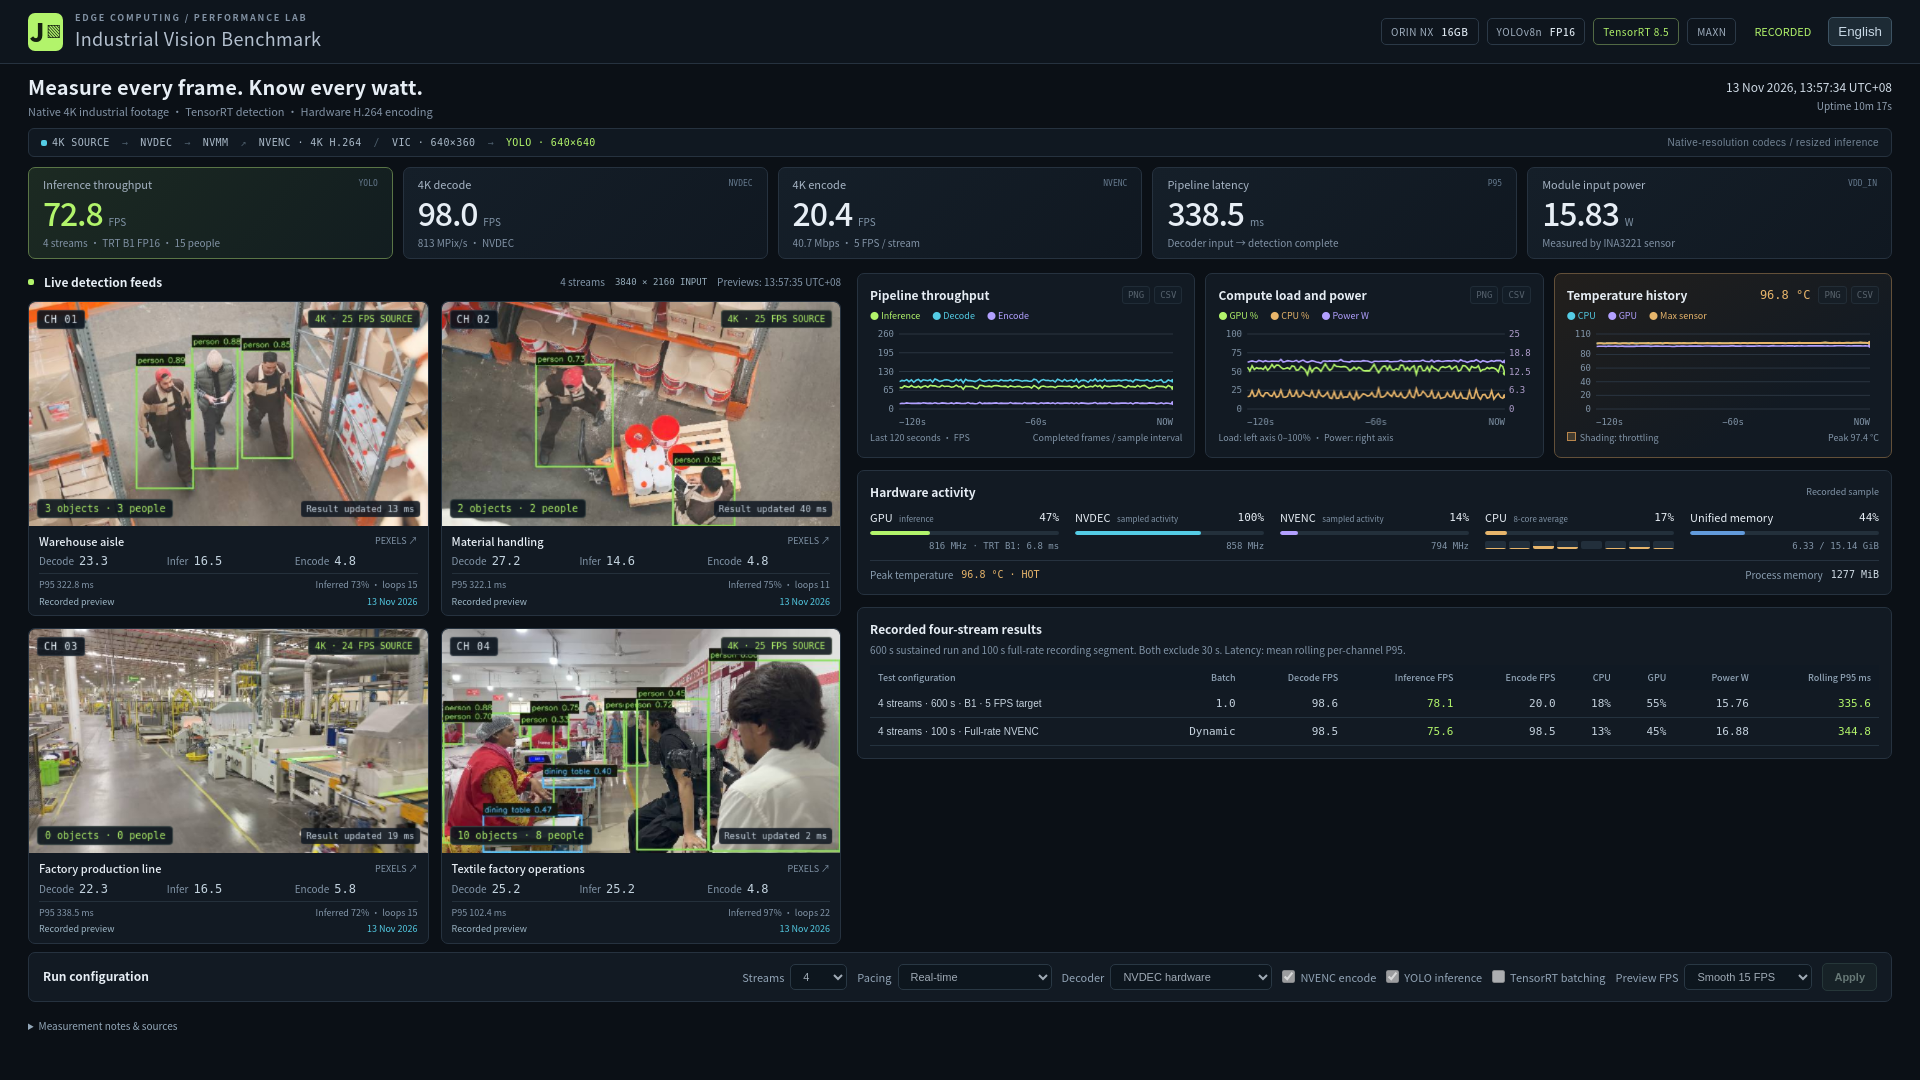
Jetson Orin NX 16GB — 硬件 NVENC
测试平台与工作负载
| 配置 | Jetson Orin Nano 8GB | Jetson Orin NX 16GB |
|---|---|---|
| 模组标识 | Orin Nano 8GB | Orin NX 16GB |
| JetPack 部署目标 | 6.2 | 5.1.3 |
| Jetson Linux | L4T 36.4.3 | L4T 35.5 |
| CUDA | 12.6.10 | 11.4 |
| TensorRT | 10.3.0 | 8.5.2 |
| 配置的功耗模式 | 25W | MAXN |
| 运行时频率限制 | 默认 DVFS | CPU 1.50 GHz;GPU 816 MHz |
| CPU 归一化方式 | 六核平均 | 八核平均 |
| 视频解码器 | NVDEC | NVDEC |
| H.264 编码器 | CPU x264 仿真;无 NVENC | 硬件 NVENC |
| 推理配置 | 顺序 batch 1,FP16 | 顺序 batch 1,FP16 |
| 报告运行期间的散热方式 | 被动散热 | 被动散热 |
上表中的软件版本描述的是部署目标。Nano 目标遵循 JetPack 6.2 软件栈;其先前记录的基准测试轨迹并未在该目标镜像上重复。功耗模式是配置的模组功耗预算;Nano 在记录运行期间测得的平均模组输入功耗为 11.02 W。
模型为 YOLOv8n,输入为 640×640 letterbox,置信度阈值 0.30,IoU 阈值 0.45。解码和编码保持原生 3840×2160 分辨率。“4K 分析”描述的是视频处理管线;检测器本身消耗的是已缩放的图像。
四路活动片段覆盖仓储和工厂场景:
| 通道 | 场景 | 原生帧率 | 来源 |
|---|---|---|---|
| 1 | 仓库通道 | 25 FPS | Men Working in a Warehouse |
| 2 | 物料搬运 | 25 FPS | Video of Man Loading Cart |
| 3 | 工厂生产线 | 24 FPS | Wide View of Modern Factory Production Line |
| 4 | 纺织厂作业 | 25 FPS | Documentary Filming Inside Textile Factory |
这些源合计包含每秒 99 帧的视频。片段在工作负载中循环播放,并受 Pexels License 许可覆盖。本实验全程使用 H.264。
管线架构
解码后的帧保留在 NVMM 中,然后再分支到录像和推理:
3840×2160 H.264 → NVDEC → NVMM
                           ├─ Recording
                           │    NX:   hardware NVENC → 4K H.264
                           │    Nano: VIC → CPU-accessible I420 → x264 → 4K H.264
                           │
                           └─ VIC resize to 640×360
                                → CPU letterbox/preprocessing to 640×640
                                → TensorRT FP16 YOLOv8n
                                → CPU class-aware NMS
                                → detection results

Independent 640×360 JPEG preview worker → browser
Latest completed detections → preview overlays
Nano 编码器使用 x264 的 ultrafast 预设、zerolatency 调优、每路两条线程、切片线程、无 B 帧,以及 10,000 kbit/s 的目标码率。一个有界的录像队列在压力下会丢弃旧帧,从而允许推理继续进行。编码后的帧和输出字节在真实编码完成后进行计数。
VIC 转换和 TensorRT 推理并不提供 GPU H.264 码流编码。 Nano 上的 NVENC 活动被报告为不可用;不会为缺失的编码器虚构任何硬件利用率数值。
Nano 的持续运行为每路流选择 5 FPS 的录像媒体时间目标。这在转换到 CPU 内存之前减少了录像工作量。该设置并不保证每秒墙钟时间完成 20 帧:实际输入进度和编码器能力仍然决定输出吞吐量。仪表盘同时报告实际编码 FPS 和编码覆盖率。
测量内容
NX 上的四个视频文件通过 SHA256 与 Nano 参考进行了校验。两次持续运行都使用四路视频流、源速率节奏、顺序 TensorRT batch 1、每路 5 FPS 的录像媒体时间目标、15 FPS 预览生成,以及 10 分钟的数据采集。汇总结果排除了最初的 30 秒。这些是采用不同编码器后端和运行点的已部署系统测量,而不是孤立的 GPU 对比。
- Nano 持续运行: 2026 年 11 月 13 日,10:08:04–10:18:04(UTC+08),599.83 秒内采集 582 个样本。
- NX 持续运行: 2026 年 11 月 13 日 13:47:26(UTC+08)至 2026 年 11 月 13 日 13:57:27(UTC+08),599.86 秒内采集 582 个样本。CPU/GPU 频率限制如上所列。采集期间暂停了 Visual Hub,并在之后恢复。
- NX 全速录像片段: 一次单独采集的前 99.72 秒,在移除录像上限并启用动态推理批处理的条件下完成。计划的 150 秒采集在达到 99°C 的测量保护阈值时停止;这一短时容量片段排除了最初的 30 秒,并保持源速率节奏和相同的频率限制。
采集期间后端预览生成保持启用;额外的浏览器预览客户端仅在持续测量结束后才打开。
吞吐量统计的是已完成的帧数,而不是请求的 FPS。两次持续运行的汇总都使用计数器差值和集成模组能量:
Throughput (FPS)       = completed frames / elapsed seconds
Average module power  = integrated module energy / elapsed seconds
Encoding coverage     = encoded frames / decoded frames
曲线图例展示的是最终采样值;汇总表则使用预热后的计数器增量。
功耗来自 INA3221 的 模组 VDD_IN 轨道。它不包含单独供电的外设,也不是墙上插座功耗。CPU 负载在各模组的核心之间做了归一化。NVDEC/NVENC 活动百分比表示在 20 Hz 采样中非零计数器样本所占的比例,而不是经过校准的硬件利用率测量。
四路视频结果
| 指标 | Orin Nano 8GB | Orin NX 16GB |
|---|---|---|
| 解码总吞吐量 | 65.24 FPS | 98.63 FPS |
| 推理总吞吐量 | 58.82 FPS | 78.06 FPS |
| H.264 编码总吞吐量 | 13.24 FPS,CPU x264 | 20.00 FPS,NVENC |
| CPU 负载 | 49.34% | 18.10% |
| GPU 负载 | 30.49% | 54.68% |
| 端到端时延,滚动 P95 均值 | 1108.46 ms | 335.57 ms |
| 模组输入功耗 | 11.02 W | 15.76 W |
| 测得的峰值温度 | 58.19°C | 97.38°C |
| 温度限频样本数 | 0 | 0 |
吞吐量与编码压力
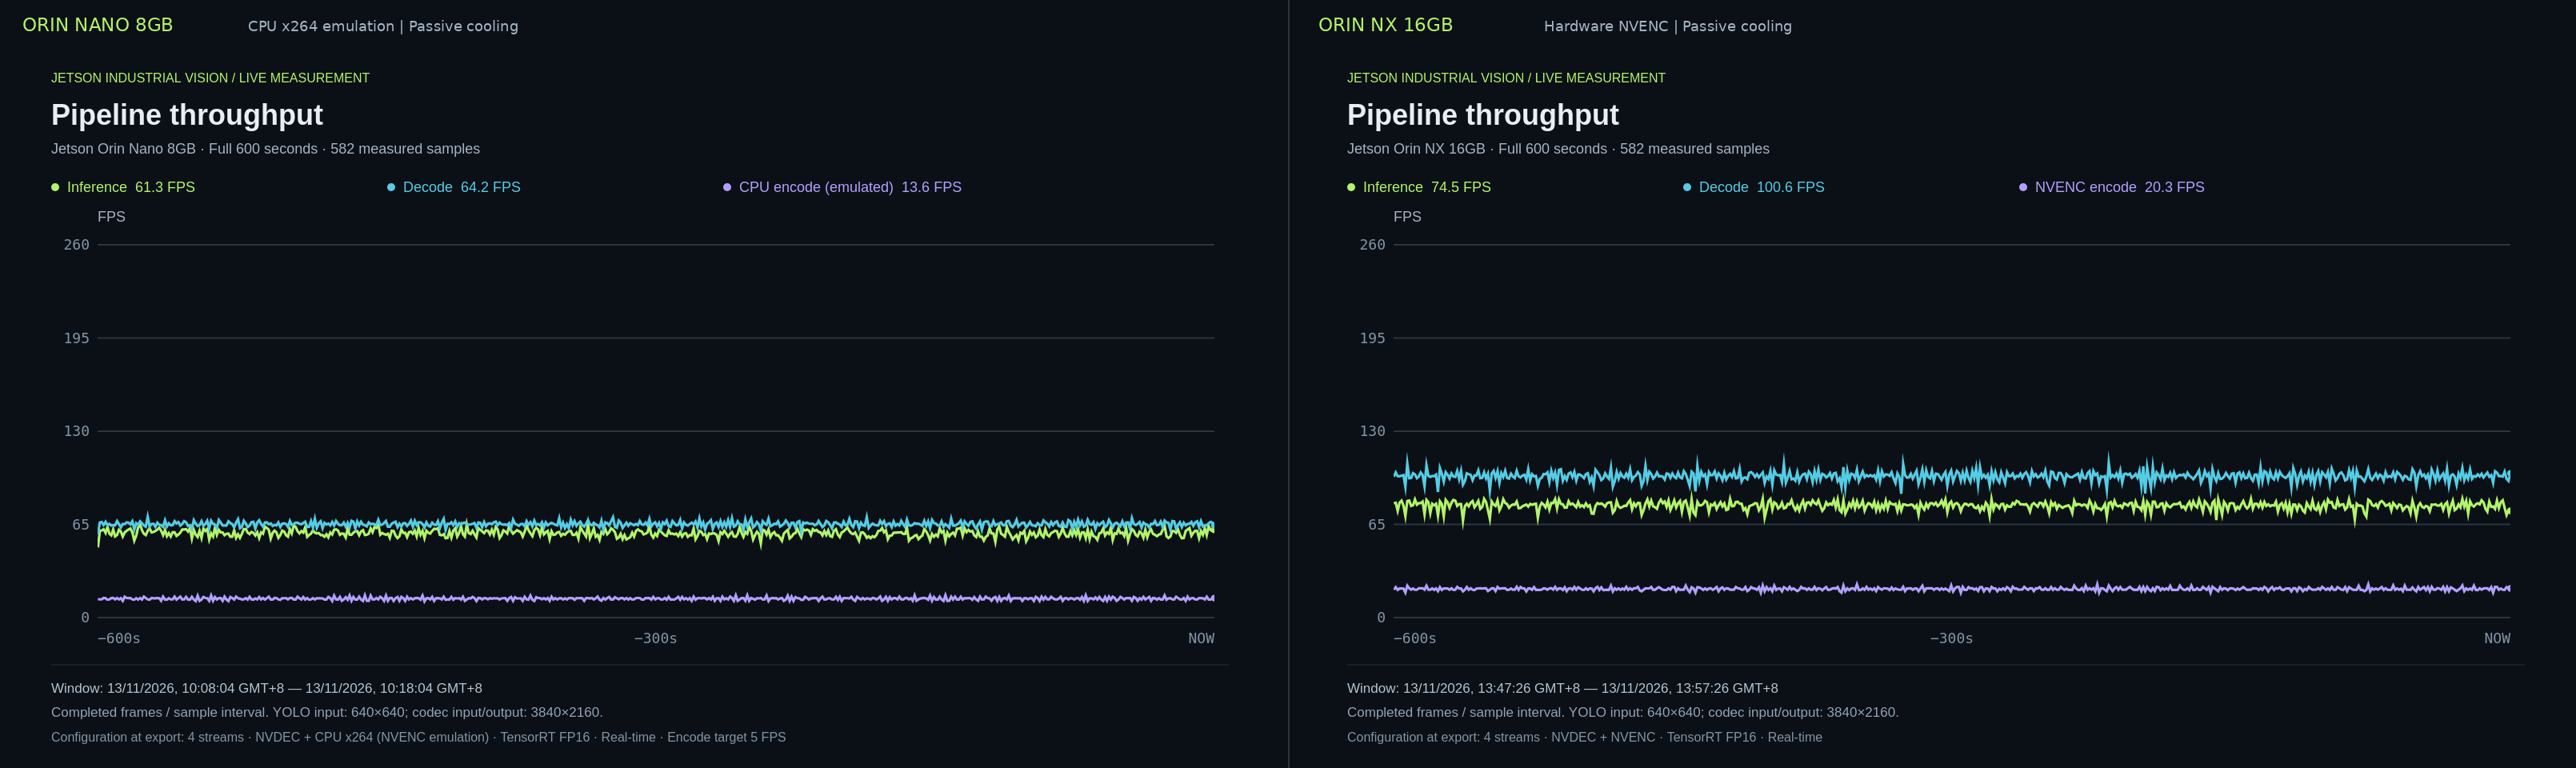
在相同的四路源文件下,NX 维持 78.06 FPS 的推理吞吐量和 98.63 FPS 的解码吞吐量。Nano 完成 58.82 FPS 的推理吞吐量和 65.24 FPS 的解码吞吐量。两者都使用每路 5 FPS 的录像目标;实际完成的录像速率分别为 20.00 和 13.24 FPS。
全速 NVENC 录像
移除 NX 的录像上限后,在推理仍以 75.63 FPS 继续运行的同时,可实现 98.51 FPS 的 4K H.264 编码总吞吐量。解码吞吐量为 98.51 FPS,归一化 CPU 负载为 12.79%,模组功耗为 16.88 W。这个短时容量片段使用动态推理批处理和源速率录像;它不是一个 10 分钟的耐久性结果。
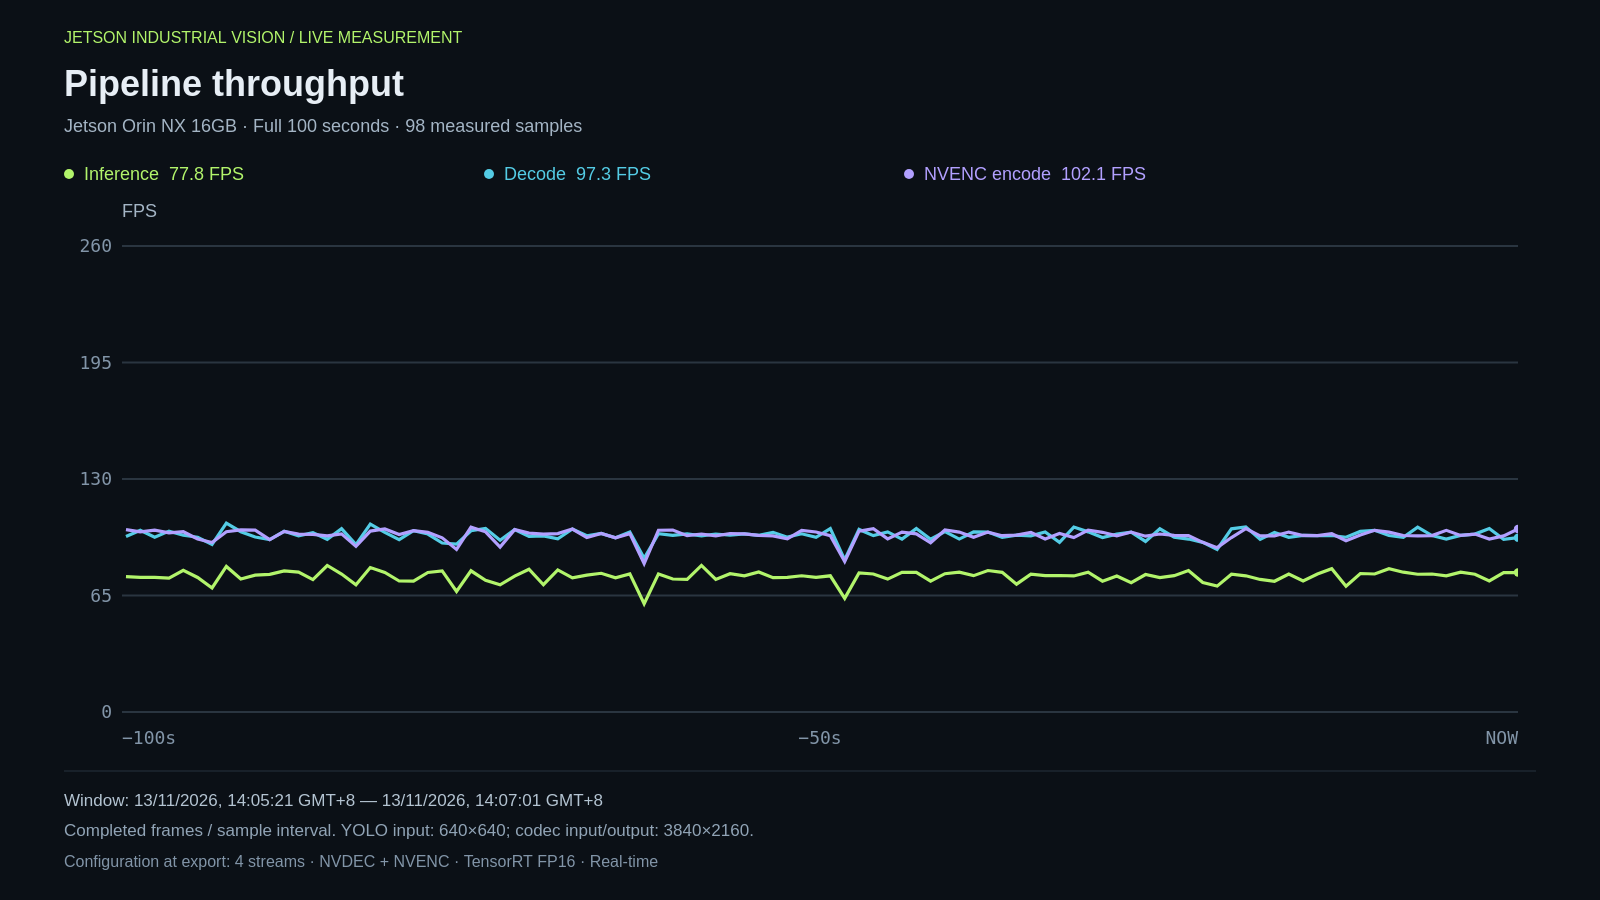
硬件 NVENC 允许录制分支在与检测共享系统的同时处理源帧率的 4K 负载。Nano 的 CPU x264 替代方案需要显式的录制预算,以保护应用程序的其余部分。
计算负载与功耗
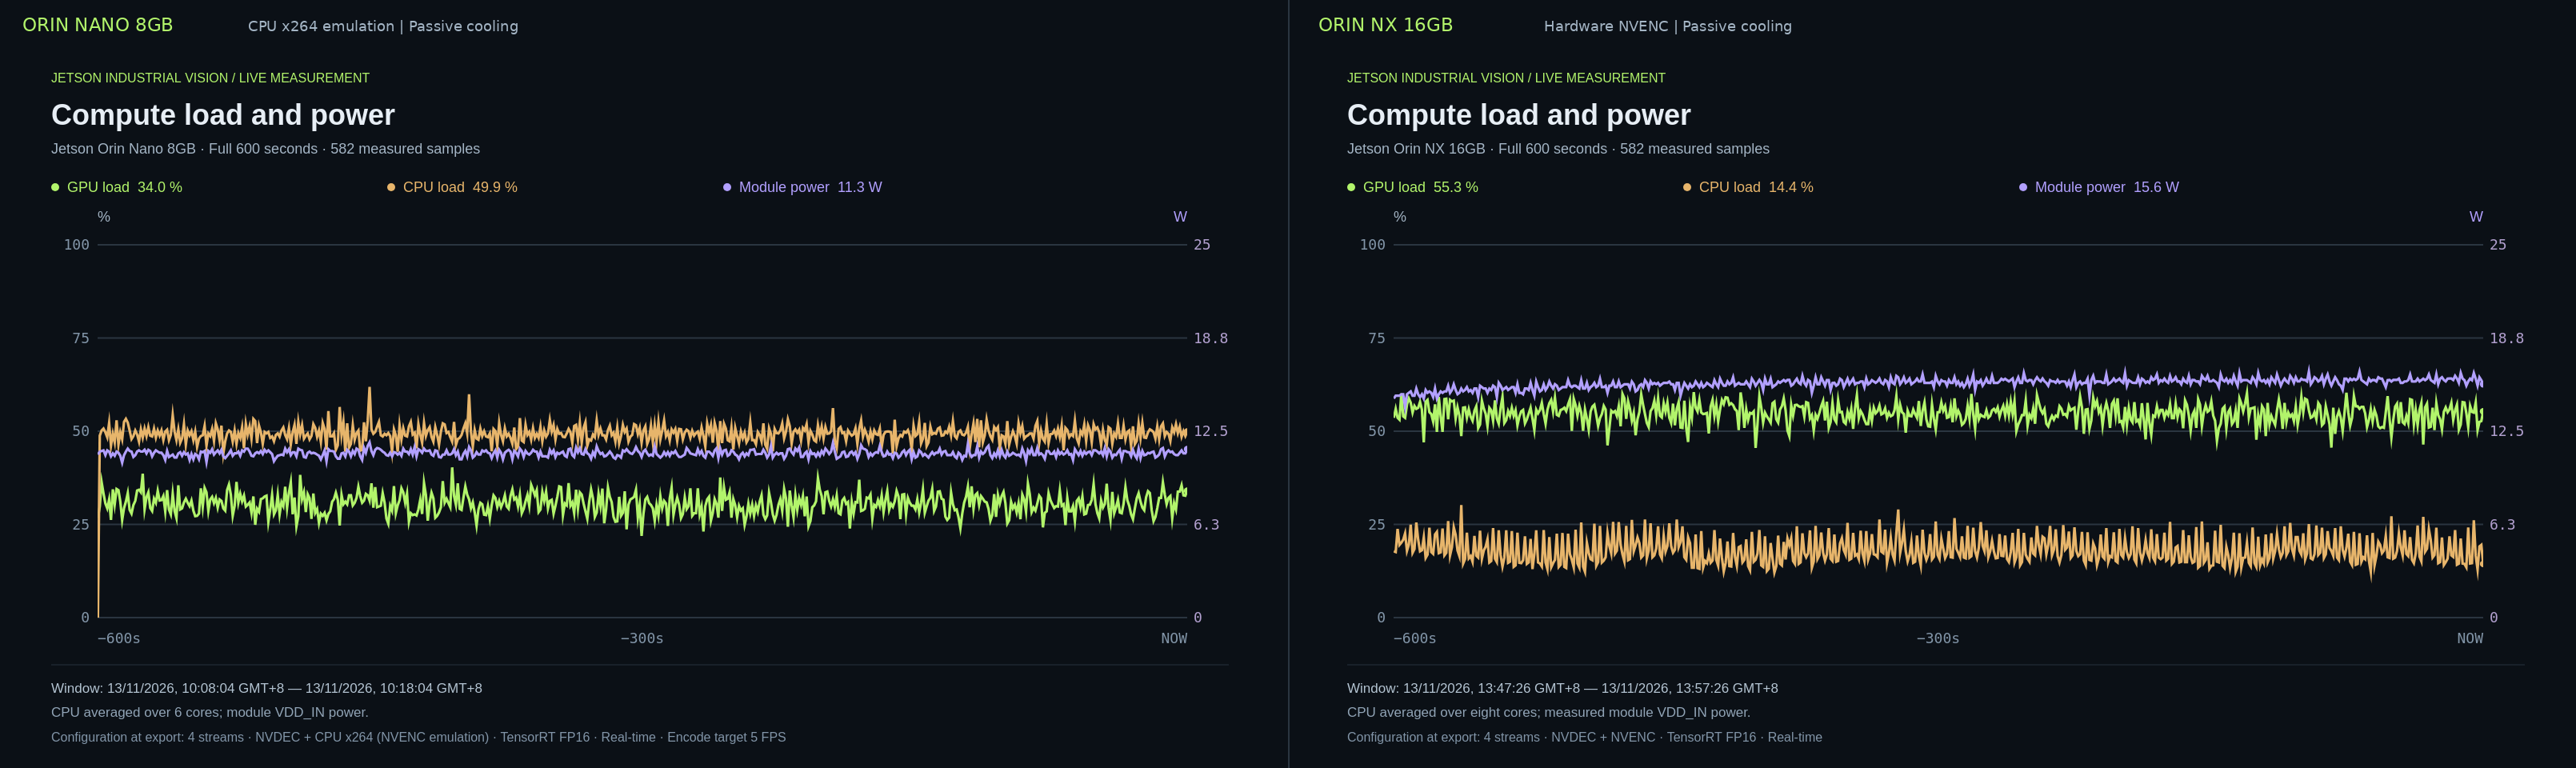
单独曲线:Nano 负载与功耗 · NX 负载与功耗。
在 Nano 上,x264 与预处理、后处理、预览生成和应用线程共享 CPU 资源。因此,仅凭 GPU 负载无法解释流水线能力。NX 上的硬件 NVENC 独立于 CPU 码流编码来处理录制分支,尽管解码、内存流量和热限制仍然会影响应用。
温度与散热
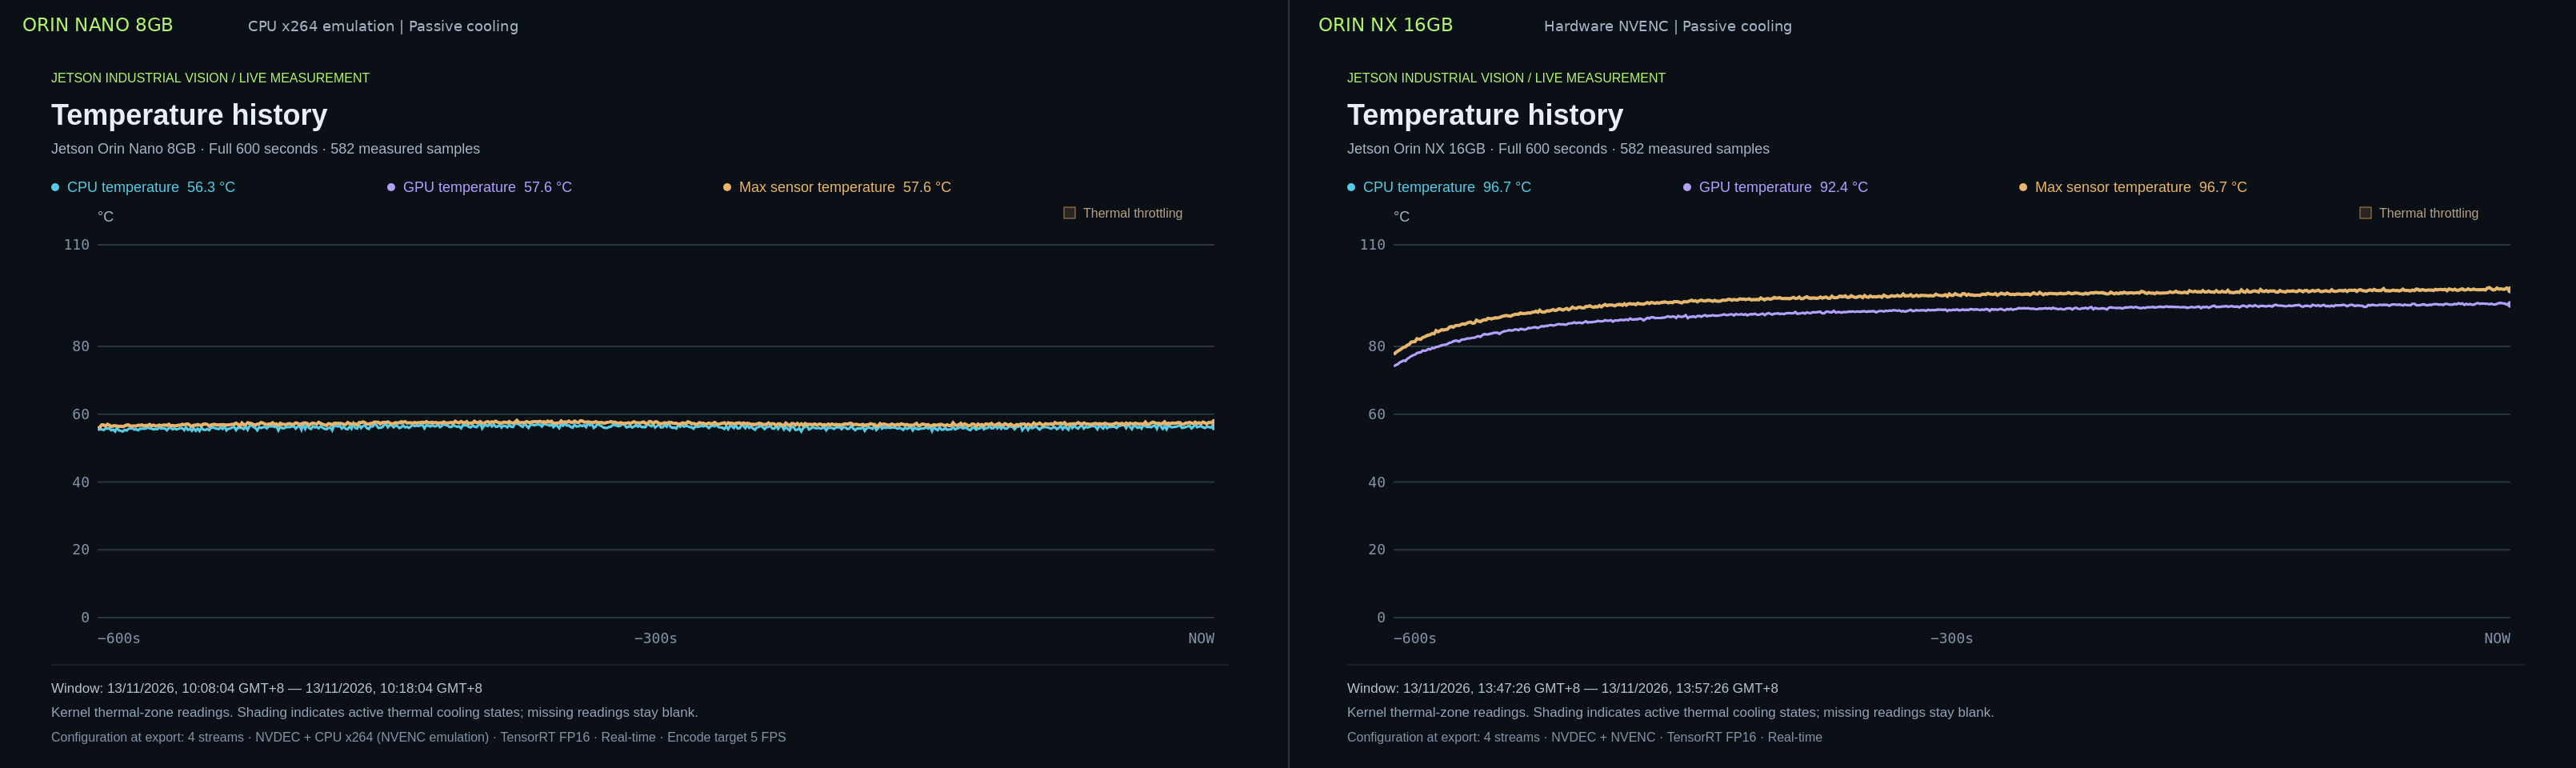
Nano 达到的最高温度为 58.19°C。持续运行的 NX 峰值为 97.38°C,记录到 0 次采样到的热降频事件。一个初步的无限制 MAXN 采集在 99°C 时被停止;因此持续结果使用了上文列出的 CPU/GPU 限制。硬件热保护仍然处于激活状态。
两个设备都使用被动散热。环境温度和等效散热组件未被控制,因此这些会话并不能建立模块之间的热优势对比。
端到端延迟
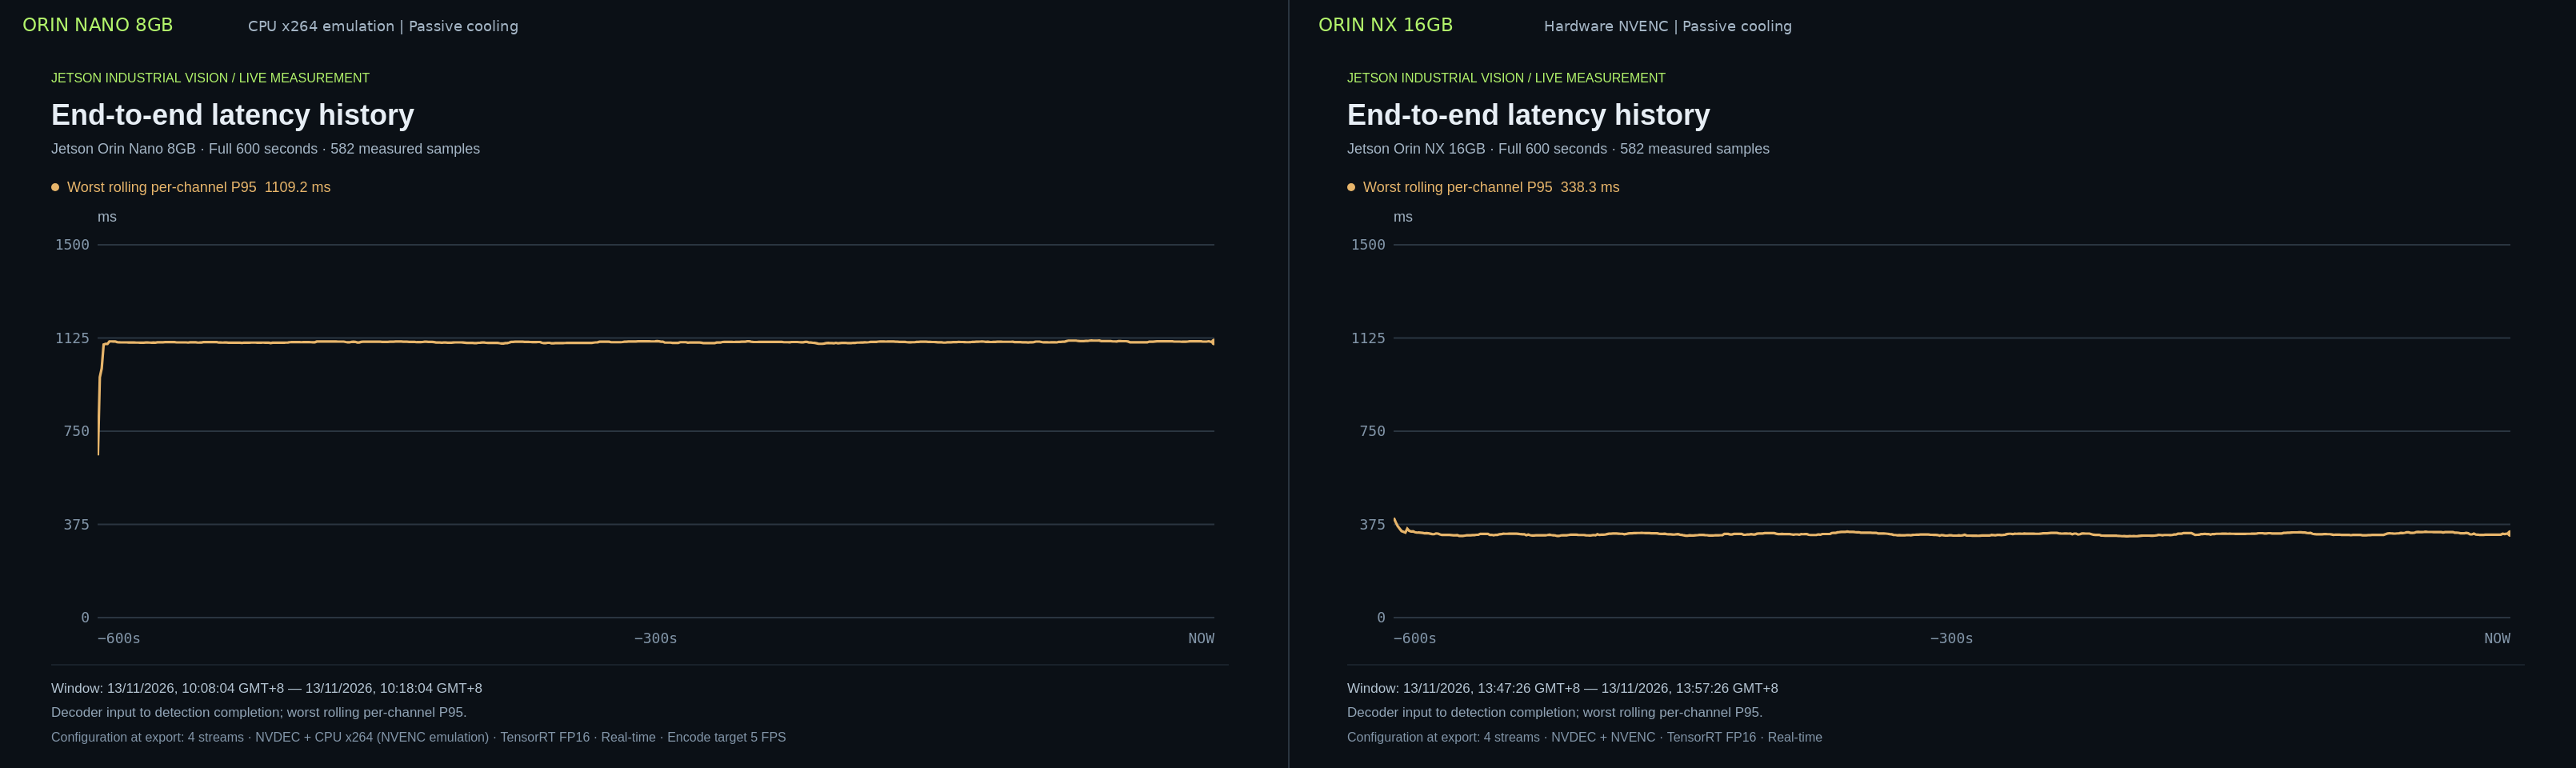
两条曲线都显示了从解码器输入到检测后处理完成的最差滚动每通道 P95。预热后的时间加权平均值为 Nano 1108.46 ms、NX 335.57 ms,在这一记录统计量上减少了 69.7%。
这些是完整流水线的延迟测量,而不是孤立的 TensorRT 执行时间,也不是在十分钟运行中的每一帧上重新计算的 P95。两条曲线和两个汇总值都使用相同的滚动统计。
内存行为
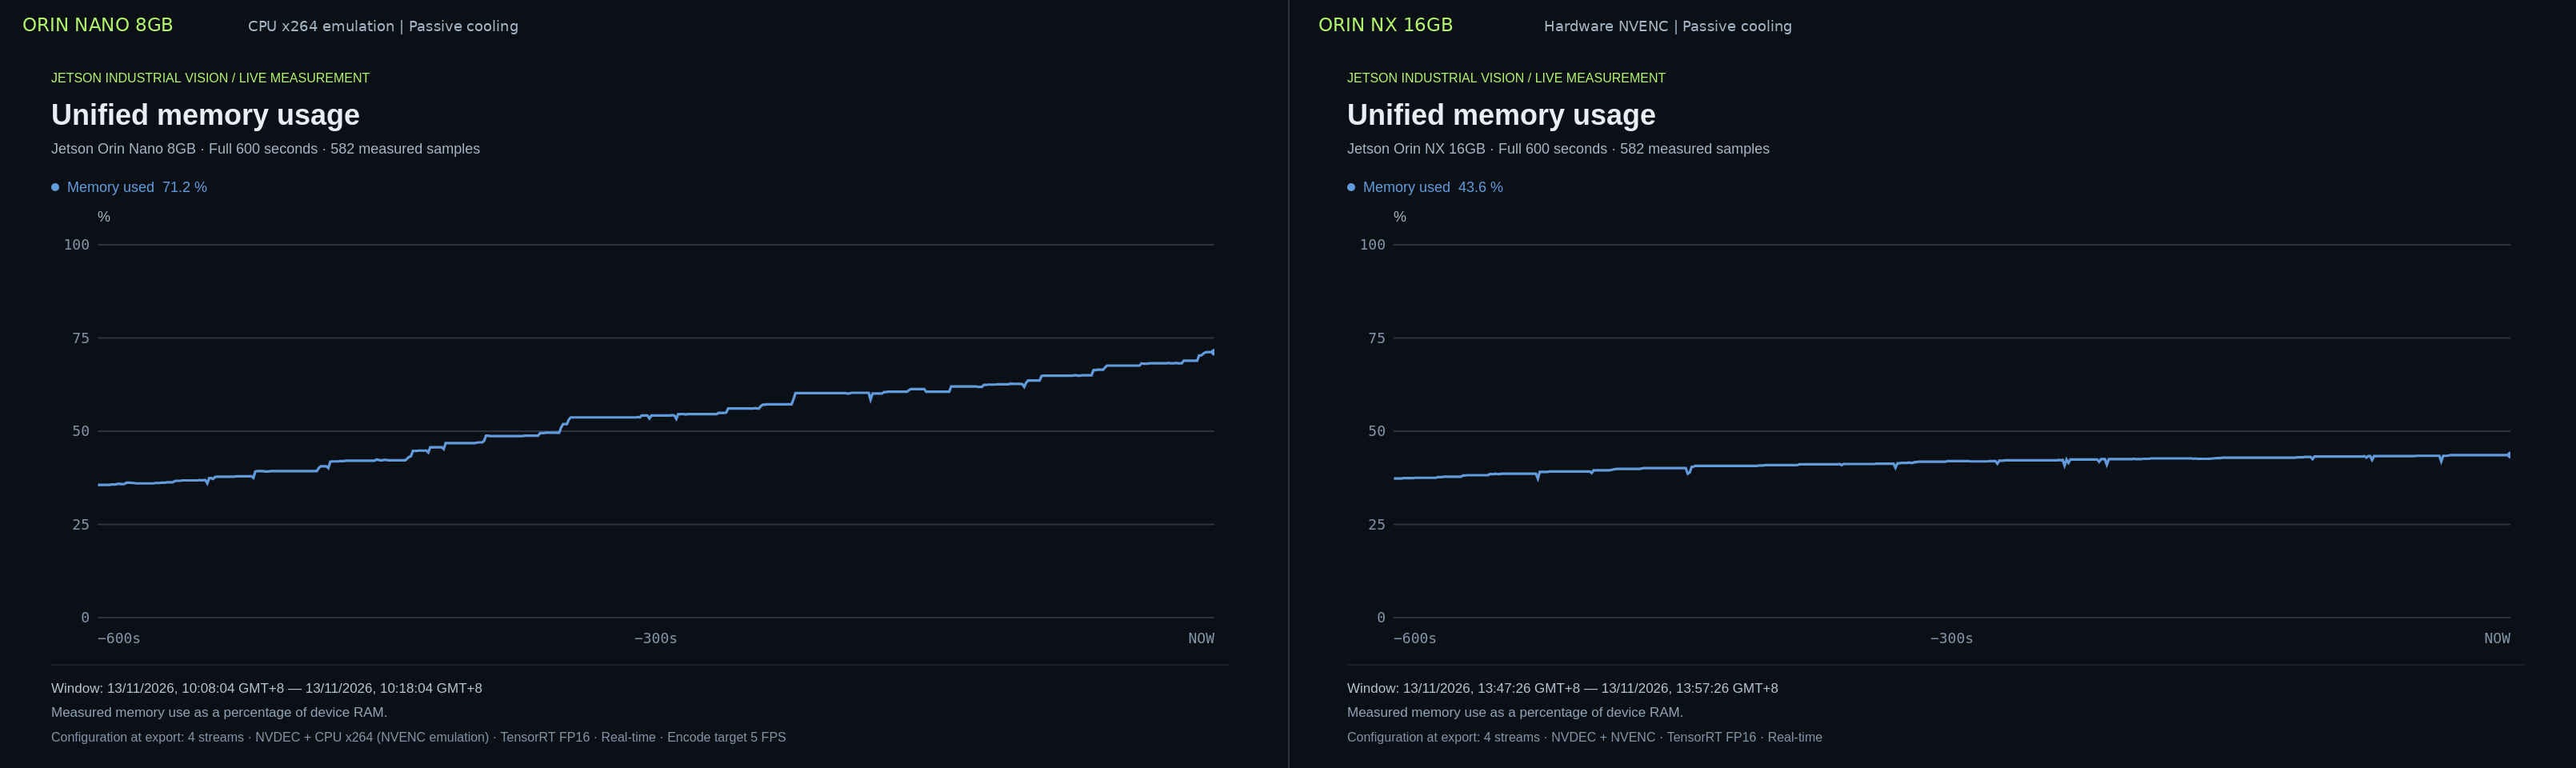
曲线显示了实际设备内存使用量占各自设备可用 RAM 的百分比。Nano 在运行过程中从 35.6% 上升到 71.2%;应用 RSS 从约 2,108 MiB 上升到 4,695 MiB。新的持续运行中,NX 内存从 37.3% 上升到 43.6%,应用 RSS 最终为 1277 MiB。在这一测量中,Nano 更大的增长仍未得到解释。十分钟的可接受温度和吞吐量并不能证明连续运行的内存稳定性。
检测预览与仪表盘行为
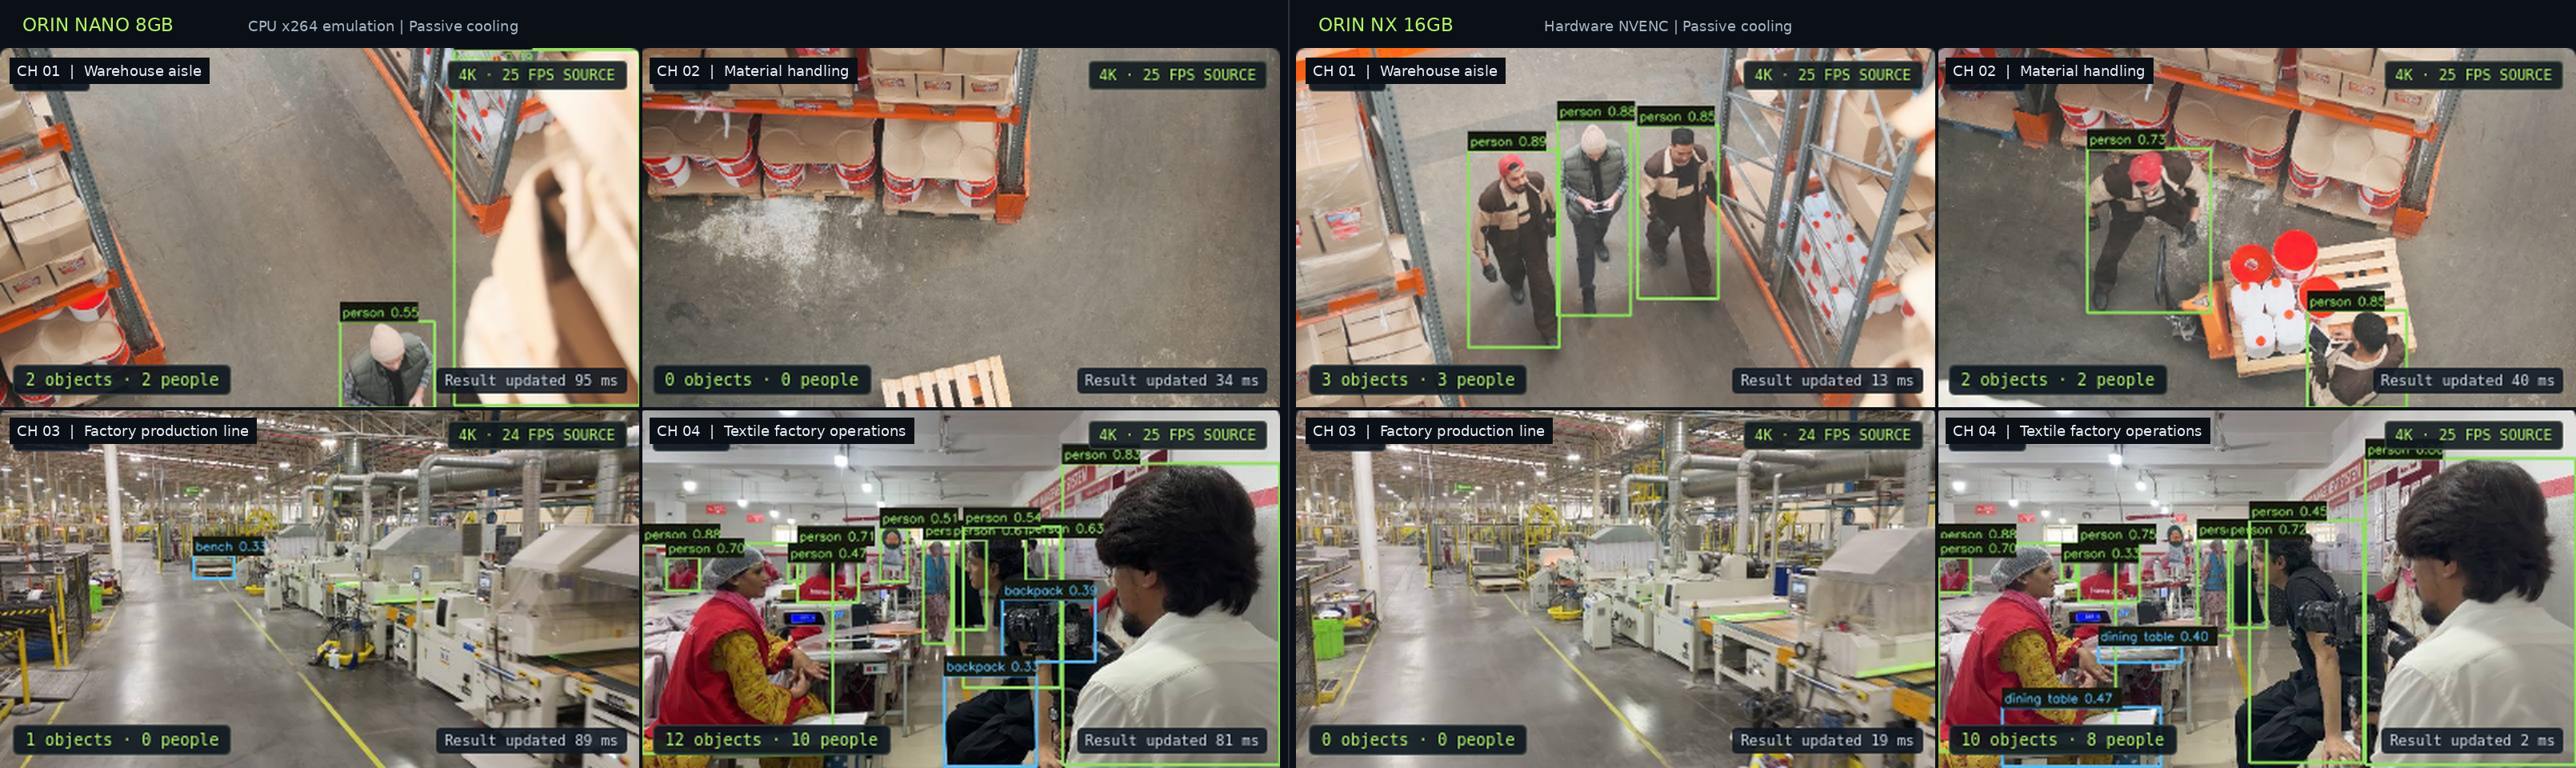
浏览器使用独立的 640×360 JPEG 预览,并可选择 5 或 15 FPS 目标。每个通道有一个未完成的帧请求,绘制新帧,并避免累积旧帧队列。生成的预览 FPS、浏览器显示 FPS、推理 FPS 和视频编码 FPS 会分别报告。
边界框使用最新完成的检测结果。叠加层显示其更新时长,并在 300 ms 内没有新结果时隐藏边界框。因此,浏览器图像的流畅性并不意味着每一帧都已完成推理,这些叠加层也不是目标跟踪。
两个仪表盘图都渲染了记录的遥测数据和完整运行的汇总。Nano 遥测数据来自 11 月 13 日 10:18:04(UTC+08);其预览像素在 11:05:05 单独采集。NX 遥测和预览像素在持续运行结束后于 13:57:34(UTC+08)采集。仪表盘的瞬时值可能与窗口平均值不同,且不同设备之间的预览场景并不同步。
YOLOv8n 使用通用的 COCO80 类别。这些预览展示了工业场景中的人员和物体检测;不对任何 PPE、缺陷检测或工业精度基准做出声明。
复现测量方法
在选择录制后端之前,请检查实际的模块标识和已安装软件。仅靠载板的 device-tree 型号字符串可能不足以区分模块。此处使用的 Orin Nano 8GB 标识是通过模块 EEPROM 验证的。
在 Jetson 安装上有用的检查包括:
cat /etc/nv_tegra_release
/usr/local/cuda/bin/nvcc --version
python3 -c "import tensorrt as trt; print(trt.__version__)"
sudo nvpmodel -q
gst-inspect-1.0 nvv4l2decoder
gst-inspect-1.0 nvv4l2h264enc
gst-inspect-1.0 x264enc
在 Nano 上,缺失的 NVENC 插件绝不能被报告为可用的硬件编码器。请独立验证输出编码格式和分辨率,并统计已完成编码的帧数,而不是提交到队列的帧数。TensorRT 引擎应针对目标模块和软件栈构建。
为了获得可重复的运行,请保留源文件及其校验和、模型设置、电源模式、散热状态、编码器目标、节奏策略、预览设置和测量时间戳。在负载开始前启动监控,并区分短时容量测试与持续运行。保留每通道计数器,以免聚合吞吐量掩盖某个摄像头的停滞。
仪表盘从同一后端提供前端资源和测量 API。每条曲线都可以单独导出。这使得可以同时检查吞吐量与功耗、温度、延迟和内存,而不是只选择单个有利的 FPS 数值。
实际部署选择
- 对于全帧率多路 4K 录制,请为编码器预留预算。 NX 的硬件 NVENC 分支在其源帧率录制运行中达到了 98.51 编码 FPS。Nano 的 CPU x264 替代方案需要录制帧率预算和可见帧覆盖。
- 调优完整流水线。 早期的 Nano 短套件在其受限编码器配置下测得顺序推理为 56.82 推理 FPS,而批处理为 51.70 FPS。仅靠批大小并不能预测应用吞吐量。
- 将散热和内存视为运行约束。 持续运行的 NX 工作点使用了显式频率限制;Nano 记录中存在内存增长。在更长的耐久运行中监控温度、降频和内存。
- 将新鲜度与显示流畅度分开测量。 浏览器 FPS 描述呈现效果。从解码器到检测的延迟描述结果何时可供应用使用。
相关资源
技术支持与产品讨论
如需技术问题解答和实现讨论,请访问 Seeed Studio 论坛或 Wiki 讨论区。