使用 MTP 加速 NVIDIA Jetson AGX Orin 上的 llama.cpp
介绍
本 wiki 解释 Multi-Token Prediction(MTP)的工作原理,以及如何在 NVIDIA Jetson AGX Orin 上的 llama.cpp 中配合 Qwen3.5-4B 启用它。按照步骤完成配置,并通过本地人群监控演示对比 MTP 开启/关闭时的性能。
先来看一下实际测试结果。我们让 LLM 生成一个用于计算斐波那契数列的 Python 脚本,对比在启用和未启用 MTP 模型时的生成速度。
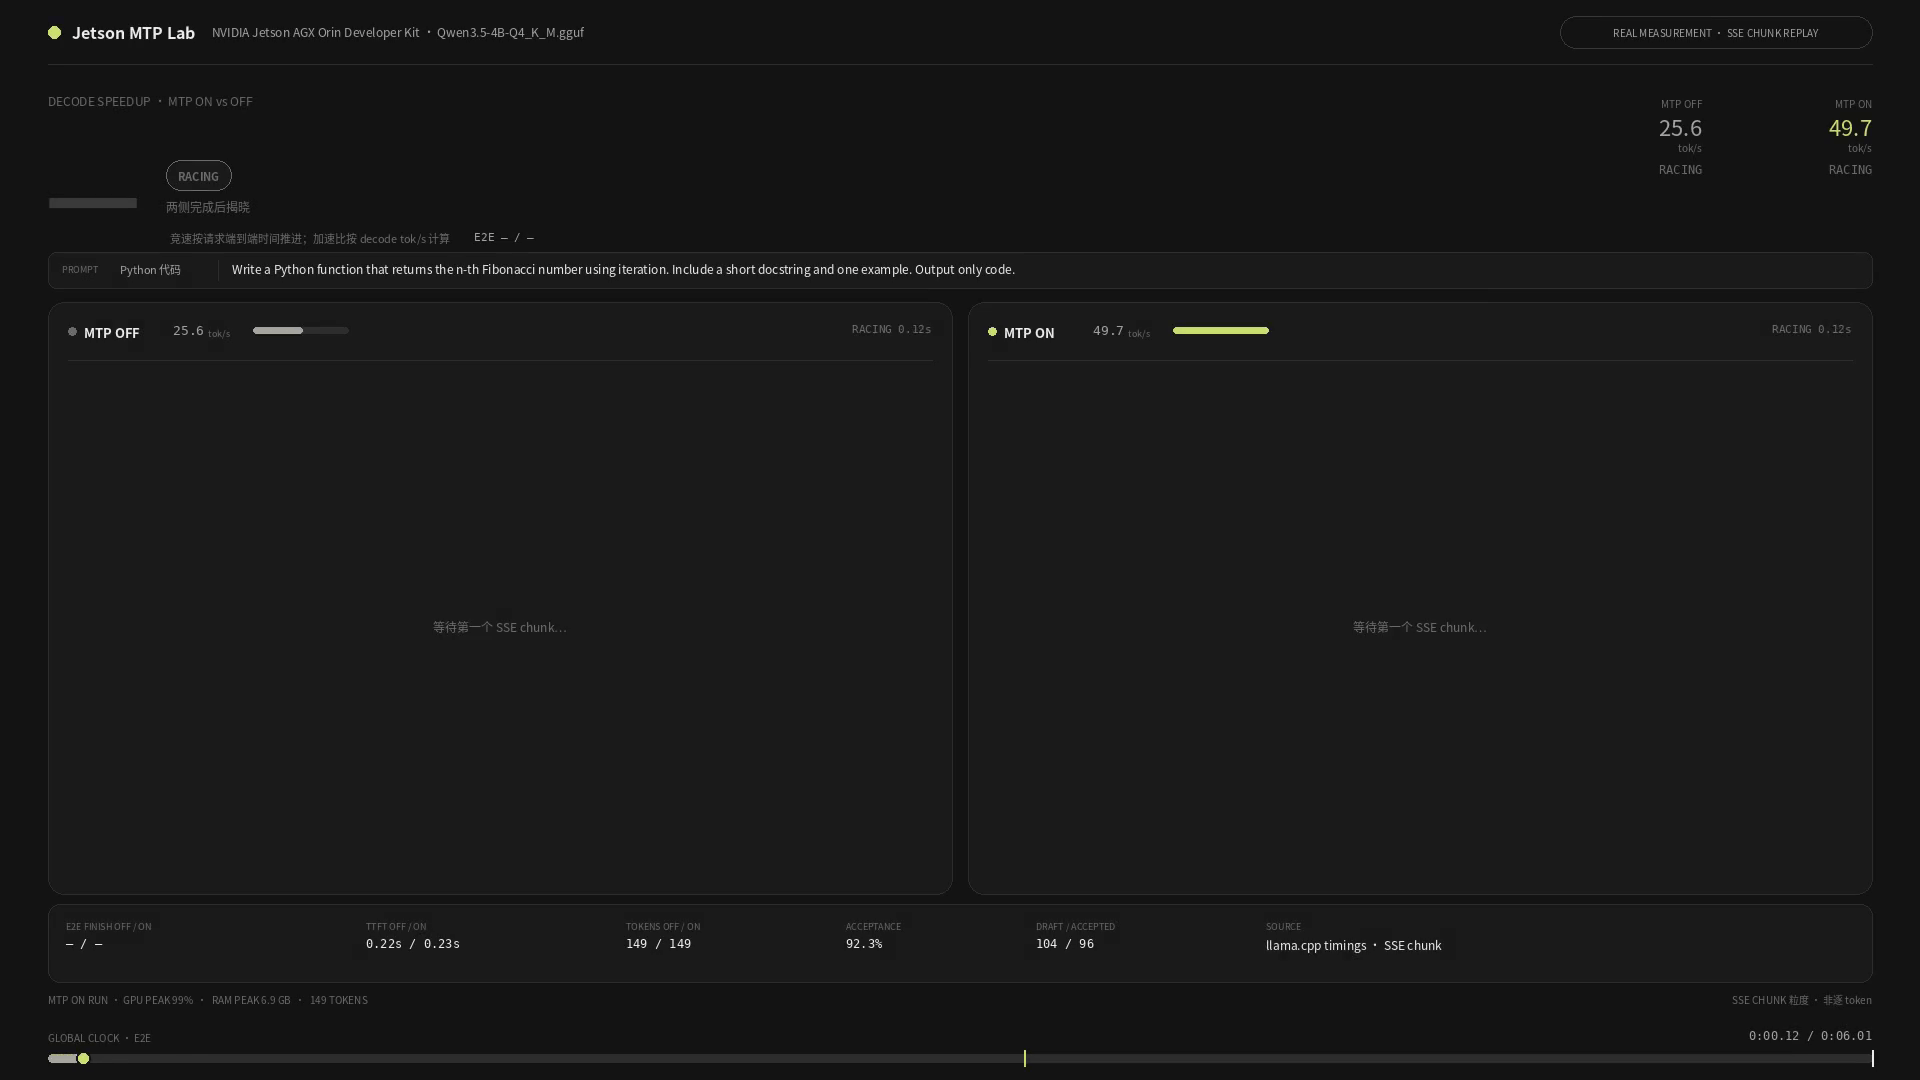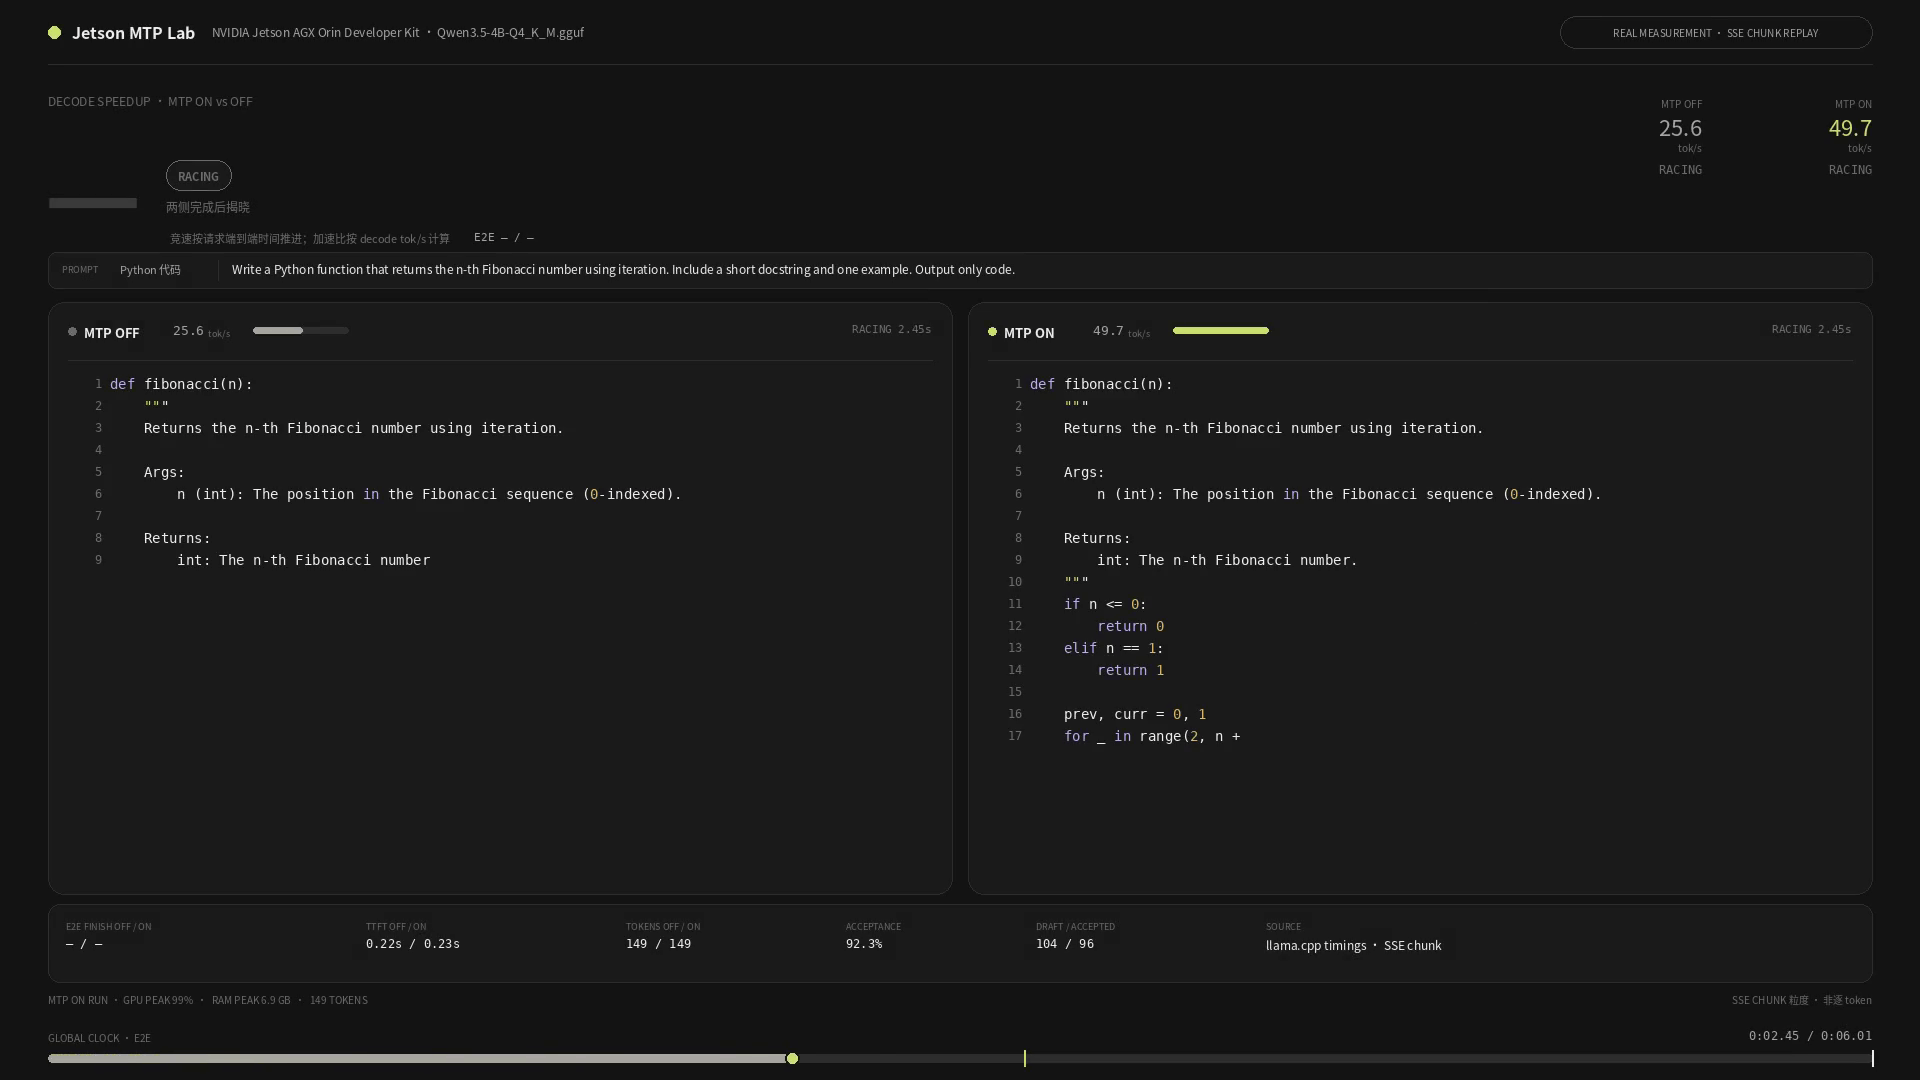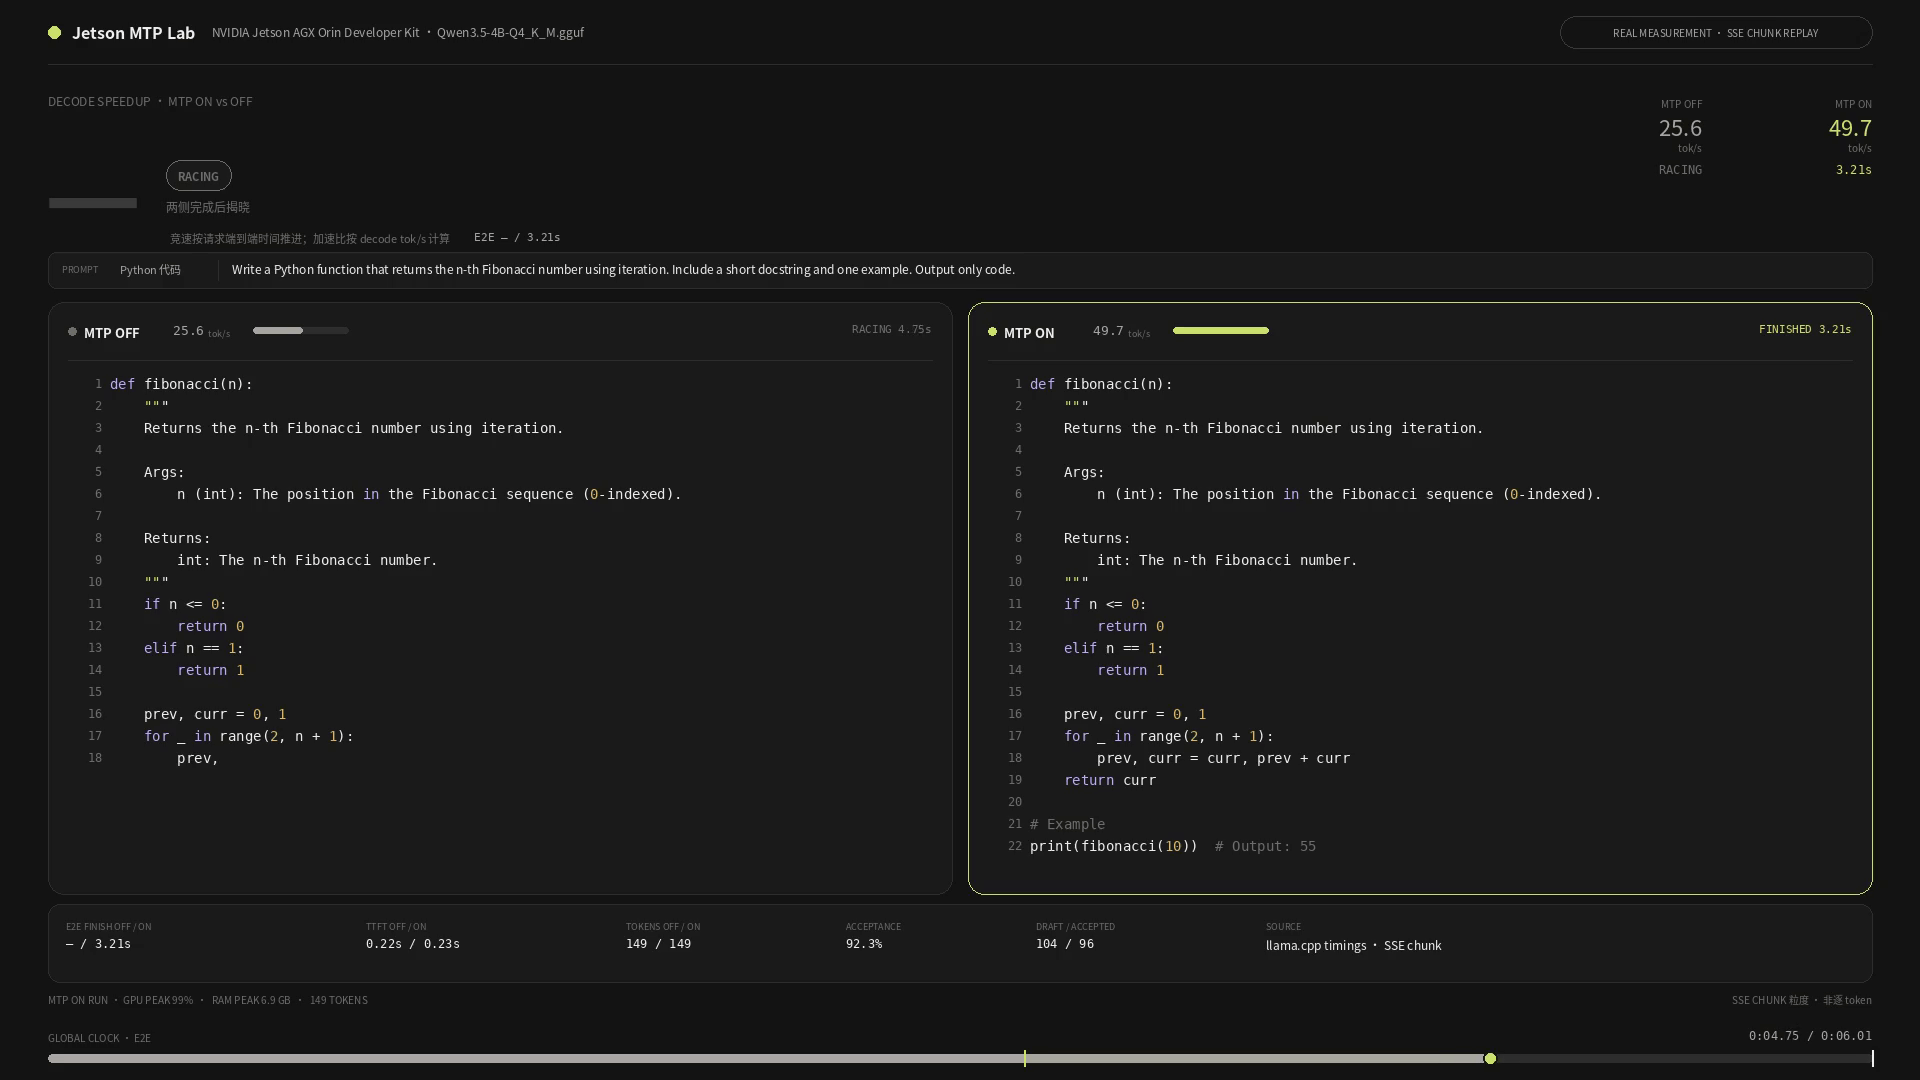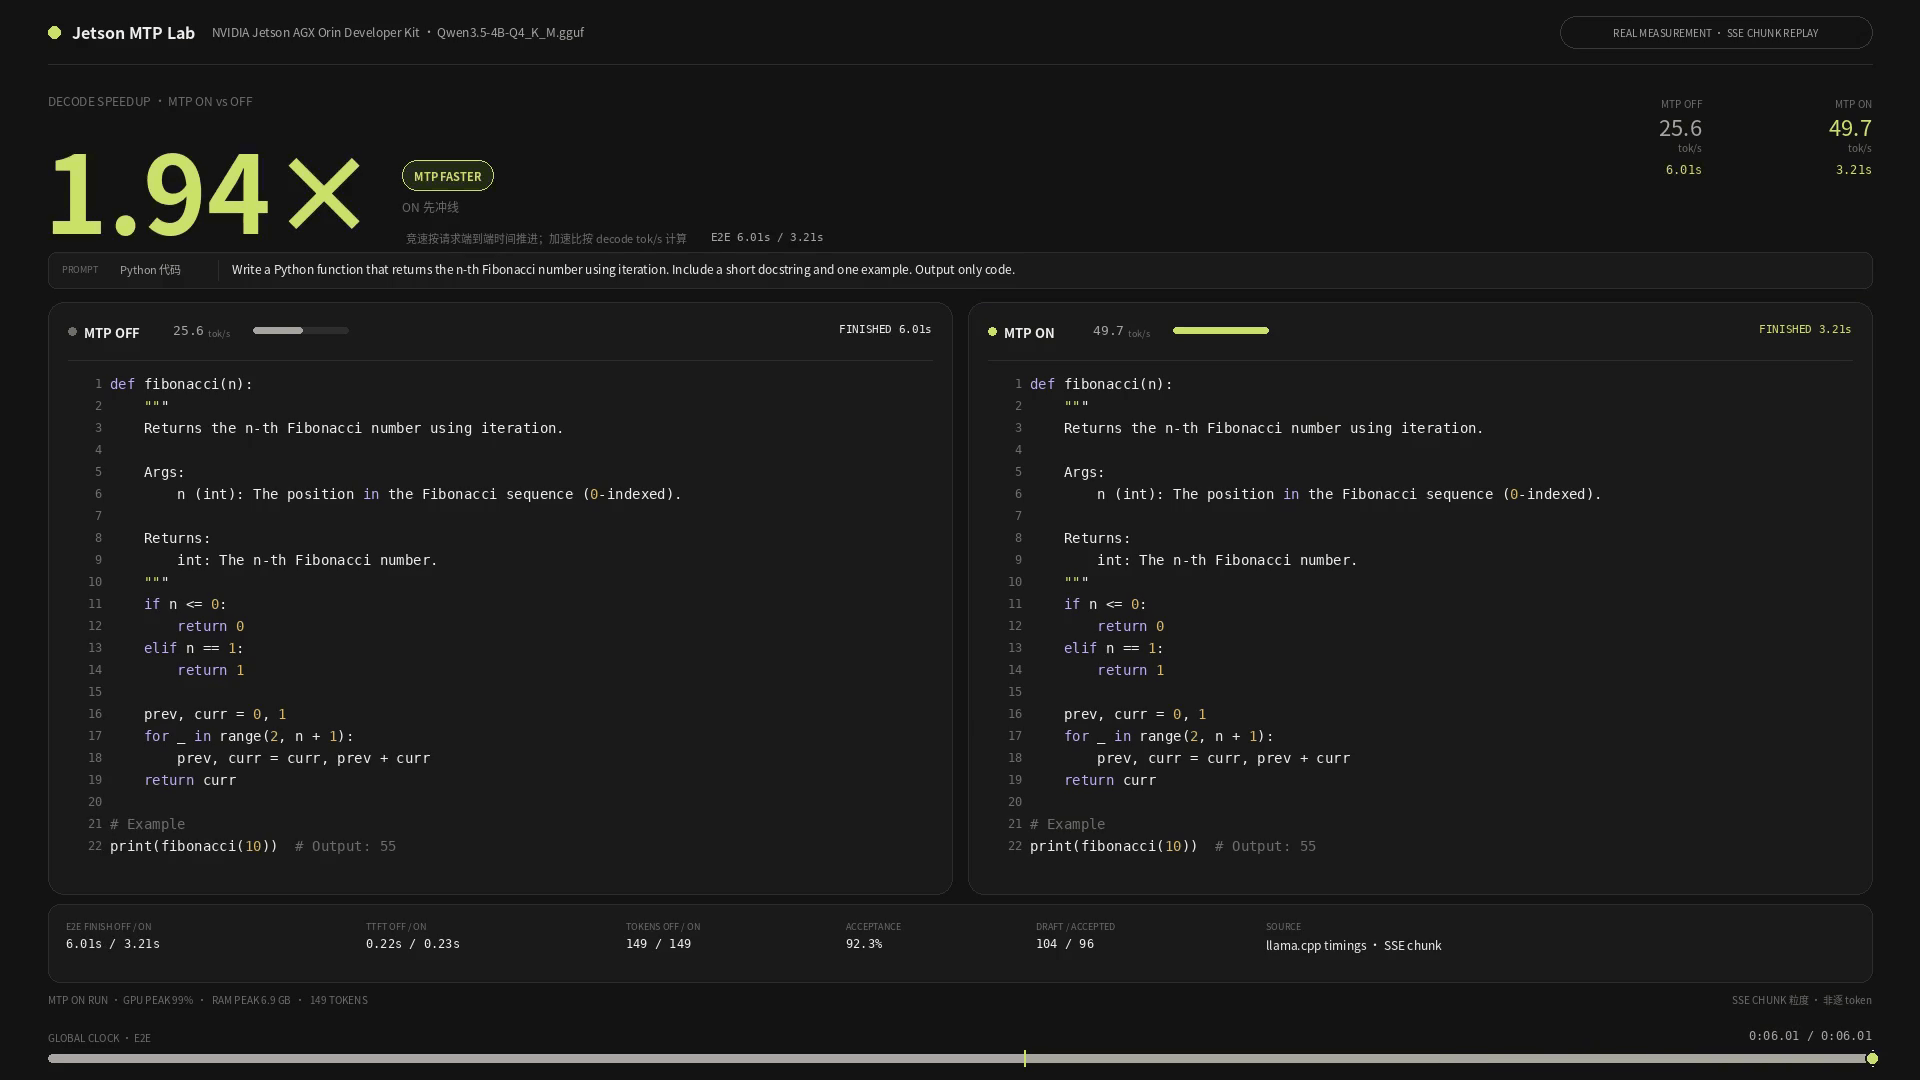
在未启用 MTP 模式时,Qwen3.5 4B 模型的输出速率约为 25.6 tokens/s,而启用 MTP 模式后,同一设备上的同一模型生成速度可达到 49.7 tokens/s。可以看到,对于这类相对确定性的内容,模型的生成速度几乎翻倍。这给了我们一些启示:对于某些相对常规的任务,启用 MTP 模式可以带来相当可观的性能提升!
再看一个视觉分析场景:定义一个 ROI 区域,监控该 ROI 内人数是否在 1.5 秒内持续大于等于 5 人;如果满足条件,则调用 LLM 进行异常分析和诊断。让我们看看在视觉分析场景中,启用 MTP 模式后能快多少!
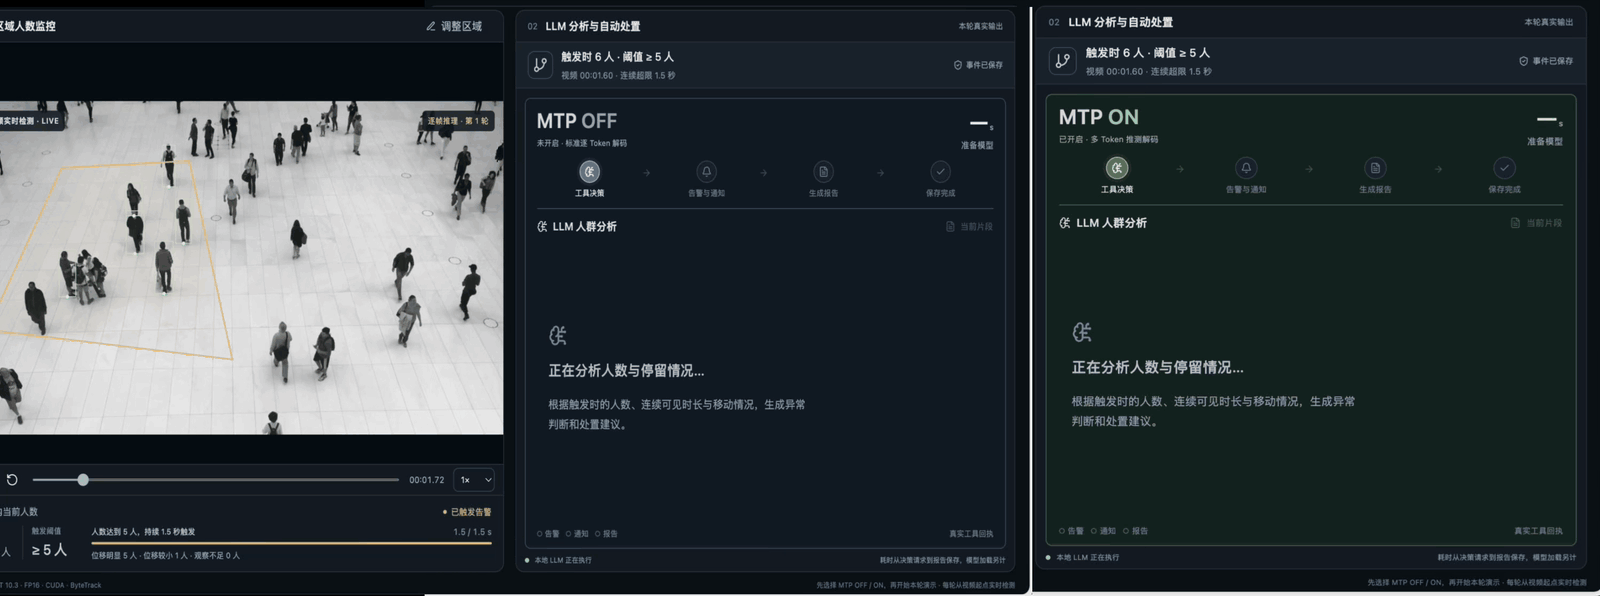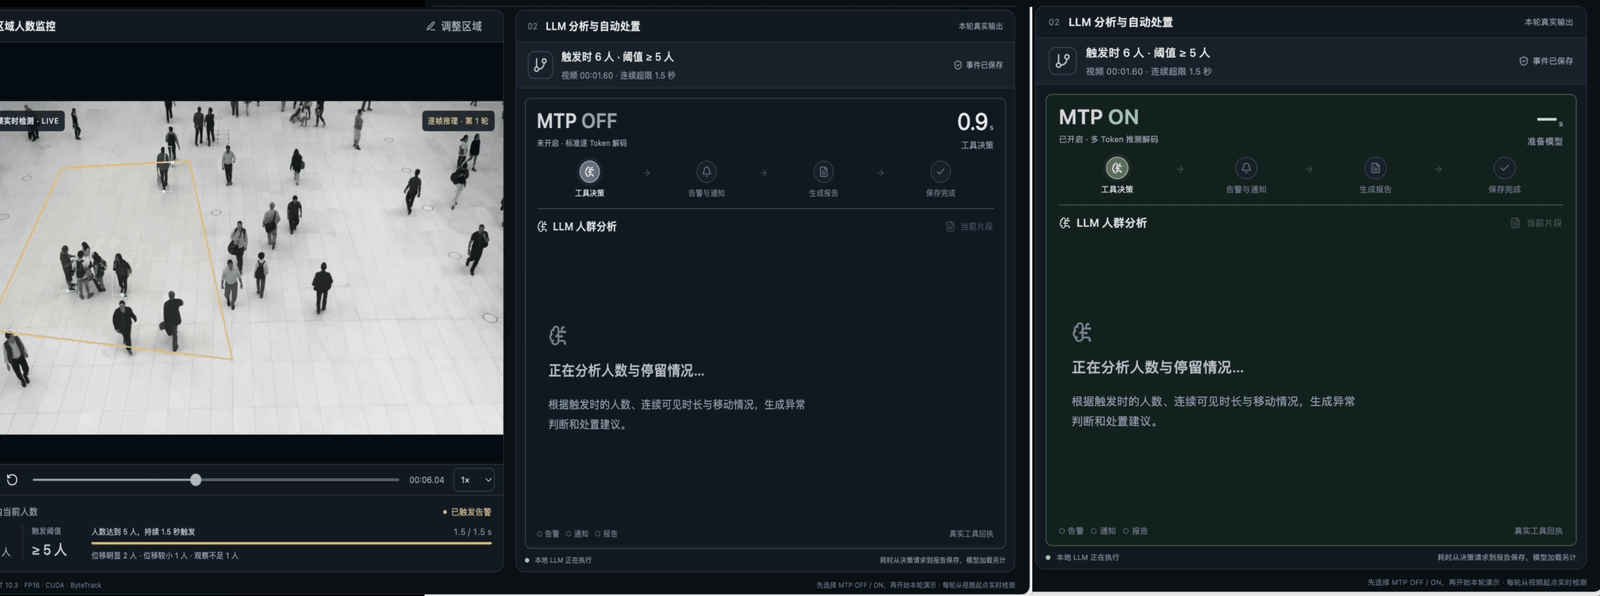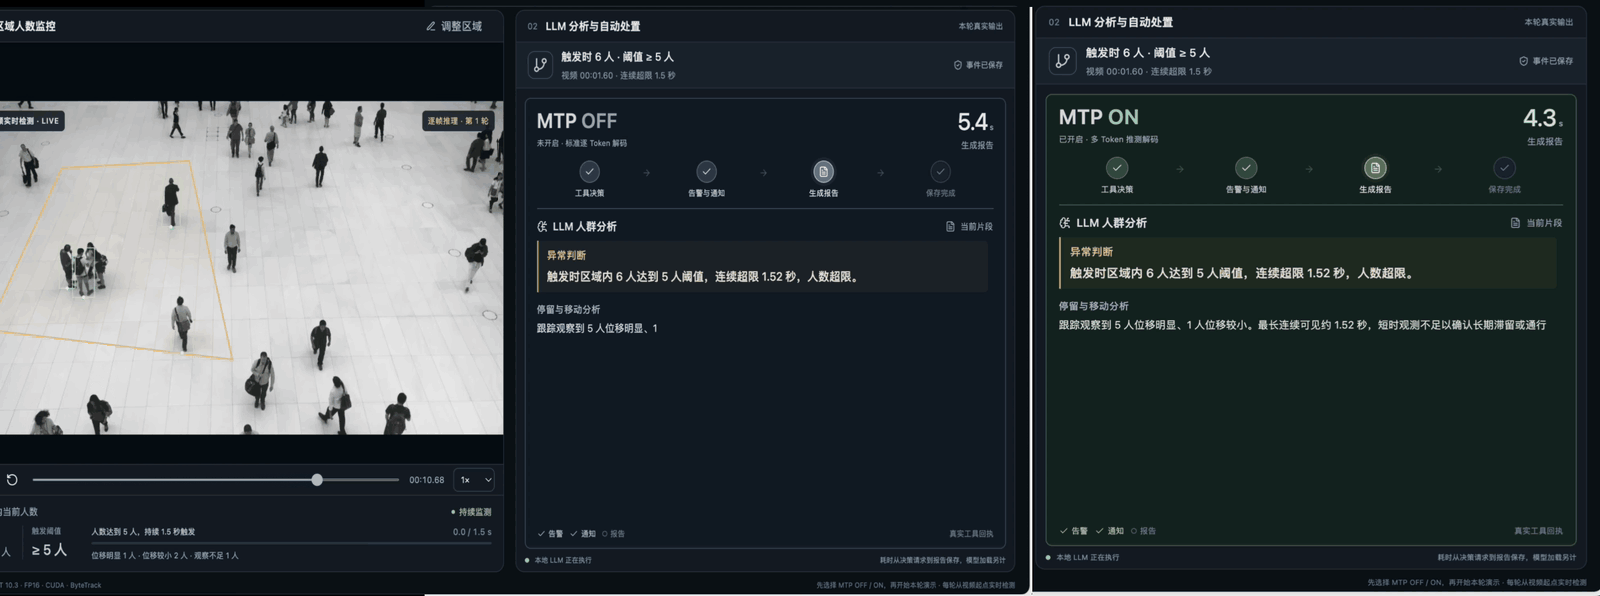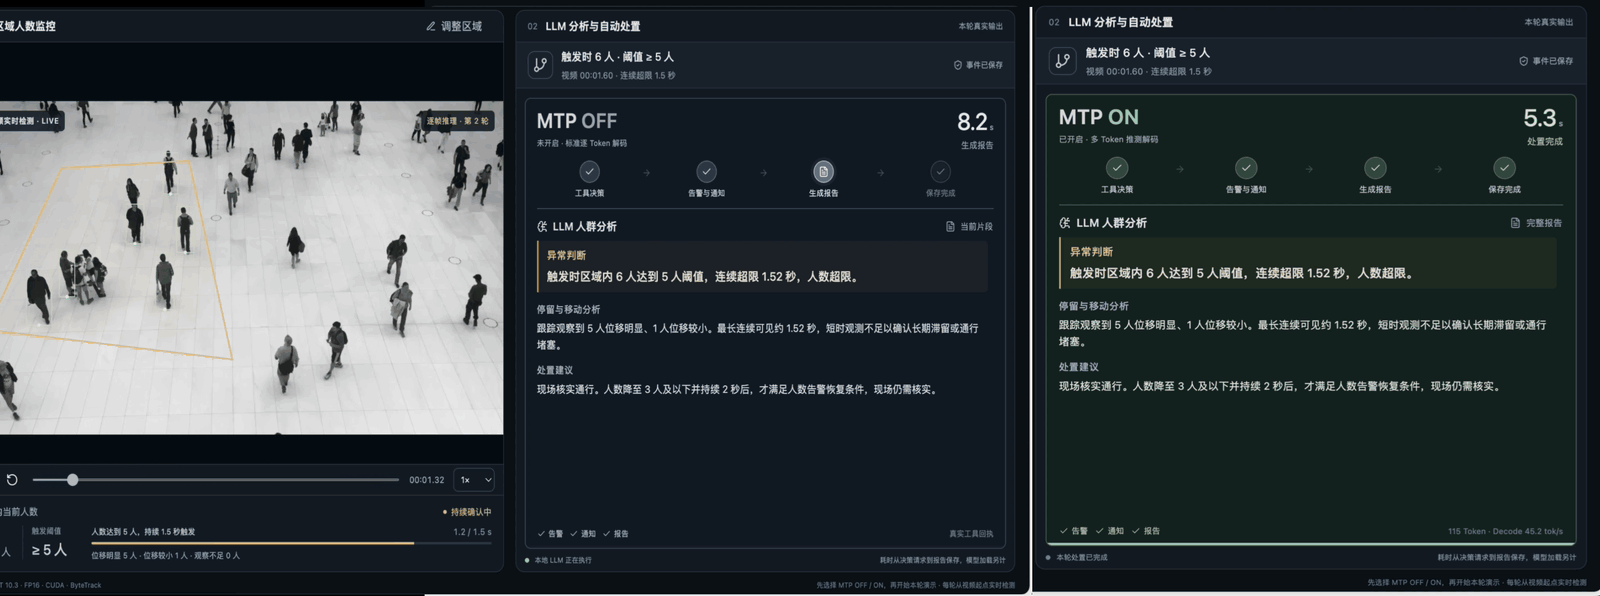
可以看到,在上述场景中,启用 MTP 模式可以将任务完成时间缩短约 3 秒——这一优化相当显著!
为什么 LLM 文本生成会耗时?
一次生成一个 token
向模型询问 NVIDIA Jetson 可以用于哪些场景,它可能会回答机器人、工业视觉和边缘监控。句子是逐渐出现的,因为自回归 LLM 会先预测一个 token,将其加入上下文,再利用该上下文预测下一个 token。
一个 token 可能是一个单词、单词的一部分或一个标点符号。每次新的预测都依赖于之前的内容,因此模型会重复这一过程,直到完成整个回复。
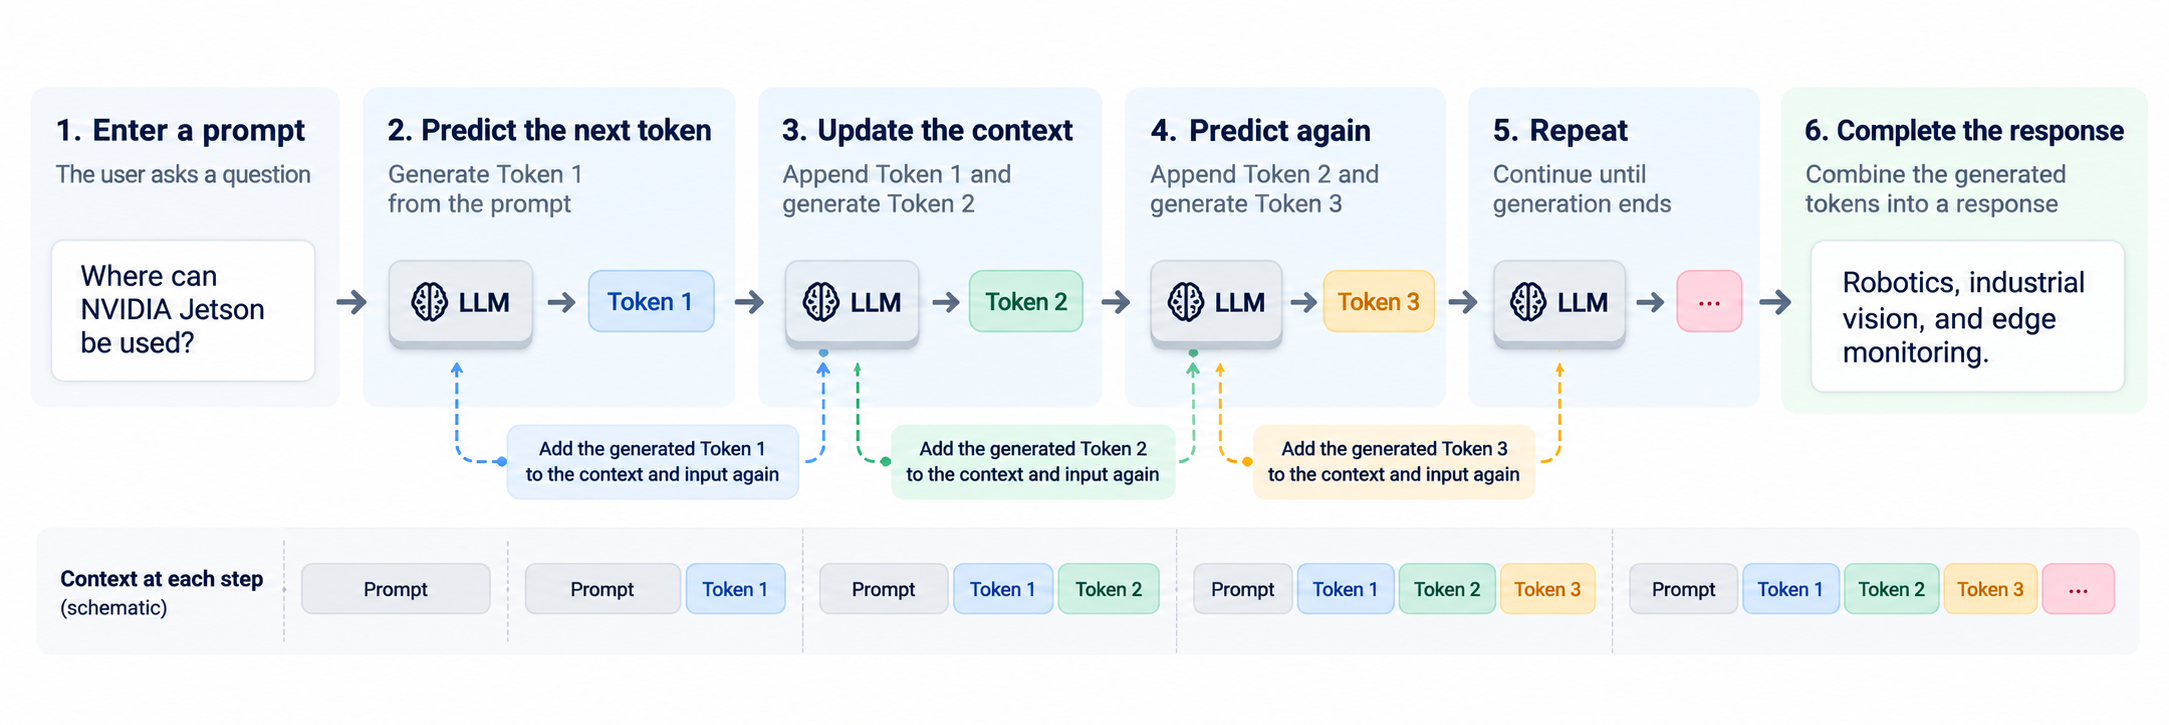
在 20 tokens/s 的速率下,生成 500 个 token 需要大约 25 秒的解码时间。当本地助手在编写代码或报告时,这样的等待就会变得明显。
预填充与解码
LLM 推理主要包含两个阶段。
| 阶段 | 主要任务 | 特点 |
|---|---|---|
| 预填充(Prefill) | 读取提示词并构建上下文状态 | 输入位置可以并行处理 |
| 解码(Decode) | 生成回复 | 后续 token 依赖于较早的输出 |
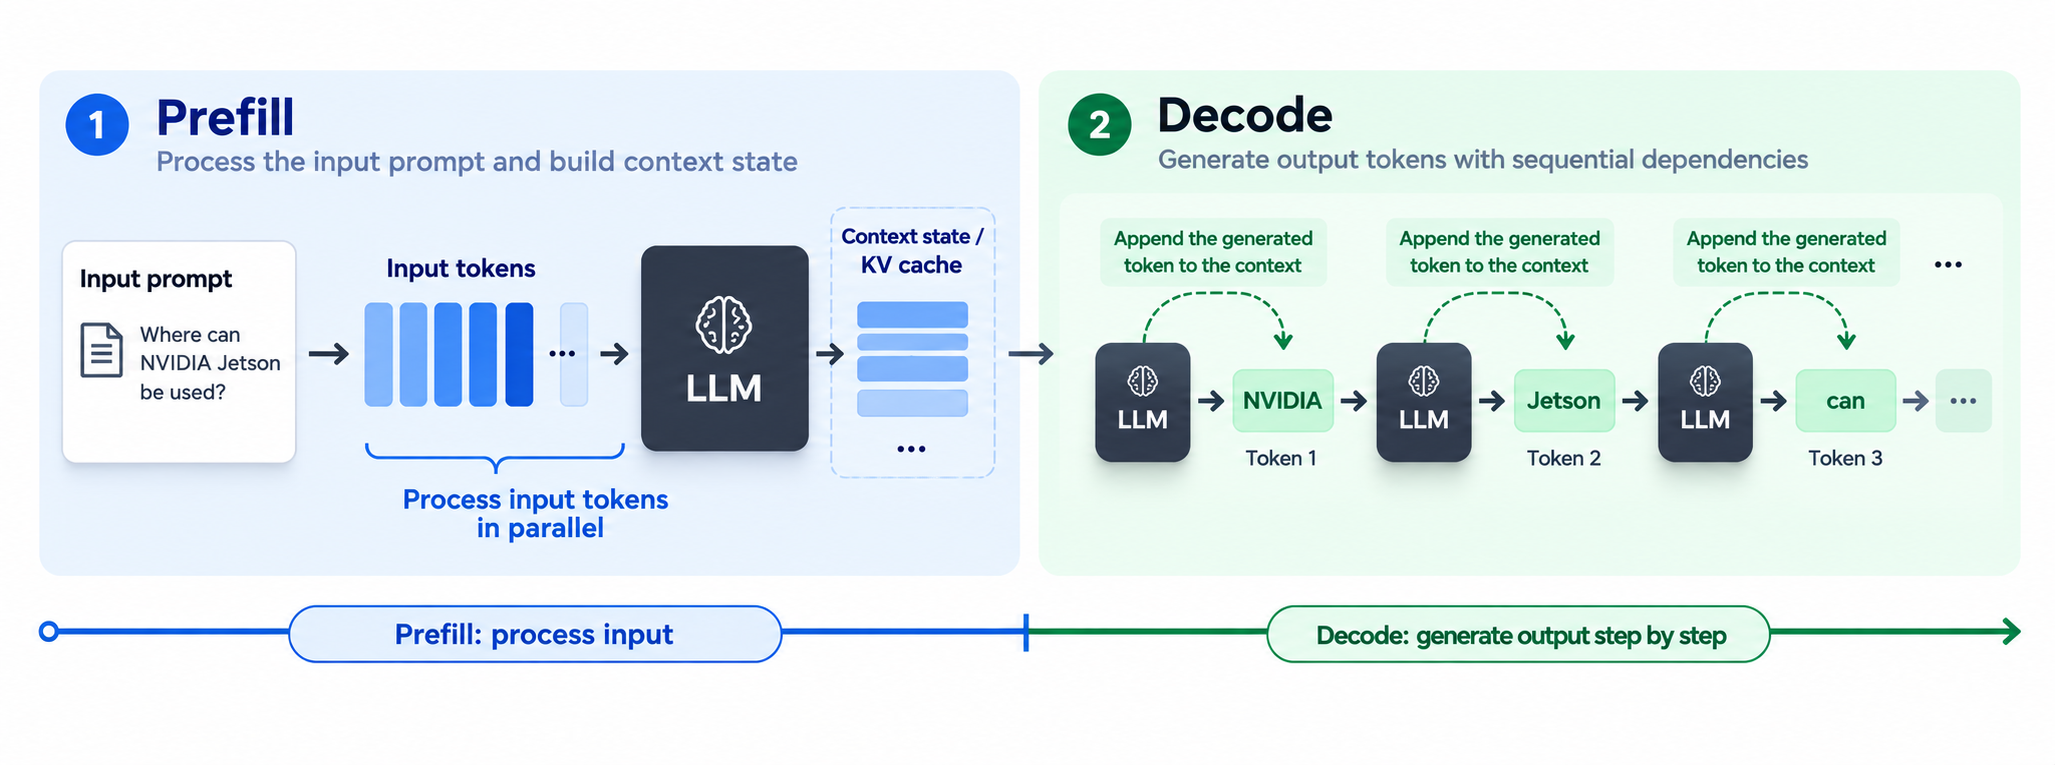
对于在 Jetson 上运行的单用户 LLM,解码阶段往往会花费大量时间从内存中读取模型权重和缓存的上下文。GPU 具备并行计算能力,但单 token 串行步骤的序列可能只能有限利用这些能力。MTP 主要针对的就是这一解码阶段。
什么是 Multi-Token Prediction?
Multi-Token Prediction 会训练额外的预测头或层来提出未来的 token 候选。这些候选随后可用于 speculative decoding,在该过程中,目标模型会一次性验证多个位置,然后再接受输出。
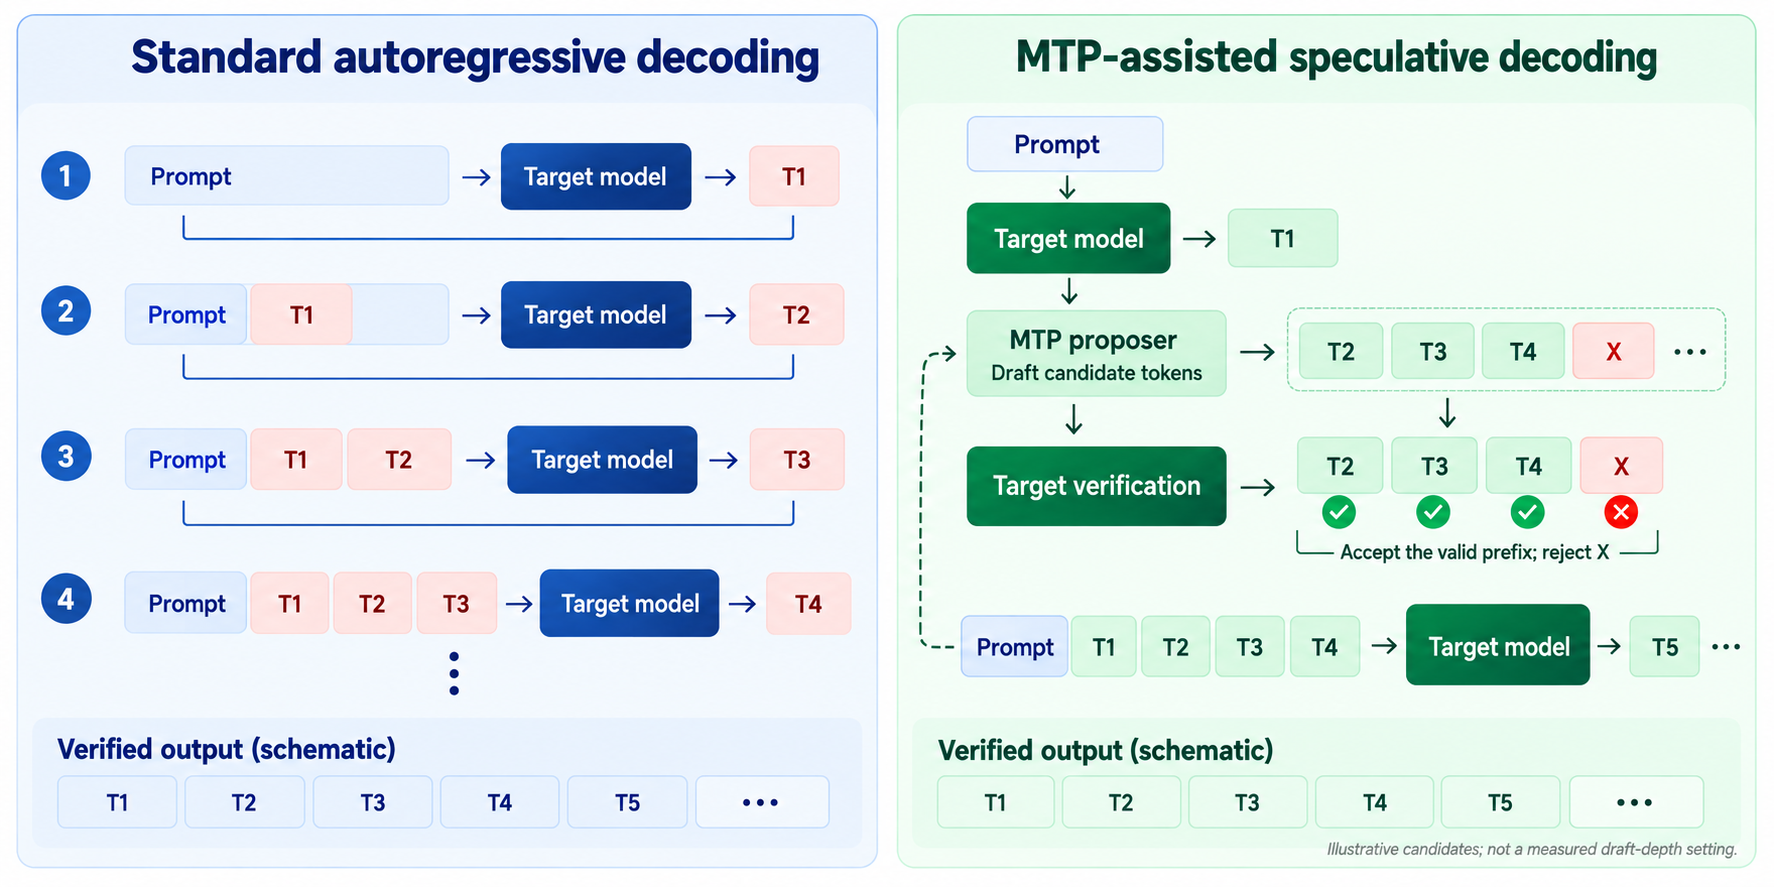
当多个候选通过验证时,回复可以在一次目标模型前向计算中前进多个 token。如果某个候选未通过,运行时会保留已接受的前缀,并丢弃被拒绝的候选及其后续草稿,目标模型则从该位置继续。
当候选足够准确时,这可以减少串行解码前向计算的次数。目标模型仍然会检查输出。正确的无损 speculative decoding 会保留其贪心结果或采样分布,尽管量化和运行时数值差异可能会影响实际行为。
multi-token prediction 论文解释了训练思路。llama.cpp speculative decoding 文档描述了其在推理阶段的使用方式。
为什么 MTP 会更快?
每次验证产出更多有效输出
批量验证可以让目标模型一次检查多个候选。在受内存带宽限制的工作负载中,这可能比通过多次串行前向生成相同数量的 token 成本更低。
起草和验证本身也需要时间。只有当节省下的工作量超过这部分额外开销时,MTP 才能加速生成。一个有用的诊断指标是草稿接受率,即已接受草稿 token 数除以生成的草稿 token 数。同时也要衡量每次验证能让回复前进多少 token,以及整个请求耗时多久。
草稿深度需要测试
最大草稿长度由 --spec-draft-n-max 控制。更长的草稿会给目标模型提供更多候选可供检查,但后面的候选可能不够准确。丢弃这些候选的代价可能会抵消更大批量带来的收益。
从较小的深度开始,并在你自己的提示上进行对比测试。Edge Crowd Agent 的对比实验使用的是深度 2。对常规代码或报告格式表现良好的设置,在其他工作负载上可能会有不同表现。
在 Jetson 上的 llama.cpp 中启用 MTP
本演示使用以下配置。
| 组件 | 配置 |
|---|---|
| 硬件 | NVIDIA Jetson AGX Orin 32GB |
| JetPack | 6.2.1 |
| 运行时 | llama.cpp(启用 CUDA) |
| 模型 | 带 MTP 张量的 Qwen3.5-4B |
| 量化 | Q4_K_M GGUF |
| 对比 | 关闭 MTP / 开启 MTP |
按照官方构建说明使用 CUDA 构建 llama.cpp。选择 启用 MTP 的 Qwen3.5-4B GGUF,并检查你编译出的二进制文件的帮助输出中是否列出了 draft-mtp。
运行时准备就绪后,启用 MTP 的启动命令非常简短。
llama-server \
  -hf unsloth/Qwen3.5-4B-MTP-GGUF:Q4_K_M \
  -ngl 99 -c 8192 -np 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 2
使用你构建出的 llama-server 二进制文件。对于已下载到本地的模型,将 -hf 替换为 -m,并在其后跟上本地 GGUF 路径。
--spec-type draft-mtp 用于启用 MTP;--spec-draft-n-max 用于控制其深度。对于关闭 MTP 的对比实验,使用 --spec-type none,并保持模型和其他共享设置不变。
生成结束后,在启动日志中检查已加载的 MTP 张量以及服务器的草稿接受统计信息。本配置下请使用单 slot 且仅文本请求;关于当前兼容性限制,请参考模型发布者的说明。
MTP 适用于哪些场景?
巡检与监控报告
Jetson 可以采集检测结果、传感器读数和设备日志,然后让本地 LLM 撰写巡检报告。重复出现的字段和描述,使其成为测试候选接受情况的一个有用工作负载。其收益是缩短书面报告的等待时间;实时控制和保护仍然是独立的。
本地编码助手
Python 脚本、shell 命令和设备配置文件通常会产生语法较为规则的长回复。介绍部分的斐波那契示例展示了该设备上的潜力。生成的代码仍然需要检查和测试。
离线语音助手和机器人
语音助手会将识别出的语音传给本地 LLM,然后将其回复发送给文本转语音模块。
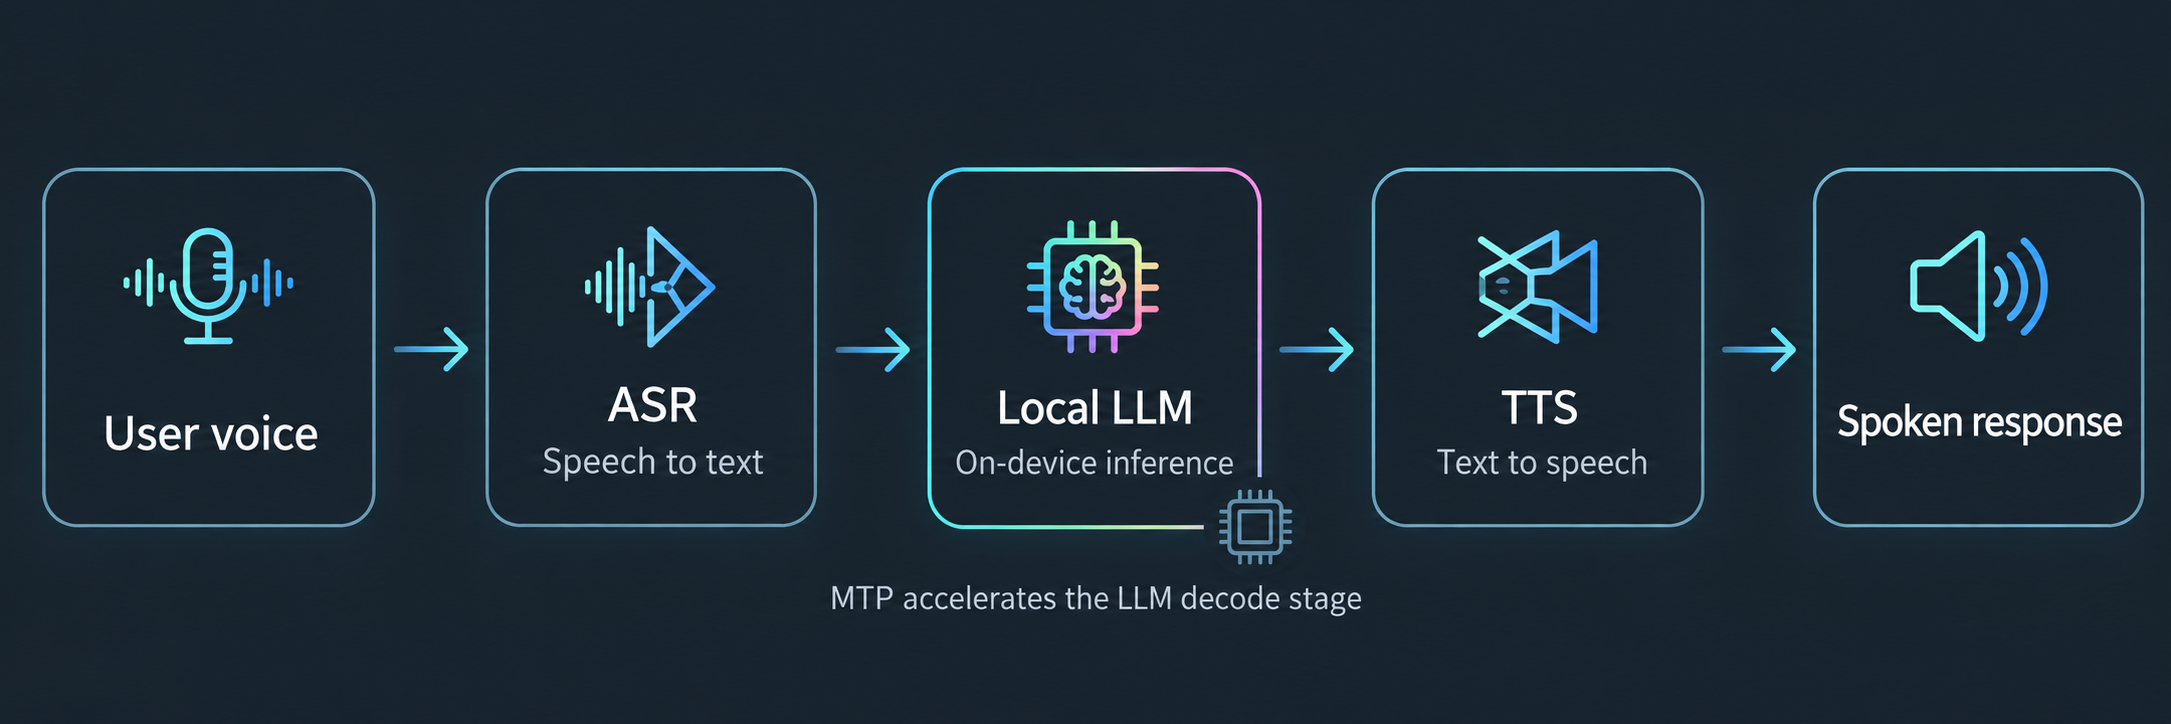
对于较长的回复,MTP 可以缩短 LLM 的解码阶段。语音识别、合成以及流式传输共同决定用户真正听到答案的时间,因此既要测量到首段可用语音的时间,也要测量完整回复的时间。
本地知识与技术说明
基于设备日志生成的故障排查说明和长篇回答,可能会在输出生成上花费大量时间,这类场景值得测试。对于只需要一句话回答的长文档,提示处理可能占主导,从而几乎没有可节省的解码时间。
什么时候值得启用 MTP?
首先需要兼容的模型。运行时必须支持其预测组件,并且额外的起草工作必须能在你的硬件和提示上“回本”。更高的接受率和更长的输出通常有帮助,而较低的接受率或非常短的回复则可能让 MTP 变得更慢。
将其与您的应用实际所需时间进行比较。更快的解码并不会按相同比例缩短图像处理、工具执行或模型加载时间。保持模型、输入、输出限制和采样设置一致,然后根据测得的结果做出决定。
试用人群监控演示
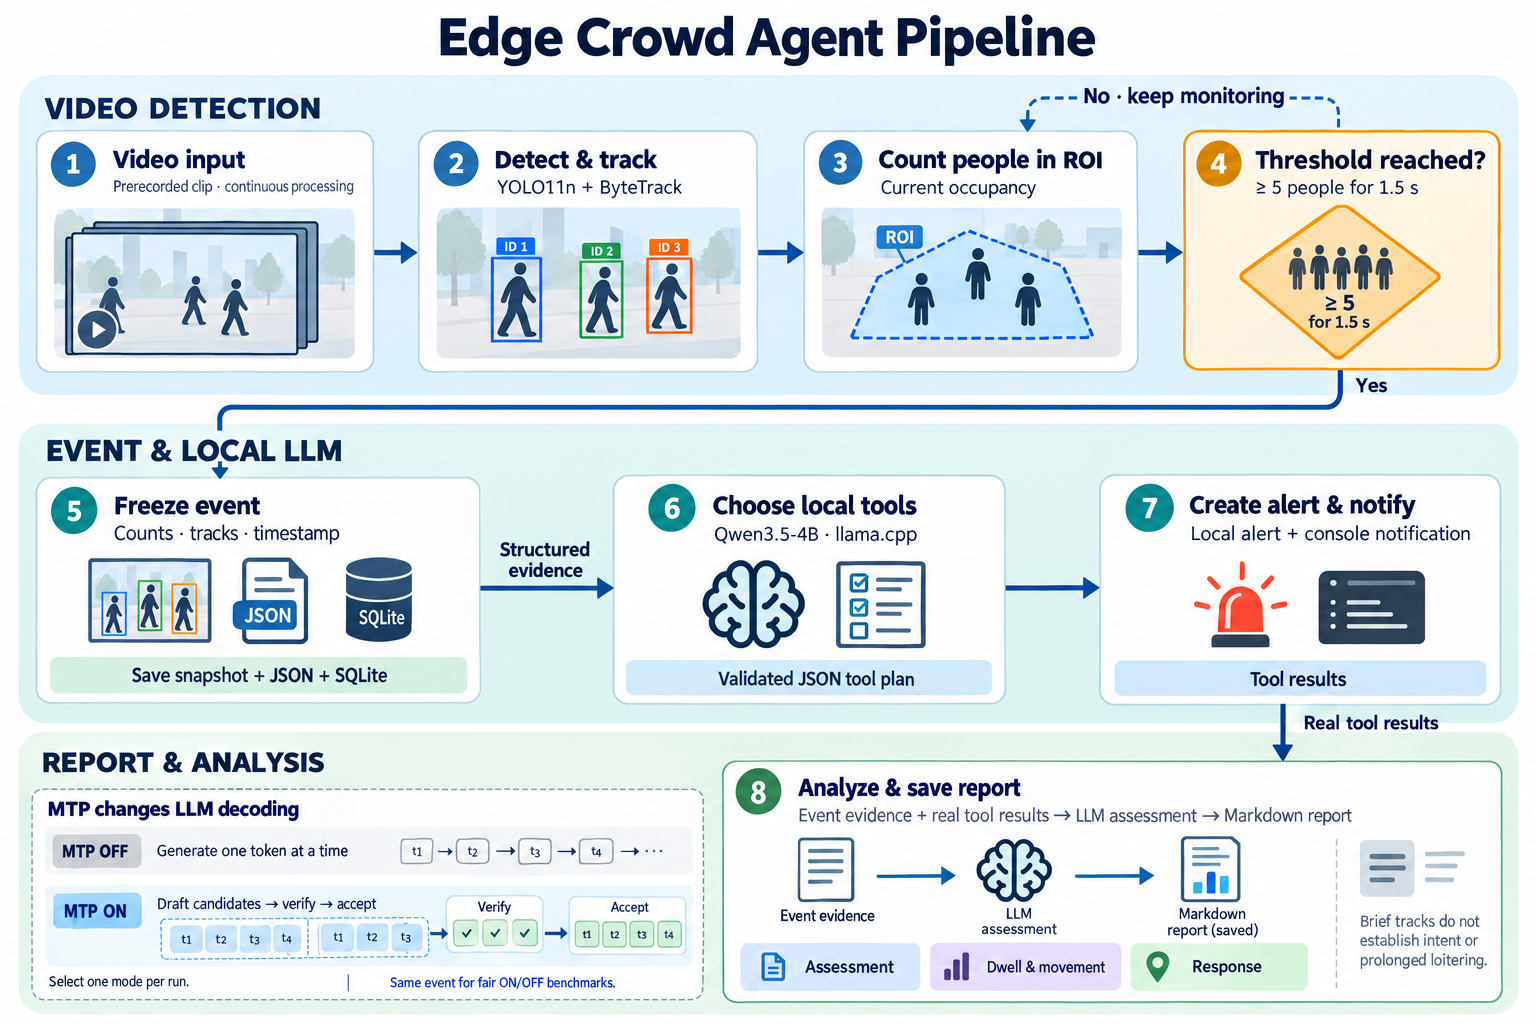
开头演示所使用的源码是 Edge Crowd Agent。YOLO11n 和 ByteTrack 用于测量当前 ROI 的占用情况,本地 LLM 会在事件被触发时,根据保存的计数和移动证据进行说明。
请按照 README 中的 Start on Jetson 进行依赖安装、模型和视频路径配置、环境检查以及启动。该项目使用 uv 搭配系统自带的 Python 3.10,以保留对 JetPack 中 TensorRT 绑定的访问。
启动后,选择关闭或开启 MTP,然后选择 Start demo。左侧为视频检测,右侧为分析和工具进度。recording guide 说明了如何运行这两种演示。
默认的事件条件是在 ROI 中至少有 5 个人,并且在连续 1.5 秒的视频时间内保持。LLM 接收的是结构化证据而不是视频像素;较短的轨迹可以支持占用情况评估,但无法判断意图或长时间逗留。
为了进行可控的对比,请使用同一个冻结事件,而不是两段不同的录制。README 中的 benchmark 部分 提供了测试方法和测得结果,并将模型加载时间单独列出。
参考资料
- Edge Crowd Agent 源码与使用说明
- Edge Crowd Agent 基准测试记录
- Jetson AI Lab 推测解码教程
- llama.cpp 推测解码文档
- llama.cpp SPEED-Bench
- Qwen3.5-4B MTP GGUF 模型
- Better & Faster Large Language Models via Multi-token Prediction
技术支持与产品讨论
感谢您选择我们的产品!我们将为您提供多种支持,确保您在使用我们产品的过程中尽可能顺畅。我们提供多种沟通渠道,以满足不同的偏好和需求。