使用 NVIDIA Skills 在 Jetson 上进行快速原型开发
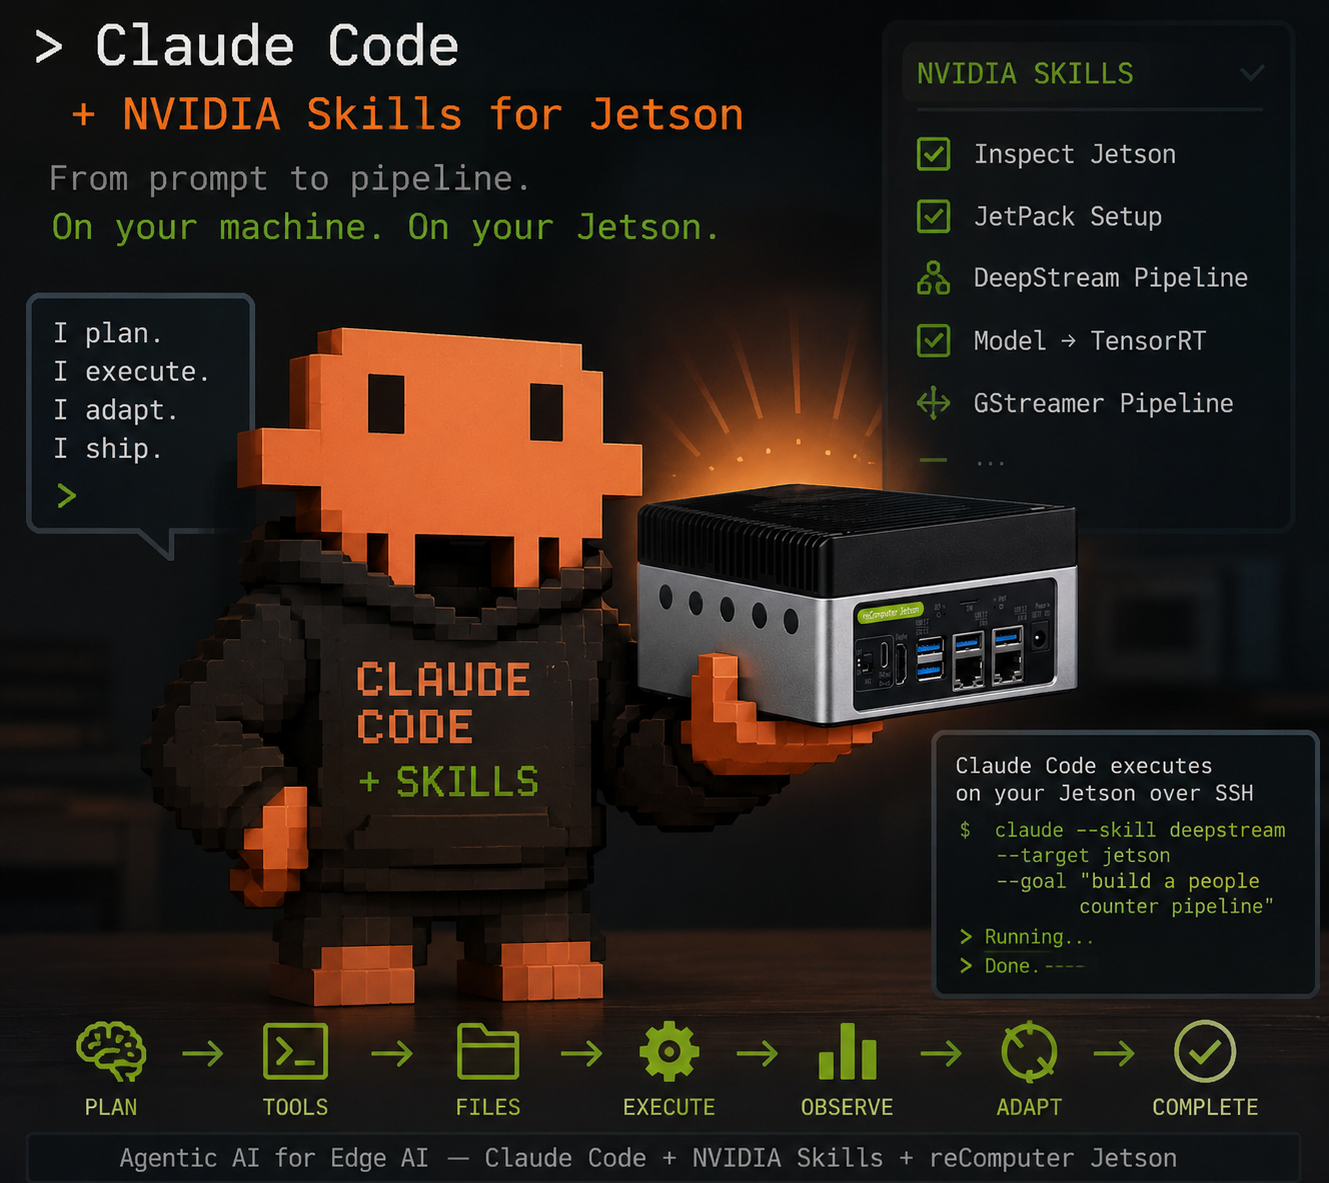
介绍
Jetson 项目很少是因为开发者不会写模型代码而停滞。它们通常更早在部署相关的“胶水工作”上卡住:检查设备状态、确认 JetPack 兼容性、选择可行的安装路径、构建第一个可运行的 pipeline、验证输出,以及把结果打包成可以演示的形式。在真实项目中,最初的几天往往就消耗在这里。
这正是智能体 + 技能工作流发挥作用的地方。一个面向 Jetson 的 skill 会为 AI 编码智能体提供结构化指令,针对一小类任务,例如设备诊断、内存检查、环境准备或模型导入。你不再从一个空白 shell 开始、再从零拼凑分散在文档里的流程,而是从一个对 Jetson 友好的交付路径起步。
这种方法并不绑定于某个特定的智能体框架。任何能够加载可复用技能、检查文件、运行命令并与远程设备交互的智能体,都可以从同样的模式中获益。本文使用 Claude Code,是因为该工作流需要一个可以检查文件、运行 shell 命令并访问远程设备的智能体;这些 skills 也可以以同样方式加载到其他智能体中。
本文刻意写成一种交付方法论,而不是一次性的演示记录。我们会使用一个车辆速度检测示例,但真正的目标是展示一条可复用的路径,你可以在不同的 Jetson 应用和不同的智能体配置中反复使用。
本文中的“Skills”指的是由 NVIDIA 编写的可复用智能体技能,并由工作流中使用的编码智能体加载。这与 Seeed 的 Jetson DevelopTool “Skills” 模块不同,后者是一个独立的 GUI 自动化功能。如果你在寻找那个 GUI 模块,请参阅 DevelopTool Skills 模块 一文。
什么是 NVIDIA Skills?
一个skill 是一组可复用的指令和参考资料打包,AI 编码智能体按需加载。当你调用一个 skill 时,智能体会收到与任务相关的指导:要检查什么、遵循哪些约定、使用哪些工具,以及要验证哪些输出。在 Claude Code 中,用 /<skill-name> 显式点名一个 skill 只是触发该行为的一种方式;一旦 skills 安装到工作区,智能体也可以在它们之间自动选择。
有两个 NVIDIA skill 仓库与 Jetson 开发者特别相关:
- 面向通用工作流的 NVIDIA/skills
在本文中,我们使用这些 skills 来减少重复的 bring-up 工作,并缩短从“设备可用”到“原型验证完成”的路径。
为什么 Jetson 交付会变慢
一个 Jetson 应用的第一个版本通常需要协调硬件状态、JetPack 和运行时兼容性、在 ARM 上的包安装选择、模型放置、启动命令、输出路径,以及某种最低限度的性能验证。问题不在于任何单一步骤做不到,而在于这些步骤分散在不同的工具、文档和临时 shell 操作中,因此交付路径比应有的时间更长地保持模糊。
技能驱动工作流的实际价值在于,它把下面这种情况:
| 传统路径 | 技能驱动路径 |
|---|---|
| 在动手前阅读多份文档 | 从一个面向任务的 skill 开始 |
| 手动检查设备状态 | 让智能体诊断 Jetson |
| 猜测依赖安装路径 | 让智能体使用对 Jetson 友好的安装路径 |
| 手工搭建第一版原型 | 让智能体搭脚手架,生成最小可运行版本 |
| 手动向团队成员解释各类工件 | 让智能体总结文件、命令和输出 |
| 从零开始搭一个快速演示界面 | 让智能体把原型封装成可分享的形式 |
Skills 擅长做什么
在 Jetson 工作中,当任务仍然是降低不确定性时,skills 的作用最强:检查当前设备、选择更适合 Jetson 的安装路径、围绕某个模型或测试资产生成第一个可运行原型、解释创建了什么,以及把结果打包成可以展示或复现的形式。把它们当成生产工程的替代品就不太合适了。一个 skill 可以加速 bring-up 和验证,但它并不保证最佳性能、生产级可靠性、针对你场景的标定精度,或你为规模化和可维护性最终做出的架构选择。这条边界很重要,因为该工作流的意义在于更快地到达一个可信的基线,然后再有意识地加固。
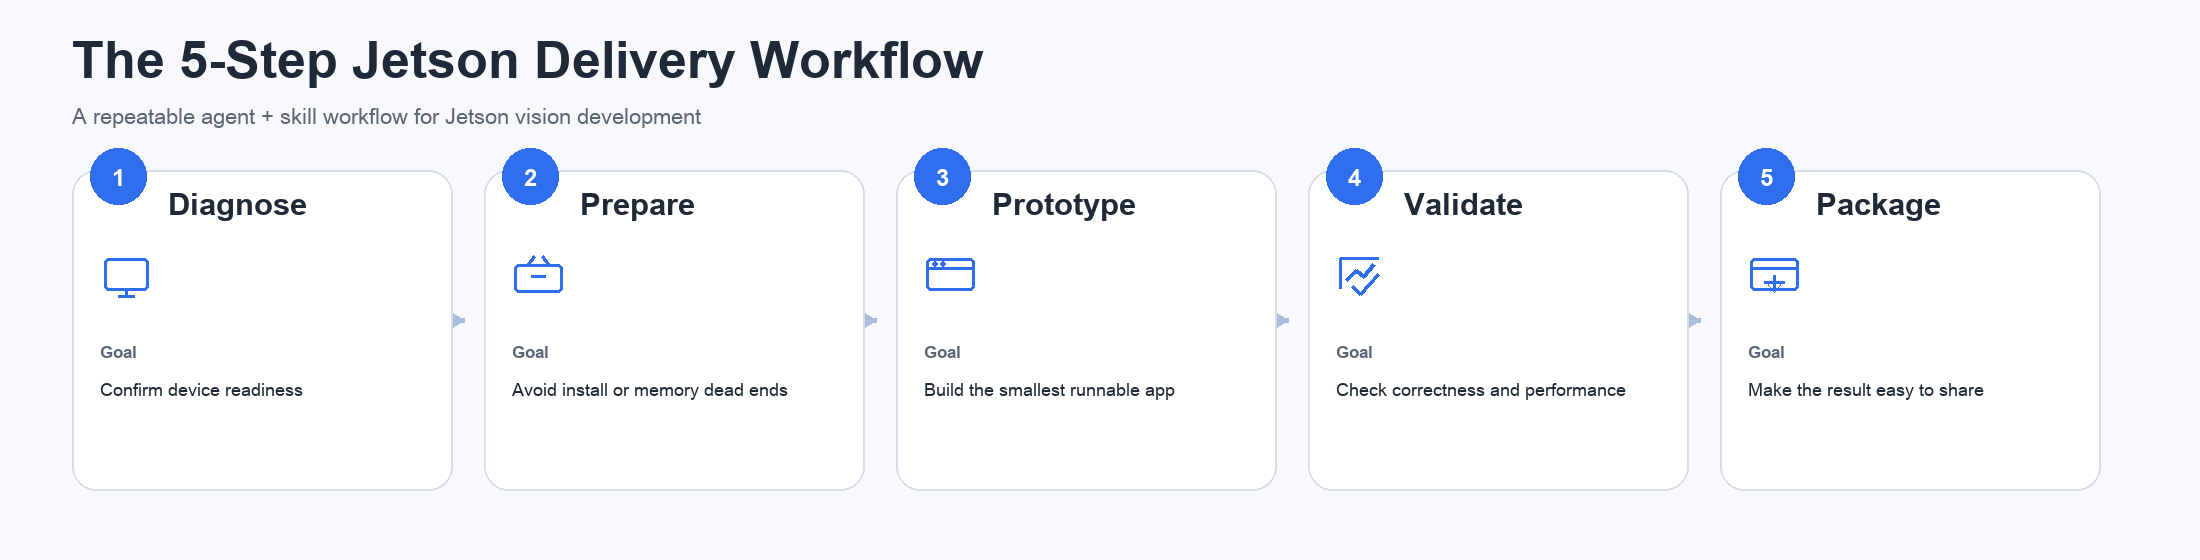
Jetson 交付的 5 步工作流
每一步该用哪个 Skill
不是每个项目都需要所有 skills。更好的心智模型是:当出现具体阻碍时,用合适的 skill 来解决。
从 jetson-diagnostic 开始
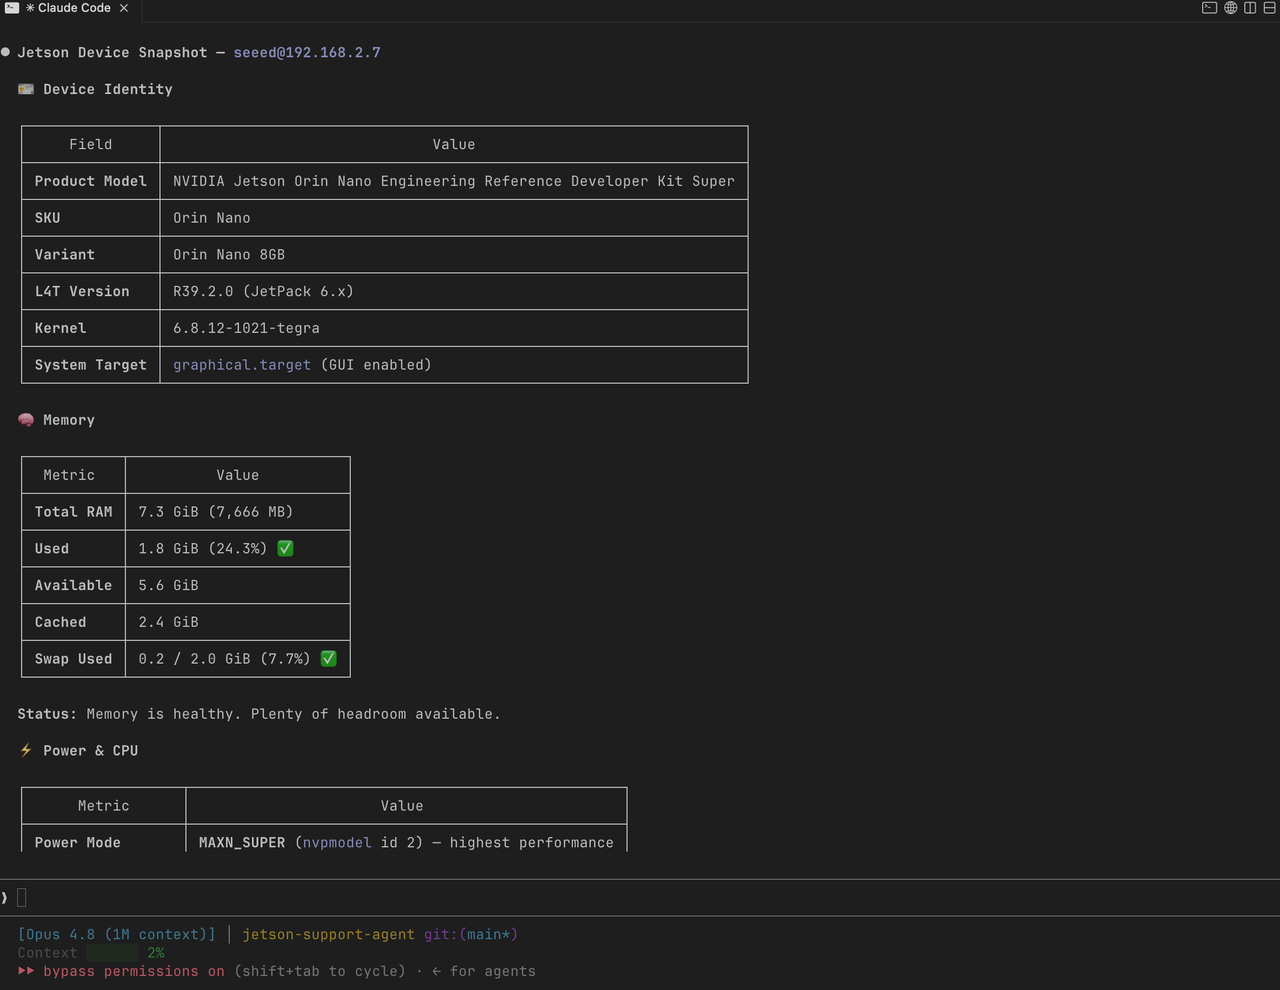
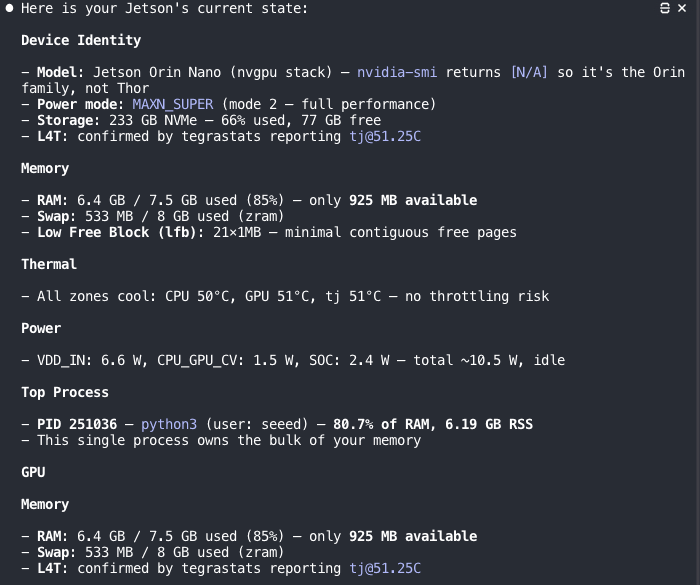
当你还不知道 Jetson 是否已准备好部署时,先用这个。在实践中,它会给智能体足够的实时设备上下文,以回答通常会阻塞后续工作流的问题:正在运行的是哪款 Jetson 型号、安装了哪个 JetPack/L4T 版本、有多少可用内存、设备是否受限于温度,以及主要服务或硬件端点是否可见。
提示示例:
/jetson-diagnostic Check whether this Jetson is ready for a real-time vision prototype and summarize any blockers.
当安装指导变得泛化或不安全时使用 jetson-package
在 Jetson 上,直接照搬来自 x86 Linux 或通用 AI 教程的包安装建议往往会失败。当你希望智能体优先选择对 Jetson 友好的来源和部署路径时,使用 jetson-package,尤其是在为 PyTorch 或 OpenCV 等依赖决定使用宿主机包、wheel 还是容器时。
/jetson-package Recommend the correct Jetson-compatible dependency path for this vision project.
当内存成为首要瓶颈时使用 jetson-memory-audit
当模型加载缓慢、进程被杀掉,或者设备在推理负载下感觉不稳定时,这个 skill 很有用。它会为智能体提供一个基于数据的视图:当前是谁在占用 DRAM、之前的进程是否真的释放了内存,以及某个配置更改是否带来了可测量的改进,而不是只是听起来合理。
/jetson-memory-audit Measure the current memory pressure and identify the biggest consumers before I deploy this prototype.
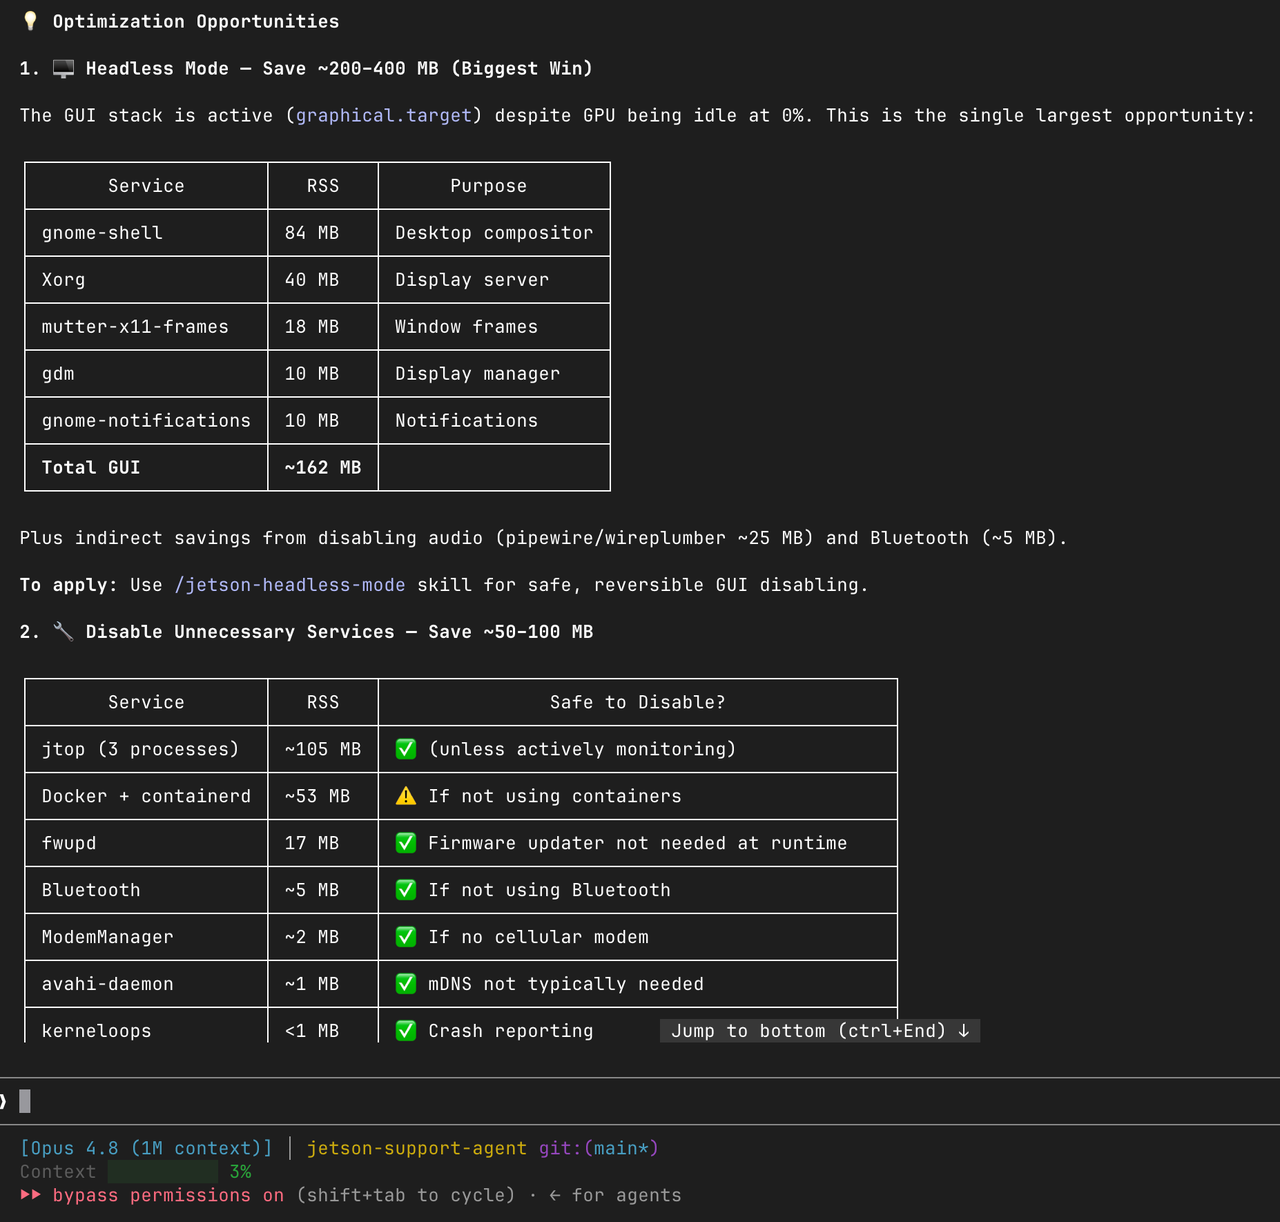
当设备作为一台“家电”使用时,使用 jetson-headless-mode
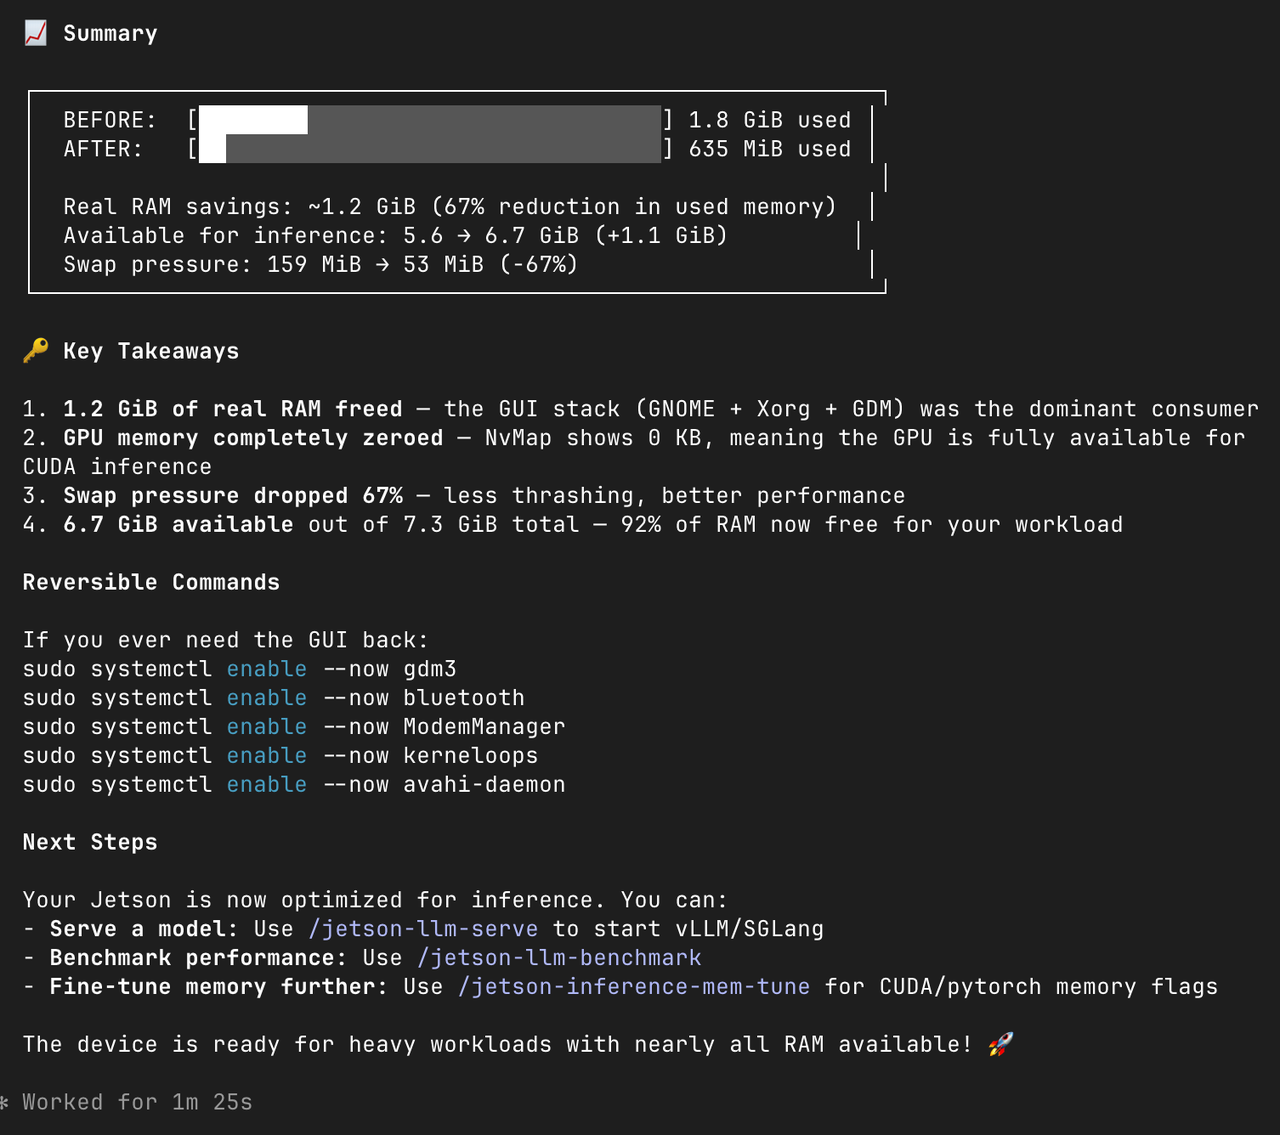
如果 Jetson 被用作专用边缘节点,而不是桌面机器,切换到 headless 模式可以为推理工作负载回收资源。
/jetson-headless-mode Compare memory usage before and after enabling headless mode for this deployment target.
使用任务特定的构建 skill 生成第一个可运行版本
一旦设备和环境已经搞清楚,下一个目标不是完美。目标是得到一个最小有用原型,并且输出可检查。
在下面的示例中,我们使用 deepstream-import-vision-model 作为构建步骤。
原型验收标准
在深入优化之前,先定义什么算是成功的原型。一个 Jetson 的首个原型通常在以下条件满足时就已经足够:可以用清晰的命令重新运行、输入和输出路径是明确的、结果可以立即检查,并且当前的资源状况不再是谜。如果你已经能看出主要瓶颈在哪里,并且下一步工程动作一目了然,那么这个原型就已经完成了它的使命。第一轮的目标不是完成产品,而是足够快地降低不确定性,让下一次迭代变成有意识的决策,而不是猜测。
前置条件
在跟随示例工作流之前,请准备以下内容:
- 一台已通电并可通过网络访问的 reComputer Jetson 或其他 Jetson 设备
- Jetson 上已配置好的 JetPack 环境
- 安装在主机上的一个 AI 编码智能体,用于驱动整个工作流
- 从主机到 Jetson 的 SSH 访问 能力
- Jetson 上有足够的存储空间,用于模型下载、临时文件和输出
- 一个已放置在 Jetson 上的 测试资产,例如一段视频
在本示例中,我们假设测试视频 top_view.mp4 已放在 Jetson 上的 /home/seeed/workspace/traffic_monitor/ 目录下。
主机运行编码智能体,并通过 skills 驱动 Jetson 上的工作,通常是通过 SSH。在实践中,根据智能体选择的具体实现路径,你的实际环境可能仍然需要额外的依赖,例如 Python、DeepStream 或容器支持。
设置 Skills 工作区
在本文使用的 Claude Code 示例中,skills 位于项目根目录下的 .claude/ 目录中。
mkdir -p project/.claude/
cd project/
git clone https://github.com/NVIDIA/skills.git
cp -r skills/skills .claude/
claude
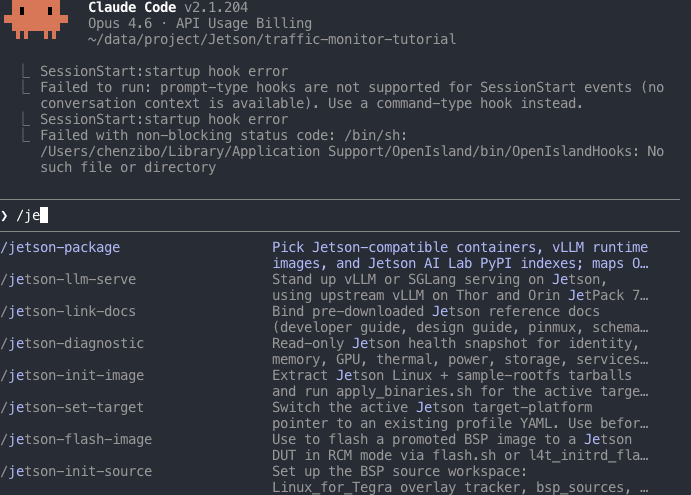
一旦启动 claude 命令,你就可以输入 /<skill-name> 来显式强制代理读取某个特定的 skill。当你已经知道自己想要哪种工作流时,这会很有用。但一旦这些 skills 安装到工作区中,代理就已经知道它们的存在,并且可以根据你的请求在它们之间自动进行选择。在实践中,它可能会在一次执行中串联多个 skills,例如将诊断、包选择、内存检查和原型生成组合在一起,而不是把每一步都当作完全独立的会话来处理。
案例研究:车辆速度检测映射到工作流
下面的示例展示了这个 5 步工作流在实践中的样子。示例本身是车辆速度检测,但真正值得关注的是交付模式。
第 1 步:诊断设备
首先检查 Jetson 是否真的已经为视觉工作负载做好准备。像下面这样的提示可以为代理提供足够的上下文,以便检查设备并报告对原型真正重要的阻塞因素,而不是仅仅倾倒原始遥测数据。
/jetson-diagnostic Check the current status of my Jetson and summarize any blockers for a vision prototype.
SSH login: seeed@192.168.6.204
Password: seeed
上面的 IP 地址和密码只是示例值。请替换为你自己的 Jetson 凭据。seeed 是某些 Seeed Jetson 设备上的默认密码,在生产设备上应当更改。
第 2 步:准备环境
如果诊断步骤表明环境对原型来说还不够干净,那么此时就应该先进行准备,而不是盲目前进。jetson-package 可以帮助代理选择与 Jetson 兼容的依赖路径,而当内存压力或不必要的桌面开销成为首要障碍时,jetson-memory-audit 和 jetson-headless-mode 会很有用。
/jetson-package Recommend the correct dependency path for this Jetson vision prototype.
/jetson-memory-audit Measure memory usage before I deploy the model and identify the top consumers.
/jetson-headless-mode Compare whether this device should be switched to headless mode for better inference headroom.
实际的好处是,只有在前面的诊断表明确实有必要时,你才会花时间做这些环境准备工作。
第 3 步:构建最小可运行原型
现在从环境就绪转向应用程序的启动。
/deepstream-import-vision-model Help me access the following directory on Jetson: /home/seeed/workspace/traffic_monitor
Deploy a vehicle speed detection system under this directory. Use the top_view.mp4 file in this directory for testing.
下面是本演练中使用的样例俯视交通视频:
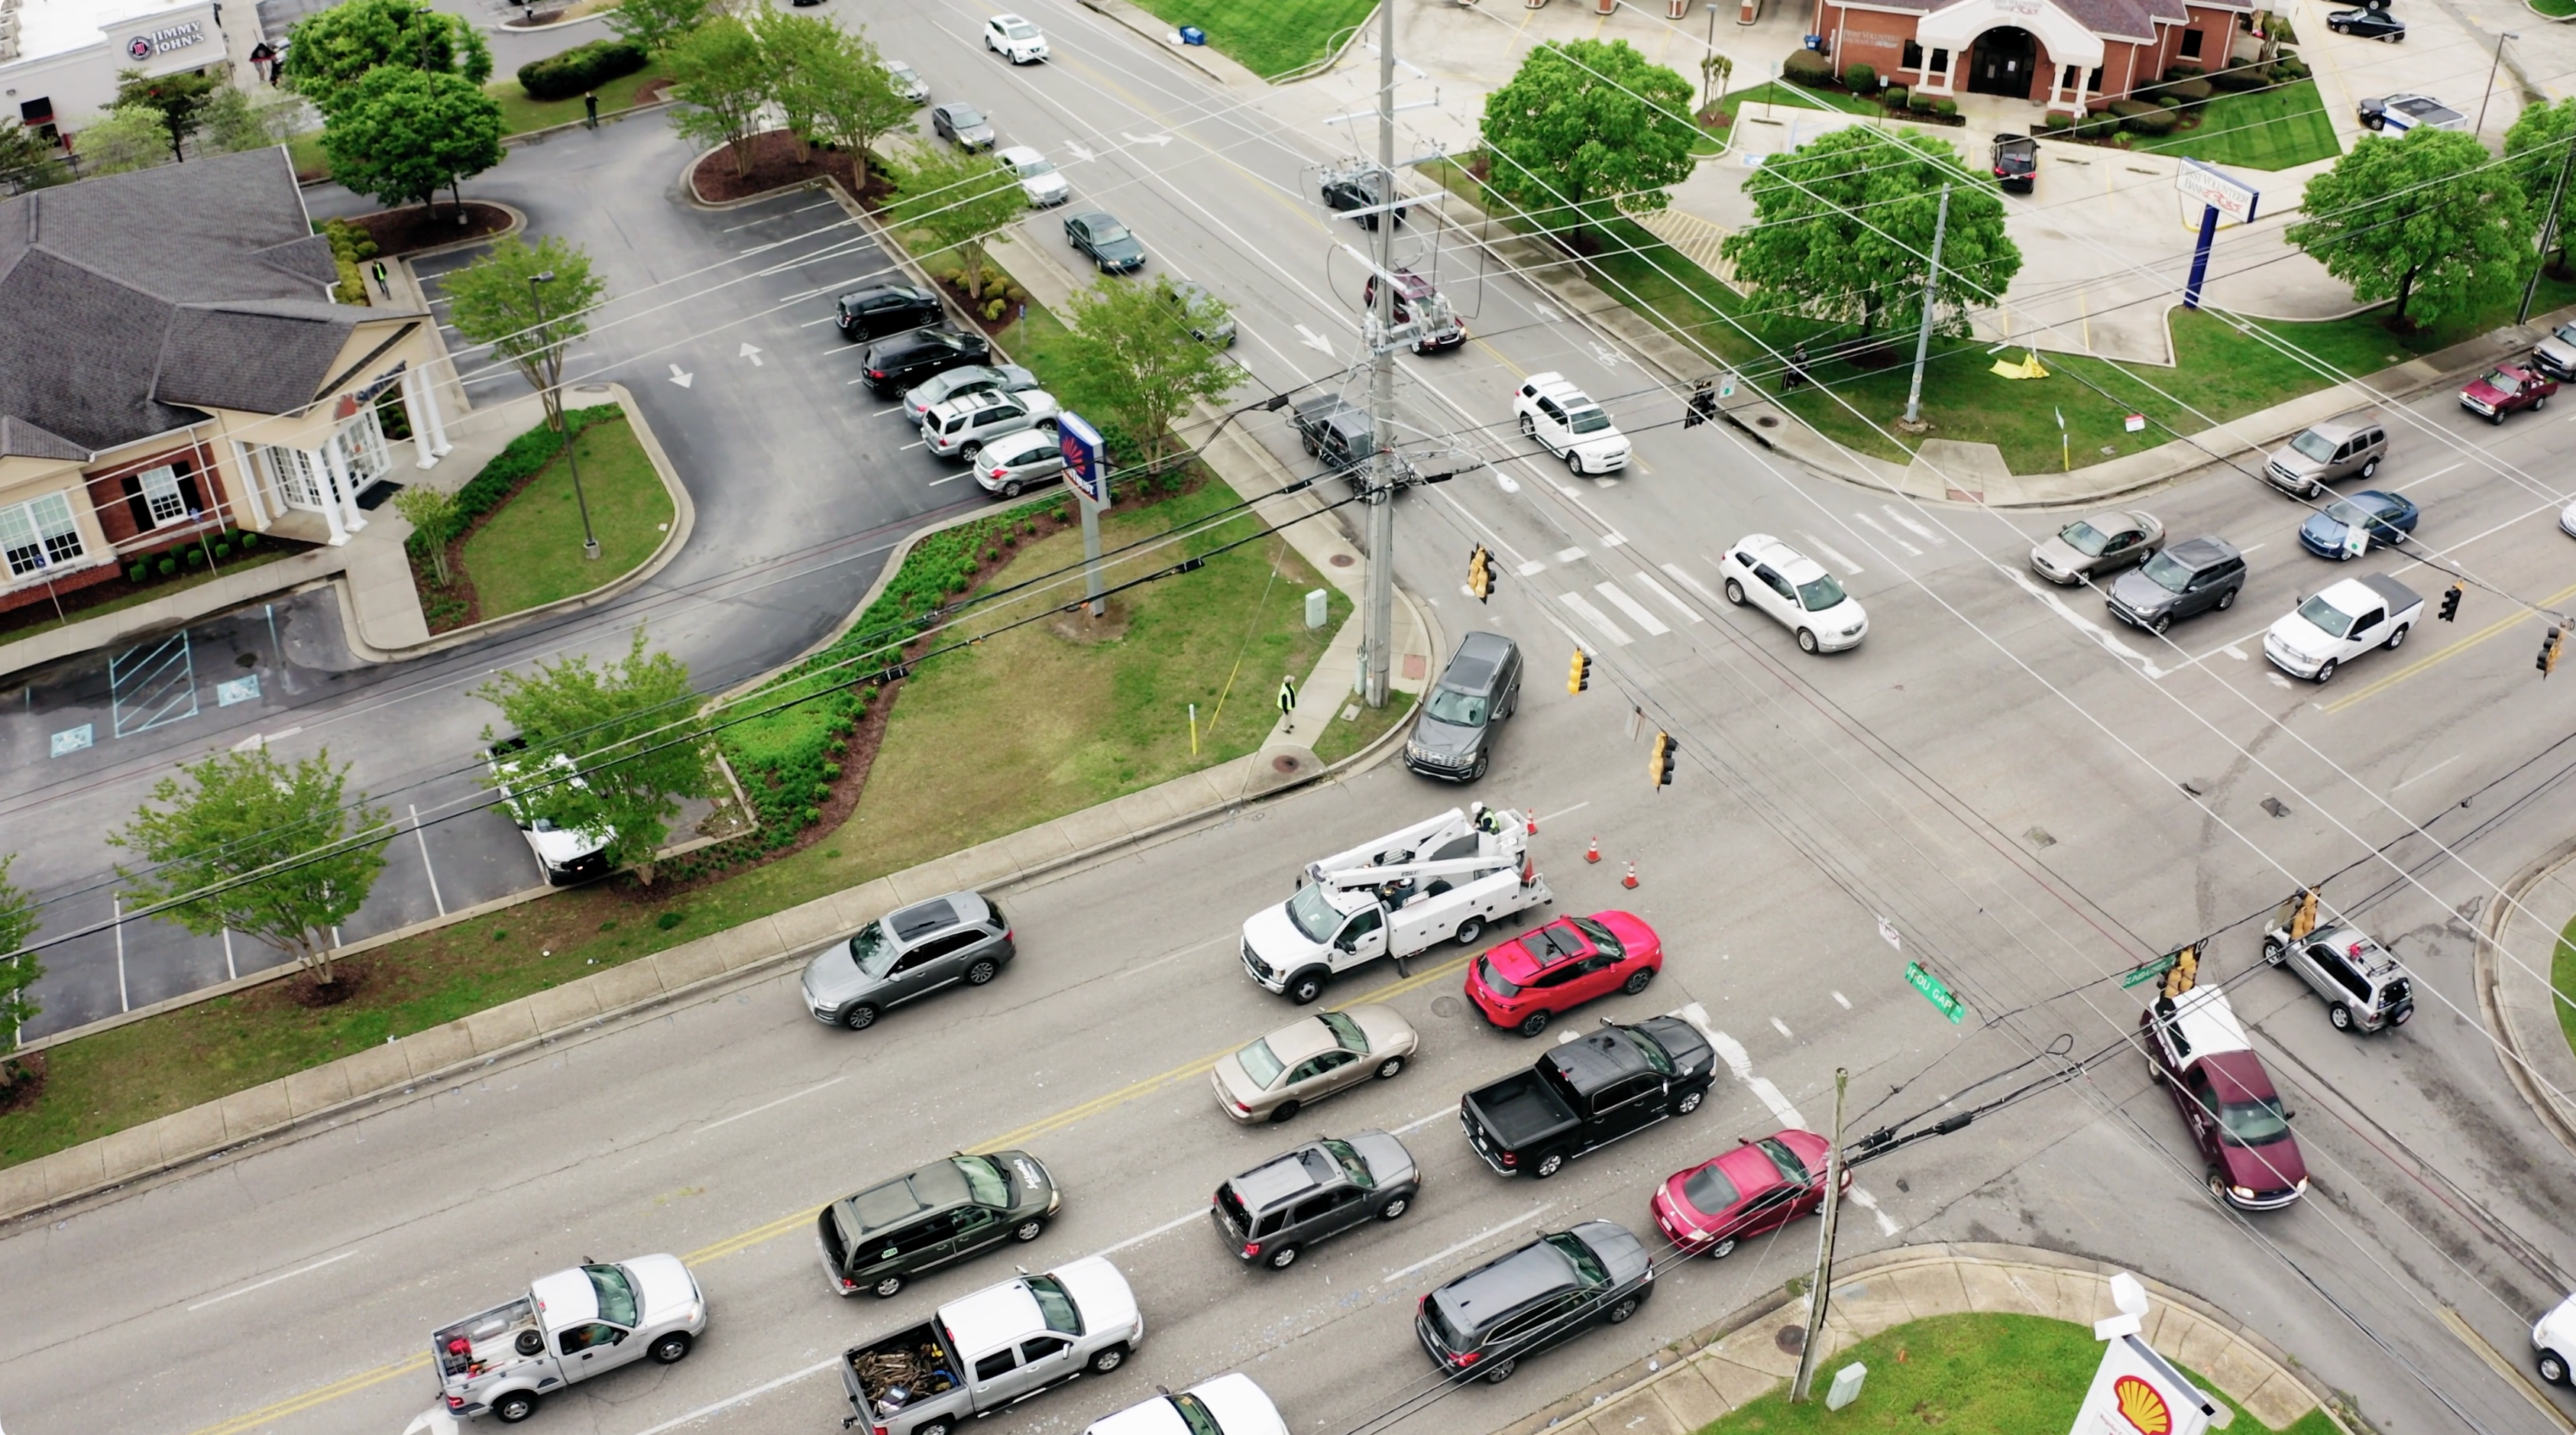
代理可能会根据设备上已有的内容选择不同的实现路径。在这个阶段,重要的不是它是否选择了最终的生产技术栈,而是它是否产出了一个可运行的首版,并且结果是可检查的。
在这一步结束时,你希望拥有一个主推理脚本或应用入口点、一条清晰的重新运行路径、一个带标注的输出视频或类似的工件,以及放置在已知工作区中的生成文件。如果这些部分都已经存在,即使最终技术栈仍有调整空间,这个基线也已经是有价值的。
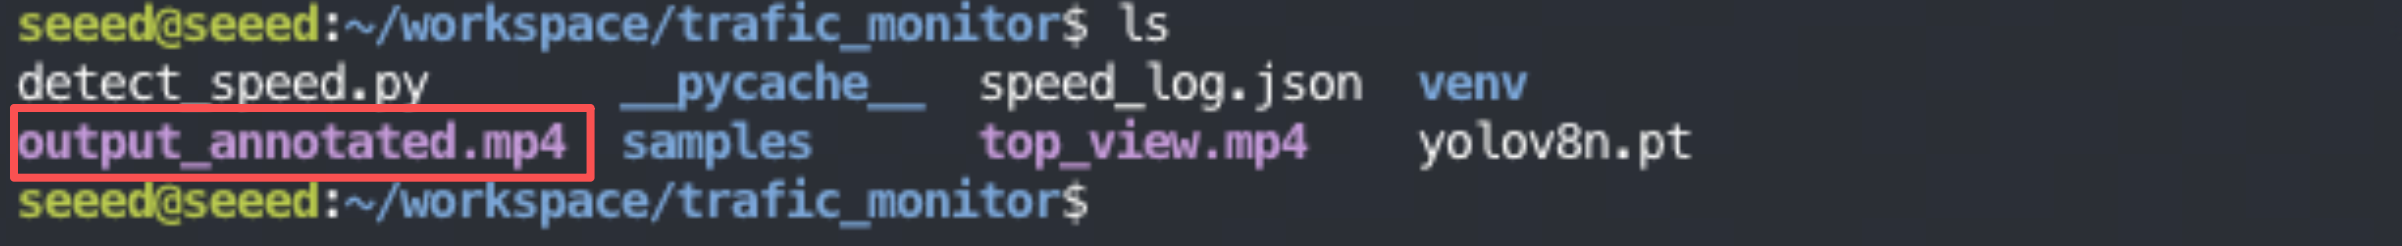
这就是工作流开始发挥价值的地方。你不再需要在第一轮就手动连接脚本和路径,而是可以评估一个可运行的基线,并决定哪些部分值得投入更深入的工程工作。
第 4 步:验证输出并检查架构
一旦首版已经存在,就让代理解释它创建了什么,以及如何再次运行。
Please explain the generated files, the rerun command, the output locations, the current bottlenecks, and the technical approach and architecture you are using.
此时,有用的问题不再是“有没有东西跑起来?”而是“到底创建了什么、我该如何再次运行、输出在哪里、以及代理在架构上做了哪些选择?”一个好的后续说明应该让你清楚了解文件布局、重新运行路径、输出位置、检测和速度估计的方法,以及可能的性能瓶颈。
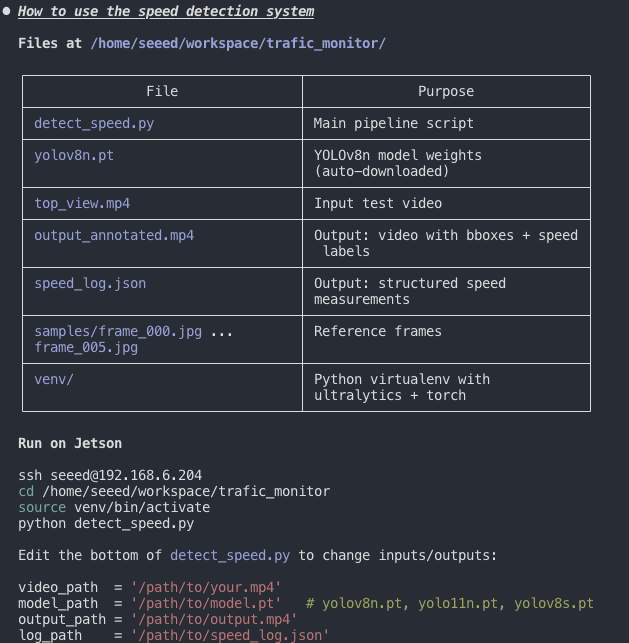
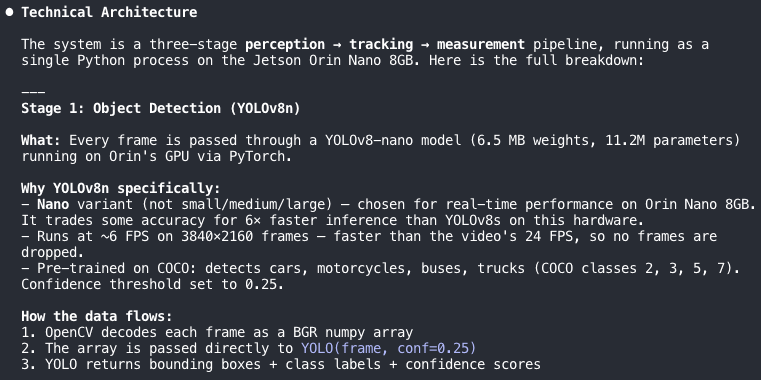
这可以节省时间,因为代理不仅在生成代码,还在缩短理解和评估其刚刚产出的基线所需的时间。
第 5 步:将原型打包成可分享的形式
一旦算法可以从命令行运行,下一个缺口通常就是演示能力。
Help me create a web UI that I can access from my local PC to upload videos for detection and continuously loop the output video.
代理可以将原型封装成一个小型 Web 服务或类似接口,这样队友或客户就可以在不接触命令行的情况下进行试用。
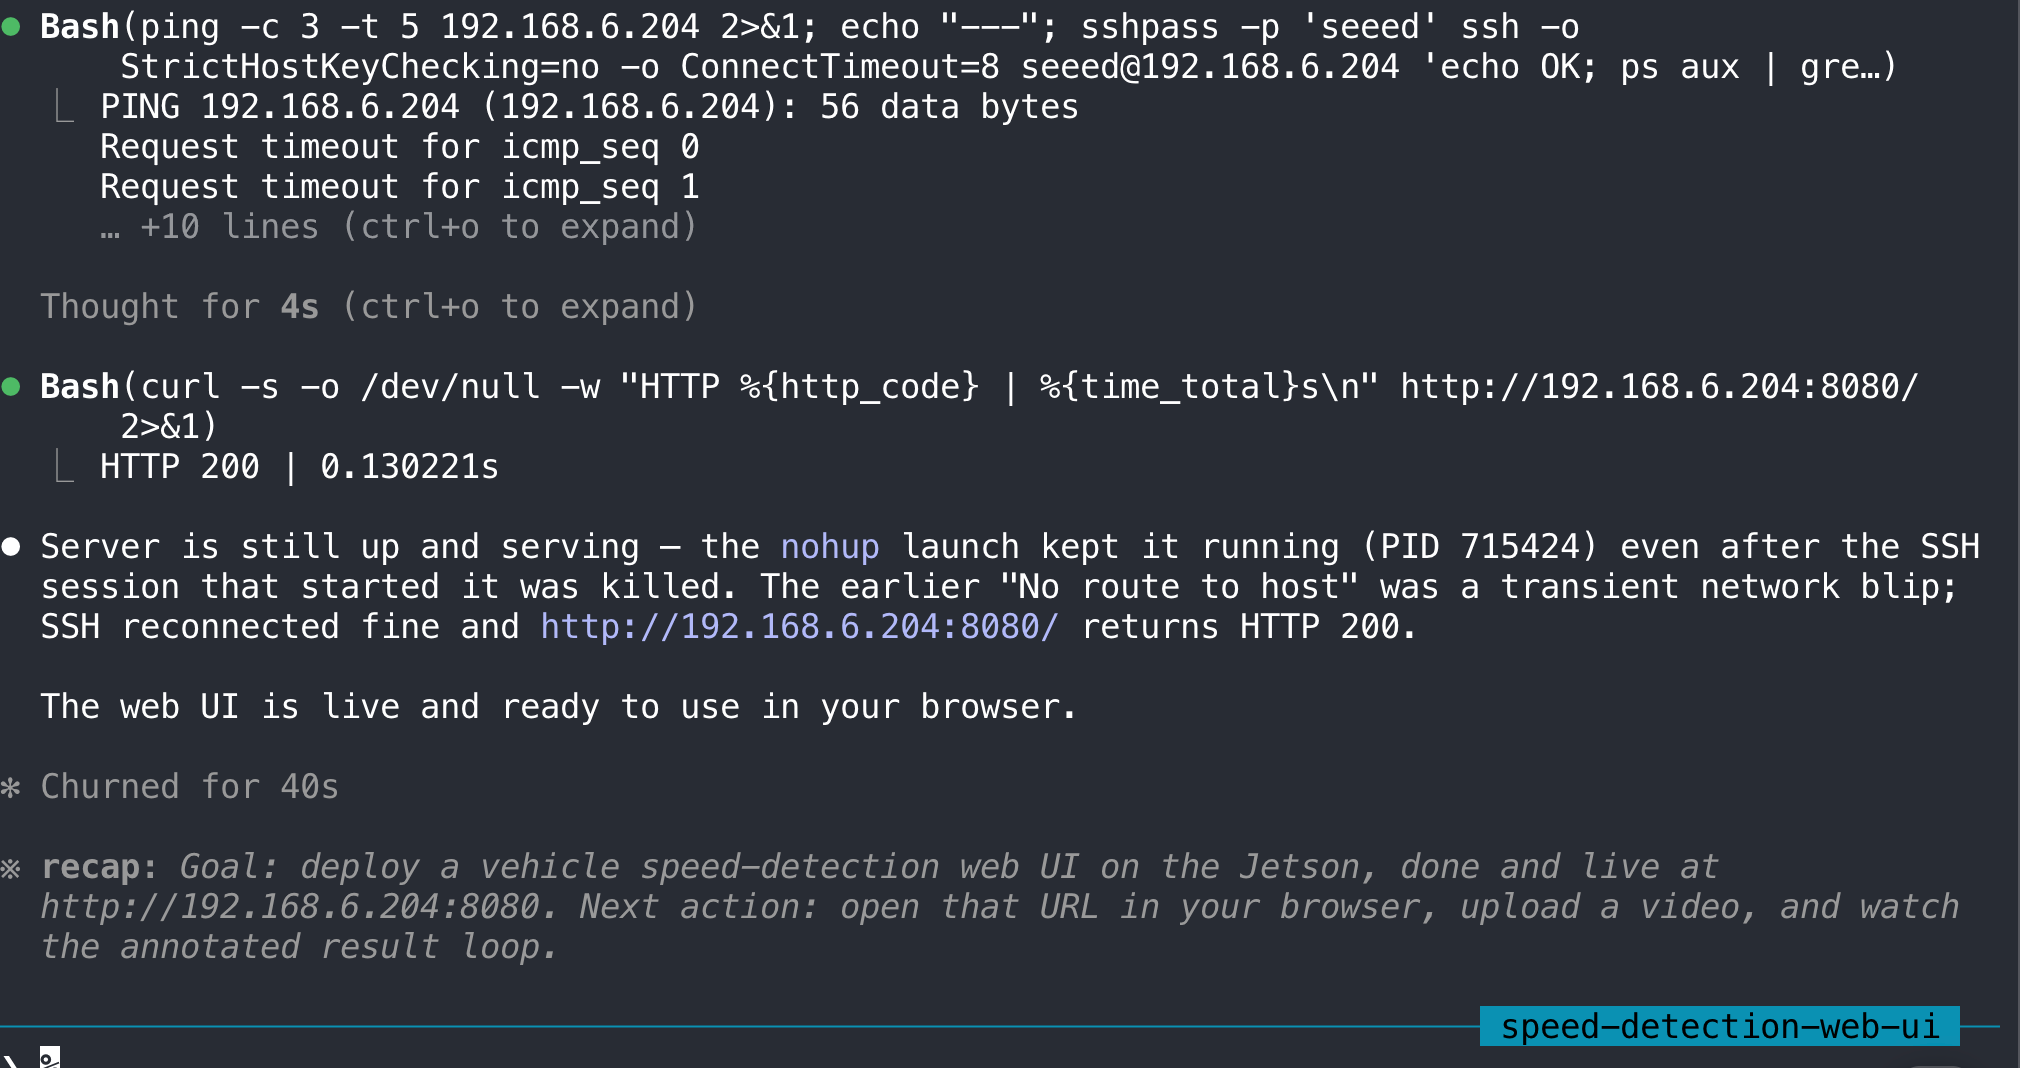
要从本地 PC 访问 UI,请确保所选端口在 Jetson 上是可访问的,并且两台机器处于同一网络,或者使用 SSH 端口转发。在判断推理速度时,请以本地 Jetson 端的运行时为参考点,因为转发的 Web UI 可能会因为网络延迟而显得更慢,而不仅仅是模型性能的原因。
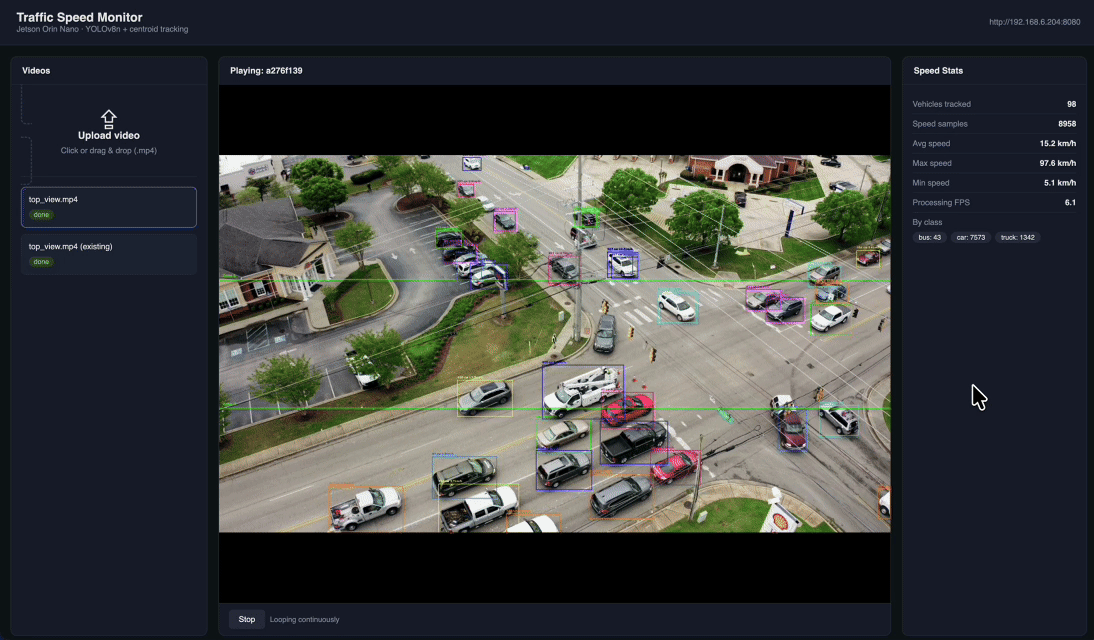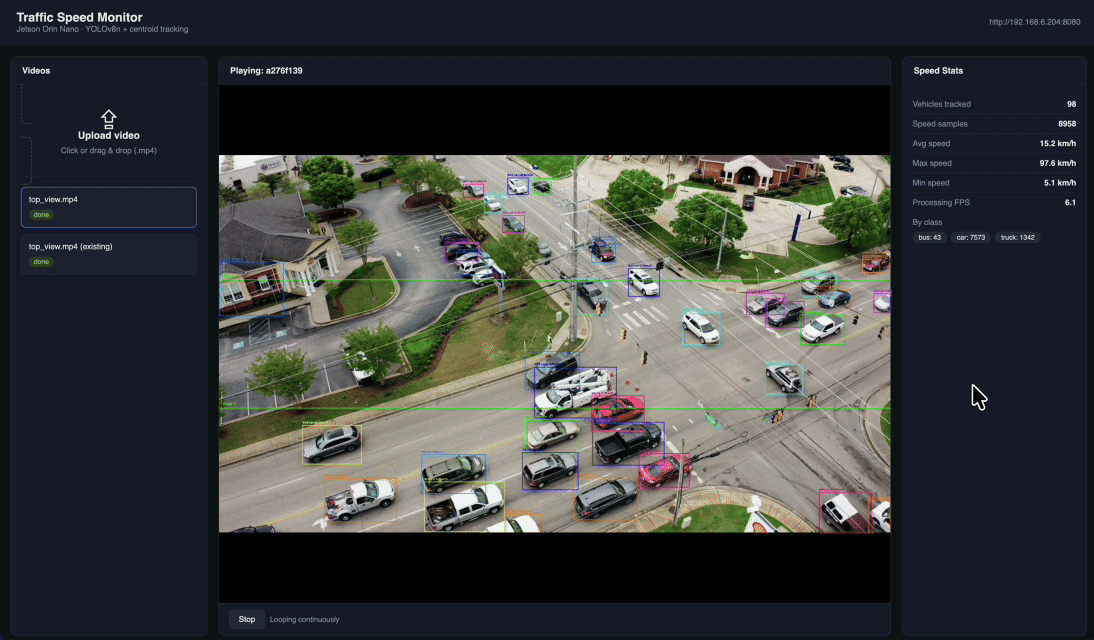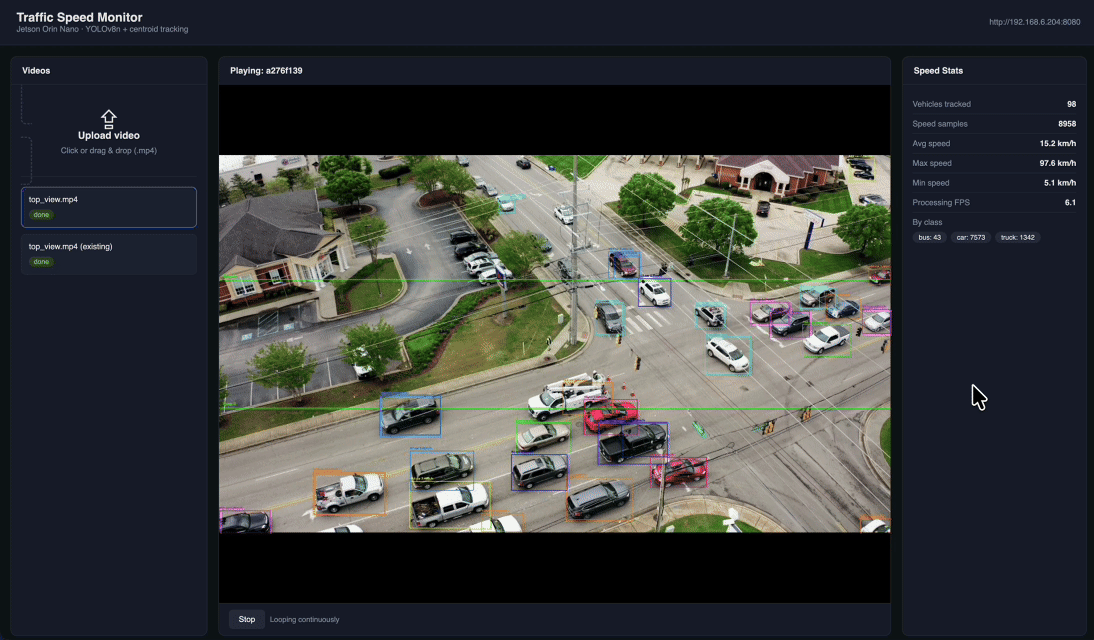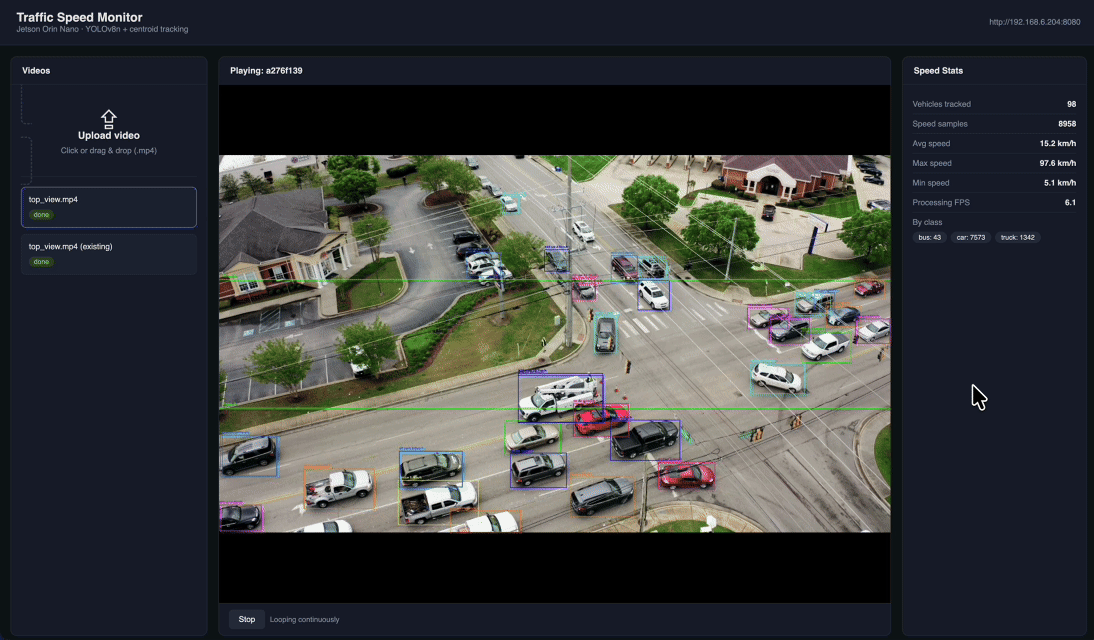
这也是该工作流在实践中有用的另一个原因:创建原型的同一套流程,也可以弥合从后端概念验证到可演示打包之间的鸿沟。
常见失败模式及后续措施
当你用它在正确的时间减少正确的不确定性时,这个工作流最为有用。
| 问题 | 通常意味着什么 | 应该怎么做 |
|---|---|---|
| 安装路径看起来很通用,或者在 ARM 上出错 | 正在忽略 Jetson 兼容性 | 使用 jetson-package |
| 模型加载失败或推理不稳定 | 内存压力是首要瓶颈 | 使用 jetson-memory-audit |
| 设备在桌面服务上浪费了太多内存 | Jetson 更适合作为一台专用设备来对待 | 使用 jetson-headless-mode |
| 原型可以运行但太慢 | 基线是有效的,但尚未优化 | 让代理识别瓶颈并推荐 DeepStream 或 TensorRT |
| 演示只能以终端形式运行 | 工程基线已经存在,但不可分享 | 让代理打包一个 Web UI 或服务封装 |
从原型到生产
这个工作流在探索、启动和验证阶段最为强大。一旦基线得到验证,下一步通常就是手动加固。
典型的生产化动作都很熟悉:用更结构化的 DeepStream 流水线替换原型逻辑,将模型转换为 TensorRT 以获得更高吞吐量,提高跟踪鲁棒性和标定质量,把临时脚本变成可维护的服务或应用,并为真实系统补充所需的监控和部署规范。关键点很简单:使用 skills 压缩通往可信基线的路径,然后有计划地进行加固。
可复用提示模板
下面的提示序列是新 Jetson 项目的一个不错的起始模板:
1. Diagnose this Jetson and list any blockers for running a vision prototype.
2. Recommend the correct Jetson-compatible dependency path.
3. Build the smallest runnable prototype in /path/to/workspace using /path/to/test-asset.
4. Explain the generated files, rerun command, and expected outputs.
5. Measure the current bottleneck and recommend whether to stay in Python or move to DeepStream/TensorRT next.
6. Package the prototype into a simple demo interface if the baseline is validated.
你可以将此模板改编用于目标检测、视频分析、机器人感知或其他在 Jetson 端进行应用启用的工作。
总结
这里的主要收获并不是某个特定智能体可以构建一个车辆速度检测演示。更有价值的收获是:当你把技能视为一个结构化工作流时,Jetson 应用交付会变得快得多:先诊断设备,只在需要的地方做准备,生成最小可运行原型,验证输出和瓶颈,然后将结果打包以便分享。这才是可重复的模式,车辆测速示例只是其中的一个实例。
参考资料
- NVIDIA/skills (GitHub) — 来自 NVIDIA 的通用智能体技能
- NVIDIA-AI-IOT/jetson-device-skills (GitHub) — Jetson 专用技能
- Claude Code documentation — 安装和使用 Claude Code
- Traffic Management DeepStream SDK — 更偏向 DeepStream 的手动路径
- Deploy YOLOv8 with TensorRT and DeepStream SDK — 更偏向模型部署的手动路径
- DevelopTool Skills module — Seeed DevelopTool 的 "Skills" 自动化模块
相关资源
技术支持与产品讨论
感谢您选择我们的产品!我们将为您提供多种支持,确保您在使用我们产品的过程中尽可能顺畅。我们提供多种沟通渠道,以满足不同的偏好和需求。