ACT:低成本双臂精细操作
Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware
- 模仿学习
- ALOHA
- 动作分块
- 时间集成
先验知识
什么是模仿学习
-
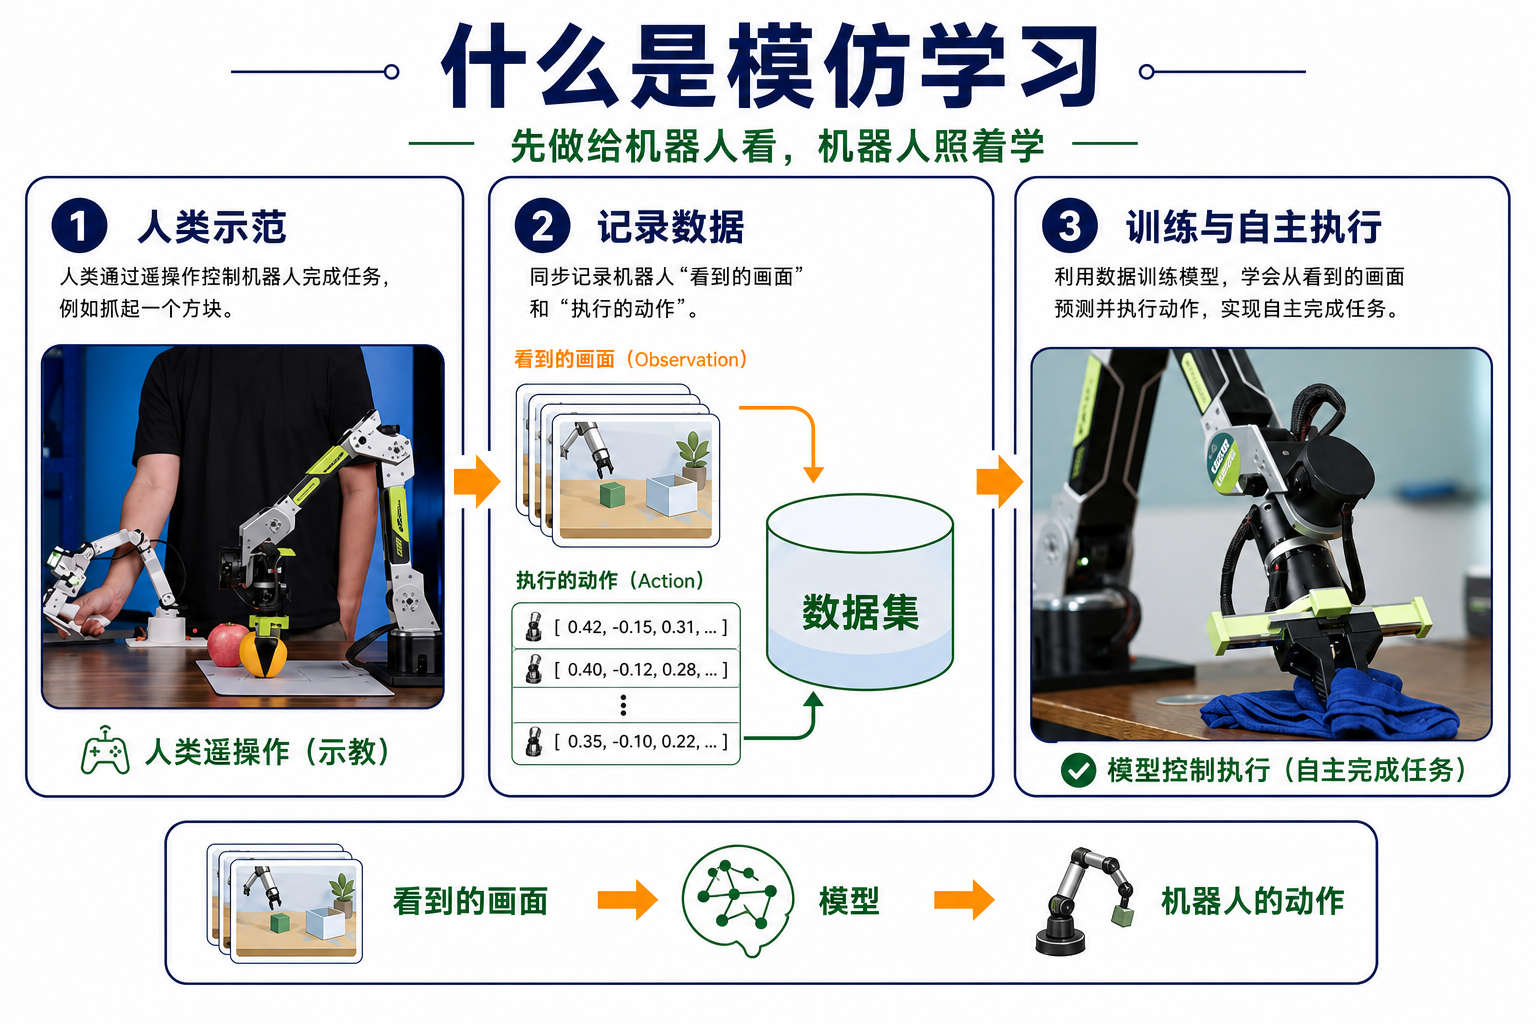
模仿学习的思想朴素到一句话就能说完:先做给机器人看,机器人照着学。
- 在模仿学习中,人类操作者通过遥操作(Teleoperation)控制机械臂完成任务,系统同时记录"看到的画面"和"执行的动作"。这些数据被用来训练一个模型,训练完成后,模型就能在没有人类操作的情况下,自己看着画面做出动作。
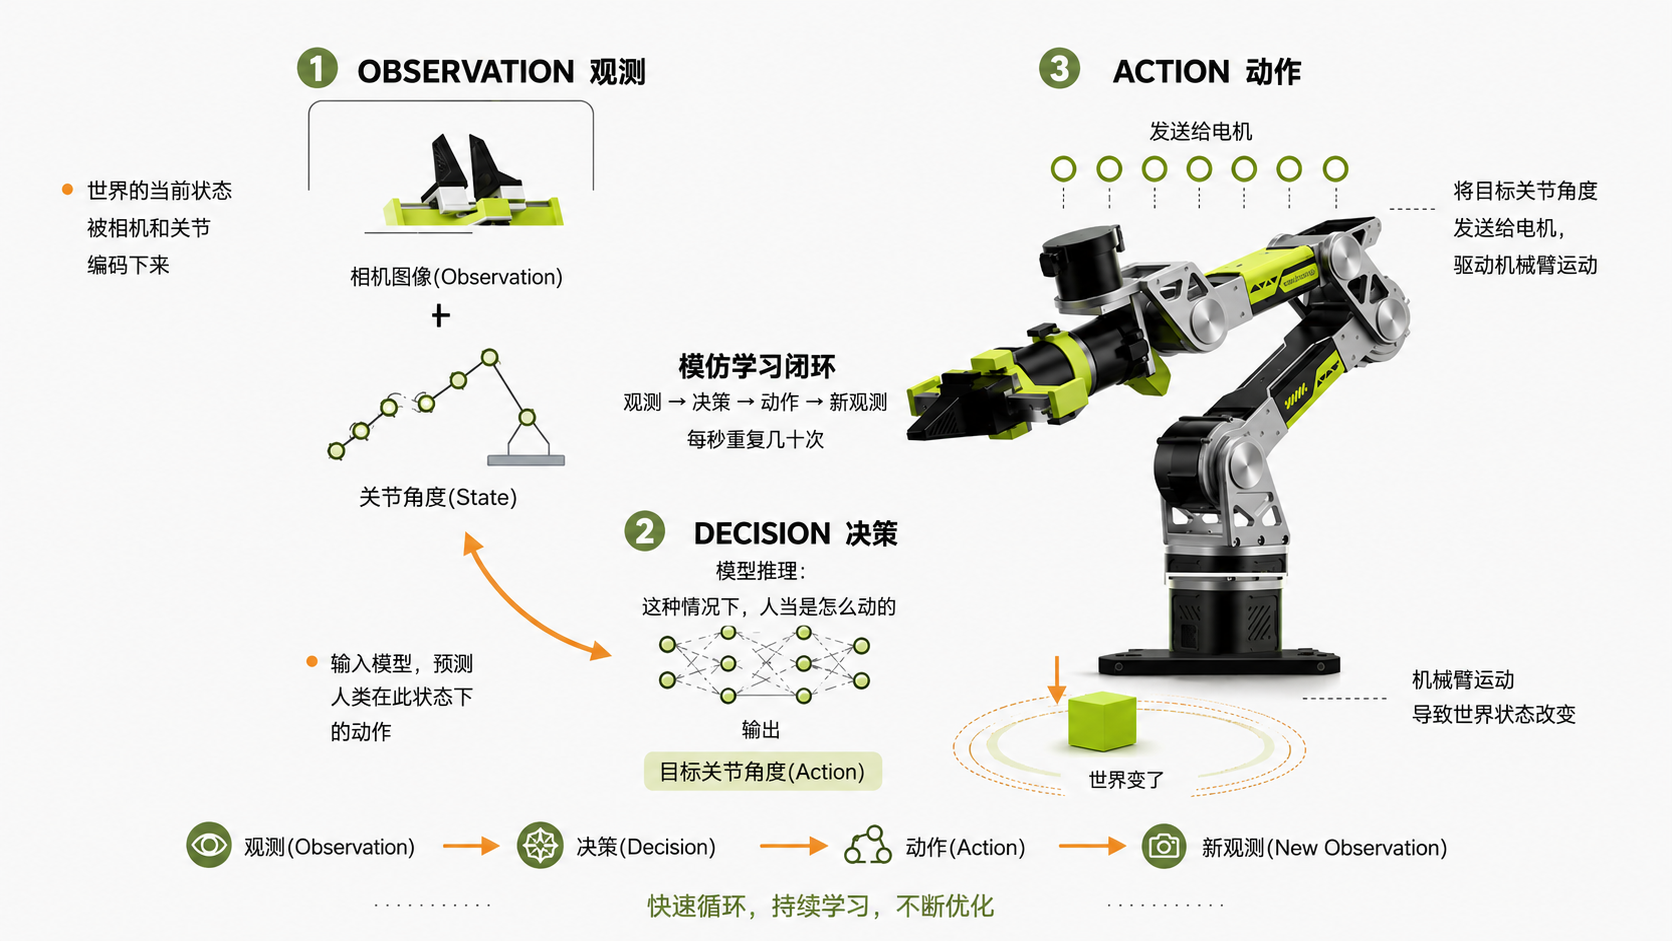
Observation(观测):机器人"看到"的世界
-
Observation 是机器人通过传感器获得的关于外部环境的信息。你可以把它理解为机器人的"眼睛"。它告诉机器人世界现在是什么样子,对 reBot Arm 来说也就是:
-
前置相机(俯拍)看到的全局画面:桌面上有什么物体、在哪个位置;
-
腕部相机(装在机械臂末端)看到的近距离画面:夹爪和目标之间的相对关系。
-
State(状态):机器人"自己"的样子
-
State 是机器人对自身状态的描述,和外部环境无关。这相当于人类的本体感觉——你闭上眼睛也知道自己的手在哪、胳膊弯了多少度,State 告诉机器人自己现在是什么姿态,对 reBot Arm 来说,State 就是:
-
6 个关节当前的角度;
-
夹爪当前的开合程度。
-
Action(动作):机器人"要做"的事
-
Action 是模型输出的、发给机械臂的执行指令。注意一个关键细节:在 reBot Arm 上,State 和 Action 的维度是一样多的(都是 6 个关节 + 1 个夹爪)。State 是"现在在哪儿",Action 是"下一步要去哪儿"。:
-
6 个关节的目标角度;
-
夹爪的目标开合程度。
-
单步动作与 Action Chunk
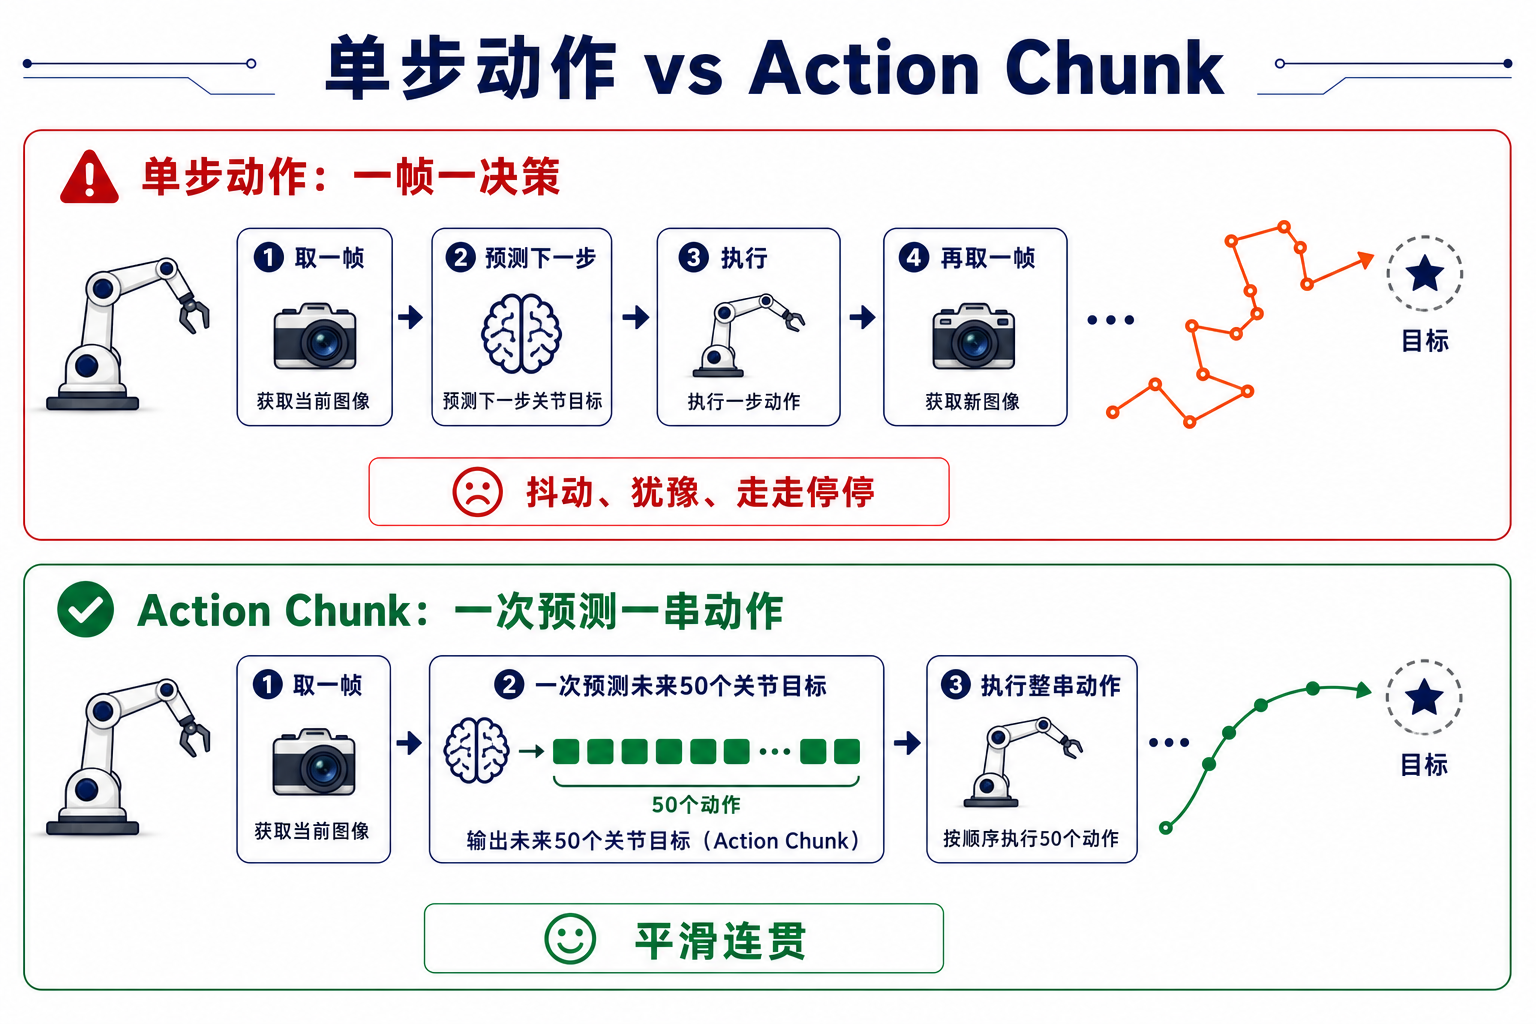
单步动作:一帧一决策
-
每一帧画面,模型预测下一个瞬间的关节目标,机械臂执行,然后取下一帧再预测。
- 单步动作有一个明显的缺陷。模型每一步都可能有一点点偏差,而每一步的偏差都会改变机械臂的位置,让下一帧的画面偏离训练数据见过的分布,导致下一步偏差更大。反映在机械臂上,就是动作抖动、犹豫、走走停停——就像一个人每走半步就停下来重新想一次"我接下来该迈哪条腿"。
Action Chunk:一次预测一串动作
-
让模型一次预测未来一小段时间内的一连串动作(比如未来 1 秒内的 50 个关节目标),而不是只预测下一步。
-
推理频率要求降低。 一次推理管一小段时间,即使模型推理稍慢(比如用没有顶级显卡的电脑),机械臂也能流畅运动。这对真机部署非常关键。
-
任务有"记性"。 一次预测未来一段动作,模型必须"想清楚"接下来要干什么,这让它更不容易被瞬时干扰带偏。
-
动作更平滑连贯。
-
当然,Action Chunk 也不是越长越好。预测得太远,环境可能在中途发生变化(比如物体被碰了一下),而机械臂还在执行"过时"的动作。实际系统会采用开环执行一小段、然后重新观测再预测的折中方案。
训练、推理和评估:模仿学习的三个阶段
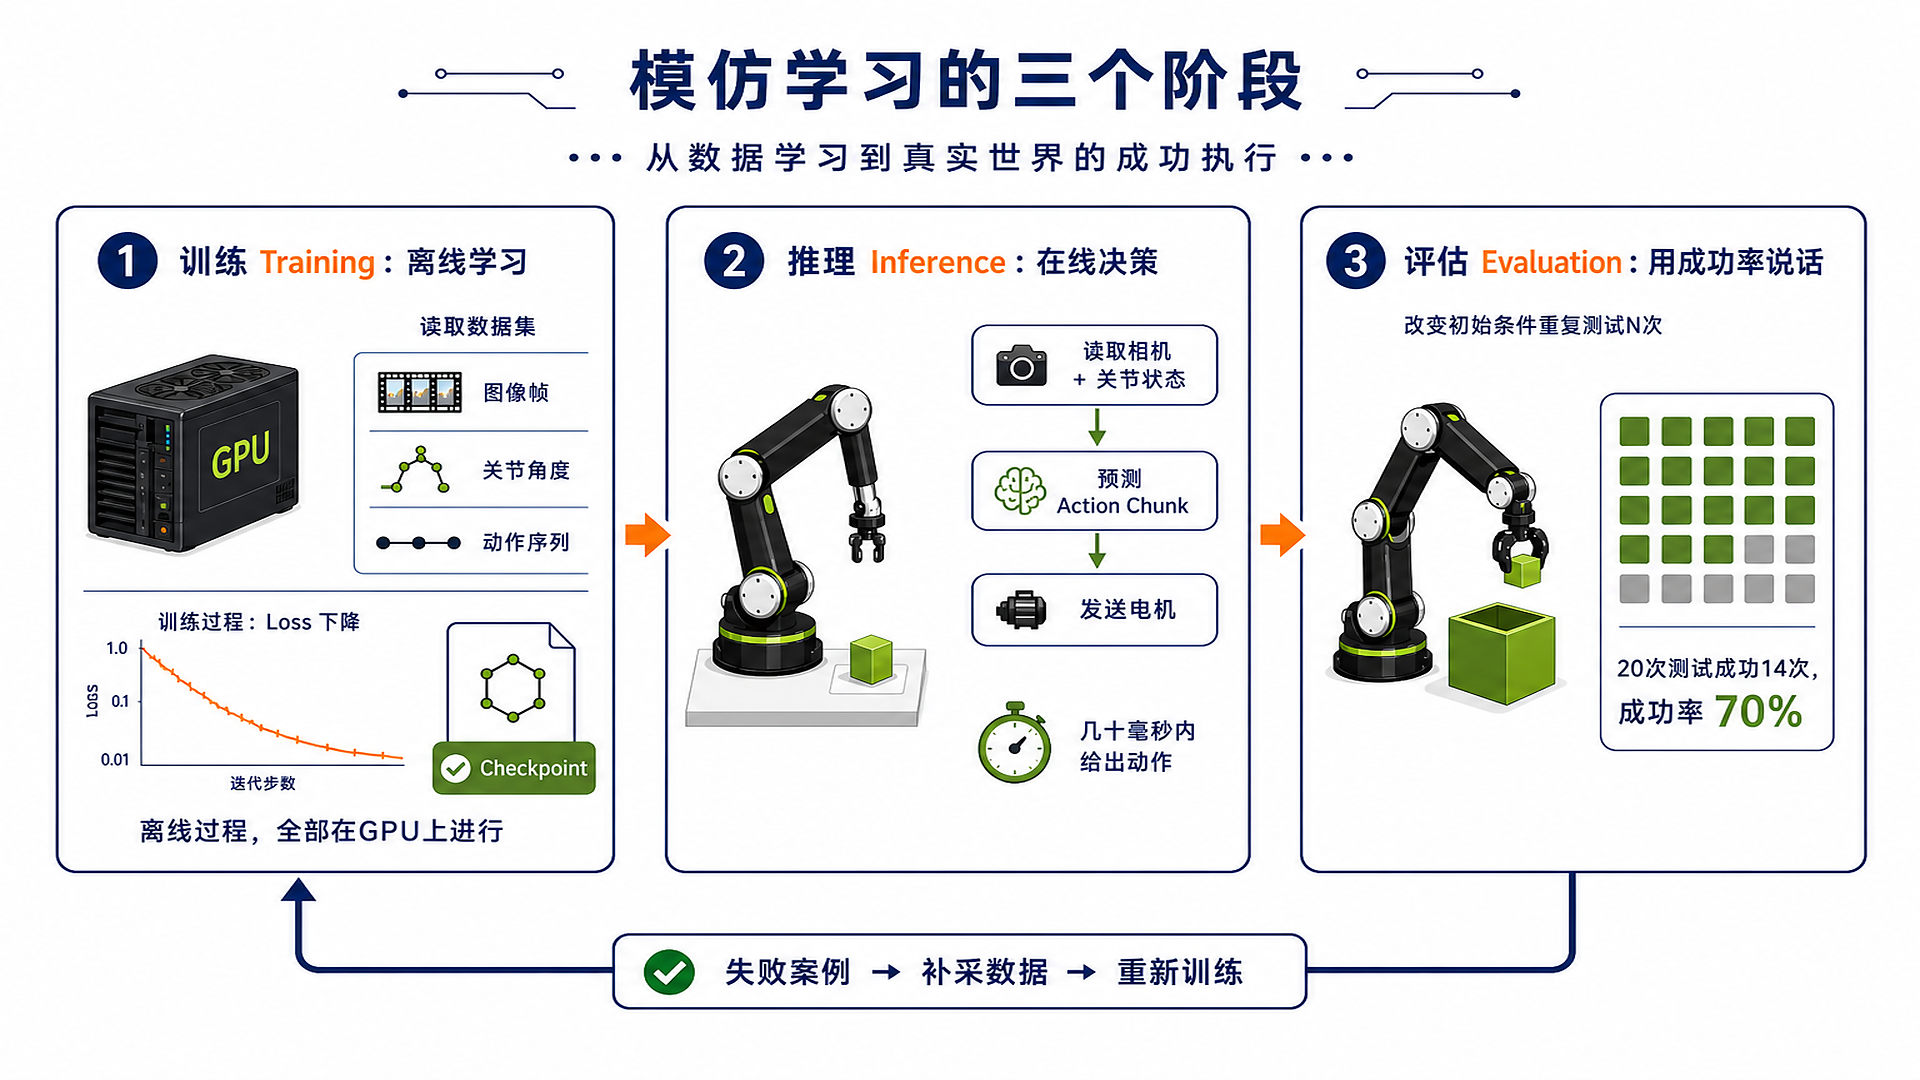
训练:离线学习
训练发生在数据采集完成之后,是一个离线过程:机械臂可以断电放在一边,全部工作在 GPU 上进行。
-
输入:采集好的数据集(图像、State、Action 的时间序列);
-
过程:模型反复读取数据,不断调整内部参数,让自己预测的 Action 越来越接近人类的示范;
-
输出:一个训练好的模型文件。
训练的好坏主要通过 Loss(损失值) 观察:Loss 下降,说明模型预测的动作和人类示范越来越像。
推理:在线决策
- 推理是模型部署上真机、实时工作的过程,也就是:读取相机和关节状态 → 模型预测 Action Chunk → 发送给电机执行。推理对实时性有要求——模型必须在几十毫秒内给出动作,否则机械臂会卡顿。
评估:用成功率说话
模型训练好了,Loss 也很低,它能干活吗?不一定。Loss 低只说明模型"像人",不说明它"能完成任务"。 评估的唯一可靠方法是真机测试:
-
设定明确的任务成功标准(比如"方块最终进入盒子");
-
改变初始条件(方块位置、光照),重复测试 N 次;
-
统计任务成功率,例如 20 次测试成功 14 次,成功率 70%。
评估发现的失败案例不是终点,而是下一轮数据采集的输入——哪里失败,就补采哪里的数据,然后重新训练。这就是数据迭代闭环,也是真实机器人学习项目的日常。
论文背景
作者:Tony Z. Zhao1 Vikash Kumar3 Sergey Levine2 Chelsea Finn1 1 Stanford University 2 UC Berkeley 3 Meta
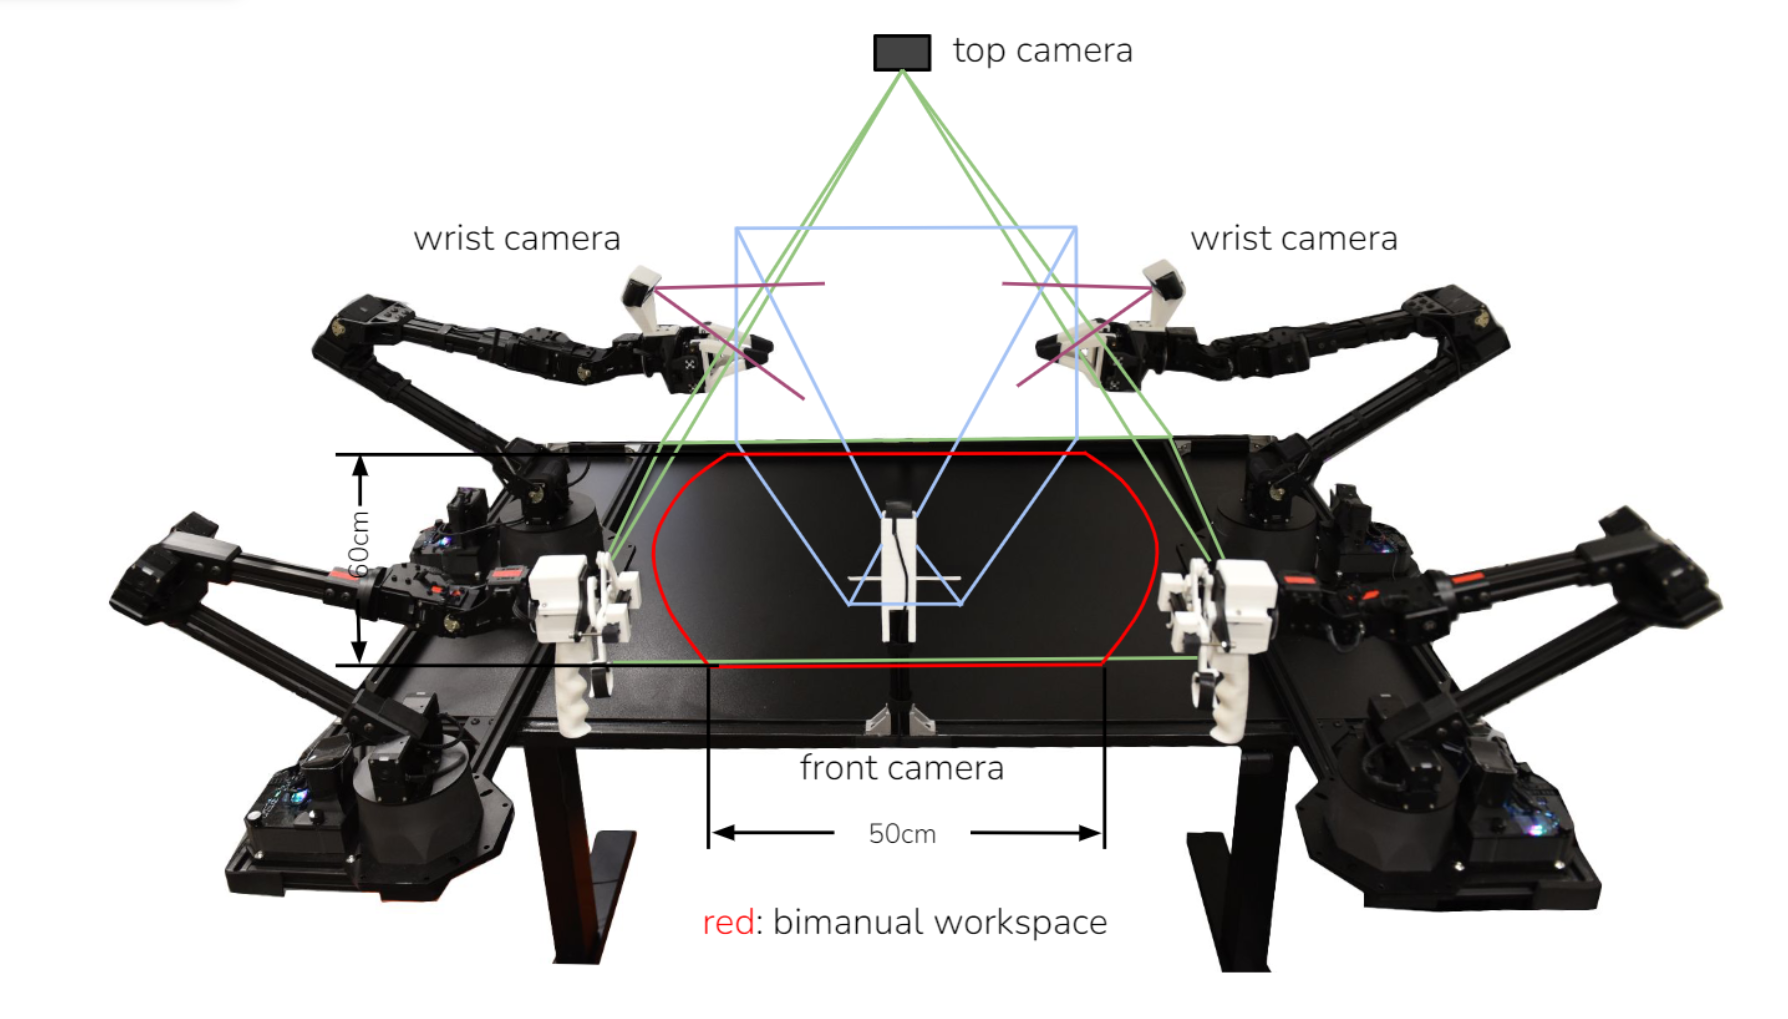
论文背景: 这是一篇2023年发布的,来自斯坦福和伯克利团队联合研究的基于卷积+Transformer的模仿学习轻量化算法。作者所使用的硬件是6自由度ALOHA双臂遥操作配合2个夹爪末端的单目相机和顶部全局的单目相机作为实验平台。
摘要
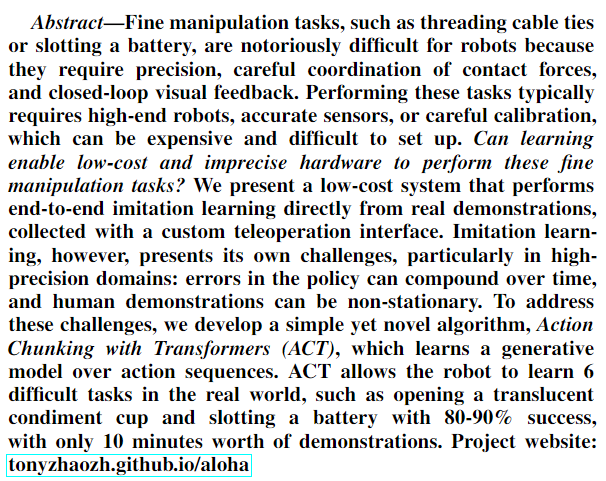
- 翻译:
精细操作任务,例如穿束线带或安放电池,对机器人而言素来难度极高。这类任务需要高精度、接触力的精细协同以及闭环视觉反馈。完成此类任务通常需要高端机器人、高精度传感器或是精细校准,成本高昂且部署调试难度大。能否借助学习算法,让低成本、精度有限的硬件完成这类精细操作任务?
本文提出一套低成本系统,可通过定制化遥操作界面采集真实演示数据,直接开展端到端模仿学习。但模仿学习本身也存在诸多难题,尤其在高精度任务场景下:策略产生的误差会随时间不断累积,人类演示样本还可能存在非平稳特性。为解决上述问题,本文设计一种简洁且新颖的算法 —— 基于 Transformer 的动作分块算法(ACT)。该算法针对动作序列学习生成式模型。借助 ACT,机器人仅需 10 分钟的演示数据,就能够在现实环境中完成 6 项高难度任务,例如打开半透明调料杯、安放电池,任务成功率可达 80%‑90%。
- 批注:
传统的模仿学习往往采用“观察当前画面 → 预测一个动作 → 执行 → 再观察”的方式。对于抓取、插拔、穿线这类精细操作来说,这种方式有一个明显问题:只要某一步出现了一点误差,机器人接下来看到的状态就会逐渐偏离训练数据中的状态,最终导致误差不断累积,也就是论文中提到的 compounding errors(误差累积)。
ACT 的核心思路就是 Action Chunking(动作分块)。相比每次只预测一个动作,它会让模型一次生成未来一段连续的动作序列。这样做可以让机器人在执行操作时具有更强的连续性,也减少了频繁进行单步预测所带来的误差积累。
熟悉大语言模型和计算机视觉的同学应该知道,Transformer 非常擅长处理“序列关系”的神经网络:它不仅关心机器人当前应该做什么,还能够学习一段动作之间的前后联系。
ACT = 让机器人一次思考并预测“一小段动作”,而不是只考虑下一步。
引言
-
第一段: 抛出现有领域的问题:作者提出了在机器人捏、撬、撕等细腻动作场景下,例如盖杯盖子、安装电池,其涉及捏取、撬动、撕扯,依靠精准闭环反馈,对手眼协调要求高,需根据环境变化调整、重新规划动作。
-
第二段: 总结现有别人的问题和自己的方法: 作者提到[Grasping with Chopsticks]、[Goal-conditioned dual-action imitation learning]等等传统策略使用的是非常昂贵的传感器和机械臂以及很仔细的系统标定才可以实现一些简单任务。而作者提出他做一套便宜、容易获得、别人也容易复现的机器人系统。通过普通摄像头 RGB 图像 → 神经网络 → 机器人动作。
-
第三段: 作者介绍自己的实验平台,只需要2w美金以内。
-
第四段:作者开始介绍 ACT,核心是解决模仿学习中的“误差累积”问题。
对于插电池、撬盖子这类需要高精度和视觉反馈的任务,即使人类提供了很好的示范,机器人每一步预测出来的动作仍然可能存在一点误差。而在精细操作中,一个很小的动作误差就可能让机器人进入和训练数据完全不同的状态,之后的预测会越来越偏,这就是 Compounding Error(误差累积)。
作者受到心理学中 Action Chunking(动作分块) 的启发:人类完成一个动作时,通常不会把每个瞬间都当成独立动作,而是会把一系列连续动作组合成一个“动作块”来执行。
传统模仿学习通常是:当前观测 → 预测下一步 Action
而 ACT 改成:当前观测 → 一次预测未来 k 个时间步的 Action
也就是说,机器人不是每次只思考“下一步怎么动”,而是一次预测接下来的一小段动作序列。这样,相当于把原本很长的任务决策过程缩短了 k 倍,从而降低误差一步步累积的影响。
Action Chunking 还有一个好处:它可以更好地处理人类示范中的一些“不规则行为”。例如人在遥操作时可能突然停顿一下,如果模型只预测单步动作,就很容易把这种停顿错误地学习成某种重要动作;而一次预测一段动作序列后,模型更容易理解动作前后的整体关系。
为了让机器人实际执行时更加平滑,作者又提出了 Temporal Ensembling(时间集成):ACT 会频繁地重新预测新的 Action Chunk,因此不同时间预测出来的动作序列之间会出现重叠。执行某一个时刻的动作时,不直接使用某一次预测,而是将多个重叠预测进行加权融合,从而减少动作抖动,让执行轨迹更加平滑。
在网络结构上,作者使用 Transformer 来建模动作序列,同时使用 Conditional VAE(CVAE) 来处理人类示范数据中的多样性。因为对于同一个任务,人并不只有唯一一种正确操作方式:不同示范的速度、轨迹甚至动作顺序都可能稍有不同。CVAE 的作用就是让模型能够学习这种“一种任务存在多种合理动作方式”的分布。
Action Chunking with Transformers,简称 ACT。
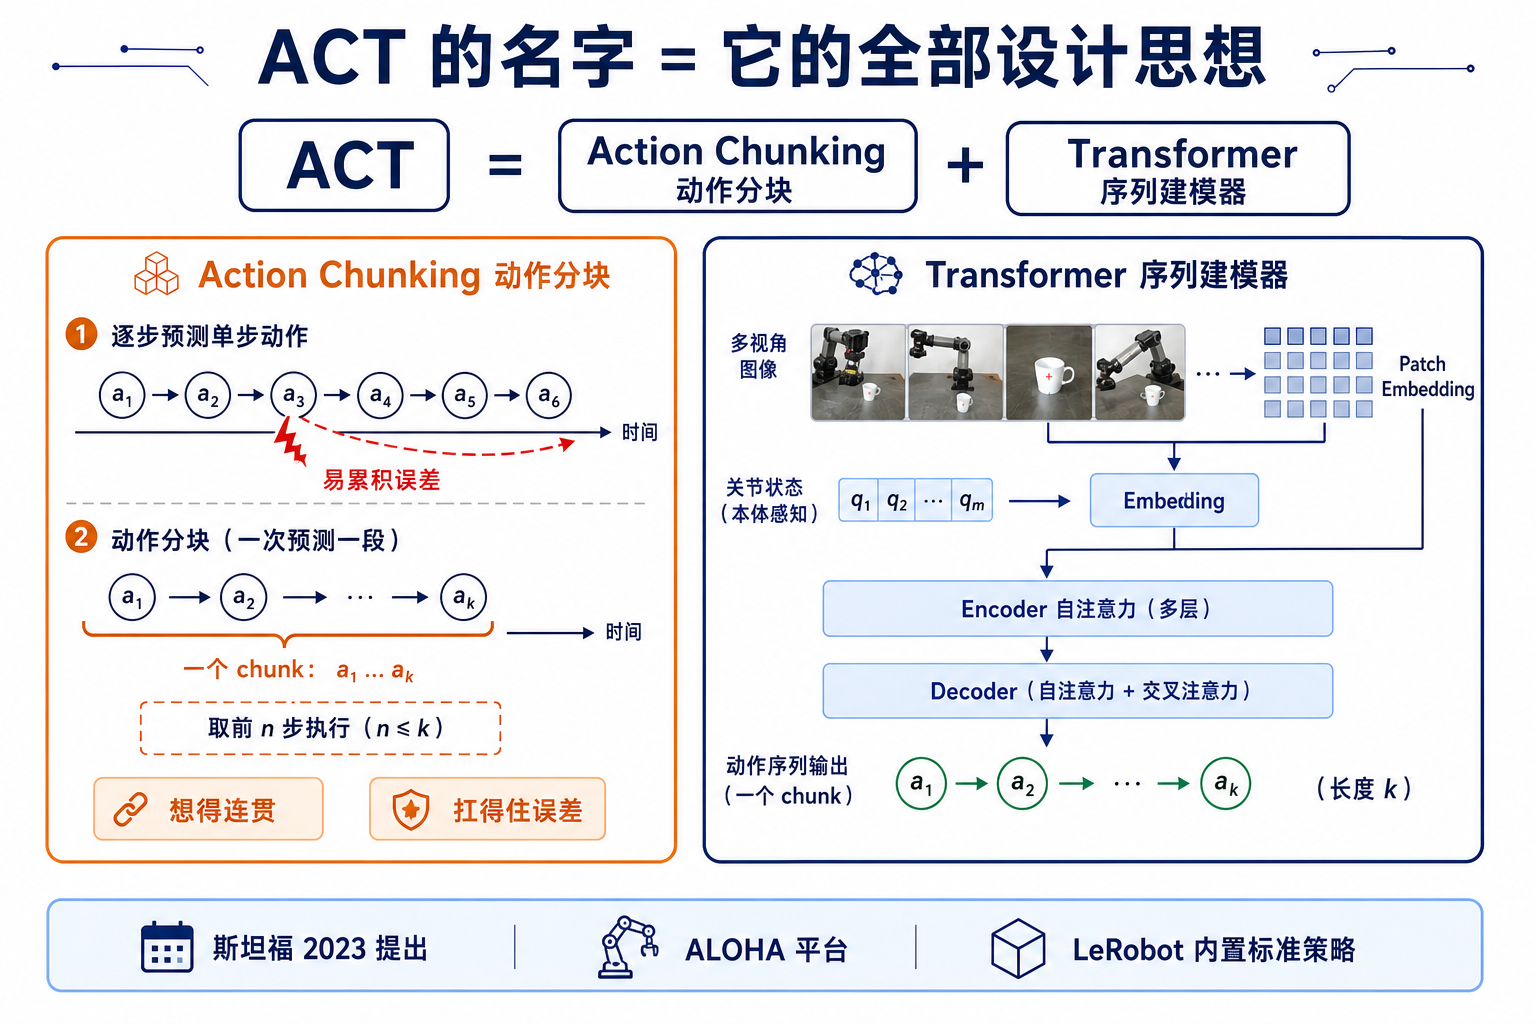
- 第五段:作者总结整篇论文的两个核心贡献——低成本遥操作平台 + ACT 模仿学习算法。
这篇论文并不是单独提出了一个神经网络,而是同时解决了机器人学习中的两个问题:
① 数据怎么来?
作者设计了一套低成本遥操作系统,让人能够直接控制机器人完成精细操作,并快速采集高质量示范数据。
② 数据有了以后,机器人怎么学?
作者提出 ACT,通过 Action Chunking、Transformer、CVAE 和 Temporal Ensembling,让机器人能够从这些示范中学习精细的闭环操作策略。也就是说,这篇论文真正重要的是 硬件系统和学习算法的结合:人类遥操作 → 采集 Demonstration → ACT 训练 → 真实机器人自主执行
最终,这套系统只使用大约 10 分钟、约 50 条人类示范轨迹,就能够让机器人学习 6 种真实世界中的精细操作任务,例如打开半透明调料杯、安装电池等,其中部分任务的成功率可以达到 80%~90%。
相关工作
这一部分作者列举了早期的各种克隆学习方案,以及他们的不足之处,有兴趣的可以读一下,不过对于本教程学习目标来说,可以跳过该部分。
ALOHA——低成本双臂遥操作系统
ALOHA 的设计目标和硬件组成
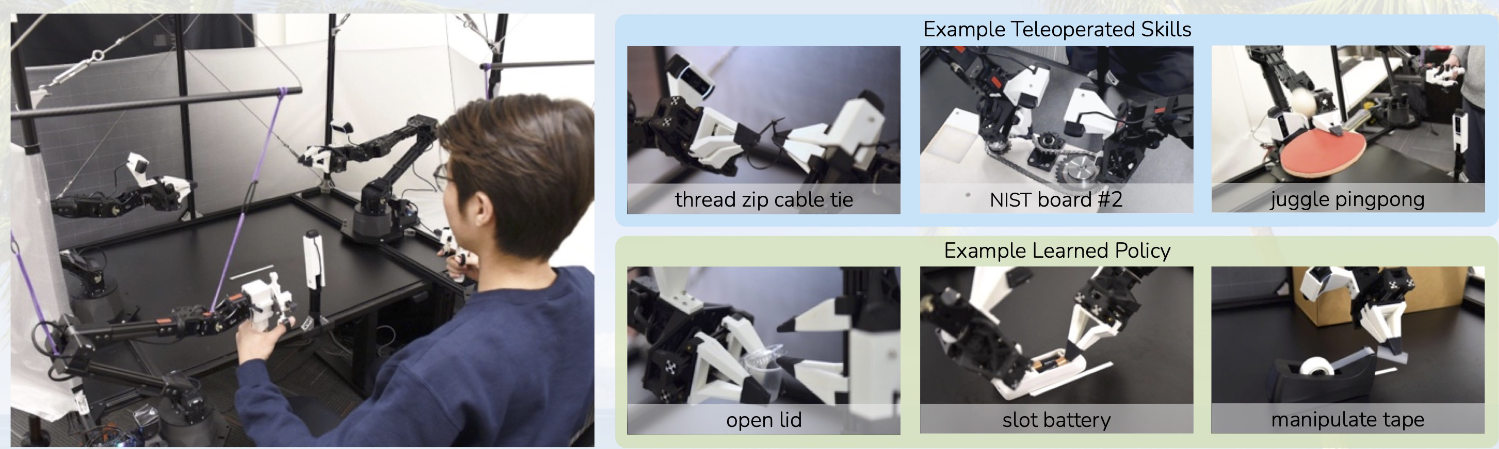
作者希望 ALOHA 不仅能完成精细操作,还要尽量降低普通实验室的复现门槛,因此提出了 5 个设计原则。
基于这些原则,ALOHA 没有选择昂贵的工业机械臂,而是使用两台 ViperX 6-DoF 机械臂作为真正执行任务的 Follower Robot。ViperX 单台价格约为 5600 美元,定位精度大约为 5~8 mm。
Leader-Follower:ALOHA 是怎么遥操作的?
ALOHA 最核心的设计之一,是使用 Leader-Follower 的方式进行遥操作。操作者直接用手推动 Leader,Follower ViperX 则跟随 Leader 的关节运动。
整体过程可以理解成:人推动 Leader → 读取 Leader 关节角度 → Follower 同步运动 → 完成任务
这里作者采用的是 Joint-space Mapping(关节空间映射)。Joint-space Mapping 有几个明显优势:
-
不需要频繁计算逆运动学;
-
接近机械臂奇异位形时更加稳定;
-
控制延迟更低;
-
人的操作能够更加直接地映射到机器人。
摄像头、数据采集和最终能力
完成遥操作以后,ALOHA 还需要把人的操作过程记录下来。作者使用了 4 个 普通 RGB 摄像头:
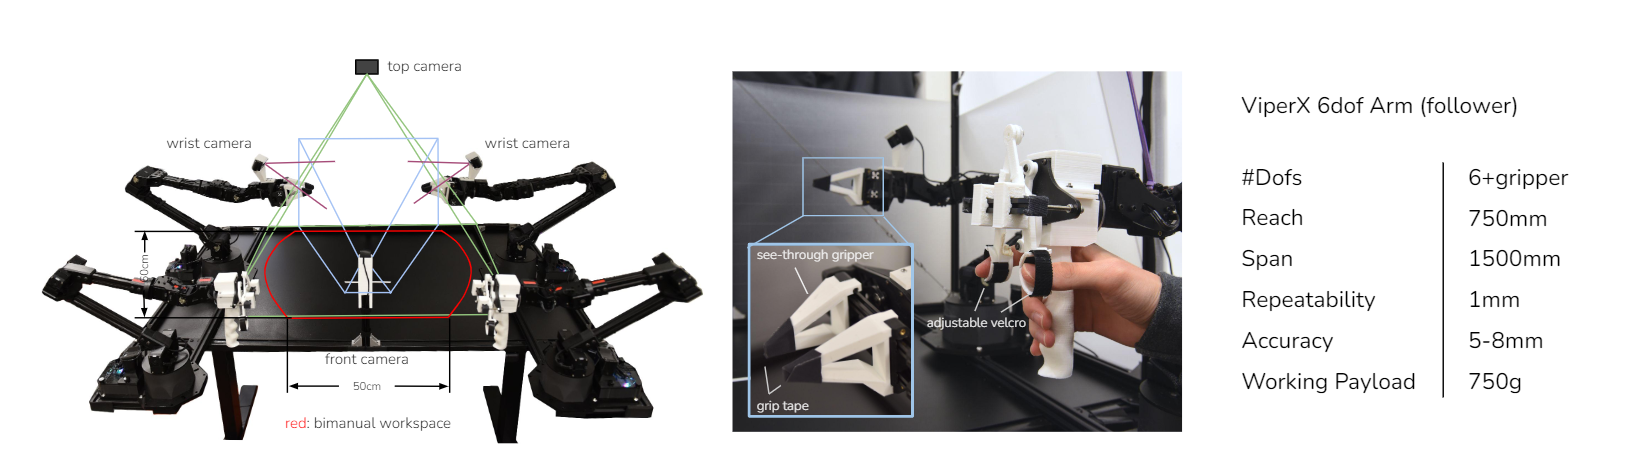
作者把这些任务大致分成三类:
动作分块(Action Chunking)与时间集成(Temporal Ensembling)
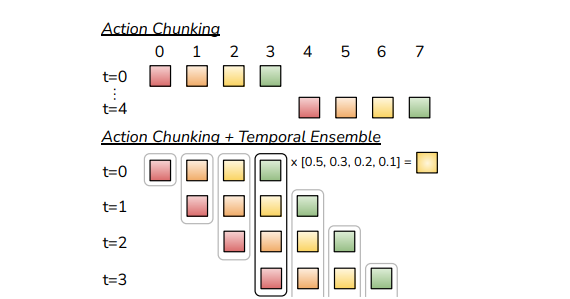
动作分块(Action Chunk):一次预测一段动作
Action Chunking(动作分块)是 ACT 最核心的思想之一。传统模仿学习通常是“看到当前状态,只预测下一步动作”,例如机器人在插电池时,每次只决定“现在往前一点”“现在往下一点”。这种单步预测的问题是:只要某一步出现一点误差,机器人下一步看到的状态就会和训练数据中的状态产生偏差,误差可能一步步累积,最后导致任务失败,这就是 Compounding Error(误差累积)。
ACT 的做法是:不再一次只预测一个动作,而是一次预测未来连续的一段动作。 假设 chunk_size = 4,普通策略是 t=0→a0,t=1→a1,t=2→a2,t=3→a3;而 ACT 会在 t=0 时直接预测 [a0,a1,a2,a3]。这一串连续动作就叫一个 Action Chunk(动作块)。用公式表示,就是从只预测当前动作的 πθ(at|st),变成预测未来一段动作的 πθ(at:t+k|st),其中 k 就是 Action Chunk 的长度。
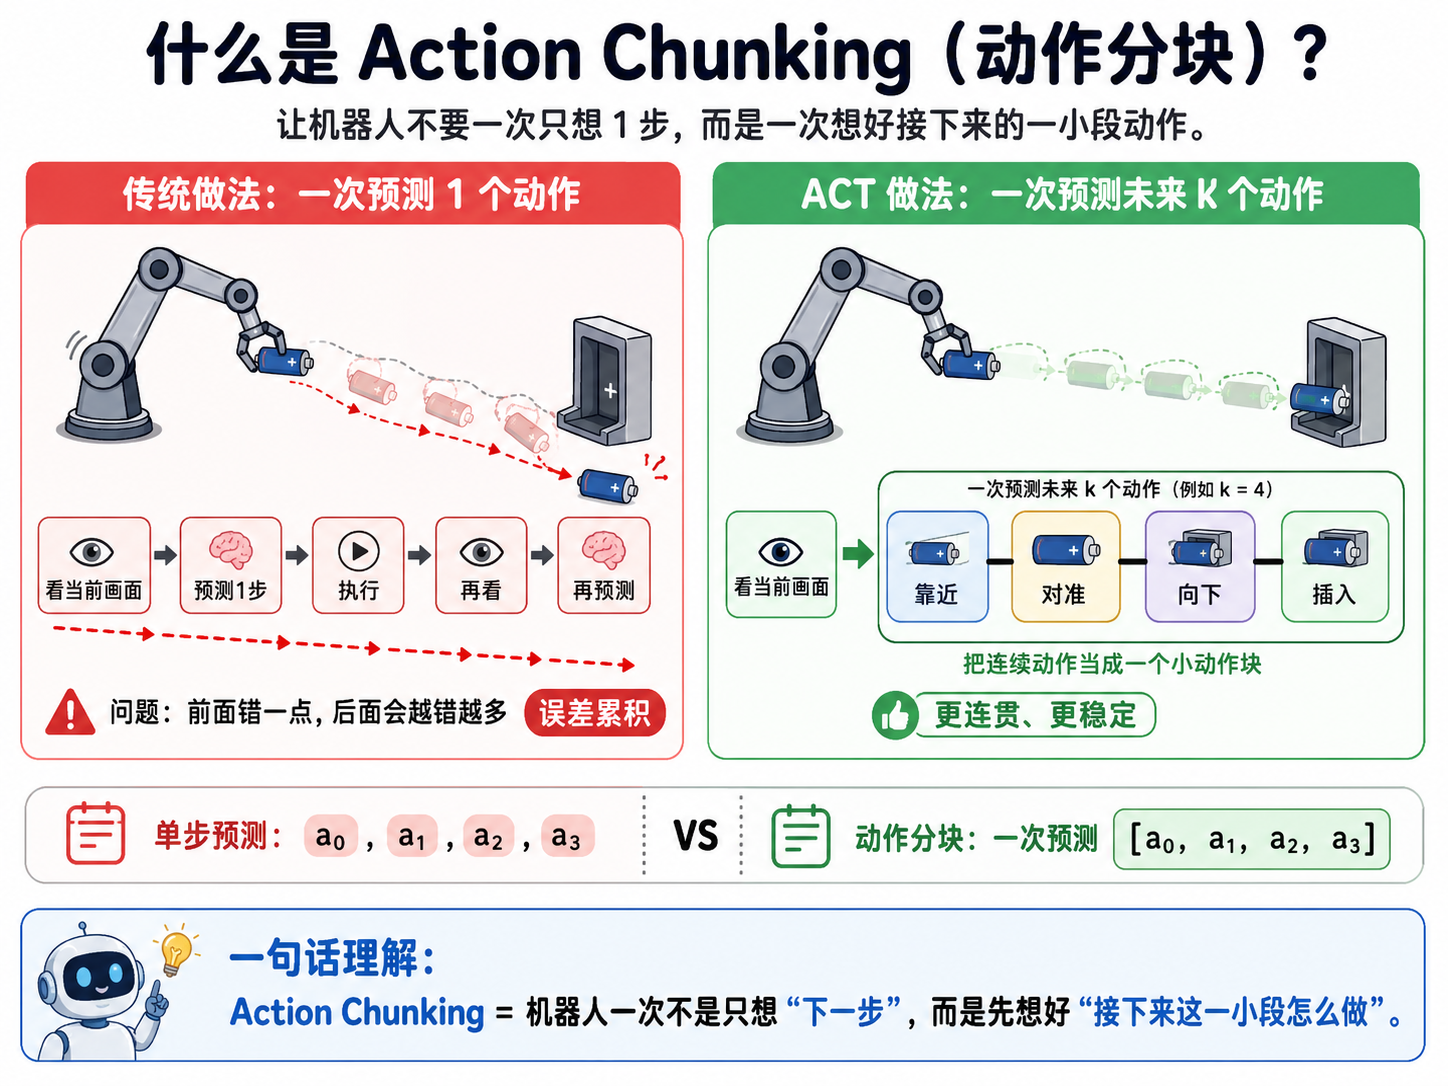
为什么这样做会更好?可以把它理解成:让机器人不要每一步都“临时想”,而是一次考虑接下来的一小段动作。 人类其实也是这样完成任务的。比如插电池时,我们通常不会把它理解成“向前移动1毫米→向下移动1毫米→再向前移动1毫米”,而会把“靠近→对准→插入”看成一个连续的小动作。Action Chunking 就是在让机器人学习这种连续的动作结构。
它还有一个很重要的作用,就是降低任务的有效预测长度。假设一个任务有100个时间步,如果每次只预测一个动作,就相当于连续做100次单步决策;如果 chunk_size=10,模型每次都会考虑未来10步,因此从动作块的角度看,原本很长的任务被分成了更少的连续片段。论文中把这个称为 effective horizon 减少了 k 倍。对于小白,可以简单理解成:以前机器人只看脚下这一步,现在它会提前看接下来几步,所以不容易因为某一步的小误差马上把后面的动作带偏。
Action Chunking 对真实的人类示范数据也很有帮助。人在遥操作机器人时并不是完全稳定的,可能会出现停顿、犹豫、速度变化等情况。如果模型只学习单个时间点,就很难理解“为什么这里突然停了一下”;但如果它学习的是一整段动作,例如“靠近→停顿→调整→插入”,就更容易理解这些动作之间的连续关系。
https://github\.com/huggingface/lerobot/blob/main/src/lerobot/policies/act/modeling\_act\.py
时间集成(Temporal Ensembling)
前面我们讲了 Action Chunking:ACT 一次不是只预测 1 个动作,而是预测未来一小段动作。那问题来了:如果模型一次预测了很多步,执行过程中环境发生变化怎么办?
所以 ACT 并不是“预测 10 步,然后闭着眼执行 10 步”,而是会每个 timestep 都重新观察、重新预测一段新的 Action Chunk。假设 chunk_size = 4,模型可能会这样预测:
t=0 → [a0, a1, a2, a3]
t=1 → [a1', a2', a3', a4']
t=2 → [a2'', a3'', a4'', a5'']
你会发现,同一个未来时刻会被预测很多次。比如 t=2 这个动作,可能同时有:
t=0 时预测的 a2
t=1 时预测的 a2'
t=2 时预测的 a2''
那机器人到底该听哪一个?ACT 的做法不是只选其中一个,而是把这些针对同一个 timestep 的多个预测进行加权融合,得到最终真正执行的动作,这就是 Temporal Ensembling(时间集成)。你可以把它理解成:
同一个动作,模型会在不同时间、根据不同观测反复给出意见,最后把这些意见综合起来。
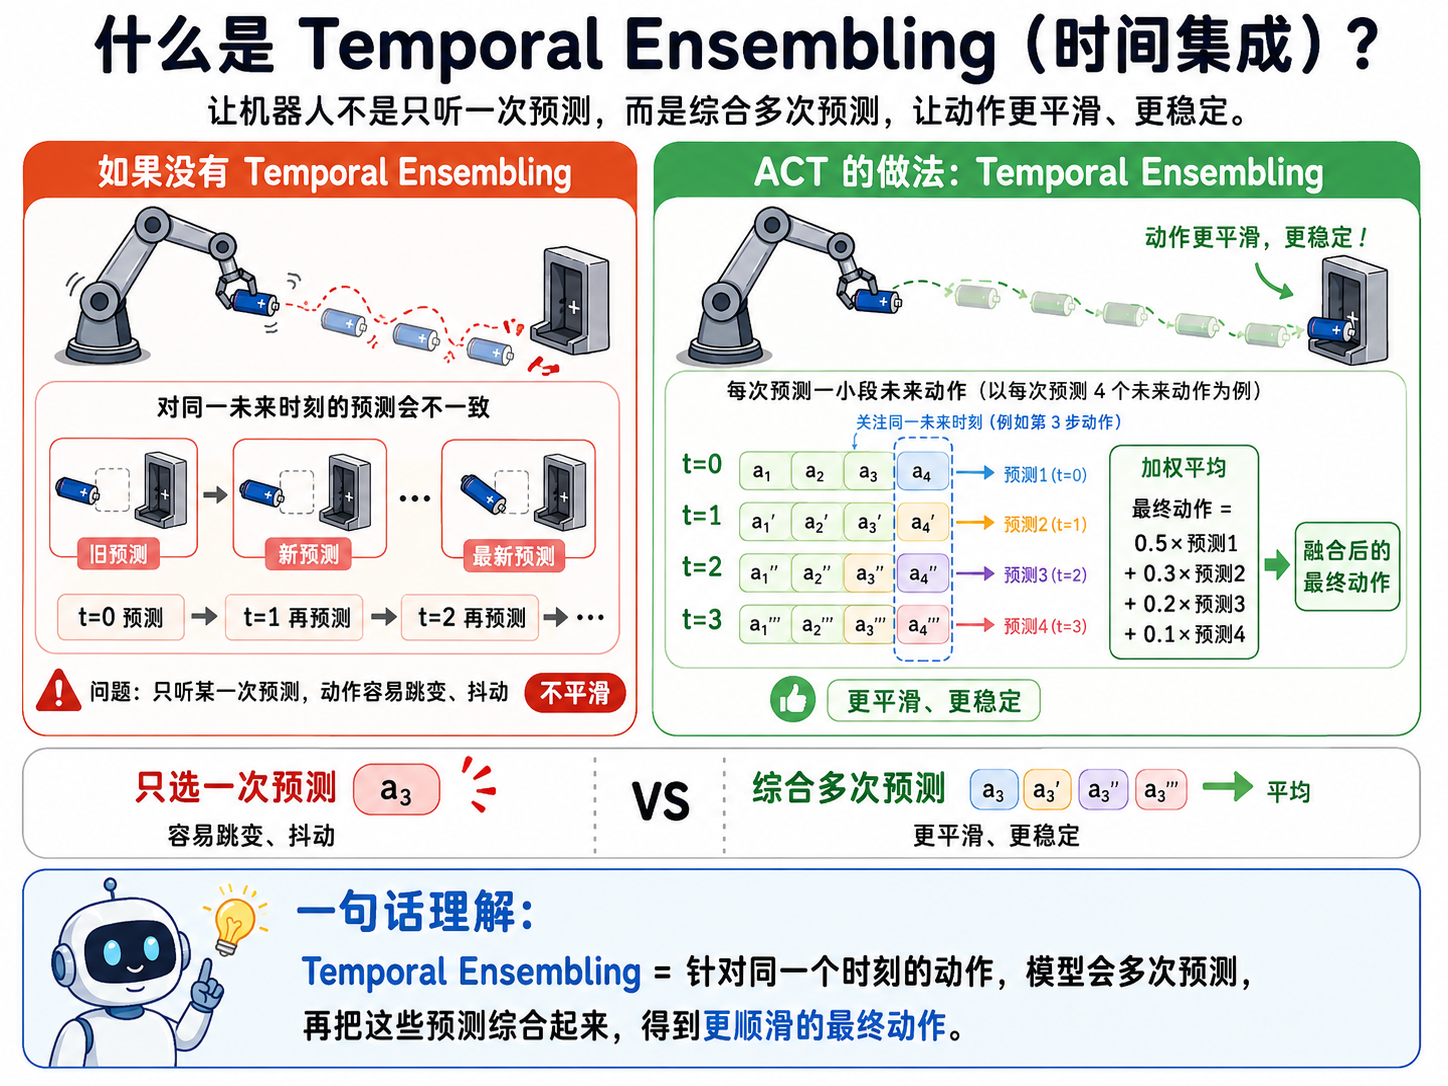
如果机器人每次完全跟着最新预测走,动作可能会不断跳动;而 Temporal Ensembling 会把这些预测做加权平均,最后可能得到一个更平滑的结果。所以它主要解决的是两个问题:
论文里使用的是指数权重:
所以Action Chunking:一次多想几步。Temporal Ensembling:每一步都不断重新看、重新想,再把多次意见平滑融合。
CVAE-Modeling Human Data:如何处理人类示范中的“不确定性”?
前面我们已经知道,ACT 通过 Action Chunking 一次预测一段动作,再通过 Temporal Ensembling 让动作更加平滑。但这里还有一个问题:不同人类提供的示范数据本身并不完全一致。
比如,同样是把电池插进插槽,不同的人可能会:
-
从不同角度靠近;
-
有的人动作快,有的人动作慢;
-
有的人先向左调整,再插入;
-
有的人直接对准后插入。
甚至是同一个人重复做同一个任务,两次轨迹也不一定完全一样。所以对于同一个 Observation,并不存在唯一正确的 Action Sequence。如果我们强行让模型认为:
“看到这个画面,就必须输出唯一的一条动作轨迹。”
模型就很容易把多种不同的人类操作方式“平均”到一起,最后得到一条谁都不像的动作。例如有两条示范:
示范 A:从左边绕过去 → 插入
示范 B:从右边绕过去 → 插入
如果模型简单做平均,可能学成:
直接从中间过去
但中间可能刚好有障碍物。
所以作者希望 ACT 不只是学习一个固定答案,而是学习:
在当前状态下,人类可能采用哪些合理的动作方式。
这就是这一节为什么要引入 CVAE(Conditional Variational Autoencoder,条件变分自编码器)。
CVAE 在 ACT 里面怎么工作?
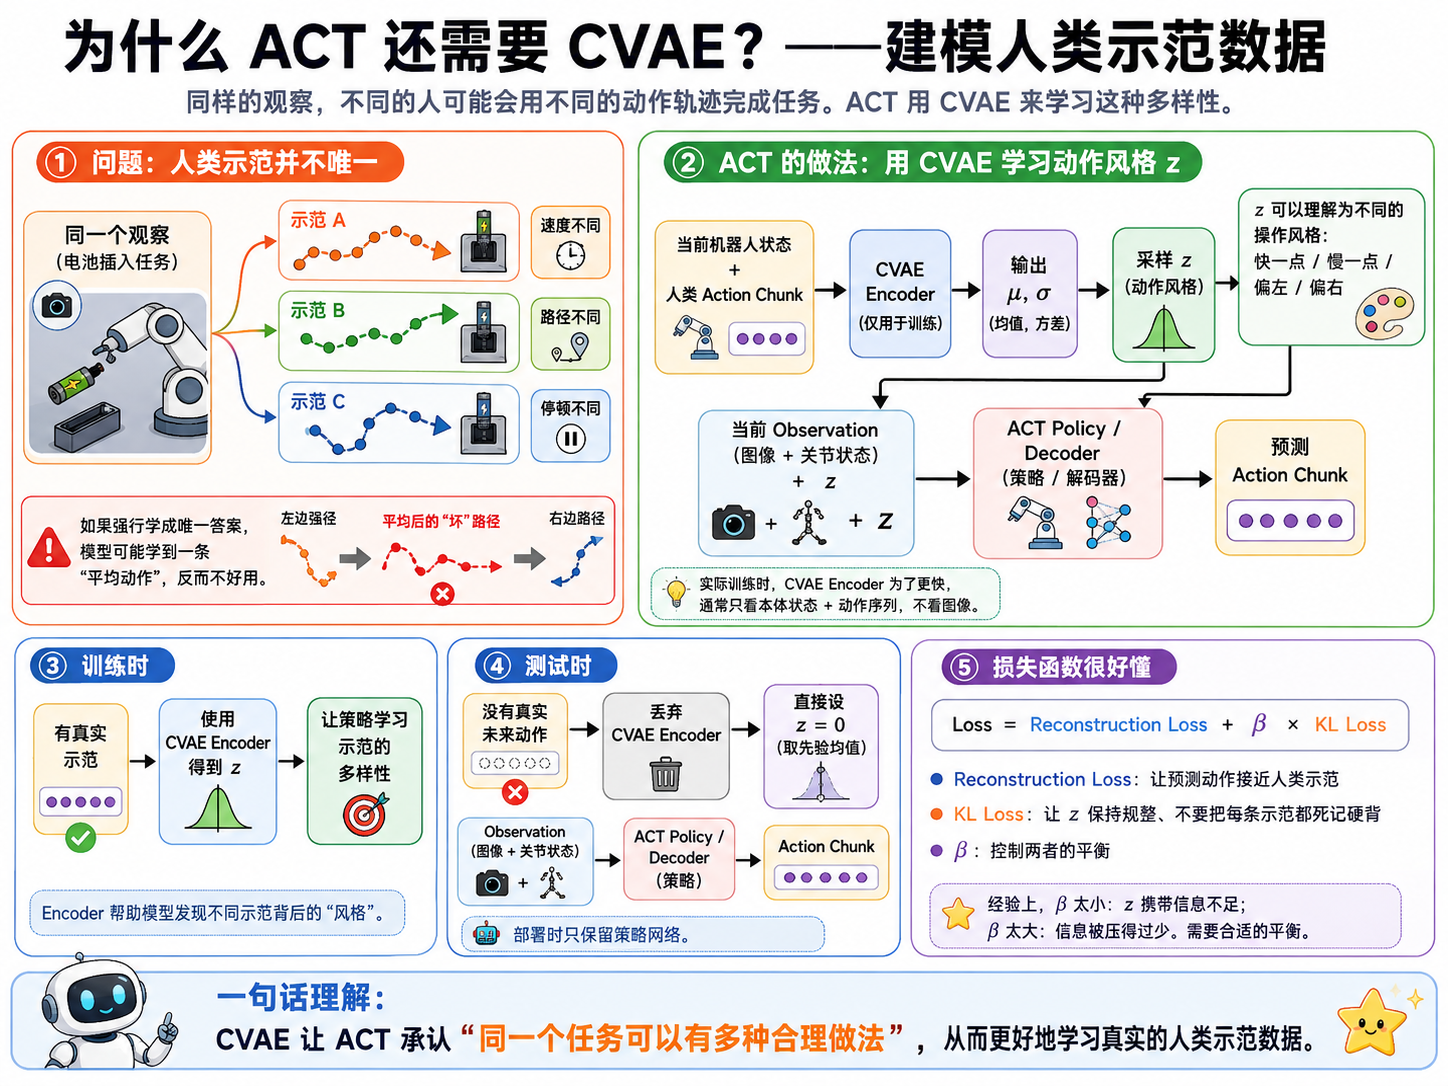
CVAE 主要分成两个部分:
其中,CVAE Encoder 会根据:
-
当前机器人的状态;
-
人类真实执行的 Action Sequence;
推测这条示范属于什么样的“动作风格”。论文中并不是直接输出一个固定的 ,而是输出:。也就是一个高斯分布的:
-
Mean(均值)
-
Variance(方差)
然后从这个分布中采样z,所以模型学习的不是:“这条动作的风格一定是某一个固定值。” 而是:“它大概属于这样一个动作分布。” 这也是 VAE 的核心思想之一。
论文这里还有一个很实用的工程设计,训练时 CVAE Encoder 理论上可以输入:
Image + Robot State + Action Sequence
但作者为了提高训练速度,没有把 图像放进 CVAE Encoder。
实际上使用的是:
Robot State + Action Sequence
        ↓
   CVAE Encoder
而摄像头图像还是会进入真正负责预测动作的 ACT Policy。因此可以理解成:
CVAE Encoder 只负责从示范动作中提取“风格”,真正决定机器人应该怎么行动的 Policy 仍然会看图像。
完整的 ACT 网络
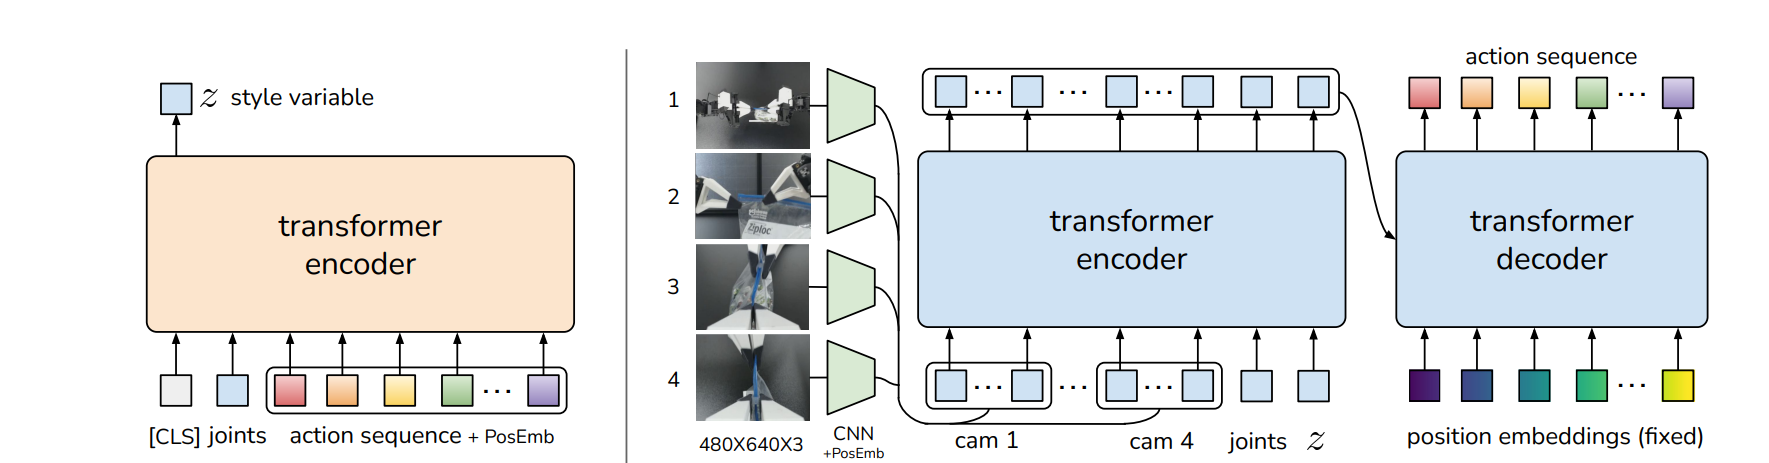
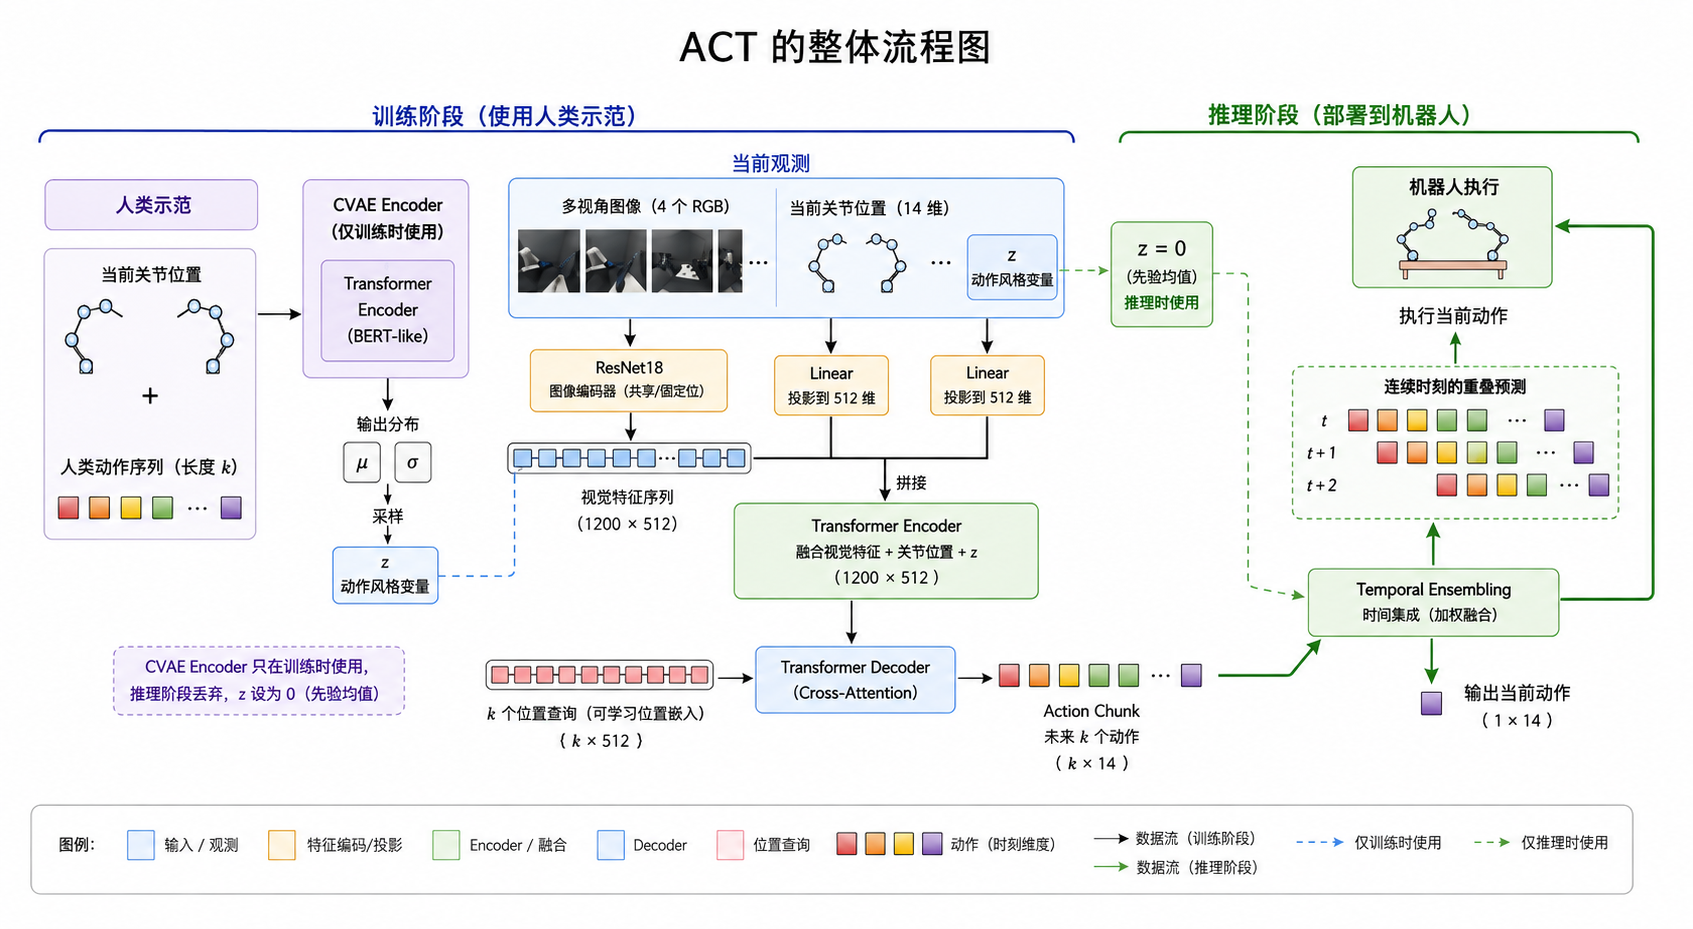
从原文图和拆解图中,我们可以进一步理解整个 ACT 网络。人类示范数据中的关节位置和 Action Chunk 会先经过 CVAE Encoder,用来学习不同示范之间的动作风格,并得到高斯分布的均值和方差 以及动作风格变量z。需要注意的是,CVAE Encoder 主要处理的是关节状态和动作序列,并不会直接处理摄像头图像。
由于原始 RGB 图像分辨率为 ,直接送入 Transformer 计算量会非常大,因此算法首先使用 ResNet18 对每个摄像头图像进行特征提取,将一张图像转换成 的特征图。随后将空间维度展平,得到 的视觉特征序列。ALOHA 一共有 4 个摄像头,因此最终会得到 的视觉 Token。
除了图像之外,模型还会把机器人当前的 14 维关节位置和 CVAE 学到的动作风格变量 分别通过 Linear 层投影到 512 维,并与视觉特征拼接。因此 Transformer Encoder 最终接收到的是:
1200+1+1=1202
也就是一个 的特征序列。我们可以把 Transformer Encoder 理解成一个“信息融合器”,负责综合回答三个问题:机器人看到了什么?机器人现在处于什么姿态?当前示范属于什么动作风格?
这些融合后的信息会继续送给 Transformer Decoder。Decoder 中准备了 个位置查询,可以简单理解为:“未来第 1 步做什么、未来第 2 步做什么……未来第 步做什么”。通过 Cross-Attention,Decoder 从 Encoder 的输出中获取当前环境信息,最终一次生成未来 个动作。由于 ALOHA 左右两条机械臂一共有 14 个关节,因此 ACT 最终输出的是:
例如 chunk_size = 100 时,模型一次会预测未来 100 个 timestep × 14 个关节位置,这一整段预测结果就是前面介绍的 Action Chunk。
训练过程中,模型会将预测出来的 Action Chunk 与真实的人类示范进行比较。论文使用 L1 Loss 作为动作重建损失,同时加入 CVAE 的 KL Loss,让预测动作尽量接近人类示范,并约束动作风格变量 的分布。
当模型真正部署到机器人上进行推理时,就不存在未来的人类 Action Chunk 了,因此 CVAE Encoder 会被丢弃,并直接令 。此时模型只需要根据当前摄像头图像和机器人关节状态预测新的 Action Chunk,再结合前面介绍的 Temporal Ensembling 对多个时间点产生的重叠预测进行融合,最终只取当前 timestep 的动作发送给机器人执行。
因此整个 ACT 的数据流可以简单记成:
训练时:人类示范 → CVAE 学习 → 图像 + Joints + → Transformer → Action Chunk
推理时:图像 + Joints + → Transformer → Action Chunk → Temporal Ensembling → Robot
可以把这一节记成:
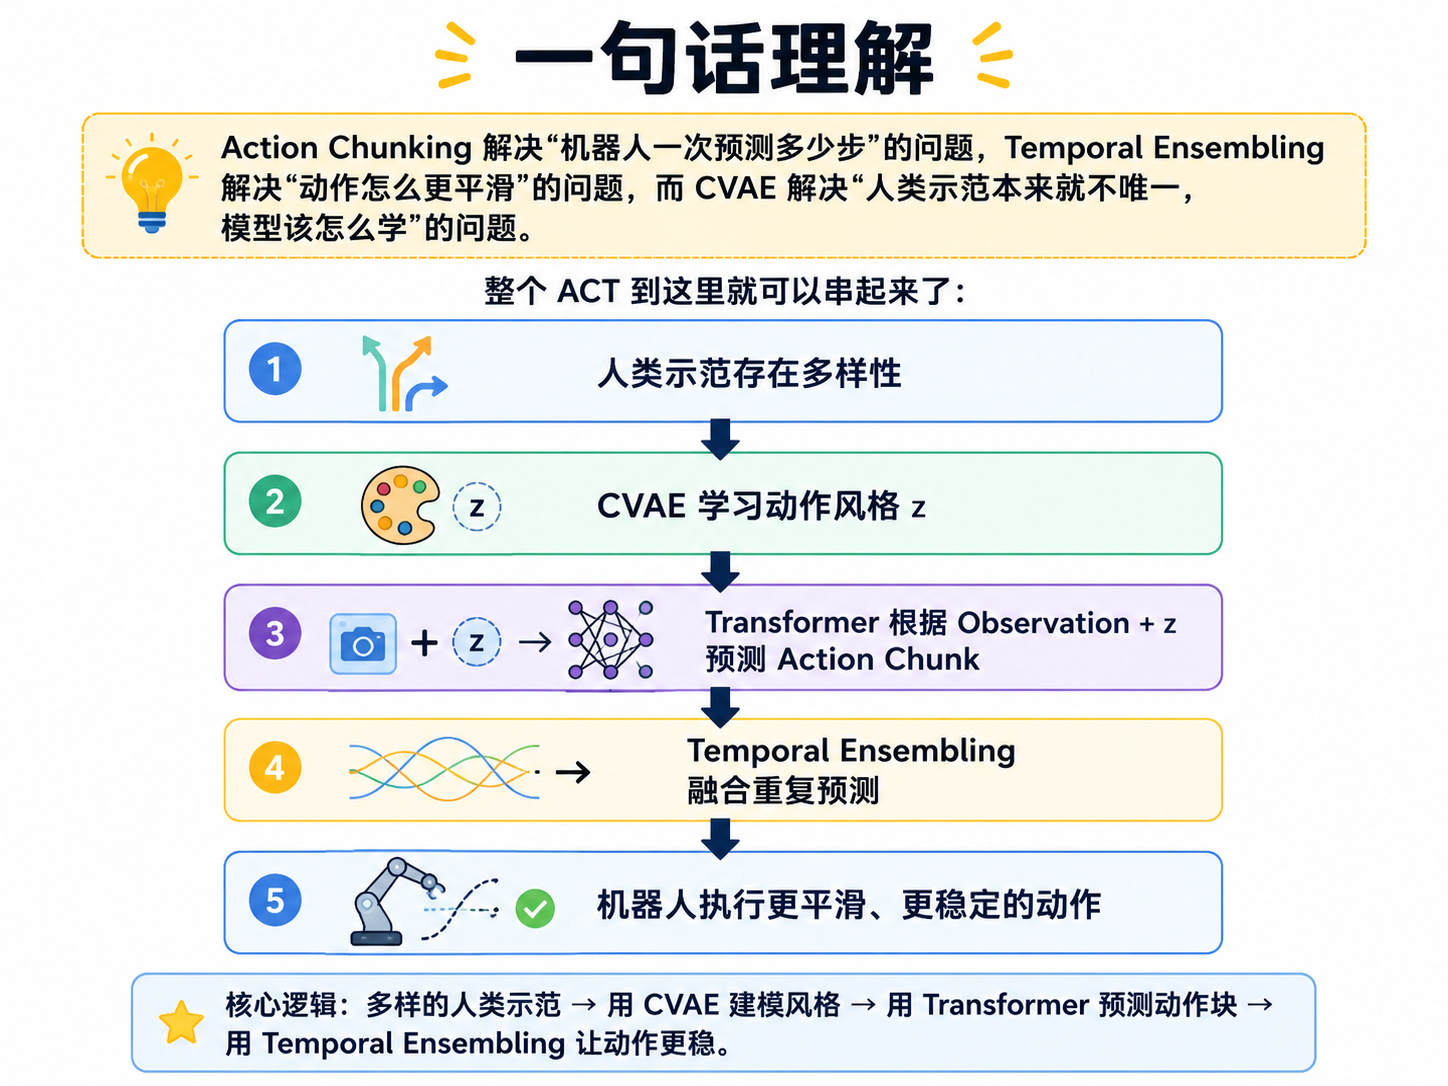
Action Chunking 解决“机器人一次预测多少步”的问题,Temporal Ensembling 解决“动作怎么更平滑”的问题,而 CVAE 解决“人类示范本来就不唯一,模型该怎么学”的问题。
整个 ACT 到这里就可以串起来了: