DM0.5:用历史上下文与轨迹对齐走向开放世界
DM0.5: An Open-World Foundation Model for General-Purpose Embodied Intelligence
- 历史上下文
- 具身推理
- 轨迹对齐
- 连续动作
机器人接到指令:“拿起杯子,把下面的桌面擦干净,再放回原处。”杯子拿走后,当前画面未必还包含它的初始位置;同样是握着杯子,擦桌前和擦桌后的下一步也不同。示范者的快慢与停顿,又会给动作学习带来额外差异。
DM0.5 从三个方面处理这些问题:保留历史、学习任务阶段、对齐示范轨迹。 本文依据 Dexmal 的官方技术博客,结合公开实现解释这三个机制。
整体架构:先理解场景,再生成动作
视觉语言动作模型(Vision-Language-Action,VLA)把图像、指令和机器人状态转成控制动作。DM0.5 使用 4B 视觉语言模型(VLM)与 680M 动作专家(Action Expert):前者组织场景与任务信息,后者生成连续动作。
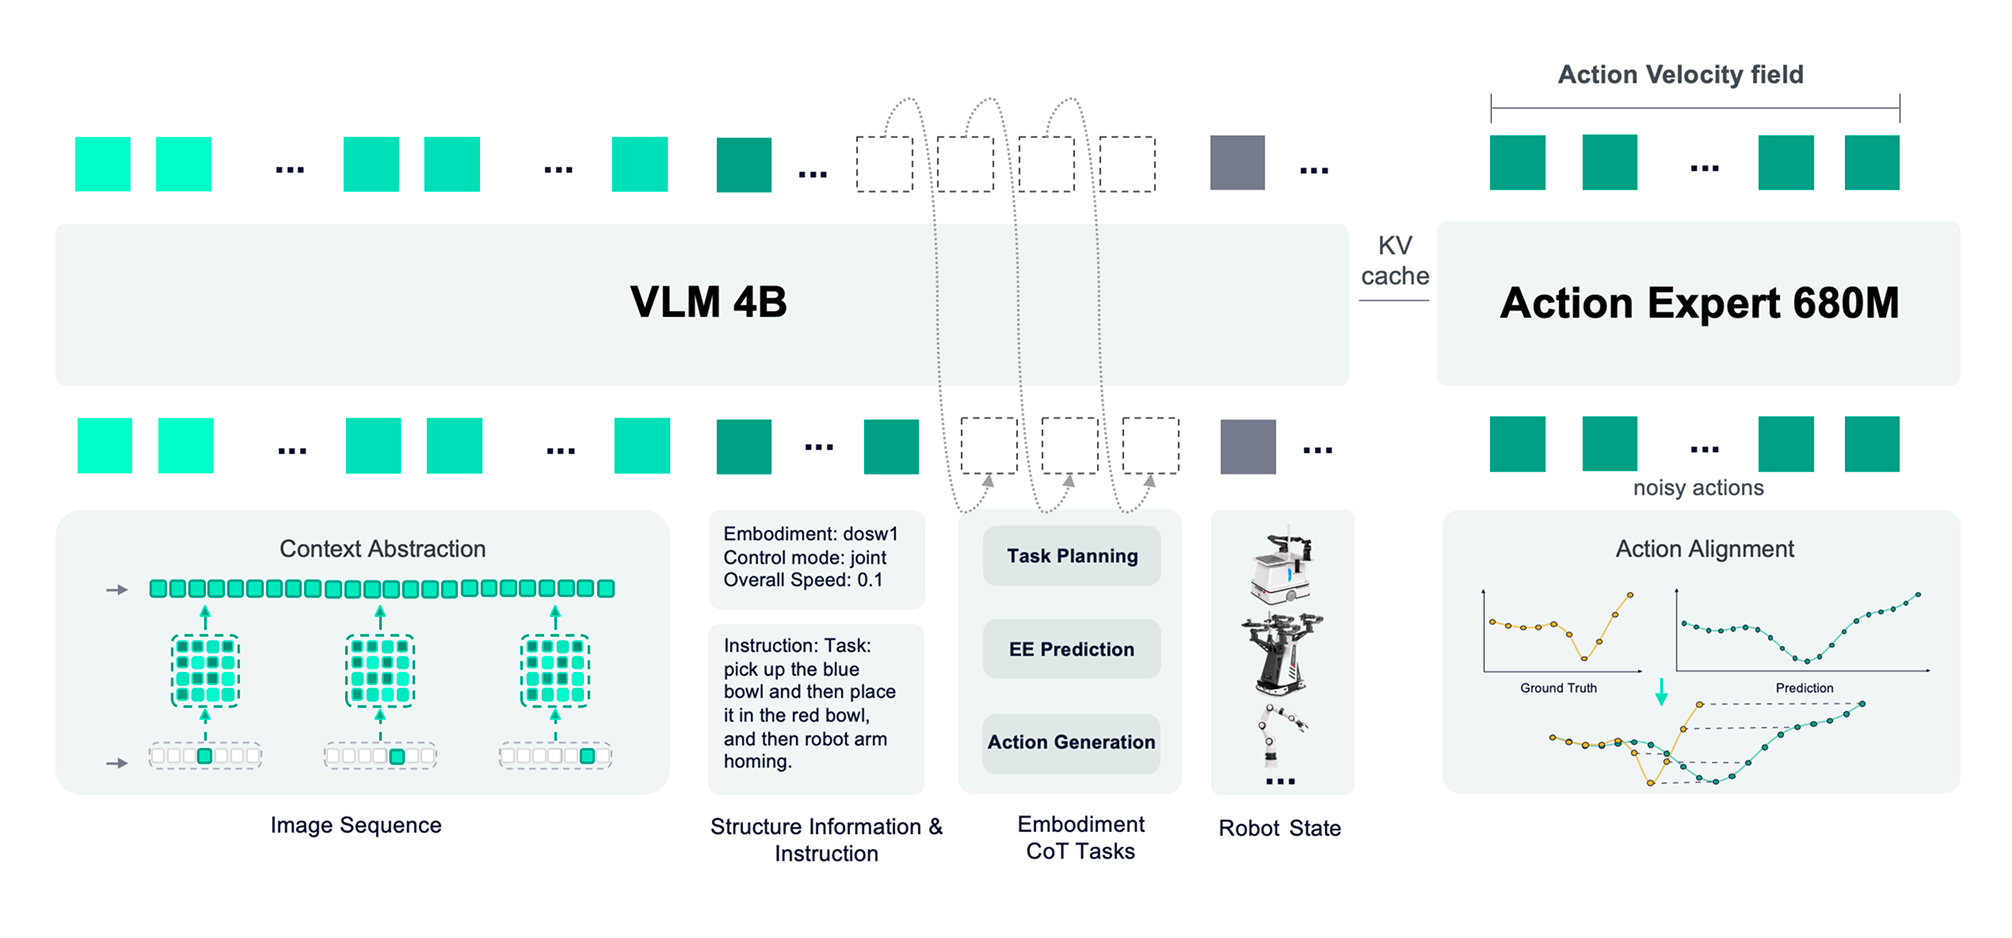
来源:官方博客 Model。历史压缩、具身推理与轨迹对齐分别改进输入信息和训练监督。
在放回杯子的时刻,历史画面提供初始位置,当前画面提供杯子与桌面的现状,指令说明要恢复什么关系。VLM 将它们编码为动作条件;动作专家读取这些条件,生成一段搬移与放置动作。
模型一次预测一段未来动作,称为动作块(action chunk)。图中的 KV cache(键值缓存)用于复用图文计算;任务历史则需要实际输入过去的观测,两者作用不同。
历史上下文:找回当前画面缺少的信息
要把杯子“放回原处”,模型需要同时利用拿起前与当前的画面。但直接输入长视频会增加计算量。
DM0.5 的上下文抽象层(Context Abstraction Layer) 从过去采样画面,将每个历史位置压缩为固定数量的视觉 token,再与当前观测共同建模。公开记忆路径通过二维平均池化,把较密的视觉特征网格压小。
教学示意:历史只来自当前时刻之前,灰色槽位表示缺失历史。
博客称可纳入最长约 60 秒的历史。能否找回杯子初始位置,还取决于相关画面有没有被采到,以及压缩后是否保留足够的位置线索。例如,每秒保留一张图,可能漏掉仅短暂清楚可见的细节。
历史能力也需要检查点与输入路径配套。本文所引版本的普通 LeRobot 接入未提供 OpenDM 的独立历史图像路径,开头的 LIBERO 命令不能直接用于验证记忆能力。
具身推理:让示范包含任务进度
动作标签告诉模型“这里怎样运动”,却未必直接表达“已经做完什么、接下来要做什么”。DM0.5 在机器人数据上加入 11 项自回归任务,通过逐 token 预测文字答案,增加阶段、事件与动作意图的监督。
博客将这些 Embodiment CoT Tasks(具身思维链任务) 分成三类:
| 类别 | 学习内容 | 擦桌任务的教学例子 |
|---|---|---|
| 任务规划 | 当前阶段与后续步骤 | 杯子已移开,接下来擦桌 |
| 事件与环境预测 | 场景变化与关键事件 | 擦拭后,该区域应变干净 |
| 动作生成 | 未来动作或意图摘要 | 将杯子放回先前的位置 |
这些例子用于解释监督含义,并非公开训练样本。历史提供“发生过什么”的线索,语义监督要求模型学习这些变化与任务进度的关系,形成有助于动作选择的表示。这里描述的是训练目标,不表示每次执行前都要输出一段可读推理。
轨迹对齐:减少示范节奏的影响
两位操作者都完成“接近—接触—抓稳—抬起”,其中一位在接触前停了半秒。若固定按时间位置对应,相同的预测位置就可能被要求学习不同的操作阶段。
DM0.5 的轨迹对齐层(Trajectory Alignment Layer) 为固定长度的预测动作,在更细的真实轨迹中寻找对应锚点。匹配必须保持时间顺序,再通过动态规划寻找整体代价较小的对应关系。
教学示意:一维数值代表某个归一化动作分量,简化代价仅包含点误差。
看一个简化算例:真实轨迹为 [0, 0, 0.5, 1, 1],预测为 [0, 0.5, 1]。若固定对应前三个位置,平方误差为 0² + 0.5² + 0.5² = 0.5;若依次匹配第 1、3、4 个位置,误差为 0。模型便有机会学习动作变化,而不必照搬前面的停顿。
只找误差最小的点,也可能跳过关键接触阶段。因此博客还描述了锚点之间的轨迹连续性约束,但未给出完整公式。上述算例只解释单调匹配原理;它调整训练监督的对应关系,部署时的动作节拍仍由控制系统决定。
连续动作:从噪声生成动作块
历史与指令形成条件,轨迹对齐处理监督对应;具体的数值动作由**流匹配(Flow Matching)**生成。
公开普通 SFT 实现将真实动作块 A 与同形状的高斯噪声 ε 混合:
其中 s 从 0 到 1 表示动作到噪声的混合位置。动作专家读取带噪动作、s 和图文条件,学习预测更新方向 U。例如,单个动作值为 0.6、噪声为 −0.2、s=0.5 时,混合值为 0.2,目标方向为 −0.8。
教学示意:内部生成更新次数与动作块中的控制点数量是不同概念。
推理时从噪声出发,将 s 从 1 逐步减到 0。沿上例,若当前位置为 0.2、预测方向为 −0.8,用时间步长 −0.1 更新,就得到 0.28,朝动作值 0.6 靠近。生成后撤销归一化,交给控制器执行,再读取新观测。
博客默认用 10 次内部更新生成 50 步动作块;实际执行多少步后重新观察,取决于具体配方。普通 LeRobot SFT 使用流匹配损失,并不自动重建博客全部推理任务和轨迹对齐训练。
数据与训练:给这些机制提供经验
DM0.5 混合机器人操作、具身导航、第一人称人类操作和通用图像/视频数据。机器人轨迹提供动作监督,其他来源扩展语义、空间与时序经验;人类视频不能直接等同于带机器人关节真值的示范。
数据清洗会去除异常与长静止片段、检查图像和动作是否同步,并修正错误的任务标注。先保证记录正确,再处理示范快慢差异,轨迹对齐才能针对真正的节奏噪声发挥作用。
基础训练中,VLM 使用较小学习率以保留图文能力,动作专家使用更大学习率学习控制。之后再从基础权重适配具体任务或机器人;相机、状态、动作含义与归一化都需要保持一致。
实验:哪些能力得到了支持
零样本指令执行
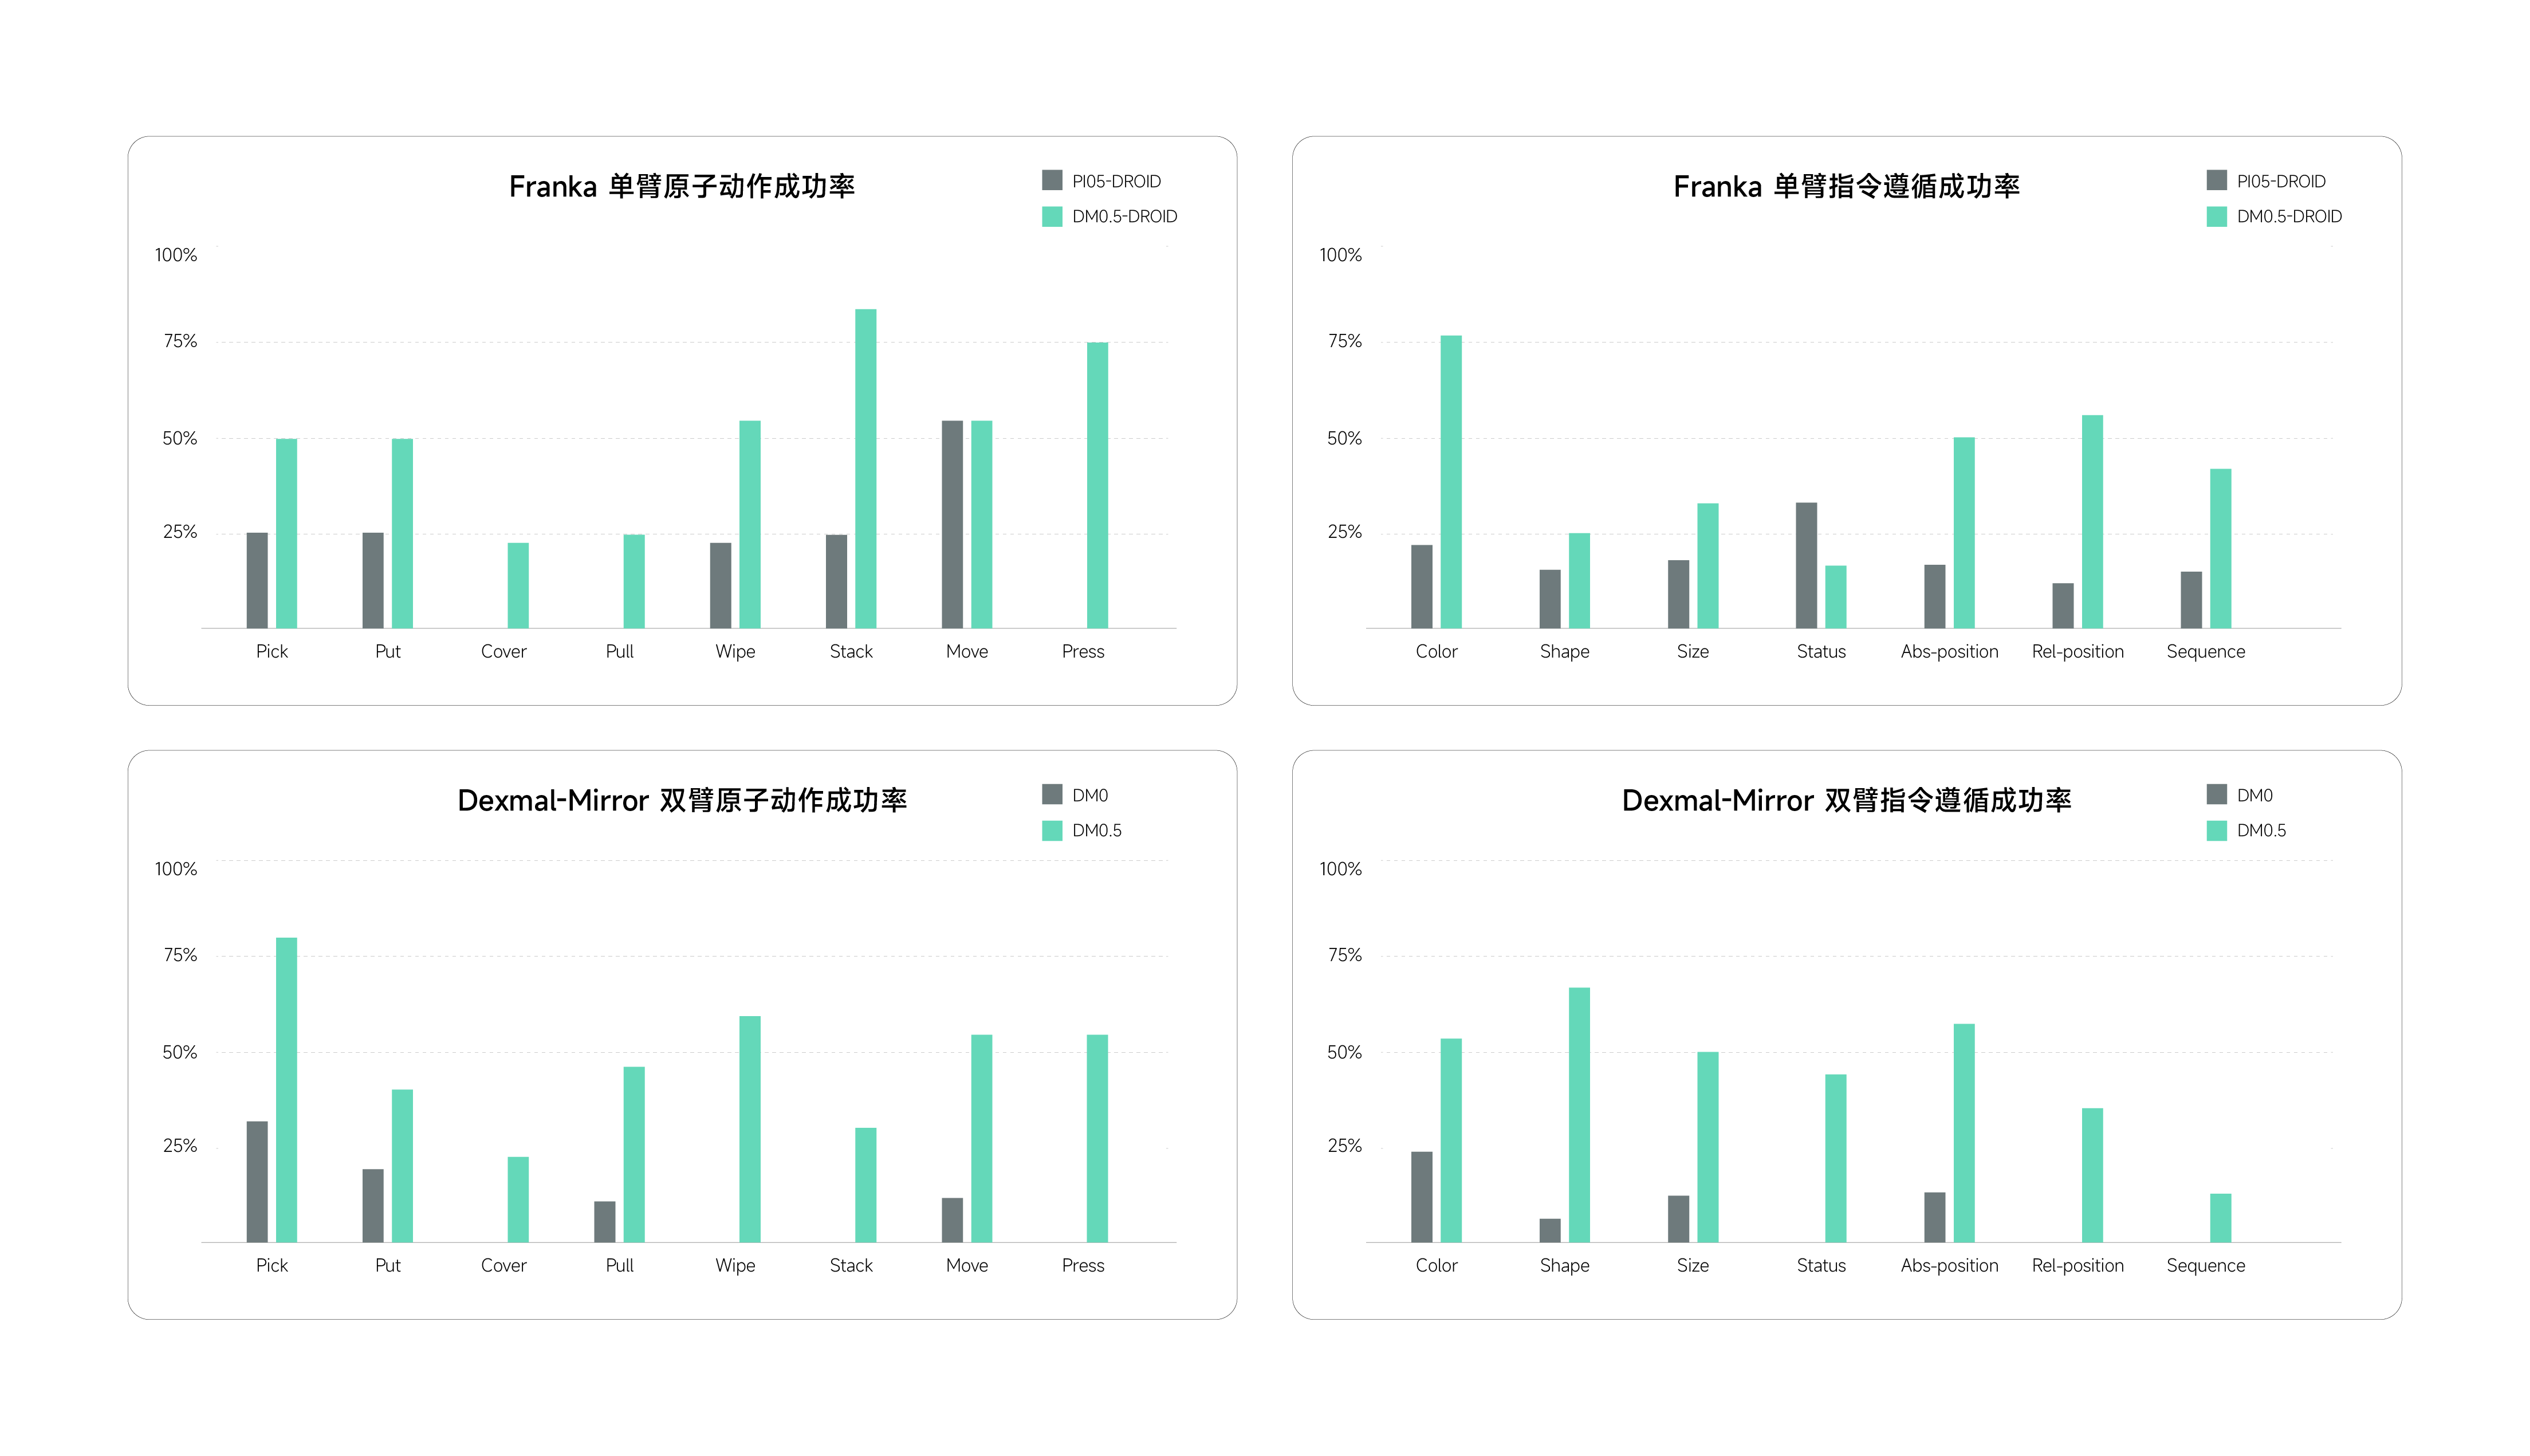
来源:官方博客 Zero-Shot Generalization。上排在 Franka 上比较 DM0.5-Droid 与 π0.5-Droid,下排在 Dexmal-Mirror 上比较 DM0.5 与 DM0;纵轴为成功率。
DM0.5 在多数动作与语义约束类别上更好,但 Franka 上“移动”持平、“状态”约束更低。因此可以读出多数条件改善,不能推成所有指令都更可靠。比较应在同一平台内进行;这里的零样本指未见任务配置,仍依赖已有训练经验。
任务适配与真实执行
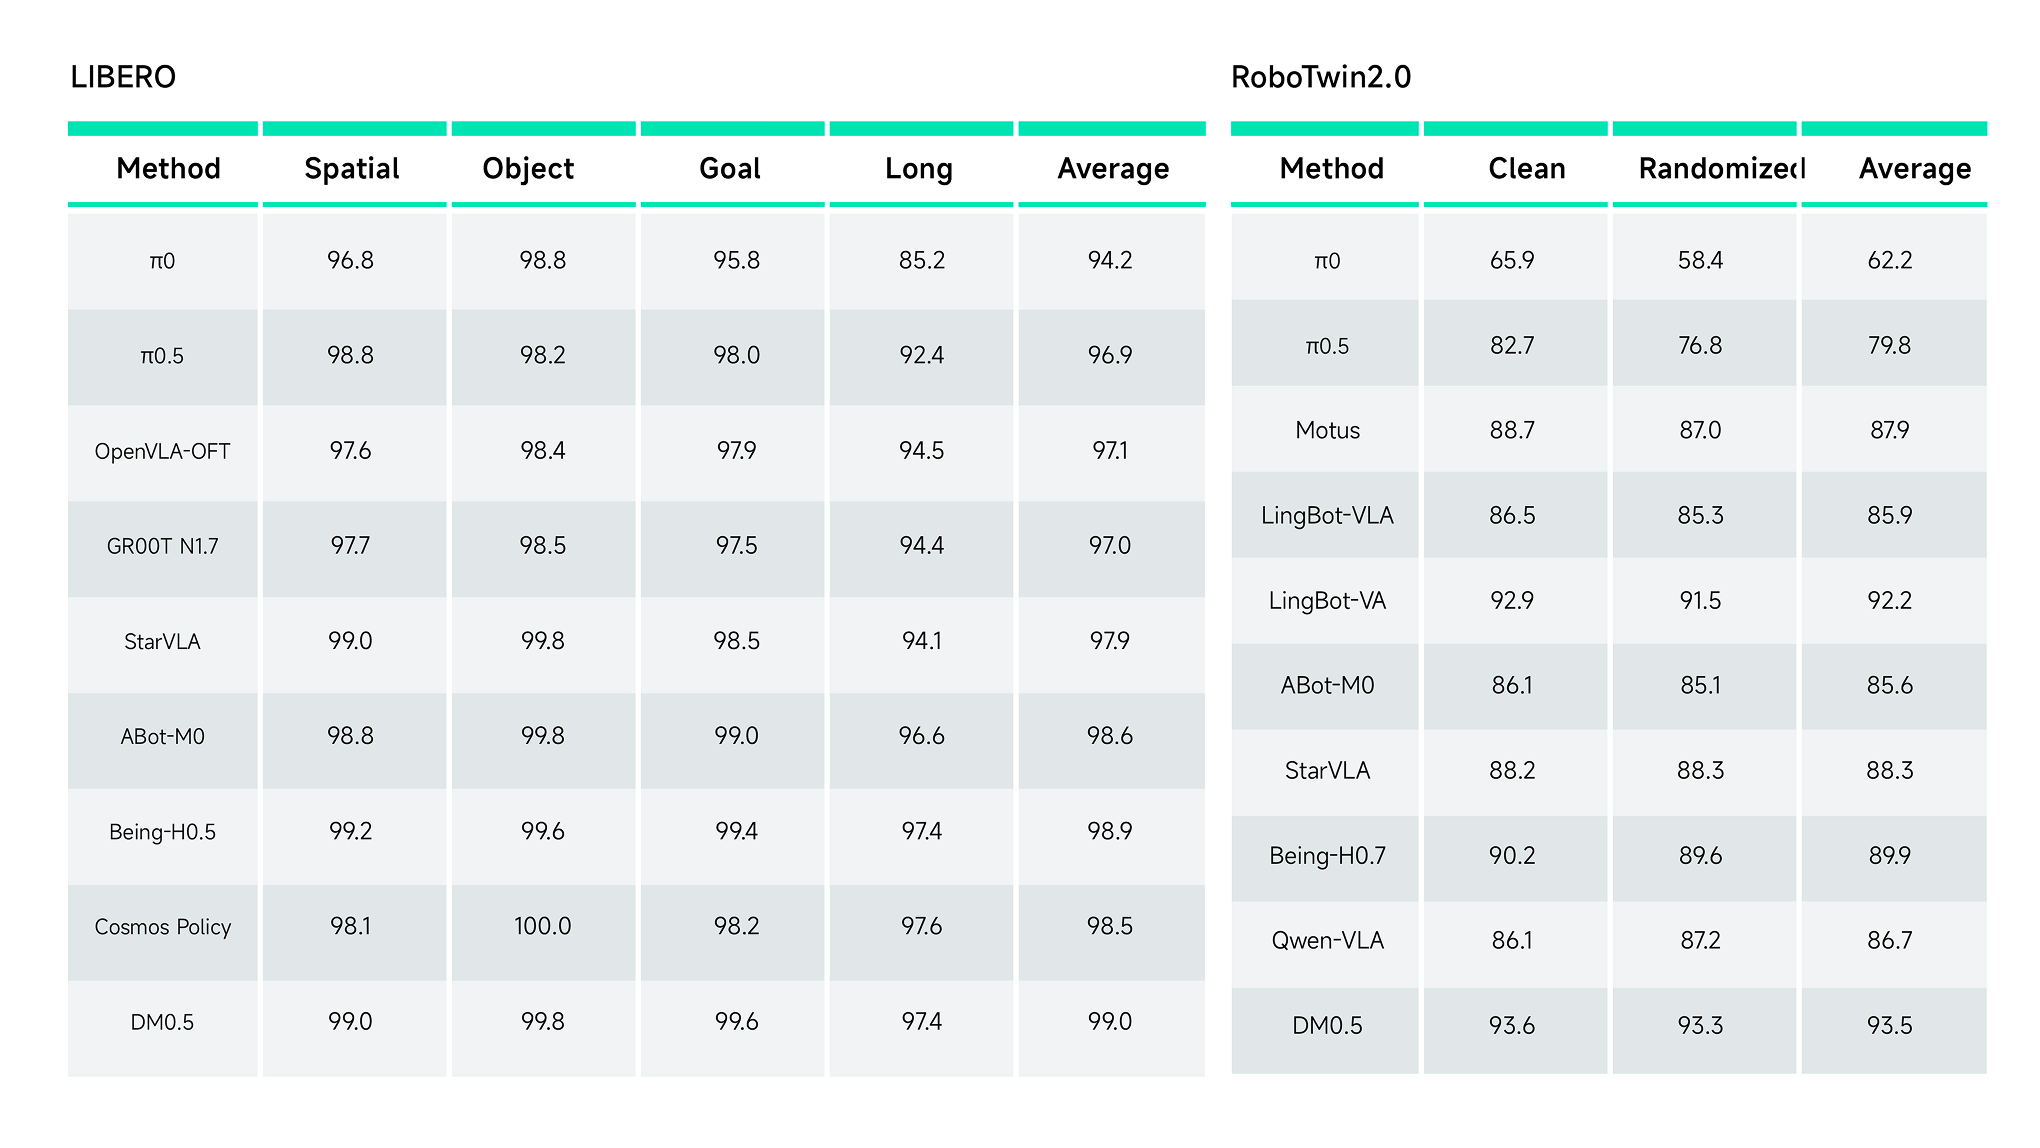
来源:官方博客 Fine-Tuning Capability。表中成功率单位为百分比。
LIBERO 四套任务平均成功率为 99.0%,同表 π0.5 为 96.9%;RoboTwin2.0 的 Clean/Randomized 为 93.6%/93.3%,π0.5 为 82.7%/76.8%。这些结果支持 DM0.5 是较强的任务适配起点。
实机 RoboChallenge Table30 v2 中,作者为每种测试本体训练统一的多任务策略,完整成功率为 43.0%,综合 Score 为 54.42;两项指标不能混读。较高的仿真成绩也未消除真实操作中的失败。
记忆方面,博客展示了杯子放回原位、观察人类演示后遵循电池放置规则。相机扰动测试在固定腕部相机、改变两台外部相机的九种组合下,每组测试 10 次,成功率为 80%—100%;人为干扰则主要提供行为演示。
这些证据支持整体系统的能力,但尚未分别量化历史、推理任务和轨迹对齐各自贡献多少。记忆与人为干扰的演示也缺少完整量化对照,不能据此保证任意长任务或扰动下都能成功。
结论
DM0.5 提供了一条值得理解的路线:历史补足当前观测,语义监督连接任务阶段,轨迹对齐减少示范节奏噪声,动作专家将这些条件落实为连续控制。
用到自己的机器人时,先判断任务是否确实依赖过去的信息,再核对检查点是否接收这些信息,以及动作接口是否匹配。方法是否有效,最终仍要通过目标任务中的对照实验判断。