EO-1:统一具身推理与机器人控制
EO-1: An Open Unified Embodied Foundation Model for General Robot Control
- 统一具身模型
- 交错学习
- 具身推理
- 机器人控制
先验知识:模型看见什么,输出什么
解释: 模仿学习(Imitation Learning)让模型从人的操作记录中学习:遇到这样的场景、接到这样的指令时,应怎样运动。视觉-语言-动作模型(Vision-Language-Action Model,VLA)在此基础上加入语言理解,输入通常包括相机画面、任务文字和机器人自身状态。
以“把番茄放进购物袋”为例:画面提供番茄与袋子的位置,自身状态提供机械臂当前姿态,文字说明目标,动作则控制抓取和放置。EO-1 还可以回答“接下来做什么”“任务完成了吗”,把判断接到动作前后。
| 概念 | 本文中的含义 |
|---|---|
| 观测(Observation) | 多视角图像与机器人自身状态;新图像来自相机 |
| 状态(State) | 机器人自身的低维数值,例如关节状态;具体维度依平台而定 |
| 动作(Action) | 控制机器人运动的连续数值,物理含义依数据集与平台而定 |
| 动作块(Action Chunk) | 一次预测未来多步动作;EO-1 的实现采用 16 步 |
| 具身推理(Embodied Reasoning) | 围绕物体、空间、任务进度和物理交互做判断 |
单步方式可写成 当前观测 → aₜ;动作块方式是 当前观测 → [aₜ, aₜ₊₁, …, aₜ₊₁₅]。解释性例子: 若只看一个动作维度,三步序列可以是 [0.1, 0.12, 0.15];这只是帮助理解,实际 EO-1 输出多维、16 步的数组。
动作块让模型联合安排一段运动,但其长度不等于模型调用间隔。论文没有给出所有平台共用的动作块执行比例、重规划频率或控制频率,不能据此推导系统每秒推理多少次。
摘要:翻译与批注
翻译
人类能够在开放世界中自然地进行多模态推理与物理交互,这也是通用具身智能系统的核心目标。近期的 VLA 模型通过大规模机器人数据和视觉文本数据联合训练,在通用机器人控制上取得了明显进展,但仍未达到人类在推理与交互交替进行时的灵活程度。
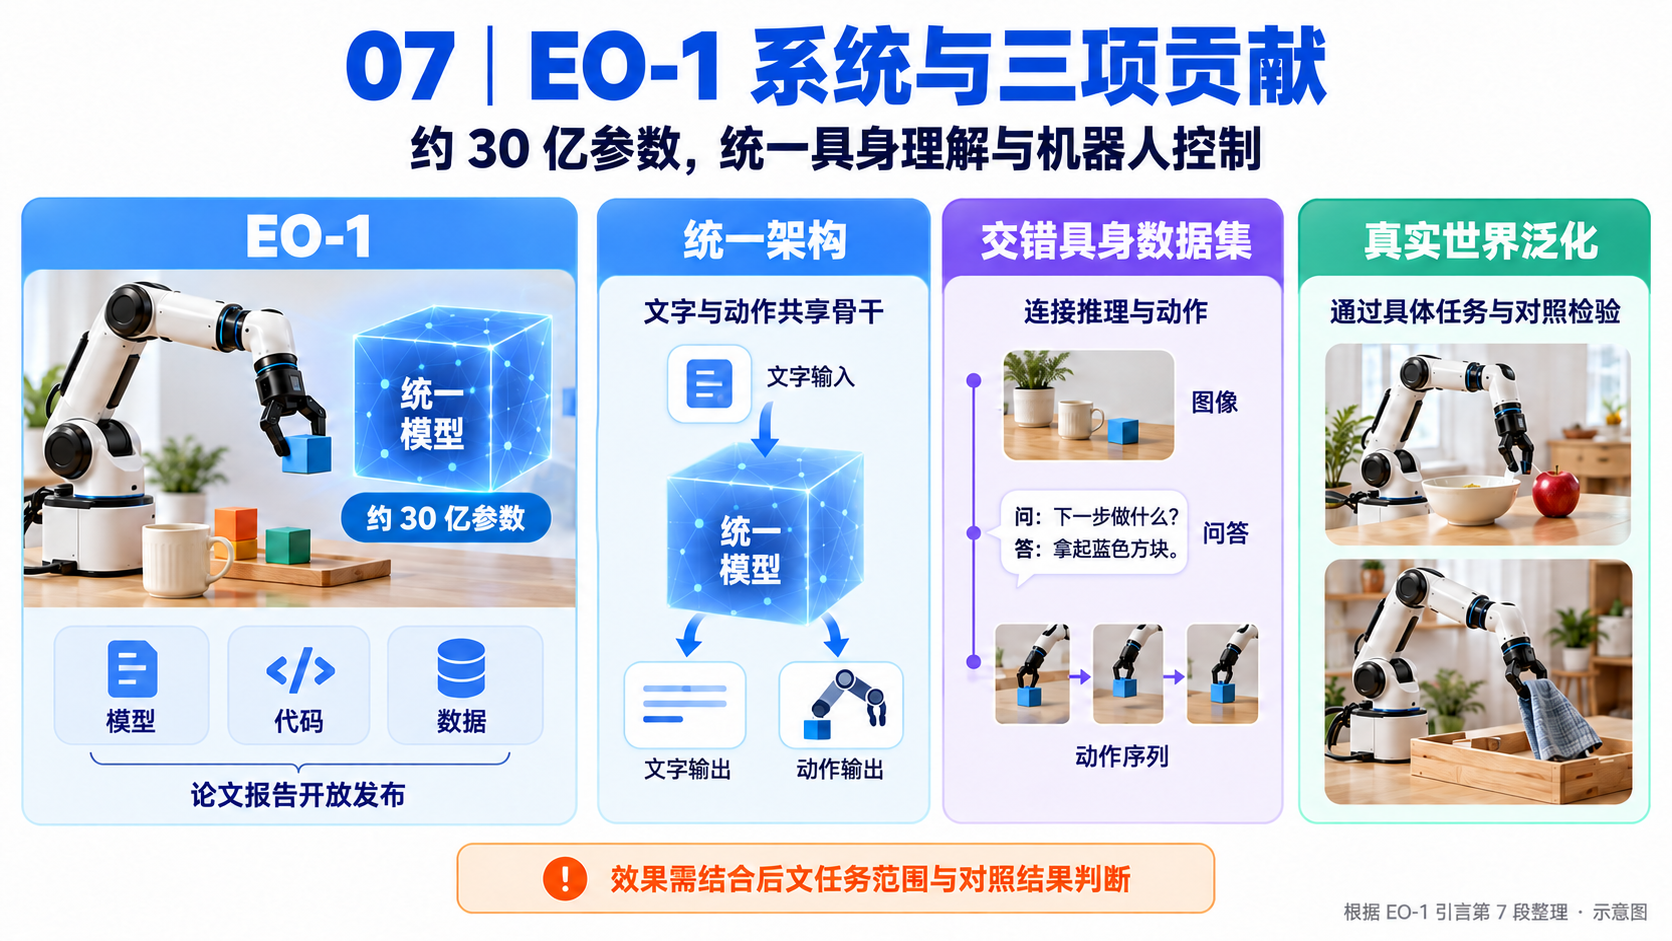
本文介绍 EO-Robotics,包括 EO-1 模型与 EO-Data1.5M 数据集。EO-1 是一个统一具身基础模型,通过交错的视觉-文本-动作预训练,提升多模态具身推理和机器人控制表现。其开发建立在两个支柱上:能够统一处理图像、文本、视频和动作输入的架构,以及强调交错视觉-文本-动作理解、包含超过 150 万个样本的大规模高质量具身推理数据集 EO-Data1.5M。
EO-1 在 EO-Data1.5M 上结合自回归解码(Auto-regressive Decoding)与流匹配去噪(Flow Matching Denoising)进行训练,使机器人动作生成与多模态具身推理自然衔接。广泛实验通过多种机器人形态上的长程、灵巧操作任务,验证交错学习对开放世界理解和泛化的有效性。论文介绍模型架构、数据构建策略与训练方法,为具身基础模型开发提供参考。
批注
-
改变的是推理与动作的连接方式。 模型不仅接受“图像+指令”后输出动作,还学习动作之后如何根据新画面继续判断。
-
架构和数据缺一不可。 网络需要同时支持文字与连续动作,数据则需要提供二者前后衔接的示例。
-
“超过 150 万”指数据集总体。 不能理解为全部样本都包含完整交错动作序列;正文另报告约 12.2 万条交错视觉-文本-动作数据。
-
有效性限定在实验范围内。 多平台、多任务结果支持该路线,但不能直接等同于人类水平或任意场景下的通用能力。
引言与相关工作:为什么需要交错学习
按原文七个正文段落拆解
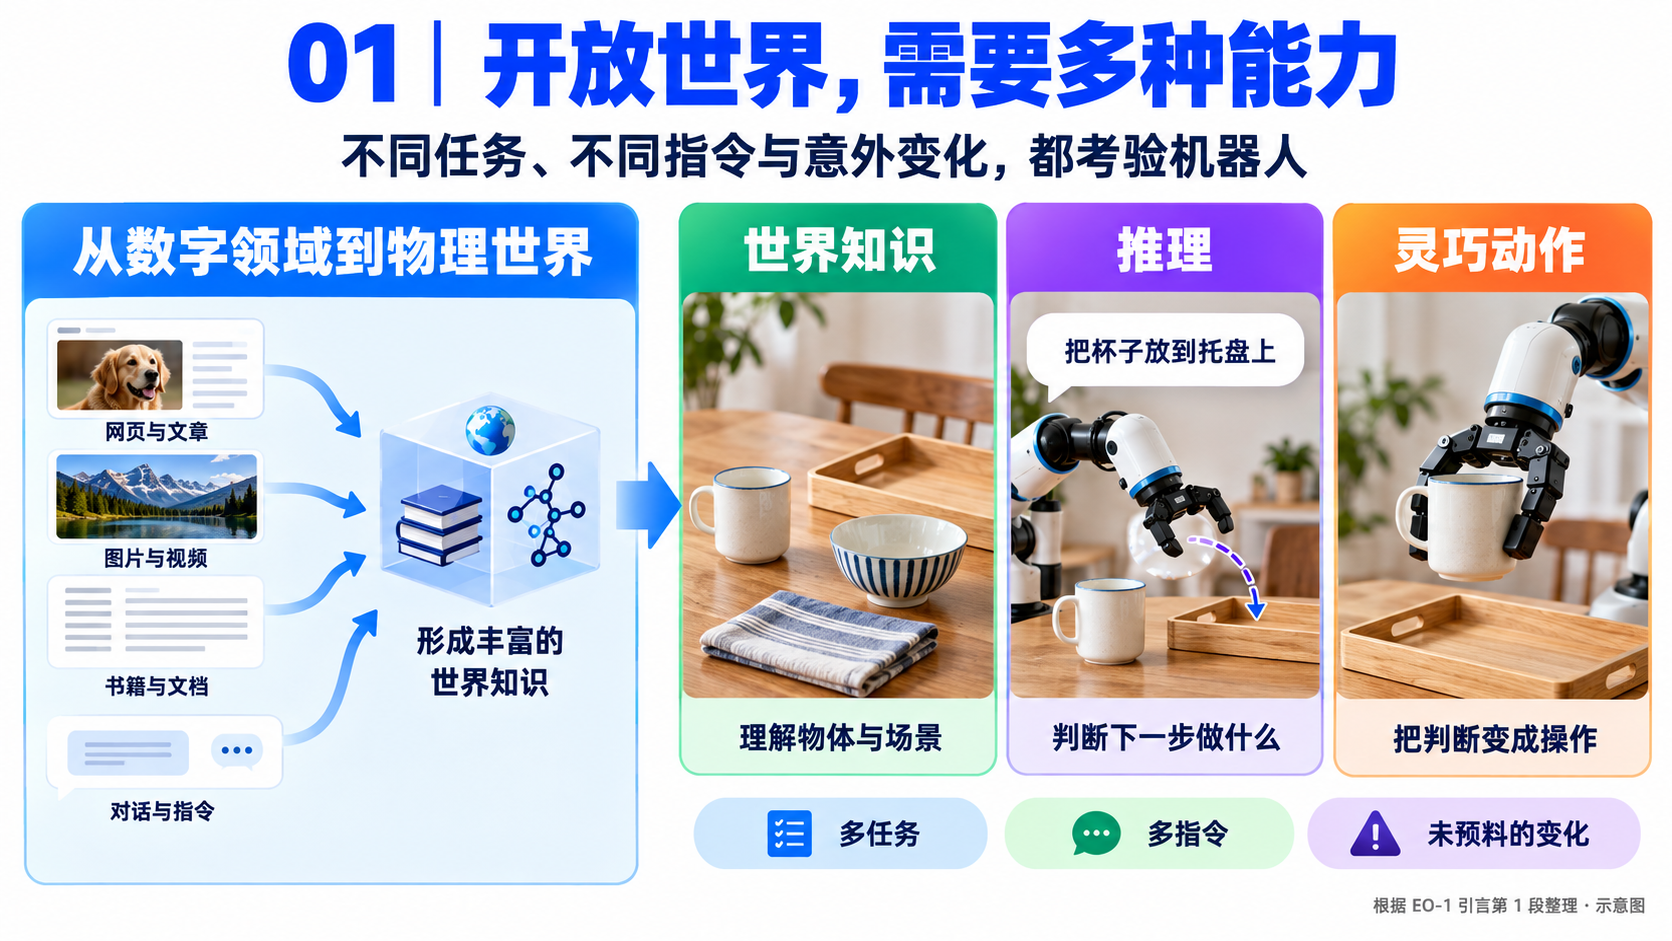
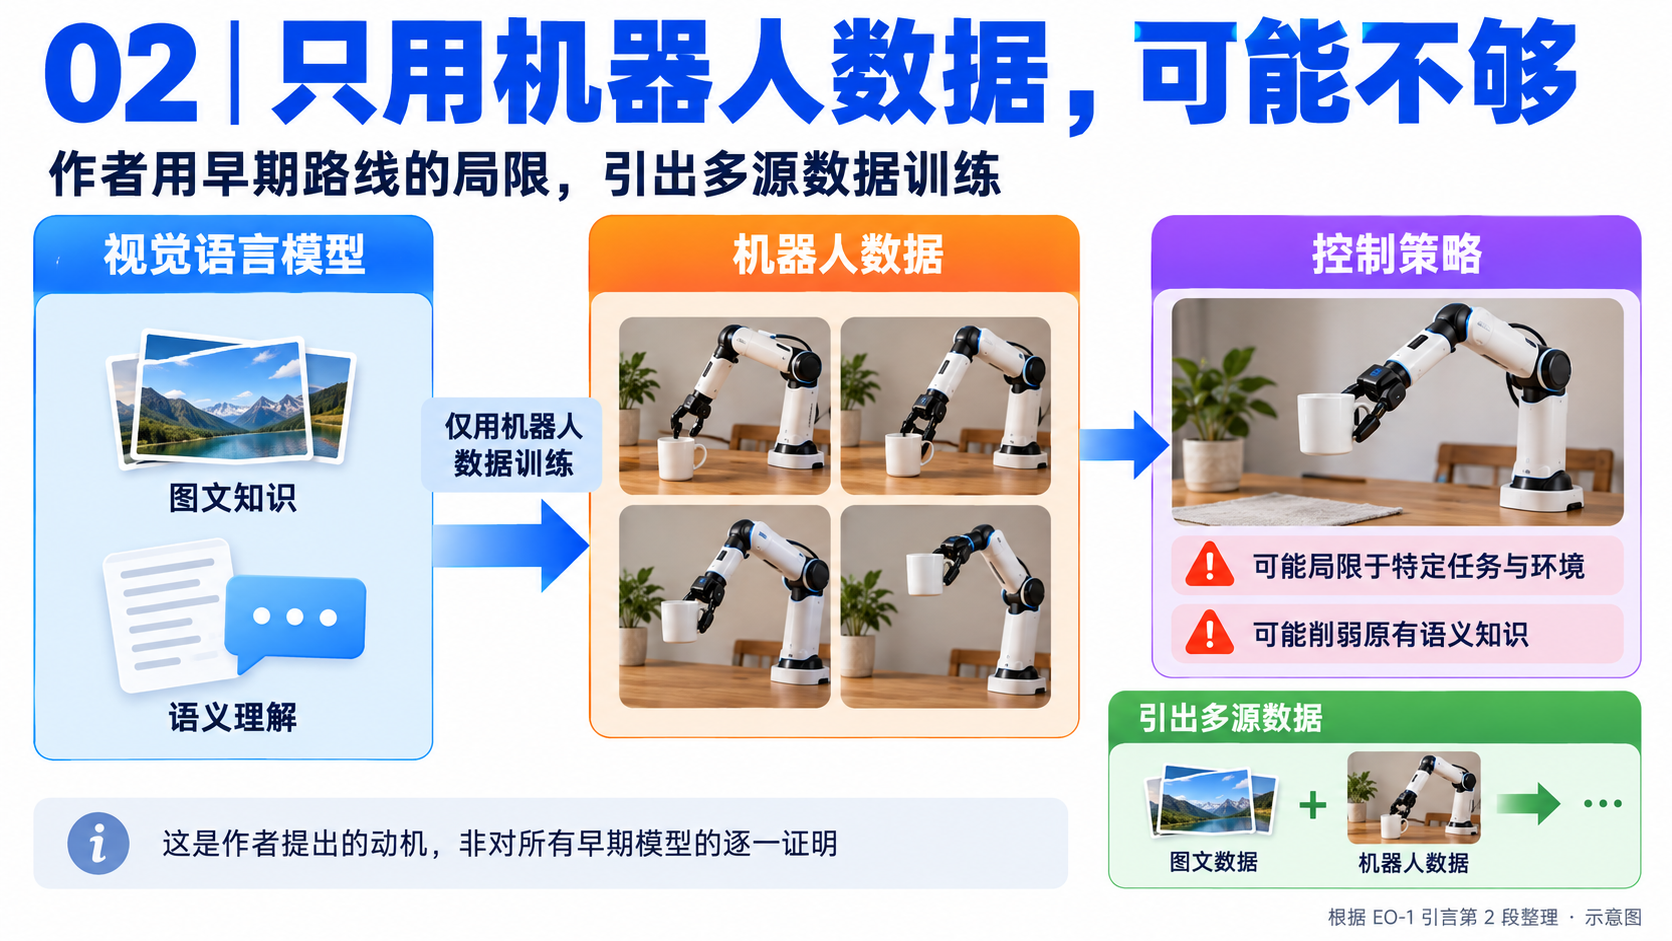
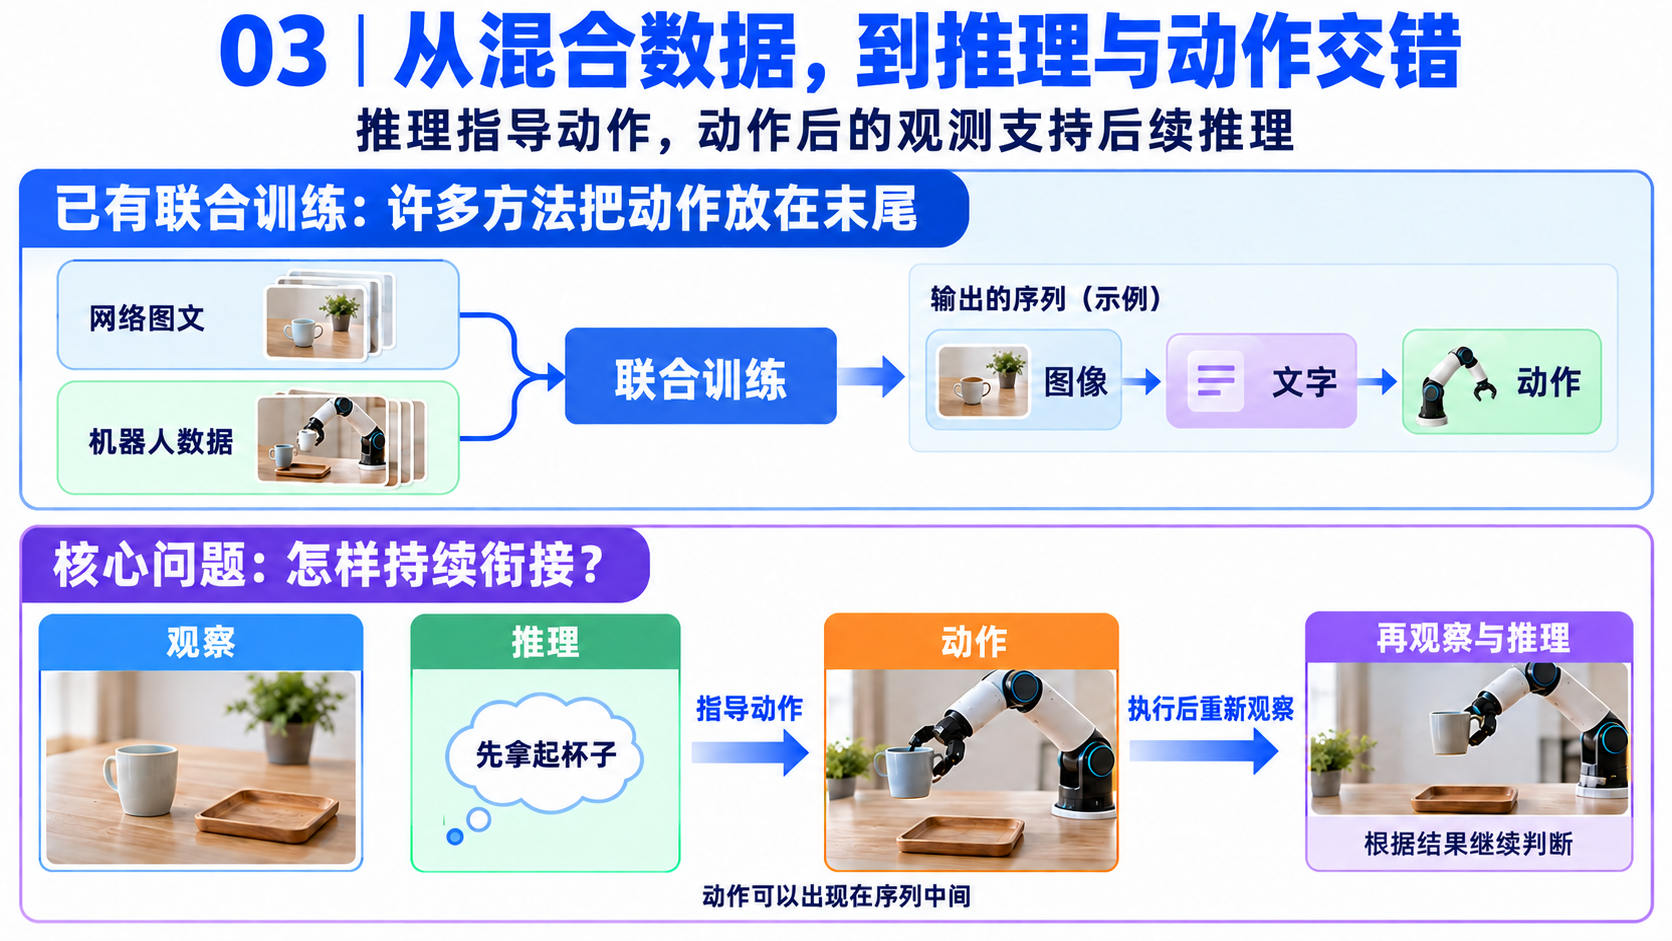
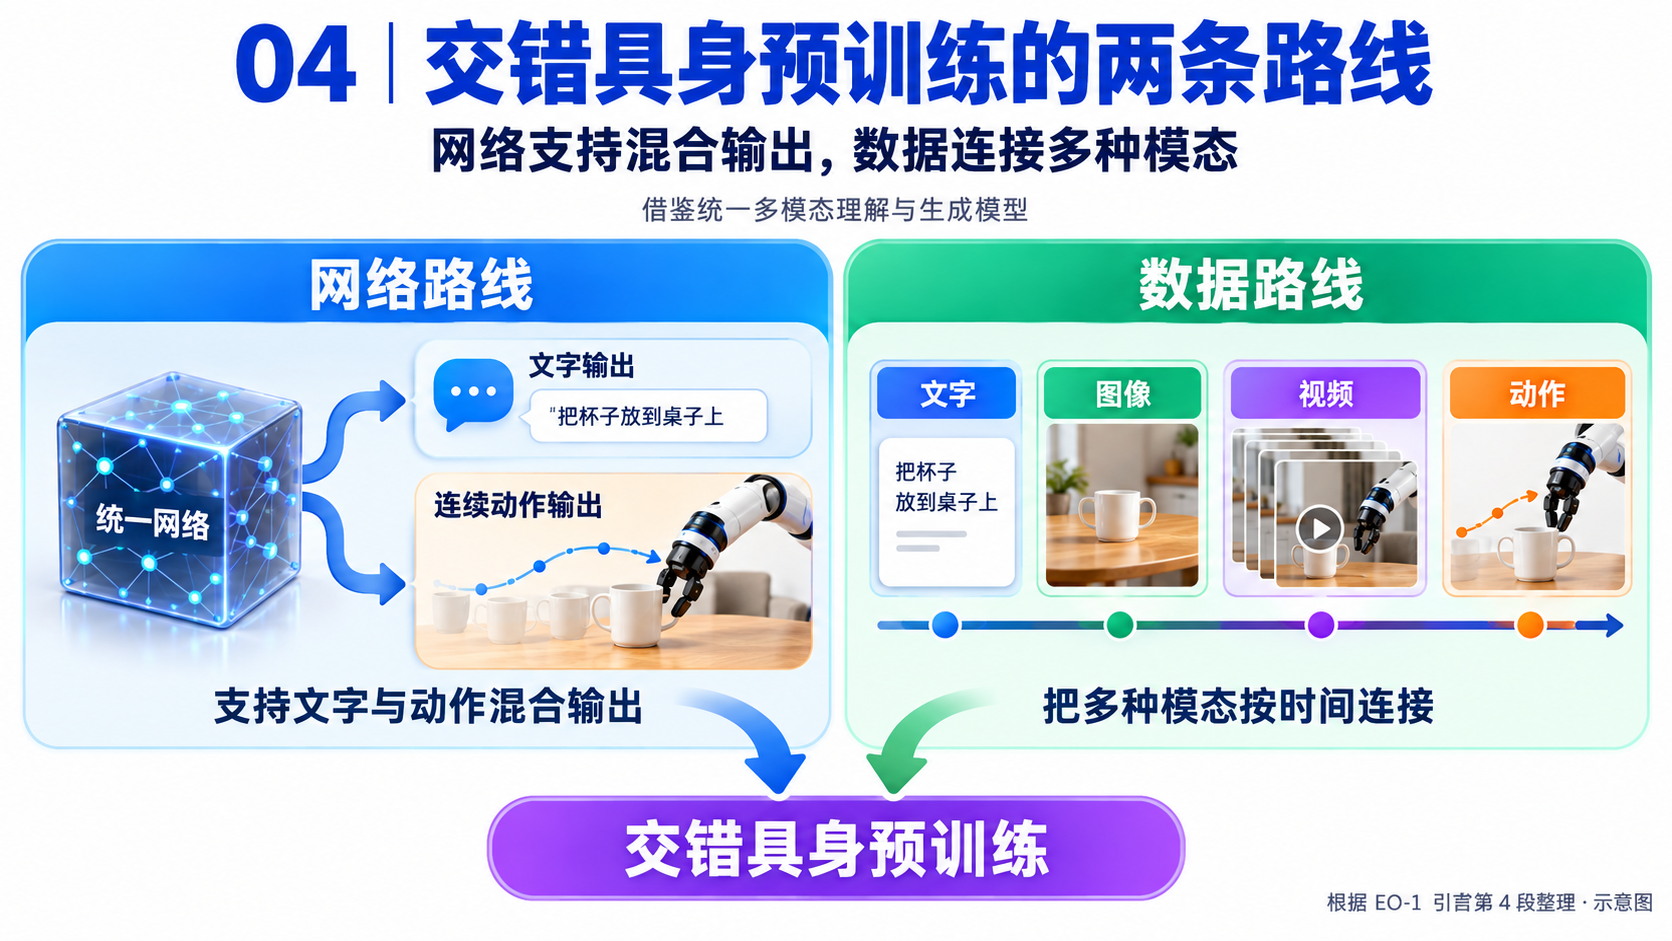
与已有工作的关系
核心方法:一个骨干,两种输出
共享的是网络,保留的是不同模态的接口
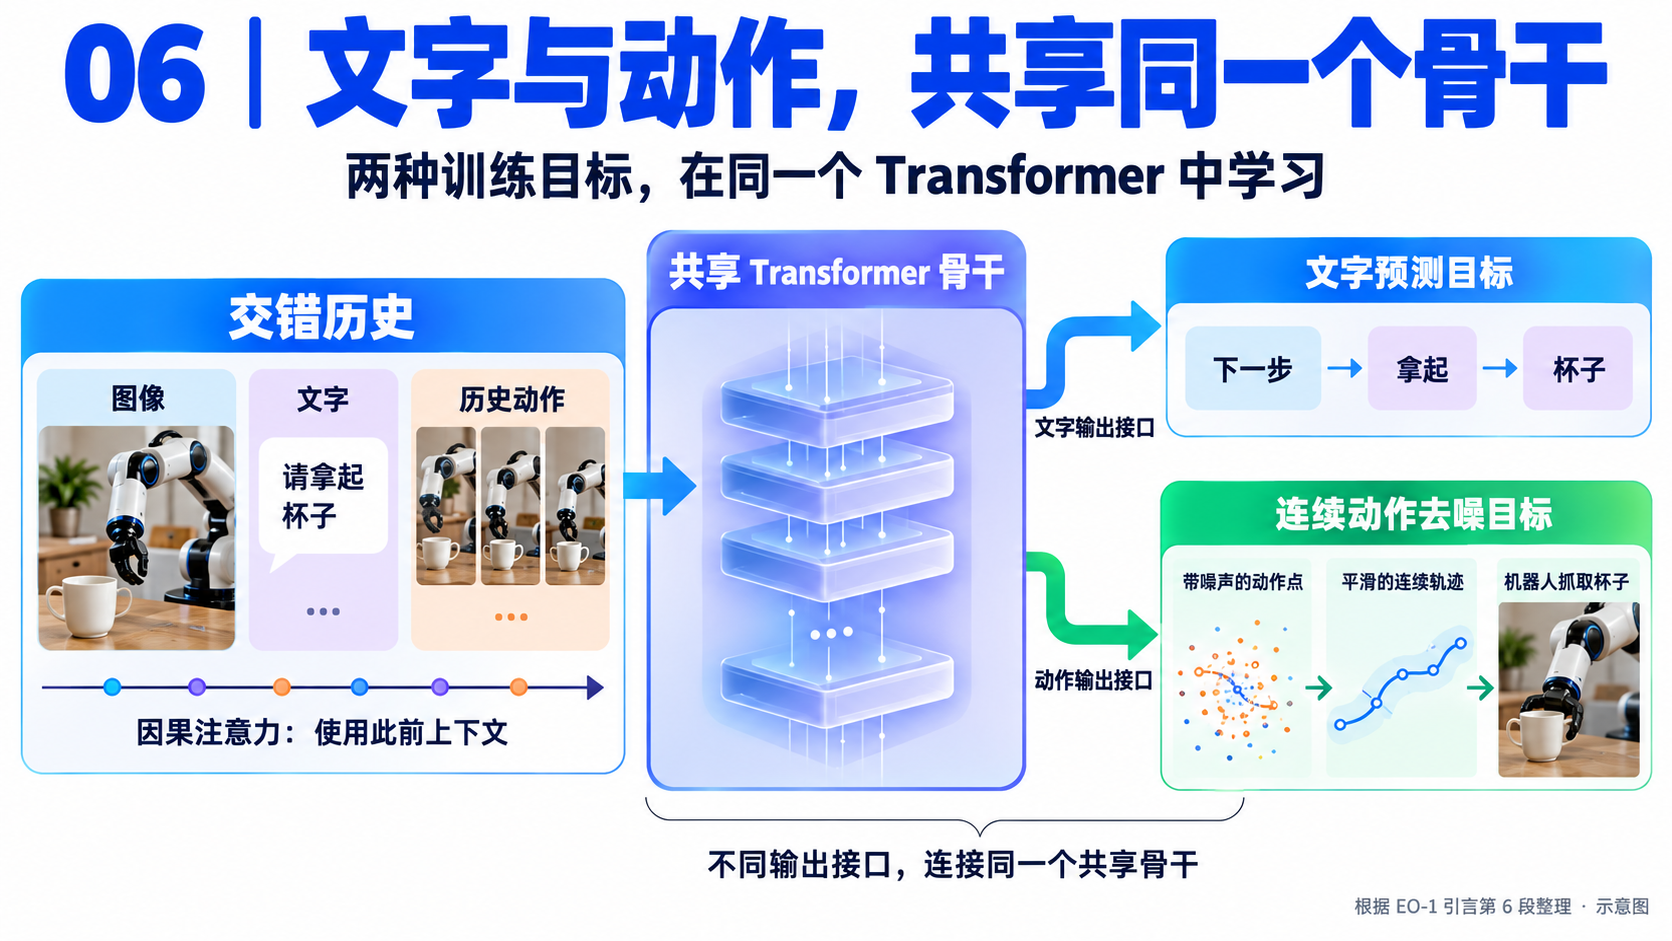
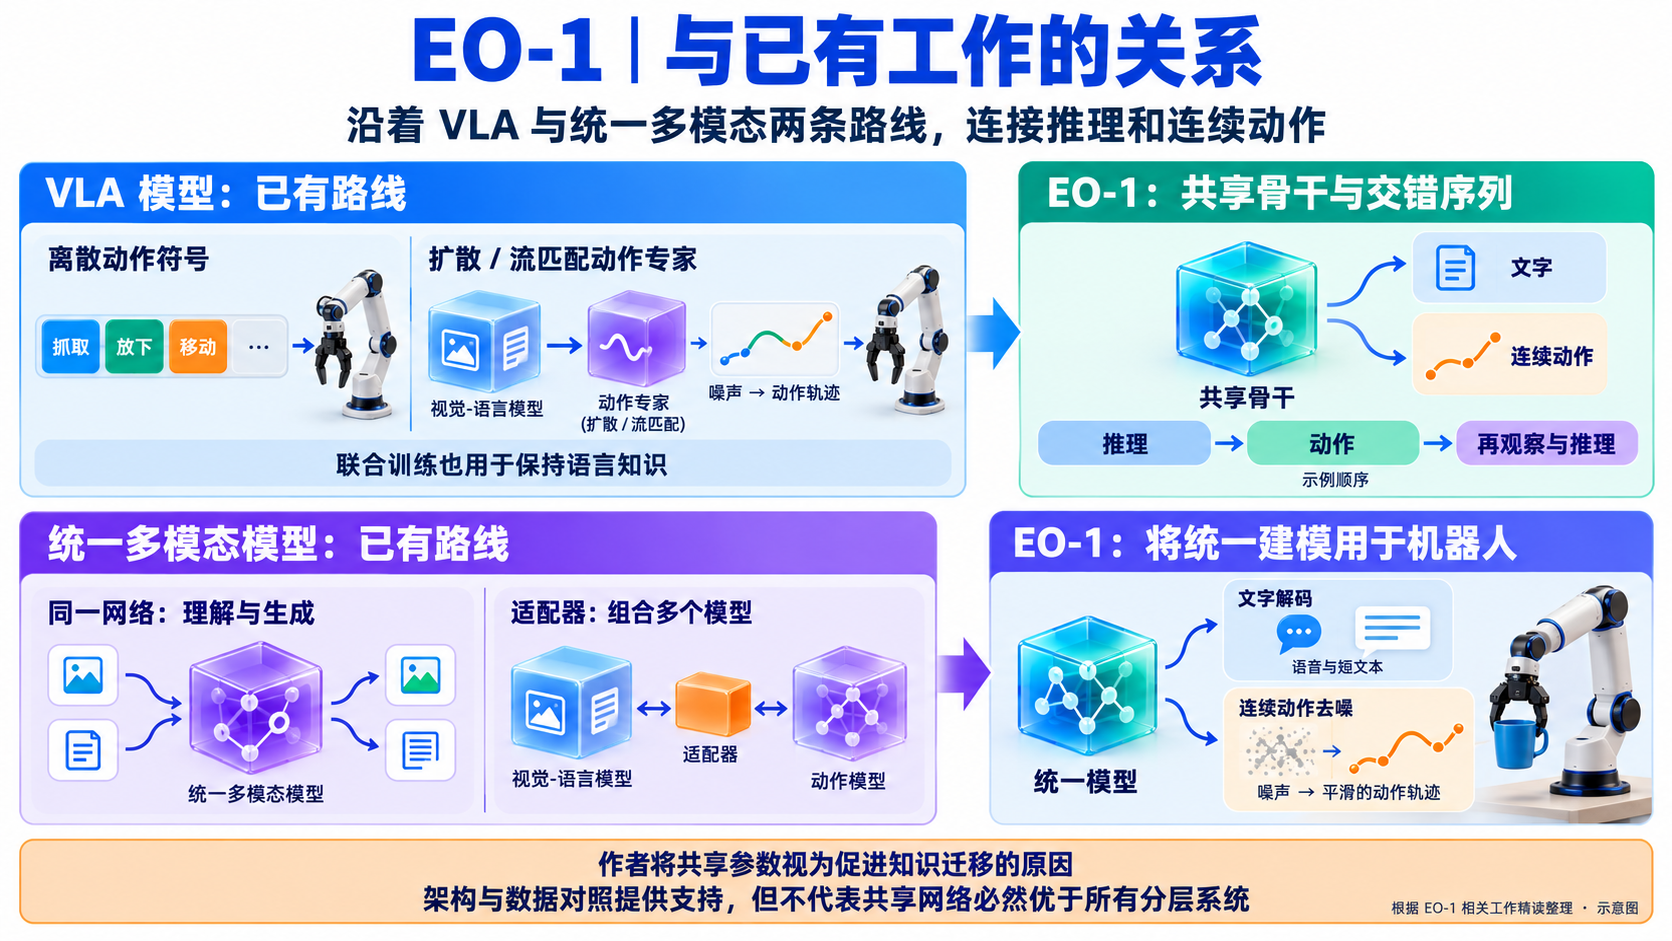
文字回答“做什么、为什么”,机器人动作回答“怎样运动”。二者表示不同,但都需要理解相同的物体、目标与任务进度。EO-1 的直觉是让它们使用同一个预训练骨干,减少规划与控制之间的信息割裂。
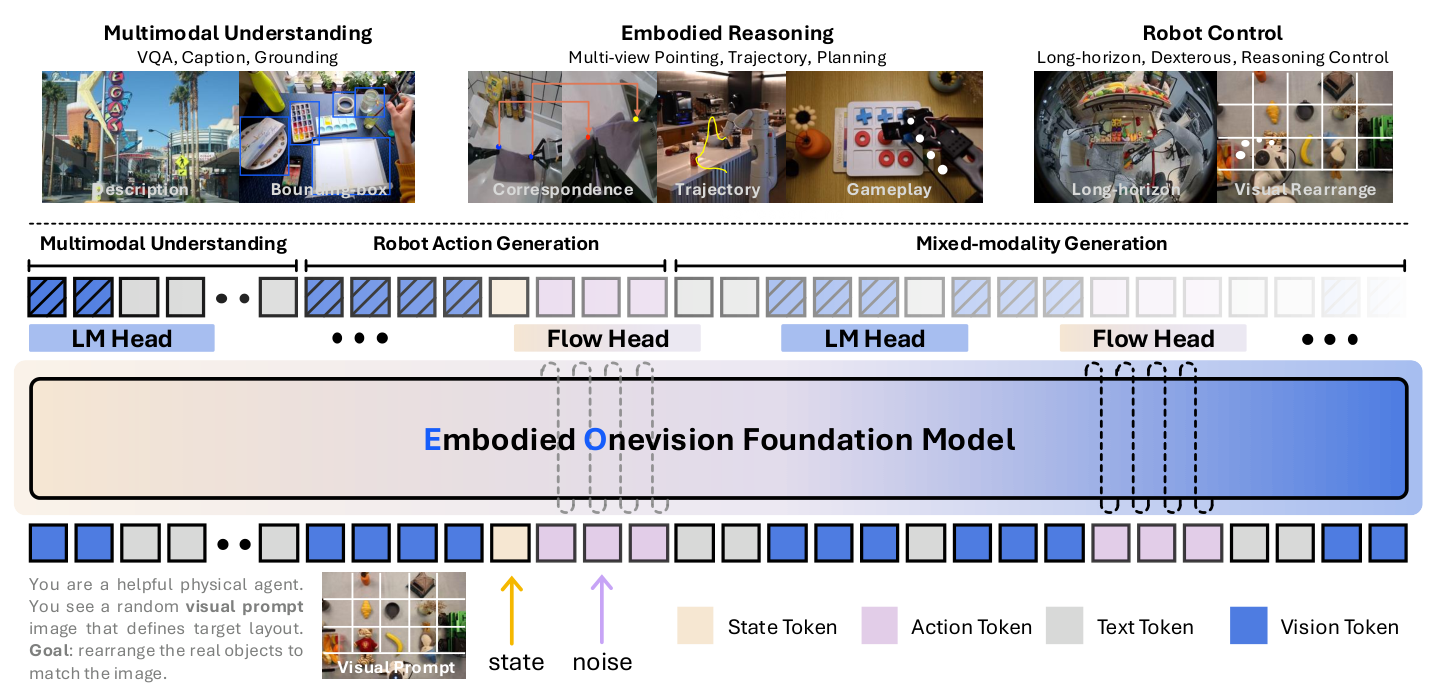
原文: EO-1 使用由 Qwen2.5-VL 初始化的仅解码器 Transformer(Decoder-only Transformer)。图像与视频沿用视觉编码器,文字沿用文本分词器;机器人状态与带噪动作通过投影进入同一特征空间。
词元(Token)在这里是模型处理的序列单元,并非全部都是离散单词。视觉、状态与动作 token 可以是连续特征向量。
| 原始输入 | 编码方式 | 进入骨干后的表示 |
|---|---|---|
| 多视角图像、视频帧 | 预训练视觉编码器 | 视觉特征序列,每个特征宽度为 D |
| 指令与推理问答 | 文本分词器与嵌入层 | 文字特征序列,每个特征宽度为 D |
自身状态 qₜ | 状态投影 | 将 d_q 维状态映射到 D 维特征 |
带噪动作块 Xτ 与去噪进度 τ | 动作输入投影 | 动作特征序列,特征宽度为 D |
D 是共享骨干的特征宽度,d_q 是平台状态维度。论文没有统一列出所有平台的状态、动作维度及完整 token 数,表中保留符号,不补写固定数值。
骨干输出随后分流:语言建模头(Language Modeling Head,LM Head) 预测下一个文字 token;流匹配头(Flow Head) 将对应隐藏特征映射为连续动作的更新量。机器人最终得到的动作块形状为 16 × d_a,d_a 是平台动作维度。
最小形状例子: 假设某平台动作有 7 维,则动作输出是 16 × 7,共 112 个数;这是解释性假设,不是 EO-1 对所有机器人的配置。D 维特征通过输出映射回 d_a 维,不能把两种维度直接相加。
注意: 论文所说“不增加动作专用参数”,应结合其结构理解为没有另外增加一套动作专家骨干。状态投影、动作输入映射和动作输出头仍包含参数,不能理解成“接入动作完全不需要新参数”。
文字逐个生成,动作整块去噪
自回归生成像逐字写答案:根据已经看到和生成的内容,预测下一个文字 token。其条件关系可写成:
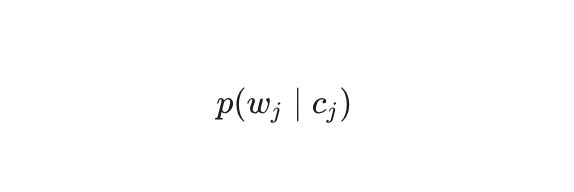
w_j 是第 j 个文字 token,c_j 是它之前的多模态上下文。解释性例子: 已生成“下一步拿起”后,模型继续预测“番茄”;它也可以读取之前的图像和动作历史。
动作则通过流匹配(Flow Matching)生成。解释: 先给出一个随机数数组,再让模型多次预测该怎样调整,最终得到整段动作。每次更新处理整块动作,并不是逐个文字 token 拼出控制数值。
训练时,论文将真实动作与高斯噪声混合:
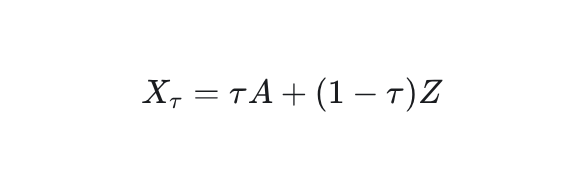
A 是真实动作块,Z 是同形状的标准高斯噪声,二者均为 16 × d_a 数组;τ∈[0,1] 是去噪过程的内部进度,不是机器人运动的秒数。τ=0 时输入全是噪声,τ=1 时输入为真实动作;原文从偏重较噪阶段的 Beta 分布采样 τ。
最小数值例子: 只取一个元素,令 A=0.6、Z=−0.2、τ=0.5,则 Xτ=0.2。这说明训练中模型看到的是处于噪声与真实动作之间的中间值,而不是直接读取完整答案。
训练目标,按原论文式(2)保留:
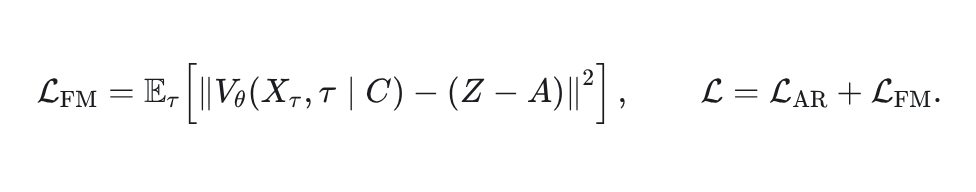
Vθ 是共享模型及流匹配头预测的更新场,θ 是可训练参数,C 是当前动作之前的多模态上下文;平方范数衡量整个数组的预测误差,期望表示对采样进度求平均。L_AR 是预测正确文字 token 的交叉熵损失,两项权重均为 1。上例中原文动作目标 Z−A=−0.8。
推理过程,按原论文式(1)保留:
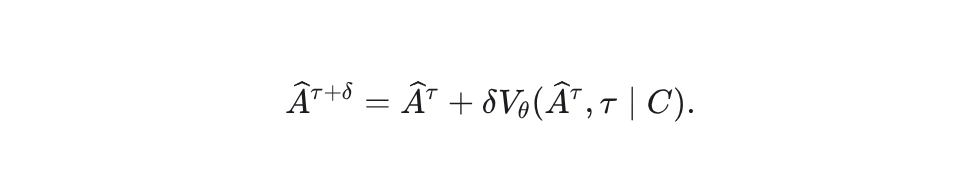
Âτ 是当前动作估计,初值是新采样的噪声;δ 是内部积分步长。原文称从 τ=0 积分到 1,实现采用 10 次去噪更新。解释性例子: 若采用十次等步长更新,则 δ=0.1;它是内部生成步长,不是动作执行周期。
注意:原文存在方向不一致。 上述线性路径随 τ 增大的导数是 A−Z,但式(2)将目标写为 Z−A,式(1)又使用正号更新。按这三处文字直接组合,方向无法一致:上例前向路径应增加 0.8,原文目标却为 −0.8。本文保留原式并指出差异;复现时需核对实现中的时间或更新符号约定,不能据此断言实际训练错误。
交错序列:动作之后还有新的判断
普通动作预测样本可以写成:
图像 → 任务文字 → 自身状态 → 动作块
EO-1 进一步训练如下时间结构:
当前图像 → 规划问答 → 自身状态 → 动作块
→ 新图像 → 完成情况问答 → 下一步规划 → 下一动作块
原文: 图像、文字、状态和动作使用各自的开始与结束标记,例如 [BOI]/[EOI] 标记图像、[BOR]/[EOR] 标记状态、[BOA]/[EOA] 标记动作。因果注意力(Causal Attention)让后续生成依赖此前上下文,而不是未来答案。
解释性例子: “番茄放进袋子”之后的新画面可能显示番茄仍在夹爪里。模型可以据此判断放置尚未完成,再生成下一段动作。这里解释的是反馈结构;是否稳定纠错仍需具体实验,不能仅由数据格式推出。
EO-1 只生成文字和动作,不预测下一幅相机画面,也不生成自身状态。新图像与状态由真实环境提供;支持交错模态也不意味着每个控制点都必须先输出一段文字。
交错校正采样:历史动作干净,当前动作加噪
仅把问答和动作串起来仍有问题:训练当前动作需要加入噪声,但后面的文字应当依据之前已完成的动作。若历史动作仍被噪声污染,后续问答读到的上下文就与执行后的历史不同。
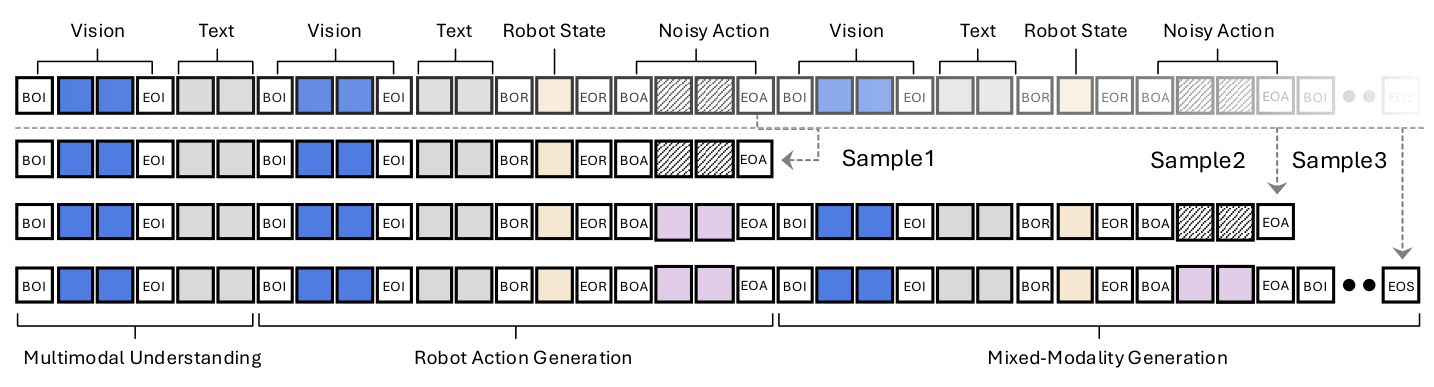
原文: 交错校正采样(Interleaved Rectifying Sampling)以动作生成片段为边界,将含 N 个动作片段的交错序列拆成 N+1 个训练子序列。中间已经成为历史的动作使用干净值,当前需要生成的动作保留噪声。
最小例子: 设原序列包含两段动作:
图像₁/文字₁ → 动作₁ → 图像₂/文字₂ → 动作₂ → 图像₃/文字₃
则 N=2,对应三个前缀样本:
| 样本 | 使用的上下文与训练目标 |
|---|---|
| Sample1 | 图像₁/文字₁ → 带噪动作₁;训练动作₁去噪 |
| Sample2 | 图像₁/文字₁ → 干净动作₁ → 图像₂/文字₂ → 带噪动作₂;训练后续文字和动作₂ |
| Sample3 | 前两段动作均为干净历史,再学习末尾文字₃ |
动作片段既在自身生成位置获得去噪监督,也在后续预测中作为干净上下文参与梯度传播。这样,模型学到的不只是怎样生成动作,还包括怎样利用动作历史继续推理。
边界与代价: 该策略涉及重复处理多个序列前缀;论文未单独报告其计算开销,也没有给出移除该策略的独立消融。训练时干净历史来自记录数据,部署时历史可能包含模型误差,采样校正不能自动消除这种差异。它也不是 ACT 的时间集成或相邻动作平滑。
把训练与推理完整串起来
训练时: 多源图文、机器人记录与交错序列 → 编码各模态 → 对当前动作加噪、历史动作保留干净值 → 共享骨干 → 文字交叉熵与动作流匹配损失 → 联合更新参数。没有动作的问答样本只提供相应文字监督。
推理时: 相机画面、指令、自身状态及已有上下文 → 共享骨干生成所需文字 → 新噪声经 10 次更新得到 16 步动作块 → 控制系统执行 → 新观测进入后续上下文。键值缓存(Key-Value Cache,KV Cache)用于复用已有上下文计算,不代替重新观察。
正文报告预训练 5 轮、平均打包序列长度 16,384、batch size 为 1;语言模型及多模态投影学习率为 5×10⁻⁵,视觉编码器为 1×10⁻⁵。它们是该实验的实现设置,不是方法对所有平台的通用最优值。
EO-Data1.5M:把操作记录变成推理与动作的共同教材
三类数据各自提供什么
| 数据类别 | 正文表 1 报告的规模 | 提供的监督 |
|---|---|---|
| 网络多模态数据 | 570 万样本,71 亿 token | 图文问答、视频理解、物体定位等 |
| 机器人控制数据 | 120 万条操作轨迹,1,273 亿 token | 不同机器人上的连续操作 |
| EO-Data1.5M 具身数据 | 150 万样本,10 亿 token | 空间、时间、物理与任务推理,以及交错操作 |
注意: 轨迹、问答样本和 token 是不同统计单位,不能把表中的数字直接相加成“操作次数”。EO-Data1.5M 也不是全部训练数据,其完整交错序列只是其中一部分。
数据管线:先保留多样场景,再补充推理
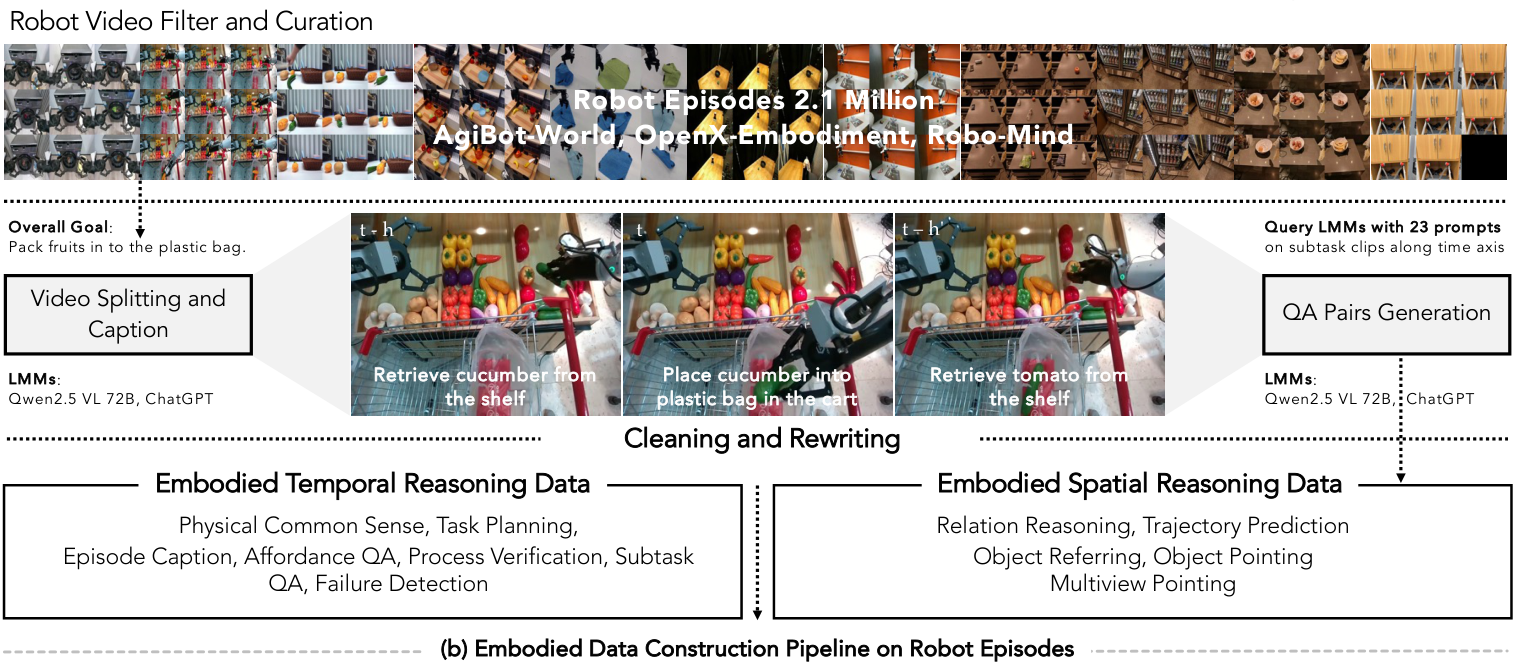
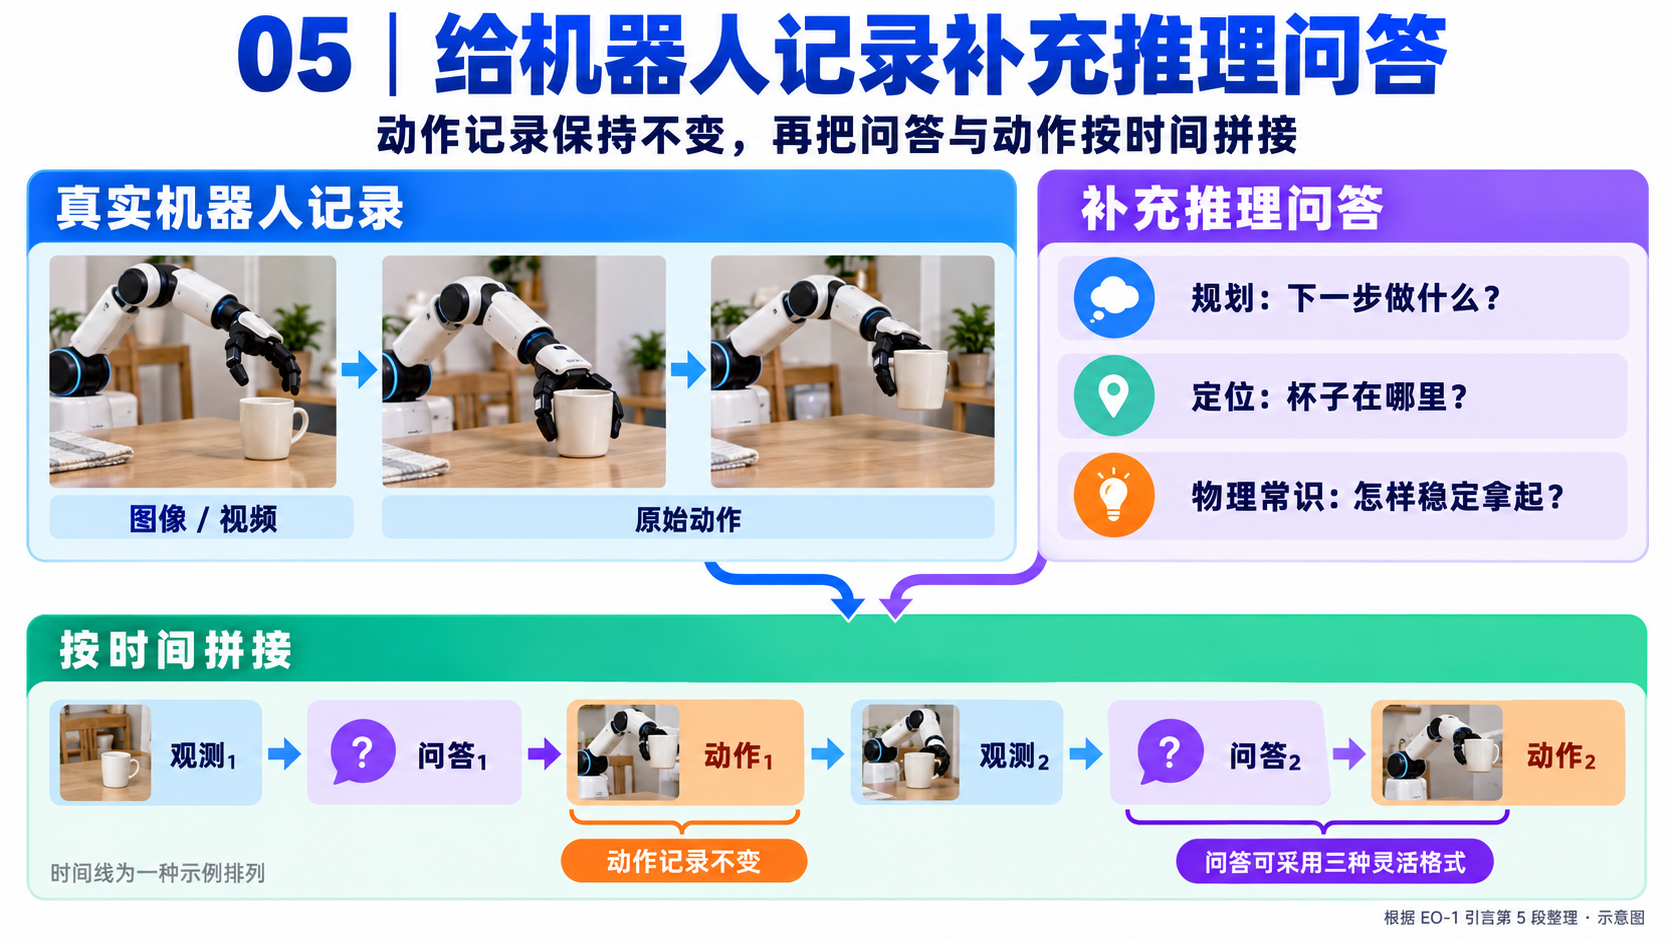
原文: 首先提取视频视觉特征并聚类,按簇采样、人工检查,以减少固定场景的重复。然后将视频分成子任务片段,用模型和人工生成动作描述,再根据模板构造问答;模型产生候选答案,人工选择或改写,最后做规则清洗与语言改写。
时间推理包括物理常识、任务规划、视频描述、可供性问答(Affordance QA,即某动作能否或如何实施)、过程验证、子任务问答和失败检测;空间推理包括关系判断、轨迹预测、物体框选、物体指点和多视角指点。
解释: 同一条抓取记录由此可以回答“抓哪个”“从哪里接近”“刚才放好了吗”。但标注来自已有示范,不能理解成机器人探索了这些问题中的全部可能动作。
三种交错格式怎样连接问答与动作
| 格式 | 连接方式 | 学习重点 |
|---|---|---|
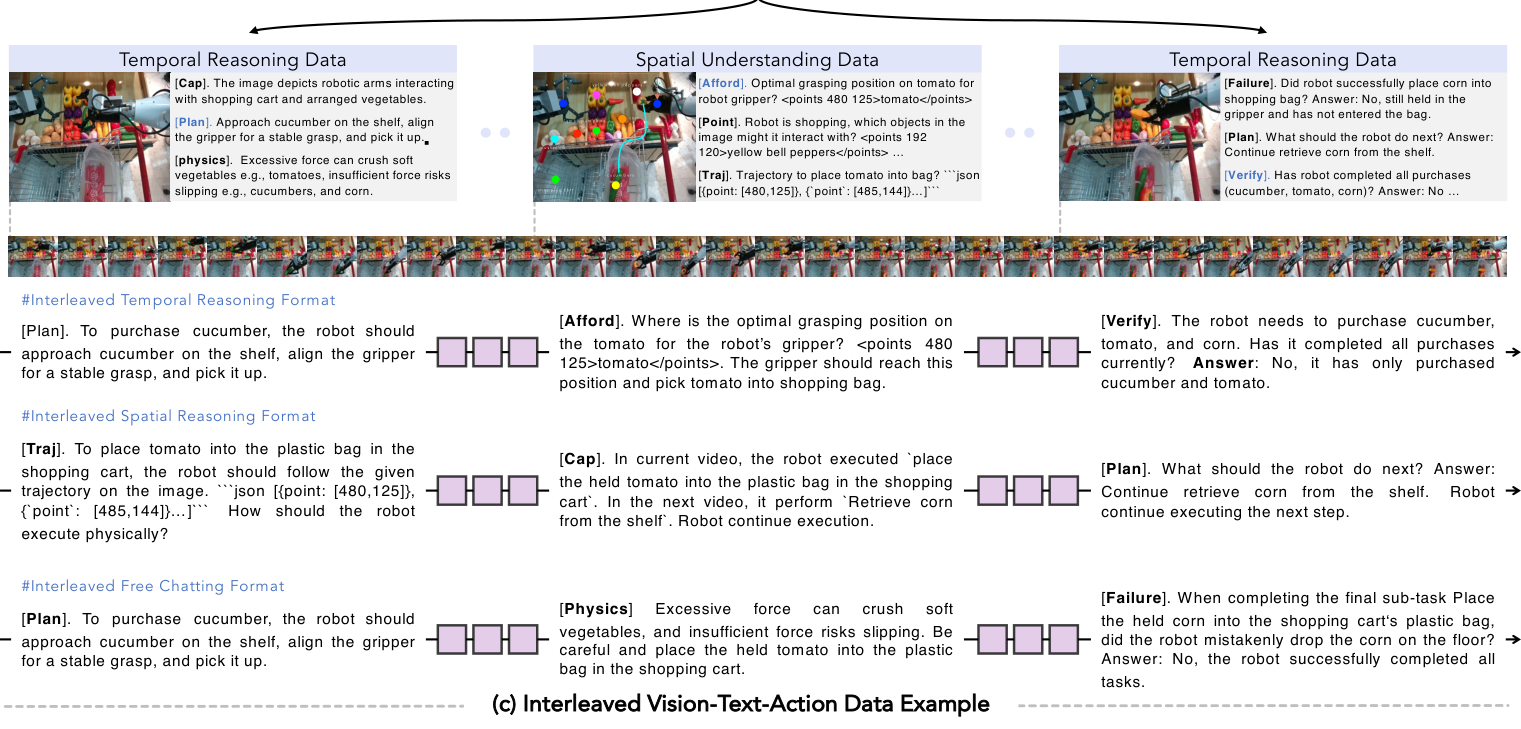
| 时间推理 | 当前图像 → 下一子任务问答 → 将回答写入指令 → 动作 → 新图像与完成验证 | 该做什么、做完没有 |
| 空间推理 | 当前图像 → 轨迹预测问答 → 将轨迹写入指令 → 动作 → 新图像与验证 | 怎样把空间目标落实为运动 |
| 自由问答 | 当前图像 → 其他推理问答 → 原任务指令 → 动作 → 后续验证 | 在控制上下文中保持多种推理能力 |
空间格式中的轨迹回答是一组图像平面的 [x,y] 坐标,不是可以直接发送给机械臂的关节命令。例如 (480,125) → (485,144) 描述图像上的路径变化;真正怎样运动仍由连续动作生成部分学习。
正文报告约 12.2 万条交错视觉-文本-动作数据。注意: 本版本各处统计并不完全一致:表 1 的网络样本为 570 万,附录表 6 汇总为 620 万;图 3(a) 空间理解标为 37.6 万,正文 3.2.1 又写为 150 万。因此这里按来源分别引用,不把各分项拼成一个未经确认的总量。
实验:哪些证据支持作者的主张
推理能力与控制能力分别评估
训练损失表示拟合情况;问答成绩、仿真成功率与真实任务完成度表示不同能力,不能互相替代。
| 评测 | EO-1 结果 | 对照与含义 |
|---|---|---|
| RoboVQA,BLEU-4 | 58.5 | Qwen2.5-VL 3B 为 55.9;衡量回答与参考文本的匹配 |
| ERQA,准确率 | 45.5% | Qwen2.5-VL 3B 为 35.3%,Gemini 1.5 Flash 为 46.3%;EO-1 并非领先所有对照 |
| EO-Bench,空间/时间得分 | 36.4/38.9 | Qwen2.5-VL 3B 为 20.0/22.6;任务相关推理改善,但仍有较多错误 |
| LIBERO,平均成功率 | 98.2±0.3% | π0 为 94.2±0.9%,OpenVLA-OFT 为 97.1±0.6% |
| SimplerEnv,WidowX/Google VM/Google VA | 72.7%/76.5%/63.0% | π0 为 69.2%/71.4%/54.7%;分别提高 3.5/5.1/8.3 个百分点 |
来源:原论文表 2、3、4,第 13–14 页。上述模型名称与版本沿用论文记录;不同指标不可直接求出一个统一“机器人能力分数”。
注意: EO-Bench 的题数也有口径冲突:3.3 节写 648 道,列出的四类数量合计 642 道;4.2 节写 700 道且均匀分布。因此不据这些数字推算显著性或每类具体样本量。
真实机器人测试了什么
论文的 28 个任务设置分为四组:Franka Panda 抓取放置 7 个、WidowX 250 S 开箱测试 13 个、AgiBot G-1 长程灵巧操作 4 个、具身推理控制 4 个;涉及的机器人还包括 SO100。
模型接收多视角画面、自身状态和指令,再输出动作给执行系统。附录表 6 报告的训练数据配置包括:AgiBot 的自视角与左右视角、30 FPS;DROID 的左右与腕部视角、15 FPS;SO100 的第三人称与腕部视角、30 FPS;IPEC-Franka 的第三人称与腕部视角、10 FPS。这些是数据来源配置,不能套成所有评估机器人的统一相机数或控制频率。
长程专项微调每任务使用 150 条示范、训练 25 轮;子任务与完整任务数据按 9:1 混合,每任务评估 10 次。原文报告各任务套件约 50 万帧、涉及 8 步,但未将其解释为统一的任务时长。
注意: 长程实验按子任务指令计算平均完成度,不等同于给一句总指令后整项任务独立完成的成功率;“开箱测试”也不表示预训练从未接触该机器人数据。
推理与动作结合,是否真的更有效
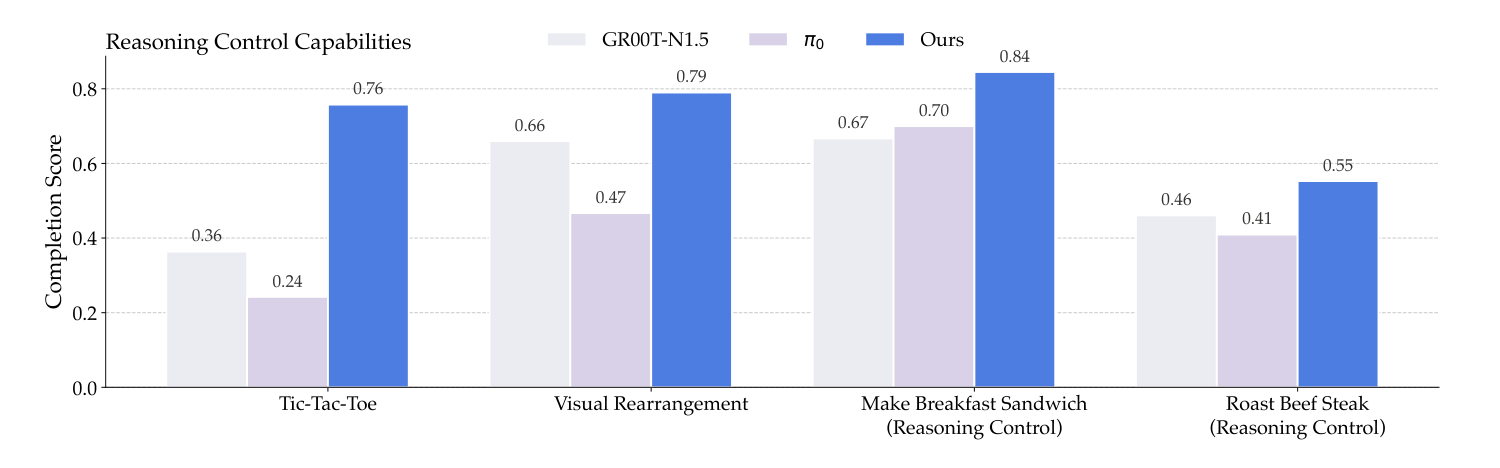
EO-1 在井字棋、按参考图重排物体、制作三明治和烤牛排上分别得到 0.76、0.79、0.84、0.55 的完成分数。井字棋对照为 π0 的 0.24 与 GR00T-N1.5 的 0.36,说明此设置下它更能结合局面判断与放置动作。
这些任务经过专项数据构建与微调:物体重排有 800 条示范,井字棋有 450 个数据样本。对照采用外部 GPT-4o 规划器配合控制模型,而 EO-1 使用统一解码器。因此结果支持整个训练与系统方案,不能仅归因于某一个网络组件,也不是新任务零样本学习的证明。
泛化改善在哪里,数据作用在哪里
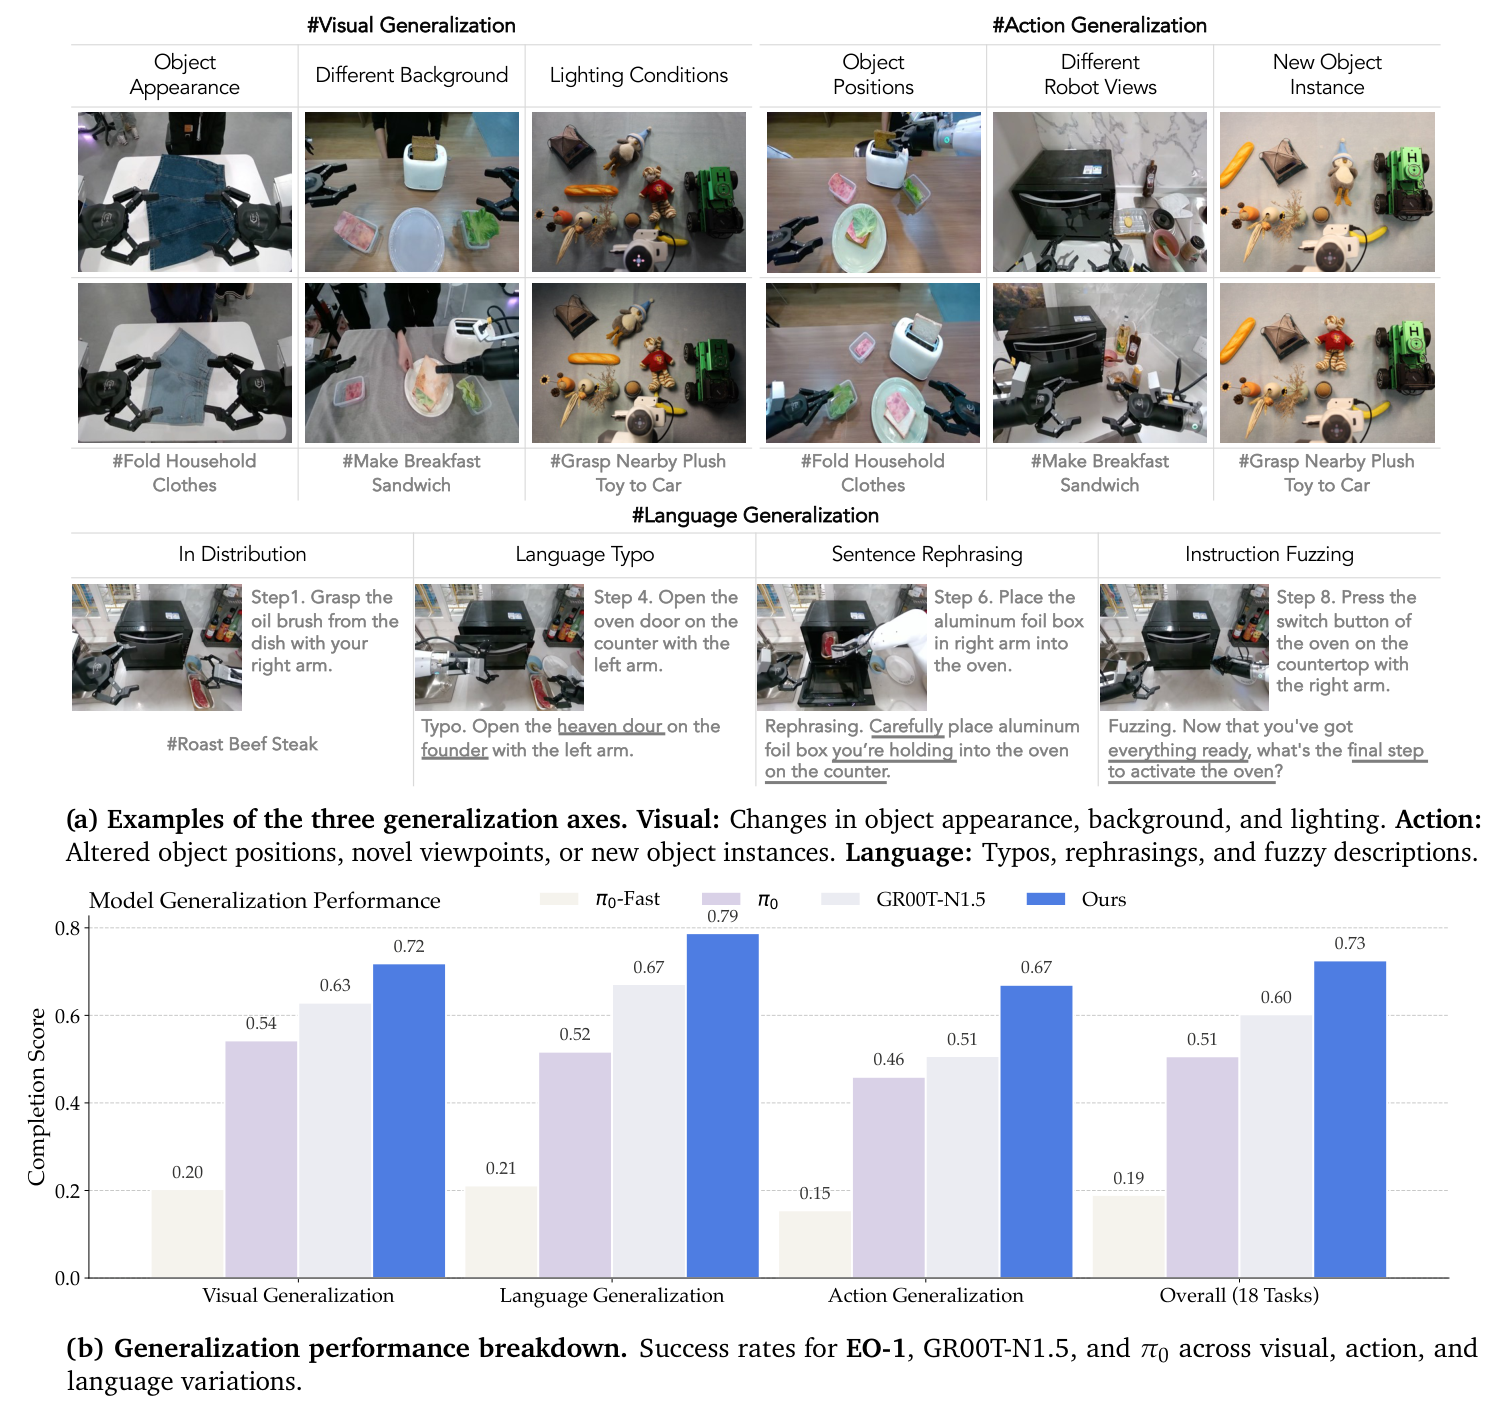
EO-1 在视觉变化、语言变化、动作变化下分别得到 0.72、0.79、0.67 的完成分数,总体为 0.73。其中动作变化主要指物体位置、机器人视角和新物体实例;它不等于能自动学会任意未见技能。正文与图示的任务总数不一致,故这里仅引用图 9 的结果,不将其“18 Tasks”当作全论文统一试验数量。
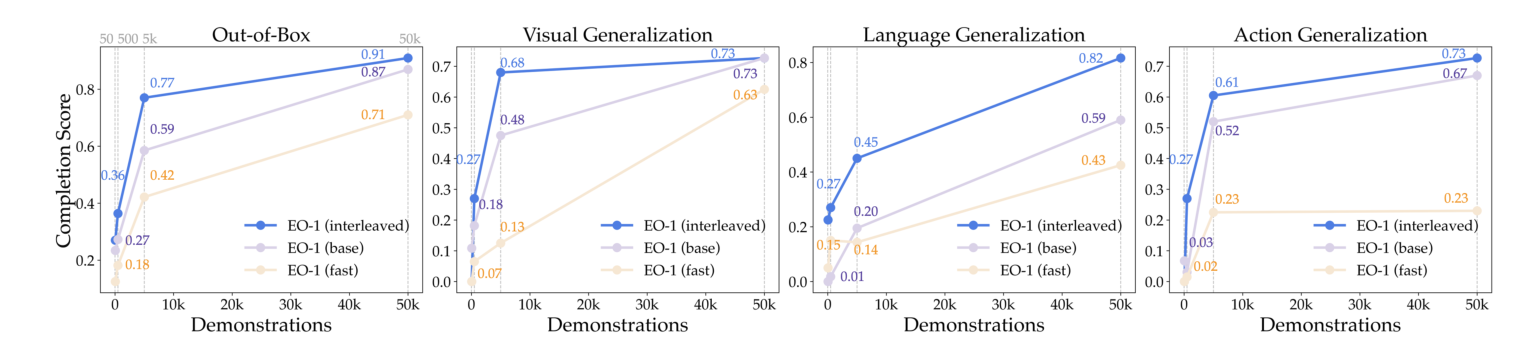
论文进一步比较四个配置:fast 使用 FAST 动作编码、完全自回归生成;base 使用共享骨干与连续流匹配,但只训练机器人控制数据;llava 增加通用图文指令数据;interleaved 增加相关交错数据。
表 5 给出两条重要证据:
-
连续动作生成有帮助: LIBERO 上
base为 98.2%,fast为 88.0%。这支持该设置下混合解码的优势,不代表所有离散动作方案都必然较差。 -
数据的相关性比“更多模态”更关键: WidowX 总体完成分数由
base的0.71提升到interleaved的0.80,加入通用图文数据的llava却为0.34。该组对照说明数据与控制任务的对齐很重要,不能推广成“网络数据总是有害”。
改善也有边界:AgiBot 三明治任务的动作泛化在 base 与 interleaved 中均为 0.75。交错标注没有自动补足有限操作示范未覆盖的动作变化。
如何理解这篇论文的结论
原文支持的核心结论: 在本文的训练与测试设置下,共享骨干结合交错具身数据,能够同时提升任务相关推理和连续操作表现。它把“推理指导动作、动作后继续判断”变成一个可训练的统一接口。
需要保留三条边界:
-
统一不等于完全可靠。 烤牛排等复杂任务的完成分数仍较低,EO-Bench 也未接近满分;导航、避障、复杂失败分析与人机协作仍被作者列为后续方向。
-
推理与运动没有实现任意并发。 作者将更高效架构与异步推理列为未来工作;交错序列表示前后依赖,不等于已经做到人类式同时思考与行动。
-
复现需要补齐实现细节。 统计口径与流匹配符号存在差异,状态/动作维度、执行节奏也不能从概念图补出。论文报告单张 RTX 4090 推理约需 6 GB 显存,但未给出可通用于各任务的完整延迟与控制频率,不能据此保证任意平台实时运行。
解释: EO-1 的价值是提供一条将语义判断与运动控制一起学习的路线。共享网络解决信息如何共同处理,交错数据提供时间上的联系,校正采样处理历史动作与当前去噪的区别;真实效果仍取决于示范覆盖、任务设置和执行系统。