Evo-1:保留语义对齐的轻量 VLA
Evo-1: Lightweight Vision-Language-Action Model with Preserved Semantic Alignment
- 轻量 VLA
- 语义对齐
- 交叉注意力
- 两阶段训练
先验知识:从理解指令到输出动作
VLA 学的是什么
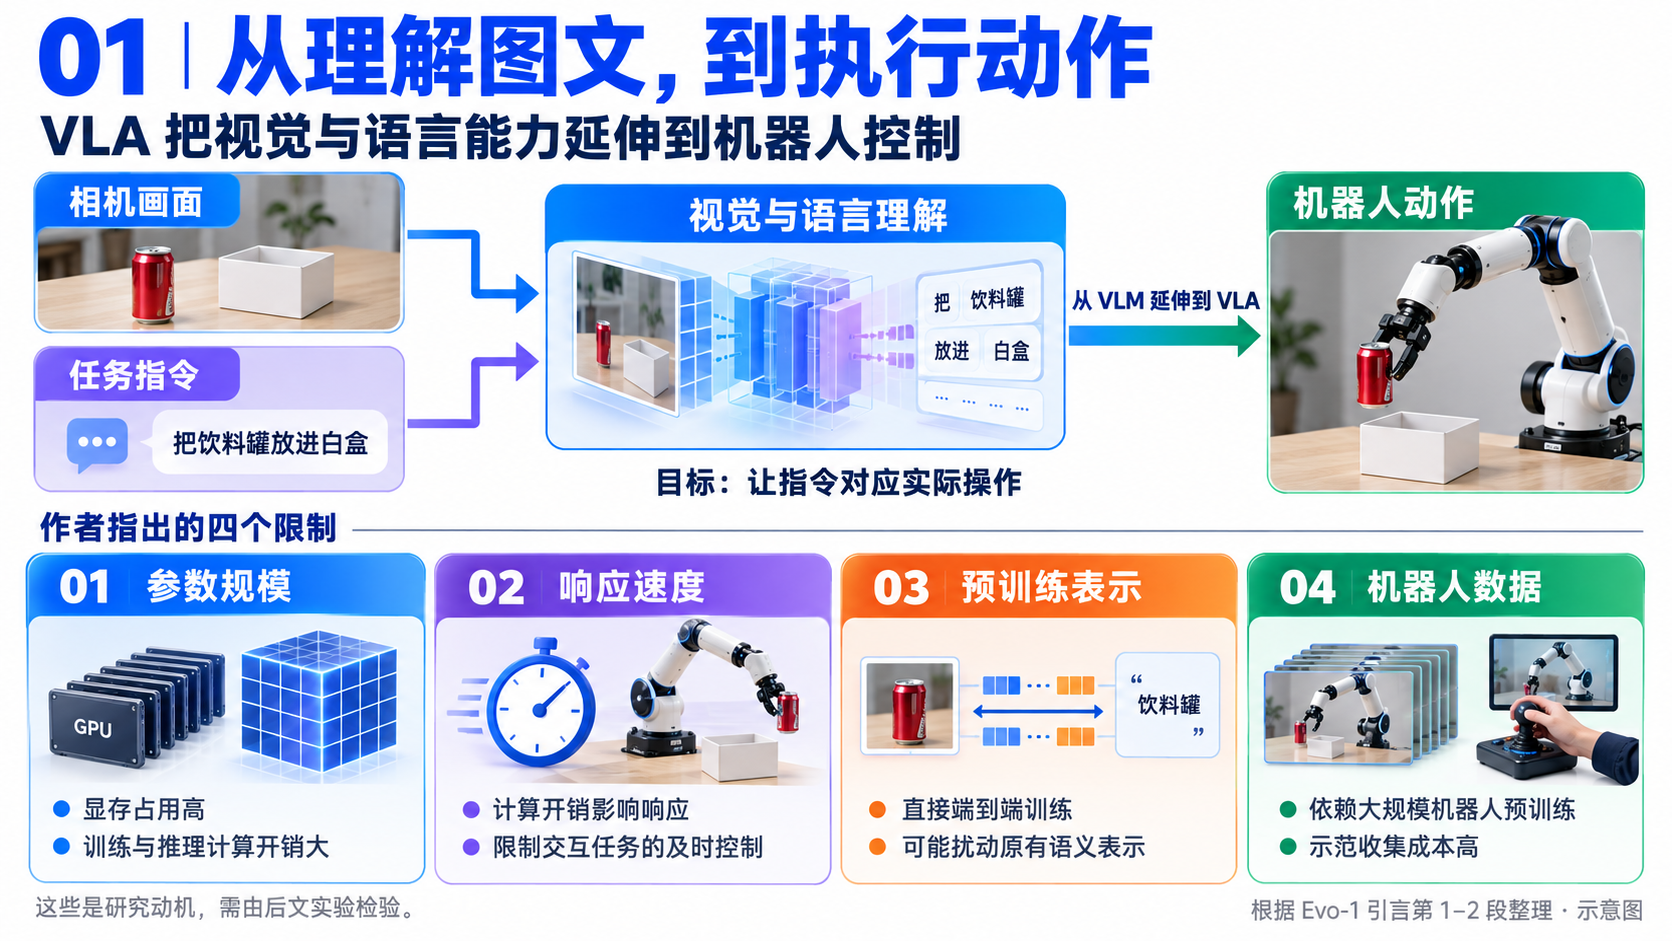
解释: 模仿学习(Imitation Learning)是让机器人学习示范中的“遇到这个场景时,应该怎样运动”。视觉-语言-动作模型(Vision-Language-Action Model,VLA)把任务文字也加入输入,从而学习根据画面和指令生成控制动作。
以论文的“把饮料罐放进白盒”为例:人的遥操作记录提供相机画面、机器人姿态和对应动作;模型学习三者与任务文字之间的关系。部署时输入实时画面、任务指令和当前状态,输出一段未来动作,而不是只回答一句“先抓起来”。
| 概念 | 含义 | Evo-1 中的实例 |
|---|---|---|
| 观测(Observation) | 模型用来判断环境的信息 | 多视角 RGB 图像;真实 xArm6 系统有固定相机与腕部相机 |
| 本体状态(Proprioceptive State) | 机器人自身的数值状态 | 真实数据记录绝对关节角 |
| 动作(Action) | 发给机器人控制接口的数值 | 真实数据以绝对关节角记录动作;其他平台按其动作接口定义 |
| 视觉语言模型(Vision-Language Model,VLM) | 将图像与文字变成能共同处理的特征 | InternVL3-1B 骨干 |
| 语义对齐(Semantic Alignment) | 图像内容与文字含义在表示中保持对应 | “饮料罐”应与画面中的罐体建立关联,而不是被无关背景吸引 |
注意: “保持语义对齐”是本文的目标,注意力图与任务结果提供支持;它不等于模型的全部语言知识经过了完整测评。
单步动作与动作块
单步预测只输出当前动作;动作分块(Action Chunking)一次输出未来多步动作,让模型联合安排一小段运动。Evo-1 的默认预测长度为 50 步。
单步方式:当前画面、指令、状态 → aₜ
动作分块:当前画面、指令、状态 → [aₜ, aₜ₊₁, …, aₜ₊₄₉]
解释性例子: 只看一个关节,三步目标角度可以是 [0.10, 0.12, 0.15] 弧度。单步方式分别预测这些值,动作块方式一次预测整个序列;实际 Evo-1 输出的是多维、50 步动作块。
动作块有利于联合建模连续轨迹,但执行后环境仍可能变化。论文没有明确给出每次执行多少步后重新观察、是否重叠融合以及全部平台的重规划规则,因此不能把“预测 50 步”写成“必然开环执行 50 步”,也不能从块长推导最终控制频率。
三个阶段要分清
| 阶段 | 输入与操作 | 判断或产出 |
|---|---|---|
| 训练 | 示范图像、指令、状态和真实动作;对动作加噪,学习生成方向 | 得到模型参数,损失衡量方向预测误差 |
| 推理 | 当前图像、指令、状态和新采样的噪声动作块 | 逐步生成未来连续动作,交给控制系统执行 |
| 评估 | 在规定任务与初始条件下运行策略 | 按成功标准统计成功率;另测指定 GPU 上的显存和推理频率 |
训练损失低,不能直接等同于真实任务成功率高。后文分别讨论训练机制和实际评估。
摘要:翻译与批注
翻译
视觉-语言-动作模型已成为统一感知、语言和控制的有力框架,使机器人能够通过多模态理解执行多样任务。然而,现有 VLA 模型通常包含大量参数,并高度依赖大规模机器人数据预训练,导致训练计算成本高,也限制了实时推理的部署。此外,多数训练范式往往削弱视觉语言骨干的感知表示,造成过拟合与下游任务泛化不足。
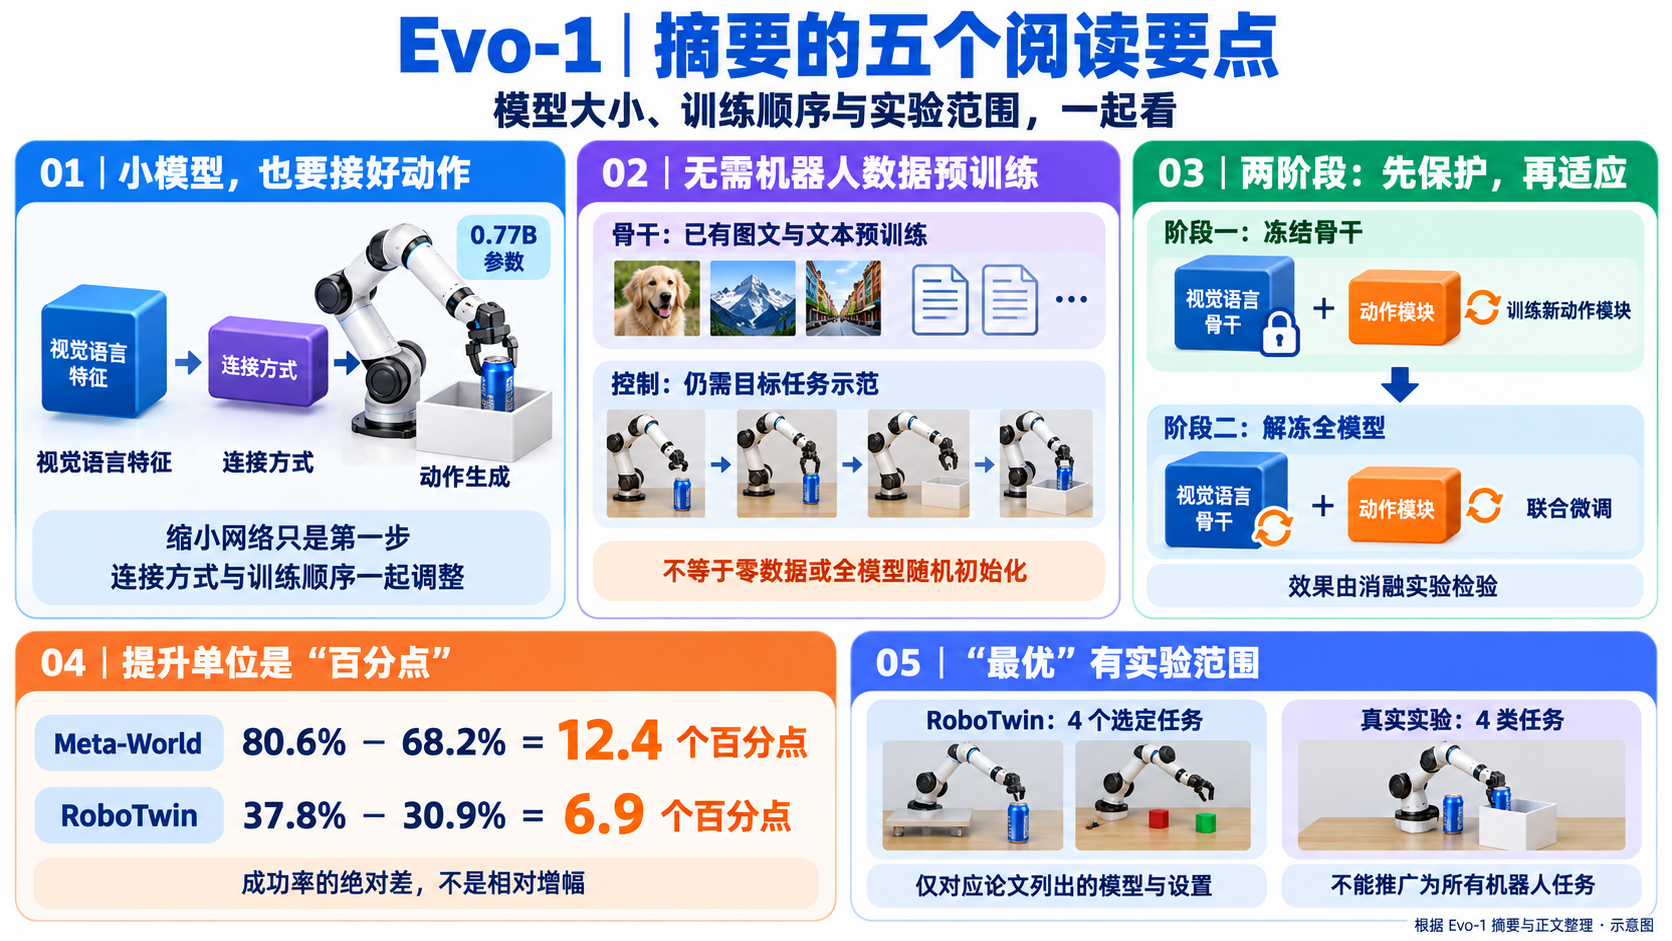
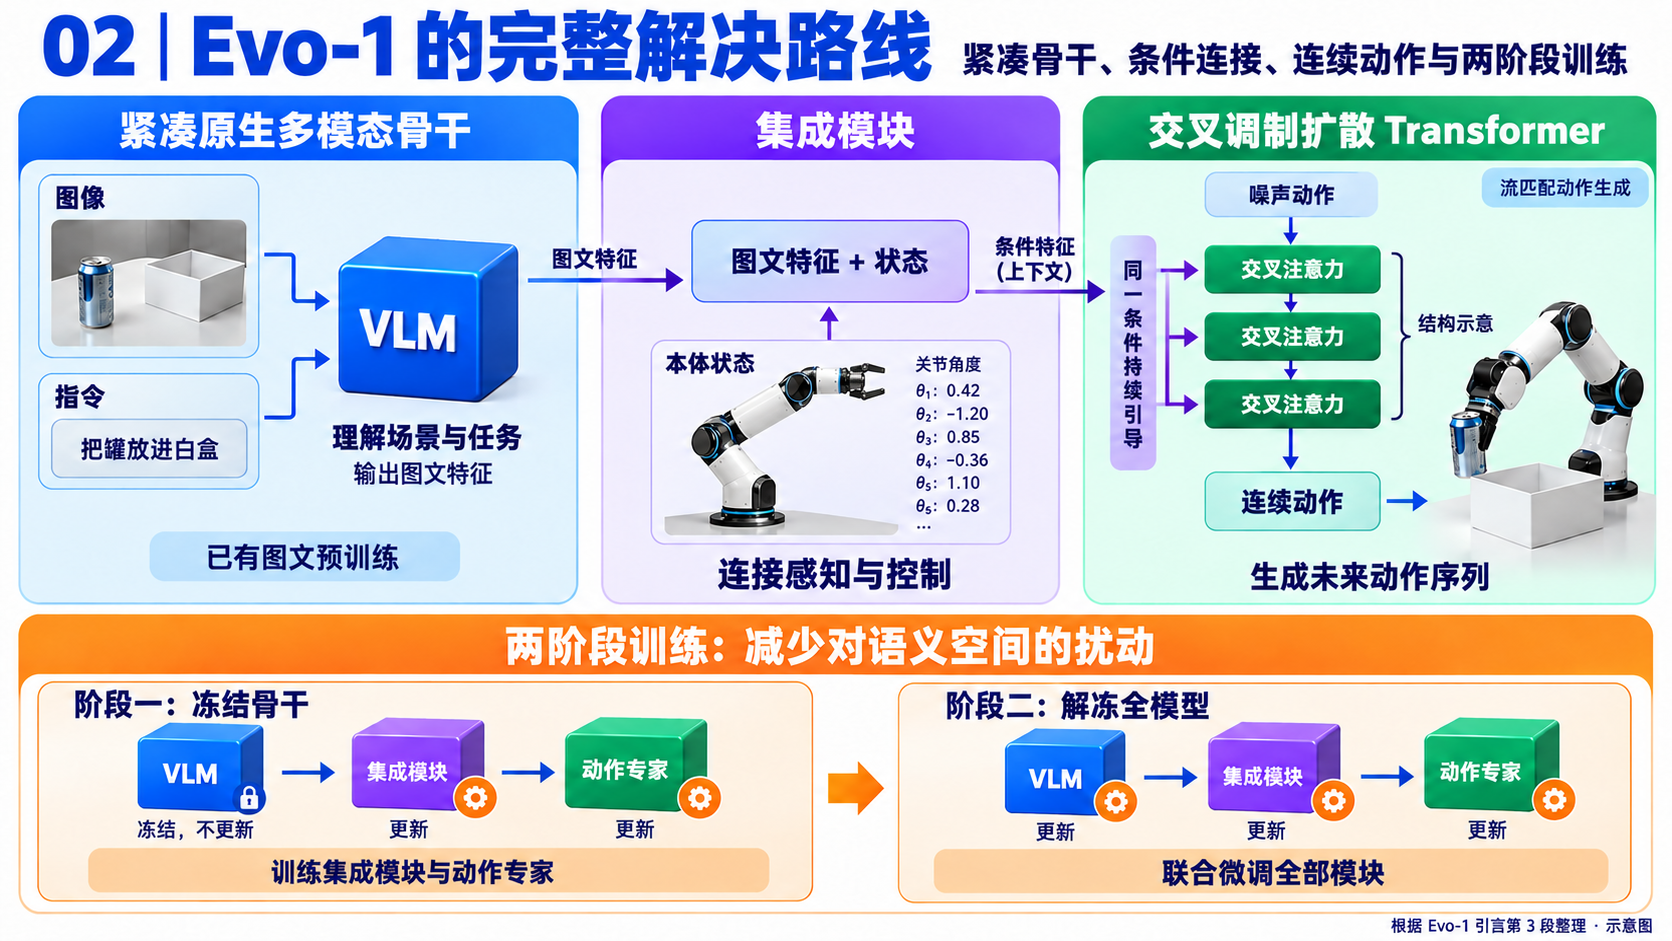
本文提出 Evo-1,一种轻量 VLA 模型,在不进行机器人数据预训练的情况下,减少计算、提高部署效率,同时保持较强性能。Evo-1 建立在原生多模态 VLM 上,结合新的交叉调制扩散 Transformer(Cross-modulated Diffusion Transformer)与优化的集成模块,形成有效架构。作者进一步提出两阶段训练范式,逐步对齐动作与感知,并保留 VLM 的表示。
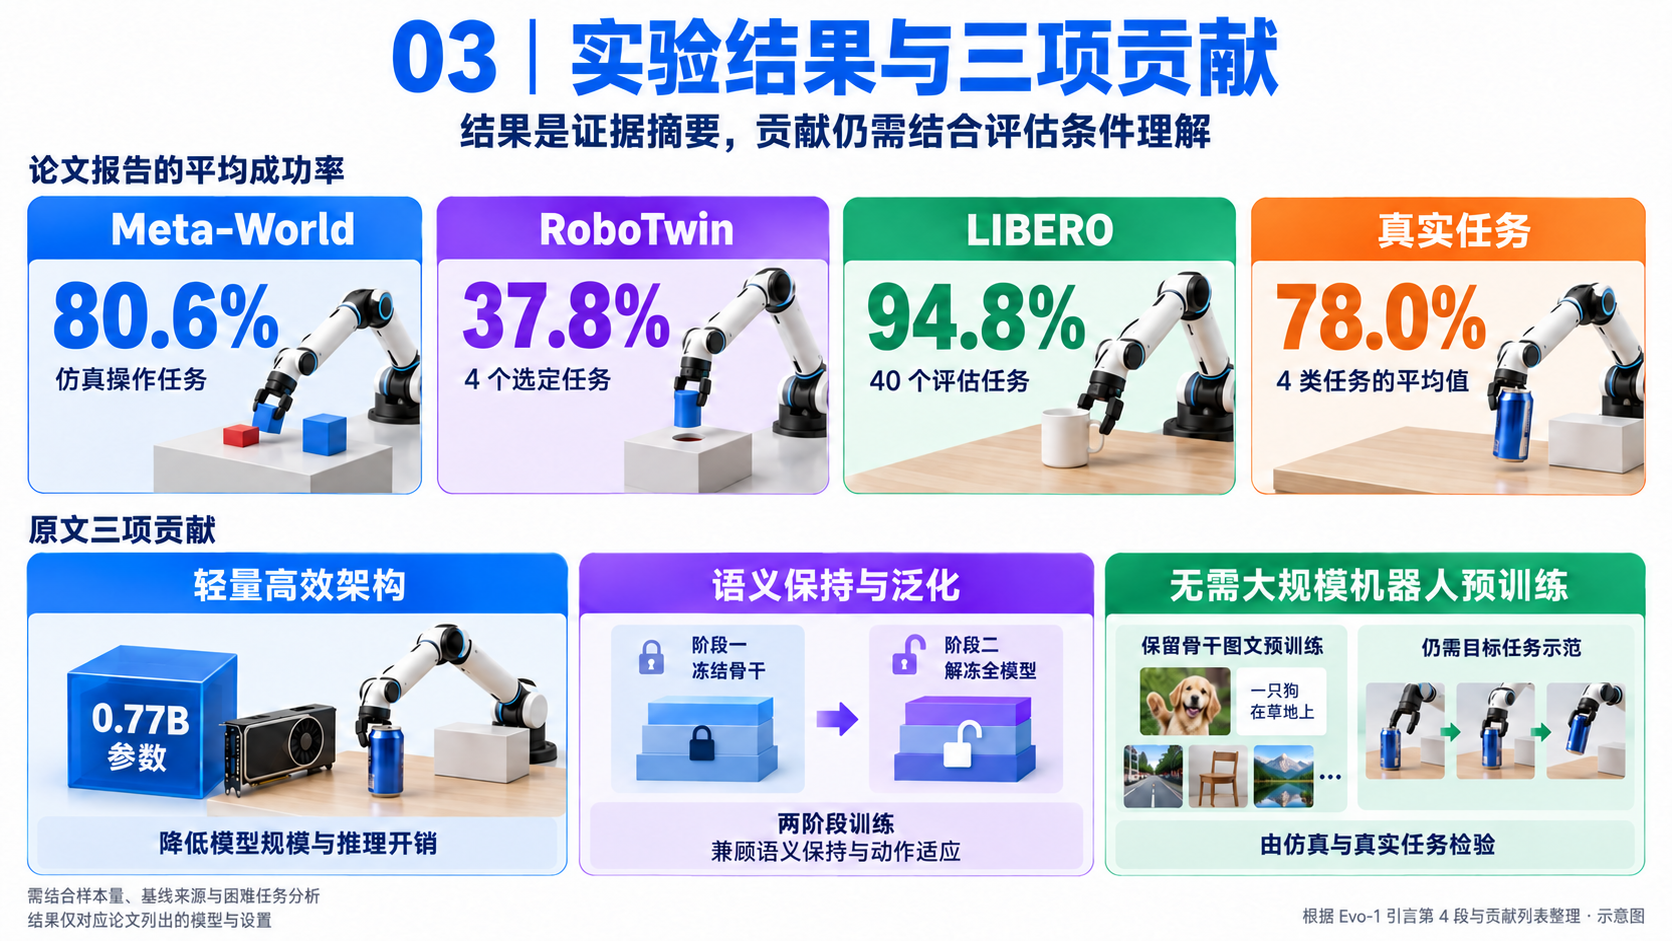
Evo-1 仅有 7.7 亿参数,在 Meta-World 和 RoboTwin 套件上取得当时最优结果,分别超过此前最佳模型 12.4% 和 6.9%,并在 LIBERO 上达到具有竞争力的 94.8%。真实世界评估中,Evo-1 以较高推理频率和较低显存开销取得 78% 成功率,超过所比较的全部基线。作者发布代码、数据和模型权重,以支持轻量、高效 VLA 模型研究。
批注
引言与相关工作:为什么同时改架构和训练
按原文四个正文段落拆解
与已有工作的关系
-
大规模 VLA: OpenVLA 使用机器人示范和离散动作建模,π0 使用连续动作专家,Hi-Robot 探索分层推理。作者指出,这类路线常使用数十亿参数的骨干。Evo-1 的区别在于压缩视觉语言主干,并用自己的集成与训练设计完成下游动作学习。
-
轻量、高效 VLA: TinyVLA 将小型视觉语言骨干与扩散动作解码器组合;SmolVLA 使用紧凑流匹配动作专家,并采用层跳过、token 减少及异步推理等设计。Evo-1 与它们目标相近,但选用 InternVL3、连续堆叠交叉注意力,以及先冻结后解冻的训练顺序。
注意: 上述对比沿用原论文两类相关工作。它没有证明所有大型模型都必须依赖机器人预训练,也没有证明紧凑架构在所有任务上更优。
核心方法:用稳定上下文引导连续动作
整体网络与输入输出
模型先把“看见什么、要做什么”编码为多模态特征,再结合“机器人现在在哪里”,从噪声中生成未来动作。
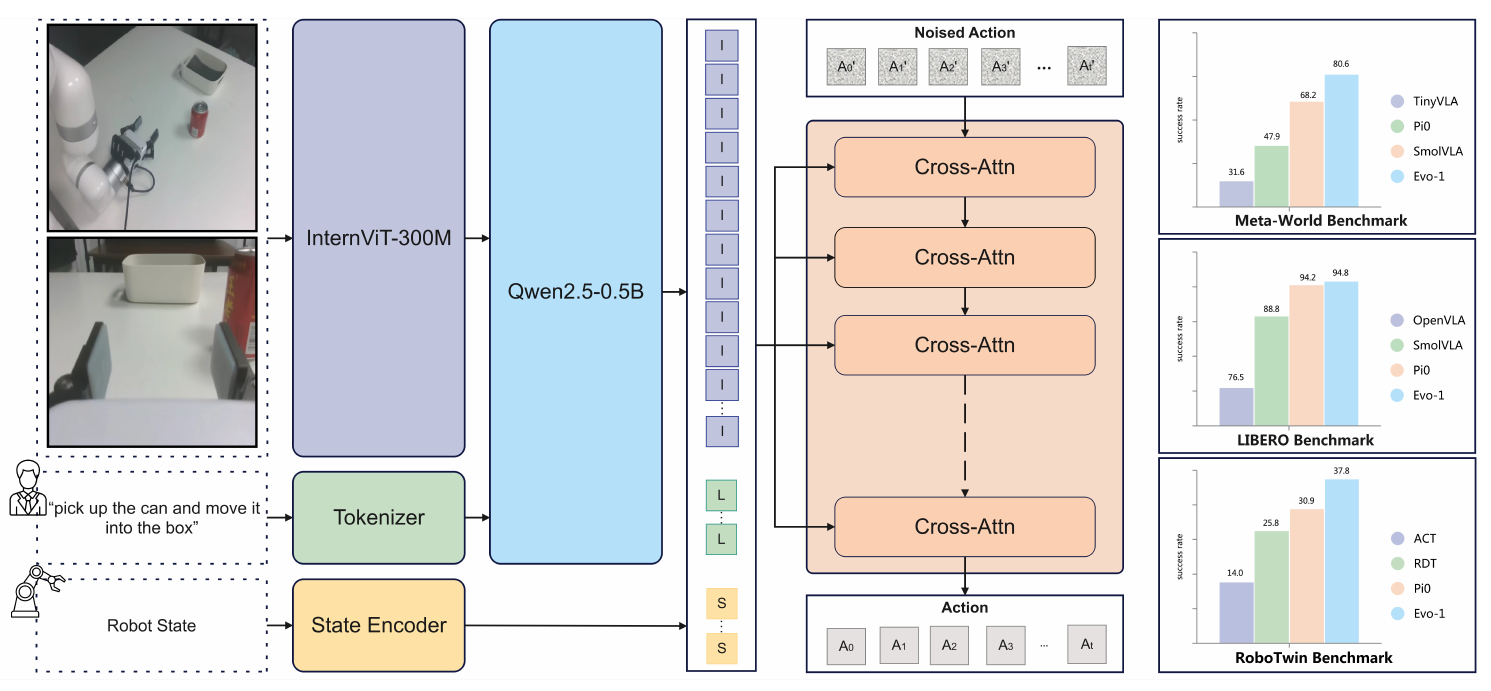
原文: 三个核心组件分别是视觉语言骨干、集成模块和交叉调制扩散 Transformer。模型总计 0.77B 参数,不应将 InternVL3-1B 名称中的“1B”与裁剪后模型总参数量直接相加。
| 路径 | 原始输入 | 编码与处理 | 输出或用途 |
|---|---|---|---|
| 视觉 | 当前时刻 N 路 RGB 图像 | 每路统一为 448 × 448 × 3,InternViT-300M 提取视觉特征;pixel-unshuffle 将视觉 token 数减少为原来的 1/4 | 视觉嵌入插入图文序列 |
| 语言 | 自然语言指令 | 分词后送入 Qwen2.5-0.5B 分支,只保留前 14 层 | 第 14 层输出融合的图文特征 |
| 状态 | 机器人本体状态 | 默认补齐为 24 维,图 1 显示状态编码器(State Encoder) | 接入动作专家的条件上下文 |
| 动作 | 带噪未来动作块 | 默认形状 50 × 24,经动作专家的 8 层 Transformer 处理 | 同形状的生成更新,最终得到连续动作块 |
N 是相机路数,依平台而定;真实 xArm6 设置为 2。词元(Token)是模型处理的序列单元,图像 token 是连续特征,并不是文字单词。像素重排下采样(Pixel-unshuffle)在这里减少视觉序列长度,不意味着原始图像直接缩成四分之一的宽高。
原文: InternVL3 在其原生多模态预训练中联合学习图文与文本表示。视觉分支使用从 InternViT-6B 蒸馏得到的 InternViT-300M;图像嵌入替换指定的 <img> 占位,随后与文字共同进入共享解码器。Evo-1 从第 14 层读取图文特征,并移除后续语言层。
解释性形状例子: 一个样本的动作块有 50 × 24 = 1,200 个数,批量 16 个样本则是 16 × 50 × 24。24 是统一接口的补齐维度,包含非实际控制维度;它不表示 xArm6 有 24 个关节。不同平台的有效维度与物理单位需要按数据接口解释。
注意: 论文没有完整列出视觉 token 总数、图文隐藏宽度、动作专家隐藏宽度和状态编码细节。本文保留这些实现边界,不根据组件名称补写数字;图 1 的状态编码器也不能被省略为“原始 24 维向量直接与所有图文特征相加”。
集成模块:每层都读取同一份条件
问题: 图文特征描述任务和场景,机器人状态描述当前姿态。如果动作生成过程中读不到这些信息,就难以让轨迹持续服从当前任务。
直觉: 把多模态特征和状态作为一份条件“资料”,每个动作层都根据自己当前的动作表示读取它。最终采用中间层交叉注意力(Mid-Layer Cross-Attention),即论文的 Module A。
交叉注意力(Cross-Attention)中,查询(Query,Q)表示“当前动作需要什么信息”;键(Key,K)负责与查询匹配;值(Value,V)提供读出的内容。原文: 以第 14 层图文特征与状态拼接所得条件作为 K、V,带噪动作表示作为 Q;所有动作层使用相同条件来源。
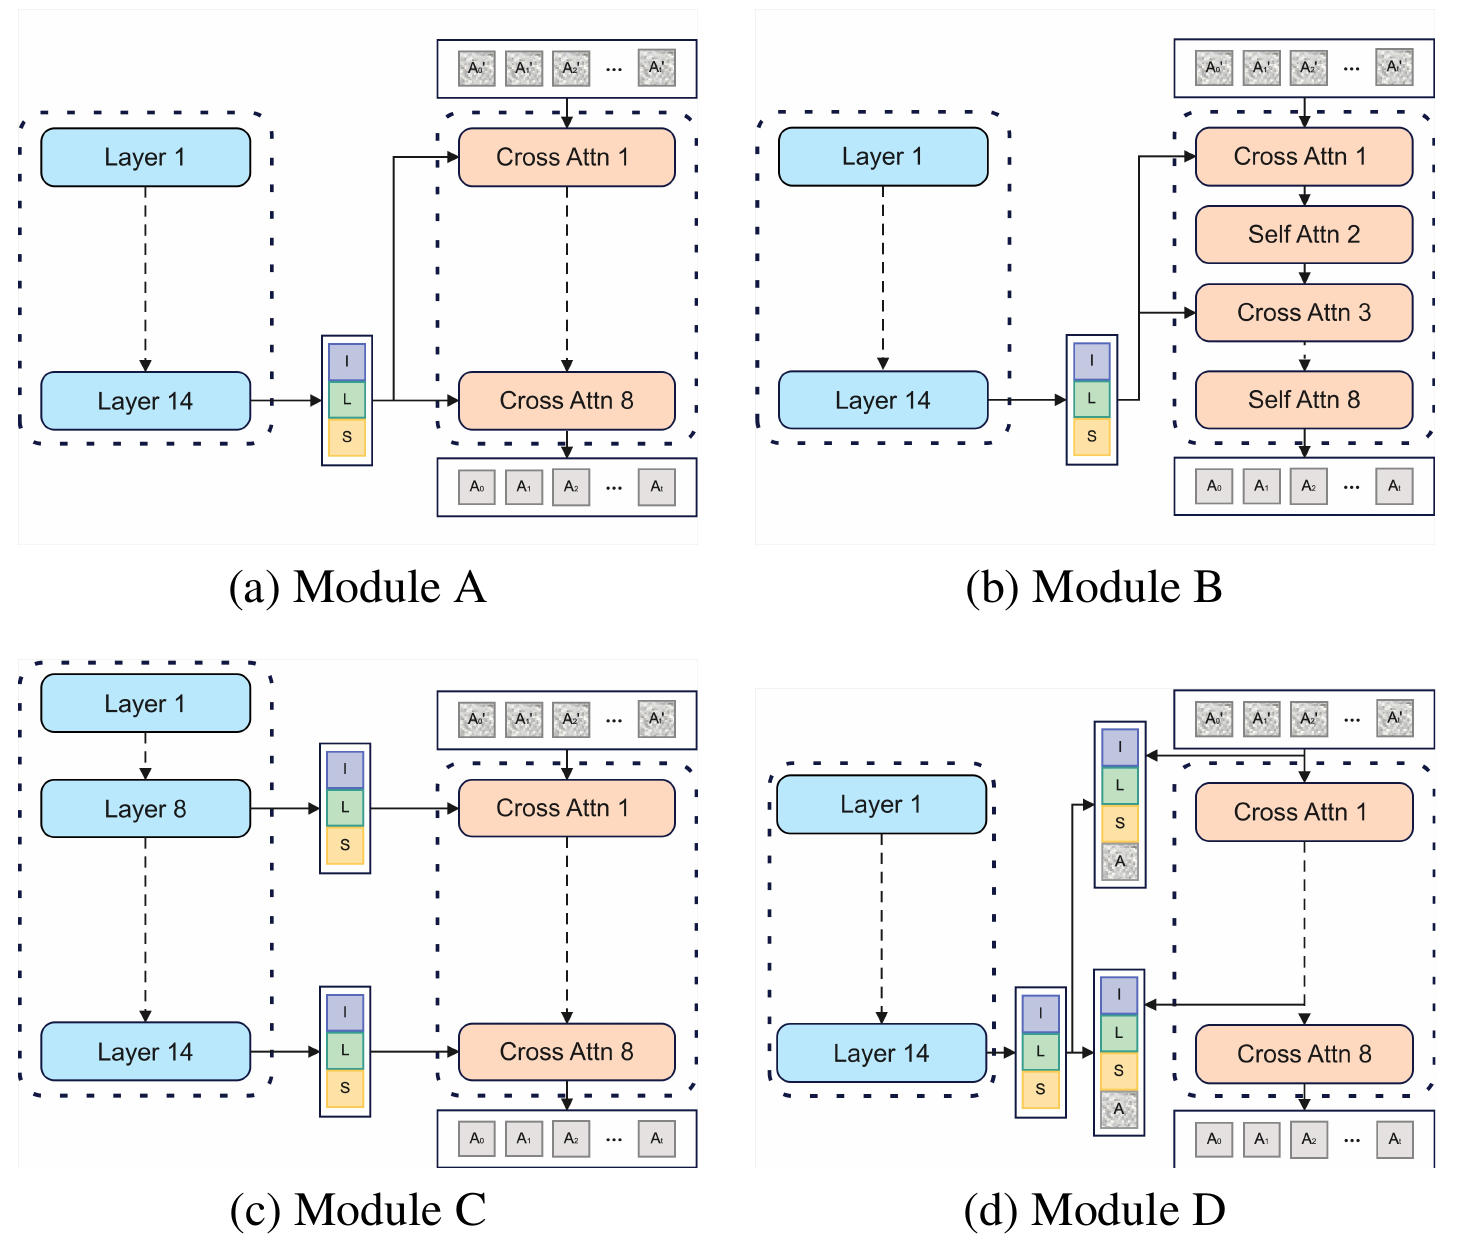
| 设计 | 如何连接 | 与最终设计的差别 |
|---|---|---|
| A:中间层交叉注意力 | 第 14 层图文特征与状态作为每个动作层的 K、V | 最终采用,各层条件来源一致 |
| B:中间层交错交叉/自注意力 | 读取条件后,再插入自注意力(Self-Attention)层 | 增加动作序列内部的注意力交互 |
| C:逐层交叉注意力 | 不同动作层使用不同深度的 VLM 特征与状态 | 条件随动作层变化 |
| D:联合 K、V 交叉注意力 | 将图文、状态和带噪动作共同放入 K、V | 动作也成为被读取的上下文 |
用于解释的标准注意力公式,并非原文新增损失:
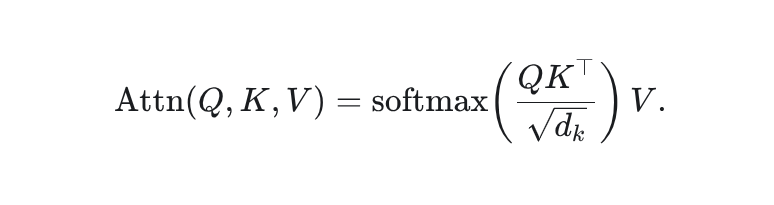
若有 50 个动作位置、M 个条件 token,单个注意力头中 Q 为 50 × d_k,K 为 M × d_k,V 为 M × d_v;输出为 50 × d_v。d_k、d_v 是该头特征宽度,softmax 对每个查询的 M 个匹配分数归一化。M 与各宽度的具体数值未在论文中完整报告,这些是解释计算关系的符号。
最小数值例子: 某个动作位置对两个条件 token 的归一化权重为 [0.75, 0.25],若只取值向量的一维 [6, 2],读出的结果是 0.75 × 6 + 0.25 × 2 = 5。这个值是内部特征,不是直接给机械臂的角度;下一层可根据更新后的动作表示重新读取条件。
注意: 正文强调“拼接,而不是投影到共享嵌入空间”,图 1 同时画有状态编码器。应理解为保留独立条件再拼接的设计意图,不能扩大成“网络完全不使用投影或编码”。拼接的具体轴与编码宽度仍需实现补充。
动作专家:通过流匹配生成整块动作
问题: 图文特征不能直接当作关节角。一段未来轨迹包含很多连续数值,需要一个能根据任务条件生成整段动作的模型。
直觉: 先给动作块填入随机噪声,再让模型学习“当前这组数应向哪个方向调整”,逐步得到示范中的动作。论文将模块称为扩散 Transformer(Diffusion Transformer,DiT),具体训练目标采用流匹配(Flow Matching)。两者分别描述网络结构和学习方式,并不矛盾。
原文式(3):
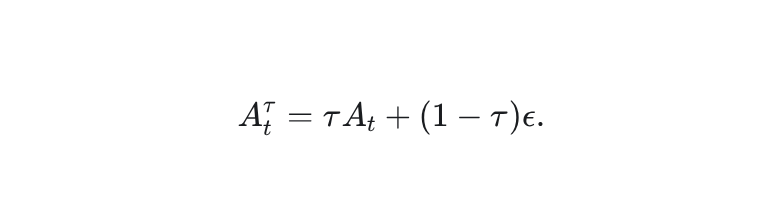
t 是机器人观测时刻;A_t 是从该时刻开始的真实动作块;ε 是同形状的随机噪声;τ 是内部生成进度,与机器人时间不同。默认两块数组均为 50 × 24,τ 为无单位标量,训练中从 Beta 分布采样并限制到 [0.02, 0.98]。论文没有给出这里的 Beta 分布参数。
最小数值例子: 对动作块的一个元素,令真实值为 0.6、噪声值为 −0.2、τ=0.5,则带噪值为 0.2。按这条线性路径,τ=0 对应噪声,τ=1 对应真实动作;训练只在上述截断区间采样。
原文式(4),简写期望的采样来源:
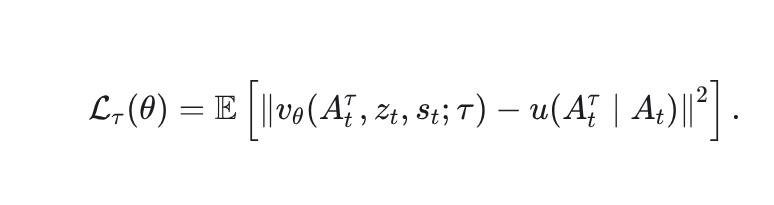
θ 是可训练参数;z_t 为图文特征,s_t 为本体状态;v_θ 是模型预测的时间条件速度场;u 是目标生成方向;二者与动作块同形状。平方范数比较所有元素的方向误差,期望来自示范动作与加噪样本。原式将时间条件省略在网络实参中,此处写出 τ,便于与正文“时间条件速度场”的说明对应。
解释: 对式(3)的线性路径,随 τ 增大的数学方向为 A_t−ε;这是根据公式推导的直观解释,原文没有将 u 进一步展开为这个表达。上例中方向为 0.8,若预测为 0.7,该元素的平方误差为 0.01。训练要学习的是如何移动,不是只把带噪值直接回归成答案。
推理时从新噪声出发,使用图文与状态条件反复预测方向、更新整段动作,最终得到 [âₜ, âₜ₊₁, …, âₜ₊₄₉]。动作专家使用 8 层 Transformer,最终架构堆叠交叉注意力,而非交替插入自注意力。
用于解释的离散更新示意:
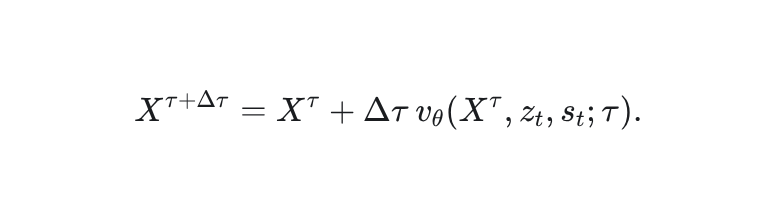
X^τ 是当前动作估计,Δτ 是无单位的内部步长;这是帮助理解速度场的欧拉更新(Euler Update),不是论文明确指定的完整推理算法。最小例子: 一个元素当前为 0.2,预测方向为 0.8,若内部步长为 0.1,更新后为 0.28。
注意: 文中没有明确报告内部更新次数、数值求解器或完整执行调度。不能把 8 层 Transformer 当成 8 次去噪,也不能将内部进度 τ 当成机器人运动时间。模型生成整块动作,也不代表全部动作互相独立。
两阶段训练:先让新模块适应旧表示
问题: 骨干已有图文能力,动作专家却是新初始化的。若一开始就一起训练,新模块产生的梯度可能同时改变既有表示,让骨干过早适应有限机器人示范。
直觉: 先让动作模块学会使用已有特征,再允许整个模型共同调整。类比“先熟悉已有资料,再一起修改资料和解题方法”;实际机制就是控制哪些参数能更新。
| 阶段 | VLM 骨干 | 集成模块与动作专家 | 目的 |
|---|---|---|---|
| 第一阶段:动作专家对齐 | 完全冻结 | 更新 | 在固定图文表示上建立感知与动作的连接 |
| 第二阶段:全模型微调 | 解冻并更新 | 继续更新 | 从第一阶段检查点出发,联合适应下游控制 |
原文: 全部实验使用 8 张 NVIDIA A100 分布式训练。Meta-World 第一阶段 10,000 步、第二阶段 65,000 步;两阶段学习率均为 1×10⁻⁵,batch size 均为 16,warmup 均为 1,000 步,梯度裁剪为 1.0,权重衰减为 0.001。默认动作专家 dropout 为 0.2,数据增强持续开启。其他基准沿用两阶段路线,训练步数随数据规模调整(第 11 页表 4、表 5)。
解释性例子: 第一阶段某批动作预测错了,梯度只修改新模块;第二阶段同样的误差也可以修改图文骨干。两阶段不是使用两种机器人,也不是先预训练机器人数据、再训练目标任务。
论文没有增加明确的“语义保持损失”,报告的动作训练目标是流匹配。保持语义主要依靠预训练初始化和训练顺序;第二阶段仍会改变骨干,不能理解成语义表示被永久锁定。论文没有报告训练墙钟时长或完整成本,所以“训练成本低”不能被具体化为单张消费级显卡即可完成全部训练。
把训练与推理分别串起来
训练时:示范图像+指令 → VLM 第 14 层图文特征
        示范状态 → 状态编码/集成条件
        示范动作块+随机噪声+生成进度 → 带噪动作块
        条件+带噪动作 → 动作专家 → 预测生成方向 → 流匹配损失
        第一阶段只更新新模块;第二阶段联合更新全模型

推理时:当前图像+指令 → 图文特征
        当前状态 → 条件上下文
        新采样噪声动作块 → 时间条件动作专家反复更新
        → 50 步连续动作预测 → 由平台控制接口执行 → 获取后续观测
一句话理解: 紧凑骨干负责理解场景和目标,集成模块让各动作层持续读取图文与状态,流匹配负责把噪声变成连续轨迹,两阶段训练负责安排感知与动作模块的适应顺序。
实验:效果提升落在哪些范围
仿真结果:平均值领先,单项仍有差异
| 基准与范围 | 训练与评估设置 | Evo-1 平均成功率 | 主表中的主要对照 |
|---|---|---|---|
| Meta-World,50 个任务 | 每任务 50 条示范,共 2,500 条;每任务 10 次评估,5 次独立运行取平均 | 80.6% | SmolVLA 68.2%,提升 12.4 个百分点 |
| LIBERO,四组共 40 个任务 | Spatial/Object/Goal/Long;每任务 10 次评估,5 次独立运行取平均 | 94.8% | π0 94.2%,提升 0.6 个百分点 |
| RoboTwin 2.0 的四个选定任务 | 每任务 50 条示范;easy/hard 两种难度,正文报告 100 次评估试验 | 37.8% | π0 30.9%,提升 6.9 个百分点 |
来源:PDF 第 5 页表 1,第 5–6 页实验设置及第 12–13 页补充材料。RoboTwin 原文对“100 次试验”与两种难度的分配描述不够明确,本文不推算额外总次数。LIBERO 的逐任务训练示范数量未在该版本中明确列出。
原文: Meta-World 四个难度组分别为 89.2%、76.8%、77.2%、79.2%,都高于表中基线。LIBERO 四组分别为 92.7%、97.7%、96.3%、92.3%,Object、Goal、Long 领先,但 Spatial 低于 π0 的 96.8%;“平均领先”不能写成“所有单项都领先”。
RoboTwin 的优势集中在 Click Alarmclock:easy/hard 为 77%/58%,π0 为 63%/11%。其他任务仍有明显失败,例如 Place Can Basket 的 hard 仅为 1%,低于 π0 的 5%。这支持模型在选定双臂任务上的有效性,同时表明困难场景远未被全面解决。
注意: Meta-World、LIBERO 的基线来自原论文或已有复现,RoboTwin 基线来自官方论文,并非本研究统一重训全部方法。表 1 将 SmolVLA 标为 2.25B,而真实效率表 2 标为 0.45B;原文没有充分解释该差异,不能把两处当成同一规模配置直接比较。
真实系统:两路 RGB,绝对关节角监督
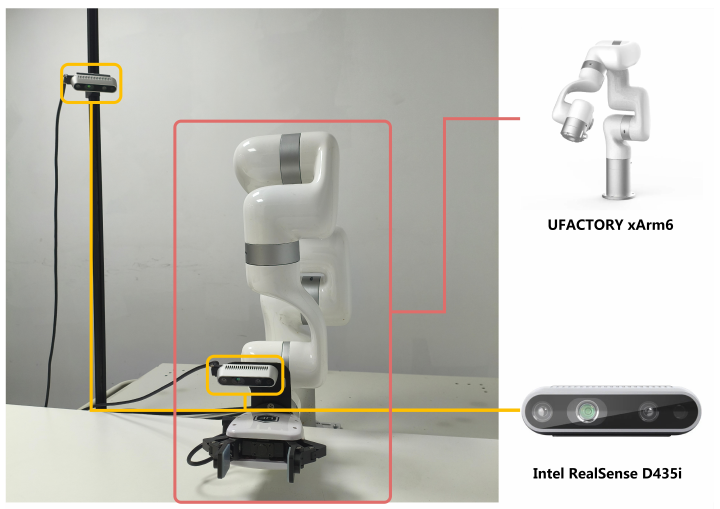
| 项目 | 原论文设置 |
|---|---|
| 机器人 | 6 自由度 xArm6 单臂,配平行夹爪,通过官方 xArmAPI 控制 |
| 视觉输入 | 两路 RGB:固定环境相机、腕部相机;不将设备的深度能力当成本文输入 |
| 数据记录 | LeRobot v2.1 格式,同步观测记录频率为 30 Hz |
| 状态与动作 | 使用绝对关节角记录,保持监督与回放接口一致;补齐后的模型接口为 24 维 |
| 示范与评估 | 四个任务各 100 条遥操作示范,共 400 条;每任务 20 次评估,共 80 次 |
来源:第 6 页、第 14–15 页。论文没有明确报告原始相机分辨率、各示范时长,以及夹爪数值在状态与动作中的完整字段映射;448 × 448 是模型输入尺寸。
真实效果与推理效率
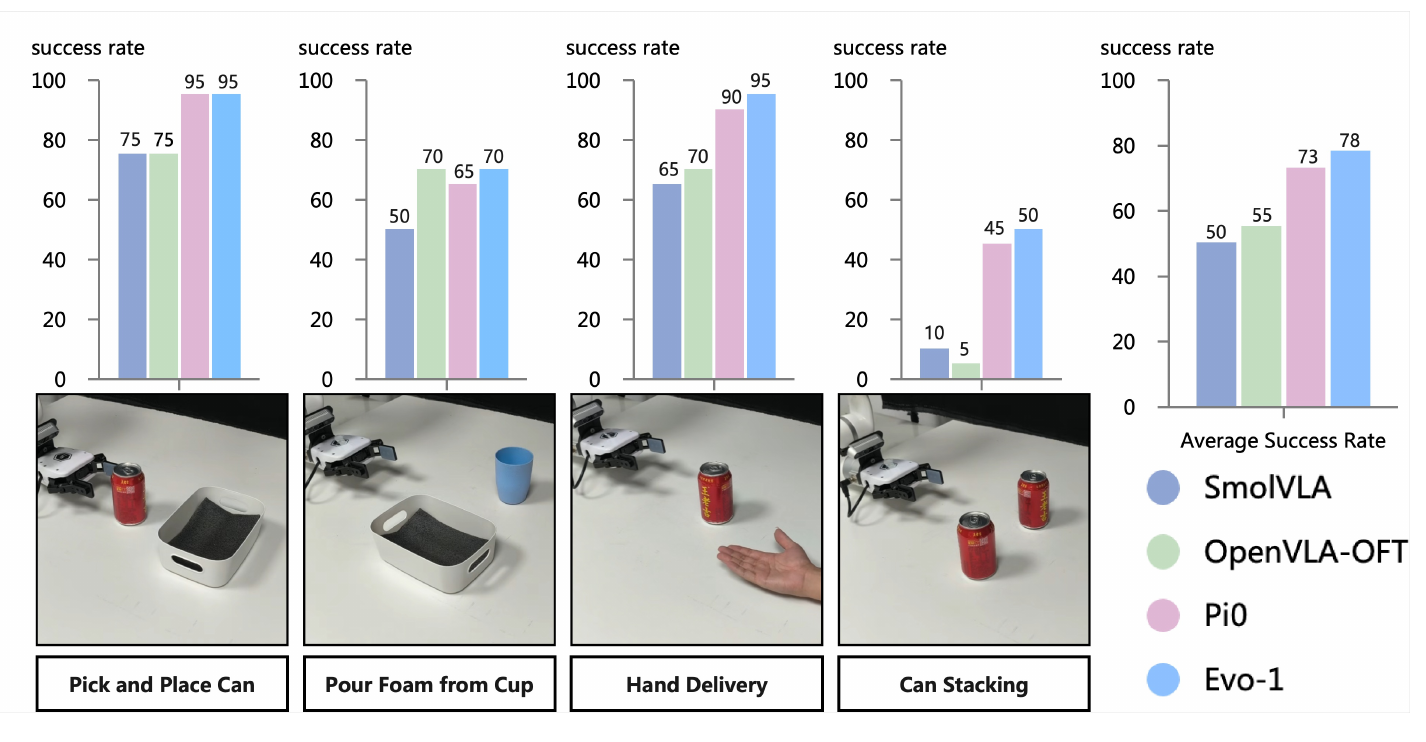
| 任务 | 论文成功标准 | Evo-1 成功率 |
|---|---|---|
| 抓取并放置饮料罐 | 完全进入白盒并稳定停留,不滚出 | 95% |
| 从杯中倒出泡沫 | 大部分泡沫进入白盒,盒内可见积累,外部洒落很少 | 70% |
| 把饮料罐交到人手中 | 稳妥放到手中,人无需追赶或调整来接住 | 95% |
| 叠放饮料罐 | 上方饮料罐至少稳定 2 秒,不滑落或倾倒 | 50% |
来源:图 4 与第 15 页成功标准。Evo-1 四项平均为 77.5%,论文以 78% 报告;不是每个任务都有 78% 成功率。叠罐仍是明显弱项。
原文表 2:指定 RTX 4090d GPU 上的比较。
| 模型 | 参数量 | 平均推理显存 | 平均推理频率 | 真实任务平均成功率 |
|---|---|---|---|---|
| SmolVLA | 0.45B | 2.0 GB | 12.7 Hz | 50.0% |
| OpenVLA | 7.0B | 15.1 GB | 7.9 Hz | 55.0% |
| π0 | 3.5B | 17.9 GB | 11.5 Hz | 73.0% |
| Evo-1 | 0.77B | 2.3 GB | 16.4 Hz | 78.0% |
来源:第 7 页表 2。图 4 与结果正文将对应基线称为 OpenVLA-OFT,表 2 写作 OpenVLA;本文保留各处名称,不自行认定其全部实现配置相同。
Evo-1 在这组测量中推理最快、平均成功率最高,但显存略高于 SmolVLA。2.3 GB 是推理平均显存,不是训练显存,也不代表模型在任何 2.3 GB 显存设备上都能按该频率运行。
注意: 30 Hz 是示范记录频率,16.4 Hz 是 GPU 推理频率,50 是动作预测步数,三者分别描述不同环节。论文没有完整给出感知、通信、执行的端到端时延,不能直接将 16.4 Hz 写成机械臂最终控制频率。
泛化:在一个任务上改变干扰与位置
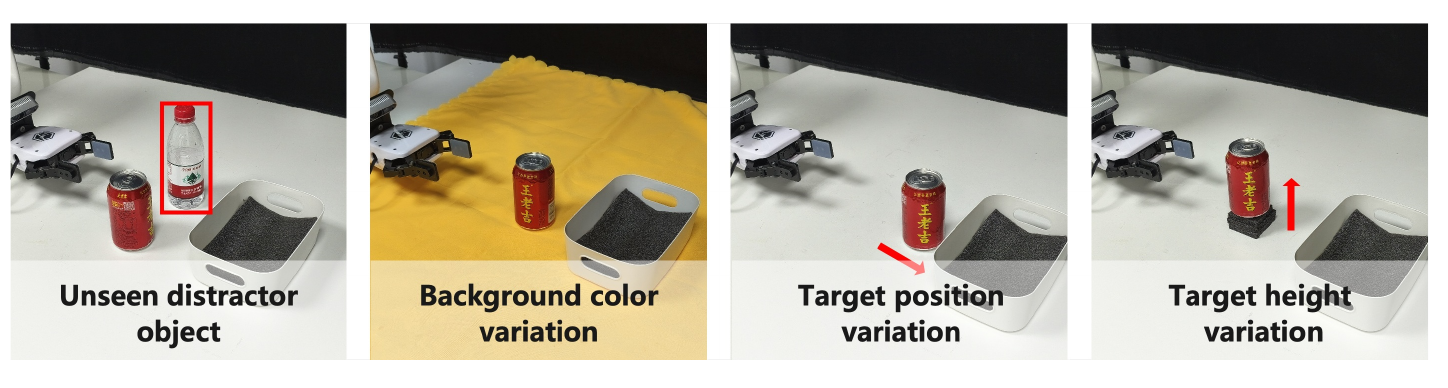
泛化实验以“抓罐放入白盒”为基准,每种扰动条件评估 20 次。以下变化均被作者定义为超出训练分布。
| 条件 | SmolVLA | Evo-1 |
|---|---|---|
| 基础场景 | 75% | 95% |
| 添加未见瓶子 | 65% | 80% |
| 添加黄色桌布 | 60% | 75% |
| 目标向后移动 10/20/30 mm | 75%/60%/60% | 95%/85%/80% |
| 目标升高 10/20/30 mm | 75%/65%/60% | 100%/90%/70% |
来源:第 7 页表 3。这里的位移与高度单位为毫米。
解释: 结果支持模型对这几类局部变化有一定适应能力,且各条件均高于所比较的 SmolVLA。升高 30 mm 时下降到 70%,说明变化增大仍会影响效果;每条件 20 次试验,单次成功就对应 5 个百分点,不宜将小差异解释为确定的普遍规律。实验没有检验任意新物体、新任务或新机器人上的零样本泛化。
补充材料还展示 LeRobot SO-100 抓取小方块并放入固定容器的执行示例(第 15、19 页)。该部分没有给出同等规模的成功率、示范数量和效率测量,应作为部署展示,不能认定为已量化证明无需适配即可跨机器人迁移。
消融与结论边界:哪些设计有证据支持
同一条件持续注入是否有帮助
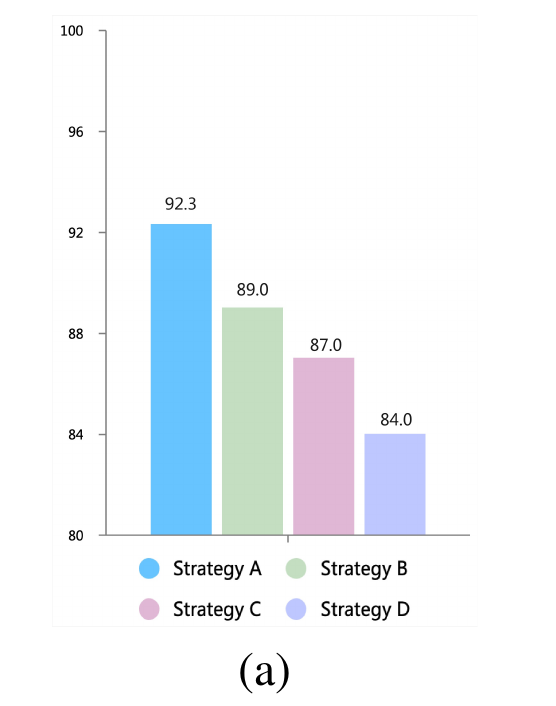
原文: A、B、C、D 的成功率分别为 92.3%、89.0%、87.0%、84.0%。A 比 B 高 3.3 个百分点,因此论文最终使用 A。
解释: 结果支持“各层读取相同中间层图文特征与状态”这一选择。作者将优势归因于条件信息传播更连续;实验比较的是四套具体设计,没有独立隔离每一个因素,所以不能推出“自注意力普遍有害”或“多层特征融合一定较差”。
两阶段训练是否有帮助
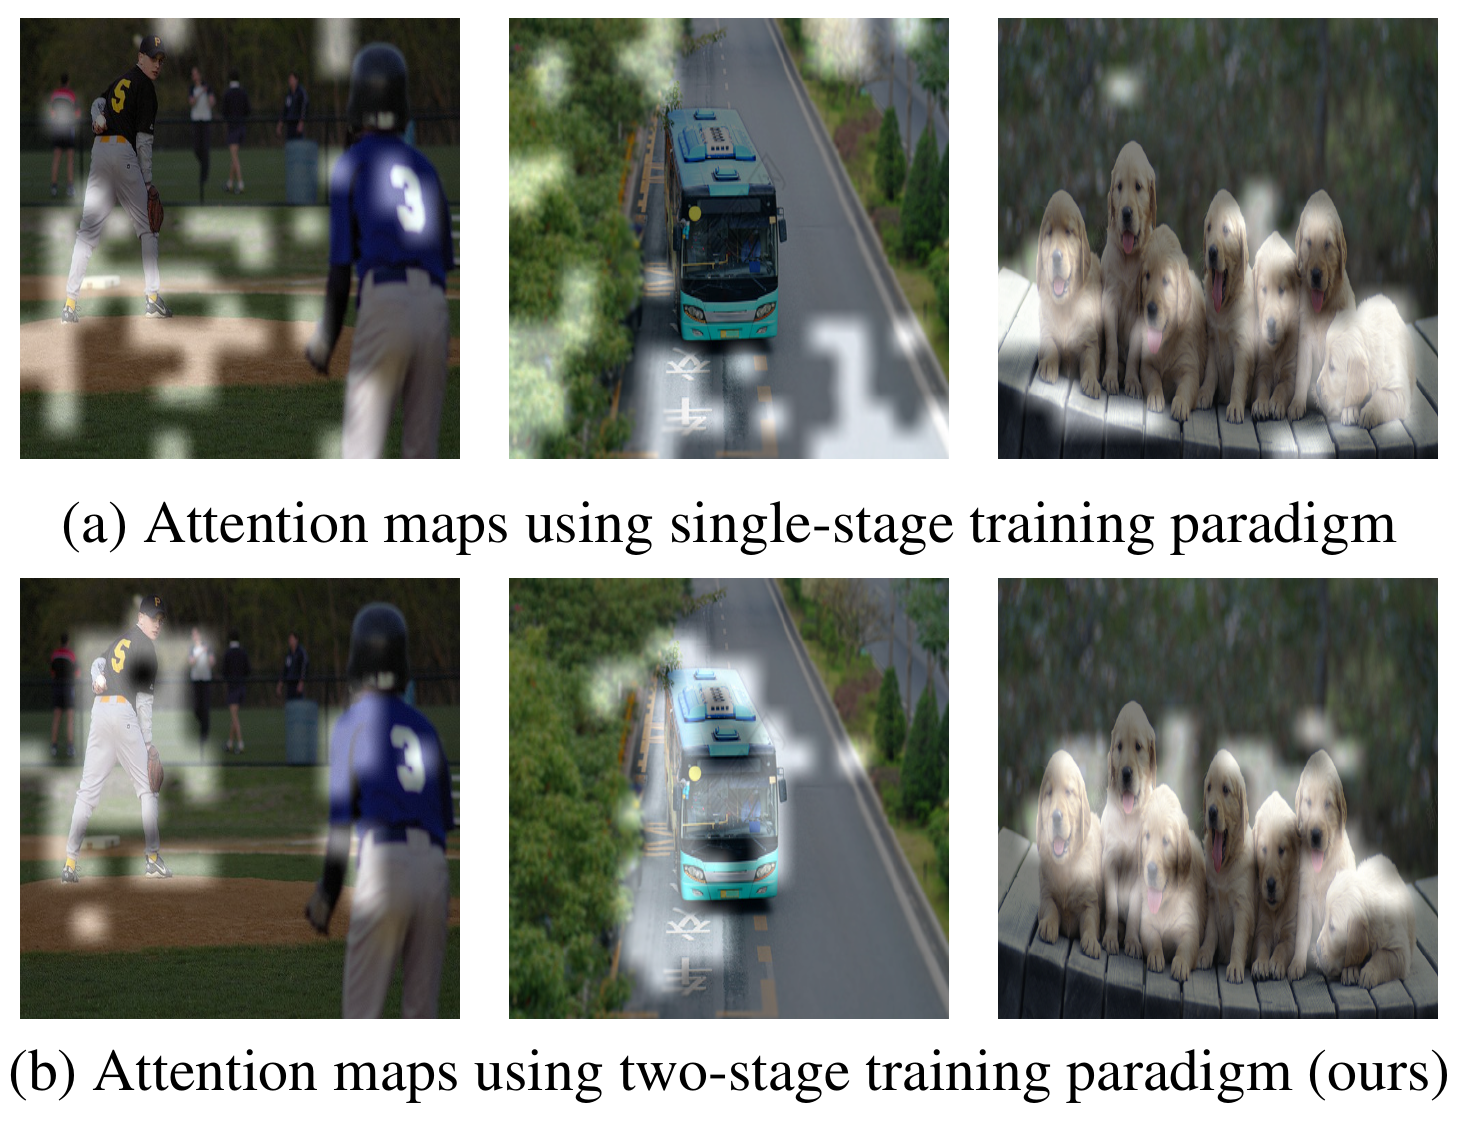
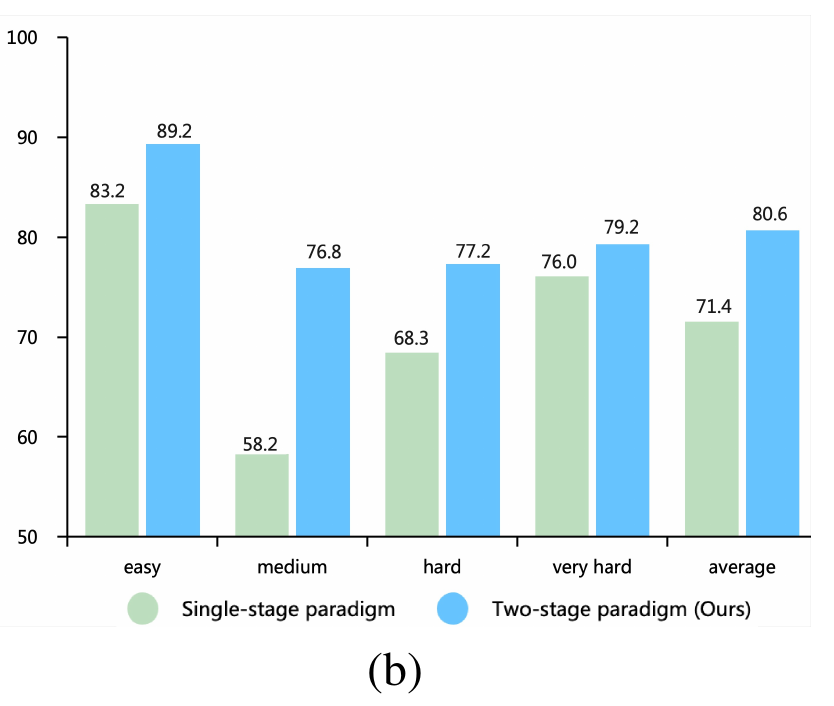
原文: 两阶段训练在四个难度组均高于单阶段;总体为 80.6% 对 71.4%,提升 9.2 个百分点。单阶段直接联合训练全部模块,两阶段先冻结骨干、再联合微调。
解释: 成功率对照支持训练顺序有效,注意力图则提示两阶段更容易保留清晰的图文关注区域。论文图 2 另外比较 Evo-1 与 OpenVLA 的注意力,但二者骨干与参数规模不同,不能单独用它来确定两阶段训练的因果作用;同架构训练路线对照更直接。
注意: 本文没有通用视觉问答、文本理解或语义遗忘的完整量化测评。“保持语义”有局部可视化和任务效果支撑,不能扩大为已经证明全部预训练知识都被保留。
读完应带走什么
Evo-1 的贡献是将三个选择结合起来:紧凑且裁剪过的原生多模态骨干、稳定的交叉注意力条件、先对齐后微调的训练顺序。在论文的仿真与真实操作任务中,这个组合以 0.77B 参数取得较强表现;动作专家采用流匹配,仍需要目标任务示范训练。
结论应停留在证据范围内:RoboTwin 只是四任务子集,真实任务叠罐成功率为 50%,泛化只测试一个任务的几类变化;效率测量依赖 RTX 4090d,训练使用 8 张 A100。本文说明“小型 VLA 值得通过架构和训练设计挖掘”,尚未证明小模型全面替代大模型,也未给出任意机器人上的直接部署方案。