G0.5:用同一序列生成推理和动作
Galaxea G0.5: One Autoregressive Stream for Robot Reasoning and Action
arXiv阅读论文原文Galaxea Team · arXiv:2608.11739v1 · 2026 年 8 月 12 日 · Galaxea 项目主页
机器人接到指令,要拉开抽屉、倒入核桃,再关上抽屉。第一次看到把手时,下一步是伸手拉开。倒完核桃后,即使眼前还是同一个把手,下一步已经变成推回去。G0.5 要解决的问题是,能否让同一个视觉语言模型把“现在该做什么”和“手臂接下来怎样动”连续生成出来?
预备知识:同一策略怎样预测一段动作
视觉语言动作模型(Vision-Language-Action,VLA)从操作示范中学习,把相机画面、任务文字和机器人的本体状态转换成控制量。本体状态是机器人对自身的测量,例如关节位置。对于拉抽屉,画面给出把手位置,状态给出手臂当前姿态,动作则让手臂接近、合爪并向外拉。
动作块(Action Chunk)是按控制时刻排列的一段动作。单步策略在时刻 预测 。分块策略用同一次观测预测 ,其中 表示第 步的控制向量。后者可以先执行前几步,再根据新观测重算剩余动作。生成一个动作块的时间、执行多少步和底层控制频率是三个量。
自回归(Autoregressive,AR)描述的是动作块的生成方式。G0.5 的视觉语言模型(Vision-Language Model,VLM)每次预测一个词元(Token),再用已经生成的词元预测下一个。它可以先写出“抓住把手”,再接着写压缩后的动作代码。机器人执行前,动作编解码器把这些代码还原为连续控制量。
摘要与阅读线索
摘要意译。 许多 VLA 使用预训练 VLM 编码场景和指令,再由单独训练的流匹配(Flow Matching,FM)动作专家输出控制量。Galaxea 提出 G0.5,用同一个 Transformer 解码器、同一训练目标生成推理与动作词元。为支持这种做法,作者学习了跨本体的动作分词器,把子任务、目标位置等具身推理写入动作生成序列,并用视觉编码器处理数秒的历史画面。作者报告,模型可以根据提示改变动作粒度和任务执行方式,部分行为变化无需再次训练。
作者混合机器人数据与视觉问答(Visual Question Answering,VQA)样本进行预训练,并报告七类评估。R1-Lite/R1-Pro 真机微调的平均成功率为 76.7%,π₀.₅ 为 53.3%,GR00T-N1.7 为 24.4%。在 50 项长程家务的 2025 BEHAVIOR Challenge 中,单一策略的进度分为 31.4%,π₀.₅ 为 26.3%,冠军方案为 26.1%。其余评估包括 DROID 后训练后向未见环境和物体迁移(82.5%)、拾取放置语言遵循基准,以及 LIBERO(98.9%)、RoboTwin 2.0(93.3%)和 SimplerEnv-Bridge(87.3%)。
批注。
- 压缩动作,才有余地让 VLM 逐个生成动作词元。 一次手臂运动包含多步、多个控制通道。先压缩时间序列,再省去空闲部件的词元,分别解决序列过长的两个来源。
- 推理是否有用,要看生成动作时能否读到它。 目标框或子任务如果出现在动作前面,后续预测就能把本次输出当作条件。论文专门切换推理开关,观察动作是否随之改善。
- 两种“泛化”对应两种评估条件。 DROID 测的是用该数据集后训练后能否换到未见环境和物体。BEHAVIOR 测的是同一个后训练策略能在 50 项任务上完成多少目标条件。
引言与相关工作:为什么让 VLM 自己生成动作
论文从 RT-2 和 OpenVLA 的动作离散化说起。控制频率、动作维度或预测长度增加时,逐值分词会推高生成成本。连续动作专家可以一次输出动作块,视觉语言主干主要提供条件。作者由此提出一个问题:预训练 VLM 的语言与推理能力,怎样更直接地影响控制?
G0.5 提出三项贡献。首先学习跨本体动作编解码器,再把推理链纳入动作序列,最后观察提示措辞能否调节实际行为。视觉记忆提供近期观测。作者用常规控制基准、语言遵循与长程分阶段任务分别检验这些主张,提示词对行为的影响仍是小样本定性观察。
- 动作词元怎样压缩。 FAST 通过离散余弦变换压缩动作的时间冗余,G0.5 学习按身体部件压缩的共享词表,并允许省略空闲组。
- 推理怎样传给控制。 ECoT 已经让自回归动作读取前面的推理词元。G0.5 在这条路线上使用跨本体动作接口,并让提示选择子任务、目标框、轨迹和动作提示等字段。
与 π₀.₅ 对比:子任务怎样进入动作生成
两篇论文都可先产生当前子任务。以“倒完核桃后关上抽屉”为例,π₀.₅ 可以先给出“把抽屉推回去”,再由连续动作专家读取条件生成运动。G0.5 的主路径则在子任务后接着生成离散动作代码,再由 ActionCodec 把它们恢复为连续动作。
| 比较项 | π₀.₅ | G0.5 |
|---|---|---|
| 高层输出 | 自回归生成子任务文字 | 可选子任务、目标框、二维轨迹、动作提示 |
| 动作输出 | 流匹配专家生成连续控制量 | 同一解码器继续生成离散代码,ActionCodec 解码成连续控制量 |
| 离散动作的用途 | FAST 动作词元用于预训练,执行走连续动作专家 | ActionCodec 词元用于预训练,也用于 AR 执行 |
教学示意。 两条路径都省略共同的图像、状态等输入。
G0.5 也保留了可选的流匹配头。表中 G0.5 一列指论文主线,后文实验会把两种动作头切换比较。π₀.₅ 论文精读
数据:示范动作与推理标签从哪里来
G0.5 基础预训练混合覆盖 14 种本体的机器人示范,以及通用和具身视觉问答(VQA)。示范告诉模型不同身体怎样运动,问答和额外标注帮助模型学习指令、目标和任务阶段。DROID 在基础预训练之后才用于专项适配。
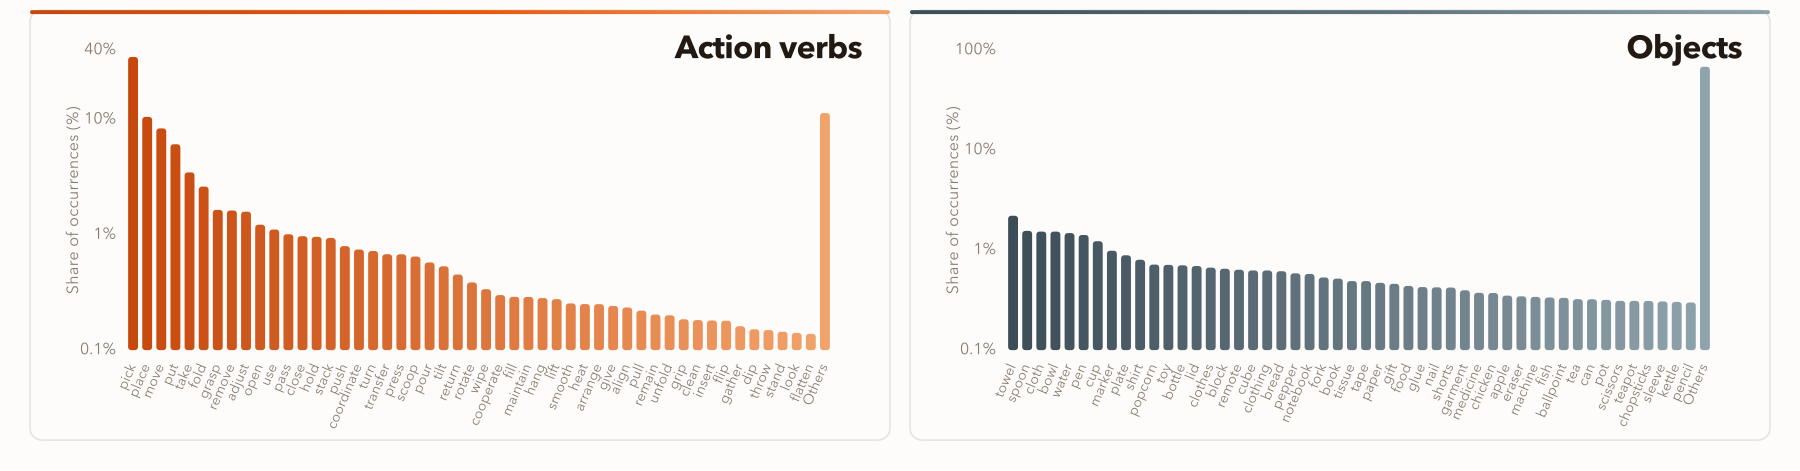
分布图的纵轴按对数尺度显示出现占比,左图为动作动词,右图为物体名词。拿取、放置、移动等常见动作出现更频繁,长尾里的较少见技能和物体仍占一定比例。覆盖多种本体与技能,和每种技能都有足够示范,是两个不同的问题。
| 训练目标 | 怎样从数据中得到 |
|---|---|
| 任务和子任务 | 按时间切分示范片段,再由多模态模型标注任务描述和局部动作提示 |
| 目标框 | 由视觉模型定位目标,再用跟踪模型延伸到后续帧 |
| 二维末端轨迹 | 用关节位置做正运动学,将三维末端位置投影到头部相机画面 |
| 动作代码 | 将对齐后的示范动作块交给预先训练好的 ActionCodec |
| 视觉问答 | 从通用和具身图文问答样本取得文本目标 |
机器人样本从八种推理格式中加权选一种,包括直接生成动作的格式。这样模型既能学习在动作前给出中间判断,也能在没有推理文本时工作。
统一的 27 维动作空间
不同本体的控制通道先按身体部件对齐。论文的基础布局共 27 维,每一步都用同样的槽位顺序。一个 步动作块可写成 的数组,其中 表示预测的控制步数。
| 部件 | 维度 | 用途 |
|---|---|---|
| 左侧控制/左夹爪 | 9+1 | 放入左臂控制和左夹爪动作 |
| 右侧控制/右夹爪 | 9+1 | 放入右臂控制和右夹爪动作 |
| 下半身 | 7 | 为支持的躯干、底盘等动作保留控制槽位 |
教学示意。 假设一台右臂机器人只有五路关节控制和一路夹爪。把示范的一步动作放进右侧对应槽位,就可以和双臂示范一起表示。空槽用占位值补齐。生成时,模型只需发出活跃部件的代码。执行时,从解码结果里取回这台机器真正使用的通道,再映射回其控制接口。
这是一例简化映射。实际机器人采用自己的关节或末端定义、槽位映射与归一化统计。27 维布局也不同于 LeRobot SO-101 转换检查点内部使用的 20 维布局。
核心网络:把场景判断接到动作代码
一次策略查询里发生了什么
G0.5 从 Qwen3.5-2B 初始化。图像通过视觉编码器形成视觉表示,与任务指令、当前本体状态和本体标识一起提供给解码器。开启具身推理链(Chain of Thought,CoT)时,解码器先生成指定的推理字段,例如要完成的子任务和把手所在的目标框。接下来,它以同一份输入和刚生成的推理为条件,继续预测动作词元。ActionCodec 把这些词元还原为连续动作块,再交给机器人执行。
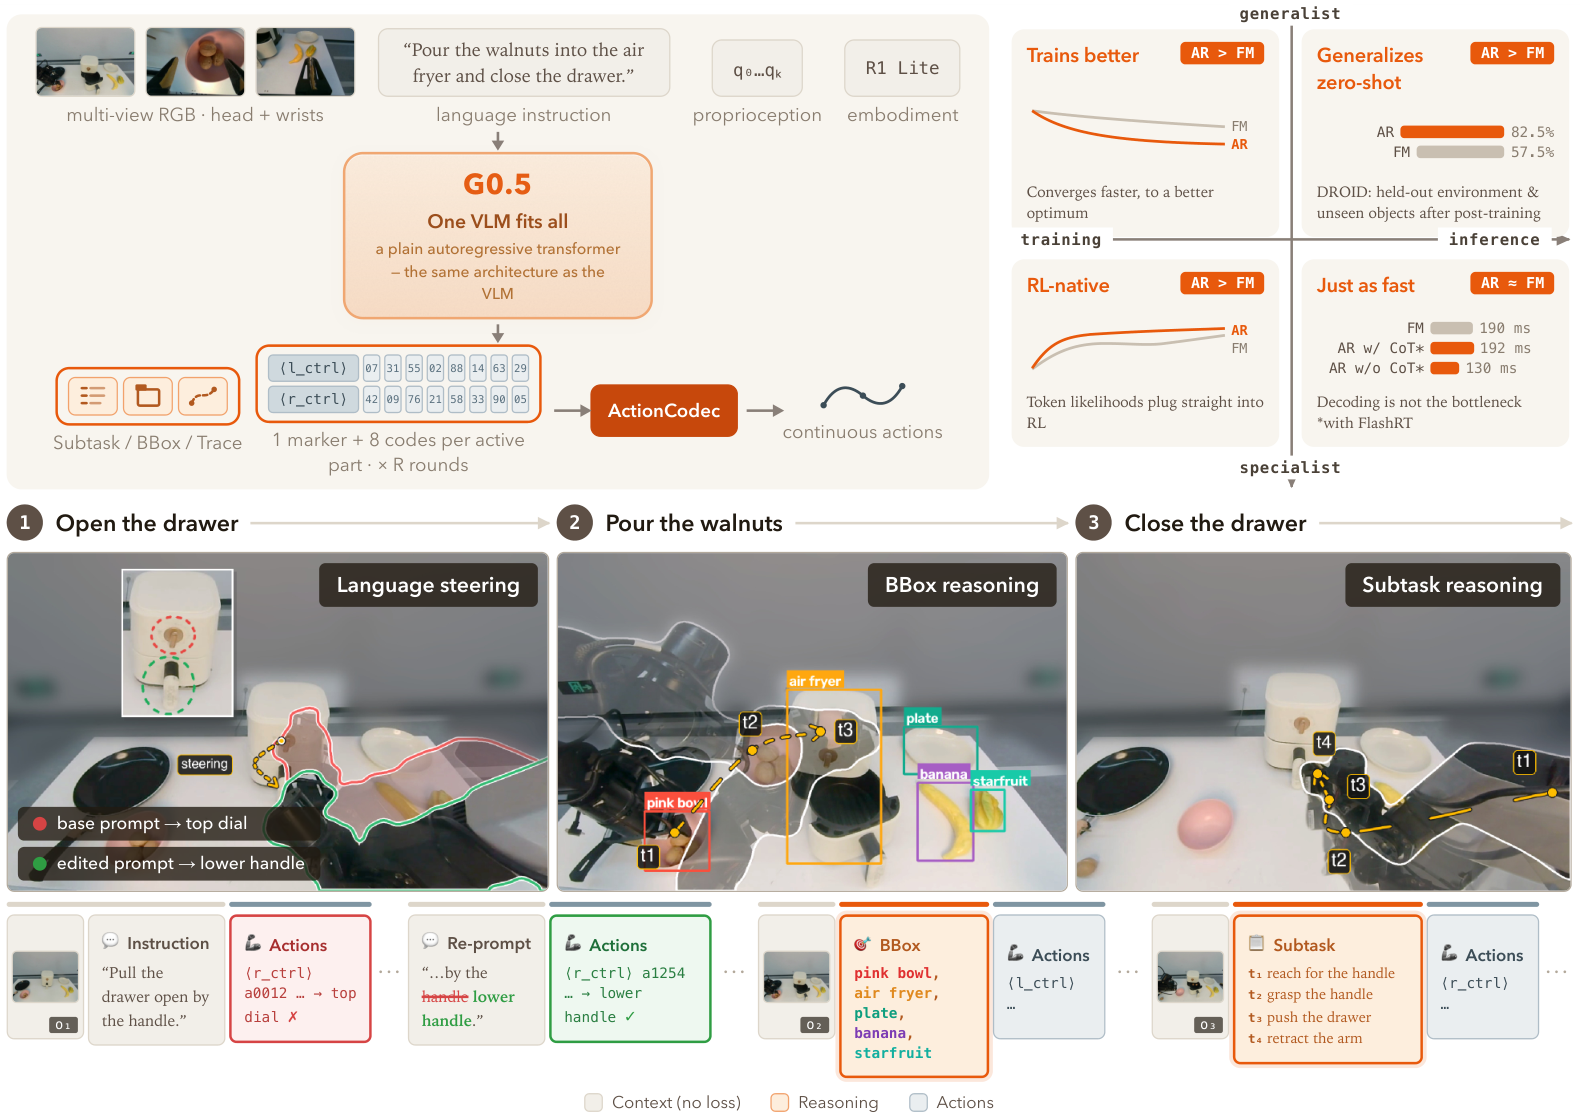
架构图左上展示四类输入怎样经过推理和动作编码变成连续控制。下方三幅图分别对应拉开、倒入和关上,每一阶段都有新观测。开抽屉的例子里,改写提示把目标从上方旋钮指向下方把手,是作者的行为观察。右上汇总了不同协议的结果,受控的推理开关比较见后文实验。
ActionCodec 怎样减少动作词元
右臂拉开抽屉时,动作块包含从接近到拉动的多步控制,左臂可能全程静止。ActionCodec 把右臂这一段运动压成少量代码。模型还可以省去静止部件的代码,减少需要逐个预测的词元。
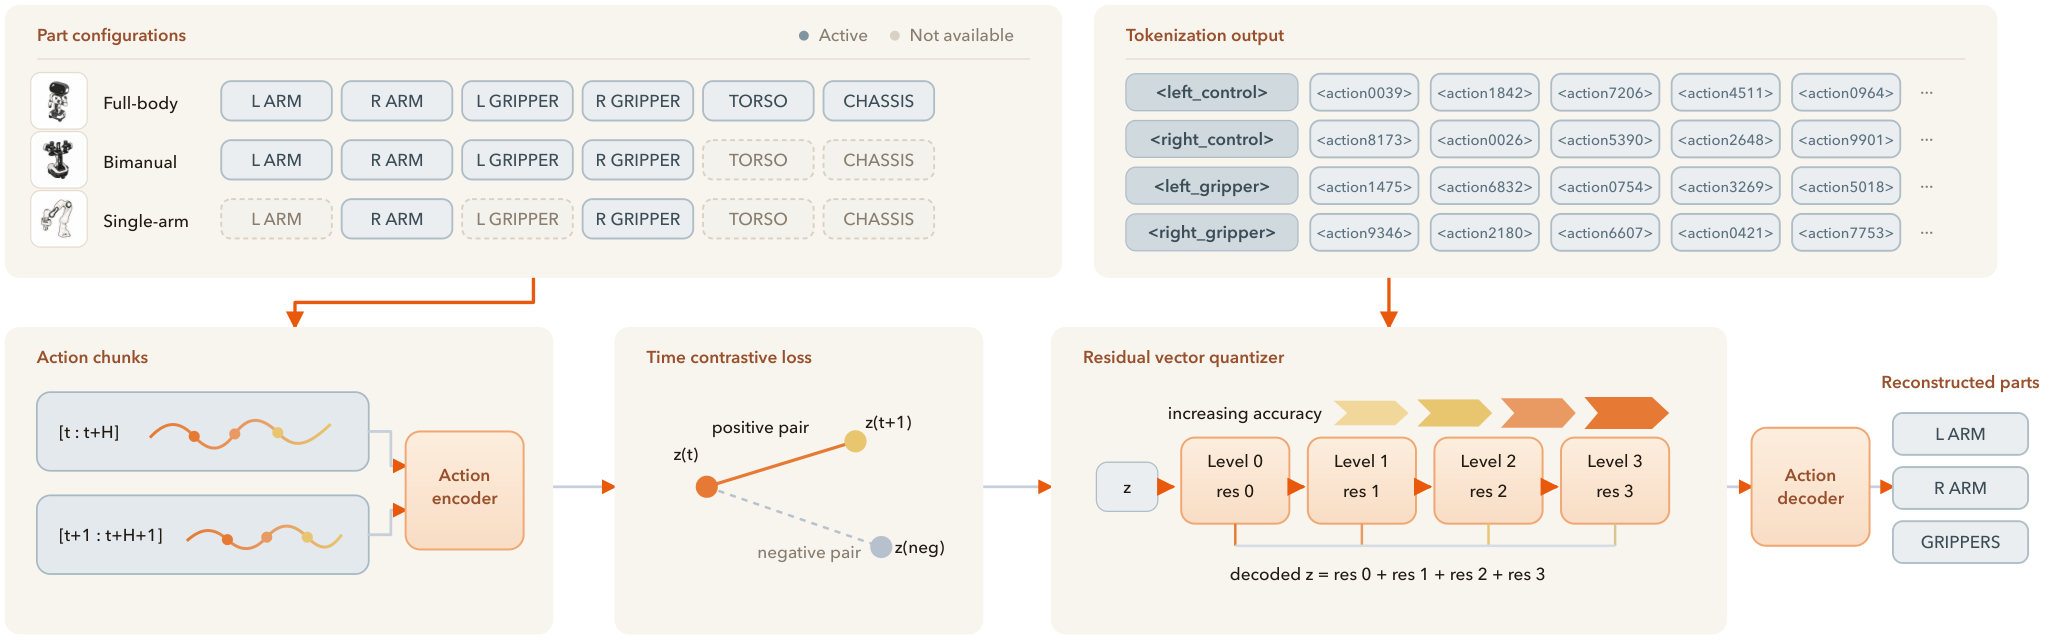
从左向右看,不同本体的动作先填入对应部件,再按组编码。量化器输出离散索引,词元序列保留索引所属的运动部件。图中间的时间对比目标约束相邻时刻的相似运动,使其编码更一致。
残差向量量化(Residual Vector Quantization,RVQ)用多轮查表近似一个动作片段的潜向量。第一轮查到最接近的向量,第二轮对第一轮剩下的误差查表。解码时按索引取出各轮向量并相加,再由编解码器恢复动作。
教学例子。 只看一个没有物理单位的潜变量,目标值为 。首轮查到 ,余下 。第二轮查到 ,两轮相加得到 ,误差从 降到 。实际编码保存的是表中向量的索引。
每轮给每个活跃组写 1 个组标记加 8 个动作代码。假设用两轮,只有右侧组运动时,生成主体需 个词元。左右两组都活跃时需 个。这个计数忽略序列边界和推理文本,也说明了为什么统一布局里的占位通道可以存在,而空闲部件仍然能在生成序列里省略。VLM 学习预测这些索引,ActionCodec 学习编码和重建动作,两者的学习目标各有用途。
序列模板将两臂标记写为总是输出。论文对动作分词的描述允许省略空闲组,上面的词元计数按这一设定计算。
推理为什么会影响动作
目标框说明在哪里,子任务说明接下来做什么。 同一序列可以包含以下四类推理输出。
| 生成字段 | 在抽屉场景里提供的信息 |
|---|---|
Subtask | 说出当前操作,例如“抓住下方把手” |
BBox | 给出目标在图像中的边界框 |
Trace | 描述末端执行器在图像平面上的轨迹 |
ActionHint | 提示局部运动,例如接近后合爪 |
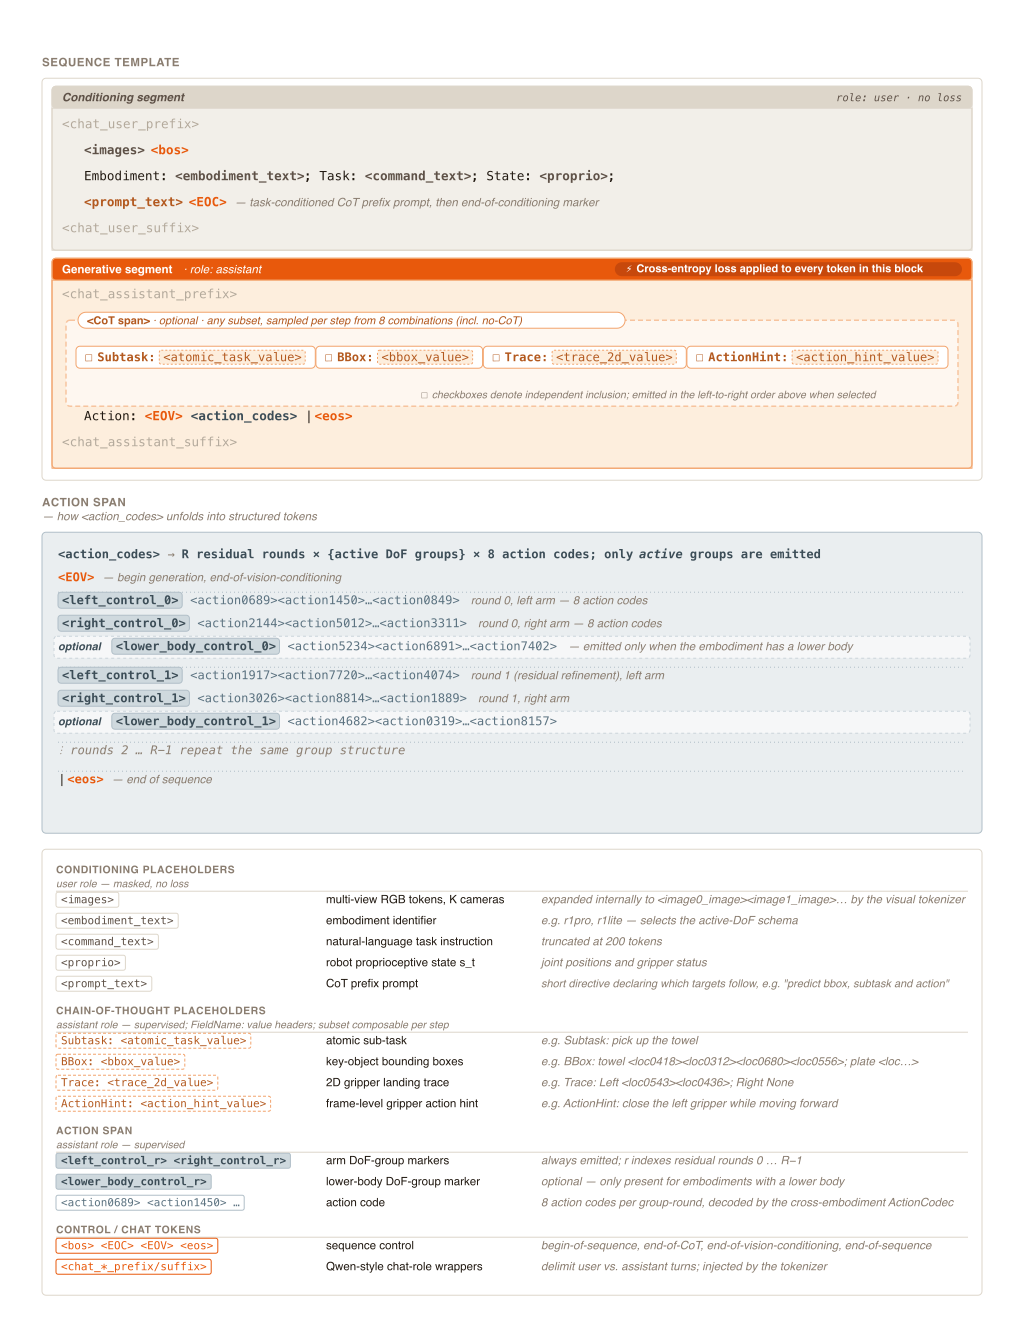
条件段含图像、本体、状态和提示。下方生成段先放所选推理字段,再放带组标记的动作代码。可选 FM 头根据主干隐藏状态生成连续动作,启用 CoT 时也可以利用推理后的上下文。
教学例子。 拉开抽屉前,模型根据画面和当前姿态,生成“抓住下方把手”的子任务和把手的边界框。解码器接着读取刚生成的子任务和框坐标,预测右臂接近把手的动作代码。执行一小段后,机器人用新画面和状态更新下一轮的条件。
训练时两类输出共用下一词元交叉熵。论文式(1)为
是解码器参数, 是生成段的位置集合。 是位置 的目标词元, 包含条件及前面的目标词元。条件段提供上下文,损失对生成段求和。假设一个子任务词元和一个动作代码的目标预测概率分别为 和 ,两项损失合计 。训练中可利用标注好的前缀,推理时动作受到模型自己生成的前缀影响,因此推理错误也有机会传到动作。
几秒钟的视觉历史怎样进入模型
手腕伸向抽屉时可能挡住把手。前几帧还能看到把手,当前帧只剩手腕。G0.5 在视觉 Transformer 中每隔四层加入分解式时空注意力,分别融合空间图块与不同时间的观测。最后一层只把已经吸收历史信息的当前帧表示交给解码器。带历史的路径使用连续状态嵌入,将机器人状态与对应时刻的画面对齐。
训练中会随机整组丢弃历史帧,让视觉编码器也适应只看到当前画面的情况。论文在 BEHAVIOR 后训练中使用单帧。作者将部分长程收益归因于历史预训练,实验没有单独量化该模块的贡献。
训练和实际使用怎样衔接
| 阶段 | 提供什么 | 学到什么或输出什么 |
|---|---|---|
| 编解码器训练 | 已对齐并分组的连续动作 | 学会把动作块压缩为离散索引,再用这些索引重建动作 |
| VLA 预训练 | 图像、指令、状态,以及由固定编解码器产生的动作代码和推理标注 | 用下一词元交叉熵学习推理和动作代码,也学习回答 VQA |
| 下游后训练 | 目标任务示范与对应本体的观测和控制接口 | 得到用于特定机器人或基准的检查点 |
| 推理执行 | 最新观测、任务指令、本体标识与状态 | 可选推理 → 动作代码 → 连续动作块 |
按论文主路径,机器人执行一部分动作,再采集新画面和状态并重新预测。以前面关抽屉为例,推到一半如果把手发生位移,下一轮动作可以根据实际位置重新生成。这个反馈循环依赖观测与重规划。不同平台或检查点的预测和执行长度分别由各自的配置确定。
实验:改善发生在哪里,还剩什么困难
切换推理开关,比较同一动作头
作者用同一个 G0.5 检查点交叉切换 AR/FM 动作头与 CoT 开/关,共四种设置。启用 CoT 时,两种动作头都能利用生成后的上下文。单阶段拾取放置评估使用 64 次试验。长程评估包括空气炸锅和煎培根,每个任务分五个阶段,每种设置各跑五次,运行时提供当前阶段的子目标。
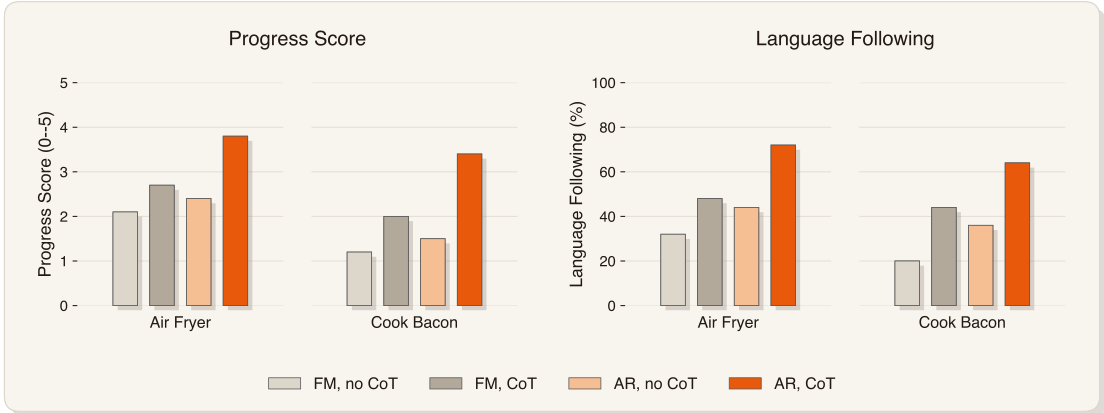
左图统计完成的阶段数(0–5),右图统计语言遵循率。开启 CoT 后,空气炸锅任务中 AR 平均完成的阶段数从 2.4 升到 3.8,FM 从 2.1 升到 2.7。单阶段拾取放置的变化小得多,AR 的语言遵循率从 65.6% 升到 67.2%。这组结果支持 CoT 在给定阶段目标时帮助定位和执行。改写动词或方位提示所带来的行为变化仍是小样本定性观察。
拾取放置:选对目标与完成动作分别计分
R1-Lite 在有干扰物的桌面上,把指定物体放进指定容器。两种模型各做 64 次真机试验,使用相同指令、物体摆放和初始姿态。测试包含后训练数据中见过和没见过的物体类别。
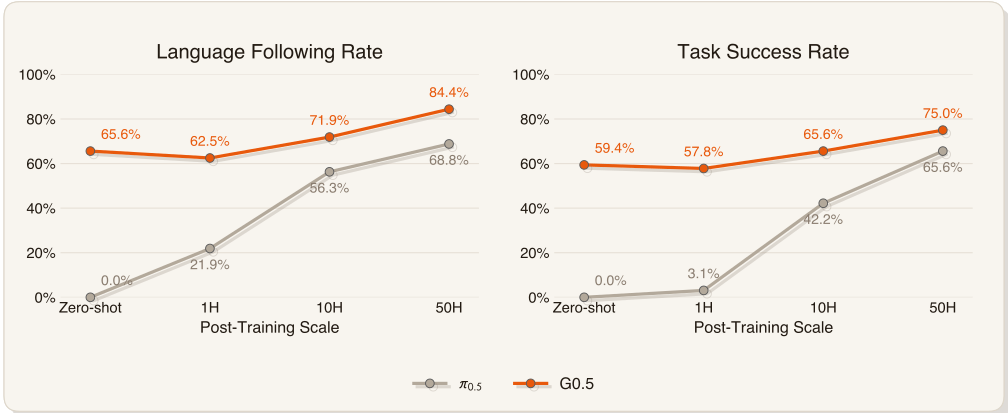
左图的语言遵循率看机器人是否靠近正确物体并尝试抓取。右图的任务成功率还要求抓稳并放入指定容器。例如,机器人尝试抓对物体却中途掉落,这次仍计入语言遵循,任务记为失败。50 小时专项后训练后,G0.5 的两项成绩分别为 84.4% 和 75.0%,π₀.₅ 分别为 68.8% 和 65.6%。
DROID:迁移到新环境,低对比度仍会失手
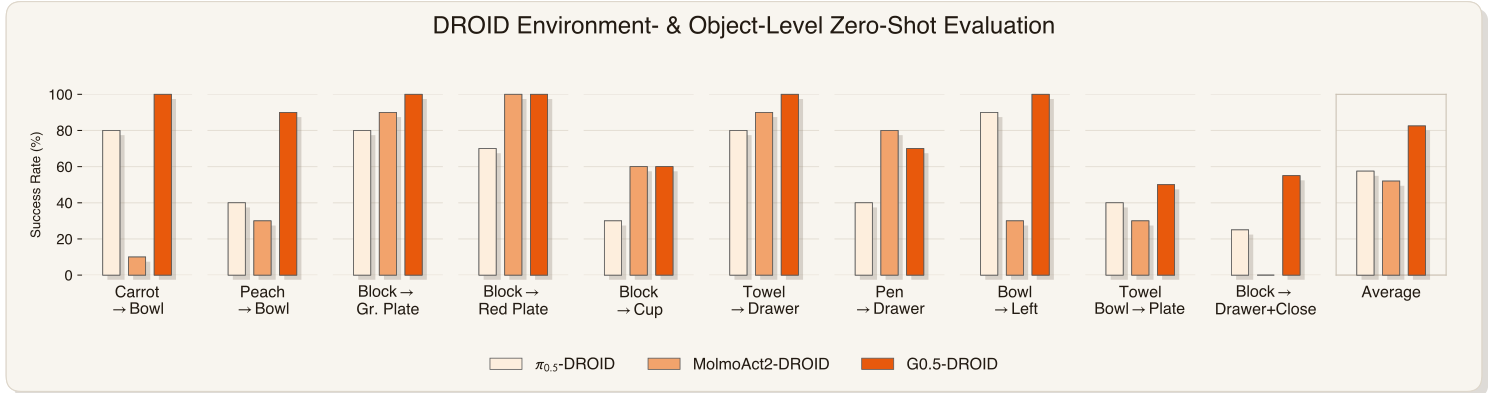
横轴为 10 项操作任务及其均值,纵轴为按论文协议计算的成功率。各模型先用 DROID 数据训练,再对留出的真实环境和物体实例测试,每项各 10 次。最后一项允许部分完成记 0.5 分。G0.5 平均为 82.5%,π₀.₅-DROID 为 57.5%,MolmoAct2-DROID 为 52.0%。
在低对比度抽屉里放入毛巾时,G0.5 成功率为 60%。加上高对比度标记后变为 100%。平均领先的同时,个别任务仍受目标是否容易看清影响。
真机微调与长程操作:均值和单项怎样读
| 评估 | 设置 | 论文结果 |
|---|---|---|
| R1-Lite/R1-Pro 真机 | 两台移动双臂平台。四个任务形成六组任务与本体组合,每组 15 回合。各模型对齐数据和训练预算。 | G0.5 平均成功率 76.7%,π₀.₅ 为 53.3%,GR00T-N1.7 为 24.4% |
| 2025 BEHAVIOR Challenge | 50 项家务,每项 10 个实例。分数按目标条件的完成比例计,允许部分得分。 | G0.5 单检查点后训练 1/4 轮分别为 0.2904/0.3136,π₀.₅ 4 轮为 0.2626 |
真机测试的 R1-Lite 与 R1-Pro 每臂分别有 6、7 个自由度,均使用外部相机和双腕相机。搬箱叠放一项,π₀.₅ 的 93.3% 高于 G0.5 的 80.0%。BEHAVIOR 对两种单检查点策略各取两次评估的平均。竞赛冠军方案使用四个检查点,得分为 0.2605。这两项都比较完整策略,单个模块的作用需要另外控制变量。
三个标准仿真基准的分数也来自各自的适配协议。LIBERO 用微调后的策略,在四个任务套件中测得平均 98.9%。RoboTwin 2.0 在干净和随机场景平均 93.3%。Bridge 在真机示范上后训练,以不提供本体状态的设置转入 SimplerEnv,得到 87.3%。这些结果衡量整体控制效果,与前面的 CoT 开关比较回答的问题不同。
动作以词元生成还有一个训练上的用途。AR 策略直接给出所选词元的对数概率,可用于基于概率比的强化学习。作者在四个起始成功率相近的 LIBERO 任务上比较 GRPO 微调,AR 的最终平均成功率更高。比较对象是论文中带随机去噪近似的 FM 版本,证据限于这组低示范量设置。
LeRobot 接入与论文结果的边界
实现补充。 policy.action_head 决定用 ActionCodec 解码还是用 FM 生成连续动作。policy.runtime_system 决定是否先生成推理。System 1 直接出动作。System 2 在同一次策略查询里先生成子任务、或生成目标框加子任务,再据此生成动作,需要检查点配置 predict_cot=true。所以动作头与是否启用 CoT 是两个独立配置。
| 检查点 | 发布的动作路径 | 预测/执行 | 接口要点 |
|---|---|---|---|
lerobot/g05_base | 显式选 ActionCodec 或 FM,可启用 CoT | 32/16 步 | 27 维全身布局,随包 R1 Lite 处理器为头部和双腕、6 帧含当前帧 |
lerobot/g05_libero | FM、System 1 | 32/10 步 | 单臂末端与夹爪映射到 20 维,外部与右腕相机 |
lerobot/g05_robotwin20 | FM、System 1 | 32/8 步 | 双臂与夹爪映射到 20 维,高位与双腕相机 |
lerobot/g05_so101 | ActionCodec 或 FM,可启用 CoT | 32/16 步 | 单臂 6 路控制映射到 20 维,外部与右腕相机,左腕槽可留空 |
以 SO-101 的同步策略为例,模型预测 32 步,但动作队列只放入前 16 步,队列用完后再查询策略。20 维是内部布局,输出处理器按检查点携带的统计量反归一化,并映射回 6 路控制。训练普通示范可以提供动作目标,要训练子任务和目标框还需对应标注。论文的仿真分数采用 Galaxea 的评估设置,LeRobot 的 LIBERO、RoboTwin 转换版使用连续头,应按实际检查点配置评估。移植代码和检查点采用含非商业限制的 G0.5 Community License。
结论
G0.5 的设计把两个问题接在一起:通过分组量化把多步控制压缩成可生成的词元,再让这些词元读取同一轮已经生成的子任务和目标位置。最直接的证据来自同一检查点切换 CoT 的试验。它在已提供阶段目标的五阶段任务上改善进度,而在单阶段拾取放置上变化很小。视觉记忆只覆盖数秒,低对比度抽屉的失败仍表明,看清目标和做出正确动作都受实际观测条件限制。
原图引自 Galaxea Team 的 arXiv v1,保留原始内容与图例。论文许可 CC BY-NC-SA 4.0