GR00T N1:通用人形机器人开放基础模型
GR00T N1: An Open Foundation Model for Generalist Humanoid Robots
- 人形机器人
- 双系统架构
- 数据金字塔
- 流匹配
先验知识
从 ACT 到 GR00T N1:机器人学习的闭环没有变
如果你已经跑过 LeRobot + ACT,那么你已经熟悉这条链路:
人类遥操作
    ↓
采集 Camera / State / Action
    ↓
整理成 Episode Dataset
    ↓
训练 Policy
    ↓
Observation → Action Chunk → 真机执行
GR00T N1 仍然在回答同一个问题:
机器人现在看到了什么、身体处于什么状态、用户要它做什么,接下来应该怎么动?
区别是,ACT 通常针对“一种机器人 + 一类任务”从示范数据里学习;GR00T N1 希望先从多种机器人、人类视频和合成数据中学到通用能力,再适配到某一台真实机器人。
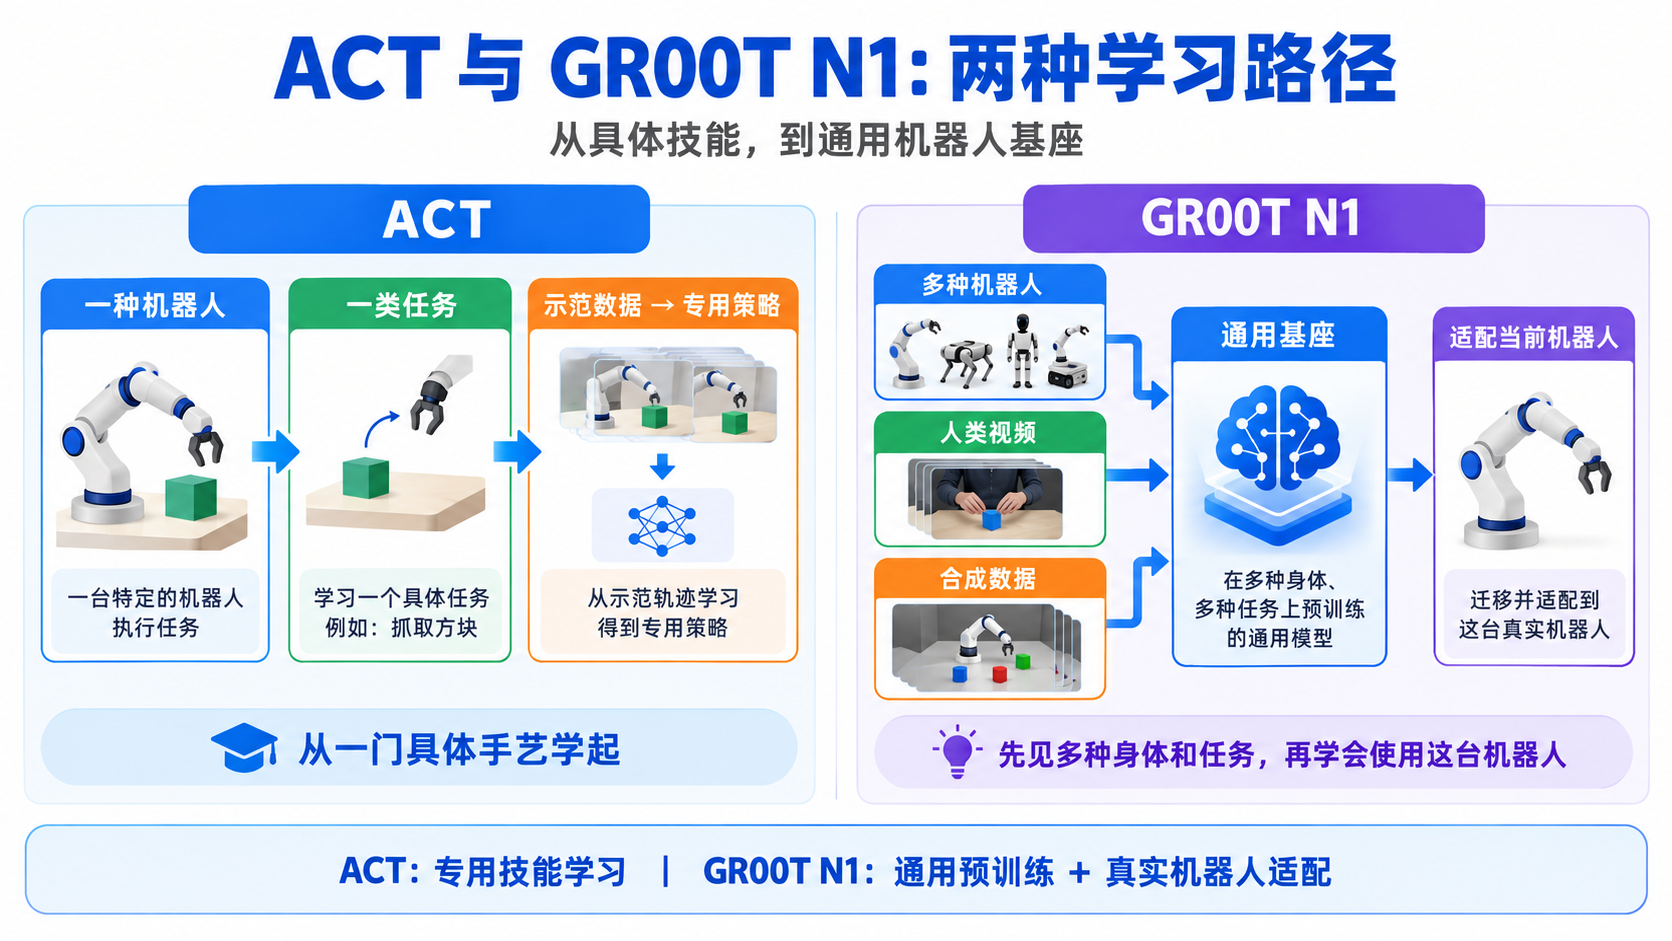
ACT 是让机器人从一门具体的手艺学起;GR00T N1 是先训一个见过很多身体和任务的“基座”,再教它使用当前这台机器人。
Observation、State、Action 和 Embodiment
ACT 中已经出现的三个词,在 GR00T N1 中仍然不变。
-
Observation(观测):相机看到的外部世界,例如头部相机、腕部相机和多视角 RGB 图像。
-
State(状态):机器人对自身姿态的描述,例如关节角度、夹爪开合、末端位姿、腰部和颈部状态。
-
Action(动作):模型要求机器人执行的控制量,可能是关节目标、关节增量、末端位姿或夹爪命令。
GR00T N1 还频繁使用 Embodiment(具身形态) 这个词。它不只是“机器人外形”,而是一整套身体和控制定义:
机器人结构
+ 传感器
+ State 定义
+ Action 定义
+ 控制频率与控制方式
= 一种 Embodiment
例如单臂 Franka、双臂机器人和 GR-1 人形机器人的 State / Action 维度完全不同。GR00T N1 的重要问题之一,就是如何让这些不同的身体共用同一个模型主体。
VLA、Action Chunk 和 Flow Matching
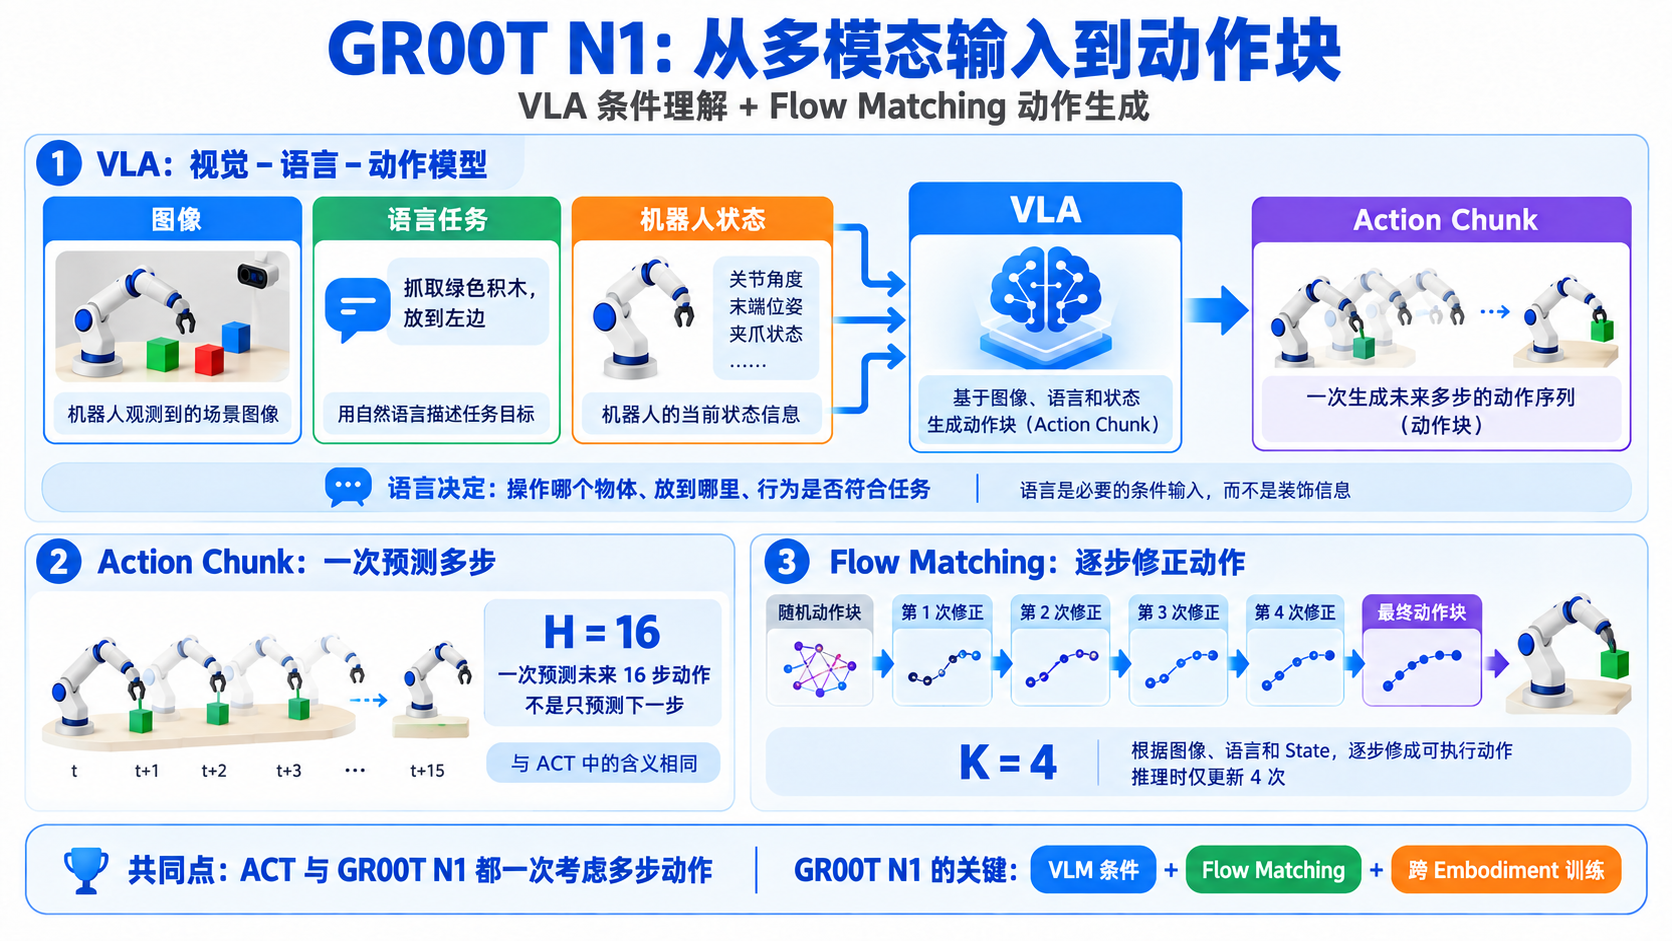
VLA(Vision-Language-Action) 是视觉-语言-动作模型。普通视觉策略是“看图 + 看状态 → 动作”,VLA 还会读取语言任务:语言决定“要操作哪个物体、放到哪里、当前行为是否符合任务”,不是装饰信息。
Action Chunk 与 ACT 中的意思相同:一次预测未来一小段动作,而不是只预测下一步。GR00T N1 设定动作块长度 H = 16。
Flow Matching 可以先理解成“从一段随机动作出发,根据图像、语言和 State,逐步把它修成可执行的动作块”。论文推理时只做 K = 4 次更新。
摘要
通用机器人需要灵活的身体和智能的“大脑”。近年来,人形机器人展示出在人类环境中构建通用自主能力的潜力。要让机器人理解新情况、应对真实世界的变化,并快速学习新任务,需要一个由大规模、多样化数据训练的机器人基础模型。
为此,作者提出 GR00T N1,一个面向人形机器人的开放基础模型。GR00T N1 是采用双系统架构的 VLA 模型:视觉语言模块(System 2)通过图像和语言理解环境与任务;后续的 Diffusion Transformer(System 1)实时生成流畅的机器人动作。两个模块紧密连接,并以端到端方式联合训练。
模型的训练数据混合了真实机器人轨迹、人类视频和合成数据。实验表明,GR00T N1 在多种机器人形态的标准仿真基准上优于当时的模仿学习基线;在 Fourier GR-1 人形机器人上,它也能以较高的数据效率完成语言条件下的双臂操作任务。
摘要中有三句话决定了整篇论文的结构:
-
双系统 VLA:一部分负责看懂,一部分负责动起来。
-
异构数据混合:不只使用真机示范,还使用人类视频、仿真和生成视频。
-
跨 Embodiment:不是给每台机器人各训一个完全独立的模型,而是让不同身体共享主体能力。
引言与相关工作
从 Hardware、Model、Data 到“数据孤岛”
引言首先把通用机器人拆成三个不能缺少的部分:
-
Hardware 决定机器人的能力边界,人形身体之所以有吸引力,是因为人类环境本来就是按照人的身体设计的。
-
Model 需要支持开放任务,不能只完成一个固定动作。
-
Data 决定模型能见过多少环境、物体、任务和机器人身体。
语言和视觉基础模型能从互联网获得海量数据,但机器人没有对应的“动作互联网”。真实机器人数据昂贵、采集慢,而且每台机器人的关节、传感器、控制方式都不同。
即使把多台机器人的数据集放在一起,它们也容易变成一座座 Data Islands(数据孤岛):在磁盘上同属一个数据库,但在语义和动作空间上仍然互不相通。
这也是论文与普通单机器人模仿学习工作的根本区别:作者不只在问“策略网络怎么设计”,还在问“训练语料怎么统一”。
Data Pyramid:整篇论文的数据总纲
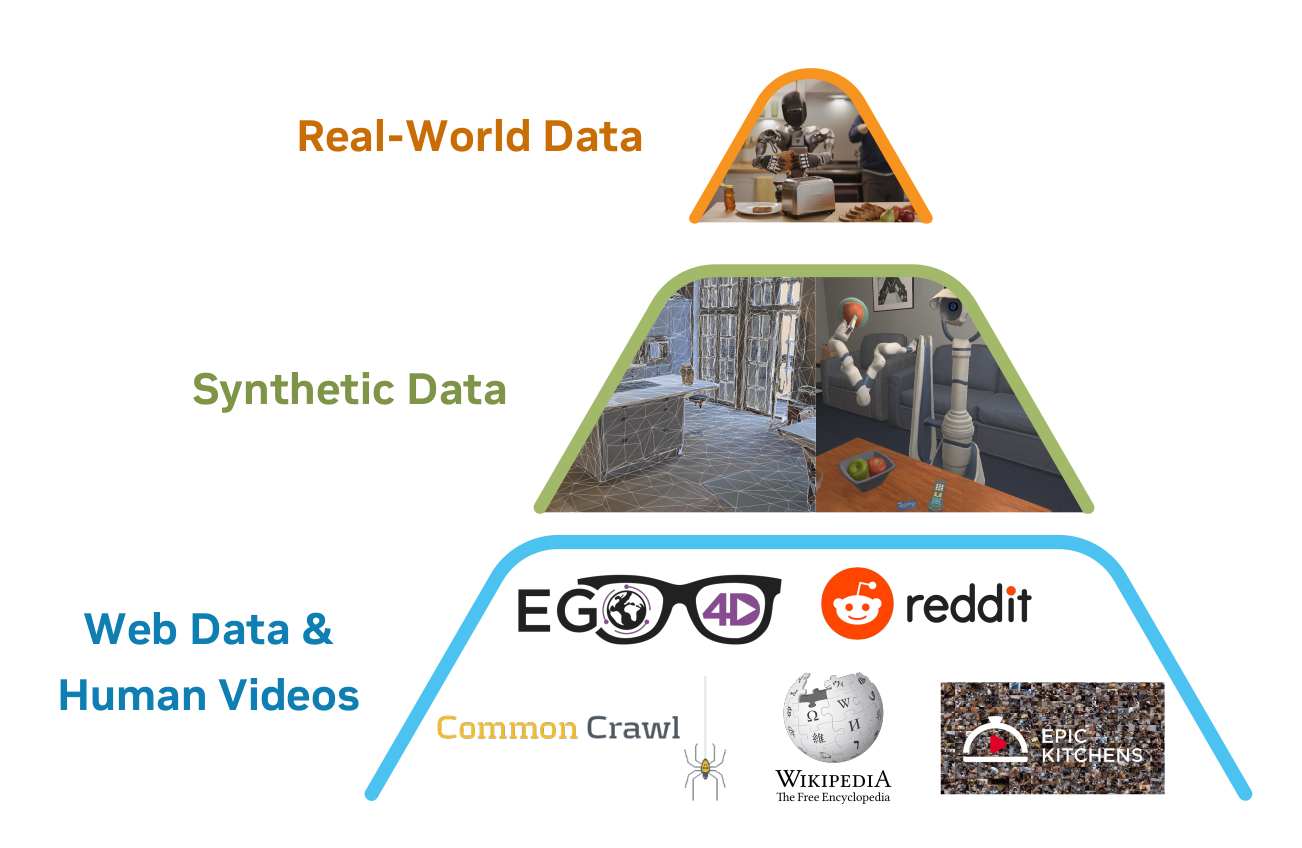
| 位置 | 数据 | 数量 | 与真实机器人的关系 |
|---|---|---|---|
| 底层 | Web Data + Human Videos | 最多 | 动作概念丰富,但没有真实 Robot Action |
| 中层 | Simulation + Neural Trajectory | 较多 | 可控、可扩展,但存在仿真或生成偏差 |
| 顶层 | Real-World Robot Data | 最少 | 最接近真实执行,但采集成本最高 |
从底层向顶层,数据量逐渐减少,但对具体 Embodiment 的针对性越来越强。
人类视频告诉模型:世界上有哪些动作和任务 仿真/生成数据告诉模型:这些任务还可以怎样变化 真机数据告诉模型:真正的身体应该怎样执行
GR00T N1 网络结构
双系统:System 2 看懂,System 1 动起来
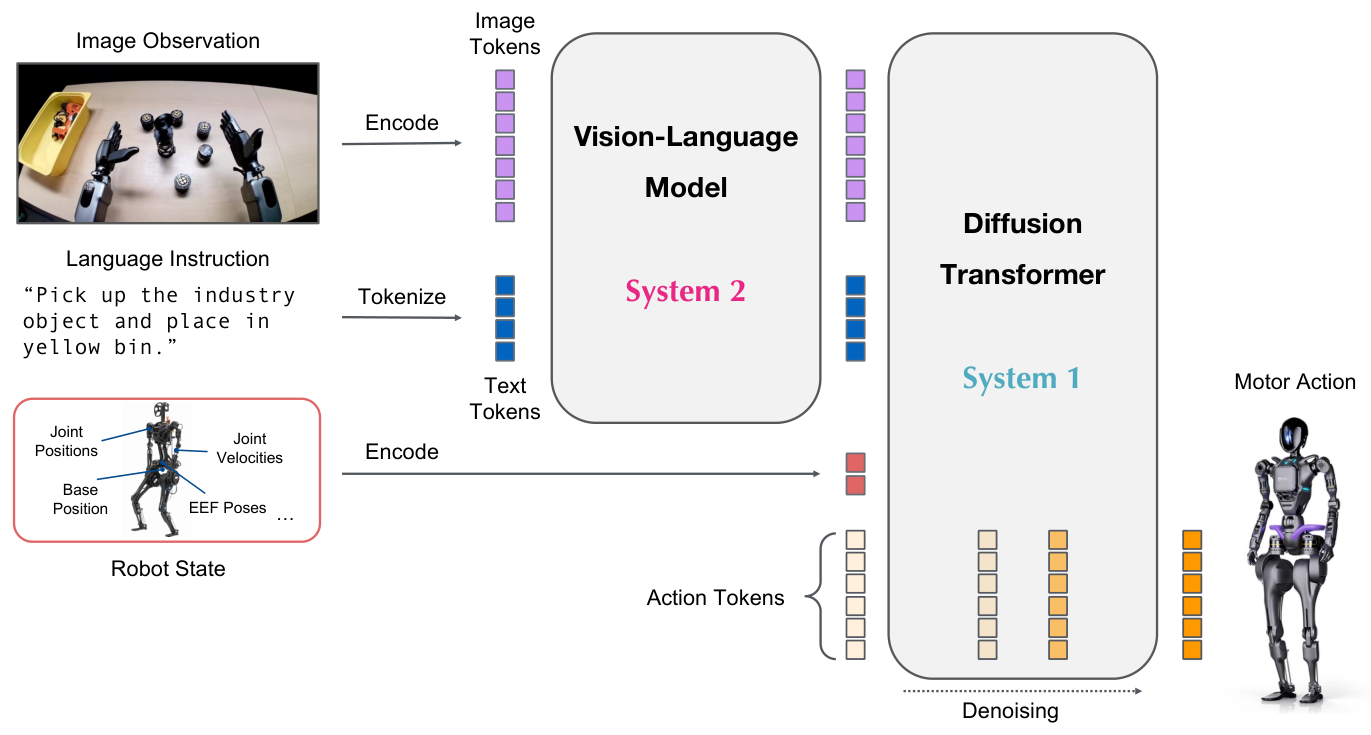
GR00T N1 借用了人类认知中的“双系统”比喻:
-
System 2:Eagle-2 VLM,负责理解图像、语言和任务。
-
System 1:Diffusion Transformer(DiT),负责快速生成连续动作。
不要把它理解成两个互不相干的程序。论文中两者通过 Cross-Attention 紧密连接,并在训练时端到端联合优化。
System 2 的 Eagle-2 由语言模型与图像编码器组成。图像以 224 × 224 分辨率输入,每帧得到 64 个图像 Token。作者使用 VLM 第 12 层的中间特征,而不是最后一层输出;实验中这样推理更快,下游策略成功率也更高。
论文报告 System 2 在 NVIDIA L40 上约以 10 Hz 工作,动作系统则可以更高频率输出闭环动作。这可以理解成:高层语义理解不必每毫秒重算,但底层动作必须连续。
不同机器人怎么接入同一个 DiT
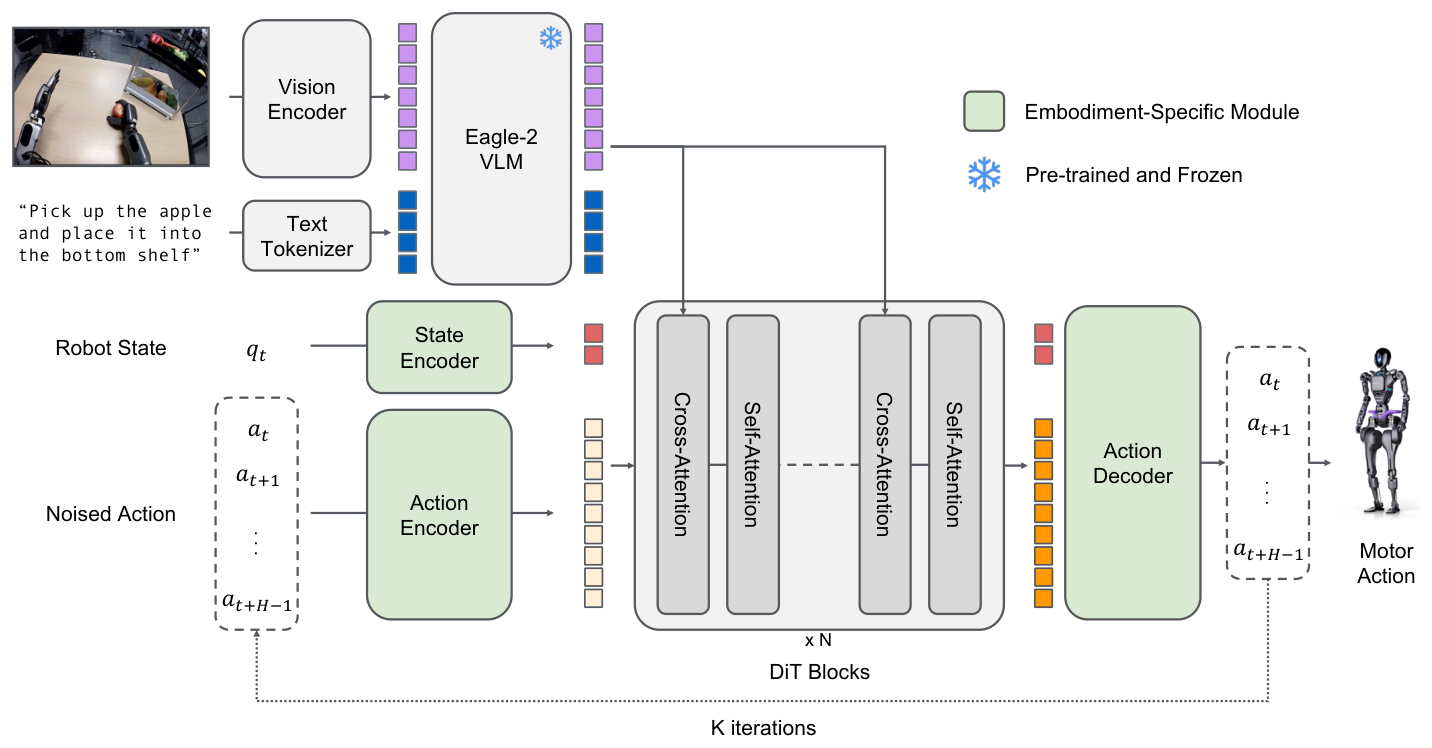
这里有两类模块:
-
共享主体:VLM 和 DiT,尽量从不同机器人中共享视觉、语言和行为知识。
-
Embodiment-Specific 接口:State Encoder、Action Encoder 和 Action Decoder,负责把某台机器人特有的维度与控制语义翻译成共享表示,再把结果翻译回它的 Action Space。
| 模块 | 做什么 | 为什么需要针对 Embodiment |
|---|---|---|
| State Encoder | 将当前 State 编码成 Token | 各机器人的 State 维度和字段含义不同 |
| Action Encoder | 编码当前带噪动作和去噪时间步 | 各机器人的 Action 维度不同 |
| Action Decoder | 将 DiT 的隐表示还原成真实控制量 | 关节、末端、夹爪的控制方式不同 |
批注: 跨机器人学习不是简单地把所有向量用 0 补成同样长。如果不知道每个数值代表哪个关节、哪种位姿和哪类命令,“维度一样”也没有意义。
Action Chunk 怎么通过 Flow Matching 生成
对于时刻 t,模型不只生成一个动作,而是生成:
A_t = [a_t, a_(t+1), ..., a_(t+H-1)]
H = 16
训练时,先准备真实动作块 A_t、高斯噪声 ε 和 Flow Timestep τ,然后构造带噪动作:
A_t^τ = τ A_t + (1 - τ) ε
-
τ接近 0 时,它更像随机噪声。 -
τ接近 1 时,它更像真实动作。
DiT 会同时看到视觉语言特征、State 特征和当前带噪动作,学习一个更新方向。论文的损失写为:
L_fm(θ)
= E_τ [ || V_θ(φ_t, A_t^τ, q_t) - (ε - A_t) ||² ]
其中 φ_t 是 VLM 的视觉语言特征,q_t 是机器人 State 特征。
推理时没有真实动作可以参考,所以从随机动作块开始,使用 Forward Euler 做 4 次更新:
A_t^0 ~ N(0, I)

A_t^(τ+1/K)
= A_t^τ + (1/K) V_θ(φ_t, A_t^τ, q_t)

K = 4
GR00T-N1-2B 总参数量为 2.2B,其中 VLM 约为 1.34B。论文报告,在 L40 GPU 上生成一个 16 步动作块约需 63.9 ms。
数据与训练
视频没有 Robot Action,怎么用来训练
真机轨迹同时拥有图像、State 和 Action,可以直接监督策略。但人类视频和生成视频只有画面,没有机器人关节命令。
GR00T N1 使用两种方法为这类视频补上“动作信号”。
Latent Action(潜在动作) 不尝试恢复精确的关节角,而是学习画面变化中的离散行为编码,例如“向左移”“抓取”“推进”。
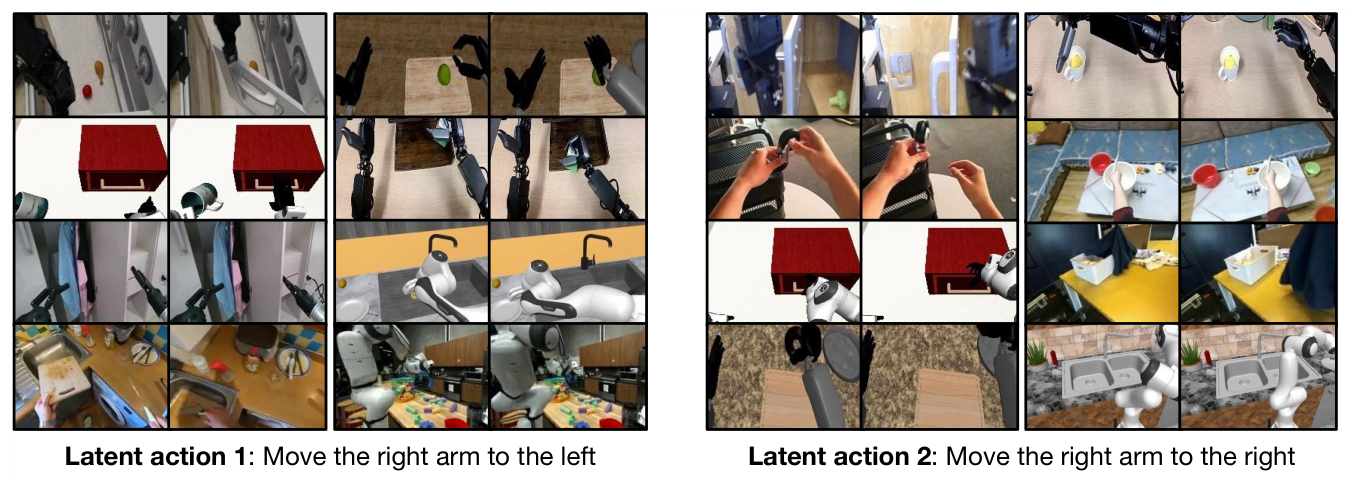
这种表示的优势是,它可以跨越 Embodiment:人的手和机器人的夹爪没有相同关节,但画面中都可能出现“把物体向左移动”。
IDM(Inverse Dynamics Model,逆动力学模型) 则使用相邻画面反推中间发生了什么动作:
Observation_t + Observation_(t+1)
                  ↓
                 IDM
                  ↓
          Pseudo Action Label
Latent Action 更像“无单位的行为词汇”,IDM 更像“反推出的伪动作标签”。两者都不会把人类视频瞬间变成完美的真机数据,它们的作用是让“只有画面”的数据能进入预训练。
Neural Trajectory 和仿真:用少量示范造更多变化
作者使用视频生成模型,从真机初始画面出发,修改语言提示,生成不同任务、物体位置和执行轨迹。这类数据被称为 Neural Trajectory。
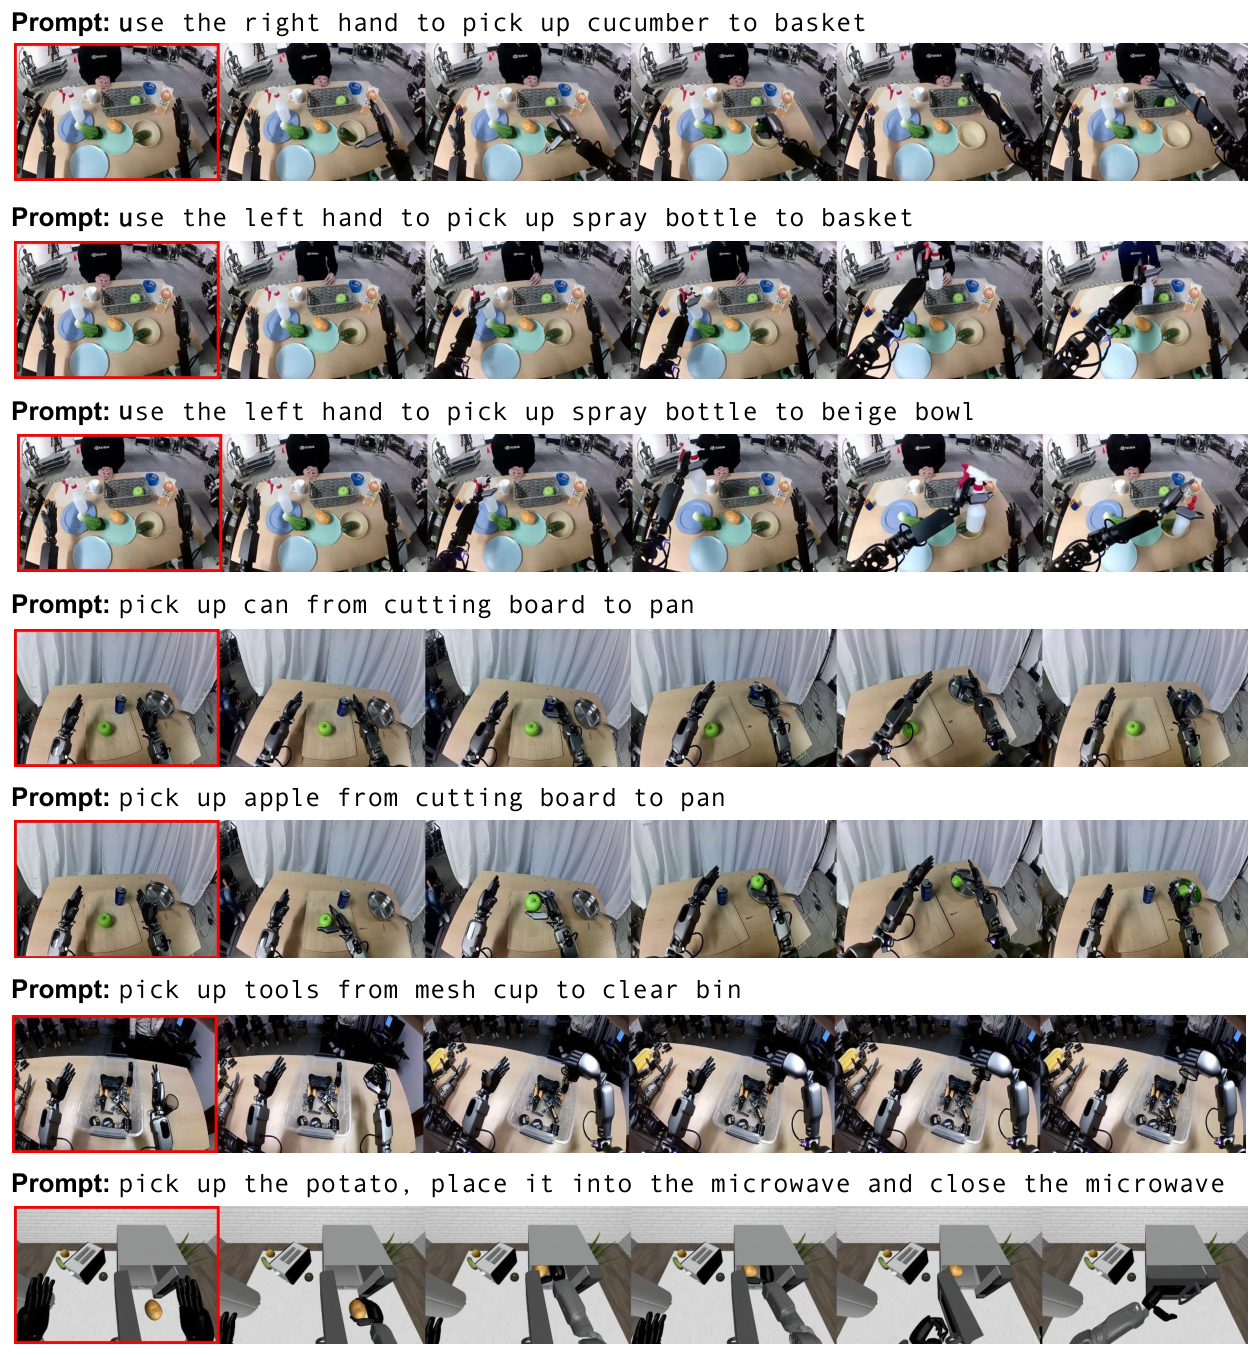
作者把 88.4 小时的内部真机遥操数据,扩展成 827.3 小时生成视频,规模接近 10 倍。但生成视频不能无条件相信,因为它可能出现物体突然移动、接触关系错误或机器人结构变形。因此还需要语言模型和规则过滤低质量样本,并用 Latent Action 或 IDM 补上动作信号。
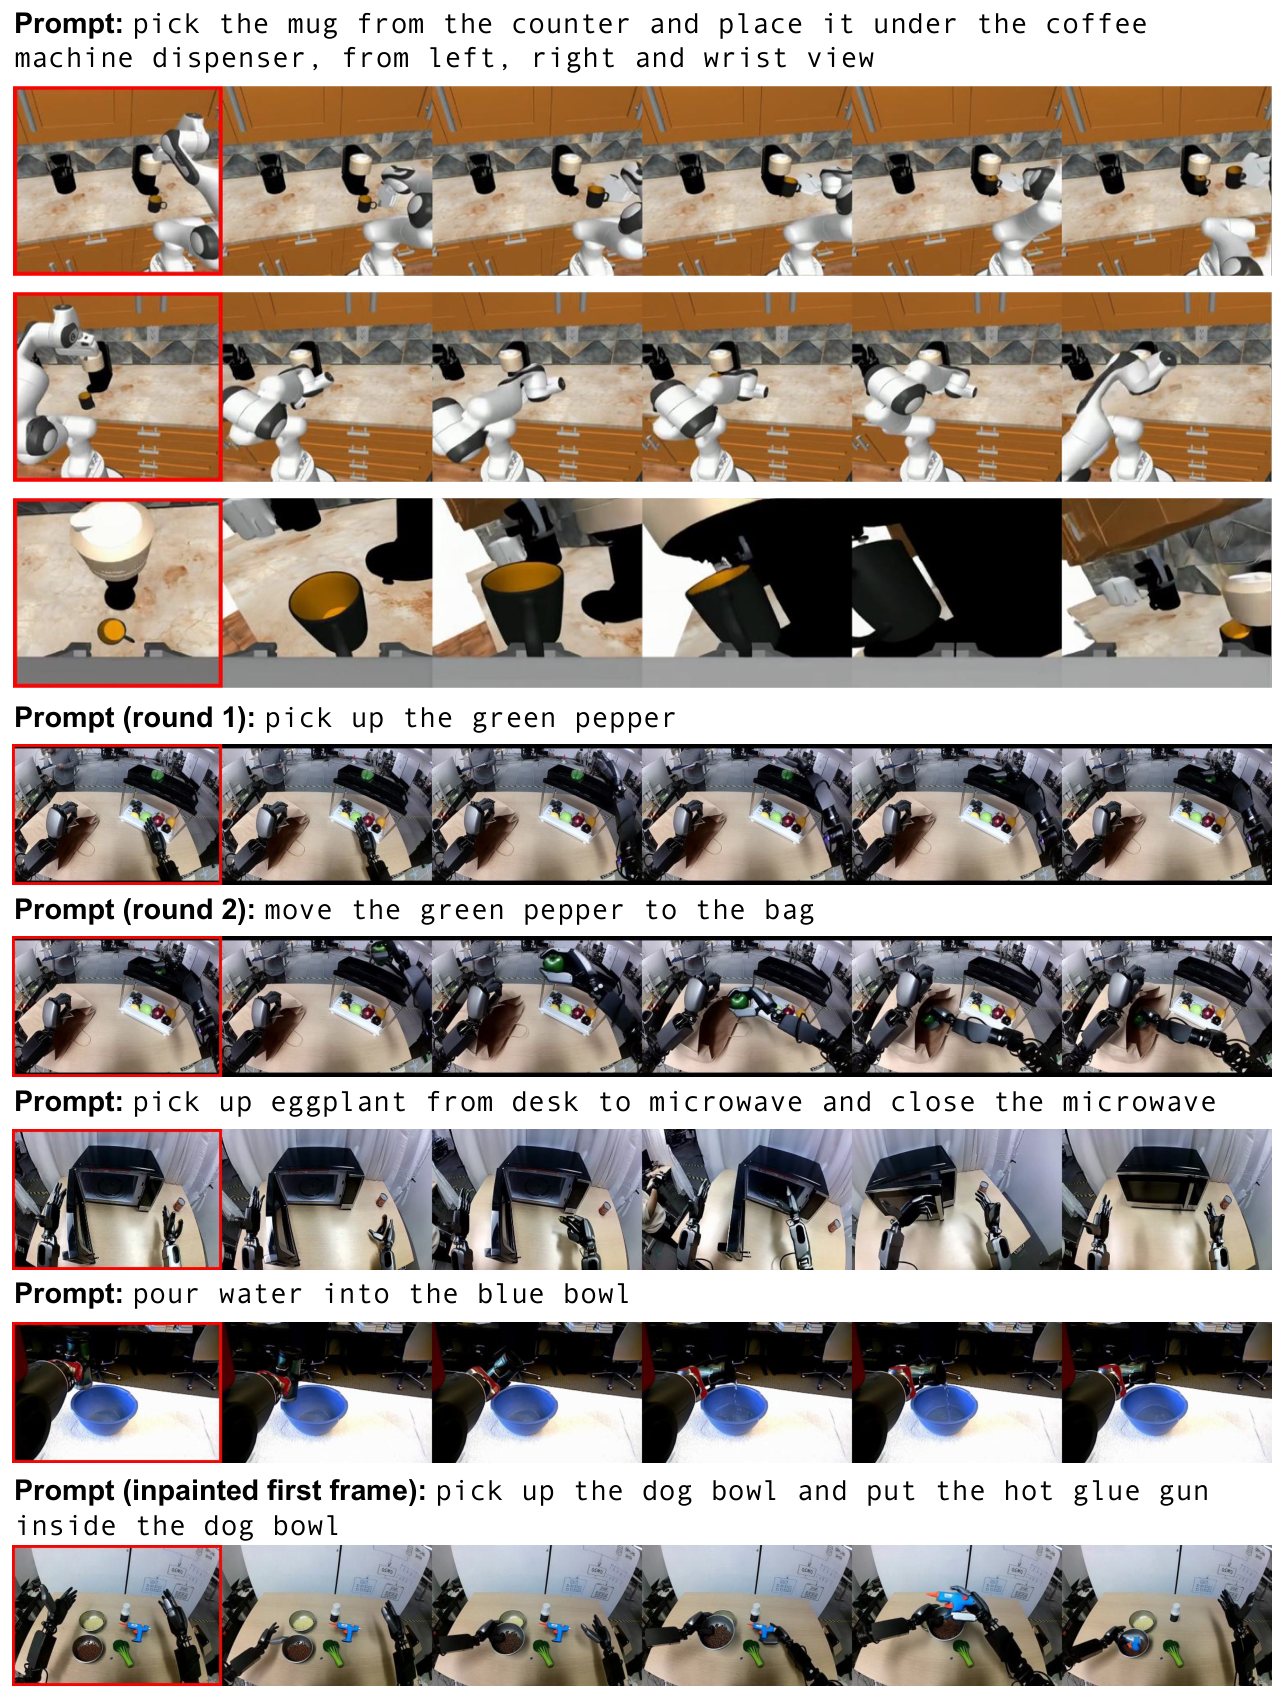
仿真数据的思路与生成视频相似,但它在物理引擎中执行。论文使用 DexMimicGen 等方法,把少量人类示范按照物体中心的轨迹表示重定位到新场景,共生成约 78 万条仿真轨迹,相当于约 6,500 小时数据。
两者的区别:
-
Neural Trajectory 更容易制造视觉与语义变化,但物理可信性有限。
-
Simulation Trajectory 可以提供准确动作标签和物理交互,但仿真环境与真实世界仍有差距。
Pre-training 和 Post-training
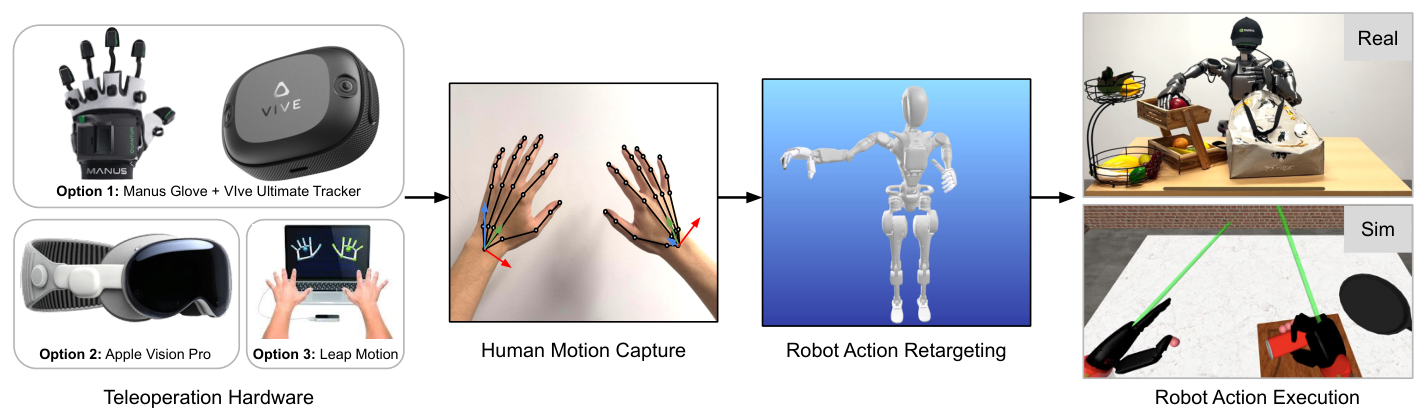
真机数据的采集来自多种遥操设备,包括 Manus、VIVE、Apple Vision Pro 和 Leap Motion,再通过动作重定向映射到机器人。
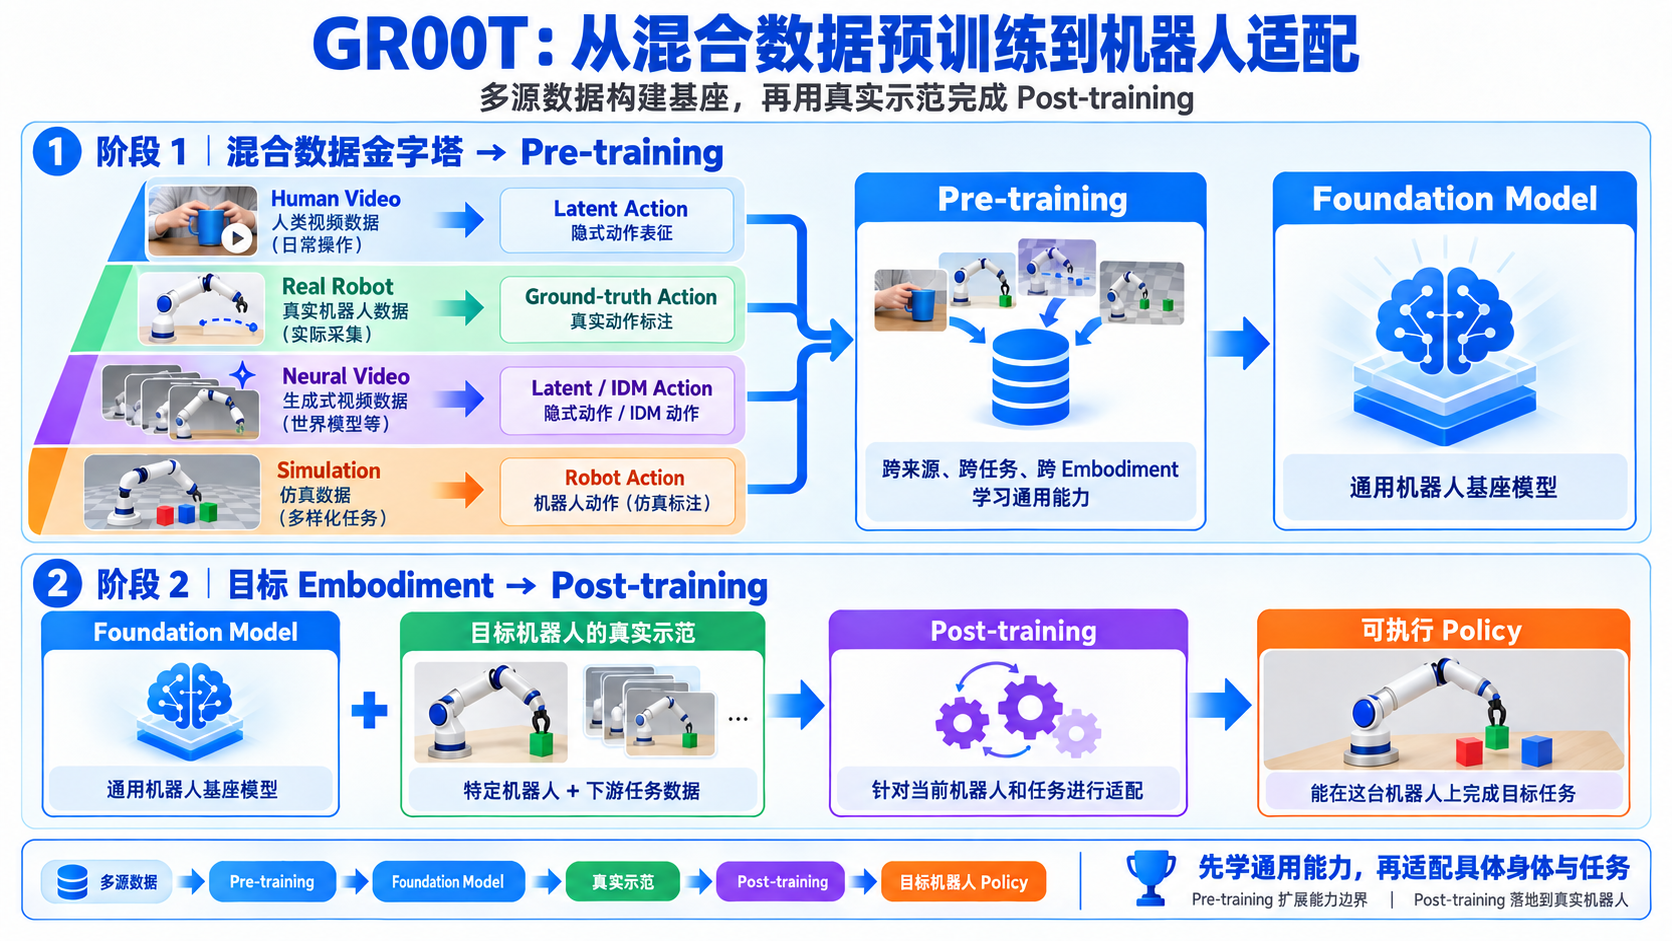
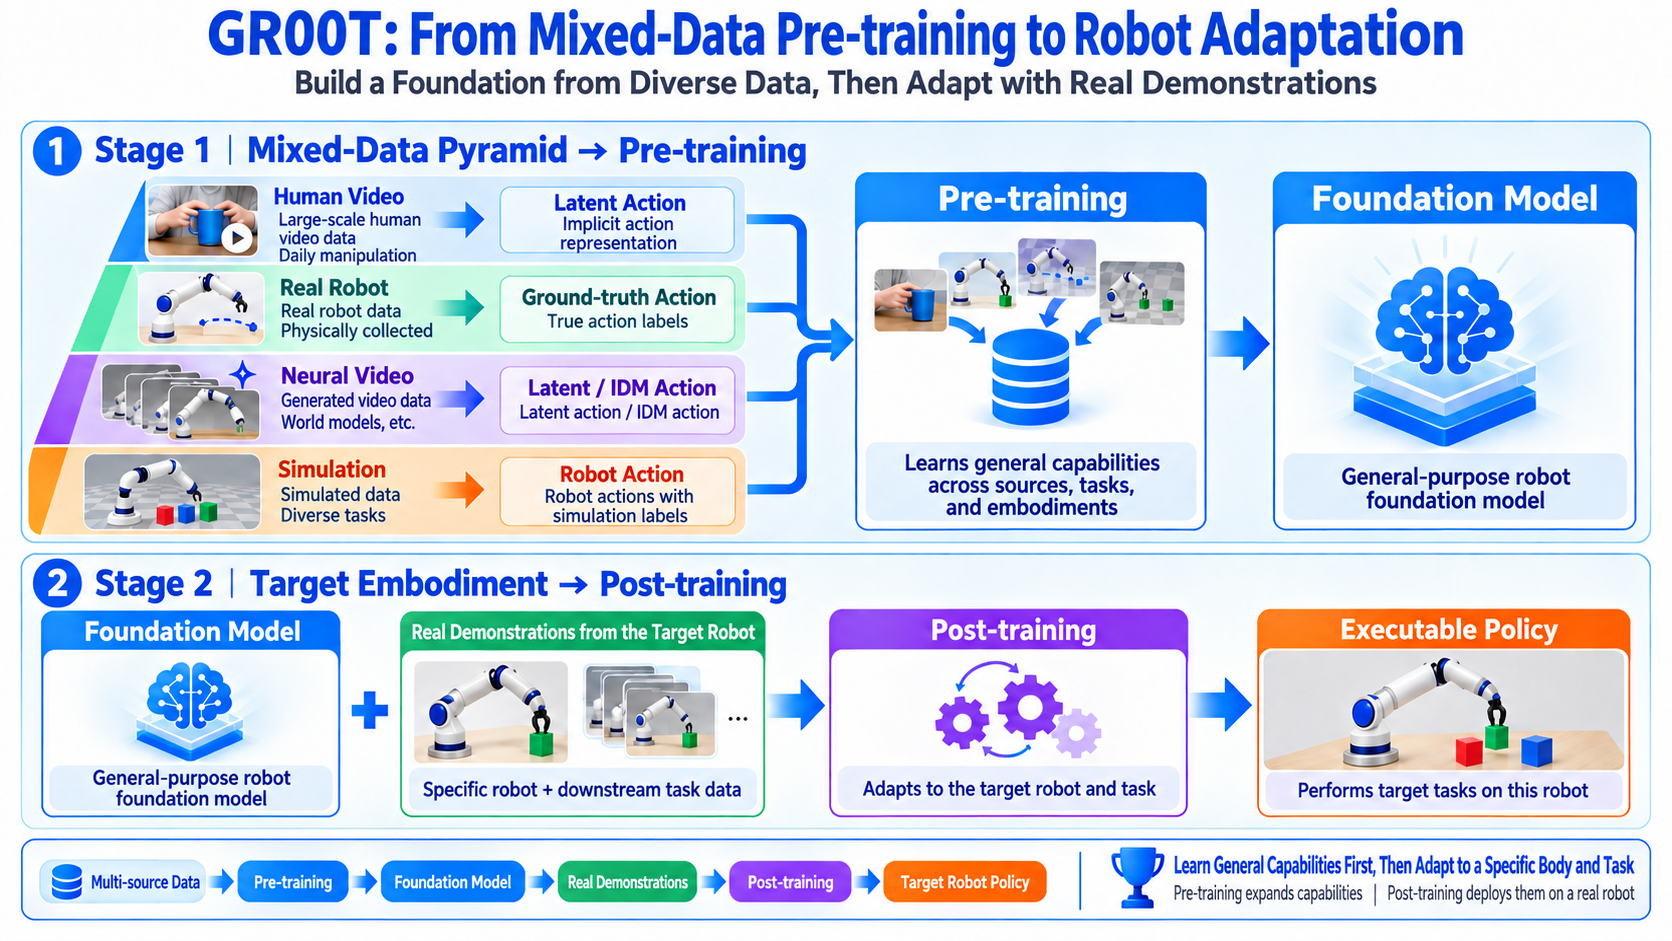
Post-training 不是从零训练,也不是不经适配就直接零样本控制任意机器人。它是在预训练能力上,教模型理解目标机器人的相机、State、Action 和任务。
| 训练项 | Pre-training | Post-training |
|---|---|---|
| Batch Size | 16,384 | 128 或 1,024 |
| Gradient Steps | 200,000 | 20,000-60,000 |
| 主要数据 | 多 Embodiment 混合 | 单一 Embodiment / 任务 |
| 目的 | 学习通用先验 | 适配具体身体和任务 |
GR00T-N1-2B 预训练约使用 50,000 H100 GPU 小时。论文数据集总规模为 8,375.7 小时、592.9M 帧。
一句话理解: Pre-training 让模型见过很多世界和身体,Post-training 再告诉它“现在你要使用的是这台机器人”。
实验与结果
作者如何证明模型有效
实验同时覆盖仿真和真机,不只验证“训练集任务能不能做”,还观察预训练先验和少样本适配。
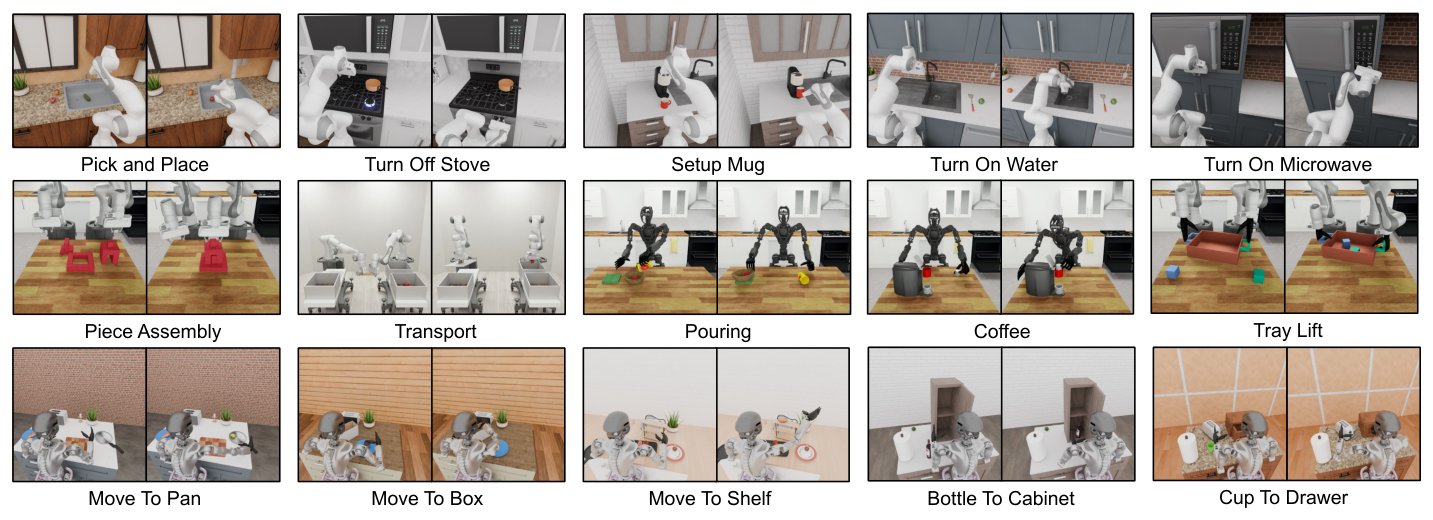
仿真基准包括:
-
RoboCasa Kitchen:24 个厨房操作任务。
-
DexMimicGen Cross-Embodiment Suite:9 个跨机器人操作任务。
-
GR-1 Tabletop:24 个人形机器人桌面任务。
真实世界测试则使用 GR-1 人形机器人,包括 Pick-and-Place、铰接物体操作、工业操作和多机器人协作。
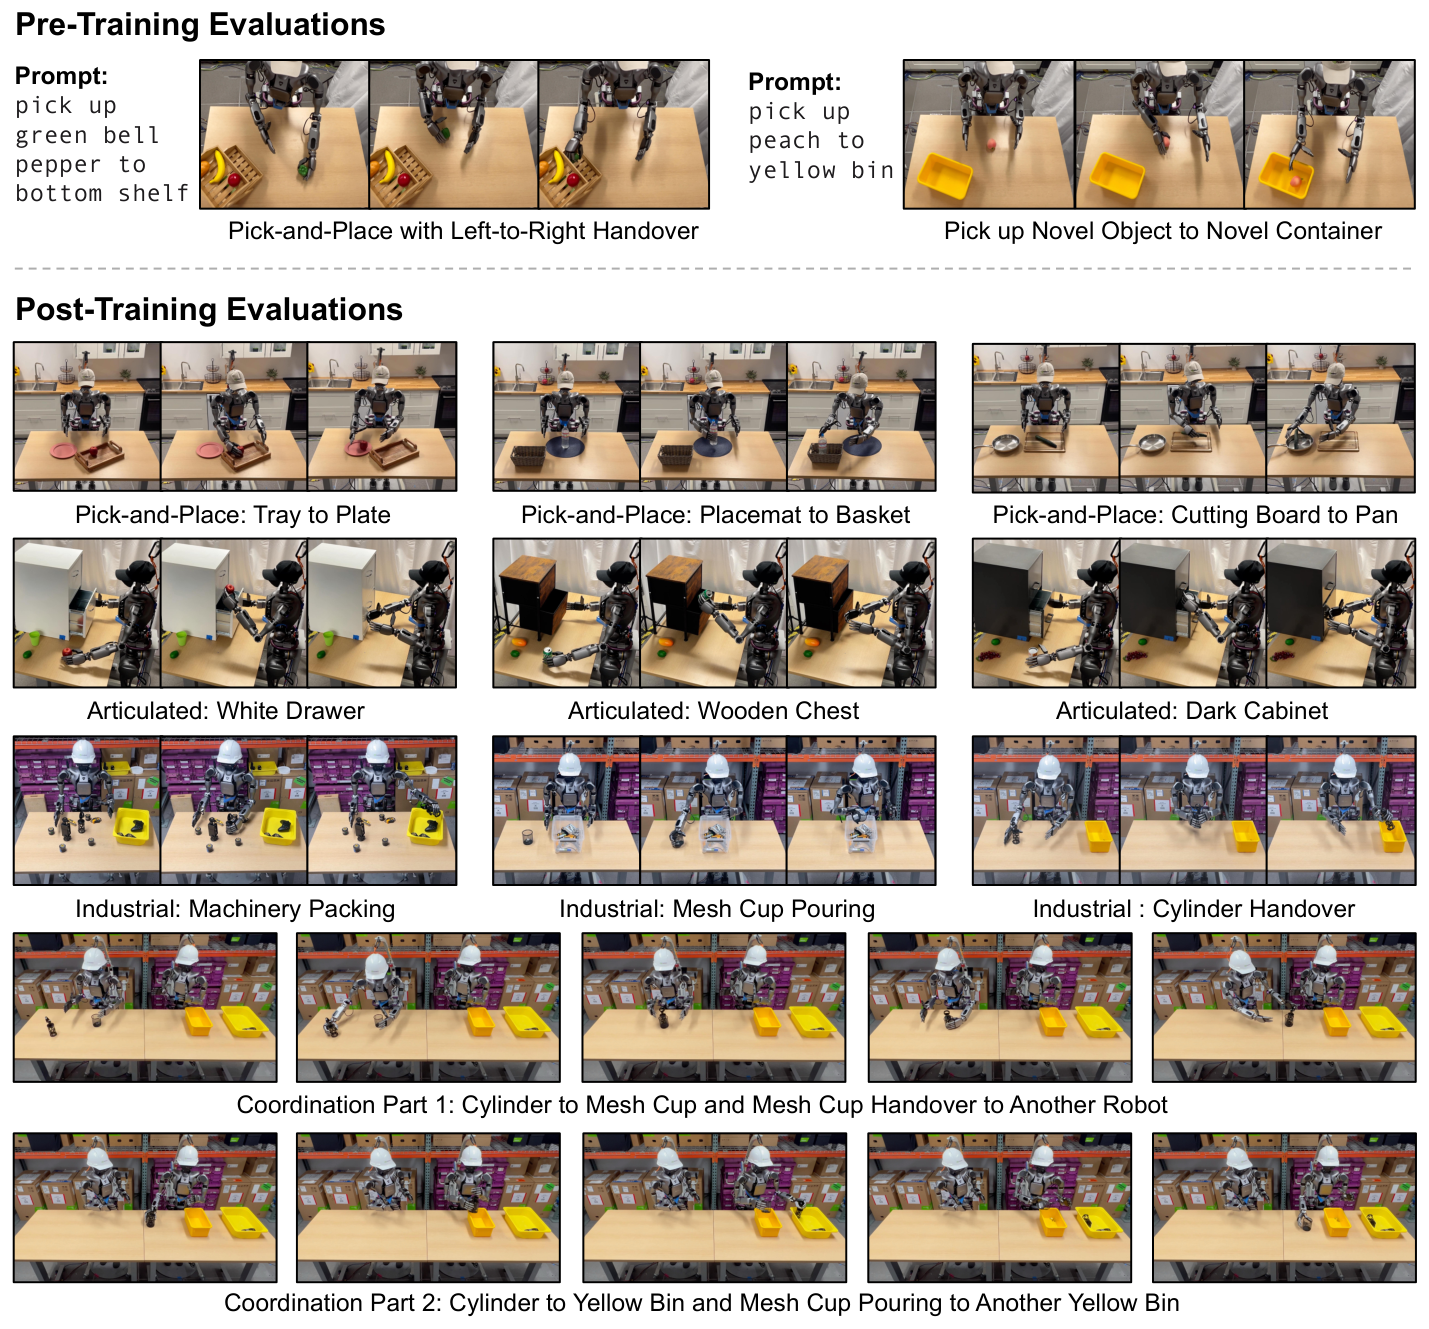
作者主要与 BC-Transformer 和 Diffusion Policy 对比。对比时应注意:GR00T N1 不只是更大的 Policy,它还携带了多数据源与多 Embodiment 预训练。所以结果不只反映架构差异,也反映预训练数据和训练策略的价值。
数据少时,预训练是否真的有用
论文在仿真中分别使用每任务 30、100 和 300 条示范进行 Post-training。结果的主要趋势是:
-
数据很少时,GR00T N1 的预训练先验带来的帮助最明显。
-
数据增多后,专门训练的 Diffusion Policy 会缩小差距,但 GR00T N1 仍然有较强数据效率。
-
在部分设置中,GR00T N1 只使用约 10% 的任务数据,也能接近使用全量数据的 Diffusion Policy。
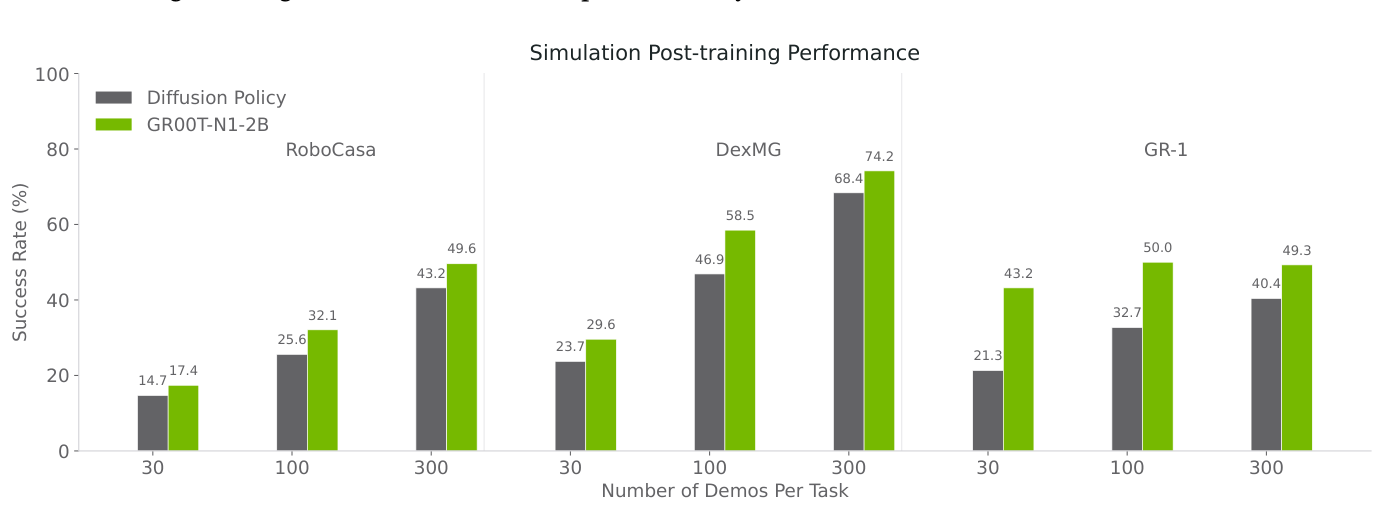
这个结果的工程意义是:
基础模型最值钱的地方不是“它不需要数据”,而是“你手里数据很少时,它仍然可以站在预训练的起点上学”。
Neural Trajectory 有没有真正帮到机器人
作者对 Neural Trajectory 做了消融实验,比较只用真实数据、加入 Latent Action 生成数据,以及加入 IDM 伪动作数据的效果。
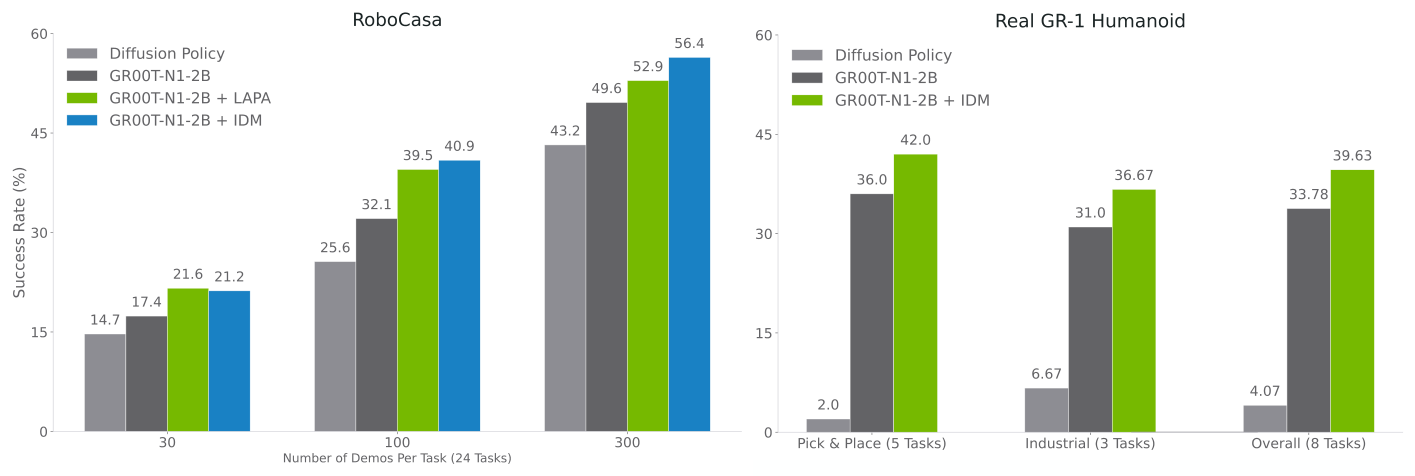
结果表明,合成轨迹在部分任务上能提高成功率,而 IDM 提供的伪动作通常比纯 Latent Action 更直接地对接真实机器人 Action Space。但这不是“生成数据越多越好”:生成错误、物理不一致和伪标签偏差都会进入训练。
论文还观察到一个很重要的现象:预训练模型在一个新场景中,可以自发使用左手抓取,再交给右手完成任务;但针对特定数据做 Post-training 之后,模型反而可能丢失这种 Handover 能力。
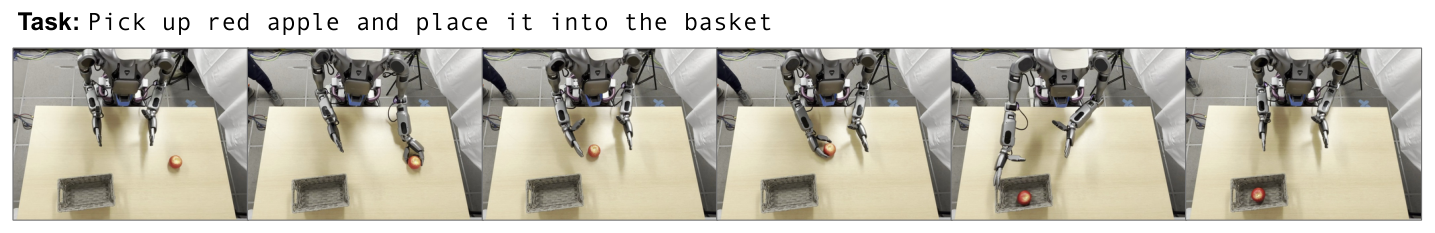
这就是基础模型中常见的 Catastrophic Forgetting(灾难性遗忘):当下游数据太窄时,专项训练可以提高特定任务成功率,也可能覆盖预训练中更广的能力。
局限、工程启示与总结
论文还没有解决什么
-
任务仍然偏短时桌面操作。 长时间导航、全身运动与操作联合规划仍然是未来工作。
-
VLM 的空间推理还不足。 看懂物体语义不等于精确理解三维位置、接触和受力。
-
合成数据有物理一致性问题。 视频看起来合理,不代表轨迹在真实机器人上可执行。
-
Post-training 可能遗忘预训练能力。 下游适配不只要看特定任务的成功率,还要观察泛化能力是否被破坏。
与 LeRobot 实践的连接
GR00T N1 的工程附录使用并扩展 LeRobot Dataset Format。一个数据集不只需要存下数字,还要说清数字的语义。
| 内容 | 需要明确的信息 |
|---|---|
| Video | 相机名称、视角、分辨率、帧率和时间对齐 |
| State | 每个维度对应哪个关节或位姿 |
| Action | 是绝对目标、增量、关节控制还是末端控制 |
| Language | 任务指令与 Episode 的对应关系 |
| Rotation | 旋转矩阵、欧拉角、四元数或 6D Rotation |
论文中的 modality.json 就是用来补充这些语义。它解决的不是“文件能不能打开”,而是“模型是否知道第 7 个数字到底表示什么”。
对于已经用 ACT 采集过数据的读者,可以用下面这张表理解工作量的变化:
| 阶段 | ACT 实践 | GR00T N1 / Foundation VLA 还要关注 |
|---|---|---|
| 采集 | Camera / State / Action 对齐 | 再加上稳定的 Language Annotation |
| 数据 | 同一机器人内部一致 | 跨 Embodiment 时字段语义也要一致 |
| 训练 | 从示范训练 Policy | 从 Foundation Checkpoint 做 Post-training |
| 推理 | Image + State → Action Chunk | Image + Language + State → Action Chunk |
| 评估 | 真机成功率 | 成功率 + 泛化 + 是否遗忘预训练能力 |