LingBot-VLA 2.0:跨本体动作与未来感知
From Foundation to Application: Improving VLA Models in Practice
- 跨本体数据
- 55 维动作空间
- 稀疏 MoE
- 未来预测
机器人要把水果放进冰箱,需要看清物体、伸手抓取、移动底盘、打开冰箱,再完成放置。换一台机器人,关节数量、相机位置和可执行动作又会改变。LingBot-VLA 2.0 关注的问题是:怎样让同一个基础模型学到可共享的操作经验,同时容纳不同身体的控制差异,并预判接下来的场景变化?
预备知识:共享经验与共享控制接口
视觉语言动作模型(Vision-Language-Action,VLA) 接收画面、任务文字和机器人当前状态,输出数值控制量。它要学习“看到这个场景时怎样运动”,而不只是描述画面。
本体(embodiment) 指具体的机器人身体与控制条件。双臂夹爪、人形灵巧手和带底盘机械臂,即使执行同一条指令,也不能照搬同一组关节数值。统一数据格式提供共同的接口,模型仍需学习不同本体的运动规律。
动作块(action chunk) 是一次预测的多步动作序列。公开实现默认预测 50 步,每步使用 55 维规范向量,形状为 50 × 55。其中包括补齐位置,并不表示机器人有 55 个关节;生成一次动作块也不等于控制器每秒只能运行一次。
摘要与阅读线索
摘要意译: 尽管 VLA 基础模型不断进步,实验室与实际应用之间仍有差距。LingBot-VLA 2.0 从三个功能方向改进前代模型:重新设计数据处理流程,用约 6 万小时数据进行预训练,其中包括覆盖 20 种机器人配置的 5 万小时轨迹与 1 万小时第一视角人类视频;扩展控制空间以支持头部、腰部、移动底盘与灵巧手;以未来预测作为辅助任务,借助视频表示模型提供语义先验、深度模型提供几何线索。作者在 GM-100 的通用策略设置和两种平台的长程移动操作中验证这些改进。
批注: 三个功能方向共同构成系统贡献。MoE 是扩大动作建模容量的结构手段,双查询蒸馏是学习时空表示的训练手段。论文主表检验的是整体方案;不能把平均成绩的全部改善归因于其中一个模块。
引言与相关工作:为什么要一起改三件事
原文引言第 1 段先肯定两种基础:视觉语言模型提供图文语义,扩大机器人数据规模提供操作经验。第 2 段指出现实应用提出了更强要求:数据来自不同身体,动作包含更多身体部件,环境变化还要求模型理解后续结果。
第 3 段梳理已有路线:扩充机器人数据、设计适应本体差异的结构,以及利用潜在动作或预测建模。第 4 段将它们组织为本文的三项改进:更广且更干净的数据、更多可控制的身体部件、面向未来的感知学习。最后用双臂与移动操作实验检验这条路线(PDF 第 1–2 页)。
相关工作分成两组(第 2 节):
- 通用操作策略: 数据扩展、人类第一视角经验、统一动作表示、几何监督和预测目标分别补充不同能力。本文将这些需求放到同一套预训练与控制框架中。
- 混合专家 VLA: 有些工作按力觉、身体部件或原子技能组织专家。本文让每个动作 token 根据自身特征选择专家,不预先规定“某个专家只管某台机器人”或“只管某项技能”。
与 LingBot-VA 对比:未来信息怎样进入动作生成
LingBot-VA 与 LingBot-VLA 2.0 都希望机器人利用环境变化来行动。区别在于:LingBot-VA 在推理时生成未来视频潜状态,再从视觉变化推断动作;LingBot-VLA 2.0 用未来特征监督训练查询,推理时由动作专家读取这些查询来生成动作。
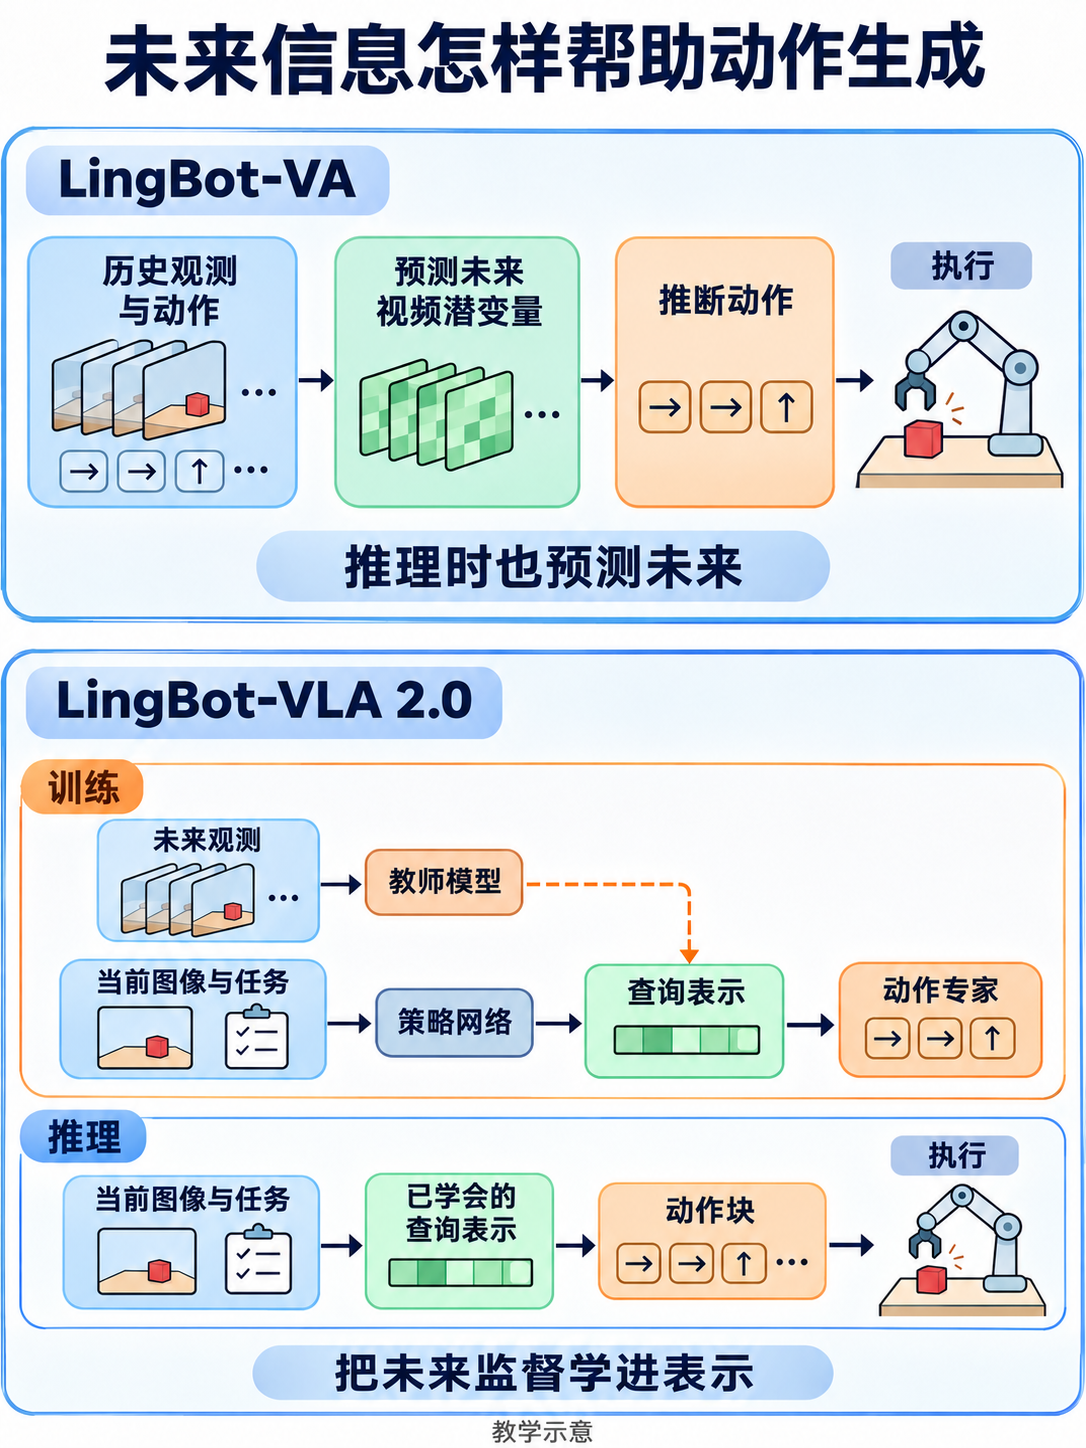
教学示意:沿实线看动作生成,沿橙色虚线看训练监督。VLA 2.0 的教师目标对齐到动作专家实际读取的查询表示,推理行保留学到的查询路径。图中省略机器人状态等共同条件。
| 比较项 | LingBot-VA | LingBot-VLA 2.0 |
|---|---|---|
| 主要基础 | Wan2.2 视频生成先验、文本条件 | Qwen3-VL 视觉语言理解骨干 |
| 未来表示 | 预测视频 VAE 潜状态,作为动作生成条件;需要时可解码画面 | 查询预测深度与 DINO-Video 特征;不是 RGB 视频生成器 |
| 动作学习 | 视频动力学与逆动力学的双流流匹配 | 动作流匹配,加当前/未来教师特征对齐 |
| 容量组织 | 论文为非对称双分支 MoT;当前发布版为共享骨干 | 动作专家采用稀疏 MoE,公开配置为 32 个路由专家、top-4 |
| 数据与身体范围 | 约 1.6 万小时机器人操作轨迹;30 维双臂规范空间 | 约 5 万小时机器人轨迹与 1 万小时第一视角人类轨迹;55 维覆盖头、腰、底盘和灵巧手 |
| 历史与反馈 | 逐块生成,并将真实观测与动作历史接入 KV 缓存 | 当前观测、语言、状态与查询构成动作条件;当前 LeRobot 默认单步观测 |
| 推理额外计算 | 视频潜状态生成仍在控制路径中;论文用部分去噪与异步减轻成本 | 未来教师只在训练使用,推理保留查询,无需运行深度/视频教师 |
以“夹爪没有抓住箱盖”为例:LingBot-VA 需要让真实反馈替换或校正原先“已经抓住”的视觉预测,否则下一块可能沿错误想象继续生成。其论文异步方案通过前向动力学重新对齐正在执行的动作后果;当前 LeRobot 接入只实现队列耗尽后的反馈更新,并未完整实现该异步算法。VLA 2.0 则在下一轮由实际观测与状态重新生成动作块;它的未来查询提供学到的预测特征,不等于显式滚动一段想象视频。
两者默认的生成数量也不能直接比较速度:固定 LeRobot 代码中,VA 一般块为 4×4=16 个动作位置,默认视频/动作更新为 20/50 次;VLA 2.0 为 50 步动作块、10 次动作生成更新。网络结构、精度、分辨率与调度均不同,不能仅凭更新次数判断快慢。VA 的首块还因初始条件帧只返回 12 步,详见其精读的接入说明。
实验结论同样需要限定范围:VA 的 RoboTwin 论文主表为 Easy/Hard 平均 92.93%/91.55%;本篇接入文档的 93.52%/92.80% 来自 VLA 2.0 后续发布检查点。两篇没有提供把模型、训练和执行条件全部统一后的直接对照,不能据这四个数字宣称 VLA 2.0 在所有方面优于 VA。它们分别突出“推理时显式预测环境变化”和“将未来感知监督注入跨本体动作模型”两条路线。
数据:先让不同来源的轨迹值得学、能够一起学
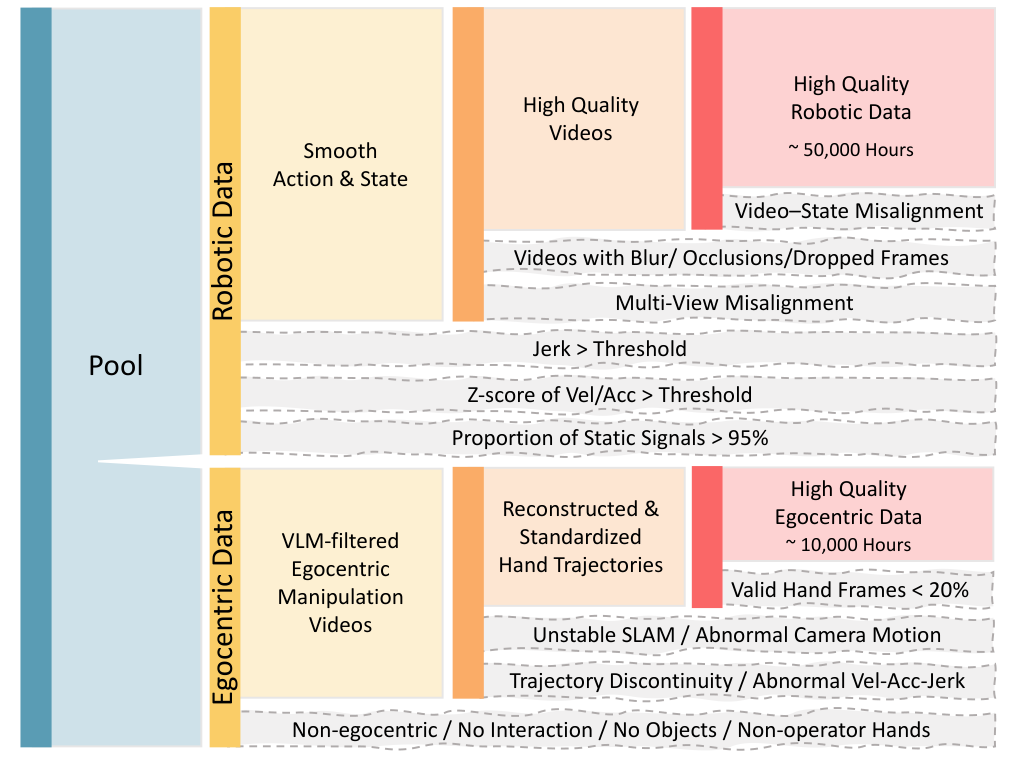
图 3 的两条路径最终分别留下约 5 万与 1 万小时数据。6 万小时是筛选后的训练规模,不是最初收集规模。 机器人原始池约 9 万小时,第一视角原始池约 2 万小时(第 3.1 节)。
机器人轨迹先检查速度、加速度及加加速度(jerk,反映加速度变化),去掉运动突变;若几乎静止的部分占整段超过 95%,也会丢弃。阈值按本体分别设置。随后用 URDF 机器人描述与记录状态投影回图像,由人工检查画面与状态是否对齐,并去除模糊、严重遮挡、掉帧和多相机错位。
第一视角视频先用 VLM 排除纯走动、无手物交互、第三人称观察及非操作者手部占据画面的片段。已有手轨迹的数据做时间与坐标对齐;缺少轨迹的视频用 SLAM 估计相机运动,再结合 MANO 手部姿态估计恢复世界坐标中的手轨迹。有效手部帧比例低于 20%、相机估计不稳或手运动违反生理约束的片段会被过滤。这类视频进入训练前要形成轨迹监督,并非直接把任意人类视频当作机器人关节动作。
为避免“人头转动”被误当成“手在运动”,轨迹统一储存在世界坐标系;采样当前帧后,将后续手轨迹转换到这同一时刻的相机坐标系。原文式(1)为:
这里, 是轨迹时刻, 是当前观测时刻, 是世界坐标系。 包含旋转和平移,按齐次坐标作用于位置。教学例子: 若相机沿世界 x 轴位于 1 米处、方向与世界轴一致,手在世界 x=1.3 米处,则在当前相机中是 x=0.3 米。后续点也使用同一个 ,而非各自变化的相机坐标系。
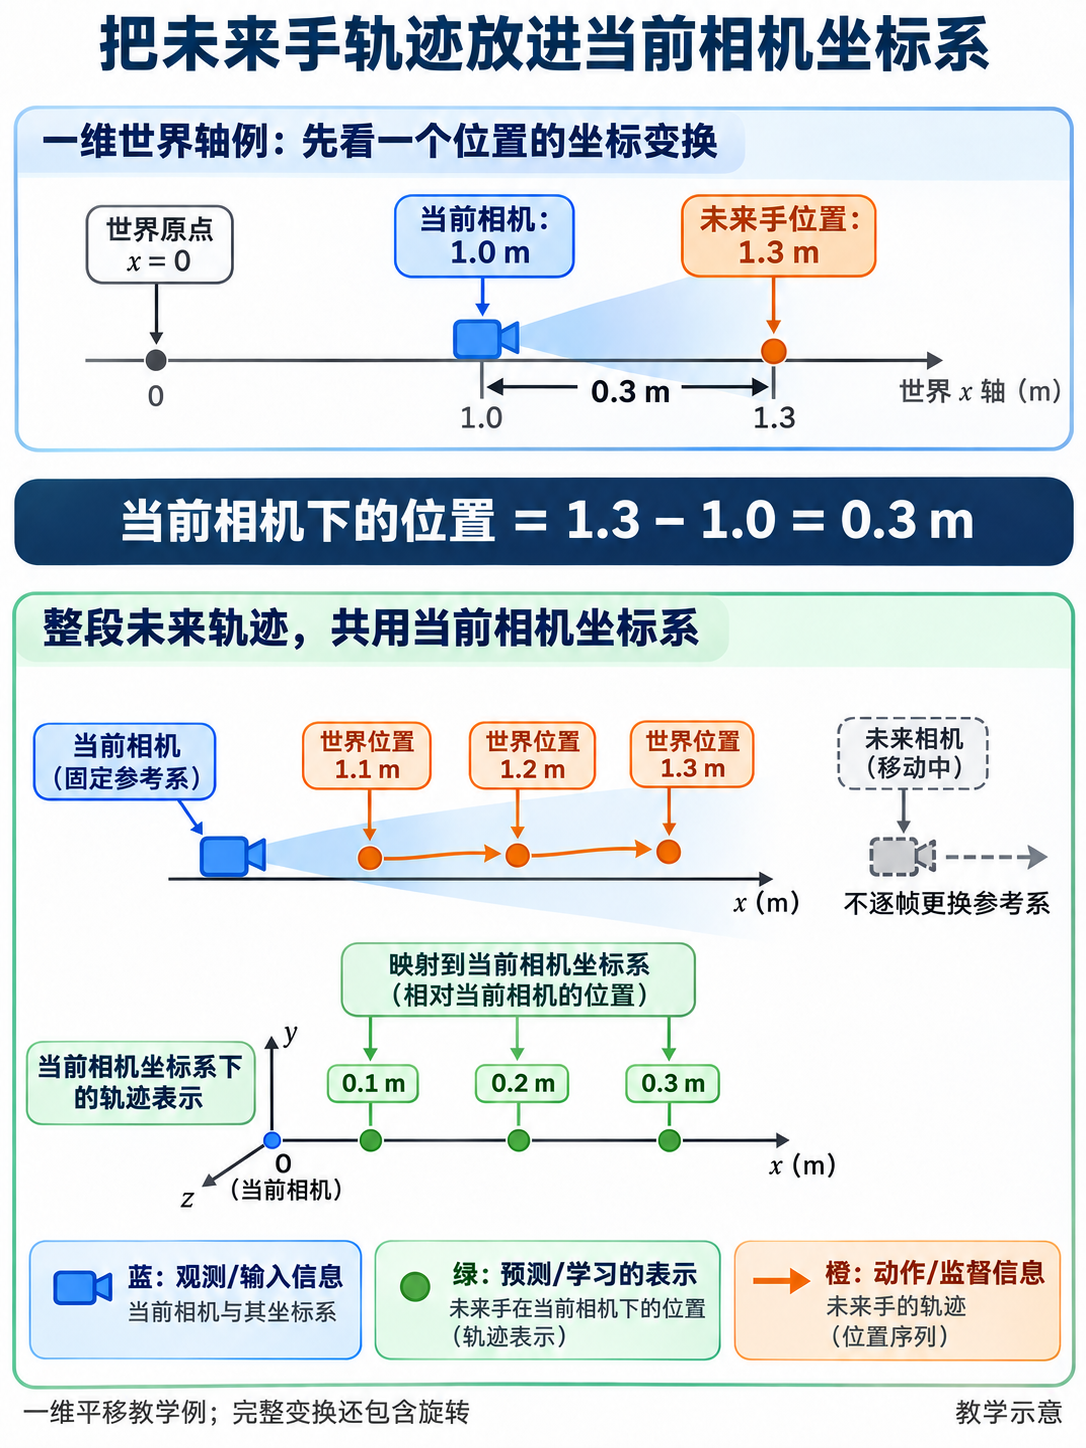
教学示意:先从世界坐标减去当前相机的位置,再用同一个参考系表达后续各点。图中的 0.1、0.2、0.3 米是方向一致时的一维平移例子;完整变换还包含旋转。
语言监督由 Qwen3.6-27B 自动标注,包含整段任务指令及时间连续的子任务指令。动作标签使用 15 类操作与 transit、idle、other 三类辅助标签;物体名称是开放词汇。同一次交互的抓取、搬运、释放归入一个子任务,避免切得过碎。原文图 5 显示 move 与 transit 合计约占子任务数量的 88.7%,idle 被排除出训练;数据量大仍不意味着各类技能均衡。
统一的 55 维动作空间
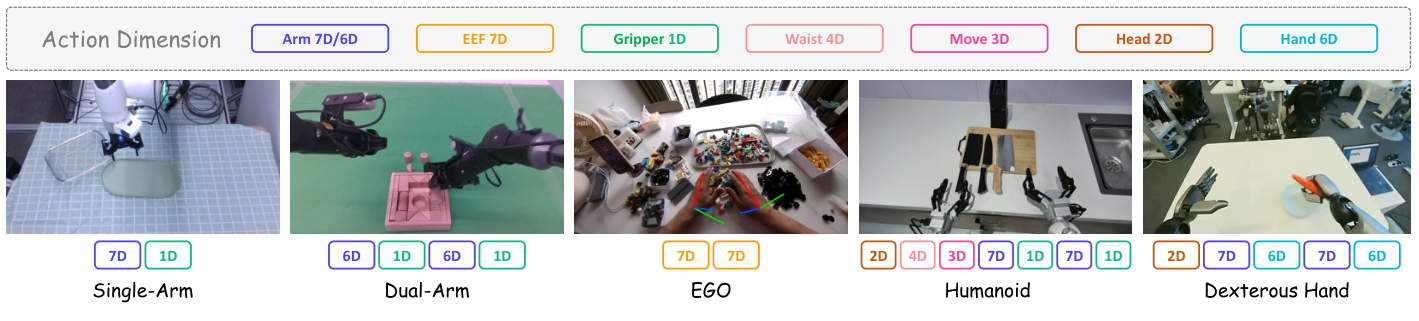
图 4 用颜色将不同机器人的控制量放入共同部件槽位。第 3.1.3 节规定状态与动作都使用以下规范向量:
| 部分 | 维度 | 含义 |
|---|---|---|
| 双臂关节 | 14 | 每臂最多 7 个关节位置 |
| 双臂末端位姿 | 14 | 每臂 XYZ 位置与四元数,共 7 维 |
| 夹爪 | 2 | 两侧夹爪位置 |
| 灵巧手 | 12 | 双手关节位置 |
| 腰部/头部 | 4 + 2 | 对应身体关节 |
| 移动信号 | 3 | 底盘移动;LeRobot 槽名为 base.velocity |
| 预留 | 4 | 保留扩展空间 |
合计为 14 + 14 + 2 + 12 + 4 + 2 + 3 + 4 = 55。没有的身体部件或不足的维度用补齐值占位。关节位置和末端位姿是不同表示,不能因同时预留就将它们当成独立的 28 个物理自由度。
教学例子: 一个“5 个关节 + 1 个夹爪”的单臂数据集,原始向量可为 [q₁,…,q₅,g]。LeRobot 将前 5 个数放到 arm.position 槽位前部,将 g 放到 effector.position,其余补零并通过有效维度掩码排除动作损失;输出后再取回原始 6 维。对应映射分别用于状态与动作,还需与相机映射、归一化统计保持一致。
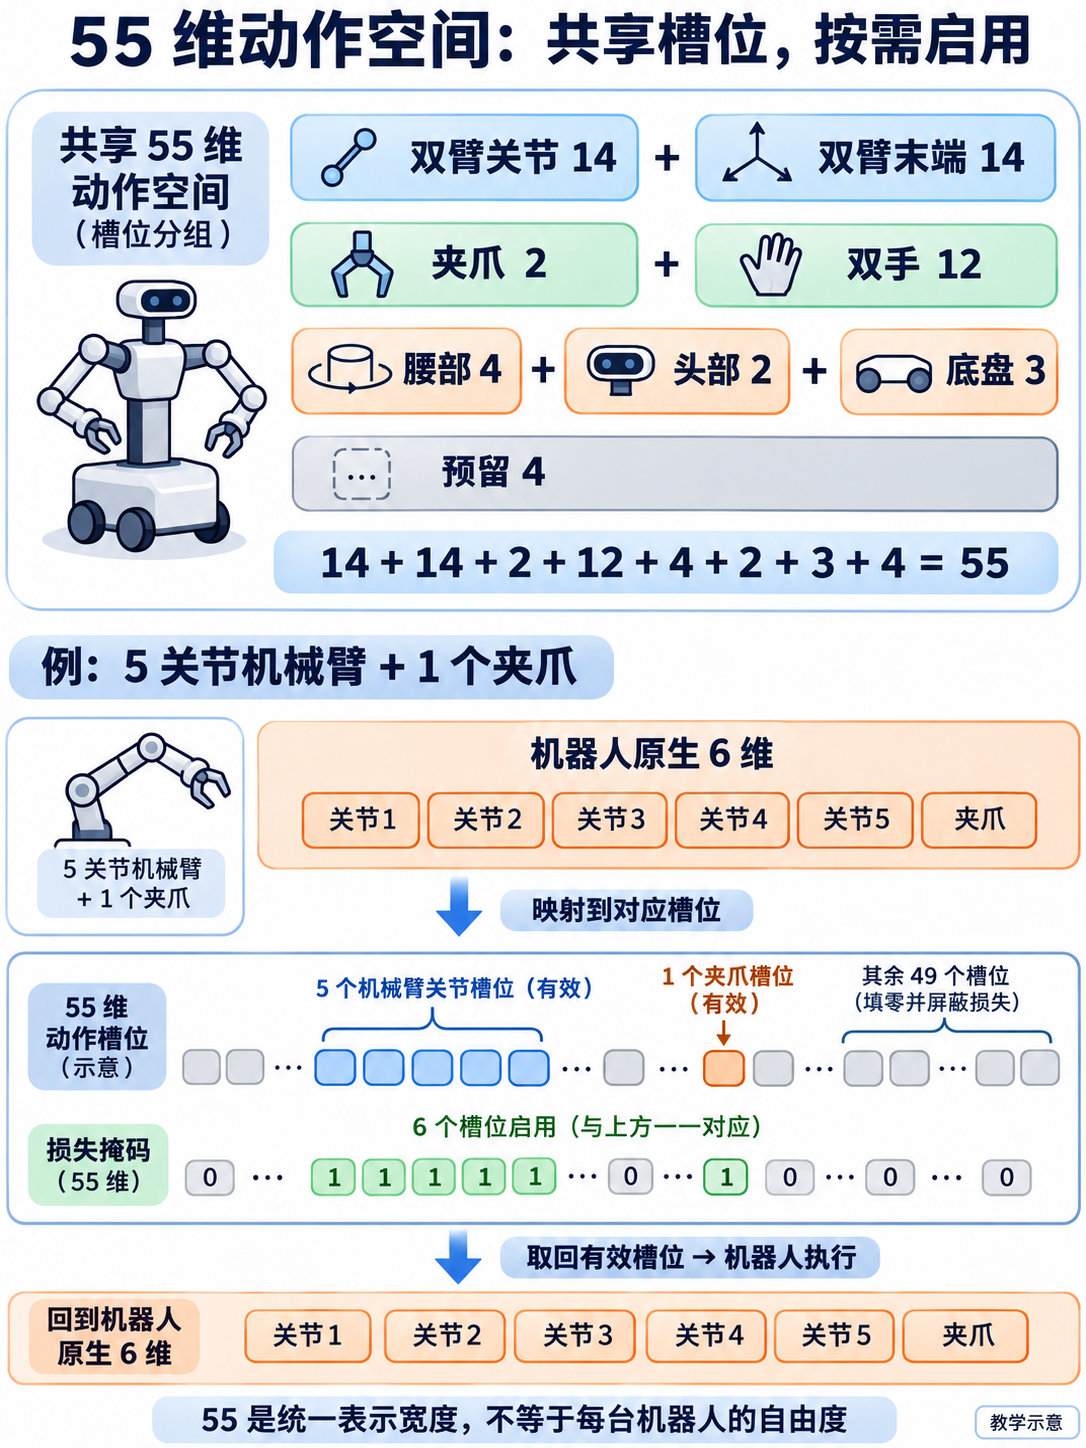
教学示意:五个关节和一个夹爪占用各自对应的槽位,中间可以隔着未使用维度。灰色槽位被屏蔽的是动作损失;输出还要取回有效维度、恢复机器人的控制接口。
统一槽位让数据能够拼批训练;不同机器人的坐标、单位、关节含义仍须正确配置。它提供跨本体学习的接口,不能单凭向量长度保证新机器人无需适配。
核心网络:理解场景、组织专家、生成动作
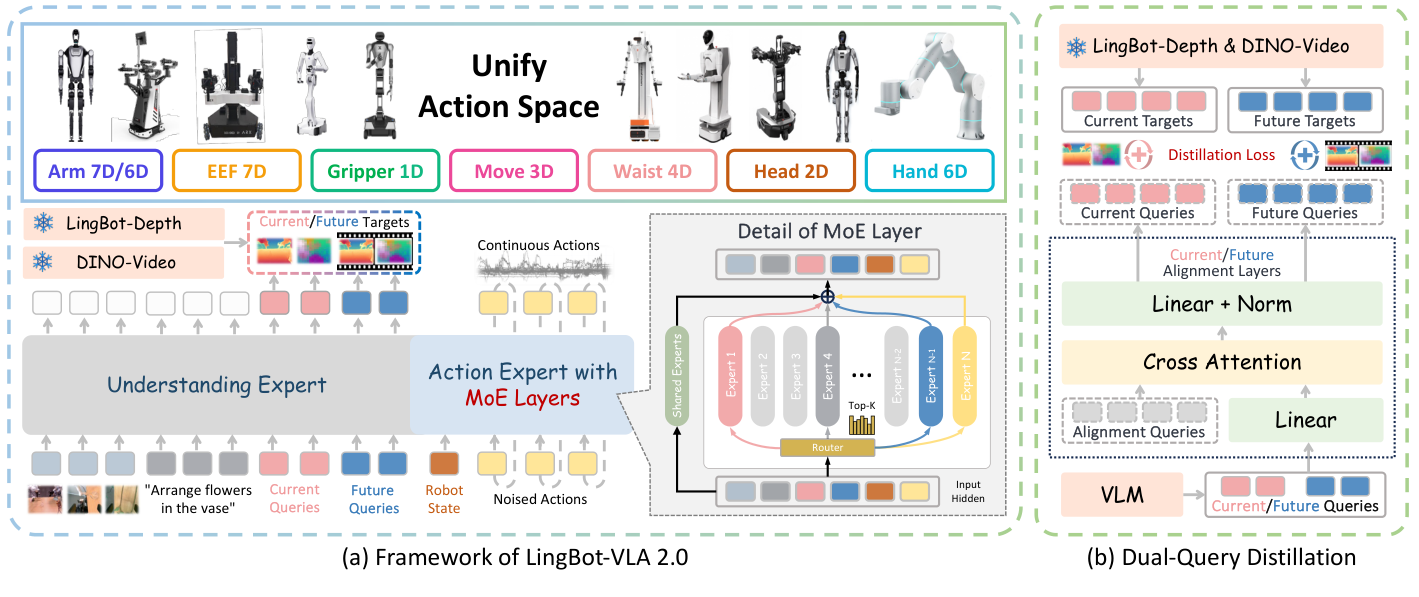
先读图 1 左侧:图像与指令进入理解分支,当前与未来查询放在图文 token 后;动作分支接收当前机器人状态、带噪动作,并读取包含查询的多模态上下文,最后输出连续动作。右侧解释查询怎样接受教师监督。
实现补充: 公开版本使用 Qwen3-VL-4B 视觉语言骨干与 Qwen2 结构的动作专家。状态、动作分别经过投影,动作生成还接收噪声时间编码;两条分支通过注意力交换条件信息。下面的流匹配形式和 50 步默认值来自固定源码,而非论文第 4 节完整给出的训练配方。
MoE:每个 token 选择少量专家
混合专家(Mixture-of-Experts,MoE)将动作 Transformer 中的前馈网络替换为一个共享专家与一组可选择的专家。共享专家处理可复用模式,路由器(router)按每个 token 的当前特征挑选少数专家,使容量可以增加而不必每次计算全部专家。公开配置为 32 个路由专家、每个 token 激活 4 个,并保留共享专家。
省略层与 token 下标,原文式(2)、(6)、(7)可合写为:
是动作 token 的内部特征, 是路由向量, 是匹配分数, 是均衡使用量的修正偏置; 缩放路由分支输出。共享专家 与选中的 都是 MLP。选择用加偏置的分数,混合权重仍用原始分数。
教学例子: 将专家简化为 3 个、选 2 个。原分数 [0.8, 0.6, 0.2],偏置 [−0.4, 0, 0.3],则按 [0.4, 0.6, 0.5] 选择第 2、3 个;混合权重为 0.6/0.8=0.75 与 0.2/0.8=0.25。这样可以增加冷门专家被选中的机会,同时保留其原始匹配程度。
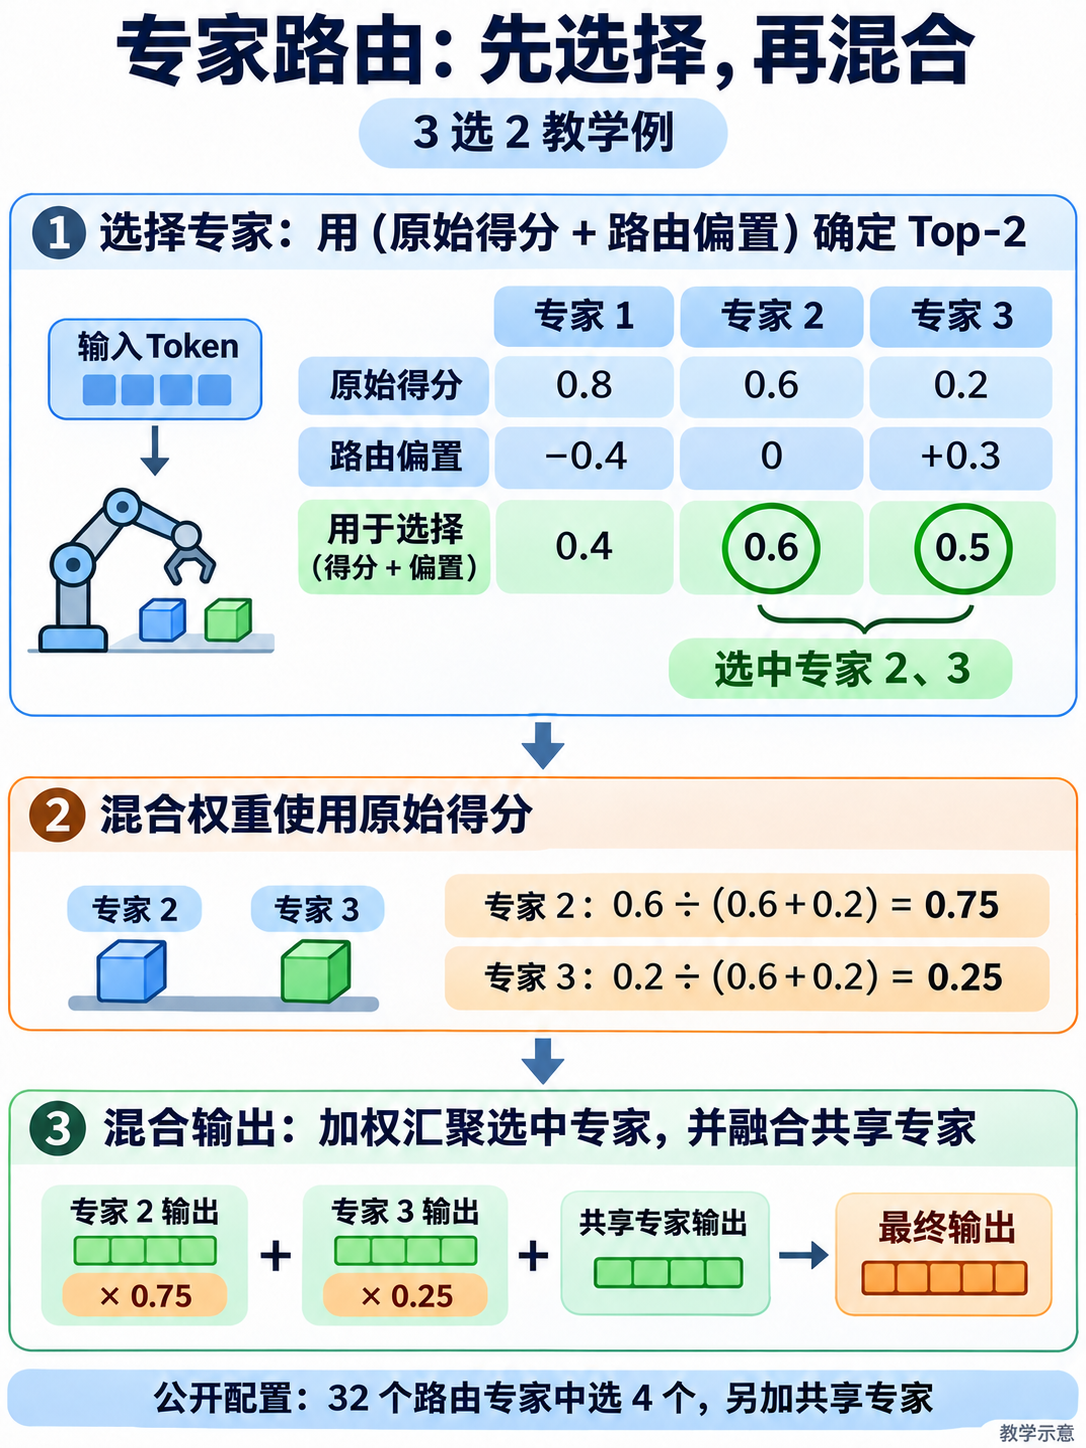
教学示意:从上到下依次看选择、加权和汇合。三选二与路由分支缩放系数取 1 都是教学简化;共享专家另走一路,公开配置仍是 32 选 4。
论文预训练采用不额外加入均衡损失的策略:专家负载高于均值就减小偏置,低于均值就增大偏置(式 8)。这里的“loss-free”仅指负载均衡,不表示模型没有动作损失。当前公开后训练配置另启用了序列均衡损失和 router z-loss,不能与论文预训练机制混为同一设置。
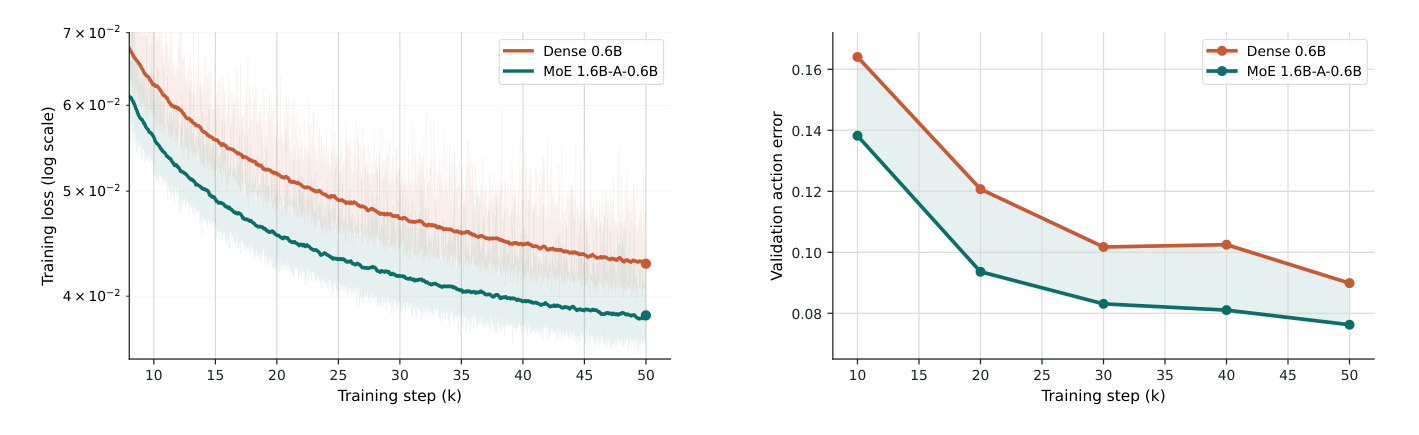
图 7 对比稠密 0.6B 与总量 1.6B、激活量 0.6B 的 MoE:随训练步数增加,MoE 的训练损失和 GM-100 验证动作误差更低。它支持稀疏容量分配的价值;横轴是训练步数,并非实测推理延迟,也不是把完整模型都称为 0.6B。
双查询蒸馏:让未来表示成为动作条件
查询(query) 是可学习的内部 token,经过网络后承载模型需要提取或预测的信息。本文按当前与未来两组组织为 、,不是说实现中总共只有两个 token。它们分别学习“现在是什么状态”和“这段动作时间之后可能是什么状态”。
教师有互补作用:LingBot-Depth 提供空间几何特征,DINO-Video 提供带运动信息的视频特征。学生看到当前观测与指令,教师在训练时还可看到未来画面来提供目标。未来图像不作为学生推理时的输入。
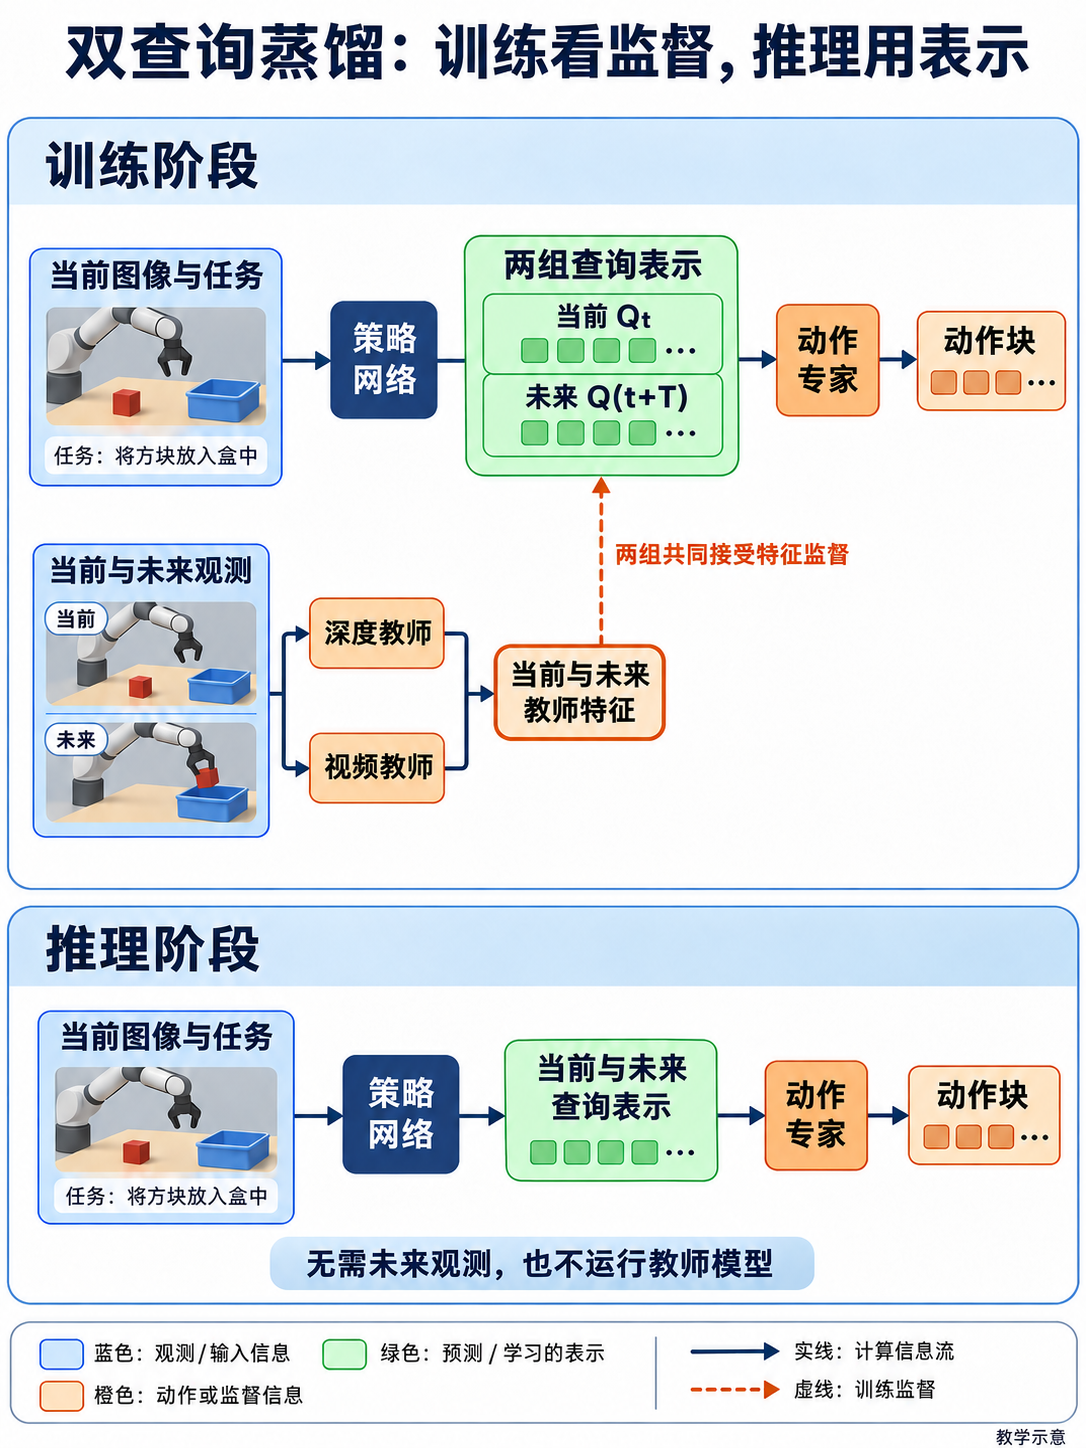
教学示意:绿色大框包含当前与未来两组查询,训练中的深度、视频教师共同提供两时刻的目标。橙色虚线表示特征对齐,具体投影与损失见下式;推理只沿下排实线计算。
原文式(9)、(10)在当前和未来两处分别对齐。令 ,可等价写为:
与 是教师深度、视频特征;投影模块把学生查询转换到教师特征的形状,深度投影包含交叉注意力。第一项累加绝对误差,第二项累加平方误差。教学计算: 若一个简化特征的预测是 [0.2,0.7]、目标是 [0.3,0.5],L1 为 0.1+0.2=0.3,平方误差和为 0.01+0.04=0.05;还要对当前、未来及训练样本聚合。真实特征远高于两维,源码中的约简、权重和额外对齐项以配置为准。
DINO-Video 从 DINOv3 初始化,增加按时间因果的注意力及三维旋转位置编码,用 500 万视频片段训练,每个样本采样 16 帧(第 4.2 节)。它的当前帧特征只依赖当前与过去帧,未来特征则由截至未来时刻的帧形成。16 帧是教师预训练的采样设置,不能理解为机器人推理必须输入 16 帧。
查询接受监督后,仍作为上下文供动作专家读取。因此几何与未来变化的学习可以影响动作生成;它不要求先输出一张完整未来图像再规划,也没有在本文中定义显式搜索多个未来的规划器。
流匹配:把噪声动作块变成可执行轨迹
流匹配(flow matching)让网络学习连续动作生成的更新方向。按照作者固定源码的时间方向,设示范动作块为 ,同形状高斯噪声为 ,噪声时间为 ,有:
模型以当前图像、语言、状态、查询及 为条件预测 ,用 L1 或 L2 对齐 。这里的“速度”是动作空间的生成方向,不是底盘物理速度; 也不是机器人执行时间 。推理从 的噪声开始,按 Euler 方法逐步减小 :
教学例子: 一个归一化动作目标为 0.2、噪声为 1.0,理想方向为 1.0−0.2=0.8。若 N=10,第一步得到 1.0−0.1×0.8=0.92;在这个理想的一维直线路径中,十步到达 0.2。实际模型每步重新估计方向,并同时生成整块 50 × 55 数值。10 次生成更新与 50 个动作时刻是两个不同的数量。
训练和实际使用怎样衔接
| 阶段 | 可用信息与学习内容 | 产物或使用方式 |
|---|---|---|
| 教师准备 | 深度模型提供几何;DINO-Video 经视频自蒸馏学习时序特征 | 训练 VLA 时作为冻结教师 |
| VLA 预训练 | 筛选后的机器人/人类轨迹、语言、当前画面与未来教师目标 | 学习共享图文条件、动作建模和当前/未来表示 |
| 下游后训练 | 目标平台的状态动作、相机映射和任务示范 | 获得目标任务策略与归一化统计 |
| 推理执行 | 当前画面、指令、当前状态与新采样噪声 | 生成动作块,反归一化、逆映射后交给机器人控制接口 |
未来画面与教师只在训练提供额外监督,推理保留学到的查询,无需运行教师。LeRobot 的未来监督取动作块最后一帧,索引偏移是 chunk_size−1;论文将预测时域写为 。两者分别是概念时域与代码索引,不应机械地多取一帧。
论文没有提供完整预训练超参数及所有平台的执行调度。公开代码中的训练示例属于后训练配方,预训练的 GPU 数量、训练时长与完整冻结范围仍未披露。动作块长、实际执行步数和重新观察的节奏则取决于检查点及控制策略。
实验:改善发生在哪里,还剩什么困难
双臂操作:平均提高,任务表现并不一致
论文从 GM-100 中选取 9 个任务,在每种本体上联合训练单一策略;并非测试完整 GM-100,也不是同一个后训练策略同时测试两台机器人。表 5 同时报任务进度分与整任务成功率。进度分依据完成步骤获得部分分数,成功率要求完成整条任务。
| 平台 | GR00T N1.7 | π0.5 | LingBot-VLA 1.0 | LingBot-VLA 2.0 |
|---|---|---|---|---|
| AgileX Cobot Magic | 36.3 / 17.8 | 59.1 / 32.2 | 58.2 / 30.0 | 66.2 / 34.4 |
| Galaxea R1 Pro | 16.4 / 5.6 | 27.4 / 8.9 | 32.7 / 15.6 | 34.6 / 15.6 |
表中均为“进度分 / 成功率(%)”,对九任务取平均。Cobot Magic 相比 1.0 增加 8.0 / 4.4 个百分点;Galaxea 的进度提高,成功率仍为 15.6%。论文未在该部分明确给出每任务试验次数和置信区间,不能将小幅差距直接称为统计显著。
任务细分更能说明能力边界:Cobot Magic 的取钥匙串达到 100 / 100,但积木排序只有 56.8 / 0,而 π0.5 为 90.4 / 60;Galaxea 的微波炉取碗从 1.0 的 97.5 / 100 下降到 65 / 30。这些结果说明语义定位、抓取和最终精确完成仍有不同瓶颈,平均领先不意味着每项任务都变好。
长程移动操作:相对优势下仍有明显分布外退化
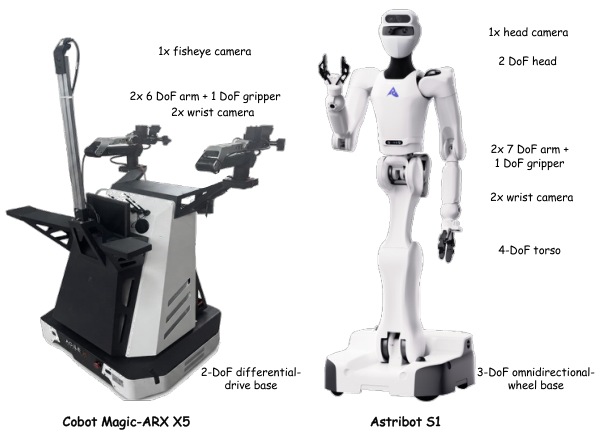
图 9 展示了不同底盘、躯干、机械臂和相机组合。移动任务因此检验的是身体协调与多步完成:冰箱整理分为 11 个子任务,灶台清洁分为 7 个。每个“任务—设置”对每个模型进行 15 次独立试验(第 5.3 节、表 6–7)。
| 平台与任务 | 设置 | LingBot-VLA 2.0 | π0.5 |
|---|---|---|---|
| Astribot S1:冰箱整理 | 分布内 ID | 77.1 / 60.0 | 65.3 / 46.7 |
| Astribot S1:冰箱整理 | 分布外 OOD | 37.0 / 13.3 | 30.3 / 6.7 |
| Cobot Magic-ARX X5:灶台清洁 | ID | 84.3 / 66.7 | 79.9 / 60.0 |
| Cobot Magic-ARX X5:灶台清洁 | OOD | 67.5 / 40.0 | 62.5 / 33.3 |
仍为“进度分 / 成功率(%)”。OOD 将初始位置前后左右扰动至标称位置约 ±10 厘米;冰箱任务还替换为未见过的水果与水瓶类别,灶台任务没有相同的物体替换。因此两种任务的 OOD 难度不能直接等同。
2.0 在四种条件下均高于 π0.5,但冰箱任务从 ID 的 60.0% 成功率降至 OOD 的 13.3%,约为 9/15 → 2/15。一场试验就对应约 6.7 个百分点,这支持已有条件下的相对改善,也提醒我们其长期完成与泛化仍有限。
消融:动作目标、空间、归一化都影响结果
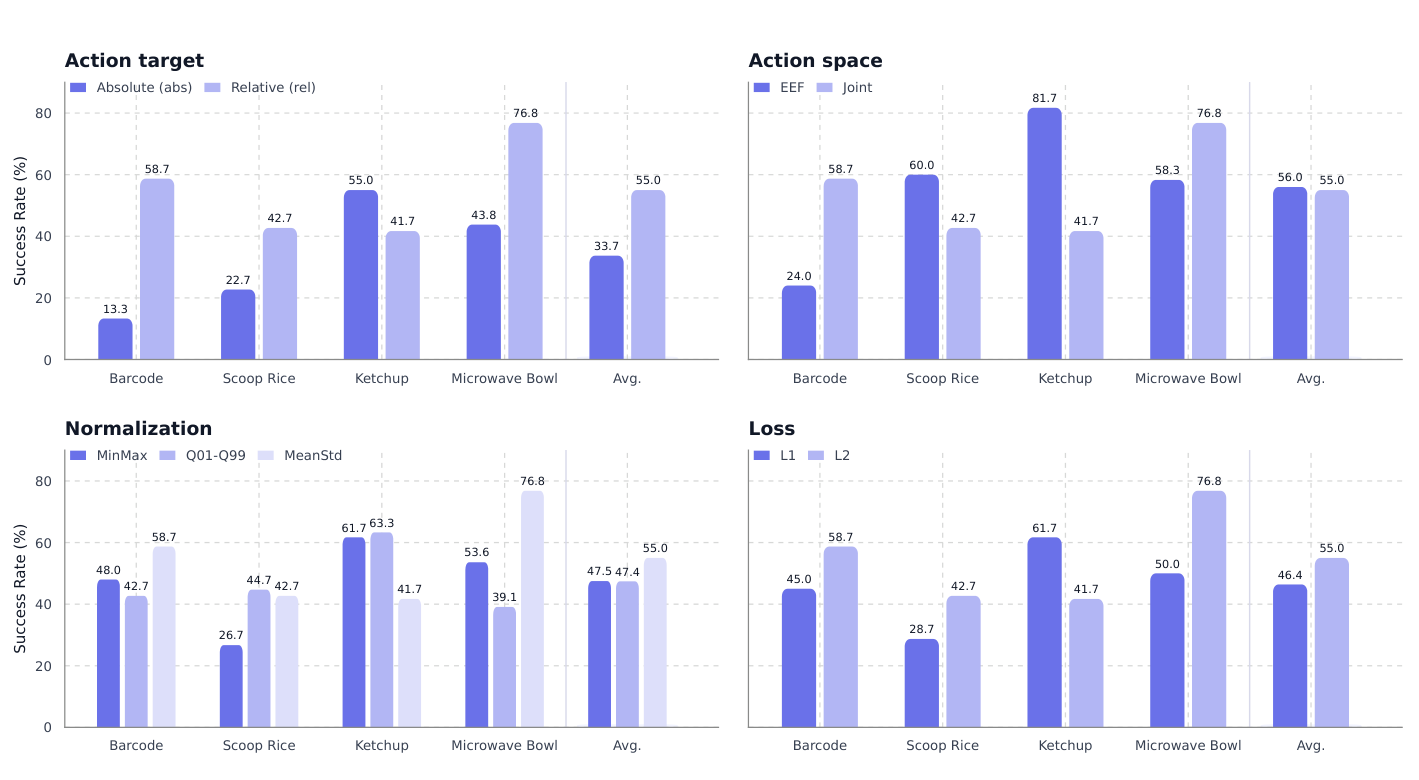
图 10 对应扫码、舀米、挤番茄酱和微波炉取碗四任务;每组右侧 Avg. 是这四任务平均成功率,不能与表 5 的九任务平均混用(第 6.1 节)。
- 相对/绝对关节目标: 相对目标平均 55.0%,绝对目标 33.7%。作者认为局部运动变化更集中、方差更低,较容易学习。当前实现的相对动作以当前状态为参照,区别于对相邻未来动作求逐步差分。
- 末端/关节空间: 平均分别 56.0% 与 55.0%,差距很小,任务偏好却明显。挤酱时末端空间为 81.7%、关节空间 41.7%;扫码则分别为 24.0%、58.7%。没有一种动作空间包揽全部任务。
- 归一化: MeanStd 为 55.0%,MinMax 为 47.5%,Q01–Q99 为 47.4%。作者将差异联系到目标分布的有效动态范围;这里 Q01–Q99 的实际设置没有裁剪,不能解释成“裁剪删除大动作导致失败”。
- 损失: L2 为 55.0%,L1 为 46.4%,但挤酱任务 L1 更好。当前 LeRobot 默认及官方 RoboTwin 后训练示例为
L1_fm,它们与这个实机四任务消融属于不同配置。
这些消融说明,动作表示、归一化与损失选择会影响不同任务的表现;模型结构之外,控制量的定义也是性能的重要条件。
未来预测的证据支持到哪里
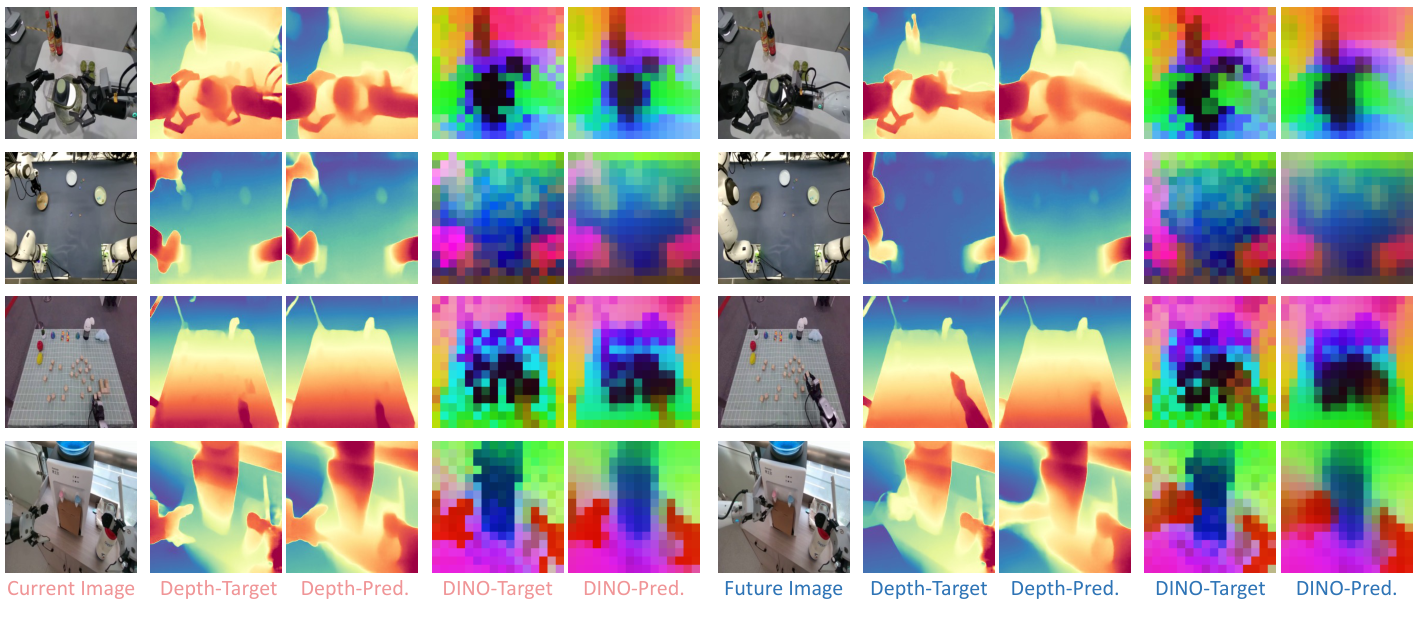
图 13 左半是当前画面对应的教师特征与预测,右半是未来画面对应结果;DINO 的彩色结果是特征 PCA 可视化。相似的形状与空间分布说明学生学到一定几何、时序线索,颜色本身不代表物理深度,也不是生成的 RGB 视频。
表 3 另外检验了教师:DINO-Video 在 LARYBench 四项指标中的三项最好,但人类组合动作分类为 80.21,略低于 V-JEPA 2 的 80.35。教师能力与图 13 的定性结果支持表示学习的可行性;论文没有单独移除当前/未来查询、深度/视频监督来量化各自的控制收益,因此不能仅凭这些图证明蒸馏导致了多少成功率提升。
LeRobot 接入与论文结果的边界
LeRobot 提供的 lerobot/lingbot_vla_v2_base 用于从规范空间开始微调;lerobot/lingbot_vla_v2_robotwin 是 14 维双臂接口的 RoboTwin 检查点。适配新机器人时,需要明确状态/动作槽位、相机名称、有效维度及数据统计,然后再反向映射输出。
接入文档列出的 RoboTwin Clean 93.52%、Randomized 92.80% 来自作者后续发布检查点的上游评测:50 个任务、每任务 100 个 episode,使用 clean 与 randomized 数据共同后训练及 FP32 推理。这组结果与前述 GM-100、移动操作实验的任务和协议不同。
实际使用还需分清两项设置:论文描述预训练的无辅助损失路由,发布的后训练示例使用额外均衡项;论文四任务偏好相对目标与 L2,LeRobot 默认相对动作关闭、损失为 L1_fm。这些差异应按目标检查点与任务理解,不能把某个默认值当成论文通用最优配方。
结论
LingBot-VLA 2.0 最值得理解的是这条连接:筛选与重建形成可信轨迹,规范槽位连接异构身体,稀疏专家承载共享与差异,当前/未来查询将感知监督接入动作生成。 它把基础模型能力向更完整的机器人控制接口推进。
实机结果支持整体方案在所测条件下的平均改善,也保留了低整任务成功率、部分任务退步和明显 OOD 退化。统一表示不等于任意本体即插即用,未来特征相似也不等于获得可靠的通用规划;方法效果仍取决于数据对齐、动作定义与目标任务评估。