LBM 与 MultiTask DiT:多任务预训练如何帮助机器人学习
A Careful Examination of Large Behavior Models for Multitask Dexterous Manipulation
- 扩散 Transformer
- 多任务预训练
- 数据效率
- 严格评测
多任务示范能否让机器人用更少数据学会新任务,并更好地应对环境变化?这篇论文固定策略架构,通过受控实验检验预训练的收益。
TRI LBM 论文研究多任务预训练,采用扩散目标;LeRobot MultiTask DiT是参考该路线的开源实现,也支持流匹配;Boston Dynamics Atlas 博客介绍全身控制应用。三者的平台、数据和训练配方不同,模型规模、动作空间与结果需分别理解。
预备知识:从示范到动作块
训练与推理
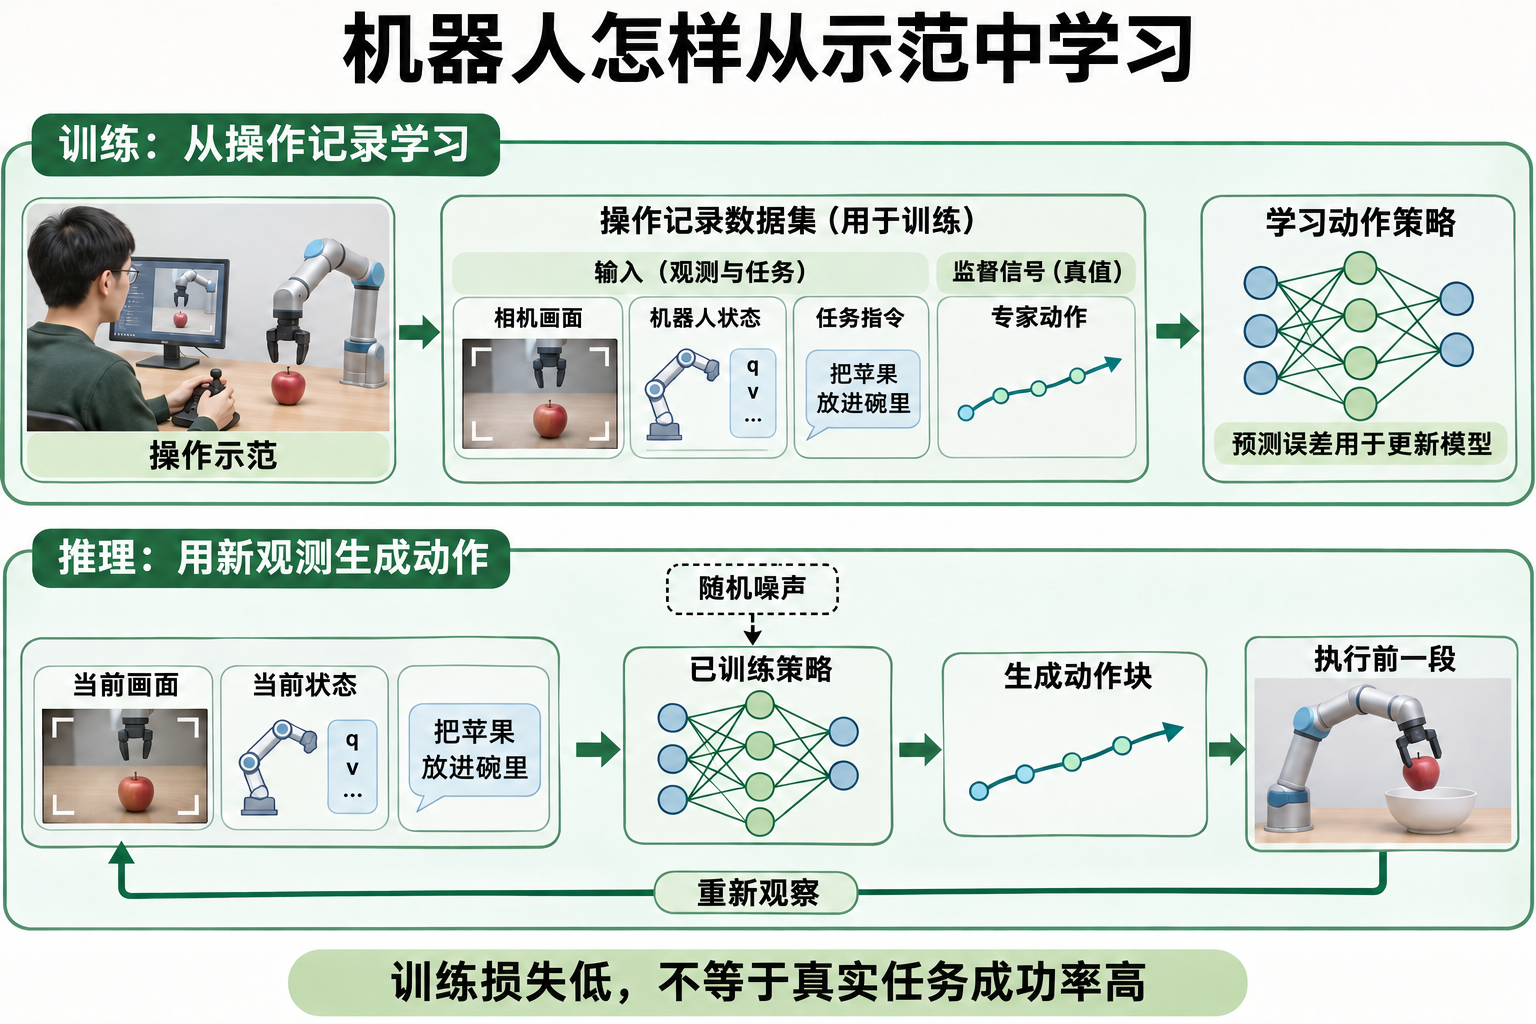
教学示意图|根据原论文与 LeRobot 实现整理,示例用于解释学习流程。
行为克隆(Behavior Cloning)用专家动作监督模型,根据画面、本体状态(Proprioception)和任务指令生成动作。训练时提供专家未来动作,推理时由模型根据观测与指令生成动作块。
大行为模型(Large Behavior Model,LBM)在本文中指从多任务示范学习的视觉运动策略。它使用对比语言图像预训练模型(Contrastive Language–Image Pre-training,CLIP)的图像和文本编码器,将画面与指令变为条件特征;任务指令由此参与动作生成。
动作块与生成模型
动作分块(Action Chunking)一次预测多个控制点,执行一段后再观察和预测。LeRobot 默认在动作队列耗尽后生成下一块,块内为开环执行,区别于 ACT 的重叠预测与时间集成。窗口与执行段的关系见动作窗口与执行段。
同一场景可能有多条合理轨迹,取平均未必可行。本文使用的扩散生成模型学习轨迹的条件分布,从随机噪声出发,结合观测生成动作。
扩散“时间”表示去噪进度,不是机械臂运动时间。下文以 表示物理时刻, 表示离散去噪步。
摘要:预训练的价值
摘要意译
模仿学习已能处理复杂操作,但大型机器人模型的真实收益仍缺少可靠评测。作者将 Diffusion Policy 扩展到多任务数据,对照单任务策略:仿真使用匹配随机种子与自动评分,实机采用盲测和随机执行顺序。
结果表明,多任务预训练后微调可提高成功率与抗扰动能力,减少新任务所需示范;在所测范围内,更大、更多样的预训练数据通常带来更多收益。
批注
- 固定核心架构,减少模型规模对预训练收益的干扰。
- 本文的数据效率结论来自任务微调,不等于零样本学习。
- 评测控制初始条件、试验顺序和评分,并进行统计分析。
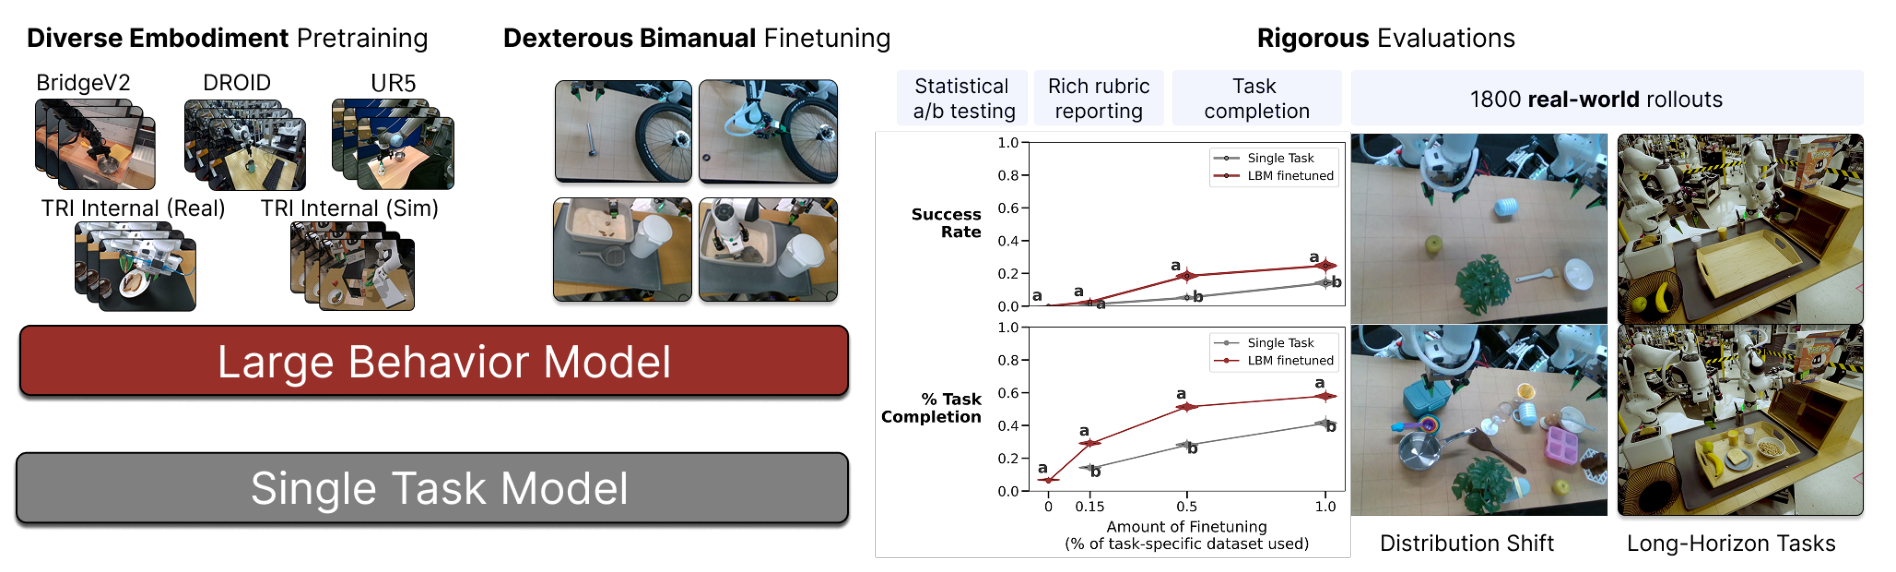
原论文图 1(PDF 第 2 页)|左侧对比预训练后微调与单任务训练,右侧通过实机试验和统计分析判断差异。
引言与相关工作
按原文三段理解研究问题
第 1 段:从硬件与自主能力的差距,引出示范学习。 机器人硬件能够执行许多动作,可靠自主运行却常局限于简单任务或结构化环境。行为克隆用任务示范替代逐任务编程,在复杂接触、柔性物体与双臂协作上已有进展,因此成为作者研究通用操作能力的起点。
第 2 段:从单任务策略的脆弱性,提出预训练收益的疑问。 单任务行为克隆难以应对训练分布之外的变化。LBM 尝试利用多任务示范扩大经验覆盖,但已有成功究竟有多少来自多任务预训练,仍缺少清晰证据。这一疑问把文章重点落到受控评测上。
第 3 段:说明实验规模,并列出三个主要发现。 作者使用约 1,700 小时示范训练模型,以仿真和约 1,800 次受控实机试验研究预训练收益。原文随后列出三点:微调达到相近表现所需的目标任务数据更少;相同目标任务数据量下,跨任务汇总表现更好;部署条件偏离训练条件时,上述收益更明显。后文分别检查其证据与适用范围。
相关工作
| 方向 | 已有工作 | 本文重点 |
|---|---|---|
| 通用机器人策略与 VLA | 用多任务数据、预训练表示和动作生成方法扩展能力 | 固定架构,量化预训练收益 |
| 大规模机器人数据 | 通过遥操作、公开数据、仿真和手持设备扩大数据来源 | 统一观测与动作格式,研究数据规模与多样性的作用 |
| 机器人评测 | 仿真基准、真实物体集、远程机器人和成功率指标 | 结合盲测、随机顺序、场景复位与步骤评分比较策略 |
论文未统一比较各类 VLA,结论不支持“DiT 总是优于 VLA”。
核心方法:条件 Diffusion Transformer
网络结构
直觉: 画面说明物体在哪里,指令说明要做什么,本体状态说明机器人当前姿态。网络将这些信息编码为条件,从随机动作块出发反复修正,生成符合当前情境的一段动作。
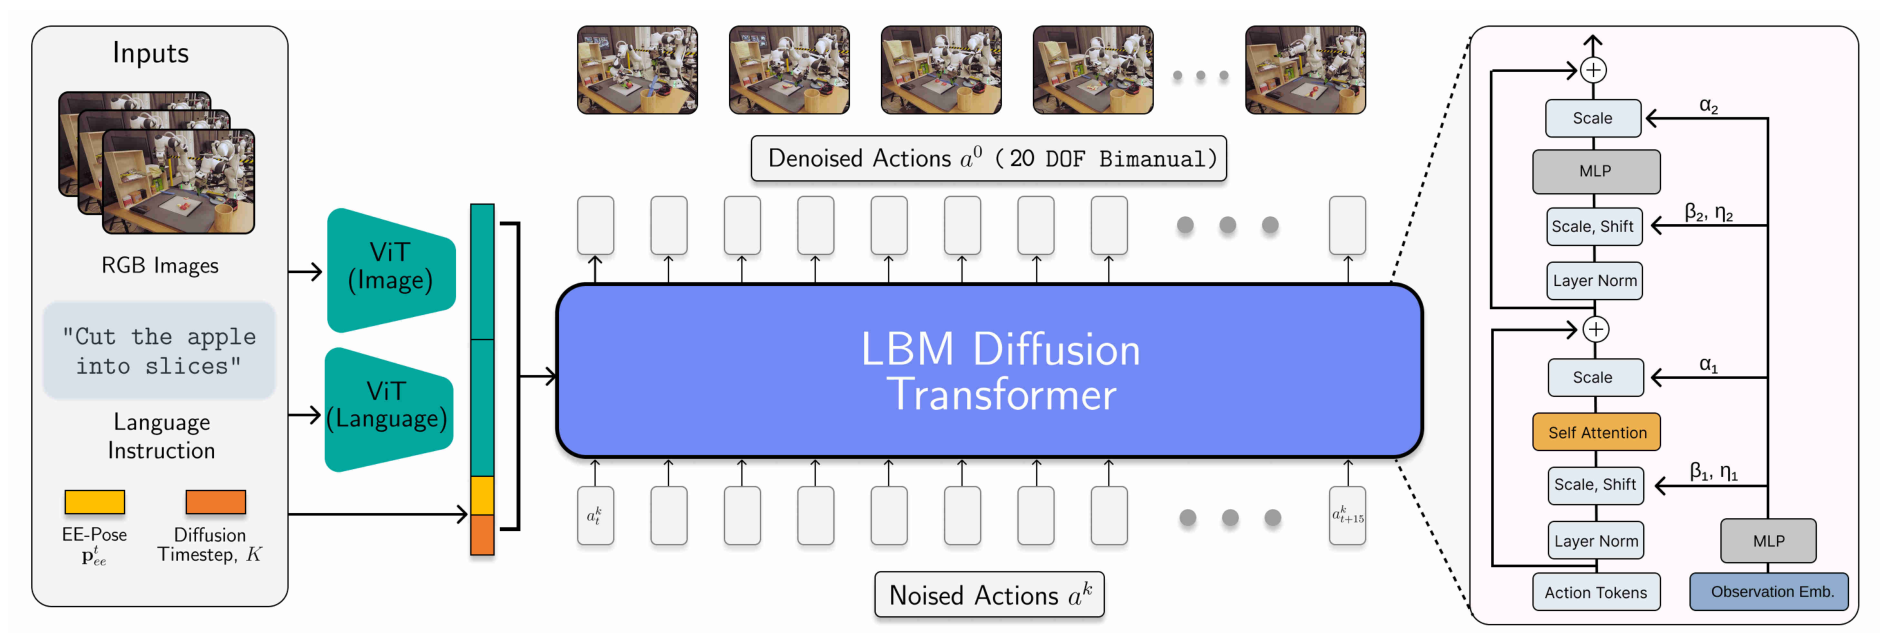
原论文图 9(PDF 第 12 页)|LBM 网络:左侧编码观测,中间去噪生成动作,右侧展示 Transformer 条件调制模块。
视觉编码器提取图像的分类词元(Classification Token,CLS token),用这一向量概括图像信息;训练时更新,各相机共享权重。文本编码器将指令转为定长特征,主干冻结,仅训练其后的投影层。扩散 Transformer(Diffusion Transformer,DiT)在动作时间轴上计算自注意力,预测整段动作的噪声。这里的词元(Token)是网络处理的特征单元,可以是连续向量。
观测与动作维度
原论文输入最多 6 路 RGB,缺失相机补零,使用 2 帧观测。状态包括双臂末端相对基座及彼此的位姿、夹爪开度,不是关节角向量。
动作轨迹以当前时刻观测为参照进行相对表示(原文第 IV-D1、D2 节)。每只手的动作包括平移 3 维、旋转表示 6 维、夹爪开度 1 维,因此双臂动作是:
是每个控制时刻的动作维度。网络输出 16 点,单条样本形状为 ,共 320 个数。6 维旋转取自旋转矩阵前两行,并非 6 个旋转关节;20 维输出不能直接驱动单臂关节控制器。
论文的两帧观测特征共 6,732 维,使用 8 个 DiT 块,隐藏宽度为 768。LeRobot 则按相机数、状态维度和配置计算条件维度。
扩散训练:预测噪声
设 为干净动作块, 为视觉、语言和状态条件。训练时随机选择噪声等级 ,采样高斯噪声 。下面用标准去噪扩散概率模型(Denoising Diffusion Probabilistic Model,DDPM)的加噪形式解释训练目标:先按噪声等级混合动作与噪声,再让网络预测加入的噪声。
为块长度, 为动作维度, 为噪声调度中的累计信号保留系数, 为 DiT 的噪声预测。期望覆盖样本、噪声和去噪等级。原论文式(2)给出噪声预测损失,并将加噪写作 ;此处采用标准 DDPM 形式解释 LeRobot 的 add_noise 路径,并非原式的逐项展开。
解释性例子: 取归一化后的一个动作值 ,令 、噪声为 ,带噪输入为 。网络接收 及观测条件,监督目标是噪声 。这里只演示一个元素,实际模型同时预测整个动作块的噪声。
DiT 如何使用观测条件
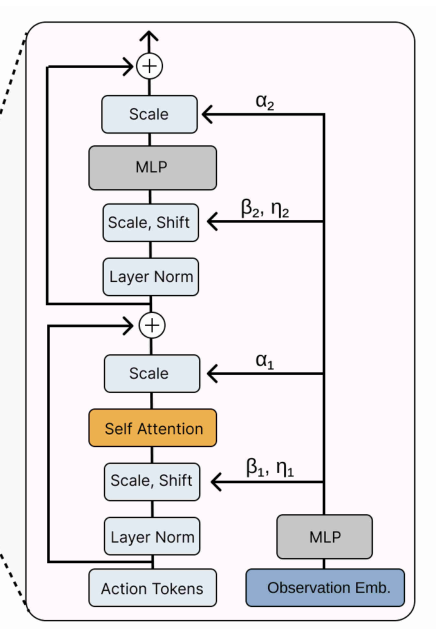
动作向量投影后形成长度为 的词元序列,自注意力联系前后控制点。观测条件则通过自适应层归一化(Adaptive Layer Normalization,adaLN)影响动作特征:根据当前场景和任务,为各特征维度生成缩放与偏移参数。其调制作用可写成:
为动作隐藏特征, 包含视觉、文本、状态与去噪步条件, 为层归一化,、 为条件预测的缩放增量与偏移, 表示逐元素相乘。参数沿动作序列广播,影响整段动作;注意力处理动作间关系。LeRobot 还由条件生成注意力与多层感知机(Multilayer Perceptron,MLP)残差支路的门控系数。
解释性例子: 某维归一化特征为 ,缩放增量为 ,偏移为 ,调制后为 。条件改变时,网络可以生成不同的缩放与偏移;这些是内部特征参数,不是直接发给机械臂的动作。
结构事实: 该网络将编码后的观测拼接为定长条件,通过 adaLN 调制动作特征。作者的解释: 论文讨论中认为,未微调 LBM 的表现不稳定,可能部分源于小型语言编码器的指令引导较脆弱。原论文没有单独消融条件压缩,不能据此确定压缩本身造成了语言能力限制。 原论文图 9 右侧局部(PDF 第 12 页)|条件嵌入生成缩放、偏移与门控参数,作用于注意力和 MLP 支路。图 9:条件调制模块放大图
推理:去噪与执行
推理时编码当前观测,从随机动作块出发,多步调用同一 DiT 去噪。论文采用去噪扩散隐式模型(Denoising Diffusion Implicit Model,DDIM)采样,即用训练好的噪声预测网络逐步更新动作块;执行选定前段后,根据新观测生成下一段。
控制频率、块长度与采样次数需区分。 论文一次生成 16 点,执行 8 点后重新预测;生成一块需多次调用 DiT。标注的 10 Hz 策略循环不等于每秒生成 10 块,也不是其他硬件的延迟保证。
训练:预训练与微调
机器人与示范数据
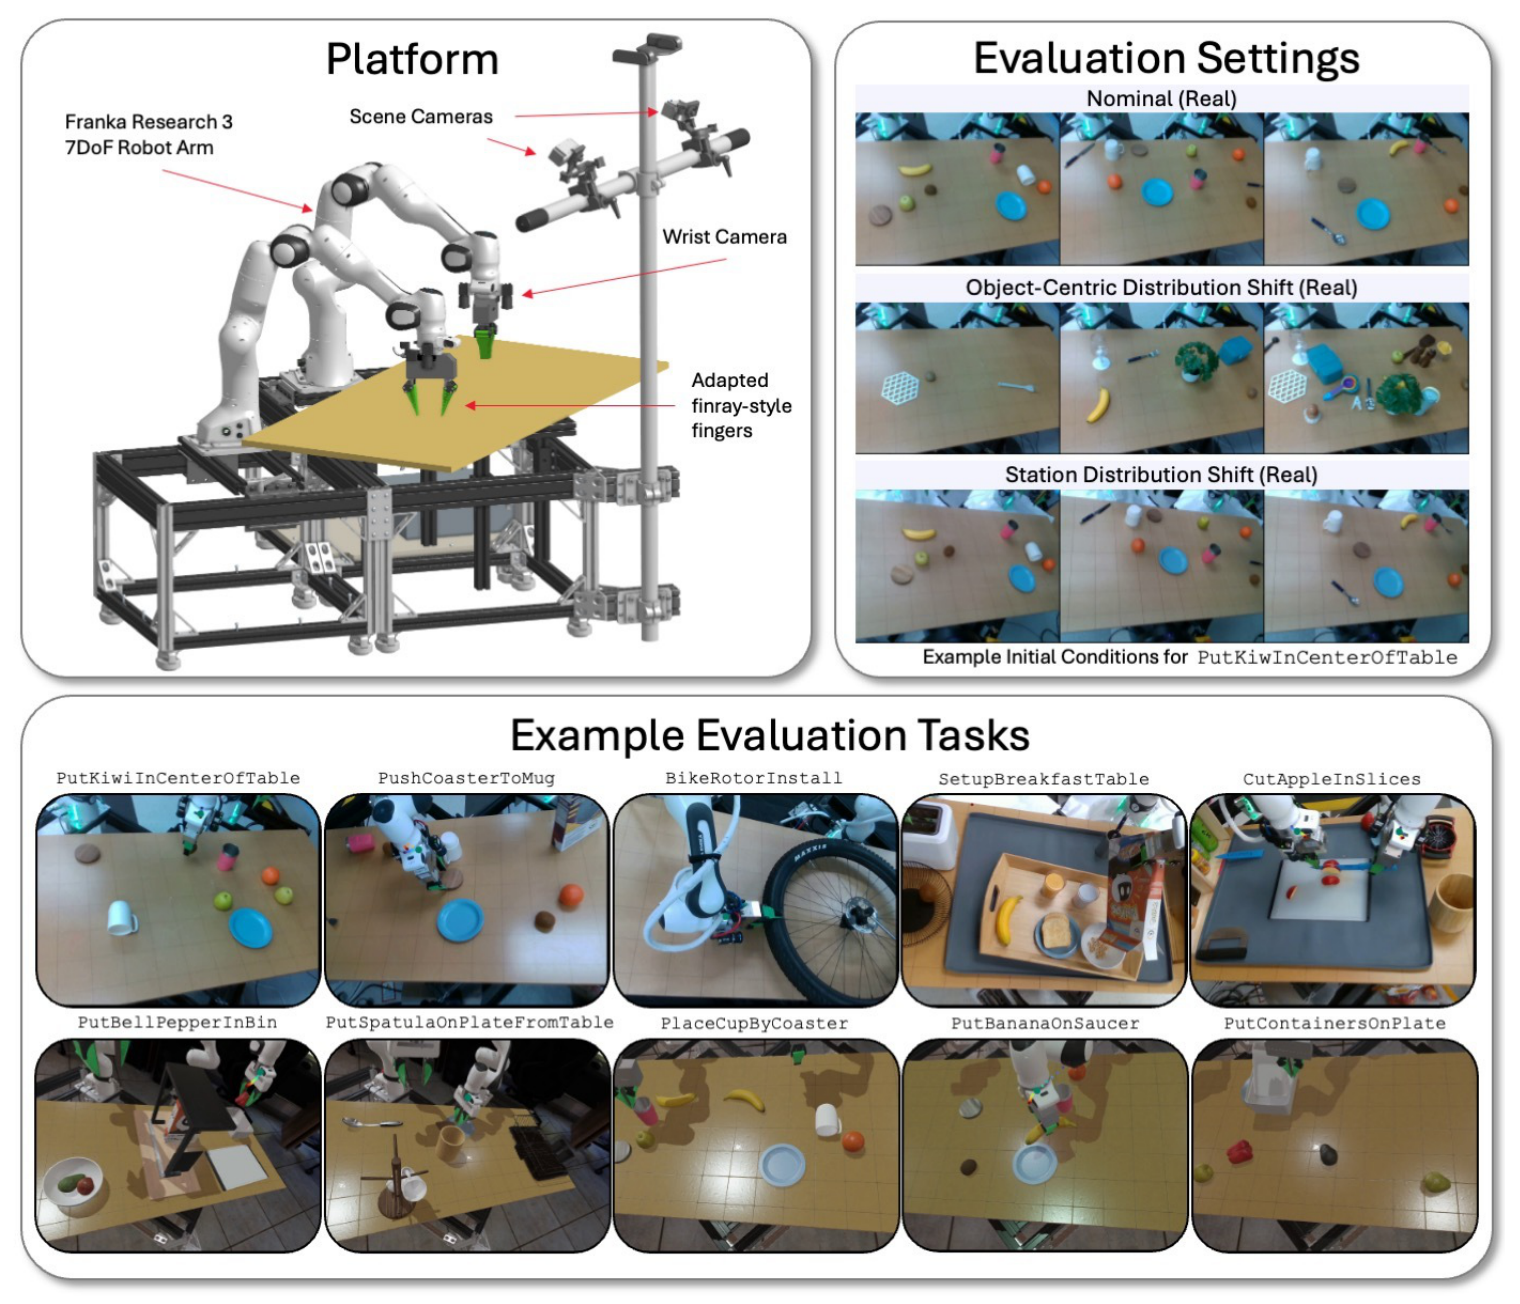
原论文图 10(PDF 第 14 页)|左上为双臂与相机配置,右上为环境变化,下方为摆放与多步骤精细操作任务。
原论文使用两台 Franka FR3、平行夹爪和定制 finray 指端。新平台有 2 台场景相机、每腕 2 台相机,共 6 路 RGB。数据覆盖硬件升级前后,实机测试使用新平台。末端目标由微分逆运动学与关节阻抗控制器跟踪,底层控制负责避碰;“端到端学习”仍依赖这些执行接口。
| 数据来源 | 论文报告的规模 | 作用 |
|---|---|---|
| TRI-Ramen-Real | 468 小时,362 个任务,46,063 条示范 | 内部真实双臂机器人数据 |
| TRI-Ramen-Sim | 45 小时,41 个任务,7,348 条示范 | 与真实平台对应的仿真数据 |
| TRI-Ramen-UMI | 32 小时,129 个任务,10,851 条示范 | 手持设备在实验室外采集的操作 |
| OXE-Ramen | 约 1,150 小时 | 从公开 Open X-Embodiment 数据筛选并统一格式 |
前三项共约 545 小时、532 个任务、64,262 条示范;含 OXE 子集共约 1,695 小时。532 仅统计内部数据任务。
数据对齐与归一化
跨来源数据需统一坐标系、位姿单位、夹爪宽度和图像处理。论文将单臂数据补零为双臂形式,随机交换左右侧,并按来源加权采样,避免大数据源主导批次。
较远动作点的变化范围通常更大。论文按特征维度、相对时间点和数据来源计算分位数,将 2% 至 98% 分位区间映射到 ,在 截断;6 维旋转不参与此缩放。
LeRobot 差异: 此版本默认对状态和动作使用 MIN_MAX,视觉使用 MEAN_STD,未自动复现论文按来源、时间点计算的分位数归一化。数据处理差异同样影响结果。
训练配置
| 阶段 | 起点与数据 | 学习率 | 全局 batch | 训练步数 |
|---|---|---|---|---|
| 多任务预训练 | 完整混合数据;视觉和文本编码器使用 CLIP 预训练权重 | 3e-4 | 2,560 | 48,000 |
| 真实任务微调 | LBM 权重,加目标任务示范 | 2e-5 | 320 | 30,000 |
| 仿真任务微调 | LBM 权重,加目标任务示范 | 2e-5 | 320 | 10,000 |
| 真实单任务基线 | 无机器人多任务预训练,但仍采用相同 CLIP 初始化 | 2e-5 | 320 | 100,000 |
| 仿真单任务基线 | 同上,仅用目标任务示范 | 2e-5 | 320 | 25,000 |
视觉编码器的学习率为其余可训练部分的十分之一。图像训练时先缩放到 256×342(高×宽),再随机裁成 224×224 并使用颜色增强;推理时改为中心裁剪。
“从零训练”指未经过机器人多任务预训练,仍使用 CLIP 初始化。单任务基线的目标任务训练步数更多。
评测方法
任务划分与评分
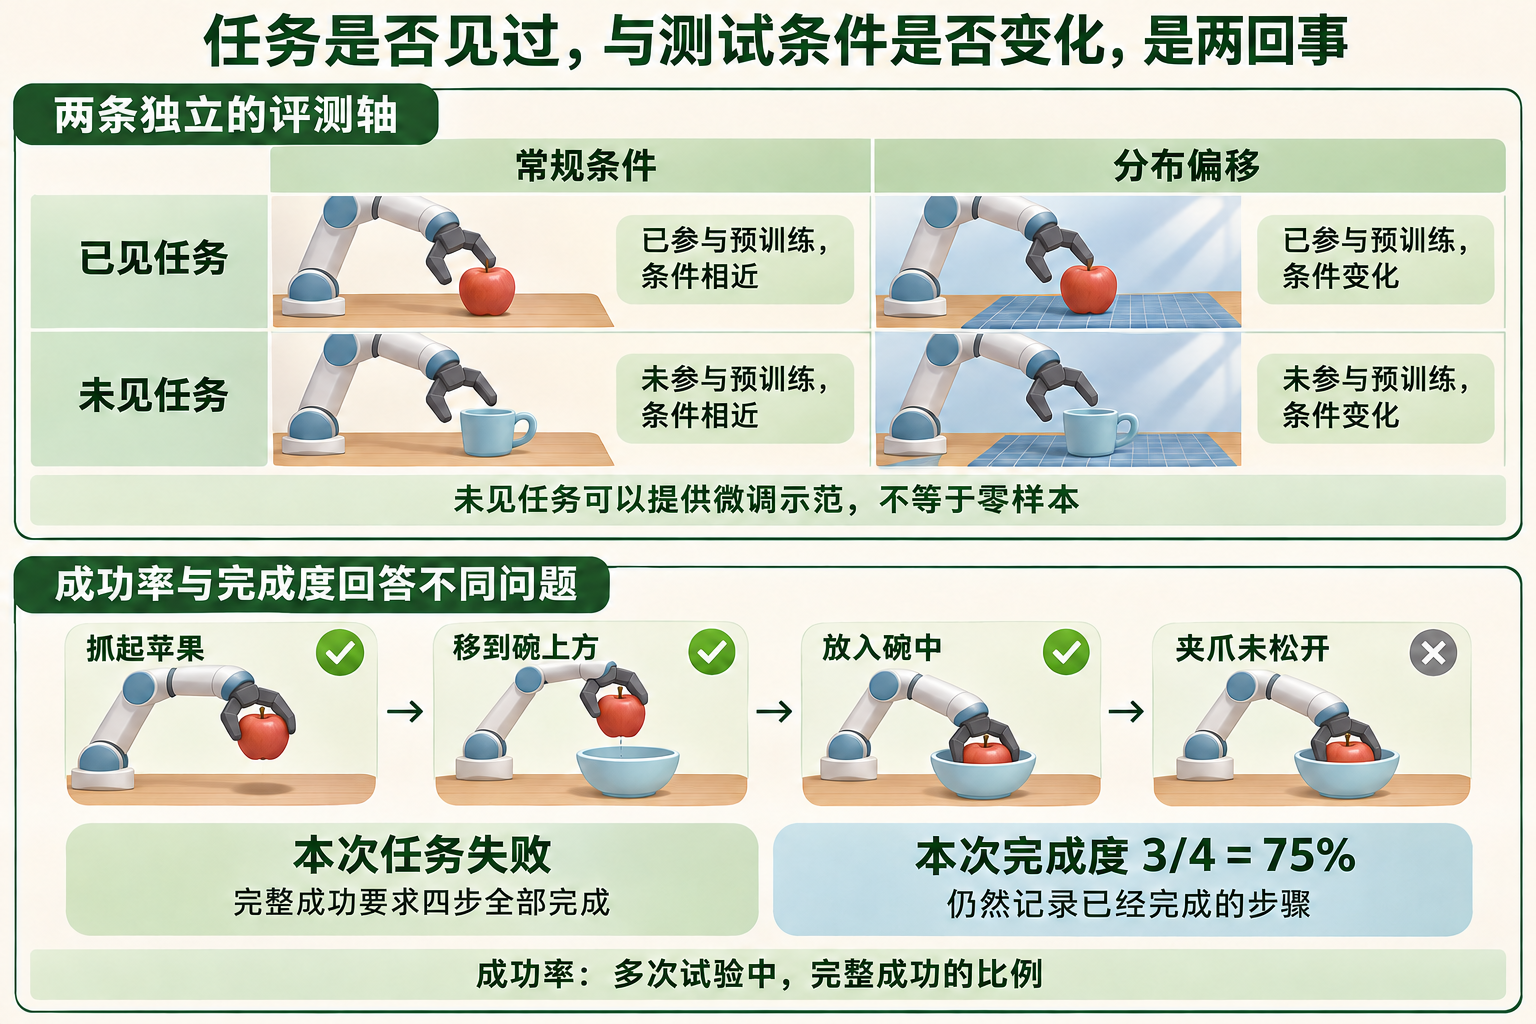
教学示意图|根据原论文整理;苹果入碗的四步评分用于解释指标,不是论文实测任务的计分记录。
上半图区分已见/未见任务(Seen/Unseen)与分布偏移(Distribution Shift)。未见任务可提供微调示范;分布偏移指干扰物、物体组合或工作站等测试条件变化。
下半图以四个里程碑解释成功率(Success Rate,SR)与任务完成度(Task Completion,TC):苹果入碗但夹爪未松开,完成 3/4 步,TC 为 75%,任务仍失败。此为计分示例。
是试验次数, 是完全成功次数; 是里程碑数, 表示第 次试验是否完成第 项。
盲测、随机顺序与复位
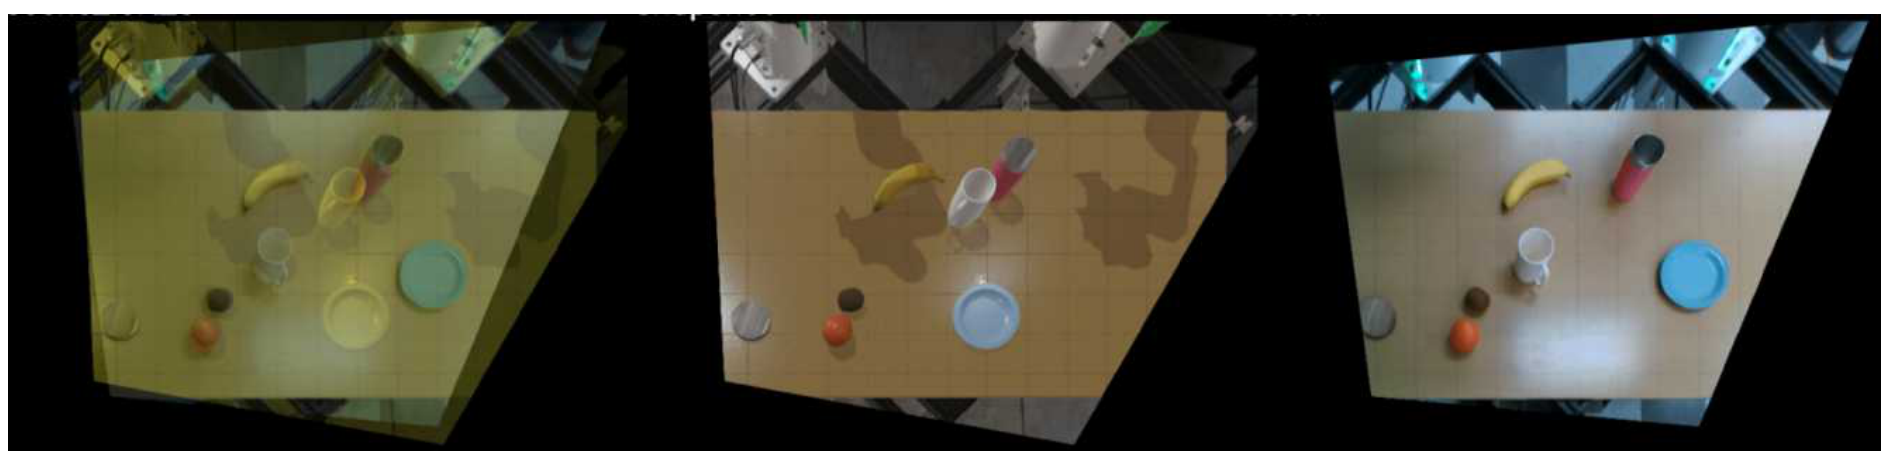
原论文图 8(PDF 第 11 页)|左侧叠加目标与当前场景,辅助复位;中间为目标场景,右侧为当前场景。
评价人员不知策略身份;各策略在同一初始条件下随机排序,每次运行后复位,减小顺序、灯光和摆放偏差。仿真使用对应随机种子,实机用图像叠加辅助复位;测试初始状态不逐一复用训练示范。
实机测试含 3 个 seen、5 个 unseen 任务,仿真含 16 个 seen、8 个 unseen 任务。每个“任务×策略×条件”分别计划运行 50 次、200 次,少数仿真组合因数据缺失不足 200 次。分析共覆盖约 1,800 次实机和超过 47,000 次仿真运行。
小提琴图与统计比较
SR 小提琴图表示基于成功/失败记录估计的真实成功概率的贝叶斯后验。TC 单任务图主要展示完成度的原始分布,部分汇总与数据量实验则展示平均完成度的后验,需区分图意。
论文用紧凑字母显示(Compact Letter Display,CLD)标示统计比较。无共同字母表示检出显著差异;共享字母表示未检出差异,不代表效果相同。阅读时需结合图注、检验方法与比较范围。
实验结果与限制
未见任务的完成度
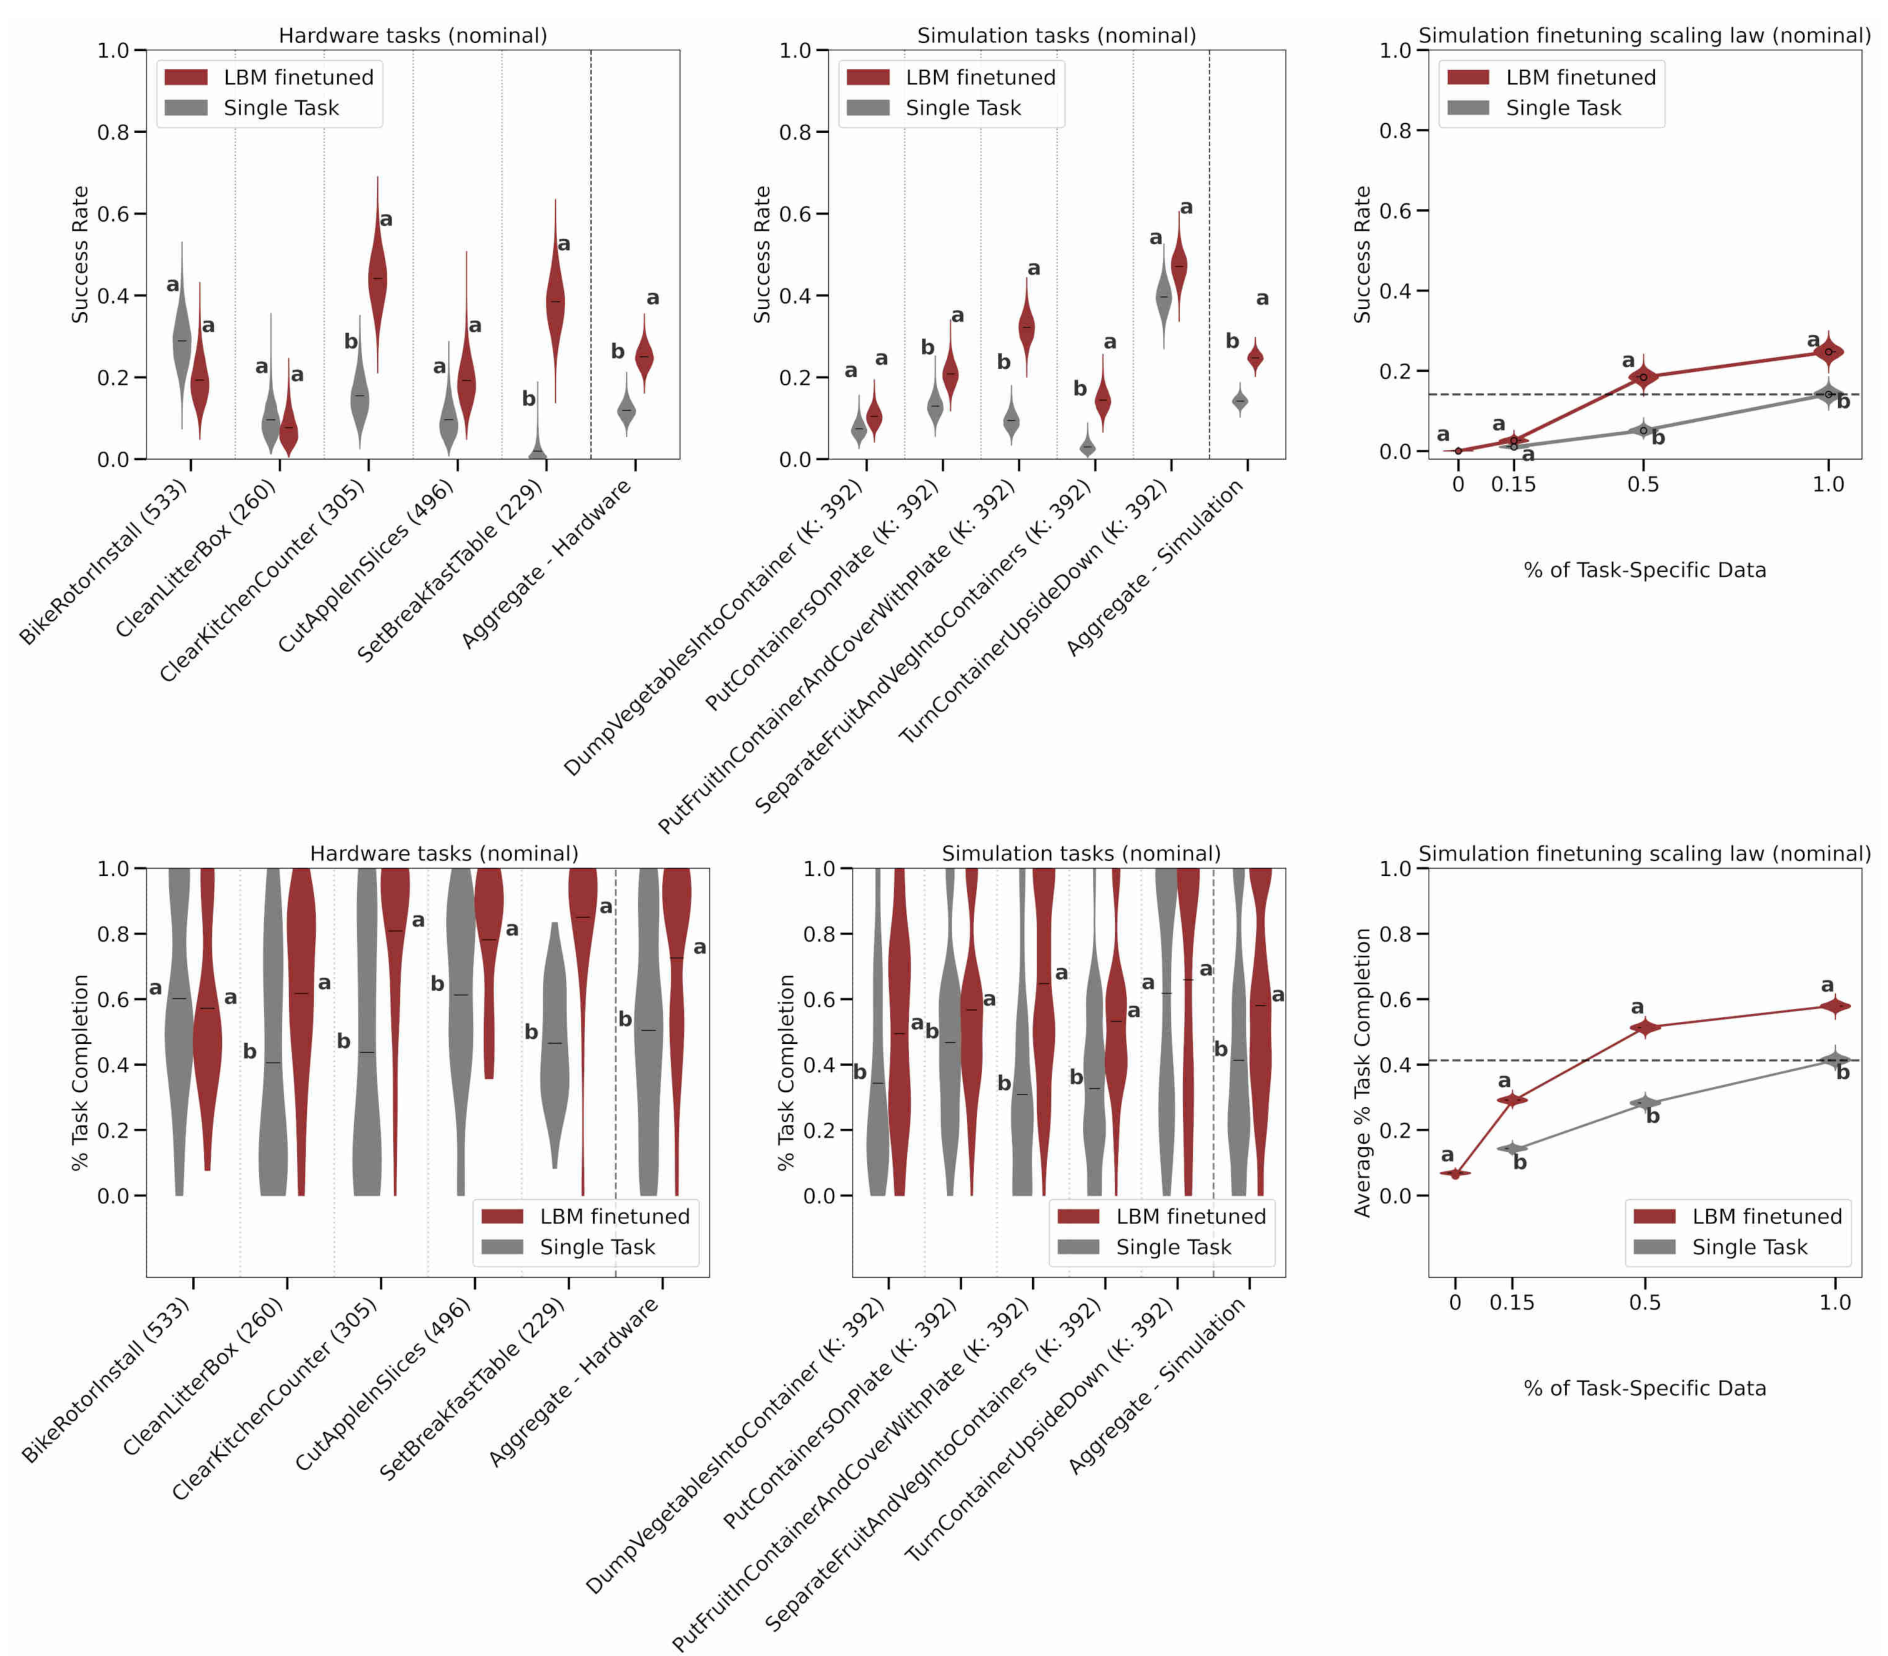
原论文图 4(PDF 第 7 页)|名义条件下的未见任务。上排是 SR,下排是 TC;左列真实机器人、中列仿真、右列仿真数据效率。红色为预训练后微调,灰色为单任务基线。
复杂任务的完整成功率仍不高,但微调 LBM 通常能完成更多步骤。5 个真实复杂未见任务中,4 个任务的 TC 显著优于单任务基线,SR 仅 2 个任务有显著优势。
汇总优势较稳定,但部分任务差异不显著,或基线更好。模型仍会起始不动、选错任务,需结合单项结果与失败案例判断。
鲁棒性:测试条件变化后,优势是否保留
仿真的分布偏移主要改变外观:引入训练时未见的环境光照贴图,改变光源、相机参数、物体与桌面的纹理及颜色,部分场景还加入干扰物。作者在这些条件下重新比较微调 LBM 与单任务基线,检查预训练的收益是否保留。
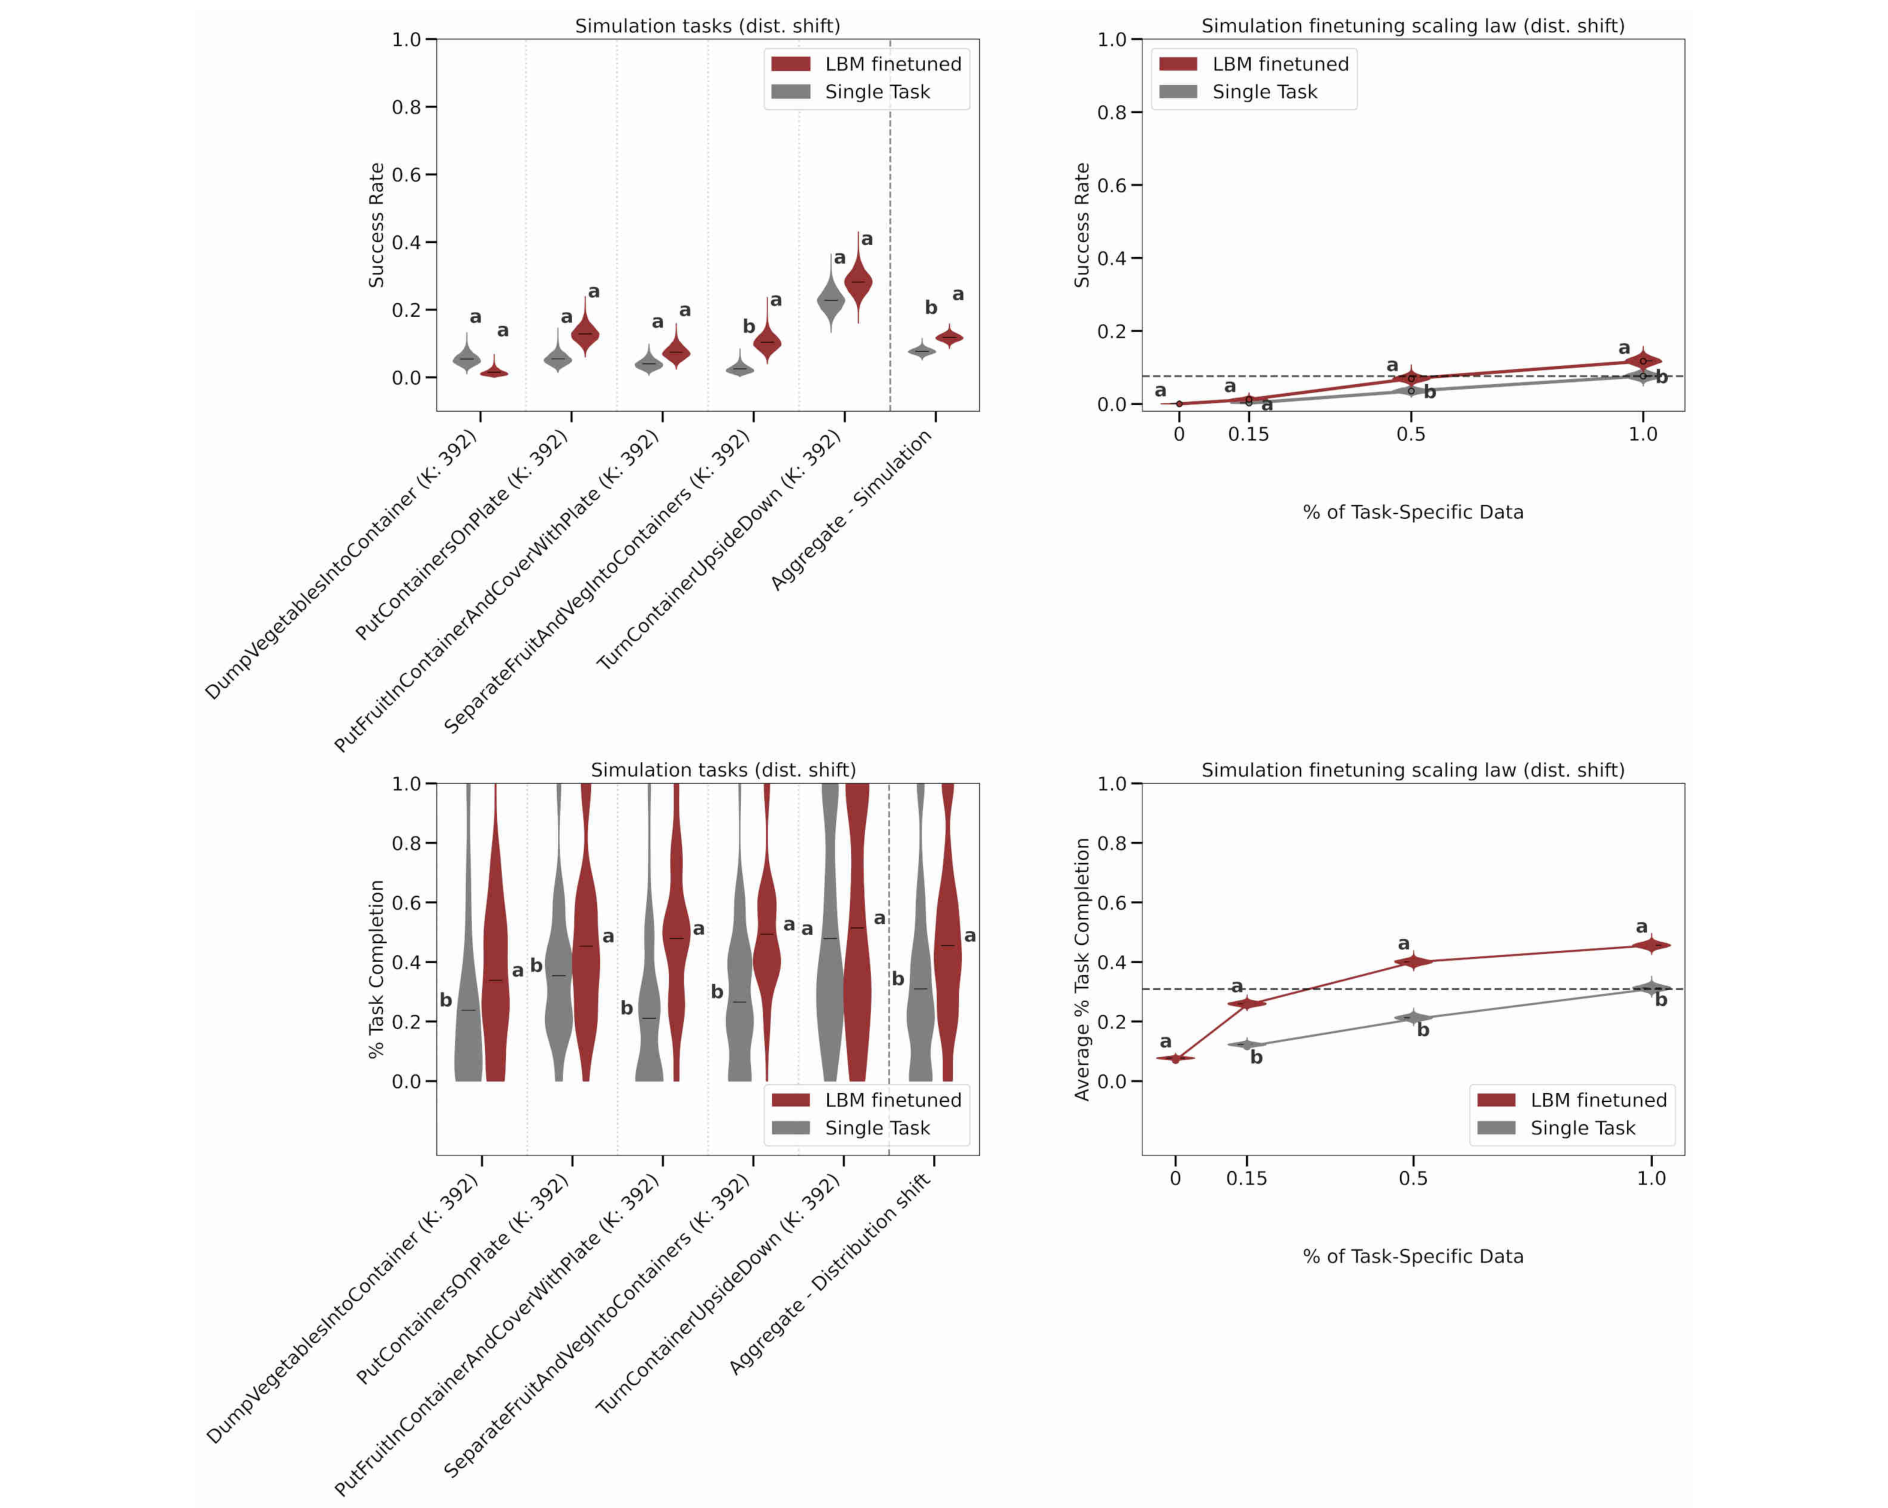
原论文图 6(PDF 第 9 页)|上排为 SR,下排为 TC;左列为单项任务及汇总,右列为不同目标任务数据比例。红色为预训练后微调,灰色为单任务基线。对照图 4 的仿真部分阅读,图 6 不包含实机结果。
在 5 个复杂仿真未见任务中,分布偏移下有 4 个任务的 TC 显著优于基线,但 SR 仅 1 个任务有显著优势。原文的已见任务实验还显示:微调 LBM 的 SR 显著优于单任务基线的仿真任务数,由名义条件下的 3/16 增至分布偏移下的 10/16,汇总成功率的差距也扩大(原文第 III-A 节、图 2)。
这些结果支持微调 LBM 在所测分布偏移下更稳健,但引入变化后,多数任务的绝对表现仍下降。复杂任务即使完成更多步骤,完整成功率仍可能很低;仿真外观变化与实机的工作站、物体变化也不能直接等同。
新任务的数据效率
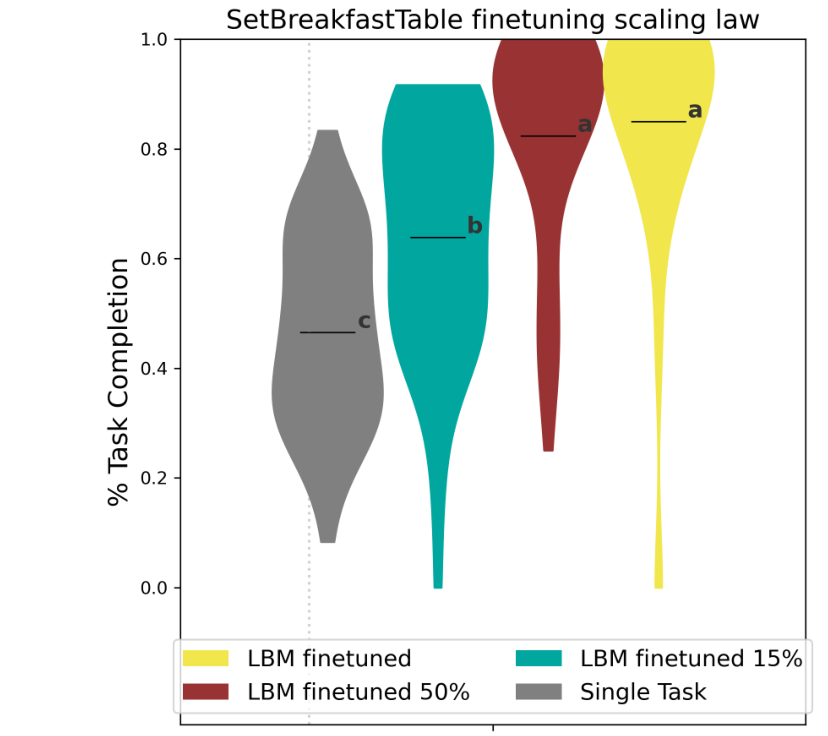
原论文图 5(PDF 第 8 页)|实机数据效率:纵轴为 TC,各组比较不同比例数据微调的 LBM 与全量数据训练的单任务基线。
真实任务 SetBreakfastTable 中,LBM 用 15% 目标任务数据微调,其 TC 显著优于使用全部目标任务数据的单任务基线。该结果衡量完成度,不是成功率。
复杂仿真任务的汇总曲线插值表明,达到相近表现所需数据可低于从零训练的 30%。这与实机 15% 的结果来自不同实验,均不能推广为所有任务的固定节省比例。
预训练数据的规模与多样性
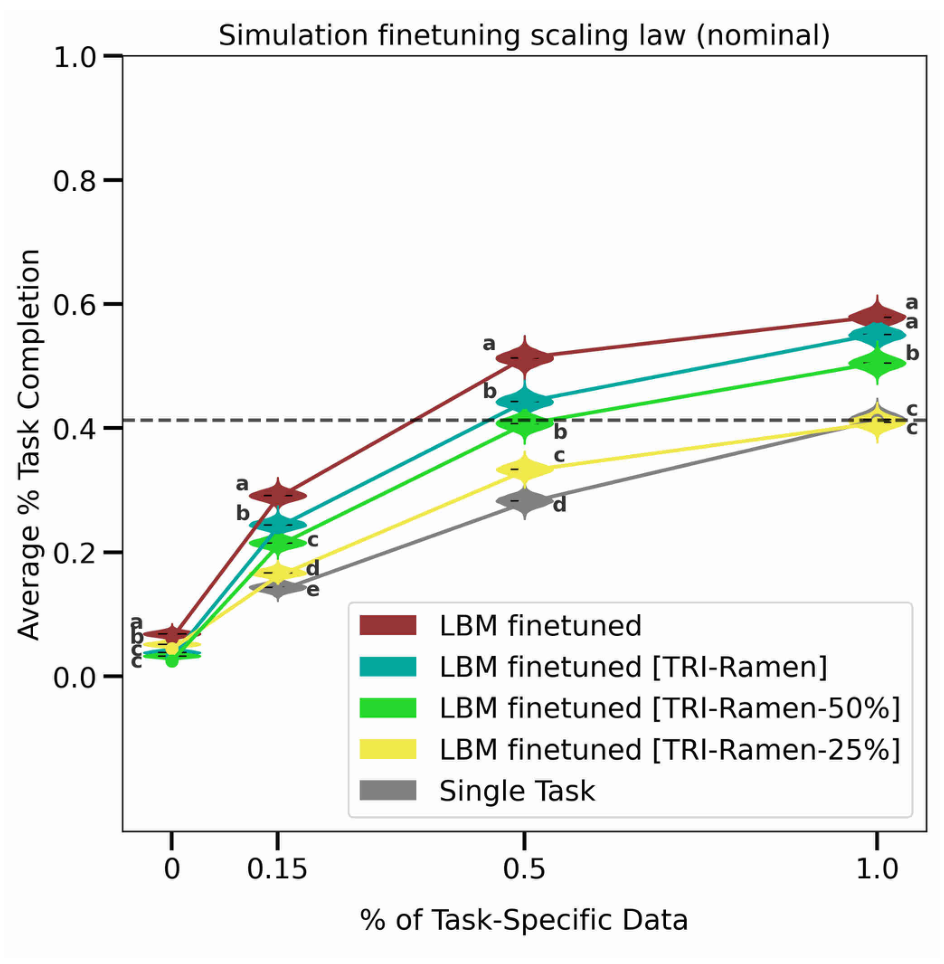
原论文图 7(PDF 第 10 页)|横轴为微调数据比例,纵轴为 5 个仿真未见任务的平均 TC;各曲线对应不同预训练数据组合。
相同微调数据比例下,更丰富的预训练数据通常表现更好,目标任务数据较少时收益尤为明显。横轴为微调数据比例;有限子集实验未证明普适缩放定律或增加参数量的收益。
研究限制
- 直接部署优势不稳定。 未微调 LBM 未持续优于单任务策略;作者推测,这可能部分与小型语言编码器的语言引导能力有关。
- 实验范围有限。 特定双臂平台的结果不能直接推广到单臂或任意家庭场景。
- 未充分评估训练随机性。 小提琴主要反映固定 checkpoint 的评测不确定性,未完整涵盖重复训练差异。
- 预训练存在归一化错误。 部分数据误用其他来源的参数,主实验未全部重跑;修复后,补充实验中所测仿真分布偏移表现更好。
- 过滤静止帧效果不一。 去除起始低运动片段改善了部分单任务仿真策略,却使部分预训练模型更常选错任务,因此未统一过滤。
LeRobot 实现与应用
以下对照固定提交 f5c9bc0。LeRobot MultiTask DiT 参考了 LBM 的条件 DiT 路线,但配置、数据处理与训练结果应按各自来源理解。
配置对照
| 项目 | TRI 论文 | 固定版本 LeRobot 默认配置 |
|---|---|---|
| 训练目标 | 扩散噪声预测;DDIM 采样 | diffusion,也支持 flow_matching |
| 图像、文字主干 | CLIP;视觉更新、文本冻结 | 同一路线,默认 openai/clip-vit-base-patch16 |
| DiT 规模 | 8 层,宽度 768 | 6 层,宽度 512,8 个注意力头 |
| 观测历史 | 2 帧 | n_obs_steps=2 |
| 动作输出 | 16 点,每点 20 维 | horizon=32,动作维度从数据集取得 |
| 执行选段 | 选取 8 点后重规划 | n_action_steps=24;按观测偏移切片后入队 |
| 相机 | 统一 6 路,缺失补零 | 从输入特征推断相机数,默认共享视觉编码器 |
| 归一化 | 按来源、时间点、维度分位数处理 | 状态、动作默认 MIN_MAX;视觉 MEAN_STD |
默认 num_inference_steps=None,沿用 num_train_timesteps=100,即 100 次去噪。默认启用旋转位置编码(Rotary Position Embedding,RoPE),也支持可学习绝对位置编码;此版本允许两者同时启用。
参数量随相机数、层数和隐藏宽度变化。Boston Dynamics 博客中的 450M 参数、48 点预测、24 点执行属于 Atlas 配置,不能套用到任意 LeRobot 配置。
动作窗口与执行段
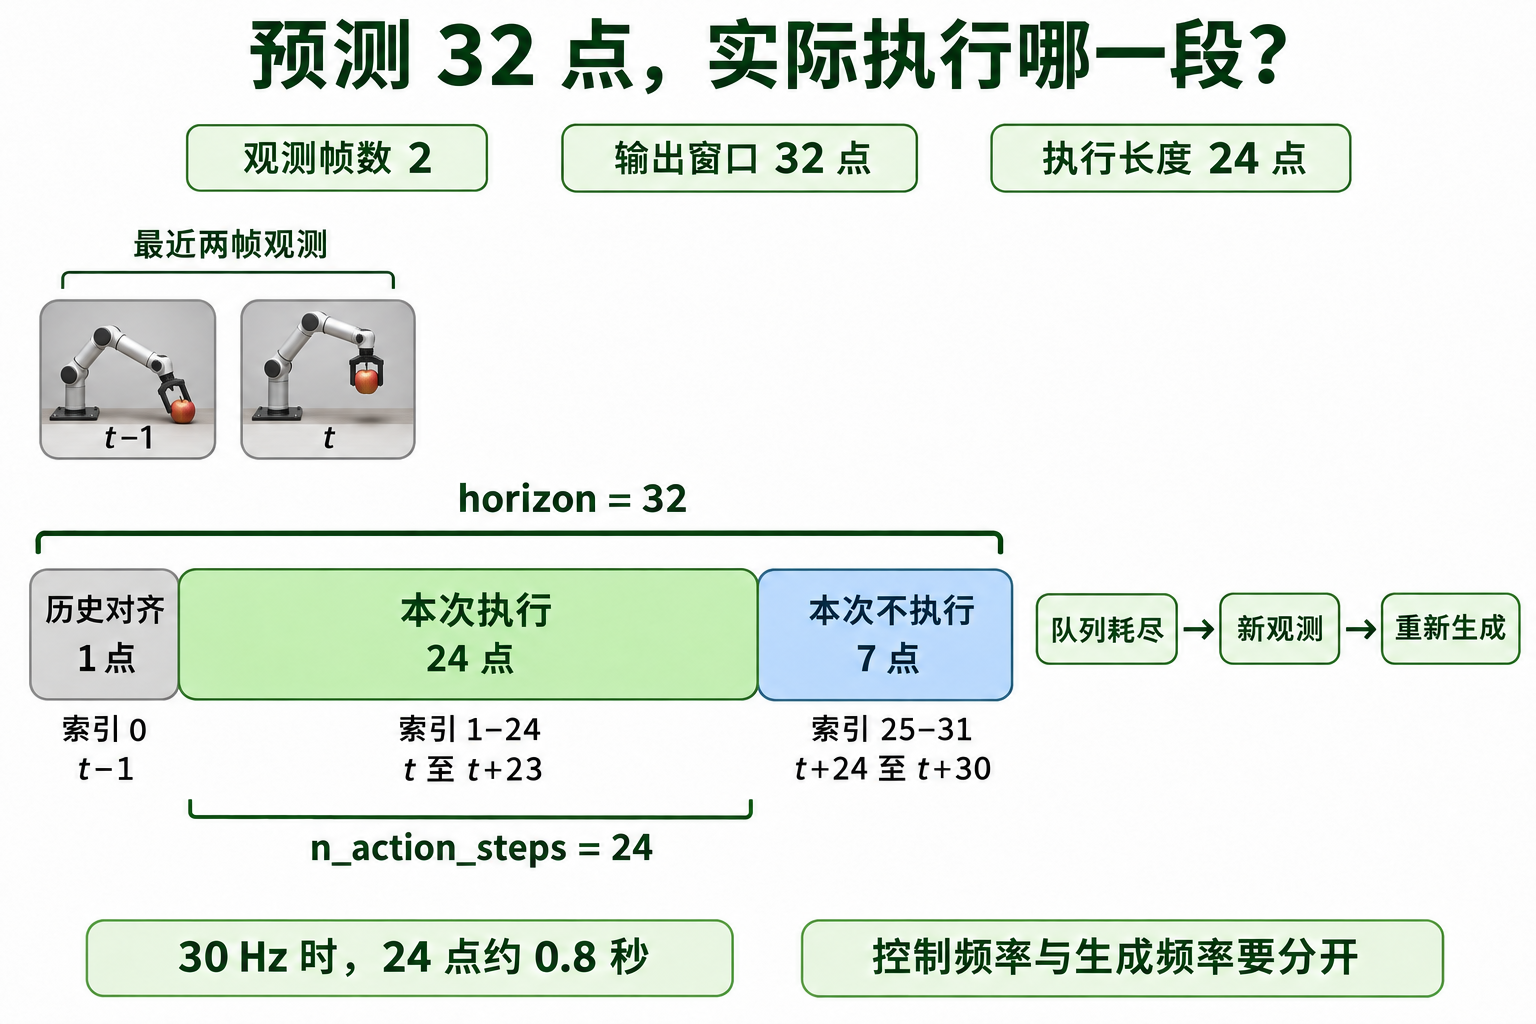
教学示意图|根据固定版本 LeRobot 的动作切片逻辑整理,32 点窗口与 24 点执行段为该版本默认值。
两帧观测时,动作窗口始于 。_generate_actions 取索引 1:25,将 至 的 24 点放入执行队列。窗口长度 、观测帧数 与执行点数 需满足:
、、 时满足 。
采样与执行均为 30 Hz 时,24 点对应图中的 0.8 秒;10 Hz 时约为 2.4 秒。缩短执行段可更快利用新观测,但需更频繁生成。实际周期还受推理和传输延迟影响,窗口参数不设置控制频率。
训练起点与论文结论的关系
LeRobot 可以从 CLIP 预训练权重初始化图像与文本编码器,再用自己的机器人示范训练动作策略;这样尚未获得 TRI 的机器人多任务预训练经验。验证论文中的迁移收益,需要另外比较单任务训练与多任务预训练后微调,并固定目标任务数据、动作接口和测试条件。
将实现迁移到 reBot 或 SO-ARM101 时,需先检查数据集的状态、动作、相机、时间戳与任务指令,再验证单任务控制链路。
如何理解这篇论文的结论
这篇论文的重点是用固定策略架构和受控评测,检验多任务预训练是否带来收益。在所测任务上,预训练后微调能提高跨任务汇总表现,并减少达到相近表现所需的目标任务示范;测试条件变化时,部分优势更明显。
这些发现支持多样化示范预训练的价值,也保留了清楚的边界:收益依赖任务与微调条件,完成度提升不一定转化为完整成功;未微调模型没有稳定胜过单任务策略。阅读时,应把网络如何生成动作、实验如何比较策略,以及结果能支持多大范围的结论一起理解。