π0:基于流匹配的通用机器人控制
π0: A Vision-Language-Action Flow Model for General Robot Control
- 机器人基础模型
- 动作专家
- 流匹配
- 跨本体训练
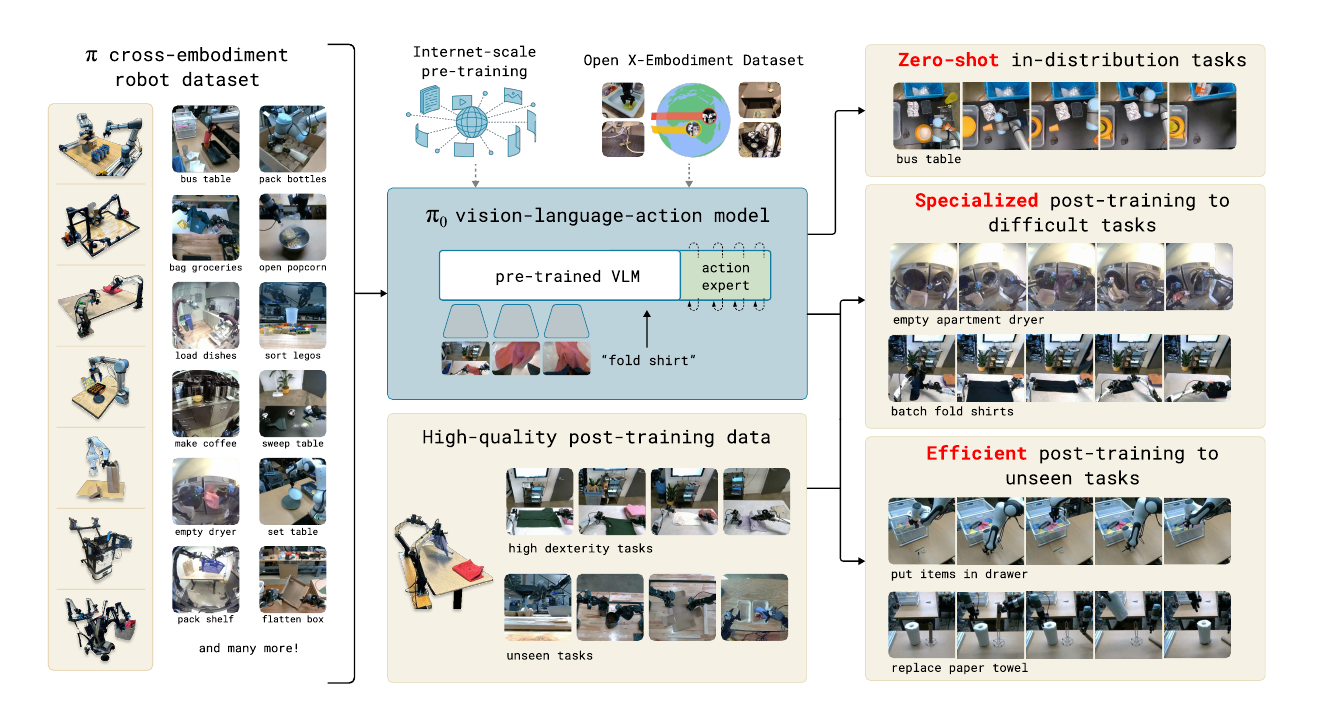
π0 以预训练视觉语言模型 PaliGemma 为语义骨干,增加一个约 3 亿参数的动作专家,用条件流匹配一次生成连续动作块,再通过大规模跨机器人预训练和高质量任务后训练,让同一个模型适配多种单臂、双臂及移动机器人。
先验知识
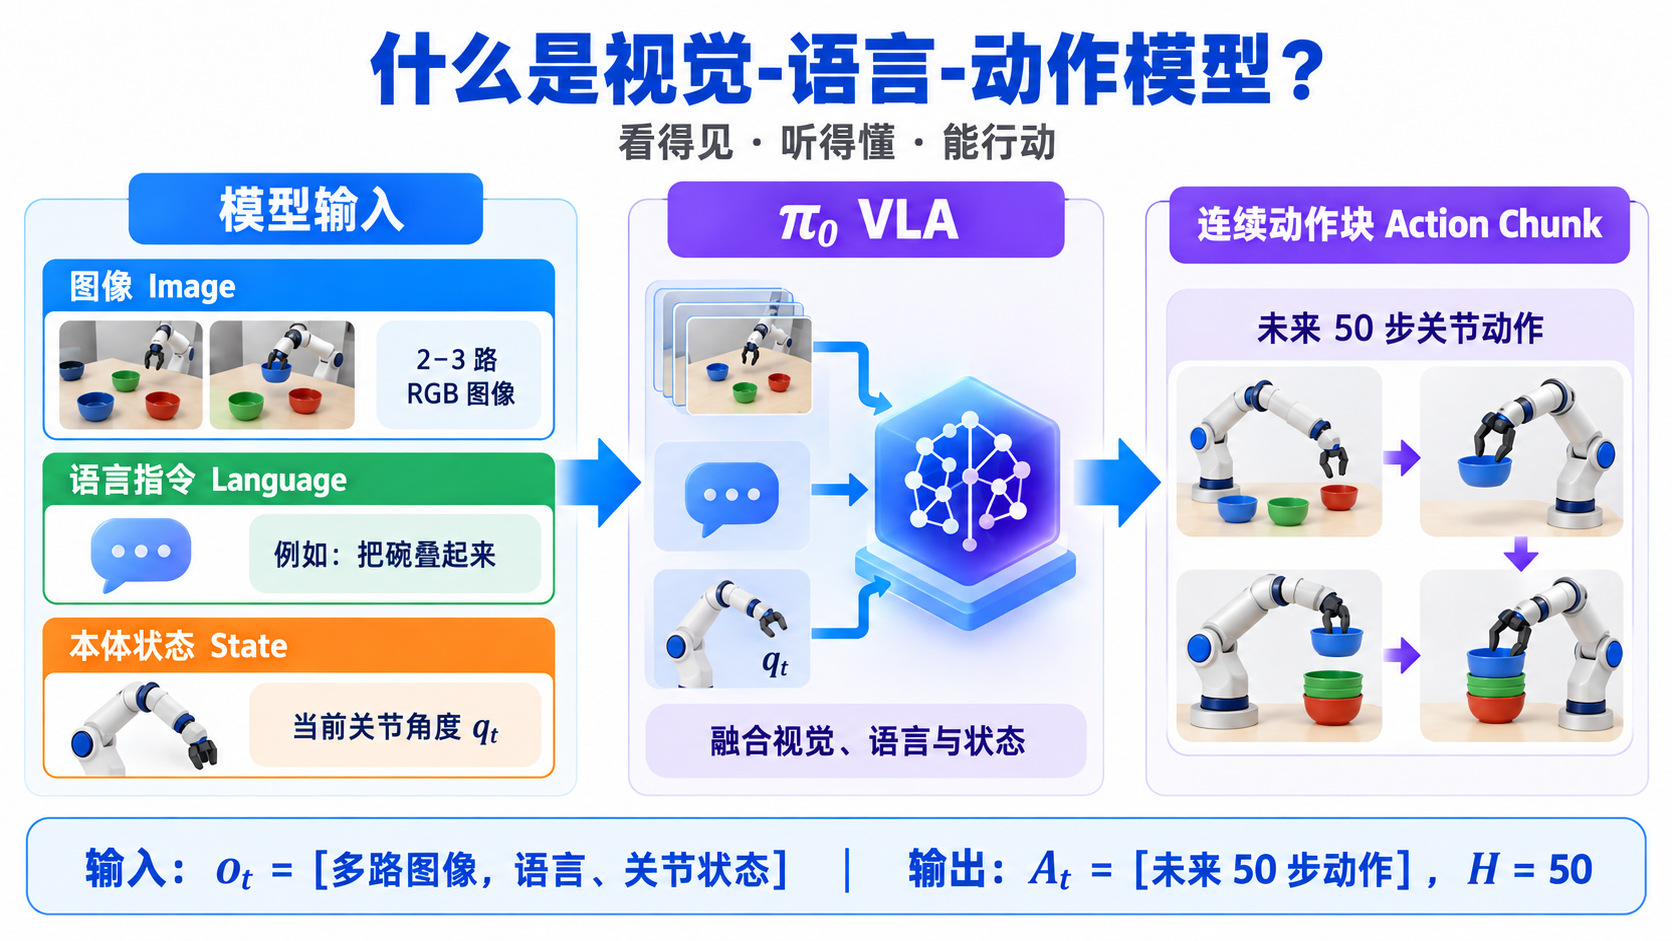
什么是视觉-语言-动作模型
自回归离散动作与连续动作块
训练、推理和评估
摘要
翻译
机器人学习有望释放灵活、通用且灵巧的机器人系统的全部潜力,也有望帮助回答人工智能领域的一些根本问题。然而,要让机器人学习达到真实系统所需的通用程度,仍面临数据、泛化能力和鲁棒性方面的重大障碍。
本文讨论通用机器人策略,也就是机器人基础模型,如何应对这些挑战,以及如何为复杂、高灵巧度任务设计有效的通用机器人策略。作者提出一种新的流匹配架构,它建立在预训练视觉语言模型之上,从而继承互联网规模数据中的语义知识。随后,模型在来自多种灵巧机器人平台的大规模、多样化数据上训练,这些平台包括单臂机器人、双臂机器人和移动操作机器人。
论文从三方面评估模型:根据提示直接执行任务;遵循人类或高层 VLM 策略给出的语言指令;通过微调学习新技能。评估任务覆盖叠衣服、清理桌面和组装纸箱等多种场景。
批注
-
问题不只是模型结构。 论文把通用机器人控制拆成三个瓶颈:规模足够大的数据、能处理连续高频动作的架构,以及合适的预训练/后训练配方。
-
VLM 提供“理解”,动作专家提供“控制”。 PaliGemma 负责图像和语言语义,动作专家专门处理机器人状态、带噪动作和连续动作输出。
-
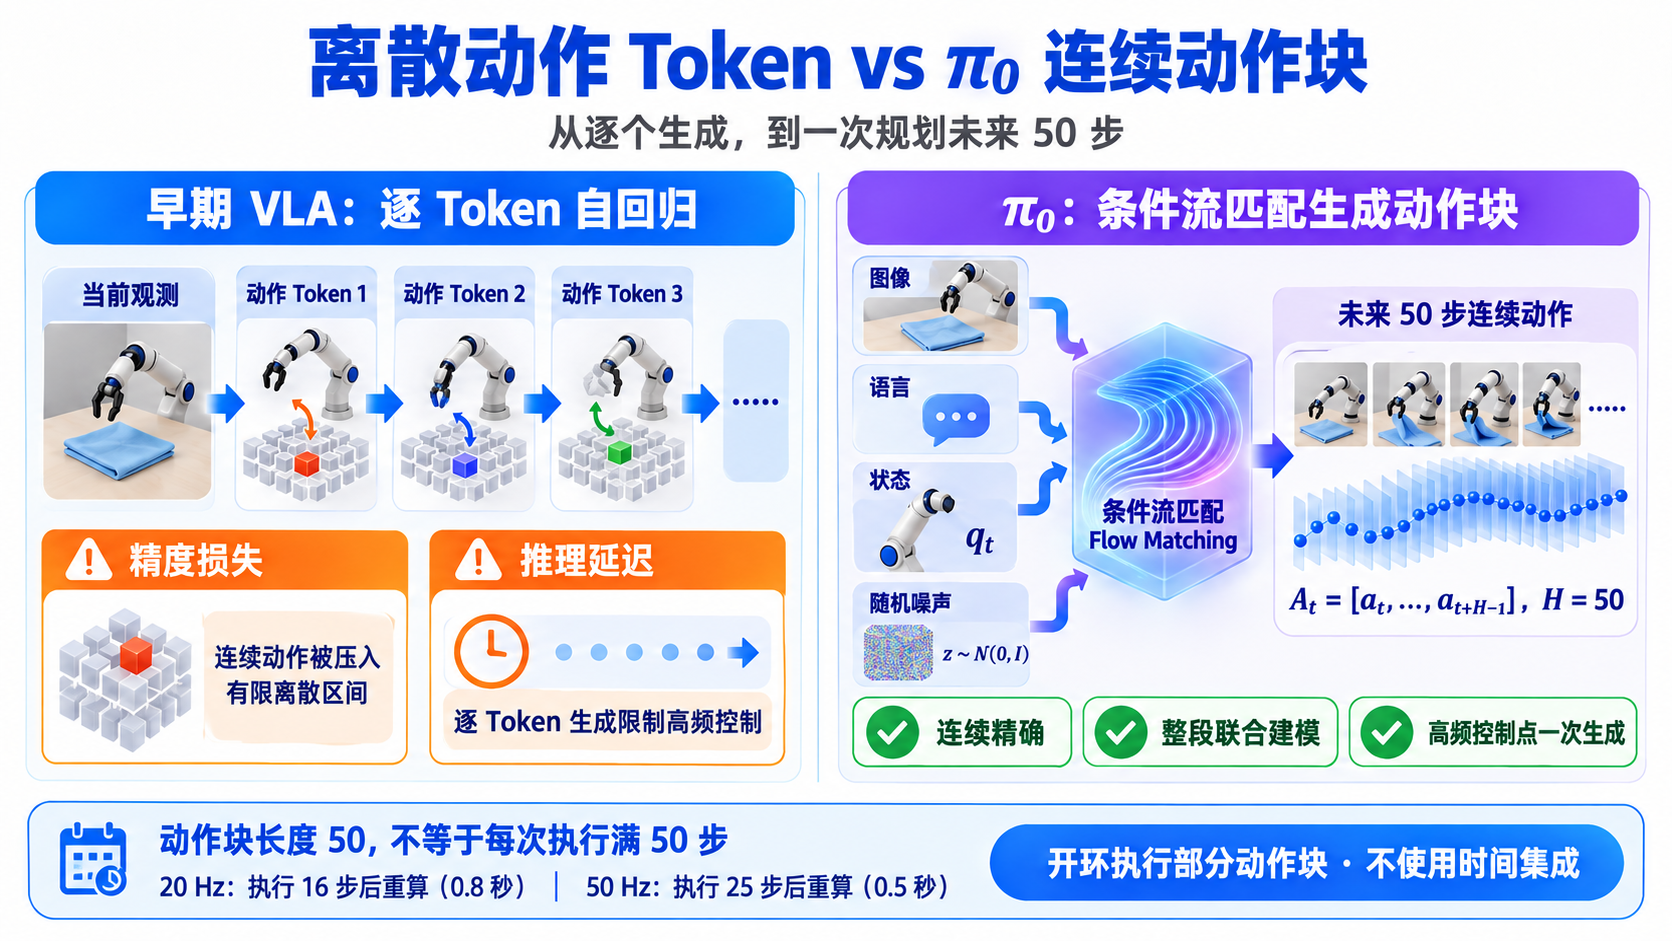
流匹配替代动作 token 自回归。 模型不是逐个预测离散动作 token,而是从噪声中并行生成整个连续动作块。
-
跨本体是核心前提。 数据来自多种机械臂与移动底盘,状态和动作空间不同;论文通过统一维度、补零和图像槽位掩码让同一模型联合训练。
-
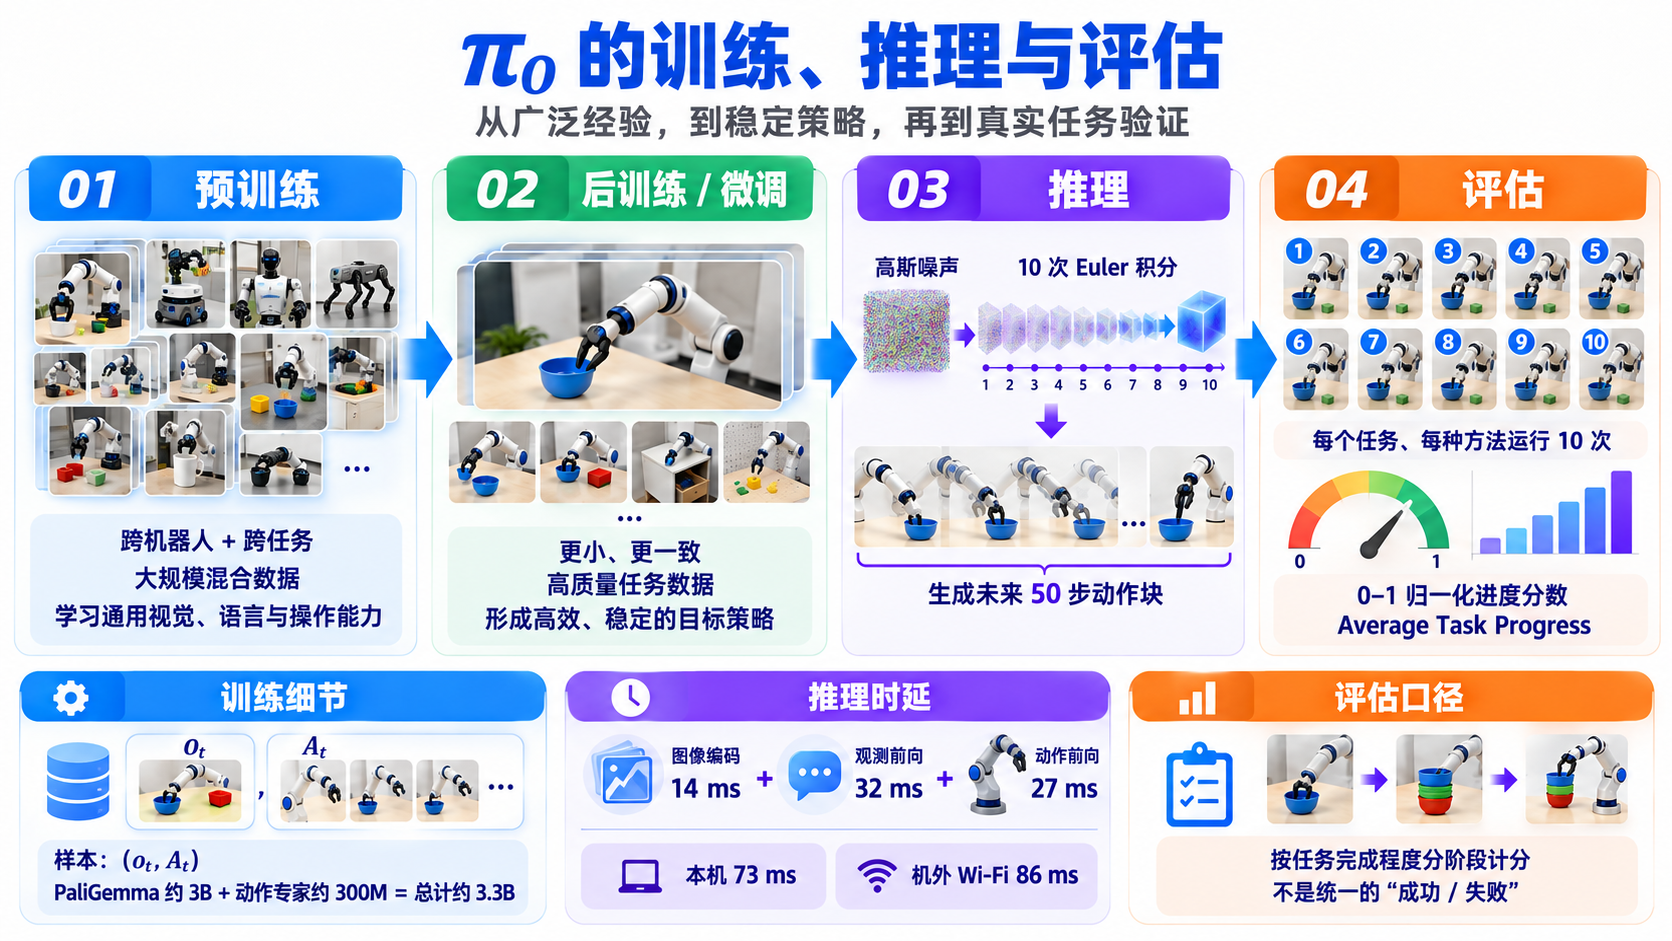
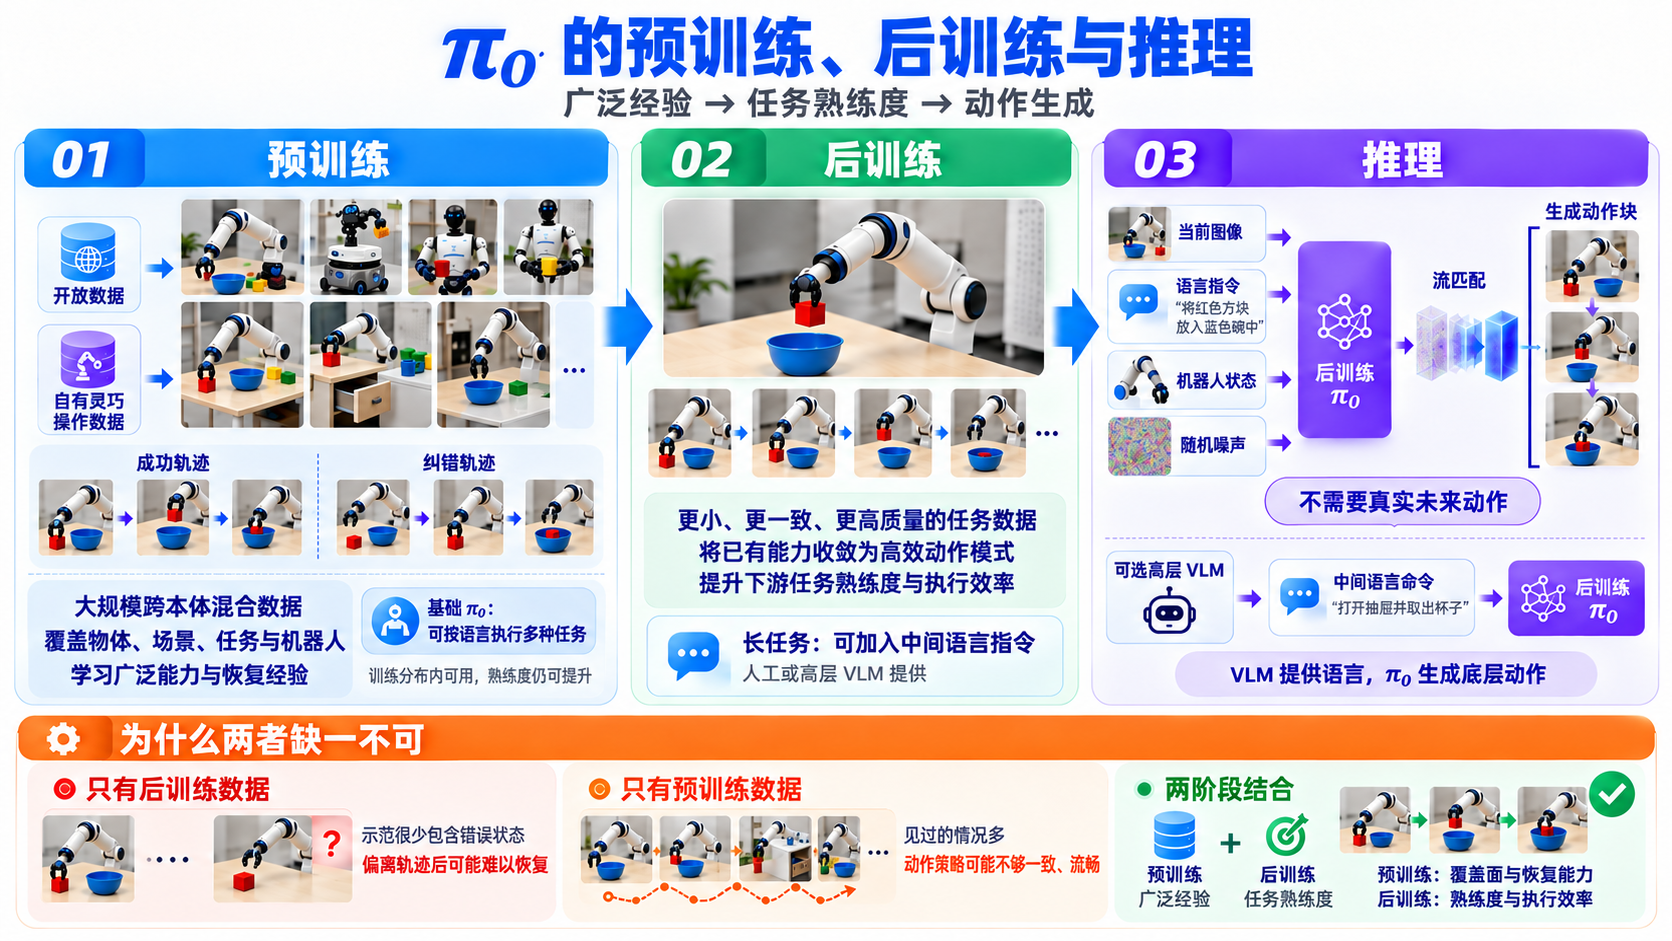
预训练与后训练分工不同。 预训练数据强调覆盖面、异常状态与恢复行为;后训练数据强调一致、流畅的成功策略。两者结合,才同时获得适应性和执行质量。
引言
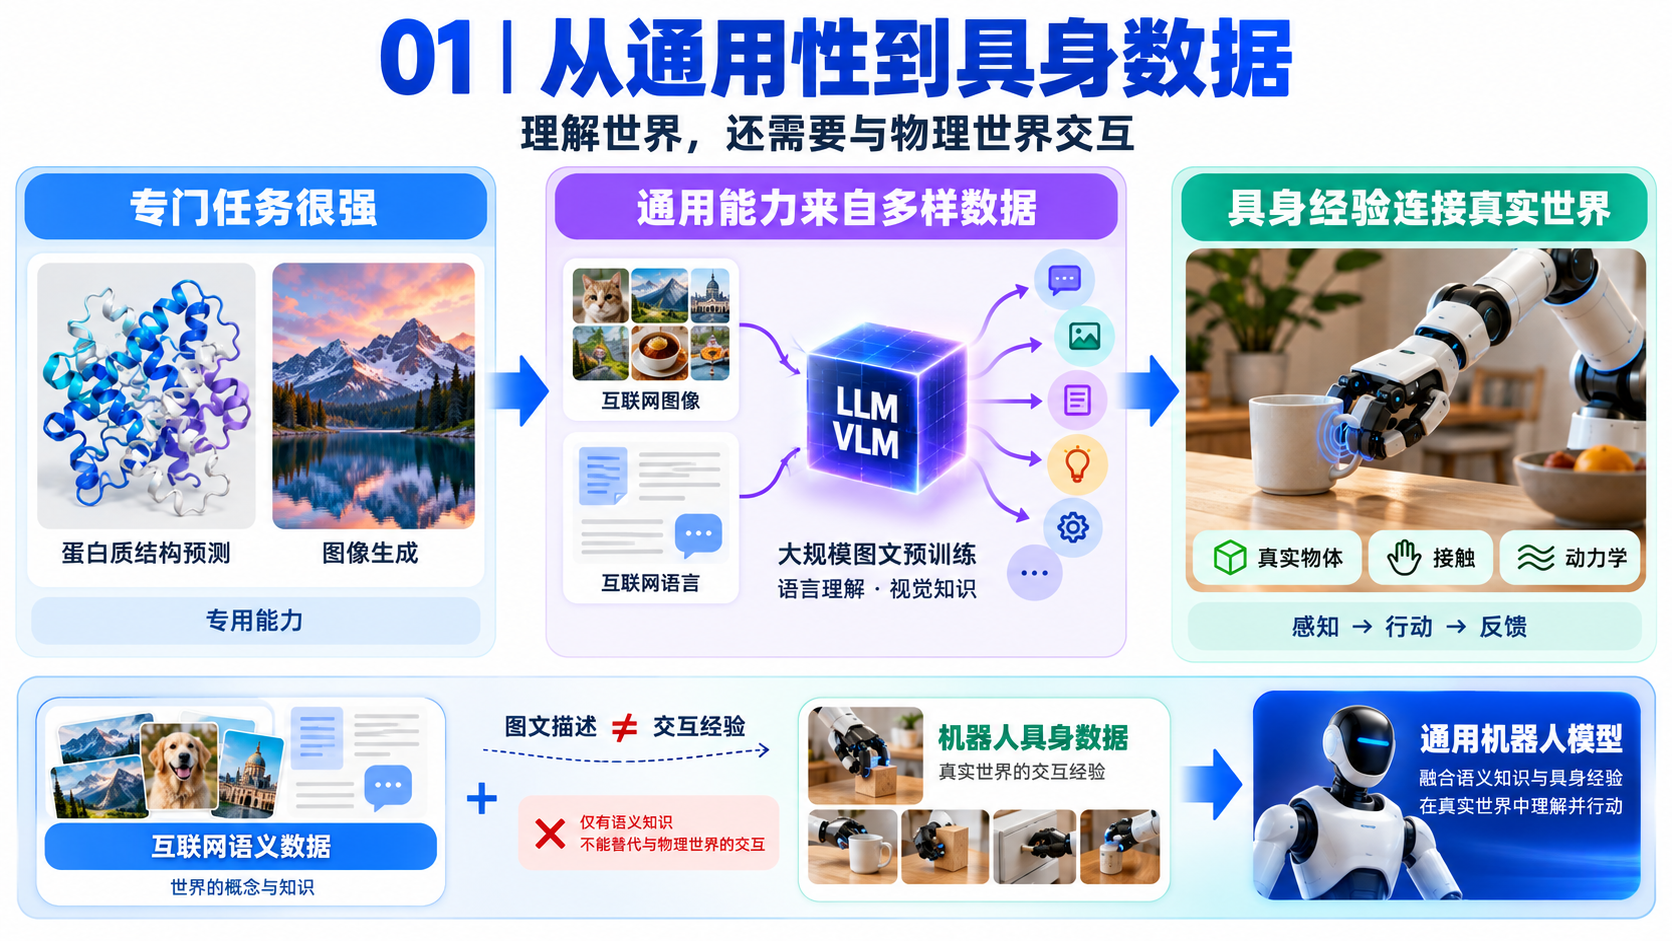
第一段:从“通用性”引出具身数据
-
原文在说什么: 现有 AI 可以在蛋白质结构预测、图像生成等专门任务上非常强,但人与机器最大的差距仍是通用性:人在不同环境中可以根据语言、约束和突发变化完成多种任务。LLM 和 VLM 展示了大规模多样数据预训练带来的通用能力,但它们并未真正处于物理世界中。
-
承接的问题: 只从图文描述学习,不能替代与真实物体、接触和动力学交互的经验。
-
为后文铺垫: 通用机器人模型必须同时吸收互联网语义数据和机器人具身数据。
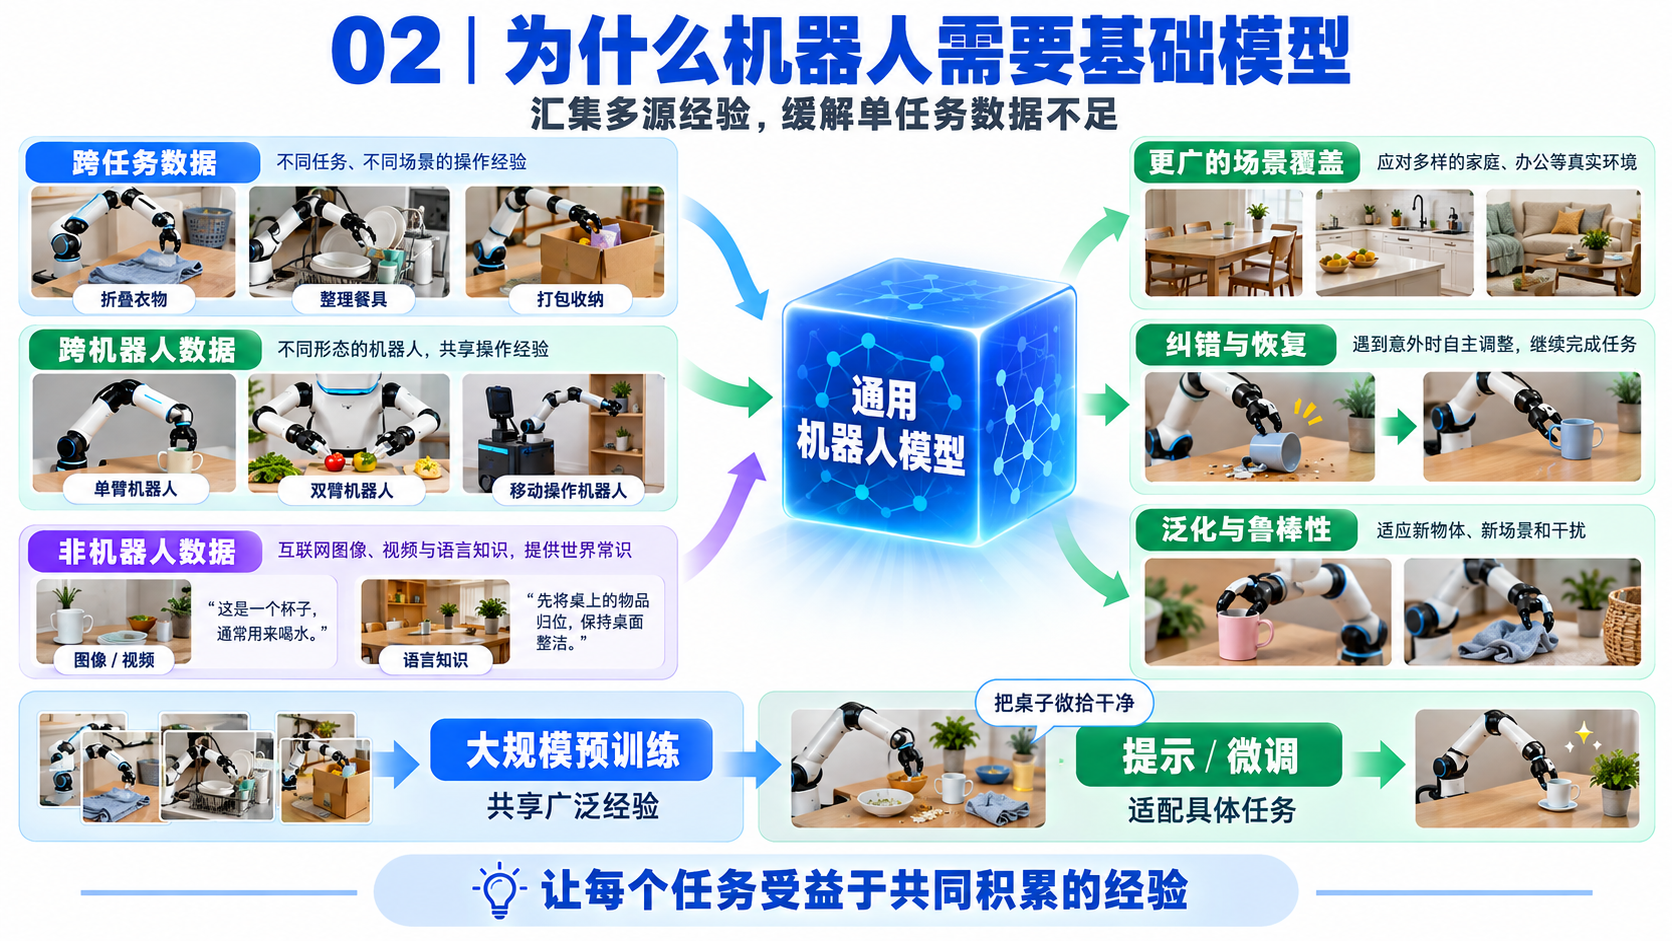
第二段:说明基础模型范式为何适合机器人
-
原文在说什么: 通用模型能够汇集其他任务、其他机器人甚至非机器人数据,从而缓解单任务数据不足。更多样的数据也覆盖更多场景、纠错和恢复行为,有望提高泛化和鲁棒性。
-
承接的问题: 单个机器人、单个任务的数据通常过少,专用策略难以覆盖失败状态。
-
为后文铺垫: 采用“大规模预训练,再提示或微调”的路线,而不是从零训练每一个任务。
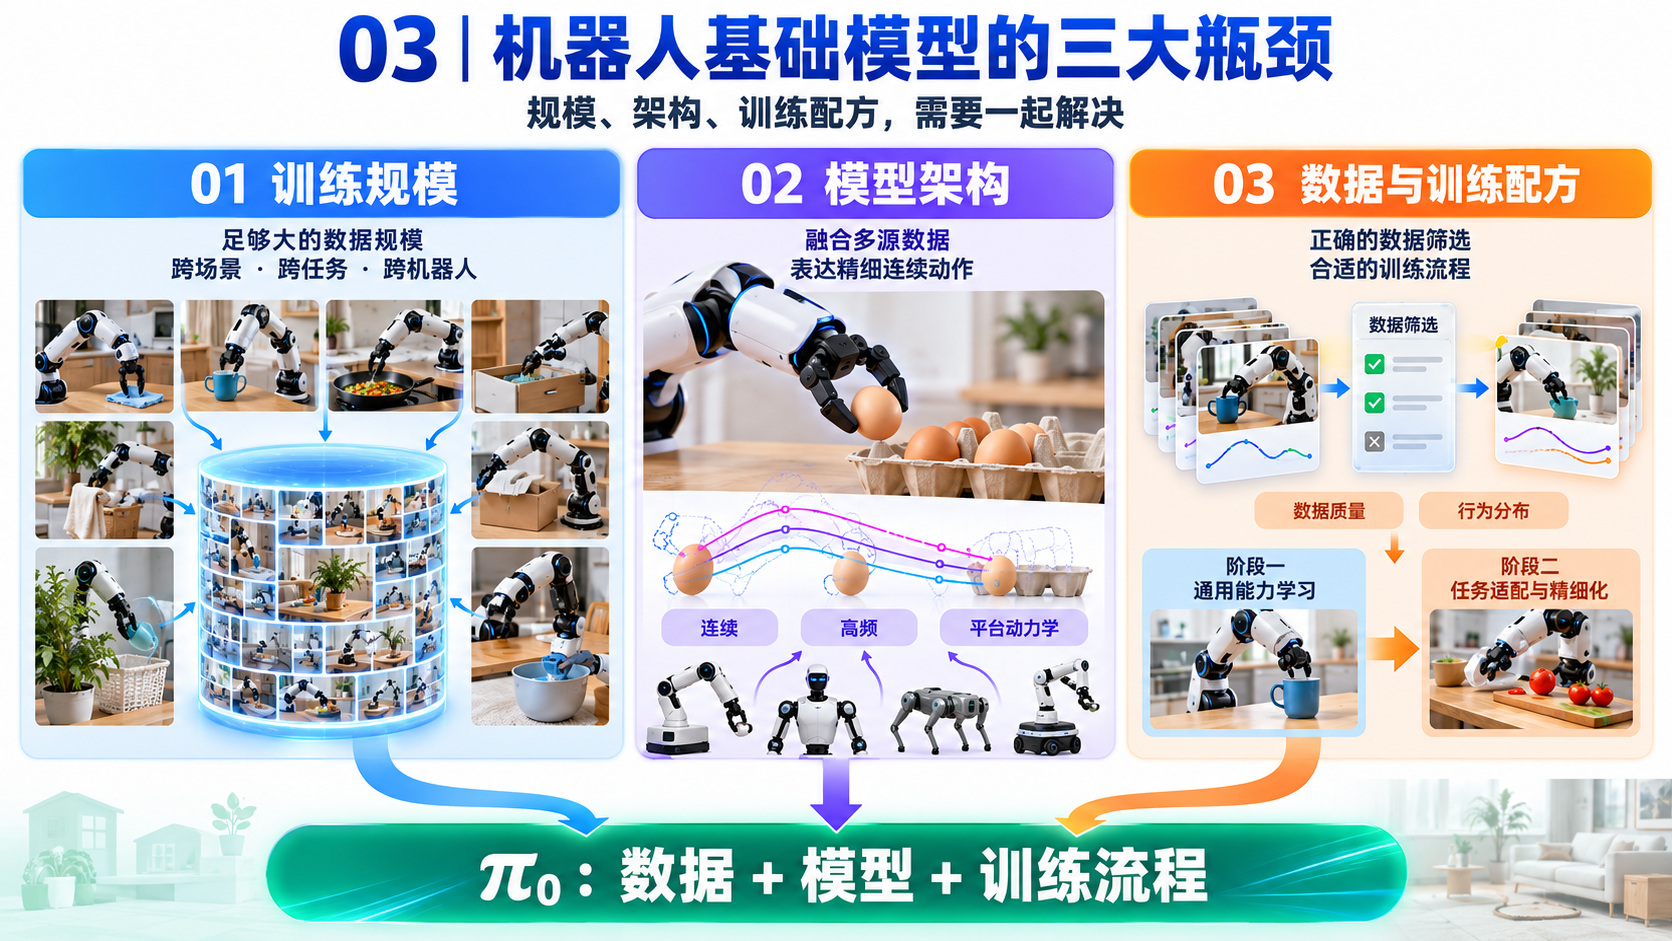
第三段:提出机器人基础模型的三个瓶颈
-
原文在说什么: 通用机器人策略需要足够大的训练规模、能融合多源数据并表达精细动作的模型架构,以及正确的数据筛选和训练配方。
-
承接的问题: 把语言模型的方法直接搬到机器人上并不够,因为机器人动作是连续、高频且与平台动力学相关的。
-
为后文铺垫: π0 将分别从数据、模型和训练流程处理这三个瓶颈。
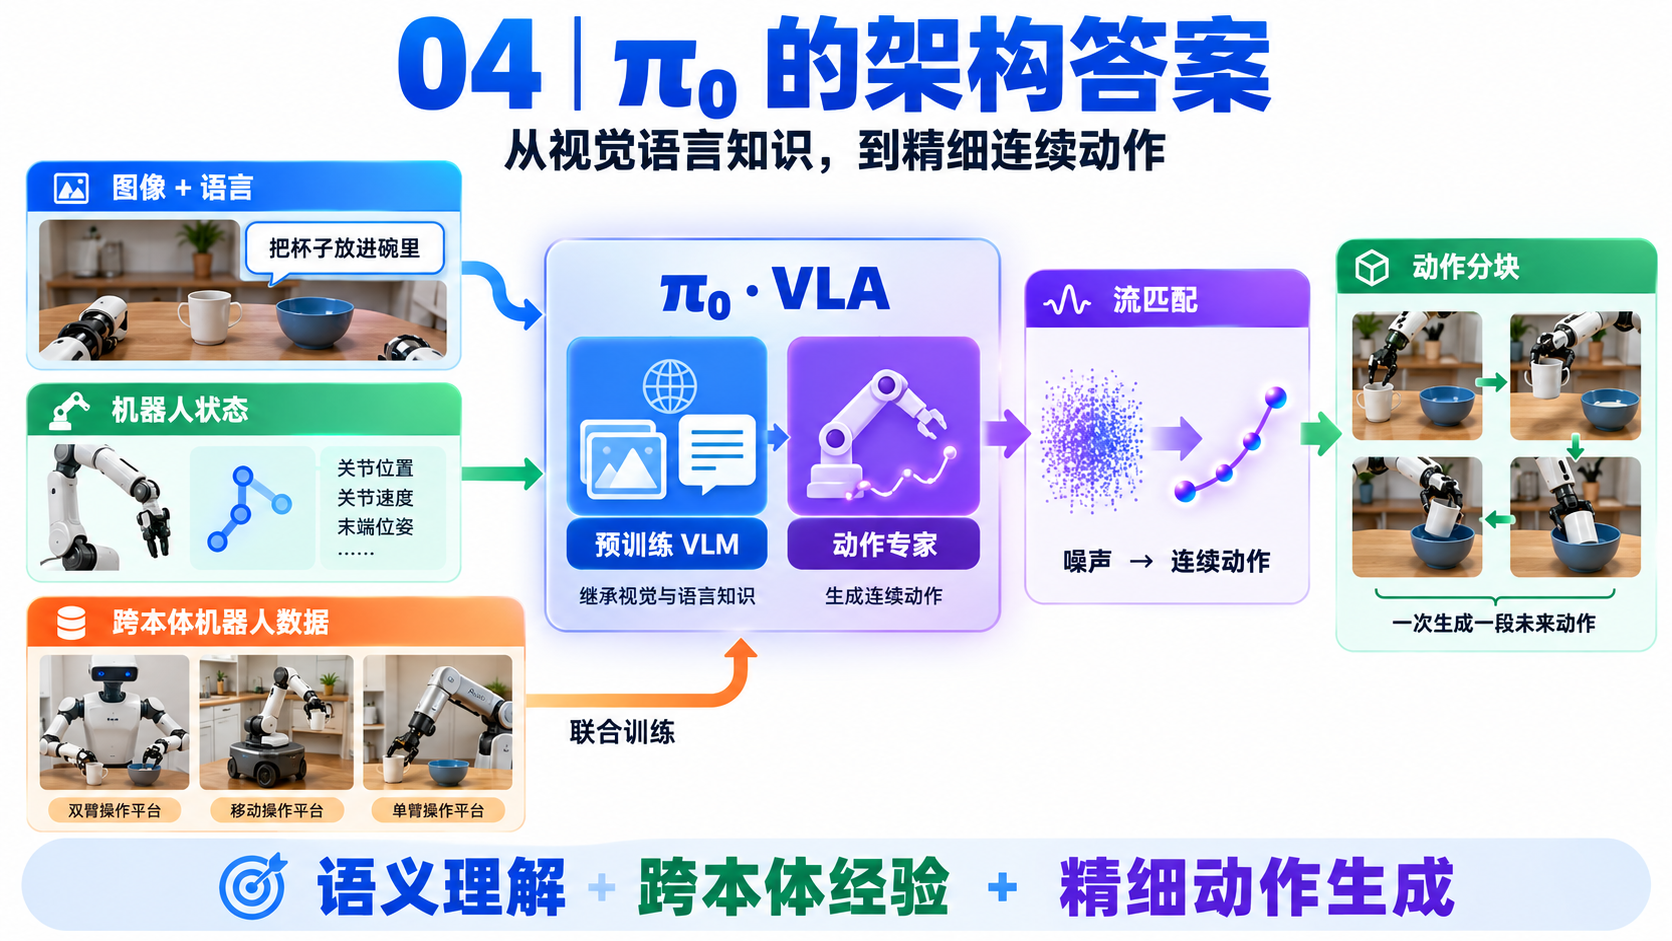
第四段:给出 π0 的架构答案
-
原文在说什么: π0 从预训练 VLM 继承通用知识,再加入机器人动作训练成为 VLA;使用跨本体数据联合训练;用动作分块和流匹配表示复杂连续动作;新增动作专家,把标准 VLM 扩展为流式动作生成模型。
-
承接的问题: 不同机器人动作空间不一样,离散自回归动作又难兼顾高频和精度。
-
为后文铺垫: 第 5、6 章将分别展开跨本体数据和动作专家架构。
第五段:给出 π0 的训练配方答案
-
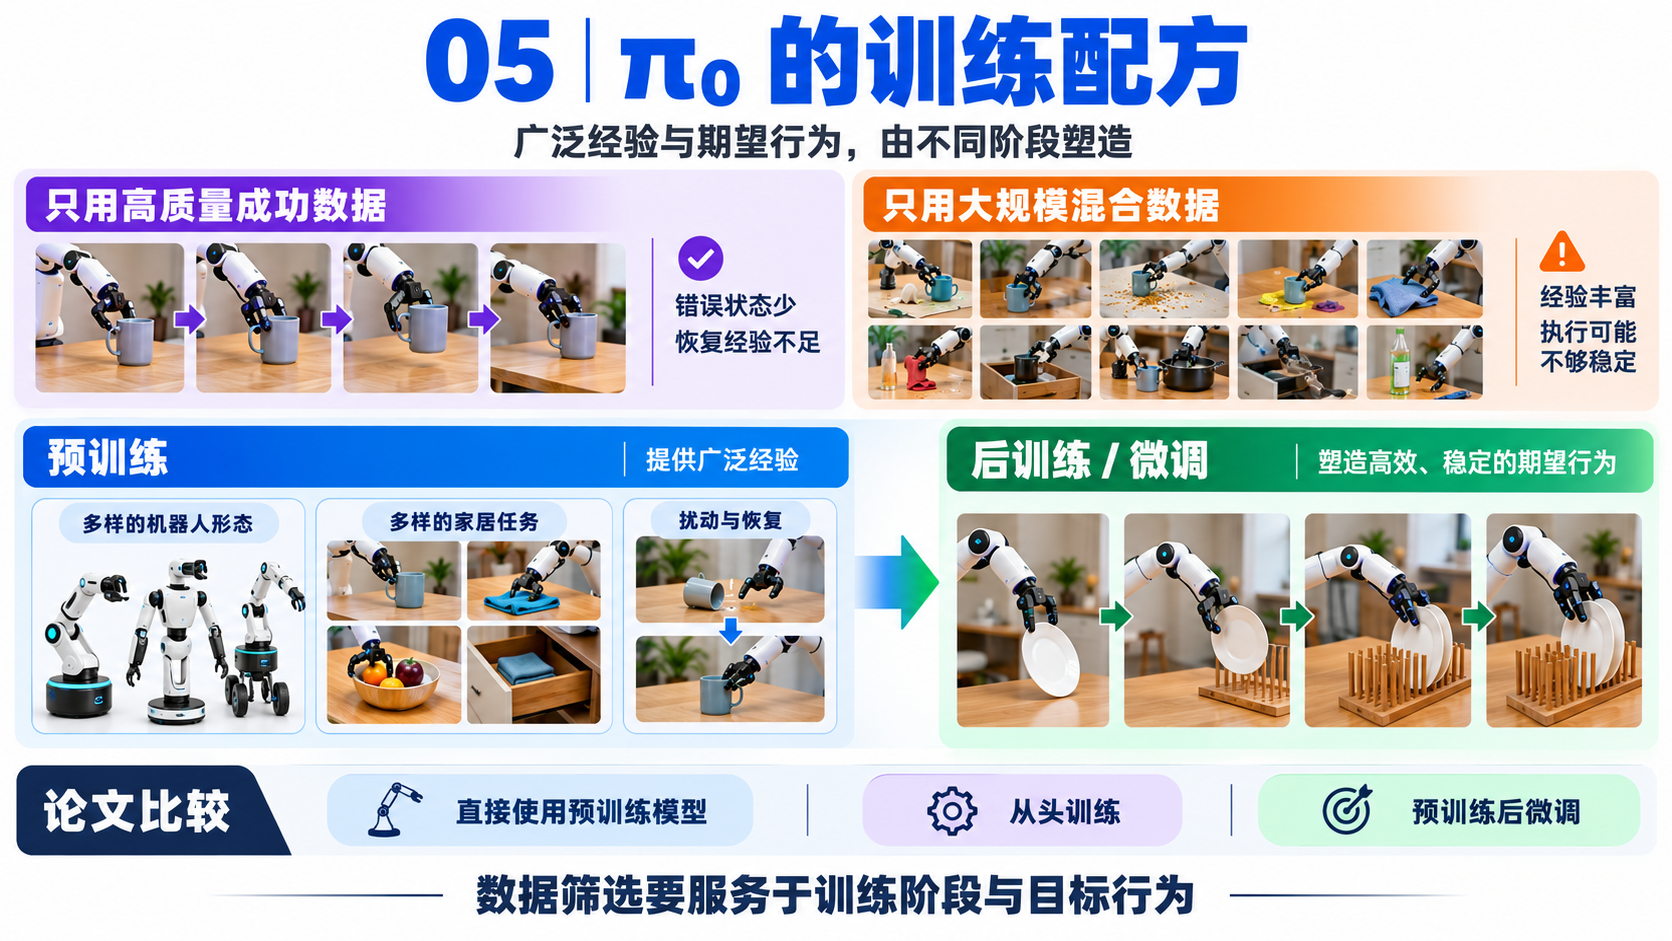
原文在说什么: 训练流程仿照大模型的预训练/后训练分工。只用高质量成功数据,模型很少看到错误,未必会恢复;只用较低质量的大规模数据,模型又可能缺少高效、稳定的执行策略。预训练提供广泛经验,后训练塑造期望行为。
-
承接的问题: “数据越干净越好”并不适合所有机器人学习阶段。
-
为后文铺垫: 论文随后比较直接使用预训练模型、从头训练以及预训练后微调。
第六段:总结贡献与评估范围
-
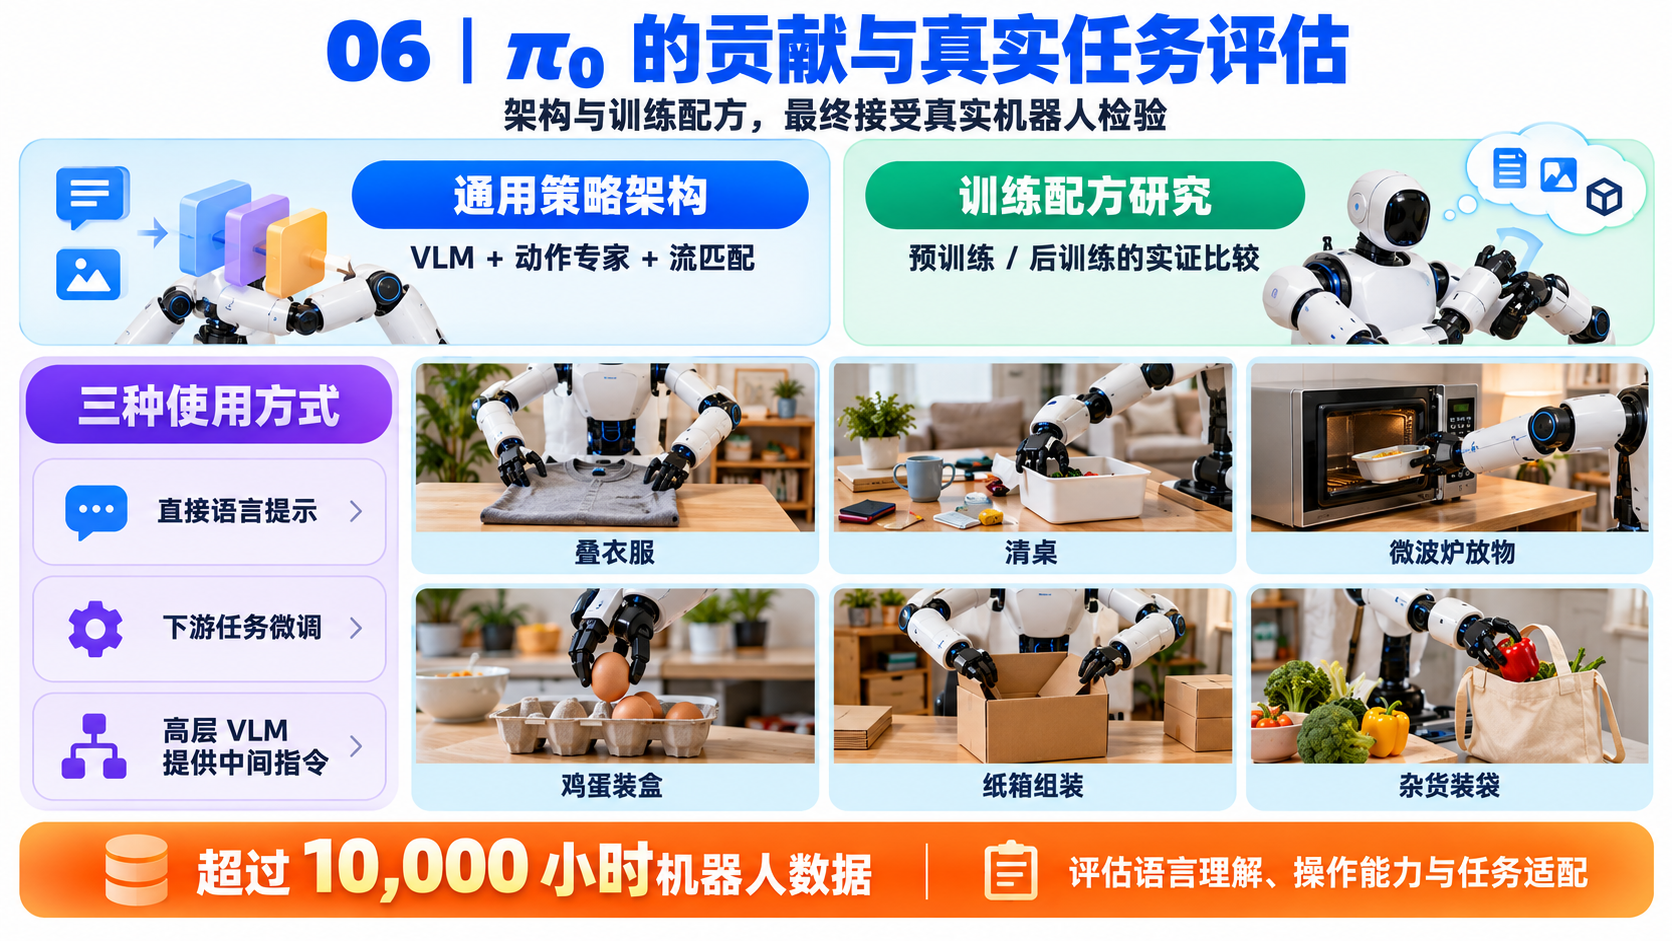
原文在说什么: 贡献包括基于 VLM 和流匹配的通用机器人策略架构,以及对机器人基础模型预训练/后训练配方的实证研究。模型接受直接语言提示、下游微调,也能与产生中间指令的高层 VLM 配合。
-
承接的问题: 架构与训练配方都需要在真实机器人上证明价值。
-
为后文铺垫: 论文使用超过 10,000 小时机器人数据,并在叠衣服、清桌、微波炉放物、鸡蛋装盒、纸箱组装和杂货装袋等任务上评估。
相关工作
-
视觉-语言-动作模型: RT-2、OpenVLA、Octo 等工作尝试把预训练视觉语言表示迁移到机器人控制。许多 VLA 把动作离散成 token 并自回归生成;π0 的区别是保留预训练 VLM 骨干,同时使用条件流匹配生成连续、高频动作块。
-
扩散/流模型与多模态 Transformer: Diffusion Policy 等方法证明扩散式生成适合多峰连续动作;Transfusion 等工作探索在同一 Transformer 中结合离散 token 与连续扩散目标。π0 借鉴这类设计,但把它落到 VLA:图像和语言走较大的 VLM 权重,机器人状态和动作走独立的动作专家权重,两者在自注意力中交互。
-
大规模机器人学习: 早期大规模采集常聚焦抓取、推动等较简单行为;OXE、Bridge、DROID 等提高了跨任务、跨机器人的数据覆盖。π0 进一步加入超过 10,000 小时、以灵巧双臂任务为主的内部数据,并采用预训练/后训练两阶段配方。
-
灵巧操作: ACT、Diffusion Policy 等能从较小的任务数据学习精细操作,但通常针对特定机器人和任务训练。π0 的目标不是替代所有专用策略,而是先训练一个跨本体基础模型,再直接提示或用少量到大量高质量数据进行后训练。
π0 跨本体机器人系统与数据平台
设计目标和组成
π0 不是绑定某一台机械臂的控制器,而是一套跨机器人本体(Cross-Embodiment)的模型与数据体系。设计目标包括:
-
在同一个模型中利用单臂、双臂和移动操作机器人数据;
-
同时处理语言语义、视觉观测、机器人状态和连续动作;
-
让预训练模型既能直接执行已覆盖任务,也能通过后训练学习困难或新任务;
-
支持最高 50 Hz 的高频灵巧控制。
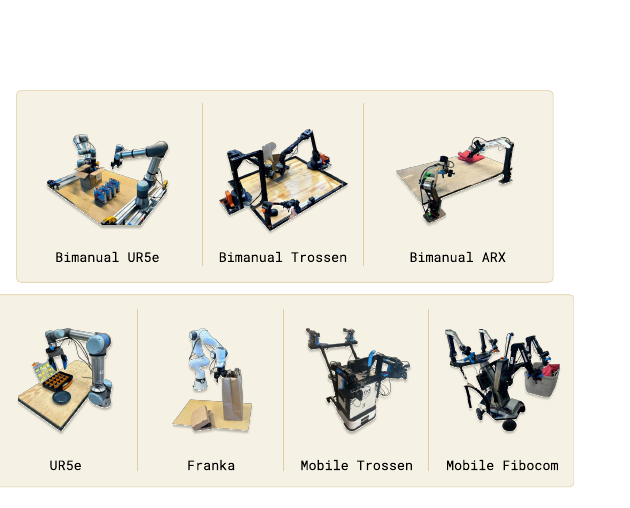
| 平台类别 | 图像输入 | 状态/动作空间 |
|---|---|---|
| UR5e 单臂 | 腕部 + 肩上,共 2 路 | 7 维状态,7 维动作 |
| 双臂 UR5e | 共 3 路 | 14 维状态,14 维动作 |
| Franka 单臂 | 2 路 | 8 维状态,8 维动作 |
| 双臂 Trossen | 双腕 + 基座,共 3 路 | 14 维状态,14 维动作 |
| 双臂 ARX / AgileX | 双腕 + 基座,共 3 路 | 14 维状态,14 维动作 |
| 移动 Trossen / 移动 ARX | 双腕 + 基座,共 3 路 | 14 维状态,16 维动作;非完整移动底盘增加 2 维动作 |
| Mobile Fibocom | 双臂 + 全向底盘 | 14 维状态,17 维动作;底盘增加平移 2 维和旋转 1 维 |
注意: 原文把运动学相近的平台合并成配置类别,因此“7 种机器人配置”不等于只有 7 台实体机器人,也不等于 OXE 中只含 7 种机器人。论文自己的灵巧数据覆盖 7 种配置;加入的 OXE 数据还来自 22 种机器人。
跨本体训练与控制流程
整体流程可以概括为:
多平台遥操作示范 + 开源机器人数据 + 互联网图文预训练
                         ↓
          加权构造跨本体预训练混合数据
                         ↓
      PaliGemma VLM 骨干 + π0 动作专家联合训练
                         ↓
             得到通用 π0 基础策略
                  ↙                 ↘
        语言直接提示            高质量任务后训练
                  ↘                 ↙
           多平台连续动作块控制
为了把不同平台装入同一模型,作者做了两项对齐:
-
状态和动作对齐: 统一扩展到数据集中最大的 18 维。维度较小的机器人在末尾补零;18 维可容纳两条 6-DoF 手臂、两个夹爪、移动底盘和可升降躯干。
-
图像对齐: 模型预留 3 个图像槽位。只有 1 或 2 路图像的平台,对缺失槽位做掩码。
数据标签既包括整段任务名,也包括通常约 2 秒的分段标注。分段语言使模型能够接受“拿起餐巾”“把餐巾扔进垃圾桶”等中间指令。对于需要语义规划的长任务,高层 VLM 可以把“清理桌面”分解成这类短指令,π0 再负责每一步的物理执行。
原文: 模型按任务-机器人组合的样本量 赋予 的权重。指数小于 1 会压低超大数据组的相对占比,避免洗衣折叠等过度采样任务完全主导训练。
传感器、数据采集和能力
数据构成
-
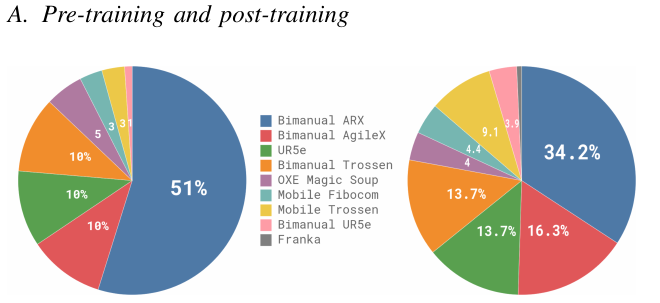
论文自有数据共 903M 个 timestep,其中 106M 来自单臂机器人,797M 来自双臂机器人;
-
自有数据覆盖 68 个宽口径任务和 7 种机器人配置;
-
开源数据占训练混合数据的 9.1%,包括 OXE、Bridge v2 和 DROID;
-
开源数据通常为 1-2 路相机、2-10 Hz 控制,但对象和环境覆盖广;
-
论文将总体机器人示范规模概括为超过 10,000 小时;
-
任务后训练数据量差异很大:简单任务约 5 小时,最复杂任务使用 100 小时或更多。
直接提示能力
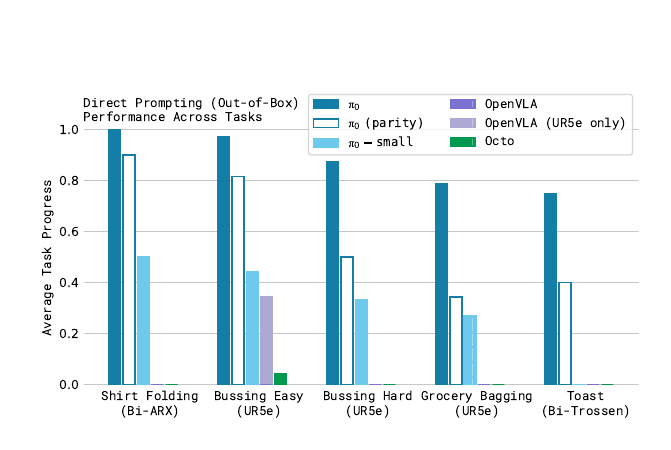
论文在衬衫折叠、简单桌面整理、困难桌面整理、杂货装袋和从烤面包机取吐司五项任务上比较 π0、OpenVLA、Octo 和无 VLM 初始化的 π0-small:
-
训练 700k 步的完整 π0 在五项任务上均取得最高平均进度;
-
只训练 160k 步、与基线更新量相当的 π0 parity 版本仍优于所有基线;
-
π0-small 通常也优于 OpenVLA 和 Octo,说明连续动作块架构本身有价值;
-
完整 π0 又明显优于 π0-small,支持 VLM 预训练有助于语义理解和跨任务控制的判断。
注意: OpenVLA 和 Octo 未训练到与完整 π0 相同的 epoch 数。论文为缓解计算量不公平增加了 π0 parity 对照,但完整 π0 与全部基线的对比仍不能被理解为严格同算力对比。
新任务后训练能力
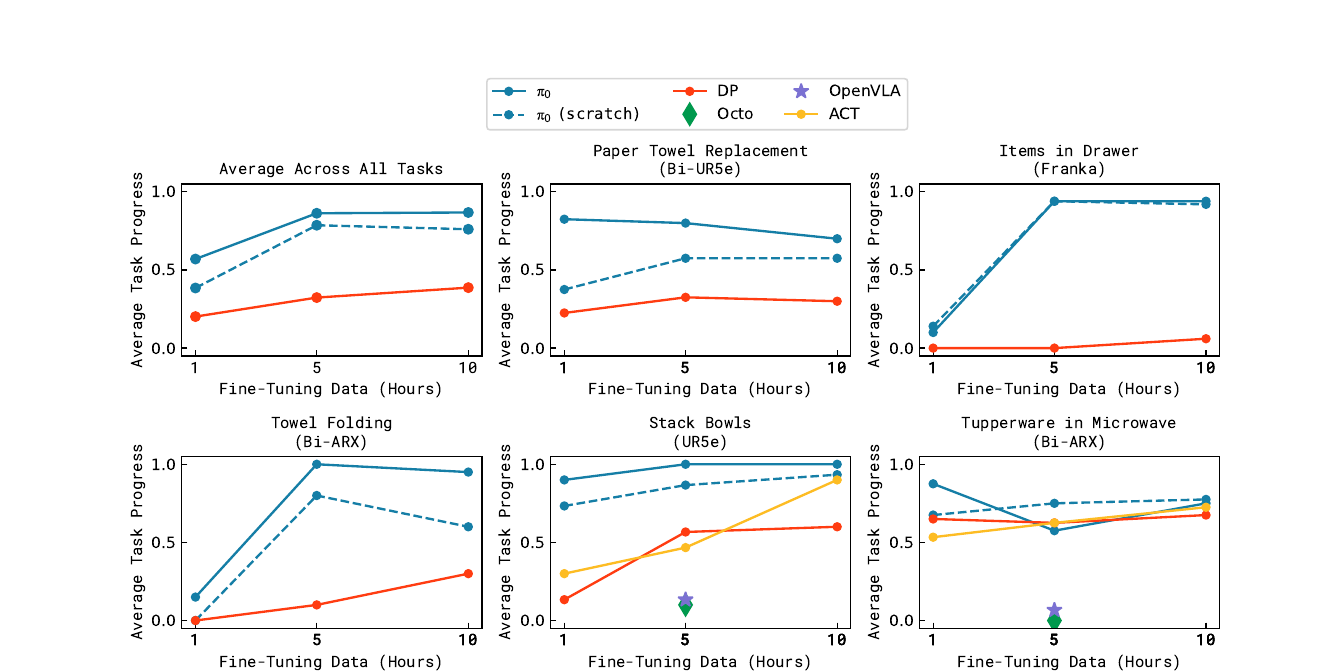
新任务包括叠碗、折毛巾、把保鲜盒放进微波炉、更换厨房纸卷,以及用 Franka 将物品放入抽屉。每个任务、每个方法同样平均 10 次:
-
π0 在总体平均和多数单项上优于从头训练及其他方法;
-
与预训练任务较相似的折毛巾、叠碗,在较少数据下已能获得较高进度;
-
对某些任务,预训练相对从头训练的提升可接近 2 倍;
-
优势并非对所有数据量单调增加。例如保鲜盒进微波炉在 5 小时数据下与基线接近,1 小时数据下预训练优势反而更明显。
长时程复杂任务能力
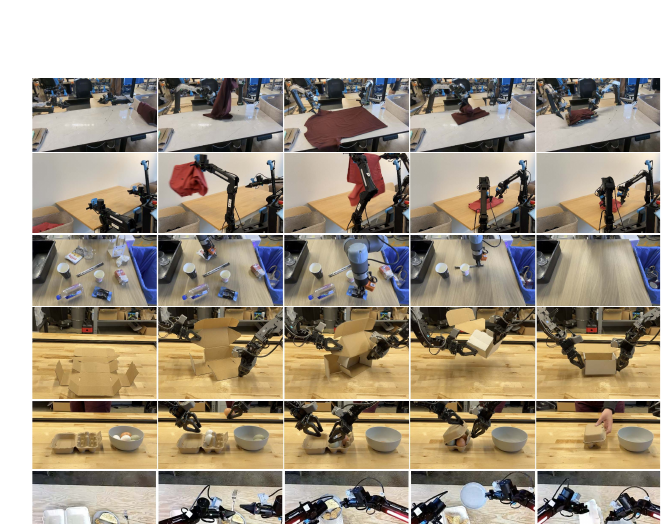
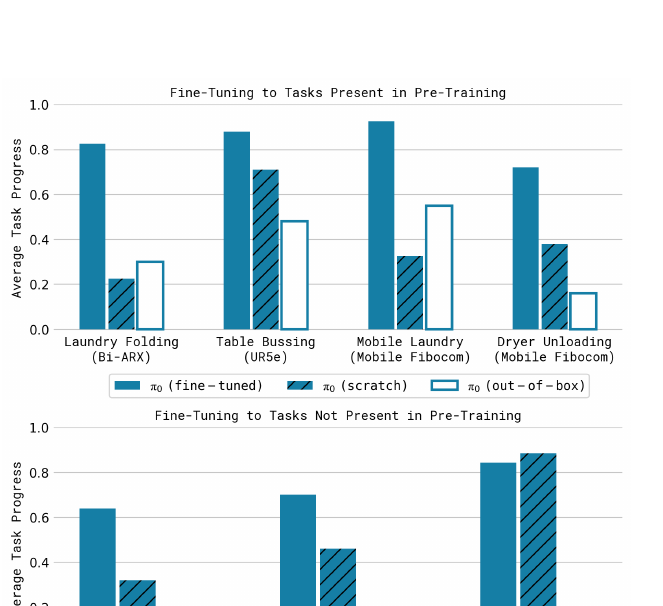
这些任务通常持续 5-20 分钟,需要组合几十种抓取、堆叠、展平和折叠行为。完整的“预训练 + 后训练”π0 在所有图示任务上都达到最高分值的 50% 以上,并且通常优于从头训练或直接使用预训练模型。最困难任务上的预训练收益更明显。
证据边界: 原文也明确指出,模型并非稳定解决所有任务。作者尚不清楚预训练数据应如何构成和加权,也不能可靠预测一个新任务需要多少、哪种数据;跨差异更大的领域(如自动驾驶、导航、腿式运动)是否仍能正迁移,尚未验证。因此这里的“通用”指论文覆盖范围内的跨任务、跨机械臂通用性,不等于任意机器人和任意环境的通用控制。
π0:基于动作专家与条件流匹配的 VLA
动作分块:一次生成未来 50 步连续动作
π0 建模的目标不是单步动作 ,而是动作块:
动作分块解决两类问题:
-
高频输出效率: 一次模型推理生成 50 个控制点,不必为每个动作维度逐 token 自回归解码;
-
动作连贯性: 整个动作块联合建模,能够表示相互依赖的连续轨迹。
极端情况下, 会退化为单步策略; 很大且全部开环执行,则会降低对新观测的反应速度。π0 取 ,但只执行其中 16 或 25 步后重新观测和推理,在推理开销与闭环更新频率之间折中。
动作向量统一补到 18 维只是训练接口;对某个具体平台执行时,只有该机器人对应的有效维度会发送给控制器。
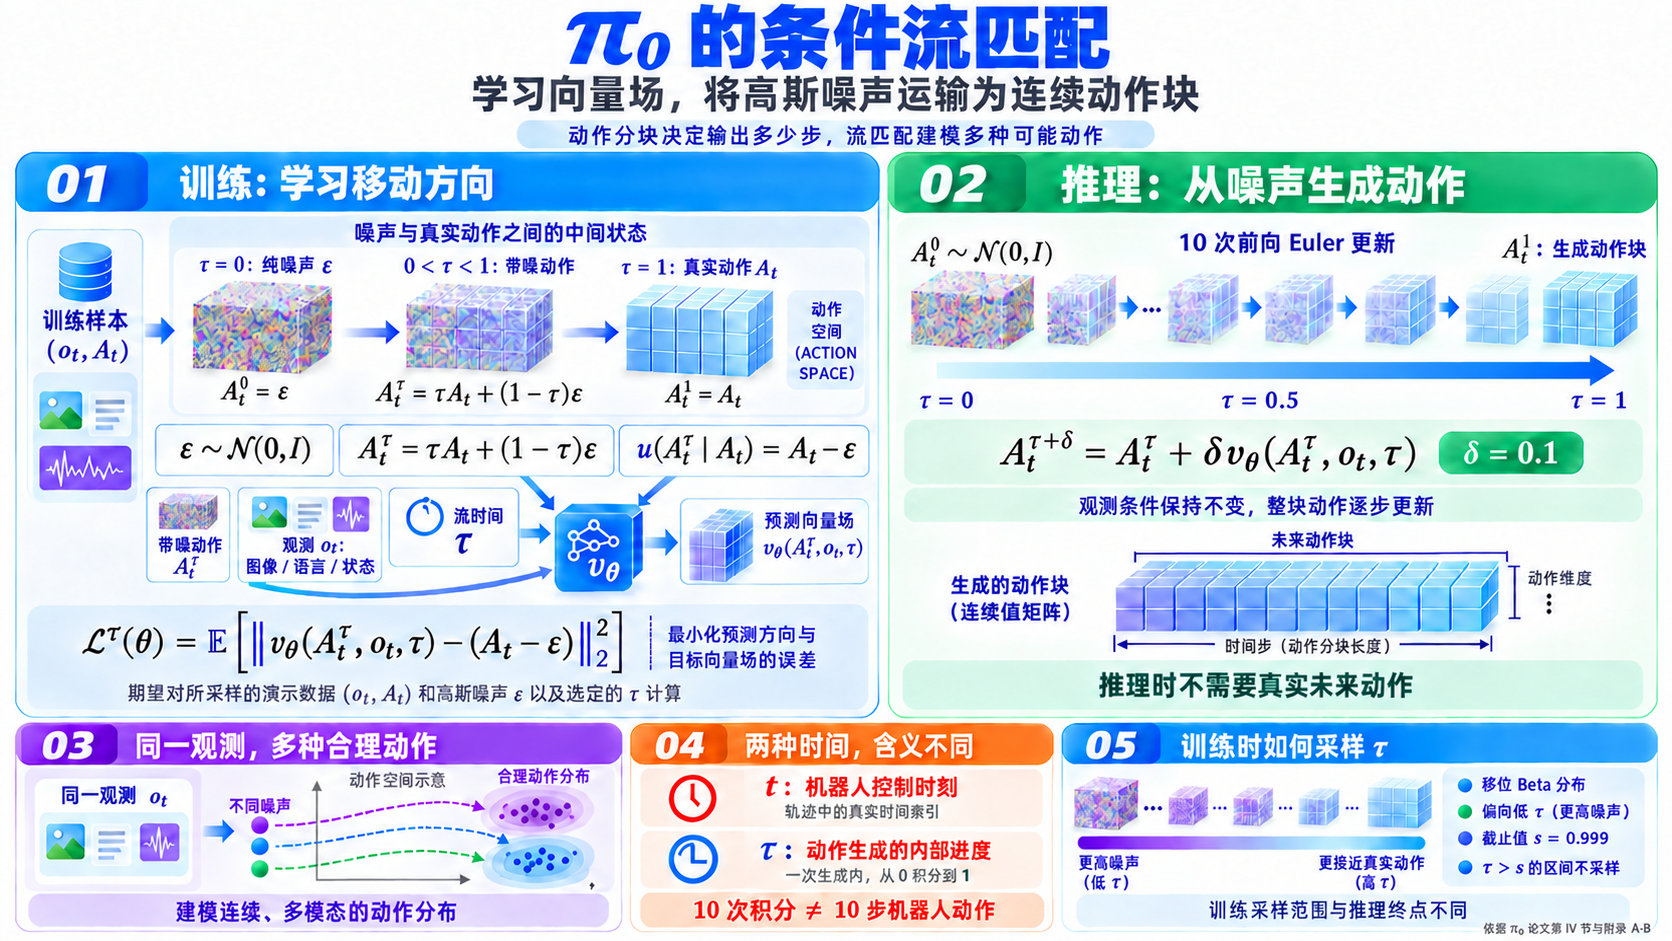
条件流匹配:从噪声生成连续动作块
跨本体数据建模:统一接口而不抹平平台差异
多种机器人带来三种不一致:相机数量不同、状态维度不同、动作维度和物理意义不同。π0 采用统一槽位表示:
-
最多 3 路图像,缺失视角通过掩码处理;
-
状态和动作补零到 18 维;
-
同一 Transformer 同时看到图像、语言、平台状态和动作示范,通过数据中的机器人-任务组合学习对应关系。
这种做法并不是把不同机器人的第 维动作强行解释成完全相同的物理量,而是提供固定大小的模型接口。模型仍需从机器人观测、状态分布和训练数据中学会各平台的动作规律。
π0 还通过两个专家分开处理不同模态:
-
VLM 骨干: 处理图像和语言 token,继承 PaliGemma 的互联网视觉语言预训练;
-
动作专家: 处理机器人状态 和带噪动作块 ,专门学习连续控制。
两套权重不是彼此隔离:它们在 Transformer 的自注意力层中交换信息,因此动作专家可以根据图像与语言产生动作,VLM 侧又不必完全改造成一个动作网络。
预训练与后训练如何配合
完整的 π0 网络
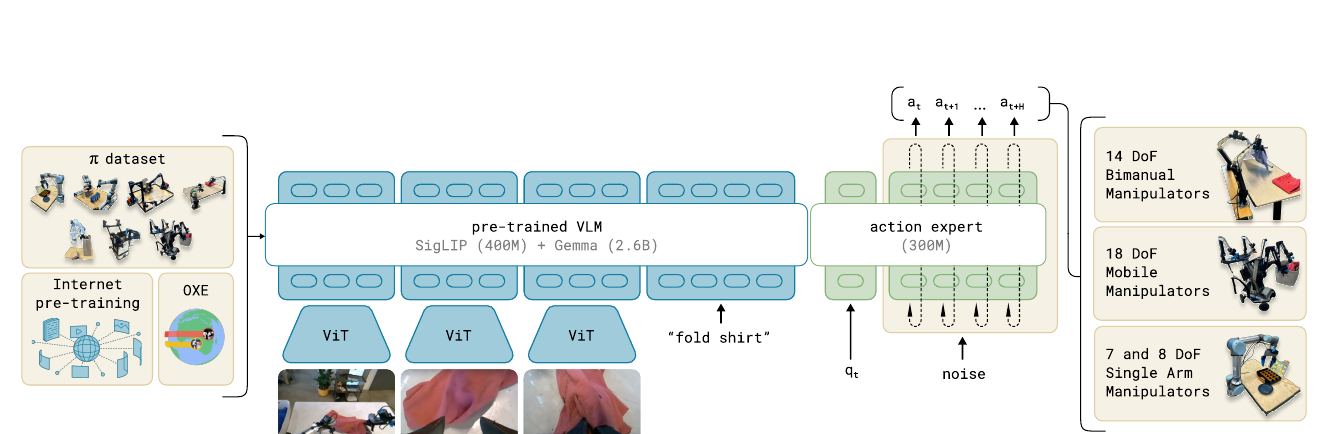
图像与语言输入
每路 RGB 图像由 PaliGemma 的 SigLIP 视觉编码器转换为视觉 token,语言指令被分词成语言 token。二者进入较大的 VLM 专家。论文图中将基础模型概括为约 400M 的 SigLIP 与约 2.6B 的 Gemma 权重。
注意: 论文 PDF 没有给出送入 SigLIP 前统一采用的图像分辨率,也没有在正文中列出每路图像最终产生的视觉 token 数量,因此这里不根据常见 PaliGemma 配置反推维度。
机器人状态输入
本体状态 先经线性投影映射到 Transformer embedding 维度,再作为单独的状态 block 送入动作专家。
带噪动作与流时间
动作块含 个动作 token。每个带噪动作 与流时间的正弦编码 一起经过 MLP:
该 embedding 进入动作专家。网络最终只读取这 50 个动作位置的输出,并线性投影为向量场 。
在统一训练接口中,动作块张量的最大形状为 ;具体机器人只使用自己的有效动作维度,其余补零位置不发送给执行器。
双专家 Transformer
-
PaliGemma 骨干约 3B 参数;
-
新增动作专家约 300M 参数;
-
总参数量约 3.3B;
-
VLM 专家使用宽度 2048、18 层、MLP 维度 16,384;
-
为降低 10 次流匹配前向的开销,动作专家缩小为宽度 1024、MLP 维度 4096。
动作专家与 VLM 专家使用不同权重,但对应 token 在同一层的自注意力中交互。这种结构类似只有两个路由分支的 Mixture-of-Experts:图像/语言 token 路由到 VLM 权重,状态/动作 token 路由到动作专家权重。
分块注意力掩码
输入序列划分为三个 block:
[图像, 语言] → [机器人状态] → [带噪动作块]
每个 block 内部使用双向注意力;前面的 block 不能读取未来 block,后面的 block 可以读取前面信息。这样既减少相对 PaliGemma 预训练分布的改变,又允许在 10 次流积分中缓存不变的图像、语言和状态 Key/Value,只重复计算动作后缀。
训练损失
动作训练使用条件流匹配的均方误差:预测向量场应接近由真实动作与噪声构成的目标向量场。其目的不是直接回归唯一动作,而是学习在观测条件下将噪声分布运输成可能的连续动作分布。
完整数据流
训练时:
多路图像 + 语言 + 机器人状态 + 真实 50 步动作
→ 采样 ε 和 τ,构造带噪动作块
→ 图像/语言进入 VLM,状态/动作进入动作专家
→ 预测动作向量场
→ 与目标向量场计算 Flow Matching Loss

推理时:
多路图像 + 语言 + 机器人状态 + 随机动作噪声
→ 缓存观测前缀
→ 动作专家执行 10 次 Euler 流积分
→ 得到 50 步连续动作块
→ 按平台执行 16 或 25 步
→ 重新观测并生成下一动作块

一句话理解:
PaliGemma 负责理解“看到了什么、用户要什么”,动作专家负责把这种理解变成连续高频动作;
动作分块解决输出效率与轨迹连贯性,流匹配解决连续、多模态动作分布,
跨本体预训练提供广泛经验,高质量后训练塑造稳定而熟练的任务策略。