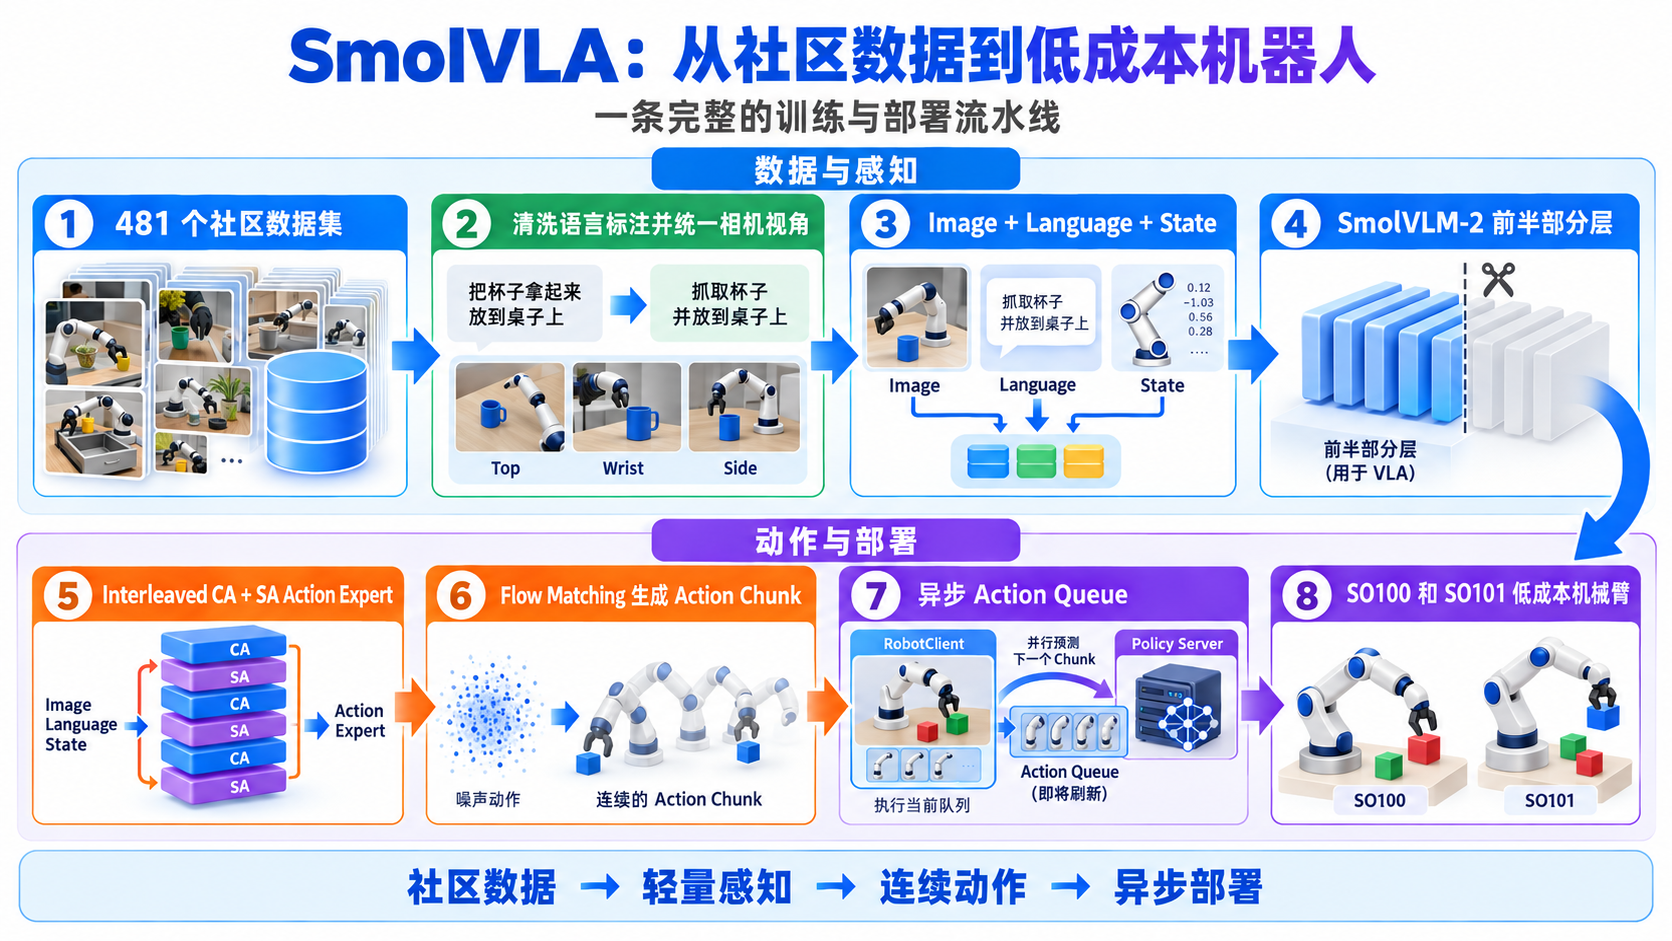
SmolVLA:面向低成本机器人的视觉语言动作模型
SmolVLA: A vision-language-action model for affordable and efficient robotics
- 轻量 VLA
- 社区数据
- 流匹配
- 异步推理
先验知识
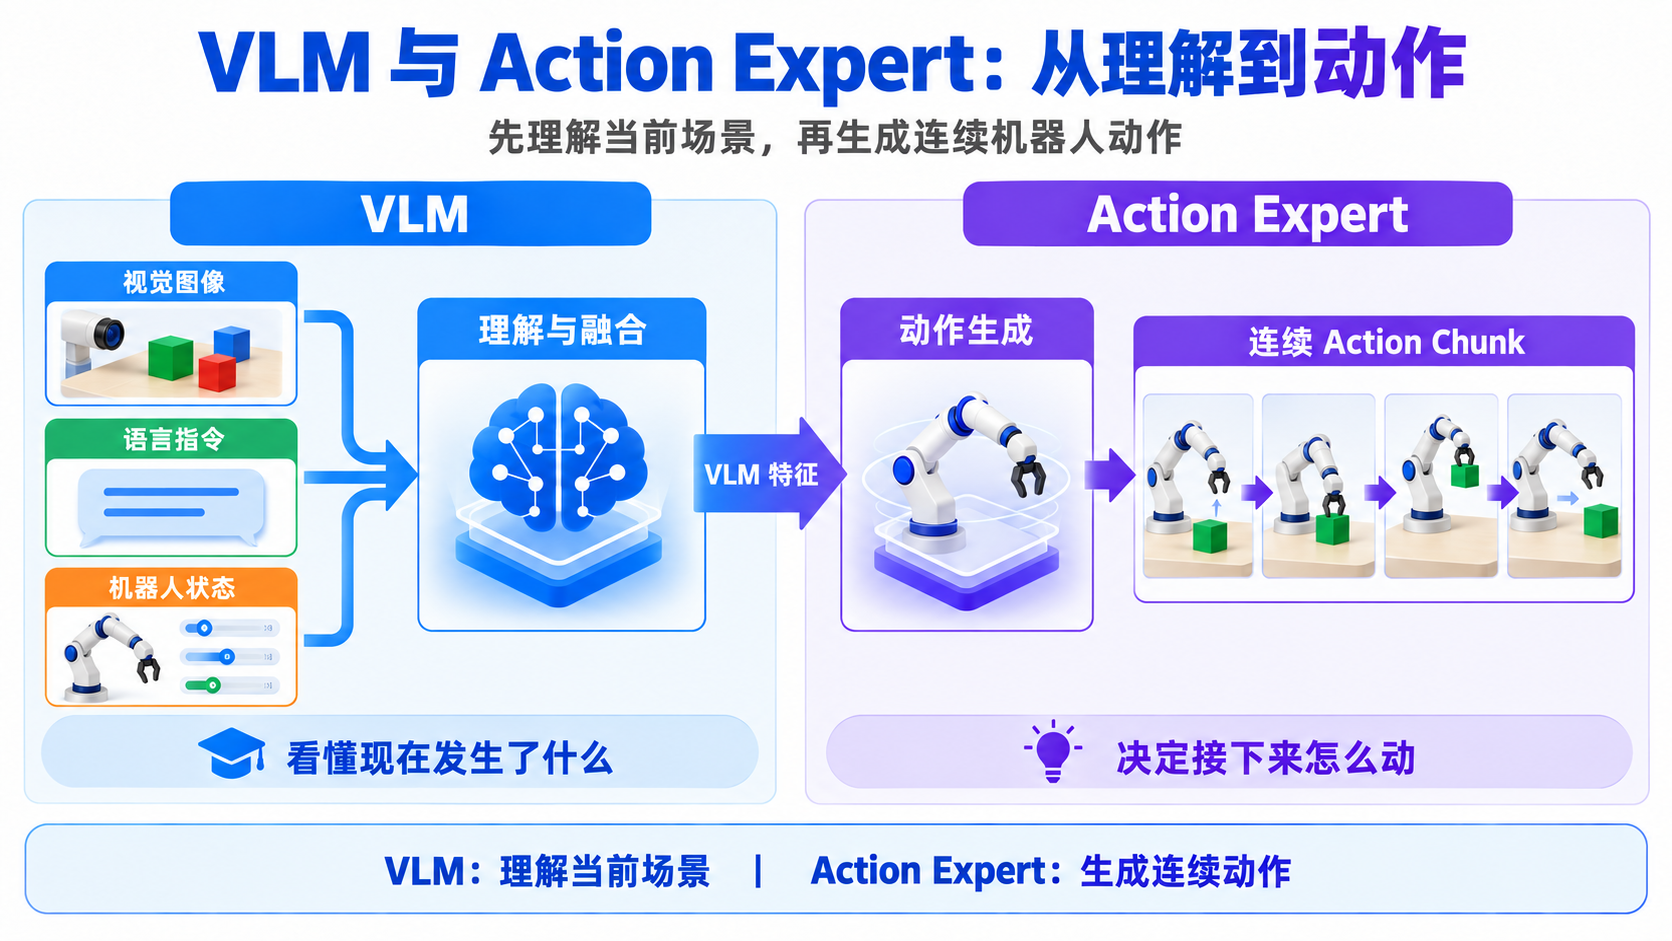
VLM 和 VLA 有什么区别
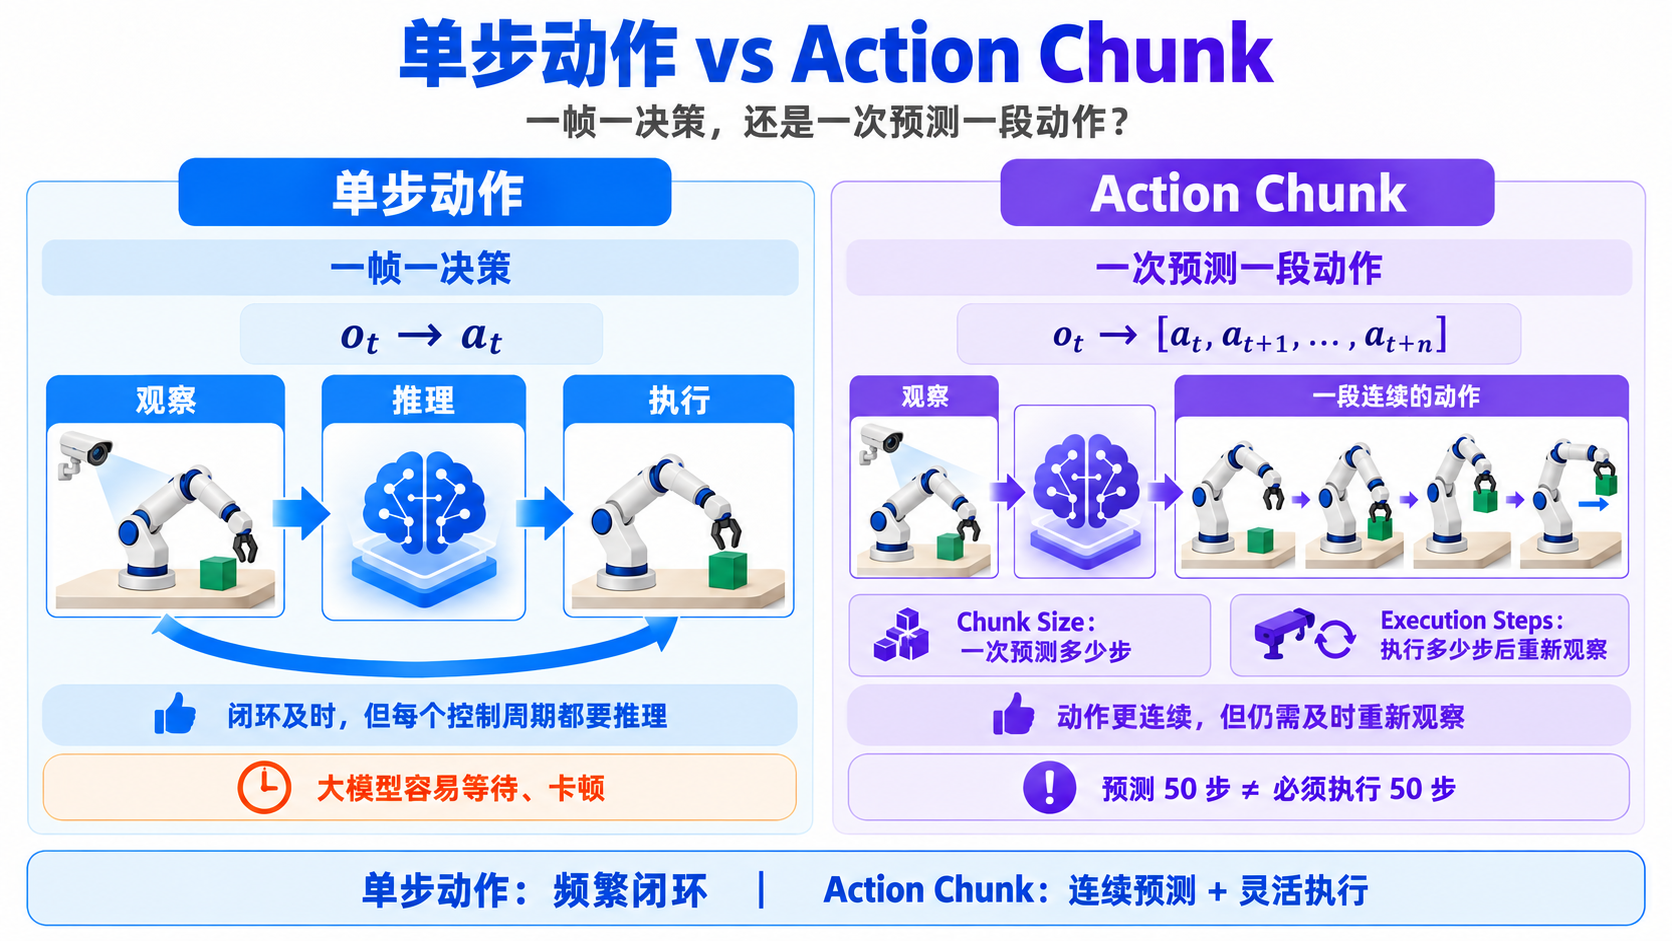
单步动作与 Action Chunk
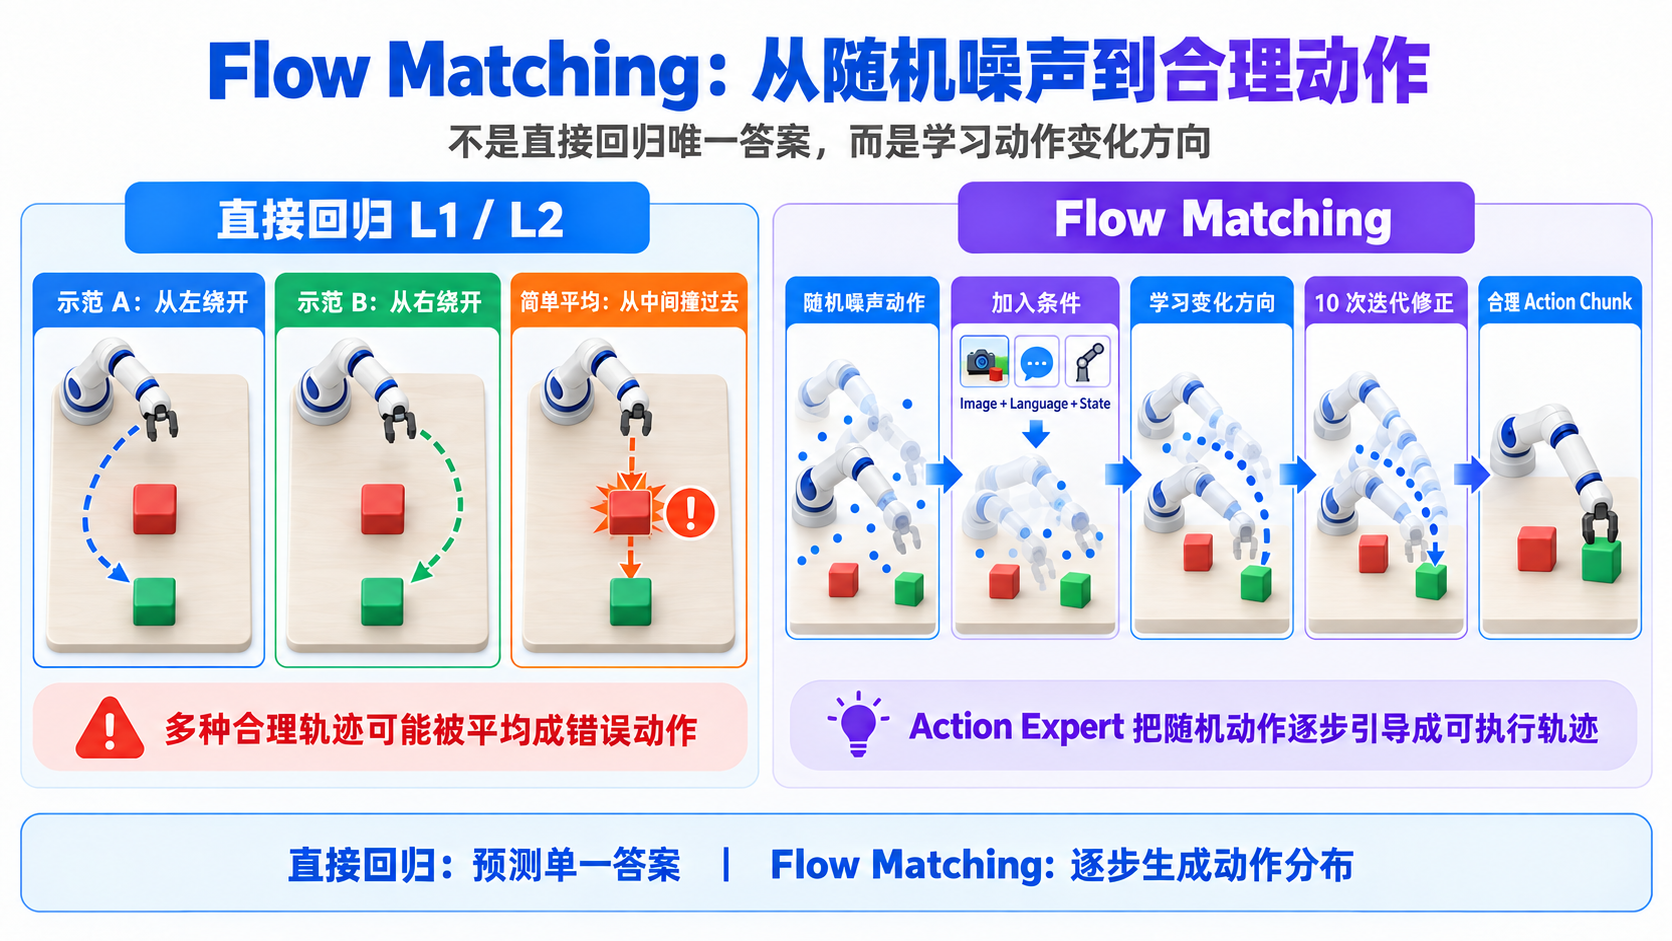
什么是 Flow Matching
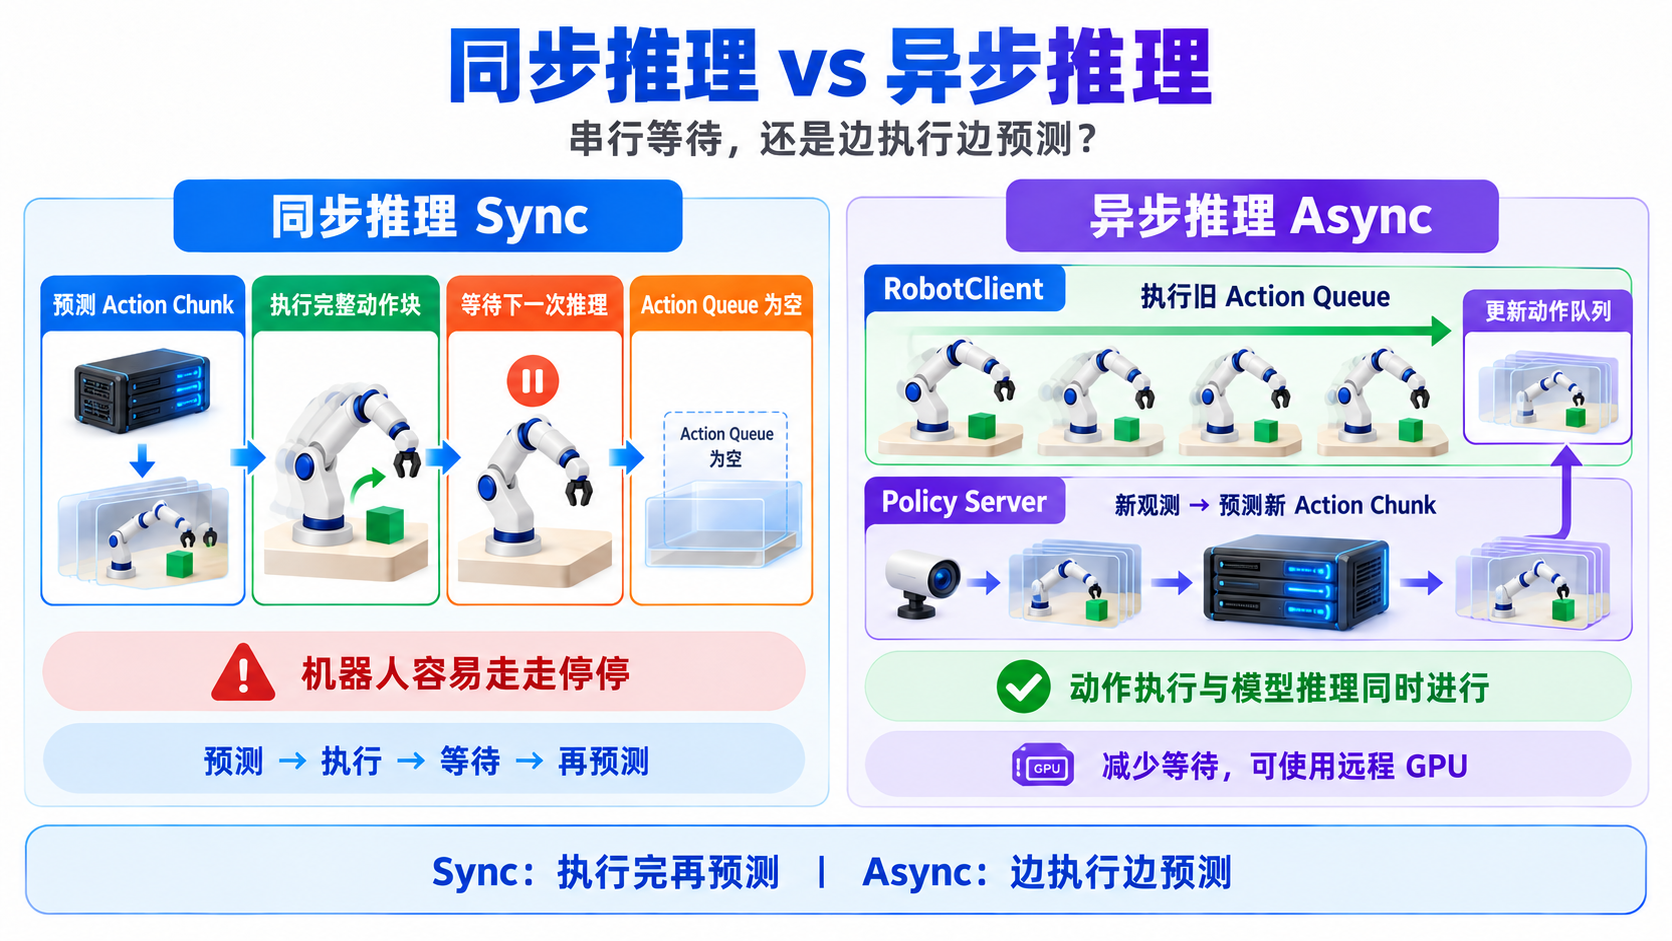
同步推理和异步推理
摘要
预训练视觉语言模型在大规模多模态数据上学习了丰富的视觉和语言知识,因此可以成为机器人策略的良好基础。近年的研究不再从零训练机器人策略,而是把 VLM 改造成 VLA,使模型能够根据自然语言进行感知和控制。
但是,现有 VLA 通常拥有数十亿参数,训练成本高,也很难部署到真实机器人上。它们还主要依赖学术界和工业界的数据,没有充分利用低成本机器人社区正在快速增长的公开数据。
本文提出 SmolVLA,一个小型、高效、由社区数据驱动的 VLA。它显著降低训练和推理成本,同时保持有竞争力的性能。SmolVLA 可以在单张 GPU 上训练,并部署到消费级 GPU,甚至 CPU 上。
为了提高机器人的响应速度,作者还提出异步推理栈,把感知和动作预测与动作执行分开,使机器人在执行 Action Chunk 的同时预测下一段动作。虽然模型规模很小,SmolVLA 的性能仍然可以和参数量大 10 倍的 VLA 相比。作者在仿真和真实机器人任务上进行了评估,并公开代码、预训练模型和训练数据。
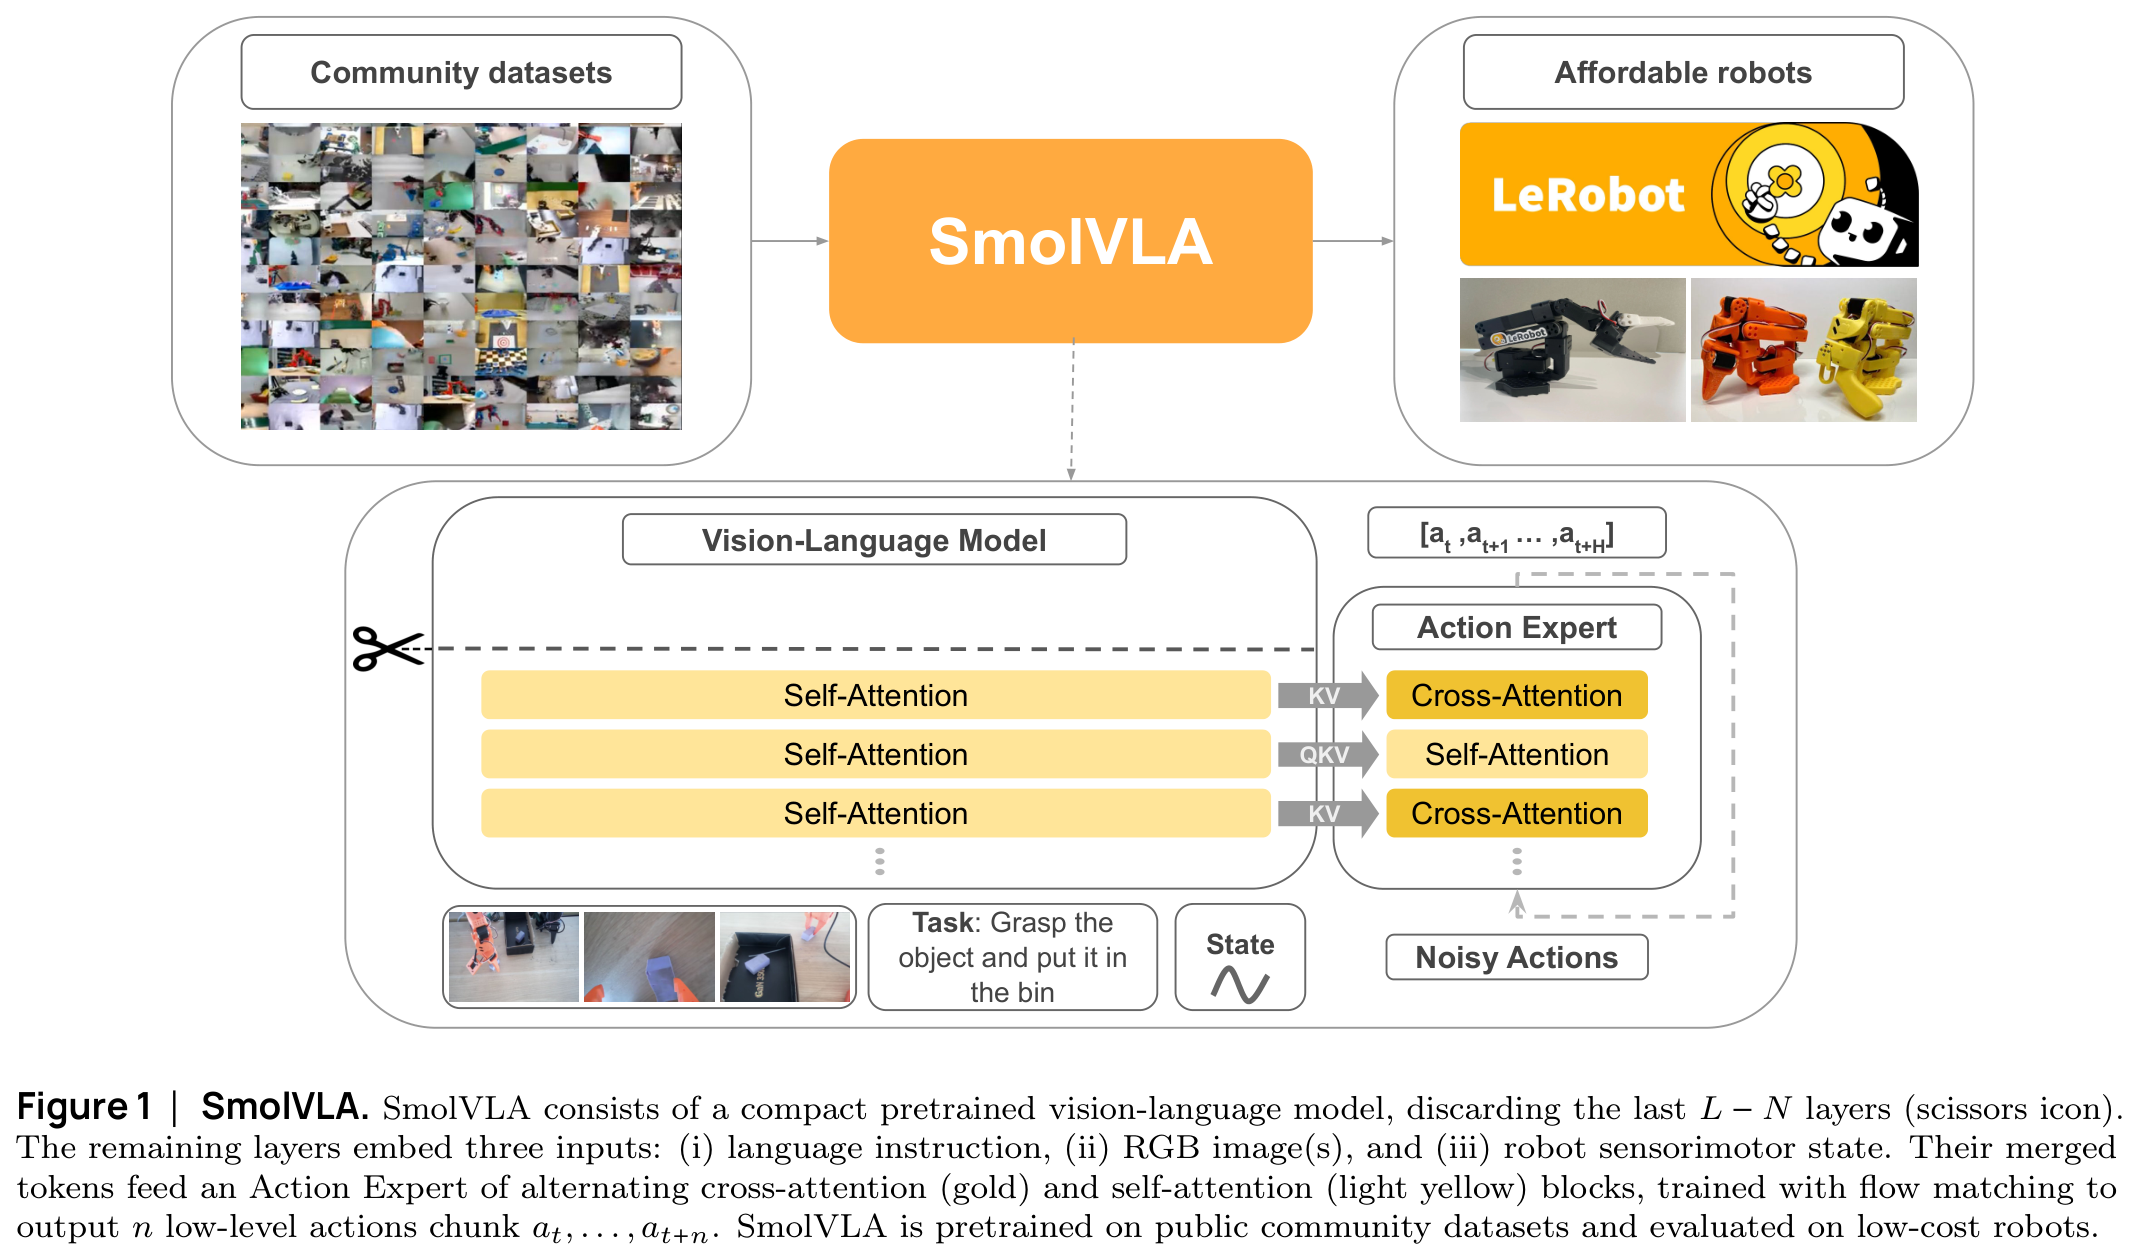
SmolVLA 轻量架构与完整网络
模型的整体数据流
- SmolVLA 由 VLM 和 Action Expert 两部分组成。
多路 RGB 图像
语言指令
机器人 State
      ↓
    VLM
      ↓
场景条件特征
      ↓
Action Expert + Noisy Actions
      ↓
Flow Matching
      ↓
Action Chunk
- VLM 负责理解当前环境,Action Expert 负责把理解结果变成连续动作。它不是让语言模型直接输出“关节 1 转多少度”,而是让语言模型提供条件特征,再由专门的动作网络生成控制序列。
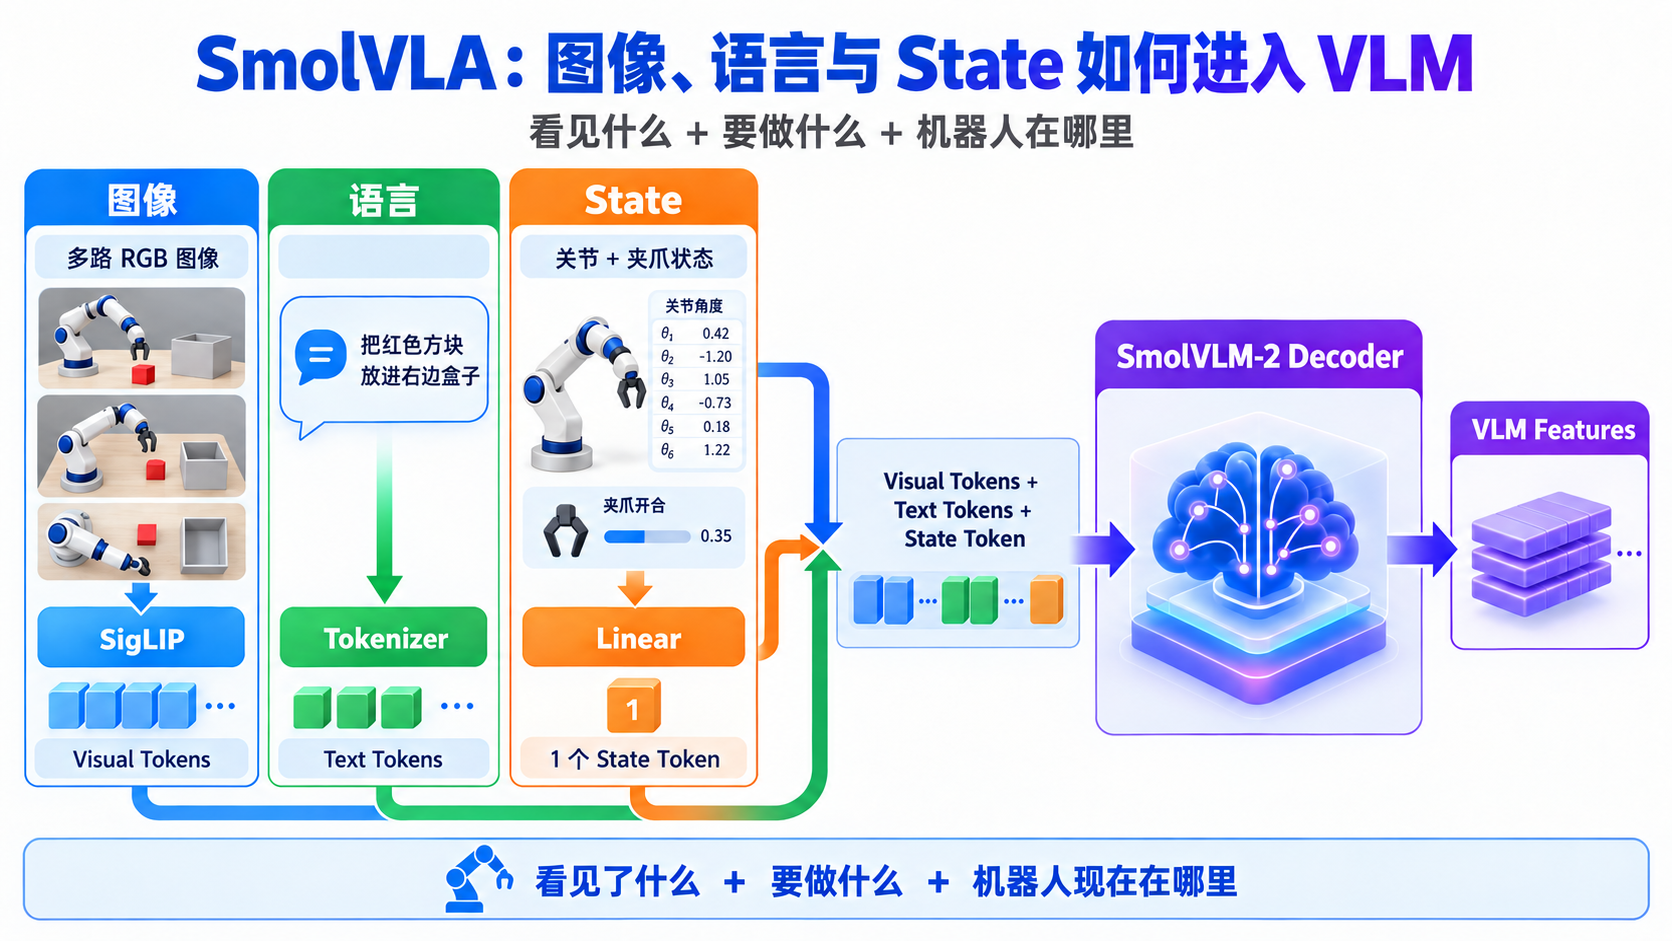
图像 语言和 State 怎么进入 VLM
为什么每帧只保留 64 个视觉 Token
-
高分辨率图像通常会产生大量 Visual Tokens。Token 越多,Attention 的计算量越大,真机推理也越慢。
-
SmolVLM-2 原本支持 Image Tiling,也就是把一张图切成多个局部区域再编码。SmolVLA 为了速度不使用 Tiling,只保留全局图像,并通过 Pixel Shuffle 把每帧限制为 64 个视觉 Token。
-
代价是模型可能丢失很小的目标和精细纹理,但计算成本明显降低。
为什么只使用 VLM 前半部分层
-
假设 VLM 一共有 L 层,SmolVLA 不运行完整 L 层,而是在第 N 层就取出特征,并直接丢弃后面的 L-N 层。
-
作者发现使用
N = L/2可以在速度和性能之间取得较好平衡。主模型只使用语言模型的前 16 层。
完整 VLM:Layer 1 → 2 → ... → L

SmolVLA:Layer 1 → 2 → ... → N → Action Expert
                               × 后半层不计算
- 这里不是每隔一层跳一次,而是直接保留前半部分。消融实验显示,这通常比换成更小的 VLM 更好,因为前半部分仍然保留了大模型的宽度和表示能力。
Action Expert 怎么生成动作
-
Action Expert 的输入有两类:
-
VLM 输出的条件特征;
-
加噪后的 Action Chunk。
-
-
它内部交替使用 Cross-Attention 和 Causal Self-Attention。
Cross-Attention 看当前任务
- Action Token 作为 Query,读取 VLM 特征中的 Key 和 Value。它解决的问题是:
现在看到了什么?
语言要求做什么?
机器人当前是什么姿态?
Self-Attention 看动作之间的关系
- Action Tokens 之间再做 Self-Attention,让未来一段动作保持连续,例如“接近物体、闭合夹爪、抬起、移动、放下”。
为什么使用 Causal Mask
-
Causal Mask 让第 i 个动作只能看到它前面的动作,不能偷看未来 Action Token。
-
论文发现 Bidirectional Attention 的效果反而更差。作者认为禁止未来动作泄漏,可以让模型学习更合理的时间结构。
-
最终结构可以记成:
VLM Features ───────┐
                    ↓
Noisy Actions → Cross-Attention
                    ↓
              Self-Attention
                    ↓
              Cross-Attention
                    ↓
              Self-Attention
                    ↓
               Action Chunk
Flow Matching 在 SmolVLA 里怎么工作
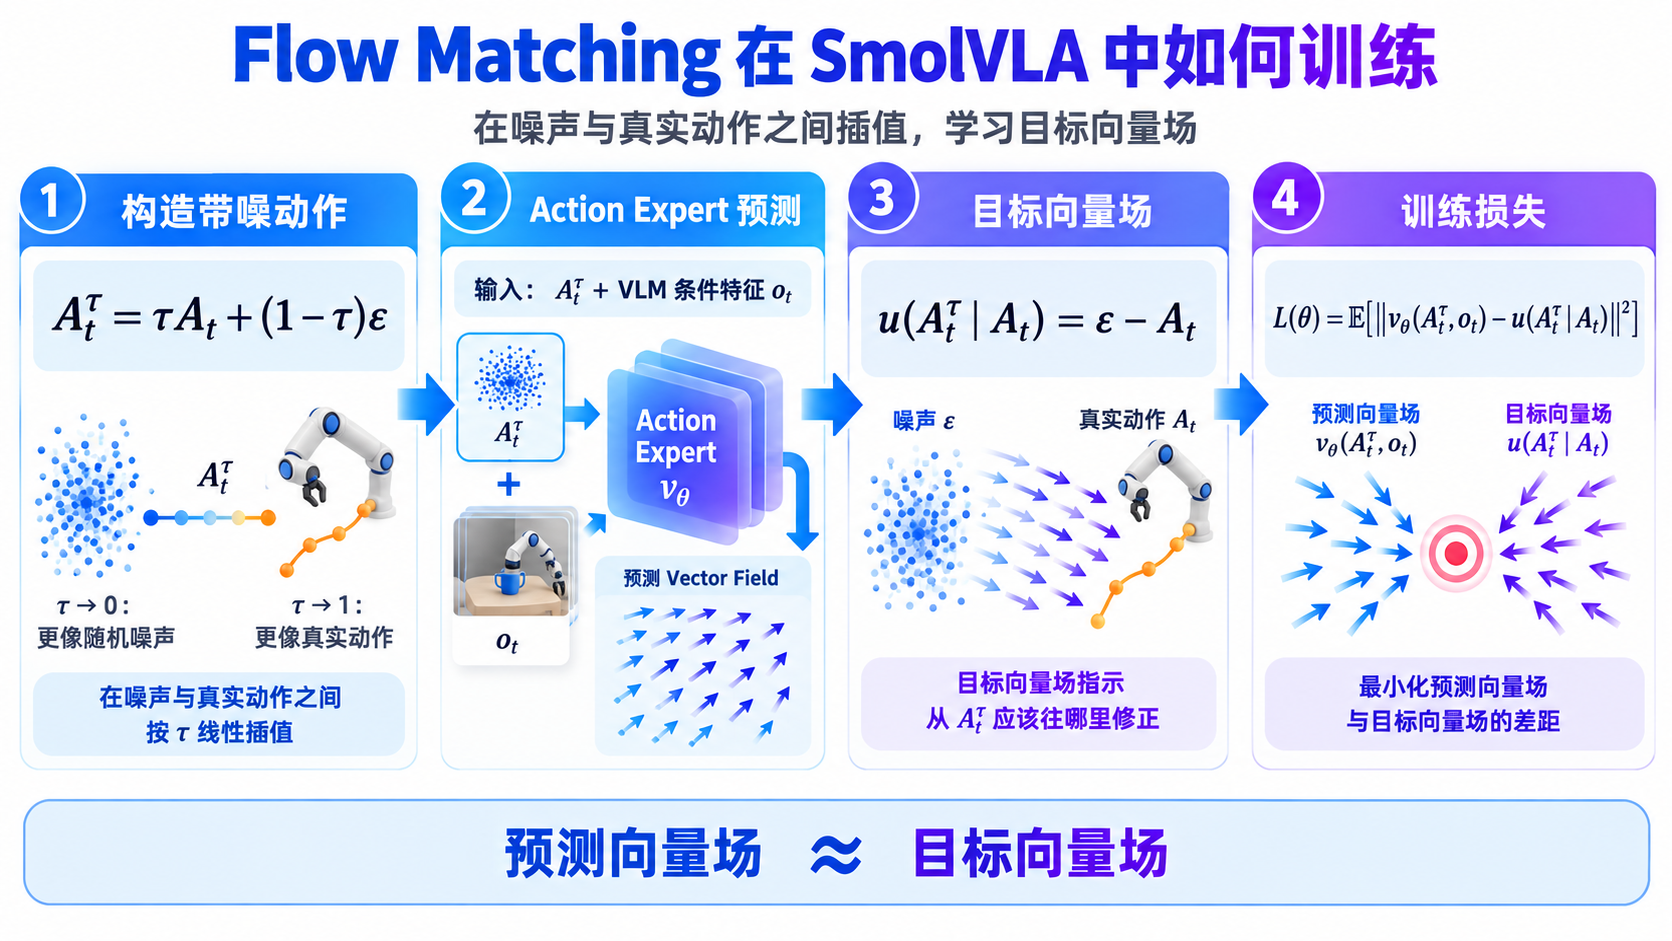
完整训练和推理流程
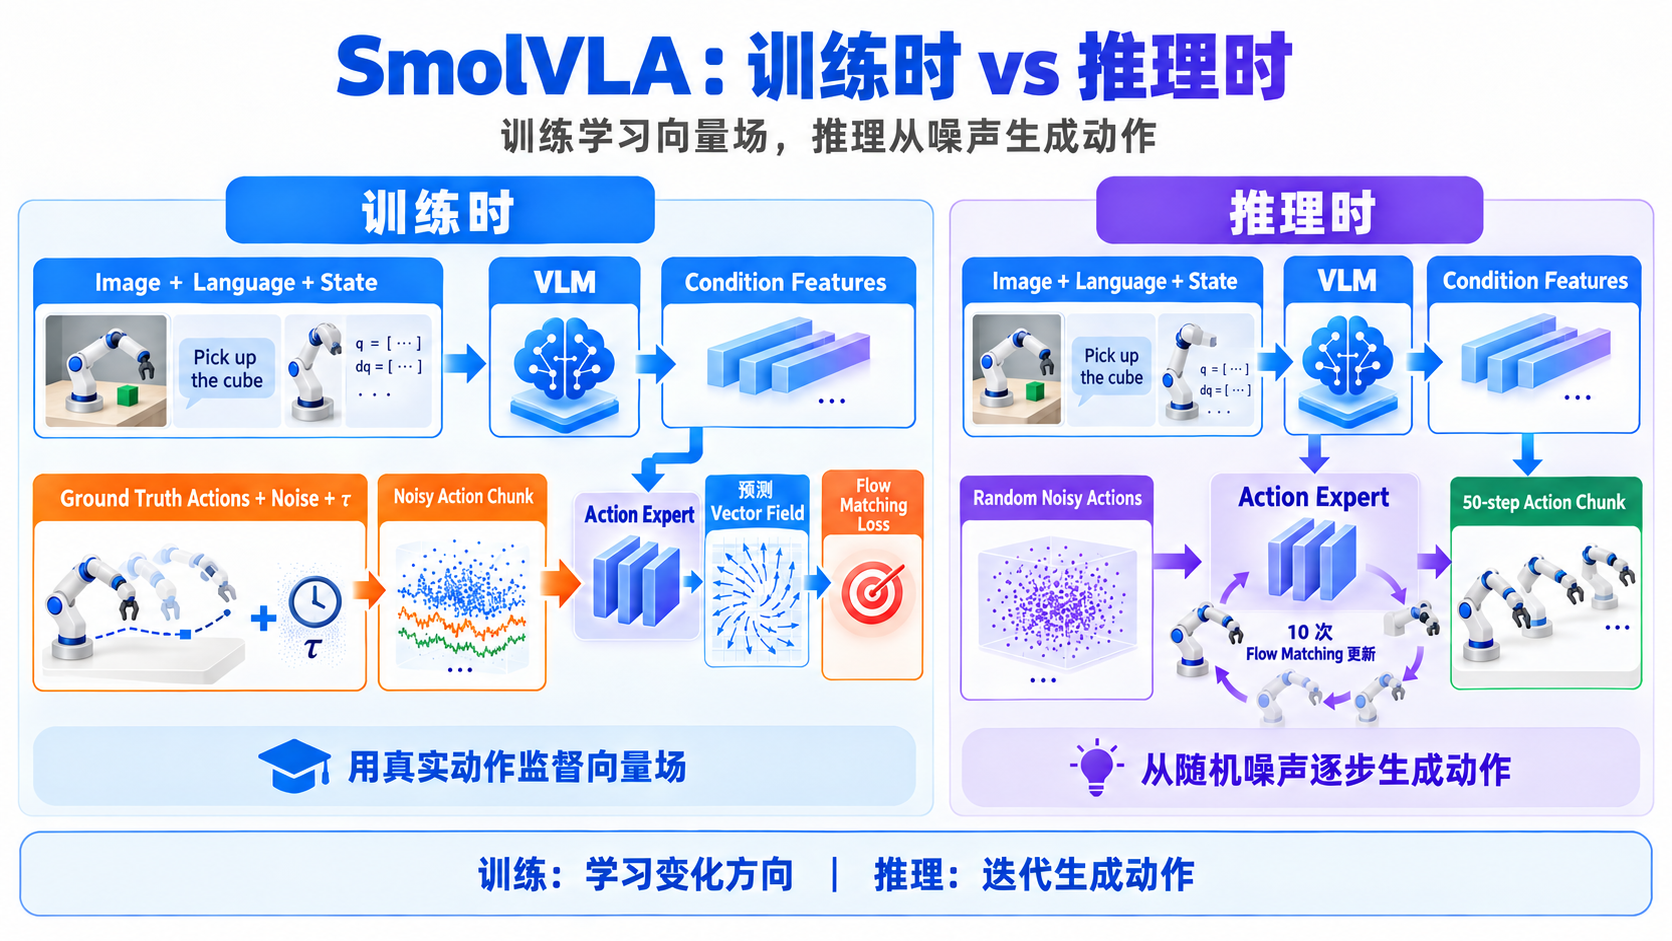
- 主模型约有 4.5 亿参数,其中 Action Expert 约 1 亿参数。训练时冻结 VLM,只训练 Action Expert。
社区数据预训练
为什么机器人数据会形成 Data Islands
-
语言和图像可以从互联网获得,但机器人数据必须通过真实硬件和遥操作采集。不同数据集还可能使用不同:
-
机械臂结构
-
控制频率
-
关节定义
-
摄像头数量和位置
-
任务描述
-
数据格式
-
-
这些彼此孤立的数据就是论文所说的 Data Islands。仅仅把文件拼接在一起,并不能直接得到可用的预训练数据。
SmolVLA 使用了多少社区数据
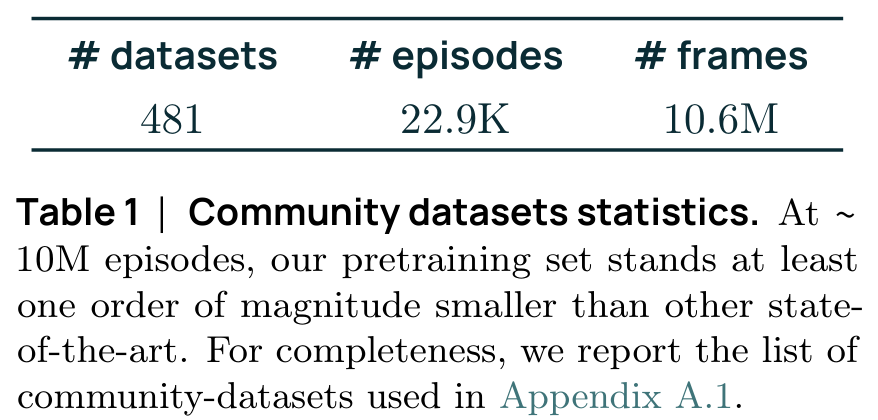
-
筛选标准包括机器人类型、Episode 数量、整体数据质量和帧覆盖情况。
-
这个数据量比许多大型 VLA 使用的数据少一个数量级。作者想证明:经过清洗的社区数据,即使规模不大,也可以产生明显的预训练收益。
用 VLM 清洗任务语言
社区数据中的任务标注经常很模糊,例如:
task desc
Hold
Up
对人类来说,也许根据视频还能猜出任务;但对 VLA 来说,这些语言无法稳定表达机器人的目标。
作者使用 Qwen2.5-VL-3B-Instruct 自动生成新的任务描述:
-
从数据集中抽取代表性画面;
-
提供原始任务描述;
-
要求 VLM 生成简短、完整、以动作动词开头的句子。
原始模糊标注 + 代表性画面
             ↓
     Qwen2.5-VL-3B
             ↓
清晰的 Action-oriented Instruction
统一 Camera Viewpoint
-
不同社区数据集使用不同相机命名。例如
images.laptop在一个数据集中可能是顶部相机,在另一个数据集中却可能是腕部相机。 -
如果模型把相机名称当成固定语义,同一个输入位置就会反复出现不同视角,训练会变得混乱。
-
作者手工把相机映射到标准顺序,优先使用:
Top → Wrist → Side
- 再统一命名为:
OBS_IMAGE_1
OBS_IMAGE_2
OBS_IMAGE_3
- 超出需要的相机视角会被丢弃。
异步推理
同步 Action Chunk 的问题
- 设模型根据观测
o_t预测动作块:
A_t = [a_t, a_t+1, ... , a_t+n]
-
最省计算的同步方式是执行完整个
A_t,再获取新观测并预测下一块。但这会带来两个问题:-
执行动作块期间没有使用新画面,形成开环区间;
-
动作块耗尽后,机器人会停下来等下一次推理。
-
RobotClient 和 PolicyServer
- SmolVLA 把系统拆成两个角色:
| 模块 | 任务 |
|---|---|
| RobotClient | 拍摄图像、读取 State、维护 Action Queue、执行动作 |
| PolicyServer | 接收观测、运行 SmolVLA、返回新 Action Chunk |
- RobotClient 不必等旧队列完全耗尽才请求新动作,而是在队列还剩一部分时就异步触发推理。
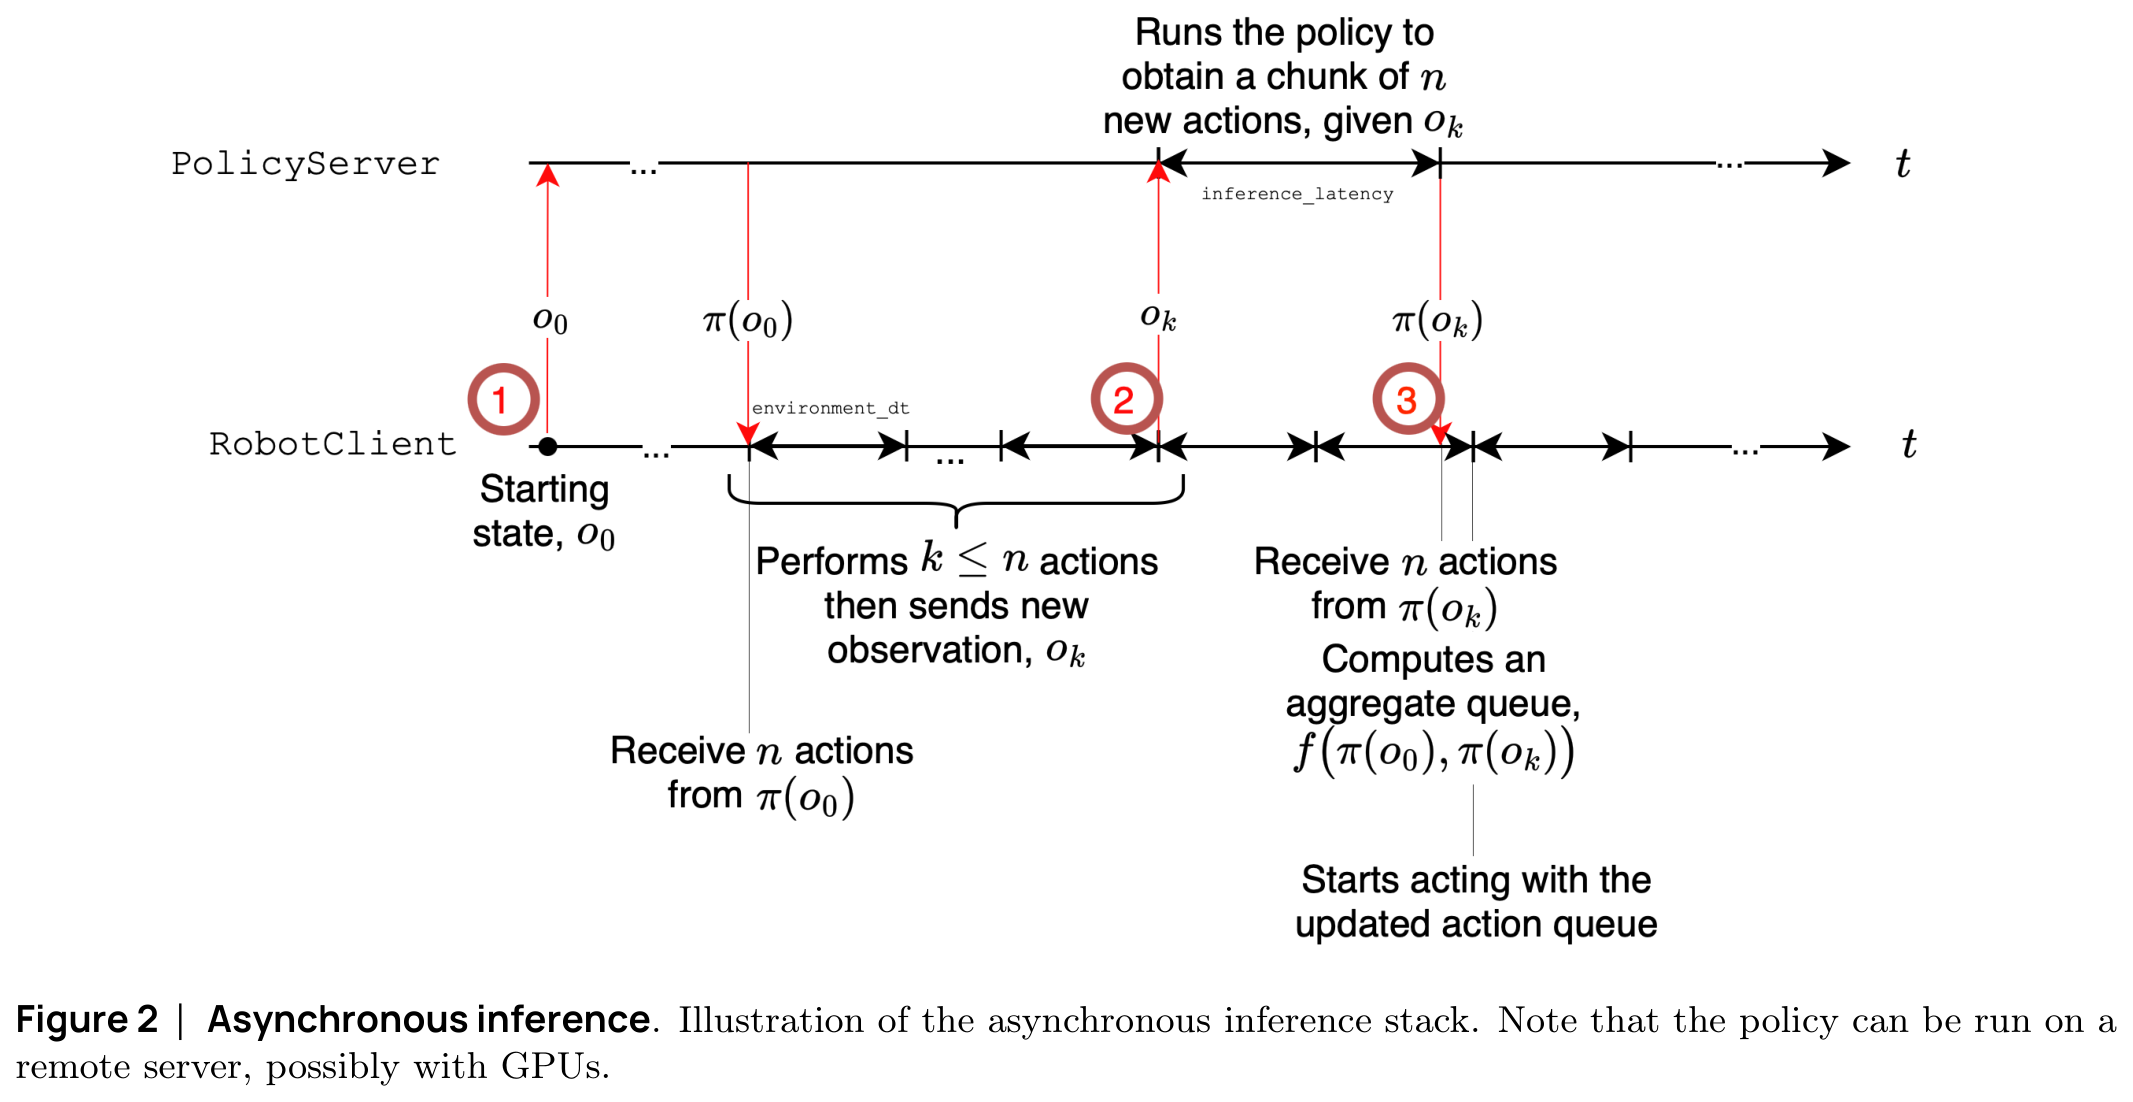
- 整体过程可以理解成:
机器人执行旧 Chunk
        ↓
队列下降到阈值
        ↓
拍摄新画面并异步请求 PolicyServer
        ↓
机器人继续执行旧队列
        ↓
新 Chunk 返回
        ↓
合并或更新 Action Queue
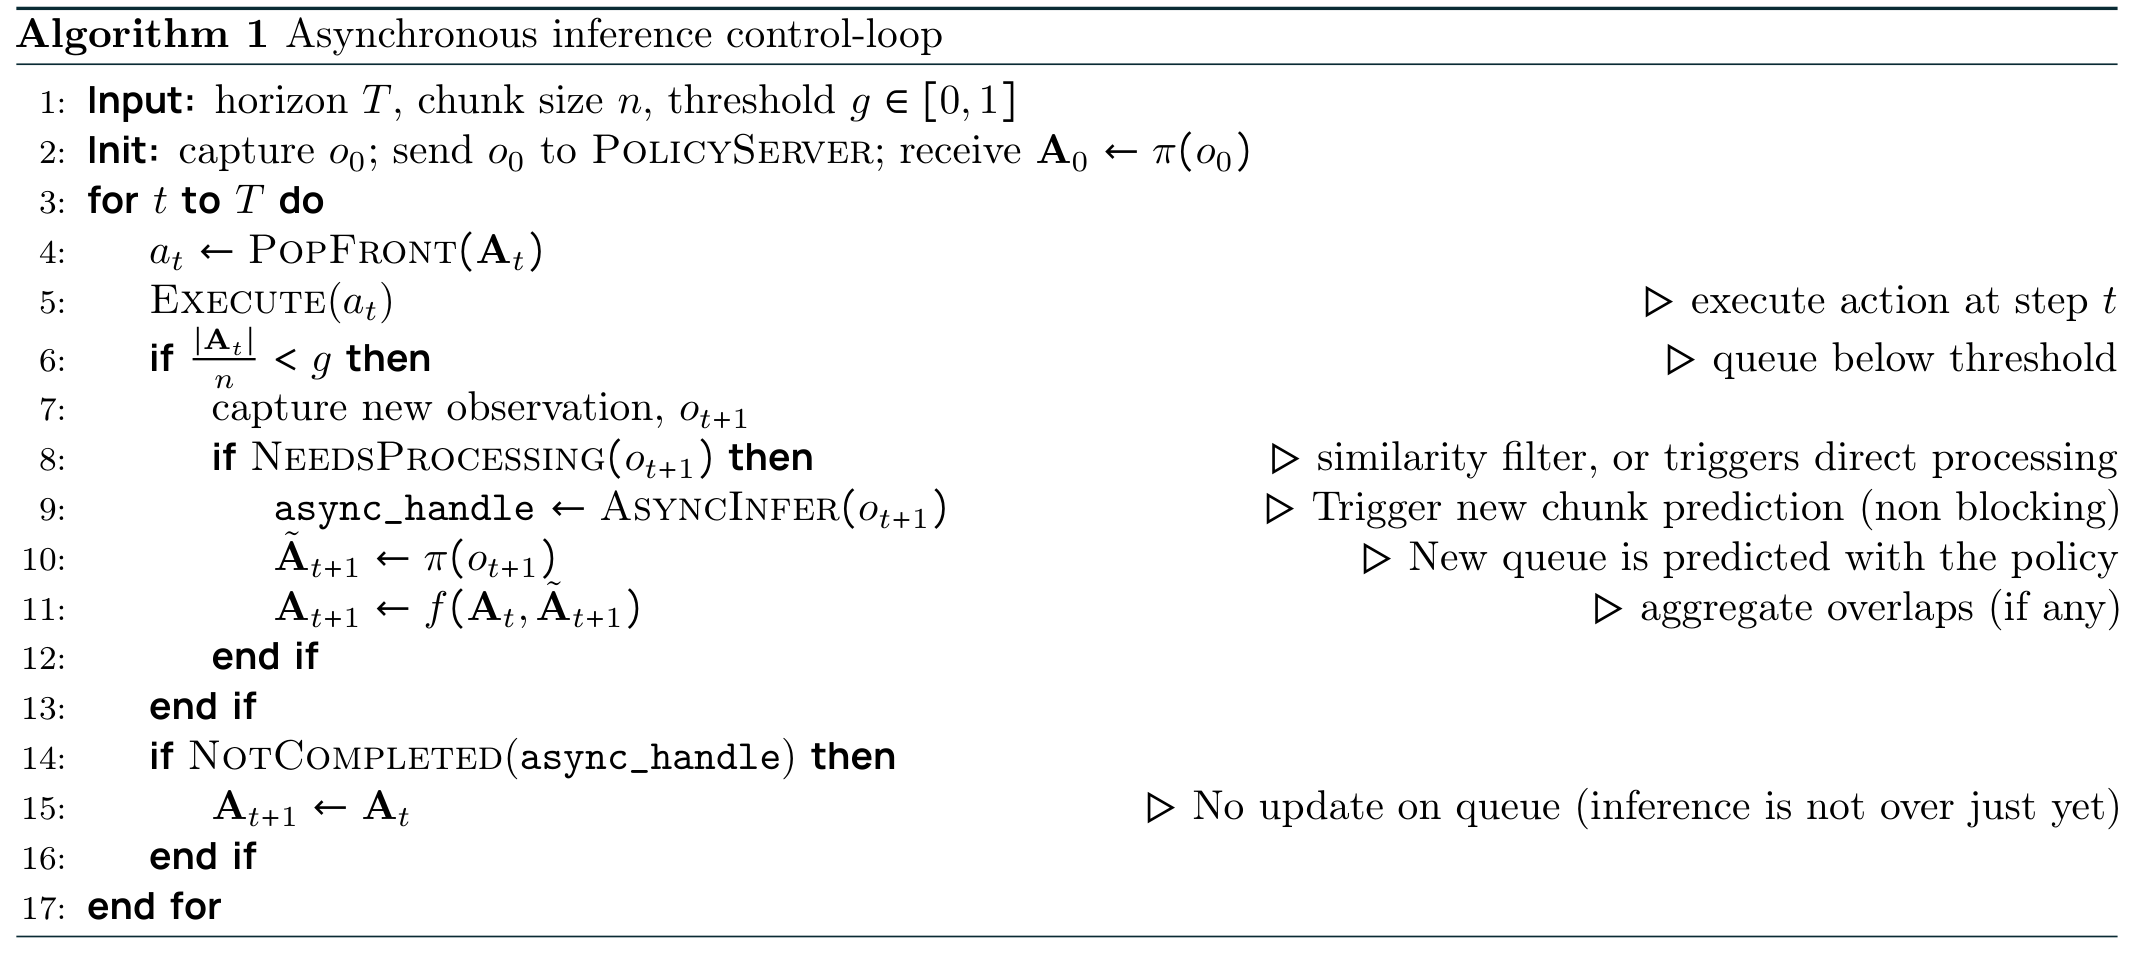
阈值 g 控制什么时候预测
- 论文使用
g ∈ [0,1]作为触发阈值。当剩余动作比例低于g时,RobotClient 请求新 Action Chunk:
|A_t| / n < g
g 等于 0
- 队列必须完全耗尽才请求新动作,接近同步推理。机器人容易出现空队列和等待。
g 等于 1
- 几乎每个控制周期都请求新动作,响应最快,但计算成本最高。
g 在 0 和 1 之间
- 论文用
g = 0.7解释折中方案:机器人先消费一部分旧队列,再提前预测新动作。这样可以减少空窗,又不必每一步都运行模型。
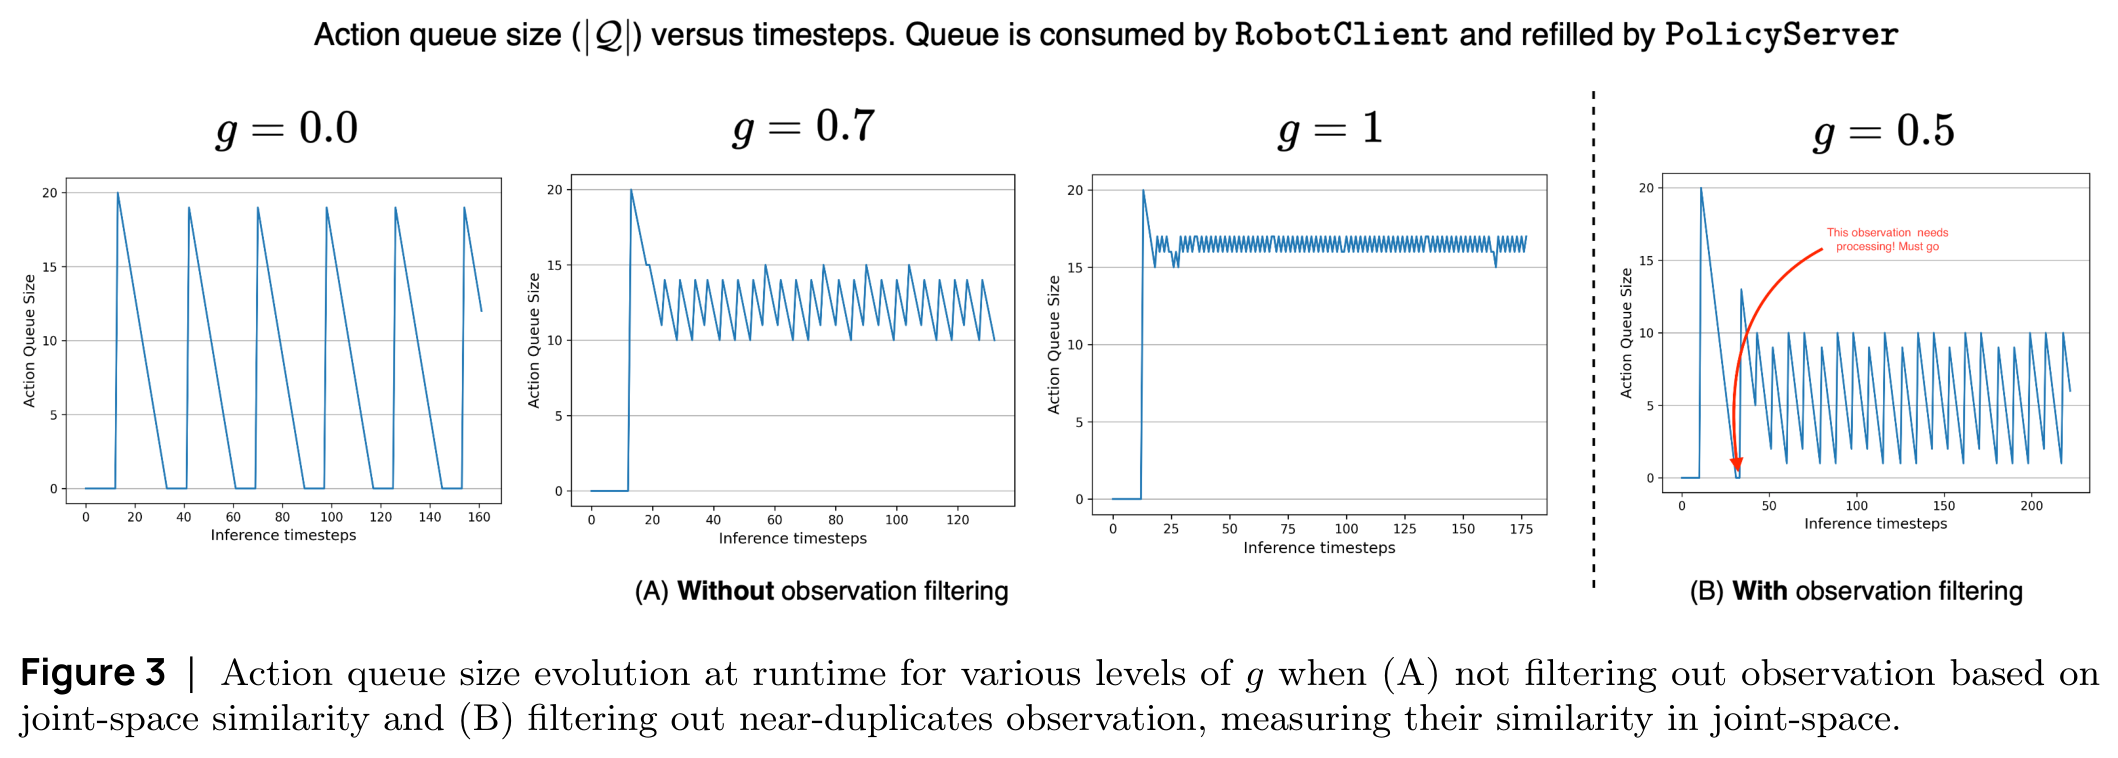
g的本质是给模型预留足够的推理时间。模型越慢、网络延迟越大,就越需要提前请求下一段动作。
为什么还要过滤重复观测
-
如果机械臂几乎没有移动,相邻两次观测可能非常相似。不断把相同状态发送给 PolicyServer 不仅浪费计算,还可能反复合并几乎一样的 Action Chunk。
-
作者根据 Joint Space Distance 比较两个观测。如果距离小于阈值
ε,就跳过近似重复观测。 -
但如果 Action Queue 已经耗尽,系统必须处理最新观测,即使它和之前很接近,否则机器人会一直停住。
实验设置
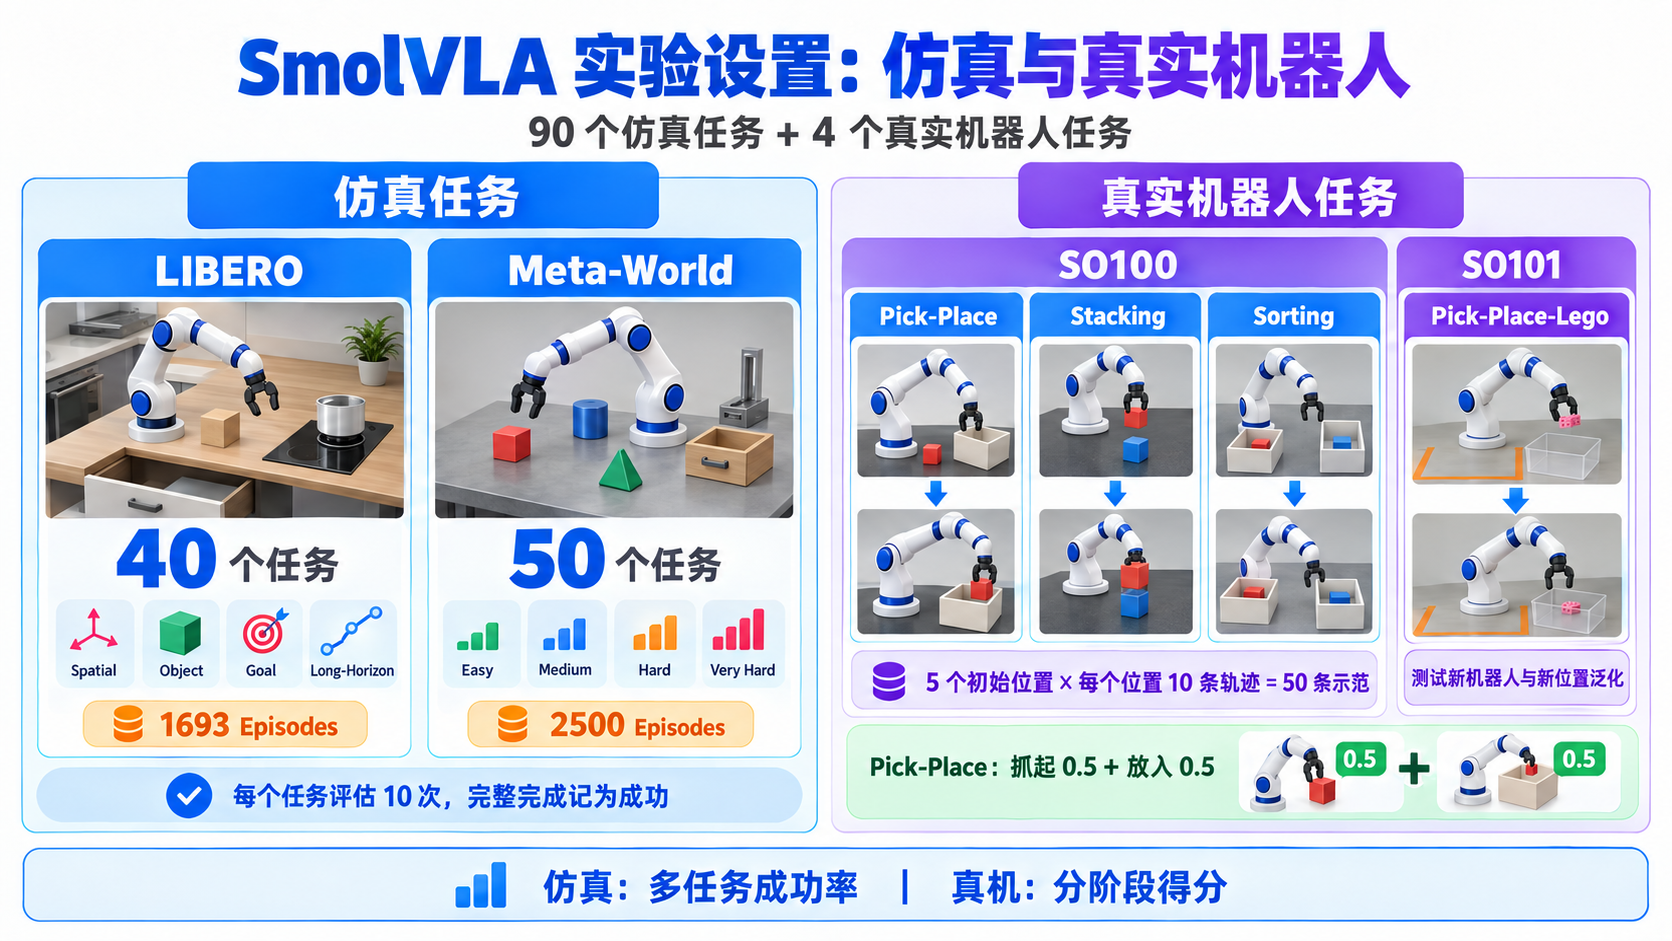
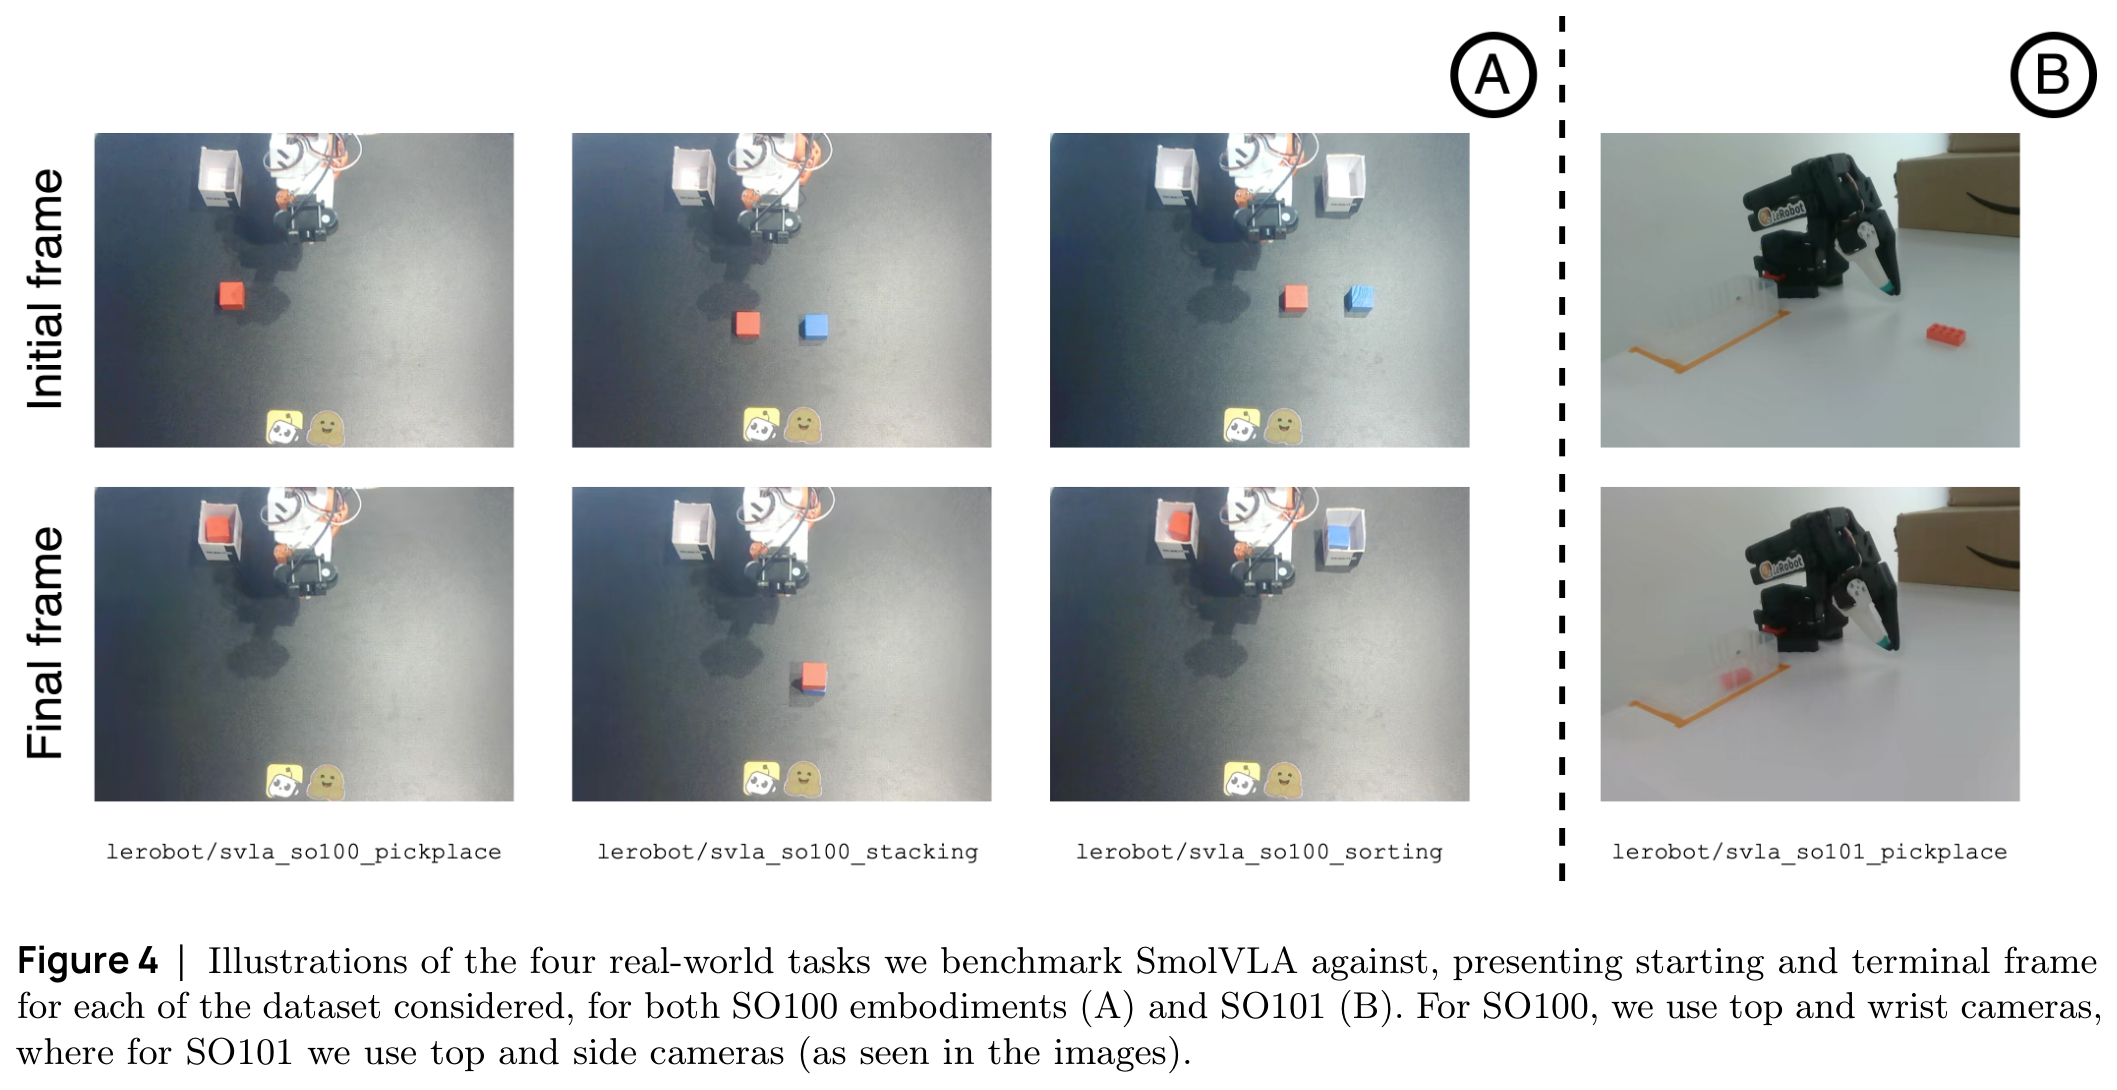
训练设置
| 项目 | 设置 |
|---|---|
| 图像分辨率 | 512 × 512 |
| 预训练步数 | 200K |
| Global Batch Size | 256 |
| Optimizer | AdamW |
| Learning Rate | 1e-4 衰减到 2.5e-6 |
| Action Chunk Size | 50 |
| Flow Matching Steps | 10 |
| 主模型参数量 | 450M |
| Action Expert 参数量 | 约 100M |
| 项目总计算量 | 约 30K GPU Hours |
- 论文的预训练使用 4 张 GPU 以获得较大 Batch Size,但作者说明模型本身可以在单张 GPU 上训练。
实验结果
仿真结果
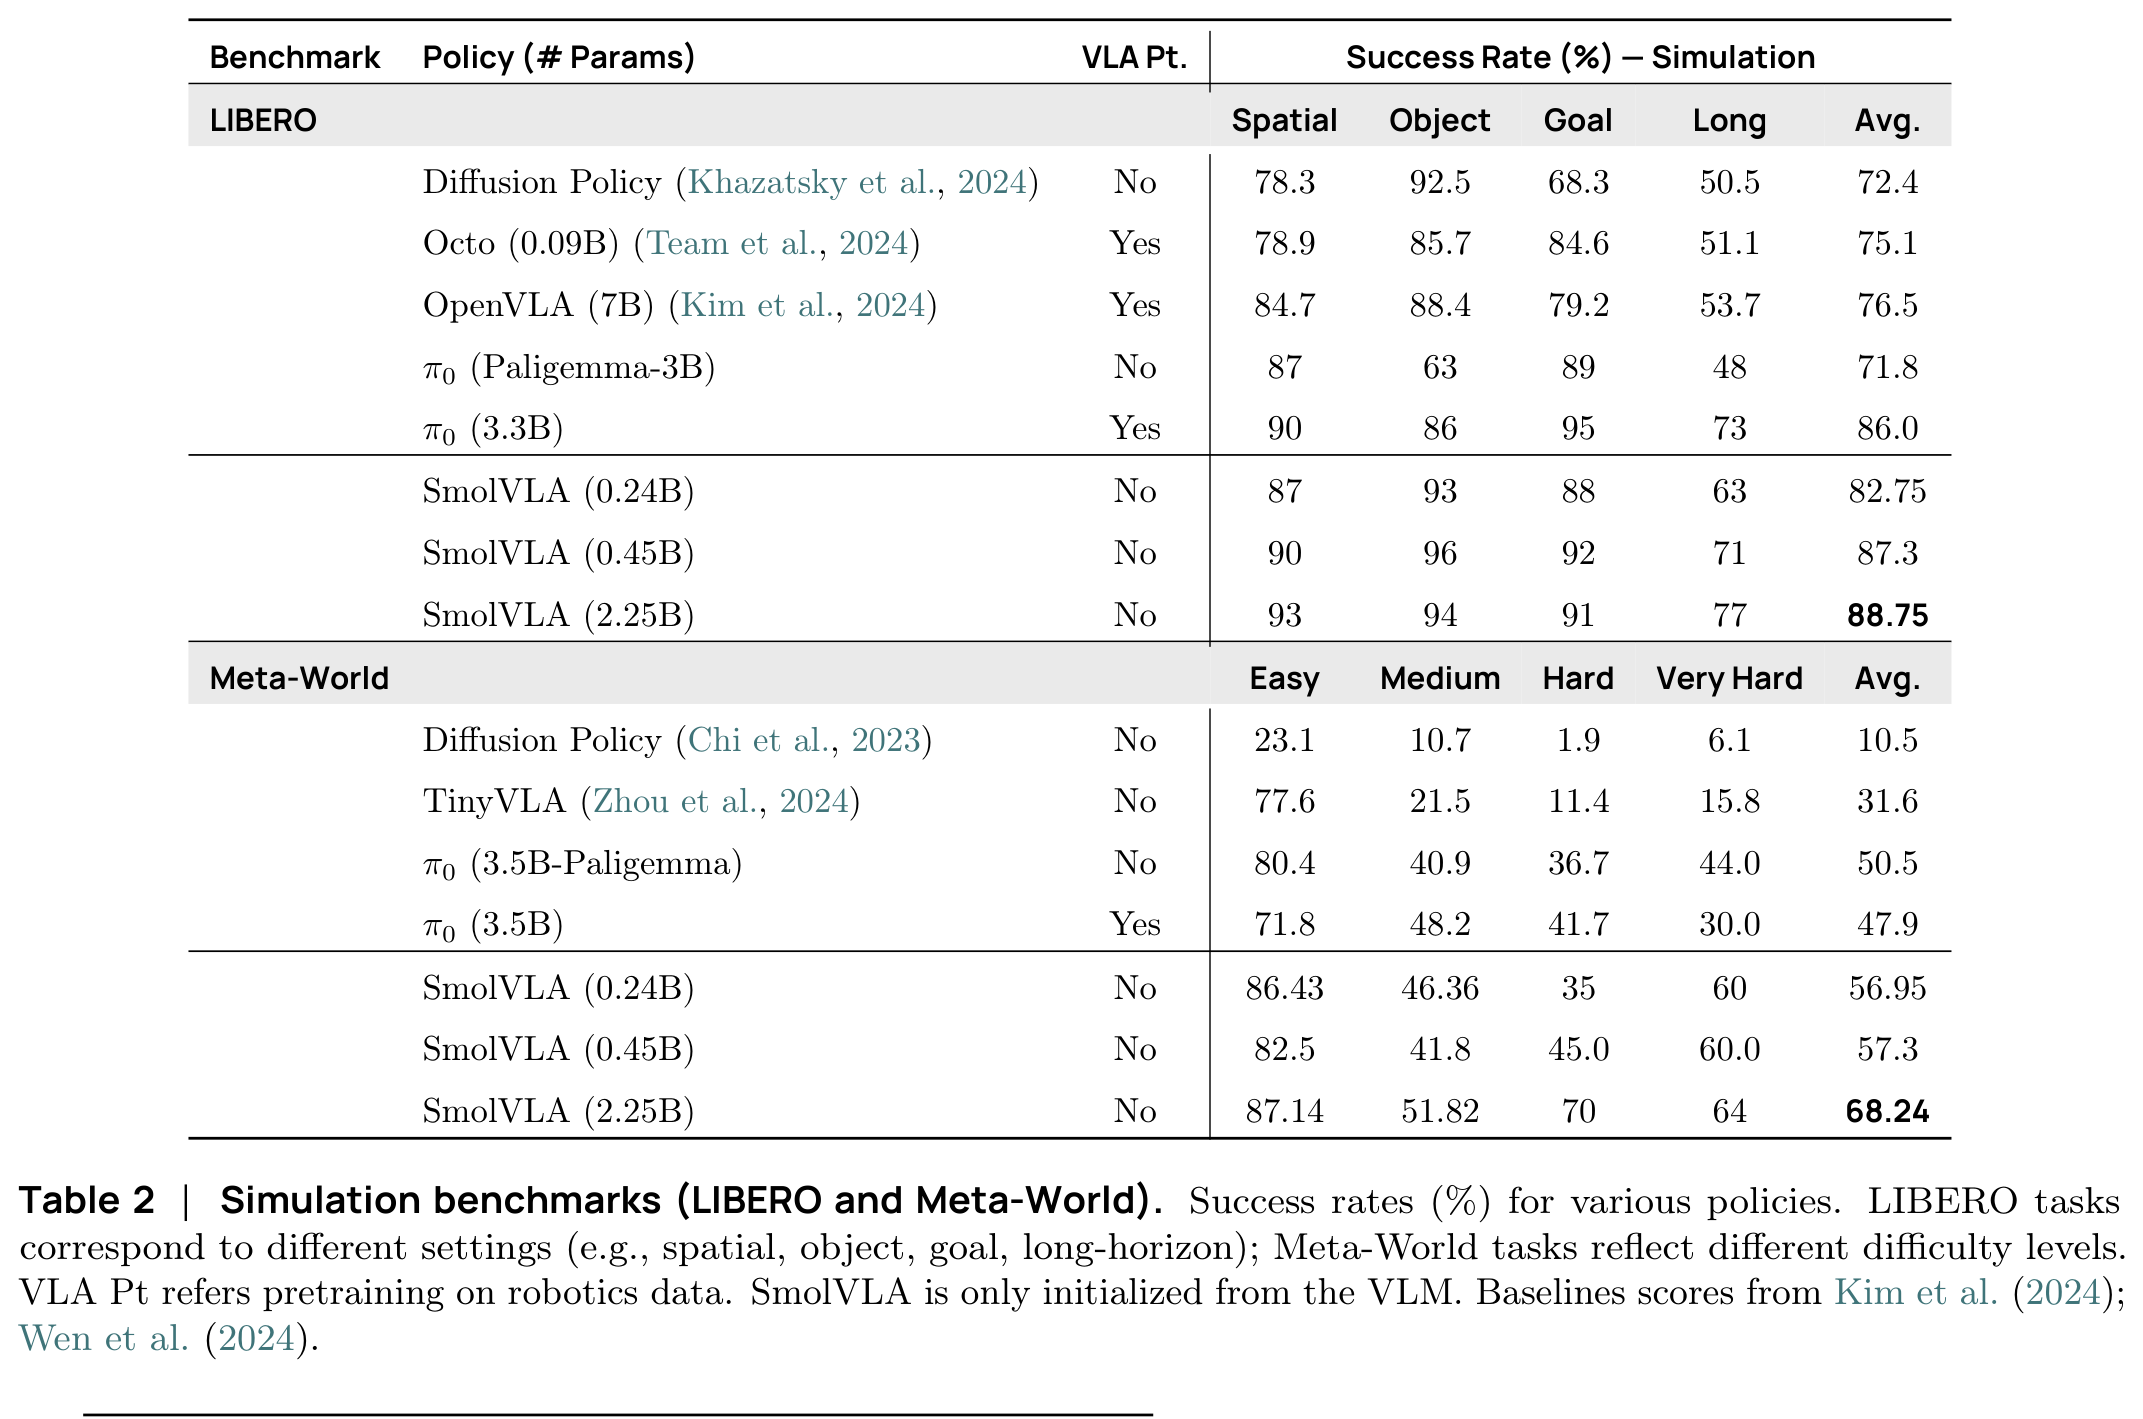
在 LIBERO 上:
-
0.45B SmolVLA 的平均成功率高于 3.3B π0 和 7B OpenVLA。2.25B 版本继续提升,但相对 0.45B 的增益已经不大。
-
在 Meta-World 上,0.45B SmolVLA 平均成功率为 57.3,2.25B 版本为 68.24。结果说明小模型并不一定弱,架构、数据和训练目标同样重要。
SO100 真机结果
-
π0 在最简单的 Pick-Place 上达到 100,但 SmolVLA 在 Stacking 和 Sorting 上明显更高,最终平均成功率最好。
-
SmolVLA 的参数量约为 π0 的七分之一。
SO101 泛化结果
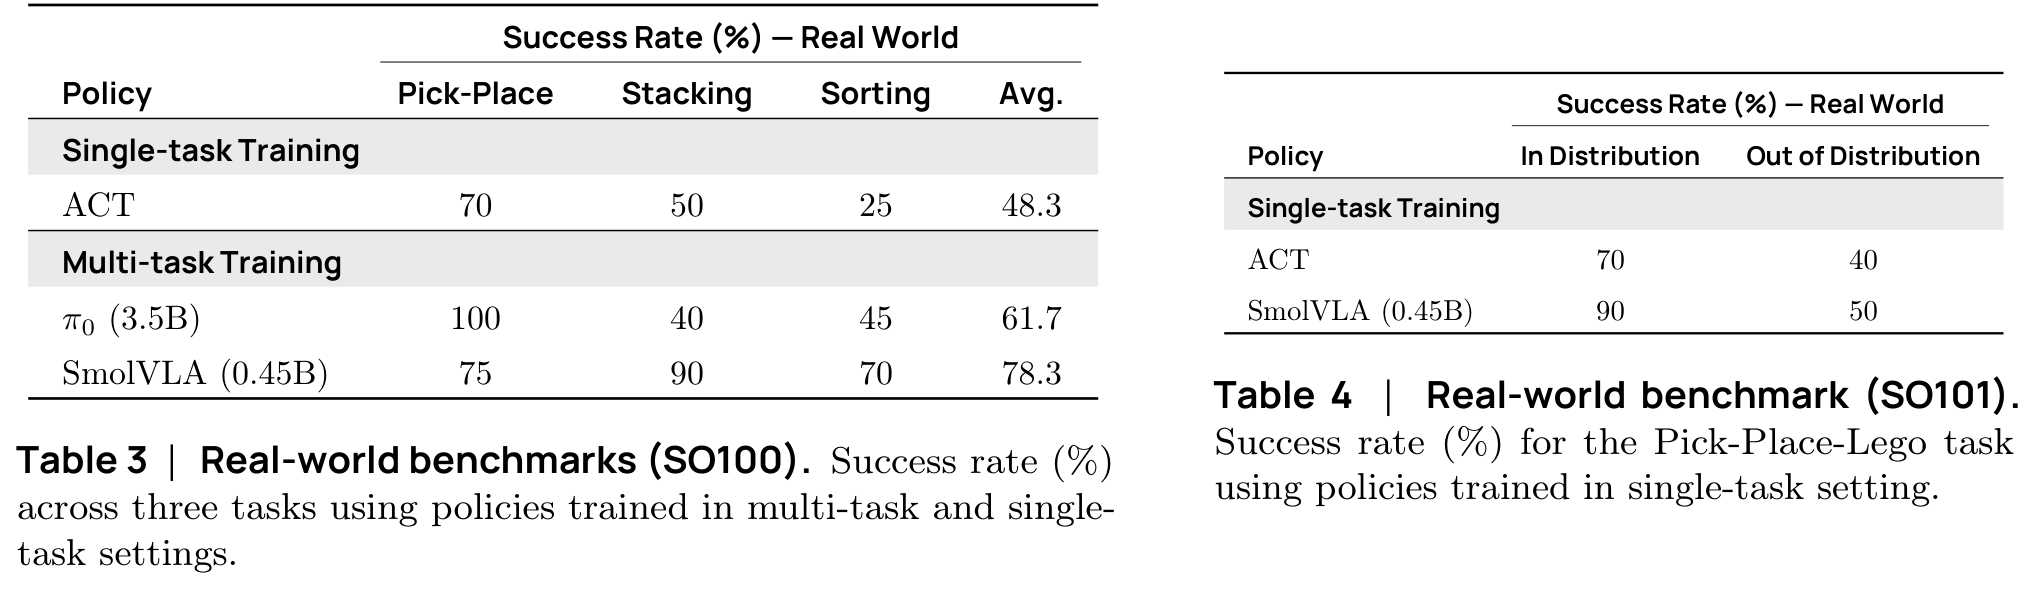
- SmolVLA 的社区预训练数据主要来自 SO100,并没有使用 SO101 数据。经过 SO101 任务微调后,它仍然优于 ACT,说明模型能够迁移到新的机器人平台。
社区预训练带来了什么
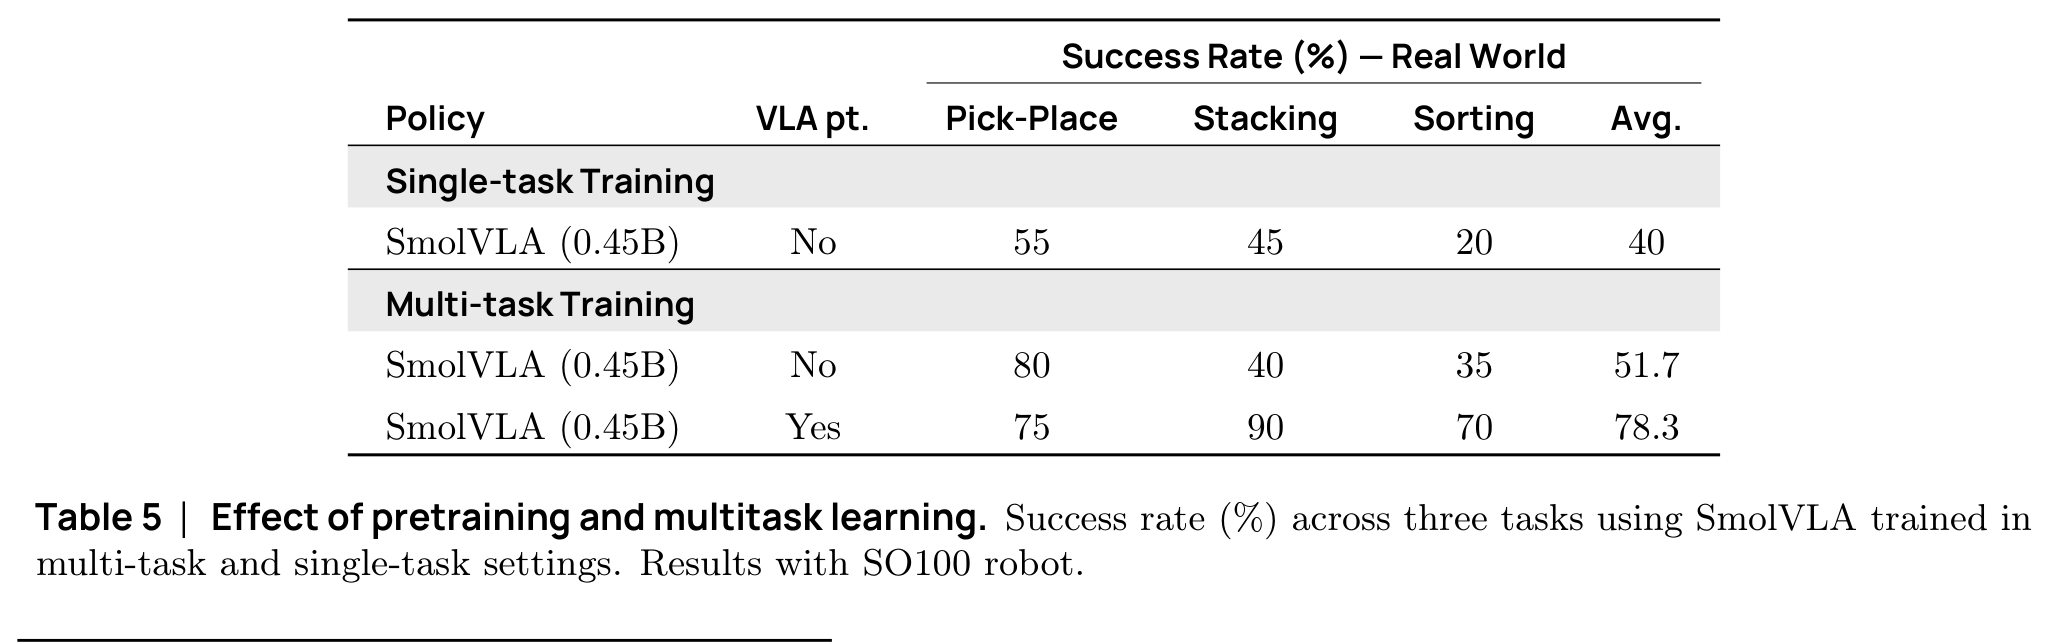
-
从单任务训练到多任务训练,平均成功率从 40.0 提升到 51.7。
-
再加入社区数据预训练,平均成功率提升到 78.3。
-
因此这篇论文最重要的结论之一是:预训练数据带来的收益,比单纯增加模型参数更值得关注。
同步和异步推理
| Inference | Pick-Place | Stacking | Sorting | 平均 |
|---|---|---|---|---|
| Sync | 75 | 90 | 70 | 78.3 |
| Async | 80 | 90 | 50 | 73.3 |
-
Async 并没有让所有任务成功率都提升,Sorting 反而从 70 降到 50。因此不能简单说异步推理一定更准。
-
它真正的优势是速度和吞吐:
平均完成时间:13.75 秒 → 9.70 秒
固定时间完成数量:9 个 → 19 个
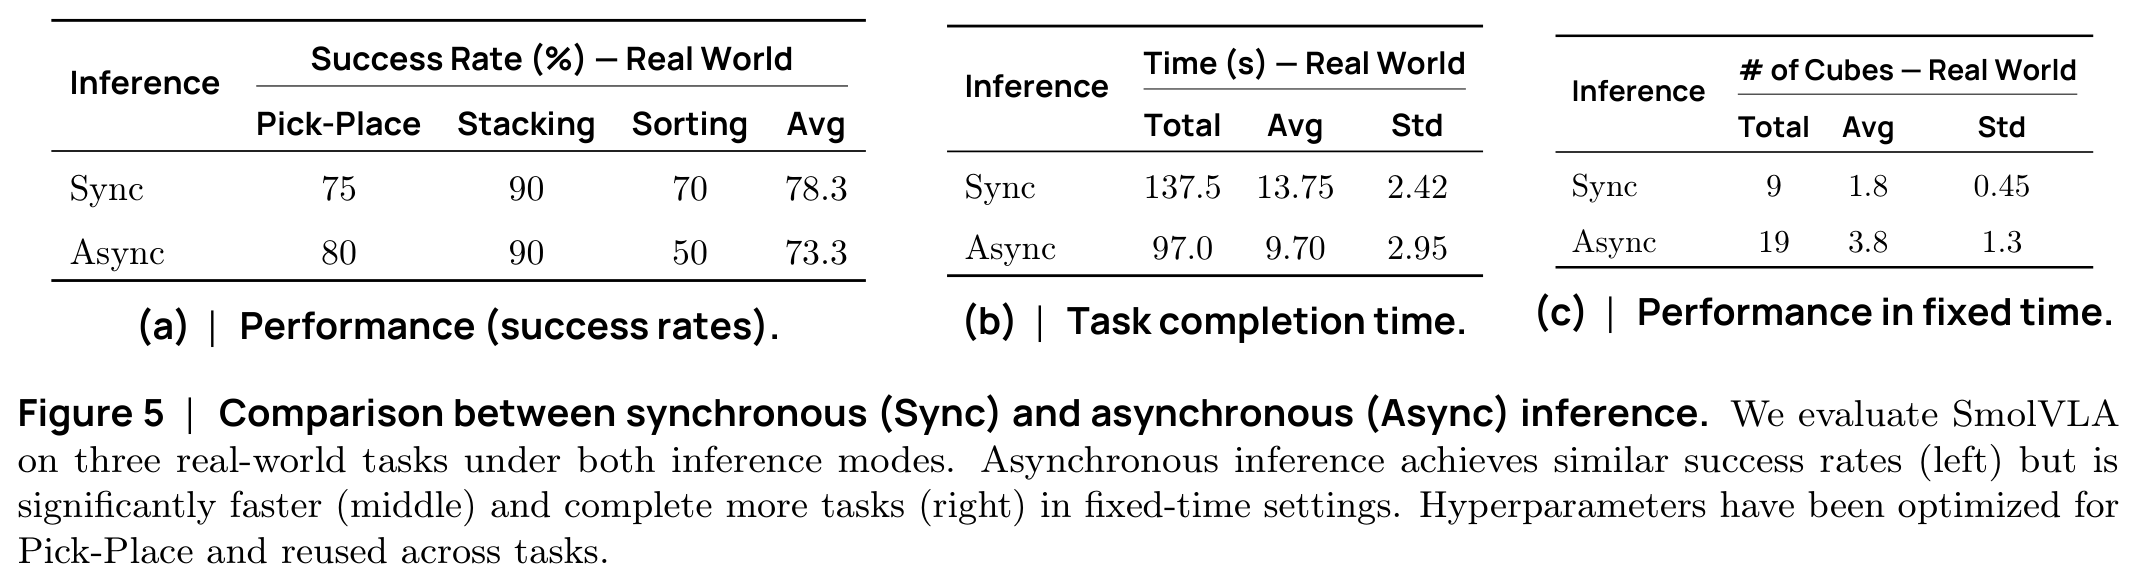
- Async 在平均成功率接近的情况下,完成 Pick-Place 约快 30%,固定时间内完成数量超过两倍。
消融实验
Cross-Attention 和 Self-Attention
| Attention | LIBERO 平均成功率 |
|---|---|
| Cross-Attention | 79.0 |
| Self-Attention | 74.5 |
| CA + SA 交替 | 85.5 |
- 只让动作读取 VLM 特征不够,只建模动作内部关系也不够。交替使用 CA 和 SA 的效果最好,说明“理解任务”和“保持动作连续”是互补的。
Causal Attention 和 Bidirectional Attention
| Mask | LIBERO 平均成功率 |
|---|---|
| Bidirectional | 67.5 |
| Causal | 74.5 |
- 禁止 Action Token 看到未来动作后,性能反而更高。这说明动作序列需要明确的时间方向。
Flow Matching 和直接回归
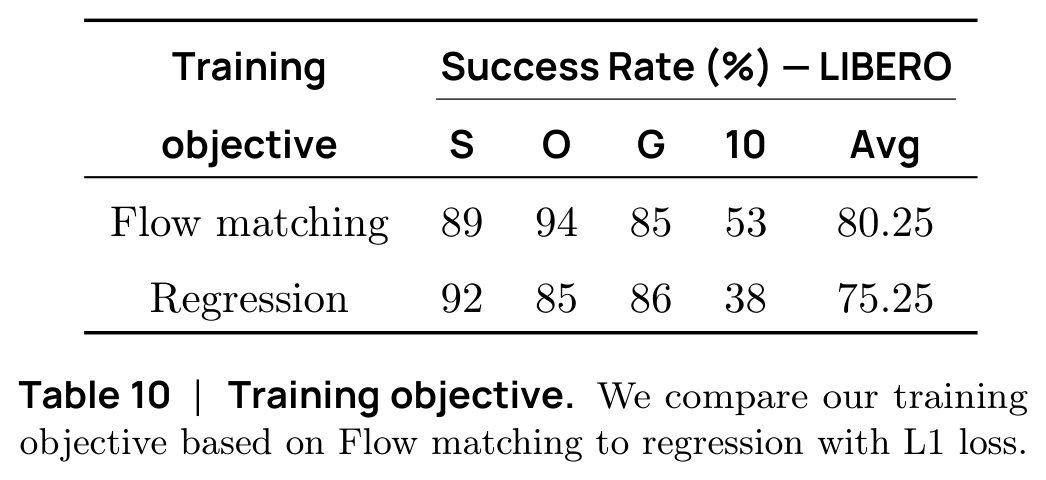
-
Flow Matching 的主要优势出现在 Long-Horizon 任务,成功率从 38 提升到 53。
-
这支持作者的判断:生成式目标更适合复杂、多模态的动作分布。
State 应该放在哪里
作者比较两种方法:
-
Suffix:State 直接送给 Action Expert
-
Prefix:State 先进入 VLM
在 Cross-Attention 设置下,Prefix 平均成功率为 80.3,Suffix 为 73.3。因此最终模型让 State 与视觉和语言一起进入 VLM。
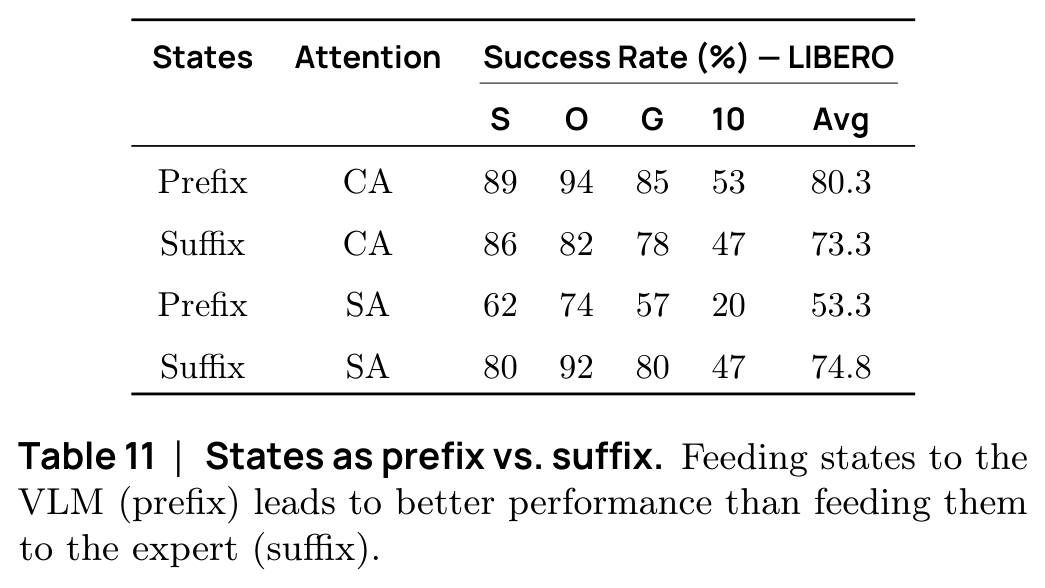
需要注意,表中纯 Self-Attention 变体没有呈现同样趋势。这项消融更准确的结论是:在作者最终采用的 VLM 条件化设计中,把 State 放进 VLM 更有效,而不是所有 Attention 结构下 Prefix 都必然更好。
Action Chunk 多长最好
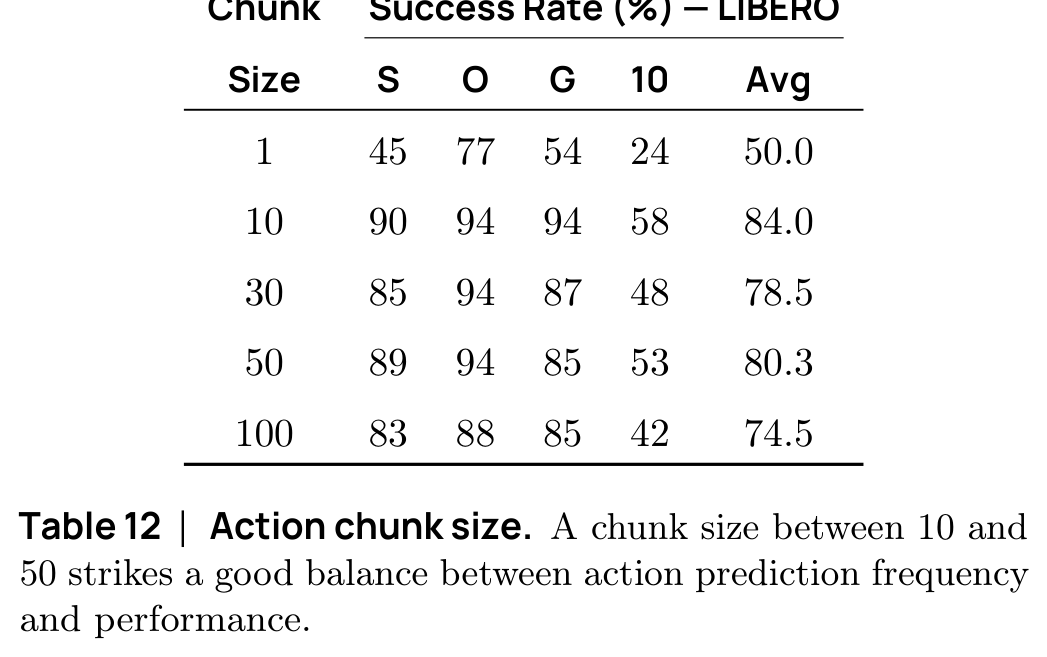
-
Chunk 太短时,模型不能充分利用动作序列结构;Chunk 太长时,预测难度增加,也更容易变成过长的开环控制。
-
论文认为 10 到 50 是较好的平衡区间,而不是越长越好。
预测 50 步不等于执行 50 步
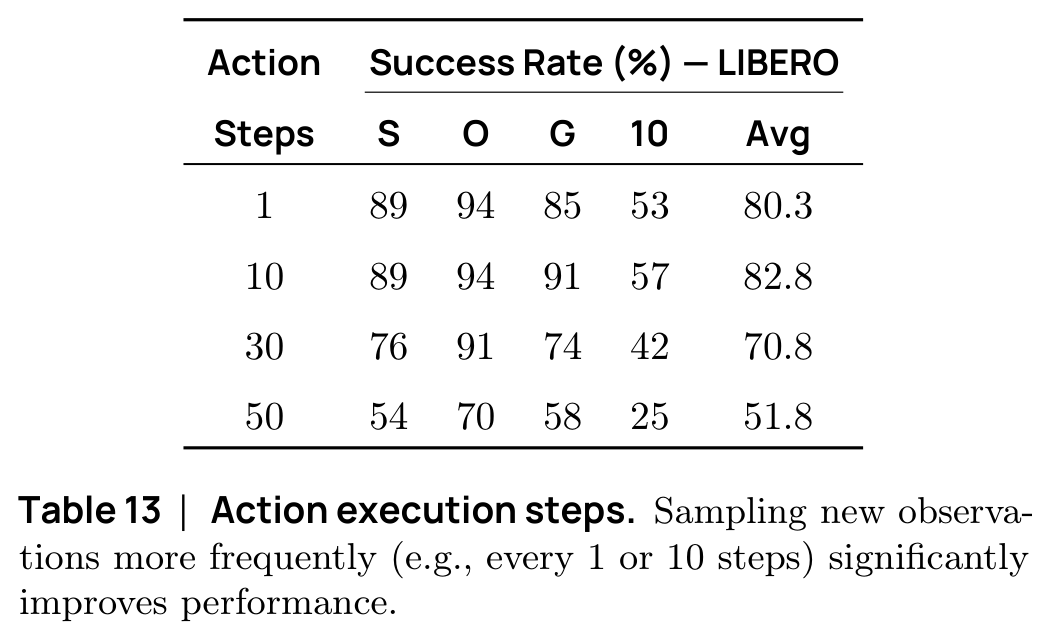
-
模型可以一次预测 50 步,但只执行 10 步就重新观察。这样既利用 Action Chunk 的连续性,又保持环境反馈。
-
如果把 50 步全部执行完再观察,平均成功率只有 51.8。
-
这也解释了为什么异步推理重要:系统既希望频繁观察,又不希望机器人停下来等模型。
局限性
-
机器人类型仍然单一。 社区预训练数据主要来自 SO100。论文证明模型可以微调到 SO101,但还没有完成真正的大规模 Cross-Embodiment Pretraining。
-
数据规模仍然小。 SmolVLA 使用约 2.3 万条轨迹,而 OpenVLA 等模型可以使用接近 100 万条轨迹。扩大社区数据规模后是否还能保持效率,需要进一步验证。
-
VLM Backbone 不一定最适合机器人。 SmolVLM-2 的预训练能力很大一部分来自文档阅读和 OCR,它是否最适合空间关系、物体可供性和真实交互,仍然是开放问题。
-
真实任务仍然较短。 Pick、Place、Stack 和 Sort 与真正的长时程任务还有明显差距。更复杂任务可能需要 Hierarchical Policy 或 Multi-level Planning。
-
主要依赖模仿学习。 模型仍然受示范数据覆盖范围限制。作者认为未来可以结合 Reinforcement Learning,提高长时程任务和灵巧操作能力。
总结