VLA-JEPA:从视频学习潜在动作
VLA-JEPA: Enhancing Vision-Language-Action Model with Latent World Model
- 人类视频预训练
- 潜在世界模型
- 流匹配动作头
- 扰动鲁棒性
人类视频能展示“把苹果放进碗里”,却没有某台机械臂的控制指令。VLA-JEPA 的思路是:先从视频学物体怎样变化,再用机器人示范学怎样执行。 世界模型把这两类学习连接起来。
预备知识
理解本文,先分清三种量。以苹果放碗为例:
- 世界状态特征 :画面里有什么、物体处于什么状态,由视频编码器提取。
- 潜在动作 :帮助模型预测状态变化的隐藏特征,例如帮助预测苹果从桌面移动到碗上方;它没有预先规定的物理单位。
- 机器人动作 :真正交给控制器的数值,例如末端移动量、旋转量和夹爪命令。
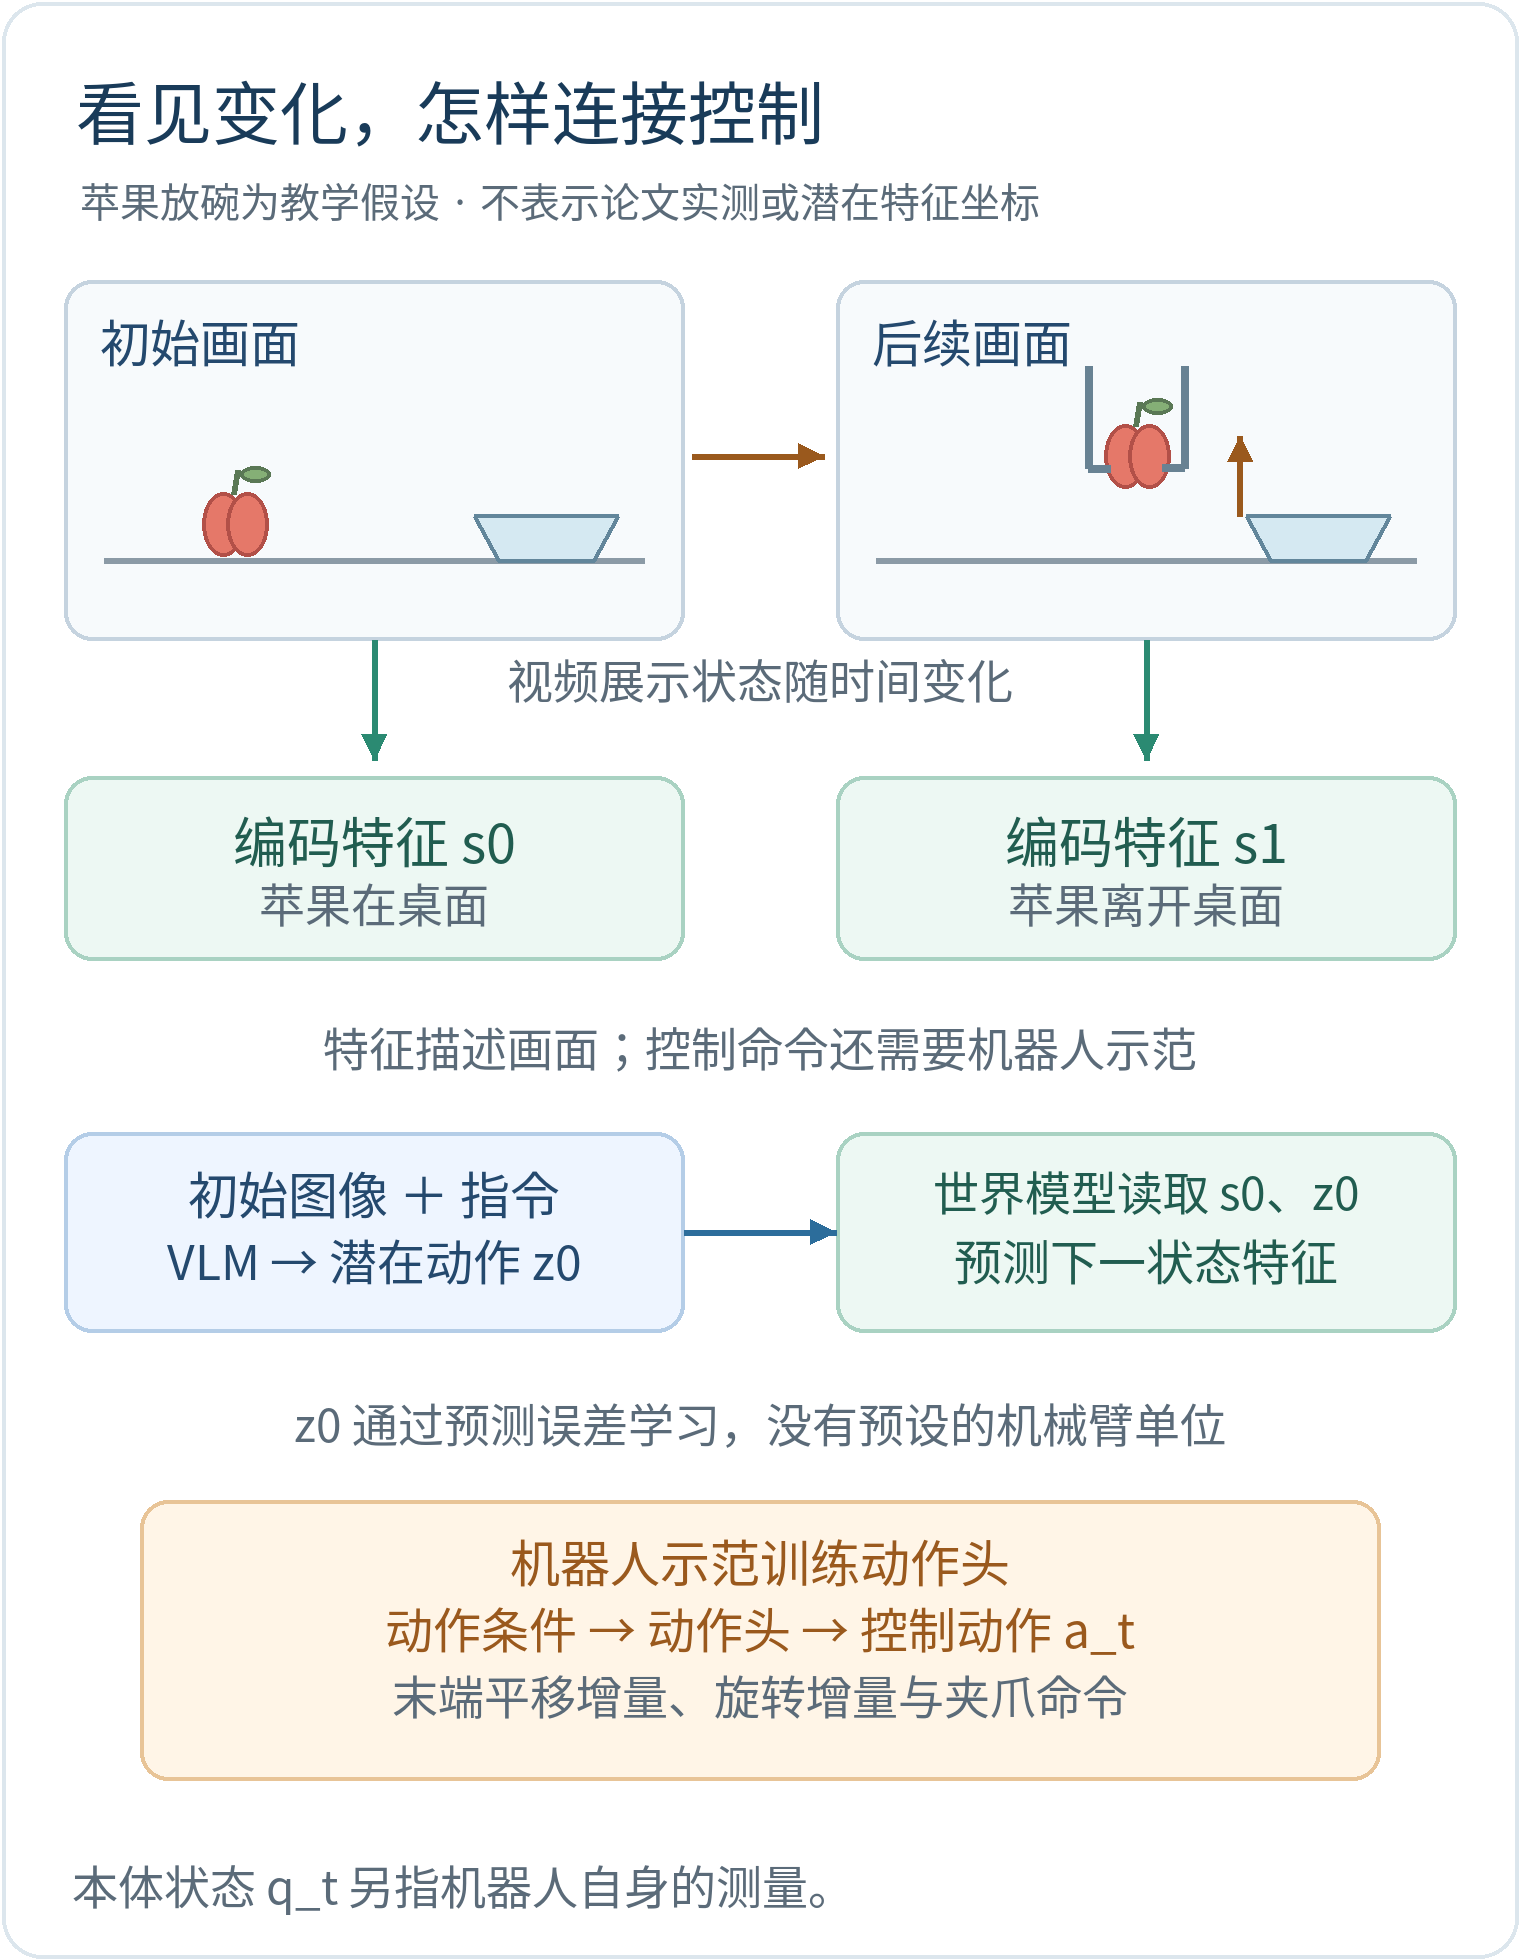
JEPA(联合嵌入预测架构)在特征空间预测未来。它不要求重画每个像素,而是比较“预测的未来特征”和“真实未来画面的特征”。VLA-JEPA 借助这个目标,让视觉语言模型(VLM)学习与操作有关的变化。
摘要
意译: 用互联网视频预训练视觉-语言-动作模型(VLA),可以减轻机器人数据不足的问题。但既有潜在动作方法容易学到外观变化、无关运动,或利用未来画面走捷径。论文提出 VLA-JEPA:由当前观测和语言产生潜在动作,再预测未来状态特征;未来画面提供监督,不直接输入产生潜在动作的 VLM。经过视频与机器人数据联合预训练,再适配下游任务,模型在仿真和实机测试中取得了有竞争力的结果。
批注: 这里的“无动作标签”针对人类视频。视频教模型理解变化,机器人示范仍负责教它输出控制值。后面的消融也表明,视频带来的收益主要体现在扰动鲁棒性,并非所有任务都提高。
引言与相关工作
先看数据问题。 机器人示范收集昂贵,人类视频丰富,因而作者希望把视频中的操作经验用于机器人学习(原文第 1 节)。但“视频多”还不够:预测像素可能过分关注纹理、光照和相机运动,未必学到控制需要的状态变化。
再看监督问题。 如果提取潜在动作的模块同时看到当前和未来画面,它可能直接编码未来答案;先提取潜在动作、再让策略对齐它,还会增加训练阶段。作者因此同时改变预测目标与信息入口:预测未来特征,潜在动作只从初始观测产生。
原文第 2 节主要讨论两类相关工作:一类是 RT 系列等依赖带动作标签示范的 VLA;另一类是 LAPA、UniVLA、MotoGPT 等先从视频提取潜在动作、再连接机器人控制的方法。VLA-JEPA 的选择,是让状态预测误差直接训练产生潜在动作的 VLM,并让机器人动作监督训练同一骨干。 这构成其统一预训练过程,之后仍需下游微调。
VLA-JEPA 怎样从视频学动作
整体网络
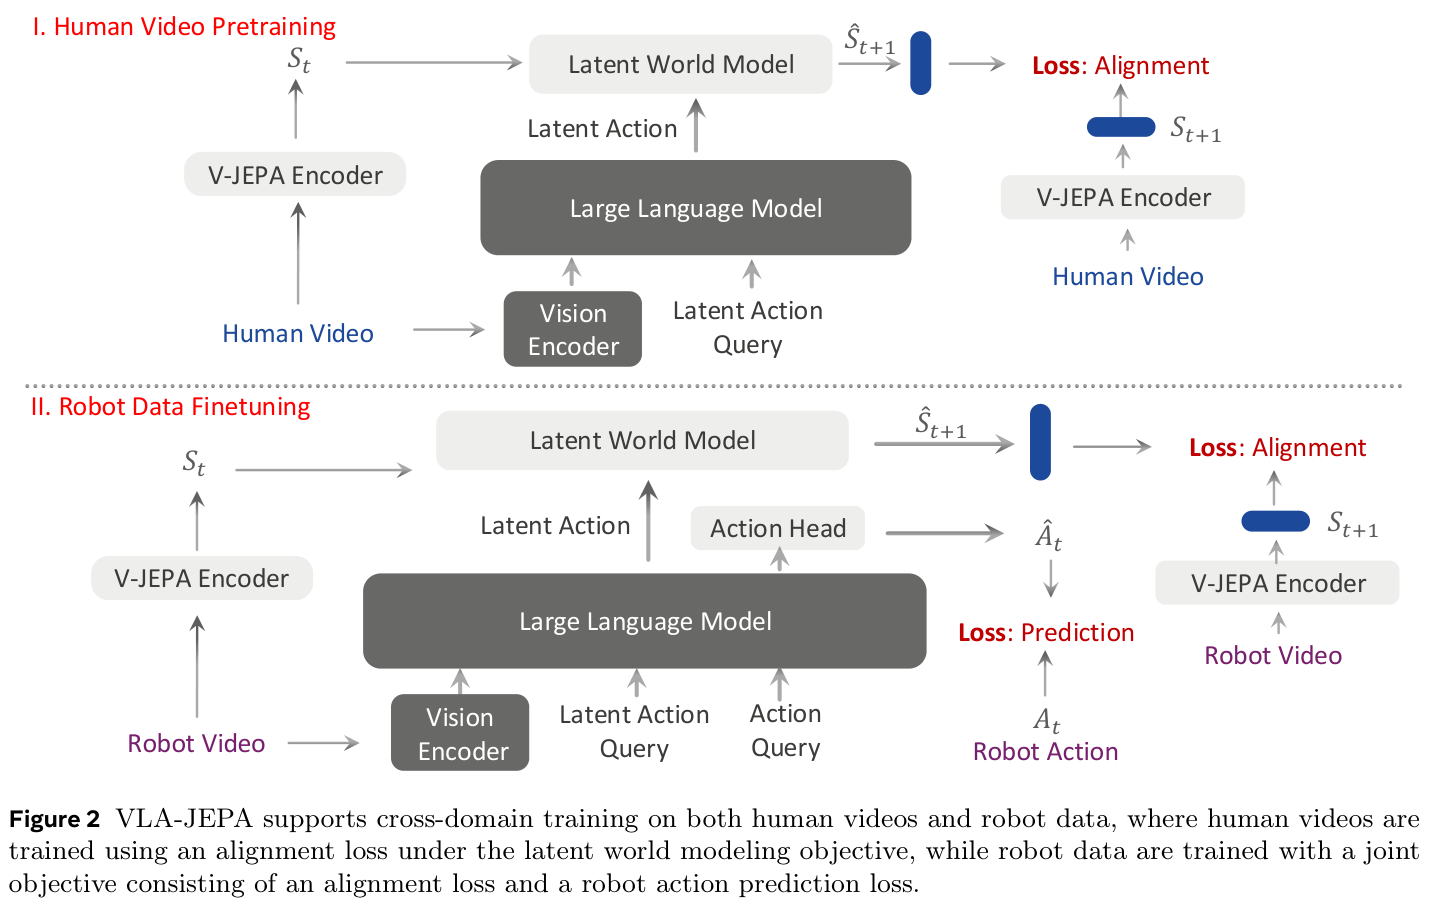
图中的四个模块各做一件事:Qwen3-VL-2B 读取当前图像和指令,产生潜在动作与动作条件;冻结的 V-JEPA2 把视频变成状态特征;世界模型预测后续状态;动作头生成机器人控制序列。
上半部分用人类视频训练状态预测,下半部分用机器人数据同时训练状态预测与动作生成。两条路径共享 VLM,因此视频中的变化经验能够影响后续控制。
用状态预测训练潜在动作
先用固定编码器 提取各视角的特征,再沿特征维拼接(原文式(1)):
表示第 个视角在时间位置 的画面。按论文表 5 的接口,两路 特征拼成 :视觉 token 的数量不变,每个 token 汇合两路信息。
接着,在初始图像和语言后加入可学习的潜在动作查询。查询经过 VLM,得到 ;世界模型 根据历史状态和潜在动作预测下一状态。将原文式(2)—(3)简写为:
是语言指令, 是可学习的查询标记。所有潜在动作都依据同一初始观测计算,不分别读取对应的未来画面。训练使用教师强制:预测 时可以读取真实历史 ,预测 时则不能把 当输入。
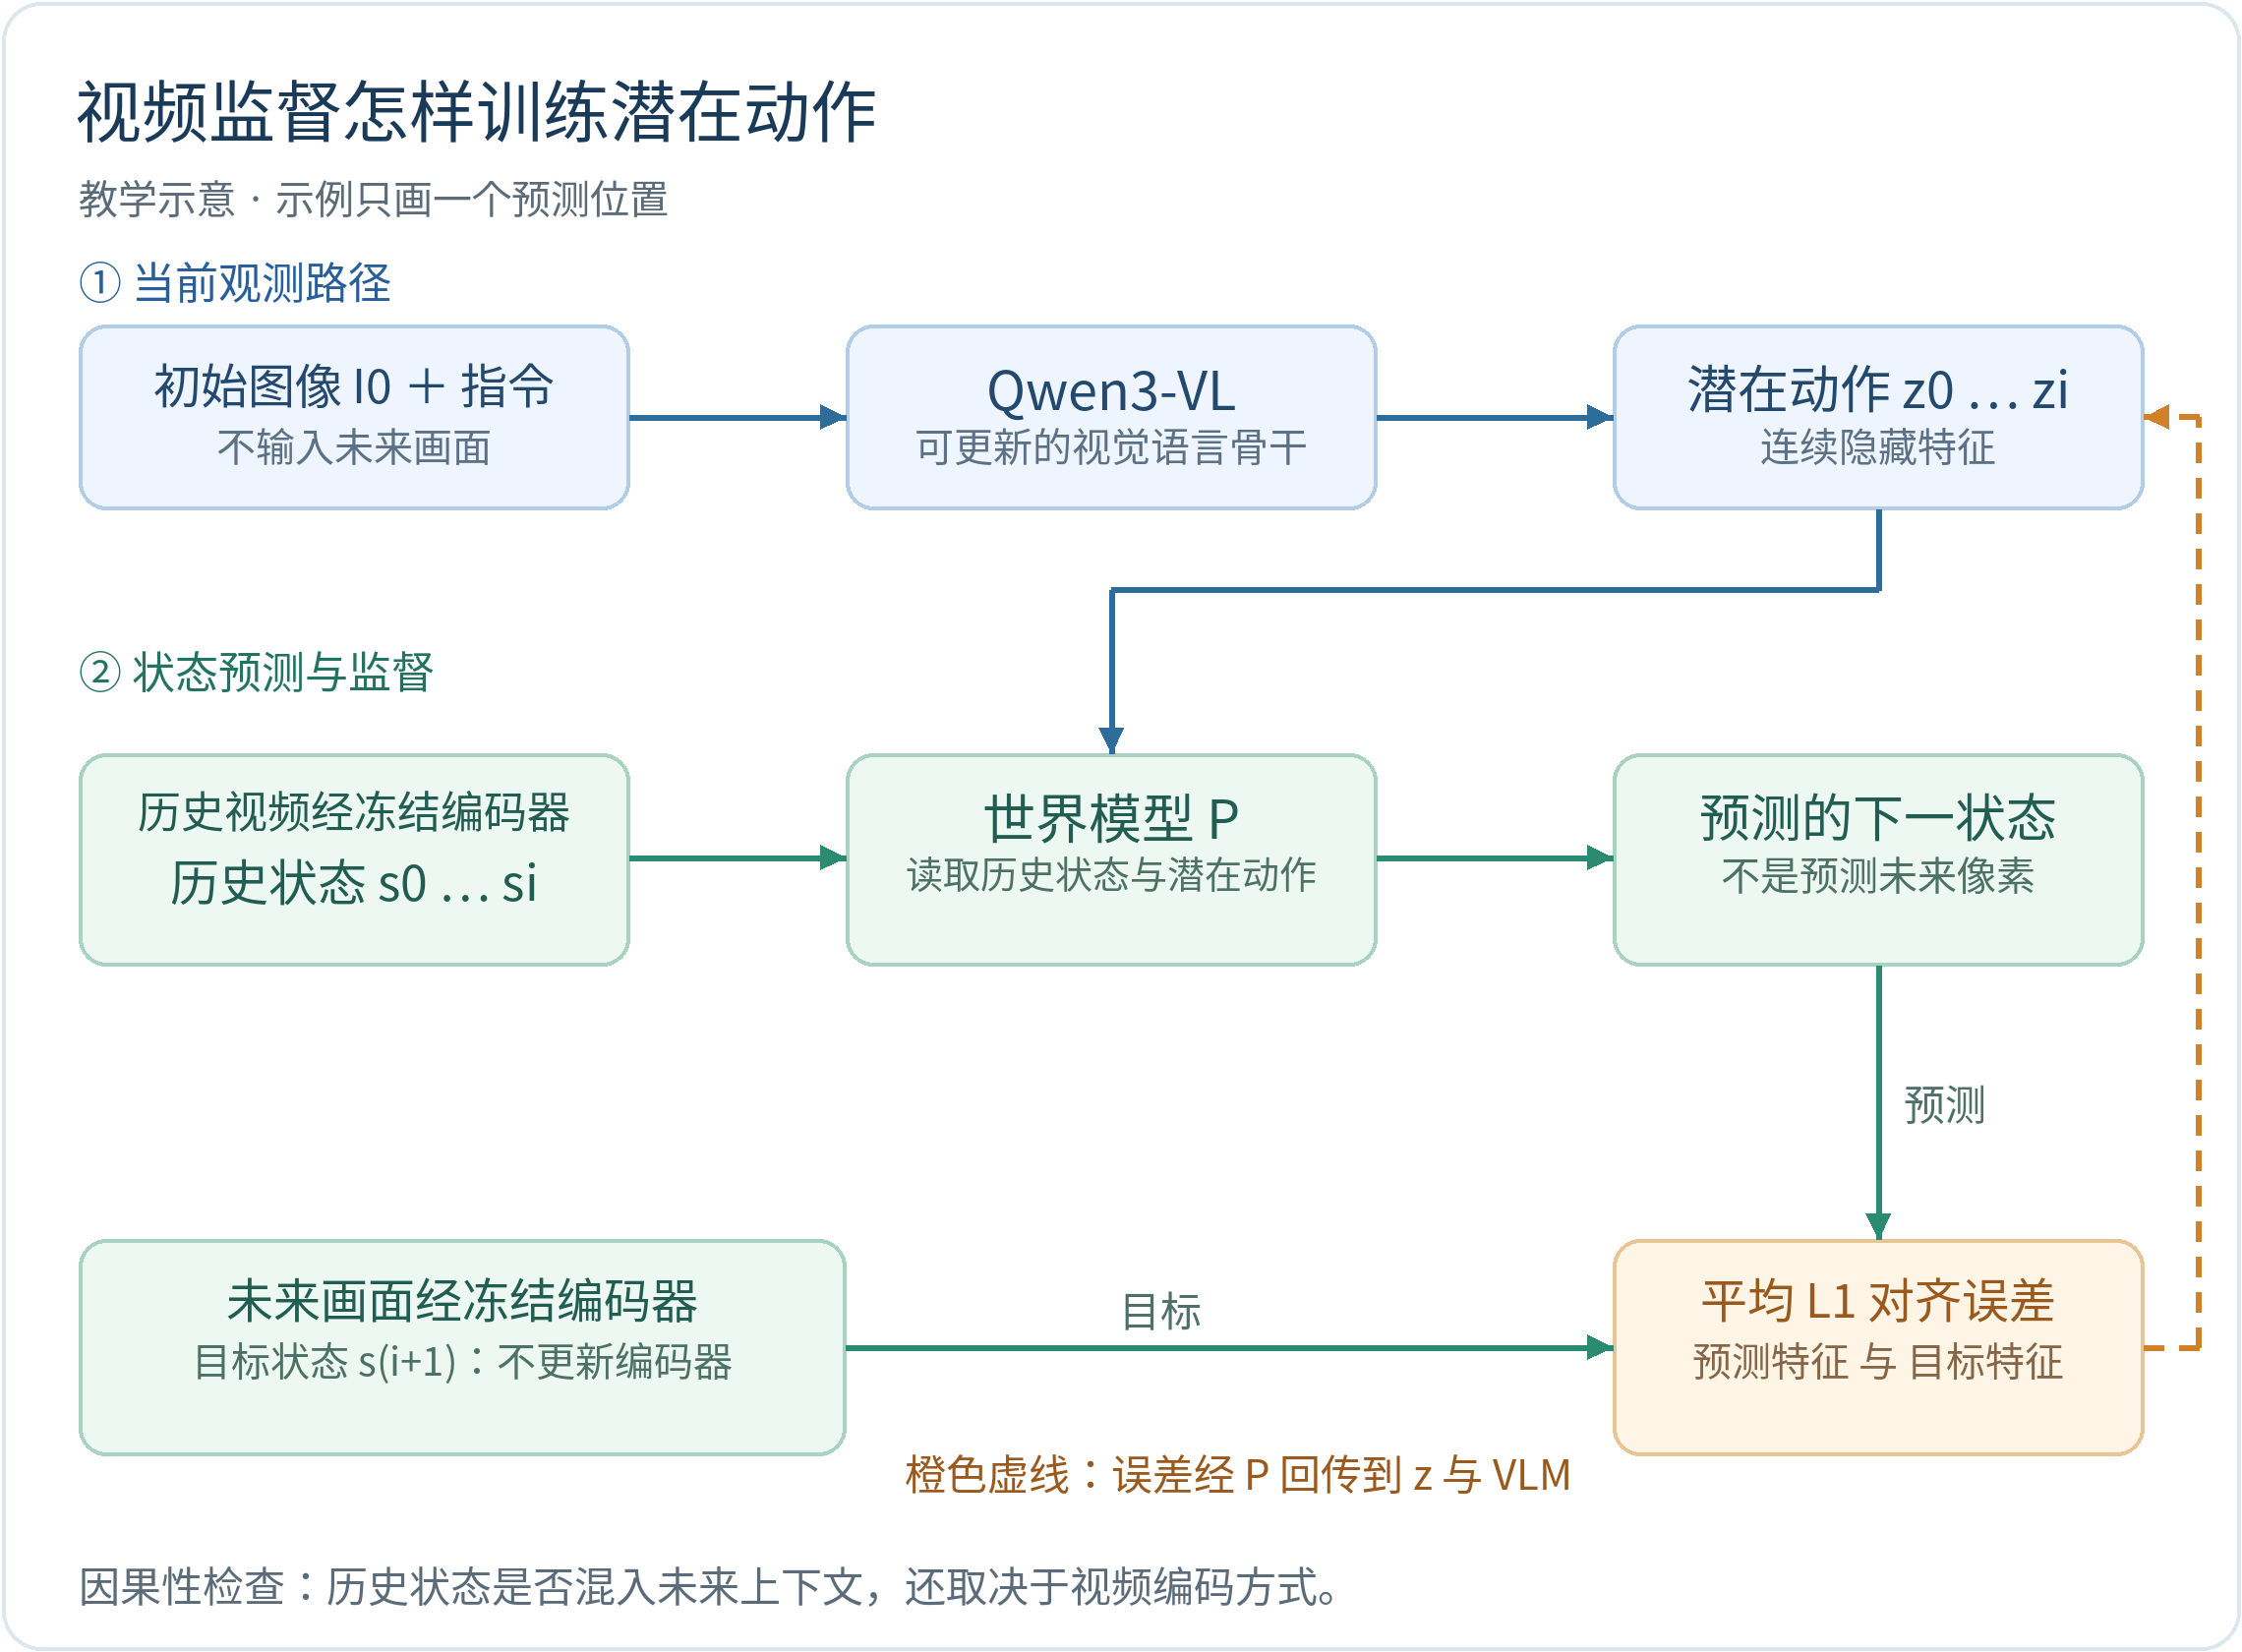
关键在误差怎样传回去。 未来画面经固定编码器得到目标。若预测不准,误差便经世界模型传回 VLM,促使潜在动作携带有助于预测变化的信息。例如要预测“苹果离开桌面”,潜在动作就需要帮助解释这次状态转移,而无需人为标注每个隐藏特征的含义。
作者实现采用平均 L1 误差。下面是其展开形式;原文式(5)本身没有明确误差范数:
汇集目标特征, 是元素数, 表示停止梯度,编码器不更新。教学例子中,目标为 、预测为 ,平均误差就是 。
这里限制的是未来图像进入 VLM 的路径;预测器的时间掩码本身,并不保证视频编码器的历史特征也严格因果。
从潜在动作到机器人动作
预测出状态特征后,还需要把表示接到控制。论文在潜在动作查询后加入另一组动作查询,读取前面的图像、语言与潜在动作,形成条件 (原文式(6))。它再送入 DiT(扩散 Transformer)动作头,生成一段连续动作。
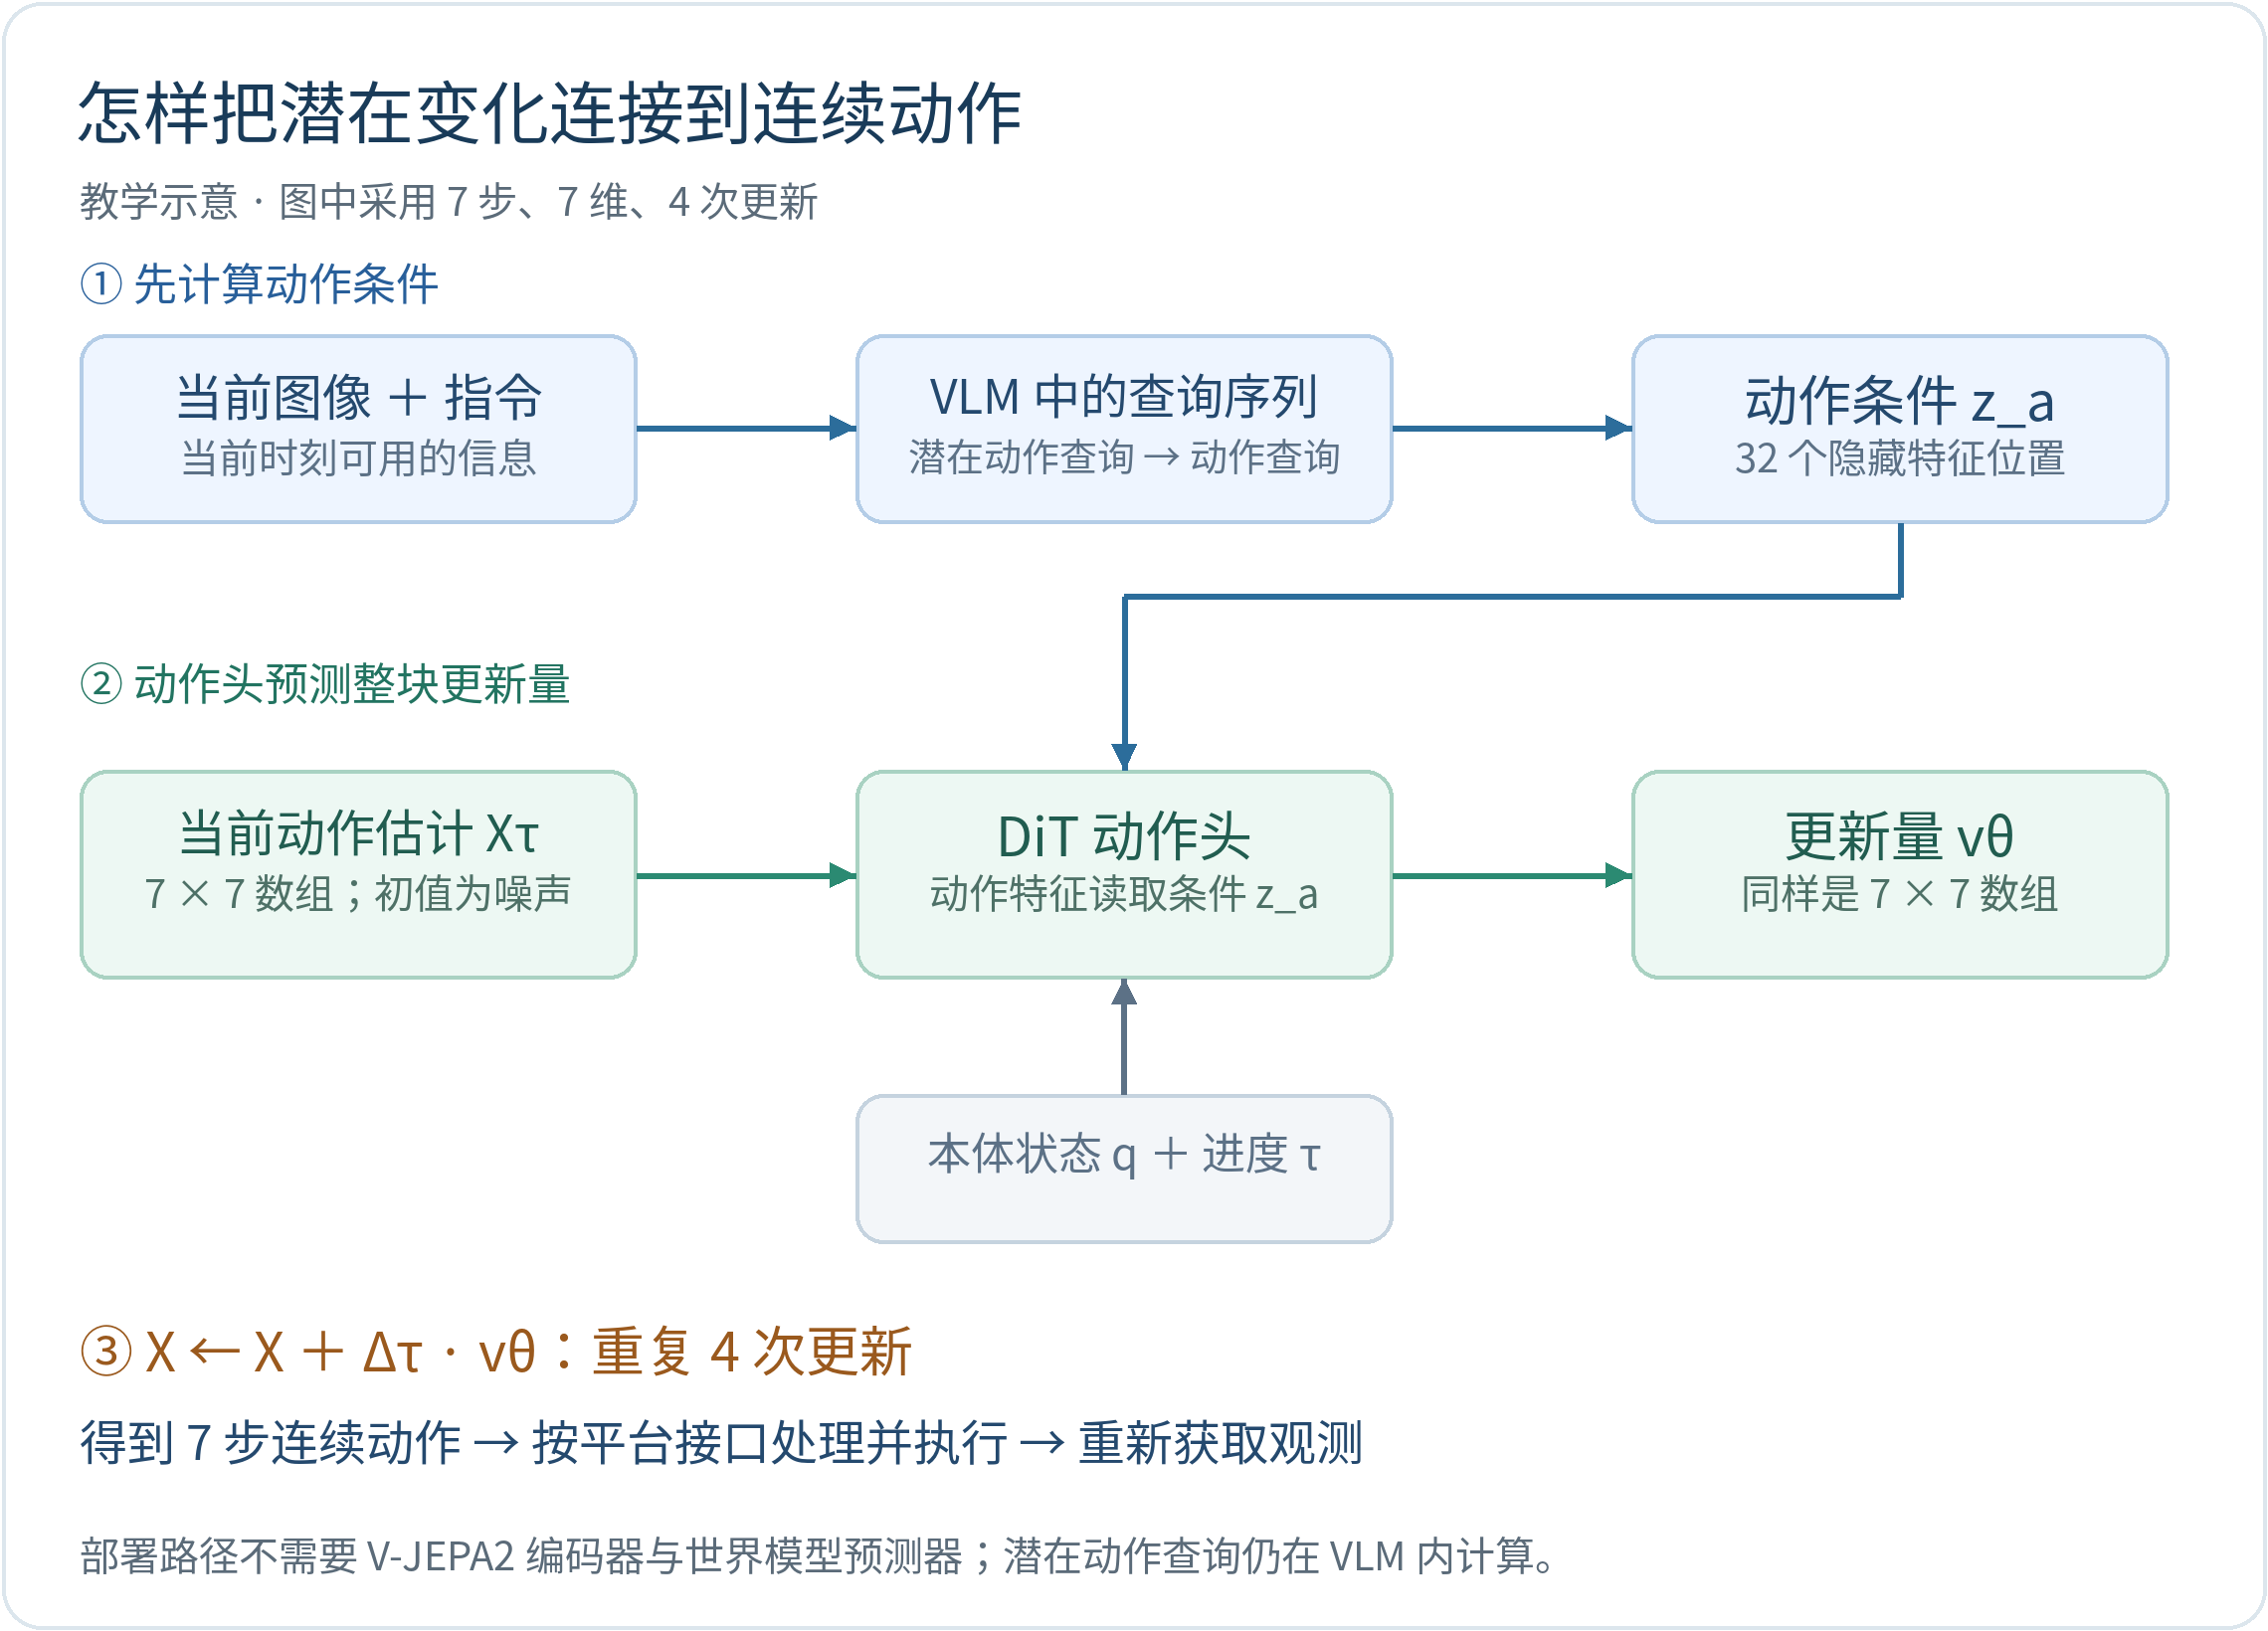
动作头使用条件流匹配:把真实动作块 与同形状高斯噪声 混合,训练网络预测从噪声走向动作的方向。原文式(7)—(8)可写为:
是生成进度,与机器人时刻不同; 输出与动作块同形状的更新量。只看一个元素,若 、、,中间值为 0.2,目标方向为 0.8;预测方向若为 0.5,平方误差为 0.09。
推理从新噪声开始,按预测方向更新;固定实现采用 Euler 步骤:
模型用 4 次更新生成 的动作块,即 7 步、每步 7 维控制量。这 4 次是动作头内部计算,不是机器人执行 4 步。固定实现还把本体状态和生成进度送入动作头,通过交叉注意力读取 ;论文采用均匀时间采样,固定实现采用 Beta 采样,两者属于训练配置差异。
训练与推理
论文用约 22 万个 Something-Something-v2 人类视频和 7.6 万条 DROID 机器人轨迹联合预训练。人类视频只有画面与语言,训练状态预测;机器人数据还有动作标签,联合优化(原文式(9)):
控制两种损失的权重;作者实现与文末固定版本 LeRobot 均取 0.1。预训练共 5 万步,之后从该检查点分别进行仿真任务训练(3 万步)和实机微调(2 万步),不把两个分支串成同一条训练流程。
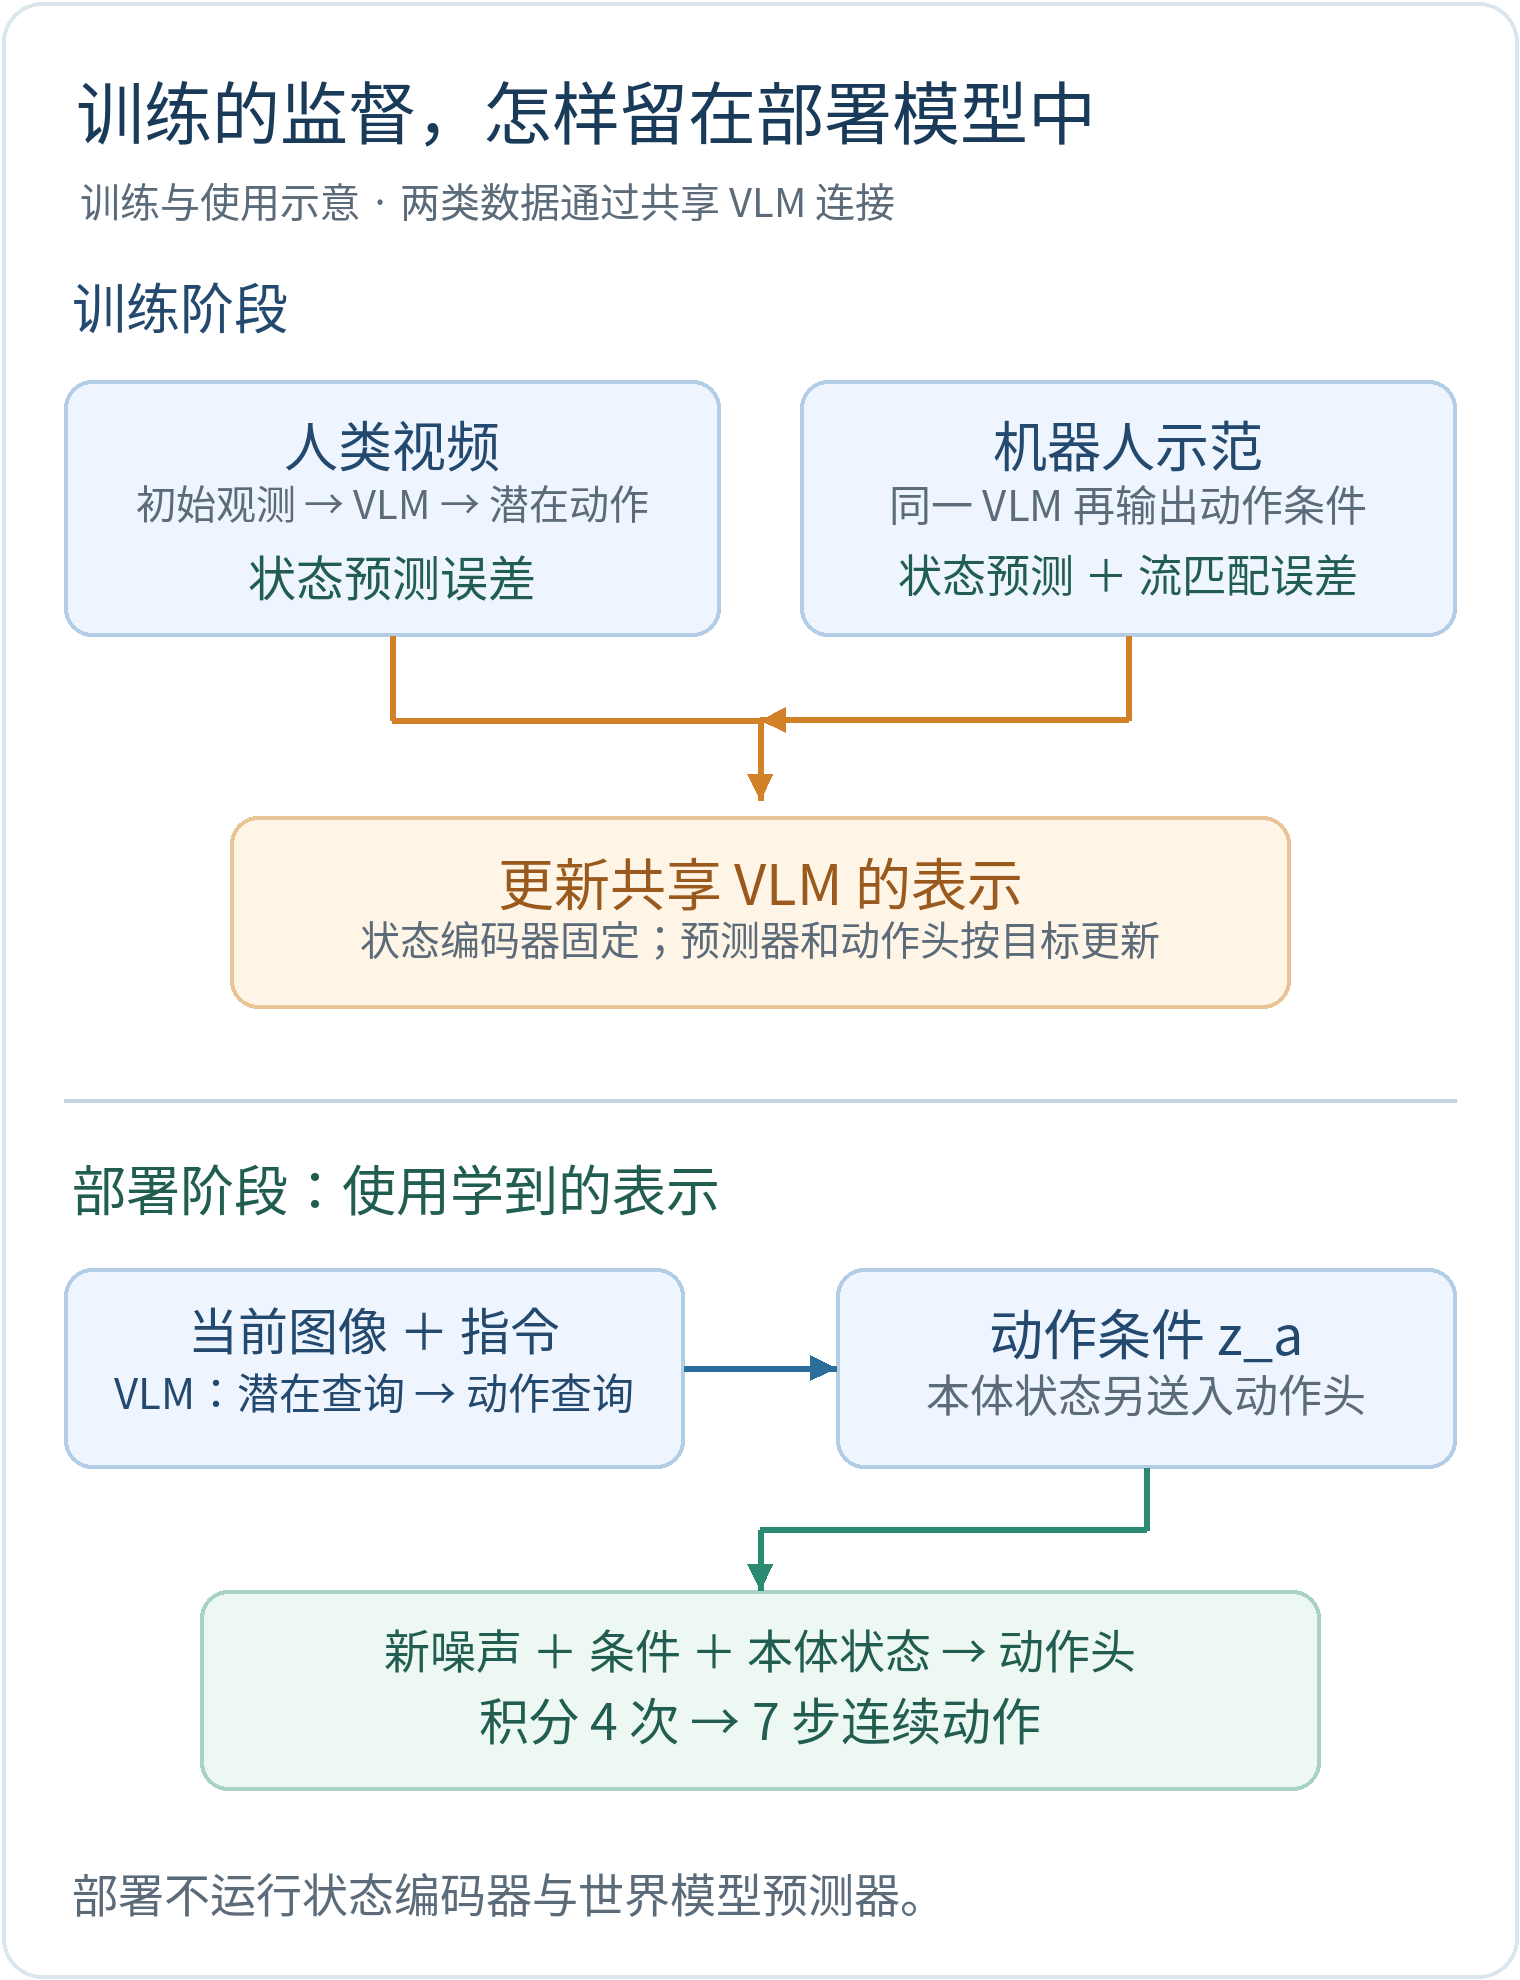
训练时,视频编码器提供历史与目标,世界模型的预测误差训练 VLM;机器人示范再提供控制监督。部署时,只输入当前图像、指令及动作头所需状态,保留 VLM 的潜在动作计算与动作头,不运行视频编码器和世界模型预测器。生成动作块后,控制系统执行,再根据新观测继续预测。
因此,世界模型主要是一位训练时的“老师”:它让模型学到的表示更有助于解释变化,部署时并不通过搜索未来视频来选择动作。
实验结果
标准任务与扰动测试
LIBERO 使用专家示范微调,四套任务各有 10 个任务,每任务测试 50 次,共 2000 次。表 1 比较完整方法,也在末两行给出人类视频消融:
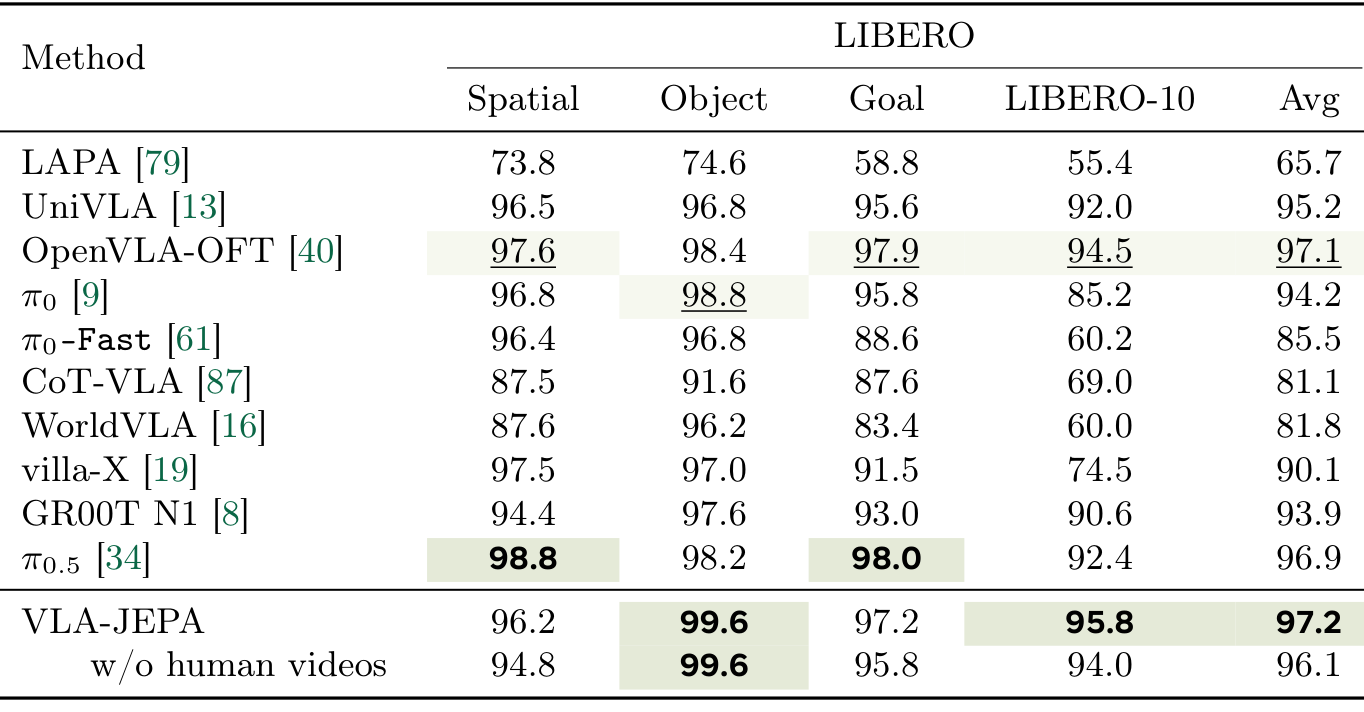
平均成功率为 97.2%,去掉人类视频后为 96.1%。完整模型高于表中其他方法,但与 OpenVLA-OFT 的 97.1% 很接近,主表也没有独立训练的误差条,不宜放大小幅差距。
LIBERO-Plus 在原有任务上增加七类扰动,训练仍用原始 LIBERO 数据:
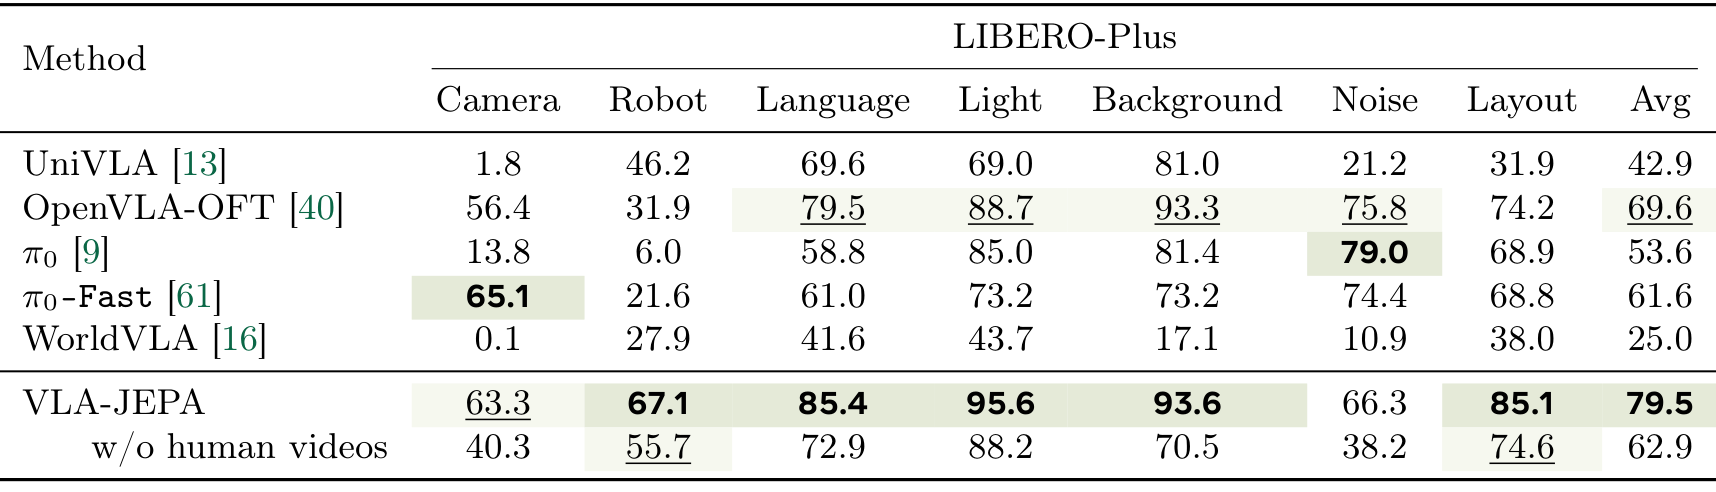
加入人类视频后,平均成功率从 62.9% 升到 79.5%,七类扰动均改善。相比标准任务的 1.1 个百分点,这里提高了 16.6 个百分点,说明视频监督在应对干扰时更有帮助。
迁移与实机表现
SimplerEnv 测试真实机器人数据训练的策略向仿真的迁移:
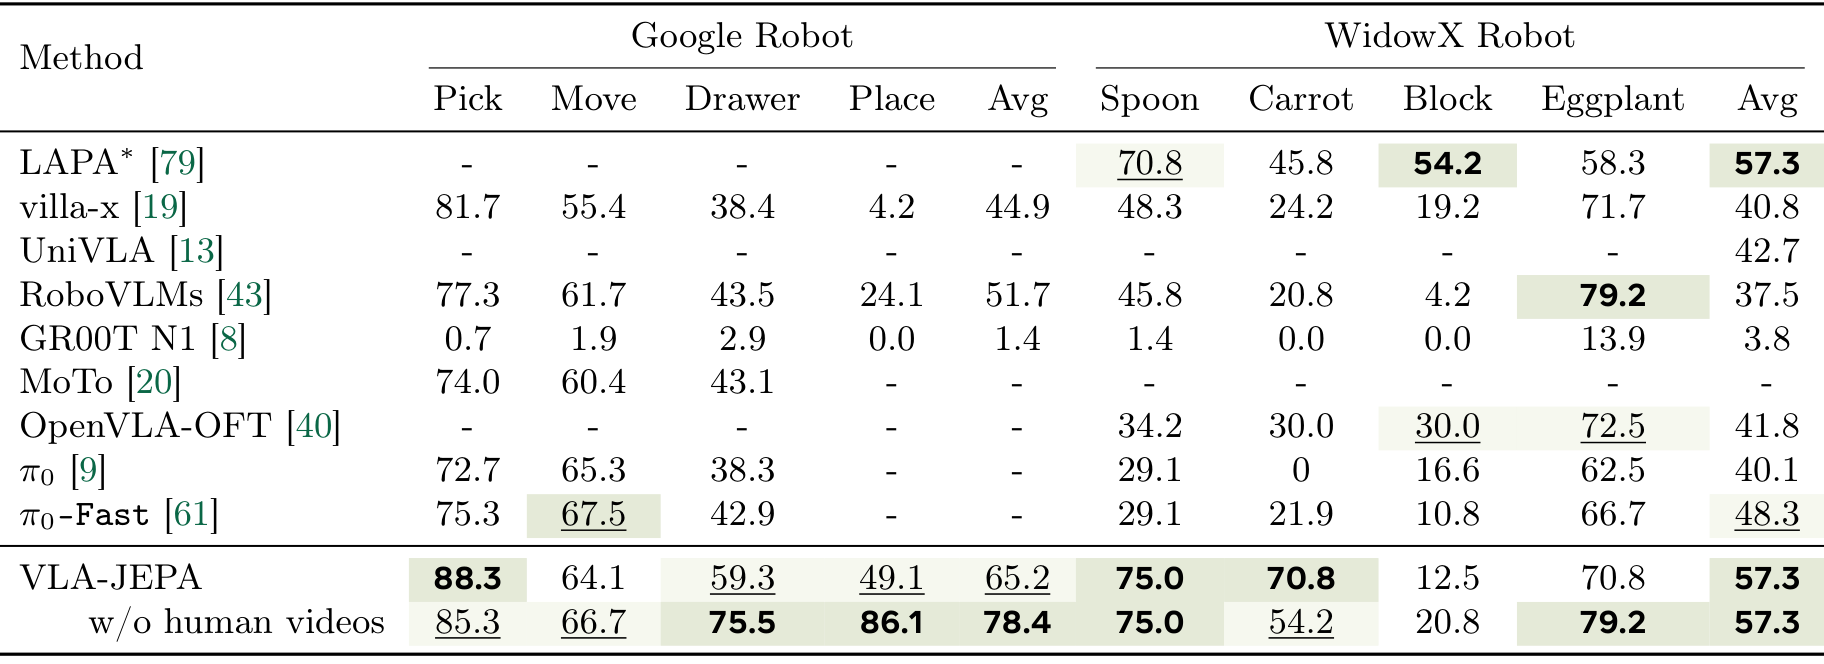
结果并非全面提高:加入人类视频后,Google Robot 平均成功率从 78.4% 降至 65.2%,WidowX 平均均为 57.3%。视频经验不能替代具体控制所需的机器人示范。表中部分基线平均值与正文排名不一致,因此这里只据模型消融判断视频的作用。
实机使用 Franka Research 3、Robotiq 夹爪和三台 D435 相机,各任务测试 10 次。结果见图 4:
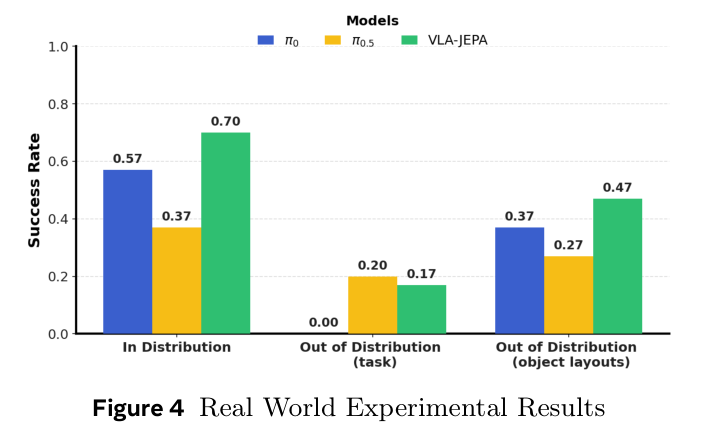
VLA-JEPA 在同分布和布局变化下的成功率分别为 0.70、0.47,领先两个对照;未见任务为 0.17,低于 π0.5 的 0.20。三个模型都未完成“把葡萄放到未见过的架子顶层”,VLA-JEPA 也会抓错目标。
这些实验支持整体方案的竞争力,以及人类视频对扰动鲁棒性的帮助;它们没有分别隔离 JEPA 目标、信息入口和训练阶段各自的贡献。
结论
VLA-JEPA 把视频里的状态变化,变成训练机器人表示的监督信号。 潜在动作负责解释变化,动作头负责输出控制,机器人示范把两者接起来。值得借鉴的是这种监督设计;它改善了所测扰动下的表现,但尚未解决稳定执行和未见任务泛化的问题。