训练第一个 ACT 策略
三个关键配置:Batch Size、Learning Rate、Steps
在终端上输入nvidia-smi可以查看自己的显卡和显存,消费级显卡(如3050)也能训
Batch Size(批量大小):显存富裕可以调大加速收敛,但不要超过你的显存余量去硬撑。
| 配置 | 情况 |
|---|---|
| 8 GB 显存及以下 | 可以训,batch size 用小值,如显存是8GB,batch size可设置为4训练,显存是4GB,batch size可设置为2训练。 |
| 12GB显存以上 | 舒适区,可以使用默认batch size训练,如果显存足够多可以设置batch size=16 |
| 只有核显 / 没有 N 卡 | 用云服务器训 |
Learning Rate(学习率):
每次更新的"步子"大小。ACT 自带预设:AdamW 优化器、学习率 1e-5、weight decay 1e-4、视觉骨干网络单独 1e-5。lerobot-train 默认启用策略预设(use_policy_training_preset),这些值会自动生效,你什么都不用写。步子太大,loss 震荡甚至发散;太小,训练慢一倍。第一次训练不要动它——这是原论文和大量实践调好的值。
-
对于修改了Batch Size,Steps都推荐不需要修改学习率
-
若是从已经训练的checkpoint 进行微调续训,可以将学习率调整至
1e-6~3e-6(降 3–10 倍) -
train loss 几乎不降(平滑贴死),先别升学习率,先加 steps / 加数据,仍不动再试
2e-5可加入以下代码,两条指令一起改、改成一样的--policy.optimizer_lr=1e-6 \
--policy.optimizer_lr_backbone=1e-6
Training Steps(训练步数):
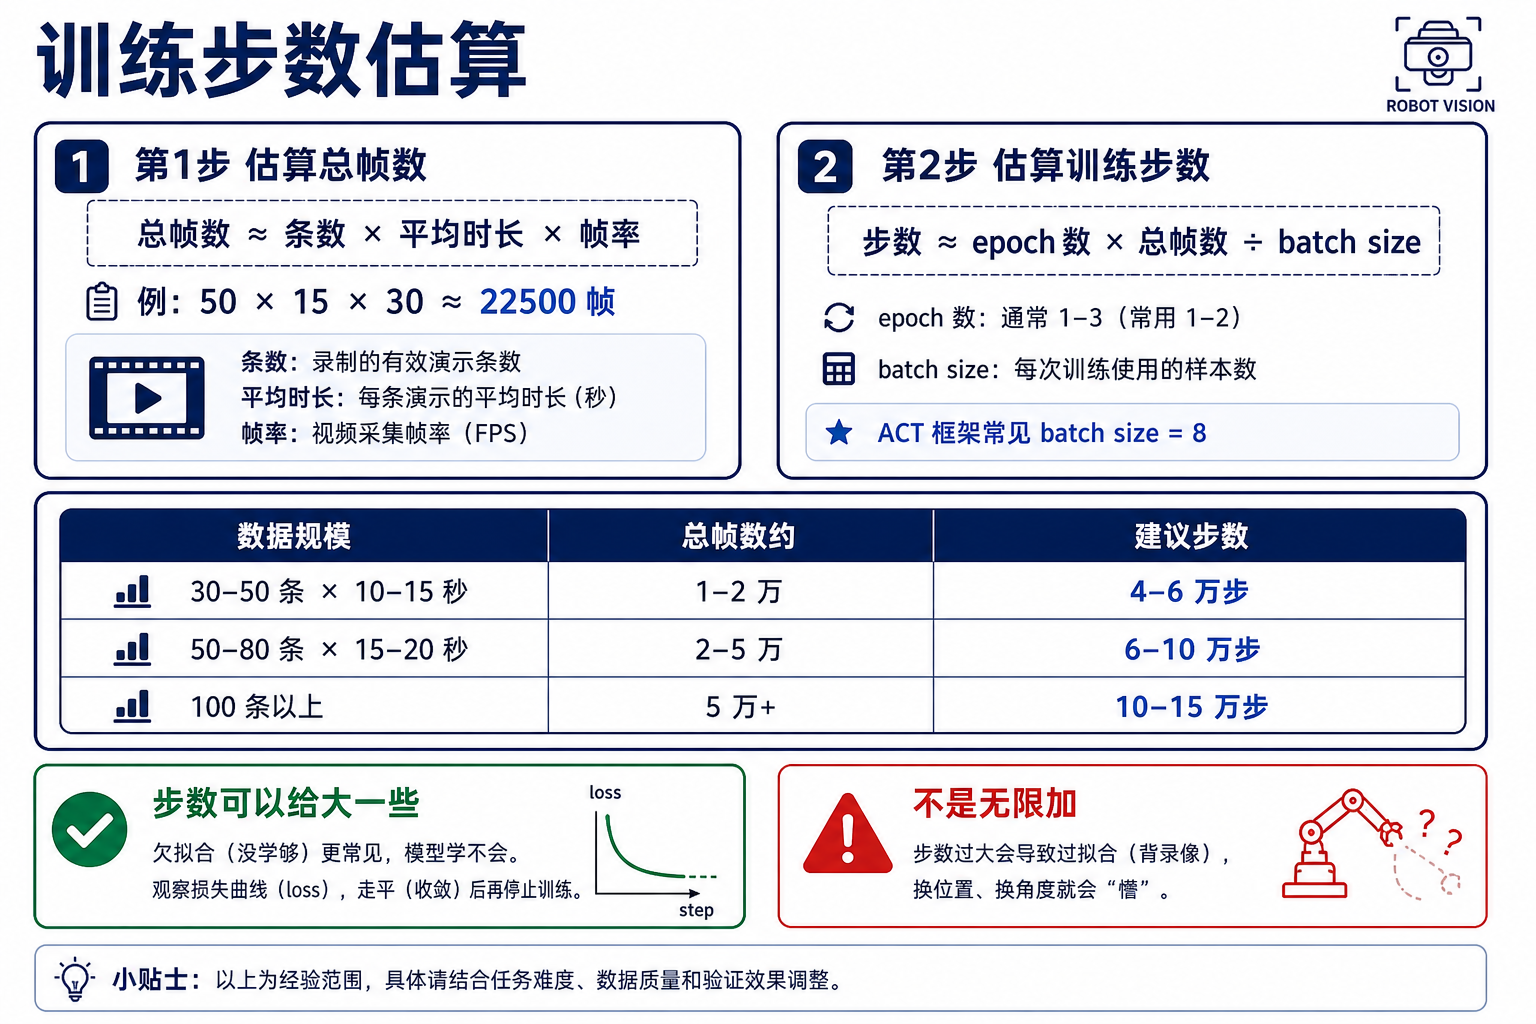
对 50 条数据,如果你不想看下面关于步数的讲解,直接按按80,000 跑(50 条数据)。
步数要按比例加:
如果batch size 减半,每步"看"到的样本就减半,想让模型把数据看够同样的遍数(epoch),步数就要翻倍。例如默认设置batch size=8,steps=80000,如若batch size=4,steps需要等于160000,batch size=2,steps就 × 4,batch size=16,steps就 ÷ 2。
当然你也可以设置更多的步数,因为在训练过程中我们可以使用Ctrl+C直接中断训练,可以根据loss等参数选择当前是否需要中断训练,同时会自动保存相应已经生成的模型。
- 总帧数 ≈ 录像的总长度;
- epoch(一轮) = 学生把录像从头到尾完整看一遍;
- 步数 = 他总共看了多少小段。
保存和管理 Checkpoint
不用手动保存:训练每 20,000 步(save_freq)自动存一个 checkpoint,训练结束还会存一份最后的。产物结构,所以说我们将步数设置过大也没有问题,因为我们可以选择步数较低训练出来的模型,丢弃其他训练不够或者过拟合的模型
outputs/train/act_grab_cube_v1/
├── train_config.json              ← 本次训练的完整配置(恢复训练要用它)
└── checkpoints/
    ├── 0020000/pretrained_model/  ← 各步数模型的存档
    ├── 0040000/pretrained_model/
    ├── ...
    └── last/pretrained_model/     ← 最后一个 checkpoint,第 17 章就用它
- 磁盘占用:每个 checkpoint 是一份完整模型权重,几十个 checkpoint 累积下来很可观。训练稳定后,早中期的小存档可以删,留
last和最近一两个即可; - 推理时
--policy.path指向的就是checkpoints/last/pretrained_model这个目录。
启动训练
检查全部通过,启动(在 conda 的 lerobot 环境里):
lerobot-train \
    --dataset.repo_id=seeed_rebot_b601_rs/test \
    --policy.type=act \
    --output_dir=outputs/train/act_rebot_test \
    --job_name=act_rebot_test \
    --policy.device=cuda \
    --wandb.enable=false \
    --policy.push_to_hub=false \
    --steps=100000
如果您是RTX50系列显卡,在训练时需要增加--dataset.video_backend=pyav部分,绕过 torchvision 预览版的 API 缺失。
显存不足或者想一次性设置多加的,可加--batch size设置批量大小
参数说明:
| 参数 | 含义 |
|---|---|
--dataset.repo_id | 第 13 章的数据集名(本地名直接填;Hub 上的填${HF_USER}/xxx) |
--policy.type=act | 策略类型,也可换 diffusion、smolvla 等,本阶段用 ACT |
--output_dir | 本次训练所有产物的存放目录 |
--job_name | 本次训练的名字,日志里用它区分不同 run |
--policy.device=cuda | 用 GPU 训练 |
--wandb.enable=false | 不开 wandb 在线看板(想用就注册后开,非必须) |
--policy.push_to_hub=false | 模型先不传 Hub,第 17 章评估满意再说 |
--steps | 训练步数 |
--batch size | 设置批量大小 |
时间预期:10 万步在消费级显卡上通常是几个小时的量级,具体看显卡和 batch size。
查看 Loss 和 GPU 状态
回车之后,终端开始滚动训练日志。LeRobot 每隔一段时间(默认每 200 步,由 --log_freq 控制)打印一行汇总,长这样:
step: 10000 smpl: 80K ep: 35.6 loss: 1.832 grdn: 12.4 lr: 1.0e-05 updt_s: 0.21 data_s: 0.003 eta: 3:42:10
字段逐个看(不同版本字段名可能略有出入):
| 字段 | 含义 | 看什么 |
|---|---|---|
step | 当前步数 | 对照--steps 看进度 |
ep | 已训练多少 epoch | 对应 16.5 的"看了几遍录像" |
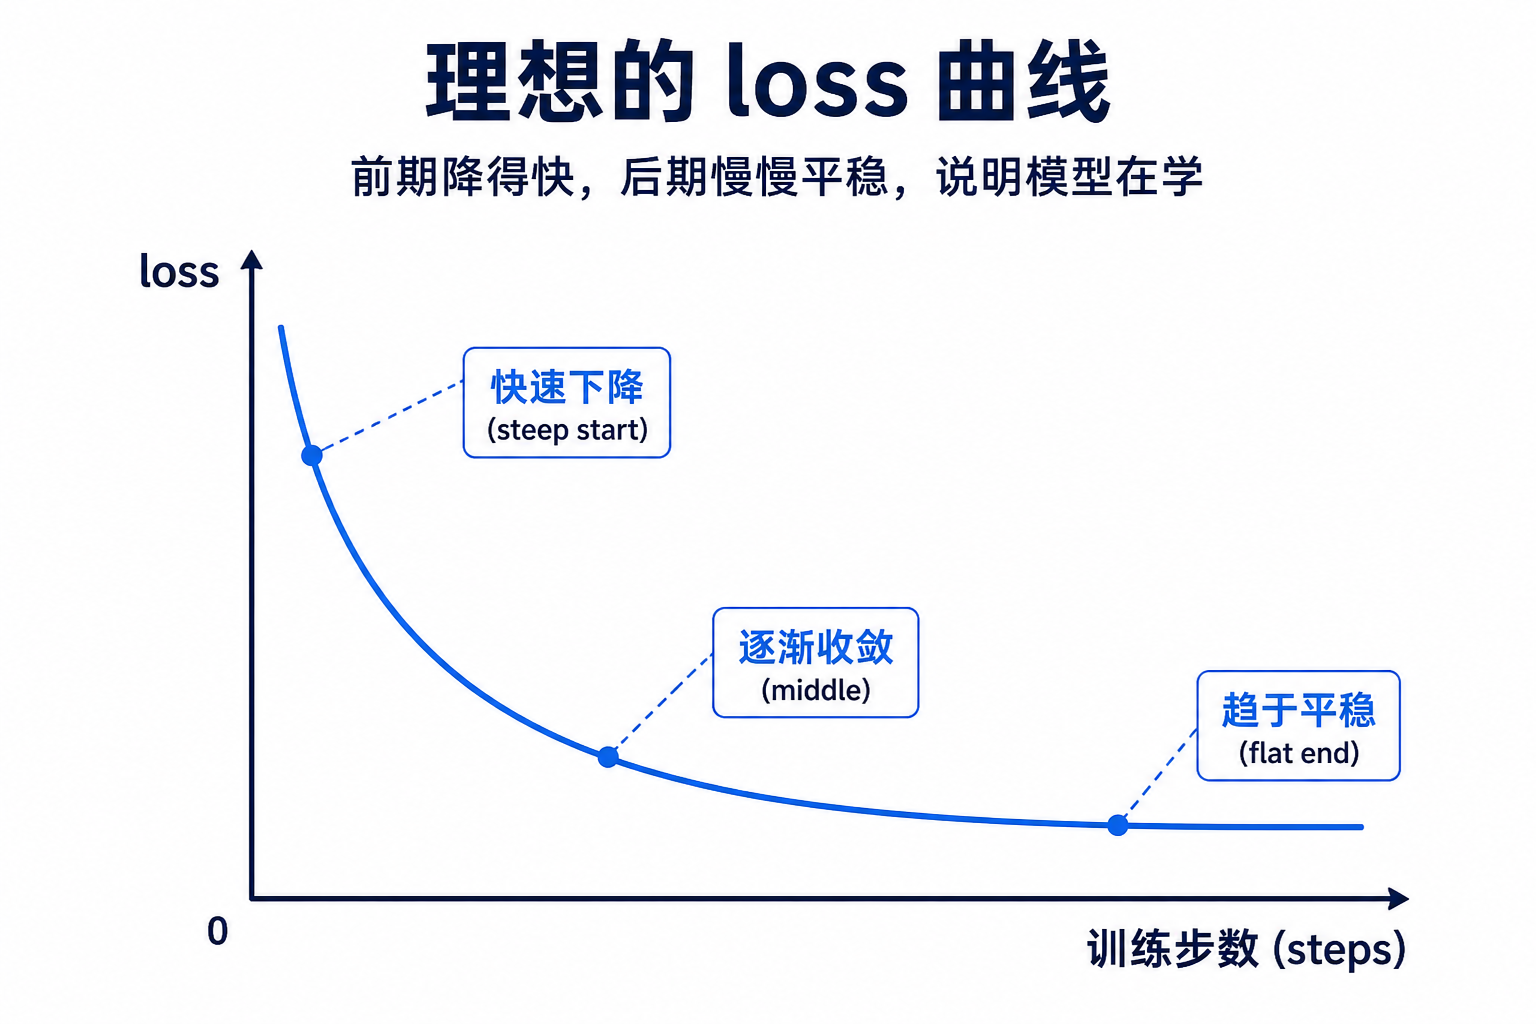
loss | 训练损失 | 前期快降、后期缓降、小幅波动是正常形状 |
grdn | 梯度范数 | 突然爆到几百上千,说明训练不稳 |
lr | 当前学习率 | 确认是预期值 |
updt_s / data_s | 每步更新/取数据耗时 | data_s 大说明数据加载拖后腿 |
eta | 预计剩余时间 | 安排去吃饭还是去睡觉 |
这些指标各自的正常走势,分三类:
- 应该一路下降的:
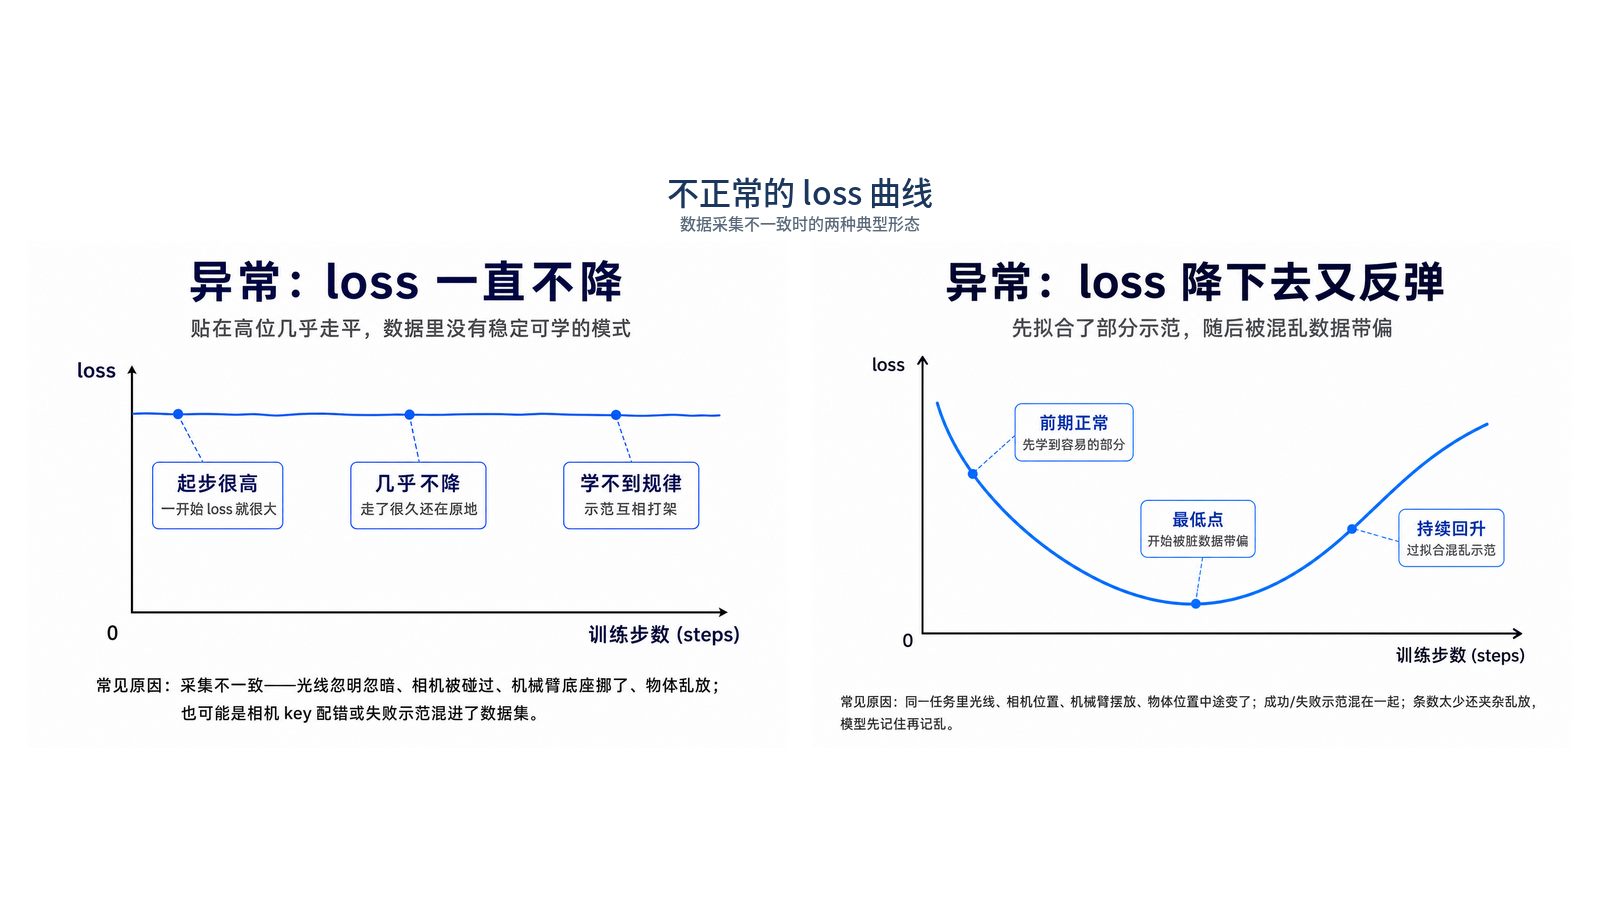
loss。 降的形态是三段式——初期陡降、中期缓降、后期在低位小幅波动、整体走平。这个"先快后慢、最后走平"的弧度就是健康的收敛曲线。两种异常形态要警惕:一直不降(数据或配置有问题,回 14\.6 查曲线、查相机 key);降下去又反弹回升(训练发散,学习率减半重训); - 应该整体收敛、允许抖动的:
grdn(梯度范数)。 大趋势跟随 loss 一起走低并稳定下来,但毛刺是正常的——偶尔一个尖峰能自己回来就没事;怕的是持续放大、一波比一波高,那是发散前兆,处理同上:降学习率; - 应该保持不变的:
lr、updt_s、data_s、GPU 利用率。lr全程等于你设的值,它只是供你确认;每步耗时(updt_s/data_s)和watch -n 1 nvidia-smi里的 GPU 利用率都应该平稳——利用率持续偏低或忽高忽低,说明 GPU 在等数据,瓶颈在数据加载而不在显卡。
恢复中断的训练
训练跑到一半断电、断网、手滑关了终端,不必从头再来——只要已经存过至少一个 checkpoint,也就是训练过已经训练过20000步了:
lerobot-train \
    --config_path=outputs/train/act_rebot_test/train_config.json \
    --resume=true
- 恢复以存档配置为准:续训时用的是
train_config.json里保存的配置,命令行再传参数也会被忽略。想改参数(比如换步数、换 batch size),就开一个新 run,别用 resume; - 从最近的 checkpoint 接着跑:优化器状态、步数计数都会还原,loss 曲线无缝衔接。