18. 多模态学习与 VLA 基础
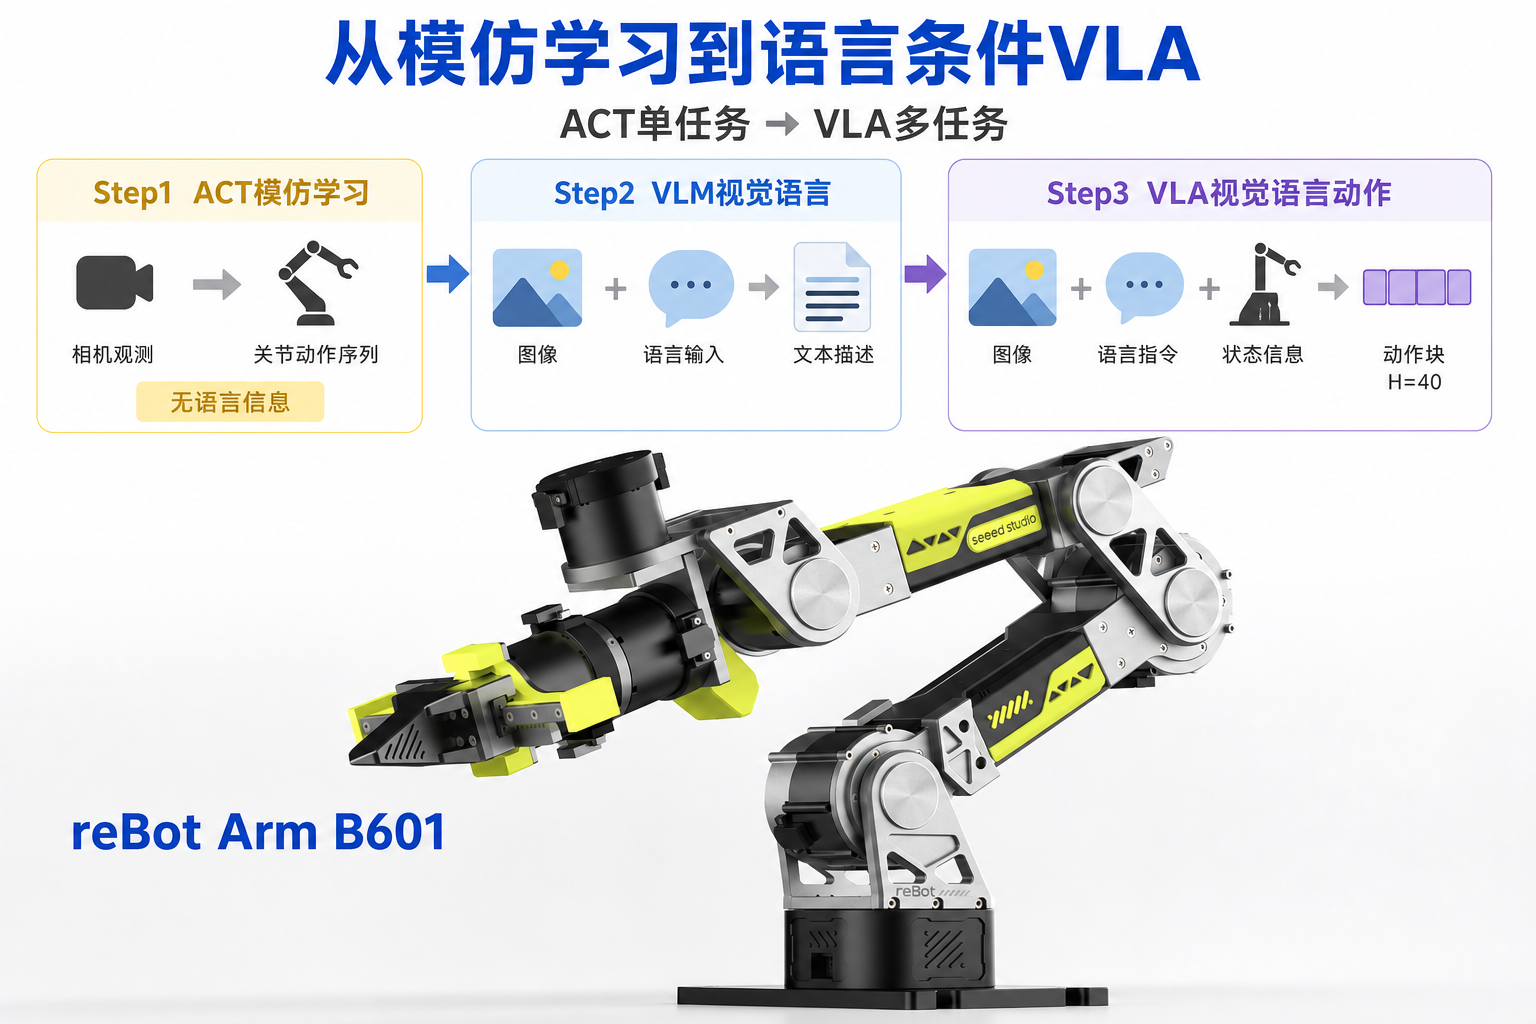
在前面的章节中,你已经用 ACT(Action Chunking with Transformers) 等策略,在 reBot Arm 上完成了「看图像 → 输出关节动作」的模仿学习。这类方法通常针对单一任务训练:模型只学会「把红色方块放进盒子」这一种行为,换任务就要重新采集数据、重新训练。
本阶段需要的硬件
本阶段需要准备的硬件如下。全部阶段的完整清单见 第 3 章。
主控单元
| 硬件 | 购买 | 数量 |
|---|---|---|
| Jetson Orin Nano Super 8G | 🛒 | 1 |
| reComputer Robotics J4012 | 🛒 | 1 |
| NVIDIA Jetson AGX Thor 128G | 🛒 | 1 |
另外还需要一台台式机或笔记本:Ubuntu 22.04、GTX 4080 以上(12G 显存以上)、16GB 以上内存。
本阶段
| 硬件 | 购买 | 数量 |
|---|---|---|
| reBot Arm B601 DM/RS | 🛒 | 1 |
| reBot Arm 102 Leader臂 | 🛒 | 1 |
| 720P单目腕部相机 | 🛒 | 1 |
| 1080P海康 | 🛒 | 1 |
| 腕部相机支架 | — | 1 |
| 海康相机俯拍支架 | 🛒 | 1 |
在前面的章节中,你已经用 ACT(Action Chunking with Transformers) 等策略,在 reBot Arm 上完成了「看图像 → 输出关节动作」的模仿学习。这类方法通常针对单一任务训练:模型只学会「把红色方块放进盒子」这一种行为,换任务就要重新采集数据、重新训练。
本章引入 VLA(Vision-Language-Action) 的核心思想:让机器人不仅能「看」,还能「听懂」自然语言指令,并在多种任务之间共享同一个策略网络。
什么是多模态模型
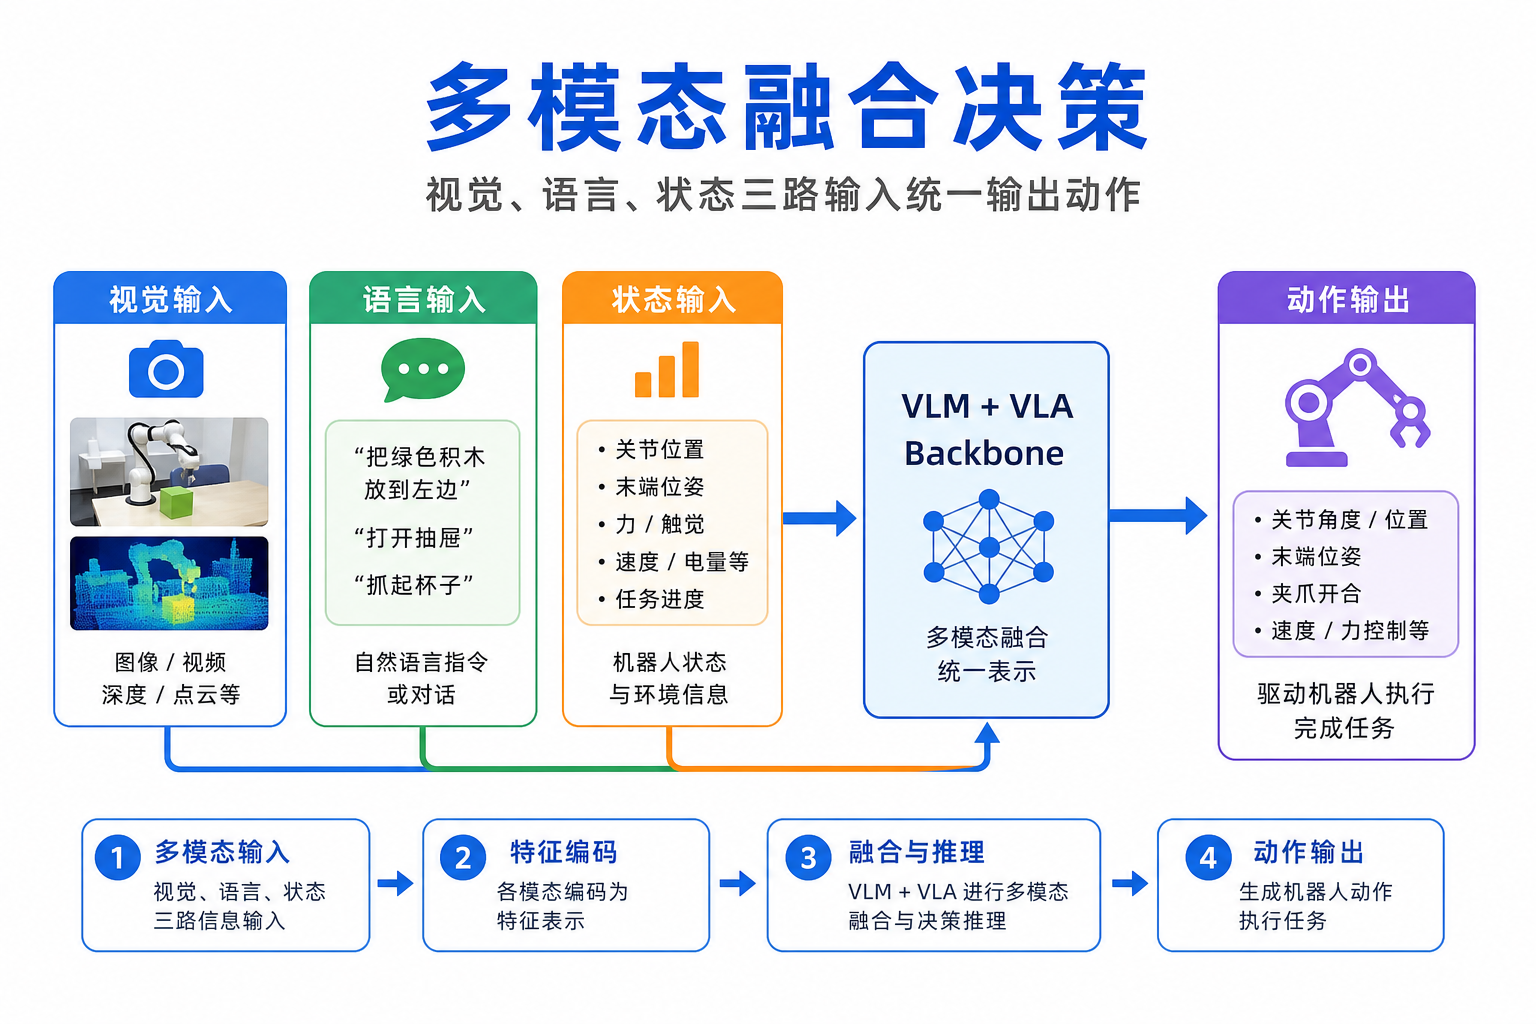
多模态(Multimodal) 指模型同时处理两种及以上信息来源。对人类来说,做「把杯子递给我」这件事,你会同时用到:
- 视觉:杯子在哪、手伸到哪里
- 语言:「递给我」是什么意思、目标对象是什么
- 本体感觉(Proprioception):自己手臂当前在哪个姿态
多模态模型的目标,是把来自不同模态的信号映射到同一个语义空间,再据此做出决策。在机器人领域,这意味着:同一张桌面场景图 + 不同语言指令,可以对应不同的抓取或放置动作。
┌─────────────┐   ┌─────────────┐   ┌─────────────┐
│   图像观测   │   │  语言指令    │   │  关节状态    │
│  (Vision)   │   │ (Language)  │   │  (State)    │
└──────┬──────┘   └──────┬──────┘   └──────┬──────┘
       │                 │                 │
       └─────────────────┼─────────────────┘
                         ▼
              ┌─────────────────────┐
              │   多模态融合骨干网络   │
              │  (VLM / VLA Backbone) │
              └──────────┬──────────┘
                         ▼
              ┌─────────────────────┐
              │      动作输出        │
              │     (Action)        │
              └─────────────────────┘
Vision、Language 和 Action
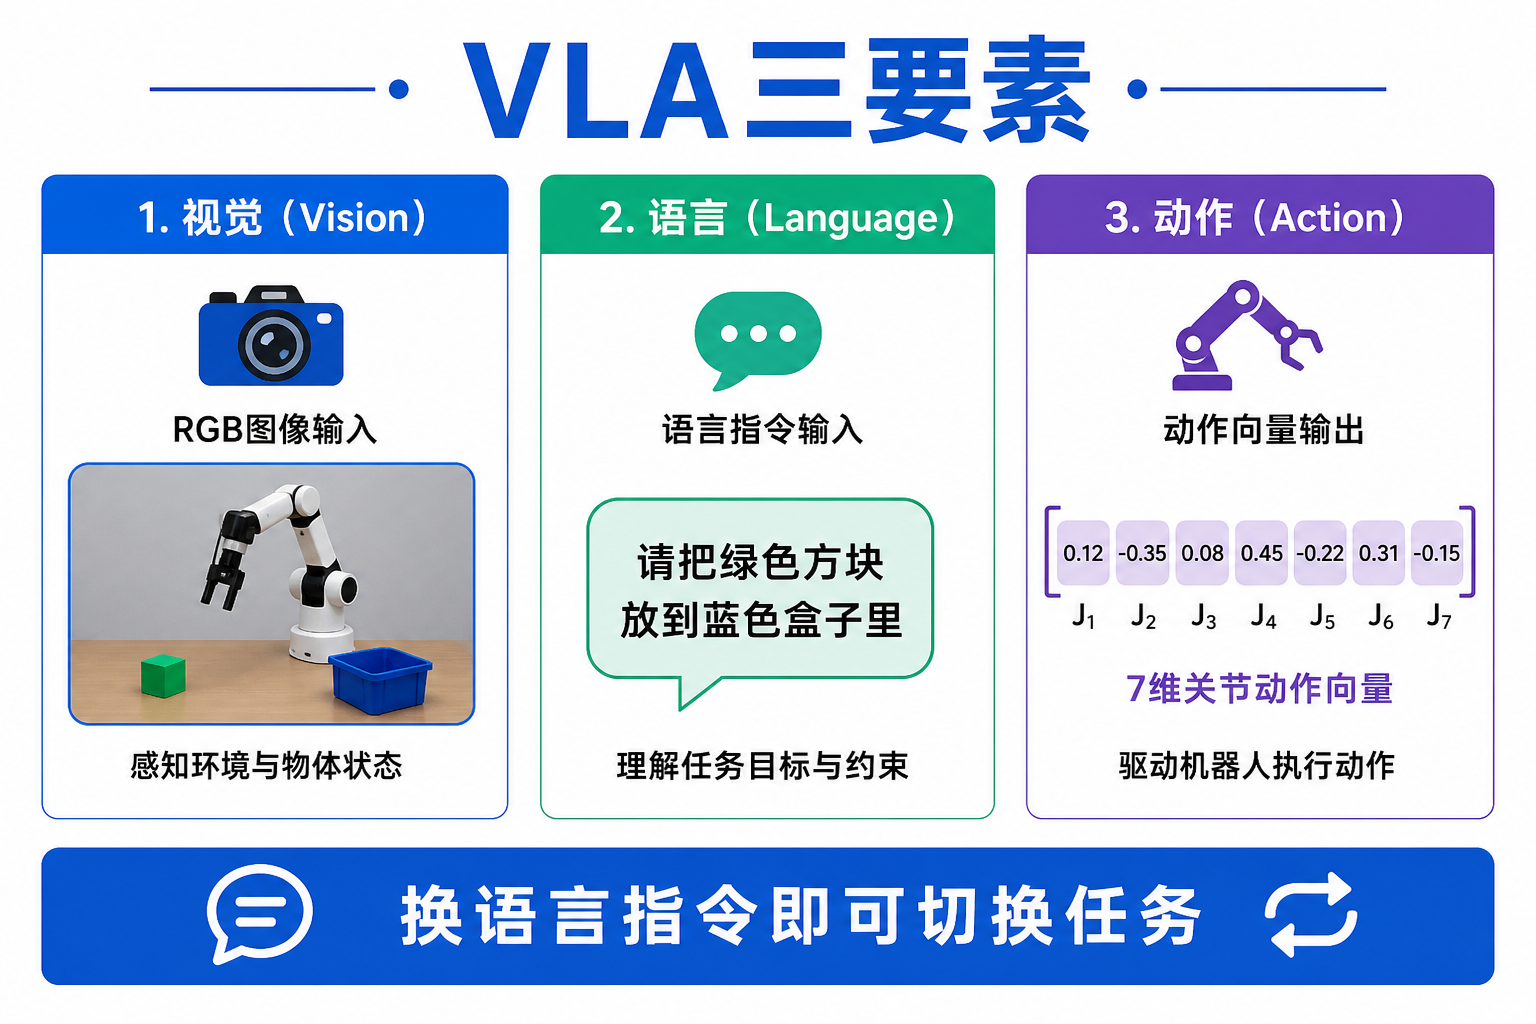
在 VLA 框架中,三个模态各有明确分工:
| 模态 | 含义 | reBot Arm 中的典型来源 |
|---|---|---|
| Vision | 外部相机、腕部相机采集的 RGB 图像 | 前置相机、腕部 RealSense / USB 相机 |
| Language | 任务的自然语言描述 | 「把螺丝刀放到工具盒里」 |
| Action | 机器人要执行的控制量 | 各关节目标角度、夹爪开合度 |
State(状态) 通常与 Action 成对出现:State 描述「机器人现在在哪」,Action 描述「下一步要去哪」。在 LeRobot 数据集中,它们以 observation.state 和 action 字段存储;在 GR00T 中还会通过 meta/modality.json 进一步拆分为 single_arm、gripper 等子键。
VLA 与纯视觉策略的关键区别:语言成为条件变量。训练时,每条演示轨迹都绑定一段任务描述;推理时,用户只需更换指令文本,无需更换模型权重(在数据覆盖范围内)。
VLM 与 VLA 的区别
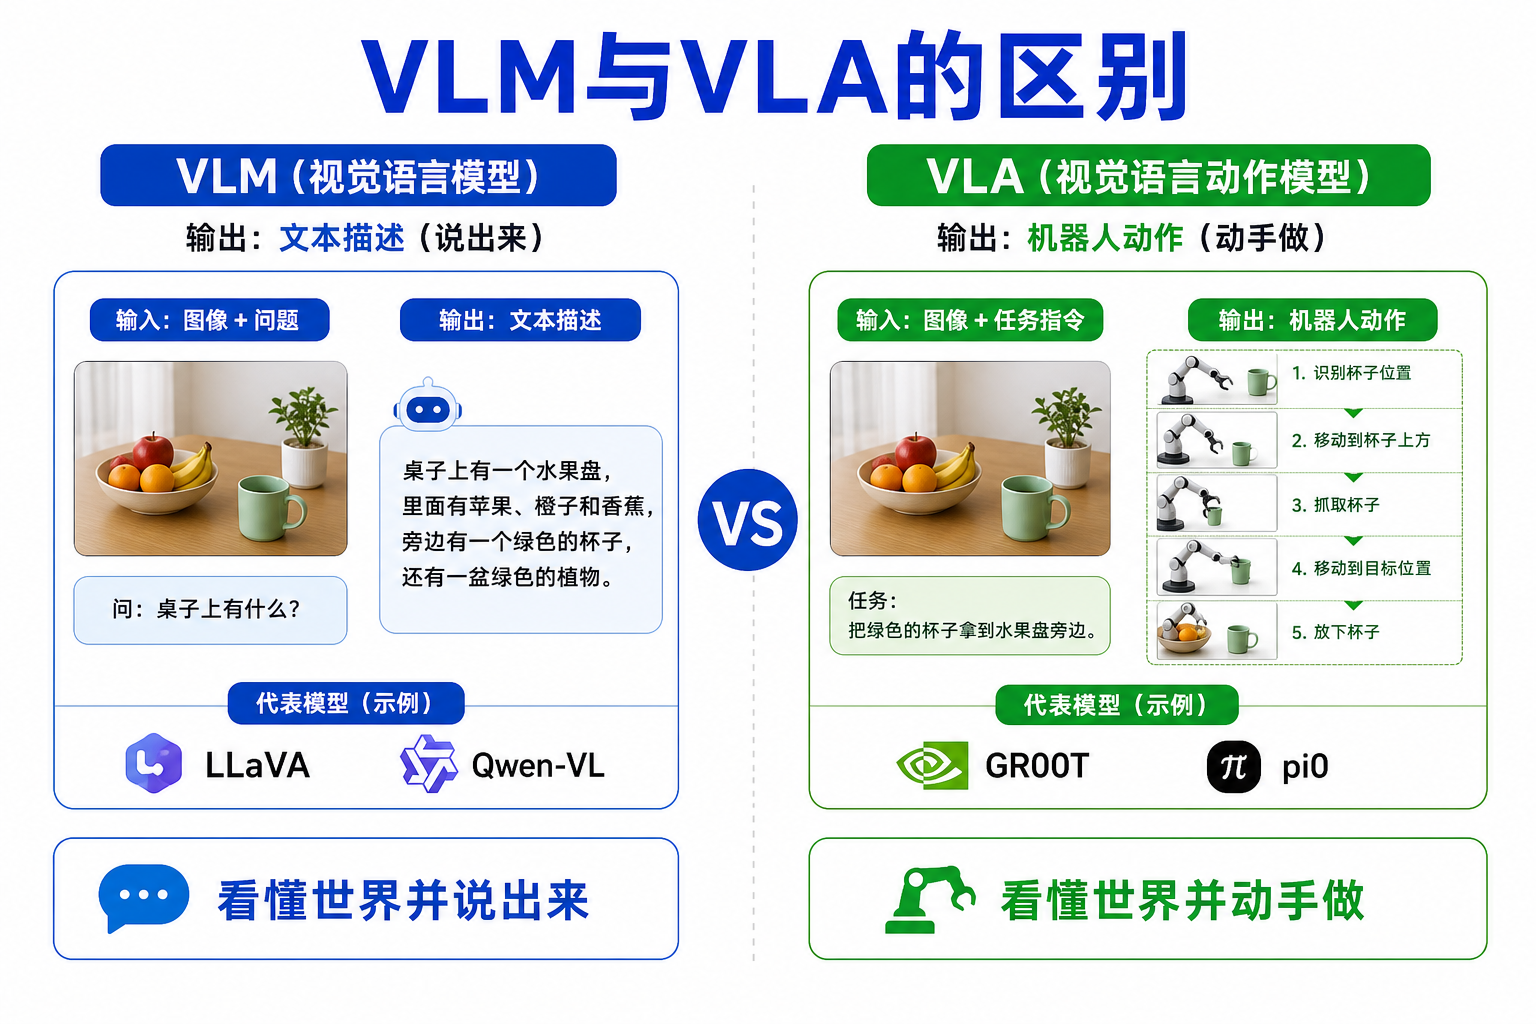
| 对比项 | VLM(Vision-Language Model) | VLA(Vision-Language-Action) |
|---|---|---|
| 输出 | 文本、描述、推理结果 | 机器人动作序列 |
| 典型应用 | 图像问答、场景理解、Caption | 抓取、放置、开关门等操控 |
| 代表模型 | LLaVA、Qwen-VL、Cosmos-Reason2 | GR00T、π0、OpenVLA |
| 与机器人关系 | 可辅助规划,不直接驱动电机 | 端到端输出控制量 |
可以简单理解为:VLM 负责「看懂世界并说出来」,VLA 负责「看懂世界并动手做」。
Isaac GR00T N1.7 在架构上复用了 VLM 的能力:其骨干网络是 Cosmos-Reason2-2B(基于 Qwen3-VL 架构,取代 N1.6 的 Eagle 骨干),负责编码图像与语言,再接一个 Diffusion Transformer(DiT)动作头,把语义表示解码为连续动作块(action chunk)。因此 GR00T 既是 VLA,也内嵌了强大的 VLM 表征能力。
ACT 与 VLA 的区别
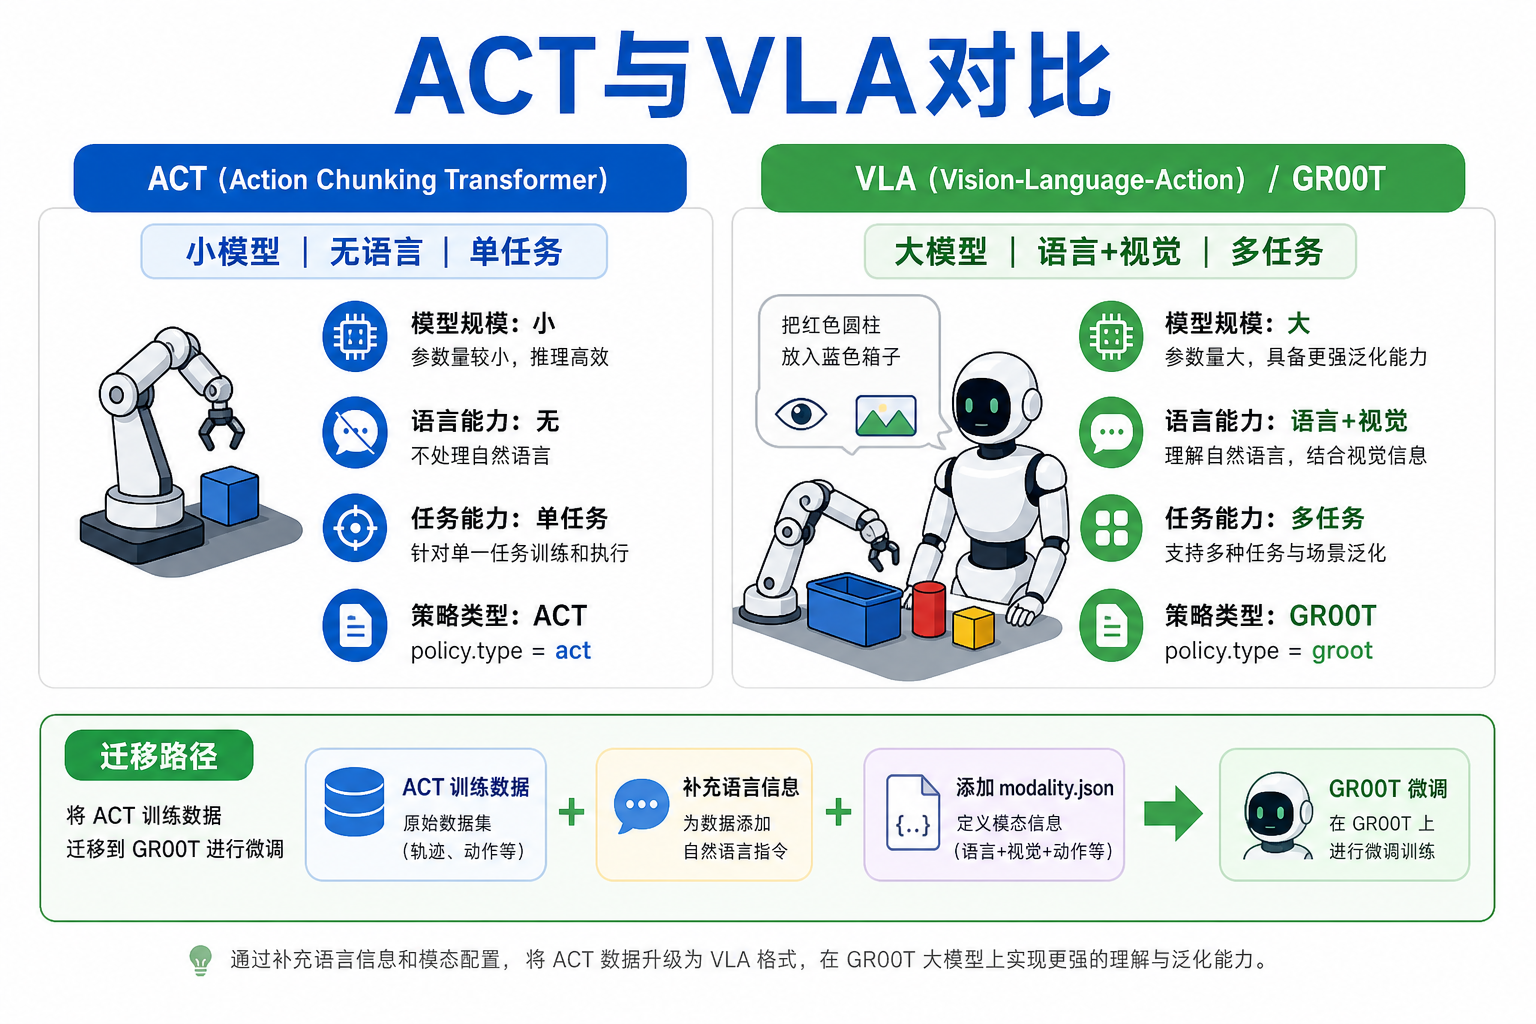
在前几章接触的 ACT,和本章的 VLA,都是模仿学习(Behavior Cloning)家族,但设计目标不同:
| 对比项 | ACT | VLA(以 GR00T 为例) |
|---|---|---|
| 任务条件 | 通常无语言,隐式单任务 | 语言 + 视觉 显式多任务 |
| 模型规模 | 较小(千万级参数) | 较大(数十亿参数基础模型) |
| 训练方式 | 从零训练或轻量微调 | 基础模型预训练 + 下游微调 |
| 动作表示 | 动作块(chunk) | 动作块 + Flow Matching 去噪 |
| 泛化能力 | 同分布内表现好,换任务需重训 | 语言条件支持零样本/少样本迁移 |
| LeRobot 策略类型 | act | groot |
ACT 的核心技巧是 Action Chunking:一次预测未来若干步动作,减少逐步推理的累积误差。GR00T 同样预测动作块,但窗口长度随版本变化:
- N1.5 / N1.6:
action_horizon = 16 - N1.7:
action_horizon从 16 扩展到 40,预训练通用状态/动作空间的最大维度随之扩展(reBot 实际仅用 7 维,其余维度自动零填充) - LeRobot
grootpolicy:源码默认chunk_size=50、n_action_steps=50
本教程按 N1.7 官方微调示例,训练时使用 chunk_size=40,与预训练动作窗口对齐。不要沿用 16——窗口不匹配会降低微调效果。action_horizon 在训练时写入扩散头,推理时不可随意改大。
迁移路径:如果你已有 reBot Arm 的 ACT 数据集(LeRobot v2 格式),第 20 章只需补充语言标注和 Modality 配置,即可用于 GR00T 微调,无需重新采集全部演示。
语言条件机器人任务
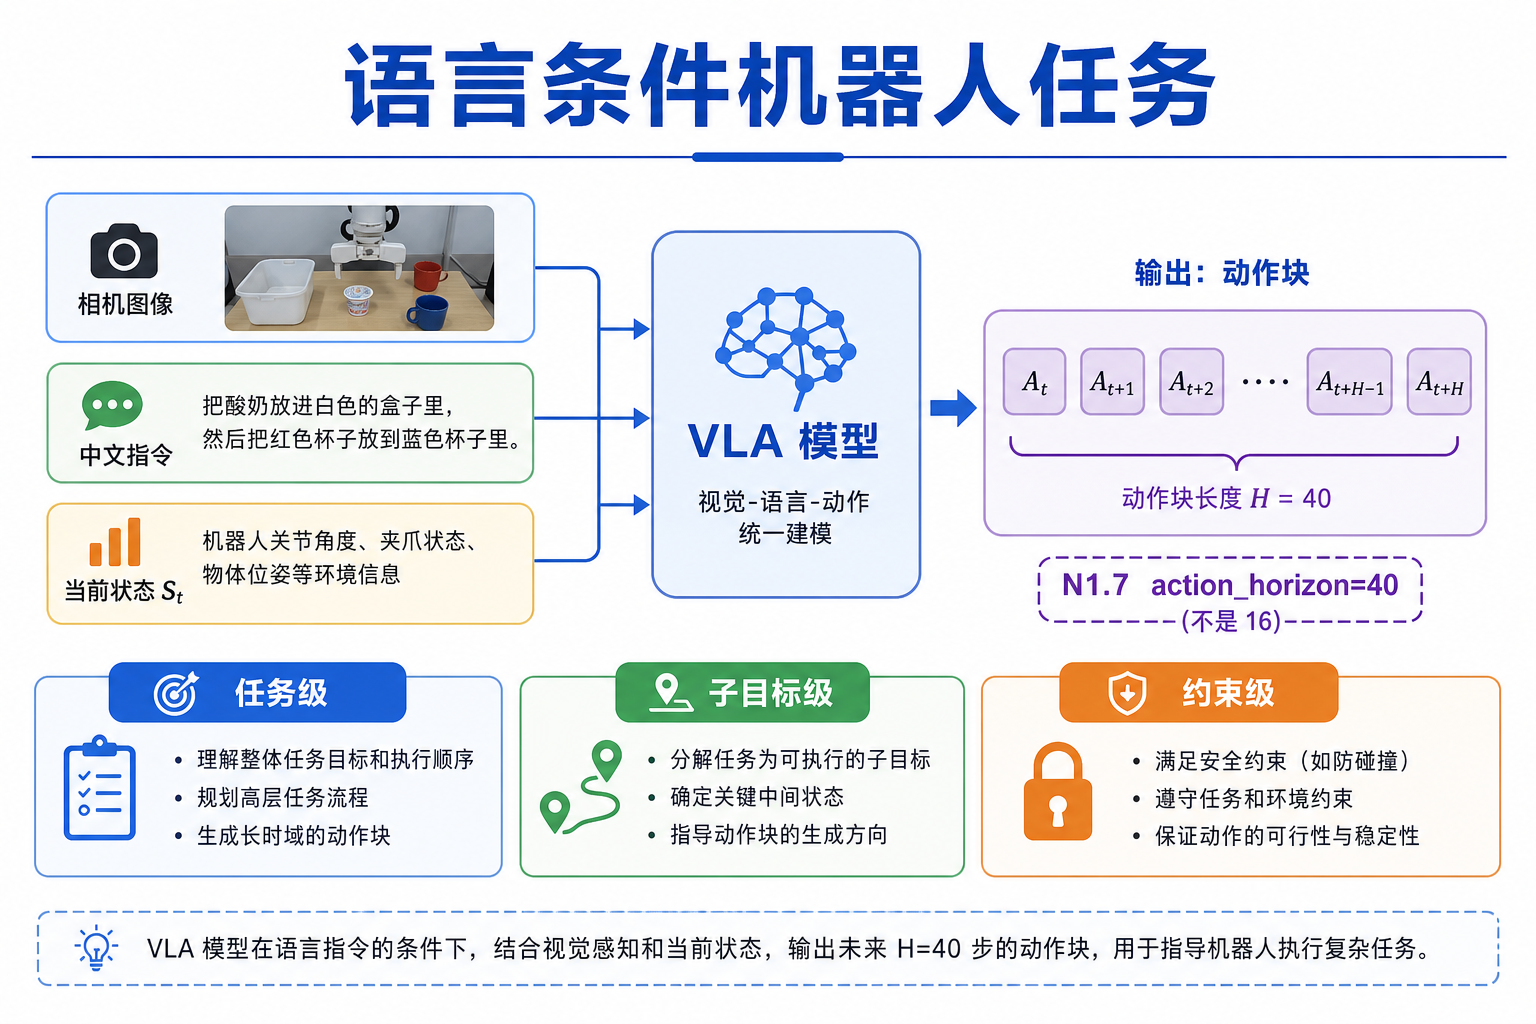
语言条件(Language-conditioned)任务的标准形式:
输入:图像 I_t + 语言指令 L + 当前状态 S_t
输出:动作 A_{t:t+H}(未来 H 步的动作块)
指令粒度可以不同:
- 任务级:「把红色方块放进蓝色盒子」(整条轨迹共用一句)
- 子目标级:「先靠近物体」→「再闭合夹爪」(分段标注,高级场景)
- 约束级:「轻放」「避开障碍物」(修饰执行方式)
在 LeRobot 数据集中,语言通常写在 meta/tasks.jsonl 或 annotation 字段。GR00T 通过 modality.json 的 annotation 键读取,常见两种写法:
| 键名 | 典型数据集 | reBot 建议 |
|---|---|---|
human.task_description | SO-100、cube_to_bowl 等简单桌面任务 | 推荐:与第 20 章示例一致 |
human.action.task_description | LIBERO、SimplerEnv 等仿真基准 | 仅当你的数据来自这些基准时使用 |
两种键都合法,但必须与数据集实际字段一致,训练与推理不要混用。
实践建议(reBot Arm):
- 每条演示录制时,用一句简短、动词开头的中文或英文描述任务
- 同类任务保持句式一致,例如统一用「把 X 放到 Y」
- 避免一条数据对应多种说法,微调初期越一致越好
单任务、多任务和泛化
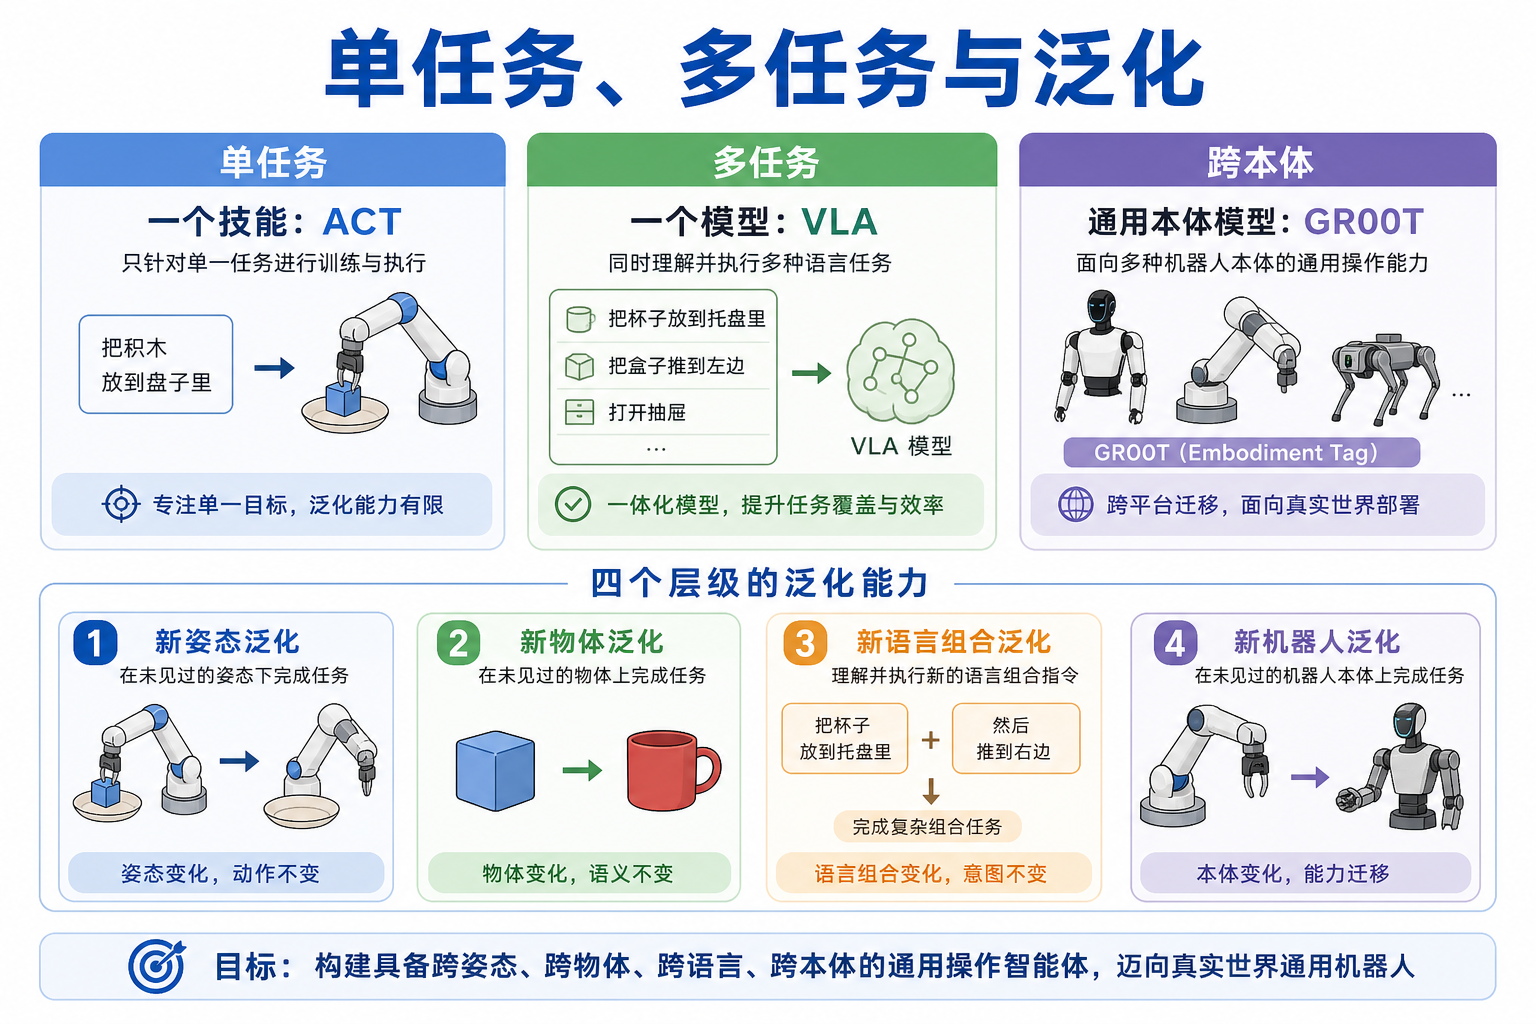
| 训练范式 | 说明 | 适用场景 |
|---|---|---|
| 单任务 | 只学一种技能 | ACT 默认方式;数据少、目标明确 |
| 多任务 | 同一模型学多种技能,靠语言区分 | VLA 微调;桌面整理、分拣等 |
| 跨本体泛化 | 不同机器人共享基础模型 | GR00T 预训练;通过 embodiment_tag 适配 |
VLA 的「泛化」分几个层次,不要混为一谈:
- 同任务、新初始位姿:方块位置变了仍能抓——ACT 通常也能做到
- 新物体、新容器:靠视觉泛化——需要训练数据有足够多样性
- 新语言指令组合:「把 A 放到 B」从未见过但句式熟悉——VLA 的语言条件优势
- 新机器人本体:换机械臂仍能用——需要 GR00T 的 embodiment 投影层 + 少量微调数据
对 reBot Arm 用户,现实预期是:微调后可在已采集的多种语言任务间切换;对全新物体或全新句式,仍需补充演示数据。
连续动作与动作 Token
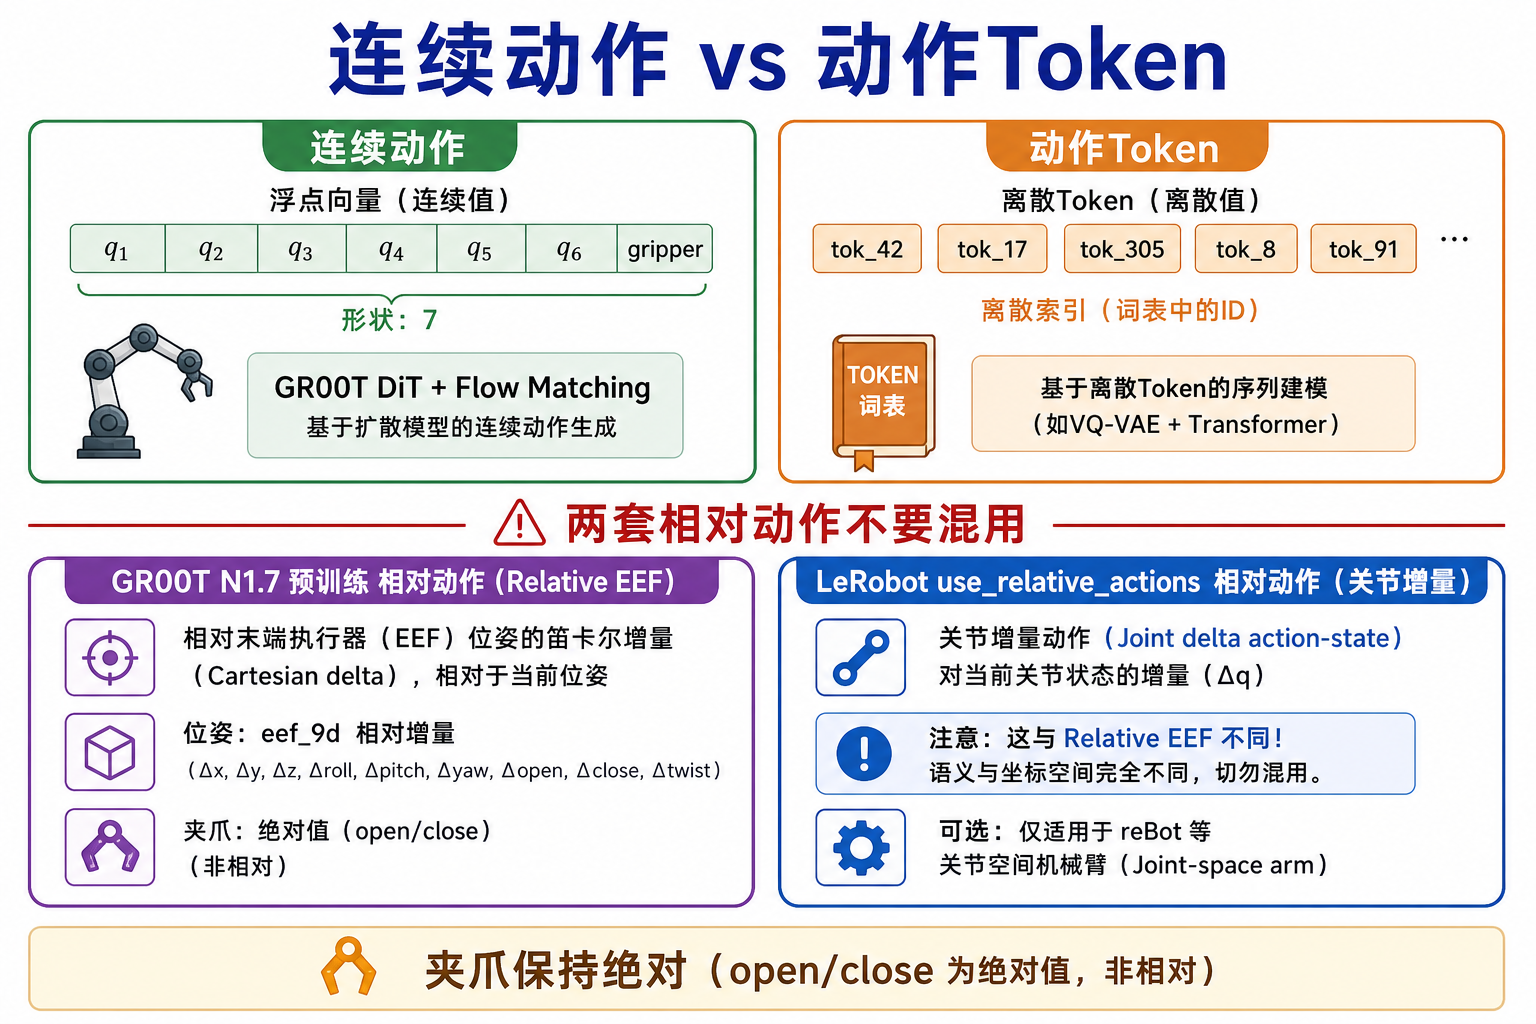
机器人控制量有两种主流表示:
连续动作(Continuous Actions)
直接输出浮点数向量,例如 6 个关节角 + 1 个夹爪开合度:
action = [q1, q2, q3, q4, q5, q6, gripper] # shape: (7,)
- 优点:精度高,与真实电机接口一致
- 缺点:高维空间回归难度大
- GR00T 采用:DiT + Flow Matching 在连续空间去噪,输出动作块
动作 Token(Discretized Actions)
把连续值量化成离散符号,像语言模型预测下一个 token:
action_tokens = [tok_42, tok_17, tok_89, ...]
- 优点:可复用自回归 LLM 架构;部分 VLA(如 π0-FAST)采用
- 缺点:量化损失、词表设计复杂
相对动作 vs 绝对动作:
- GR00T N1.7 预训练的核心是 Relative EEF(相对末端执行器)动作空间:动作表示为相对当前末端位姿的笛卡尔增量,而不是关节角增量 Δq。末端增量在不同机器人(甚至人类视频)之间语义更统一,这是 N1.7 跨本体泛化的关键。官方代码按动作组配置:
eef_9d用相对末端,joint_position用相对关节,gripper_position保持绝对。 - LeRobot 的
--policy.use_relative_actions=true是框架层开关:对关节维做action − state的相对变换。这不等于论文里的 Relative EEF,也不是「N1.7 默认推荐」。reBot Arm 走关节空间(NON_EEF)时,该开关只是 LeRobot 的可选预处理,不要写成「与 GR00T 预训练设计一致」。 - 夹爪等非关节量常用
relative_exclude_joints保持绝对控制。相对关节轨迹更平滑,但长期执行可能漂移。
VLA 的能力与局限
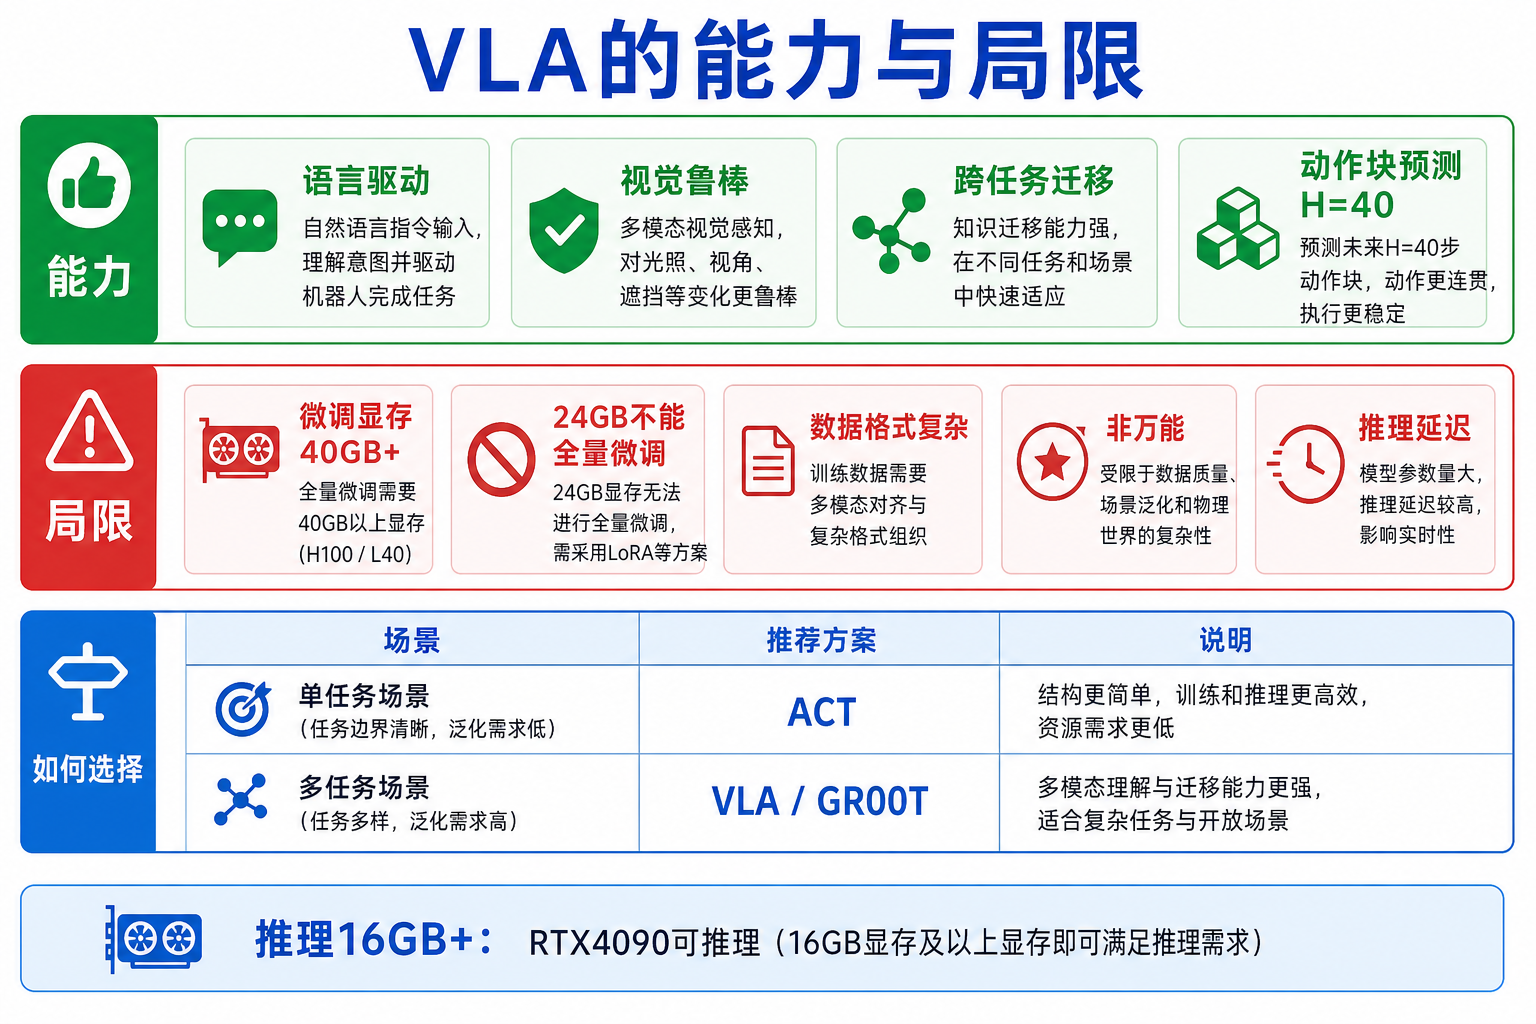
能力
- 语言驱动:一条模型、多种任务,换指令即可切换行为
- 视觉鲁棒性:大规模预训练带来比小型 ACT 更好的场景理解
- 跨任务迁移:相似句式、相似物体之间可共享表征
- 动作块预测:一次推理输出多步,适合实时控制(配合 RTC 推理策略)
局限
- 算力需求高:N1.7-3B 微调推荐 40 GB+ 显存(H100 / L40;默认只训 projector + DiT head 峰值约 35 GB;官方仿真微调教程要求 ≥ 48 GB)。推理才是 16 GB+(RTX 4090 可推理)。24 GB 卡做全量微调基本不可行,除非 LoRA / PEFT 等高效微调。
- 数据格式更复杂:除 LeRobot 标准字段外,需
modality.json、embodiment tag - 非万能:训练集未覆盖的物体、指令、工位布局仍可能失败
- 延迟:大模型推理比 ACT 慢,需合理设置
n_action_steps和 RTC 参数 - 仿真到真机差距:预训练数据以人形/特定平台为主,桌面臂需充分微调
何时选 ACT,何时选 VLA?
| 场景 | 推荐 |
|---|---|
| 单一重复任务、边缘设备、低延迟 | ACT |
| 多任务、语言交互、愿意投入 GPU 与标注 | VLA / GR00T |
| 已有 ACT 数据、想扩展多任务 | 在现有 LeRobot 数据上补语言 → GR00T 微调 |
本章小结
- 多模态模型融合视觉、语言、状态,统一决策
- VLA 在 VLM 基础上增加动作输出,支持语言条件操控
- ACT 是轻量单任务方案;GR00T 是大规模预训练 + 微调的 VLA 方案
- N1.7 预训练用 Relative EEF 与
action_horizon=40;LeRobot 里的关节相对动作是另一套可选预处理,二者不要混称 - 下一章将介绍:如何把通用 VLA 落地到 reBot Arm 这一具体本体