19. 机器人本体与 GR00T 系统架构
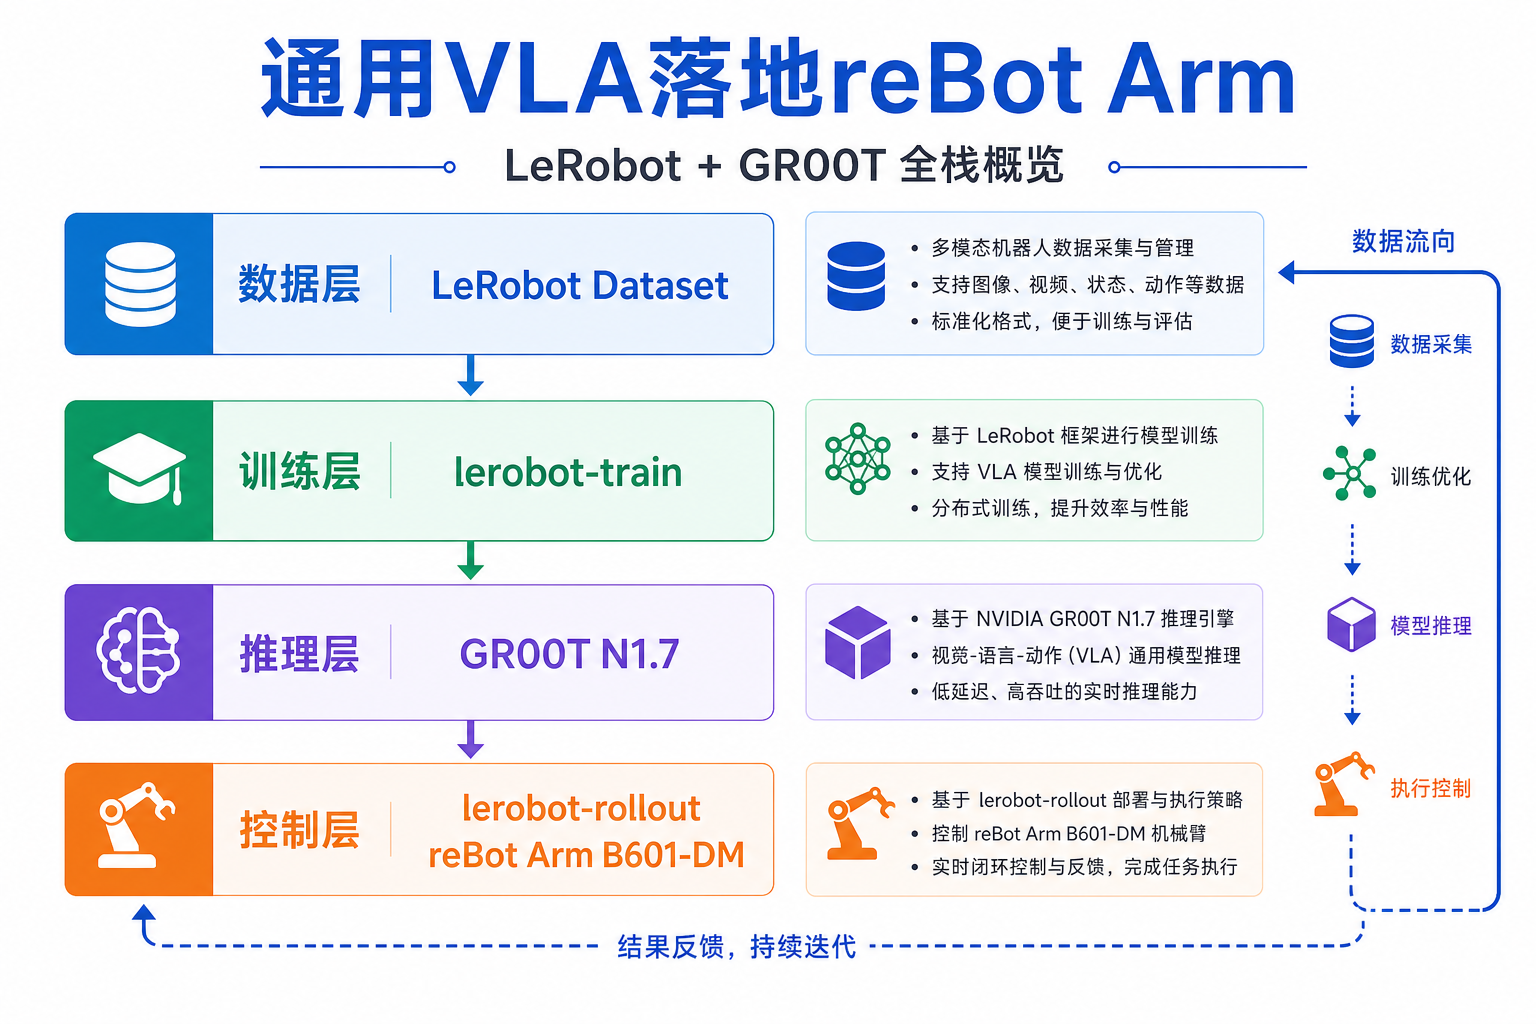
GR00T 是 跨本体(Cross-embodiment) 基础模型:它在多种机器人数据上预训练,通过 Embodiment Tag 和 Modality 配置 区分不同硬件。本章说明 reBot Arm 在 LeRobot + GR00T 栈中的位置,以及推理时各组件如何协作。
GR00T 是 跨本体(Cross-embodiment) 基础模型:它在多种机器人数据上预训练,通过 Embodiment Tag 和 Modality 配置 区分不同硬件。本章说明 reBot Arm 在 LeRobot + GR00T 栈中的位置,以及推理时各组件如何协作。
什么是 Robot Embodiment(机器人本体)
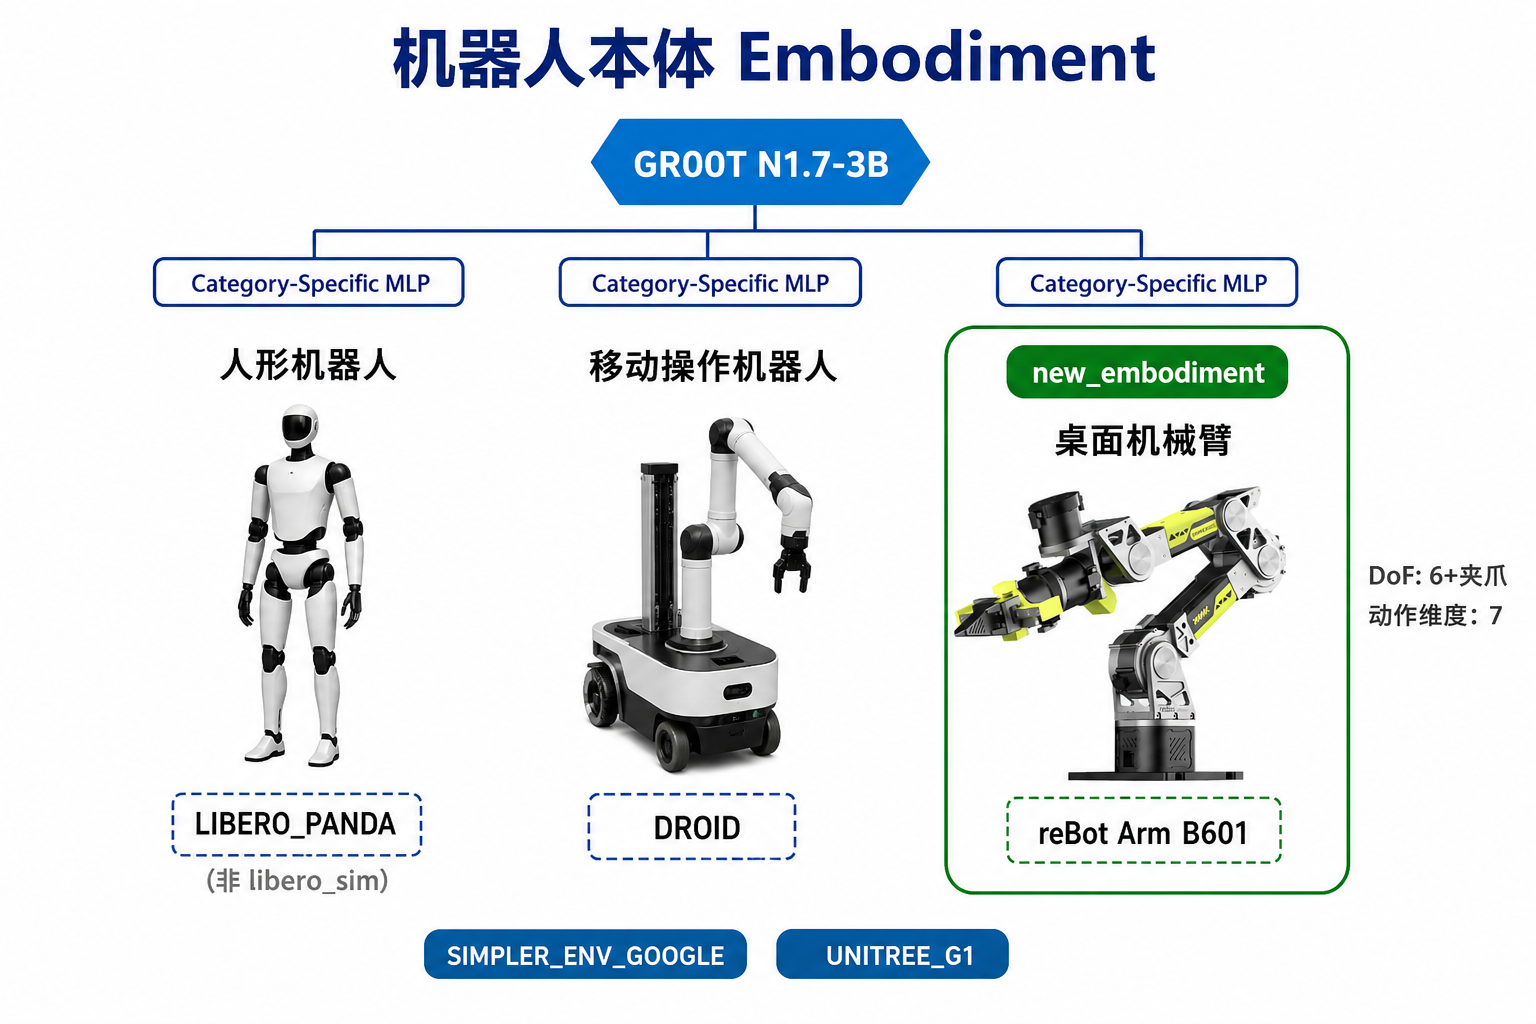
Embodiment(本体) 描述一台机器人的「物理与控制身份」,包括:
- 自由度(DoF)数量与关节顺序
- 关节限位、传动比、控制模式(位置/力矩)
- 相机数量、安装位置与分辨率
- 动作空间定义(关节空间 vs 末端笛卡尔空间)
- 夹爪类型与开合范围
同一个 GR00T 基础模型不能把 SO-101 的 6 维关节向量直接用到 reBot Arm 上。模型内部用 Category-Specific MLP(按本体分类的投影层) 把不同维度的 state/action 映射到共享隐空间,再映射回各自的动作维度。
在 LeRobot / GR00T 中,通过 embodiment_tag 指定本体。官方预训练标签(EmbodimentTag)包括:
LIBERO_PANDA、DROID、SIMPLER_ENV_GOOGLE、UNITREE_G1、OXE_WIDOWX等- 新硬件:
new_embodiment/NEW_EMBODIMENT(reBot Arm 微调时使用)
没有 libero_sim 这个官方标签。不要把预训练标签套到 reBot 数据上。
--policy.embodiment_tag=new_embodiment
这告诉 GR00T:当前数据来自一个训练时未见过的新机器人,请使用新本体的投影层进行微调。
机器人关节、State 和 Action 定义
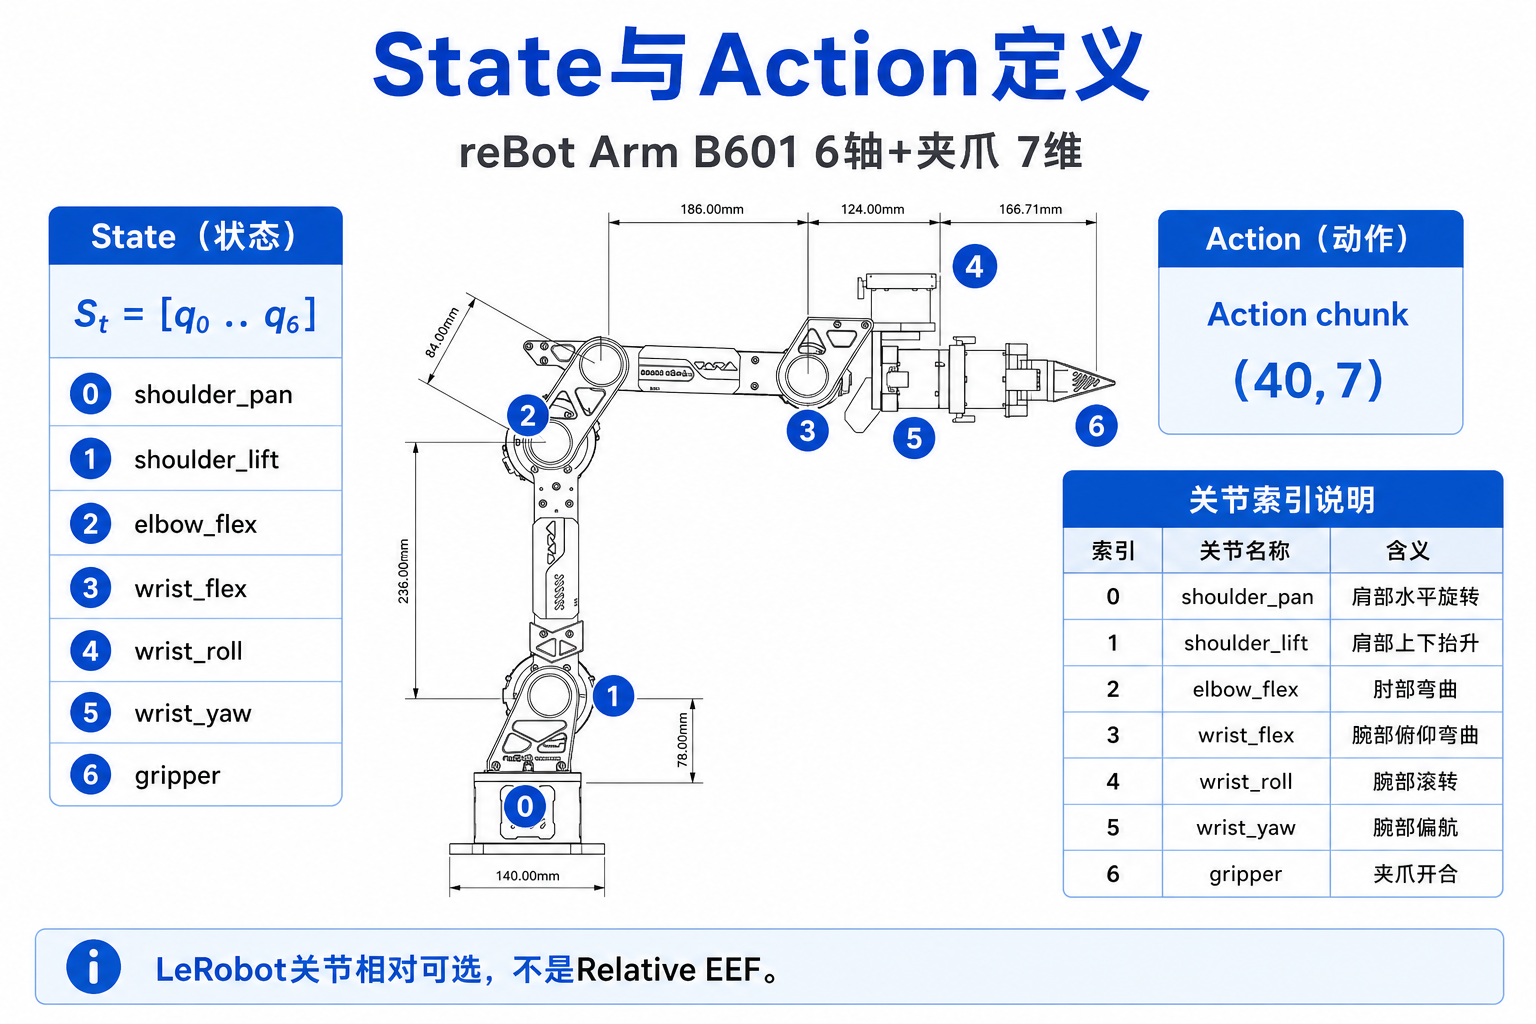
以 reBot Arm B601(6 轴 + 夹爪)为例:
关节与 State
State(观测状态) 是策略的输入之一,表示机器人当前构型:
observation.state = [q1, q2, q3, q4, q5, q6, gripper_pos]
                     └──────── 6 个关节角 ───┘  └ 夹爪 ┘
-
单位:关节角通常为弧度(rad)或度(deg),数据集内须统一
-
顺序:必须与录制脚本、
modality.json、推理客户端完全一致 -
在
meta/modality.json中可拆分为:state.single_arm→ 索引 0–5state.gripper→ 索引 6
Action
Action(动作) 是策略输出,由底层控制器执行:
action = [target_q1, ..., target_q6, target_gripper]
GR00T N1.7 一次输出 H 步动作块(预训练 action_horizon=40;LeRobot groot 默认 chunk_size=50)。本教程训练对齐 N1.7,取 H=40:
action_chunk.shape = (40, 7) # 40 步 × 7 维
控制循环通常每步或每 k 步从块中取一行发给电机;LeRobot rollout 用 n_action_steps 控制每次推理执行多少步。
Camera Modality(相机模态)
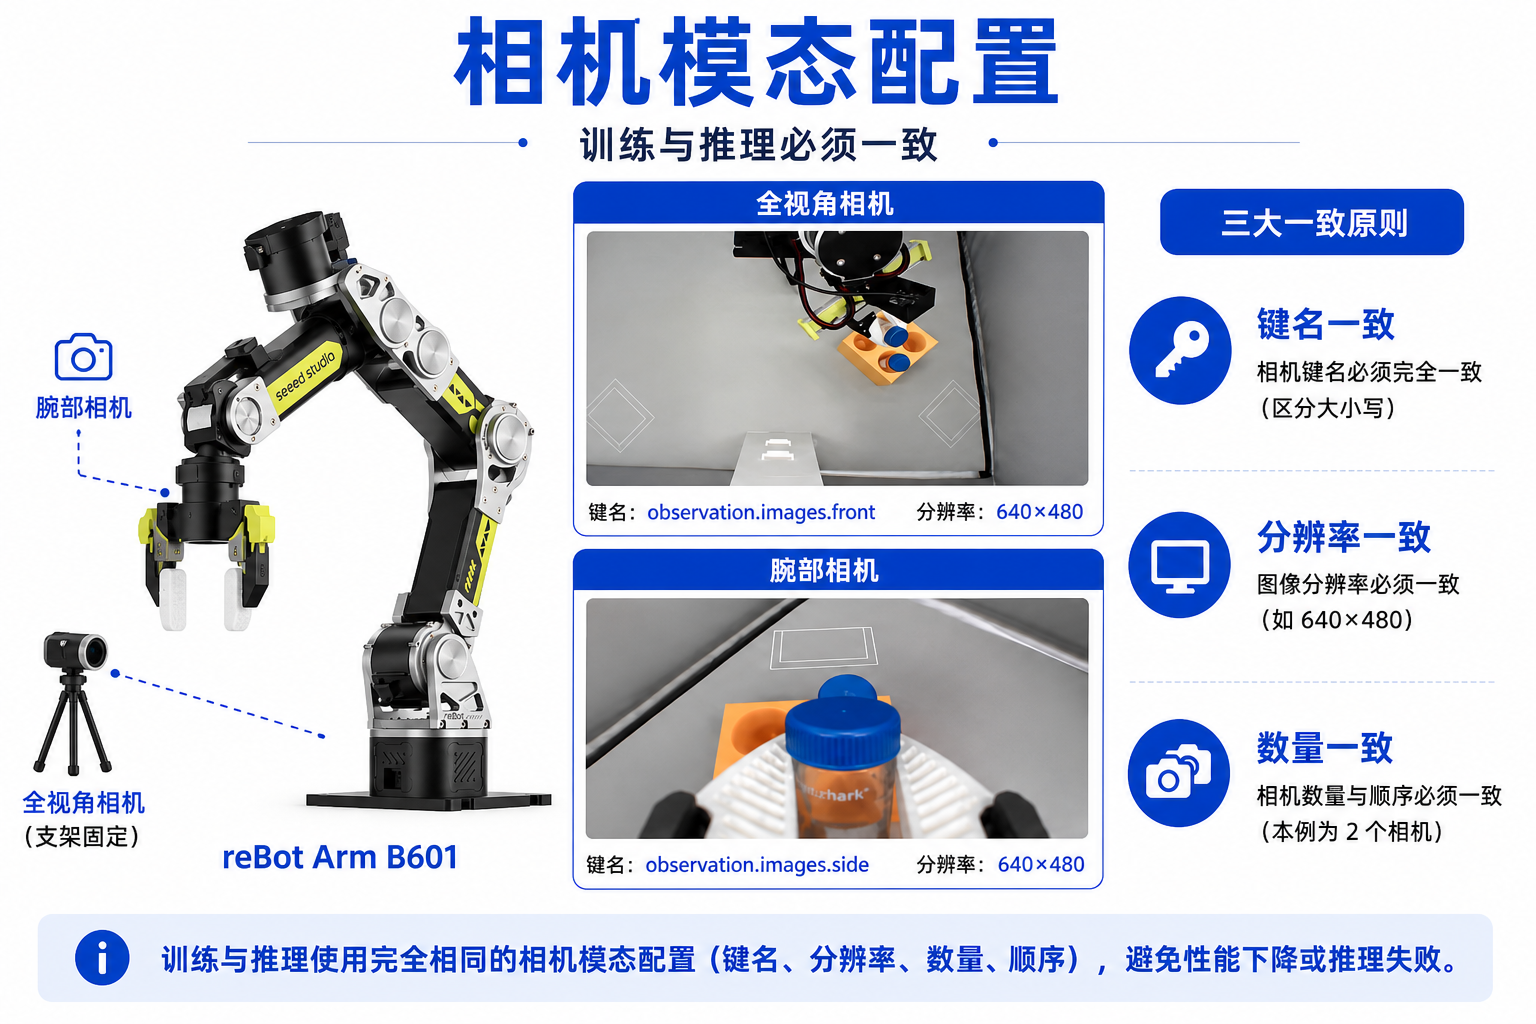
GR00T 以 视觉为主、语言为辅、状态为补充。相机配置需与训练数据严格对齐。
常见相机布局(reBot Arm)
| 键名(示例) | 位置 | 作用 |
|---|---|---|
front | 支架固定的全视角相机 | 全局场景、目标物体定位 |
side / wrist | 腕部相机 | 近距离对准、遮挡场景 |
在 LeRobot 数据集中,视频存为 observation.images.<camera_name>;在 meta/modality.json 的 video 字段声明各相机的分辨率与索引。
注意事项
- 训练与推理的相机键名、数量、分辨率必须一致
- GR00T 骨干网络支持原生宽高比,但建议统一为 640×480 或数据集约定分辨率
- 微调时可开启
dataset.image_transforms(亮度、对比度抖动)提升鲁棒性 - 查找本机相机索引:
lerobot-find-cameras opencv
Language Modality(语言模态)
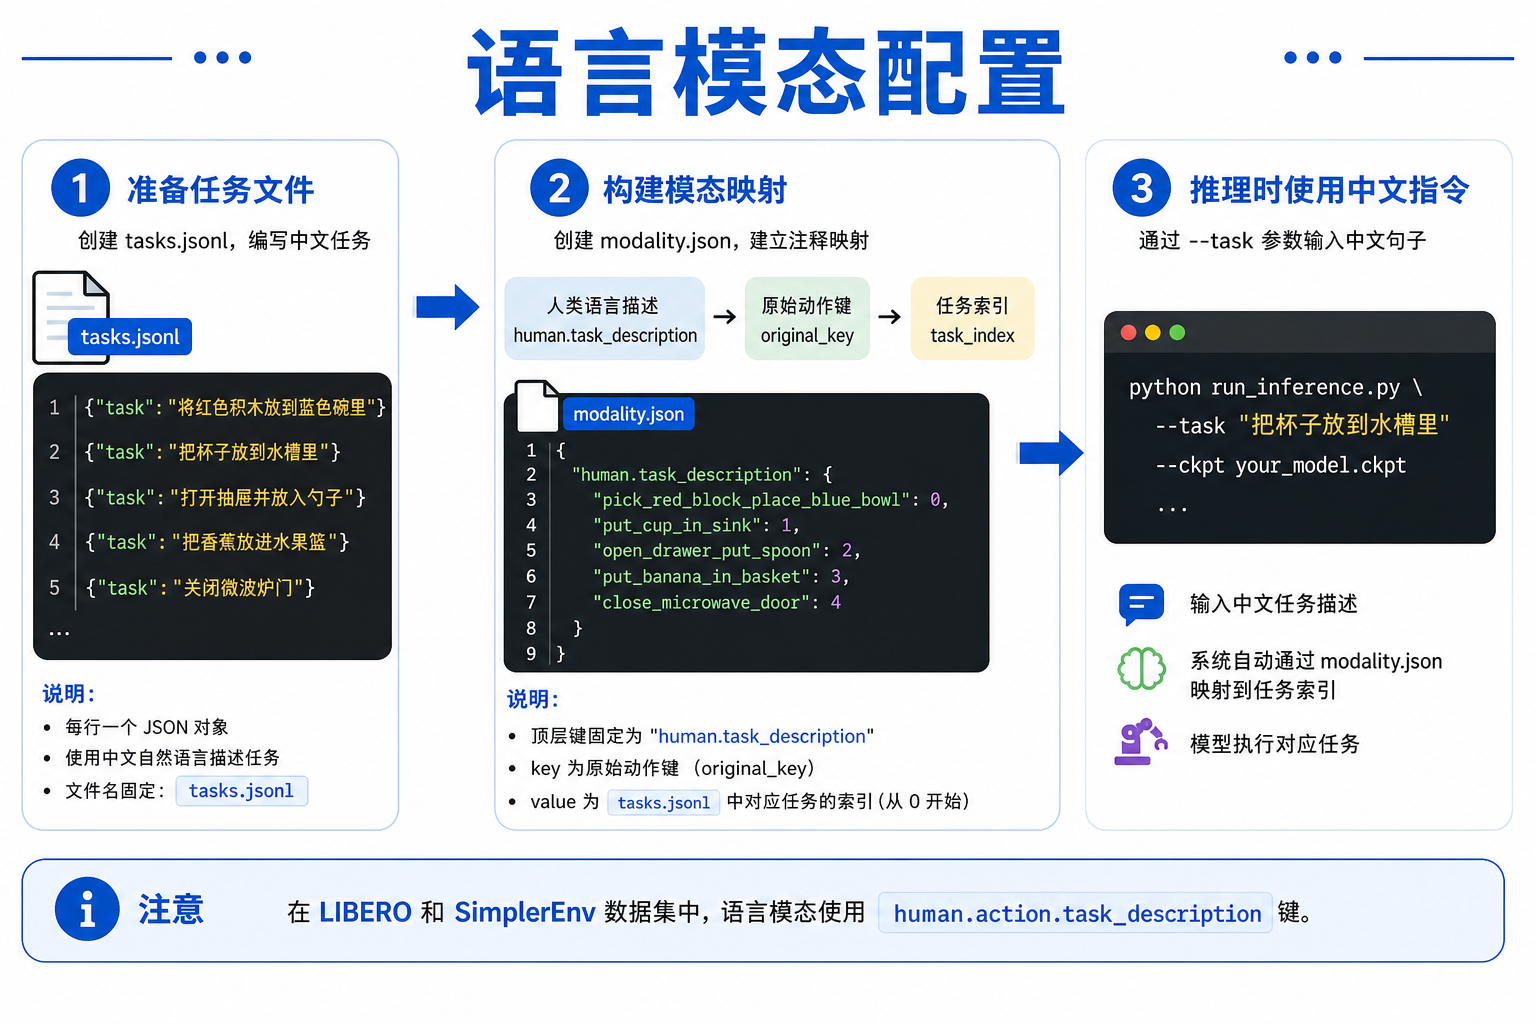
语言在 GR00T 流水线中作为 条件输入,与图像 token 一起送入 VLM 骨干。
数据侧
- LeRobot:
meta/tasks.jsonl或 episode 级 annotation - GR00T 扩展:
meta/modality.json→annotation字段
示例 modality.json 片段(reBot 桌面任务用 human.task_description):
{
  "annotation": {
    "human.task_description": {
      "original_key": "task_index"
    }
  }
}
若数据来自 LIBERO / SimplerEnv,则改用 human.action.task_description。键名必须与第 20 章完整 modality.json 一致。
推理侧
运行 lerobot-rollout 时通过 --task 传入:
--task="把红色方块放到蓝色托盘里"
该字符串会编码后与当前图像、状态一起送入模型。请使用与训练数据相近的语言风格和句式。
时间窗口与动作窗口
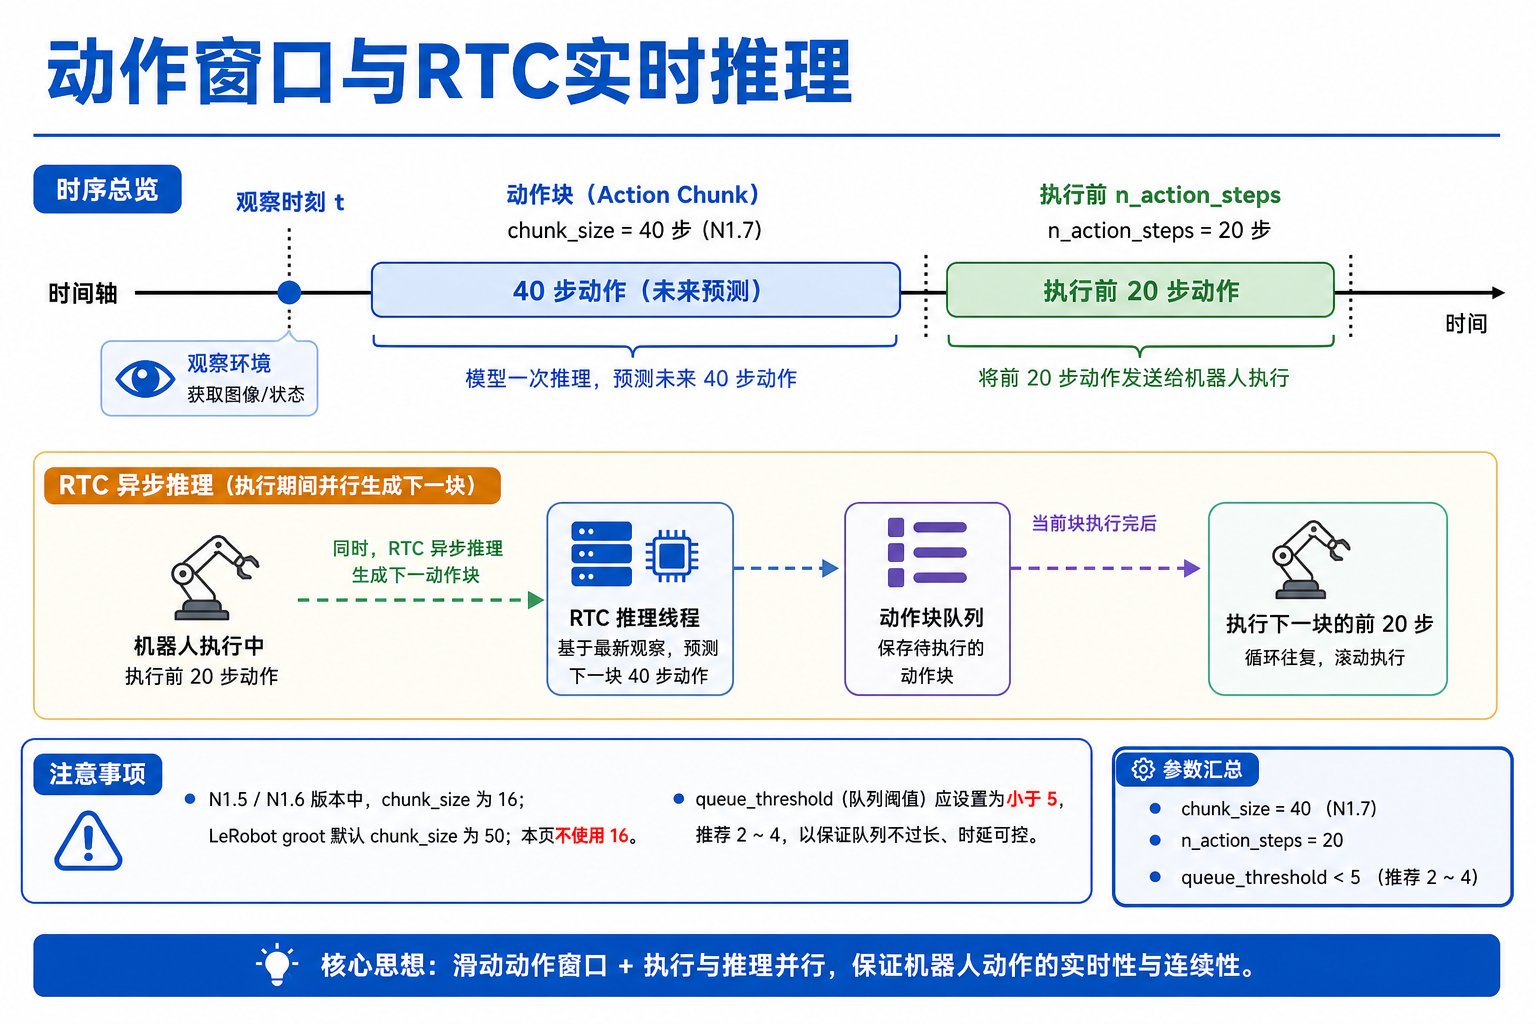
VLA 推理不是「看一帧、出一个动作」,而是涉及时间维度的采样设计:
时间轴 ─────────────────────────────────────────────►

观测窗口:     [t-k ... t-1, t]     ← 历史图像帧(可选)
状态:              S_t
语言:              L
动作预测窗口:           [A_t, A_{t+1}, ... A_{t+H-1}]
                              └── H = chunk_size / action_horizon
| 参数 | 典型值(N1.7) | 含义 |
|---|---|---|
chunk_size / action_horizon | 40(对齐 N1.7;LeRobot groot 源码默认 50;N1.5/N1.6 为 16) | 单次推理预测的动作步数 |
n_action_steps | 8–40 | 每次推理实际执行的步数,须 ≤ chunk_size |
n_obs_steps | 1 | 使用多少帧历史图像 |
RTC(Real-Time Chunking):当推理耗时接近控制周期时,LeRobot 支持 RTC 策略,在执行当前动作块的同时异步计算下一块,减少停顿。 rollout 中通过 --inference.type=rtc 启用;queue_threshold 表示动作队列低于多少步时触发新推理,建议设为 2–5;设为 0 会每次都重新推理,易增加抖动。
基础模型与微调
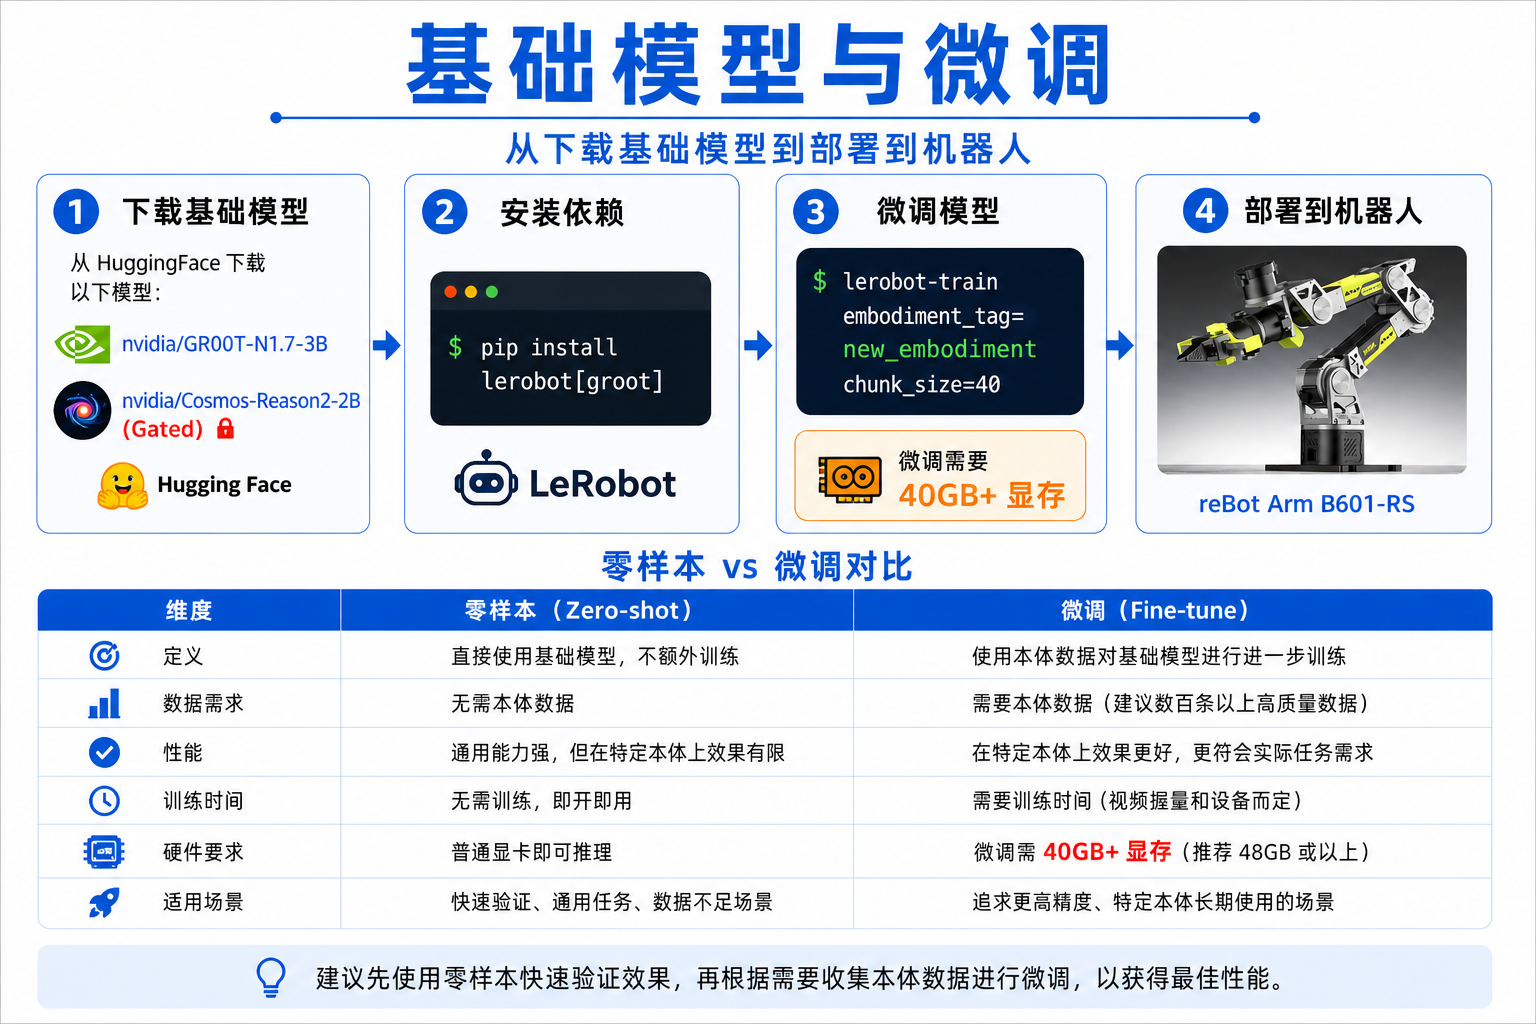
基础模型(Foundation Model)
NVIDIA GR00T N1.7-3B 在大规模多本体数据上预训练,具备通用视觉-语言-动作能力。可通过 Hugging Face 获取:
nvidia/GR00T-N1.7-3B
LeRobot 安装 GR00T 支持:
pip install "lerobot[groot]"
# 或源码:
pip install -e ".[groot]"
详见 LeRobot 安装文档。
微调(Fine-tuning)
在 reBot Arm 上的典型流程:
- 准备 LeRobot v2 数据集 +
meta/modality.json(第 20 章) - 指定
embodiment_tag=new_embodiment - 使用
lerobot-train --policy.type=groot启动训练(第 21 章) - 将 checkpoint 推送到 Hugging Face Hub 或保存在本地
outputs/
微调时:
- VLM 骨干为 Cosmos-Reason2-2B;默认微调常冻结 LLM,重点训 projector + DiT head(峰值约 35 GB)
- DiT 动作头和 embodiment 投影层适配 reBot 的 state/action 维度
- 数据量建议:每种任务至少 50 条成功演示,多任务可适当增加
- 显存:微调 40 GB+;24 GB 级显卡请用 LoRA/PEFT,或只做推理
零样本 vs 微调
| 方式 | 说明 |
|---|---|
| 零样本 | 直接使用 GR00T-N1.7-3B,仅当任务与预训练本体极相似时可能有效 |
| 微调 | reBot Arm 推荐路径;少量桌面操作数据即可显著提升成功率 |
GR00T 系统架构(LeRobot 栈)
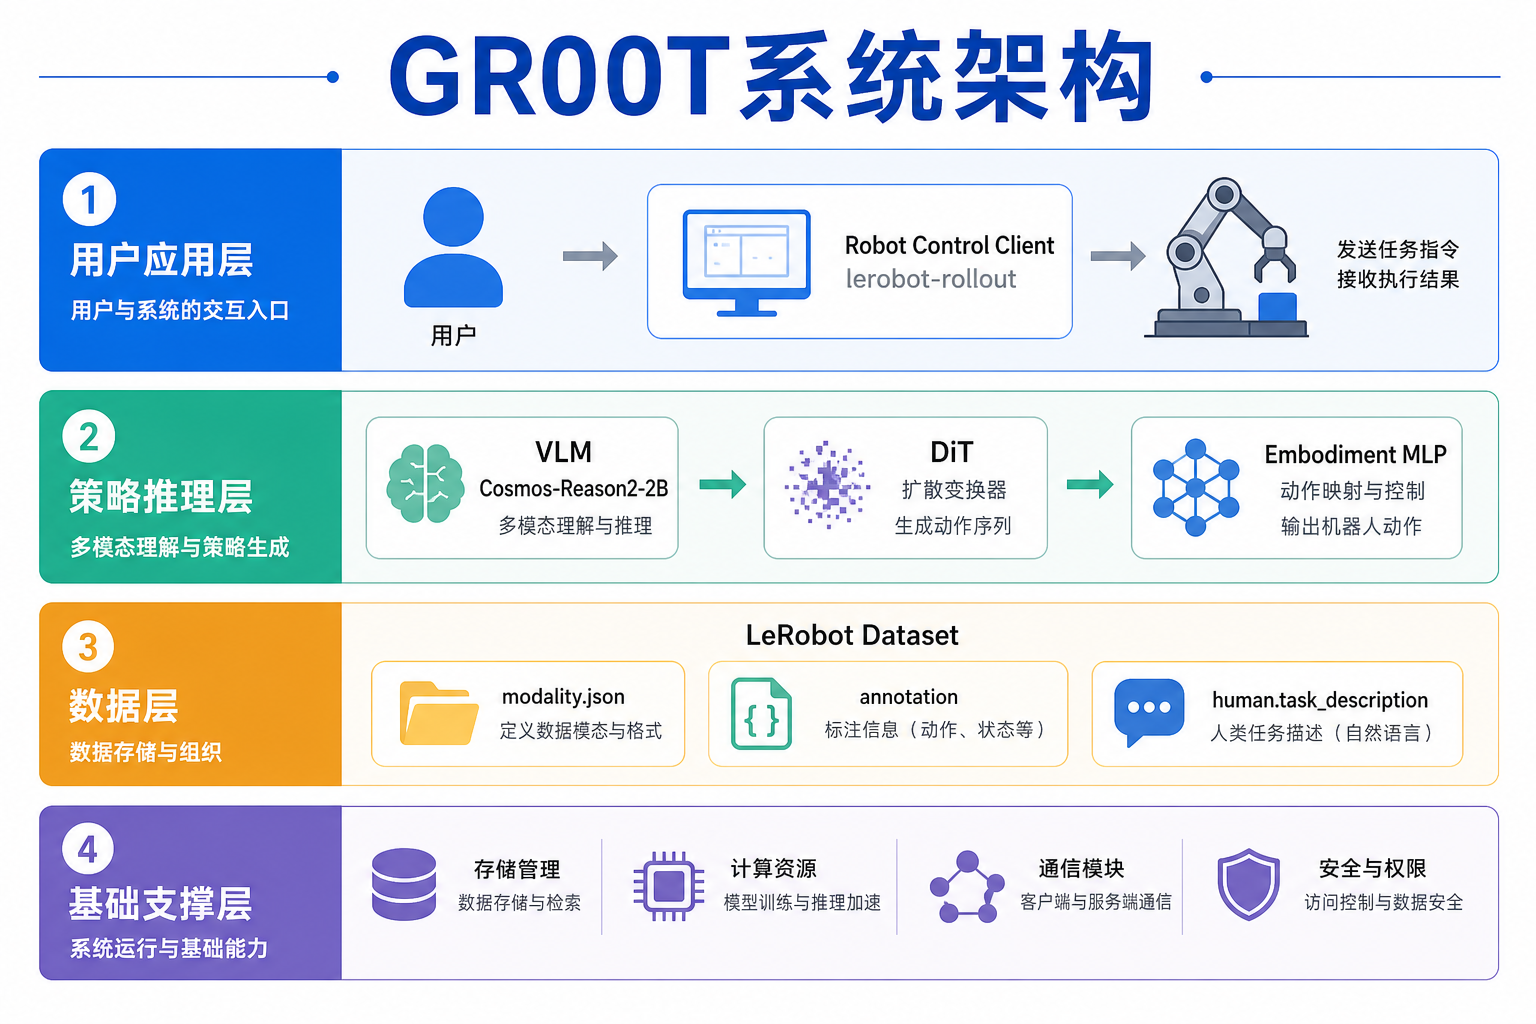
基于 LeRobot 的 reBot GR00T 系统可分为四层:
┌────────────────────────────────────────────────────────────┐
│                    用户 / 应用层                            │
│         自然语言任务  +  启动 rollout / 示教界面             │
└────────────────────────────┬───────────────────────────────┘
                             │
┌────────────────────────────▼───────────────────────────────┐
│              Robot Control Client(LeRobot Rollout)        │
│  - 采集相机图像、读取关节 state                              │
│  - 发送观测到策略,接收 action chunk                         │
│  - 通过 reBot 驱动(串口/CAN)执行动作                       │
│  lerobot-rollout --policy.type=groot --robot.type=...      │
└────────────────────────────┬───────────────────────────────┘
                             │ 观测 / 动作
┌────────────────────────────▼───────────────────────────────┐
│              Policy Inference(GR00T N1.7)                 │
│  ┌──────────────┐  ┌─────────────┐  ┌──────────────────┐ │
│  │ VLM Backbone │→ │  DiT Head   │→ │ Embodiment MLP   │ │
│  │ Cosmos-Reason2-2B │  │ Flow Match  │  │ 解码为 7维动作    │ │
│  └──────────────┘  └─────────────┘  └──────────────────┘ │
│  可与 rollout 同进程,或拆分为独立 GPU 推理服务(进阶部署)    │
└────────────────────────────┬───────────────────────────────┘
                             │
┌────────────────────────────▼───────────────────────────────┐
│              数据与训练层(LeRobot Dataset v2)              │
│  episodes / videos / meta/modality.json / tasks.jsonl      │
│  lerobot-train / lerobot-record / lerobot-replay           │
└────────────────────────────────────────────────────────────┘
模型内部数据流(简化)
- 图像 → VLM 视觉编码器 → 视觉 token
- 语言指令 → 文本 tokenizer → 语言 token
- State → Embodiment 编码 MLP → 状态 token
- 多模态 token 融合 → DiT 迭代去噪 → 动作隐变量
- Embodiment 解码 MLP →
action_chunk (H × action_dim)
GR00T 推理 Server 与 Robot Control Client
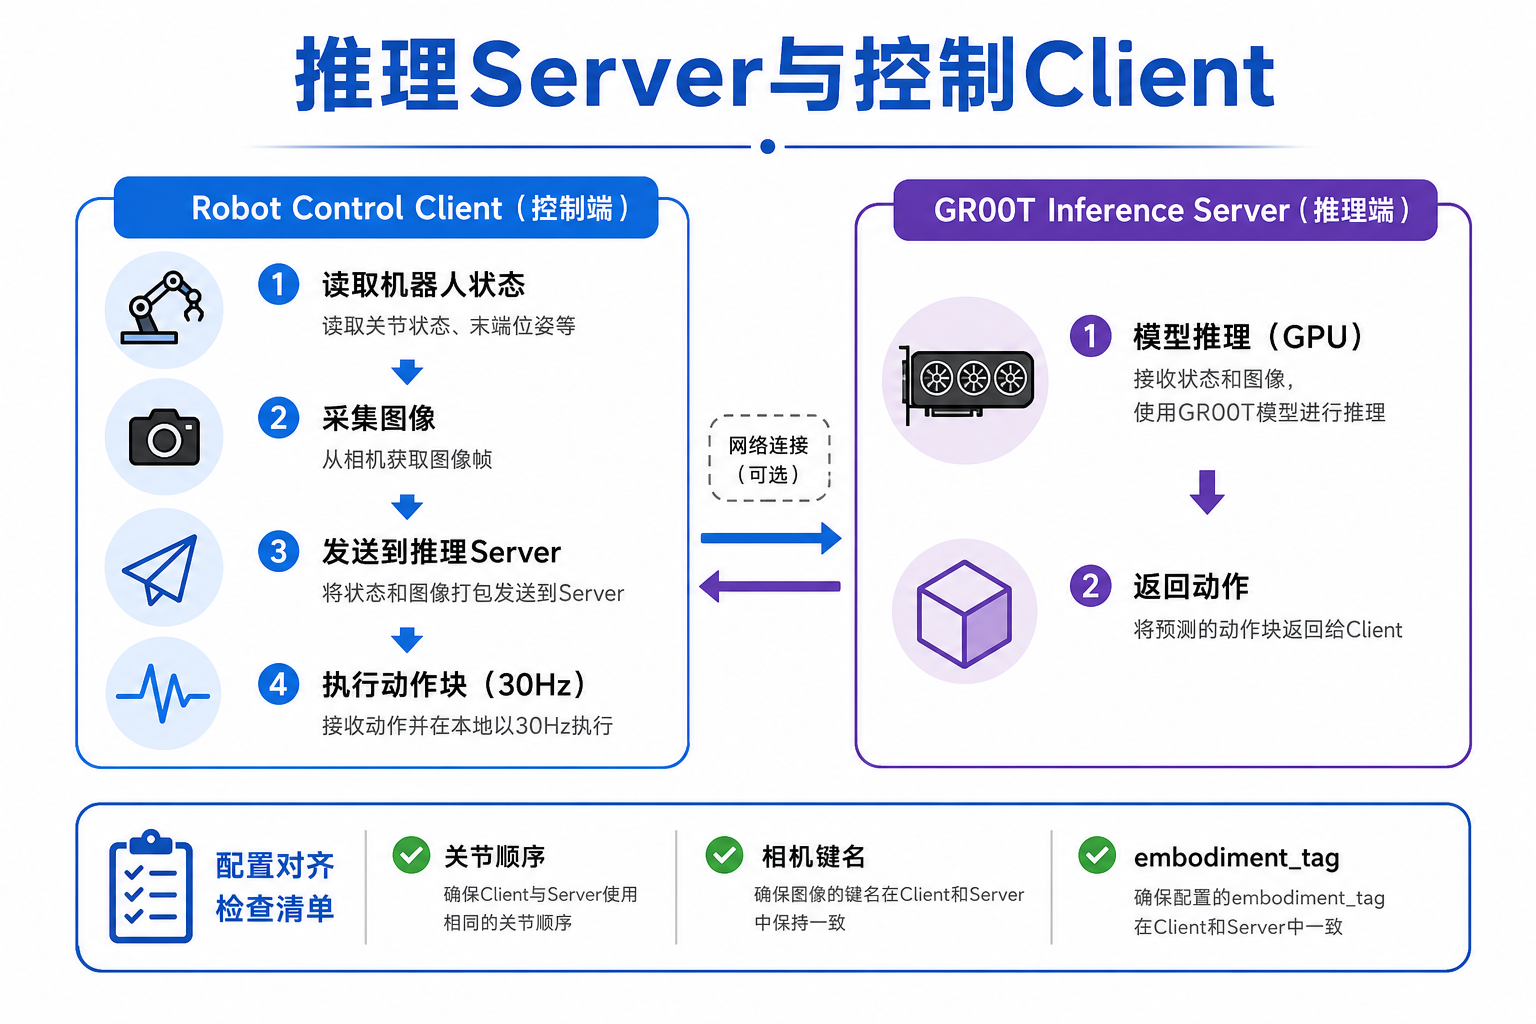
在开发板上跑通时,常把重计算与实时控制分离:
Robot Control Client(控制客户端)
职责:
- 以固定频率(如 30 Hz)读取 reBot Arm 关节 state
- 从相机抓取最新图像
- 将
{images, state, task}发给推理端 - 接收
action_chunk,按n_action_steps逐步下发到电机 - 监控安全限位、急停
LeRobot 中对应 lerobot-rollout,配置 reBot 的 robot.type、port、can_adapter、相机字典 cameras。RS 用 can0 + socketcan,DM 用 /dev/ttyACM0 + damiao。
GR00T 推理 Server(推理服务,可选)
当 GPU 在台式机、机械臂在现场时,可将策略部署为独立服务:
- 客户端通过网络发送观测 JSON / 张量
- 服务端加载
policy.path与base_model_path,返回动作块 - 降低机械臂端算力压力
LeRobot 默认将推理与 rollout 放在同一进程(--device=cuda),适合单机联调。生产环境可参考 Isaac GR00T 仓库的部署示例,将推理封装为 HTTP/gRPC 服务;核心模型接口与 LeRobot groot policy 一致。
联调检查清单
| 检查项 | 说明 |
|---|---|
| 关节顺序 | 数据集 = modality.json = rollout 驱动 |
| 角度单位 | rad 与 deg 不可混用 |
| 相机键名 | front、wrist 等与训练一致 |
| embodiment_tag | 微调与推理均为 new_embodiment |
| base_model_path | 推理时通常仍需 nvidia/GR00T-N1.7-3B 作配置基准 |
| chunk 与 RTC | n_action_steps ≤ chunk_size;RTC 队列阈值 ≤ 5 |
reBot Arm 在 GR00T 中的定位
| 项目 | reBot Arm B601 建议配置 |
|---|---|
| embodiment_tag | new_embodiment |
| state 键 | single_arm (6) + gripper (1) |
| action 键 | 与 state 对齐,7 维 |
| action 类型 | 关节空间 NON_EEF。LeRobot 可选 use_relative_actions=true(关节相对,不是 Relative EEF) |
| 动作窗口 | 训练 chunk_size=40(对齐 N1.7 action_horizon) |
| 相机 | 至少 1 路,推荐 front + wrist / side |
| 语言 | 每 episode 一句任务描述;annotation 用 human.task_description |
| 控制接口 | 见下表:RS 走 SocketCAN,DM 走达妙串口 |
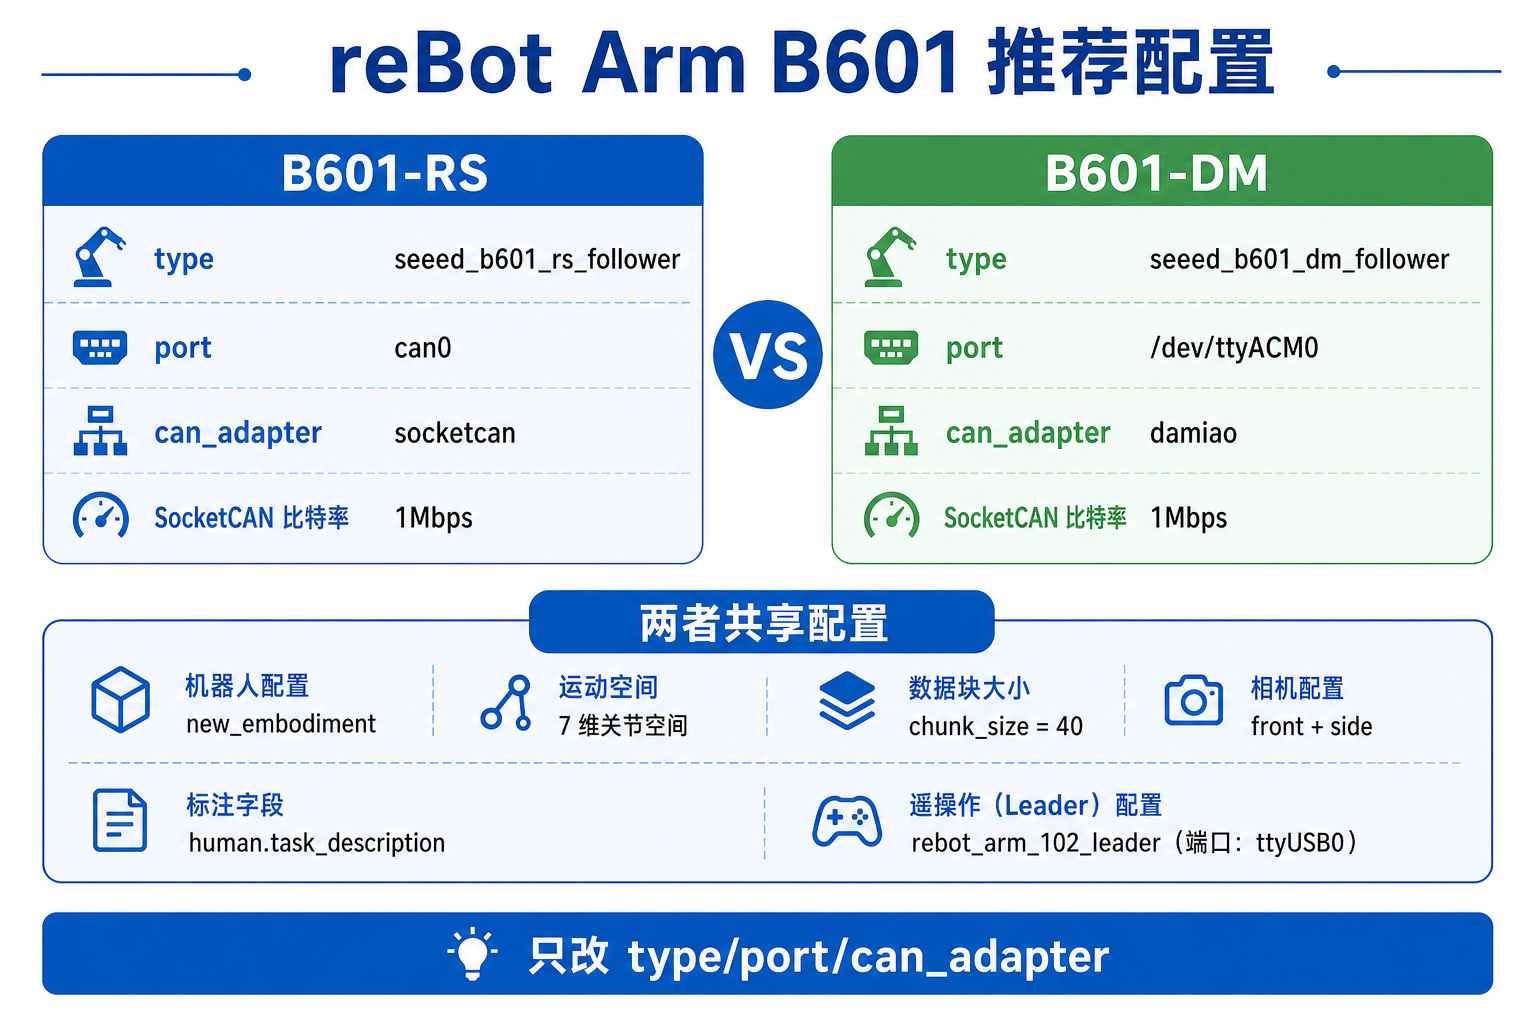
B601-RS 与 B601-DM 驱动差异(LeRobot 命令里只改这三处):
| 版本 | robot.type | robot.port | robot.can_adapter | 参考 |
|---|---|---|---|---|
| B601-RS | seeed_b601_rs_follower | can0 | socketcan | B601-RS LeRobot Wiki |
| B601-DM | seeed_b601_dm_follower | /dev/ttyACM0 | damiao | B601-DM LeRobot Wiki |
两款都是 6 轴 + 夹爪、7 维 state/action;示教端均为 --teleop.type=rebot_arm_102_leader --teleop.port=/dev/ttyUSB0。RS 使用前需配置 CAN:sudo ip link set can0 type can bitrate 1000000 && sudo ip link set can0 up。
第 20 章将手把手把已有模仿学习数据整理成上述格式;第 21 章在此基础上完成 lerobot-train 微调。
本章小结
- Embodiment 定义机器人的物理与控制接口;reBot Arm 以
new_embodiment接入 GR00T(不要套用LIBERO_PANDA/DROID等预训练标签) - State / Action 须在数据集、modality 配置、推理客户端三者间严格一致
- 相机与语言 是 VLA 的两大条件模态;reBot 的 annotation 用
human.task_description - 动作窗口:N1.7 的
action_horizon=40,与 RTC 一起决定实时性 - 机型:B601-RS(SocketCAN)与 B601-DM(达妙串口)只差
type/port/can_adapter - LeRobot 提供数据、训练、rollout 统一工具链;GR00T 提供预训练 VLA 能力
- 下一章进入实践:准备 reBot VLA 数据集