20. 准备 reBot VLA 数据集
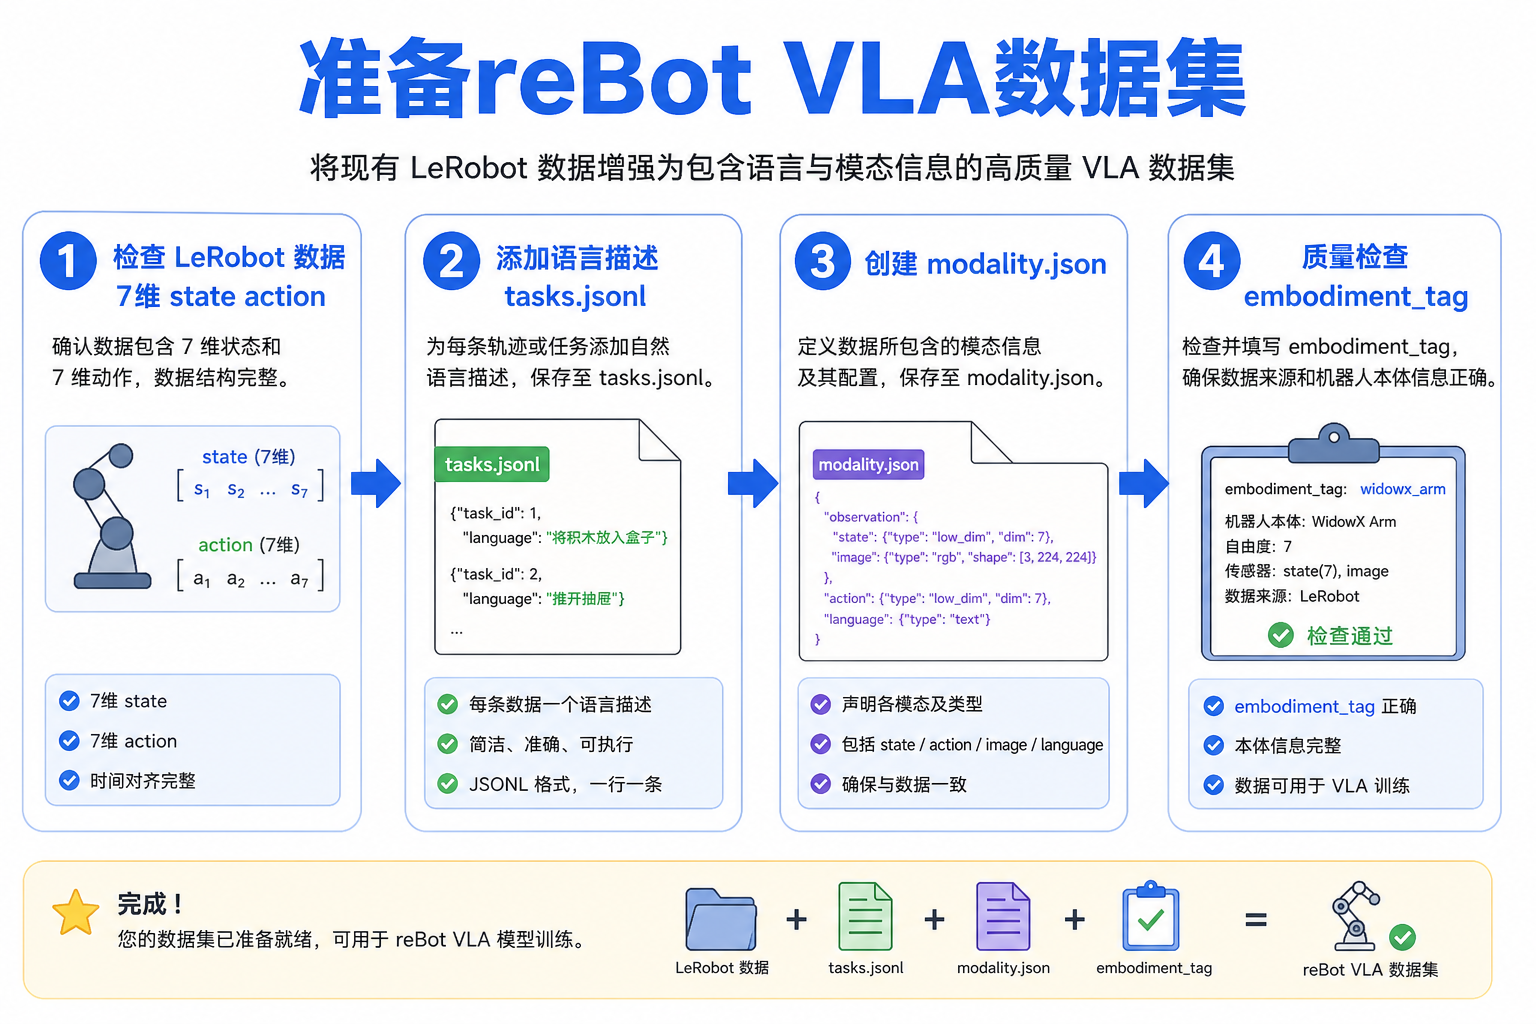
GR00T 在 LeRobot 上使用 LeRobotDataset v2/v3 格式,并额外要求 meta/modality.json 描述 state、action、video、annotation 的语义拆分。本章假设你已通过 lerobot-record 在 reBot Arm 上采集了 ACT 数据,接下来将其升级为 VLA 训练数据。
GR00T 在 LeRobot 上使用 LeRobotDataset v2/v3 格式,并额外要求 meta/modality.json 描述 state、action、video、annotation 的语义拆分。本章假设你已通过 lerobot-record 在 reBot Arm 上采集了 ACT 数据,接下来将其升级为 VLA 训练数据。
前置条件
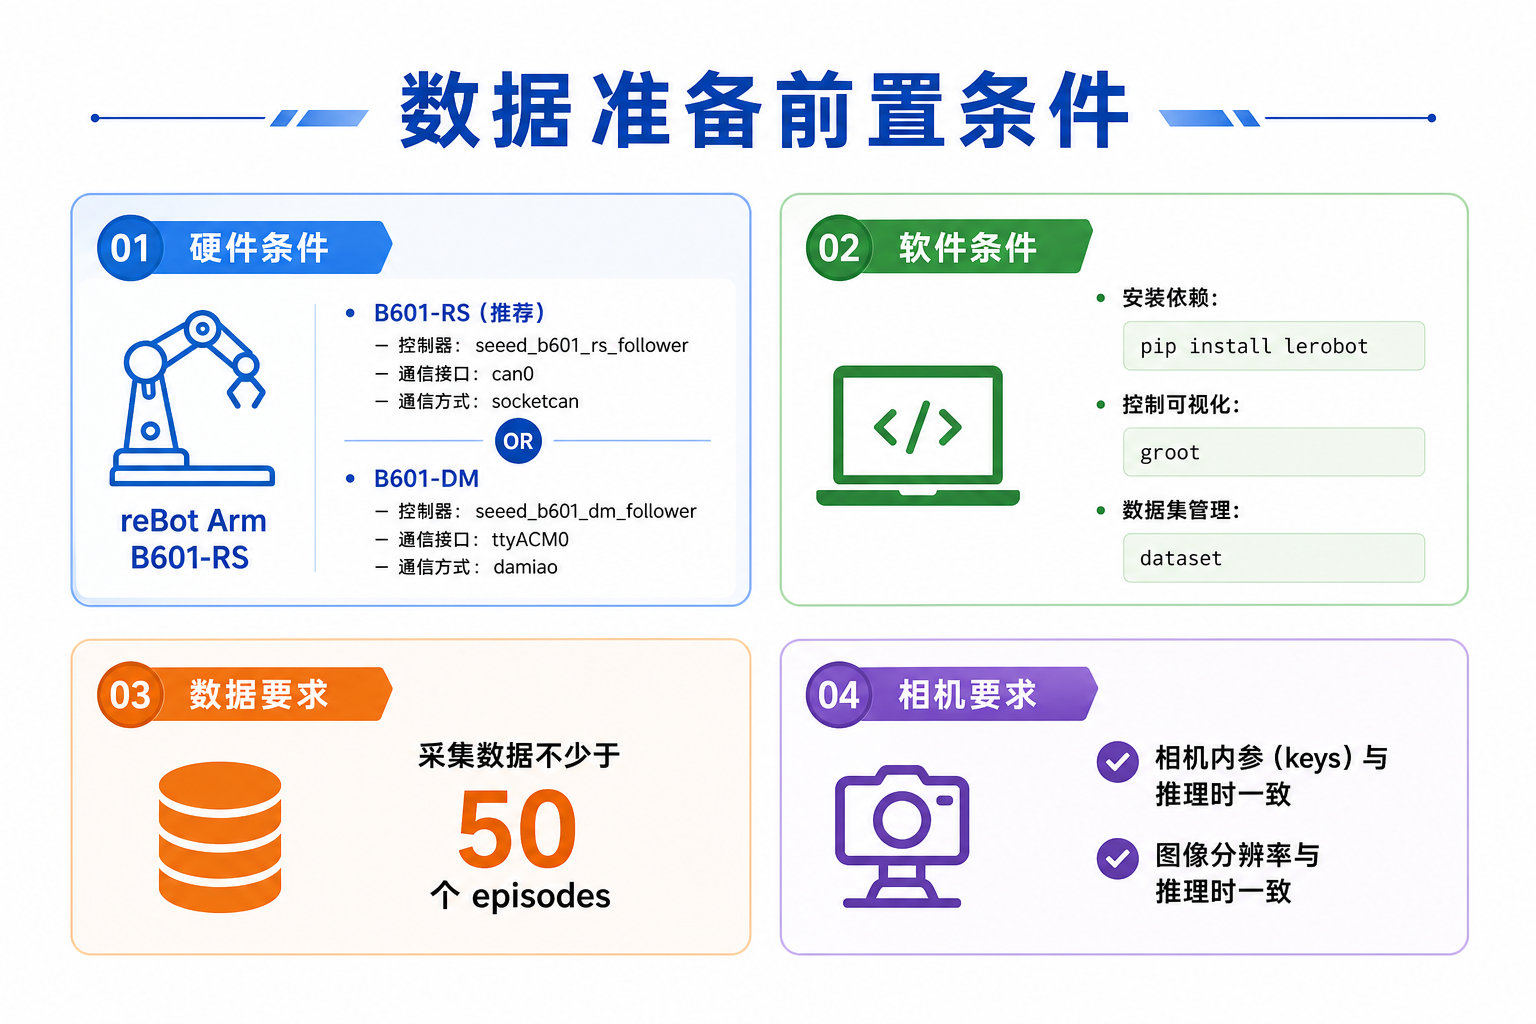
| 项目 | 要求 |
|---|---|
| 硬件 | reBot Arm B601-RS 或 B601-DM 已校准(见下表) |
| 软件 | LeRobot 已安装,建议 pip install "lerobot[groot,training]" |
| 数据 | 至少一种任务 50 条成功演示;多任务时每种任务建议 ≥ 30 条 |
| 相机 | 训练与推理使用相同键名、分辨率、数量 |
机型对照(后续所有 lerobot-record / lerobot-rollout 只改这三处):
| 版本 | robot.type | robot.port | robot.can_adapter | Wiki |
|---|---|---|---|---|
| B601-RS | seeed_b601_rs_follower | can0 | socketcan | 入门 LeRobot |
| B601-DM | seeed_b601_dm_follower | /dev/ttyACM0 | damiao | 入门 LeRobot |
RS 使用前配置 CAN:sudo ip link set can0 type can bitrate 1000000 && sudo ip link set can0 up。示教端均为 rebot_arm_102_leader,端口常见 /dev/ttyUSB0。
参考文档:
检查 LeRobot 数据集
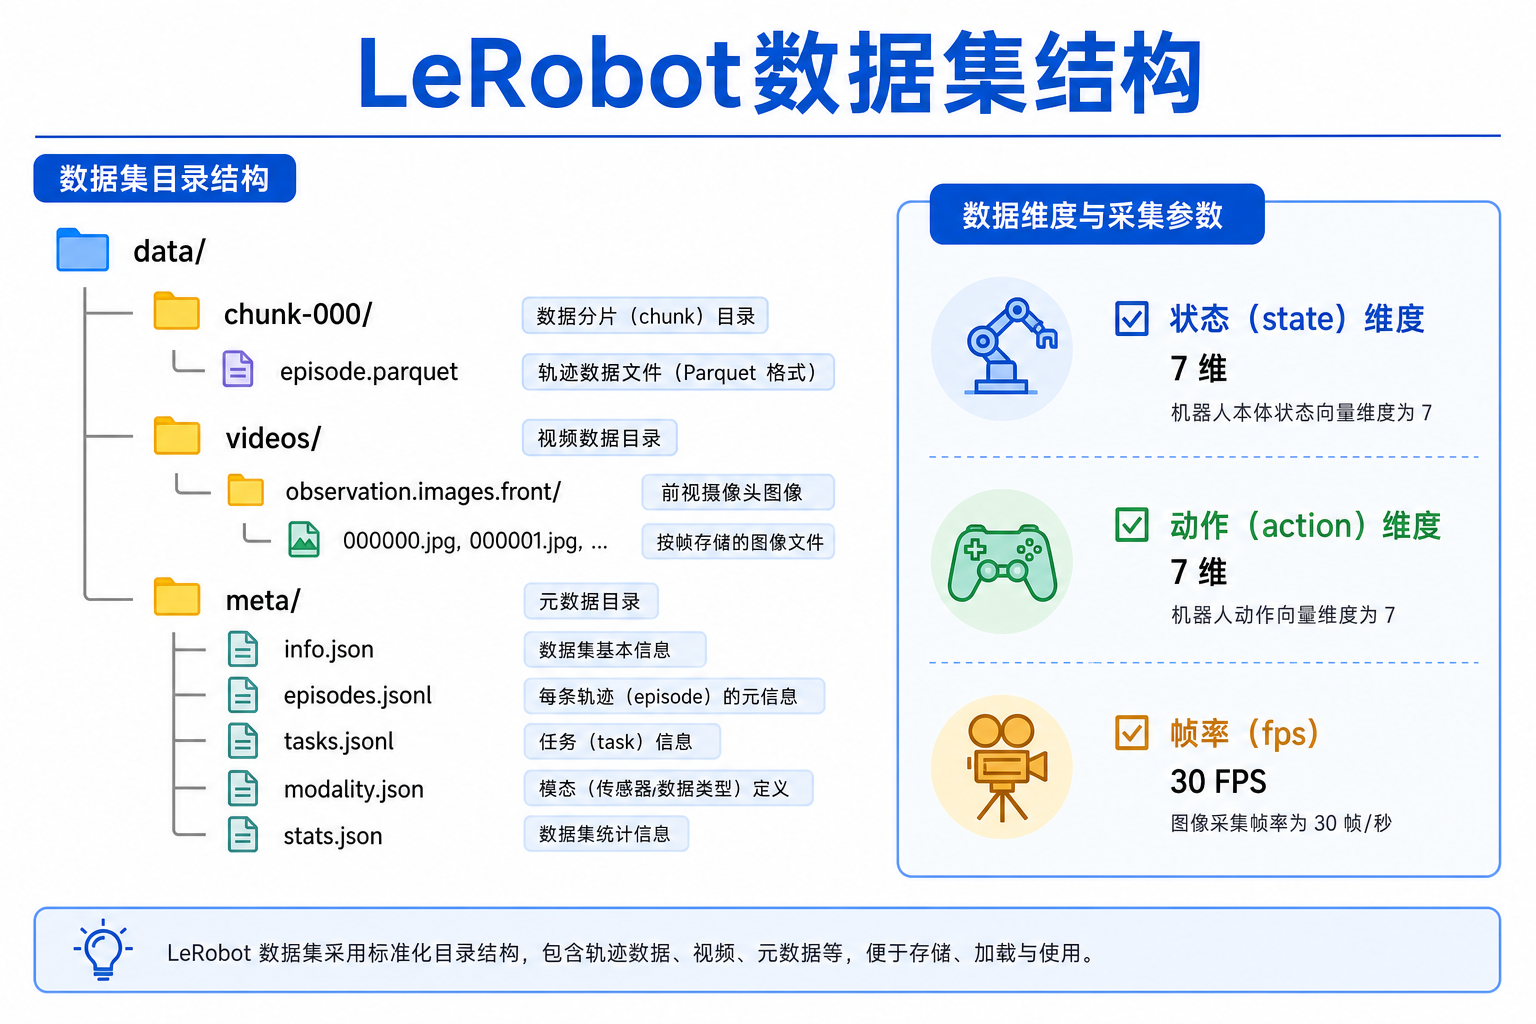
数据集目录结构
本地数据集默认位于:
~/.cache/huggingface/lerobot/<repo_id>/
├── data/
│   └── chunk-000/
│       └── episode_*.parquet
├── videos/
│   └── chunk-000/
│       └── observation.images.<camera_name>/
├── meta/
│   ├── info.json
│   ├── episodes.jsonl
│   ├── tasks.jsonl          ← 语言任务描述
│   ├── stats.json
│   └── modality.json        ← GR00T 必需,需手动创建或校验
用 Python 快速检查
from lerobot.datasets.lerobot_dataset import LeRobotDataset

dataset = LeRobotDataset("seeed_rebot_b601_rs/pick_cube")  # RS 示例;DM 改为 seeed_rebot_b601_dm/pick_cube
print(dataset)
print("特征键:", dataset.features.keys())
print("第 0 帧 state shape:", dataset[0]["observation.state"].shape)
print("第 0 帧 action shape:", dataset[0]["action"].shape)
必查项清单
| 检查项 | 期望值(reBot B601-RS / B601-DM 单臂) |
|---|---|
observation.state 维度 | (7,) — 6 关节 + 1 夹爪 |
action 维度 | (7,) — 与 state 对齐 |
| 视频键 | 如 observation.images.front、observation.images.side |
| FPS | 通常 30 |
tasks.jsonl | 每个 task_index 有对应语言描述 |
| 失败 episode | 已删除或标记,避免污染训练 |
若 state/action 不是 7 维,说明录制时机器人配置有误,需回到 lerobot-record 排查,不要强行改 modality.json 凑维度。
添加语言任务描述
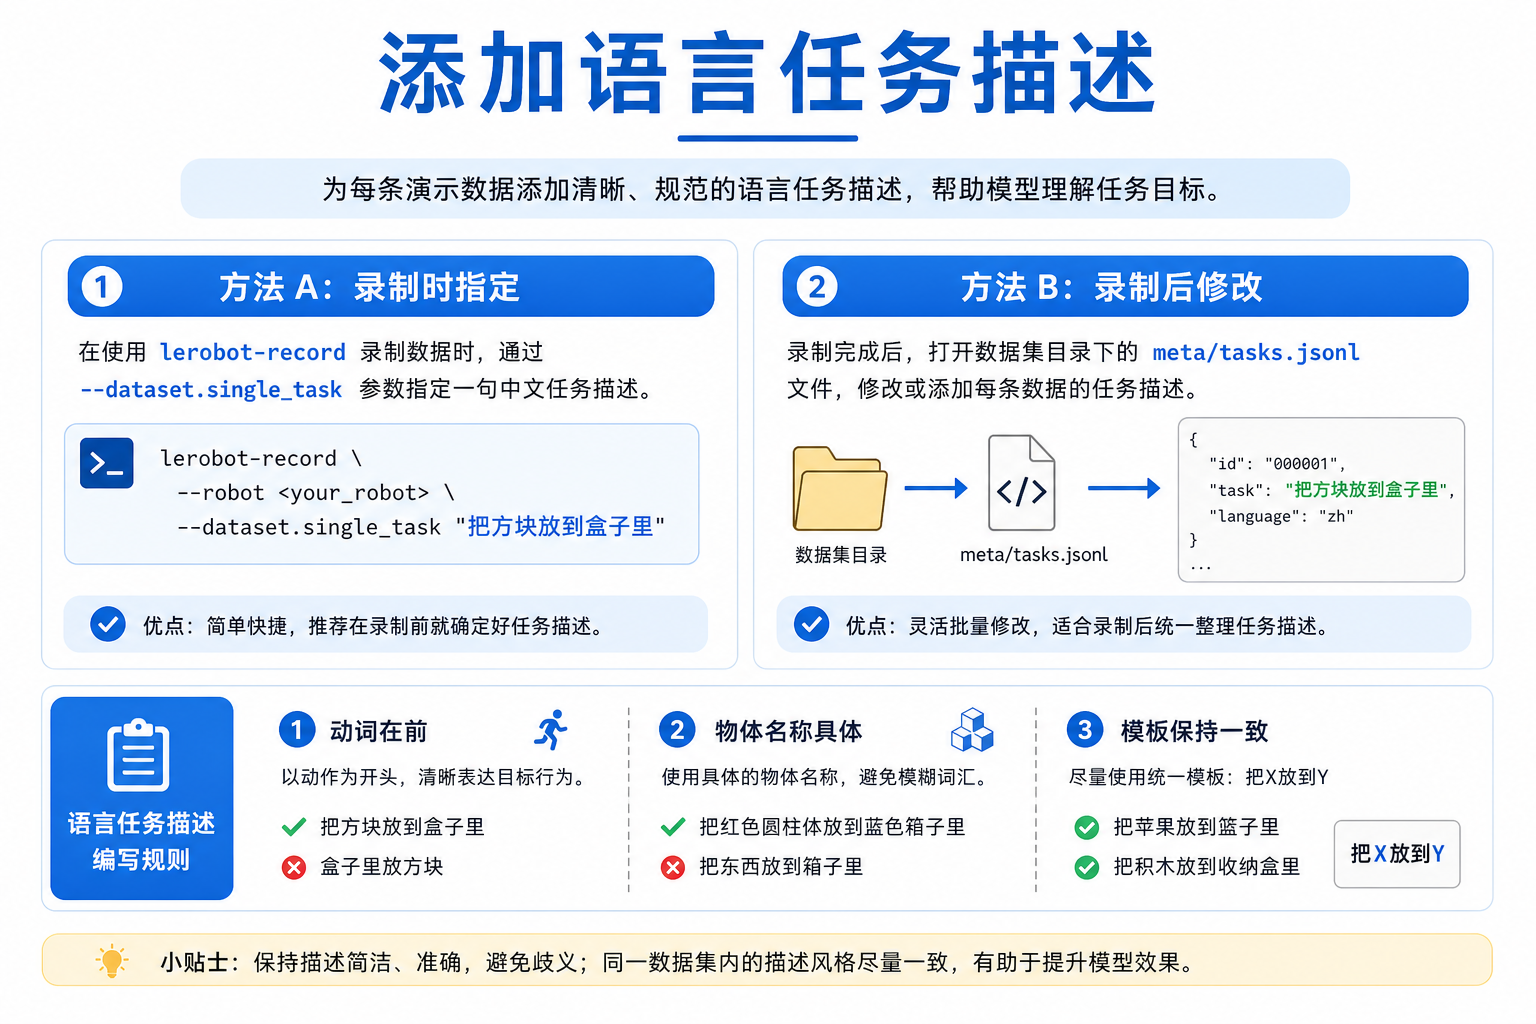
VLA 训练必须有语言条件。有两种方式:
方式 A:录制时直接写入(推荐)
每条 episode 录制时通过 --dataset.single_task 指定。下面以 B601-RS 为例(Wiki);DM 用户把 type / port / can_adapter 换成 seeed_b601_dm_follower、/dev/ttyACM0、damiao。
# RS:先拉起 CAN
sudo ip link set can0 down 2>/dev/null
sudo ip link set can0 type can bitrate 1000000
sudo ip link set can0 up

lerobot-record \
  --robot.type=seeed_b601_rs_follower \
  --robot.port=can0 \
  --robot.id=follower1 \
  --robot.can_adapter=socketcan \
  --robot.cameras="{ front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30, fourcc: \"MJPG\"}, side: {type: opencv, index_or_path: 2, width: 640, height: 480, fps: 30, fourcc: \"MJPG\"}}" \
  --teleop.type=rebot_arm_102_leader \
  --teleop.port=/dev/ttyUSB0 \
  --teleop.id=rebot_arm_102_leader \
  --display_data=true \
  --dataset.repo_id=${HF_USER}/rebot_vla_pick_cube \
  --dataset.num_episodes=50 \
  --dataset.single_task="把黑色方块放到蓝色托盘里" \
  --dataset.push_to_hub=false \
  --dataset.episode_time_s=30 \
  --dataset.reset_time_s=20
方式 B:事后补写 meta/tasks.jsonl
若已有 ACT 数据缺少语言,编辑 meta/tasks.jsonl:
{"task_index": 0, "task": "把黑色方块放到蓝色托盘里"}
{"task_index": 1, "task": "把螺丝刀放进工具盒"}
多任务数据集中,不同 episode 通过 task_index 字段关联到不同描述。同一任务的所有 episode 应共用同一个 task_index。
语言标注规范
- 动词开头,描述目标行为:「抓取…」「放置…」「推开…」
- 物体名具体:「黑色方块」优于「物体」
- 句式统一:多任务时保持相同模板,如都用「把 X 放到 Y」
- 中英皆可,但训练与推理语言应一致
- 避免一条数据多种说法(微调初期)
配置 State Keys 与 Action Keys
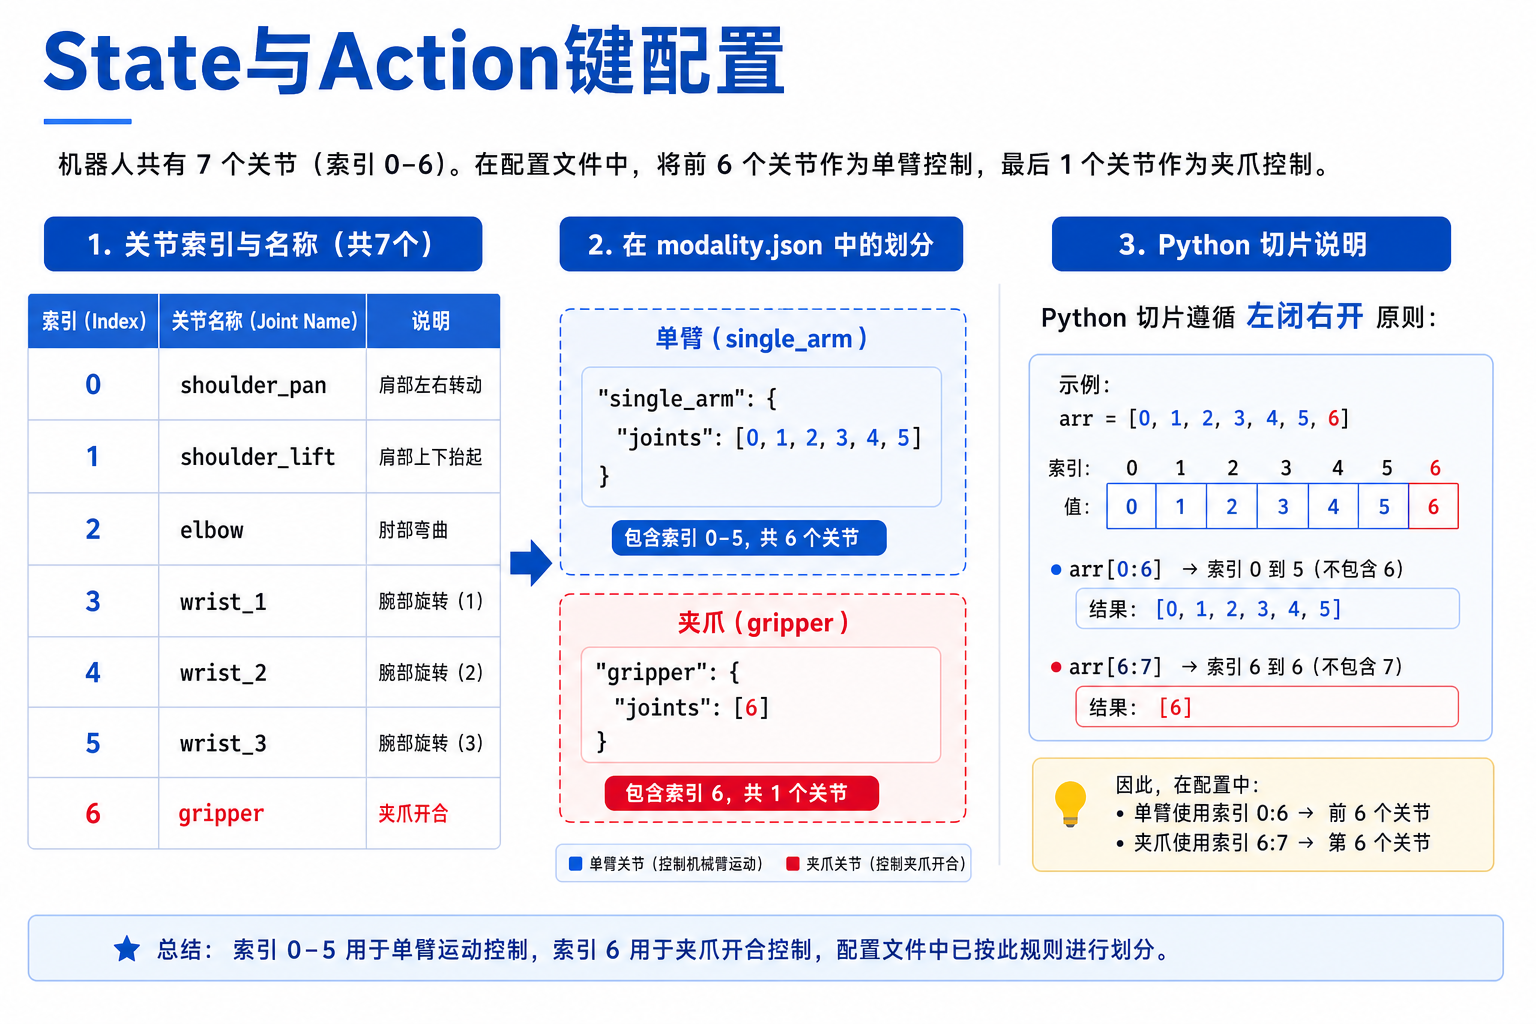
reBot Arm B601-RS / B601-DM 的 7 维向量按以下关节顺序拼接(与 LeRobot 驱动一致):
| 索引 | 键名(语义) | 含义 |
|---|---|---|
| 0 | shoulder_pan | 肩部旋转 |
| 1 | shoulder_lift | 肩部抬升 |
| 2 | elbow_flex | 肘部弯曲 |
| 3 | wrist_flex | 腕部弯曲 |
| 4 | wrist_yaw | 腕部偏航 |
| 5 | wrist_roll | 腕部滚转 |
| 6 | gripper | 夹爪开合 |
在 GR00T 的 modality.json 中,将上述 7 维拆分为两个语义键:
single_arm:索引 0–5(6 个关节)gripper:索引 6(夹爪)
注意:Python 切片规则为左闭右开,
"end": 6表示取到索引 5,"start": 6, "end": 7表示取索引 6。
配置 Camera Keys
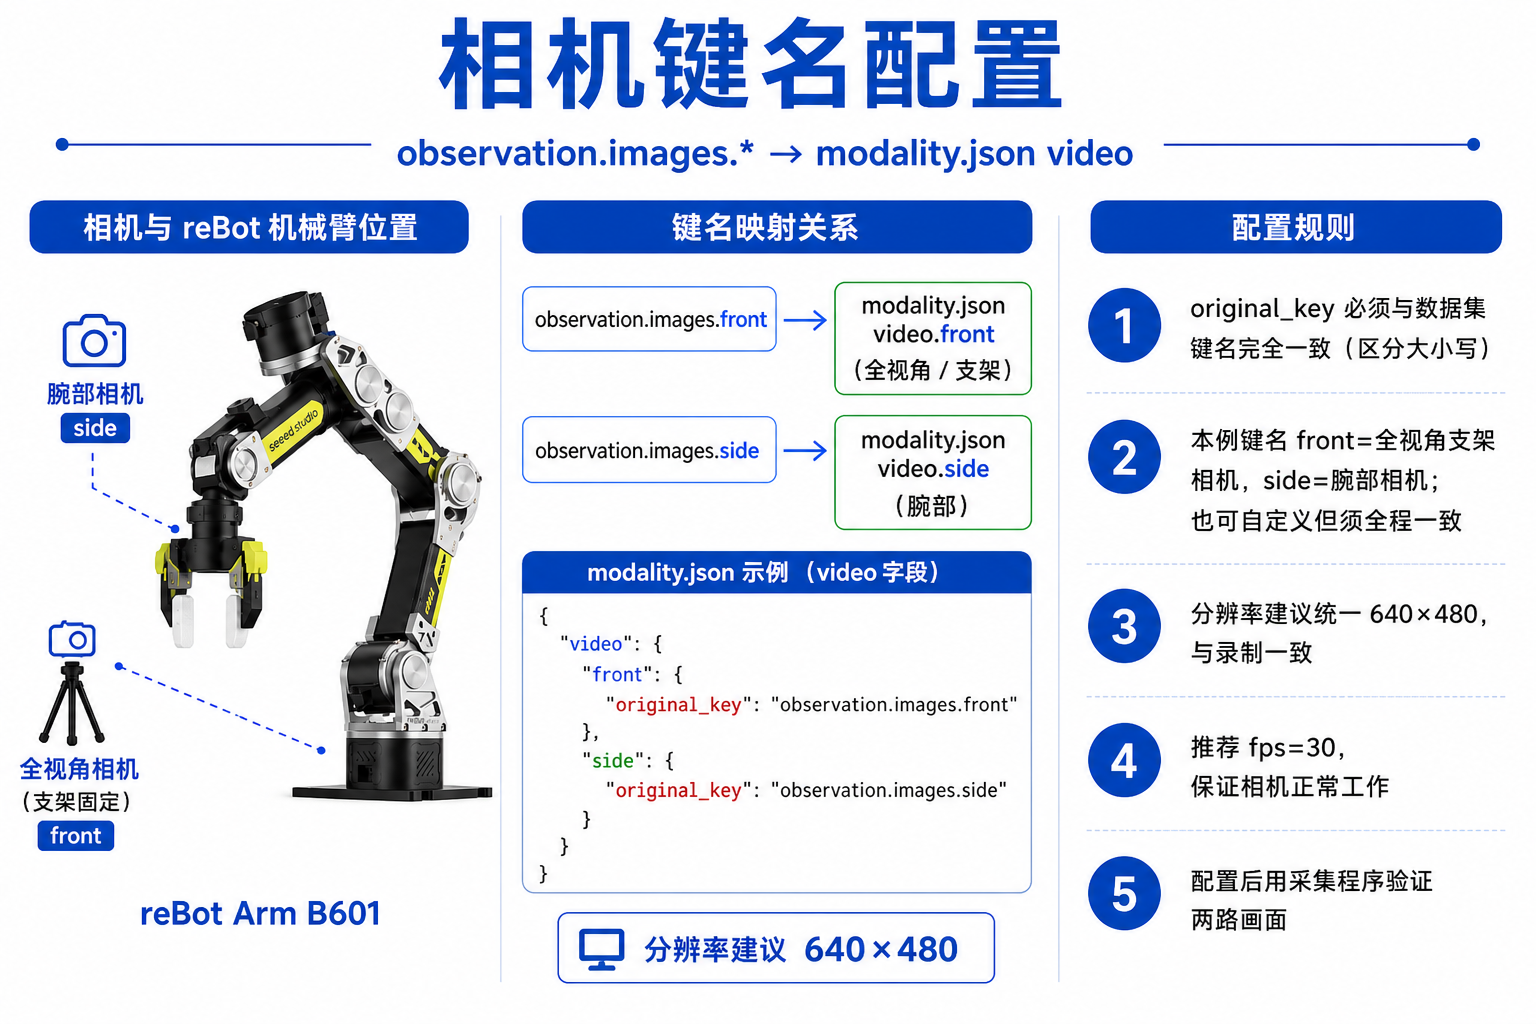
GR00T 通过 modality.json 的 video 字段,把数据集中的原始相机键映射为标准键名。
reBot 常见相机布局
| 数据集键(original_key) | modality 标准键 | 建议用途 |
|---|---|---|
observation.images.front | front | 支架固定全视角 |
observation.images.side | side | 腕部近景 |
示例:若录制时相机键为 front 和 side:
"video": {
  "front": {
    "original_key": "observation.images.front"
  },
  "side": {
    "original_key": "observation.images.side"
  }
}
关键原则:
original_key必须与数据集中实际键名完全一致- modality 左侧的标准键名(
front、side)将在训练和推理时统一使用 - 单相机也可训练,但双相机通常效果更好
- 分辨率建议统一 640×480,与录制参数一致
查找本机相机索引:
lerobot-find-cameras opencv
创建 meta/modality.json
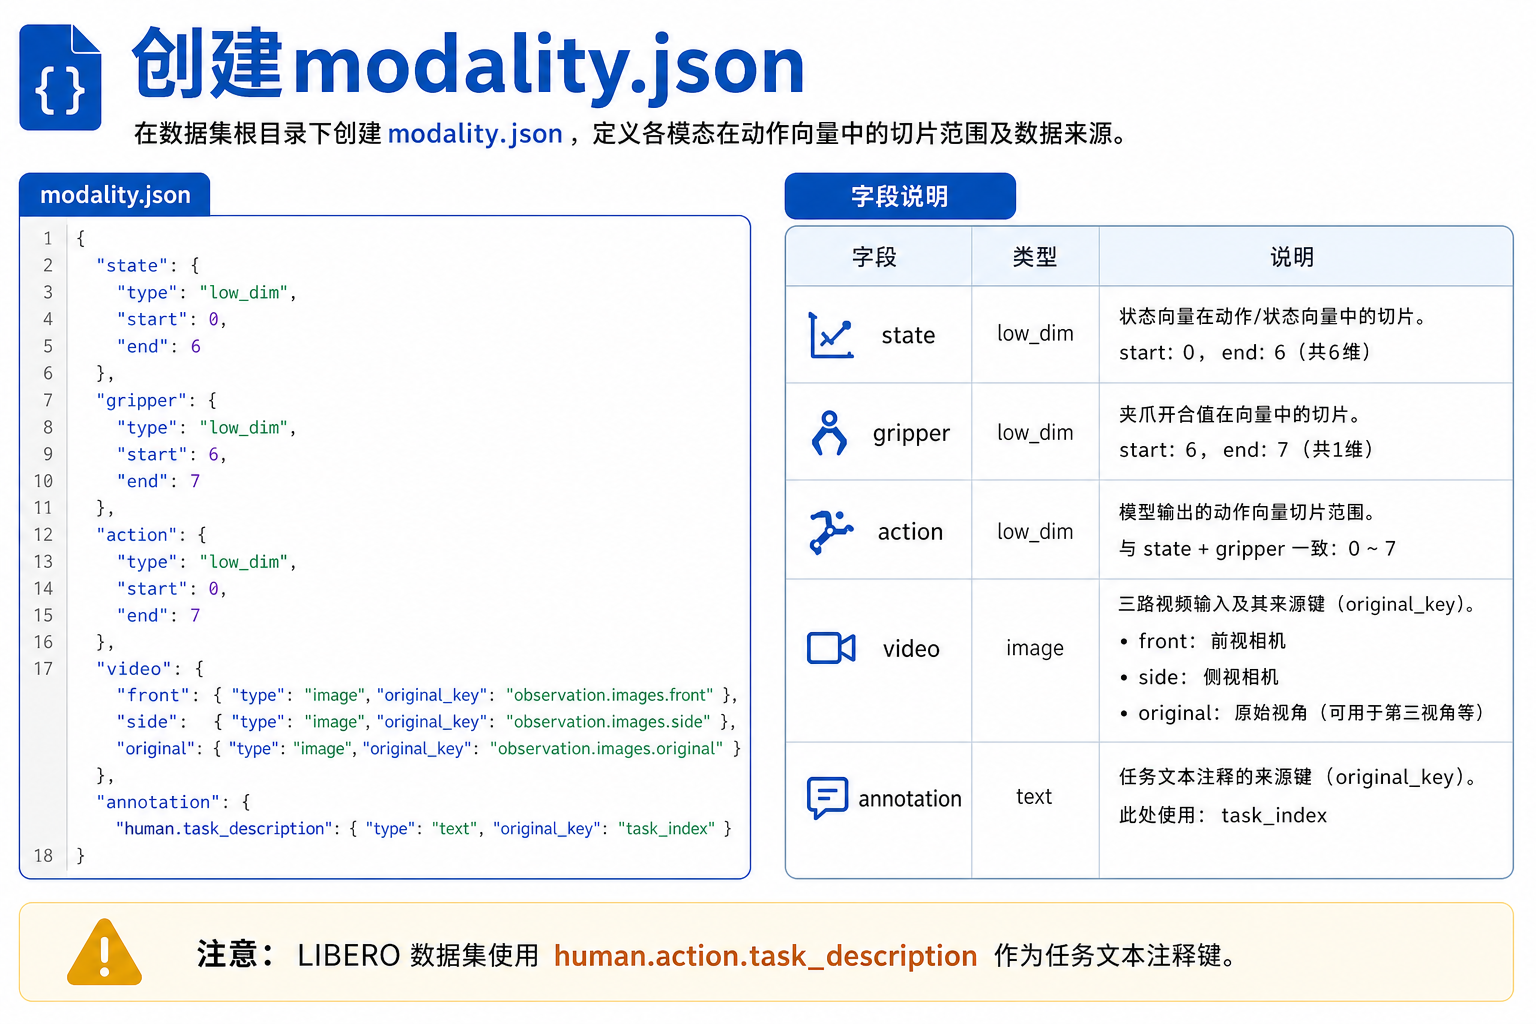
在数据集 meta/ 目录下创建 modality.json。以下是 reBot Arm B601 单臂 7 维关节空间(RS / DM 相同)的完整示例:
{
  "state": {
    "single_arm": {
      "start": 0,
      "end": 6
    },
    "gripper": {
      "start": 6,
      "end": 7
    }
  },
  "action": {
    "single_arm": {
      "start": 0,
      "end": 6
    },
    "gripper": {
      "start": 6,
      "end": 7
    }
  },
  "video": {
    "front": {
      "original_key": "observation.images.front"
    },
    "side": {
      "original_key": "observation.images.side"
    }
  },
  "annotation": {
    "human.task_description": {
      "original_key": "task_index"
    }
  }
}
字段说明
| 字段 | 作用 |
|---|---|
state / action | 定义拼接向量中各子段的索引范围 |
video | 将 LeRobot 视频键映射为 GR00T 标准相机名 |
annotation | 将 task_index 关联到 tasks.jsonl。reBot 用 human.task_description;LIBERO / SimplerEnv 用 human.action.task_description |
若数据集只有一种任务、没有 task_index 字段,需先确保 lerobot-record 写入了 tasks.jsonl,否则 GR00T 无法读取语言条件。
设置 Embodiment Tag
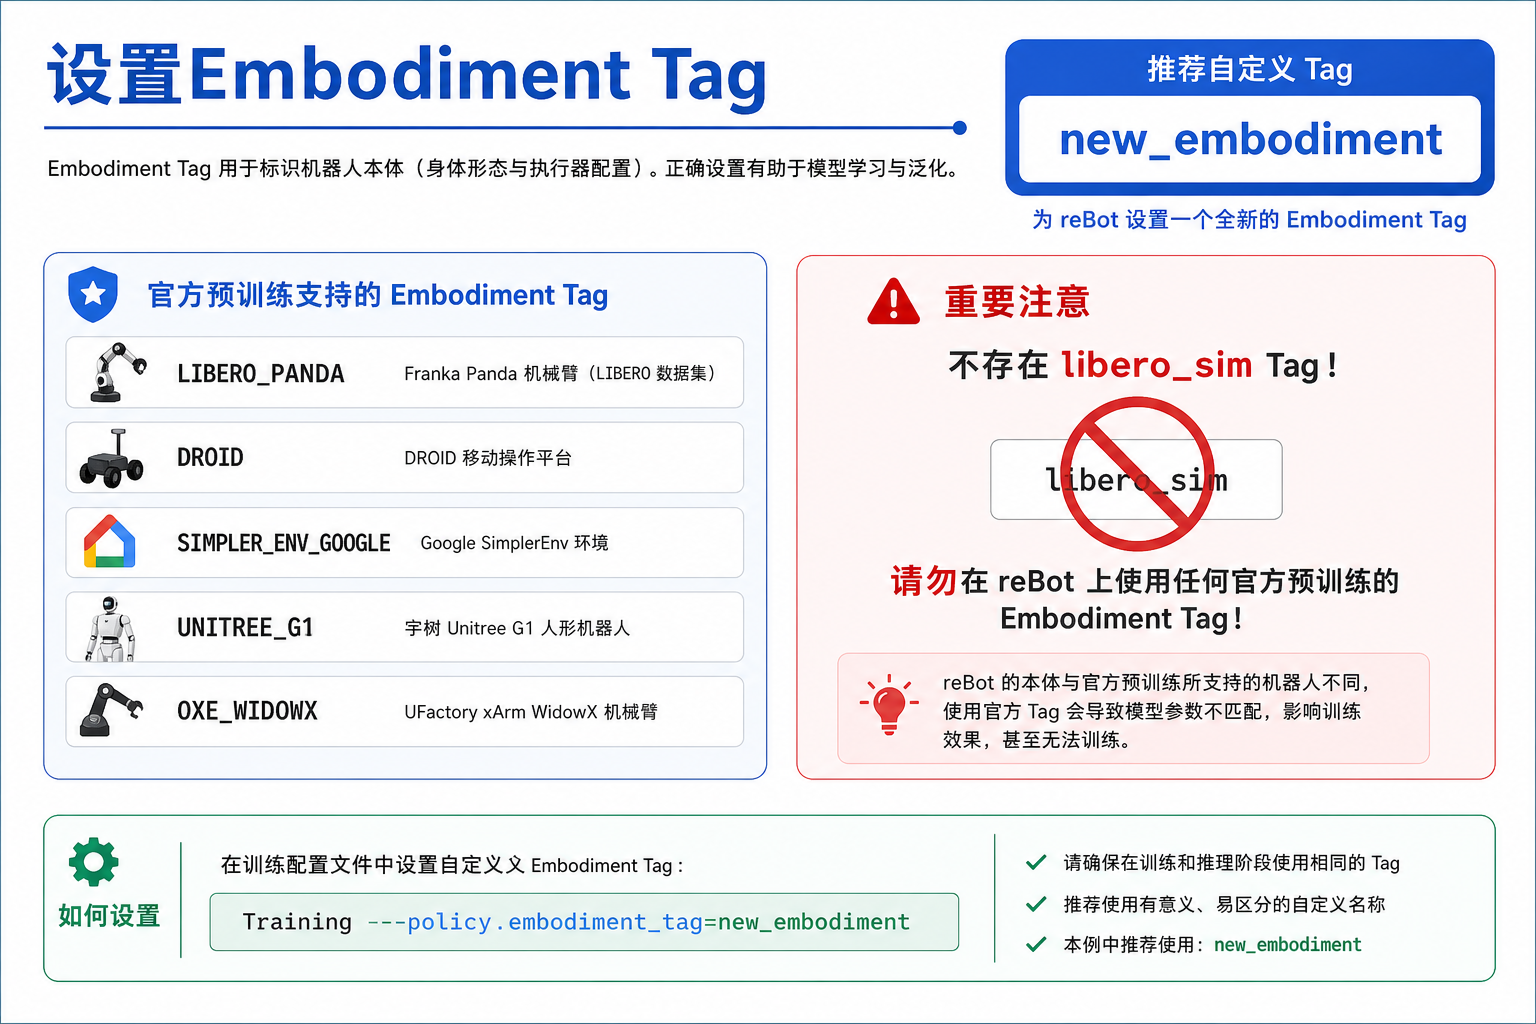
对 reBot Arm 这类自定义机器人,训练和推理统一使用:
embodiment_tag = new_embodiment
含义:
- 告知 GR00T 使用 新本体投影层,不复用预训练人形机器人的 state/action 维度
- LeRobot 训练参数:
--policy.embodiment_tag=new_embodiment - 微调后 checkpoint 会保存对应的 modality 配置,推理时自动加载
不要在 reBot 数据上使用 LIBERO_PANDA、DROID、SIMPLER_ENV_GOOGLE 等预训练标签——它们的 state/action 维度和语义与 reBot 不匹配。也不存在 libero_sim 这一官方标签。
检查关节顺序和数据维度
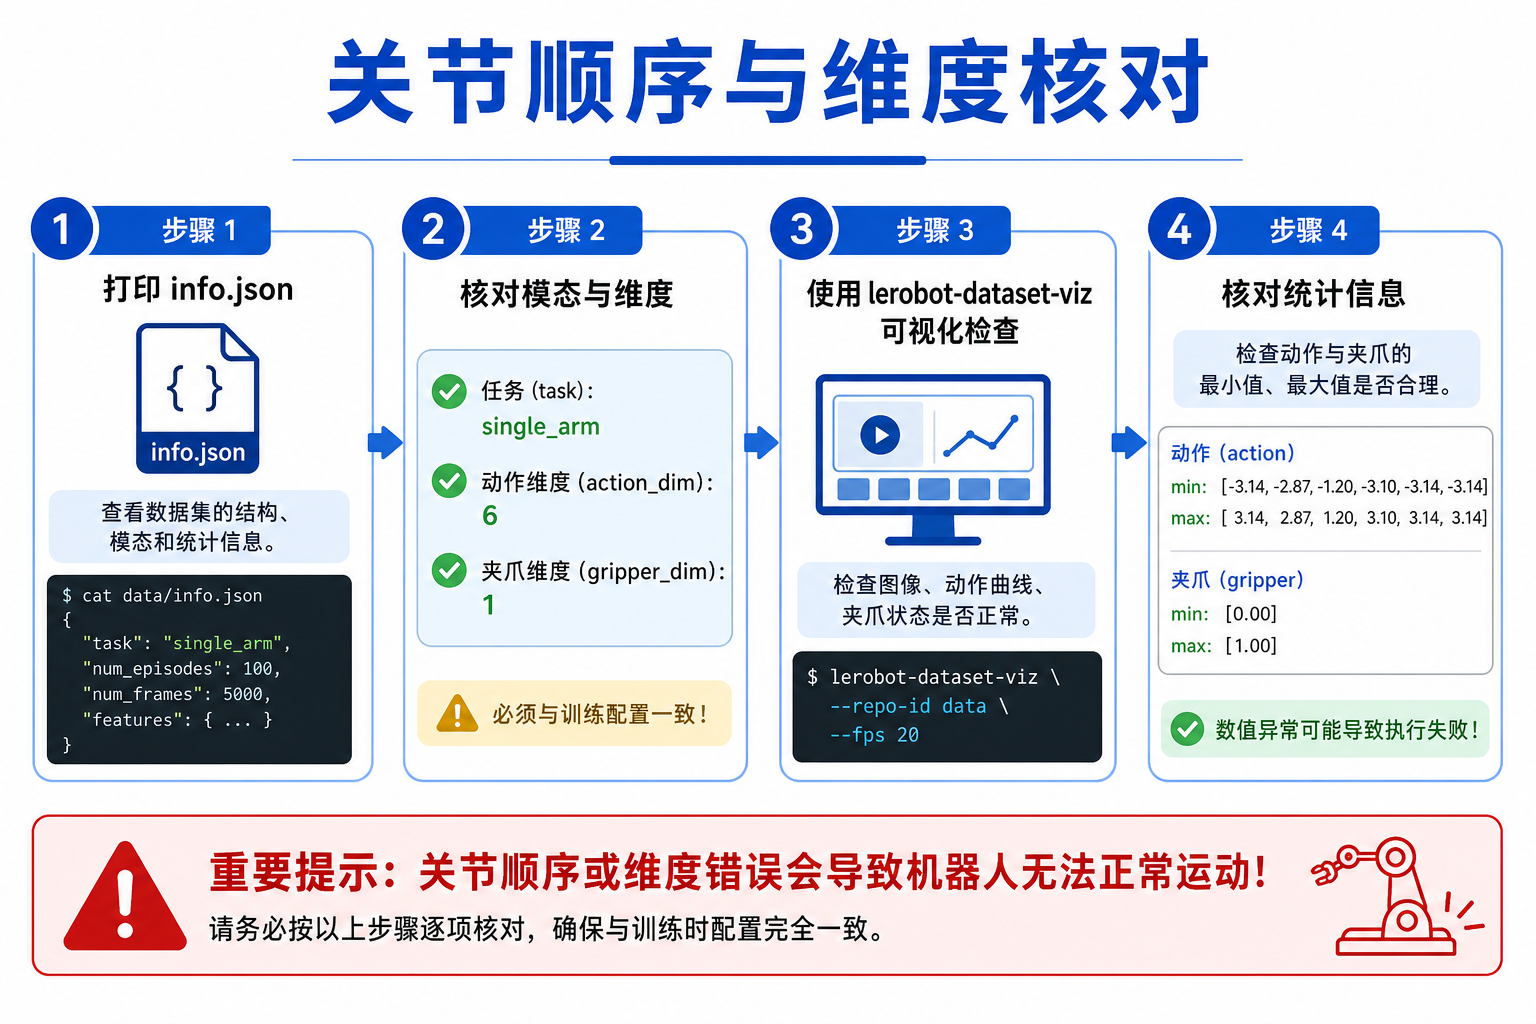
这是最容易导致「训练 loss 下降但真机完全不动」的问题。请逐项核对:
步骤 1:打印数据集 meta
import json
from pathlib import Path

meta_dir = Path.home() / ".cache/huggingface/lerobot/seeed_rebot_b601_rs/pick_cube/meta"
print(json.dumps(json.loads((meta_dir / "info.json").read_text()), indent=2))
print((meta_dir / "modality.json").read_text())
步骤 2:验证 modality 切片
import numpy as np
from lerobot.datasets.lerobot_dataset import LeRobotDataset

ds = LeRobotDataset("seeed_rebot_b601_rs/pick_cube")
s = ds[0]["observation.state"].numpy()
mod = json.loads((meta_dir / "modality.json").read_text())

arm = s[mod["state"]["single_arm"]["start"]:mod["state"]["single_arm"]["end"]]
grip = s[mod["state"]["gripper"]["start"]:mod["state"]["gripper"]["end"]]
print("single_arm:", arm.shape)  # 期望 (6,)
print("gripper:", grip.shape)    # 期望 (1,)
步骤 3:可视化数据
lerobot-dataset-viz --repo_id=seeed_rebot_b601_rs/pick_cube --episode-index=0
观察:
- 图像是否与关节运动同步
- 夹爪开合时
gripper维度是否变化 - 语言描述是否与画面内容一致
步骤 4:统计检查
print(ds.meta.stats["observation.state"])
print(ds.meta.stats["action"])
若某维度 min == max(无变化),说明该关节在数据中未运动,可考虑从训练中排除或重新采集。
多任务数据集组织
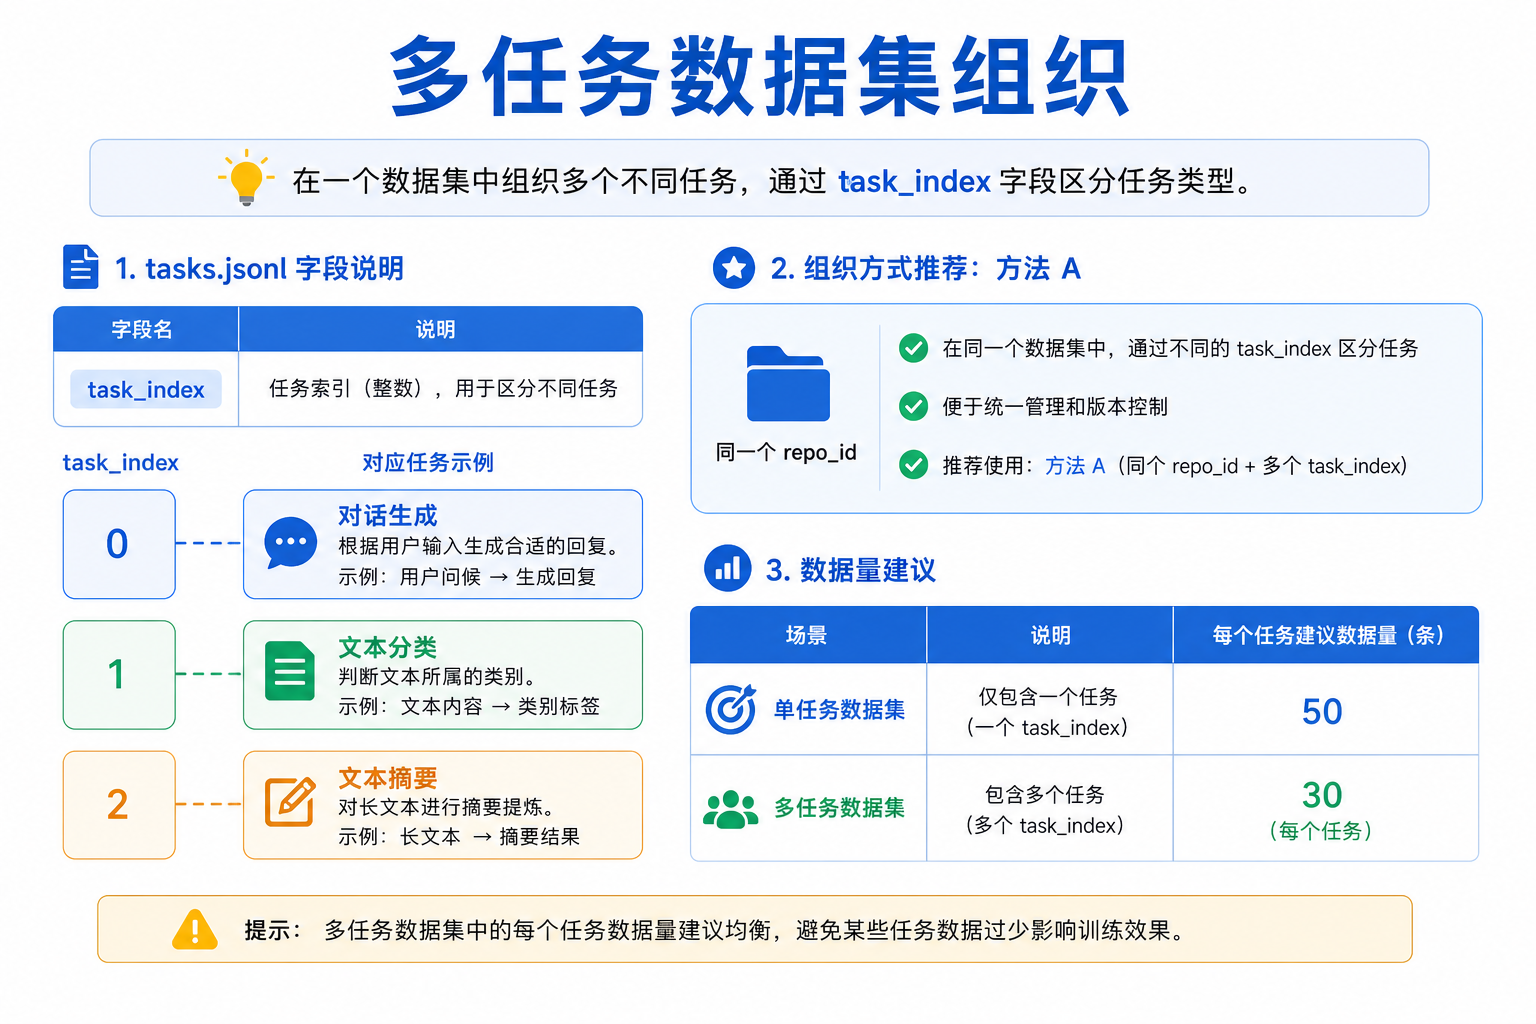
若要训练「一个模型、多种语言任务」,推荐两种方式:
方式 A:同一 repo_id,多 task_index(推荐)
{"task_index": 0, "task": "把黑色方块放到蓝色托盘里"}
{"task_index": 1, "task": "把螺丝刀放进工具盒"}
{"task_index": 2, "task": "把红色杯子推到桌子左侧"}
录制时轮换 --dataset.single_task,或分批次录制后合并到同一数据集。
方式 B:多个数据集合并
LeRobot 支持多数据集训练(视版本而定);更简单的方式是录制时统一 repo_id,用 task_index 区分。
数据量建议
| 场景 | 建议 |
|---|---|
| 单任务入门 | 50 episodes |
| 单任务稳定 | 100–200 episodes |
| 多任务(3 种) | 每种 ≥ 30 episodes |
| 位置泛化 | 每种位置变体 ≥ 10 episodes |
数据质量检查清单
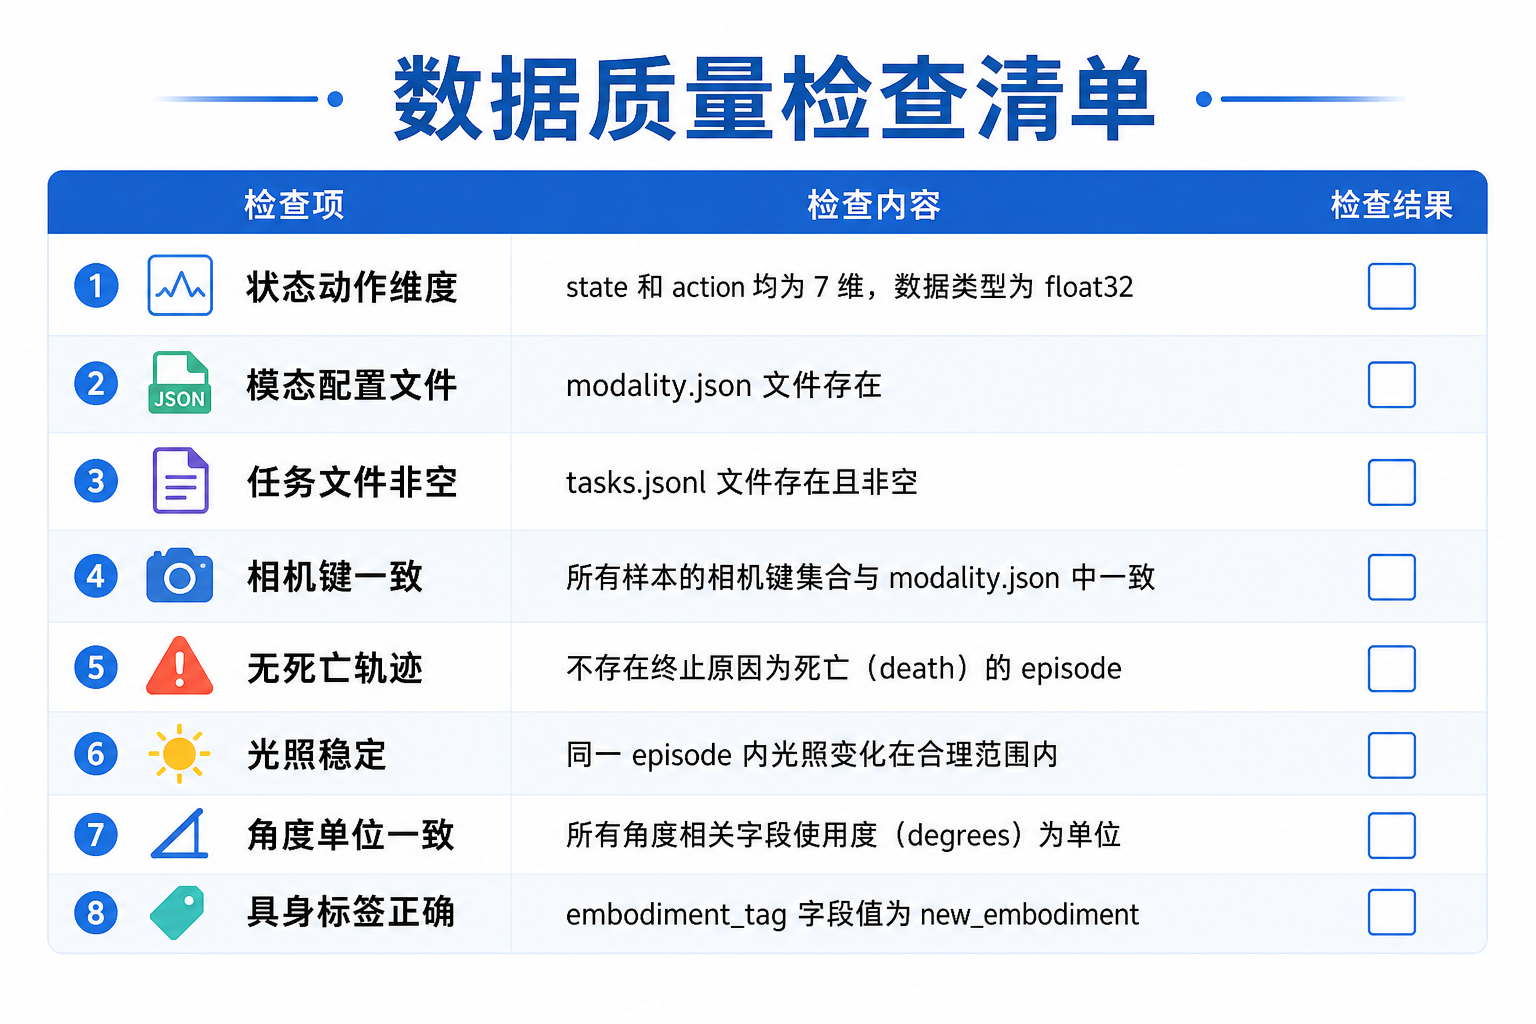
上传 Hub 或开始训练前,确认:
-
observation.state和action均为 7 维 float32 -
meta/modality.json存在且索引切片正确 -
meta/tasks.jsonl中每个 task_index 有非空描述 -
相机键名在
modality.json与数据集中一致 -
无全零 / 静止不动的废 episode
-
相机固定、物体在视野内、光照稳定
-
角度单位统一(reBot 底层电机 API 用度,LeRobot 驱动内部已转为弧度;数据集与训练推理须保持一致)
-
embodiment_tag计划使用new_embodiment
推送到 Hugging Face Hub(可选)
huggingface-cli login
lerobot-record ... --dataset.push_to_hub=true
# 或手动上传
huggingface-cli upload ${HF_USER}/rebot_vla_pick_cube ~/.cache/huggingface/lerobot/seeed_rebot_b601_rs/pick_cube
本章小结
- GR00T 需要标准 LeRobot 数据 +
meta/modality.json - reBot 7 维向量拆为
single_arm(6) +gripper(1);RS / DM 维度相同,只换驱动参数 - 语言通过
tasks.jsonl+annotation.human.task_description接入 - 相机键名必须在录制、modality、推理三处对齐
- 下一章将用整理好的数据启动
lerobot-train --policy.type=groot