22. GR00T 推理与真机部署
第 21 章完成了微调与基础真机命令;本章把推理部署单独拆开:讲清推理端与控制端如何解耦、同机/分布式怎么选、输入输出如何对齐,以及延迟、异步缓存、安全限位和任务评估。最后用阶段项目「将试管放入左侧试管架」把整条链路跑通。
第 21 章完成了微调与基础真机命令;本章把推理部署单独拆开:讲清推理端与控制端如何解耦、同机/分布式怎么选、输入输出如何对齐,以及延迟、异步缓存、安全限位和任务评估。最后用阶段项目「将试管放入左侧试管架」把整条链路跑通。
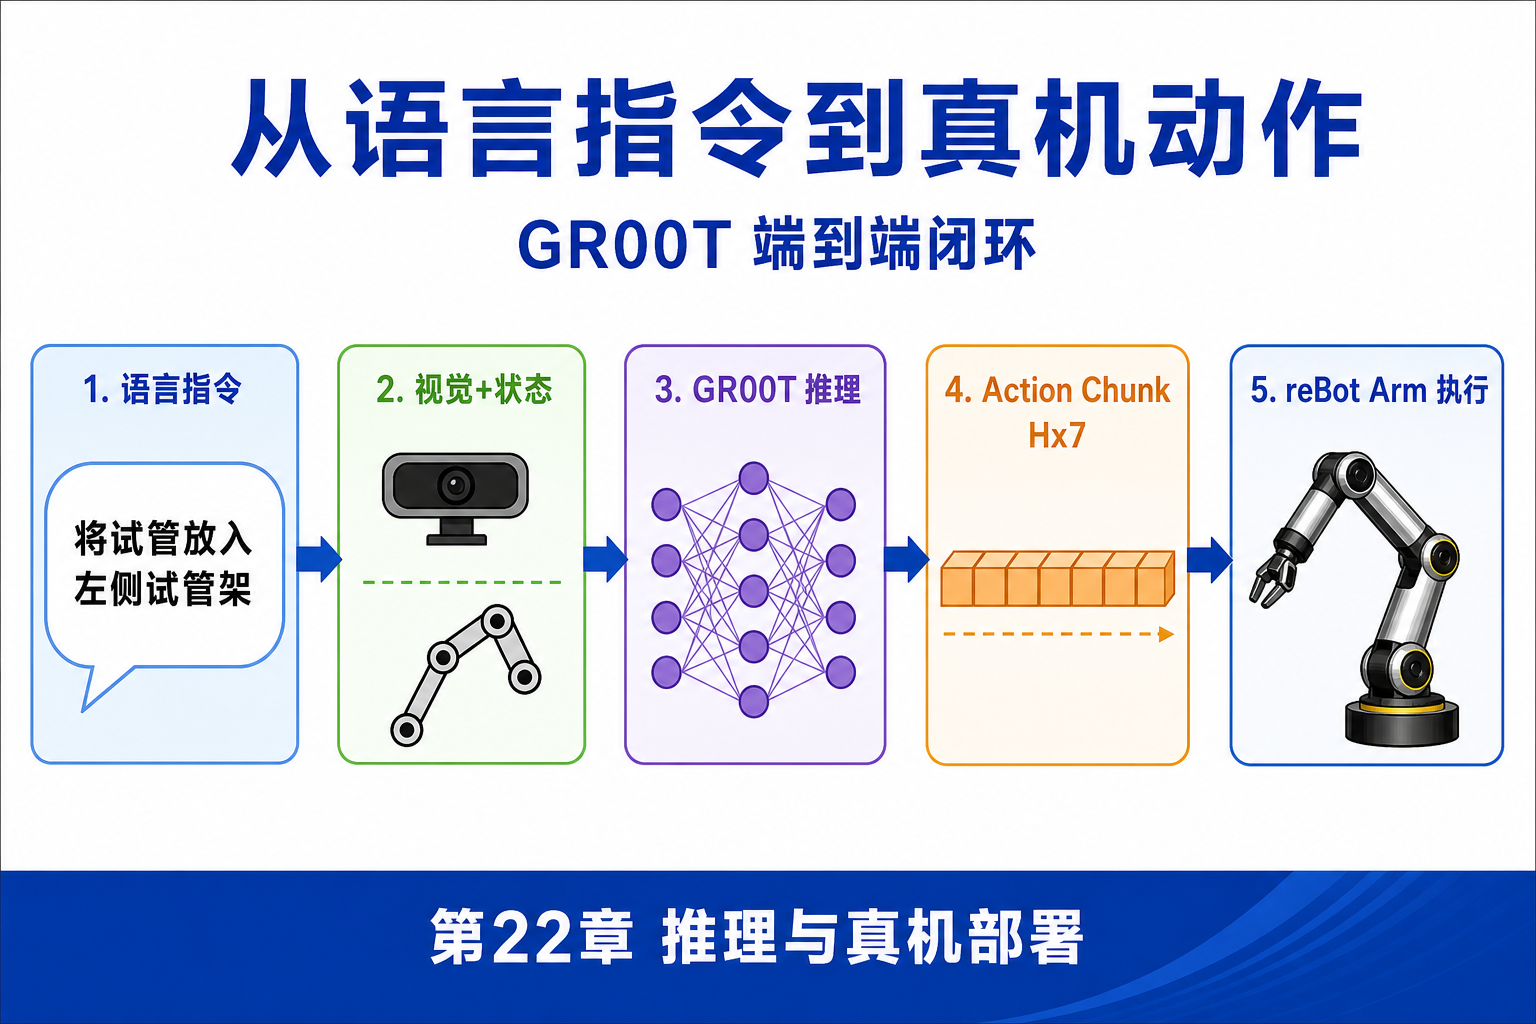
端到端闭环长什么样
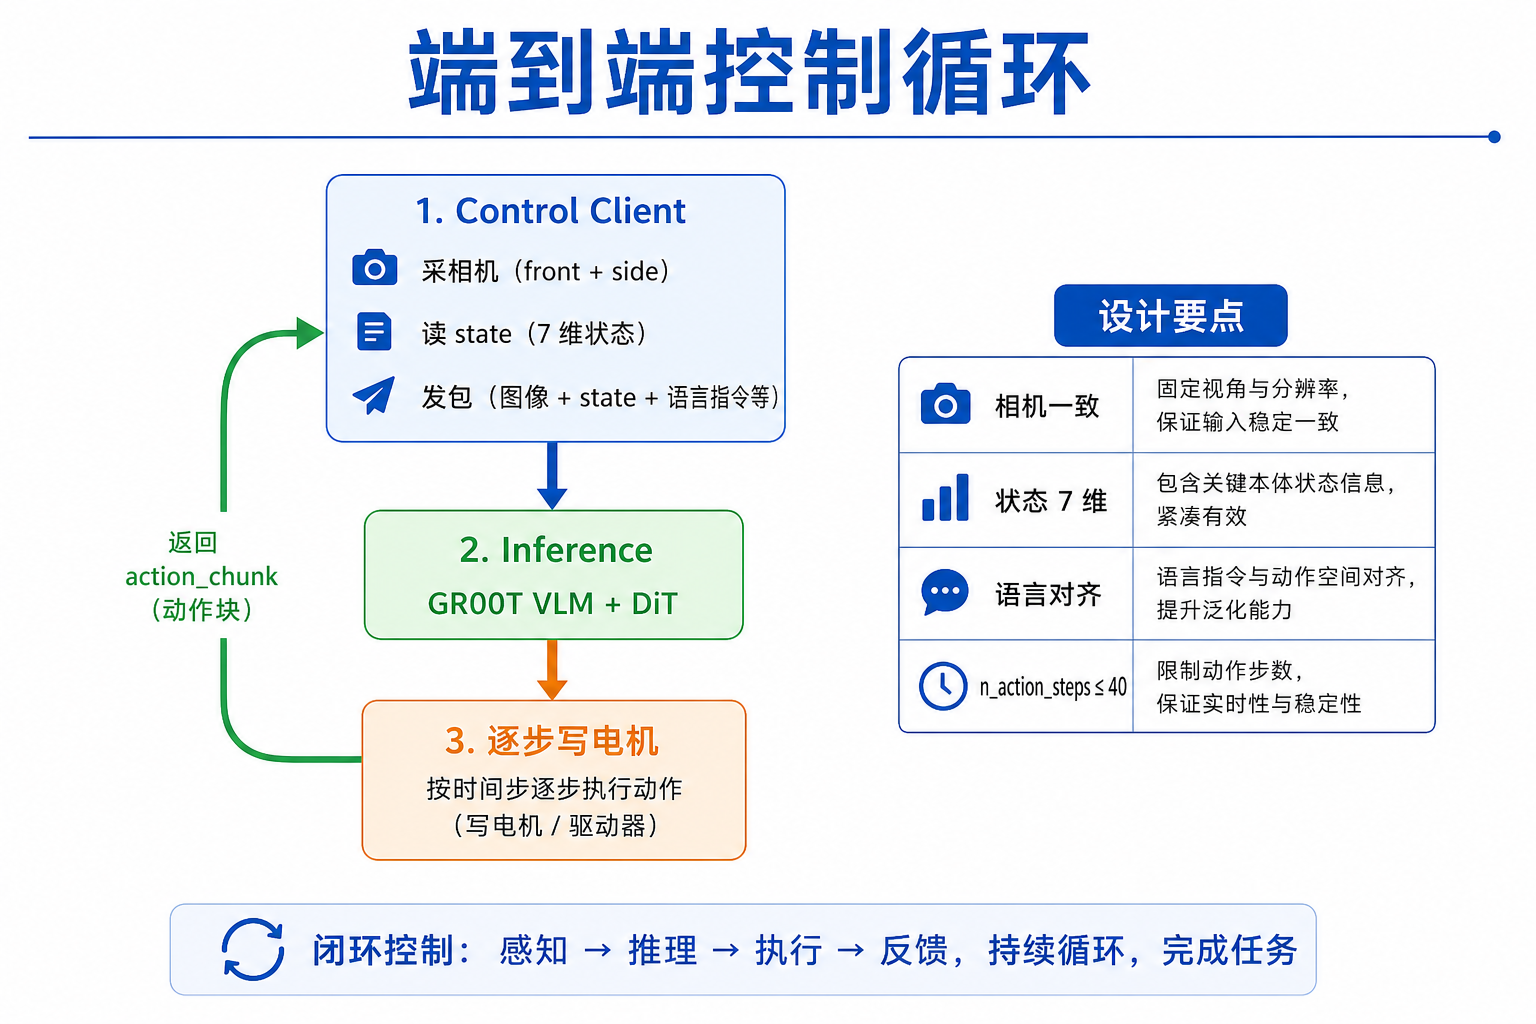
一次成功的 VLA 真机回合,可抽象为固定频率的控制循环:
用户语言指令 L(如:将试管放入左侧试管架)
        │
        ▼
┌───────────────────────────────────────┐
│  控制端(Robot Control Client)        │
│  1. 采相机:front + side               │
│  2. 读关节 state(7 维)               │
│  3. 打包观测 → 发给推理端              │
└───────────────────┬───────────────────┘
                    │  images + state + task
                    ▼
┌───────────────────────────────────────┐
│  推理端(GR00T Policy / Server)       │
│  VLM + DiT → action_chunk (H × 7)     │
└───────────────────┬───────────────────┘
                    │  动作块
                    ▼
┌───────────────────────────────────────┐
│  控制端执行                            │
│  按 n_action_steps 逐步写电机          │
│  (可选 RTC:边执行边异步预取下一块)    │
└───────────────────────────────────────┘
| 环节 | 关键约束 |
|---|---|
| 相机 | 键名、分辨率、数量与训练一致(front 全视角支架 / side 腕部) |
| 状态 | 7 维顺序与 modality.json 一致;角度单位训练推理统一 |
| 语言 | --task 句式尽量接近训练标注 |
| 动作 | n_action_steps ≤ 训练 chunk_size(N1.7 常用 40) |
推理端和控制端解耦
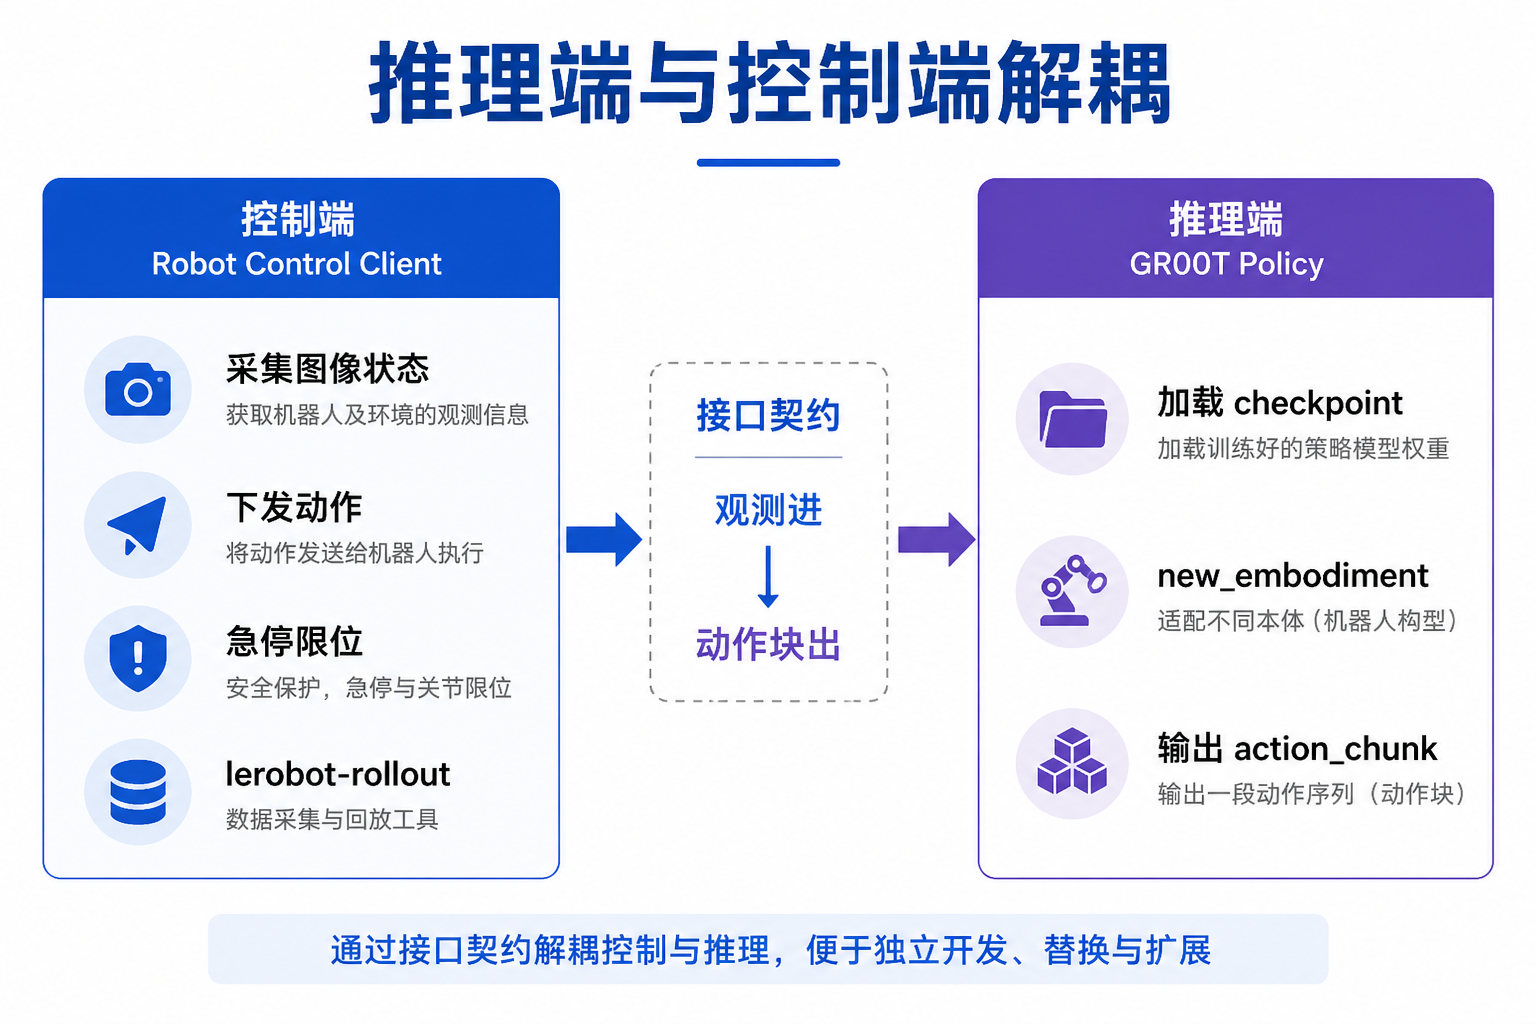
把系统拆成两端,是为了实时控制与重计算互不拖累:
控制端职责
- 固定频率采集图像与关节状态(如 30 Hz)
- 组装观测包
{images, state, task} - 接收
action_chunk,按步下发到 reBot 驱动 - 执行急停、软限位、超时保护
对应工具:lerobot-rollout / lerobot-record(带 --policy.path)。
推理端职责
- 加载
policy.path(微调 checkpoint)与base_model_path=nvidia/GR00T-N1.7-3B - 以
embodiment_tag=new_embodiment解码 reBot 动作空间 - 返回形状约为
(H, 7)的动作块(H 由训练chunk_size决定)
对应形态:默认同进程内的 groot policy;进阶可为独立 HTTP/gRPC 服务(参考 Isaac GR00T 仓库部署示例)。
解耦原则:控制端不感知模型内部结构;推理端不直接操作电机。接口契约只有「观测进、动作块出」。
同机部署和分布式部署
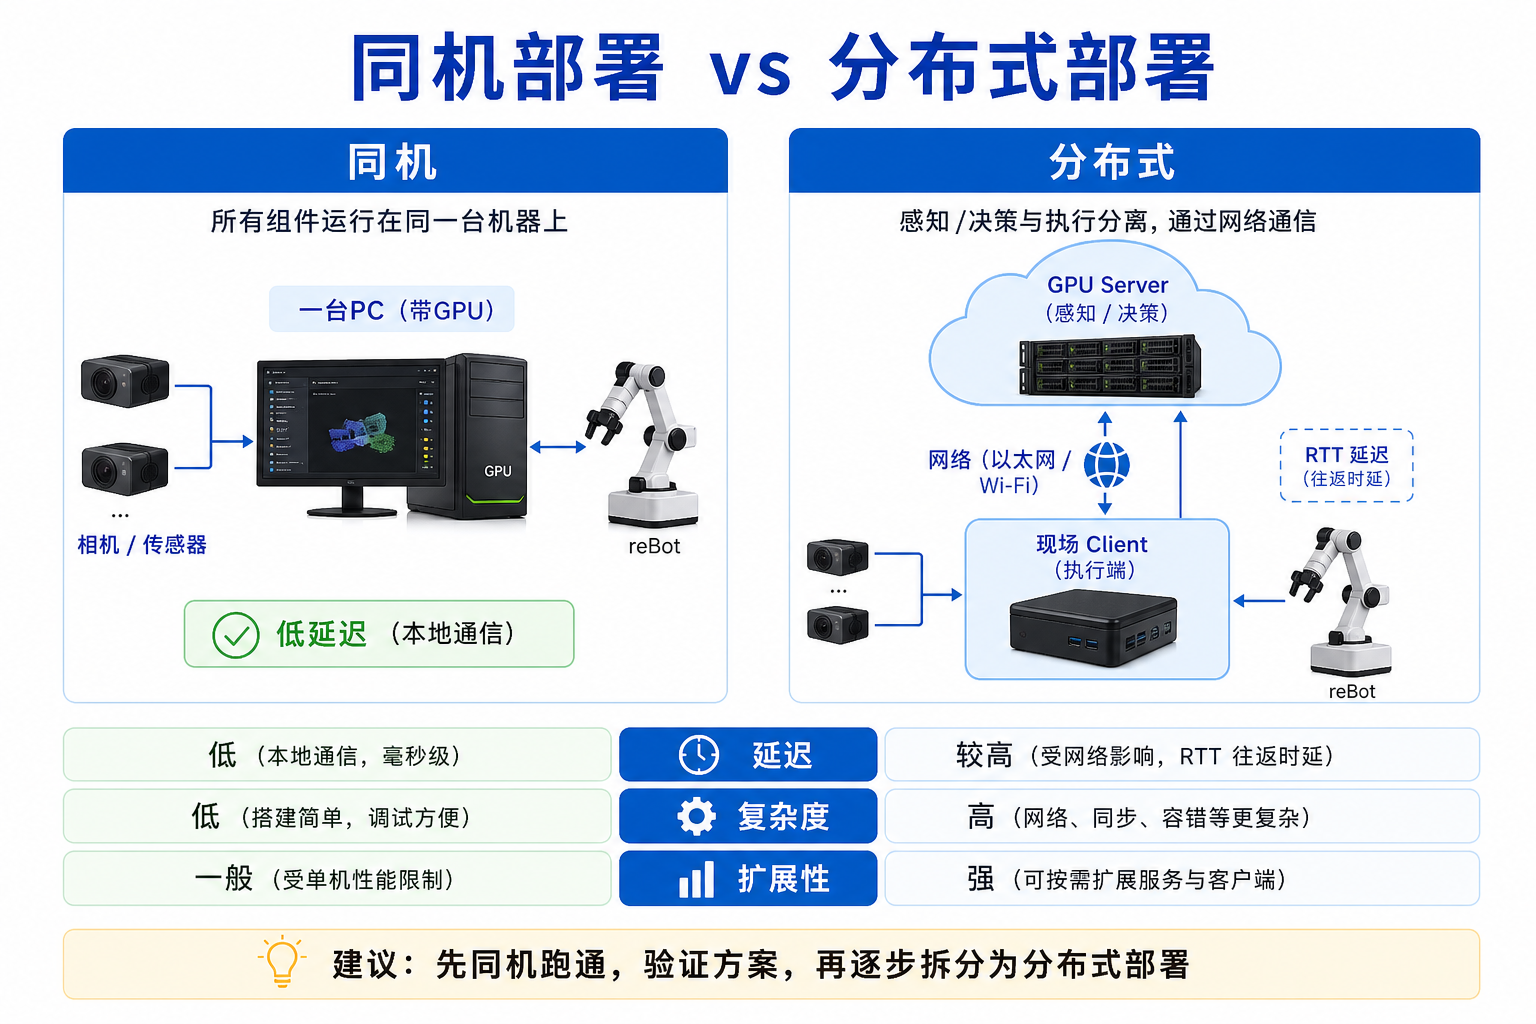
同机部署(推荐入门)
GPU 工作站同时接相机、CAN/串口与机械臂:
lerobot-rollout \
  --policy.path=${MODEL_PATH} \
  --policy.base_model_path=nvidia/GR00T-N1.7-3B \
  --policy.embodiment_tag=new_embodiment \
  --device=cuda \
  --robot.type=seeed_b601_rs_follower \
  ...
优点:无网络往返、联调简单。缺点:现场必须有 GPU 主机。
分布式部署(进阶)
| 节点 | 放置内容 |
|---|---|
| GPU 机 | 推理 Server(加载 GR00T) |
| 现场机 / 工控机 | 控制 Client(相机 + reBot 驱动) |
适用场景:实验室 GPU 与产线机械臂分离、多臂共享同一推理池。
| 对比项 | 同机 | 分布式 |
|---|---|---|
| 延迟 | 主要是推理耗时 | 推理 + 网络 RTT |
| 复杂度 | 低 | 需约定序列化、超时、重连 |
| 扩展性 | 一机一臂 | 一服务多客户端 |
选型建议:先同机跑通阶段项目;确认成功率后再拆分布式。
相机、状态和语言输入
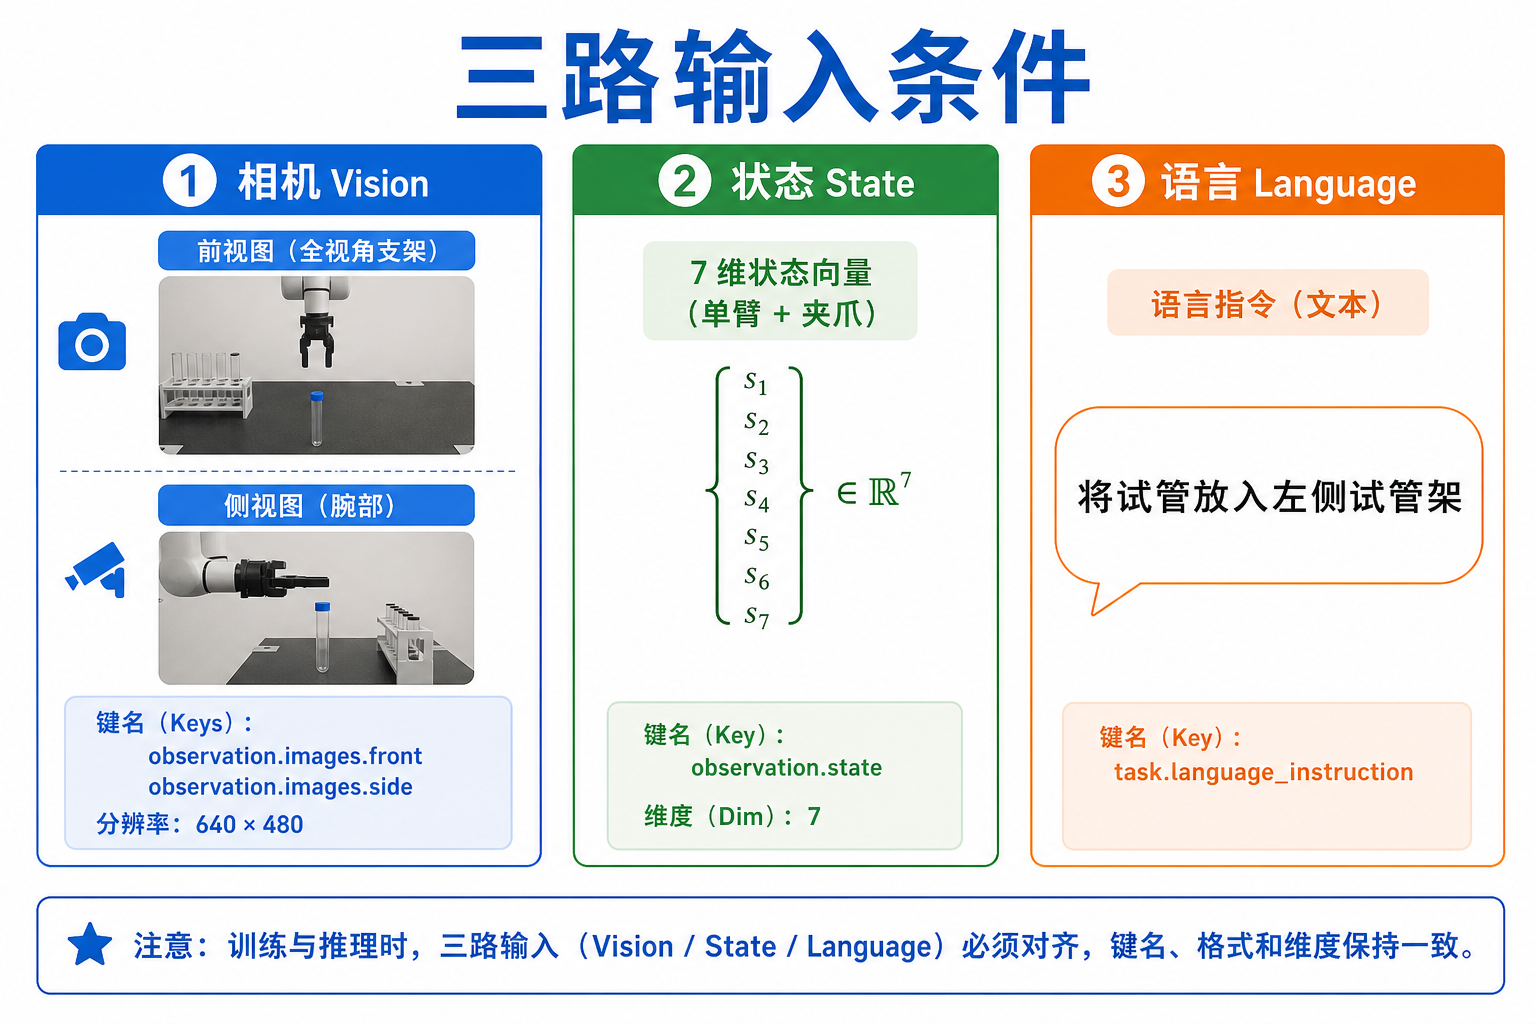
推理端每次调用需要三类条件输入,缺一不可(或与训练时声明一致):
1. 相机(Vision)
| 键名 | 安装 | 作用 |
|---|---|---|
observation.images.front → front | 支架固定全视角 | 场景与目标定位 |
observation.images.side → side | 腕部 | 近距对准、抓放 |
分辨率建议 640×480,训练与推理必须一致。
2. 状态(State)
reBot Arm:single_arm 6 维 + gripper 1 维 = 7 维,顺序与第 19/20 章一致。控制端每个控制周期读取最新关节角再送推理。
3. 语言(Language)
通过 --task / dataset.single_task 注入。例:
将试管放入左侧试管架。
要求:
- 与训练
tasks.jsonl/human.task_description同语言、同句式风格 - 物体指称清晰(「左侧试管架」需在画面中可区分)
- 不要临时换成训练从未出现过的复杂复合指令
Action Chunk 输出
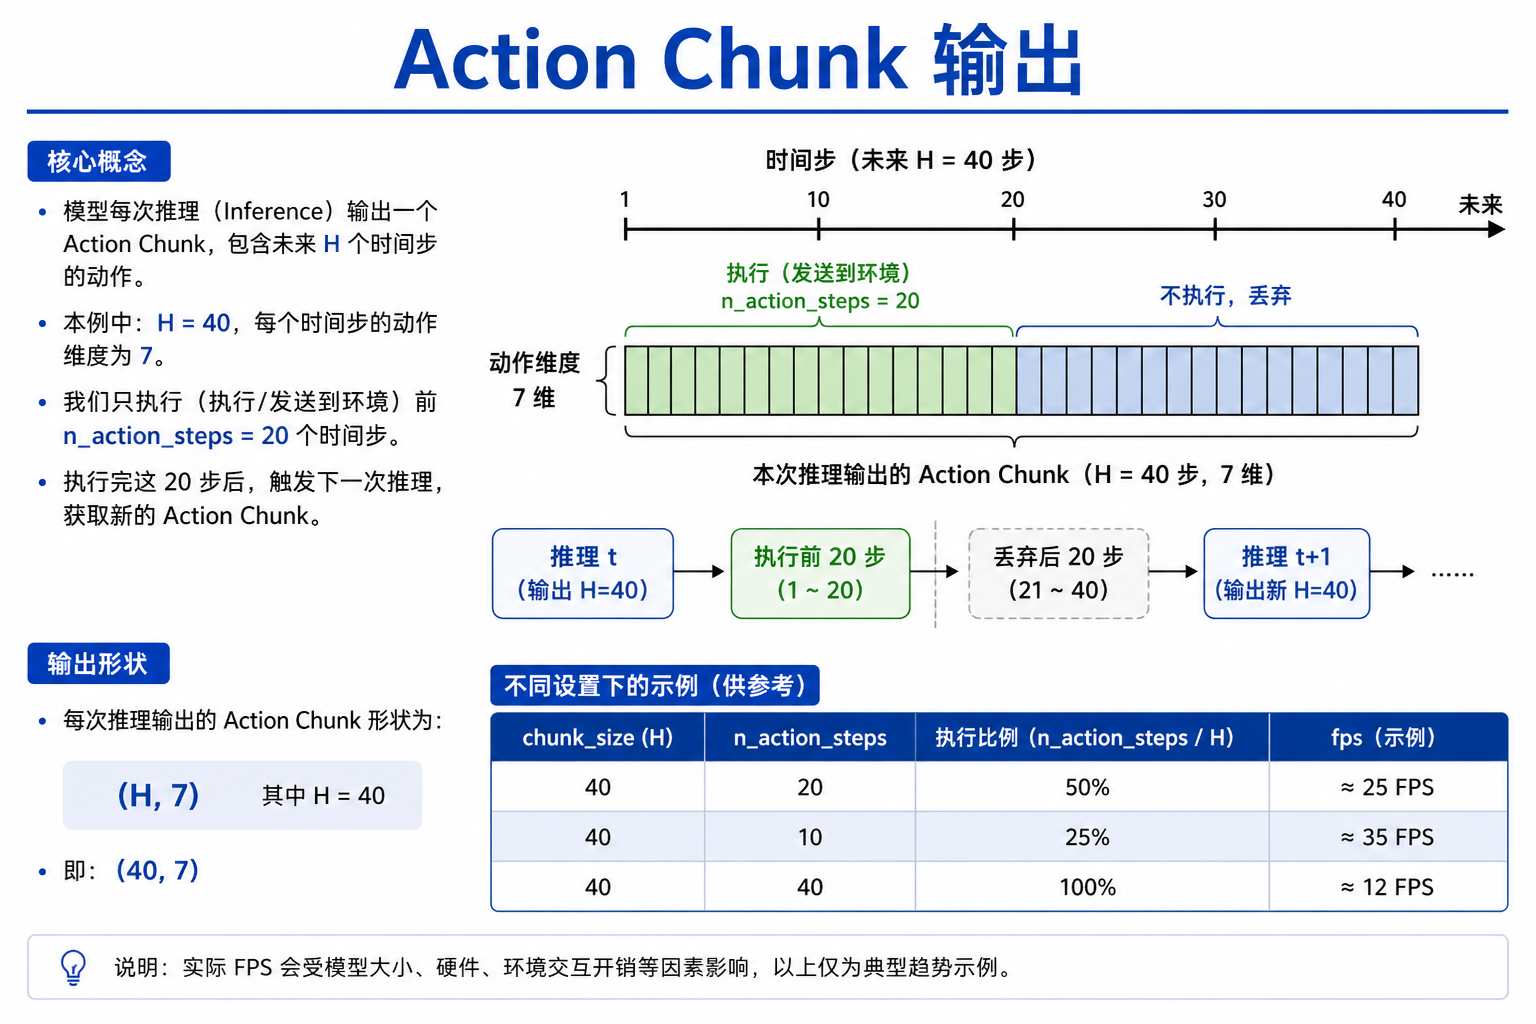
GR00T 单次推理输出的不是一个瞬时关节指令,而是动作块:
action_chunk.shape ≈ (H, 7)
H = chunk_size / action_horizon   # N1.7 微调常用 40
每行 7 维 = 6 关节 + 夹爪
控制端执行策略:
| 参数 | 建议 | 说明 |
|---|---|---|
chunk_size | 训练时 40 | 决定模型能预测多远;推理不可随意改大 |
n_action_steps | 先试 20 | 本轮实际执行的步数,须 ≤ chunk_size |
| 执行频率 | 与录制 fps 接近(如 30 Hz) | 过快/过慢都会偏离训练分布 |
若开启相对动作(use_relative_actions),控制端需按训练时同样规则还原为绝对关节指令;夹爪通常排除在相对之外。
网络延迟和推理延迟
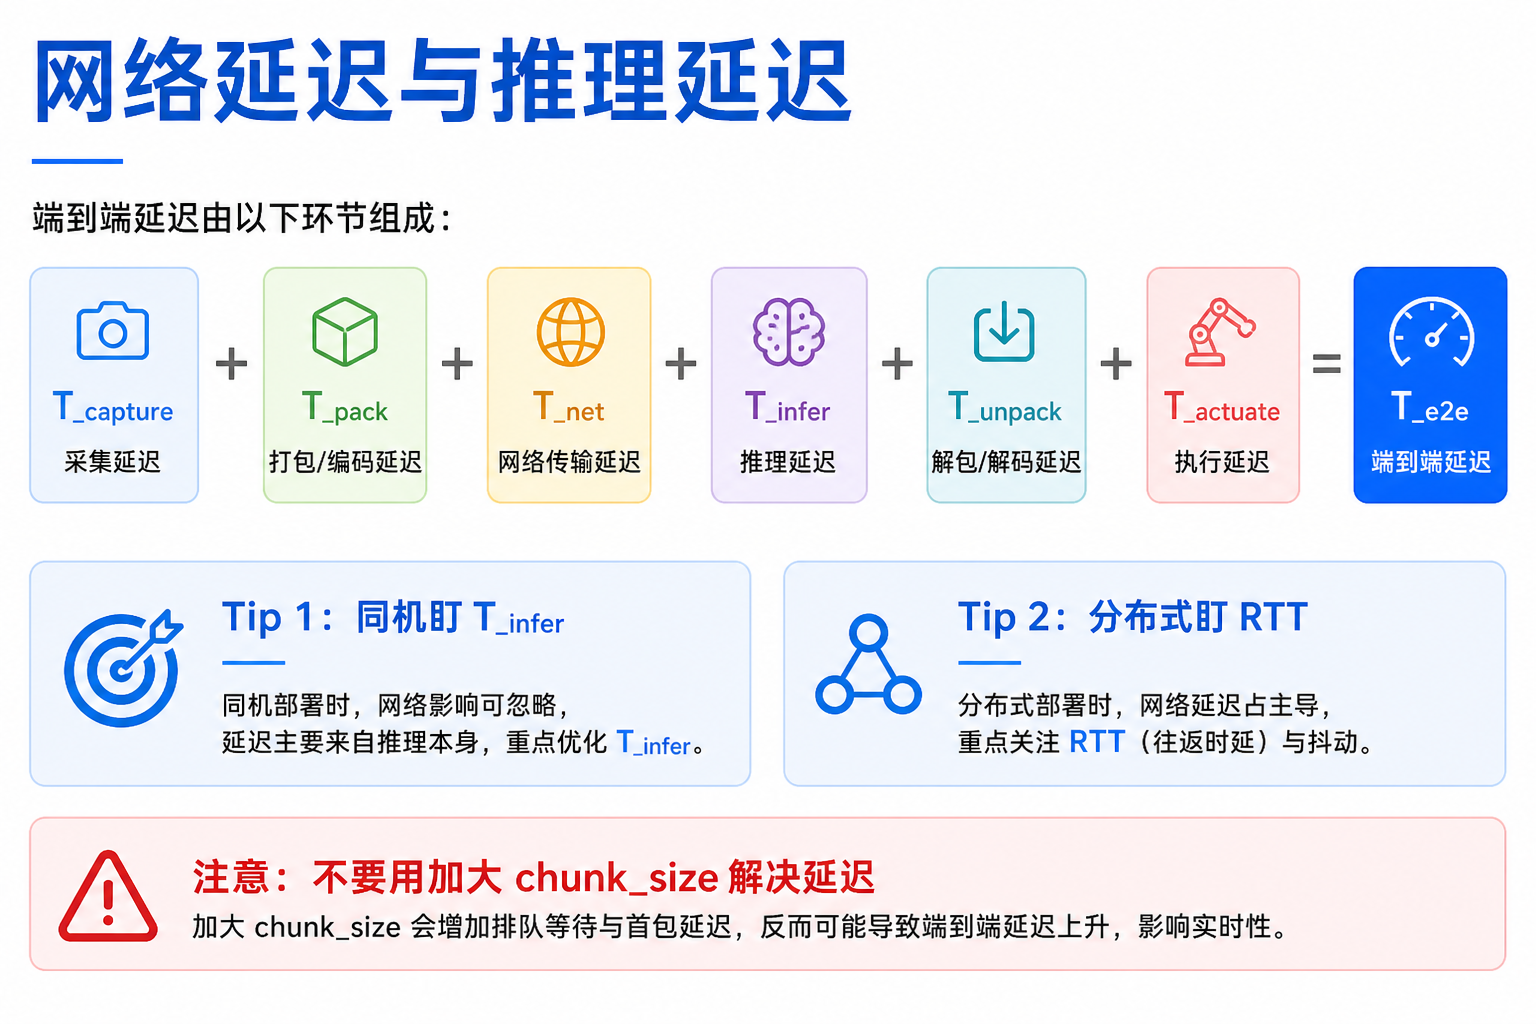
端到端延迟 roughly:
T_e2e ≈ T_capture + T_pack + T_net + T_infer + T_unpack + T_actuate
| 分量 | 典型来源 | 缓解 |
|---|---|---|
T_capture | 相机曝光/USB | MJPG、固定分辨率、避免多余预处理 |
T_infer | VLM + DiT | bf16、合适 batch=1、Flash Attention |
T_net | 分布式 RTT | 千兆网、同机房、压缩观测 |
T_actuate | CAN/串口写周期 | 保持与训练接近的控制频率 |
经验法则:
- 同机:瓶颈通常是
T_infer;用较小的n_action_steps+ RTC 掩盖停顿 - 分布式:若 RTT 不稳定,先关 RTC 做同步调试,再逐步打开异步
- 不要用「加大
chunk_size」解决延迟——窗口是训练定死的
动作缓存和异步推理
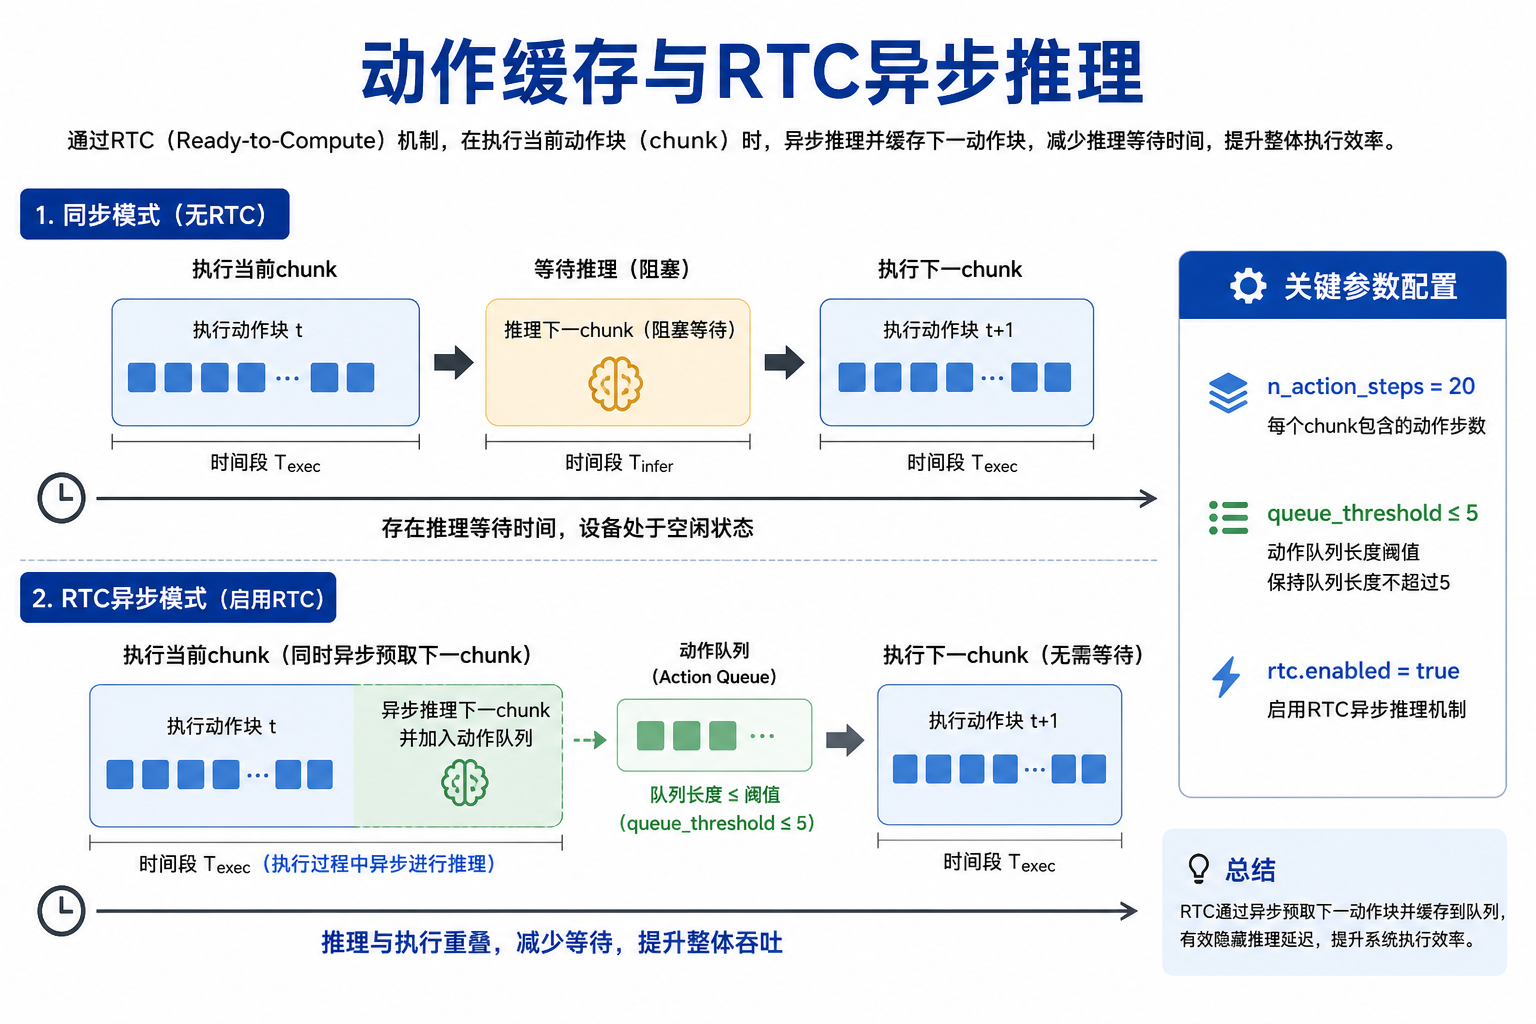
动作缓存(Action Queue)
控制端把收到的 action_chunk 写入队列,按控制周期弹出执行。队列变空前若还没拿到下一块,机械臂会停顿或复用末动作——这正是异步推理要避免的。
RTC(Real-Time Chunking)
在执行当前块的同时,后台用最新观测请求下一块:
lerobot-rollout \
  ... \
  --policy.n_action_steps=20 \
  --inference.type=rtc \
  --inference.rtc.enabled=true \
  --inference.rtc.execution_horizon=20 \
  --inference.queue_threshold=0
| 参数 | 建议 |
|---|---|
n_action_steps / execution_horizon | 先 20,再按抖动微调 |
queue_threshold | 建议 ≤ 5;过大易叠加陈旧动作 |
若出现抖动、抽搐:先设 --inference.rtc.enabled=false,确认同步路径正常后再开 RTC。
真机安全限制
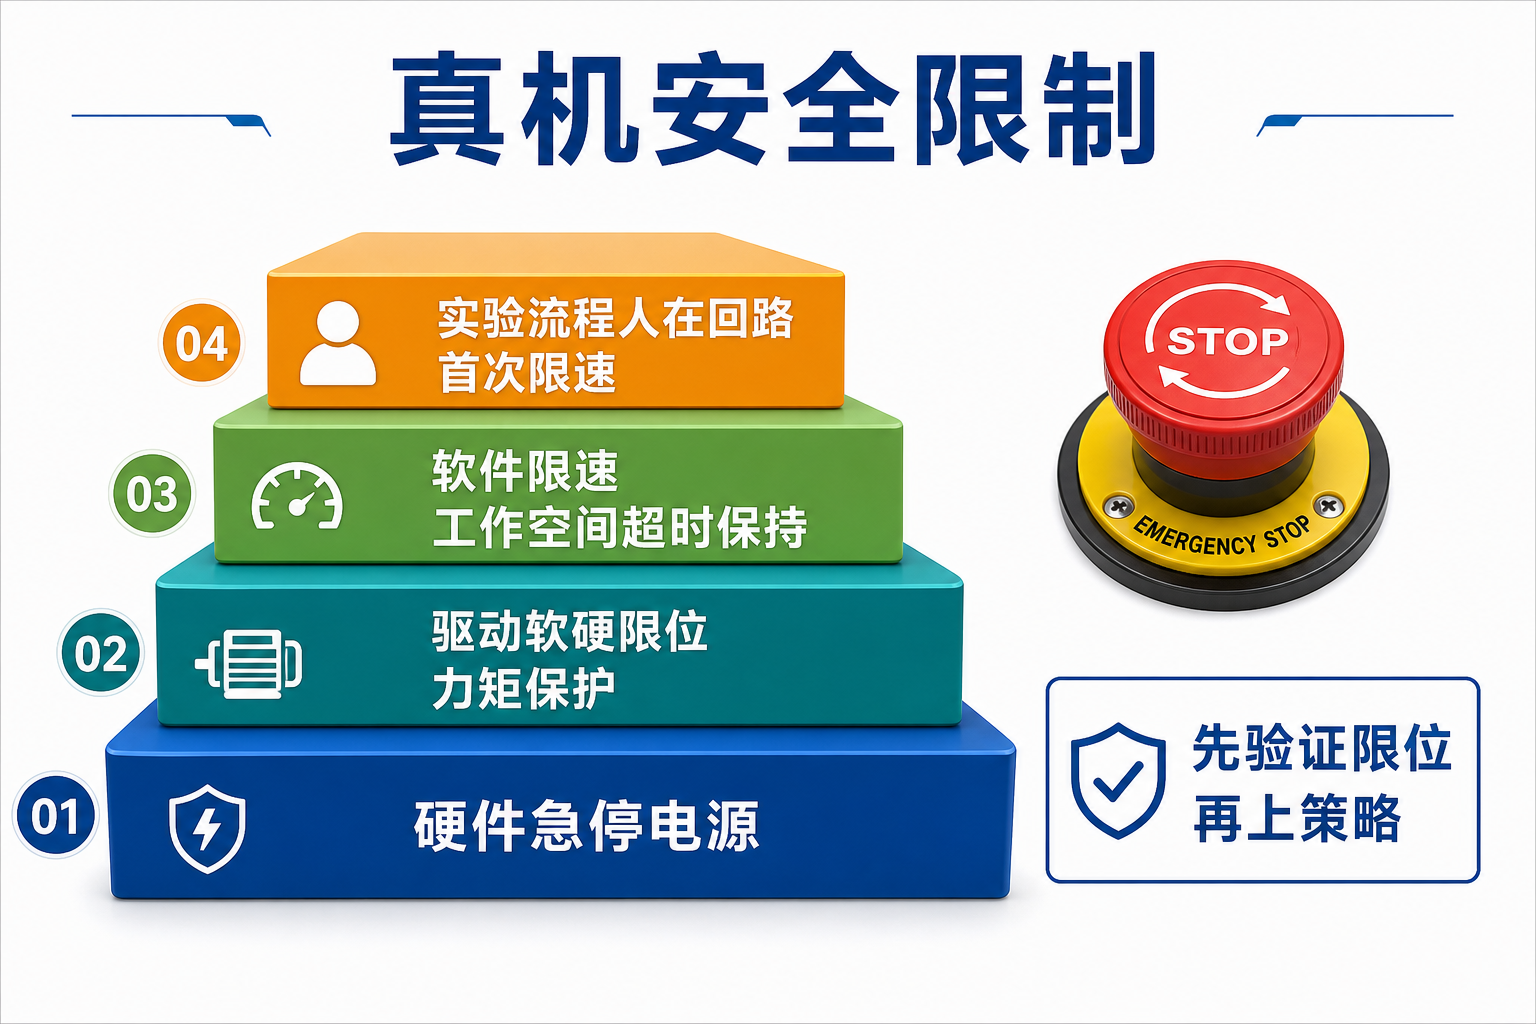
VLA 输出未经物理约束保证,安全必须由控制层兜底:
| 层级 | 措施 |
|---|---|
| 硬件 | 急停按钮、电源急断、线缆防缠绕 |
| 驱动 / 固件 | 关节软硬限位、电流/力矩保护 |
| 软件控制端 | 速度/加速度限幅、工作空间盒、超时未收到动作则保持或回安全姿态 |
| 实验流程 | 首次推理降低增益/限速;人在回路;桌面清空无关障碍 |
调试清单:
- 未加载策略前,用手动/遥操确认限位有效
- 策略上线先短时
--duration,确认无飞车 - 异常动作立即急停,记录当时
task、相机画面与 state,再回查数据与 modality
VLA 任务评估
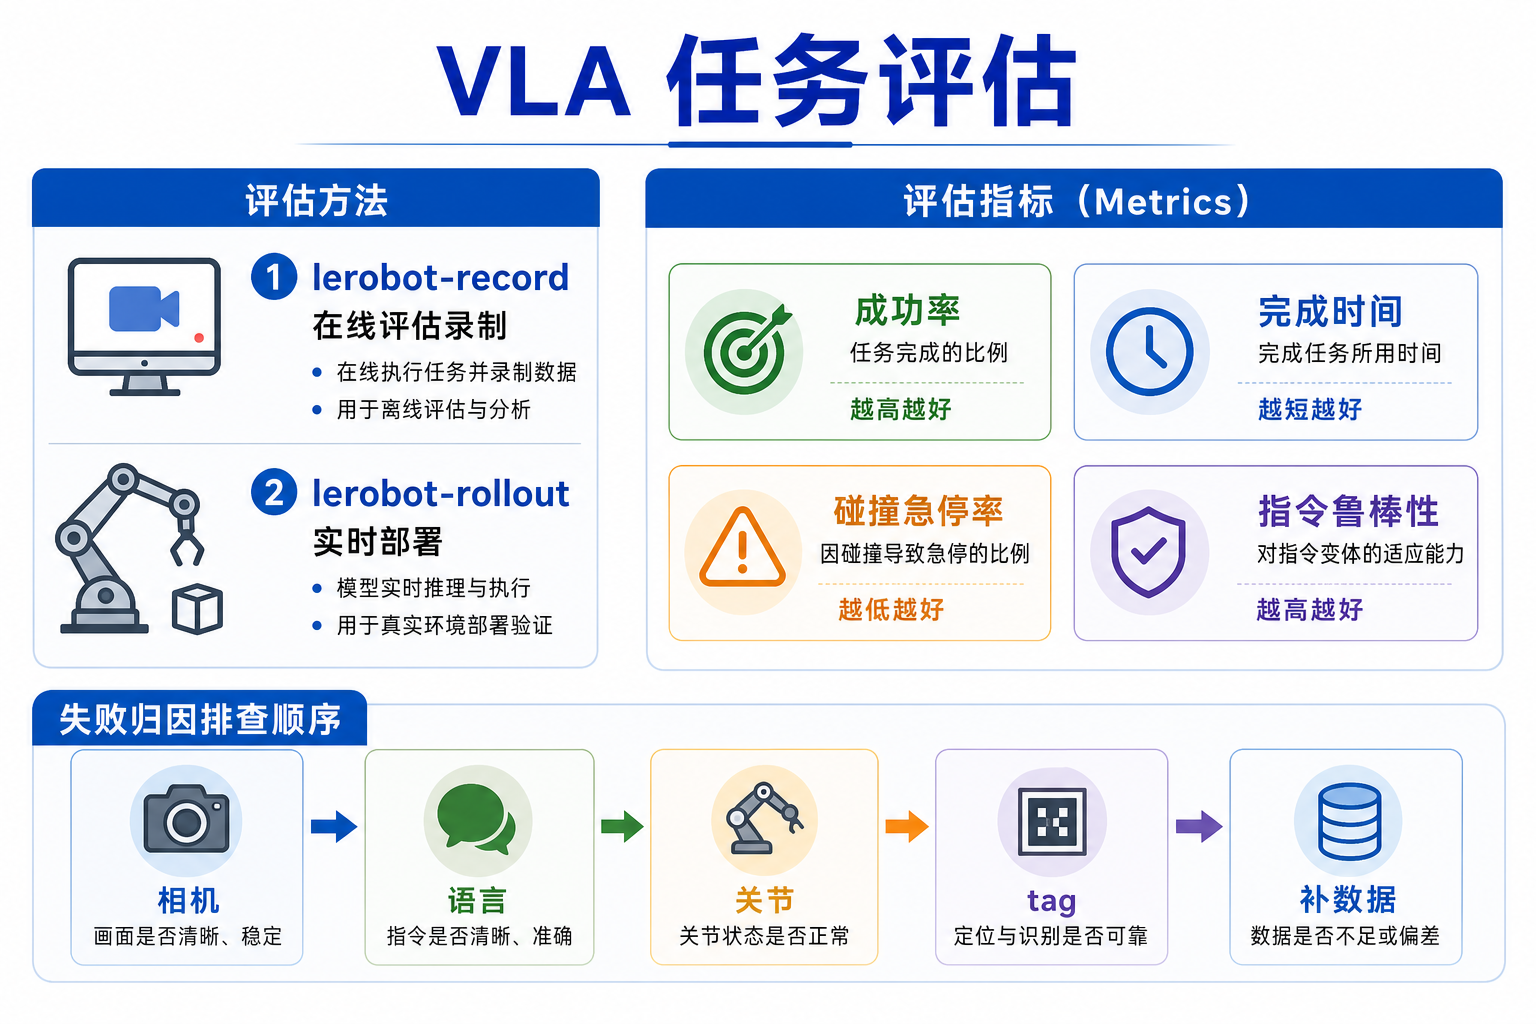
评估方式
| 方式 | 工具 | 用途 |
|---|---|---|
| 在线评估录制 | lerobot-record + --policy.path | 保存失败/成功 episode,便于回放 |
| 实时部署 | lerobot-rollout | 测延迟、RTC、长时稳定性 |
建议指标
| 指标 | 说明 |
|---|---|
| 成功率 | 固定初始条件与指令下,成功次数 / 总次数(建议 ≥ 20 次) |
| 完成时间 | 从开始到放置完成的秒数 |
| 碰撞 / 急停率 | 非任务性碰撞或人工干预比例 |
| 指令鲁棒性 | 同任务轻微改写指令是否仍成功(仅在训练分布内) |
失败归因顺序
- 相机键名 / 分辨率是否与训练一致
- 语言句式是否偏离标注
- 关节顺序与单位
embodiment_tag、相对动作开关- 数据覆盖不足 → 回到第 20 章补采
阶段项目:将试管放入左侧试管架
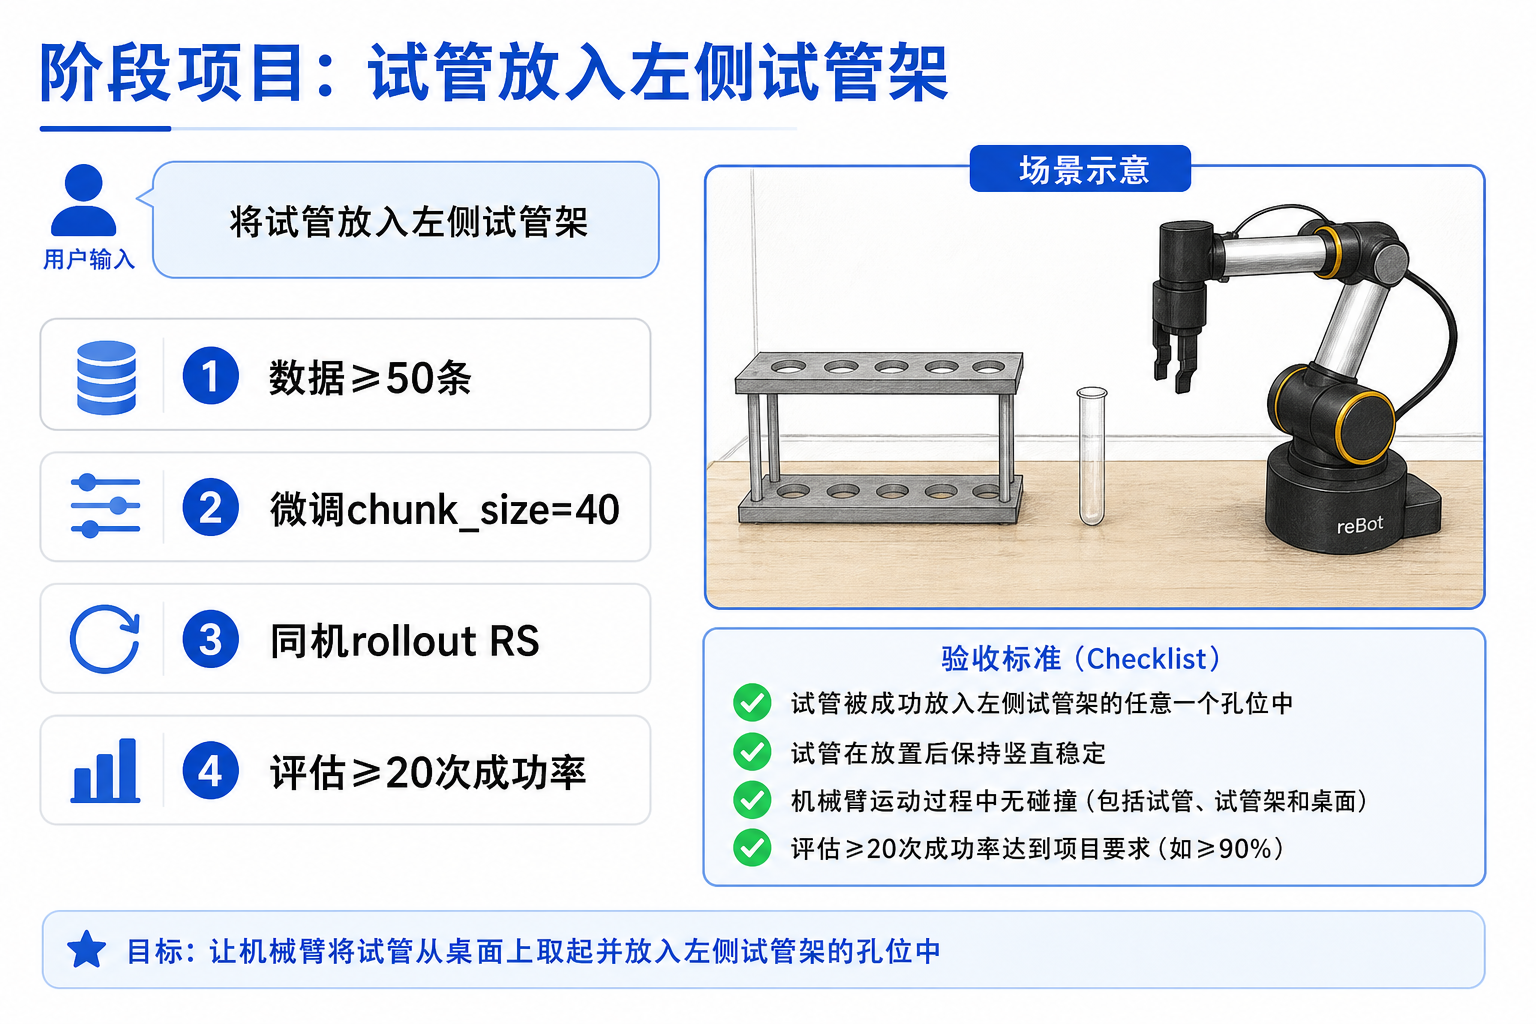
项目目标
| 项 | 内容 |
|---|---|
| 用户输入 | 将试管放入左侧试管架。 |
| 系统输入 | 全视角 front + 腕部 side + 当前 7 维 state |
| 期望输出 | 机械臂完成取试管 → 移到左侧架 → 放入 → 松爪 |
实施步骤
-
数据(若尚未覆盖该任务)
- 采集 ≥ 50 条成功演示;标注统一为上述中文句式
- 写好
meta/modality.json(front/side、single_arm+gripper、human.task_description)
-
微调(第 21 章)
embodiment_tag=new_embodiment,chunk_size=40- 得到
checkpoints/last/pretrained_model
-
同机部署推理(B601-RS 示例;DM 改
type/port/can_adapter)
export MODEL_PATH="outputs/train/${REPO_ID}/checkpoints/last/pretrained_model"

# RS CAN
sudo ip link set can0 down 2>/dev/null
sudo ip link set can0 type can bitrate 1000000
sudo ip link set can0 up

lerobot-rollout \
  --strategy.type=base \
  --policy.path=${MODEL_PATH} \
  --policy.base_model_path=nvidia/GR00T-N1.7-3B \
  --policy.embodiment_tag=new_embodiment \
  --policy.n_action_steps=20 \
  --robot.type=seeed_b601_rs_follower \
  --robot.port=can0 \
  --robot.id=follower1 \
  --robot.can_adapter=socketcan \
  --robot.cameras="{ front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30, fourcc: \"MJPG\"}, side: {type: opencv, index_or_path: 2, width: 640, height: 480, fps: 30, fourcc: \"MJPG\"}}" \
  --task="将试管放入左侧试管架。" \
  --duration=90 \
  --device=cuda \
  --display_data=true \
  --inference.type=rtc \
  --inference.rtc.enabled=true \
  --inference.rtc.execution_horizon=20 \
  --inference.queue_threshold=0
-
评估
- 固定桌面布局,重复 ≥ 20 次,统计成功率
- 失败 episode 用
lerobot-record存档,分析是定位、抓取还是放置环节出错
验收标准
-
给定指令「将试管放入左侧试管架。」可端到端执行
-
front/side与训练一致,无mean is infinity类键名错误 -
急停与软限位可用;异常时可人工切断
-
记录成功率,并明确下一步是补数据还是调
n_action_steps/ RTC
本章小结
- 解耦:控制端管采集与执行,推理端管 VLA 前向;接口是观测 → Action Chunk
- 部署:先同机,再按需分布式;分布式要额外盯网络延迟
- 输入:相机 + 状态 + 语言三者与训练严格对齐
- 输出:按
n_action_steps消费动作块;RTC 用队列掩盖推理耗时 - 安全:限位、急停、限速由控制层强制执行
- 评估:成功率 + 失败归因;阶段项目验证「语言 → 真机动作」闭环
至此,你完成了从 VLA 理论、数据、微调到 GR00T 真机部署 的完整路径。后续迭代优先补失败场景数据,而不是盲目加长训练步数。