27. 机器人视觉与三维感知
机器人视觉是机器人感知外部环境的重要方式。对于机械臂而言,仅仅知道“物体在图片中的位置”是不够的,机器人真正需要的是物体在真实三维空间中的位置。
本阶段需要的硬件
本阶段需要准备的硬件如下。全部阶段的完整清单见 第 3 章。
主控单元
| 硬件 | 购买 | 数量 |
|---|---|---|
| Jetson Orin Nano Super 8G | 🛒 | 1 |
| reComputer Robotics J4012 | 🛒 | 1 |
| NVIDIA Jetson AGX Thor 128G | 🛒 | 1 |
另外还需要一台台式机或笔记本:Ubuntu 22.04、GTX 4080 以上(12G 显存以上)、16GB 以上内存。
本阶段
| 硬件 | 购买 | 数量 |
|---|---|---|
| reBot Arm B601 DM/RS | 🛒 | 1 |
| Realsense 435i 或者 Orbbec Gemini2 深度相机 或者Realsense 405双目相机 | — | 1 |
| 相机腕部支架 | — | 1 |
机器人视觉与三维感知
章节概述:
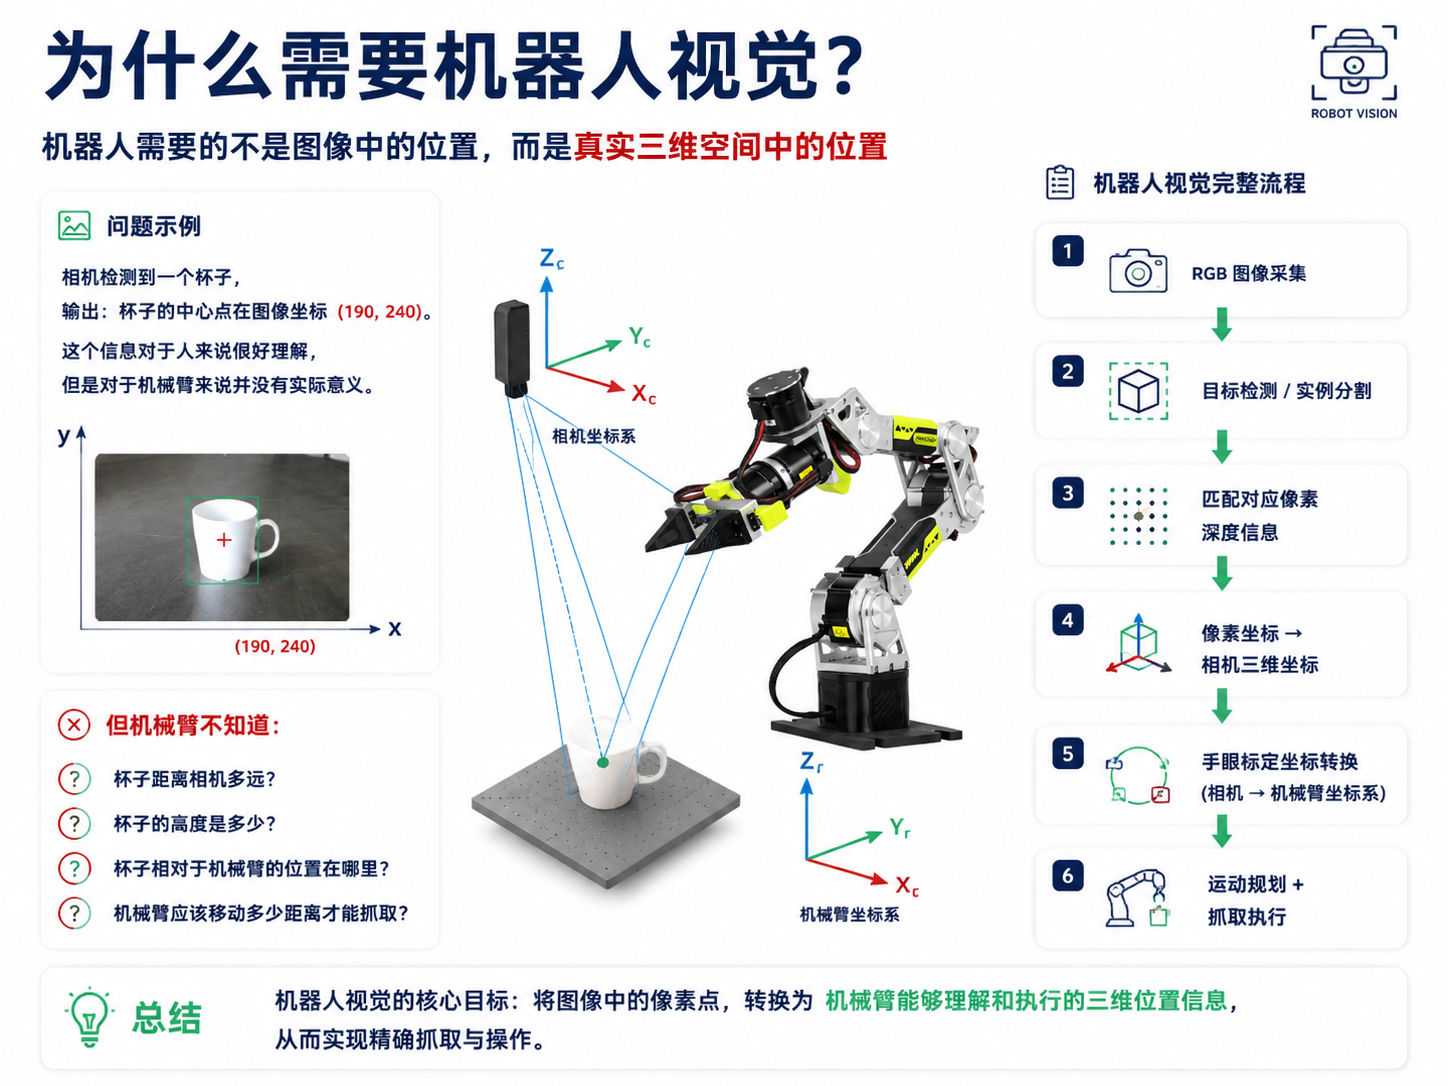
机器人视觉是机器人感知外部环境的重要方式。对于机械臂而言,仅仅知道“物体在图片中的位置”是不够的,机器人真正需要的是物体在真实三维空间中的位置。
例如:相机检测到一个杯子,输出:杯子的中心点在图像坐标(190,240)。这个信息对于人来说很好理解,但是对于机械臂来说并没有实际意义。
因为机械臂不知道:
- 杯子距离相机多远;
- 杯子的高度是多少;
- 杯子相对于机械臂的位置在哪里;
- 机械臂应该移动多少距离才能抓取。
因此机器人视觉需要完成一个完整过程:

机器人视觉系统简介
什么是机器人视觉
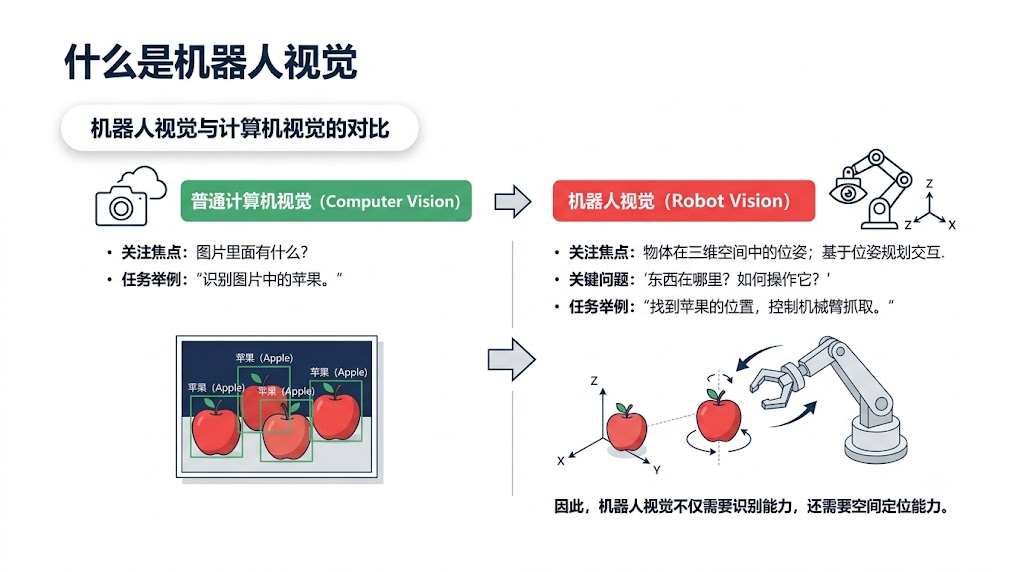
机器人视觉是指机器人利用摄像头等传感设备获取环境信息,并通过算法理解环境,从而完成定位、识别、抓取等任务。与普通计算机视觉不同:
- 普通计算机视觉关注:图片里面有什么?
- 机器人视觉关注:机器人视觉重点解决两大问题:物体在三维空间中的位姿;基于位姿规划机器人执行动作完成交互,也就是这个东西在哪里?机器人应该如何操作它?
例如:
- 计算机视觉任务:“识别图片中的苹果。”
- 机器人视觉任务:“找到苹果的位置,并控制机械臂抓取苹果。”
因此机器人视觉不仅需要识别能力,还需要空间定位能力。
机械臂视觉抓取流程
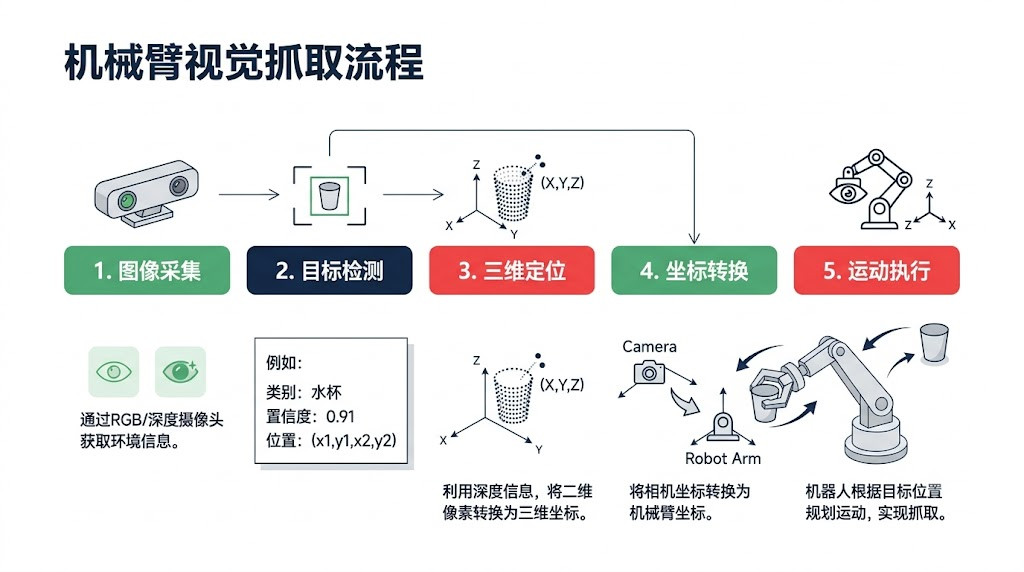
一个完整的视觉抓取系统通常包括:
-
第一步:图像采集
- 通过RGB摄像头或者深度摄像头获取环境信息。
-
第二步:目标检测
-
找到目标物体,判断类别,获取位置
-
例如:
- 类别:水杯
- 置信度:0.91
- 位置:(x1,y1,x2,y2)
-
-
第三步:三维定位
- 利用深度信息,将二维像素转换为三维坐标。
-
第四步:坐标转换
- 将相机坐标转换为机械臂坐标。
-
第五步:运动执行
- 机器人根据目标位置规划运动,实现抓取。
RGB图像与目标检测
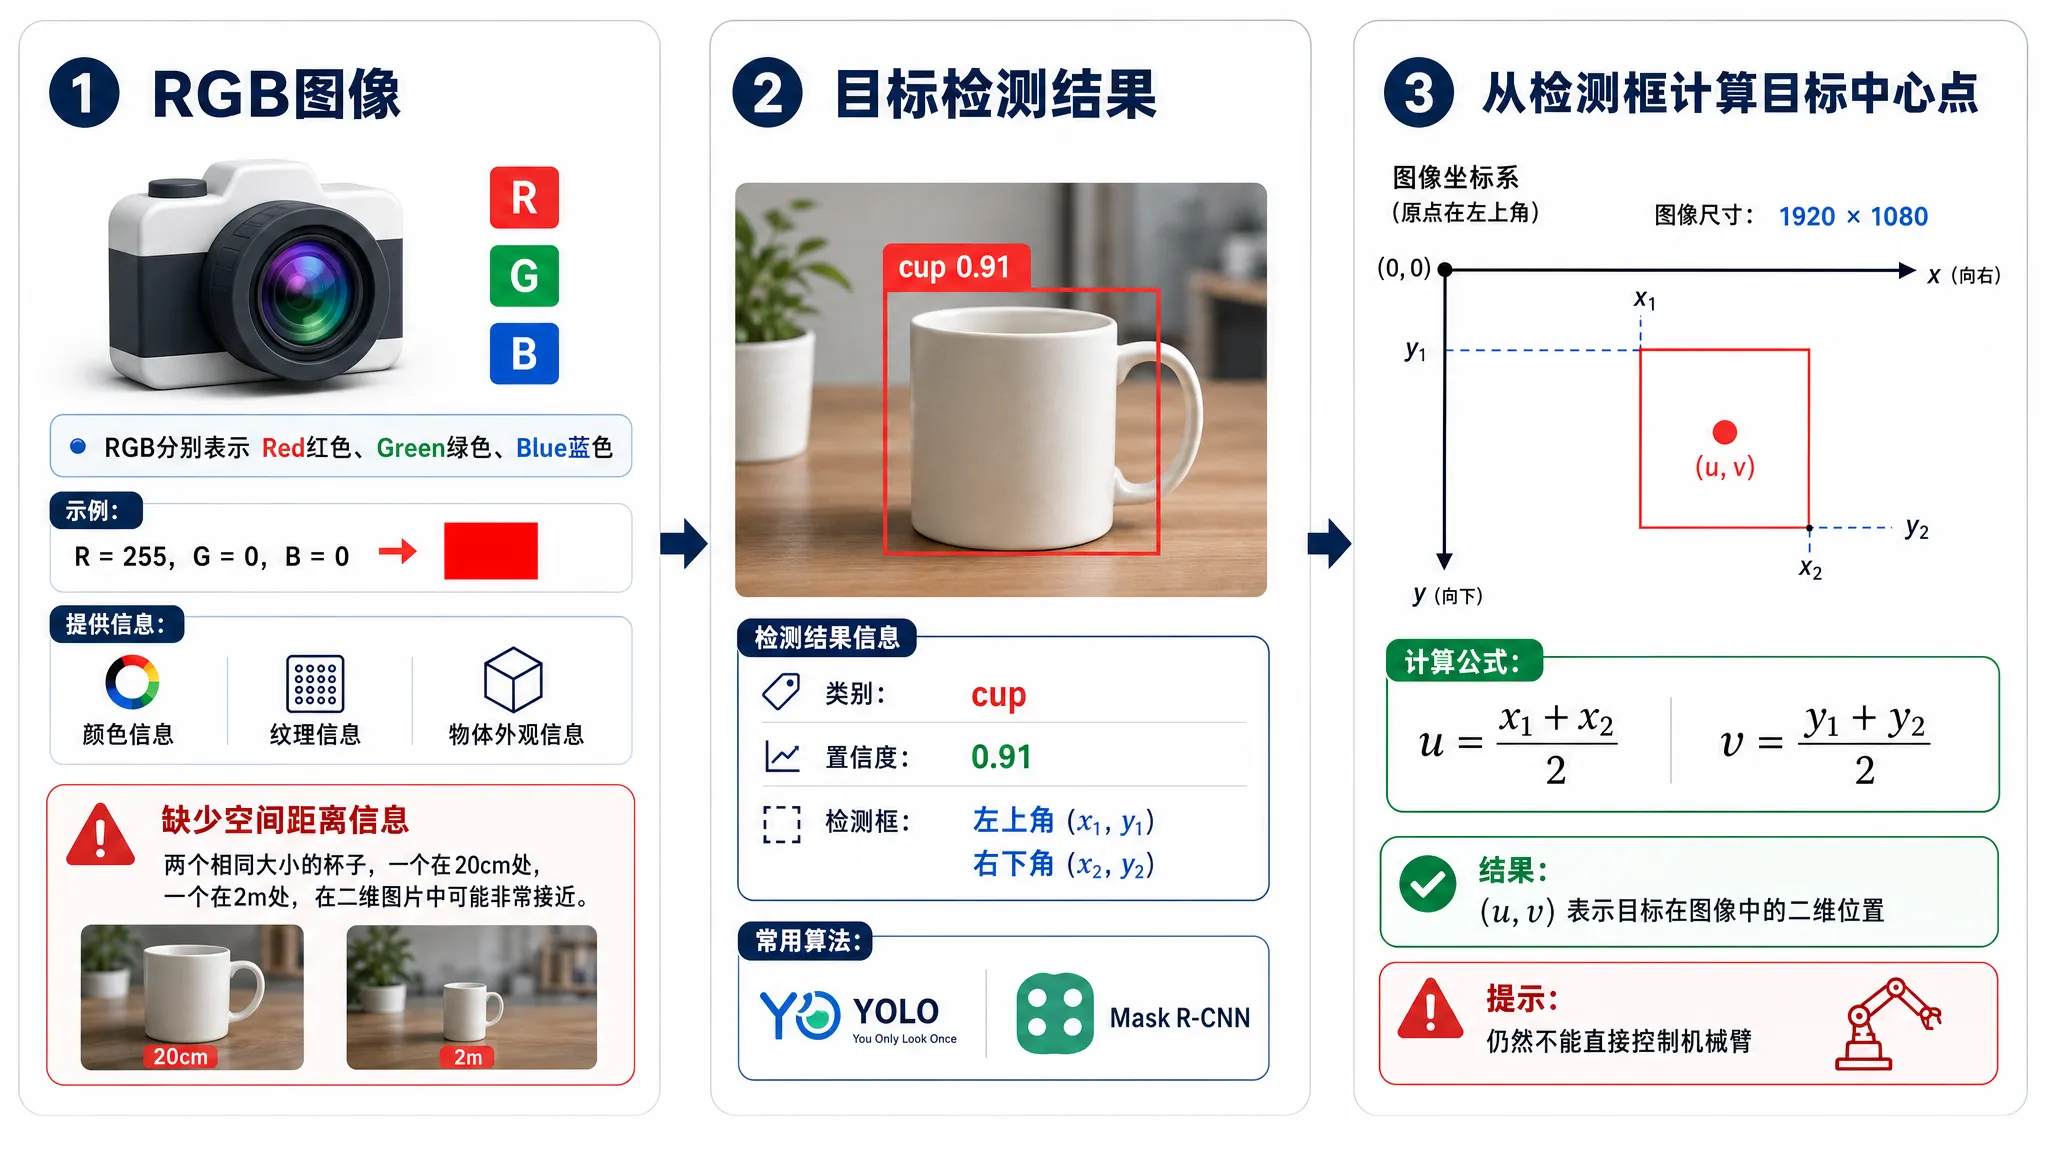
(1)RGB图像
RGB图像是机器人最常使用的一类视觉数据。RGB分别表示:
- R:Red 红色
- G:Green 绿色
- B:Blue 蓝色
每一个像素由三个数值组成:
R=255
G=0
B=0
RGB图像主要提供:颜色信息 、纹理信息、物体外观信息,但是RGB图像存在一个重要问题:缺少空间距离信息
- 例如:两个杯子,一个距离相机20cm;一个距离相机2m。如果它们大小相同,在二维图片中可能非常接近。RGB只能告诉机器人,“杯子在图片的哪个位置。”但不能告诉机器人,“杯子距离我多远。”
(2)目标检测结果
机器人通常不会直接使用整张图片,而是先进行目标检测。
目标检测算法(YOLO、Mask R-CNN)输出:
- 类别信息:cup,表示检测到杯子。
- 置信度:confidence=0.91,表示模型认为91%的概率是该类别。
- 检测框:通常表示为,左上角:(x1,y1),右下角:(x2,y2)
(3)从检测框计算目标中心点
机器人通常需要目标中心位置,计算机看到的图片,本质是一组像素。例如一张1920×1080的图片,每一个像素都有自己的坐标。左上角:(0,0),右下角:(1920,1080),通常,x方向向右增加,y方向向下增加。因此目标检测输出:(u,v),本质上就是图像坐标。计算:
、
得到:(u,v)。这个点表示,目标在图像中的二维位置。但是,它仍然不能直接控制机械臂。
为什么机器人需要深度信息
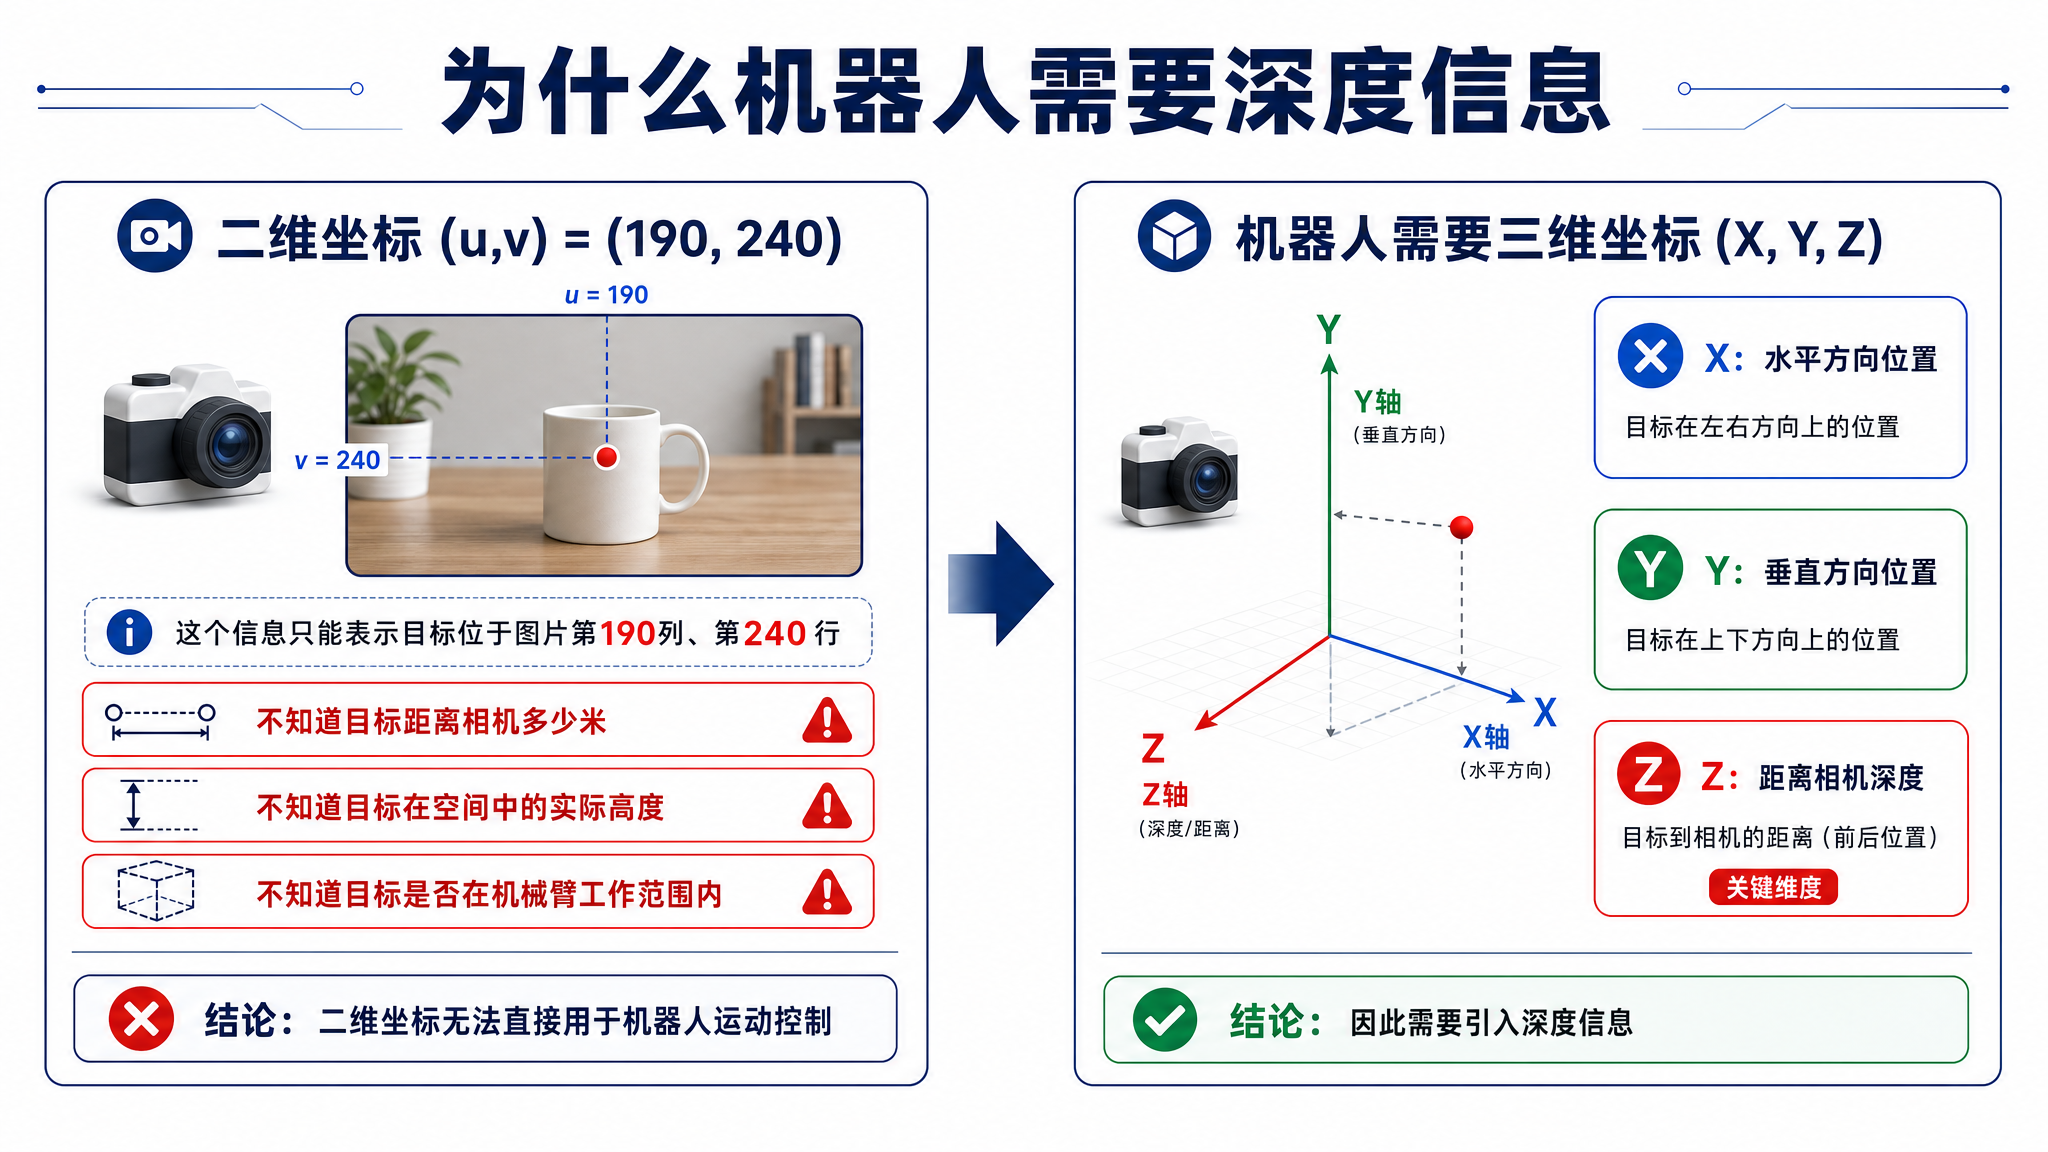
假设目标中心点:
(u,v)=(190,240)
这个信息只能表示:目标位于图片第190列、第240行。
但是机器人不知道:目标距离相机多少;目标在空间中的高度;目标是否在机械臂工作范围。因此:二维坐标无法直接用于机器人运动。
机器人需要物体所在的三维坐标,其中x,水平方向位置;Y,垂直方向位置;Z,距离相机深度,因此需要引入深度信息
深度图与RGB-D数据
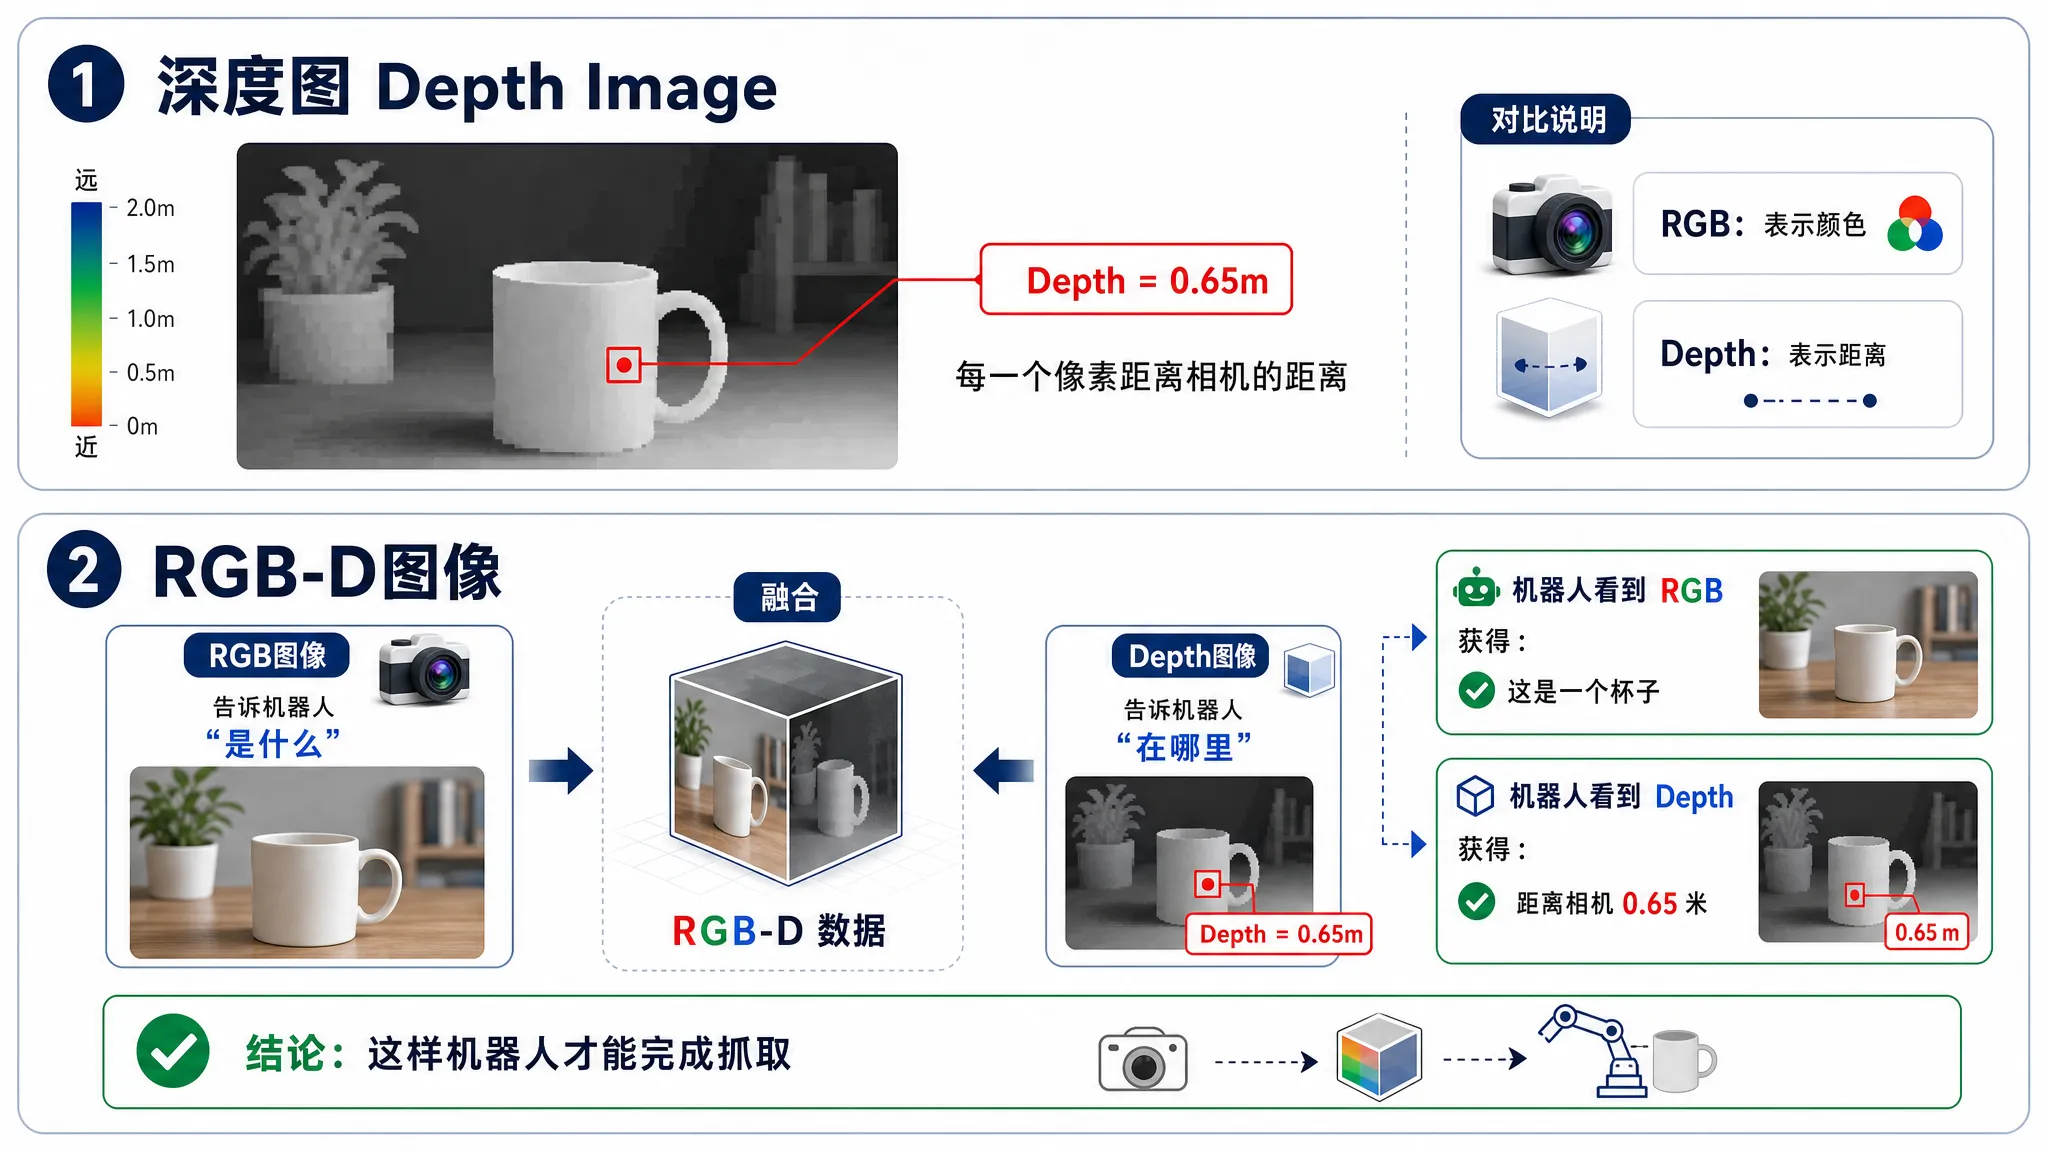
深度图
深度图(Depth Image)表示:每一个像素距离相机的距离。
例如:某个像素、Depth=0.65m
表示:这个位置距离相机约65厘米。与RGB图像不同,RGB表示颜色。Depth,表示距离。
RGB-D图像
将RGB图像与Depth图像融合,得到RGB-D数据。RGB-D包含:
- RGB部分:告诉机器人“是什么”
- Depth部分:告诉机器人“在哪里”
例如:
- 机器人看到RGB,获得这是一个杯子。看到Depth,获得杯子距离相机0.65米。这样机器人才能完成抓取。
深度相机原理
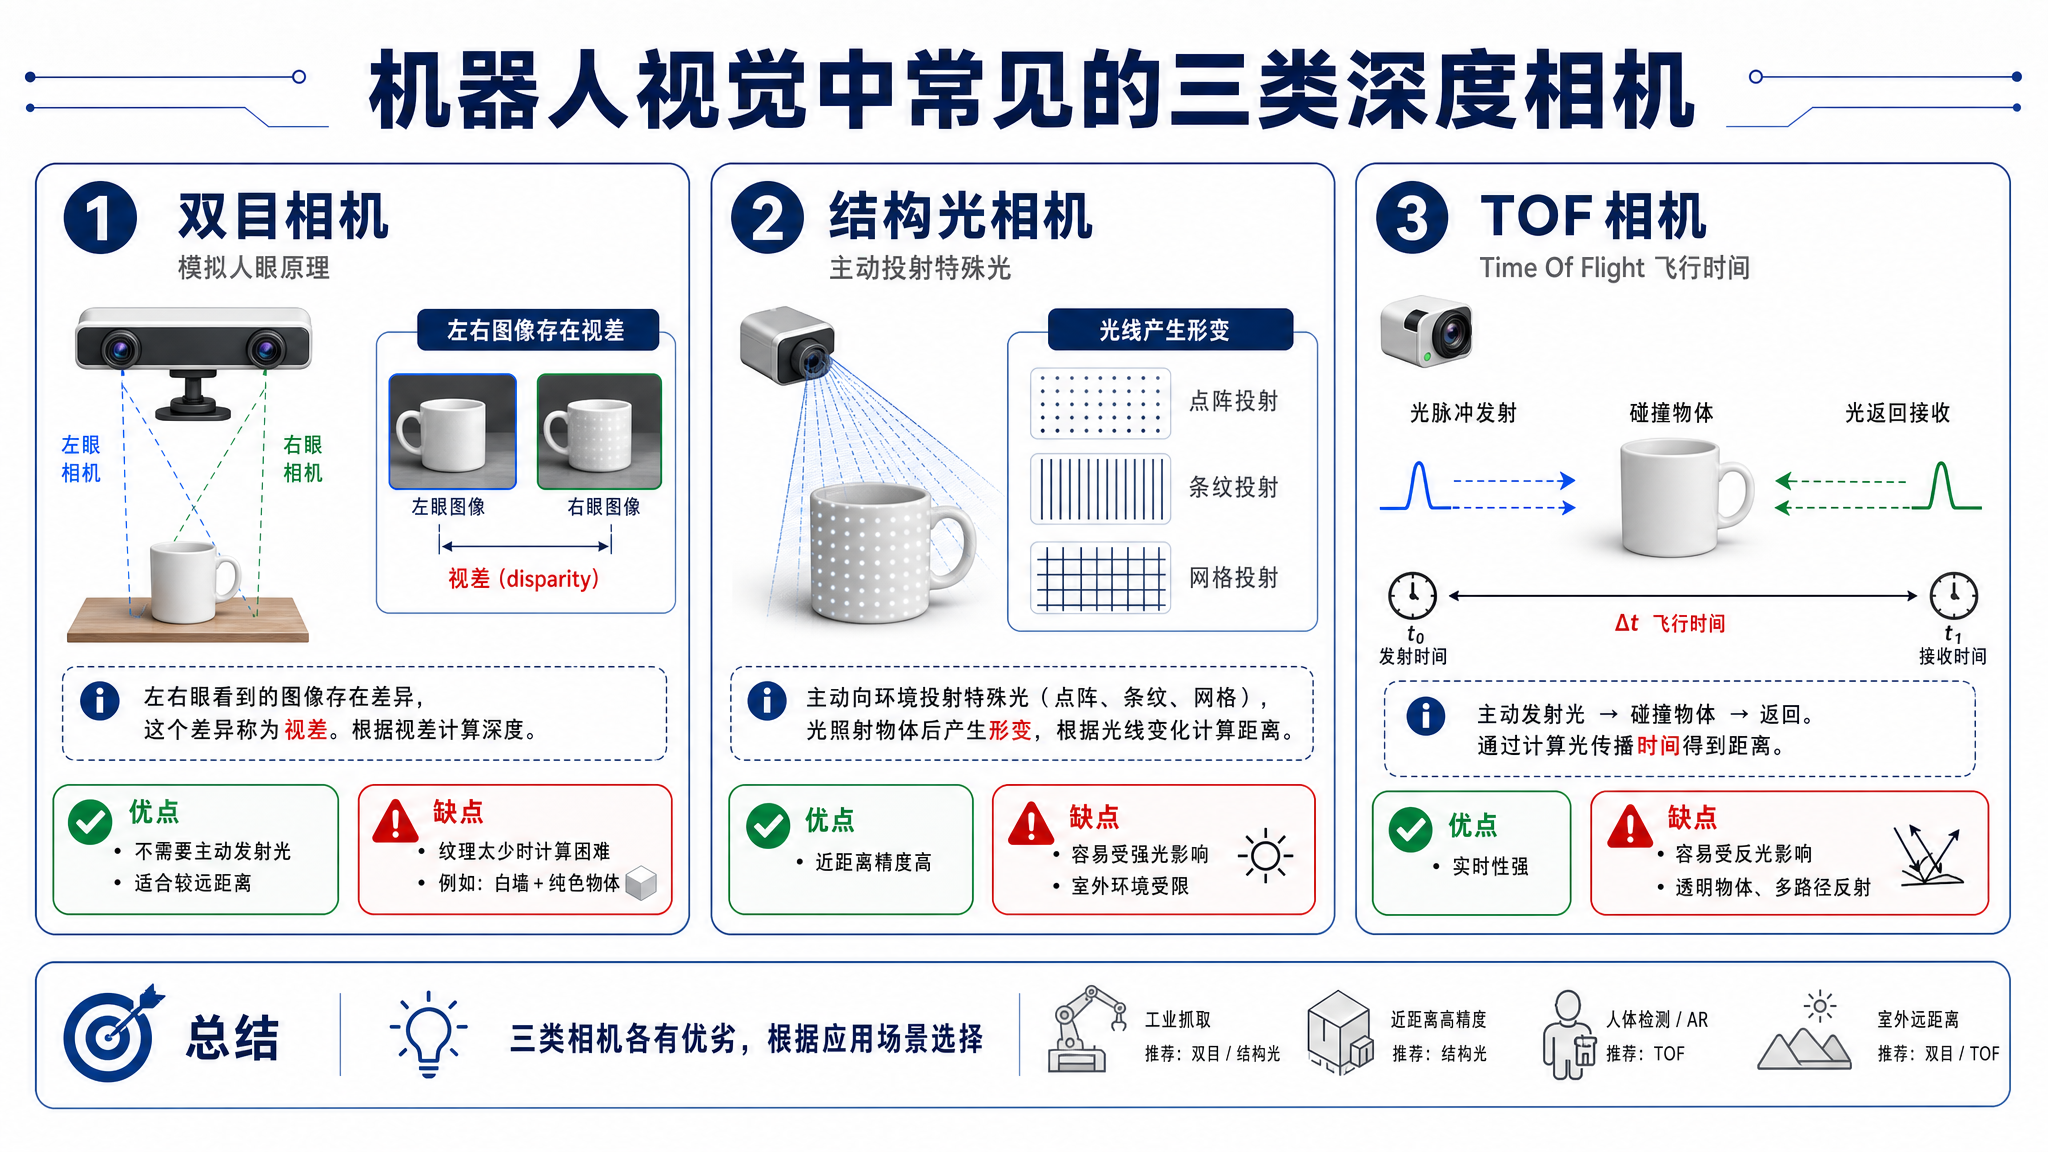
目前机器人视觉中常见三类深度相机有双目相机、结构光相机、TOF相机。
双目相机
原理:模拟人眼。人类能够判断距离,是因为左右眼看到的图像存在差异,这个差异称为视差。机器人通过两个摄像头,左摄像头与右摄像头来比较同一个物体的位置差异,根据视差计算深度。
优点:不需要主动发射光、适合较远距离
缺点:如果物体纹理太少,例如白墙+纯色物体,两个摄像头看到的信息接近,计算困难。
结构光相机
原理:结构光相机会主动向环境投射特殊光,例如点阵、条纹、网格 。光照射物体后会产生形变,相机根据光线变化程度计算物体距离。
优点:近距离精度高。
缺点:容易受到强光、室外环境影响。
TOF相机
TOF:Time Of Flight(飞行时间)。
原理:主动发射光 -> 碰撞物体 -> 返回。通过计算光传播时间得到距离。
优点:实时性强
缺点:容易受到反光、透明物体、多路径反射影响。
相机坐标模型与内参
坐标体系
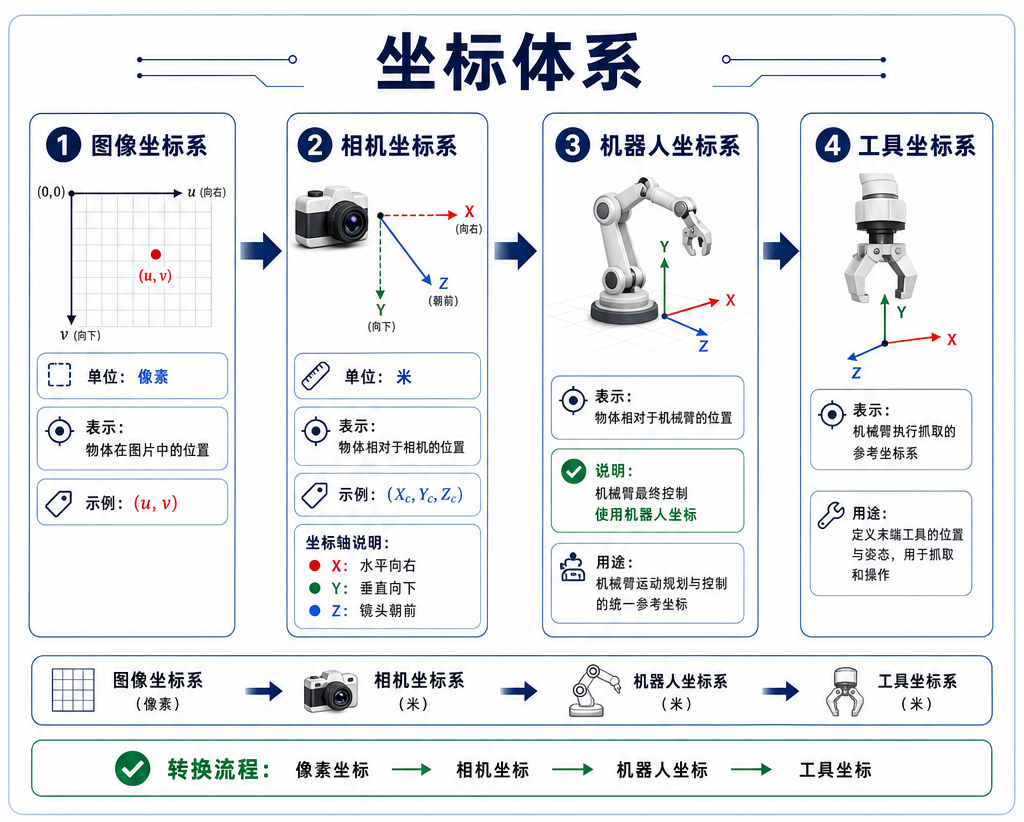
机器人视觉涉及三个坐标系:
-
图像坐标系
- 单位:像素。
- 表示:物体在图片中的位置。
- 例如:(u,v)
-
相机坐标系
-
单位:米。
-
表示:物体相对于相机的位置。
-
例如:(Xc,Yc,Zc)
- X:水平向右 Y:垂直向下 Z:镜头朝前
-
-
机器人坐标系
- 表示:物体相对于机械臂的位置。
- 机械臂最终控制使用:机器人坐标。
-
工具坐标系(末端夹爪坐标系)
- 表示:机械臂执行抓取的参考坐标系
相机内参
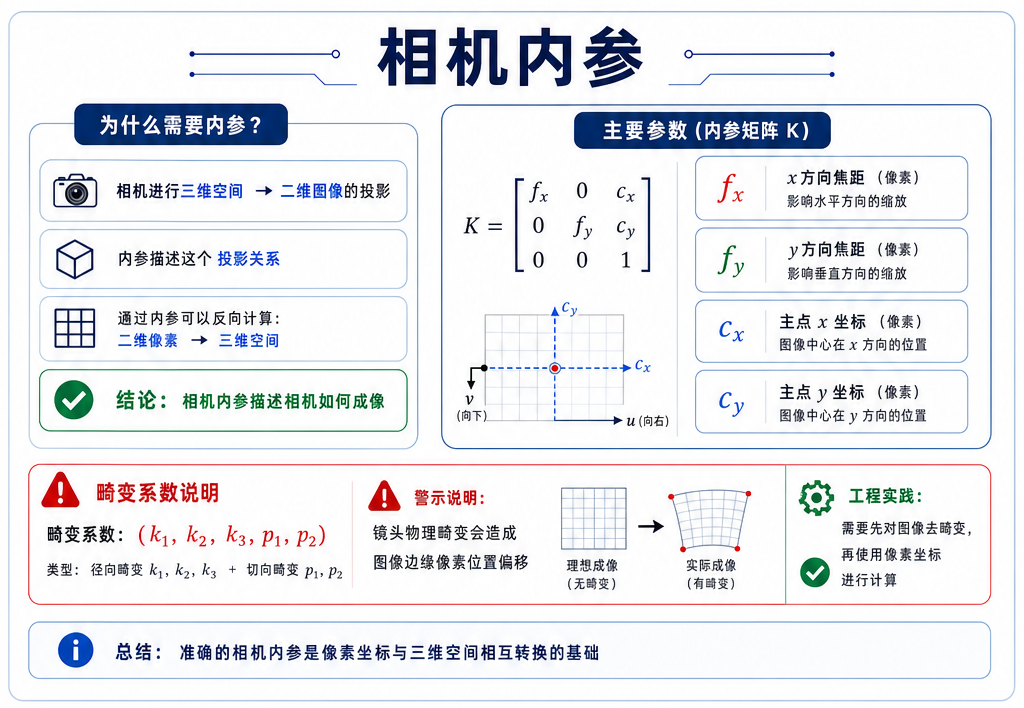
为什么需要内参?
- 因为二维图片不是现实空间,相机进行三维空间 -> 二维图像,这个过程叫投影,而内参就是描述这个投影关系。所以通过内参可以反向计算二维像素-> 三维空间,即相机内参描述:相机如何成像。
主要包括:fx、fy、cx、cy,其中:fx表示x方向焦距、fy表示y方向焦距、cx表示主点x坐标、cy表示主点y坐标。
除了这四个参数以外,还包含畸变系数 (k1,k2,k3,p1,p2)。
- 镜头物理畸变会造成图像边缘像素位置偏移,若不做畸变校正,(u,v) 像素坐标本身存在误差,三维转换结果偏差变大。实际工程中,需要先对图像去畸变,再使用像素坐标进行计算。
像素坐标转换三维坐标
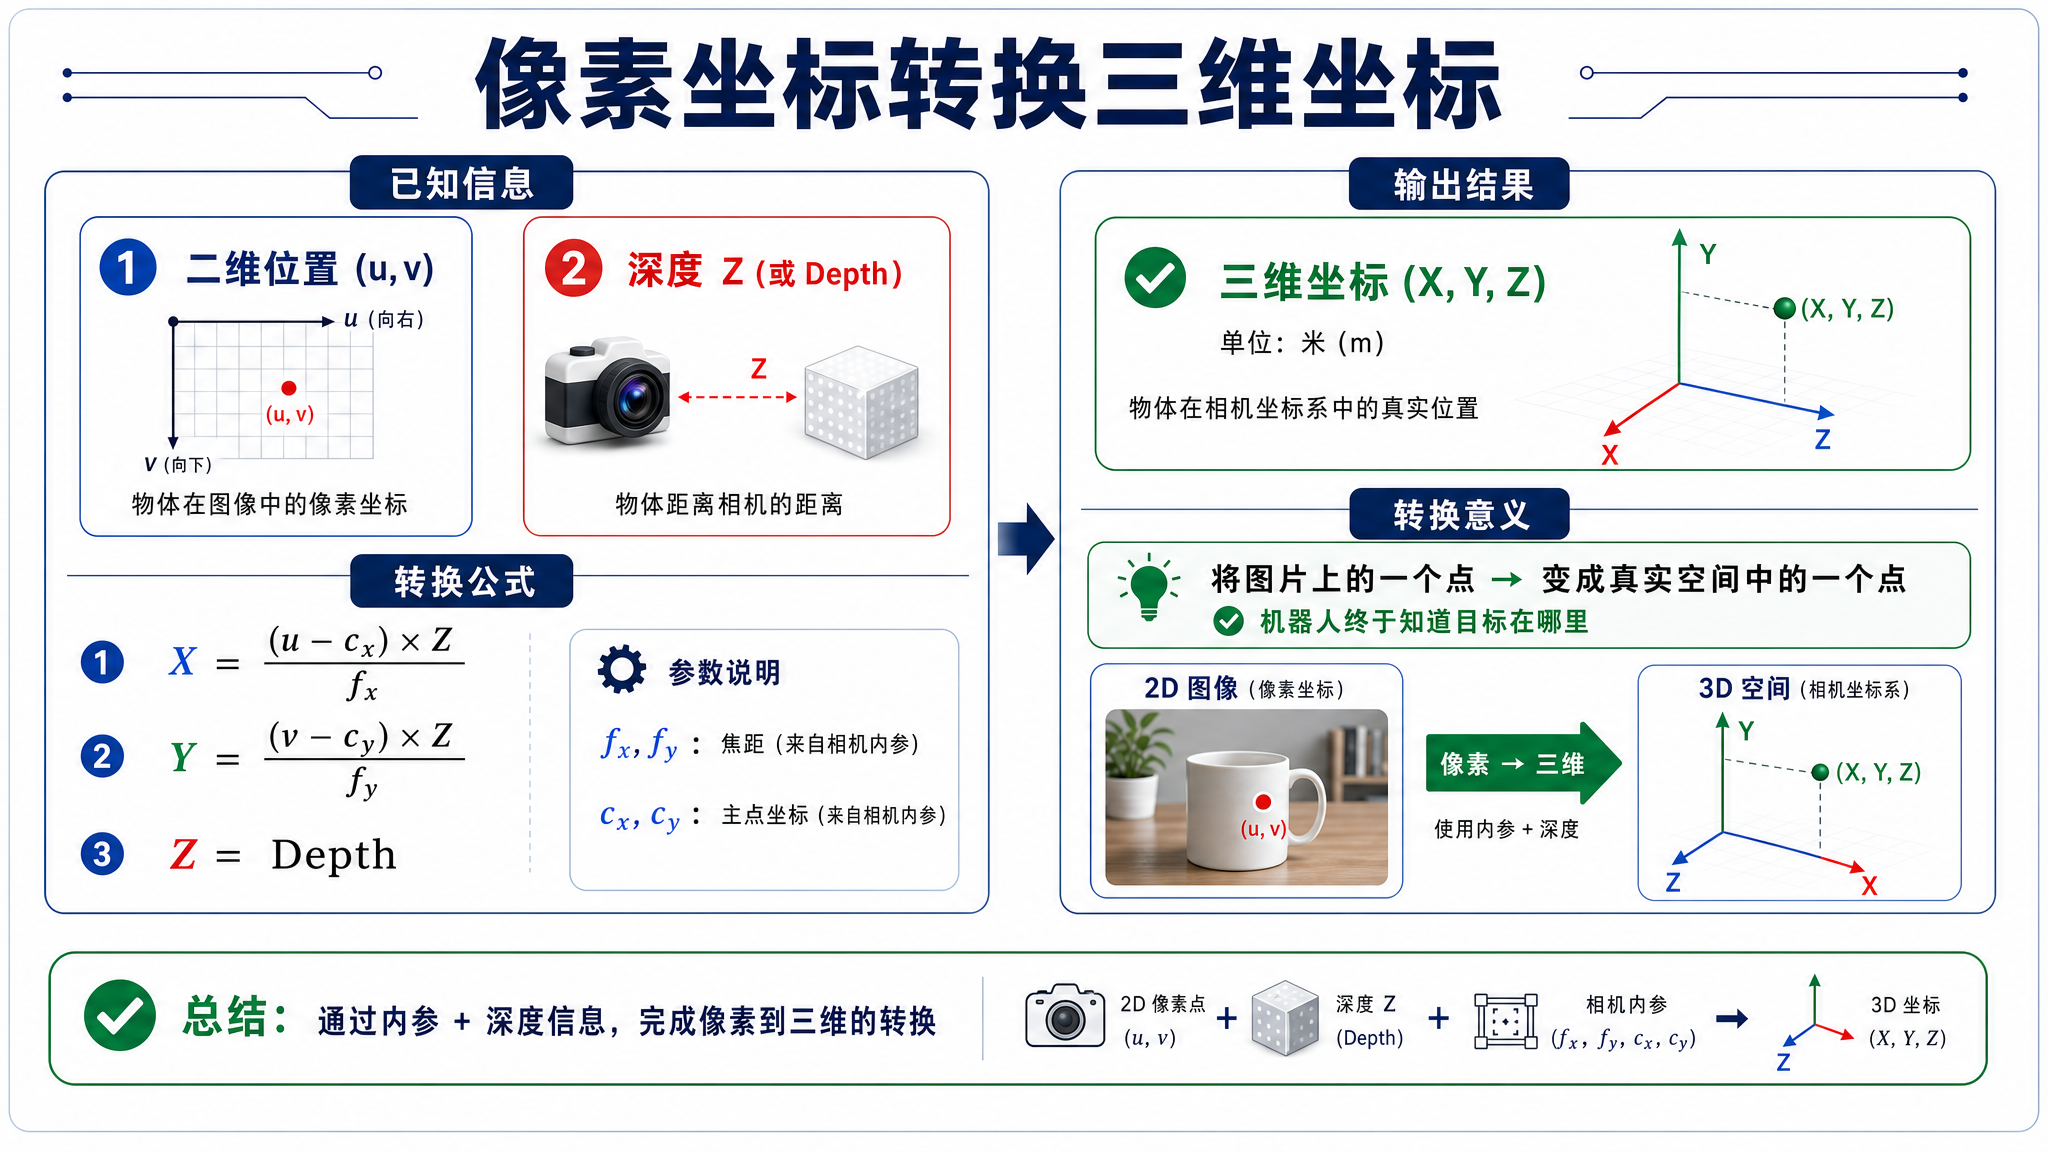
已知下列物体信息:
- 二维位置:(u,v)
- 深度:Z
通过内参得到物体的:
- (X,Y,Z)
公式:
转换意义:将原来的图片上的一点,变成真实空间中的一个点,让机器人终于知道目标在哪里。
相机外参与坐标转换
为什么需要外参?
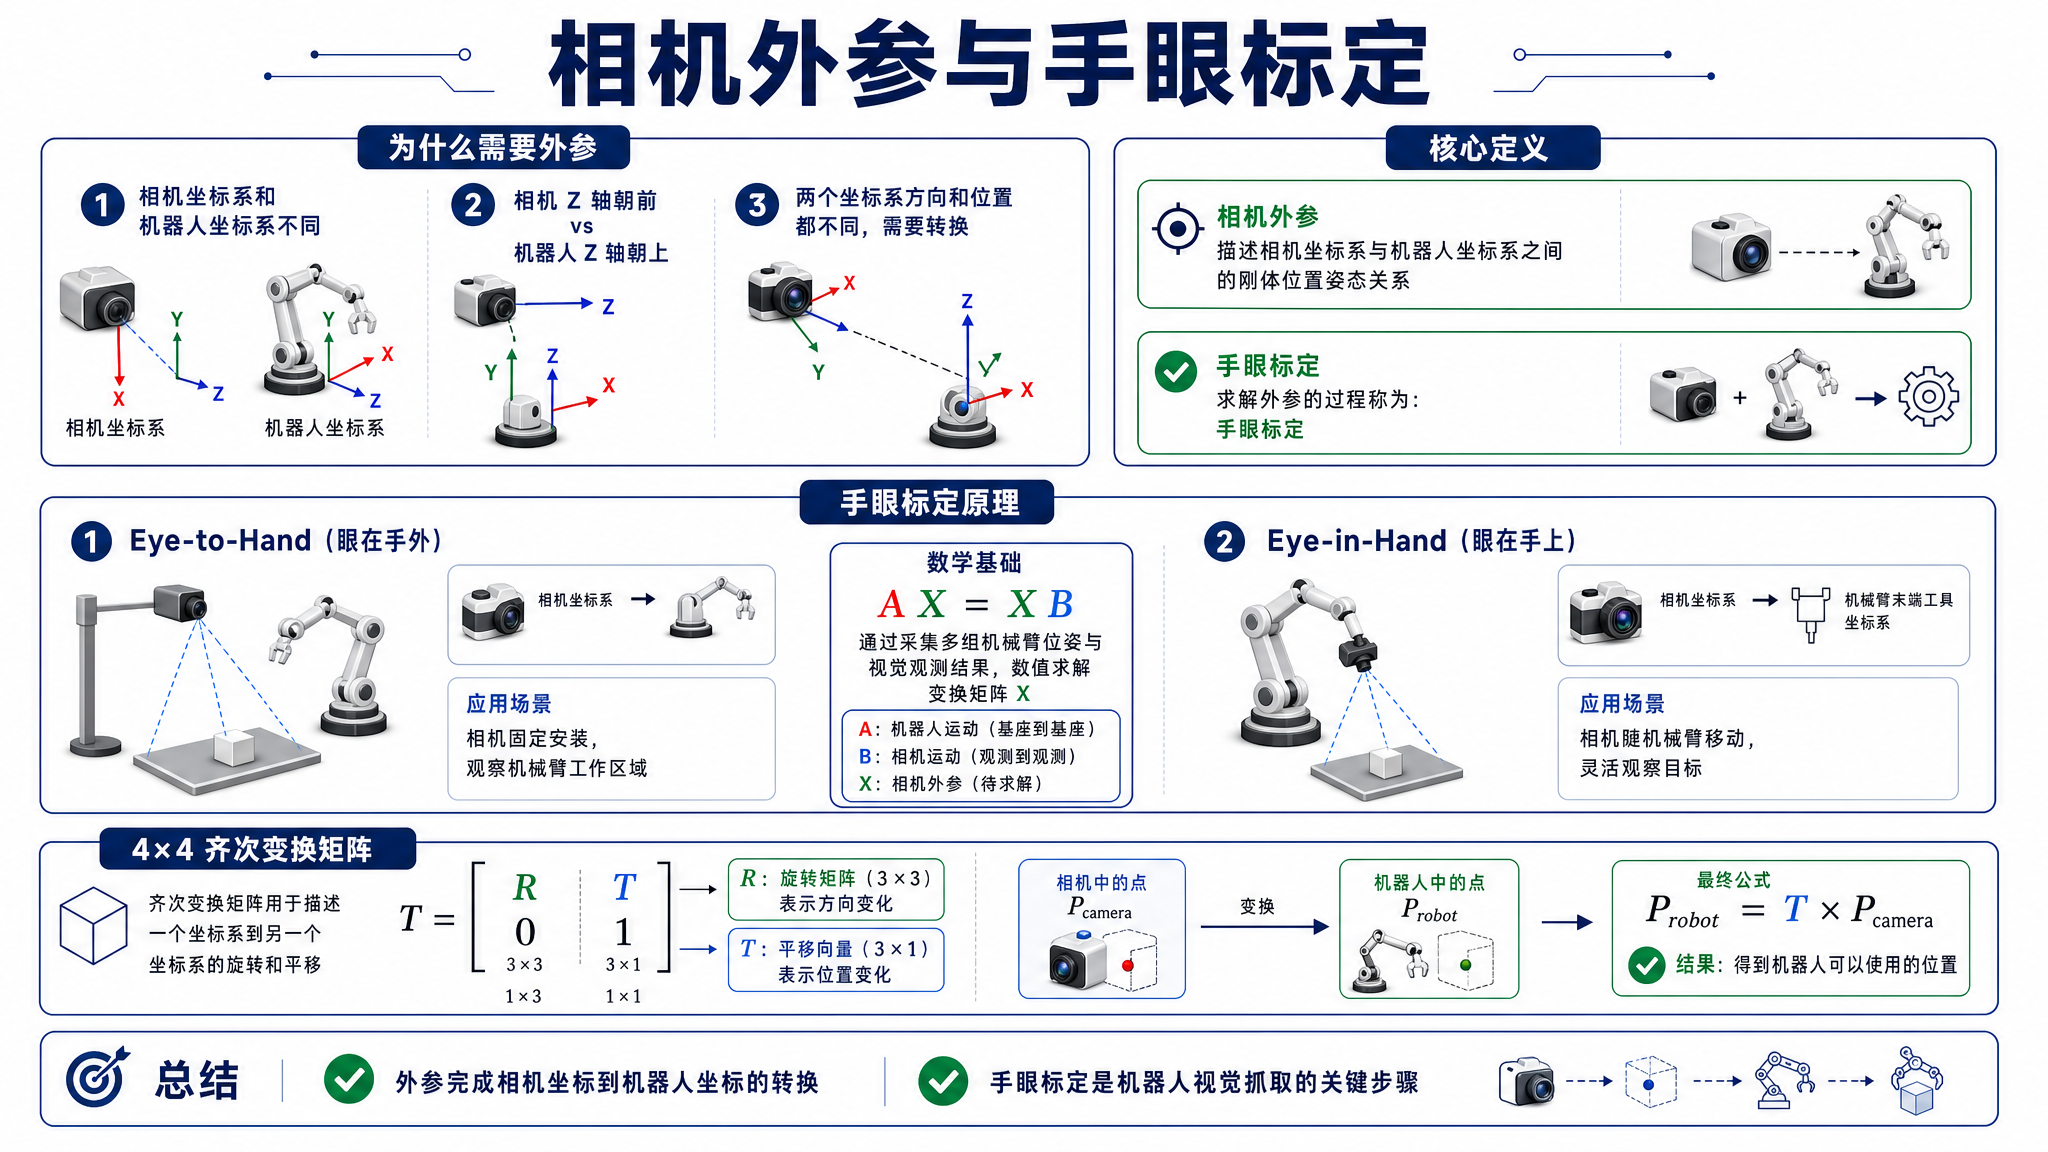
- 因为:相机坐标系和机器人坐标系不同。例如,相机Z轴朝前,机器人Z轴朝上。两个坐标系方向和位置都不同,所以需要转换,相机外参描述相机坐标系与机器人坐标系之间的刚体位置姿态关系,求解外参的过程称为手眼标定。
手眼标定原理
- Eye-to-Hand(眼在手外):求解相机坐标系 -> 机械臂基座坐标系的变换矩阵
- Eye-in-Hand(眼在手上):求解相机坐标系 -> 机械臂末端工具坐标系的变换矩阵
- 手眼标定数学基础为 ,通过采集多组机械臂位姿与视觉观测结果,数值求解变换矩阵 X。
标定矩阵
标定误差和抓取点,齐次变换矩阵X
-
机器人中通常使用4×4矩阵,表示坐标转换关系。
-
矩阵包含:
- 旋转矩阵 R,表示方向变化。
- 平移向量 T,表示位置变化。
-
最终:,得到机器人可以使用的位置。
点云
点云是什么?
-
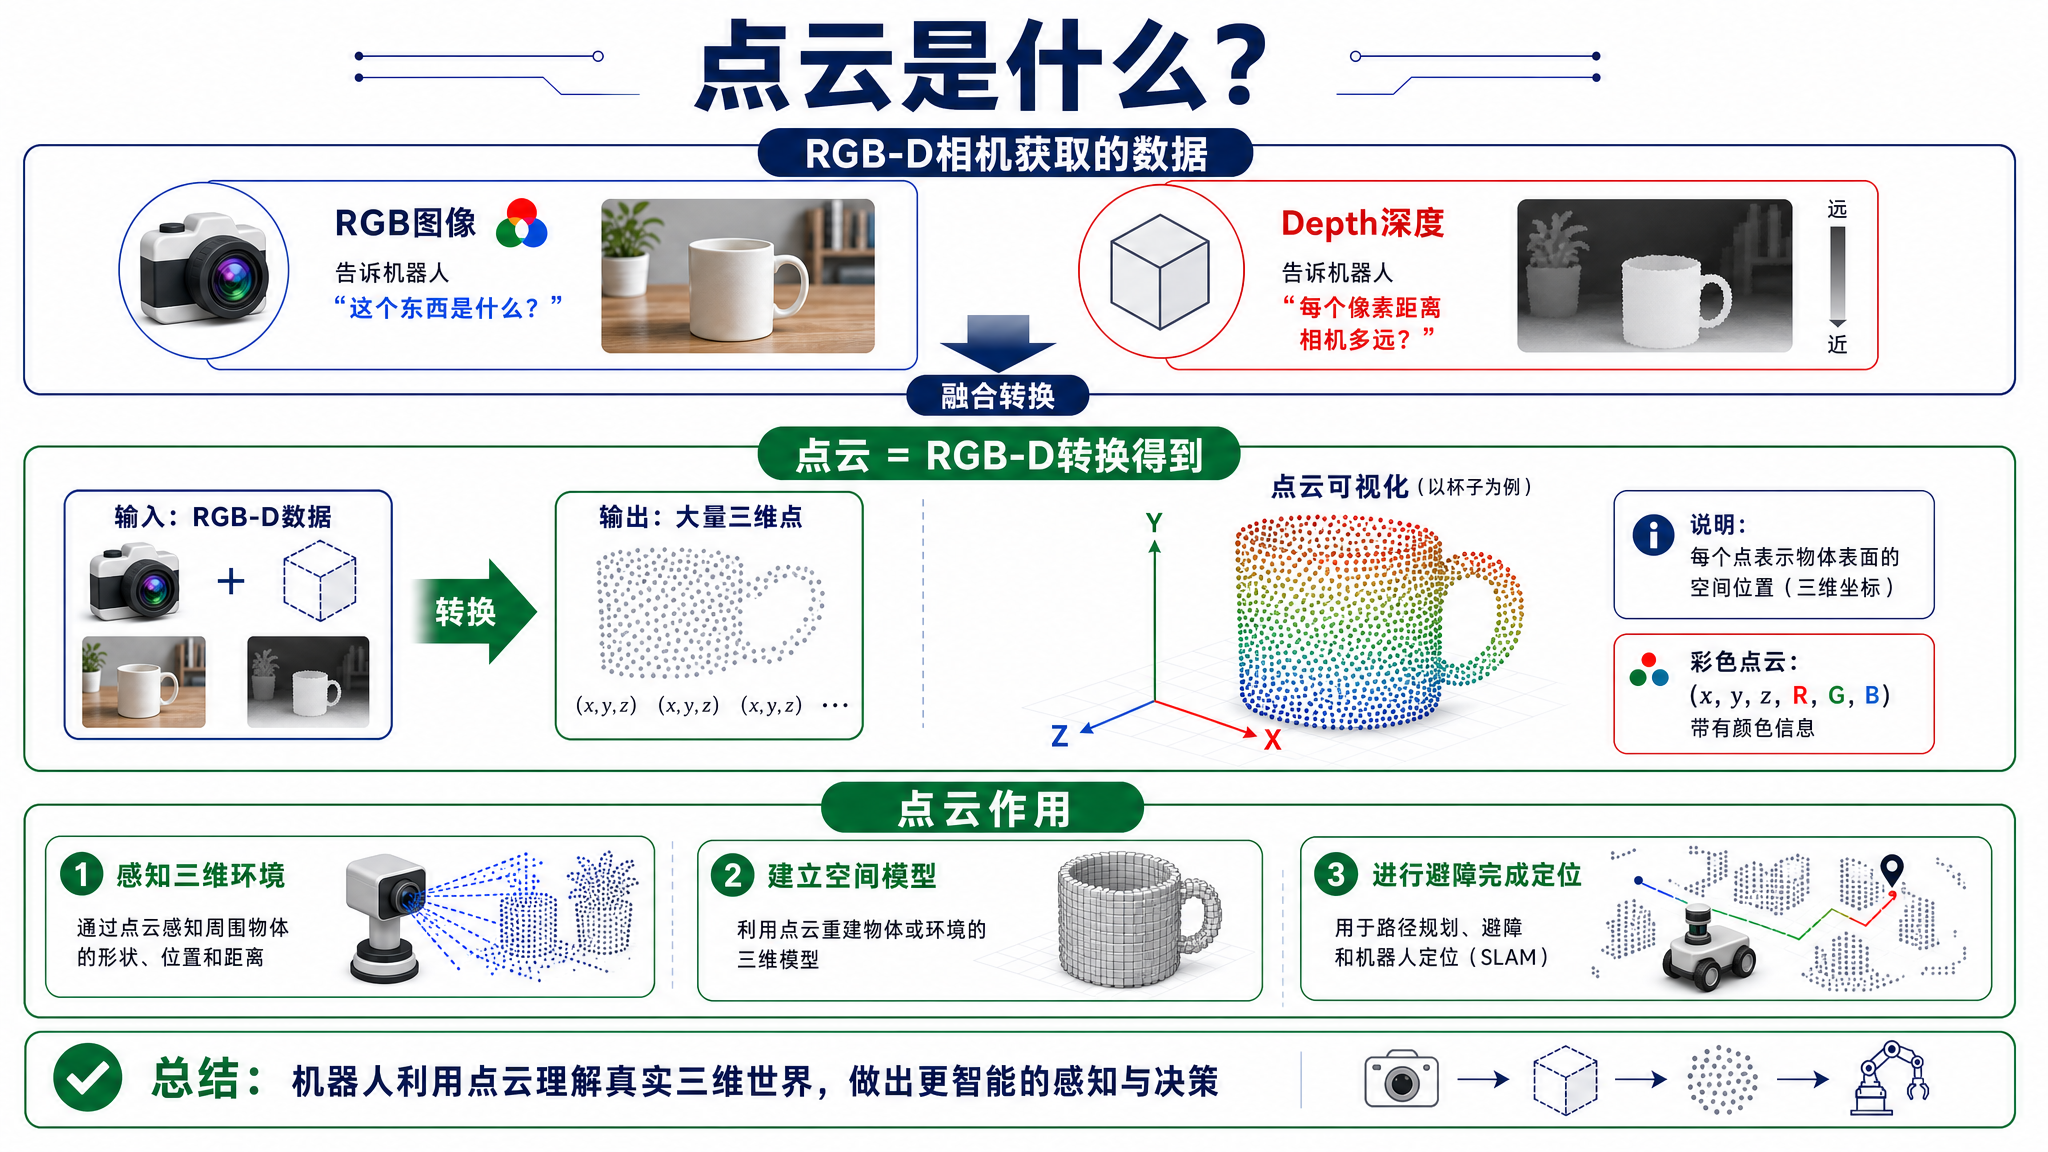
RGB-D相机获取的数据通常包括
- RGB图像告诉机器人,这个东西是什么?
- Depth深度告诉机器人,每个像素距离相机多远?
点云作用
- 机器人可以利用点云,感知三维环境、建立空间模型,进行避障完成定位