28. 目标检测与手眼标定
上一章我们学习了机器人视觉的基础流程:环境 -> 相机采集 -> 二维图像 -> 深度信息 -> 三维空间坐标 -> 机器人坐标,但对于每一环的算法原理和实现细节着墨不多。本章要把每一环"下沉一层",让读者理解算法背后的数学与工程取舍。
目标检测与手眼标定
章节概述
上一章我们学习了机器人视觉的基础流程:环境 -> 相机采集 -> 二维图像 -> 深度信息 -> 三维空间坐标 -> 机器人坐标,但对于每一环的算法原理和实现细节着墨不多。本章要把每一环"下沉一层",让读者理解算法背后的数学与工程取舍。
实际机器人系统中,机器人并不会直接面对一个已经标注好的目标位置。因此需要深入解决四个核心问题:
-
问题 1:检测算法为什么是 YOLO?YOLOE 怎么自定义类别?
- 对应:目标检测算法原理(28.3)
-
问题 2:为什么用 ArUco 而非棋盘格做相机标定?
- 对应:ArUco 标记原理(28.5)
-
问题 3:主动深度相机为什么能直接给出深度图?深度图与 RGB 怎么对齐?
- 对应:主动深度相机原理(28.6)
-
问题 4:6-DoF 抓取姿态是怎么从图像估出来的?
- 对应:6-DoF 抓取姿态估计(28.8)
-
因此本章将建立深入理解:
- 检测算法(YOLOE / OBB) -> ArUco 相机标定 -> 主动深度相机原理 -> 6-DoF 抓取姿态估计
视觉任务体系
机器人视觉中的任务链
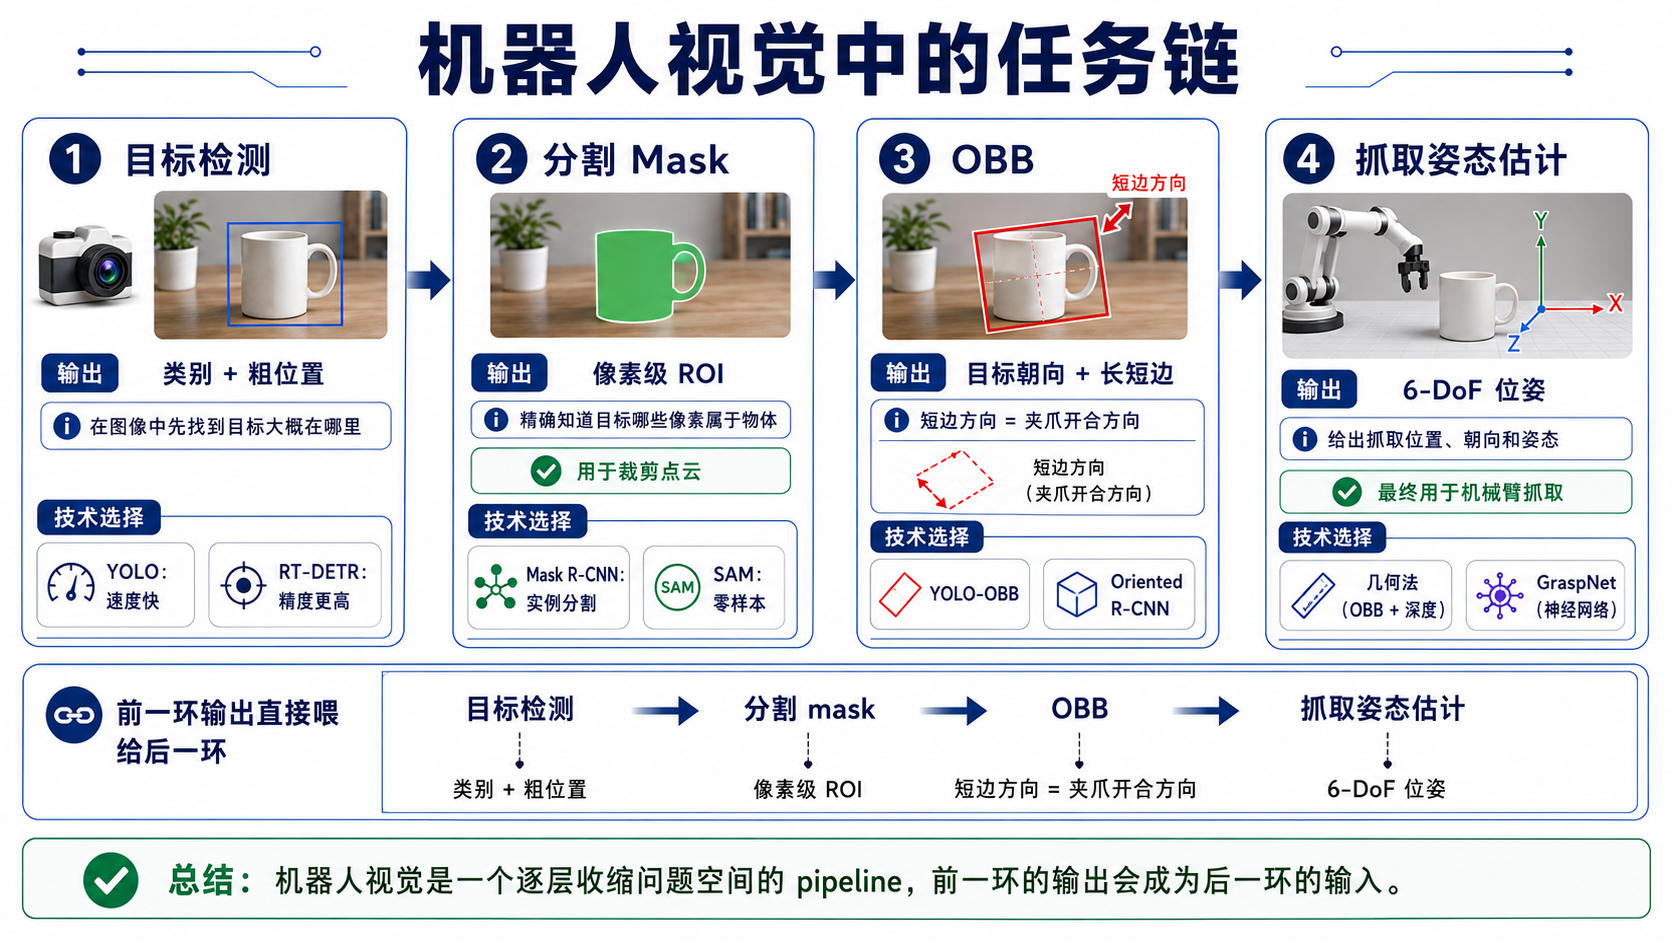
每一环都有特定的技术选择:
- 检测:YOLO(速度)或 RT-DETR(精度)
- 分割:Mask R-CNN(实例)或 SAM(零样本)
- OBB:YOLO-OBB 或 Oriented R-CNN
- 抓取:几何法(OBB+深度)或 GraspNet(神经网络)
四种视觉任务对比
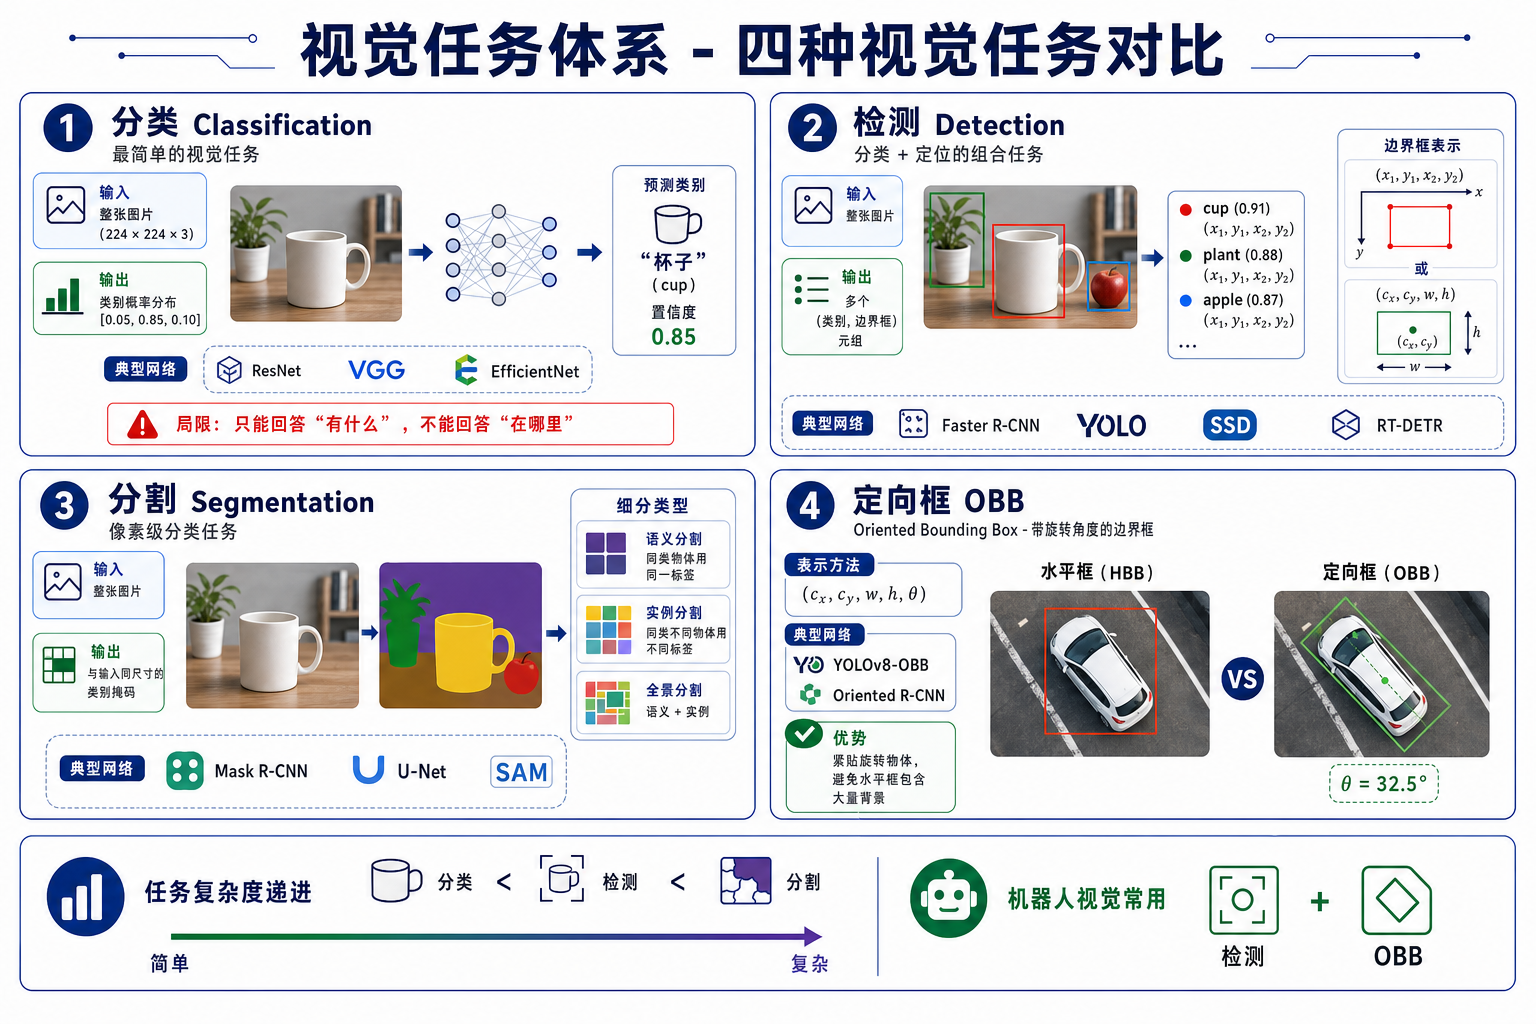
分类(Classification):最简单的视觉任务:输入一张图片,输出一个类别标签
- 输入:整张图片(如 224×224×3)
- 输出:类别概率分布(如 [0.05, 0.85, 0.10])
- 典型网络:ResNet、VGG、EfficientNet
- 局限:只能回答"有什么",不能回答"在哪里"
检测(Detection):分类 + 定位的组合任务。
- 输入:整张图片
- 输出:多个 (类别, 边界框) 元组
- 典型网络:Faster R-CNN、YOLO、SSD、RT-DETR
- 边界框表示:(x1, y1, x2, y2) 或 (cx, cy, w, h)
分割(Segmentation):像素级分类任务,给每个像素打类别标签。
-
输入:整张图片
-
输出:与输入同尺寸的类别掩码
-
典型网络:Mask R-CNN(实例分割)、U-Net(语义分割)、SAM
-
细分:
- 语义分割:同类物体用同一标签
- 实例分割:同类不同物体用不同标签
- 全景分割:语义 + 实例
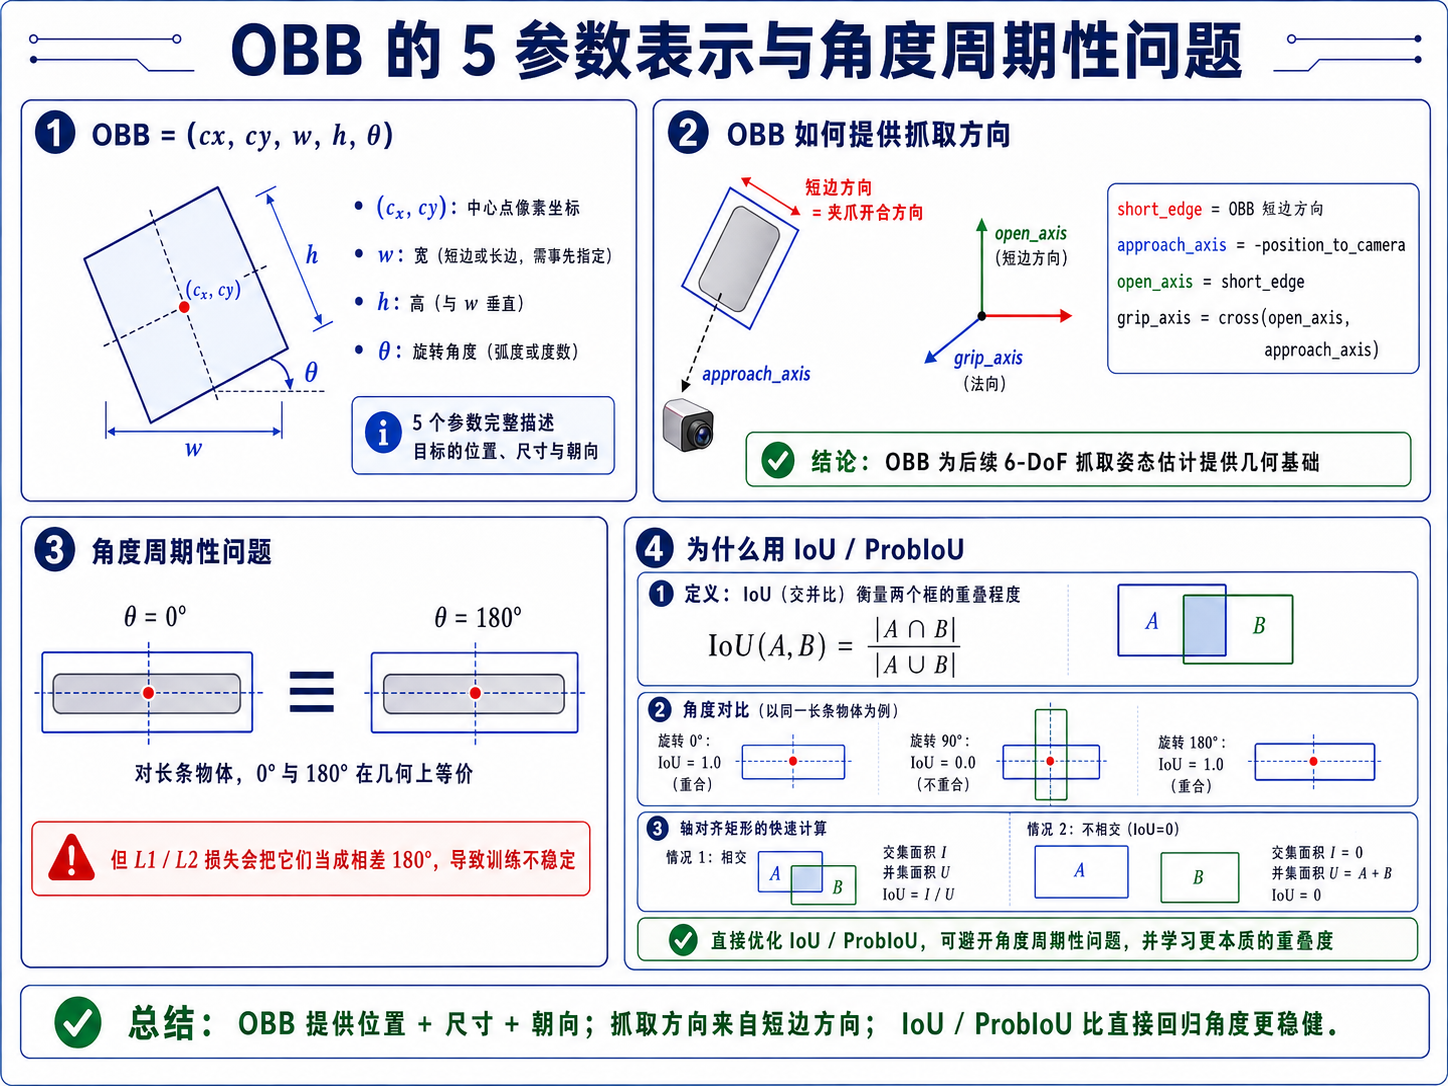
定向框(OBB, Oriented Bounding Box):带旋转角度的边界框
- 表示:(cx, cy, w, h, θ)
- 典型网络:YOLOv8-OBB、Oriented R-CNN
- 优势:紧贴旋转物体,避免水平框包含大量背景
检测算法深入
为什么实时机器人视觉选 YOLO
机器人应用对视觉算法的核心要求是实时性。考虑一个典型场景:
- 物体在传送带上以 0.1 m/s 移动,视野宽度 0.5 m,物体穿越视野时间:5 秒,假设需要 20 Hz 控制频率,每帧间隔 50 ms,如果检测算法每帧耗时 200 ms(5 Hz),机器人无法跟上物体移动,会频繁抓空。
- **YOLO 的"看一眼"思想,**一步完成图片划分成 S×S 网格、每个网格直接预测 B 个边界框 + 类别、一次前向传播出结果
开放词汇检测(YOLOE / YOLO-World)
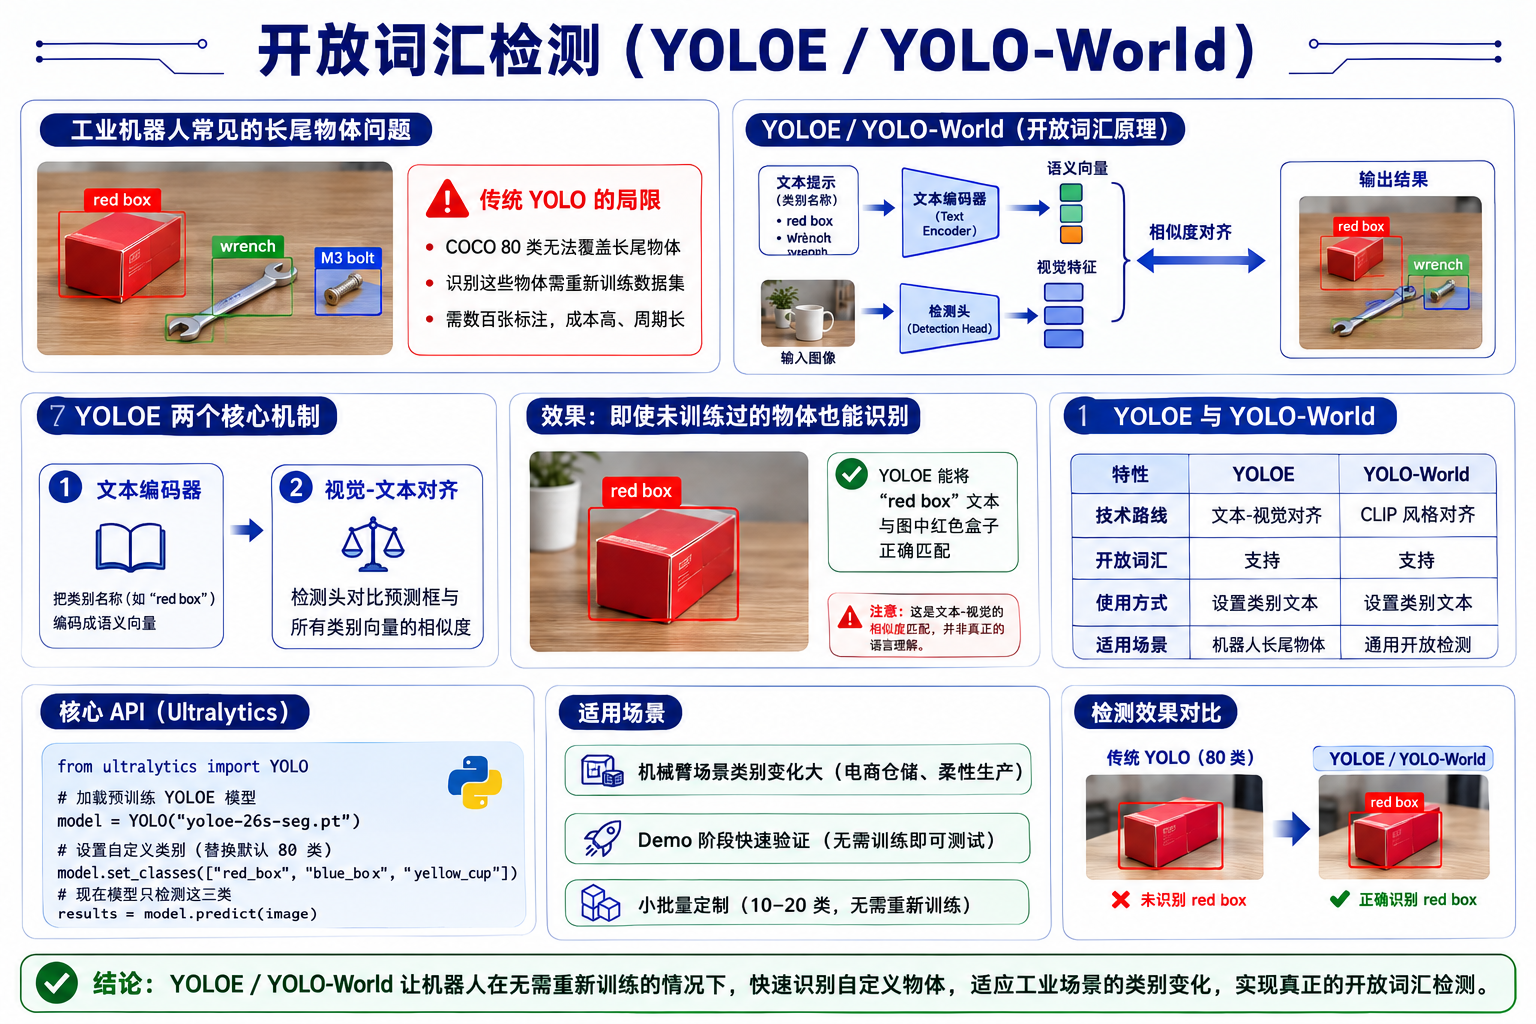
工业机器人经常遇到 COCO 80 类没有覆盖的物体:特定颜色的盒子("红盒子")、自定义零件("M3 螺栓")、临时摆放的工具("扳手"),传统 YOLO 要识别这些,必须重新训练数据集(数百张标注),成本高。
YOLOE(YOLO with Extended vocabulary)通过两个机制实现开放词汇:
- 文本编码器:把类别名称(如 "red box")编码成语义向量;
- 视觉-文本对齐:检测头对比预测框与所有类别向量的相似度
- 文本编码器知道"red box"这个词对应的视觉概念。即使训练时没见过红色盒子,它也能把“red box”这个文本和图中的红色盒子匹配上,但需要注意的是他是进行文本-视觉的相似度匹配,不是真正的语言理解,并且如果是文本编码器没有见过的词汇,他并不能够理解。
YOLO-World 类似思路
- YOLO-World 使用 CLIP 风格的图像-文本对齐,实现开放词汇,工作原理与YOLOE一致
核心 API
from ultralytics import YOLO

# 加载预训练 YOLOE 模型
model = YOLO("yoloe-26s-seg.pt")

# 设置自定义类别(替换默认 80 类)
model.set_classes(["red_box", "blue_box", "yellow_cup"])

# 现在模型只检测这三类
results = model.predict(image)
适用场景
- 机械臂场景类别变化大(电商仓储、柔性生产)
- Demo 阶段快速验证(无需训练即可测试)
- 小批量定制(10-20 类,无需重新训练)
为什么机器人视觉多用 OBB
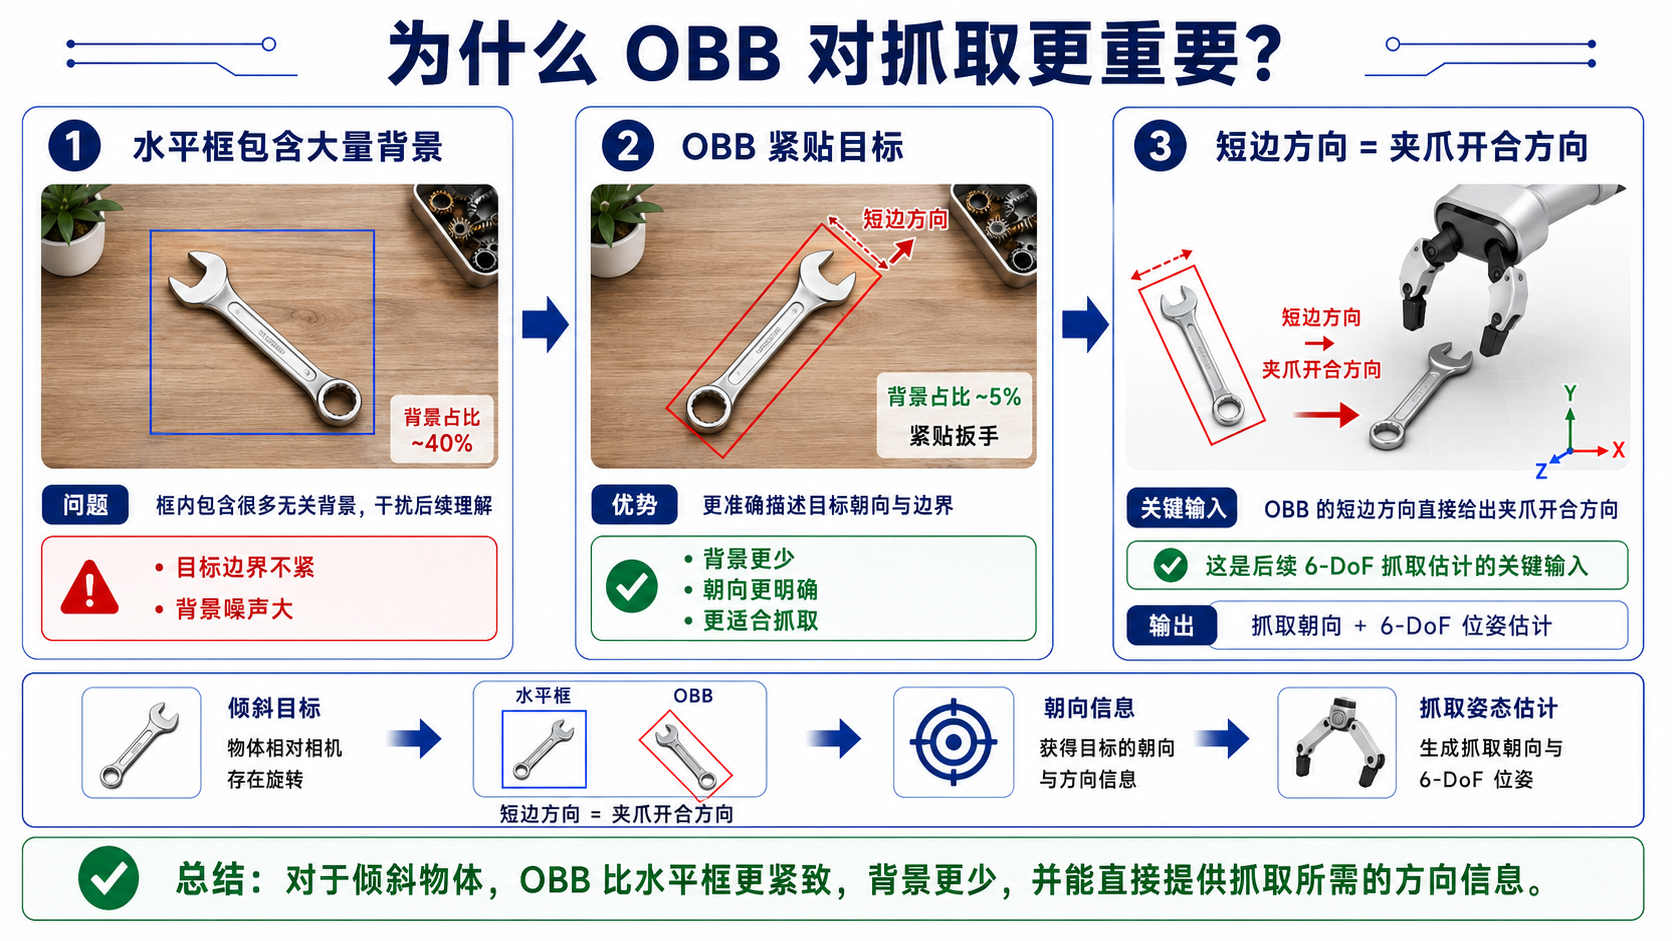
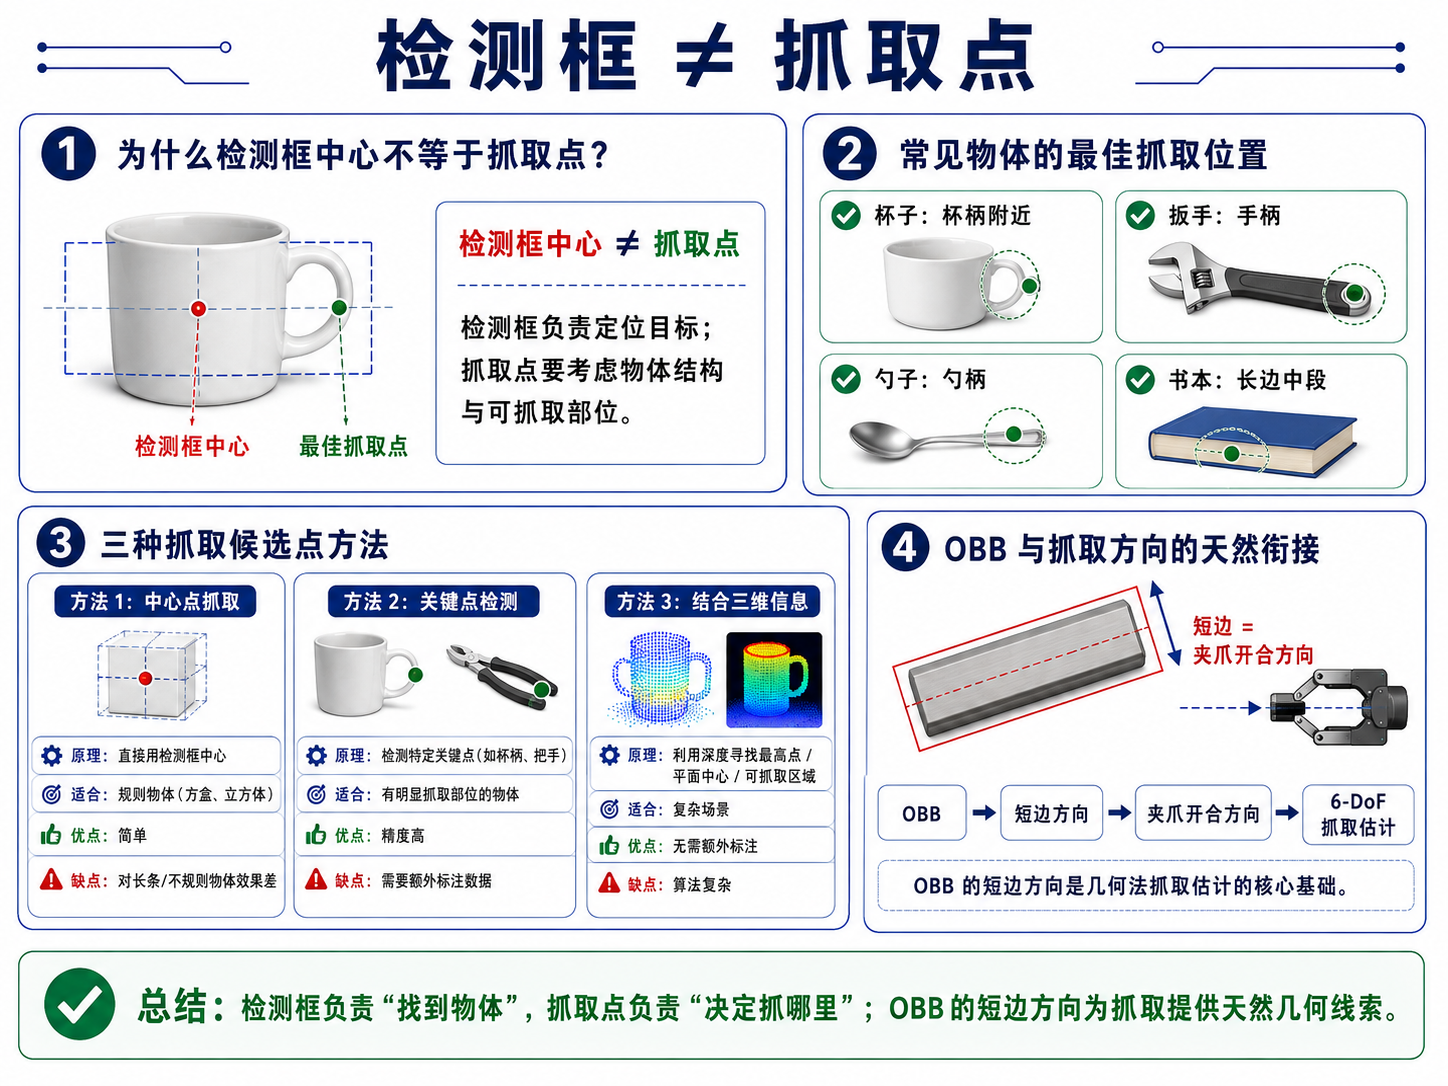
OBB 的短边方向直接给出夹爪开合方向,这是后续 6-DoF 抓取估计的关键输入。
定向框(OBB)原理
后处理 NMS
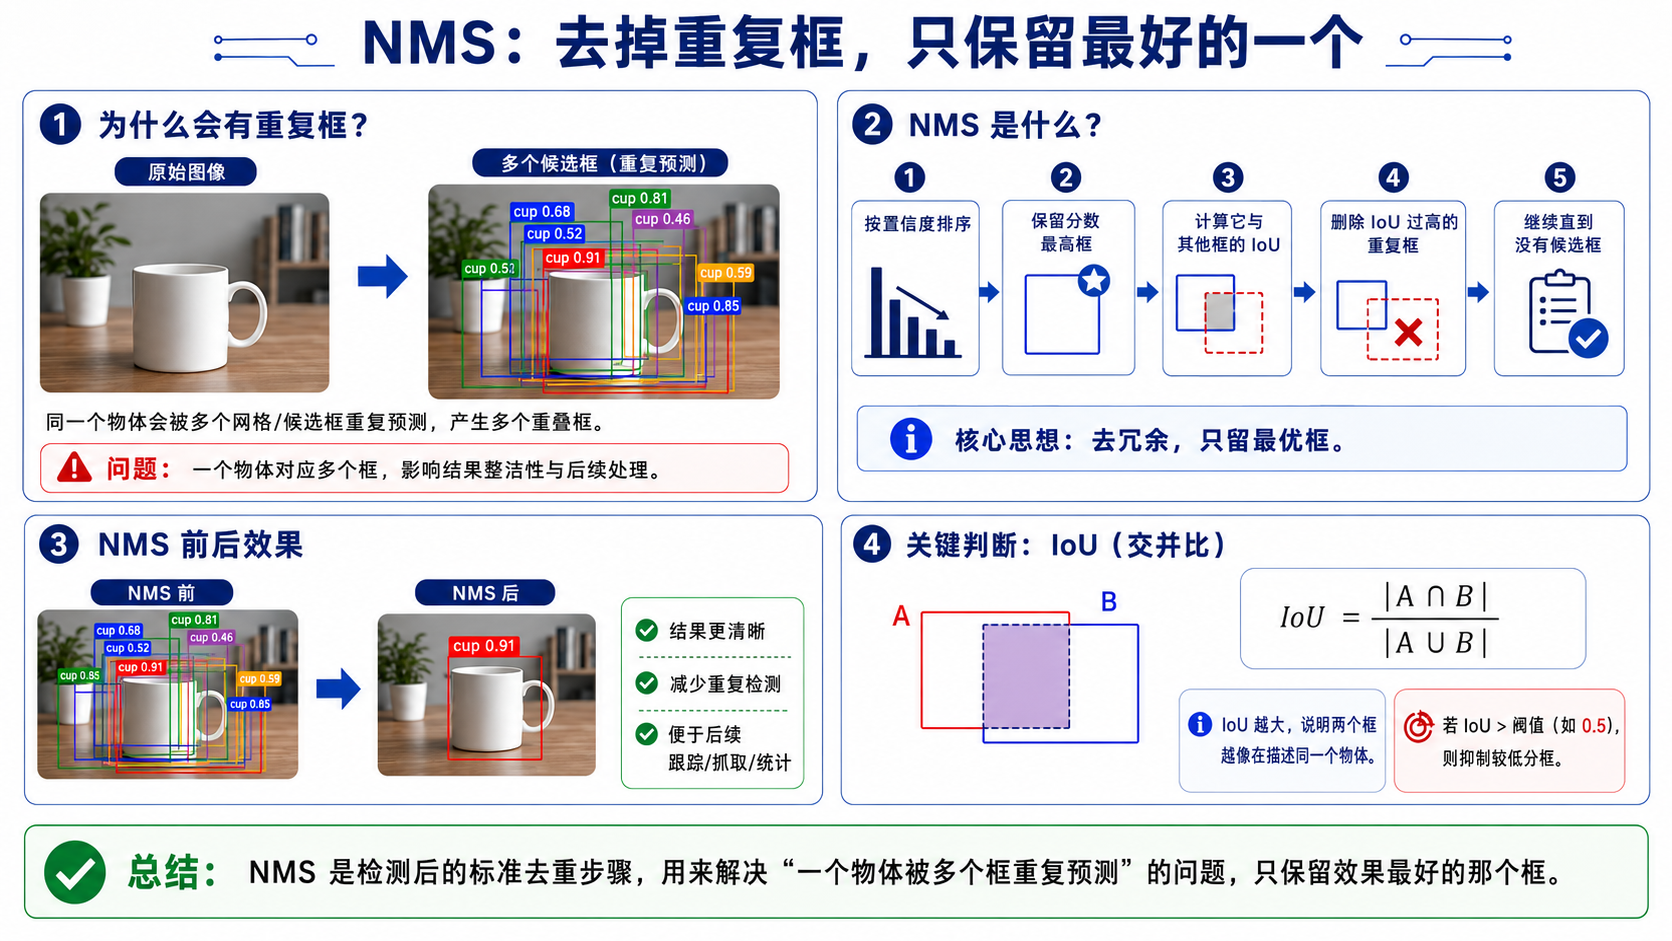
NMS 是检测后处理的标准步骤,YOLO检测完一张图后,同一个物体会被多个网格“重复”预测出多个重叠框,NMS就是把这些重复框去掉,只留一个效果最好的,解决"一个物体被多个网格重复预测"的问题。
-
实例代码
def nms(boxes, scores, iou_threshold):
    """
    boxes: [(x1, y1, x2, y2), ...]
    scores: [confidence, ...]
    返回保留的索引列表
    """# 1. 按置信度降序排序
    order = sorted(range(len(scores)), key=lambda i: scores[i], reverse=True)

    keep = []
    while order:
# 2. 选最高分框
        i = order[0]
        keep.append(i)

# 3. 计算与其他框的 IoU
        rest = order[1:]
        ious = [compute_iou(boxes[i], boxes[j]) for j in rest]

# 4. 保留 IoU < 阈值的框(去除冗余)
        order = [rest[j] for j, iou in enumerate(ious) if iou < iou_threshold]

    return keep
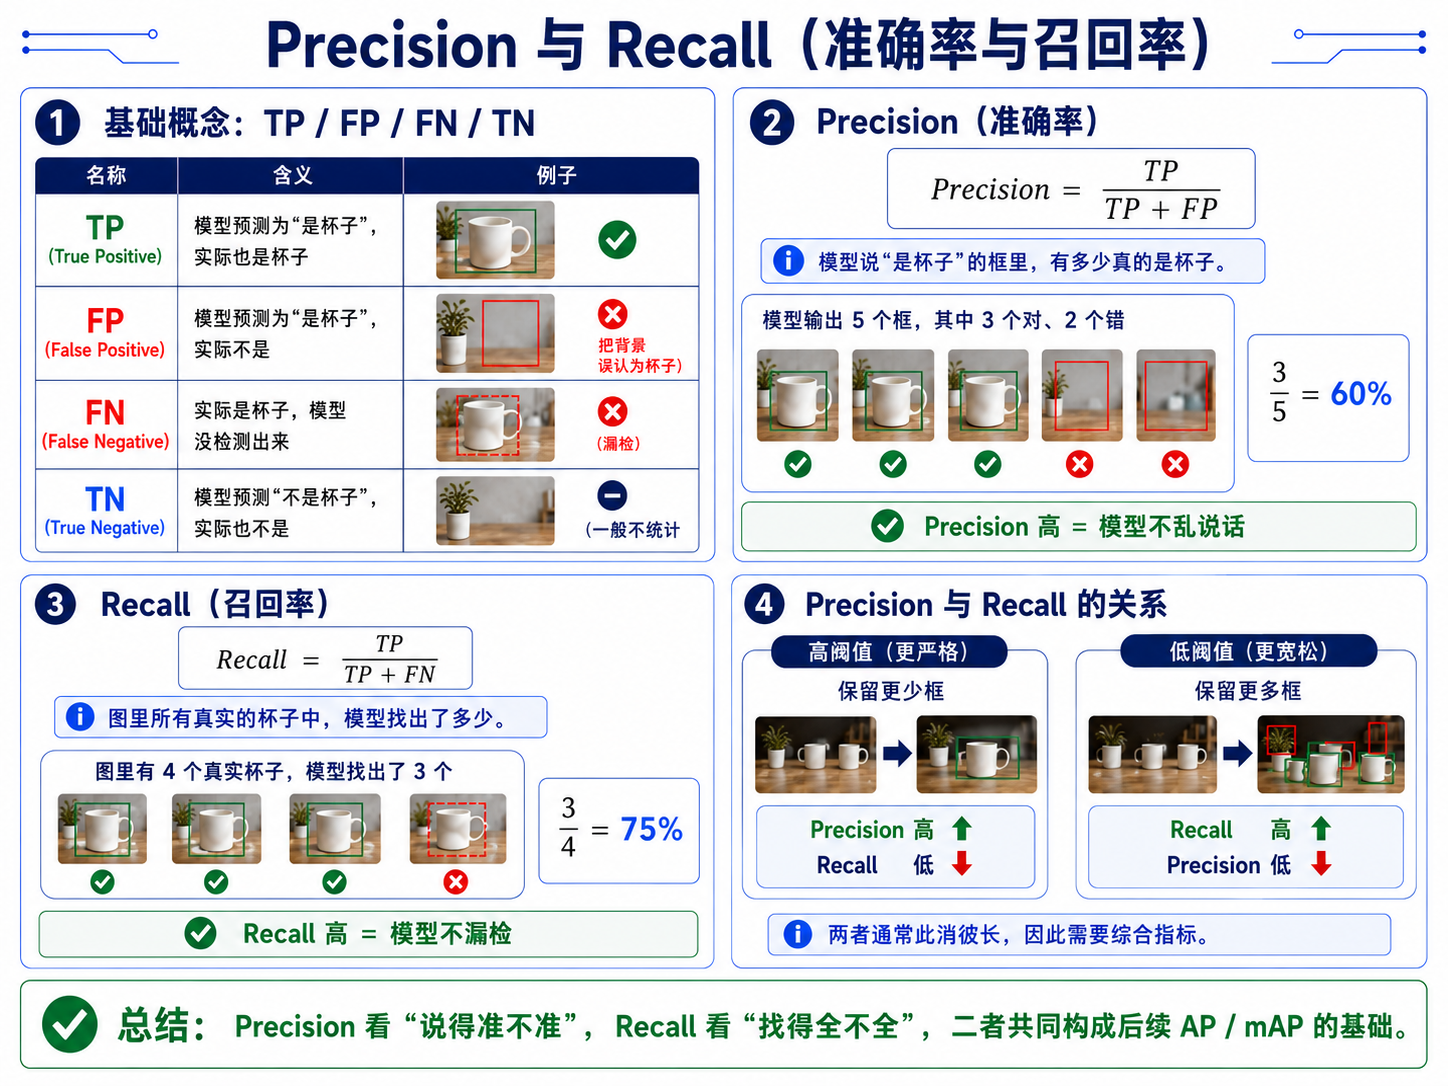
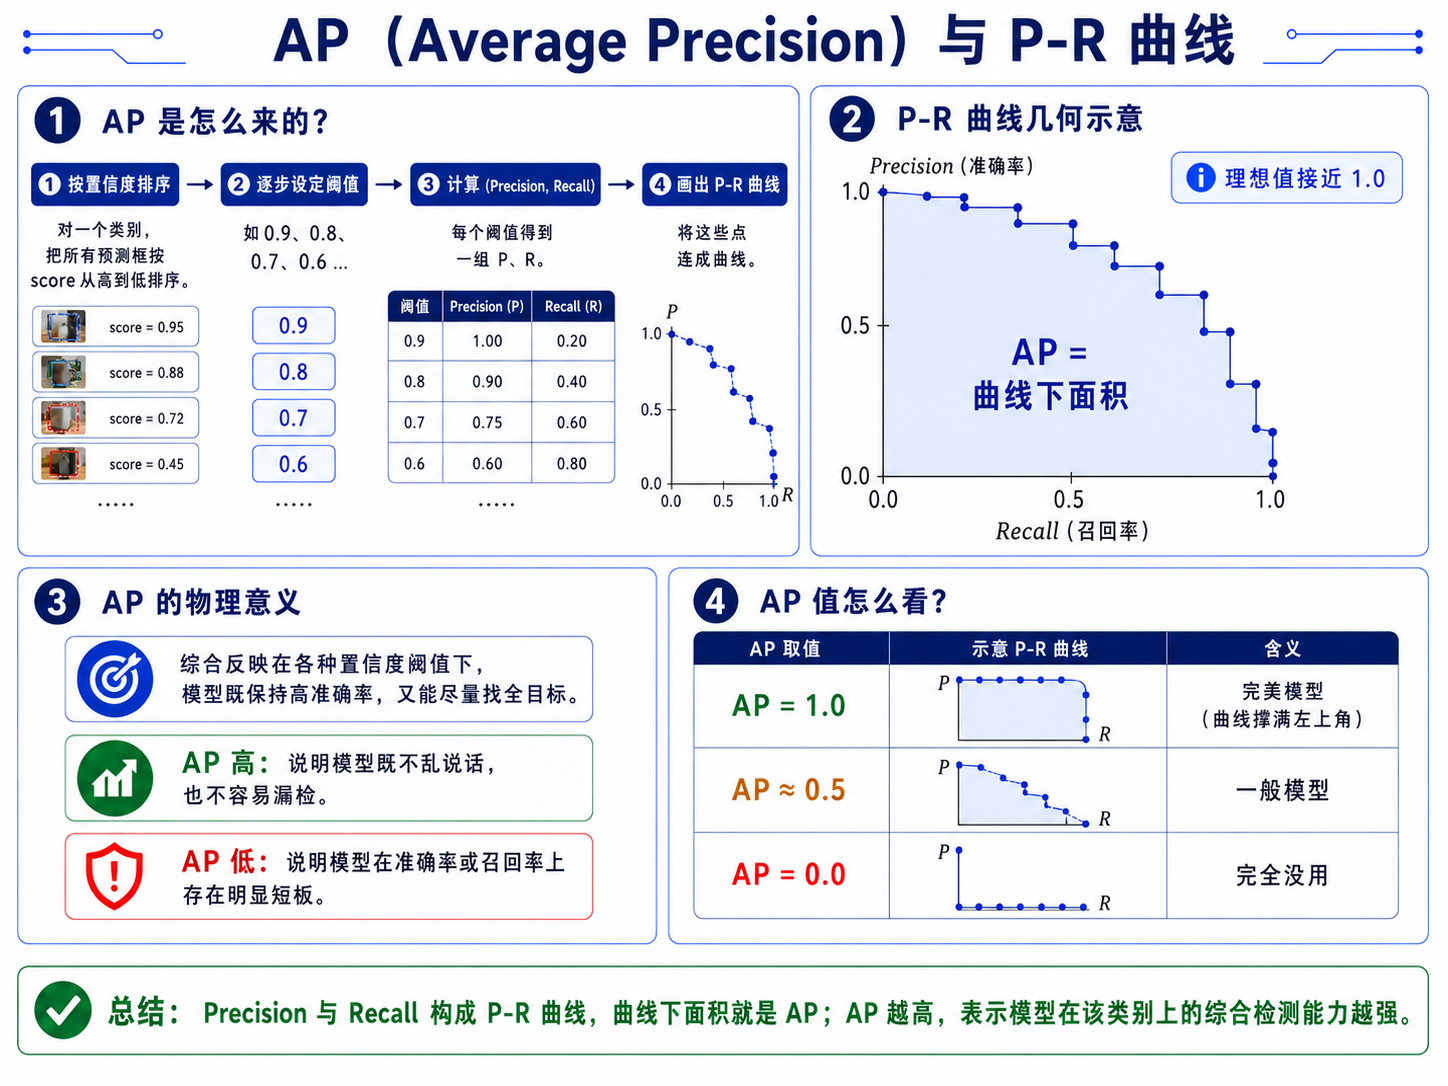
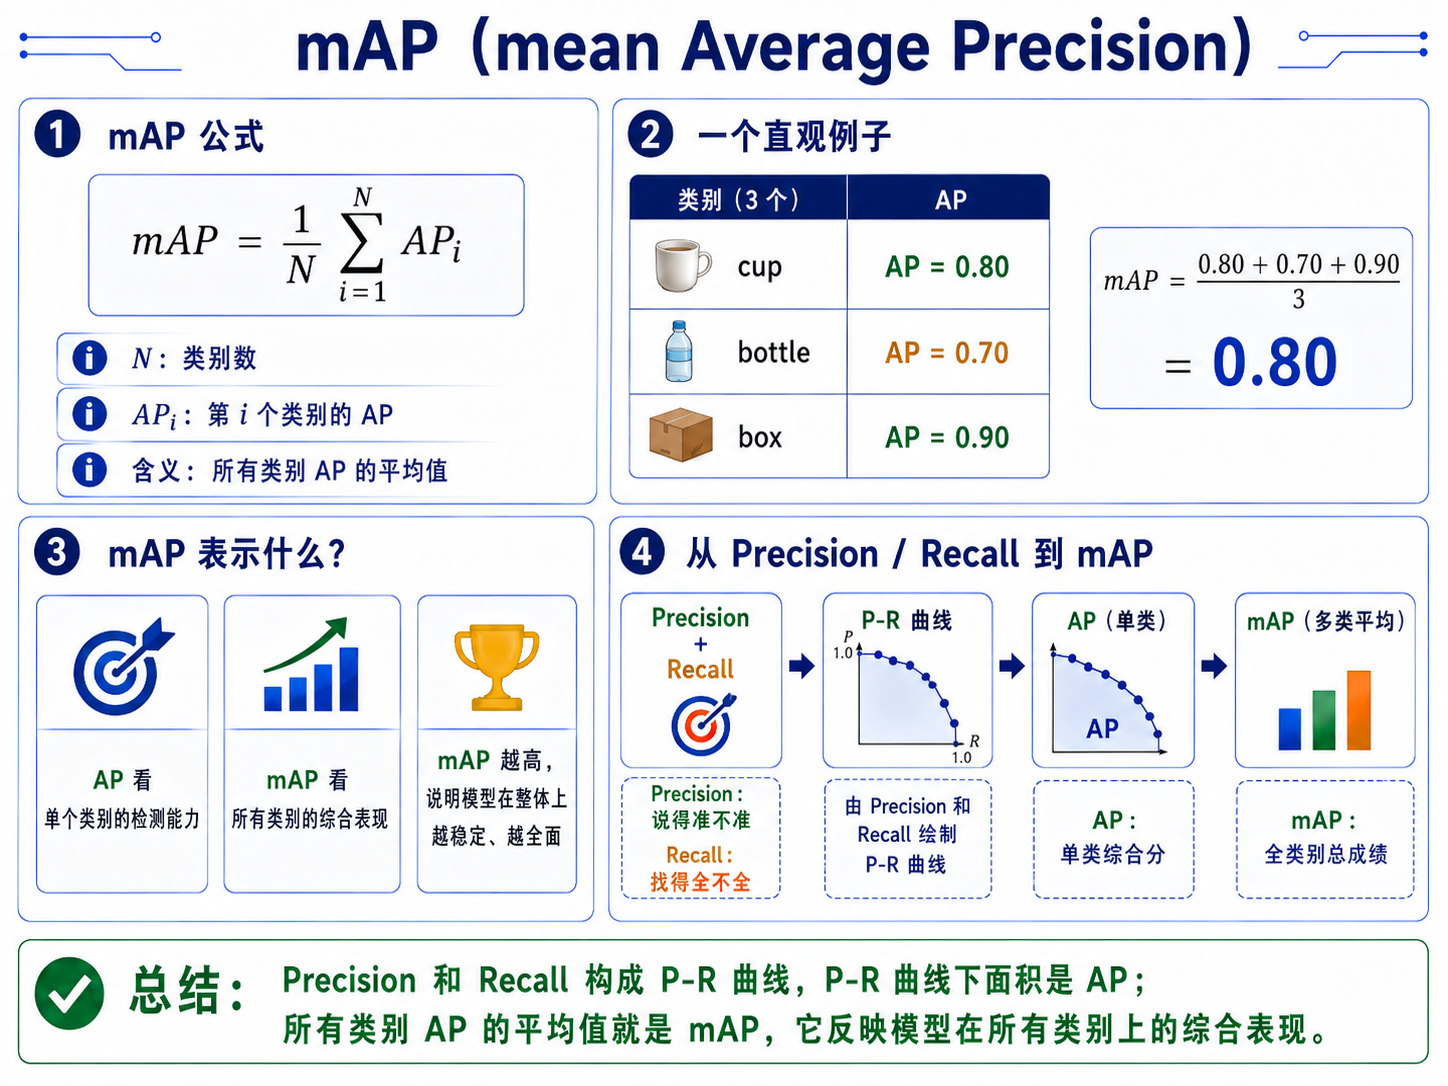
mAP(评价指标)
从检测结果到抓取方向
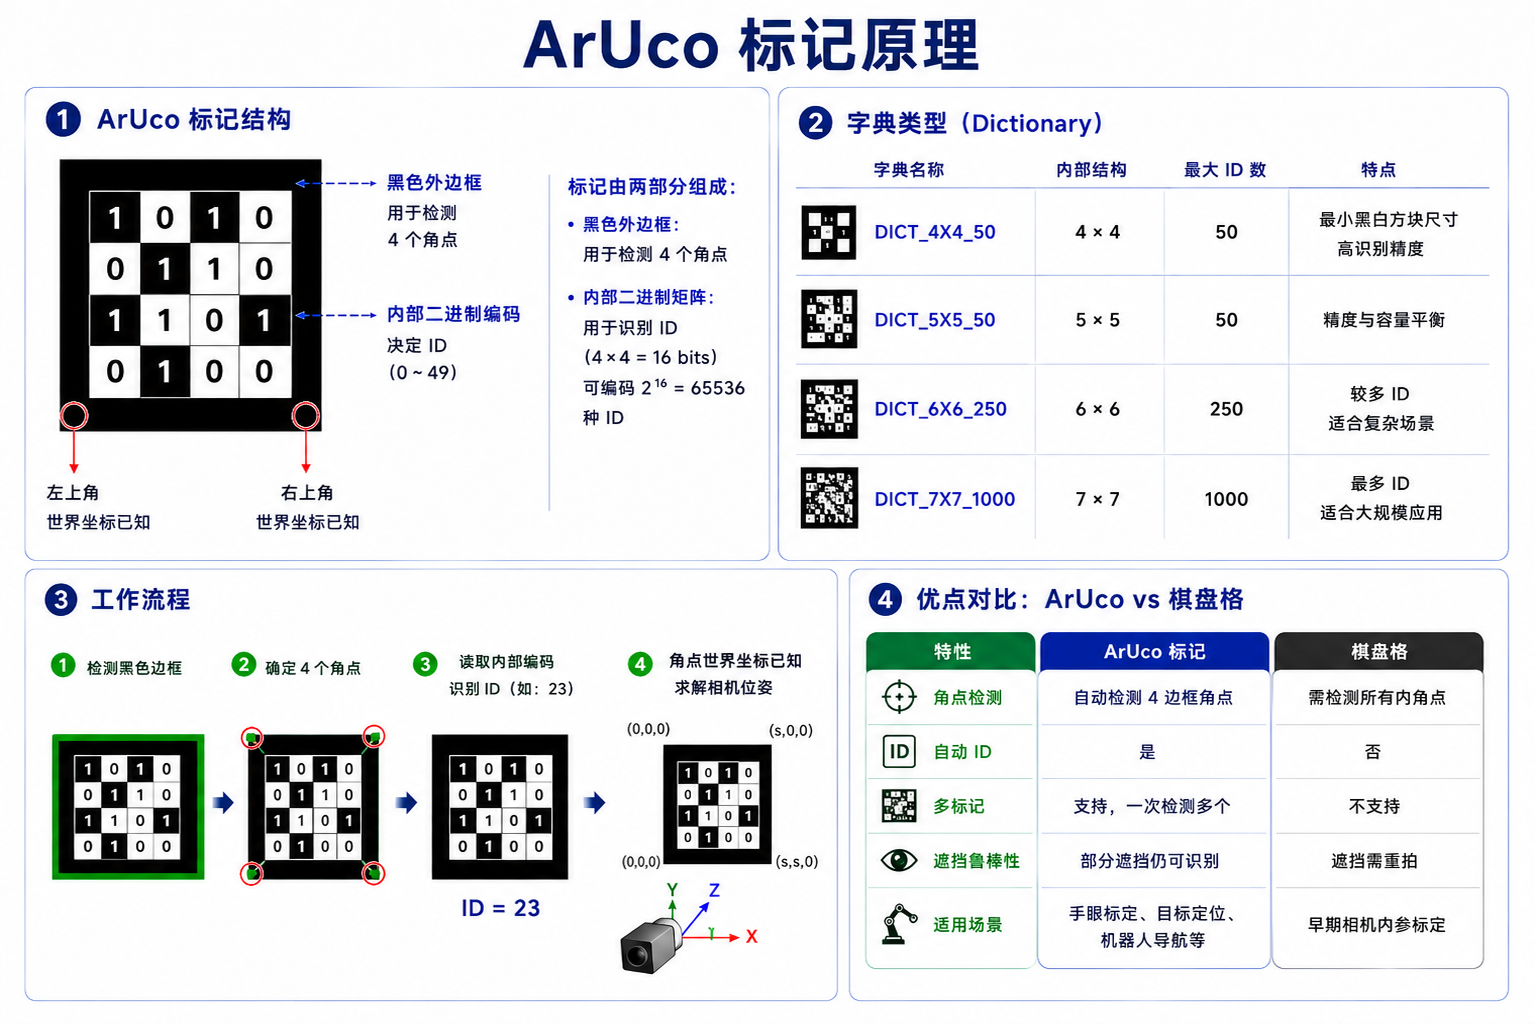
ArUco 与相机标定
像素→三维坐标的完整推导
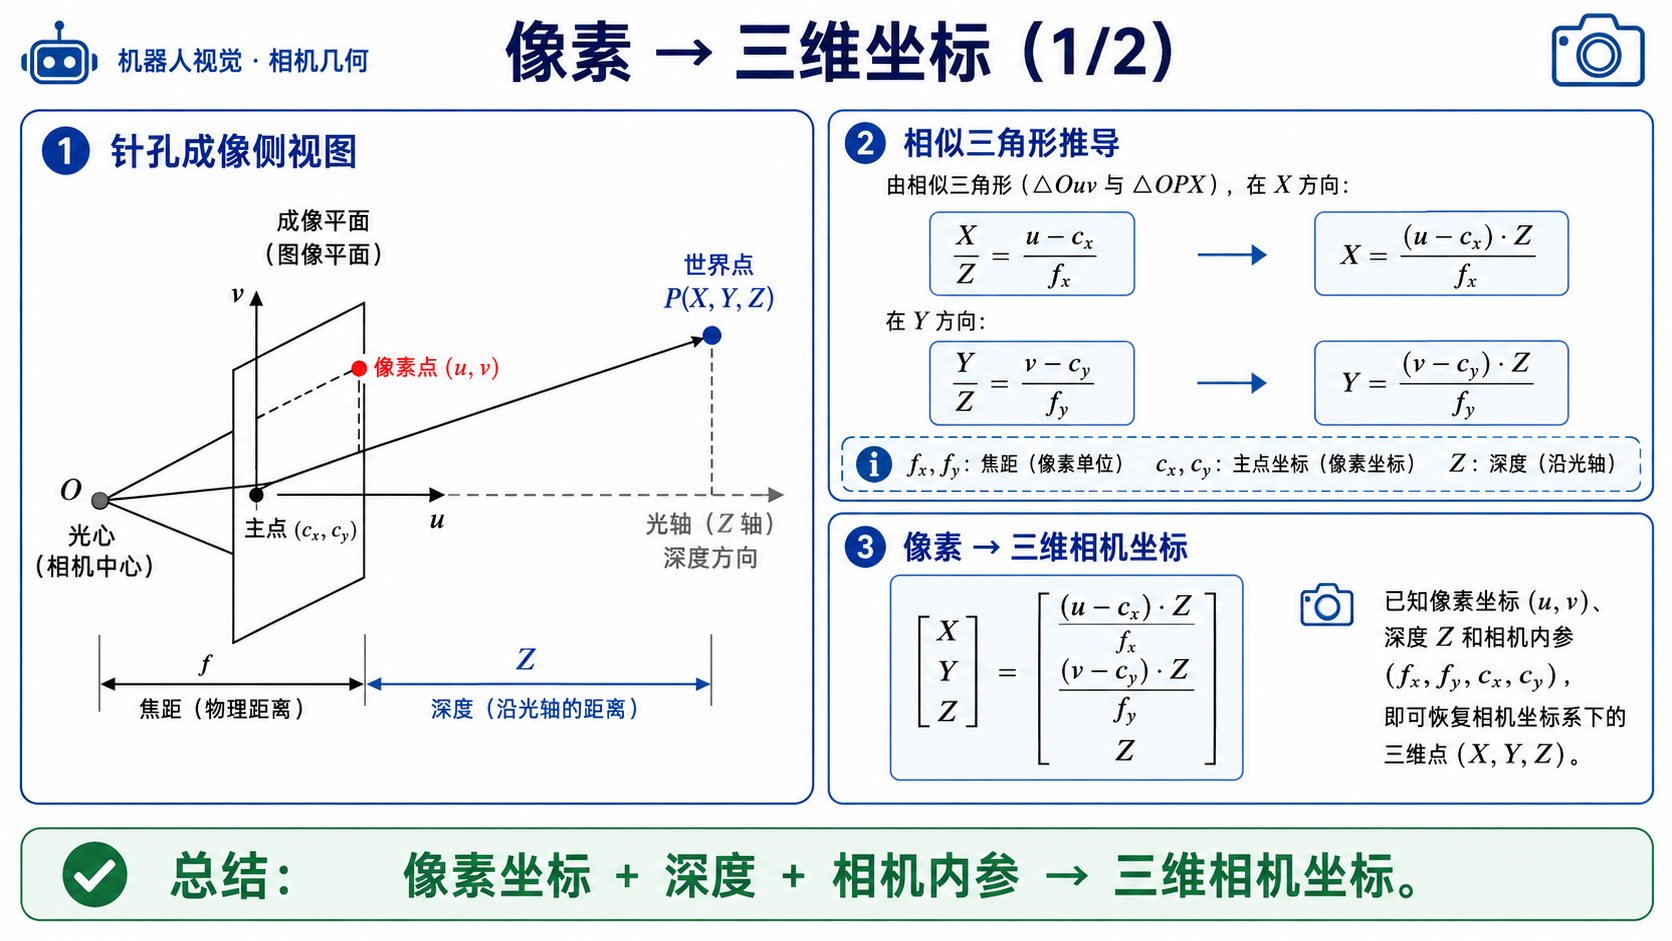
相似三角形推导
- 由相似三角形(图像平面 X 轴方向):
- 整理:、
误差传递分析
-
设深度误差为 ,由 X 公式:
- 即:图像中偏离光心 (cx, cy) 越远的点,深度误差被放大得越多。
- 物理意义:位于图像边缘的物体,由于视差角度大,深度 Z 的微小误差会显著影响 X、Y 的位置估计。
-
数值算例
-
设 fx = 600, fy = 600, cx = 320, cy = 240, Z = 0.65 m 像素点 (u, v) = (520, 240)
X = (520 - 320) × 0.65 / 600 = 200 × 0.65 / 600 = 0.217 m
Y = (240 - 240) × 0.65 / 600 = 0 m
Z = 0.65 m
-
-
物体在相机坐标系下的位置:(0.217, 0, 0.65) m
-
实现参考:
# ordinary_grasp.py L398-403 实现参考def _backproject(u, v, z_m, K):
    fx, fy = float(K[0, 0]), float(K[1, 1])
    cx, cy = float(K[0, 2]), float(K[1, 2])
    x = (u - cx) * z_m / fx
    y = (v - cy) * z_m / fy
    return np.array([x, y, z_m], dtype=np.float32)
ArUco 标记原理
ArUco 位姿估计(solvePnP)
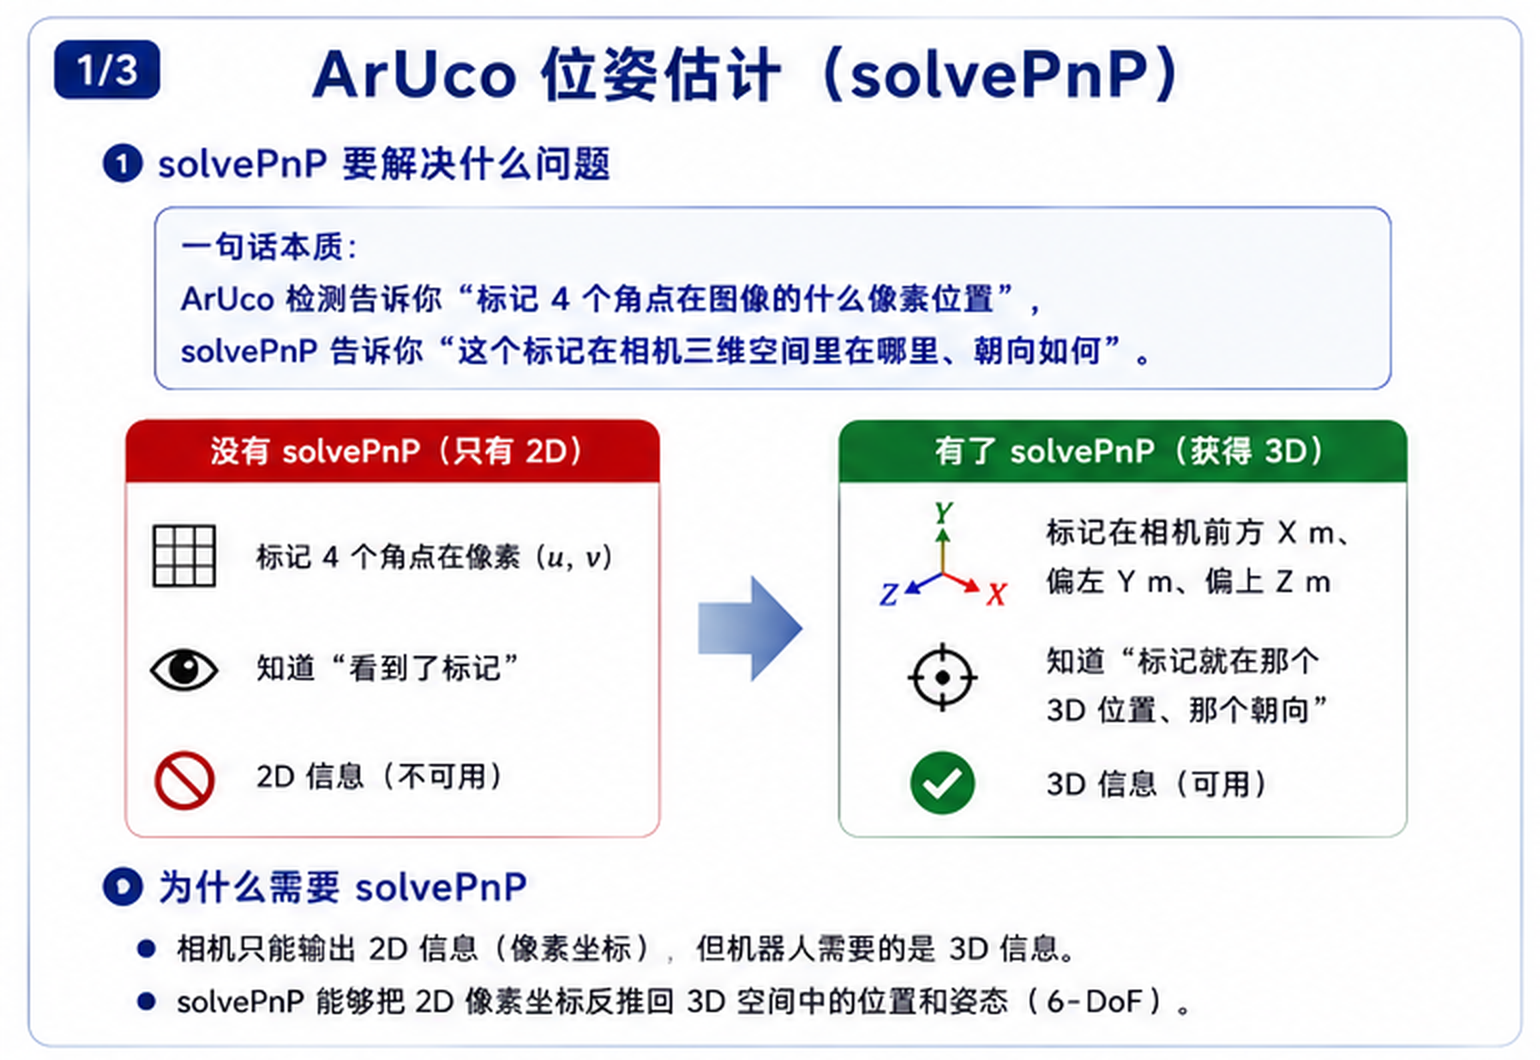
solvePnP 要解决什么问题
- 一句话本质:ArUco 检测告诉你"标记 4 个角点在图像的什么像素位置",solvePnP 告诉你"这个标记在相机三维空间里在哪里、朝向如何"。
为什么需要 solvePnP
-
相机只能输出 2D 信息(像素坐标),但机器人需要的是 3D 信息:
- 回到后面的手眼标定。手眼标定要解的方程是 AX = XB,其中 B 就是“标记到相机”的变换 T_marker2cam——这个 B 正是靠 ArUco 检测角点、再用 solvePnP 求出来的。没有 solvePnP 就没有 B,没有 B 就解不出 X,手眼标定根本做不下去。
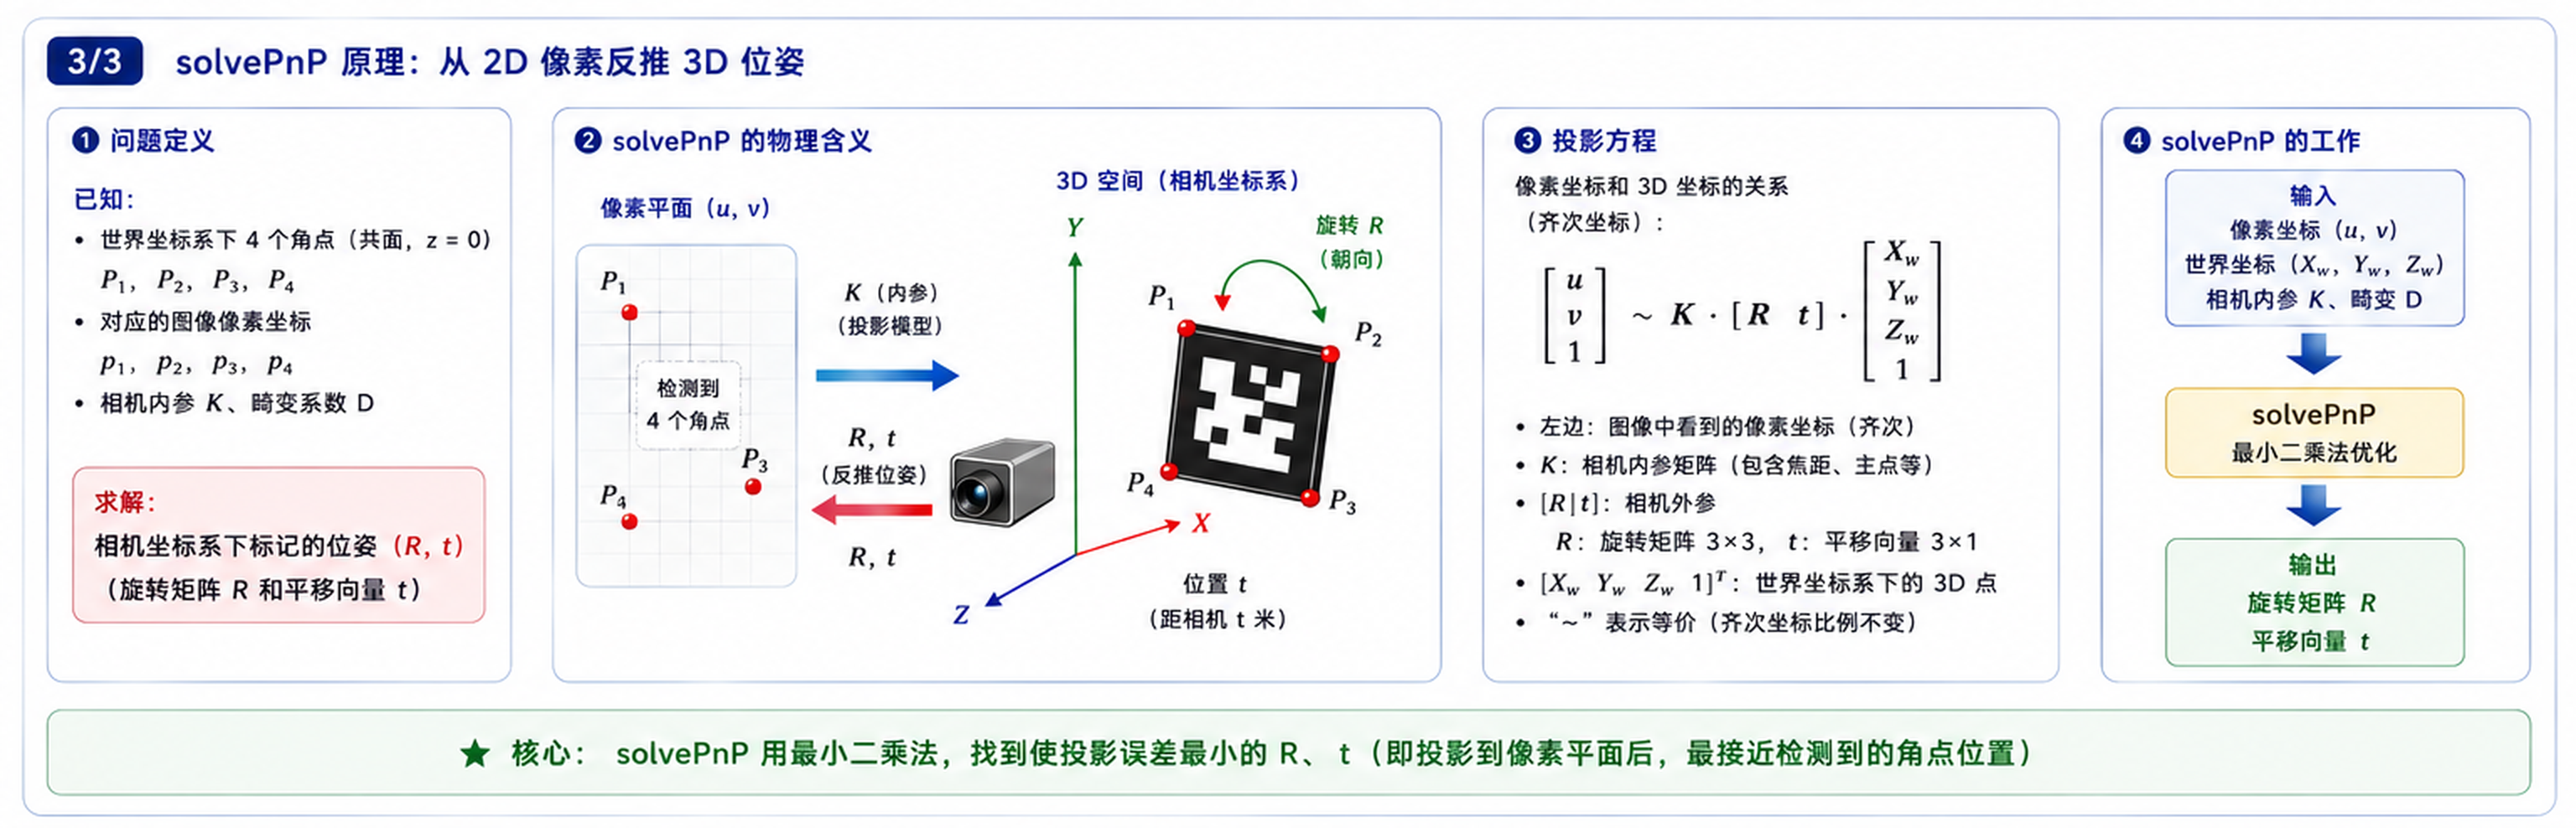
solvePnP 的物理含义:
- 已知 3D 世界坐标(固定在真实世界里的三维坐标系,用 3 个数 (X, Y, Z) 描述 "标记的角点在真实空间里位于哪里",单位是真实长度(cm/m))、对应的 2D 像素坐标(图片上的二维坐标系,用 2 个数 (u, v) 描述 "同一个角点被拍到了图像的哪个位置(第几列、第几行)")和相机内参 K,反推出相机的旋转 R 和平移 t。它内部用最小二乘优化,把投影误差最小作为目标,输出就是标记相对相机的位姿。
手眼标定深入
AX = XB 的几何意义
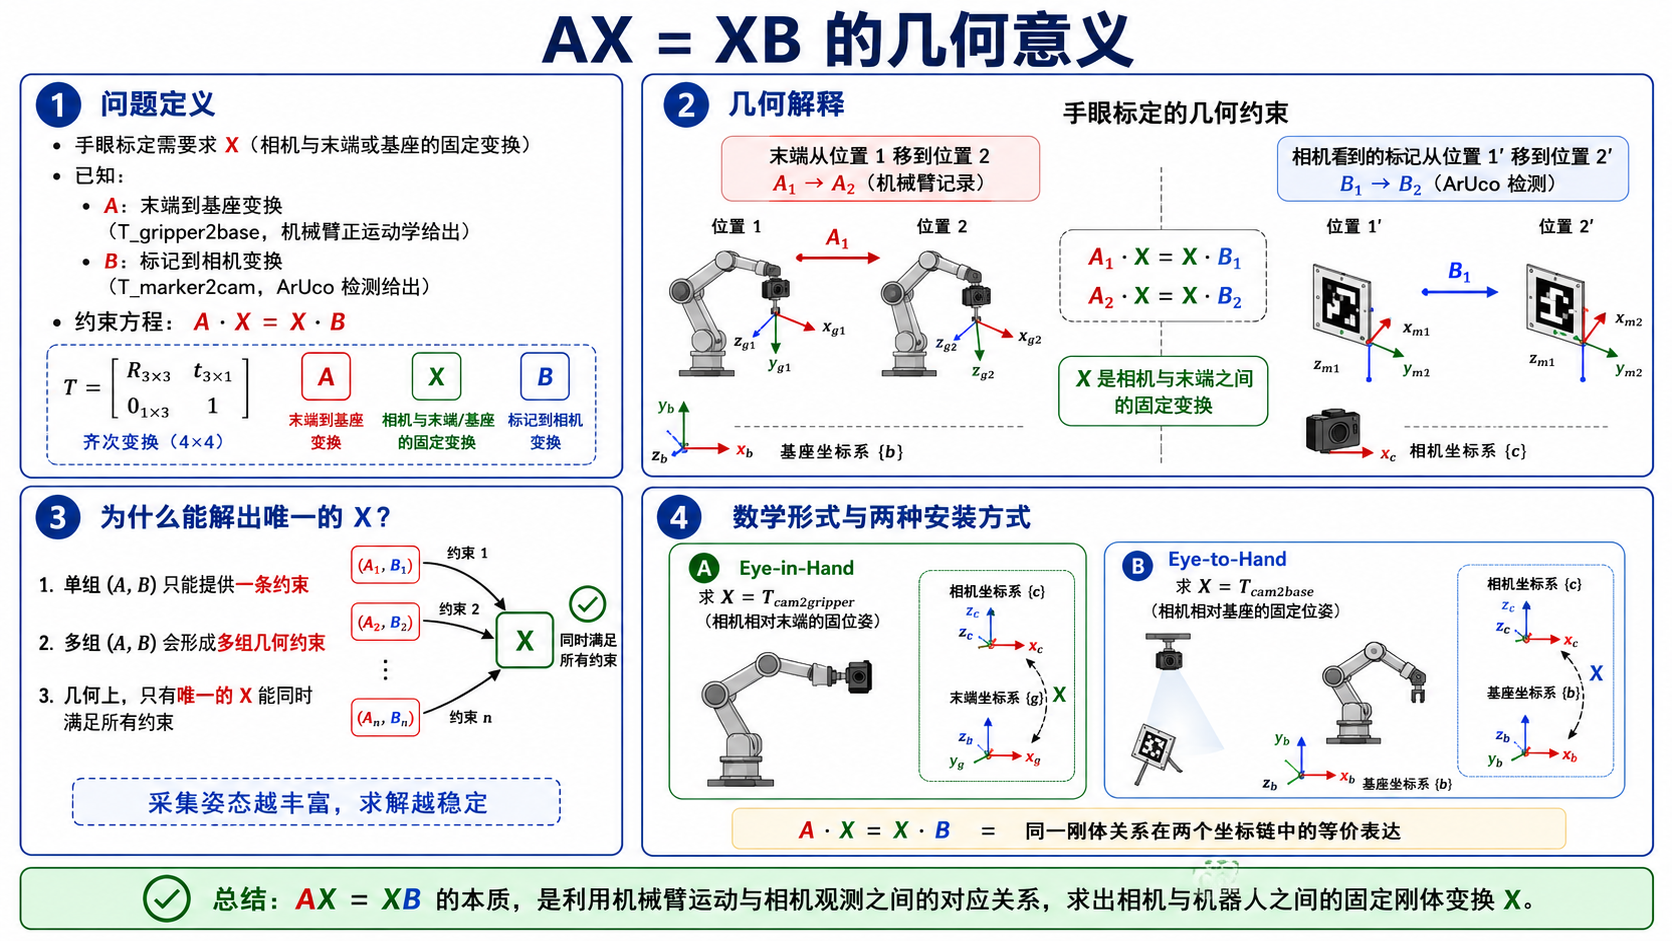
问题定义
-
手眼标定需要求 X(相机与末端或基座的固定变换),已知:
- A:末端到基座变换(T_gripper2base,机械臂正运动学给出)
- B:标记到相机变换(T_marker2cam,ArUco 检测给出)
-
约束方程:
-
X 是手眼矩阵—— 一个 4×4 的齐次变换矩阵,描述 "相机坐标系" 相对 "机械臂末端坐标系" 的固定位姿(朝向 + 位置)。
- 它内部藏着一个 3×3 旋转矩阵 R_X(管朝向)和一个 3×1 平移向量 t_X(管位置);
- 而欧拉角只是 R_X 的另一种 "读数"—— 同一个朝向,可以用旋转矩阵表示,也可以用欧拉角表示,两者可以互相换算。
几何解释
[图示:手眼标定的几何约束]

末端从位置 1 移到位置 2:
  A1 → A2 (机械臂记录)

相机看到的标记从位置 1' 移到位置 2':
  B1 → B2 (ArUco 检测)

X 是相机与末端的固定变换(相机装在末端上):
  A1 · X = X · B1
  A2 · X = X · B2
多个 (A, B) 给出多组约束,几何上只有唯一的 X 能满足所有约束。
数学形式
- Eye-in-Hand:求 X = T_cam2gripper(相机相对末端的固定位姿)
- Eye-to-Hand:求 X = T_cam2base(相机相对基座的固定位姿)
- 工程实现上,就是把每次采样到的 (A, B) 存进样本列表,攒够一组后交给标定求解器统一求解。
刚体变换数学基础
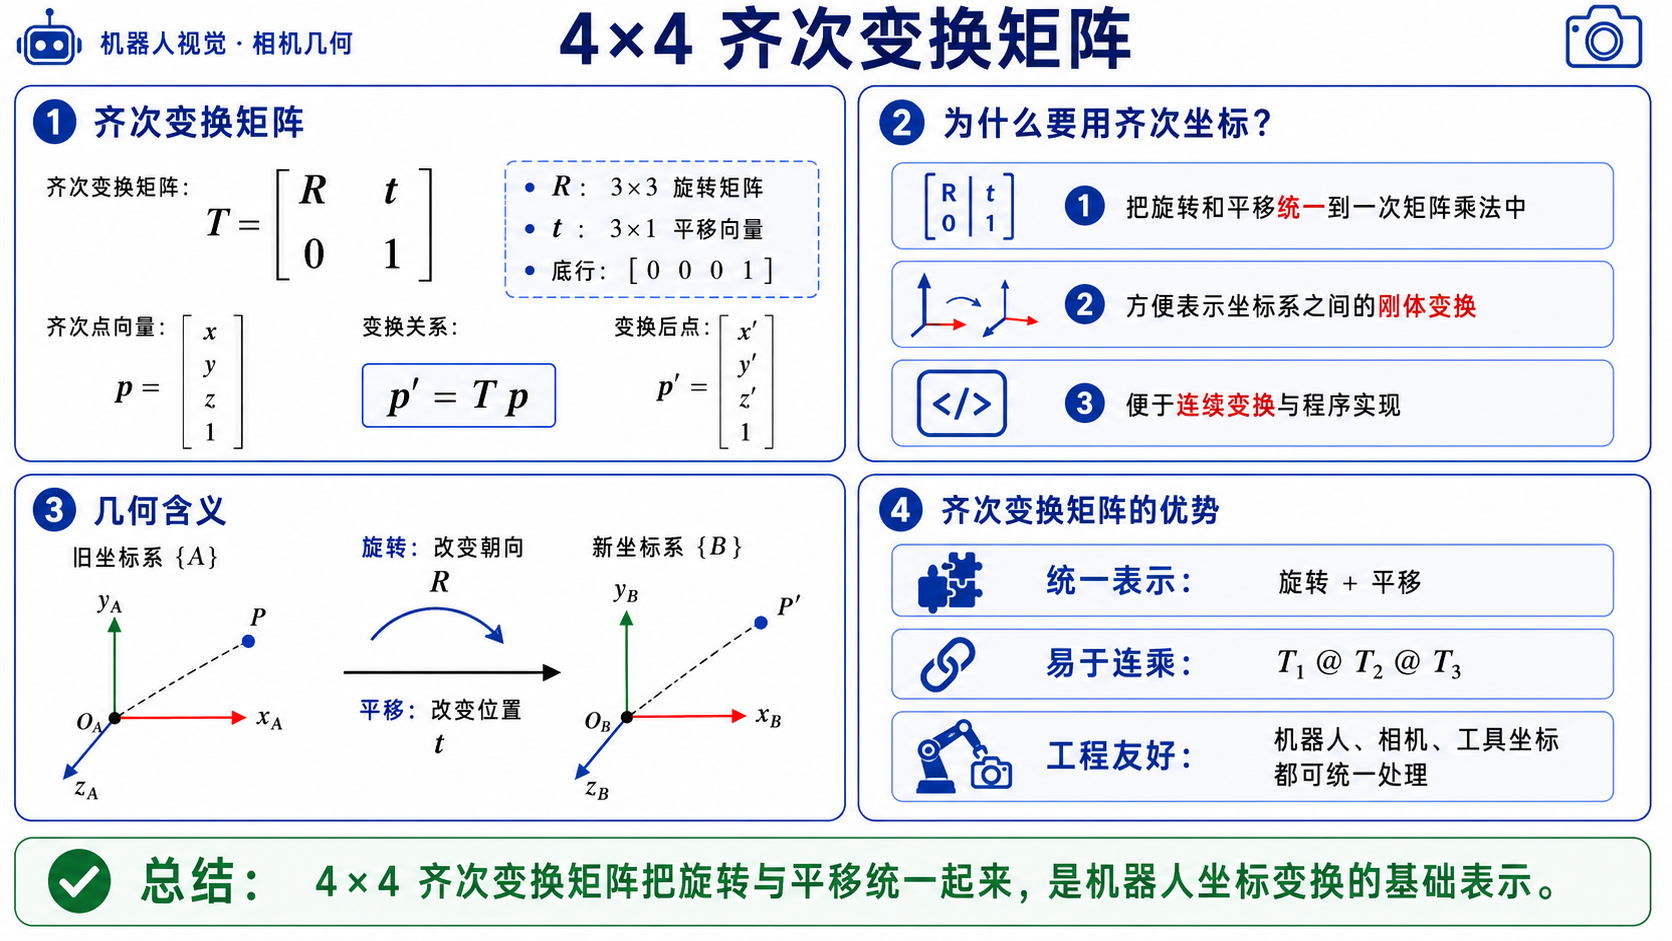
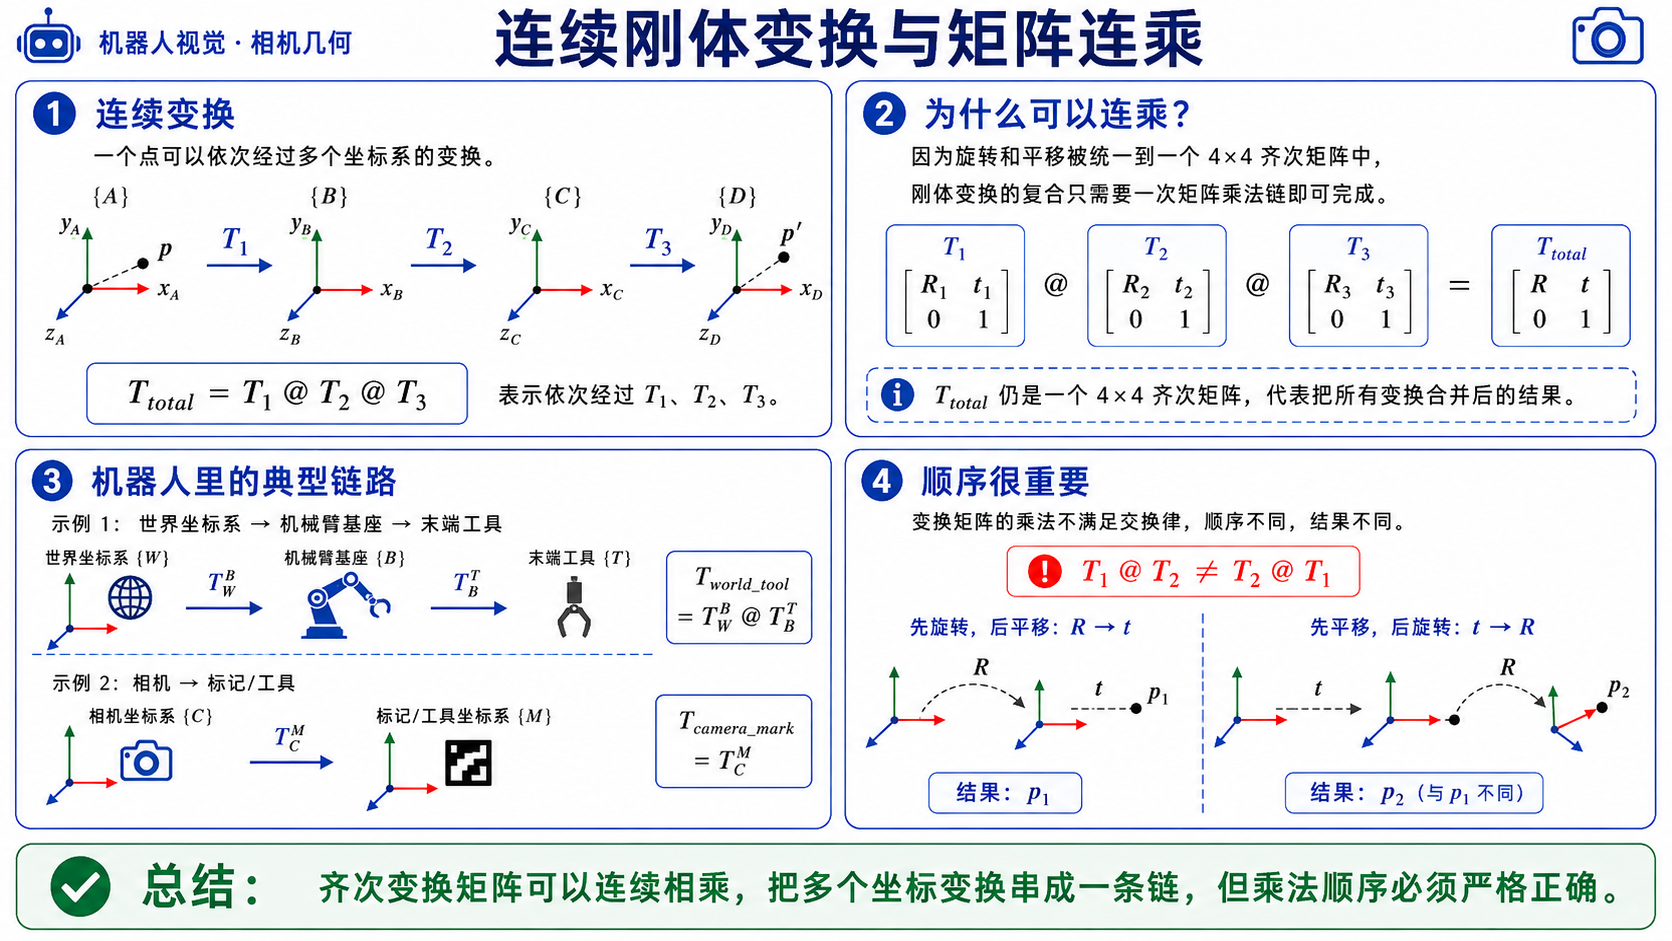
4×4 齐次变换矩阵
T = [ R   t ]    R: 3×3 旋转矩阵
    [ 0   1 ]    t: 3×1 平移向量
齐次变换矩阵的优势:
- 把旋转和平移统一在一个矩阵乘法中
- 可连续变换:T1 @ T2 @ T3 表示依次经过 T1、T2、T3三次变化,但这里必须强调:矩阵乘法不满足交换律,顺序不同结果完全不同——“先转 90 度再平移”和“先平移再转 90 度”不是一回事。
三种旋转表示
-
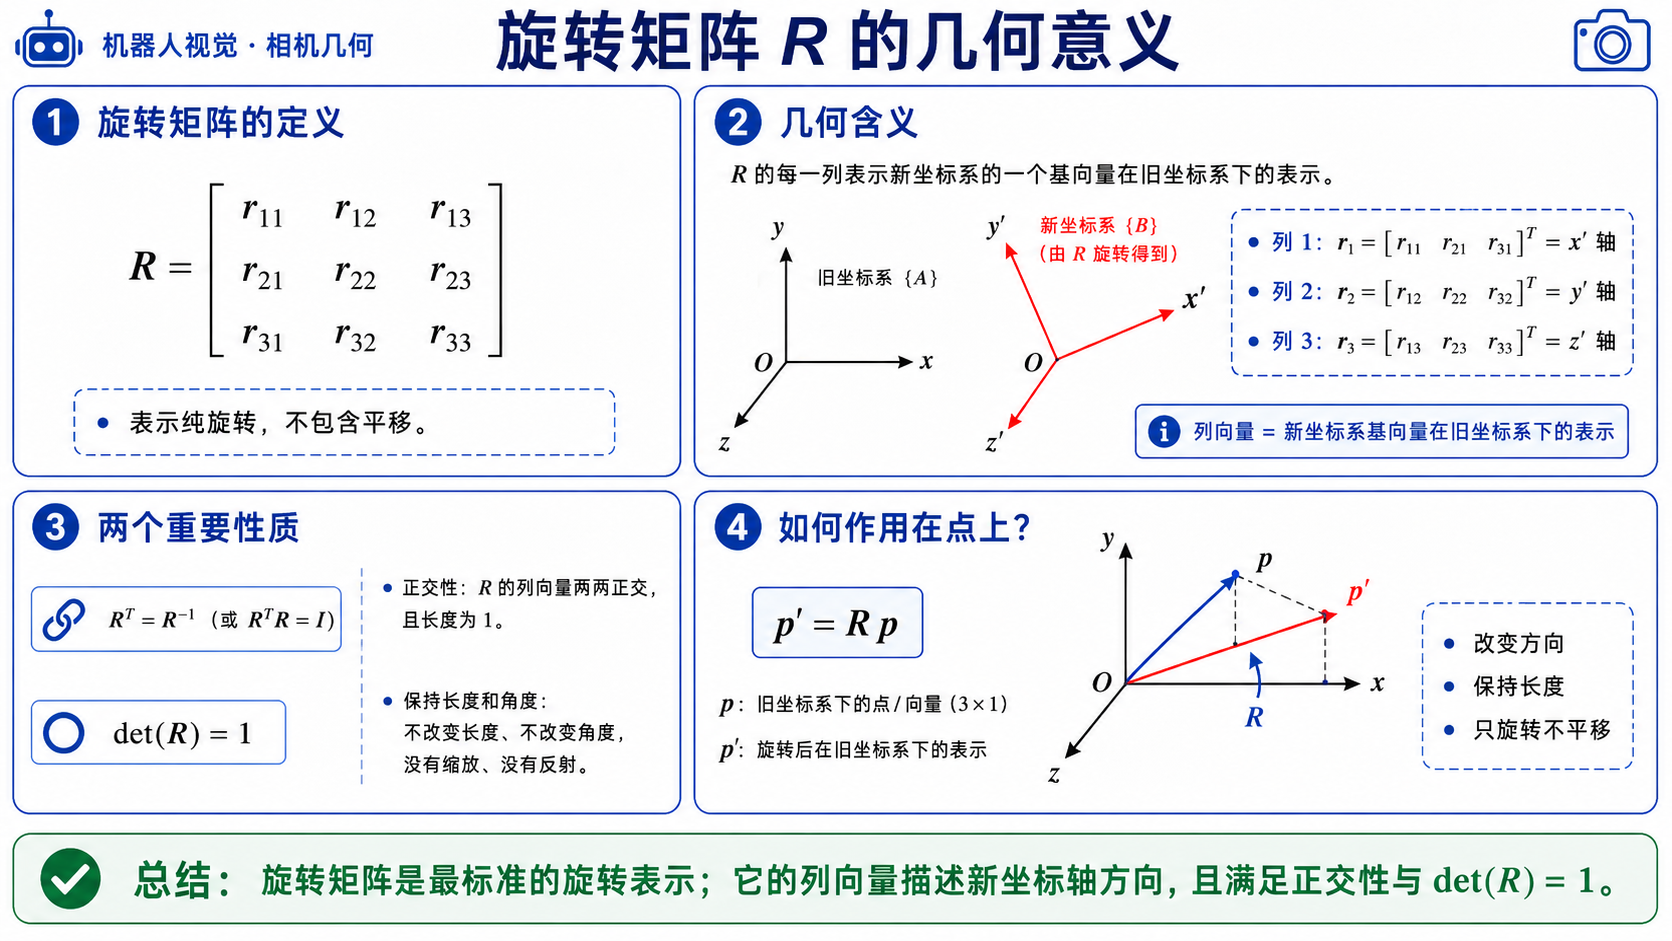
旋转矩阵 R
-
性质:
- R^T = R^(-1)(正交性)
- det(R) = 1
[图示:旋转矩阵的几何含义]

R = [ r11 r12 r13 ]    每列是某个基向量在
    [ r21 r22 r23 ]    新坐标系下的表示
    [ r31 r32 r33 ]
-
-
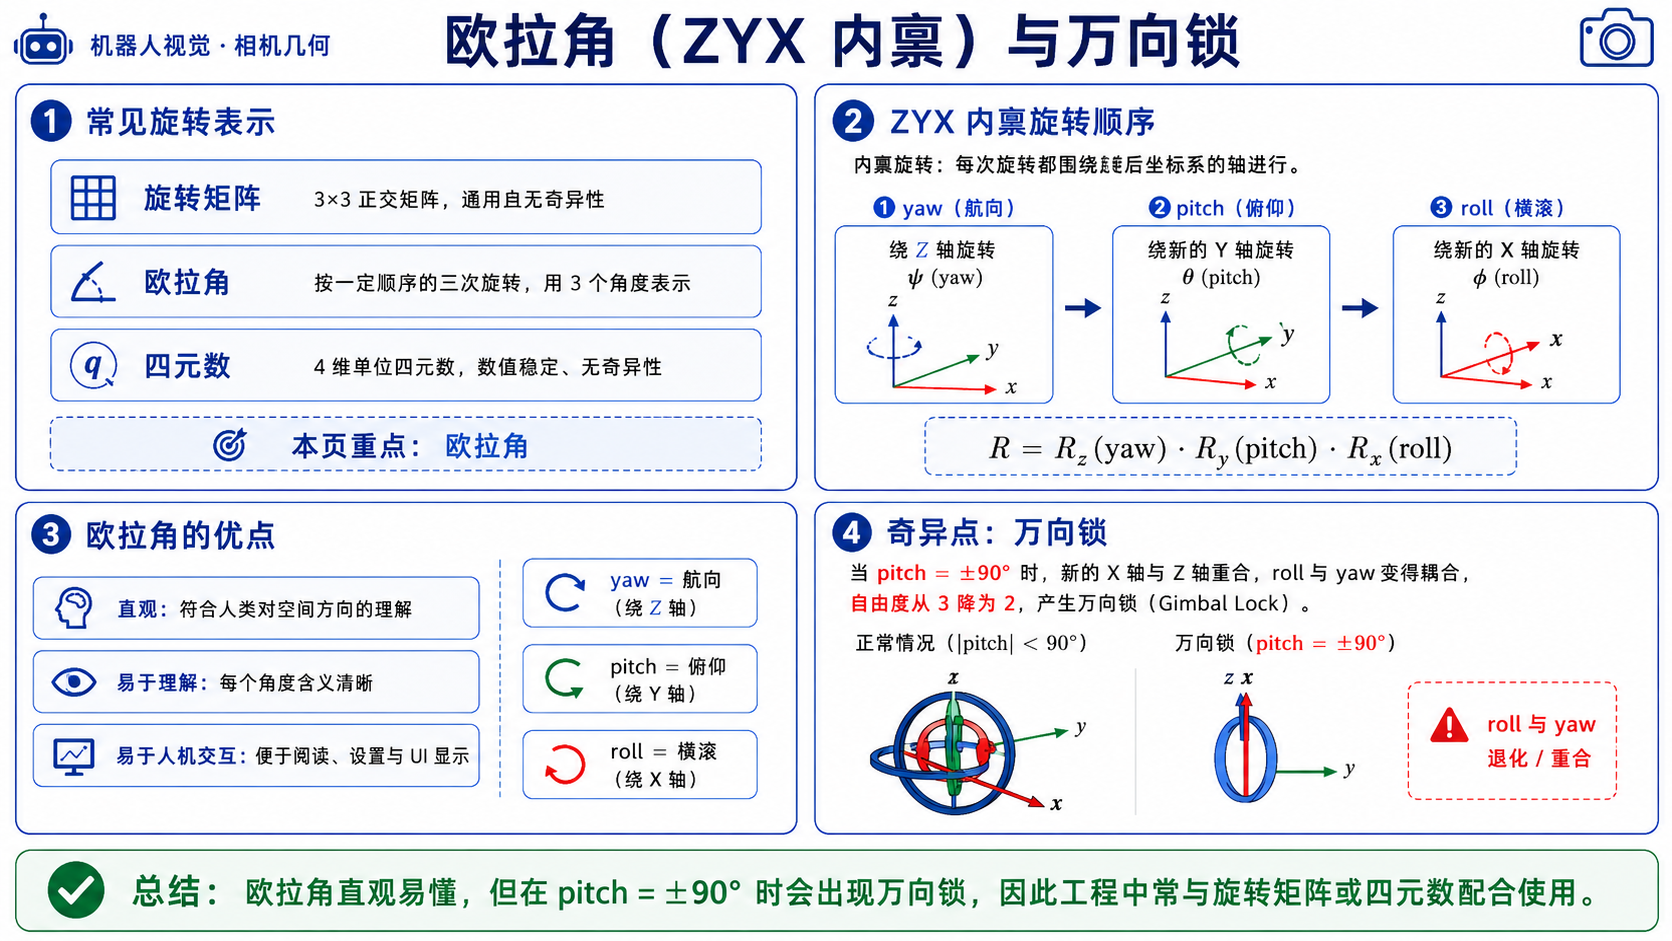
欧拉角(ZYX 内禀)
-
实现参考:绕 Z 轴转 yaw → 绕新 Y 轴转 pitch → 绕新 X 轴转 roll:
# transforms.py L32-72 实现参考def pose6d_to_mat4(x, y, z, rx, ry, rz, degrees=False):
    if degrees:
        rx, ry, rz = np.radians(rx), np.radians(ry), np.radians(rz)

# Rotation around X (roll)
    Rx = np.array([
        [1,          0,           0],
        [0,  np.cos(rx), -np.sin(rx)],
        [0,  np.sin(rx),  np.cos(rx)],
    ])
# Rotation around Y (pitch)
    Ry = np.array([
        [ np.cos(ry), 0, np.sin(ry)],
        [          0, 1,          0],
        [-np.sin(ry), 0, np.cos(ry)],
    ])
# Rotation around Z (yaw)
    Rz = np.array([
        [np.cos(rz), -np.sin(rz), 0],
        [np.sin(rz),  np.cos(rz), 0],
        [         0,           0, 1],
    ])

# Intrinsic ZYX rotation: R = Rz @ Ry @ Rx
    R = Rz @ Ry @ Rx

    T = np.eye(4, dtype=np.float64)
    T[:3, :3] = R
    T[:3, 3] = [x, y, z]
    return T
-
-
奇异点(万向锁):
-
但欧拉角有个著名的坑叫“万向锁”:当 pitch 等于正负 90 度时,X 轴与 Z 轴重合,roll 和 yaw 退化,自由度从 3 掉到 2,姿态表示不再唯一。所以代码里在奇异点附近要用备选公式处理,这也是为什么工程中欧拉角常与旋转矩阵或四元数配合使用。
# transforms.py L110-122 实现参考(处理奇异点)def rotation_matrix_to_euler_zyx(R):
    R = _nearest_rotation_matrix(R)
    sy = np.sqrt(R[0, 0] ** 2 + R[1, 0] ** 2)
    if sy > 1e-6:
        rx = np.arctan2(R[2, 1], R[2, 2])
        ry = np.arctan2(-R[2, 0], sy)
        rz = np.arctan2(R[1, 0], R[0, 0])
    else:
# 奇异点附近,使用备选公式
        rx = np.arctan2(-R[1, 2], R[1, 1])
        ry = np.arctan2(-R[2, 0], sy)
        rz = 0.0return np.array([rx, ry, rz], dtype=np.float64)
-
Eye-in-Hand 与 Eye-to-Hand 的差异
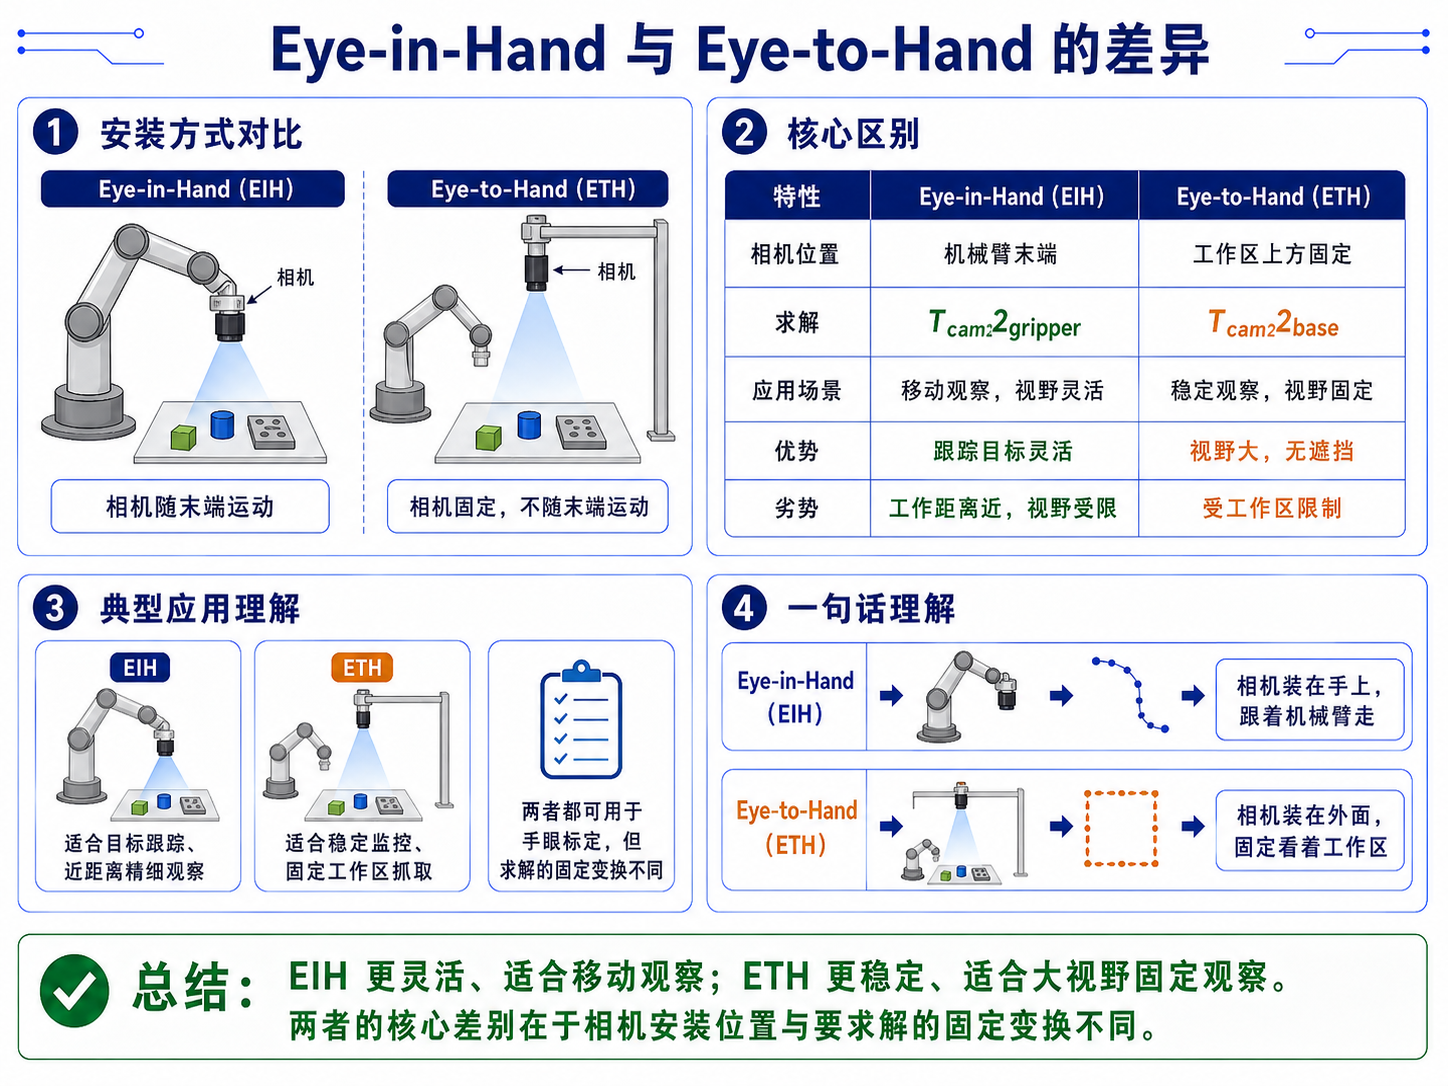
[图示:EIH 和 ETH 安装方式对比]

Eye-in-Hand:
  机械臂末端 ─ 相机 ─ 看向工作区
  相机随末端运动

Eye-to-Hand:
  工作区上方 ─ 相机 ─ 向下看
  相机固定,不随末端运动
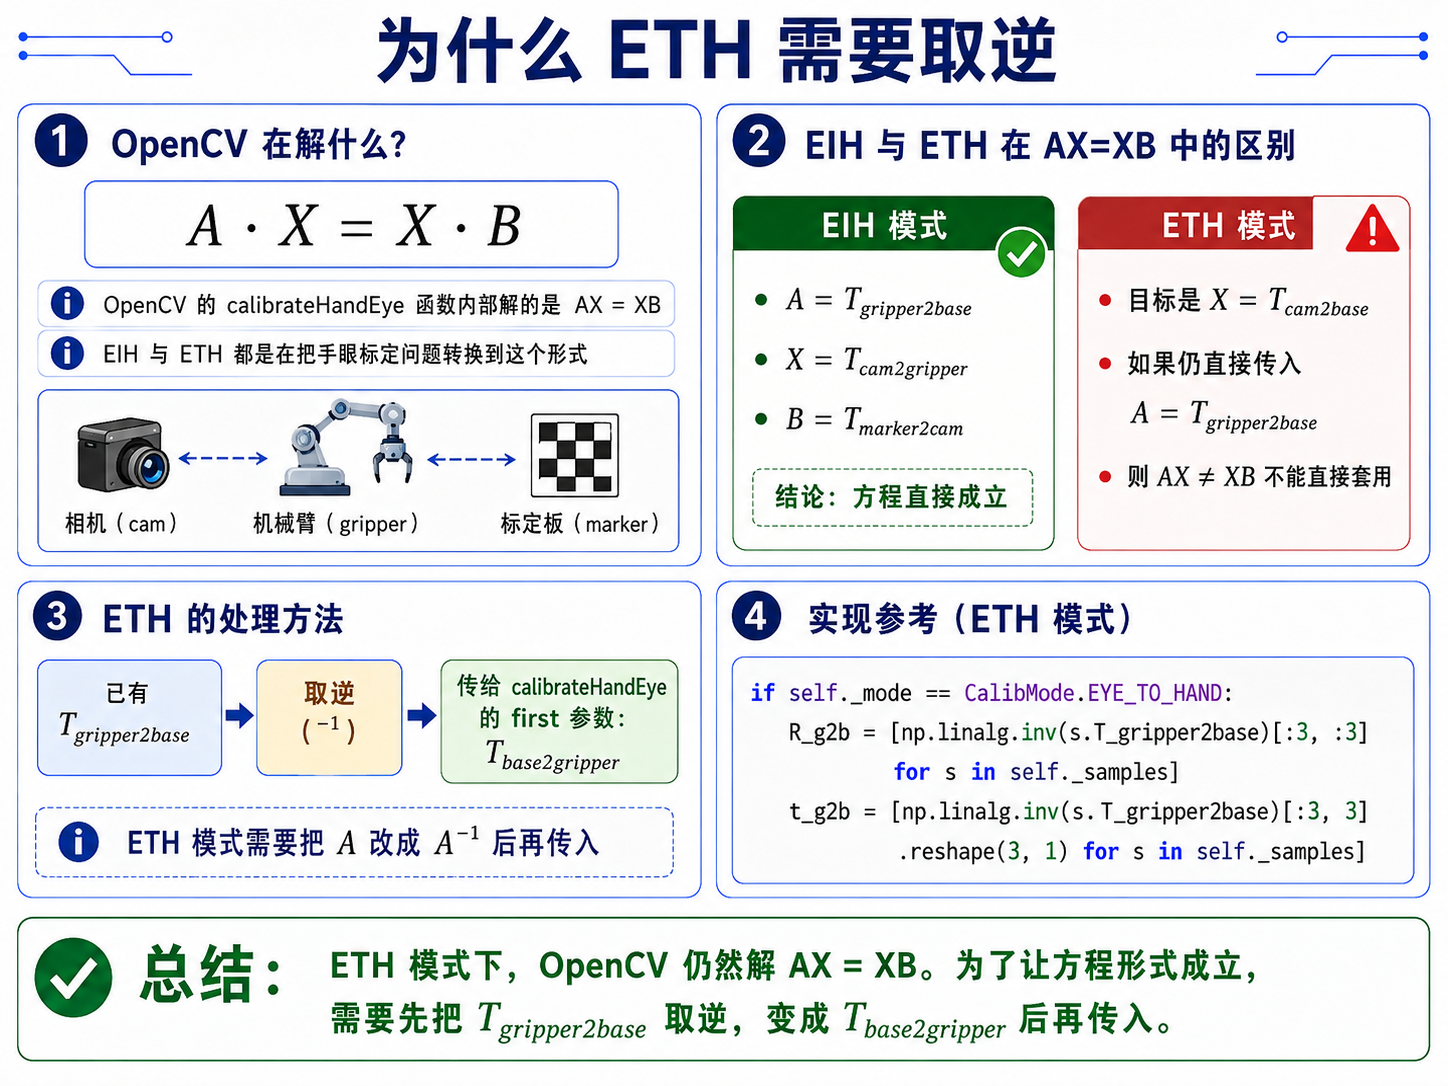
ETH 的特殊处理(取逆)
实现参考:
# hand_eye.py L110-114 实现参考(ETH 模式把 A 取逆)if self._mode == CalibMode.EYE_TO_HAND:
# OpenCV calibrateHandEye 内部解 AX=XB; ETH 模式下需要把# T_gripper2base 取逆后作为 first 参数传入,函数直接返回 T_cam2base。
    R_g2b = [np.linalg.inv(s.T_gripper2base)[:3, :3] for s in self._samples]
    t_g2b = [np.linalg.inv(s.T_gripper2base)[:3, 3].reshape(3, 1) for s in self._samples]
为什么 ETH 需要取逆:
- OpenCV 的
calibrateHandEye函数内部解的方程是 AX=XB。 - EIH 模式:A 是 T_gripper2base(末端运动),X 是 T_cam2gripper(相机-末端固定),B 是 T_marker2cam。方程直接成立。
- ETH 模式:A 仍然是 T_gripper2base(末端运动),但 X 是 T_cam2base(相机-基座固定)。此时 AX ≠ XB 直接成立,需要把 A 取逆再传入。
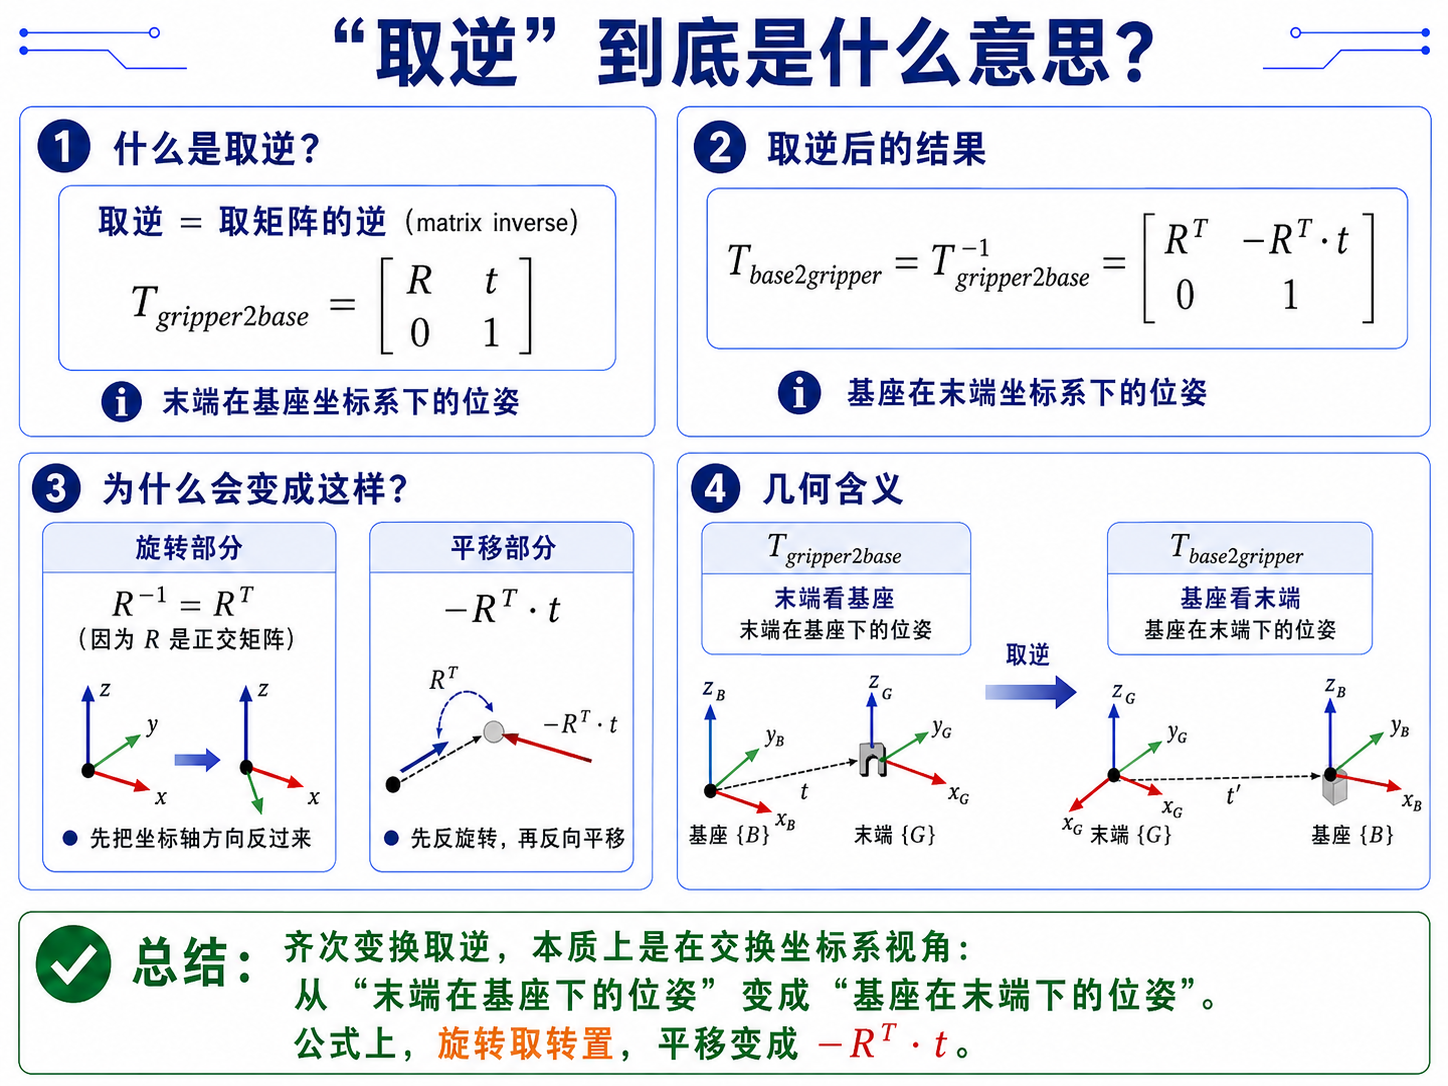
"取逆"指的是什么
-
"取逆" = 取矩阵的逆(matrix inverse)。 在 ETH 模式下,OpenCV 不接受
T_gripper2base(末端到基座),而是要求T_base2gripper(基座到末端),所以要把它取矩阵逆。# 手头有的(机械臂 FK 输出)
T_gripper2base = [R t] # 末端位姿(基座坐标系下)
[0 1]
# OpenCV ETH 模式要的(取逆后)
T_base2gripper = T_gripper2base^-1 = [R^T -R^T·t] # 末端坐标系下的基座
[0 1 ] -
旋转部分:R 的逆 = R 的转置(因为 R 是正交矩阵)
-
平移部分:-R^T · t(先反旋转,再反向平移)
-
几何含义:"末端在基座下的位姿"取逆后变成"基座在末端下的位姿"。
标定姿态设计原则
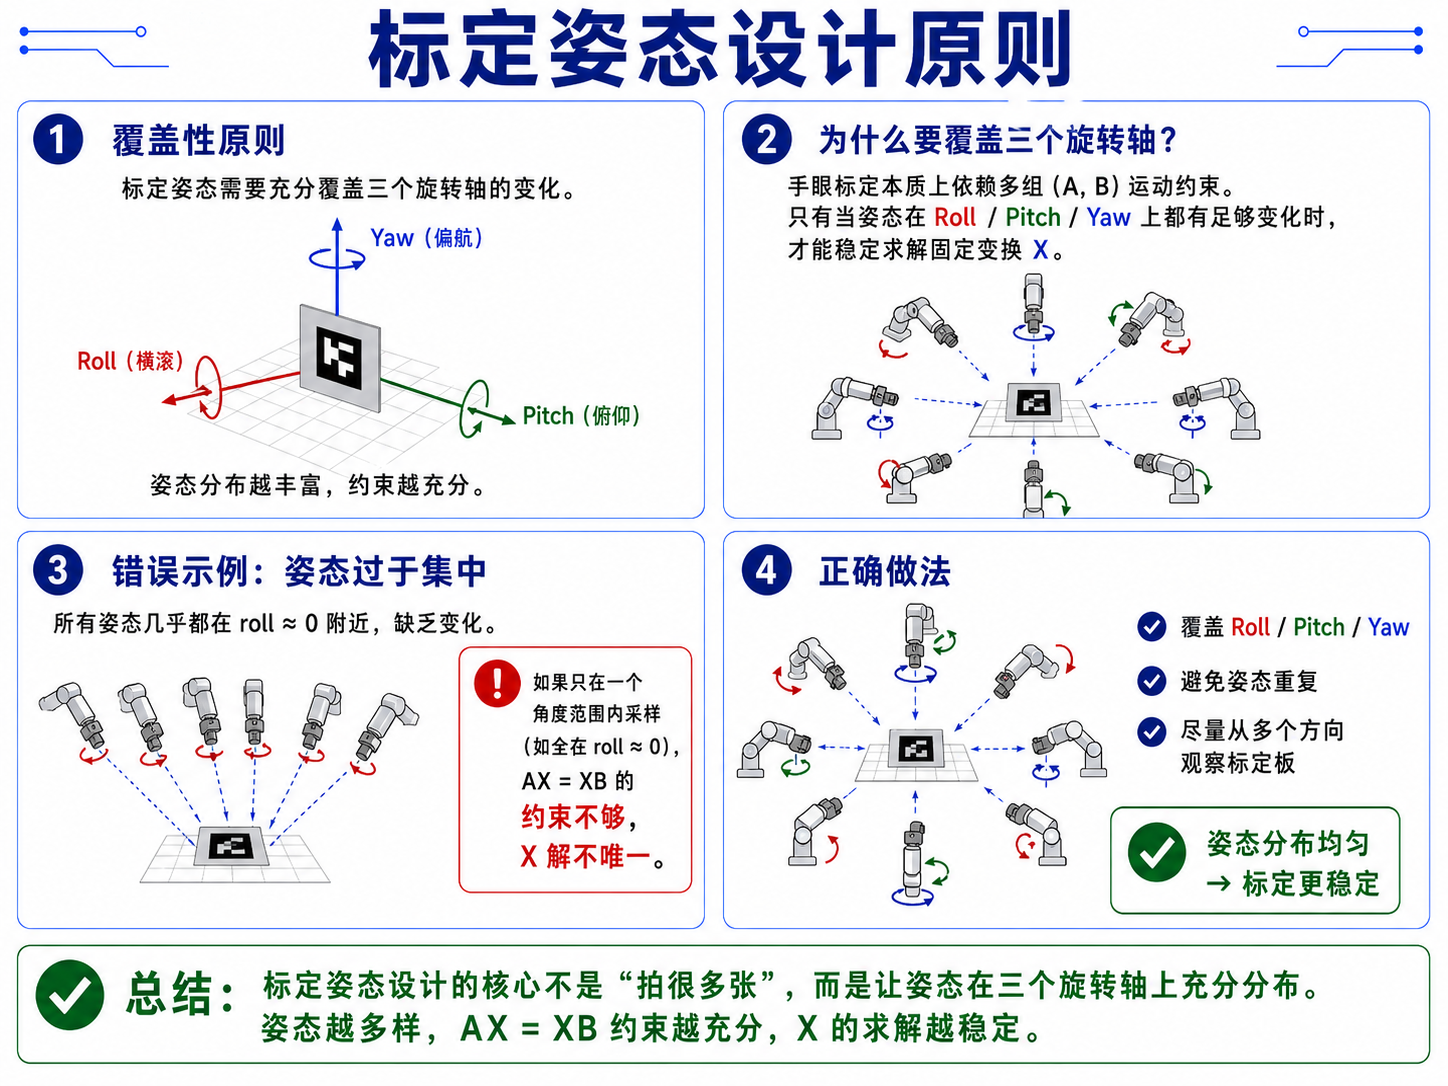
覆盖性原则
-
标定姿态需要充分覆盖三个旋转轴的变化:
[图示:标定姿态分布]

      Roll ↑
           │
   ┌───────┼───────┐
   │       │       │
   │  Yaw ─┼─→     │
   │       │       │
   └───────┼───────┘
           │
↓ Pitch -
如果只在一个角度范围内(如全在 roll ≈ 0 的姿态),AX=XB 的约束不够,X 解不唯一,因此在标定过程中机械臂的姿态变化需要涉及到Roll、Pitch、Yaw三个角度的变化
标定后坐标变换链
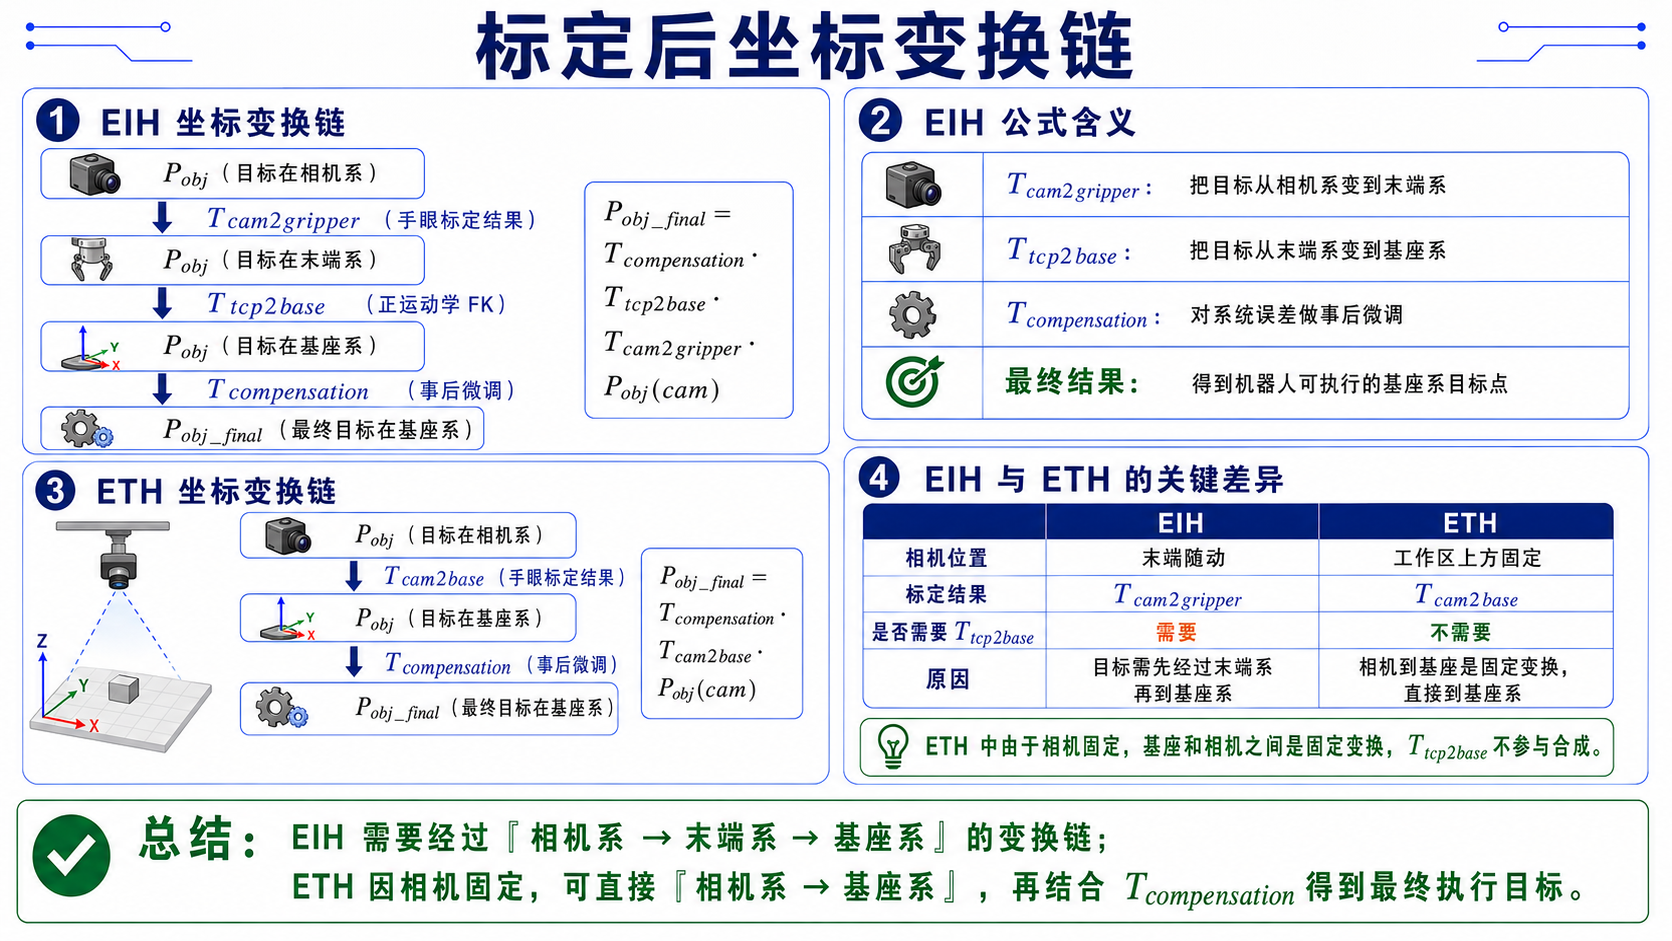
实现参考:
    """把相机观测位姿变换到机械臂基坐标系"""
    T_compensation = hand_eye_compensation_matrix(cfg)
    T_he = np.asarray(T_hand_eye, dtype=np.float64)

    if hand_eye_mode == "eye_in_hand":
# EIH: T_cam2base = T_comp × T_tcp2base × T_hand_eyereturn T_compensation @ np.asarray(T_tcp2base, dtype=np.float64) @ T_he
    if hand_eye_mode == "eye_to_hand":
# ETH: T_cam2base = T_comp × T_hand_eyereturn T_compensation @ T_he
EIH 公式含义
[图示:EIH 坐标变换链]

  P_obj (目标在相机系)
       │
       │ T_cam2gripper (手眼标定结果)
       ↓
  P_obj (目标在末端系)
       │
       │ T_tcp2base (正运动学 FK)
       ↓
  P_obj (目标在基座系)
       │
       │ T_compensation (事后微调)
       ↓
  P_obj_final (最终目标在基座系)
-
实现参考:
    """从配置读取补偿矩阵"""
    calibration = cfg.get("calibration") or {}
    compensation = calibration.get("hand_eye_compensation_m") or {}
    T = np.eye(4, dtype=np.float64)
    T[:3, 3] = [
        float(compensation.get("x", 0.0)),
        float(compensation.get("y", 0.0)),
        float(compensation.get("z", 0.0)),
    ]
    return T
ETH 公式
- 由于相机固定,基座和相机之间是固定变换,T_tcp2base 不参与合成。
标定误差与重投影分析
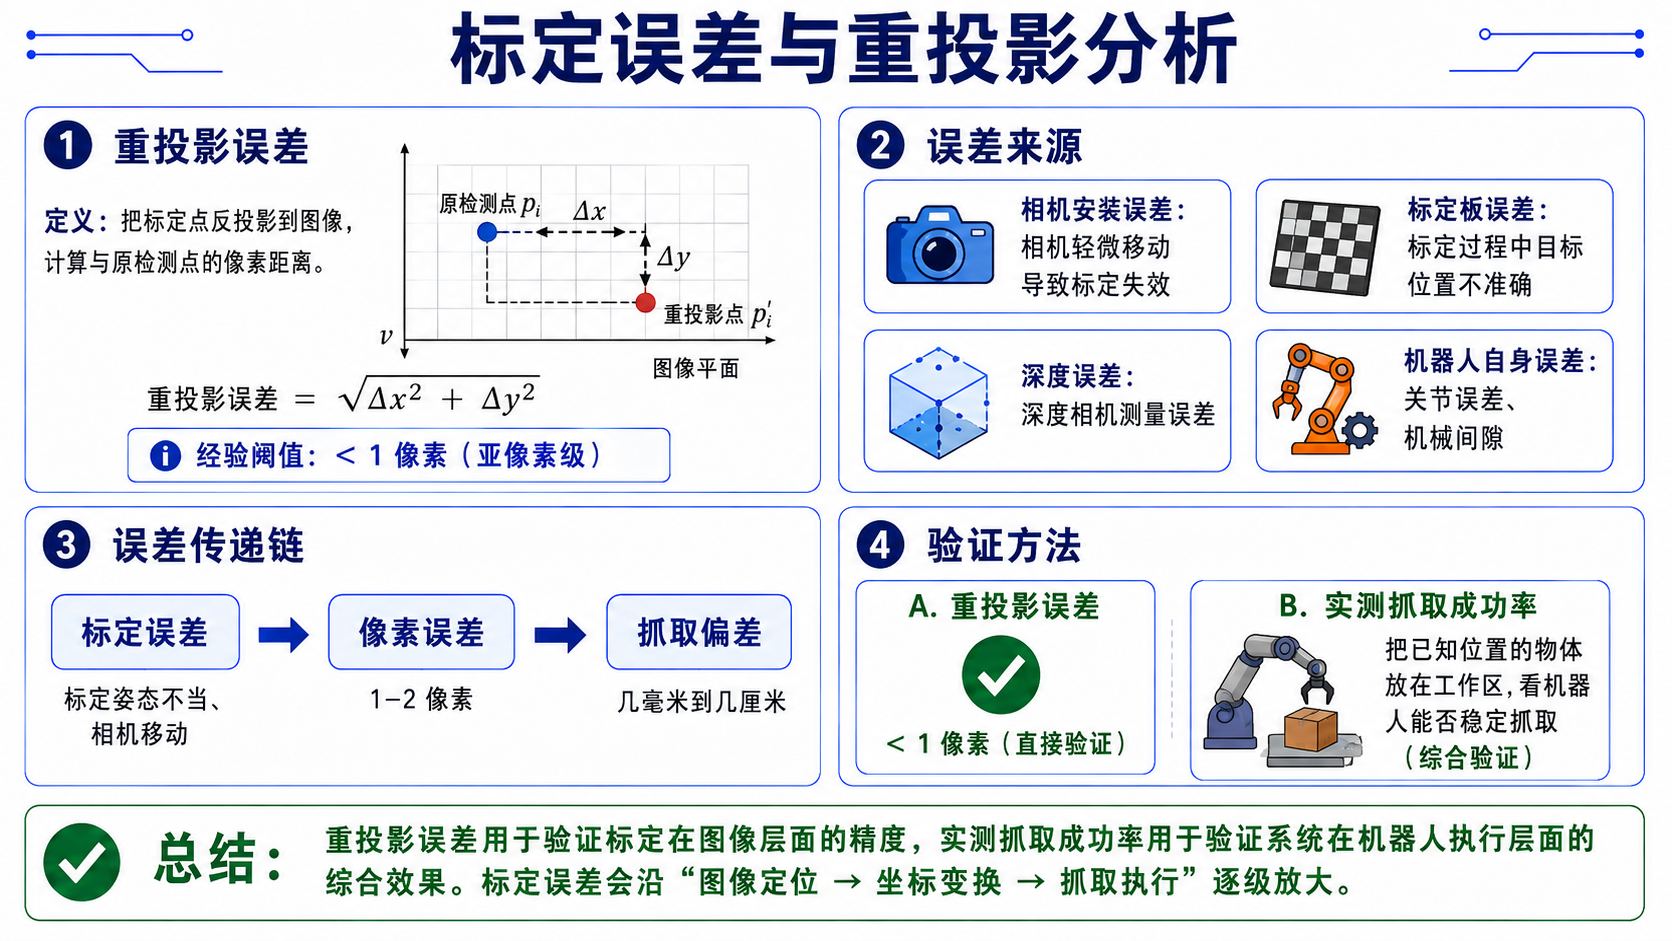
重投影误差
-
定义:把标定点反投影到图像,计算与原检测点的像素距离。
[图示:重投影误差]

  原检测点 p_i    重投影点 p_i'
       │                │
       └──── Δx, Δy ────┘

重投影误差 = sqrt(Δx² + Δy²)-
经验阈值:< 1 像素(亚像素级)。
-
误差来源
- 相机安装误差:相机轻微移动导致标定失效
- 标定板误差:标定过程中目标位置不准确
- 深度误差:深度相机测量误差
- 机器人自身误差:关节误差、机械间隙
-
误差传递链
标定误差 → 像素误差 → 抓取偏差
   ↑           ↑          ↑
   │           │          │
   │      1-2 像素   几毫米到几厘米
   │
   └── 标定姿态不当、相机移动
验证方法
- 重投影误差:< 1 像素(直接验证)
- 实测抓取成功率:把已知位置的物体放在工作区,看机器人能否稳定抓取(综合验证)
6-DoF 抓取姿态估计
6-DoF 抓取的坐标系约定
视觉抓取系(GraspNet 约定)
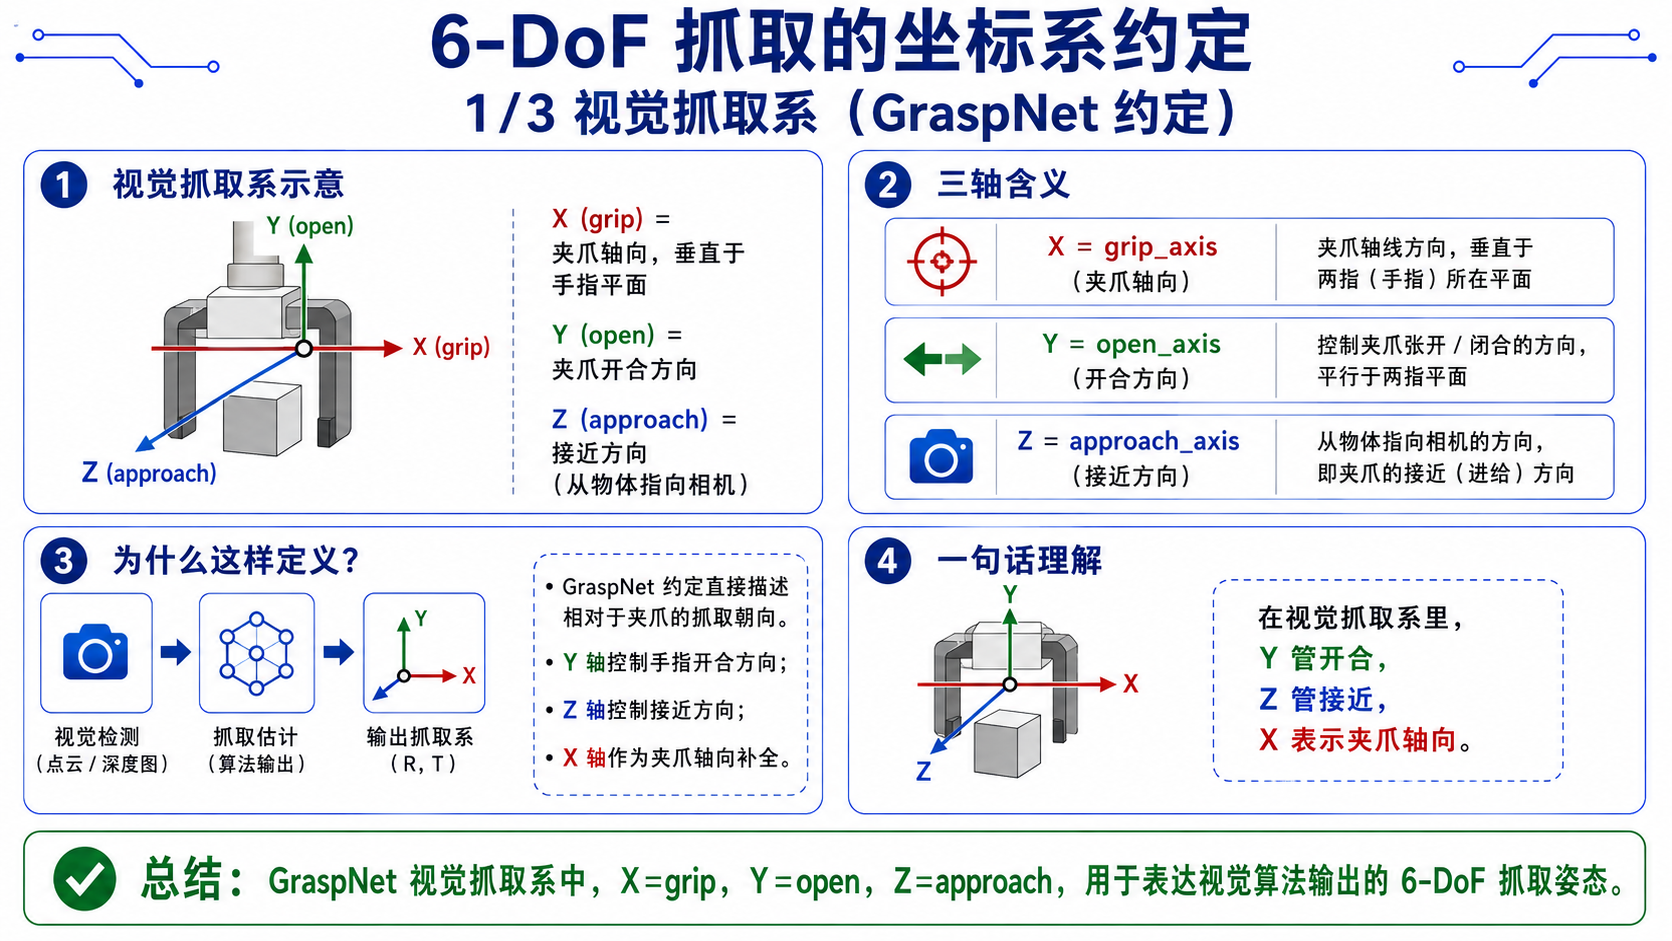
[图示:视觉抓取系]

Y (open)
│
│   夹爪开合方向
│
└────── X (grip) → 夹爪轴向(抓取方向)
╱
Z (approach)
↓ 接近方向(物体指向相机)
- X = grip_axis(夹爪轴向,垂直于手指平面)
- Y = open_axis(开合方向)
- Z = approach_axis(接近方向,从物体指向相机)
机器人 TCP 系(reBotArm 约定)
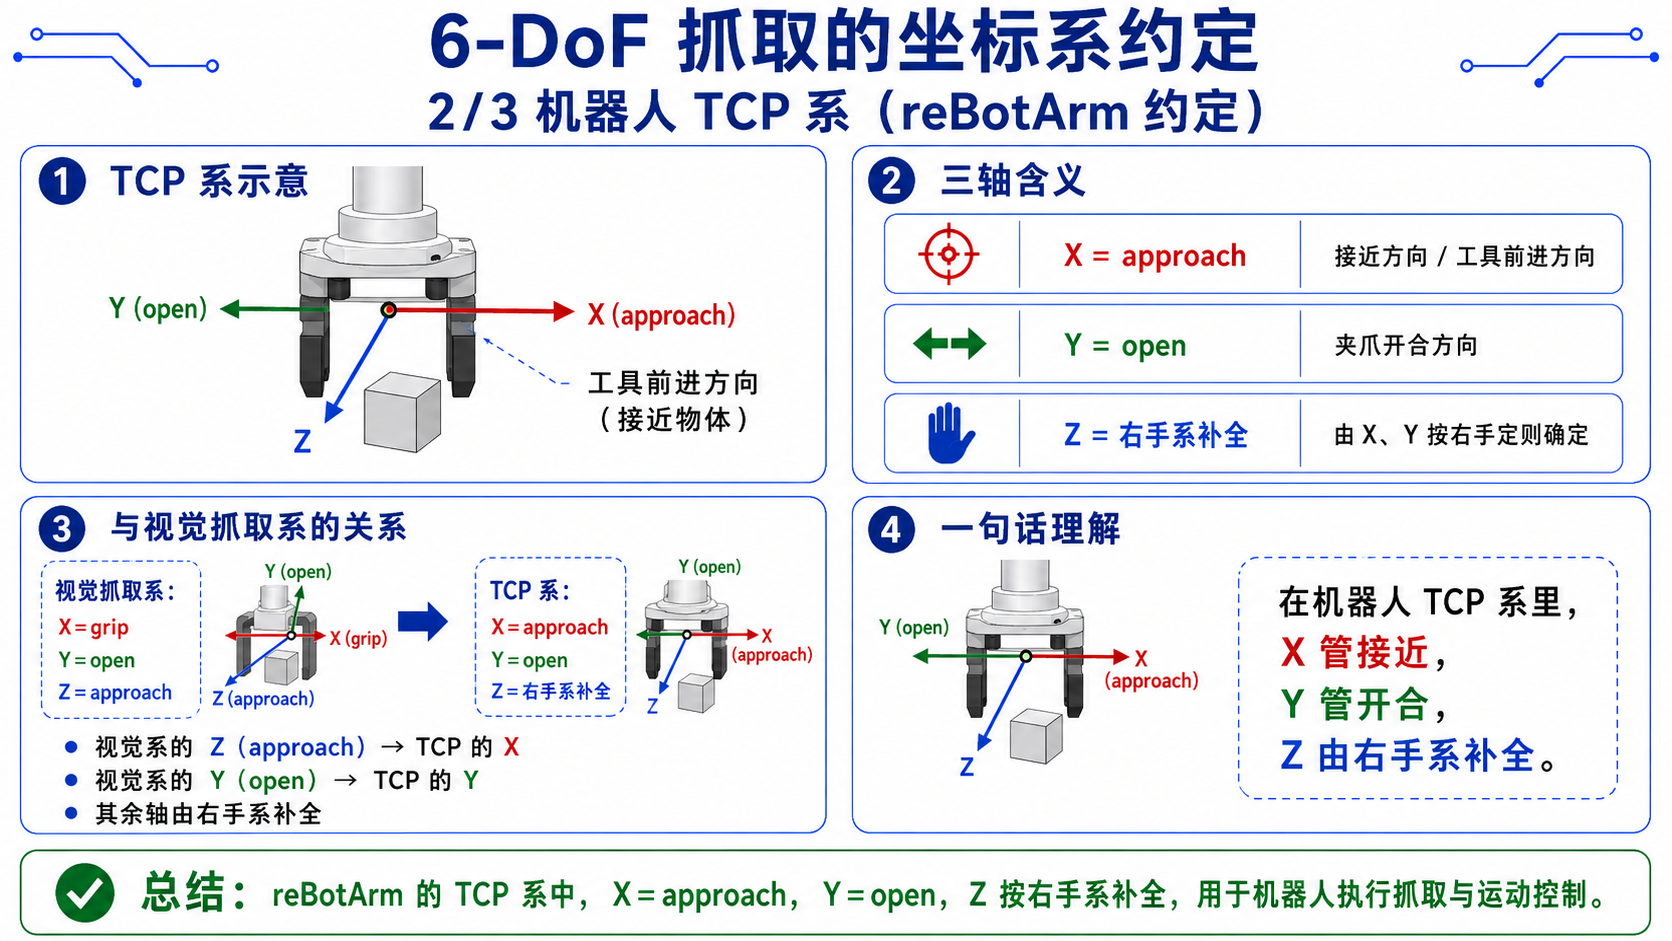
[图示:TCP 系]

Z
│  ╱ Y (open)
│ ╱
└────── X (approach) → 工具前进方向(接近物体)
- X = approach(接近方向)
- Y = open(开合方向)
- Z = 右手系补全
两个坐标系转换
-
实现参考:
# transforms.py L141-182 实现参考def grasp_axes_to_rebot_tcp_rotation(grip_axis, open_axis, approach_axis):
    """Map grasp-frame axes to the reBotArm TCP frame."""
    grip = grip_axis / norm(grip_axis)
    open_vec = open_axis / norm(open_axis)
    approach = approach_axis / norm(approach_axis)

# tcp_x = tool-forward = approach direction (negate, 因为 plane normal 朝向相机)
    tcp_x = -approach
# tcp_y = open direction, 减去 approach 分量使其正交
    tcp_y = open_vec - dot(open_vec, tcp_x) * tcp_x
    tcp_y = tcp_y / norm(tcp_y)
# tcp_z = 右手系叉积
    tcp_z = cross(tcp_x, tcp_y)
    tcp_z = tcp_z / norm(tcp_z)

# 保持 tcp_z 与 grip_axis 同向if dot(tcp_z, grip) < 0:
        tcp_y = -tcp_y
        tcp_z = -tcp_z

    R = np.column_stack([tcp_x, tcp_y, tcp_z]).astype(np.float64)
    if np.linalg.det(R) < 0.0:
        R[:, 2] *= -1.0return R
平行夹爪的 180° 对称性
-
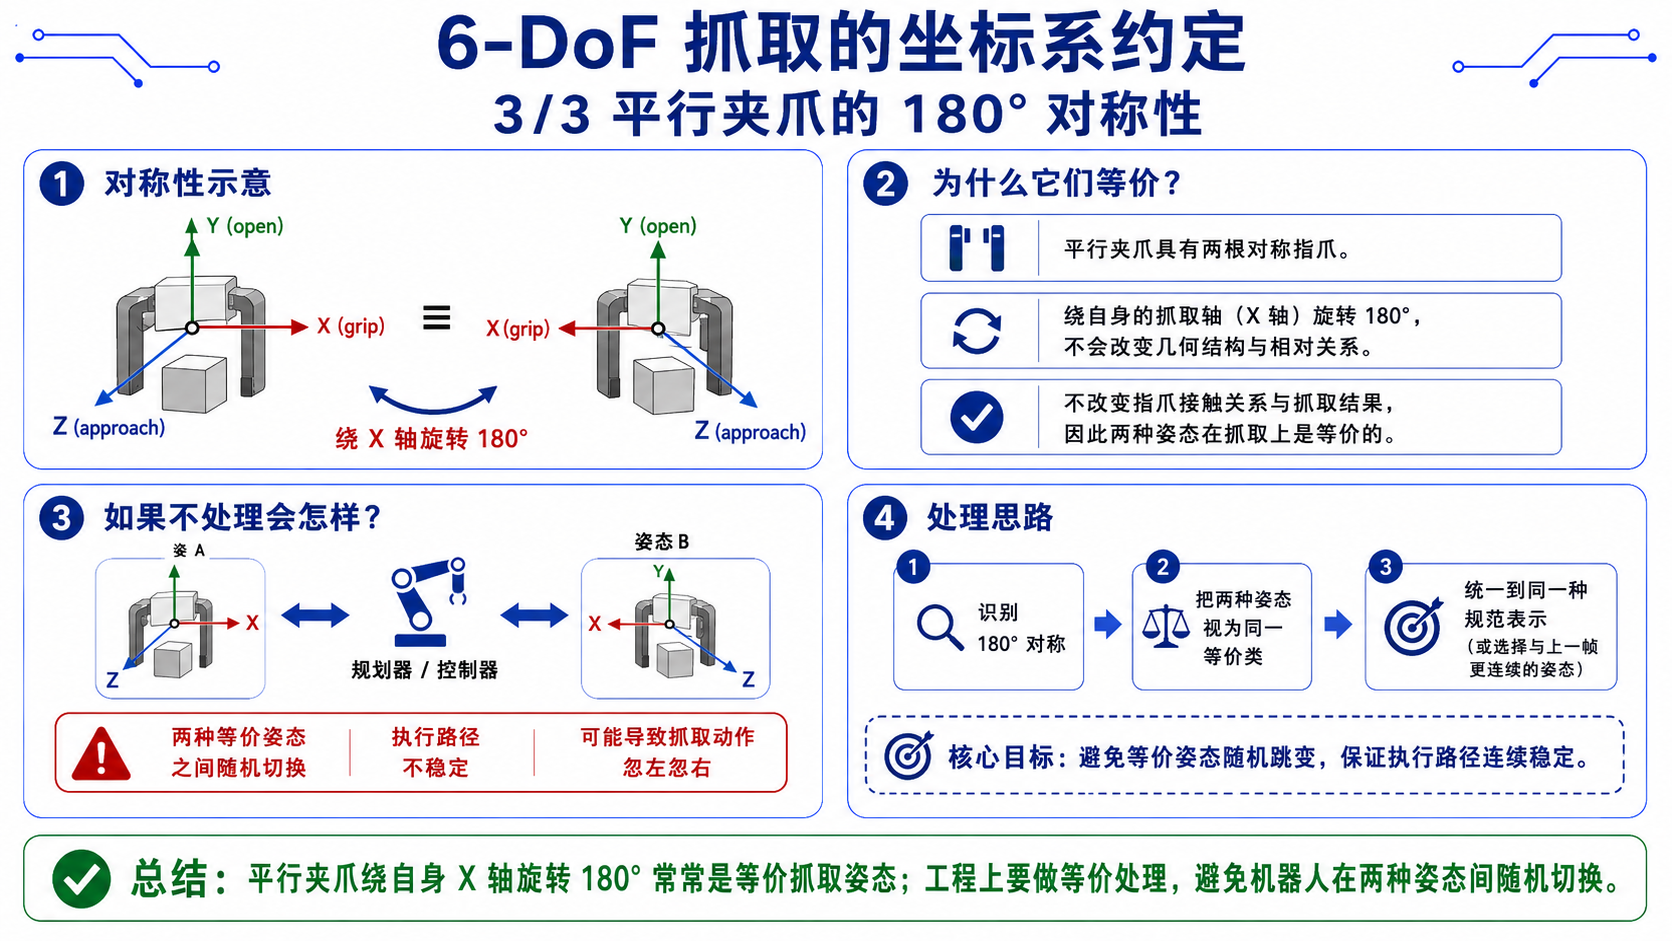
平行夹爪(两指夹爪)有一个特殊对称性:绕自身 X 轴(夹爪轴向)转 180° 是等价的。
[图示:平行夹爪对称性]

   X (grip)     X (grip)
   │            │
   ├─┐    ≡    ├─┐
   │ │   旋转   │ │
   ├─┘  180°   ├─┘
│ │ -
如果不处理,机器人会在两种等价姿态之间随机切换,导致执行路径不稳定。
-
实现参考:
# transforms.py L125-138 实现参考def canonicalize_parallel_gripper_tcp_rotation(R):
    """选稳定的等价姿态"""
    alt = R @ Rx(π)  # 绕 X 轴转 180°

    roll = rotation_matrix_to_euler_zyx(R)[0]
    alt_roll = rotation_matrix_to_euler_zyx(alt)[0]

# 选 |roll| 更小的分支(通常 roll≈0 更稳定)return alt if abs(alt_roll) < abs(roll) else R
-
基于 OBB + 深度分位数的几何抓取估计
完整流程
-
实现参考:
# ordinary_grasp.py L98-219 实现参考(核心伪代码)def estimate_grasp(result, index, depth_mm, K, depth_quantile=0.75):
# 1. 获取 OBB
    rect_points = _rect_points(result, index, depth_mm.shape, bbox_xyxy)
    center = rect_points.mean(axis=0).astype(np.float32)

# 2. 短边 = 抓取方向
    short_vec_uv, short_len_px = _short_edge(rect_points)
    short_dir_uv = _normalize(short_vec_uv)

# 3. mask 精化(用于弯曲物体)if short_dir_uv is not None:
        refined = _refine_grasp_line_from_mask(mask, center, short_dir_uv, long_len_px)
        if refined is not None:
            center, short_edge_points, grasp_span_px = refined

# 4. 深度采样 (mask 内 75% 分位)
    depth_values = depth_mm[mask > 0]
    depth_values = depth_values[depth_values > 0]
    if len(depth_values) == 0:
        center_depth = get_depth_mm(depth_mm, center_px[0], center_px[1], 5)
        if center_depth > 0:
            depth_values = np.array([center_depth], dtype=np.float32)

    z_m = float(np.quantile(depth_values, depth_quantile) / 1000.0)

# 5. 反投影中心点到 3D
    position = _backproject(float(center[0]), float(center[1]), z_m, K)

# 6. 三轴构建
    approach = _normalize(-position)       # Z 轴:物体指向相机
    open_axis = _pixel_vec_to_3d(short_dir_uv, z_m, K)
    open_axis = open_axis - float(np.dot(open_axis, approach)) * approach  # Gram-Schmidt
    open_axis = _normalize(open_axis)

# 保证 open_axis[0] >= 0(避免对称性歧义)if open_axis[0] < 0:
        open_axis = -open_axis

    grip_axis = _normalize(np.cross(open_axis, approach))
    open_axis = _normalize(np.cross(approach, grip_axis))

# 7. 组合旋转矩阵
    rotation = np.column_stack([grip_axis, open_axis, approach]).astype(np.float32)

# 8. 转换为 reBotArm TCP 旋转
    tcp_rotation = grasp_axes_to_rebot_tcp_rotation(
        rotation[:, 0], rotation[:, 1], rotation[:, 2]
    ).astype(np.float32)

# 9. 抓取宽度估计
    jaw_width_m = float(np.linalg.norm(
        _pixel_vec_to_3d(short_dir_uv * grasp_span_px, z_m, K)
    ))

    return grasp_pose
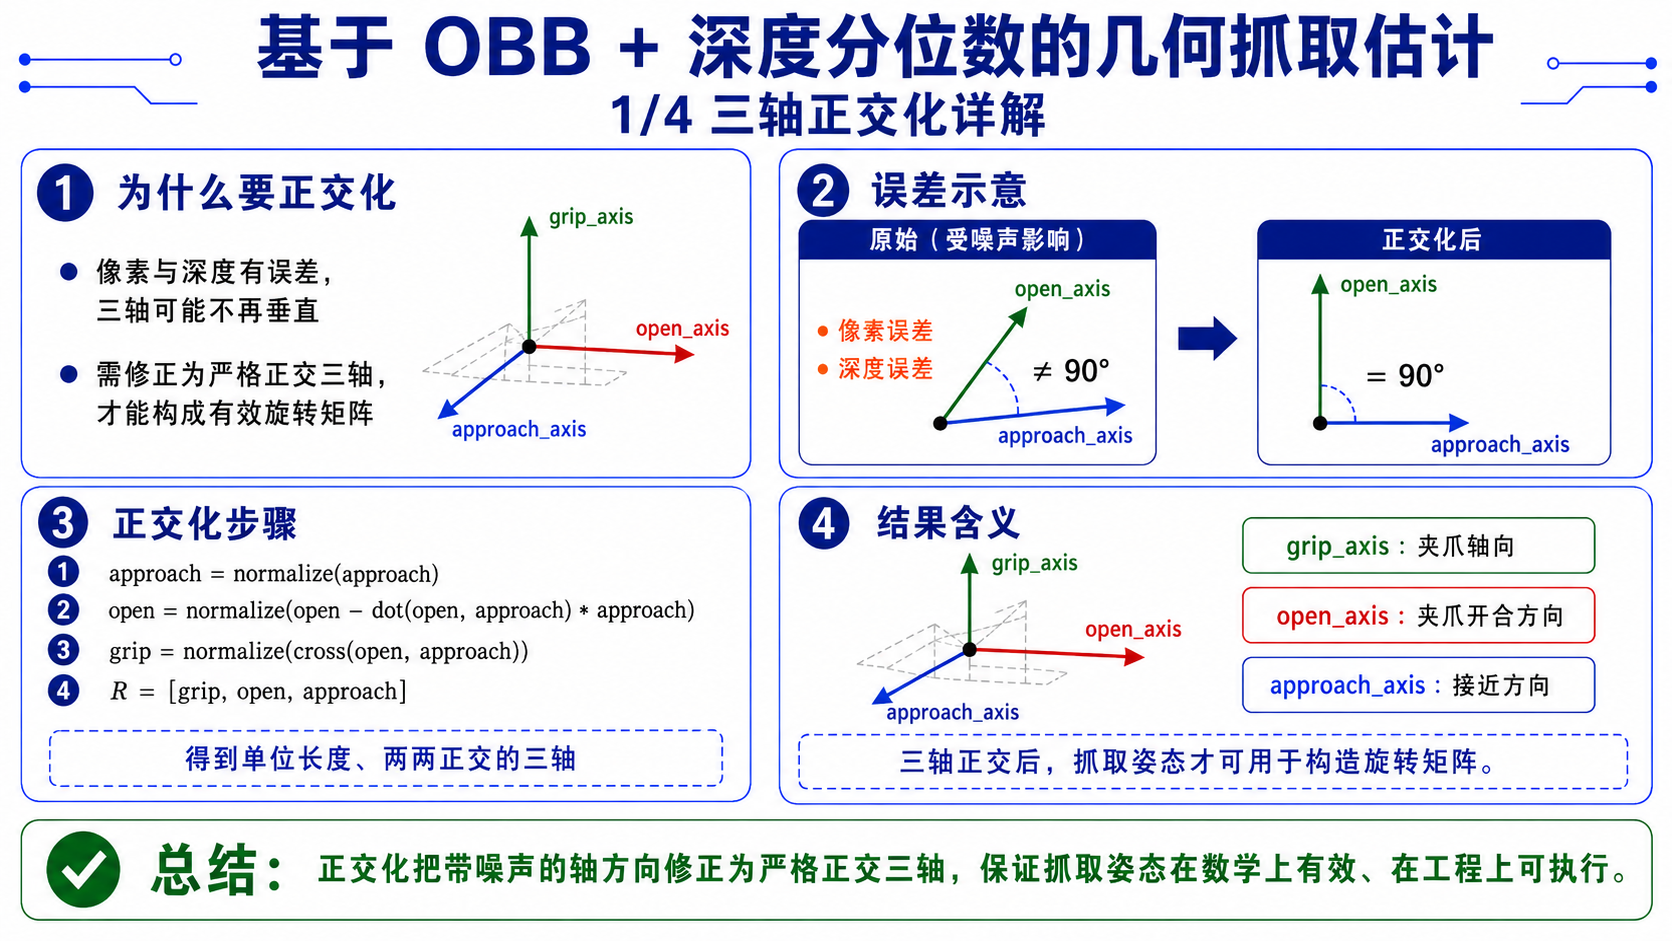
三轴正交化详解
-
为什么要正交化:
-
数值计算中,由于像素向量和深度都存在误差,
open_axis和approach可能不正交。Gram-Schmidt 正交化保证三轴严格正交,构成有效的旋转矩阵。# 关键步骤
approach = -position / norm(position) # 物体指向相机
open_3d = pixel_to_3d(short_dir_uv, z_m, K) # 短边方向 3D 化
open_axis = open_3d - dot(open_3d, approach) * approach # Gram-Schmidt 正交化
open_axis = normalize(open_axis)
grip_axis = normalize(cross(open_axis, approach))
open_axis = normalize(cross(approach, grip_axis)) # 再次正交化保证数值稳定
-
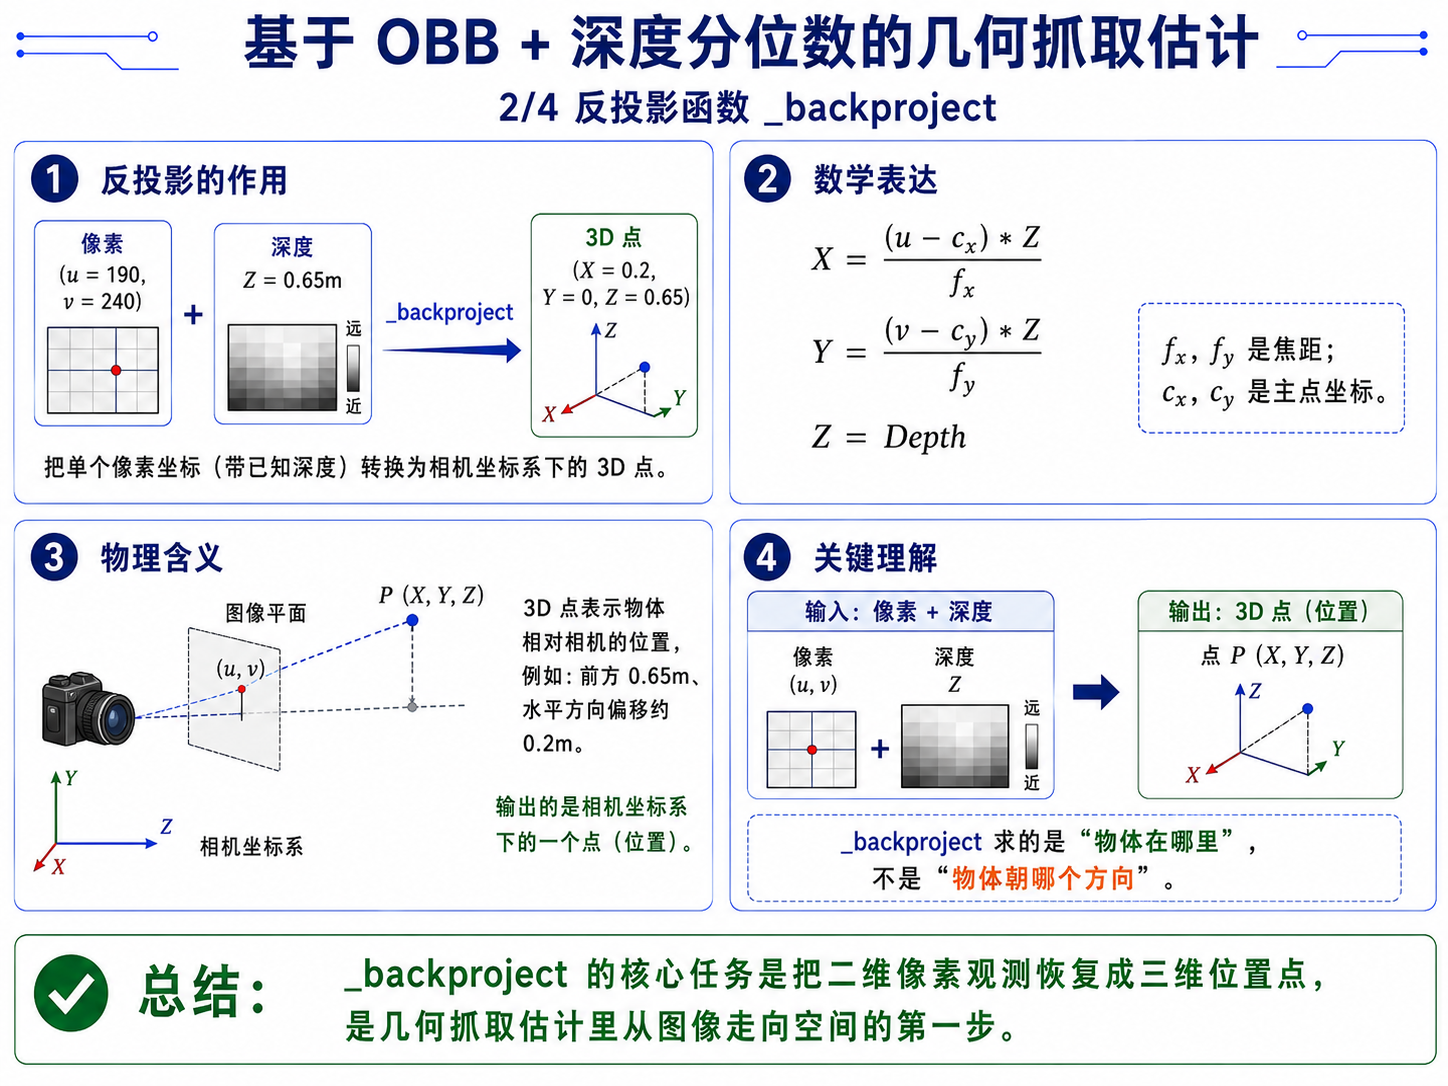
反投影函数
-
作用:把单个像素坐标(带已知深度)转换为相机坐标系下的 3D 点(位置)
[图示:反投影的物理含义]

  像素 (u=190, v=240) + 深度 Z=0.65m
           ↓ _backproject
  3D 点 (X=0.2, Y=0, Z=0.65)
           ↓
"物体在相机前方 0.65m、偏右 0.2m" -
实现参考:
# ordinary_grasp.py L398-403 实现参考def _backproject(u, v, z_m, K):
    fx, fy = float(K[0, 0]), float(K[1, 1])
    cx, cy = float(K[0, 2]), float(K[1, 2])
    x = (u - cx) * z_m / fx
    y = (v - cy) * z_m / fy
    return np.array([x, y, z_m], dtype=np.float32)
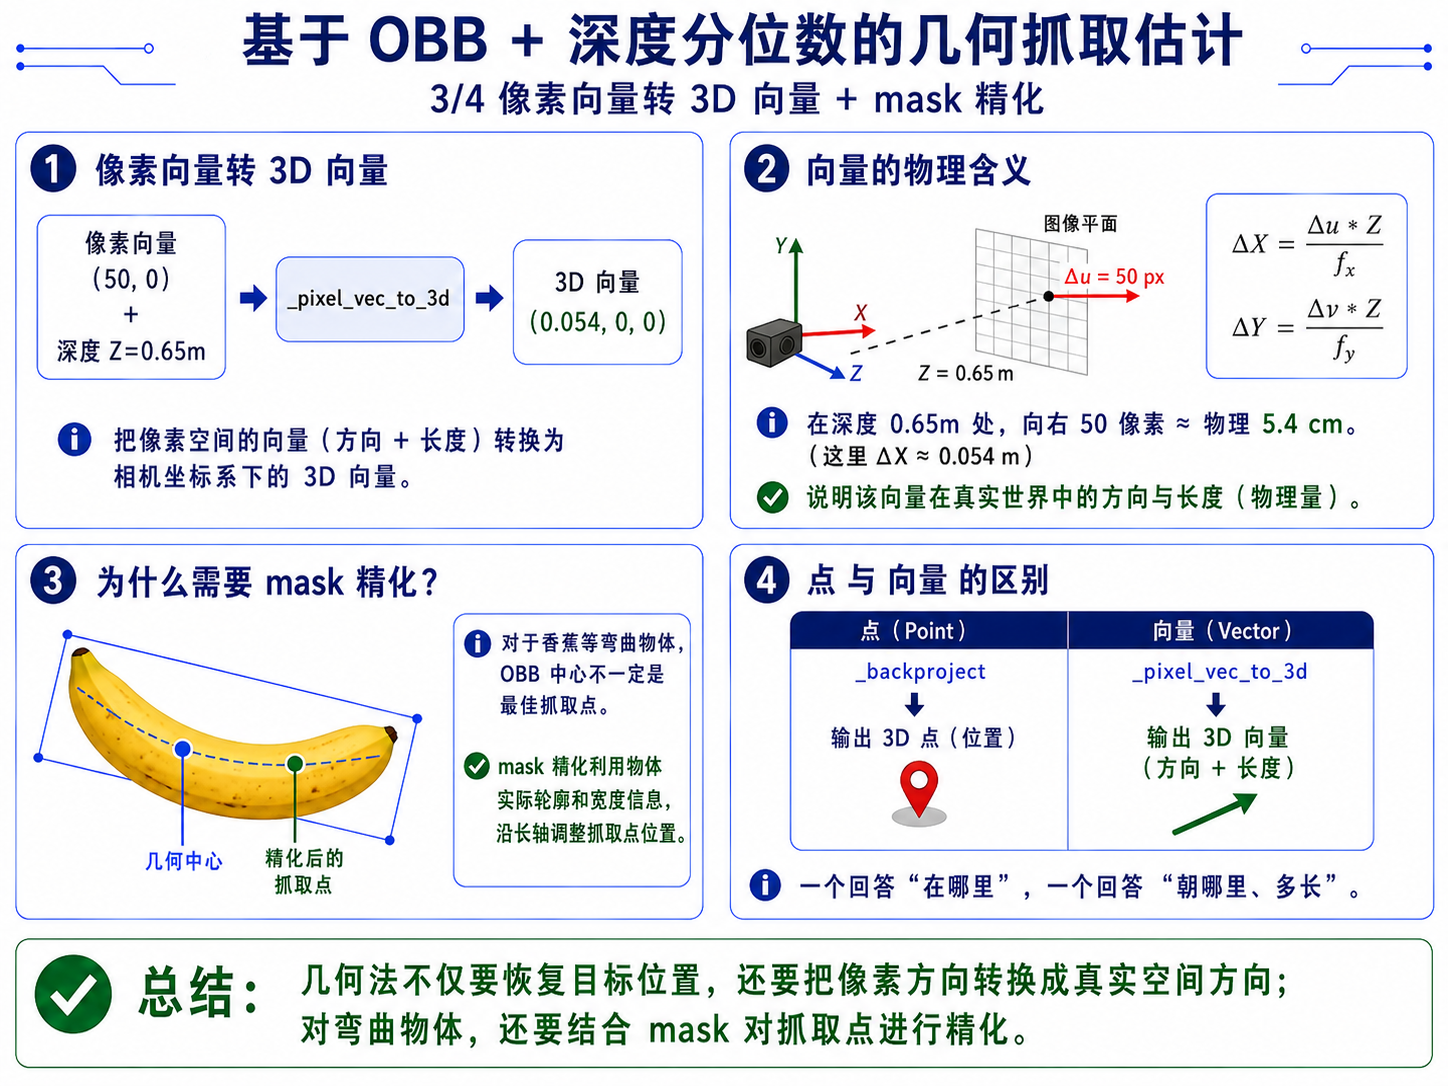
像素向量转 3D 向量
-
作用:把像素空间的向量(方向+长度)转换为相机坐标系下的 3D 向量(方向+长度)。
[图示:像素向量的物理含义]

  像素向量 (50, 0) + 深度 Z=0.65m
           ↓ _pixel_vec_to_3d
  3D 向量 (0.054, 0, 0)
           ↓
"在深度 0.65m 处,向右 50 像素 = 物理 5.4 cm" -
实现参考:
# ordinary_grasp.py L406-408 实现参考def _pixel_vec_to_3d(vec_uv, z_m, K):
    fx, fy = max(float(K[0, 0]), 1e-6), max(float(K[1, 1]), 1e-6)
    return np.array([
        float(vec_uv[0]) * z_m / fx,
        float(vec_uv[1]) * z_m / fy,
        0.0
    ], dtype=np.float32)
mask 精化(弯曲物体)
-
为什么需要 mask 精化:
-
OBB 中心是物体的几何中心,但对于香蕉等弯曲物体,最佳抓取点是长轴上某个特定位置(通常是中点附近)。精化算法用 mask 的实际宽度信息调整抓取点位置。
-
实现参考:
utils/ordinary_grasp.py_refine_grasp_line_from_mask()(L233-275)# ordinary_grasp.py L233-275 实现参考def _refine_grasp_line_from_mask(mask, center, short_dir_uv, long_len_px):
"""使用 mask 中心横截面精化短轴抓取点"""
ys, xs = np.nonzero(mask > 0)
if len(xs) < 32:
return None # mask 太小,不精化
points = np.column_stack([xs, ys]).astype(np.float32)
grip_dir_uv = np.array([-short_dir_uv[1], short_dir_uv[0]], dtype=np.float32)
rel = points - center.reshape(1, 2)
grip_coord = rel @ grip_dir_uv # 短轴方向的坐标
open_coord = rel @ short_dir_uv # 长轴方向的坐标
grip_center = float(np.median(grip_coord))
band_half_width = clip(long_len_px * 0.04, 2.0, 12.0)
band_mask = np.abs(grip_coord - grip_center) <= band_half_width
if count(band_mask) < 24:
band_half_width = clip(long_len_px * 0.08, 4.0, 18.0)
band_mask = np.abs(grip_coord - grip_center) <= band_half_width
if count(band_mask) < 24:
return None# 在窄带内取 open 方向的 5%/95% 分位
open_min = np.percentile(open_coord[band_mask], 5.0)
open_max = np.percentile(open_coord[band_mask], 95.0)
open_center = 0.5 * (open_min + open_max)
# 重新组合中心
refined_center = center + grip_center * grip_dir_uv + open_center * short_dir_uv
short_edge_points = _line_from_center(refined_center, short_dir_uv * (open_max - open_min))
return refined_center, short_edge_points, float(open_max - open_min)
-
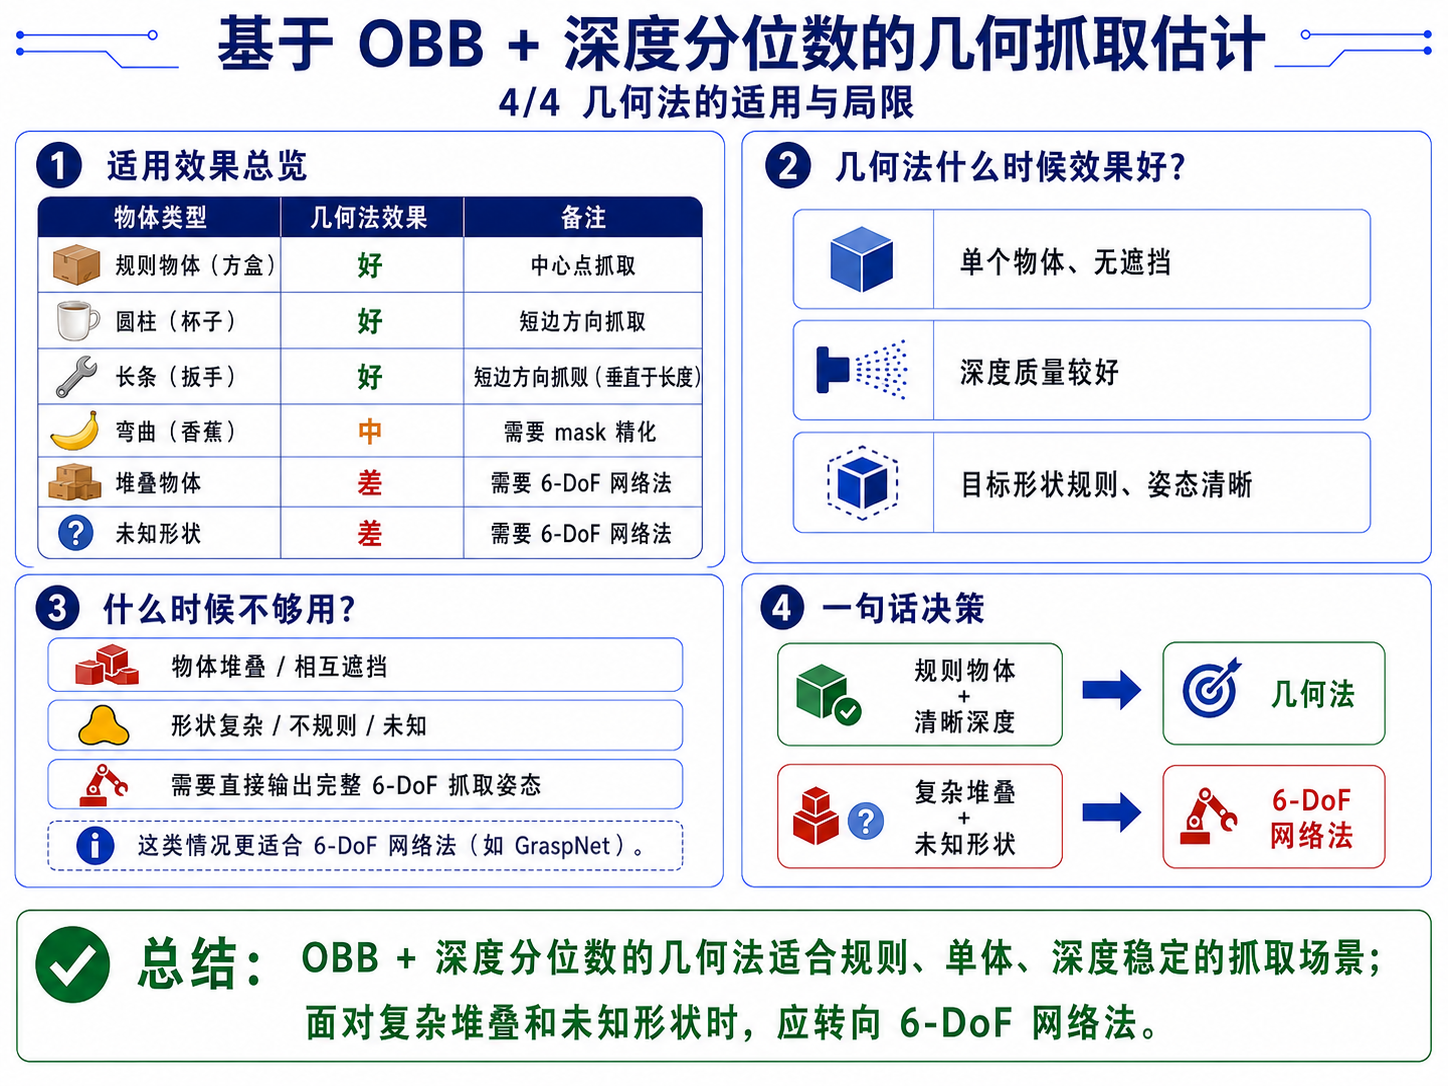
几何法的适用与局限
基于点云网络的 6-DoF 抓取估计(GraspNet)
实现参考:
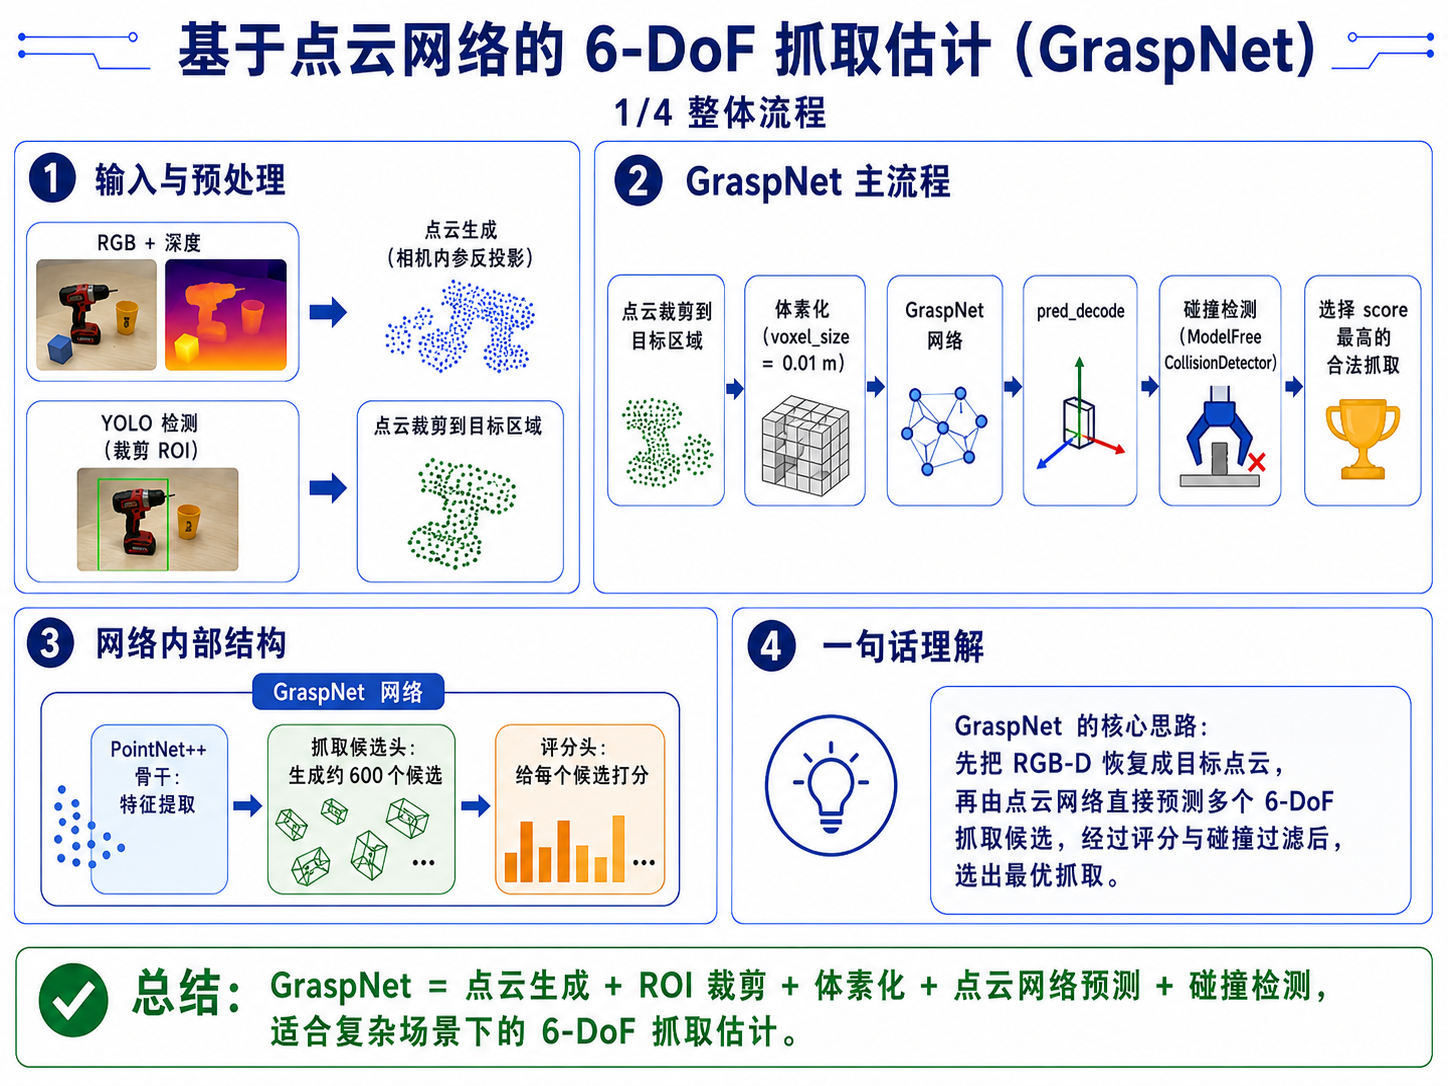
[图示:GraspNet 流程]

RGB + 深度
  │
  ├─→ 点云生成 (相机内参反投影)
  │
  └─→ YOLO 检测 (裁剪 ROI)
       │
       └─→ 点云裁剪到目标区域
            │
            └─→ 体素化 (voxel_size = 0.01 m)
                 │
                 └─→ GraspNet 网络
                      │
                      ├─→ PointNet++ 骨干 (特征提取)
                      │
                      ├─→ 抓取候选头 (生成 ~600 个候选)
                      │
                      └─→ 评分头 (给每个候选打分)
                           │
                           └─→ pred_decode (解析为 Grasp 对象)
                                │
                                └─→ 碰撞检测 (ModelFreeCollisionDetector)
                                     │
                                     └─→ 选 score 最高的合法抓取
输入:点云 + Mask
-
实现参考:
# graspnet_utils.py L21-25 实现参考
PROJECT_ROOT = Path(__file__).resolve().parents[1]
GRASPNET_ROOT = PROJECT_ROOT / "sdk" / "graspnet-baseline"
DEFAULT_NUM_VIEW = 300
DEFAULT_VOXEL_SIZE = 0.01              # 1 cm 体素
DEFAULT_WARMUP_FRAMES = 20
DISPLAY_FLIP_X = np.diag([1.0, -1.0, -1.0, 1.0]).astype(np.float64) -
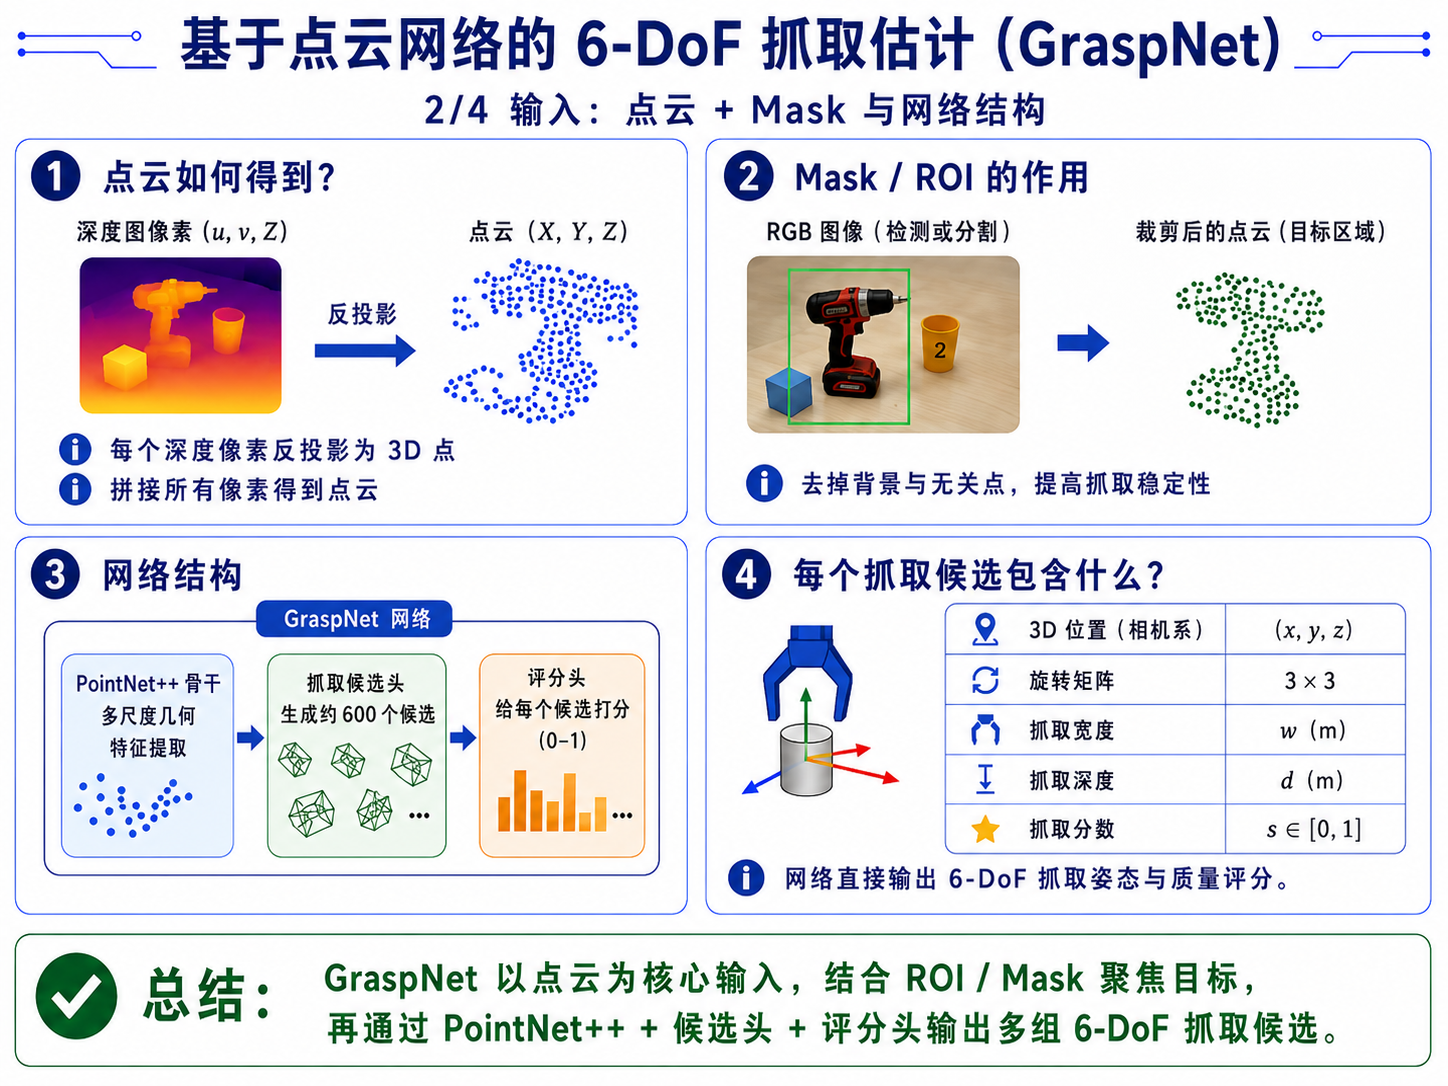
点云从深度图反投影:
- 每个深度像素 (u, v, Z) 通过反投影得到 (X, Y, Z)
- 拼接所有像素得到点云
-
网络结构
-
PointNet++ 骨干
- 点云特征提取骨干,从局部到全局提取多尺度几何特征。
-
抓取候选头
- 输出大量 6-DoF 抓取候选(约 600 个),每个包含:3D 位置(相机系)、旋转矩阵、抓取宽度、抓取深度
-
评分头
- 给每个抓取候选打分(0-1),分数越高表示抓取成功率越高。
-
输出格式
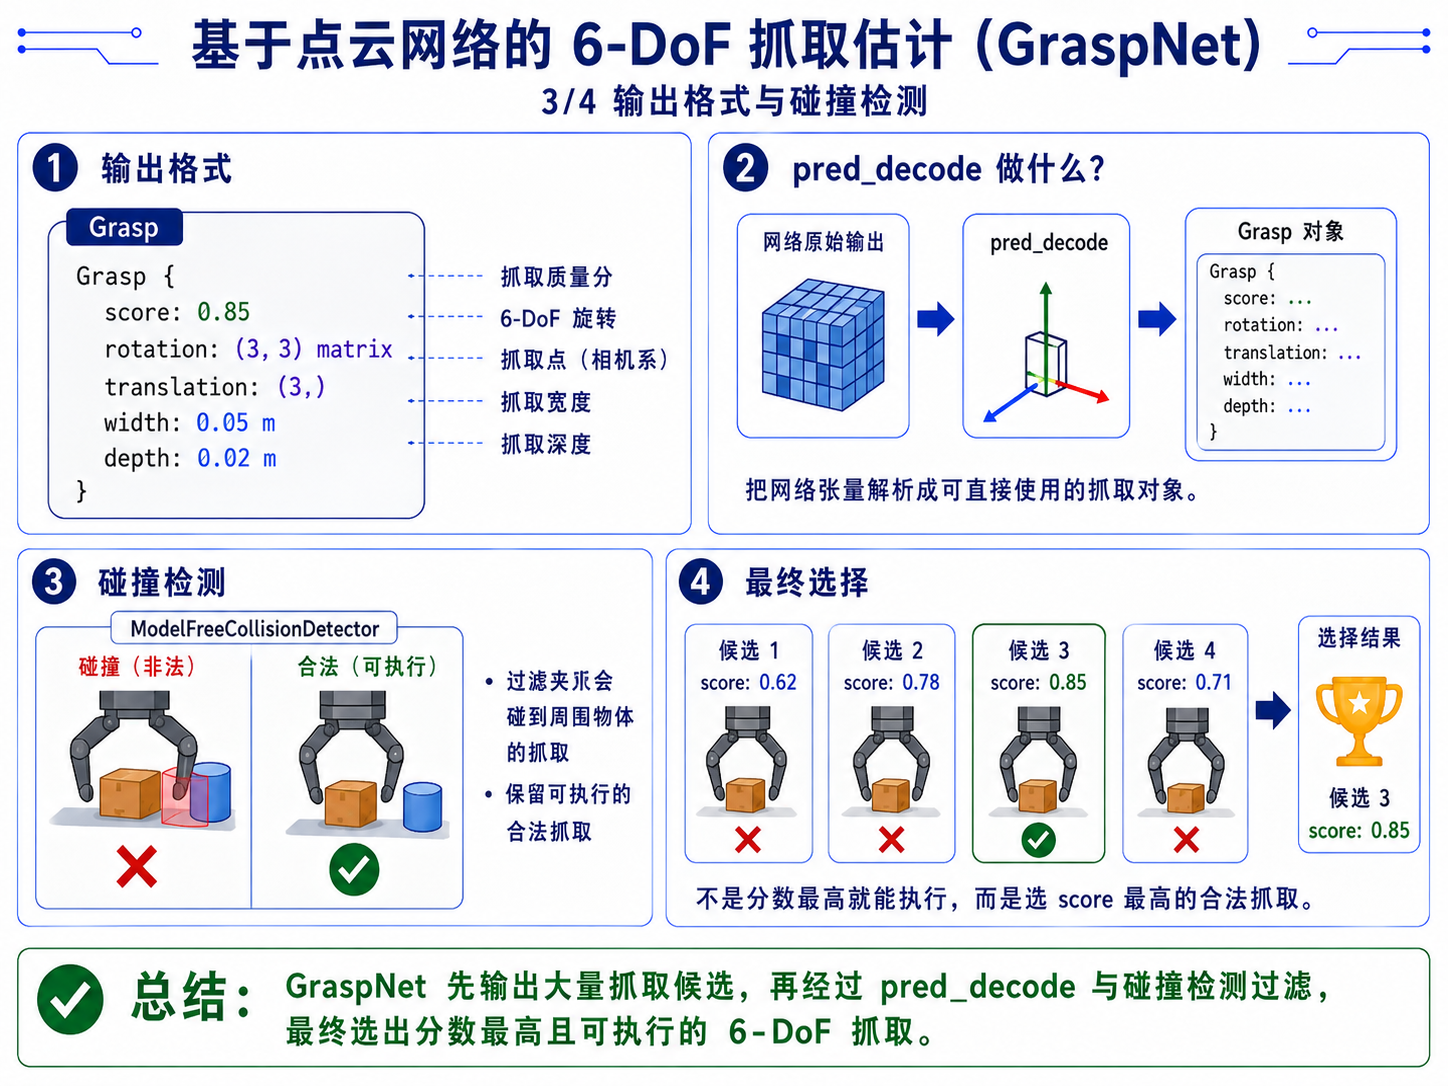
Grasp {
  score: 0.85              # 抓取质量分
  rotation: (3, 3) matrix  # 6-DoF 旋转
  translation: (3,)        # 抓取点 (相机系)
  width: 0.05              # 抓取宽度 (m)
  depth: 0.02              # 抓取深度 (m)
}
碰撞检测
-
实现参考:
# graspnet_utils.py L45 实现参考
from collision_detector import ModelFreeCollisionDetector # noqa -
碰撞检测器检查抓取执行时夹爪是否会碰到周围物体,过滤掉会碰撞的抓取。
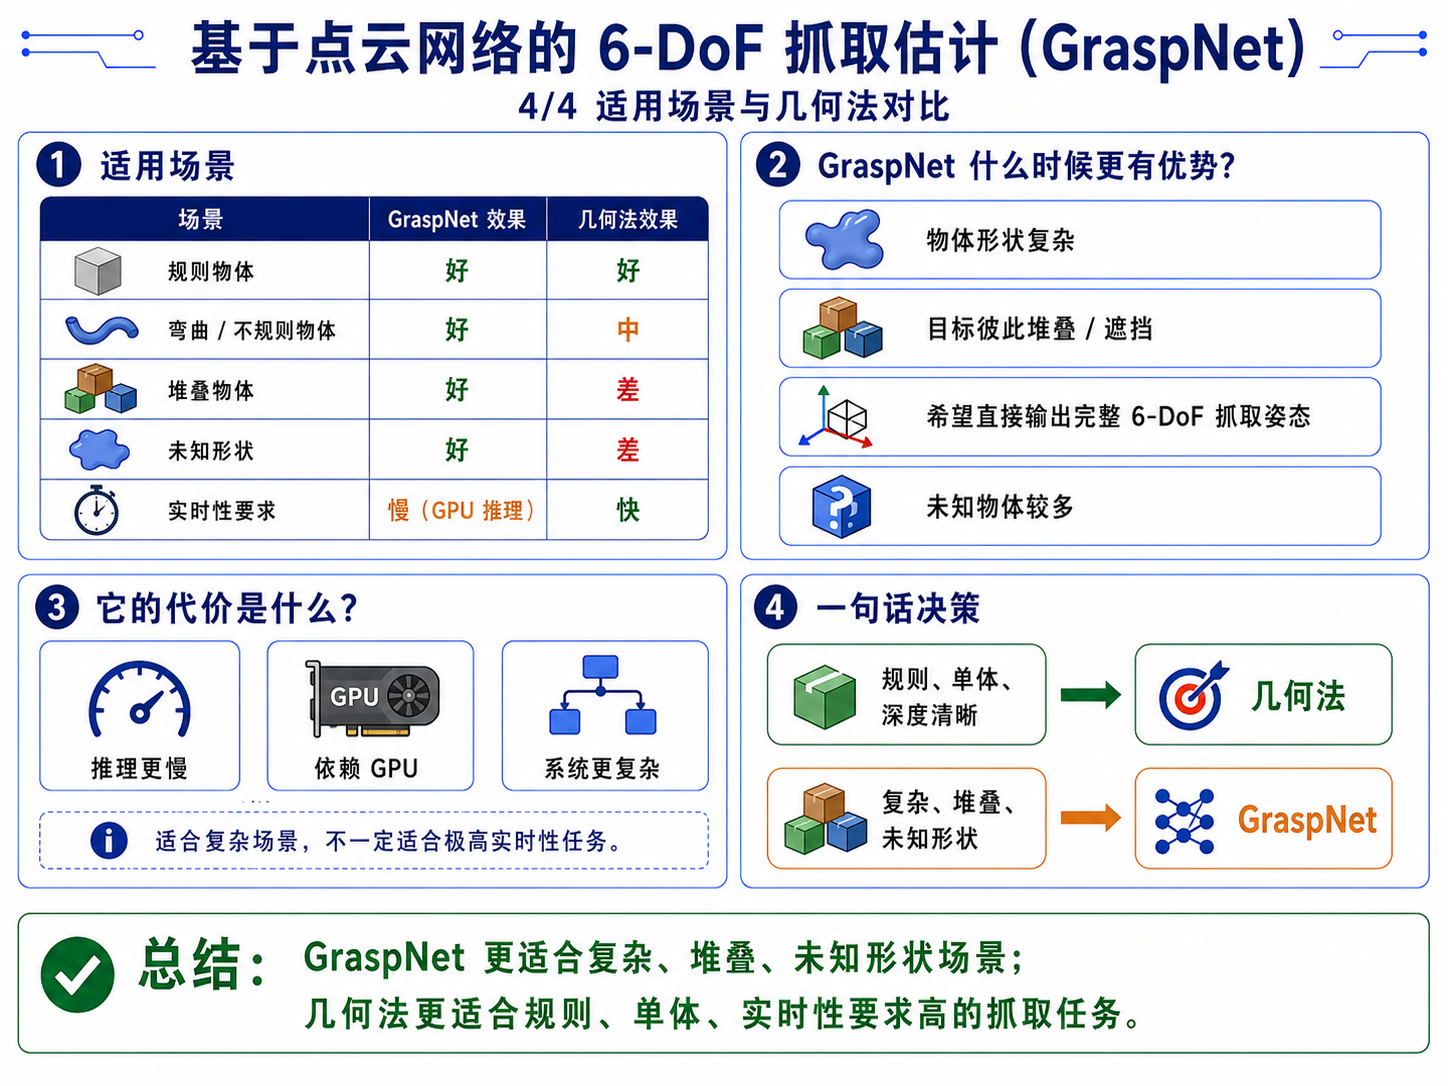
适用场景
抓取位姿到基坐标系的转换
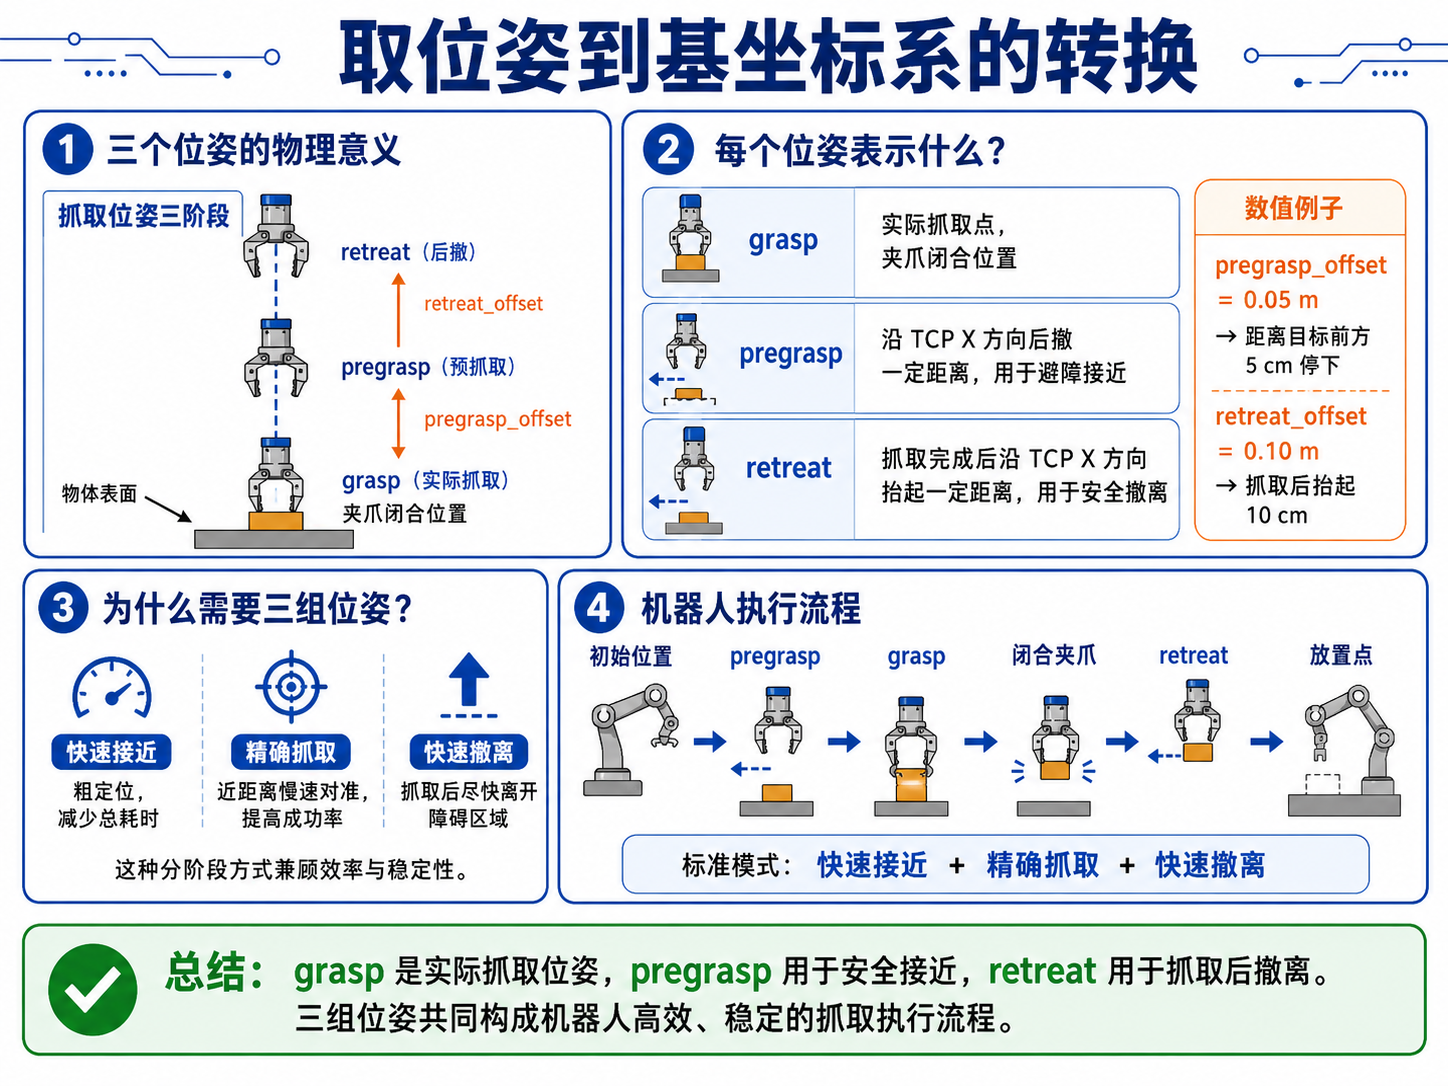
-
实现参考:
# transforms.py L227-240 实现参考def transform_grasp_pose_to_base_with_retreat(
    position_cam,           # 抓取点 (相机系)
    tcp_rotation_cam,       # TCP 旋转 (相机系)
    T_cam2base,             # 手眼变换后的相机→基座矩阵
    pregrasp_offset_m,      # 预抓取后撤距离
    retreat_offset_m,       # 后撤点距离
    insertion_depth_m=0.0,
):
# 1. 把抓取点变到基坐标系
    T_grasp_cam = make_T(position_cam, tcp_rotation_cam)
    T_grasp_base = T_cam2base @ T_grasp_cam

# 2. canonicalize 平行夹爪对称性
    T_grasp_base[:3, :3] = canonicalize_parallel_gripper_tcp_rotation(T_grasp_base[:3, :3])

# 3. 沿 TCP X 方向偏移得到 pregrasp 和 retreat
    T_grasp_base = offset_along_tool_x(T_grasp_base, -insertion_depth_m)
    T_pregrasp_base = offset_along_tool_x(T_grasp_base, pregrasp_offset_m)
    T_retreat_base = offset_along_tool_x(T_grasp_base, retreat_offset_m)

# 4. 转回 6D posereturn mat4_to_pose6d(T_grasp_base), mat4_to_pose6d(T_pregrasp_base), mat4_to_pose6d(T_retreat_base)-
三个位姿的物理意义
[图示:抓取位姿三阶段]

       retreat (后撤)
         ↑
         │ retreat_offset
         │
       pregrasp (预抓取)
         ↑
         │ pregrasp_offset
         │
       grasp (实际抓取)
↓ 物体表面-
grasp:实际抓取点,夹爪闭合位置
-
pregrasp:预抓取点,沿 TCP X 方向后撤一定距离,用于避障接近
-
retreat:后撤点,抓取完成后沿 TCP X 方向抬起一定距离
-
例如:
- pregrasp_offset = 0.05 m → 接近物体前停在距离 5 cm 处
- retreat_offset = 0.10 m → 抓取后抬起 10 cm 离开物体
-
-
为什么需要三组位姿
- 机器人执行抓取的标准流程:
- 从初始位置运动到 pregrasp(快速、粗定位)
- 从 pregrasp 慢速运动到 grasp(精确对准)
- 闭合夹爪
- 从 grasp 抬起至 retreat(快速撤离)
- 从 retreat 运动到放置点
这种"快速接近 + 精确抓取 + 快速撤离"的模式既保证了抓取精度,又提高了整体效率。