9. 机器人学习与模仿学习基础
在第二阶段,你已经可以用 Python SDK 控制机械臂了:读取关节角、发送目标位置、张开闭合夹爪。于是很自然地会想到——写一个程序,让机械臂自动抓取桌上的方块,不就行了?
本阶段需要的硬件
本阶段需要准备的硬件如下。全部阶段的完整清单见 第 3 章。
主控单元
| 硬件 | 购买 | 数量 |
|---|---|---|
| Jetson Orin Nano Super 8G | 🛒 | 1 |
| reComputer Robotics J4012 | 🛒 | 1 |
| NVIDIA Jetson AGX Thor 128G | 🛒 | 1 |
另外还需要一台台式机或笔记本:Ubuntu 22.04、GTX 4080 以上(12G 显存以上)、16GB 以上内存。
本阶段
| 硬件 | 购买 | 数量 |
|---|---|---|
| reBot Arm B601 DM/RS | 🛒 | 1 |
| reBot Arm 102 Leader臂 | 🛒 | 1 |
| 720P单目腕部相机 | 🛒 | 1 |
| 1080P海康 | 🛒 | 1 |
| 腕部相机支架 | — | 1 |
| 海康相机俯拍支架 | 🛒 | 1 |
机器人学习与模仿学习基础
为什么机械臂需要学习?
在第二阶段,你已经可以用 Python SDK 控制机械臂了:读取关节角、发送目标位置、张开闭合夹爪。于是很自然地会想到——写一个程序,让机械臂自动抓取桌上的方块,不就行了?
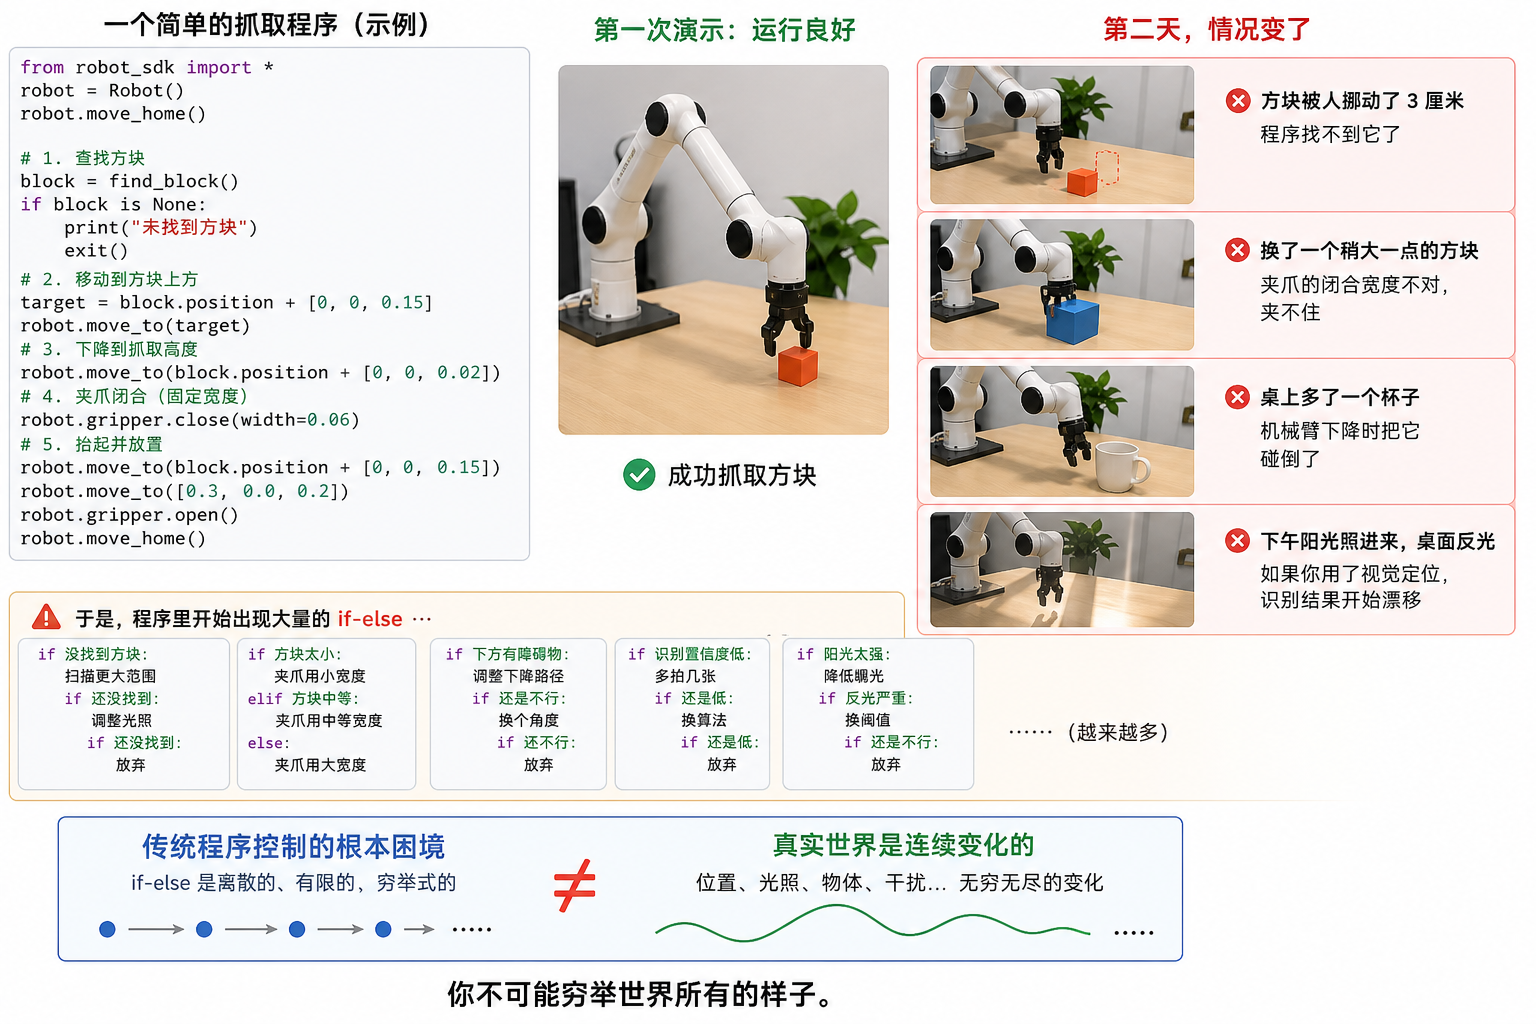
于是就有这样的一个程序:
实验室的第一次演示中,这个程序运行得很好。但第二天,情况变了:
- 方块被人挪动了 3 厘米——程序找不到它了;
- 换了一个稍大一点的方块——夹爪的闭合宽度不对,夹不住;
- 桌上多了一个杯子——机械臂下降时把它碰倒了;
- 下午阳光照进来,桌面反光——如果你用了视觉定位,识别结果开始漂移。
你会发现,为了应对这些变化,程序里的"如果"越写越多,最终变成一本谁也维护不动的"特殊情况大全"。
这就是传统程序控制的根本困境:真实世界是连续变化的,而 if-else 是离散的。 你不可能穷举世界所有的样子。
-
那么,人类是怎么解决这个问题的?
- 你是看着别人抓,然后自己试几次,就会了。而且学会之后,方块换个位置、换个大小,你照样能抓——因为你学到的不是一串坐标,而是"抓"这件事本身。
让机械臂也用这种方式获得技能,就是机器人学习(Robot Learning)要解决的问题。 而本阶段要讲的模仿学习,是其中最成熟、最容易在真实硬件上落地的一条路线。
规则控制与学习控制
在继续之前,我们先把两种控制方式摆在一起看清楚
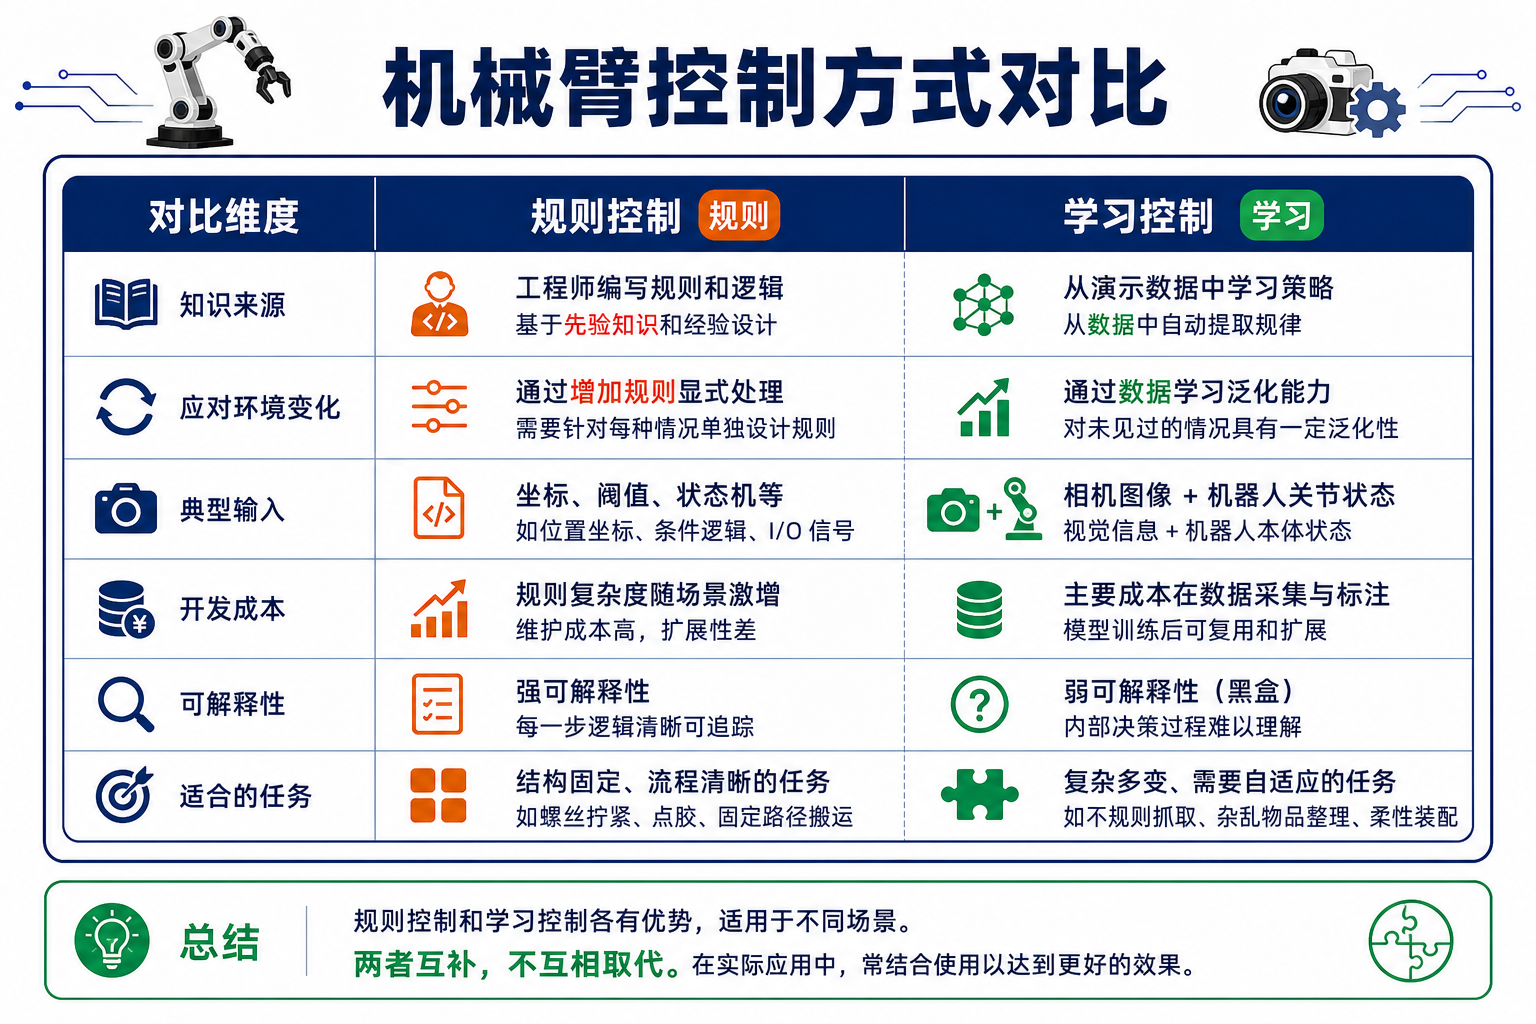
- 请注意,这两者不是谁取代谁的关系。工厂里拧螺丝的机械臂,几十年如一日重复同一个动作,规则控制至今仍是最好的选择——它精确、可靠、可审计。学习控制擅长的,是那些规则写不出来、或者写起来代价太高的任务。
本课程的第三阶段到第四阶段,走的就是"学习控制"这条路线。但请记住:即使在未来,你写的学习系统里依然会保留大量规则——比如关节限位、安全速度限制。学习和规则是互补的。
模仿学习与行为克隆
什么是模仿学习
-
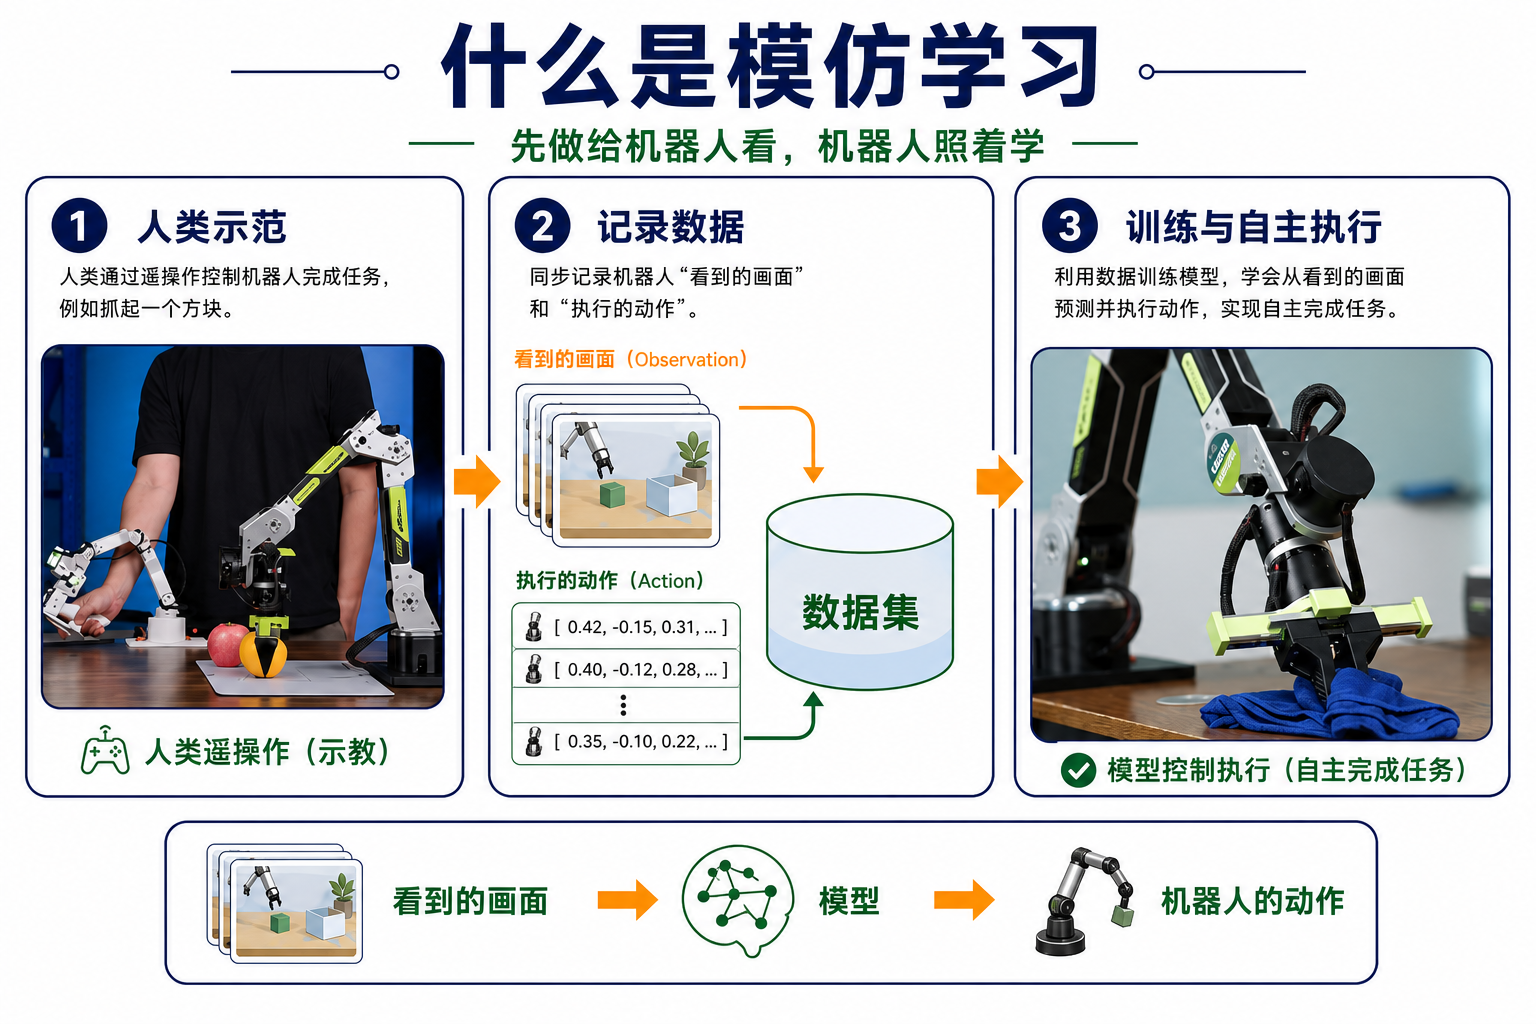
模仿学习的思想朴素到一句话就能说完:先做给机器人看,机器人照着学。
- 在模仿学习中,人类操作者通过遥操作(Teleoperation)控制机械臂完成任务,系统同时记录"看到的画面"和"执行的动作"。这些数据被用来训练一个模型,训练完成后,模型就能在没有人类操作的情况下,自己看着画面做出动作。
什么是行为克隆
-
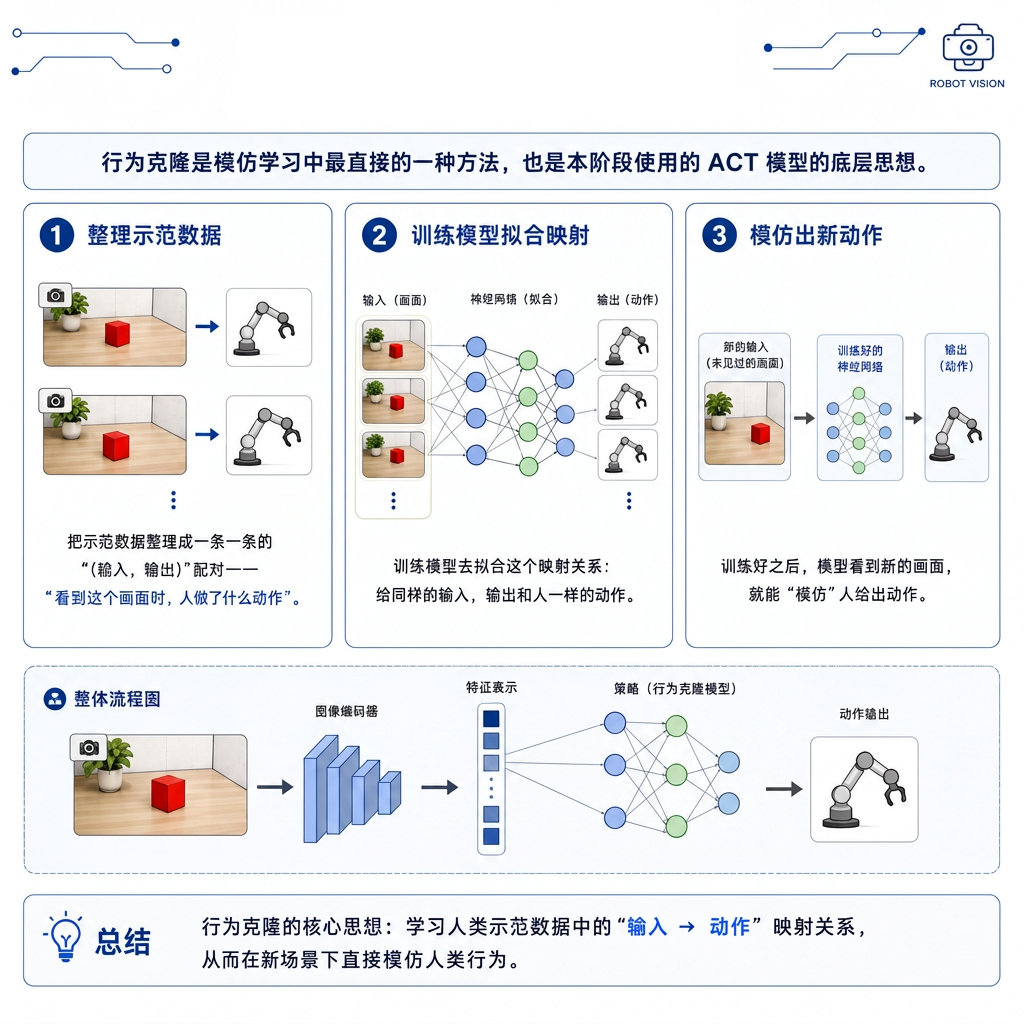
行为克隆是模仿学习中最直接的一种方法,也是本阶段使用的 ACT 模型的底层思想。它的逻辑是:
- 把示范数据整理成一条一条的"(输入,输出)"配对——"看到这个画面时,人做了什么动作";
- 训练模型去拟合这个映射关系:给同样的输入,输出和人一样的动作;
- 训练好之后,模型看到新的画面,就能"模仿"人给出动作。
Observation、State 和 Action
模仿学习的全部数据,都可以归到三个概念里。这三个词在后面的每一章都会反复出现,务必在这里建立准确的直觉。
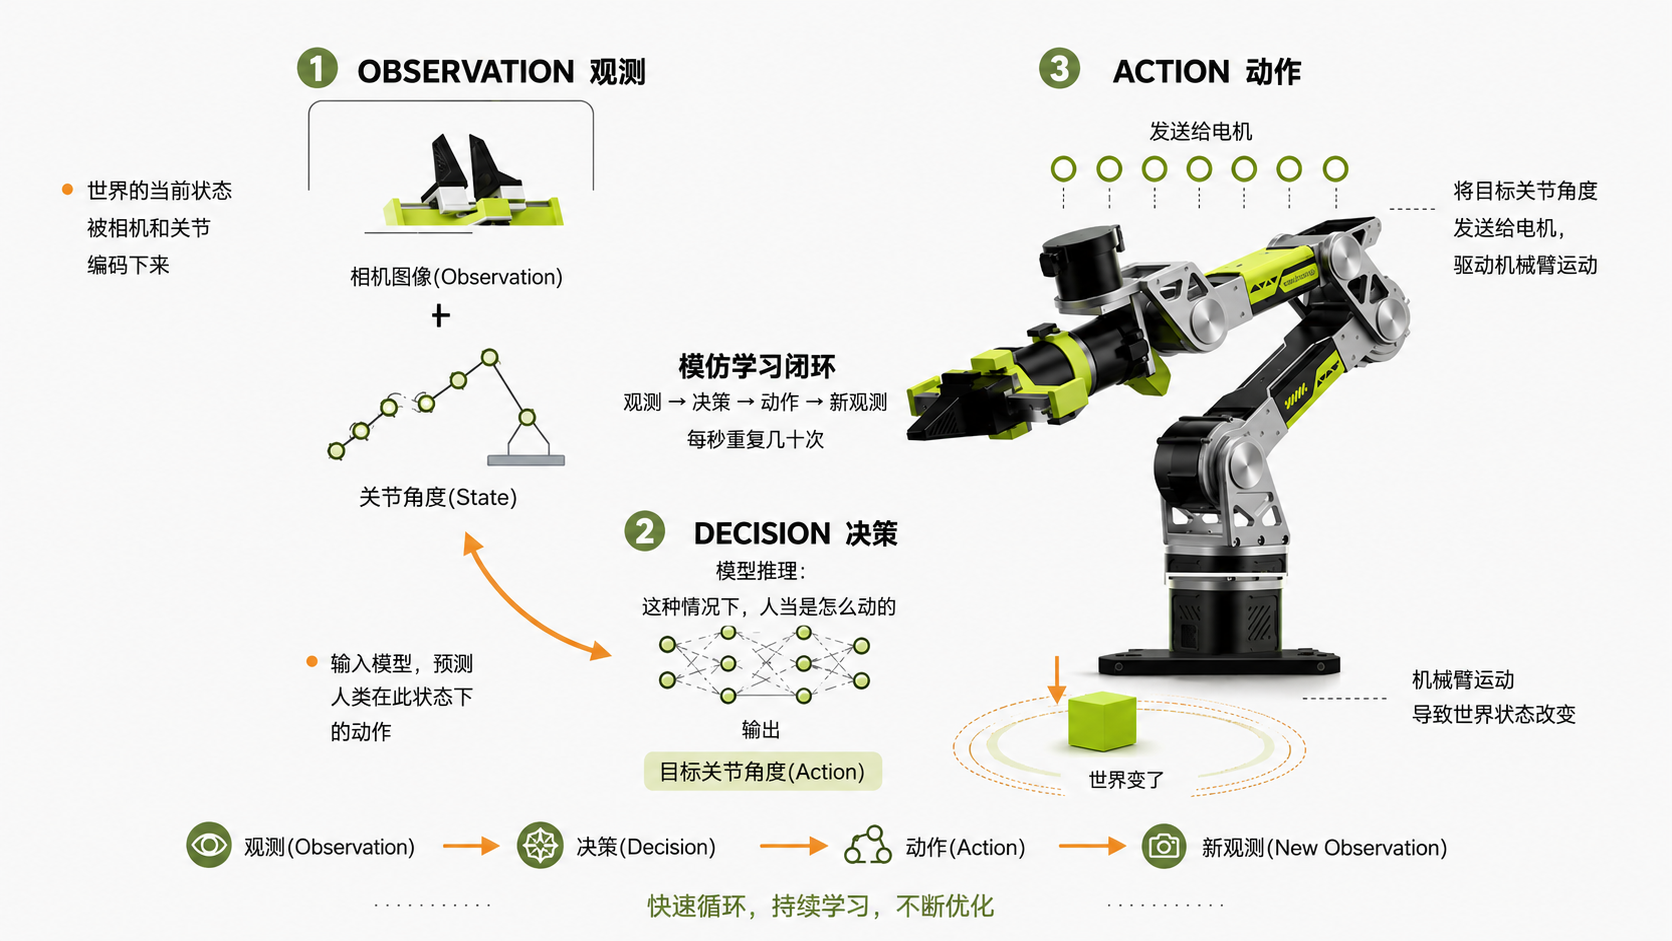
Observation(观测):机器人"看到"的世界
-
Observation 是机器人通过传感器获得的关于外部环境的信息。你可以把它理解为机器人的"眼睛"。它告诉机器人世界现在是什么样子,对 reBot Arm 来说也就是:
- 前置相机(俯拍)看到的全局画面:桌面上有什么物体、在哪个位置;
- 腕部相机(装在机械臂末端)看到的近距离画面:夹爪和目标之间的相对关系。
State(状态):机器人"自己"的样子
-
State 是机器人对自身状态的描述,和外部环境无关。这相当于人类的本体感觉——你闭上眼睛也知道自己的手在哪、胳膊弯了多少度,State 告诉机器人自己现在是什么姿态,对 reBot Arm 来说,State 就是:
- 6 个关节当前的角度;
- 夹爪当前的开合程度。
Action(动作):机器人"要做"的事
-
Action 是模型输出的、发给机械臂的执行指令。注意一个关键细节:在 reBot Arm 上,State 和 Action 的维度是一样多的(都是 6 个关节 + 1 个夹爪)。State 是"现在在哪儿",Action 是"下一步要去哪儿"。:
- 6 个关节的目标角度;
- 夹爪的目标开合程度。
单步动作与 Action Chunk
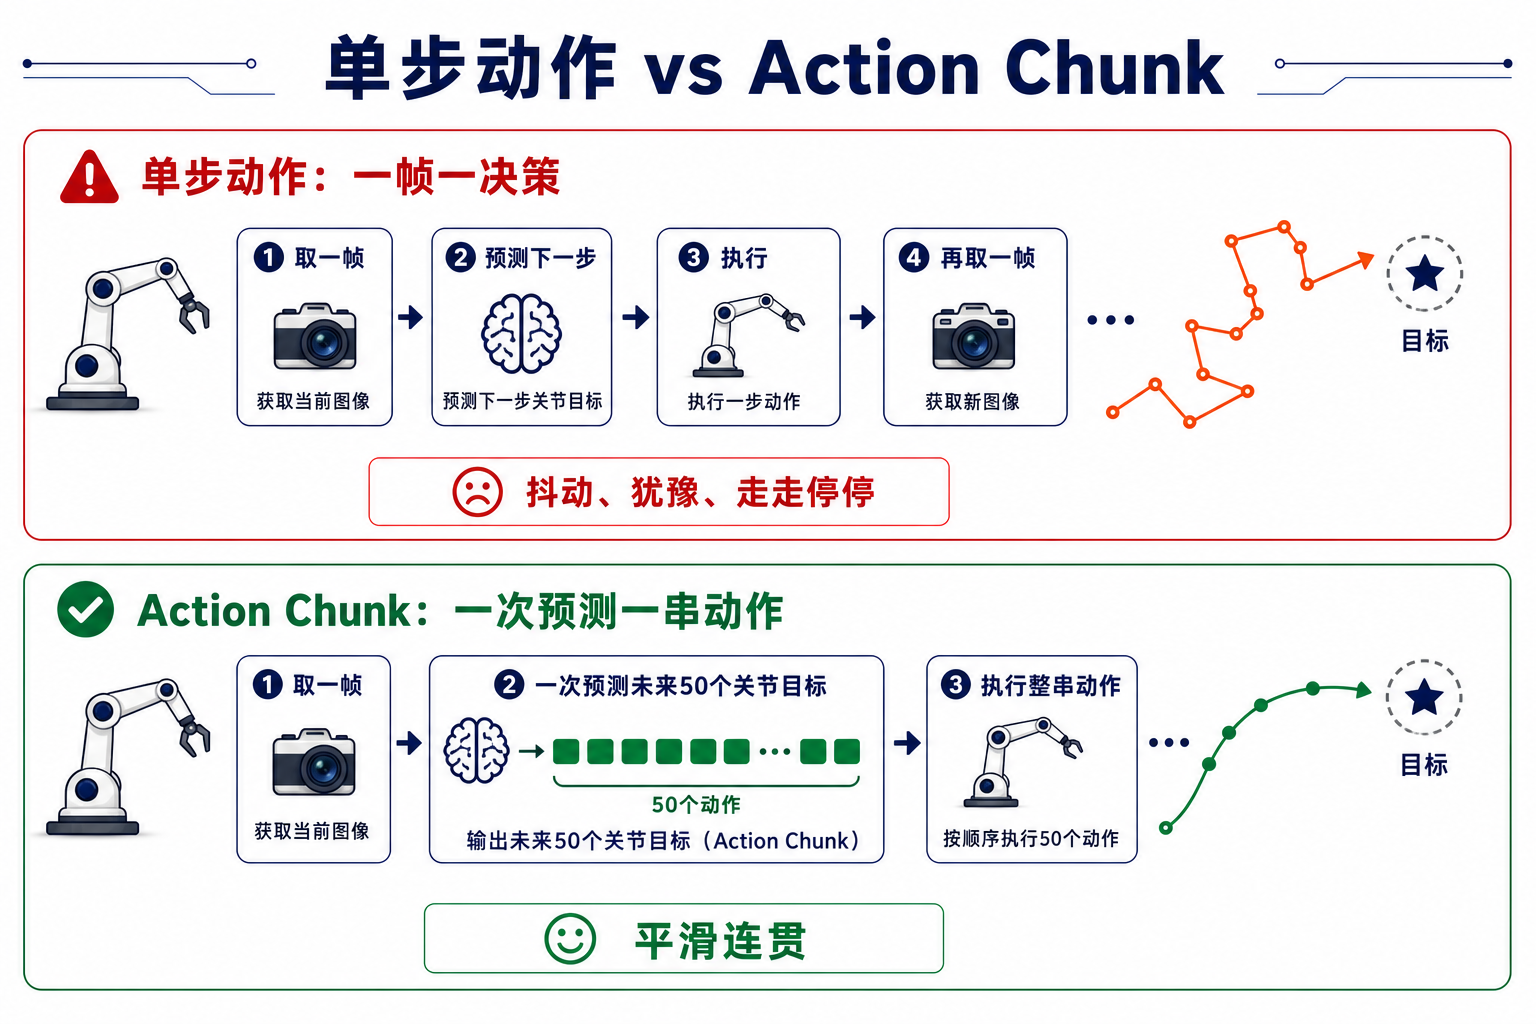
单步动作:一帧一决策
-
每一帧画面,模型预测下一个瞬间的关节目标,机械臂执行,然后取下一帧再预测。
- 单步动作有一个明显的缺陷。模型每一步都可能有一点点偏差,而每一步的偏差都会改变机械臂的位置,让下一帧的画面偏离训练数据见过的分布,导致下一步偏差更大。反映在机械臂上,就是动作抖动、犹豫、走走停停——就像一个人每走半步就停下来重新想一次"我接下来该迈哪条腿"。
Action Chunk:一次预测一串动作
-
让模型一次预测未来一小段时间内的一连串动作(比如未来 1 秒内的 50 个关节目标),而不是只预测下一步。
- 推理频率要求降低。 一次推理管一小段时间,即使模型推理稍慢(比如用没有顶级显卡的电脑),机械臂也能流畅运动。这对真机部署非常关键。
- 任务有"记性"。 一次预测未来一段动作,模型必须"想清楚"接下来要干什么,这让它更不容易被瞬时干扰带偏。
- 动作更平滑连贯。
当然,Action Chunk 也不是越长越好。预测得太远,环境可能在中途发生变化(比如物体被碰了一下),而机械臂还在执行"过时"的动作。实际系统会采用开环执行一小段、然后重新观测再预测的折中方案。
数据分布与模型泛化:模型的能力边界在哪
这是本章最重要的一节,也是初学者最容易忽视、却在实践中决定成败的一节。请先记住一句话:
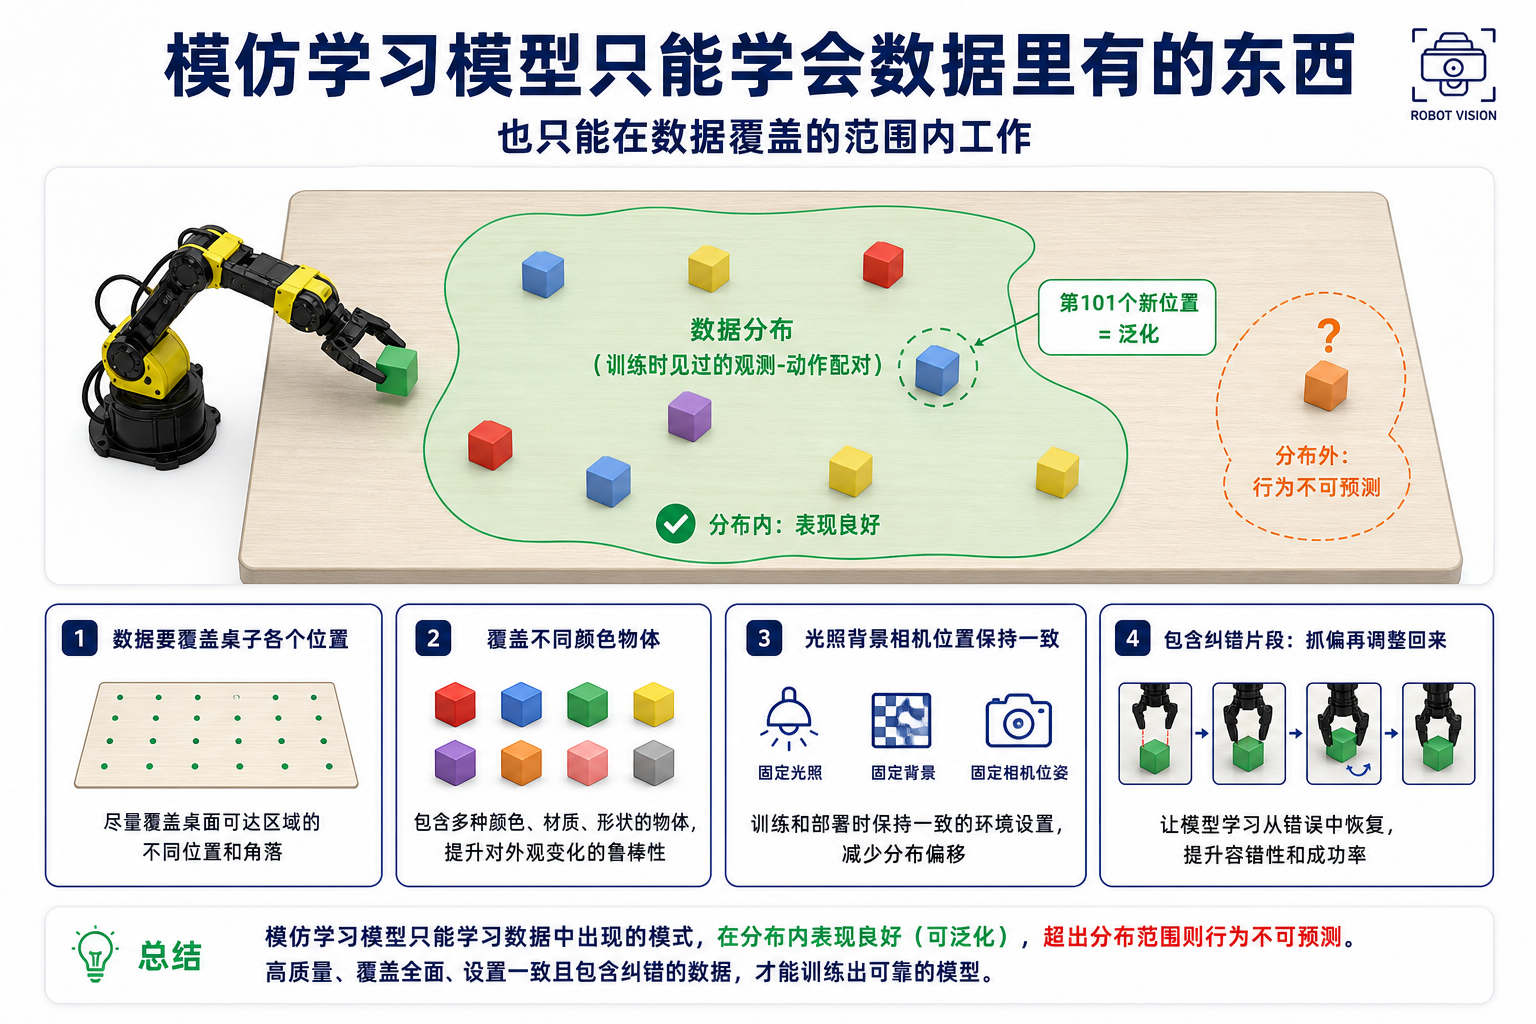
模仿学习模型只能学会数据里有的东西,也只能在数据覆盖的范围内工作。
- 模型训练时见过的所有"(观测,动作)"配对,构成了一个数据分布(Data Distribution)。推理时,如果机械臂遇到的画面和状态落在这个分布之内,模型通常表现良好;一旦跑出分布之外,模型的输出就失去依据,行为变得不可预测。
这带来几个非常实际的推论:
- 想让它在桌子的任何位置抓方块,数据里就要覆盖桌子的各个位置**。** 只在桌子中央采数据,模型就只会抓中央。
- 想让它抓不同颜色的物体,数据里就要有不同的颜色**。** 否则换一个颜色,对它来说就是陌生世界。
- 光照、背景、相机位置都要尽量和数据采集时保持一致**。** 下午采集的数据训练出的模型,在晚上的灯光下可能完全失效。
而泛化,就是模型把数据中学到的规律,应用到分布内、但从未逐一见过的新情况的能力。比如训练时见过方块在 100 个不同位置,推理时方块出现在第 101 个位置(仍在桌面上),模型依然能抓——这就是泛化。泛化不是魔法,它来自数据的多样性:数据覆盖越丰富、越连续,分布内的"空隙"就越小,泛化就越好。
模仿学习的上限,在采集数据的那一刻就已经基本决定了。 训练只是把这个上限兑现出来。
训练、推理和评估:模仿学习的三个阶段
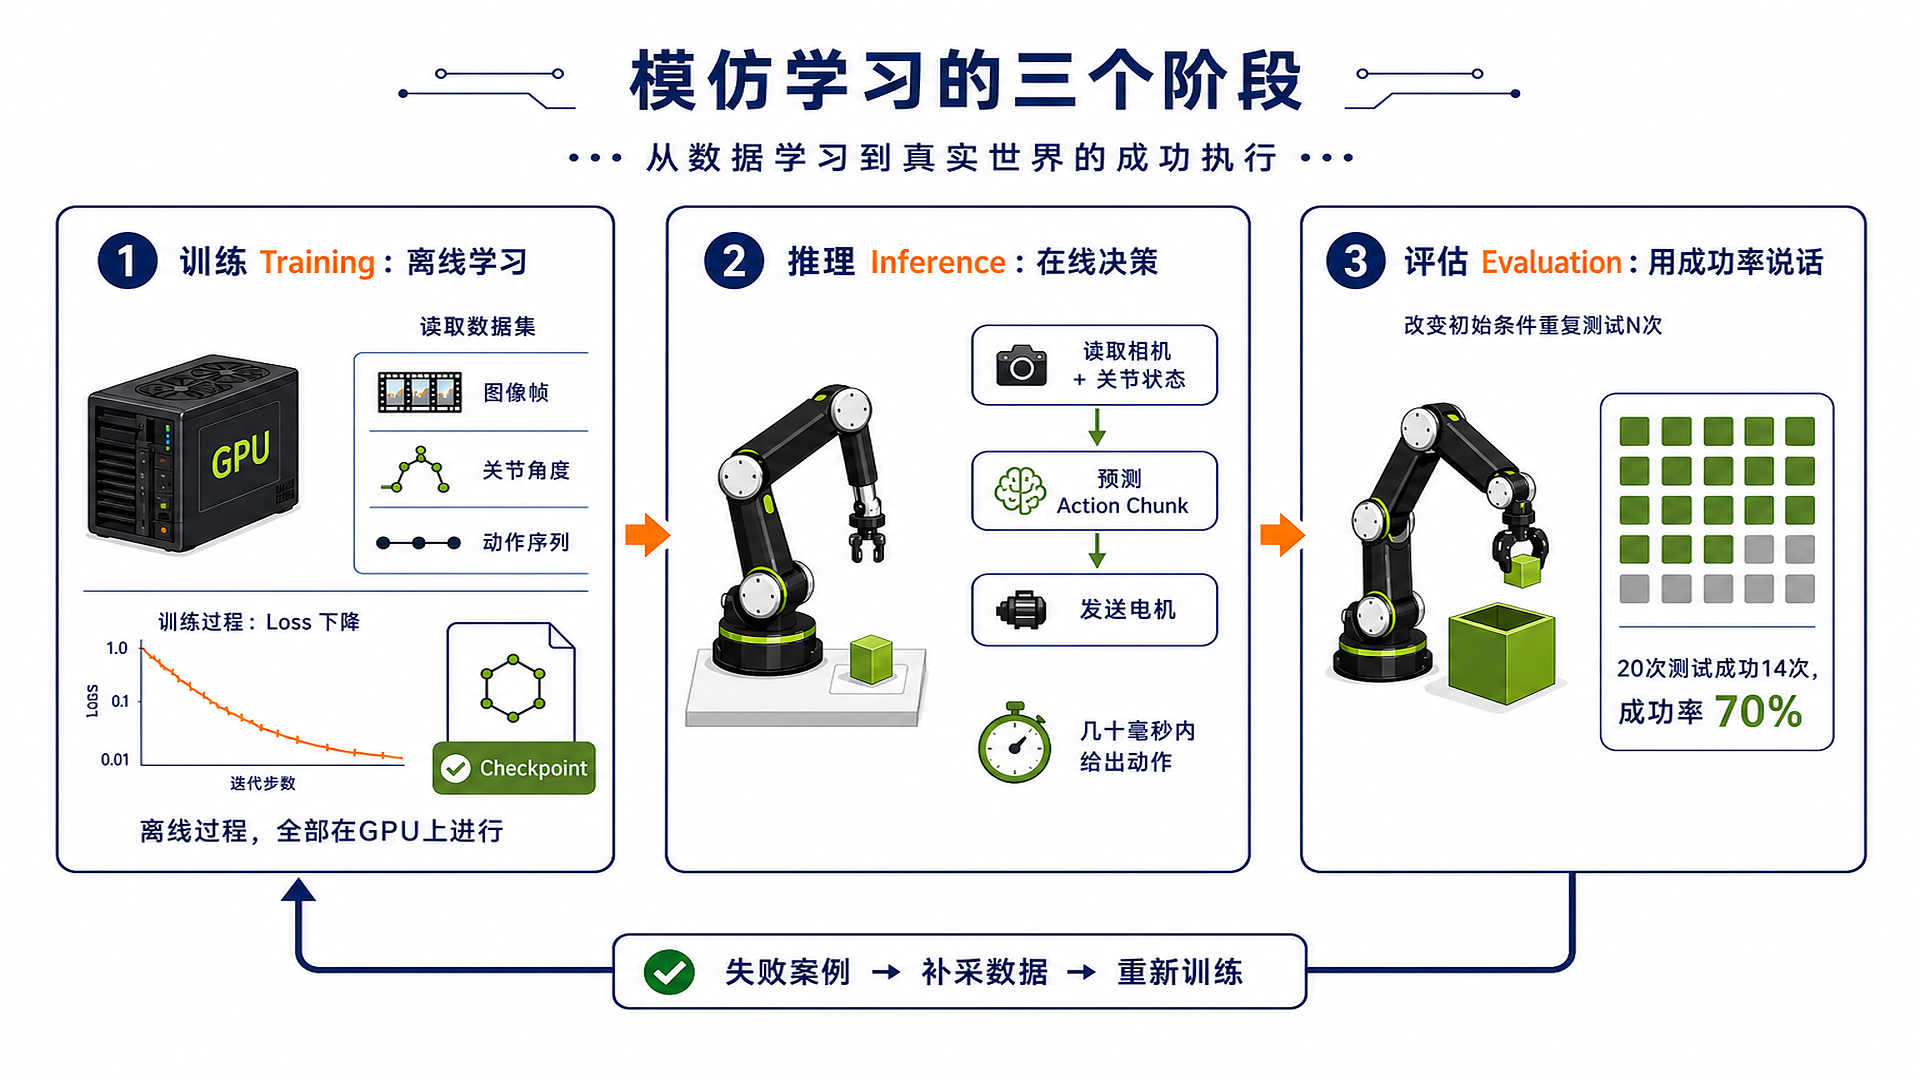
训练:离线学习
训练发生在数据采集完成之后,是一个离线过程:机械臂可以断电放在一边,全部工作在 GPU 上进行。
- 输入:采集好的数据集(图像、State、Action 的时间序列);
- 过程:模型反复读取数据,不断调整内部参数,让自己预测的 Action 越来越接近人类的示范;
- 输出:一个训练好的模型文件。
训练的好坏主要通过 Loss(损失值) 观察:Loss 下降,说明模型预测的动作和人类示范越来越像。
推理:在线决策
- 推理是模型部署上真机、实时工作的过程,也就是:读取相机和关节状态 → 模型预测 Action Chunk → 发送给电机执行。推理对实时性有要求——模型必须在几十毫秒内给出动作,否则机械臂会卡顿。
评估:用成功率说话
模型训练好了,Loss 也很低,它能干活吗?不一定。Loss 低只说明模型"像人",不说明它"能完成任务"。 评估的唯一可靠方法是真机测试:
- 设定明确的任务成功标准(比如"方块最终进入盒子");
- 改变初始条件(方块位置、光照),重复测试 N 次;
- 统计任务成功率,例如 20 次测试成功 14 次,成功率 70%。
评估发现的失败案例不是终点,而是下一轮数据采集的输入——哪里失败,就补采哪里的数据,然后重新训练。这就是数据迭代闭环,也是真实机器人学习项目的日常。
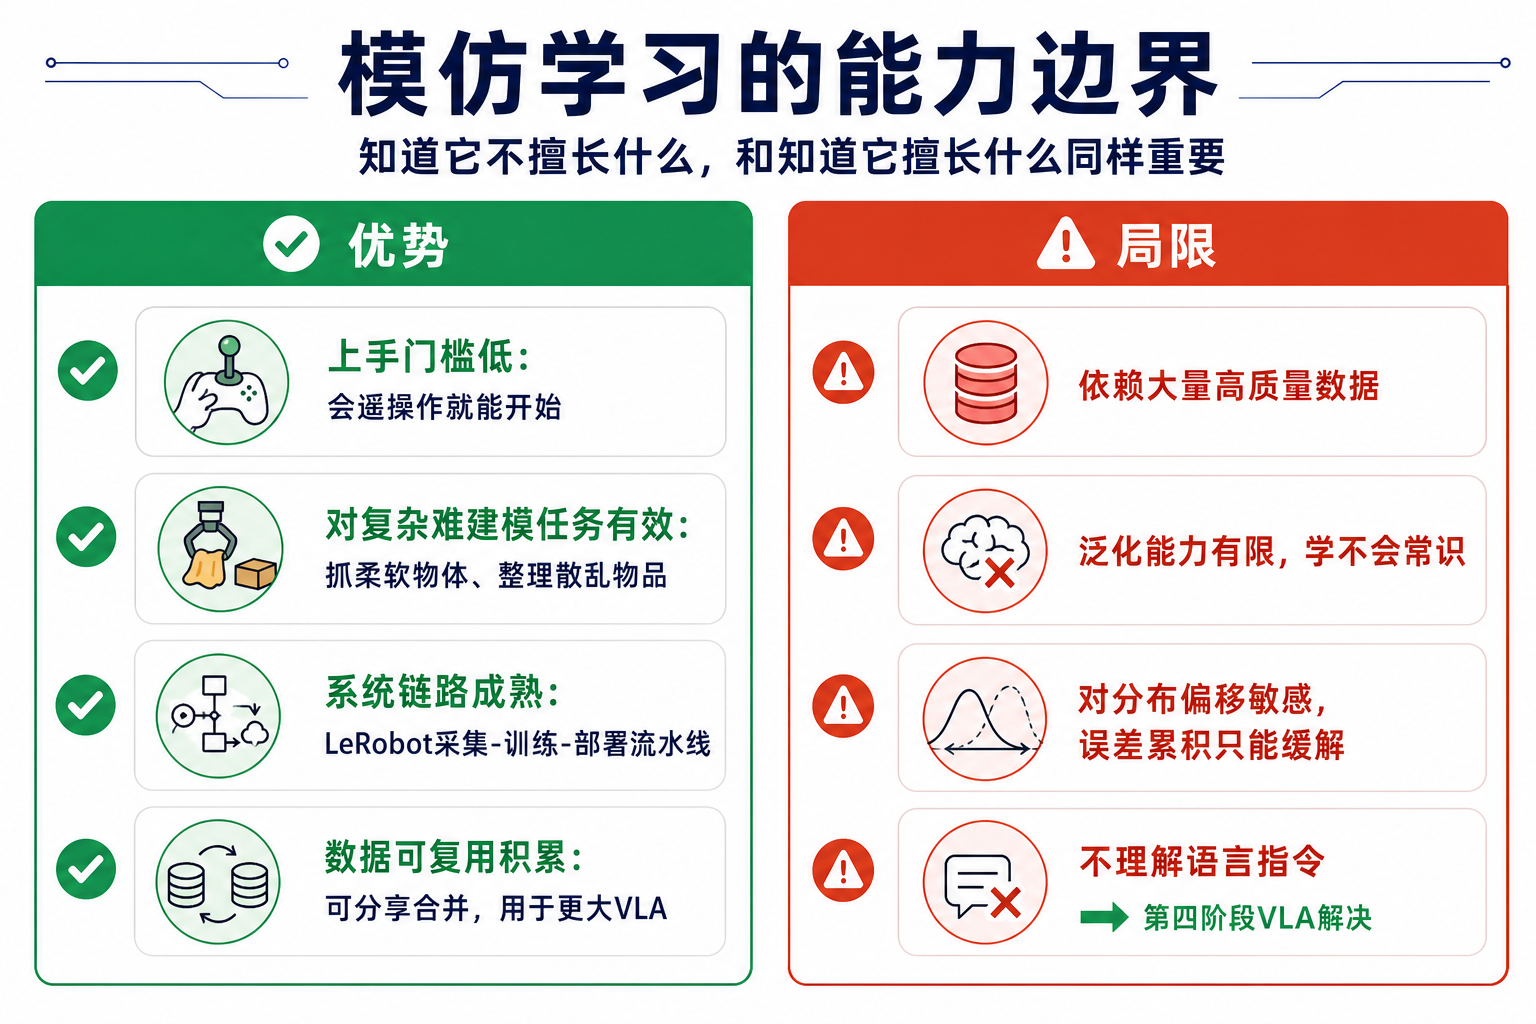
模仿学习的优势与局限