14. ACT 模型与动作分块
ACT 的输入与输出、ResNet 与 Transformer 的内部结构、注意力的直觉、CVAE、动作分块与动作视界的区别、对抗误差累积的两道防线,以及 ACT 的能力边界。
从行为克隆到 ACT
第 8 章讲过行为克隆:把遥操作示教录成数据集,让模型学"看到什么就做什么"。但留下一个问题 —— 什么样的模型配得上这些数据?一个能落地的策略模型至少要迈过三道坎:
- 看得懂图像;
- 想得有条理;
- 顶得住误差累积。
ACT(Action Chunking with Transformers) 就是为迈过这三道坎而生的策略模型。它由斯坦福团队于 2023 年提出,最早在低成本双臂平台 ALOHA 上以开杯盖、封口袋等精细操作成名;后来的 Mobile ALOHA 展示了炒虾等复杂任务。如今它作为标准策略之一内置在 LeRobot 中 —— 也是本阶段你将亲手训练与部署的模型。
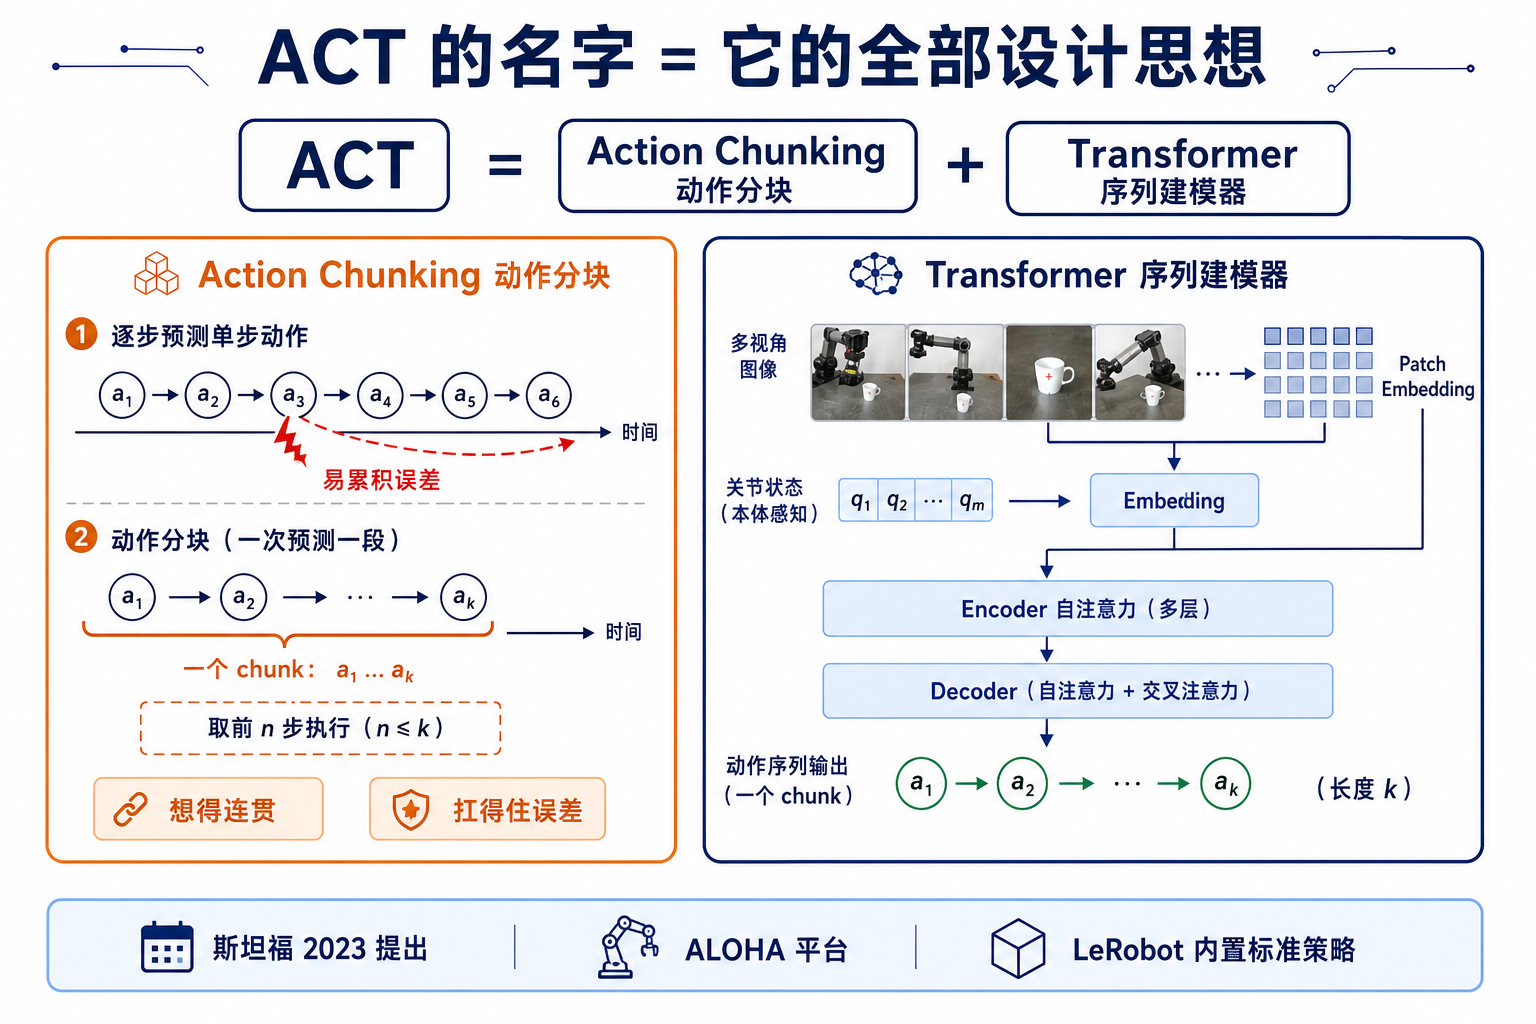
ACT 的名字就是它的全部设计哲学:Action Chunking + Transformer(序列建模器)。本章剩余部分拆解这两个词。
ACT 的输入与输出
理解任何模型最可靠的方法是先看它的"接口" —— 吃什么、吐什么。
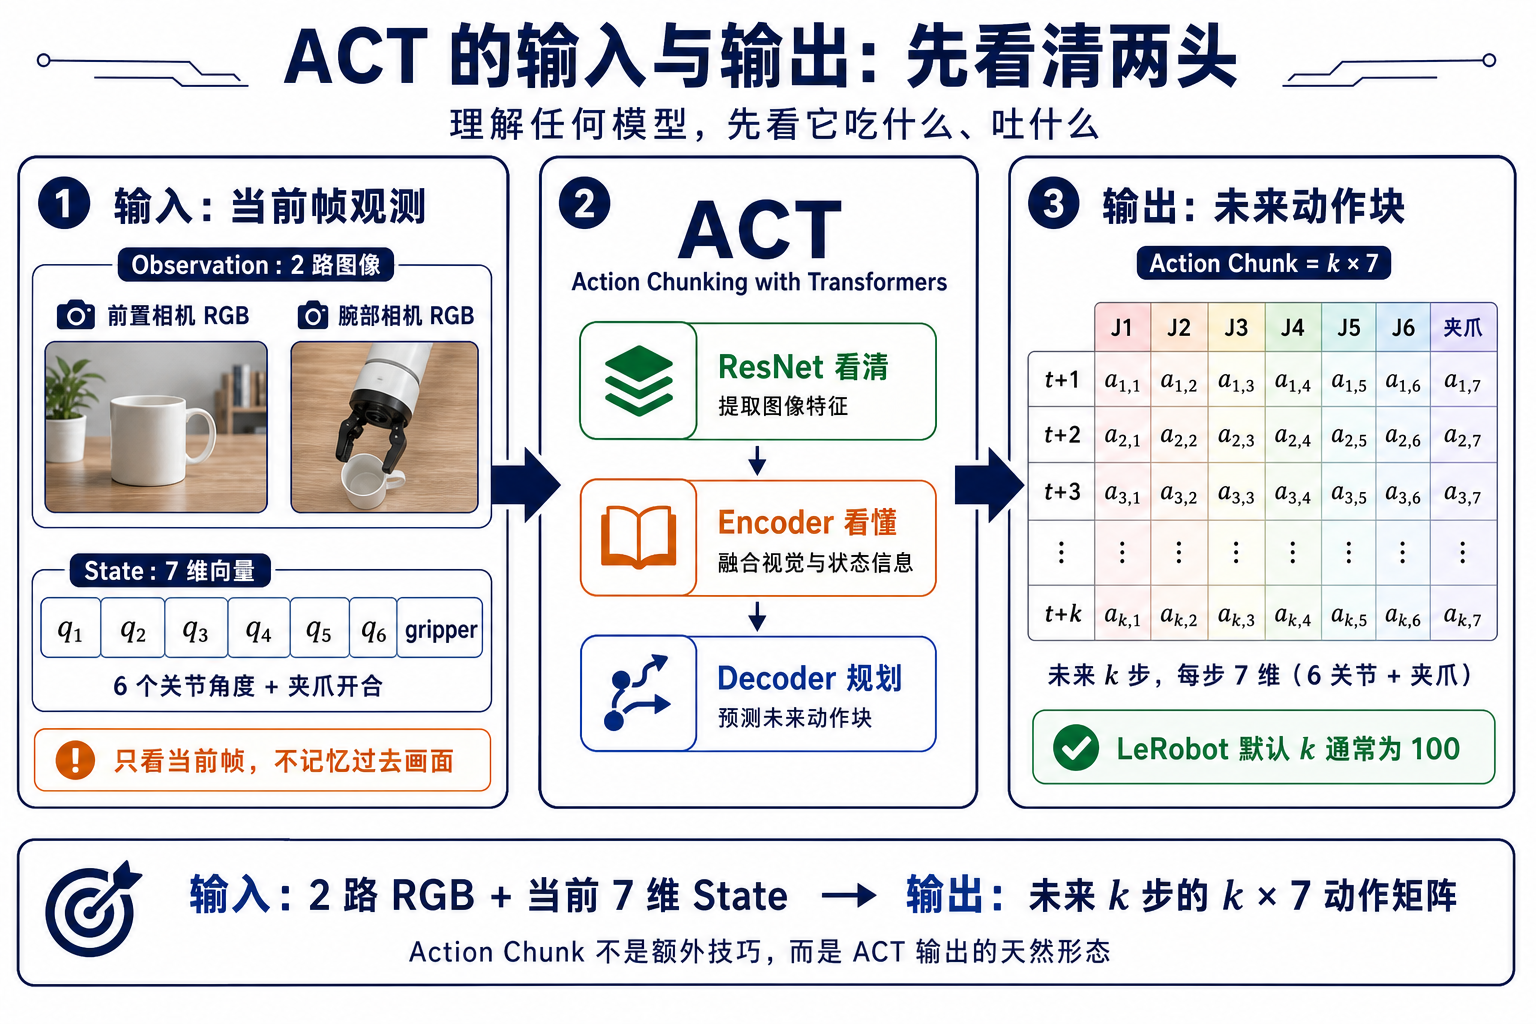
输入:当前观测
推理时,ACT 收到一帧观测,含两类信息:
| 输入 | 在 SO-ARM 上 | 维度 |
|---|---|---|
| 图像(观测) | 前视 + 侧视双路 RGB | 2 × 图像 |
| 关节状态(状态) | 5 个关节角 + 夹爪开合 | 6 维向量 |
注意 ACT 是单帧模型:它不记得过去的帧;每次决策只基于"现在看到的 + 关节现在在哪"。
输出:短未来窗口的动作分块
ACT 的输出不是下一个动作,而是整整一块动作序列(Action Chunk):
输入:2 路图像流 + 6 维关节状态(当前帧)
输出:未来 k 步的动作序列,每步 6 维(5 关节 + 夹爪)
      即一个 k × 6 的动作矩阵
在 LeRobot 的 ACT 默认配置中,k(chunk size)通常为 100 —— 一次推理给出未来约 100 个时间步的完整动作计划。这回应了第 8 章埋下的伏笔:动作分块不是抽象的优化技巧,它就是 ACT 的天然输出形式。
ACT 内部结构
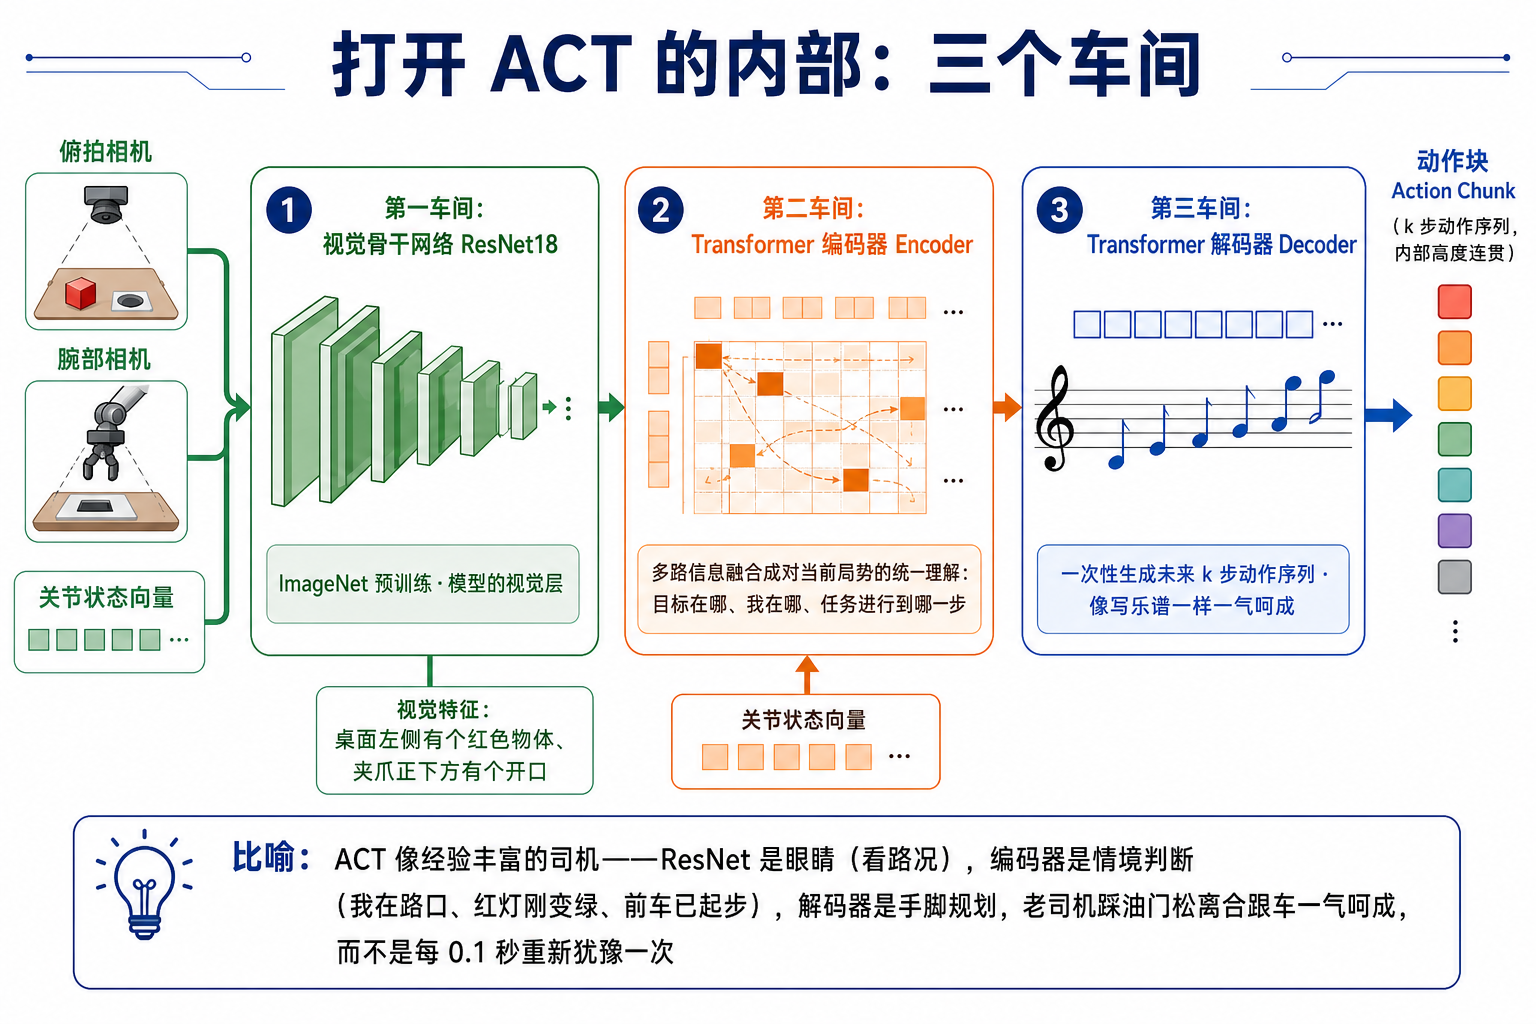
车间一:视觉骨干(ResNet)—— 从像素到特征
前视与侧视图像各自经过一个 ResNet18(在 ImageNet 上预训练的 CNN),压缩成一组视觉特征。可以把 ResNet 理解为模型的"视觉皮层":原始像素对它没有意义;它提取的是"桌子左边有个红色物体""夹爪正下方有个开口"这类结构化信息。
车间二:Transformer 编码器 —— 理解"现在"
视觉特征 + 关节状态向量汇合,进入 Transformer 编码器。编码器的职责是把多路信息融合成对当前局面统一的理解:"目标在哪、我在哪、任务进行到哪一步"。
车间三:Transformer 解码器 —— 规划"未来"
解码器拿着编码器的理解,一次性生成未来 k 步的动作序列。它不是一条一条往外吐动作,而是像写乐谱一样一口气写完整段"未来动作" —— 这就是动作分块内部高度连贯的根本原因。
什么是 Transformer
ACT 的车间二和车间三都是 Transformer,那 Transformer 到底是什么?
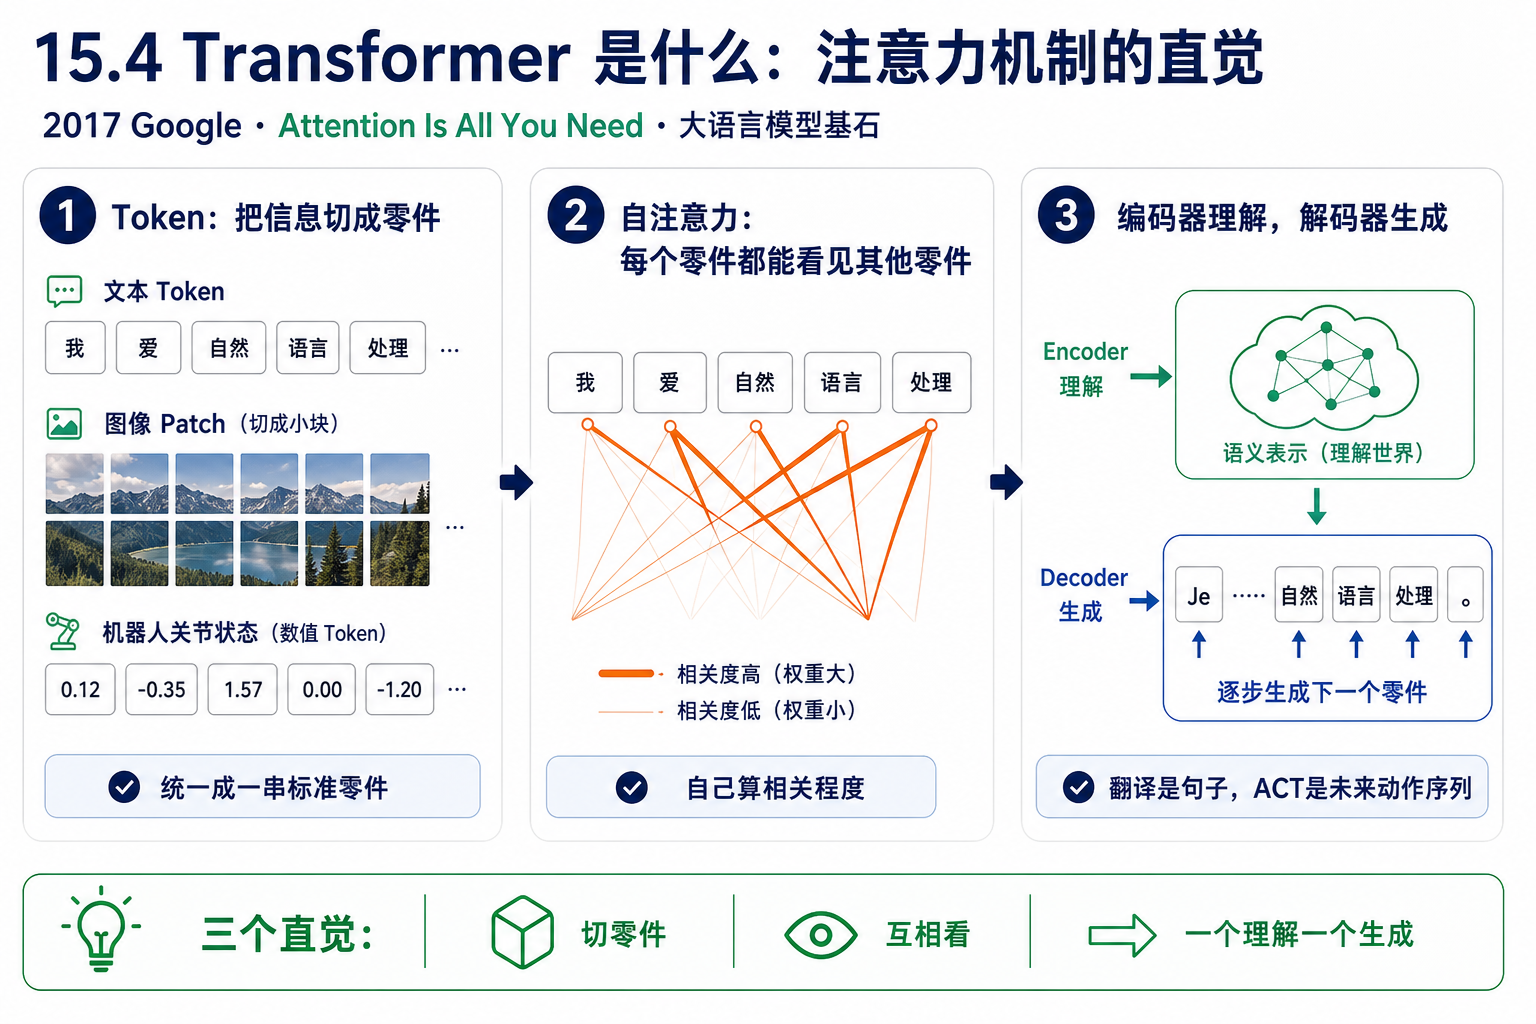
它由 Google 于 2017 年为机器翻译提出,论文标题是"Attention Is All You Need",后来成为大语言模型的基础架构。不需要公式 —— 三个直觉就够:
- Token:把信息切成"零件"。 Transformer 不直接处理原始句子或原始像素,而是先把输入切成标准化的零件(token) —— 句子切成词、图像切成 patch,一个关节状态向量也可以是一个 token。所有信息统一成"零件的序列"后,同一套机制就能处理它们;
- 自注意力:每个零件都能"看见"其他所有零件。 这是 Transformer 的核心。处理每个零件时,它计算自己与所有其他零件的相关性,把注意力集中在最相关的那些上 —— "看什么"不是人规定的,是模型自己学出来的;
- 编码器与解码器:一个理解,一个生成。 编码器把输入的零件序列融合成"对当前局面的理解";解码器拿着这个理解生成新的输出零件序列 —— 翻译里是目标语言句子,ACT 里是未来动作序列。
Transformer 在 ACT 中的用法
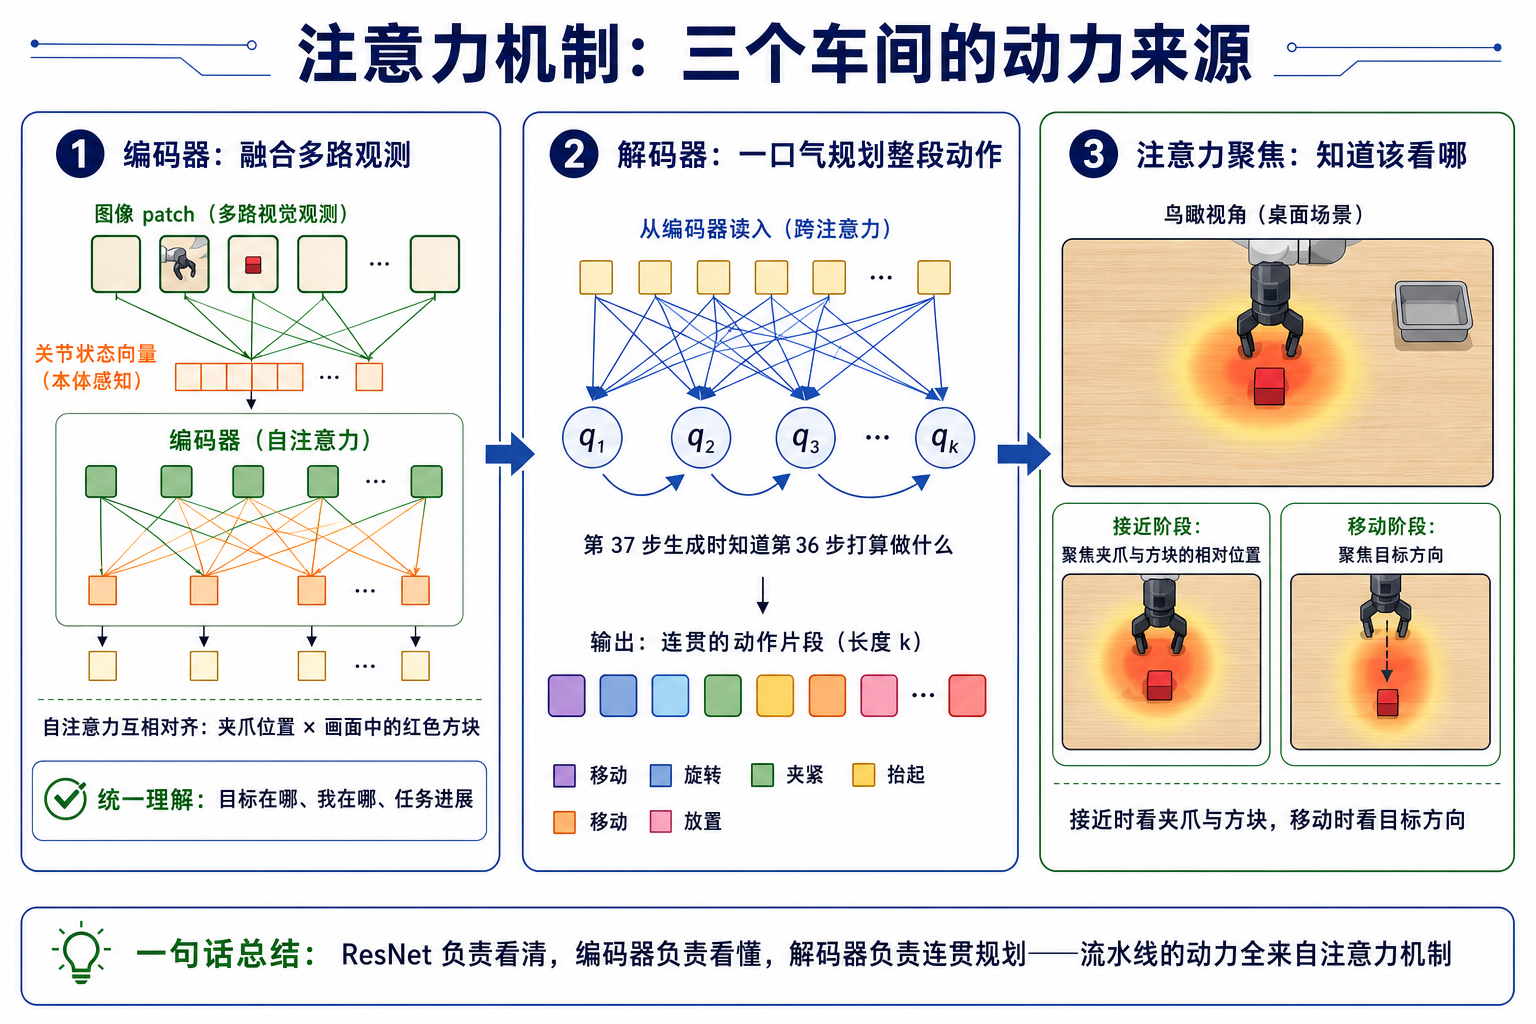
- 编码器里:融合多路观测。 两路图像(经 ResNet)的视觉特征 patch 加上关节状态向量,全部作为 token 送入编码器。自注意力把它们对齐 —— "夹爪当前位置"与"图像里那个红色方块"被关联成统一理解:目标在哪、我在哪、进行到哪一步;
- 解码器里:一次性规划整段动作。 解码器用 k 个查询向量对应未来 k 个动作步;这些查询既从编码器的理解中取信息,彼此之间也通过自注意力协调 —— 第 37 步的动作"知道"第 36 步想干什么。整块动作因此是有机的整体,而不是 100 个孤立的决策;
- 注意力聚焦:知道该"看哪里"。 生成每个动作时,模型自动聚焦到与当前动作最相关的图像区域 —— 接近目标时关注夹爪与物体的相对位置,移动中关注目标方向 —— 而不是对所有区域一视同仁。
一句话总结:ResNet 负责"看得清",Transformer 编码器负责"想得明",Transformer 解码器负责"规划得连贯" —— 驱动力都是注意力。
什么是 CVAE
CVAE(条件变分自编码器)。LeRobot 的 ACT 训练时实际带着它,只是 lerobot-train --policy.type=act 命令行里看不到。
它防的坑:均值化失手
CVAE 的作用不是把人规约成唯一正确答案,而是承认:给定当前观测,动作可以有多种风格;训练时它先辨别这条是哪种风格,再复现出那段动作序列。
论文做过对比(仿真任务):
- 如果示教是脚本式的(只有一种做法),去掉 CVAE 几乎不影响成功率;
- 换成真人数据,去掉后成功率从约 35% 跌到 2%。
所以 CVAE 不是为了让公式更花哨,而是为了让模型扛得住"人会换招、手会抖"的数据。
"条件"的意思是:生成的动作必须以当前看到的东西为依据 —— 桌上是方块还是笔,它都不能凭空编。CVAE 是"看着眼前的,谱接下来的"。
动作分块 vs. 动作视界
这是本章分辨得最清楚的一对概念,是两个独立可调的参数:
- 动作分块(Action Chunk):模型一次前向传播预测的动作序列长度,即输出矩阵的行数 k。LeRobot 中 ACT 默认 chunk size 为 100;
- 动作视界(Action Horizon):预测出这 100 步之后,实际开环执行多少步,才重新观测、重新预测。
关系是:预测的分块可以很长,但每次只信任开头一小段。
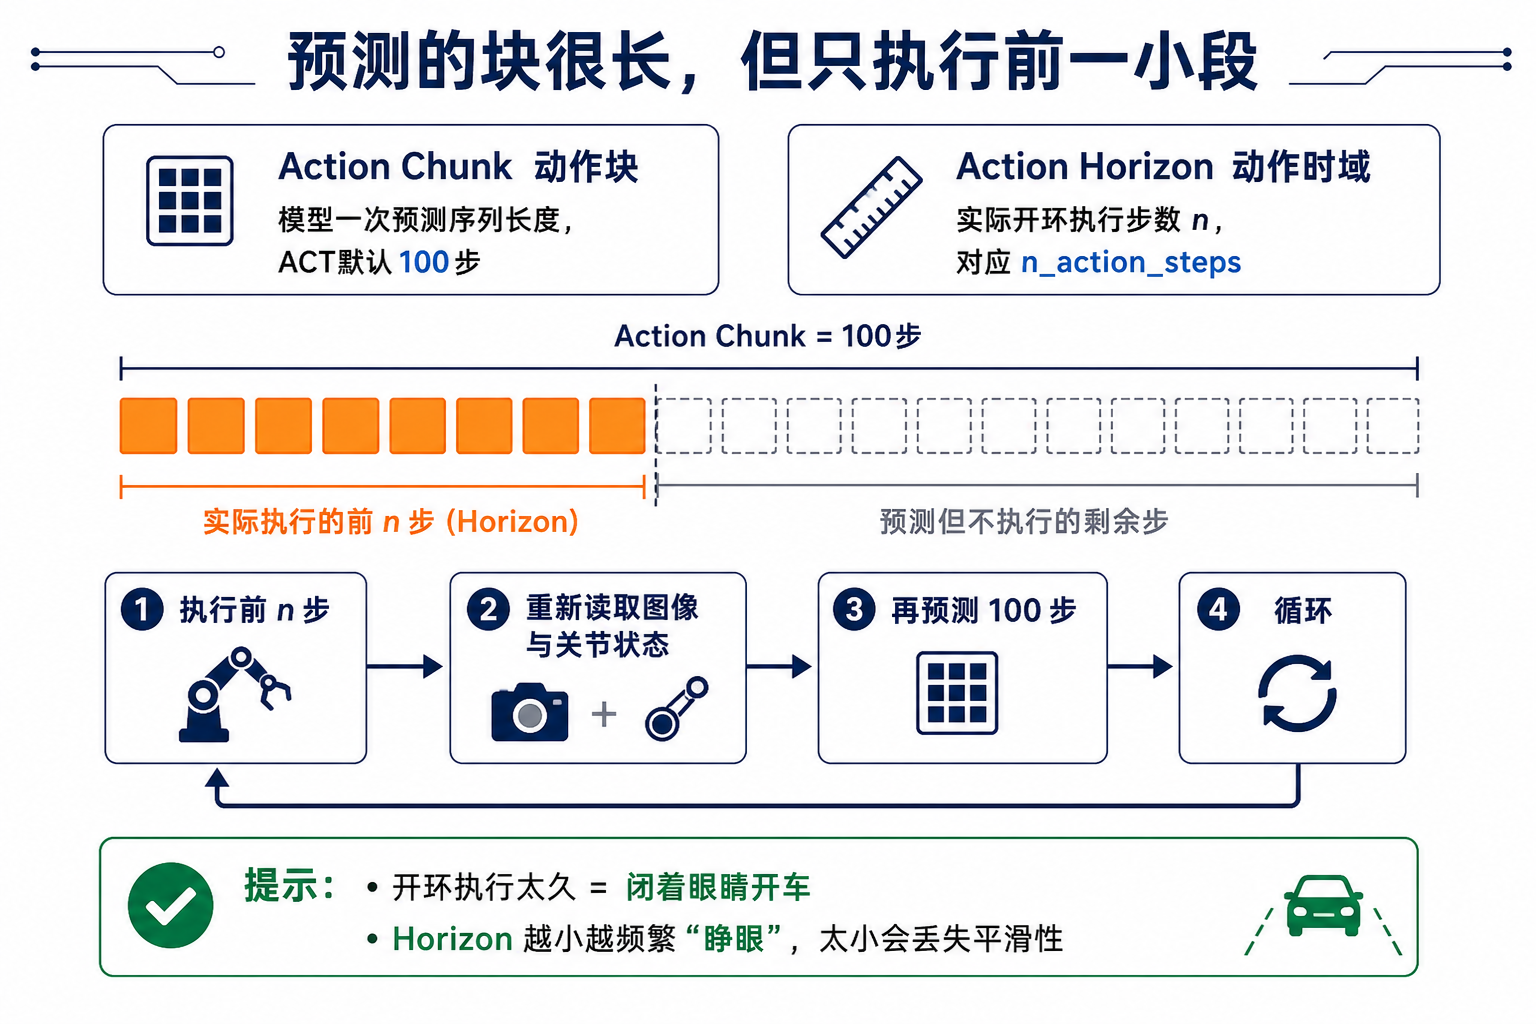
为什么不把 100 步全执行完?因为预测越远越不可靠 —— 环境会变、物体可能被碰,到后半段,模型"假设的局面"早已偏离现实。开环执行太长 = 闭着眼睛开车。 视界越小,模型越频繁"睁眼复查",对扰动越鲁棒;但太小又丢掉分块带来的平滑。
就像开车用手机导航。导航(模型)一次算好整条路线(分块),但你不会锁死方向盘 —— 每开几公里就看一眼实时路况(重新观测),导航据此重新规划(重新预测)。你"信任旧路线继续开"的距离,就是视界。
动作连续性与误差累积:ACT 的两道防线
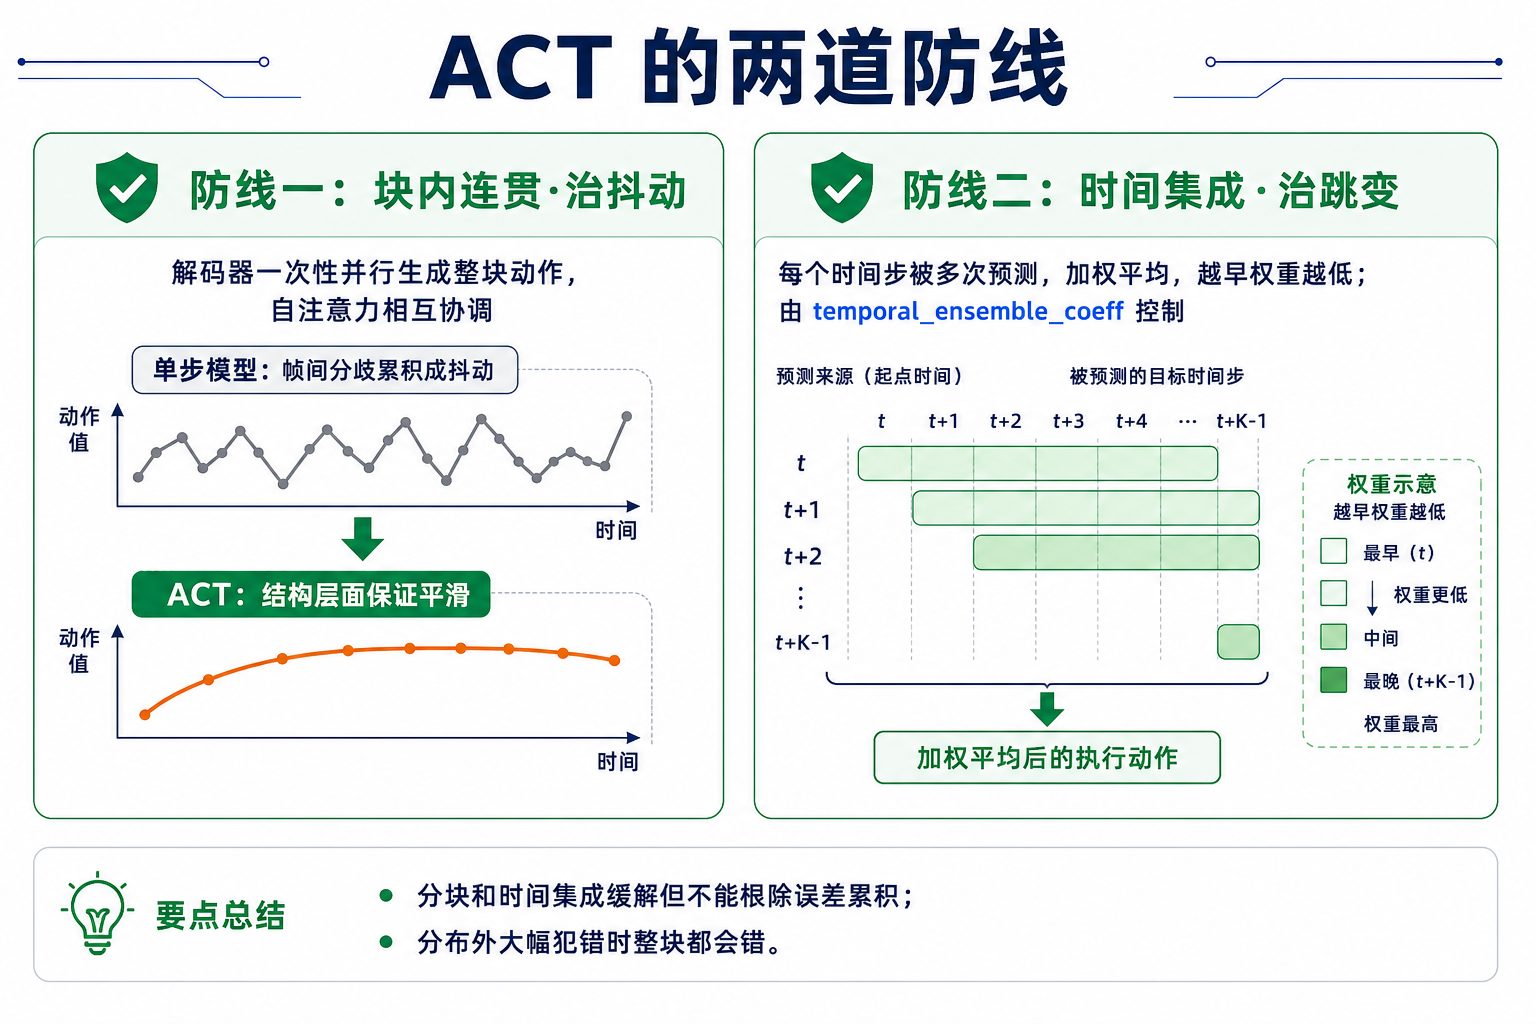
第 8 章给真机稳定性留下两个威胁:动作抖动与误差累积。现在看 ACT 如何用结构化方法应对:
- 防线一:分块内的连贯性解决抖动。
- 防线二:时间集成解决不连续。
ACT 适合什么任务?
按 ACT 的设计特点,它的"舒适区"非常清晰 —— 而 SO-ARM 恰好就在其中:
| 适合 | 原因 |
|---|---|
| 桌面操作(抓取、放置、整理、插拔) | ACT 就诞生于这类任务;数据需求与模型规模匹配 |
| 单任务或少量任务 | 行为克隆学的是任务特定的映射;任务越多数据需求越大 |
| 短任务(几秒到约 1 分钟) | 误差随时间累积;任务越短越稳 |
| 视觉信息充分的场景 | 前视 + 侧视双相机覆盖关键信息的场景 |
| 资源有限的硬件 | ACT 参数量小;消费级 GPU 可训可推;CPU 也能推理 |
ACT 的能力边界
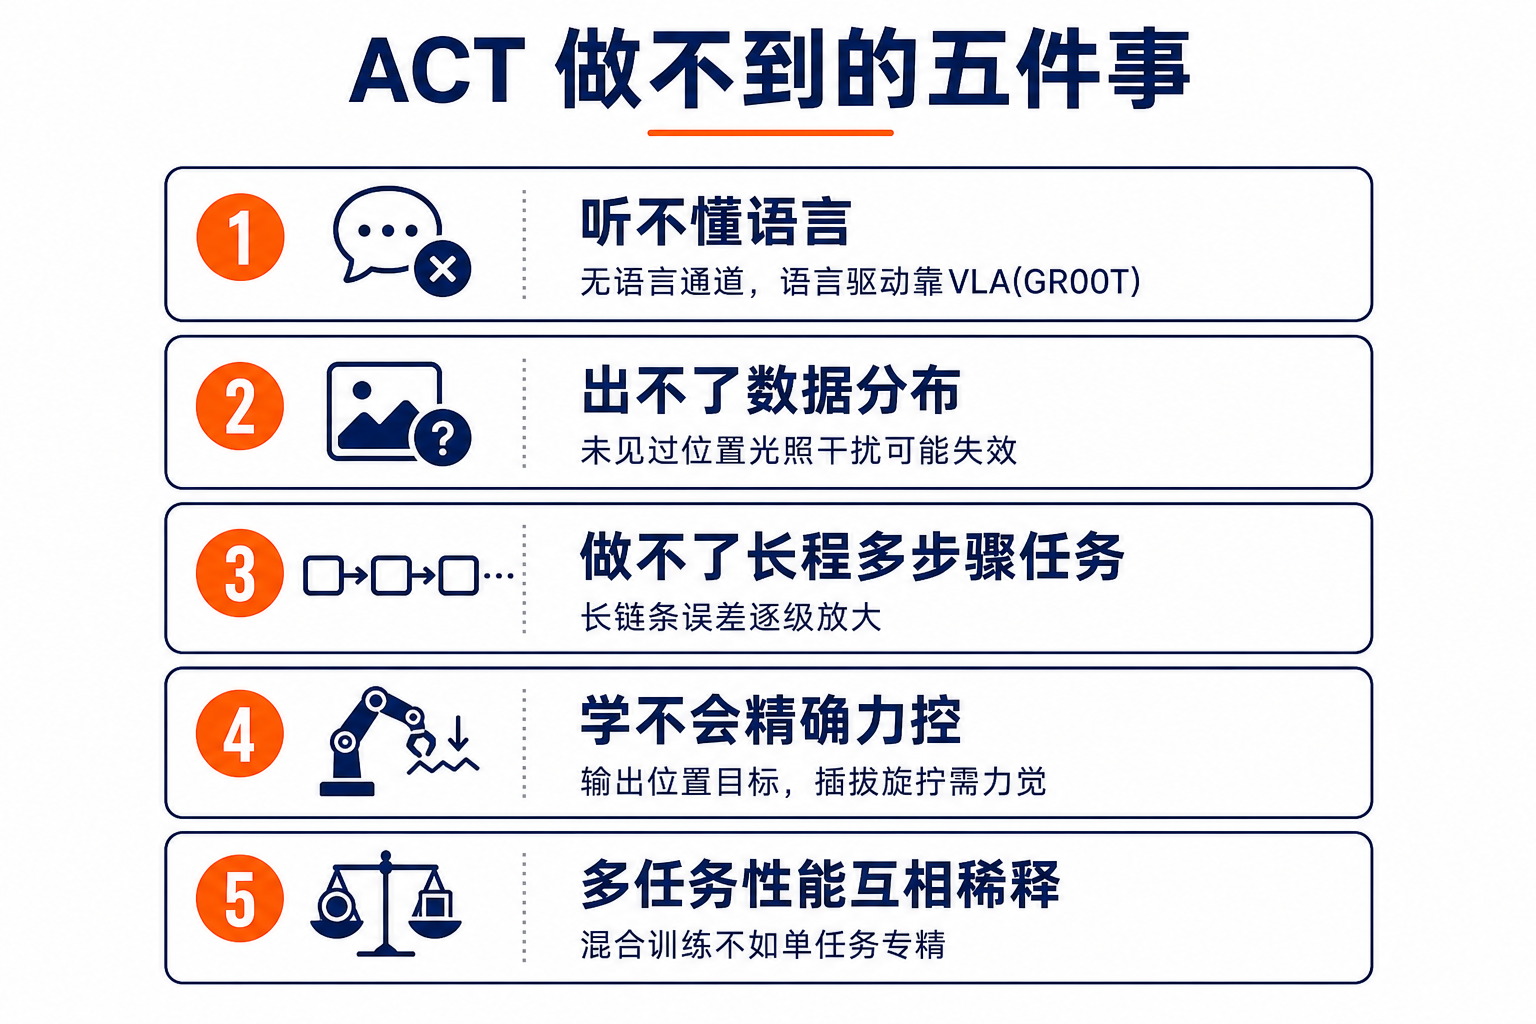
同样重要的是知道它做不到什么: