8. 机器人学习与模仿学习基础
机械臂为什么需要学习、规则控制与学习控制的对比、观测 / 状态 / 动作三个概念、动作分块、数据分布与泛化,以及训练、推理、评估三阶段。
本阶段需要的硬件
本阶段需要准备的硬件如下。全部阶段的完整清单见 第 3 章。
主控单元
| 硬件 | 购买 | 数量 |
|---|---|---|
| reComputer Robotics J4012 | 🛒 | 1 |
另外还需要一台台式机或笔记本:Ubuntu 22.04、CUDA 12+,训练建议 12GB 显存以上的 NVIDIA GPU 与 16GB 以上内存。
本阶段
| 硬件 | 购买 | 数量 |
|---|---|---|
| SO-ARM101 套件(主臂 + 从臂 + 2个摄像头及支架) | 🛒 | 1 |
| 鼠标垫 / 桌垫 | - | 1 |
为什么机械臂需要学习?
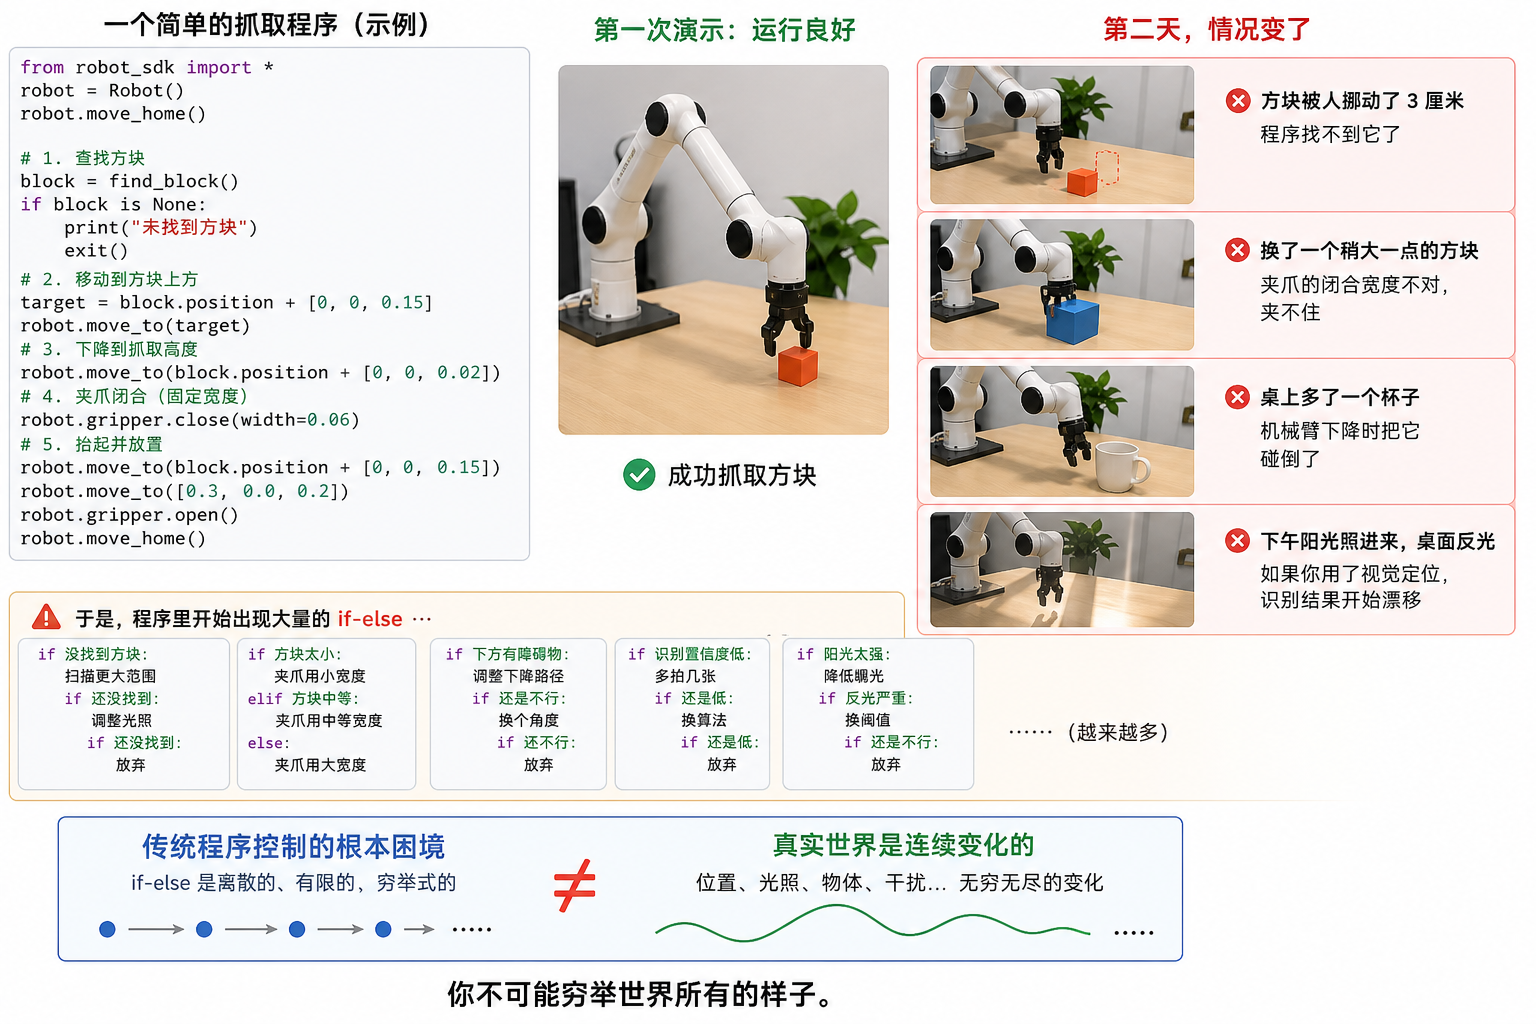
在第二阶段,你已经可以读写 SO-ARM 的每一个舵机:查询关节位置、发送目标角度、张开闭合夹爪。于是很自然地会想到 —— 写一个程序,让机械臂自动抓取桌上的方块,不就行了?
于是就有这样一个程序:实验室里第一次演示效果很好。第二天环境变了 —— 你会发现为了处理这些变化,程序里的 "if" 越加越多,最终变成一本没人维护得动的特例大全。
这就是传统程序控制的根本困境:真实世界连续变化,而 if-else 是离散的。 你无法穷举世界的所有状态。
让机械臂以这种方式习得技能,正是机器人学习(Robot Learning)要解决的问题。 而本阶段要学的模仿学习,是其中最成熟、最容易落到真机上的一条路。
规则控制 vs. 学习控制
继续之前,把两种控制方式并排放在一起看清楚:
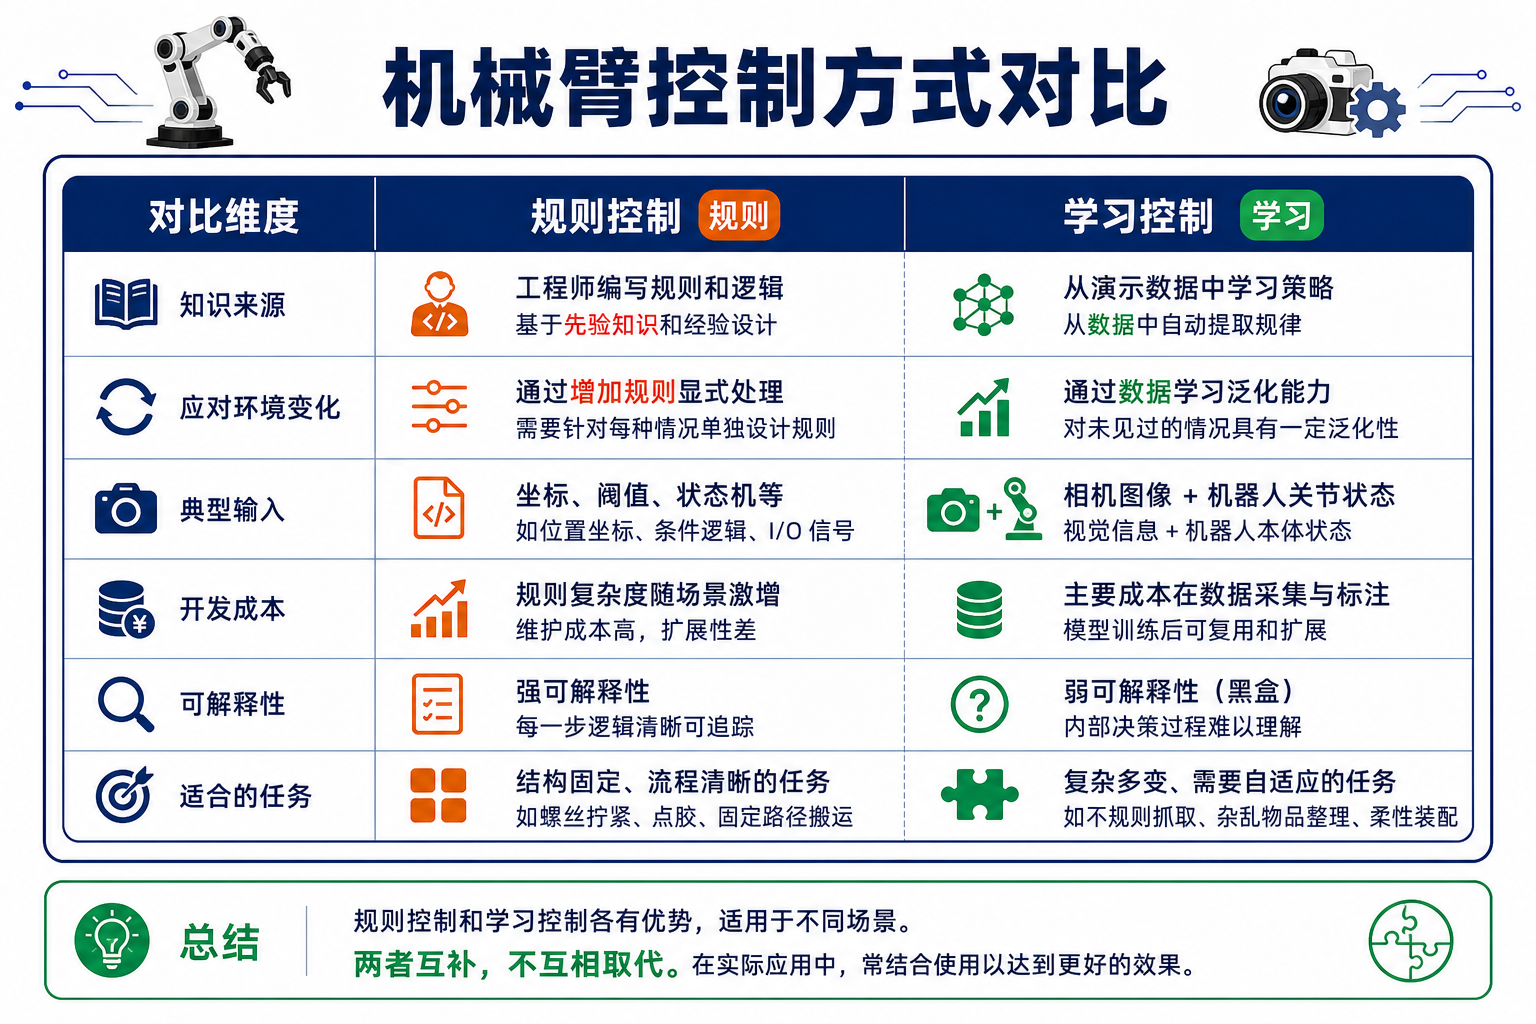
本课程的第三、四阶段走"学习控制"这条路。但请记住:即便到了未来,学习系统里仍然保留大量规则 —— 比如关节限位与安全速度约束。学习与规则是互补的。
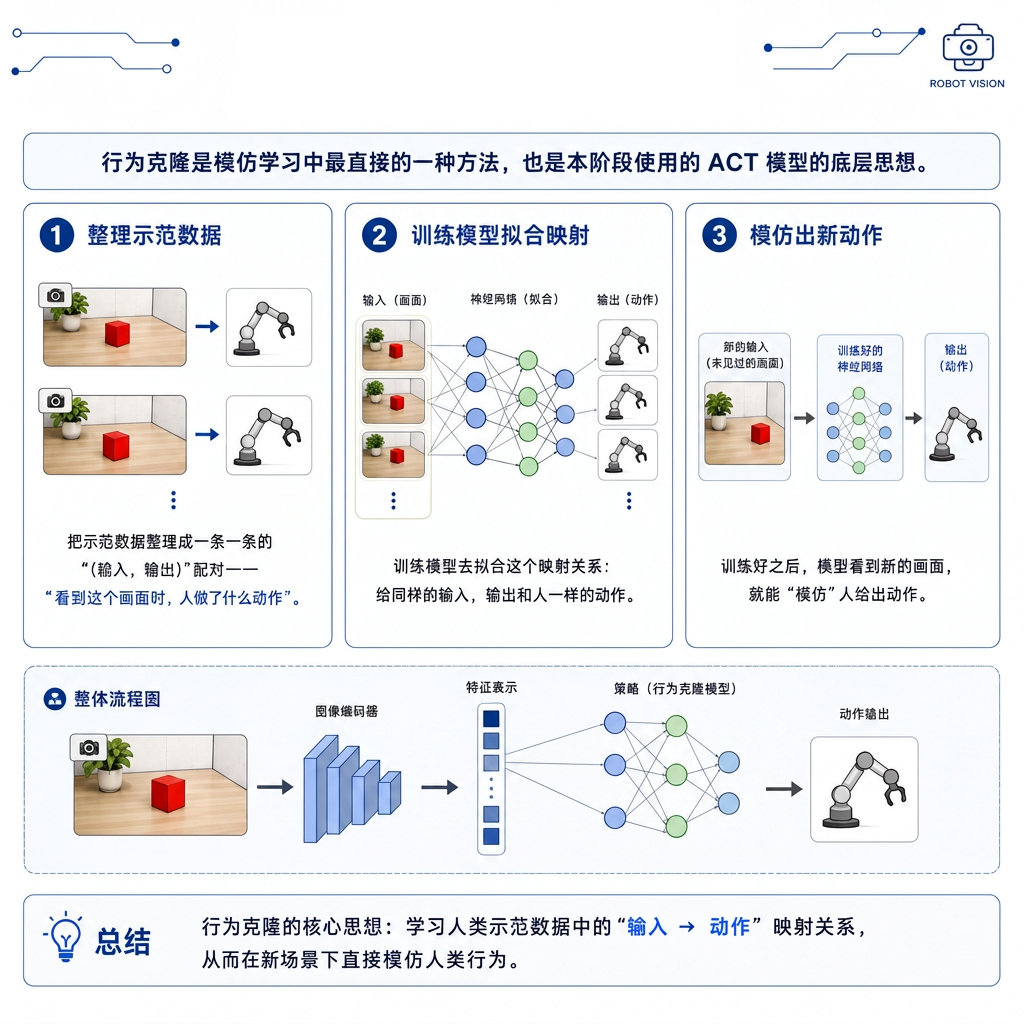
模仿学习与行为克隆
什么是模仿学习
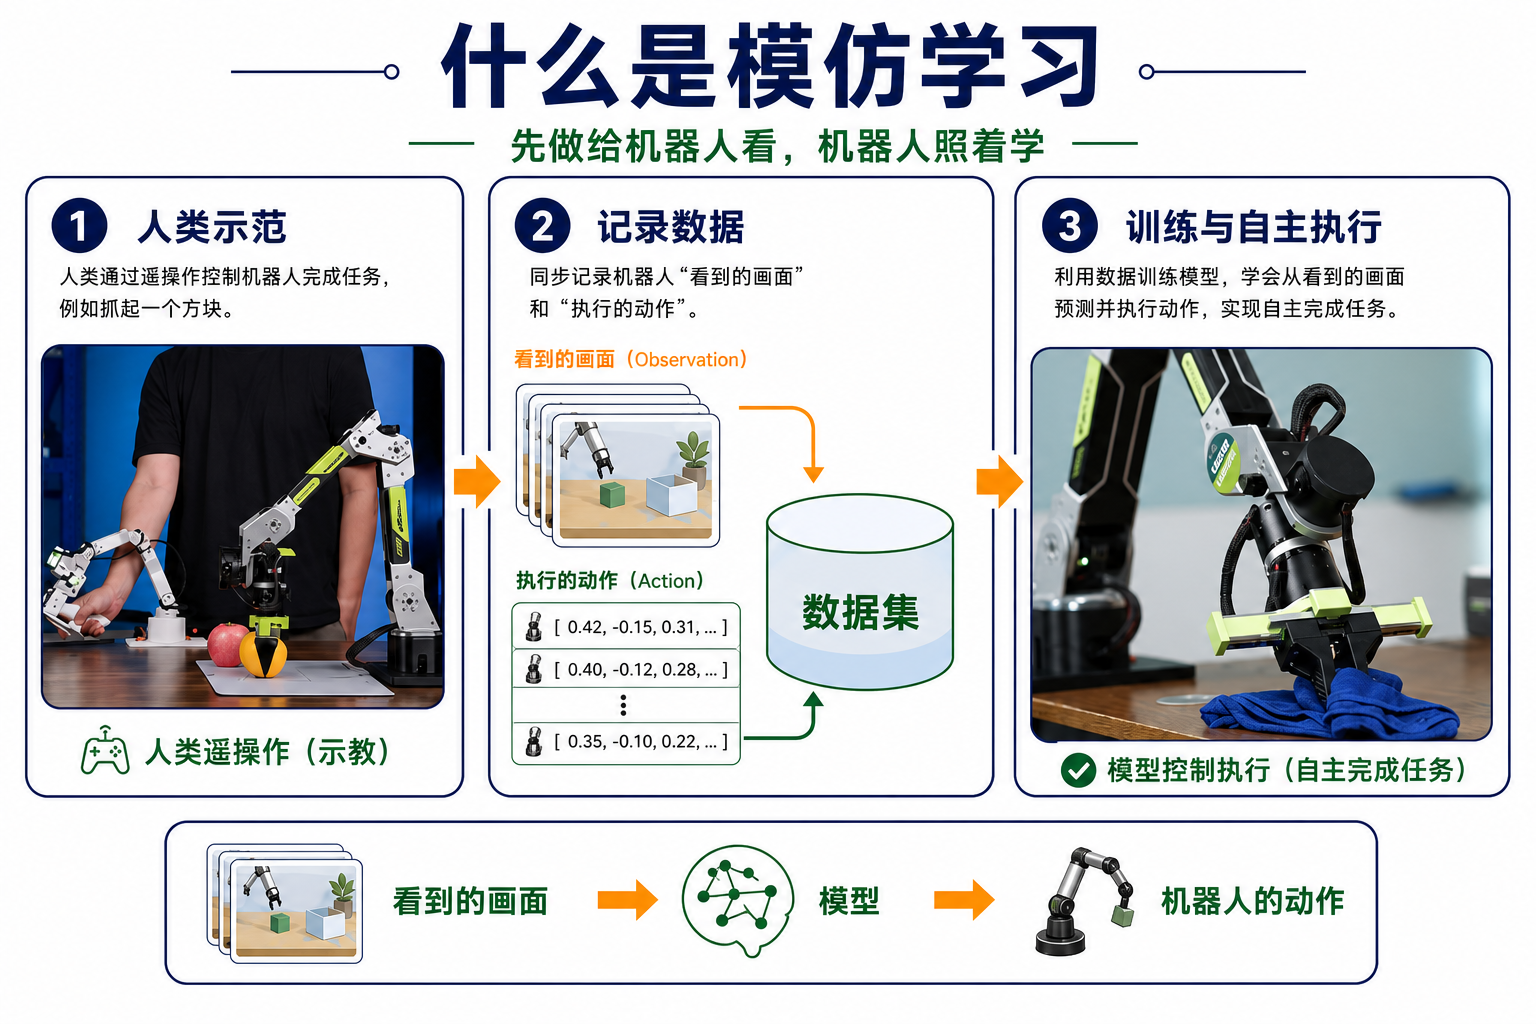
什么是行为克隆
观测、状态与动作
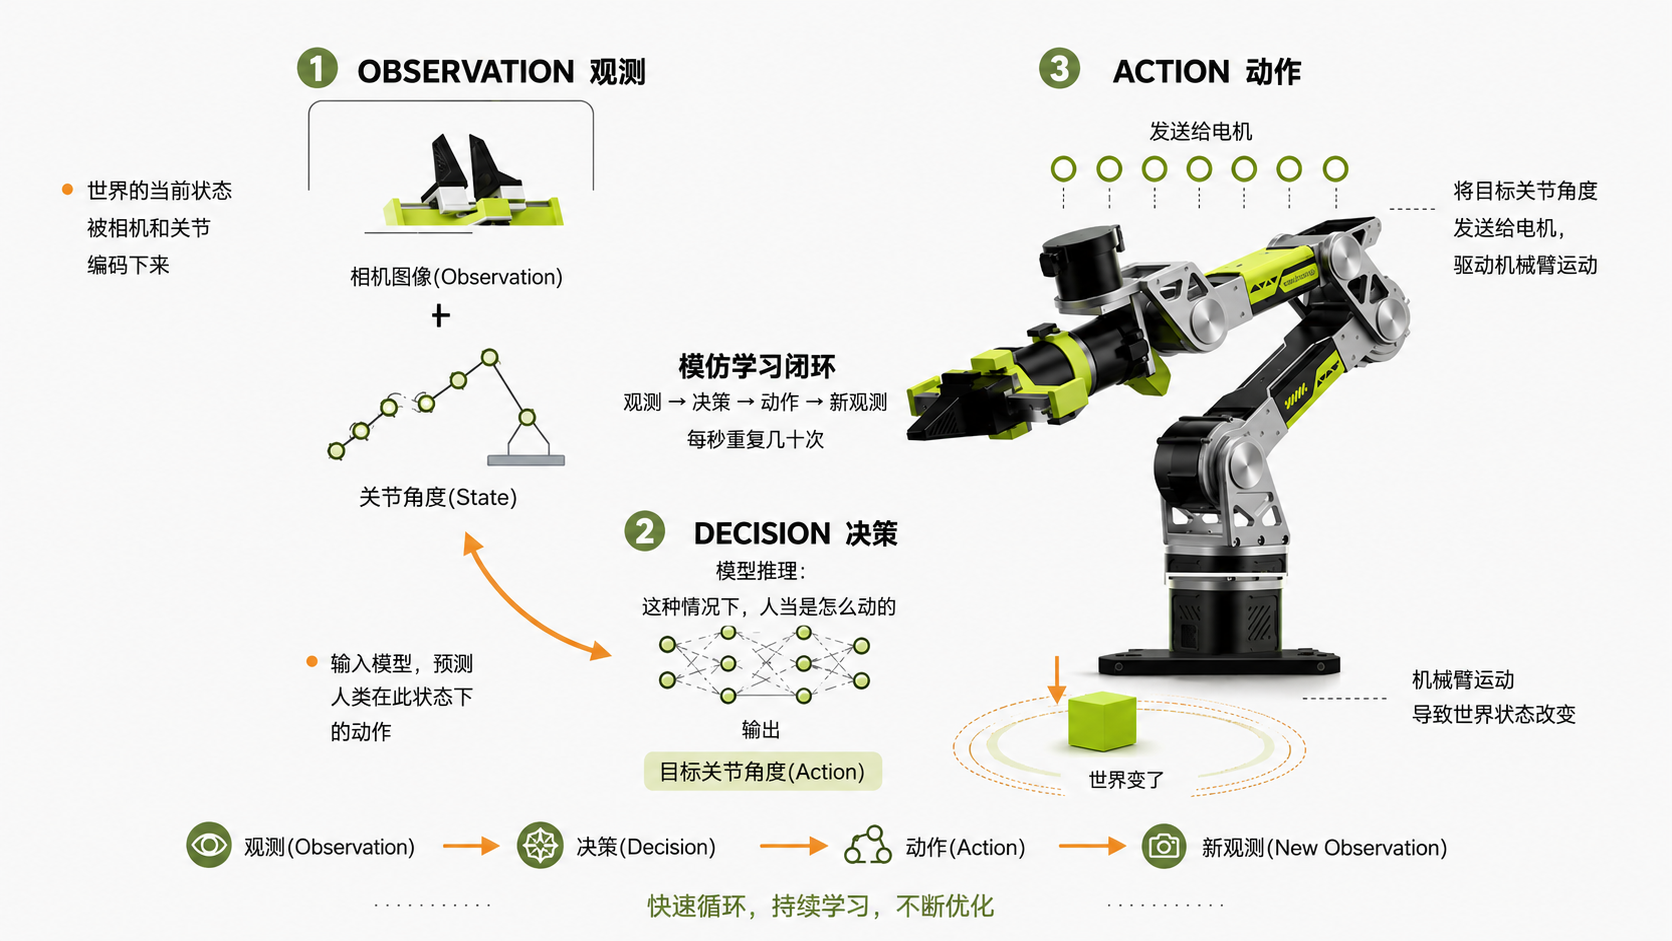
模仿学习中的所有数据都可以归入三个概念。这三个词会反复出现在后续每一章,请在这里建立准确的直觉:
- 观测(Observation):机器人"看到的"世界;
- 状态(State):机器人"自身的"状况;
- 动作(Action):机器人"将要做的事"。
具体到 SO-ARM:观测是两个相机的图像,状态是从臂的 6 个关节读数(5 个关节 + 夹爪),动作是接下来要下发的 6 个目标关节值。
单步动作 vs. 动作分块
- 单步动作:每帧决策一次;
- 动作分块:一次预测一串动作。
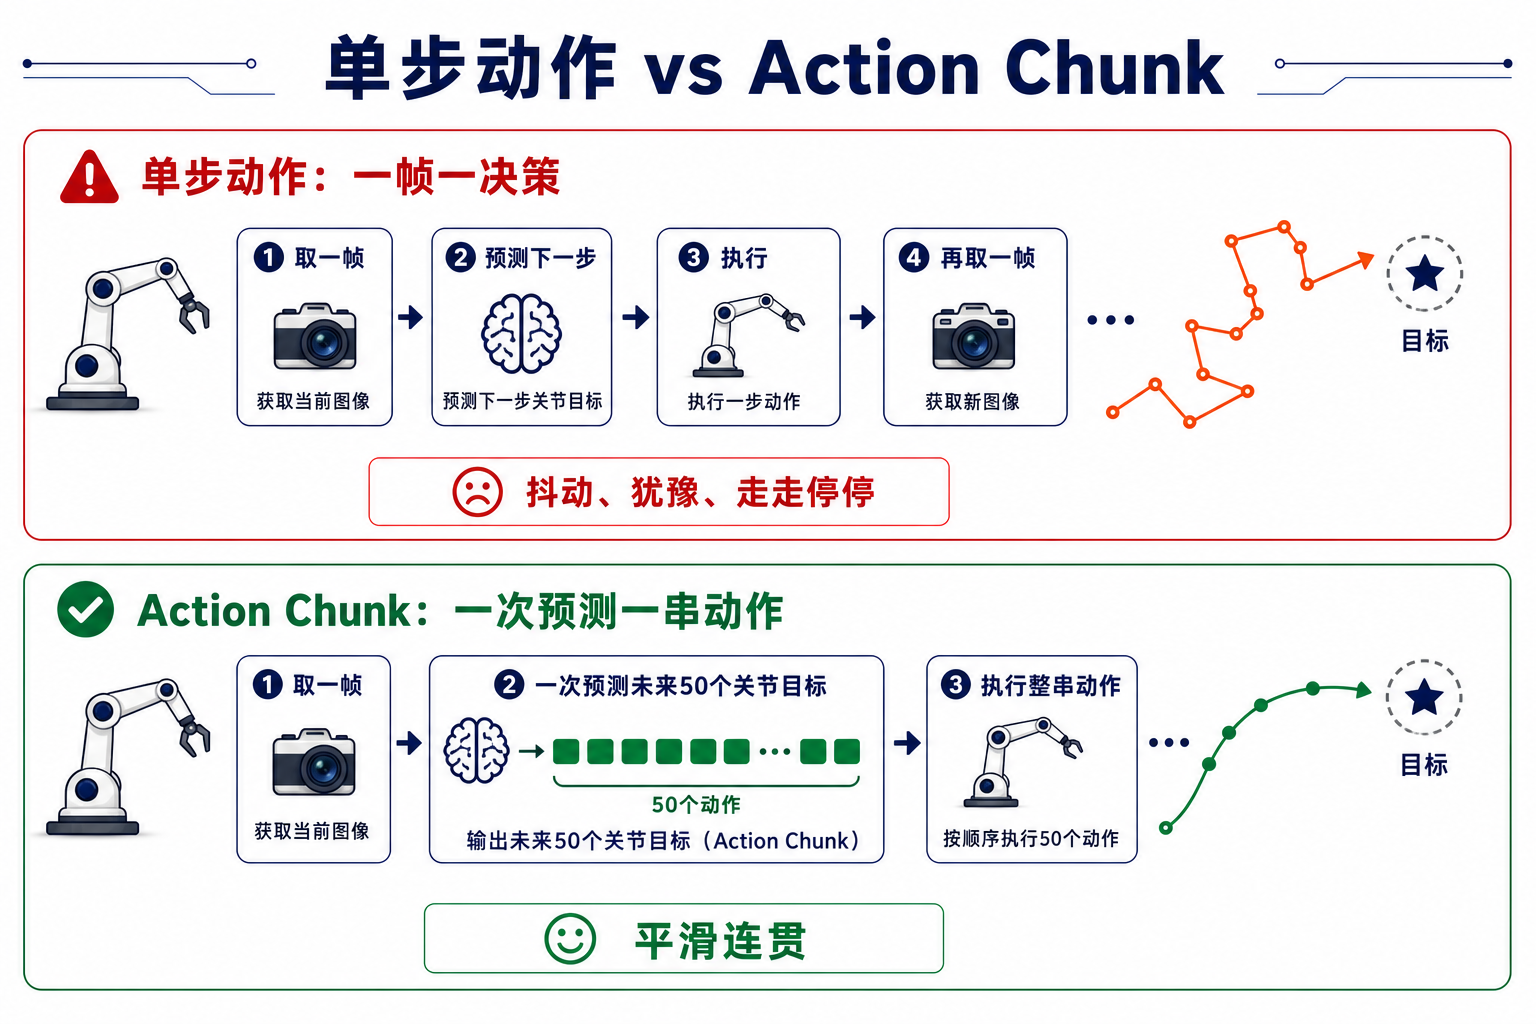
当然,动作分块不是越长越好。预测得太远,环境可能在执行中途变化(比如物体被碰了一下),而机械臂还在执行"过时"的动作。真实系统采用折中方案:开环执行一小段,再重新观测、重新预测。
数据分布与模型泛化
这是全章最重要、也最容易被初学者忽视的一节,却直接决定实践的成败。先记住这句话:
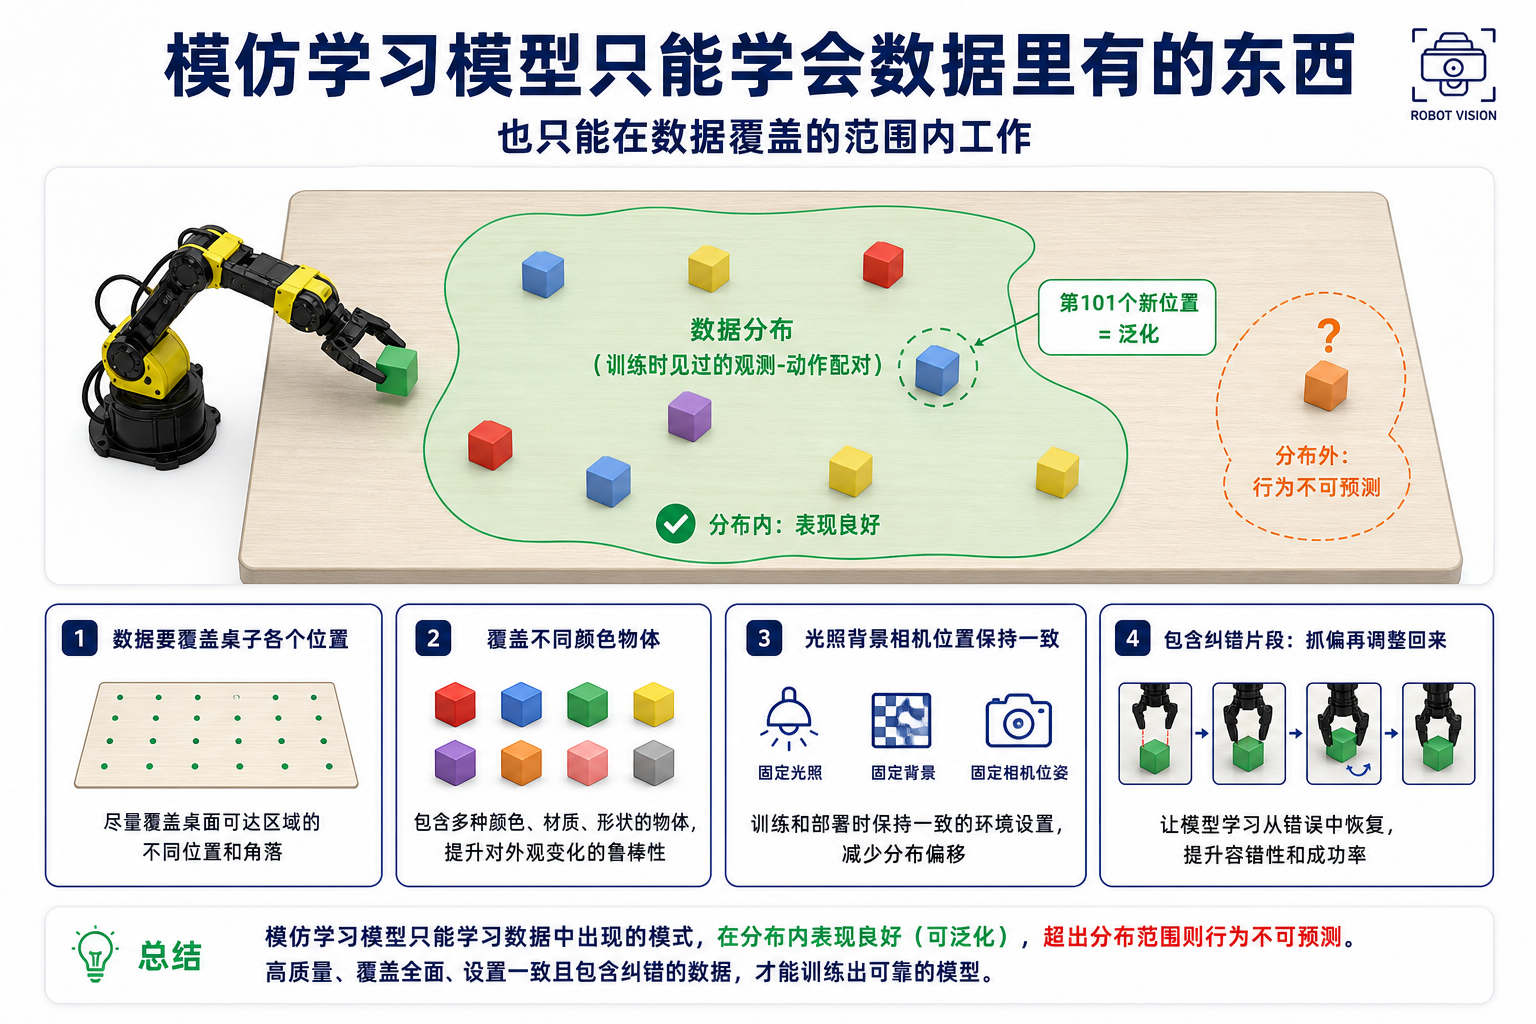
模仿学习模型只能学到数据里有的东西,只能工作在数据覆盖的范围内。
- 训练时模型见过的所有(观测, 动作)样本对构成一个数据分布。推理时,如果机械臂遇到的图像与状态落在这个分布内,模型通常表现良好;一旦越出分布,模型的输出就失去了依据,行为不可预测。
由此得到几条非常实用的推论:
- 想让它抓取桌面任意位置的方块,数据就必须覆盖整张桌面 —— 只在桌子中央采数据,模型就只会抓中央;
- 想让它抓不同颜色的物体,数据里就要有不同颜色 —— 否则新颜色对它来说就是陌生世界;
- 光照、背景与相机位置应尽量与采数据时一致 —— 用下午采的数据训练的模型,在傍晚室内光下可能完全失效。
而泛化是模型把数据中学到的规律应用到分布内、但没逐一见过的情形的能力。比如训练见过 100 个方块位置,推理时方块出现在第 101 个位置(仍在桌面),模型依然能抓 —— 这就是泛化。泛化不是魔法,它来自数据的多样性:覆盖越丰富、越连续,分布内的"空隙"越小,泛化越好。
模仿学习的上限,在数据采集完成的那一刻就已经确定。训练只是去逼近这个上限。
训练、推理与评估
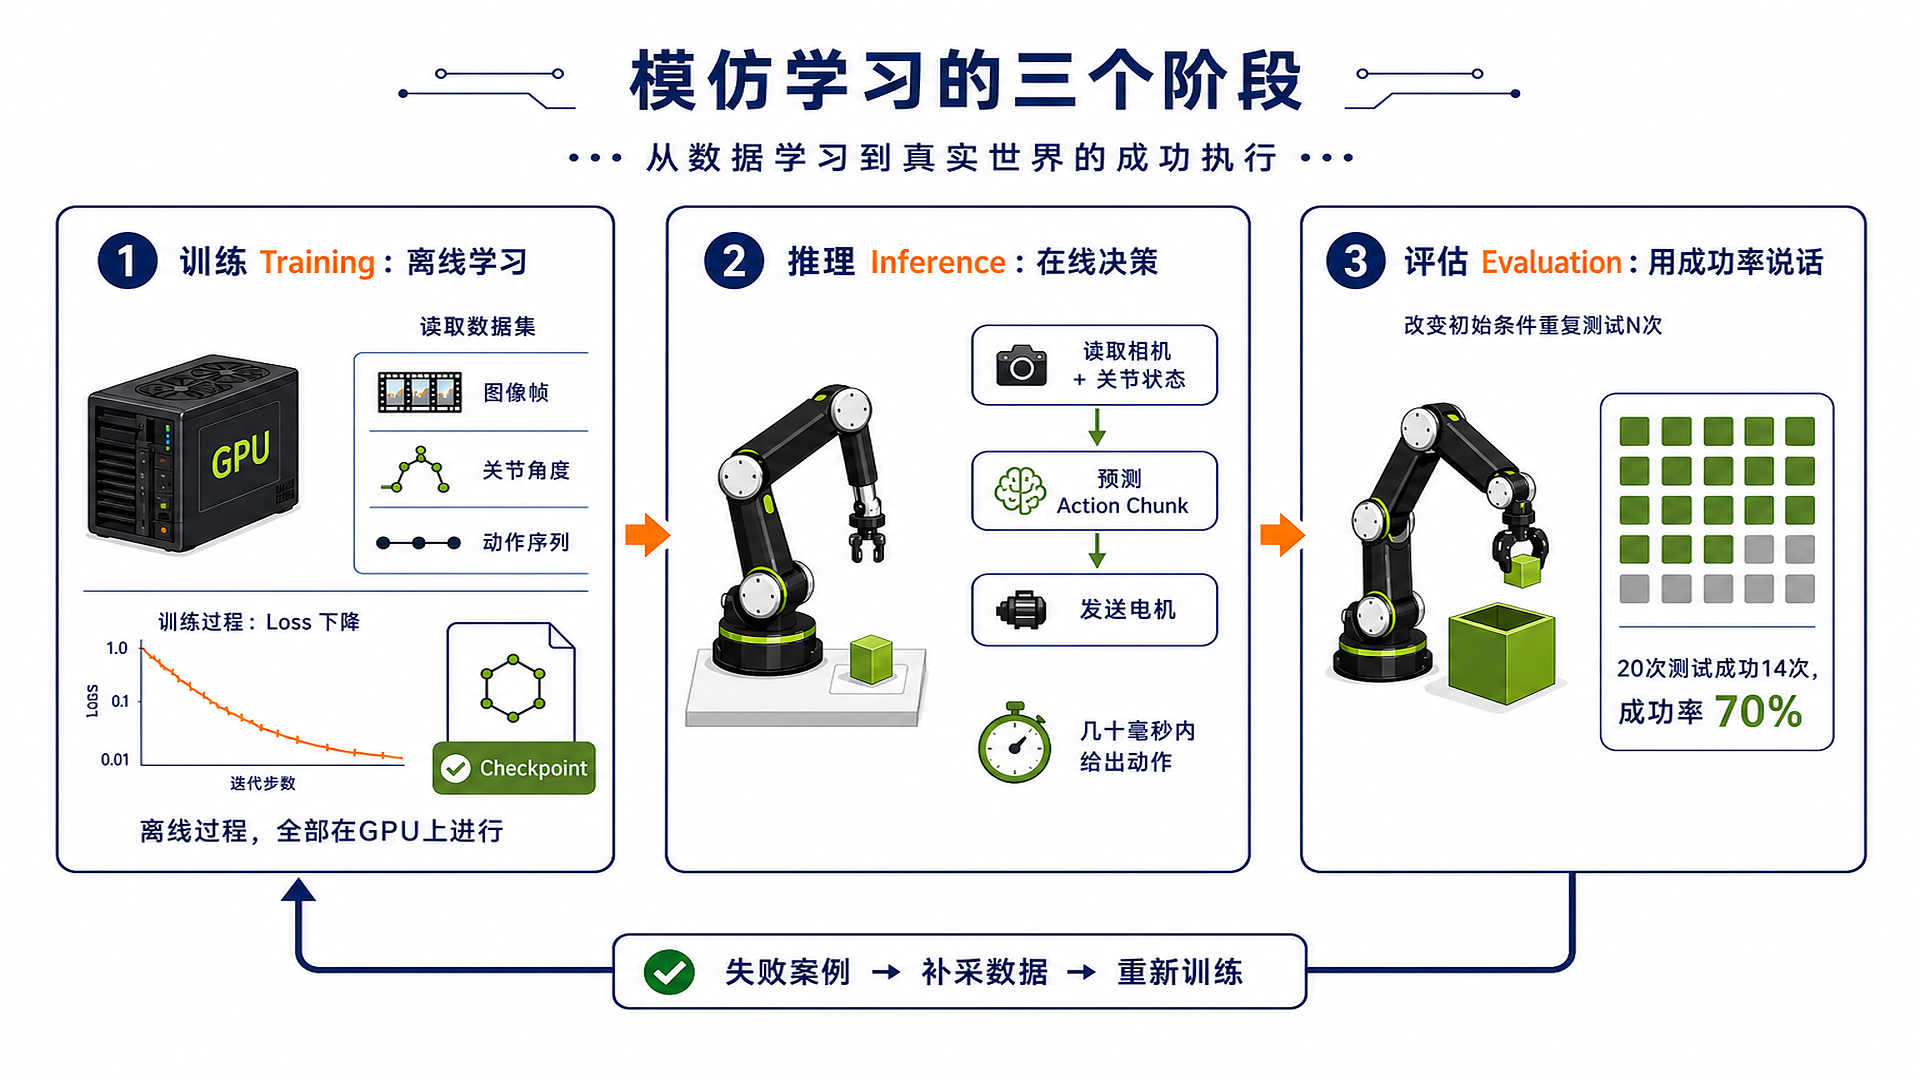
训练:离线学习
训练发生在数据采集完成之后,是一个离线过程:机械臂可以断电放一边,所有工作都在 GPU 上完成。
- 输入:采集好的数据集(图像、状态、动作的时间序列);
- 过程:模型反复读取数据,不断调整内部参数,让预测的动作越来越接近人类示教;
- 输出:一个训练好的模型文件。
训练质量主要通过 Loss 观察:Loss 下降,说明模型预测的动作越来越像人类示教。
推理:在线决策
推理是把模型部署到真机上实时工作的过程:读取相机与关节状态 → 模型预测一个动作分块 → 发给舵机执行。推理有实时性要求 —— 模型必须在几十毫秒内输出动作,否则机械臂会卡顿。
评估:以成功率说话
模型训练好了、Loss 很低 —— 就真的能干活吗?不一定。
Loss 低只说明模型"像人",不等于"能完成任务"。 唯一可靠的评估是真机测试:
- 设定明确的任务成功标准(例如"方块最终进了盒子");
- 变化初始条件(方块位置、光照),重复测试 N 次;
- 统计任务成功率 —— 例如 20 次测试成功 14 次 = 70% 成功率。
评估中发现的失败案例不是终点,而是下一轮数据采集的输入 —— 哪里失败,就往哪里补数据,然后重新训练。这就是数据迭代闭环,也是真实机器人学习项目的日常。
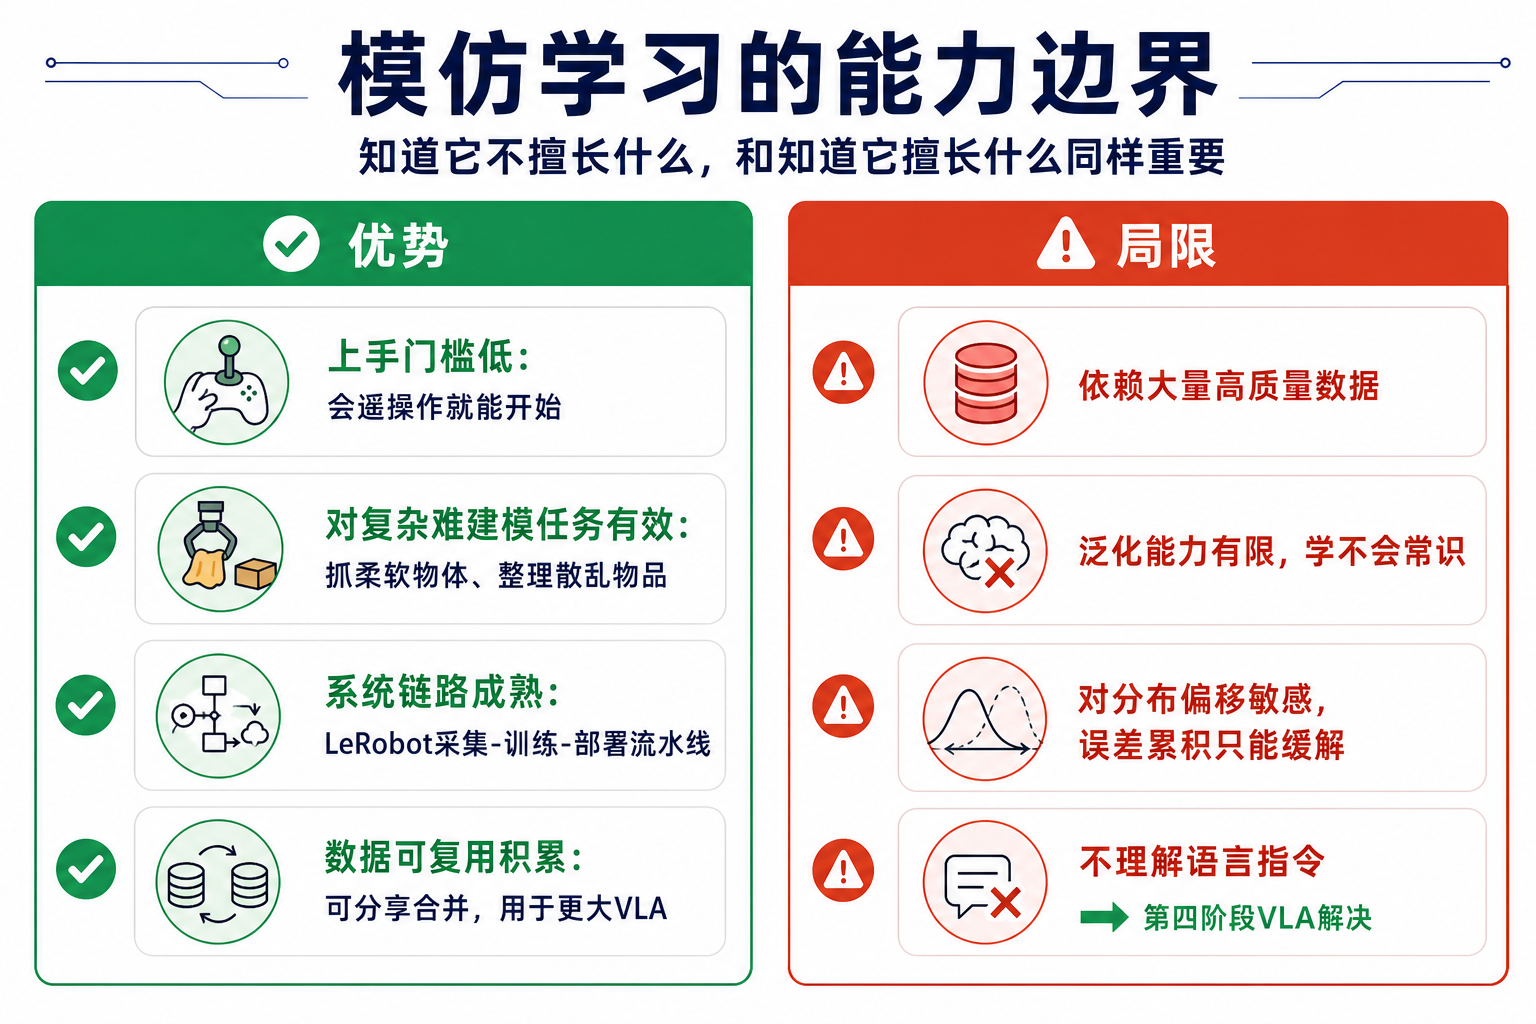
模仿学习的优势与局限