零售语音:设备本地转写,或可脱敏可硬删除的服务端栈
这是参考实现,不是认证的转写产品,也不是合规工具;说话人标签是聚类结果,不代表身份。
两种模式都把结果写入零售后台,区别在 ASR 在哪里跑:设备先转写、只上传文本 JSON;或 Clip 经手机上传音频,由服务端做 ASR。
- 设备本地转写:盒子完成 ASR,把最终文本 JSON 上传到零售后台;WAV 可选保留在本地。
- 服务端栈:一台 arm64 主机在此基础上加入库前脱敏、MySQL、MinIO、管理后台、按主体导出和硬删除接口。音频来自边缘采集端上的麦克风阵列,或你已有的手机 App。
先用本地套餐起步的站点,之后不换阵列、主机和识别器就能改成服务端栈。
这套方案是干什么的
套餐:设备本地转写
柜台上的麦克风阵列拾取对话,旁边一台小盒子把音频转成文字,再把最终转写 JSON 上传到零售后台落库和展示。Clip 模式则由 SenseCraft Voice App 经 gateway 把音频交给 voice-service,voice-service 调用 OpenVoiceStream 做 ASR,结果写入同一后台。
适合这几类现场:单店或试点门店,录音不能离开建筑;上行链路不稳定;采购规定禁止第三方处理语音;上云之前先在现场验证音频通路和识别质量。
- 选型与部署:可部署方案页
麦克风插上即用
reSpeaker XVF3800 以标准 USB 音频设备接入,回声消除、波束成形和降噪在阵列自带的 DSP 上完成,不占主机 CPU。
音频可以不出门店
设备本地转写只上传文字 JSON。WAV 片段只在打开文件输出时写入,关掉后设备上只留文字。
入库前脱敏,可按人删除
服务端栈在写入数据库前把姓名、电话替换成占位符;可按主体删除并返回残留计数,也可按主体导出。
接已有 App 和业务系统
reSpeaker Clip 配 SenseCraft Voice App 直接上传音频;BI、CRM 和工单系统通过 HTTP 接口读取脱敏文本、调用删除与导出。
套餐:服务端栈
音频进来,脱敏后的转写写入数据库;已入库的内容可以按主体删除,并返回残留计数。方案包是一套固定版本的 Docker 编排:识别、声纹、负责脱敏与入库的服务、MySQL、MinIO、管理后台,外加一个供音频接入的 WebSocket ASR 端点。
采集有两条路。设备端转录上传模式中,边缘盒子上的 reSpeaker XVF3800 阵列采音、做语音活动检测、用 OpenVoiceStream 本地转写,再由应用只向零售后台上传文字 JSON;WAV 可选留在设备本地。Clip 模式中,reSpeaker Clip 把音频交给 SenseCraft Voice App,App 上传到后台,由 voice-service 调用 OpenVoiceStream 并存储结果。App 使用部署主机 .env 中的 operator key;数据库凭据与 JWT 密钥由部署流程自动生成。
适用场景:员工与顾客在店面对话,运营方想知道顾客问了什么,但不保留是谁问的;收到删除请求时,需要证明数据库行、对象文件和声纹都已删除;已有 App 在采集音频,缺后端链路;要求音频不出场地的试点。
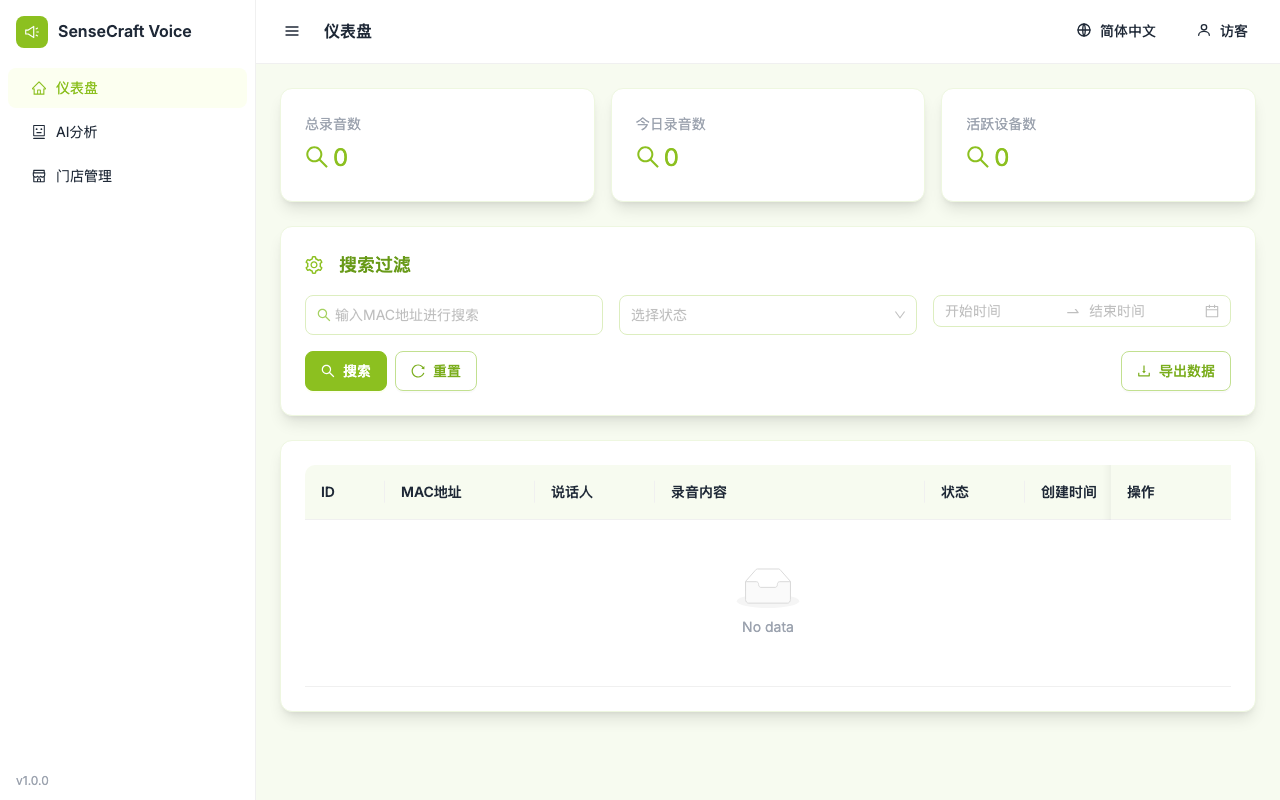
管理后台上能看到什么
服务端栈套餐登录管理后台后,录音列表按时间列出每一条的转写文本、时长与来源设备。
列表里的文本已脱敏:姓名与电话在入库前替换成占位符,原文不落库。
需要哪些硬件
套餐:设备本地转写
每个说话区两台设备,外加一个可写目录。
① 麦克风阵列:USB 主机口上接一只 reSpeaker XVF3800。回声消除、波束成形和噪声抑制在阵列自带的 XMOS DSP 上完成,主机收到一路 16 kHz 单声道音频,前端处理不占主机 CPU。阵列以标准 USB 音频设备枚举。
② 转写主机:决定有没有设备实测数据,以及标点和说话人标签能否与识别同时开。
| 主机 | ASR 跑在哪 | 什么时候选它 | |
|---|---|---|---|
 | reRouter CM4 纯 CPU 盒子,BCM2711,4 核,4 GB | 4 个 Cortex-A72 核,Paraformer 流式 | 预算优先,第一个站点按试点做 |
 | reComputer RK3576-30 6 TOPS NPU,8 GB | RK3576 NPU,SenseVoice RKNN fp16 | 需要有设备实测数据的主机,或要同时开标点和说话人标签 |
覆盖范围。 一只阵列覆盖一个说话区:稳态背景噪声不高于 70 dB 时,XVF3800 的波束成形覆盖 3 m 以内的说话人。没有多阵列模式,第二个柜台需要第二只阵列和第二台盒子。
另外需要:一个空闲的 USB 主机口;一个存放转写结果(以及可选音频)的可写目录,compose 限制了容器日志大小、模型放在命名卷里,磁盘随使用增长的只有转写目录;用于后台上传和首次启动下载模型的网络。
套餐:服务端栈
最多两样:跑栈的主机,以及边缘采集路径上的麦克风阵列。
① 栈主机:任意 arm64 Linux 主机,装 Docker,留 20 GB 空间。固定版本的镜像只有 arm64,随包的识别镜像是 RK3576 NPU 构建,没有 RKNN NPU 的主机要换成对应的识别镜像。
| 主机 | 角色 | 什么时候选它 | |
|---|---|---|---|
| — | reComputer RK3576-30(SKU 100052518) | 栈主机;边缘采集路径上同时是采集端 | 随包镜像按这块板构建,识别跑在 NPU 上 |
| — | reRouter CM4(SKU 110110110) | 只做采集端 | 手上已有 CM4;识别跑在 CPU 上,方案包没有为这条路径提供固定镜像,需要自己准备 |
② 麦克风阵列(仅边缘采集路径):reSpeaker XVF3800 USB 4 麦阵列(SKU 101991441)。降噪、回声消除与波束成形跑在阵列自己的 DSP 上,主机经 USB 收到一路 16 kHz 单声道音频。
**一台栈主机起步按 1–2 路。**ASR 本身的并发容量见「性能与实测数据」中的五种设备并发表。
其它前置条件:采集端要能访问栈主机的 ASR 端口;跨不受信网络时前面加 TLS 终结,因为令牌可能走 URL 查询参数。
选型排他边界
- 并发录音路数上限:reComputer RK3576 单机实测稳定承载至多 12 路音频转写;门店若有 16 路以上收银台或工位同时录音,请勿单机接入,应增配网关或选择 Jetson 服务端栈。
- 敏感脱敏策略:语音转写默认不开启敏感信息脱敏,若涉及金融账号、身份证号合规要求,需在服务端栈部署中显式启用本地脱敏服务。
现场怎么部署
套餐:设备本地转写
先把阵列放对位置,再把两个容器拉起来。
一、装阵列
说话人距阵列 3 m 以内,稳态背景噪声不高于 70 dB(大致是正常说话的音量)。超出这个范围,阵列的噪声抑制分不出说话人,识别错误率上升,换主机也改善不了。
阵列放在柜台上正对说话区,不要放在屏风后面或挑檐下。它接盒子上的一个 USB 主机口,两者距离要在线缆长度以内。
二、装软件
逐设备步骤在可部署方案页,流程如下。
- 选配置:页面问两件事,转写结果里要有什么(只要文字 / 文字加标点 / 还要说话人标签),以及上线前是否需要有设备实测数据的主机。主机和阵列由这两个回答确定。
- 部署方案包:两个套餐都是同样两个容器,语音服务和语音客户端。切换套餐改的是镜像 tag 和 profile,输出格式不变。
- 填设备输入项:输出目录、是否保留 WAV、是否开启标点恢复与声纹向量。后两项各加载一个模型,在 4 GB 纯 CPU 板上两个都开会压缩余量。
- 验证:拿一段短 WAV 调
POST /asr。返回文本正确、backend字段指明了实际运行时,链路就通了。之后 8090 端口的本地网页显示实时转写、麦克风状态和声纹注册库。
耗时:模型下载完成后,一次部署约 40 分钟。模型卷已填充时,RK3576 重启到健康实测约 25 s。
套餐:服务端栈
两个套餐难度都是 intermediate,预计 60 分钟,最后一步都是人工验收。逐设备操作在可部署方案页,按现场条件选完配置后可以直接下载对应的应用包。
服务端栈 + 手机 App:在 arm64 主机上部署整套栈(第 1 步),把 http://<部署设备 IP>:18621 和主机 .env 中的 operator key 配置到 App(第 2 步),打开管理后台(第 3 步),验收(第 4 步)。Clip 模式中,SenseCraft Voice App 接收 Clip 音频,向 POST http://<stt-host>:18621/v1/audio/transcriptions 上传端点支持的音频文件;后台完成转写、脱敏、落库与展示。
服务端栈 + 边缘采集端:部署采集端(第 1 步),固定版本的 compose 是一个整体,采集端会带上整套栈;打开管理后台(第 2 步);验收(第 3 步)。
人工验收做什么。 确认落库文本已脱敏、删除后没有残留。有人对着 App 或麦克风阵列说一句带电话号码的话,然后:读刚落库的那一行(号码必须显示为占位符),对这个主体调删除接口并读返回的残留计数,再核对导出。
进店前的准备:选好设备族,准备设备与 SSH 访问。部署流程自动生成数据库凭据、JWT 密钥和 operator key。operator key 保存在部署目录的 .env 中,变量名为 OPERATOR_TOKEN,在 App 中配合 http://<部署设备 IP>:18621 使用。
有哪些接口
套餐:设备本地转写
设备模式产生最终转写 JSON 并上传到零售后台;Clip 模式经手机和 gateway 把音频交给 voice-service。部署时填写客户端后台地址和接入密钥,内部数据库与 JWT 密钥自动生成。
- 只要文本:读 JSON 文件。
<输出目录>/cache/asr/下每断出一句一个文件,含转写文本、时间戳、语种,开启声纹匹配时还带说话人标签。 - 实时拿文本:连 8621 上的 WebSocket。发送 16 kHz 单声道 PCM 帧,用空帧结束一句;每条结果含转写文本、标点和 192 维 CAM++ 向量。
- 整段送入:把 WAV
POST到 8621。部署指南的验收步骤调的就是它。
完整的接口与 payload
| 接口 / 端口 | 内容 | 是否离开设备 |
|---|---|---|
<输出目录>/cache/asr/<id>.json | {"id","text","lang","start_ms","end_ms","speaker"},每断出一句一个文件 | 否 |
<输出目录>/voice/*.wav | 16 kHz 单声道 WAV 片段,仅在开启文件输出时写入 | 否 |
ws://<设备IP>:8621/asr/stream?vad=none&punctuate=true&speaker_embedding=true | 流式 ASR:送入 PCM,返回转写、标点和 192 维 CAM++ 向量 | 否 |
POST http://<设备IP>:8621/asr | 整文件转写,例如 {"text":"这个多少钱","backend":"rk:sensevoice_rknn"} | 否 |
http://<设备IP>:8090/ | 本地网页:实时转写、麦克风状态、声纹注册库,仅门店局域网内可访问 | 否 |
speaker 字段只在开启声纹匹配时出现,是本地注册库里的聚类标签,不代表身份。离线接口返回的 backend 字段是实际服务这次请求的运行时,可以用来区分 SenseVoice 跑在 NPU 上还是回落到 CPU。
套餐:服务端栈
所有数据都从栈主机上的 HTTP 或 WebSocket 接口读取。令牌是 .env 里 name:role:token 形式的条目(VOICE_API_TOKENS、ASR_API_TOKENS),角色决定一条路由放行到哪一级。
- SenseCraft Voice App:reSpeaker Clip 的音频由 App 转成端点支持的格式,调用
POST /v1/audio/transcriptions上传;转写 JSON 返回手机。 - PCM 流式客户端:8080 上的 WebSocket,operator 角色。送入原始 PCM 二进制帧,返回 JSON 消息。
- BI 或 CRM 系统:8081 上的
GET /api/v1/recordings,viewer 角色。读到的文本已脱敏,没有读取原文的接口。 - 隐私或工单流程:8081 上的
POST /api/v1/privacy/erase与GET /api/v1/privacy/export,admin 角色。 - 人工查看:3000 上的管理后台。
完整接口与 payload
| 接口 | 端口 | 路径 | 角色 | 内容 |
|---|---|---|---|---|
| WebSocket | 8080 | /ws?token=<operator> | operator | 客户端→服务端:原始 PCM 二进制帧,16 kHz、单声道、有符号 16 位小端,单条 ≤ 2 MiB。服务端→客户端:JSON,type 取 connection、vad、final、error |
| HTTP | 8081 | /api/v1/recordings | operator(POST)、viewer(GET) | 转写上报与查询;脱敏发生在插入之前 |
| HTTP | 8081 | /api/v1/privacy/erase | admin | 按主体 / 设备 / 会话硬删除 |
| HTTP | 8081 | /api/v1/privacy/export | admin | 脱敏文本 JSON 加音频清单 |
| HTTP | 3000 | / | viewer 及以上 | 管理后台:录音、关键词、设备、导出、删除 |
| HTTP | 8621 | /health | — | OpenVoiceStream 健康检查,编排探活用 |
一条 final 消息:
{"type":"final","text":"我想找[[NAME]]咨询一下","timestamp":1757030400000,
 "textLength":12,"wordCount":2,"sessionID":"a1b2","audioID":"c3d4",
 "speaker":{"identified":true,"speaker_id":"spk-7","speaker_name":"staff-a","confidence":0.83}}
三个字段的含义:
text是脱敏后的文本。 数据库里存的就是[[NAME]]这样的占位符,原文不写入任何地方,也没有加密副本。- 默认部署下
speaker.identified为false。 需要声纹匹配时选择声纹 profile;部署完成后交付端点与 key。 - 令牌可以放在请求头里。
X-API-Token与Authorization: Bearer都支持;?token=查询参数是给设不了自定义头的浏览器 WebSocket 客户端用的。
鉴权区分两类失败:缺凭据返回 401,角色档位不足返回 403,集成方据此判断该换令牌还是该改角色。没配规则的路由至少要 viewer,新加的接口默认不公开;没有 role 的旧令牌降级为 viewer。
性能与实测数据
套餐:设备本地转写
运行时与关键参数
OpenVoiceStream 语音服务的仓库不公开,因此没有 GitHub 链接。
| 主机 | 识别模型 | 精度 | 运行时 | 模型怎么到设备上 |
|---|---|---|---|---|
| reRouter CM4 | Paraformer 流式 | CPU | 4 个 Cortex-A72 核上的 ONNX / sherpa-onnx | 首次启动时从部署时选定的镜像源下载 |
| reComputer RK3576 系列 | SenseVoice | fp16 | 6 TOPS NPU 上的 RKNN | 同上;.rknn 按这块 SoC 编译 |
CT-Transformer 标点和 CAM++ 声纹在两种主机上都用 sherpa-onnx 跑在 CPU 上,在 4 GB 纯 CPU 板上同时开这两项,会与识别争用同一批 CPU 核和内存。
vad(流地址参数):一句话在哪里断开;vad=none把断句交给调用方,下表的实测用的就是这个设置。punctuate=true:加载 CT-Transformer,输出带标点的句子。speaker_embedding=true:加载 CAM++,按固定阈值与本地注册库匹配后输出speaker标签。匹配是启发式的,没有注册流程、活体检测和置信度保证,不能用于门禁、支付或针对个人的判定。
reComputer RK3576 系列实测
| 指标 | 数值 | 条件 |
|---|---|---|
| 离线转写时延 | 3.0 s 音频 → 热态约 780 ms(RTF 0.26) | SenseVoice RKNN fp16 跑在 NPU;POST /asr,容器已热 |
| 内存占用 | 容器 RSS 1.71 GiB | ASR + 标点 + 声纹全部加载 |
| 重启到健康 | 约 25 s | 模型卷已填充 |
| 短句转写 | 5 条短句(3 中 + 2 英)全部返回 "backend":"rk:sensevoice_rknn" 且文本正确;p50 678 ms,p95 810 ms(n=5,含 HTTP 开销) | 本方案原样的 compose 与 rk3576-sensevoice profile,文件输入 |
| 流式识别准确率 ▲ | 中文 CER 9.4%,英文 WER 34.6% | bench/perf/corpus short 集(5 中 + 5 英),Paraformer hybrid RKNN 编码器 + RKNN 解码器,/asr/stream 实时路径 |
| 语音结束到最终结果 ▲ | 326 ms / 347 ms(中 / 英均值) | 同一次运行,/asr/stream 带 500 ms prepare 提前量 |
| 声纹向量 | RTF 0.09–0.13(1 s → 125 ms,3 s → 255 ms,5 s → 428 ms) | CAM++ 走 sherpa-onnx CPU,2 线程;10 人聚类 1.45 ms |
| 声纹向量,A72 同档 * | RTF 约 0.10(1 s → 114 ms,3 s → 303 ms,5 s → 508 ms),冷加载 1.66 s | reComputer R10 系列(Cortex-A72,4 核),与 reRouter 内 CM4 同代 SoC;CAM++ 走 sherpa-onnx CPU |
复现:assets/docker/docker-compose.local-rk3576.yml(文件头记录)、openvoicestream/docs/perf/paraformer-rk3576-streaming-ab-20260608.md、openvoicestream/docs/specs/diarization-capability.md
▲ 这两行是 Paraformer 流式 profile 的数据,不是当前部署的 SenseVoice profile,时延不能当作当前链路的时延。当前链路的语音结束到最终结果见服务端栈一节的五种设备并发表。
* 不同板卡、同代 SoC,属折算:只说明 A72 核上声纹向量的 CPU 开销。
已知退化
- 超出拾音范围。 说话人超过约 3 m,或稳态噪声高于约 70 dB,阵列分不出说话人,识别错误率上升;调上面的参数改善不了。
- Paraformer 流式 profile 上英文弱于中文。 同一 short 集上英文 WER 34.6%,中文 CER 9.4%。
套餐:服务端栈
ASR 容量与时延:五种设备对比
| 设备族 | 模型 | 推荐同时路数 | p50 / p95 |
|---|---|---|---|
| reComputer J4012 | SenseVoice | 48 | 505 / 789 ms |
| reComputer J3011 | SenseVoice | 32 | 167 / 293 ms |
| reComputer RK3576 | SenseVoice | 12 | 583 / 1067 ms |
| reComputer RK3588 | SenseVoice | 8 | 659 / 902 ms |
| reComputer R2000 系列 | SenseVoice | 6 | 625 / 1173 ms |
| reComputer J4012 | Whisper base | 16 | 584 / 1177 ms |
| reComputer J3011 | Whisper base | 8 | 492 / 837 ms |
| reComputer RK3576 | Whisper base | 2 | 809 / 1380 ms |
| reComputer RK3588 | Whisper base | 4 | 655 / 1380 ms |
| reComputer R2000 系列 | Whisper base | 16 | 752 / 1465 ms |
条件:每条语料不超过 4 秒;SenseVoice 用 Jetson 200 路、RK 100 路并发语料,Whisper 用 Jetson/RK 72 路、R2000 100 路并发语料。p50 / p95 从 ASR 语音结束计时到最终结果,不含 VAD、声纹、标点、上传、脱敏与入库,是 ASR 本身的容量。
准确率(另用同一份 100 条语料,不与并发语料混用):中文 aggregate CER 4.82%;英文 WER 为 J4012 7.62%、J3011 7.62%、RK3576 8.51%、RK3588 7.50%、R2000 系列 8.39%。
复现:openvoicestream/bench/asr_bench/build_unified_report.py
已知边界
- 原文不落库。 手机号、身份证号、姓名、地址在写入 MySQL 之前替换成带类型的占位符;置信度 ≥ 0.85 的实体才遮蔽,低于阈值的只标记进复核队列、不遮蔽。
- 脱敏分数是文本级的。 114 条中英文书面文本金标准集上 precision 0.98、recall 0.95;分数在书面文本上算得,ASR 输出里的转写错误会移动实体边界。复现:
tools/pii_eval.py - 口述数字串有缺口。
cn_mobile_spoken规则覆盖以中文数字念出的 11 位手机号(含「幺」);身份证号、座机号及其它以中文数字词念出的数字标识未覆盖。 - 音频不脱敏。 默认保留 24 小时,部署时可选 6 小时或 1 小时;导出只含脱敏文本 JSON 加音频清单,不含音频本体。
- 按主体删除后三处残留 0(数据库、对象存储、本地音频),留下一条只含主体 SHA-256 的墓碑和审计记录。复现:
assets/tools/delete_proof.sh - 出机分析默认关闭。
c4-cloud-analytics容器只在选择cloud-analyticsprofile 时启用。
下一步
- 在 reComputer RK3576 上测服务端栈的完整入库链路:1 / 2 / 4 / 8 / 16 路并发,以及语音结束 → 脱敏 → 落库时延(p50 / p95 / p99)。
- 测服务端栈上的中英文转写准确率(WER),以及 1 / 10 / 60 / 240 分钟与 24 小时连续采集。
- 构建声纹容器镜像,之后测说话人错误率。
数据与素材出处
套餐:设备本地转写
- 识别、标点、端点检测与声纹模型:识别用 SenseVoice 与 Paraformer,标点用 CT-Transformer,声纹用 CAM++,端点检测用 Silero VAD,各自遵循上游许可,商用前按实际使用的模型核对。模型在首次启动时从部署时选定的镜像源下载。
- 测试语料:准确率各行用
bench/perf/corpusshort 集(5 中 + 5 英),短句转写一行用 5 条短句(3 中 + 2 英)。两者都不随方案包分发。 - 性能数据来源:
openvoicestream/docs/perf/paraformer-rk3576-streaming-ab-20260608.md、openvoicestream/docs/specs/diarization-capability.md、openvoicestream/docs/perf-test-runbook.md。OpenVoiceStream 仓库不公开,这些文档没有公开链接。 - 架构图:从已审批的产品贴图目录生成。麦克风节点用通用角色符号,不是 XVF3800 的实际外壳。
套餐:服务端栈
- PII 金标准集:114 条中英文样本,precision 与 recall 由它得出,不随包分发。
- 脱敏词表:《百家姓》与中国省级行政区名单,均为公有领域。脱敏不使用第三方模型。
- 栈内服务:
sensecraft-asr-service、sensecraft-voice-client、sensecraft-voice-service、sensecraft-voice-web是 Seeed 自有,识别用 OpenVoiceStream。MySQL 按 GPLv2 加 FOSS 例外拉取,MinIO 当前版本是 AGPLv3,嵌入商业产品前需核对该许可。 - 可部署方案页上的架构图由本仓库里的结构化 IR 渲染而来。