Entrenar y ejecutar movimientos oficiales de Microduck
Este capítulo cubre la ruta más corta de entrenamiento e inferencia: descubrir las tareas disponibles, entrenar una tarea oficial, visualizar un checkpoint .pt, ejecutar las políticas ONNX proporcionadas y controlar el robot simulado con un teclado.
Familias de tareas disponibles
cd ~/microduck-jetson/microduck_rl
uv run --no-sync list-envs | grep MicroDuck
| Movimiento | ID de tarea |
|---|---|
| Caminar | Mjlab-Velocity-Flat-MicroDuck |
| Caminar y recuperación de caídas | Mjlab-VelStand-Flat-MicroDuck |
| Levantarse desde el suelo | Mjlab-StandUp-Flat-MicroDuck |
| Sentarse y ponerse de pie | Mjlab-SitStand-Flat-MicroDuck |
| Recogida desde el suelo | Mjlab-GroundPick-Flat-MicroDuck |
| Voltereta hacia delante | Mjlab-Roulade-Flat-MicroDuck |
| Patada al balón | Mjlab-BallKick-Flat-MicroDuck |
| Locomoción con rodillos | Mjlab-Velocity-Flat-MicroDuck-Rollers |
Entrenar la política de caminar
Comienza con la prueba rápida de cinco iteraciones antes de cada ejecución larga:
cd ~/microduck-jetson/microduck_rl
export MUJOCO_GL=egl

uv run --no-sync train Mjlab-Velocity-Flat-MicroDuck \
  --env.scene.num-envs 64 \
  --agent.logger tensorboard \
  --agent.max_iterations 5
Para una ejecución más larga:
uv run --no-sync train Mjlab-Velocity-Flat-MicroDuck \
  --env.scene.num-envs 2048 \
  --agent.logger tensorboard
Aumenta el número de entornos solo cuando la memoria y la temperatura lo permitan. Una secuencia de reserva práctica es 4096 → 2048 → 1024 → 512.
Visualizar un checkpoint PT
Encuentra un checkpoint:
find logs/rsl_rl -type f -name 'model_*.pt' | sort
Visor en el navegador vía SSH
export MUJOCO_GL=egl

uv run --no-sync play Mjlab-Velocity-Flat-MicroDuck \
  --checkpoint-file /absolute/path/to/model_XXXX.pt \
  --num-envs 1 \
  --viewer viser
Abre http://<JETSON_IP>:8080 desde un ordenador en la misma red.
Visor nativo en el escritorio del Jetson
export DISPLAY=:0
export MUJOCO_GL=glfw

uv run --no-sync play Mjlab-Velocity-Flat-MicroDuck \
  --checkpoint-file /absolute/path/to/model_XXXX.pt \
  --num-envs 1 \
  --viewer native
Ejecutar la demo oficial ONNX multipolítica
El repositorio contiene nueve políticas ONNX oficiales en pretrained/pollen-robotics/.
cd ~/microduck-jetson/microduck_rl
export DISPLAY=:0
export MUJOCO_GL=glfw

uv run --no-sync python3 scripts/infer_policy.py \
  --walking pretrained/pollen-robotics/alpha_walking.onnx \
  --standing pretrained/pollen-robotics/alpha_stand.onnx \
  --sitstand pretrained/pollen-robotics/alpha_sitstand.onnx \
  --ground-pick pretrained/pollen-robotics/alpha_ground_pick.onnx \
  --roulade pretrained/pollen-robotics/roulade.onnx \
  --kick-left pretrained/pollen-robotics/ball_kick_left.onnx \
  --kick-right pretrained/pollen-robotics/ball_kick_right.onnx \
  --front-back-split models/exports/front_back_split/front_back_split_model_999.onnx \
  --new-cmd-obs
Controles de teclado
| Tecla | Comando |
|---|---|
| Teclas de flecha | Velocidad hacia delante, hacia atrás y lateral |
A / E | Girar a la izquierda / derecha |
G | Comportamiento de recogida desde el suelo |
Y | Transición sentarse / ponerse de pie |
R | Voltereta hacia delante |
K / L | Patada izquierda / derecha |
O | Apertura frontal-trasera de seis segundos y luego volver a estar de pie o caminando |
Space | Borrar el comando de velocidad |
Q | Salir |
Resultados de inferencia
Los siguientes GIF muestran resultados de inferencia ONNX capturados directamente desde MuJoCo en el Jetson.
Caminar
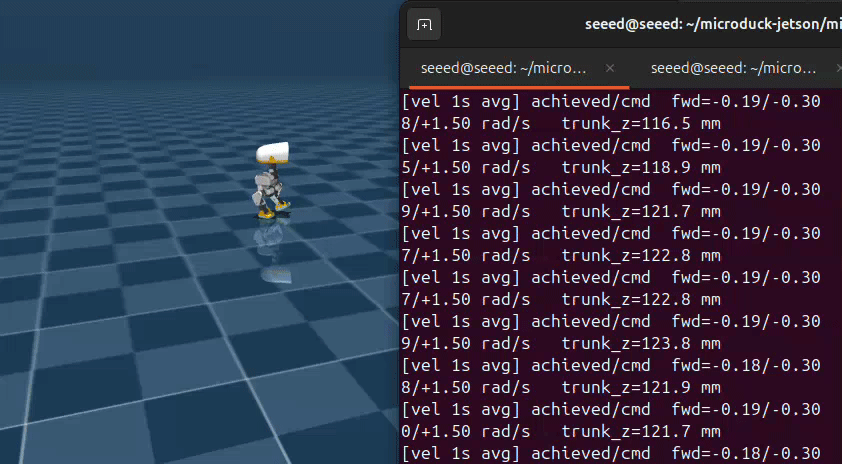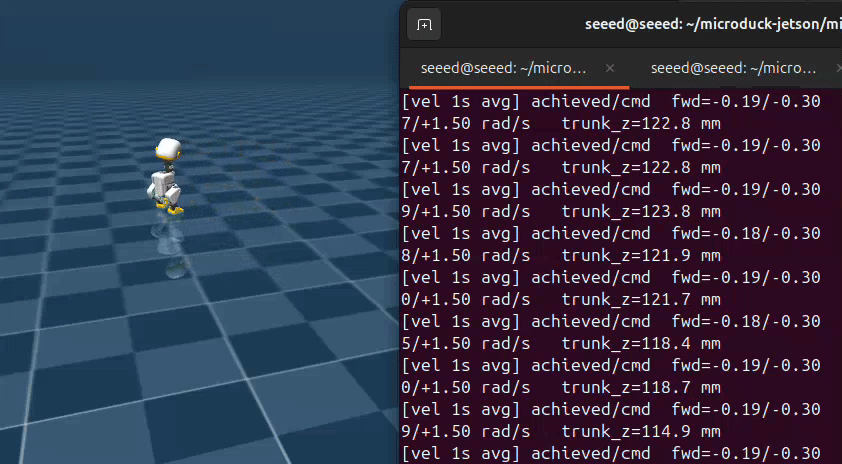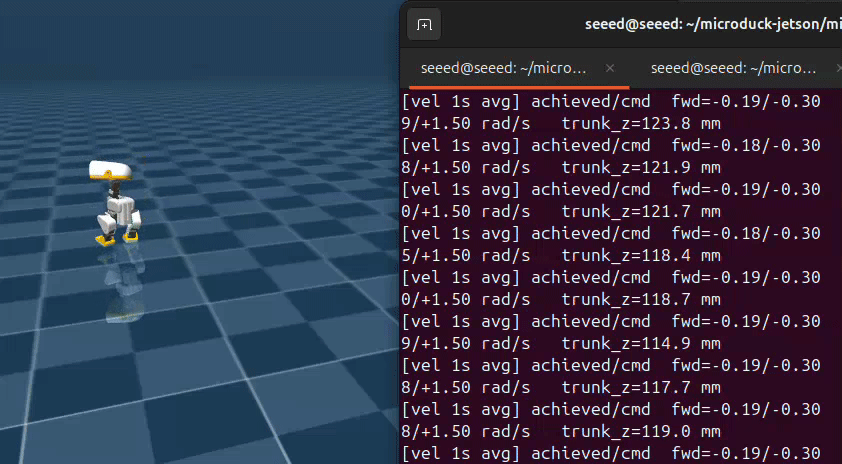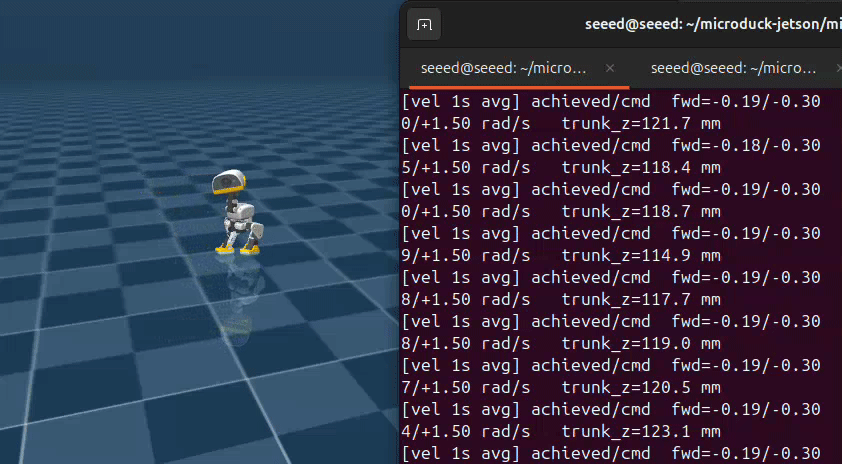
La política de caminar sigue continuamente los comandos de velocidad y giro del teclado.
Rodar
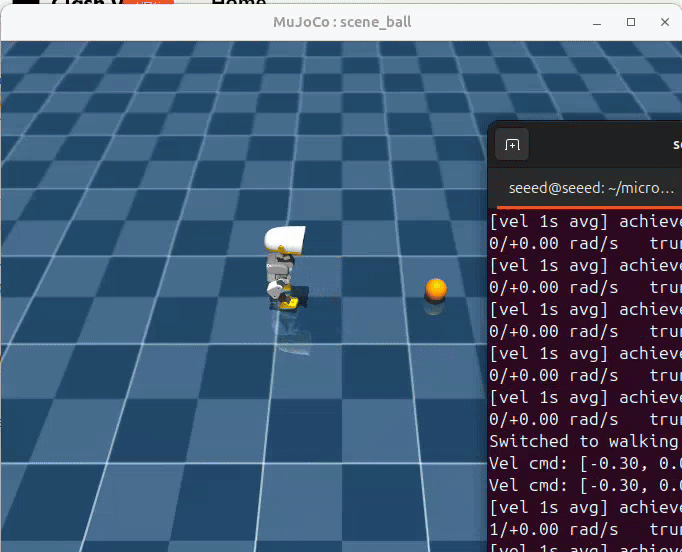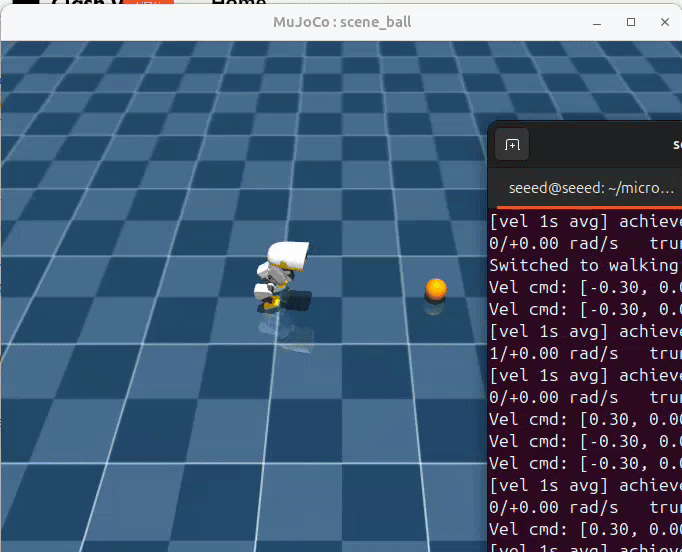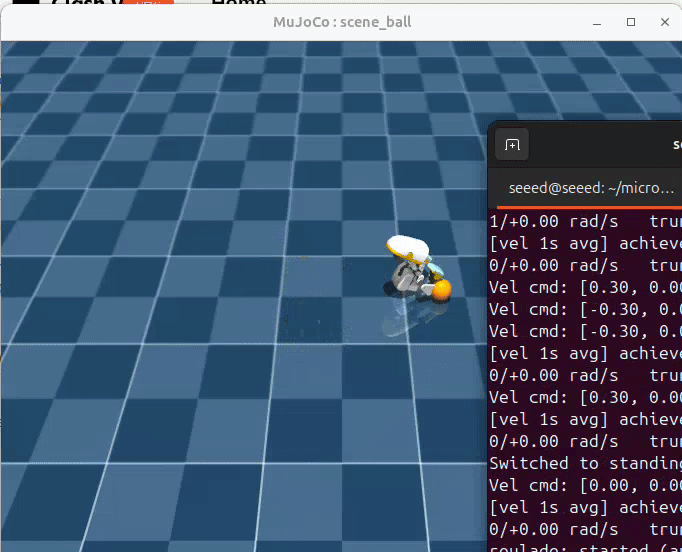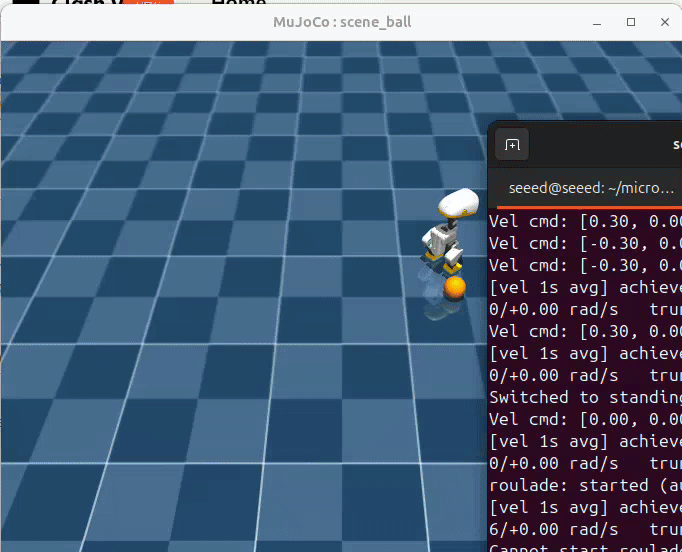
Pulsa R para cambiar a la política de voltereta hacia delante.
Patada al balón
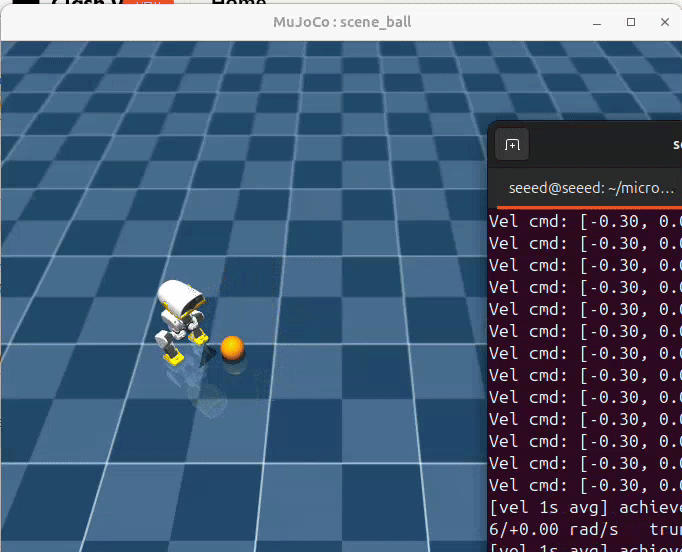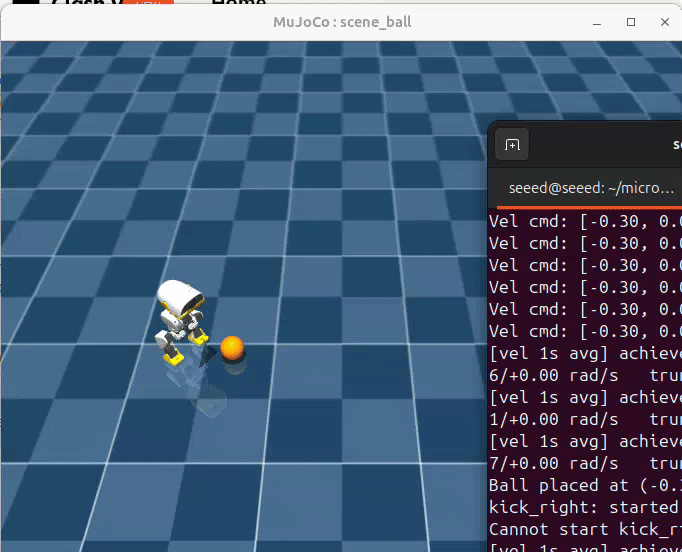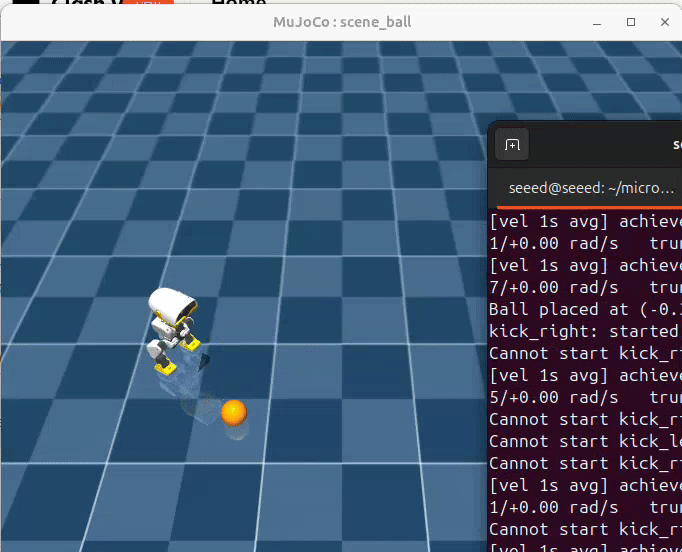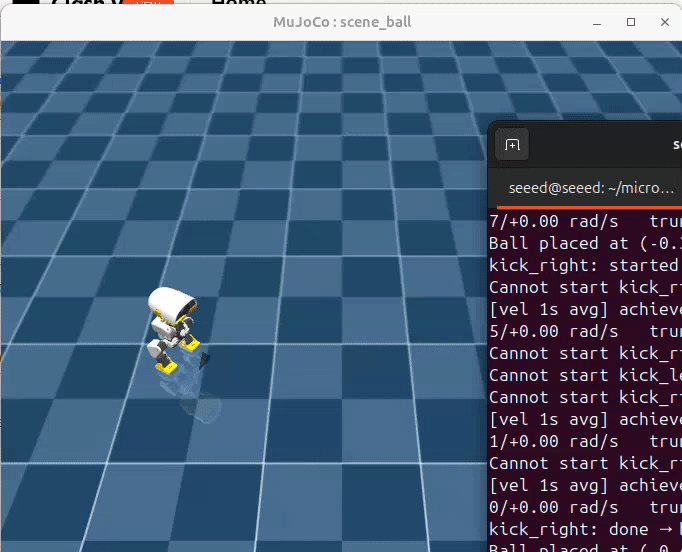
Pulsa K o L para activar la política de patada con el pie izquierdo o derecho en la escena del balón.
Apertura frontal-trasera
La antigua política de equilibrio sobre una sola pierna ha sido reemplazada por un movimiento
de doble apoyo más estable. Pulsa O para ejecutar la política entrenada: el pie izquierdo se mueve hacia delante, el
pie derecho se mueve hacia atrás, ambos pies permanecen en el suelo y el robot vuelve a
la política de estar de pie o caminar después del ciclo de fase de seis segundos.
Los artefactos incluidos son:
models/checkpoints/rsl_rl/front_back_split/2026-09-09_18-04-10_front_back_split_left_forward/model_999.pt
models/exports/front_back_split/front_back_split_model_999.onnx
PT y ONNX tienen propósitos diferentes
- Los checkpoints
.ptcontienen actor, crítico, optimizador, normalizador y estado de entrenamiento. Úsalos para reanudar el entrenamiento y para la evaluación conplay. .onnxcontiene el grafo de inferencia desplegable. Los archivos ONNX oficiales no contienen el estado de entrenamiento PPO y no se pueden convertir de nuevo en un checkpoint reanudable.- Los archivos PT bajo
models/checkpoints/son resultados de entrenamiento de caminar en Jetson incluidos con esta demo; no son lanzamientos oficiales de PT de Pollen Robotics.
Exportar tu propio ONNX
uv run --no-sync python3 scripts/export.py \
  Mjlab-Velocity-Flat-MicroDuck \
  --checkpoint-file /absolute/path/to/model_XXXX.pt \
  --onnx-file walking_custom.onnx
Utiliza siempre scripts/export.py. El exportador del proyecto integra el normalizador de observaciones en el grafo ONNX, lo cual es necesario para un comportamiento correcto en tiempo de ejecución.