Desplegar un kernel en tiempo real PREEMPT_RT con un paquete DEB precompilado en dispositivos Seeed reComputer Jetson
Un kernel en tiempo real, también conocido como kernel PREEMPT_RT, es una variante del kernel Linux con capacidades mejoradas de planificación en tiempo real. Reduce la latencia de planificación y mejora el determinismo de la ejecución de tareas, lo cual es crítico para cargas de trabajo como control de motores, adquisición de datos de sensores y comunicación por buses industriales (CAN, EtherCAT) en escenarios de robótica, automatización industrial y computación en el borde.
Si prefieres compilar el kernel PREEMPT_RT desde el código fuente, consulta este wiki. Esta guía toma un camino mucho más sencillo: un único paquete DEB precompilado instala el kernel en tiempo real en aproximadamente un minuto, mantiene el kernel estándar original intacto como respaldo y te permite cambiar entre los dos kernels en cualquier momento.
Este wiki se aplica a dispositivos Seeed reComputer y reServer Jetson basados en el módulo NVIDIA Orin (T234) que ejecutan JetPack 7.2 (Jetson Linux R39.2.0) con el kernel estándar. Un único paquete DEB cubre todas las placas carrier basadas en T234. Este wiki ha sido probado y verificado en un reComputer Super.
Requisitos previos
- reComputer Super (u otro dispositivo Seeed reComputer/reServer Jetson basado en un módulo Orin T234) ejecutando el sistema estándar JetPack 7.2
- El paquete DEB del kernel en tiempo real: nvidia-l4t-kernel-rt-7.2.0-39.2.0-2026-08-26.deb
- Un PC host para transferir el paquete DEB al dispositivo
Para dispositivos que aún ejecutan JetPack 6.2 (Jetson Linux R36.4.3), utiliza en su lugar el paquete correspondiente nvidia-l4t-kernel-rt-6.2-36.4.3-2026-08-26.deb. Los procedimientos de este wiki son idénticos; solo difieren las cadenas de versión del kernel (5.15.148-tegra / 5.15.148-rt-tegra).
Si tu dispositivo aún no está ejecutando el sistema estándar, consulta primero el wiki reComputer Super Getting Started.
Comprobar la versión del kernel estándar
El paquete DEB requiere que el dispositivo ejecute la versión del kernel estándar que coincide con el paquete. Abre una terminal en el dispositivo y ejecuta:
uname -r
Deberías ver una salida similar a:
6.8.12-1021-tegra
Si la salida muestra una versión diferente (por ejemplo 5.15.148-tegra de una versión anterior de JetPack, o 6.8.12-1021-rt-tegra del kernel en tiempo real), primero flashea la imagen del sistema estándar correspondiente y luego continúa con esta guía.
Instalar el paquete DEB del kernel en tiempo real
Paso 1. Transfiere el paquete DEB al dispositivo (tanto una unidad USB como scp funcionan):
scp nvidia-l4t-kernel-rt-7.2.0-39.2.0-2026-08-26.deb <username>@<device-ip>:~
Paso 2. Inicia sesión en el dispositivo e instala el paquete:
sudo dpkg -i ~/nvidia-l4t-kernel-rt-7.2.0-39.2.0-2026-08-26.deb
La instalación tarda aproximadamente un minuto y es completamente automática. Coloca la imagen del kernel en tiempo real en /boot/Image.real-time, instala los módulos correspondientes en /lib/modules/6.8.12-1021-rt-tegra/, reconstruye el initrd y cambia la entrada de arranque predeterminada al kernel en tiempo real. El kernel estándar original en /boot/Image se deja intacto, por lo que siempre permanece disponible como respaldo.
Paso 3. Reinicia el dispositivo:
sudo reboot
Verificar el kernel en tiempo real
Después del reinicio, confirma que el kernel en tiempo real está en ejecución:
uname -r
cat /sys/kernel/realtime
zcat /proc/config.gz | grep PREEMPT
Deberías ver una salida similar a:
6.8.12-1021-rt-tegra
1
CONFIG_PREEMPT_RT=y
El paquete incluye un kernel con los parches de la placa carrier de Seeed ya aplicados, por lo que todos los periféricos deberían comportarse exactamente igual que en el sistema estándar. Puedes comprobar algunos de ellos rápidamente:
lsmod | grep nvgpu
ip -br addr
systemctl --failed
systemctl --failed no debería informar de servicios fallidos.
Cambiar entre el kernel en tiempo real y el kernel estándar
Puedes cambiar entre los dos kernels en cualquier momento. Para volver al kernel estándar:
sudo nv-update-extlinux generic && sudo reboot
Para cambiar de nuevo al kernel en tiempo real:
sudo nv-update-extlinux real-time && sudo reboot
Durante el arranque, pulsa 0 (kernel estándar) o 1 (kernel en tiempo real) en un plazo de 3 segundos en el menú de arranque para seleccionar un kernel solo para ese arranque, sin cambiar la entrada predeterminada.
Desinstalar el kernel en tiempo real
Asegúrate de que el dispositivo se haya cambiado de nuevo al kernel estándar antes de desinstalar el paquete.
sudo nv-update-extlinux generic && sudo reboot
sudo apt remove nvidia-l4t-kernel-rt
Comparación de rendimiento: kernel en tiempo real vs kernel estándar
Para mostrar lo que realmente aporta el kernel en tiempo real, se compararon los dos kernels bajo tres cargas de trabajo: latencia del planificador (cyclictest), jitter de salida GPIO y control de motor servo EtherCAT, todo en el mismo dispositivo, bajo la misma interferencia y con la CPU mantenida a plena carga.
Todos los resultados siguientes se midieron en un Seeed reComputer Super (Orin Nano Super) ejecutando JetPack 7.2, bajo carga completa de CPU.
Principio
Los experimentos utilizan un módulo de kernel llamado spinlock_holder: un hilo de kernel ligado a un núcleo de CPU que toma repetidamente un spin_lock() y lo mantiene durante una duración configurada.
- En el kernel estándar,
spin_lock()desactiva la planificación del kernel. Cada tarea en esa CPU —incluida la tarea en tiempo realSCHED_FIFOde mayor prioridad— queda congelada hasta que se libera el bloqueo. - En el kernel PREEMPT_RT,
spinlock_tse sustituye por un bloqueo dormible respaldado por un rt_mutex, de modo que una tarea de mayor prioridad puede desbancar al poseedor del bloqueo en cualquier momento.
Esta es la diferencia que los experimentos hacen visible: en el kernel estándar, un bloqueo de 1 segundo significa una parada de 1 segundo para la tarea en tiempo real; en el kernel en tiempo real, la misma interferencia es casi invisible para ella.
¿Por qué un hilo de kernel y no un proceso de usuario con bucle ocupado? La carga en espacio de usuario siempre es planificable: en ambos kernels una tarea SCHED_FIFO tiene mayor prioridad, por lo que no aparece nada interesante. Solo una sección crítica de kernel no preemptible separa a los dos kernels. El grupo de control de abajo lo demuestra con datos.
Configuración de la prueba
| Elemento | Valor |
|---|---|
| Dispositivo | Seeed reComputer Super (Orin Nano Super, 6 núcleos) |
| Sistema | JetPack 7.2 (Jetson Linux R39.2.0) |
| Kernel estándar | 6.8.12-1021-tegra |
| Kernel en tiempo real | 6.8.12-1021-rt-tegra (desplegado mediante paquete DEB) |
| Interferencia | módulo de kernel spinlock_holder, kthread ligado a CPU3 |
| Cargas de trabajo | cyclictest, onda cuadrada GPIO (SCHED_FIFO), IgH EtherCAT master 1 kHz (SCHED_FIFO 89, mismo núcleo) |
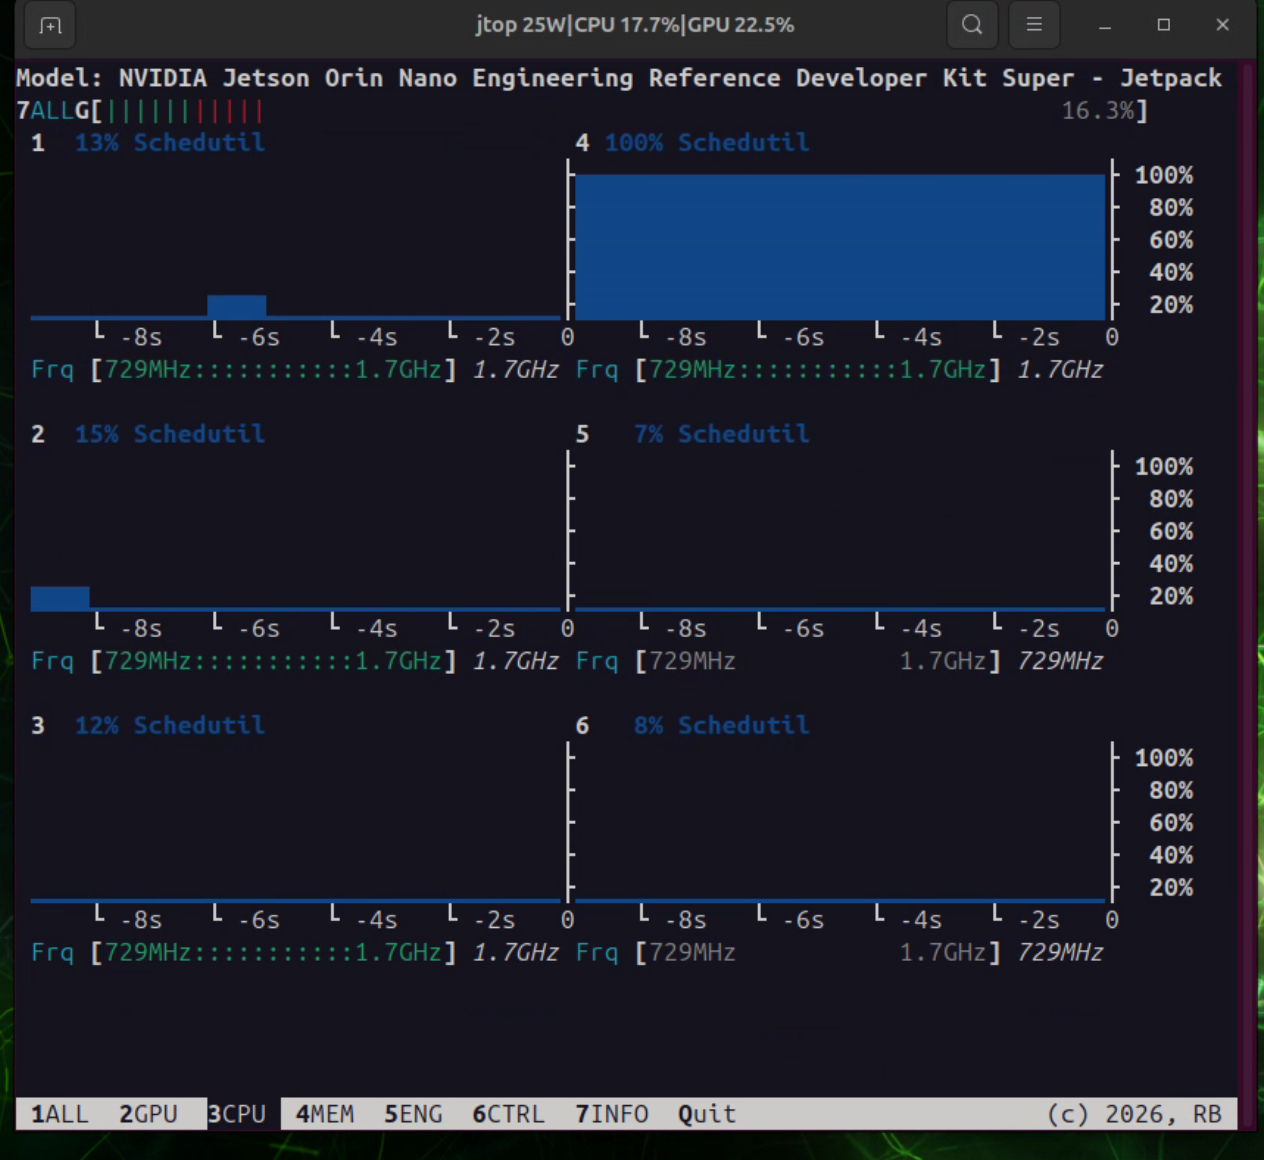
Durante los experimentos, el hilo de interferencia mantiene el núcleo objetivo fijado al 100% en jtop, mientras que los otros núcleos permanecen mayormente inactivos:
Latencia de cyclictest
Instala primero rt-tests:
sudo apt update && sudo apt install -y rt-tests
Genera carga completa del sistema en una terminal:
stress --cpu 6 --io 4 --vm 2 --vm-bytes 64M &
Luego ejecuta cyclictest en una segunda terminal, durante 30 segundos (la opción -S inicia un hilo de medición por núcleo de CPU, con el intervalo aumentando en 500 µs de un hilo a otro):
sudo cyclictest -m -S -p90 -i1000 -D30s
La imagen siguiente muestra una ejecución de ejemplo en el kernel estándar: la latencia media de cada hilo se mantiene entre 8 y 21 µs —engañosamente cerca del kernel en tiempo real— pero la latencia máxima se dispara hasta 1.909 µs, más de 60 veces el techo del kernel en tiempo real, sin forma de predecir cuándo ocurre:
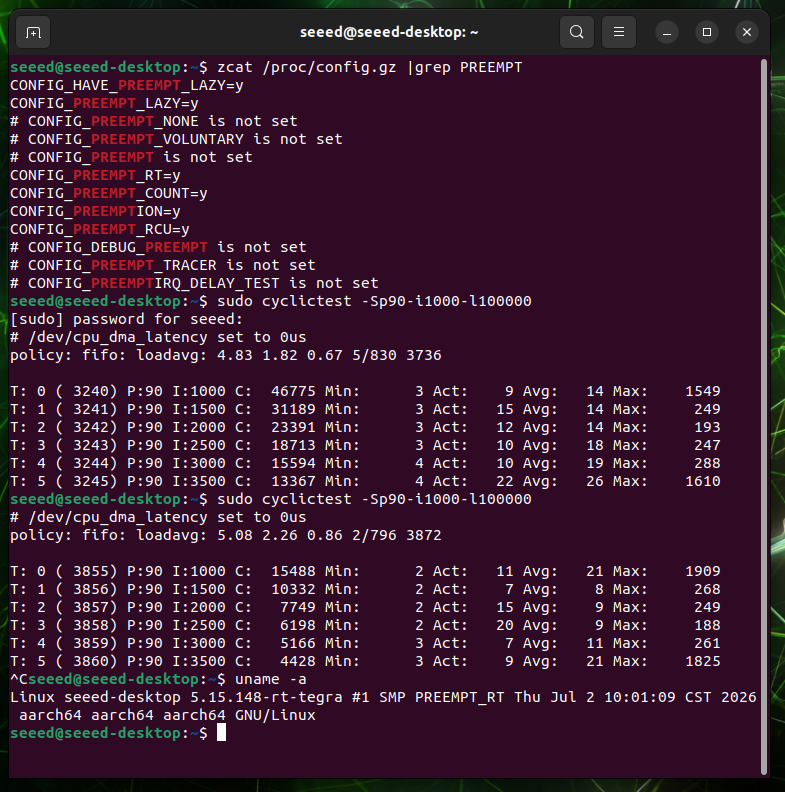
El kernel en tiempo real tiene un techo rígido en la latencia máxima: por muy pesada que se vuelva la carga, nunca se descontrola. Este determinismo es precisamente para lo que sirve un kernel en tiempo real.
Jitter de onda cuadrada GPIO
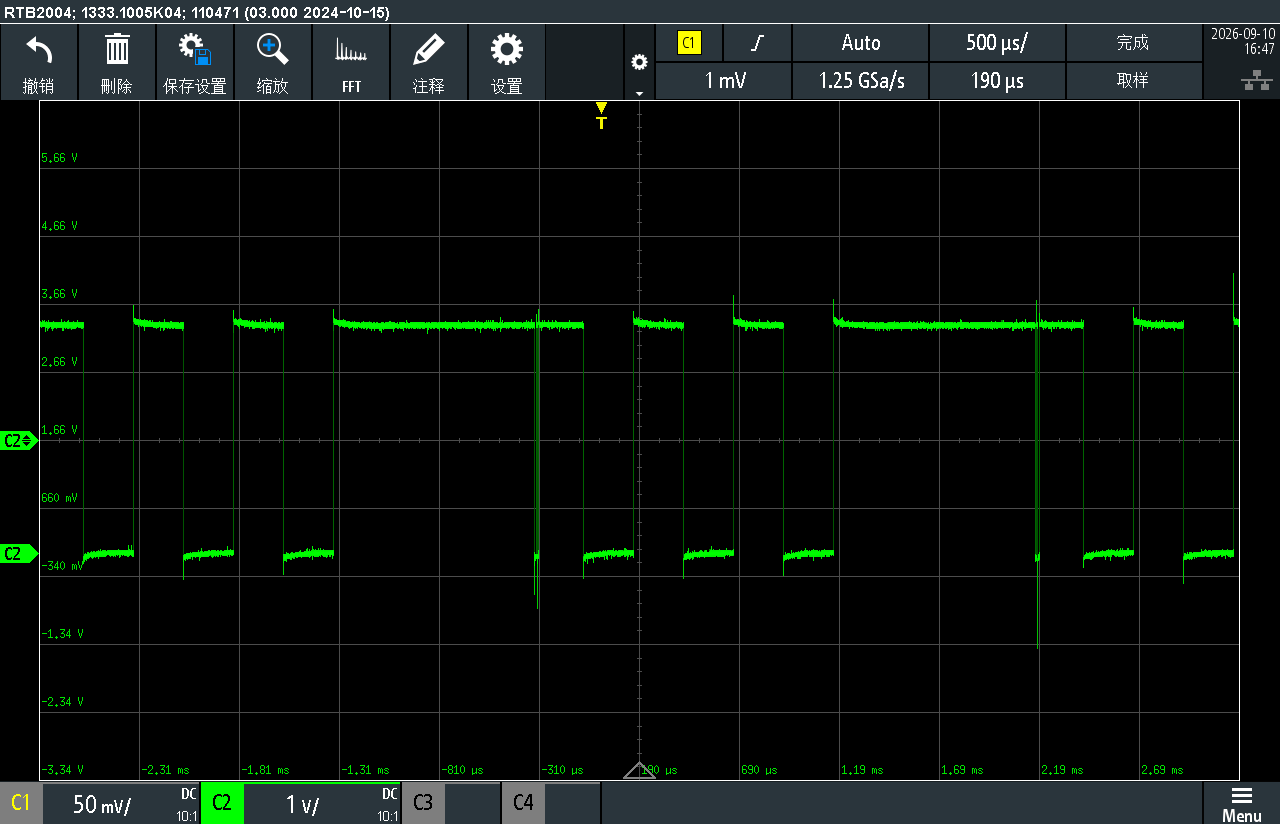
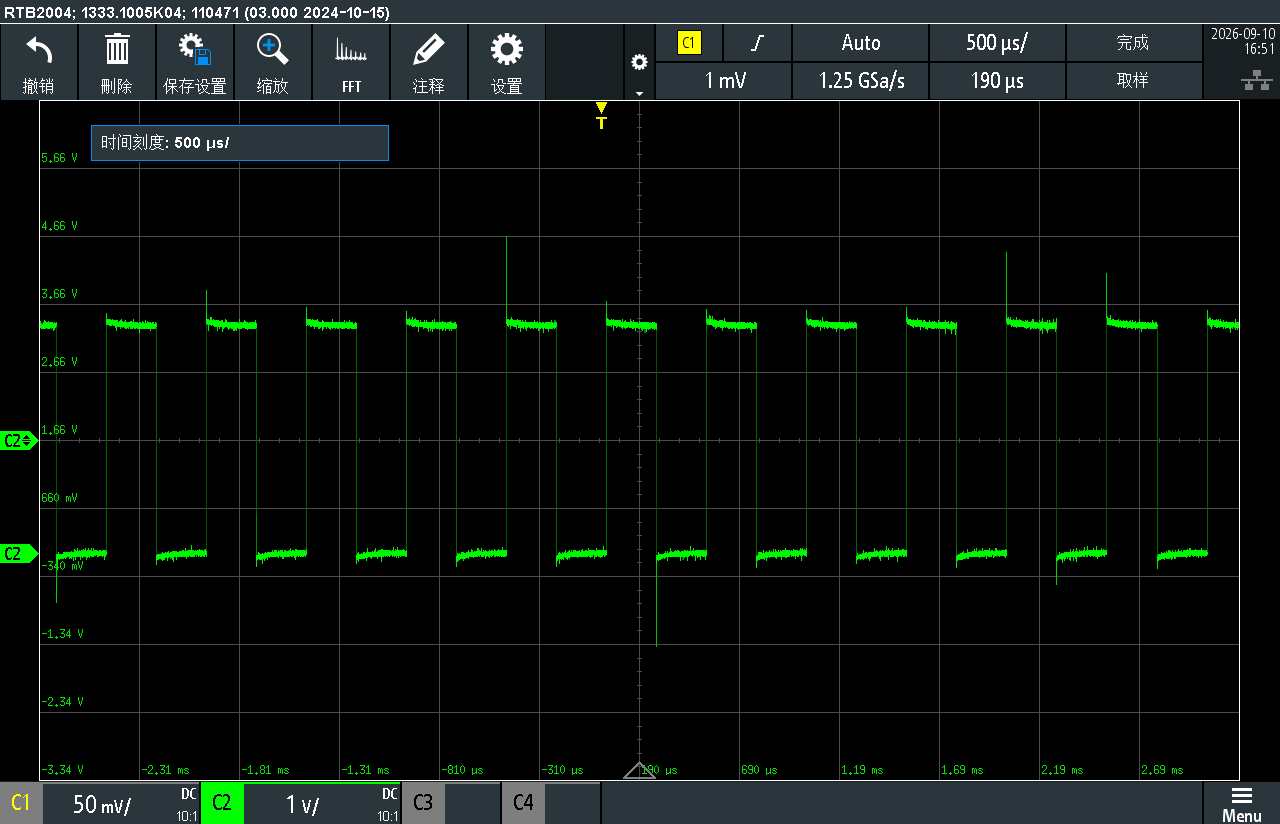
Esta prueba también se ejecuta bajo carga completa de CPU. Un hilo de kernel mantiene periódicamente un spinlock en un núcleo de CPU mientras una tarea SCHED_FIFO en el mismo núcleo conmuta un pin GPIO para generar una onda cuadrada de 2 kHz. Las marcas de tiempo de los flancos se registran en un búfer circular y se escriben en un archivo de registro al salir, de modo que el propio registro nunca añade jitter. Las estadísticas flanco a flanco y la vista del osciloscopio muestran directamente la diferencia (bloqueo mantenido durante 300 µs cada 1 ms):
| Tiempo de bloqueo / período | Métrica | Kernel estándar | Kernel en tiempo real |
|---|---|---|---|
| 300 µs / 1 ms | p99 / máx / σ | 306 / 325~547 / 40 µs | 251 / 257 / 0,56 µs |
| 500 µs / 1 ms | flancos perdidos / pares fusionados | 25% / 25% | 0 / 0 |
| 500 µs / 1 ms | p99 / máx | 506 / 529 µs | ~251 µs |
En el kernel estándar, los flancos que caen dentro de la ventana del spinlock se retrasan o se pierden, por lo que la forma de onda se distorsiona visiblemente. En el kernel en tiempo real la forma de onda se mantiene limpia.
Kernel estándar: la onda cuadrada se distorsiona y se detiene siempre que se mantiene el spinlock:
Kernel en tiempo real: una onda cuadrada continua (base de tiempo 500 µs/div):
Control de motor servo EtherCAT
Esta prueba también se ejecuta bajo carga completa de CPU: el núcleo objetivo se mantiene cargado en todas las fases. El dispositivo Jetson ejecuta un IgH EtherCAT master (ciclo de 1 kHz, SCHED_FIFO 89) que acciona un motor servo EtherCAT. El variador EtherCAT tiene un watchdog de comunicación de unos 100 ms: si los frames de datos de proceso se detienen durante más tiempo, el variador corta la salida y el motor se detiene. El módulo de interferencia mantiene un spinlock durante 1.000 ms cada 3 s en el núcleo del master, por lo que cualquier congelación más larga que el watchdog debería, y de hecho lo hace, matar el bus en el kernel estándar.
Una demostración de tres fases muestra toda la historia en una sola ejecución:
| Fase | Interferencia | Kernel estándar | Kernel en tiempo real |
|---|---|---|---|
| 1 (10 s) | Solo carga de CPU | El motor gira suavemente | El motor gira suavemente |
| 2 (15 s) | + spinlock (1,000 ms / 3 s) | CYCLE BROKEN — SAFE STOP, el bus sale de OP, el motor se detiene | El motor sigue girando, cero alarmas |
| 3 (15 s) | spinlock eliminado, la carga permanece | El maestro se autorrecupera en ~4 s, el motor se reinicia | Sin cambios |
Métricas principales en ejecuciones idénticas:
| Métrica | Kernel estándar | Kernel en tiempo real |
|---|---|---|
| Parada segura activada | En la primera ventana de bloqueo | Nunca |
| Esclavo salió de OP | 1~3 veces por 25 s | 0 veces |
| Despertar del maestro p50 / p99 / máx. | 7 / ~994,000 / ~1,018,000 µs | 2 / 3 / 12 µs |
| Ciclos por encima de 1 ms (por 5,000) | ~2,000 | 0 |
| Comportamiento del motor | Se detiene mientras está bloqueado, se recupera ~4 s después de liberar | Movimiento sinusoidal continuo |
Salida del kernel estándar cuando se produce el bloqueo (el maestro se congela durante un segundo completo y luego se recupera después de liberar el bloqueo):
############ Phase 2: LOADING spinlock interference ############
*** CYCLE BROKEN (frozen >500ms) — SAFE STOP: disabling motor ***
!!! BUS DROPPED: slave left OP (AL 0x08 -> 0x4) — comm watchdog/error !!!
[STAT] cycles=15000 WKC0=2255 late>1ms=2084 drops(total)=1
       wake_us p50/p99/max=7/994615/1018037
############ Phase 3: REMOVING interference ############
+++ cycle restored — re-enabling motor +++
Salida del kernel en tiempo real bajo la misma interferencia, durante toda la ejecución:
[STAT] cycles=5000  WKC0=131  late>1ms=0 drops(total)=0 wake_us p50/p99/max=2/3/8
[STAT] cycles=10000 WKC0=0    late>1ms=0 drops(total)=0 wake_us p50/p99/max=2/3/9
[STAT] cycles=15000 WKC0=0    late>1ms=0 drops(total)=0 wake_us p50/p99/max=2/3/8
Running: Act=41268 Vel=29970 TgtV=29630 md=9 SW=1237
El maestro tiene monitorización de salud de ciclo integrada: un retraso de despertar superior a 500 ms se trata como "congelado" y dispara una parada segura controlada (práctica estándar para pilas industriales); el motor se vuelve a habilitar después de 4 s sin ningún congelamiento. En el kernel estándar la interferencia vuelve cada 3 s, por lo que la ventana de recuperación nunca se abre.
En el kernel estándar, el maestro se bloquea durante segundos completos — más de 10 veces el tiempo de vigilancia del variador EtherCAT (~100 ms) — por lo que el bus sale del estado OP y el motor se deshabilita. En el kernel en tiempo real, el jitter de despertar del maestro se mantiene dentro de unos pocos microsegundos, y ni el bus ni el motor se ven afectados por la interferencia.
En el kernel en tiempo real, el servomotor EtherCAT gira suavemente durante 30 segundos:
En el kernel estándar, el motor se detiene siempre que se mantiene el bloqueo (10 s de giro, 15 s de parada, 15 s de giro):
Grupo de control: la carga de CPU no es el asesino
Para demostrar que el daño proviene de la sección crítica no preventible y no de la utilización de CPU, se cargó el mismo núcleo con un proceso de usuario SCHED_OTHER ordinario (ocupado 1 s / inactivo 2 s, picos al 100%) en lugar del módulo de spinlock — mismo núcleo, mismo ritmo:
| Métrica | Estándar + carga de CPU | Tiempo real + carga de CPU | Estándar + spinlock |
|---|---|---|---|
| Motor | Gira | Gira | Se detiene |
| Caídas de bus / paradas seguras | 0 / 0 | 0 / 0 | 1~3 / activadas |
| p99 de despertar | hasta 1,879 µs | 11 µs | ~994,000 µs |
| máx. de despertar | ~8,200 µs | 32 µs | ~1,018,000 µs |
| Ciclos por encima de 1 ms (por 5,000) | 28~56 | 0 | ~2,000 |
La carga en espacio de usuario nunca tiene prioridad sobre una tarea SCHED_FIFO en ninguno de los kernels, por lo que el motor sigue girando en ambas columnas — pero el kernel estándar sigue arrastrado a jitter en la escala de milisegundos (p99 aproximadamente 170 veces peor que el kernel en tiempo real). El spinlock del kernel es lo que convierte el jitter en una interrupción de un segundo. El asesino no es el uso de CPU; es la sección crítica no preventible del kernel.
Reproducir los experimentos
El código fuente completo del experimento GPIO (módulo de interferencia, tarea de onda cuadrada y Makefile) está incrustado a continuación, por lo que puede utilizarse directamente. La demostración EtherCAT está construida sobre el proyecto de código abierto ethercat-myctor con un controlador de dispositivo personalizado; el paquete completo de la demo (sobrescritura del controlador, scripts de ejecución y generador de carga de CPU) está disponible aquí: rt_ethercat_demo.zip.
El cambio entre los dos kernels se describe en Switch Between the Real-Time and Standard Kernels. Después de cada cambio, verifica con uname -v — la salida debe contener SMP PREEMPT_RT o SMP PREEMPT respectivamente.
Preparar el árbol de código fuente del kernel en tiempo real (una vez)
El paquete DEB en tiempo real incluye la imagen del kernel y los módulos pero no un paquete de headers. Los módulos del kernel deben compilarse contra un árbol de código fuente preparado mientras el kernel en tiempo real se está ejecutando, de lo contrario insmod falla con module_layout disagrees.
curl -sL -o ~/public_sources.tbz2 \
  https://developer.download.nvidia.cn/embedded/L4T/r39_Release_v2.0/sources/public_sources.tbz2
mkdir -p ~/nvsrc ~/rt-kernel-src
tar xf ~/public_sources.tbz2 -C ~/nvsrc Linux_for_Tegra/source/kernel_src.tbz2
tar xf ~/nvsrc/Linux_for_Tegra/source/kernel_src.tbz2 -C ~/rt-kernel-src --strip-components=1

cd ~/rt-kernel-src/kernel-noble
zcat /proc/config.gz > .config
sed -i 's/^CONFIG_LOCALVERSION=".*"/CONFIG_LOCALVERSION="-1021-rt-tegra"/' .config
make ARCH=arm64 olddefconfig
make ARCH=arm64 -j6 prepare modules_prepare
CONFIG_LOCALVERSION debe ser igual al sufijo de uname -r después de 6.8.12 (aquí -1021-rt-tegra), de lo contrario el vermagic del módulo no coincide. Para el kernel estándar, usa -1021-tegra y prepara el árbol de la misma manera.
Código fuente de la demo (experimento GPIO)
Crea un directorio de trabajo y coloca en él los siguientes tres archivos:
mkdir -p ~/rt_demo && cd ~/rt_demo
spinlock_holder.c — el módulo de interferencia:
// spinlock_holder: PREEMPT_RT demo module (ms and us granularity)
//
// One-shot mode (period = 0): sysfs trigger makes the bound kthread hold a
// spinlock for the configured hold time, once. On a normal kernel
// spin_lock() disables preemption so every task on that CPU freezes for
// the duration; on PREEMPT_RT spinlock_t is a sleepable rt_mutex-backed
// lock and higher priority tasks preempt the holder instead.
//
// Periodic mode (period > 0): the kthread repeats hold/idle cycles.
// Writing any *_us parameter (or period) via sysfs wakes the kthread so
// changes take effect immediately.
#include <linux/module.h>
#include <linux/kernel.h>
#include <linux/slab.h>
#include <linux/kthread.h>
#include <linux/delay.h>
#include <linux/spinlock.h>
#include <linux/wait.h>
#include <linux/sysfs.h>
#include <linux/kobject.h>
#include <linux/sched.h>
#include <linux/ktime.h>

static int demo_cpu = 3;
module_param(demo_cpu, int, 0644);
MODULE_PARM_DESC(demo_cpu, "CPU to bind the holder kthread to (default 3)");

static int hold_ms = 3000;
module_param(hold_ms, int, 0644);
MODULE_PARM_DESC(hold_ms, "critical section length in ms (one-shot default 3000)");

static int period_ms = 0;
MODULE_PARM_DESC(period_ms, "0 = one-shot trigger; >0 = repeat every period_ms (ms mode)");

static int idle_ms = 400;
module_param(idle_ms, int, 0644);
MODULE_PARM_DESC(idle_ms, "ms mode: ms to idle between critical sections");

static int hold_us = 500;
MODULE_PARM_DESC(hold_us, "us mode: critical section length in us");

static int period_us = 1000;
MODULE_PARM_DESC(period_us, "us mode: full period in us (hold_us + idle). >0 selects us mode");

static int idle_us = 700;
module_param(idle_us, int, 0644);
MODULE_PARM_DESC(idle_us, "us mode: idle part of the period in us");

static DEFINE_SPINLOCK(test_lock);
static DECLARE_WAIT_QUEUE_HEAD(trigger_wq);
static atomic_t triggered = ATOMIC_INIT(0);

static struct task_struct *holder_task;
static u64 hold_count;

static void spin_for_ns(u64 ns)
{
	u64 end = ktime_get_ns() + ns;
	while (ktime_get_ns() < end)
		cpu_relax();
}

static void spin_for_ns_periodic(u64 ns)
{
	if (ns > (u64)50 * 1000)         /* > 50 us left: udelay in chunks */
		udelay(ns / 1000);
	else if (ns > 0)
		spin_for_ns(ns);
}

static void run_critical_section_us(void)
{
	u64 t0_ns = ktime_get_ns();
	u64 t1_ns;

	spin_lock(&test_lock);
	spin_for_ns((u64)hold_us * 1000);
	spin_unlock(&test_lock);

	t1_ns = ktime_get_ns();
	hold_count++;

	/* log only every 2000 holds to keep dmesg quiet at kHz rates */
	if (hold_count % 2000 == 1)
		pr_info("spinlock_holder: cpu %d hold #%llu wall %llu us (%s)\n",
			smp_processor_id(), hold_count,
			div_u64(t1_ns - t0_ns, 1000),
			(t1_ns - t0_ns) > (u64)hold_us * 1200
				? "stretched by preemption" : "clean");
}

static void run_critical_section_ms(void)
{
	u64 t0_ns = ktime_get_ns();
	u64 t1_ns;

	spin_lock(&test_lock);
	mdelay(hold_ms);
	spin_unlock(&test_lock);

	t1_ns = ktime_get_ns();
	hold_count++;

	pr_info("spinlock_holder: cpu %d hold #%llu wall %llu ms (%s)\n",
		smp_processor_id(), hold_count,
		div_u64(t1_ns - t0_ns, 1000000),
		(t1_ns - t0_ns) > (u64)hold_ms * 1200000 / 1000
			? "stretched by preemption" : "clean");
}

static int holder_fn(void *unused)
{
	while (!kthread_should_stop()) {
		if (period_us > 0) {
			u64 cycle_start = ktime_get_ns();
			s64 spent_ns;

			run_critical_section_us();
			/* busy-wait the remainder of the period for exact rate.
			 * s64: if hold overran the period, remainder clamps to 0
			 * instead of wrapping to ~2^64 ns (which would udelay forever). */
			spent_ns = (s64)(ktime_get_ns() - cycle_start);
			if (spent_ns < (s64)period_us * 1000)
				spin_for_ns_periodic((u64)period_us * 1000 - (u64)spent_ns);
		} else if (period_ms > 0) {
			run_critical_section_ms();
			msleep(max(idle_ms, 1));
		} else {
			wait_event_interruptible(trigger_wq,
						 atomic_read(&triggered) || kthread_should_stop());
			if (kthread_should_stop())
				break;
			if (atomic_read(&triggered)) {
				run_critical_section_ms();
				atomic_set(&triggered, 0);
			}
		}
	}
	return 0;
}

static int wake_holder(const char *val, const struct kernel_param *kp)
{
	int ret = param_set_int(val, kp);
	if (ret)
		return ret;
	atomic_set(&triggered, 1);
	wake_up(&trigger_wq);
	if (holder_task)
		wake_up_process(holder_task);
	return 0;
}

static const struct kernel_param_ops wake_ops = { .set = wake_holder, .get = param_get_int };
module_param_cb(period_ms, &wake_ops, &period_ms, 0644);
module_param_cb(period_us, &wake_ops, &period_us, 0644);
module_param_cb(hold_us, &wake_ops, &hold_us, 0644);

static ssize_t trigger_store(struct kobject *kobj, struct kobj_attribute *attr,
			     const char *buf, size_t count)
{
	if (period_us > 0 || period_ms > 0)
		return -EBUSY;
	atomic_set(&triggered, 1);
	wake_up(&trigger_wq);
	return count;
}

static struct kobj_attribute trigger_attribute =
	__ATTR(trigger, 0220, NULL, trigger_store);

static struct kobject *demo_kobj;

static int __init spinlock_holder_init(void)
{
	struct task_struct *t;
	int ret;

	/* create parked, bind while parked, then start — kthread_run()+bind()
	 * races and the bind gets rejected with a WARNING in dmesg */
	t = kthread_create(holder_fn, NULL, "spinlock_holder");
	if (IS_ERR(t))
		return PTR_ERR(t);
	kthread_bind(t, demo_cpu);
	wake_up_process(t);
	holder_task = t;

	demo_kobj = kobject_create_and_add("spinlock_holder", kernel_kobj);
	if (!demo_kobj) {
		kthread_stop(t);
		return -ENOMEM;
	}

	ret = sysfs_create_file(demo_kobj, &trigger_attribute.attr);
	if (ret) {
		kobject_put(demo_kobj);
		kthread_stop(t);
		return ret;
	}

	pr_info("spinlock_holder: loaded, cpu %d, us-mode: hold %d us / period %d us%s\n",
		demo_cpu, hold_us, period_us,
		period_us > 0 ? " [ACTIVE]" : " (inactive; set period_us>0)");
	return 0;
}

static void __exit spinlock_holder_exit(void)
{
	kthread_stop(holder_task);
	kobject_put(demo_kobj);
	pr_info("spinlock_holder: unloaded after %llu holds\n", hold_count);
}

module_init(spinlock_holder_init);
module_exit(spinlock_holder_exit);

MODULE_LICENSE("GPL");
MODULE_DESCRIPTION("PREEMPT_RT demo: spinlock critical section vs schedulable tasks (ms/us modes)");
gpio_pwm.c — la tarea de onda cuadrada SCHED_FIFO (requiere sudo apt install -y libgpiod-dev):
// gpio_pwm: toggle a GPIO line every half-period from a SCHED_FIFO task.
// Half period is configurable in microseconds (default 500000 = 1s square
// wave). Edges are timestamped (CLOCK_MONOTONIC) into a ring buffer and
// flushed to edges.log so logging itself never adds jitter.
#define _GNU_SOURCE
#define _DEFAULT_SOURCE
#include <gpiod.h>
#include <sys/mman.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <time.h>
#include <sched.h>
#include <unistd.h>
#include <errno.h>
#include <signal.h>

#define CHIP    "gpiochip0"
#define LINE    41
#define NBUF    (1 << 20)                      /* 1M edges ring buffer */

static volatile sig_atomic_t stop = 0;
static void on_sigint(int s) { (void)s; stop = 1; }

static double now_sec(void)
{
	struct timespec ts;
	clock_gettime(CLOCK_MONOTONIC, &ts);
	return ts.tv_sec + ts.tv_nsec / 1e9;
}

struct edge { int level; double t; };
static struct edge ring[NBUF];
static size_t nring;

int main(int argc, char **argv)
{
	int cpu = argc > 1 ? atoi(argv[1]) : 3;
	long half_us = argc > 2 ? atol(argv[2]) : 500000;
	struct gpiod_chip *chip;
	struct gpiod_line *line;
	struct sched_param sp = { .sched_priority = 80 };
	cpu_set_t set;
	FILE *log;
	double t0, target;
	int level = 0;
	struct sigaction sa = { .sa_handler = on_sigint };
	struct timespec req;

	sigaction(SIGINT, &sa, NULL);

	CPU_ZERO(&set);
	CPU_SET(cpu, &set);
	if (sched_setaffinity(0, sizeof(set), &set)) { perror("setaffinity"); return 1; }
	if (sched_setscheduler(0, SCHED_FIFO, &sp)) { perror("SCHED_FIFO (run as root)"); }
	mlockall(MCL_CURRENT | MCL_FUTURE);

	chip = gpiod_chip_open_by_name(CHIP);
	if (!chip) { perror("gpiod_chip_open"); return 1; }
	line = gpiod_chip_get_line(chip, LINE);
	if (!line) { perror("gpiod_chip_get_line"); return 1; }
	if (gpiod_line_request_output(line, "gpio_pwm", 0)) { perror("request_output"); return 1; }

	fprintf(stderr, "gpio_pwm: toggling %s line %d every %ld us on cpu %d (fifo %d). Ctrl-C to stop.\n",
		CHIP, LINE, half_us, cpu, sp.sched_priority);

	t0 = now_sec();
	target = t0;

	while (!stop) {
		level = !level;
		gpiod_line_set_value(line, level);

		if (nring < NBUF) {
			ring[nring].level = level;
			ring[nring].t = now_sec() - t0;
			nring++;
		} else {
			fprintf(stderr, "ring full, stopping\n");
			break;
		}

		target += half_us / 1e6;
		req.tv_sec = (time_t)target;
		req.tv_nsec = (long)((target - (time_t)target) * 1e9);
		clock_nanosleep(CLOCK_MONOTONIC, TIMER_ABSTIME, &req, NULL);
	}

	gpiod_line_release(line);
	gpiod_chip_close(chip);

	log = fopen("edges.log", "w");
	if (!log) { perror("fopen edges.log"); return 1; }
	for (size_t i = 0; i < nring; i++)
		fprintf(log, "%d %.6f\n", ring[i].level, ring[i].t);
	fclose(log);
	fprintf(stderr, "gpio_pwm: stopped, %zu edges written to edges.log\n", nring);
	return 0;
}
Makefile:
# Normal kernel:            make
# RT kernel (JP7.2, no headers pkg): make KDIR=~/rt-kernel-src/kernel-noble
obj-m += spinlock_holder.o

KDIR ?= /lib/modules/$(shell uname -r)/build

all: spinlock_holder.ko gpio_pwm

spinlock_holder.ko:
	KBUILD_MODPOST_WARN=1 $(MAKE) -C $(KDIR) M=$(CURDIR) modules

gpio_pwm: gpio_pwm.c
	$(CC) -O2 -Wall -o $@ $< $(shell pkg-config --cflags --libs libgpiod)

clean:
	$(MAKE) -C $(KDIR) M=$(CURDIR) clean
	rm -f gpio_pwm

.PHONY: all clean
Para usar un pin GPIO diferente, cambia las macros CHIP / LINE en gpio_pwm.c. Lista las líneas disponibles en tu carrier board con gpioinfo gpiochip0, y elige una línea no utilizada y capaz de salida en el conector de 40 pines.
Compilar el módulo de interferencia para ambos kernels
# Standard kernel
make
# Real-time kernel
KBUILD_MODPOST_WARN=1 make KDIR=~/rt-kernel-src/kernel-noble
KBUILD_MODPOST_WARN=1 es necesario para la compilación en tiempo real: un árbol que solo ejecutó modules_prepare no tiene Module.symvers, por lo que modpost informa que cada símbolo del kernel está indefinido — todas falsas alarmas.
Ejecutar las demostraciones
Demostración de GPIO (osciloscopio en el pin GPIO), bajo carga completa de CPU:
stress --cpu 6 --io 4 --vm 2 --vm-bytes 64M &
sudo insmod spinlock_holder.ko demo_cpu=3 hold_us=300 period_us=1000
sudo ./gpio_pwm 3 250
Demostración de EtherCAT (tres fases: solo carga, carga + spinlock, solo carga):
sudo ./run_demo.sh 10 15 15
El script levanta el maestro EtherCAT, espera al bus, inicia la carga de CPU, carga y elimina el módulo de spinlock según lo programado (eligiendo el .ko correcto según la versión del kernel) y limpia al final.
Problemas conocidos
| Síntoma | Causa | Solución |
|---|---|---|
insmod: File exists después de cambiar parámetros | Los parámetros del módulo solo se aplican en la primera carga | Cámbialos vía /sys/module/spinlock_holder/parameters/, o ejecuta rmmod y luego insmod de nuevo |
| La interferencia parece cargada pero la forma de onda está limpia | El hilo holder se detuvo sin un error ("ejecución falsa") | Comprueba que el contador hold # en dmesg siga avanzando; si no, ejecuta rmmod y vuelve a cargar |
insmod: Invalid module format | Módulo compilado contra el otro kernel | Vuelve a compilar contra el árbol del kernel en ejecución |
modpost: "kfree" ... undefined | El árbol preparado no tiene Module.symvers | Compila con KBUILD_MODPOST_WARN=1 |
openssl/opensslv.h: No such file | Falta libssl-dev | sudo apt install libssl-dev |
El puerto EtherCAT muestra Link: DOWN | NetworkManager tomó el puerto | sudo nmcli dev set <interface> managed no |
| El actuador se niega a activarse tras repetidos disparos del watchdog | Bloqueo del firmware del drive después de muchas caídas del bus | Apaga y enciende el actuador |
| Todo falla después de interrumpir el script de demostración | El módulo de spinlock quedó cargado | sudo rmmod spinlock_holder, luego apaga y enciende el actuador si es necesario |
Conclusión
En el kernel estándar, un spinlock de kernel mantenido durante un segundo congela cada tarea en esa CPU durante un segundo, incluido un maestro EtherCAT SCHED_FIFO de máxima prioridad. Un segundo de pérdida de tramas es diez veces el watchdog del drive, por lo que el bus sale de OP y el motor se detiene, y la interferencia repetida impide la recuperación. En el kernel PREEMPT_RT, la misma interferencia le cuesta a la tarea en tiempo real unos pocos microsegundos. Para buses de campo de tiempo real estricto, el kernel en tiempo real no es "más rápido": es inmune a quedarse sin CPU debido a actividad dentro del kernel, una propiedad que ninguna cantidad de ajuste puede garantizar en el kernel estándar.
Referencias
- https://wiki.seeedstudio.com/es/flash_preempt_rt_kernel_on_recomputer_jetson_jetpack_6_2_1/
- https://gitlab.com/etherlab.org/ethercat
Soporte técnico y debate sobre el producto
Gracias por elegir nuestros productos. Estamos aquí para ofrecerte diferentes tipos de soporte y garantizar que tu experiencia con nuestros productos sea lo más fluida posible. Ofrecemos varios canales de comunicación para adaptarnos a distintas preferencias y necesidades.