Acelera llama.cpp en NVIDIA Jetson AGX Orin con MTP
Introducción
Este wiki explica cómo funciona la predicción multi‑token (Multi-Token Prediction, MTP) y cómo activarla en llama.cpp en NVIDIA Jetson AGX Orin con Qwen3.5-4B. Sigue la configuración y compara el rendimiento con MTP activado y desactivado usando una demo local de monitorización de multitudes.
Primero, observa los resultados de prueba reales. Hicimos que el LLM generara un script de Python para calcular la secuencia de Fibonacci y comparamos la velocidad de generación con y sin el modelo MTP activado.
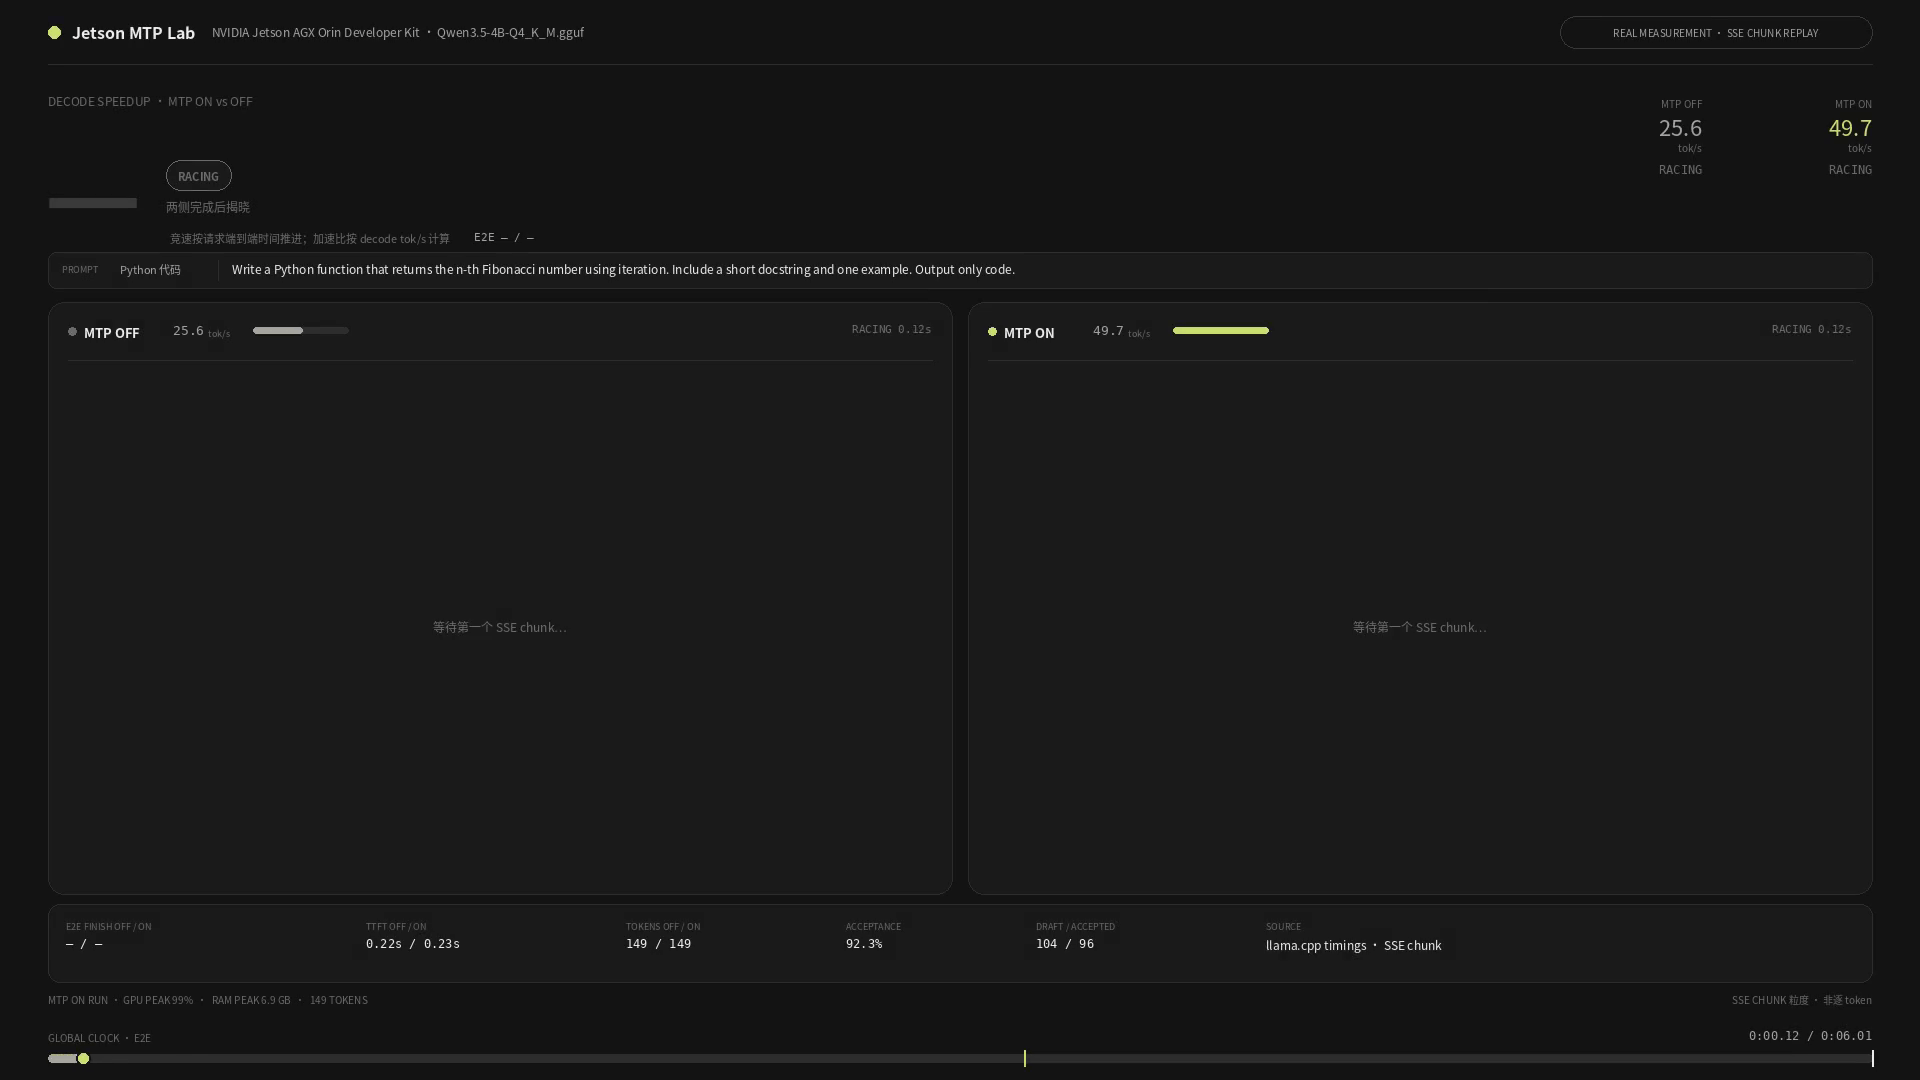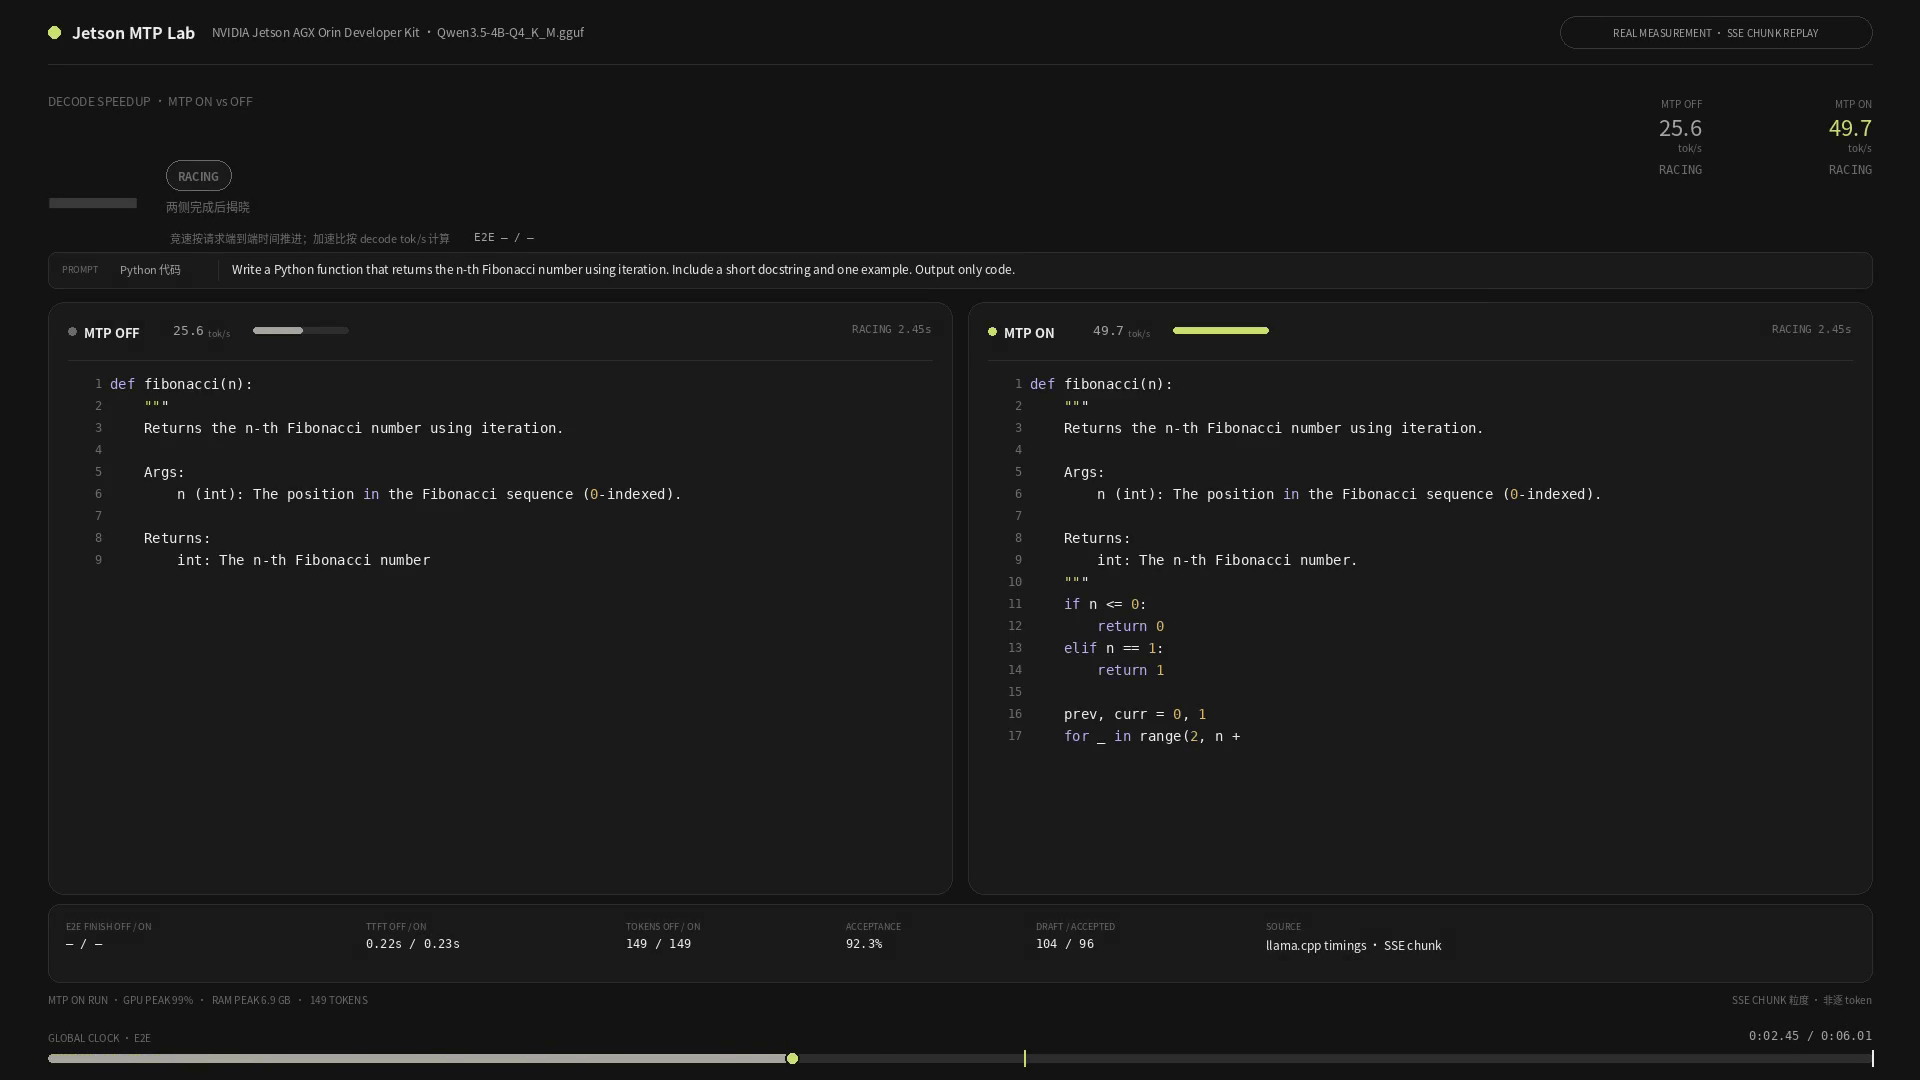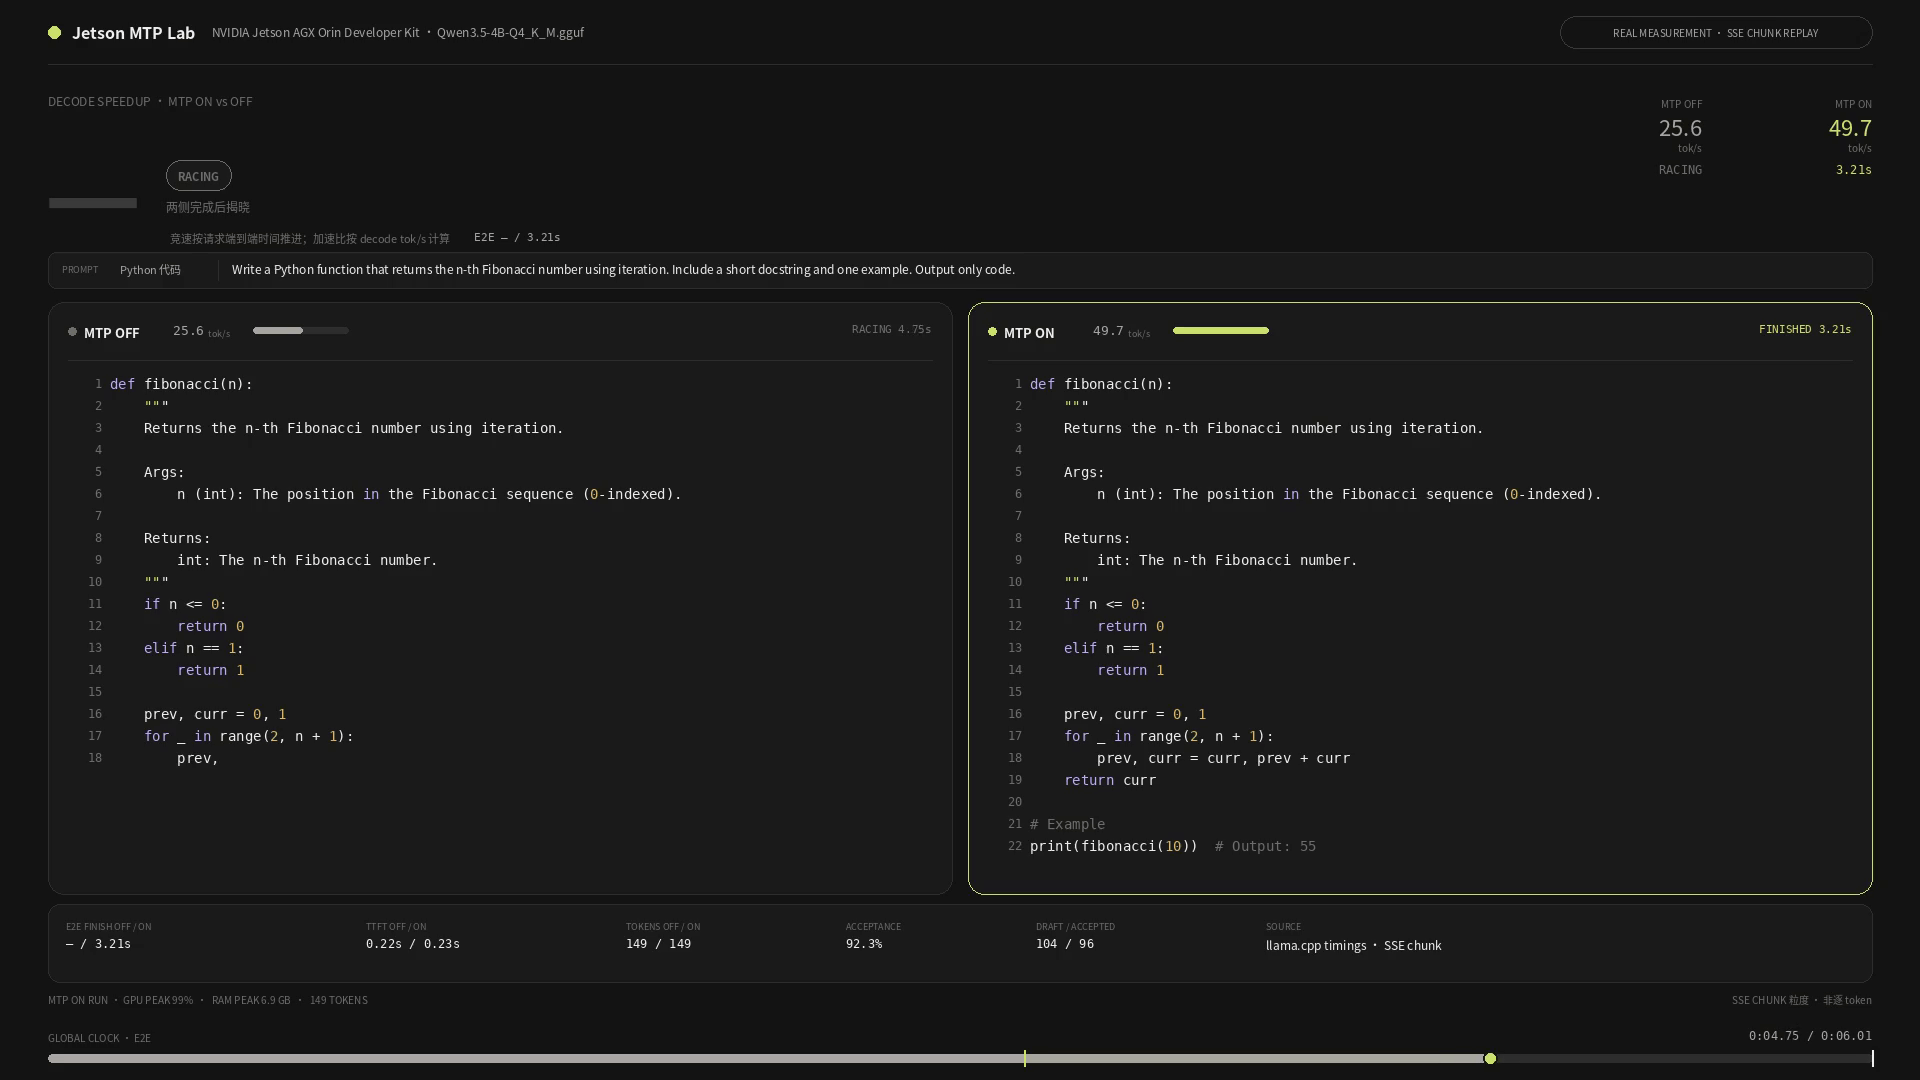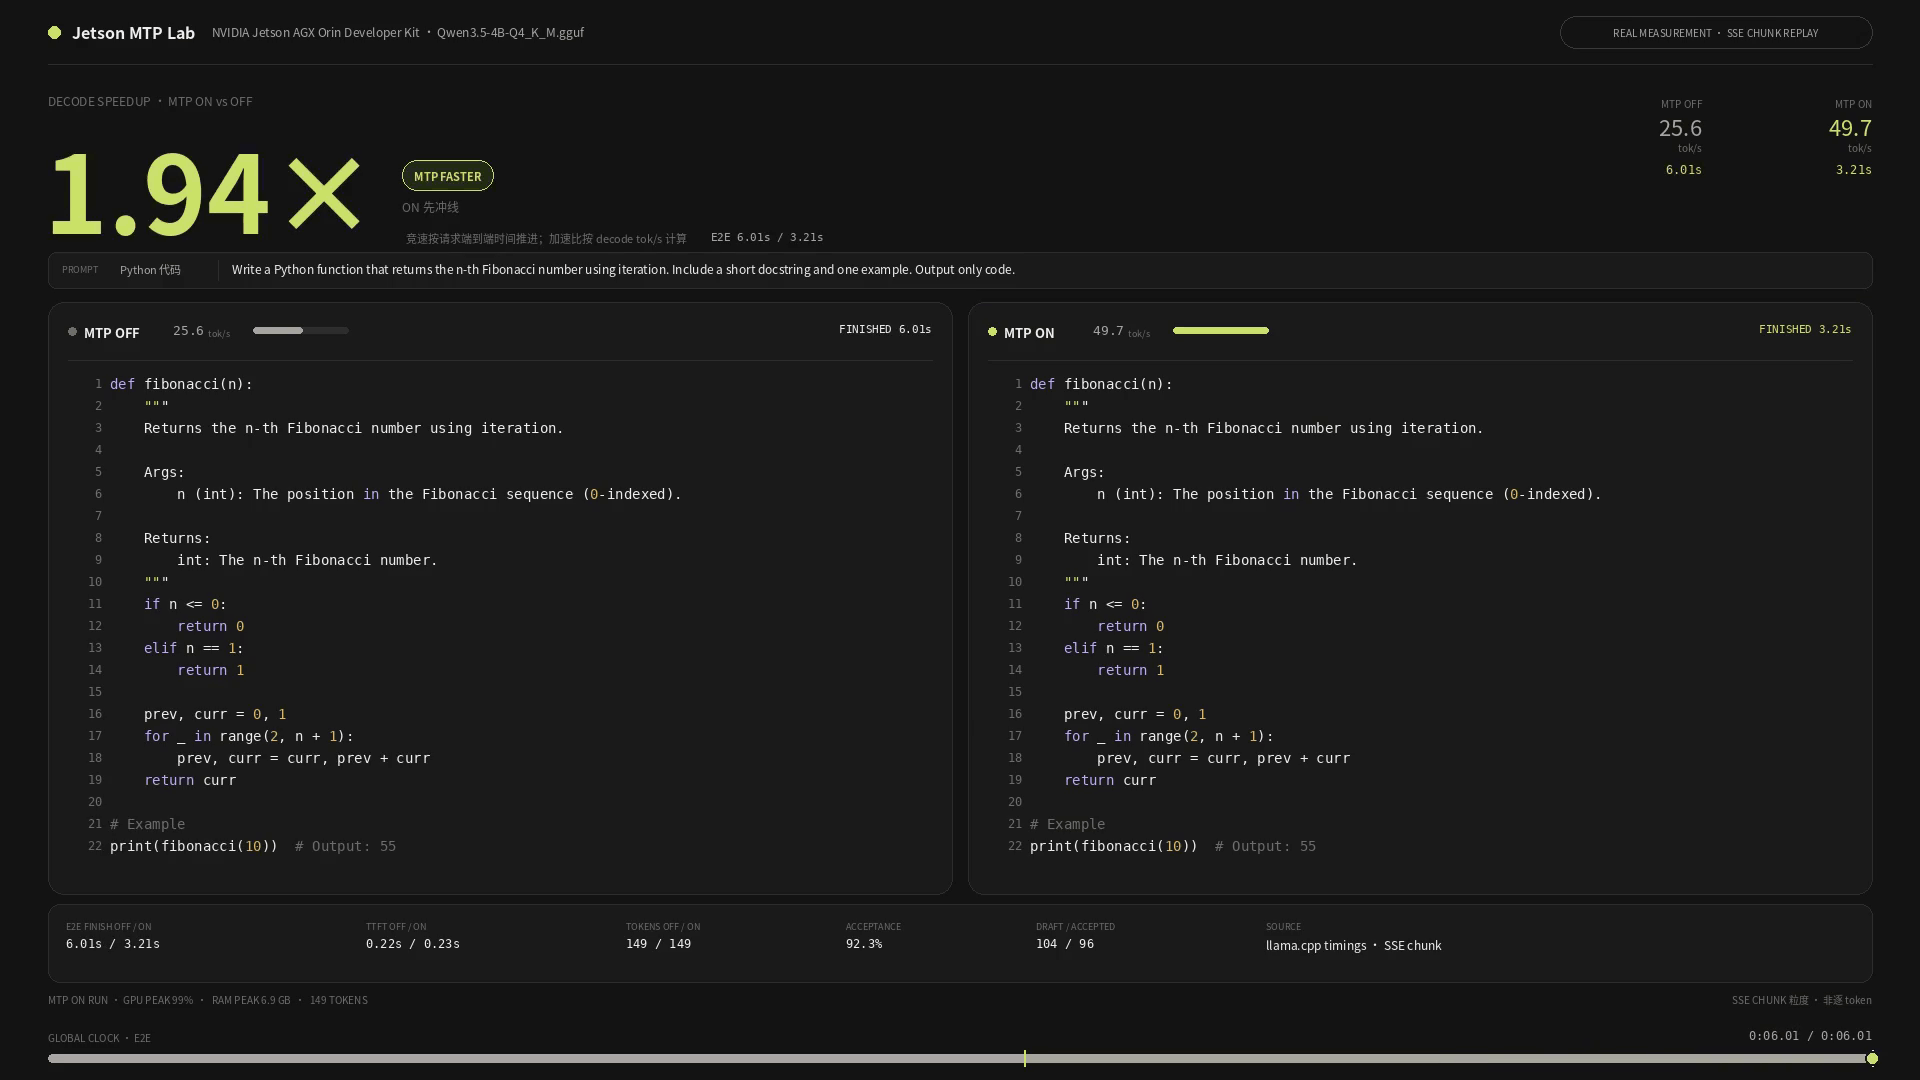
Sin el modo MTP activado, el modelo Qwen3.5 4B genera tokens a una velocidad de unos 25,6 tokens/s, mientras que con el modo MTP activado, el mismo modelo en el mismo dispositivo alcanza una velocidad de generación de 49,7 tokens/s. Se puede ver que, para este tipo de contenido relativamente determinista, la velocidad de generación del modelo casi se duplica. Esto nos da una pista: ¡para algunas tareas relativamente rutinarias, activar el modo MTP puede aportar mejoras de rendimiento considerables!
Veamos otro escenario de análisis visual: define una región ROI y supervisa si el recuento en el ROI se mantiene en cinco personas o más durante 1,5 segundos; si es así, llama al LLM para realizar un análisis y diagnóstico de anomalías. ¡Veamos cuánto más rápido es con el modo MTP activado en el escenario de análisis visual!
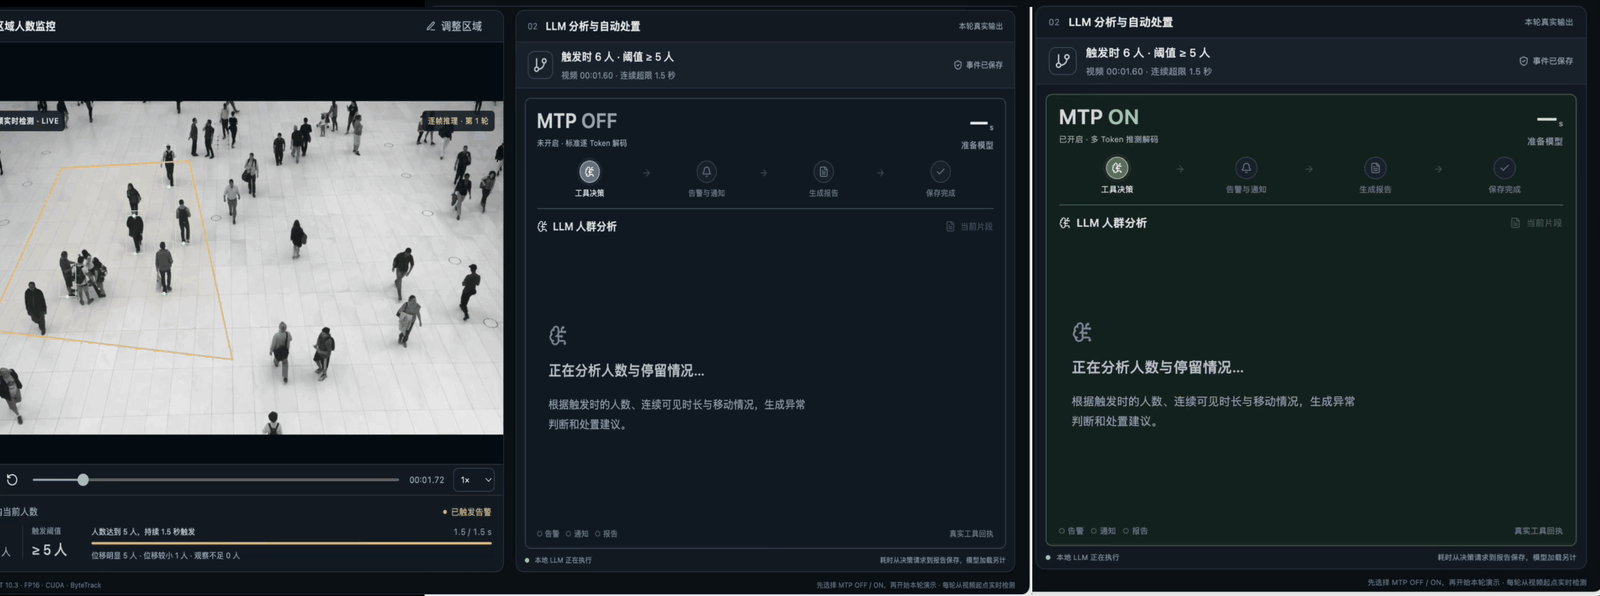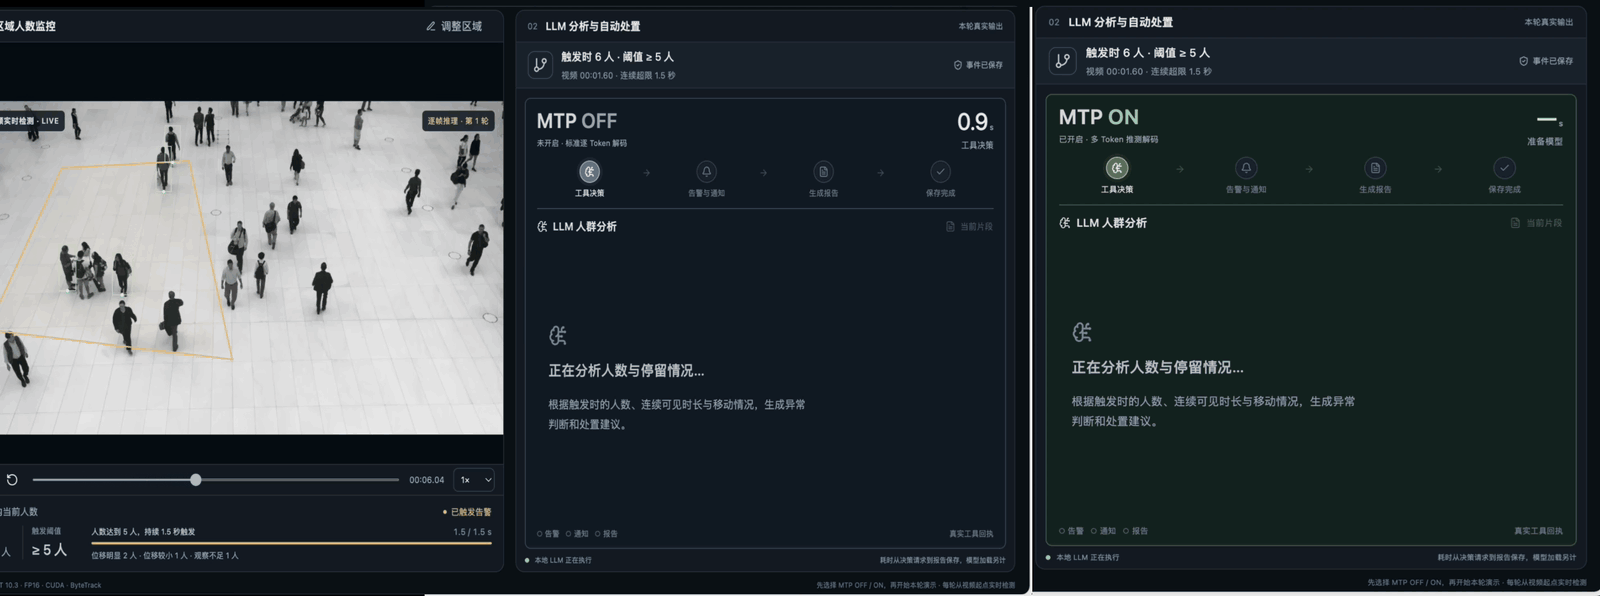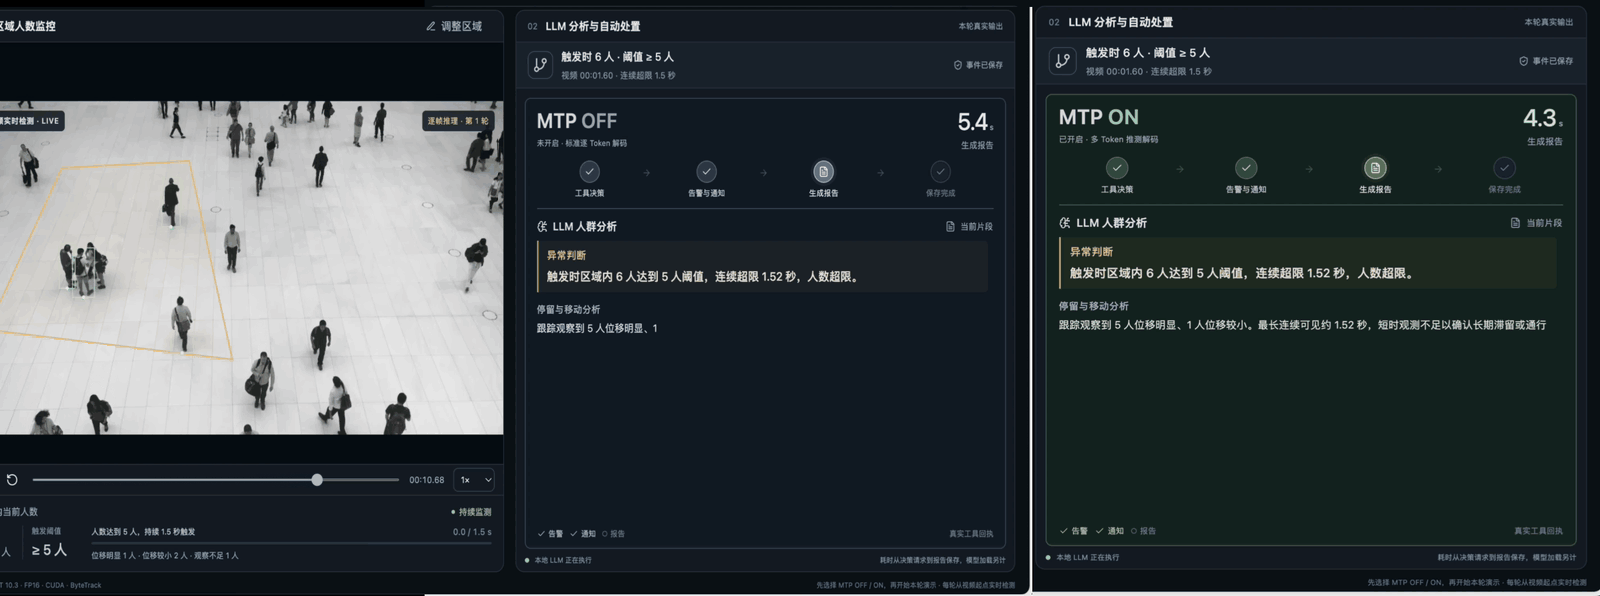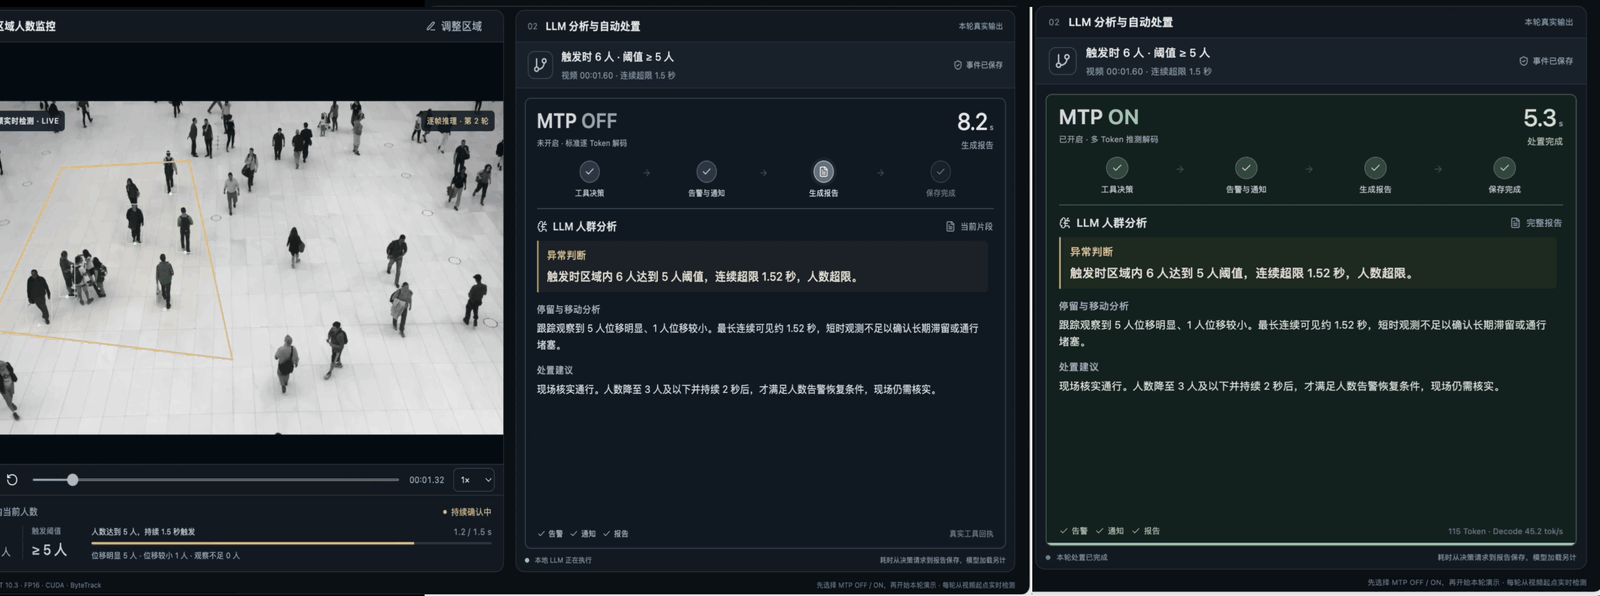
Como se puede ver, para el escenario anterior, activar el modo MTP puede acortar nuestro tiempo de finalización de la tarea en unos 3 segundos; ¡esta optimización es bastante significativa!
¿Por qué la generación de texto de un LLM lleva tiempo?
Un token cada vez
Si le preguntas a un modelo dónde se puede usar NVIDIA Jetson, puede responder con robótica, visión industrial y monitorización en el edge. La frase aparece gradualmente porque un LLM autorregresivo predice un token, lo añade al contexto y usa ese contexto para predecir el siguiente.
Un token puede ser una palabra, parte de una palabra o un signo de puntuación. Cada nueva predicción depende de lo que vino antes, por lo que el modelo repite este proceso hasta que la respuesta está completa.
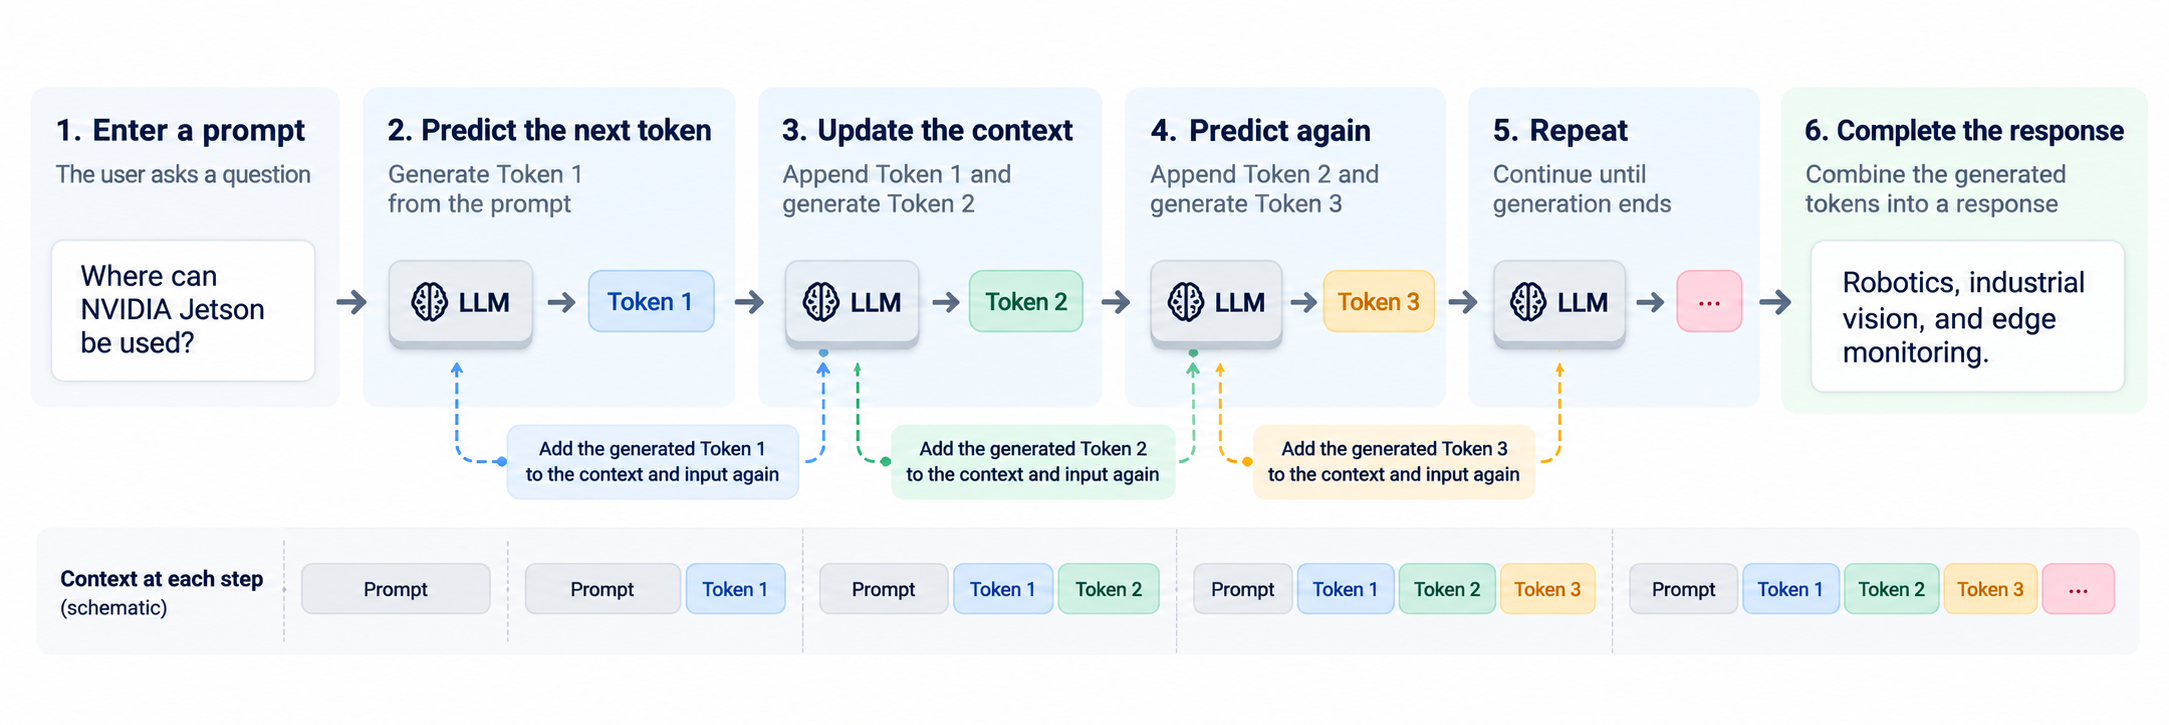
A 20 tokens/s, generar 500 tokens lleva unos 25 segundos de tiempo de decodificación. Esa espera se vuelve notable cuando un asistente local escribe código o un informe.
Prefill y decodificación
La inferencia de un LLM tiene dos etapas principales.
| Etapa | Tarea principal | Característica |
|---|---|---|
| Prefill | Leer el prompt y construir el estado de contexto | Las posiciones de entrada se pueden procesar en paralelo |
| Decodificación | Generar la respuesta | Los tokens posteriores dependen de la salida anterior |
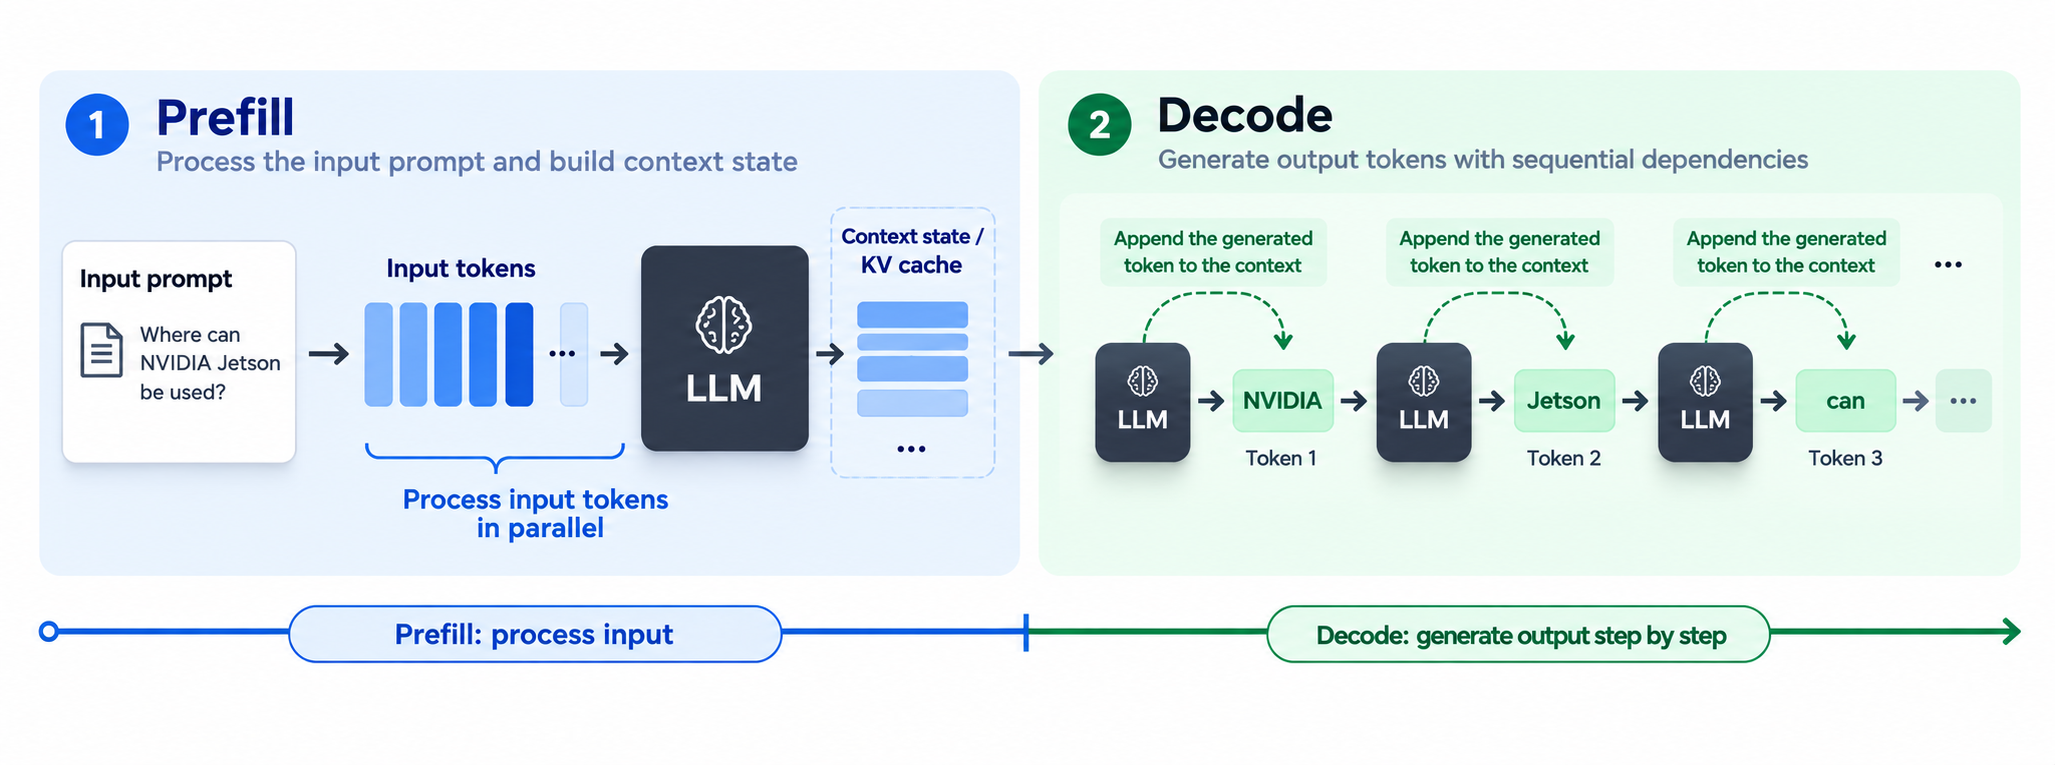
Para un LLM de un solo usuario en Jetson, la decodificación a menudo pasa gran parte de su tiempo leyendo pesos del modelo y contexto en caché desde la memoria. La GPU tiene capacidad de cómputo paralelo, pero una secuencia de pasos de un solo token puede hacer un uso limitado de ella. MTP se dirige principalmente a esta etapa de decodificación.
¿Qué es la predicción multi‑token (MTP)?
La predicción multi‑token entrena cabeceras o capas de predicción adicionales para proponer tokens futuros. Estos candidatos pueden utilizarse después en la decodificación especulativa, donde el modelo objetivo verifica varias posiciones juntas antes de aceptar la salida.
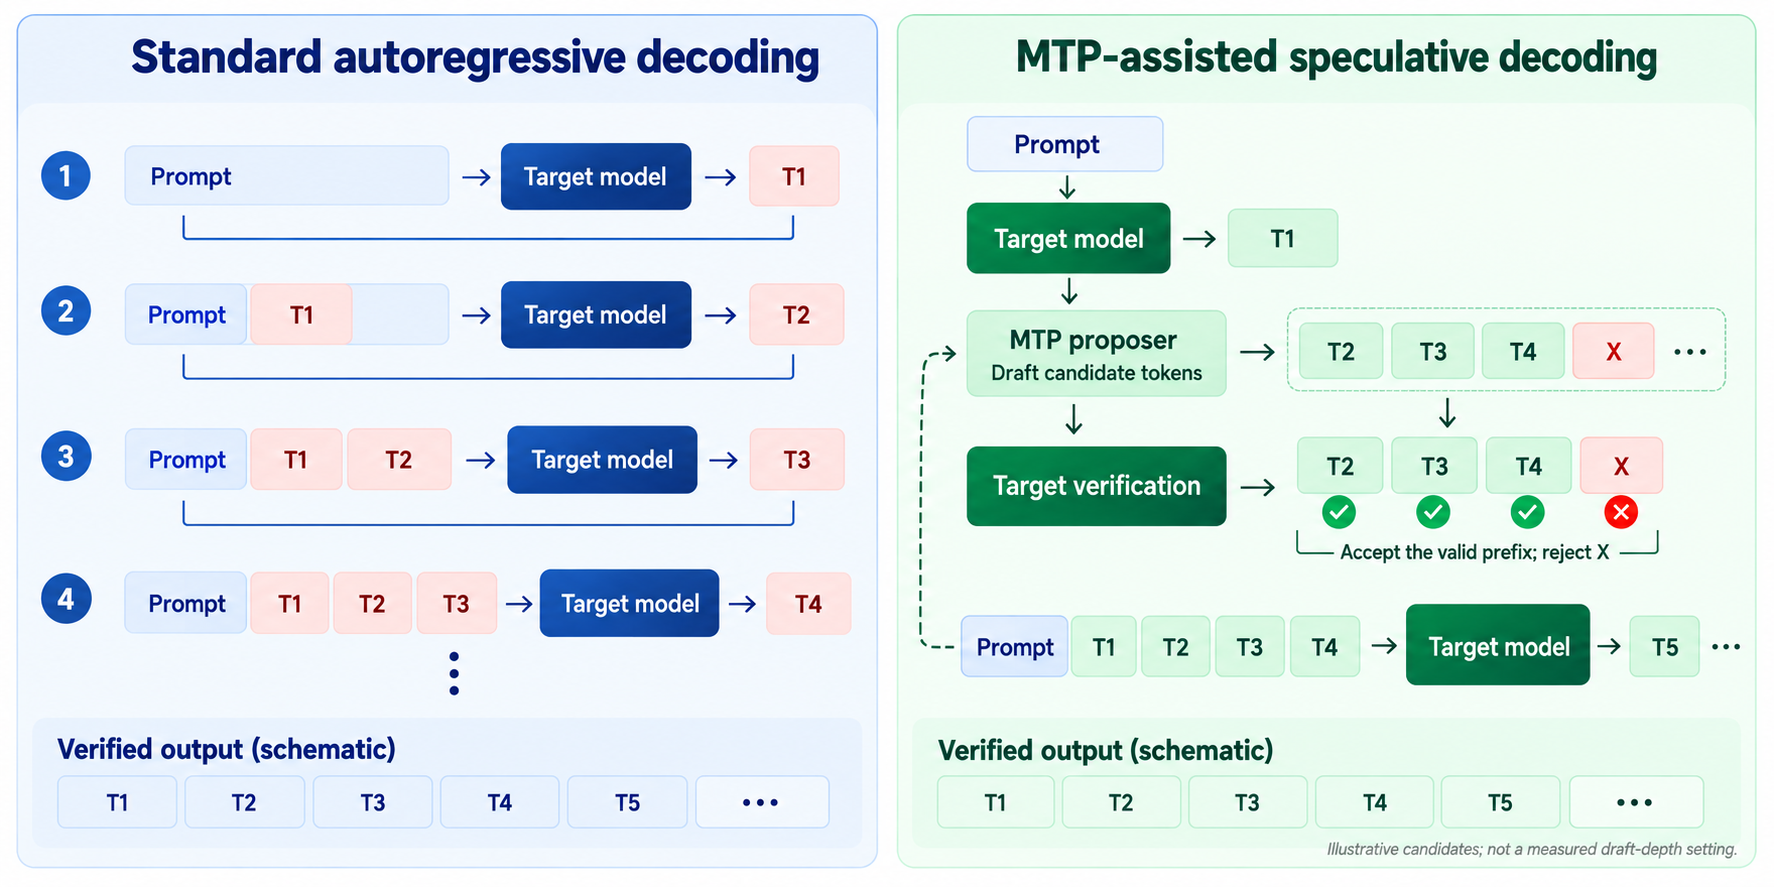
Cuando varios candidatos superan la verificación, la respuesta avanza varios tokens en una sola pasada del modelo objetivo. Si un candidato falla, el runtime conserva el prefijo aceptado y descarta el candidato rechazado y el borrador restante. El modelo objetivo continúa desde ese punto.
Esto reduce el número de pasadas de decodificación en serie cuando las propuestas son lo suficientemente precisas. El modelo objetivo sigue comprobando la salida. Una decodificación especulativa sin pérdidas y correcta preserva su resultado codicioso (greedy) o distribución de muestreo, aunque la cuantización y las diferencias numéricas del runtime pueden afectar al comportamiento práctico.
El artículo sobre predicción multi‑token explica la idea de entrenamiento. La documentación de decodificación especulativa de llama.cpp describe su uso durante la inferencia.
¿Por qué MTP puede ser más rápido?
Más salida útil por verificación
La verificación por lotes permite que el modelo objetivo compruebe varios candidatos juntos. En una carga de trabajo limitada por el ancho de banda de memoria, eso puede costar menos que generar los mismos tokens mediante pasadas en serie separadas.
La redacción y la verificación también llevan tiempo. MTP solo acelera la generación cuando el trabajo ahorrado supera este coste adicional. Un diagnóstico útil es la tasa de aceptación del borrador, calculada como tokens de borrador aceptados divididos por tokens de borrador generados. También mide cuánto avanza la respuesta con cada verificación y cuánto tarda la petición completa.
La profundidad del borrador necesita pruebas
La longitud máxima del borrador se controla con --spec-draft-n-max. Un borrador más largo da al modelo objetivo más candidatos que comprobar, pero los candidatos posteriores pueden ser menos precisos. Desecharlos puede superar el beneficio de un lote más grande.
Empieza con una profundidad pequeña y compárala en tus propios prompts. La comparación de Edge Crowd Agent usa profundidad 2. Una configuración que funciona bien para formatos regulares de código o informes puede comportarse de forma diferente en otra carga de trabajo.
Activa MTP en llama.cpp en Jetson
Las demostraciones utilizan la siguiente configuración.
| Componente | Configuración |
|---|---|
| Hardware | NVIDIA Jetson AGX Orin 32GB |
| JetPack | 6.2.1 |
| Runtime | llama.cpp con CUDA |
| Modelo | Qwen3.5-4B con tensores MTP |
| Cuantización | Q4_K_M GGUF |
| Comparación | MTP desactivado / MTP activado |
Compila llama.cpp con CUDA siguiendo las instrucciones de compilación oficiales. Elige el Qwen3.5-4B GGUF con MTP activado y comprueba que la salida de ayuda de tu binario incluya draft-mtp.
Una vez que el runtime esté listo, el comando de lanzamiento con MTP es corto.
llama-server \
  -hf unsloth/Qwen3.5-4B-MTP-GGUF:Q4_K_M \
  -ngl 99 -c 8192 -np 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 2
Usa el binario llama-server de tu compilación. Para un modelo descargado, sustituye -hf por -m seguido de la ruta local al GGUF.
--spec-type draft-mtp activa MTP; --spec-draft-n-max controla su profundidad. Para la comparación con MTP desactivado, usa --spec-type none y mantén el modelo y los ajustes compartidos sin cambios.
Después de la generación, revisa el registro de inicio para ver los tensores MTP cargados y las estadísticas de aceptación de borradores del servidor. Usa una sola ranura y peticiones solo de texto para esta configuración; consulta las instrucciones del publicador del modelo para conocer las restricciones de compatibilidad actuales.
¿Dónde es útil MTP?
Informes de inspección y monitorización
Un Jetson puede recopilar detecciones, lecturas de sensores y registros de equipos, y luego pedir a un LLM local que redacte un informe de inspección. Los campos y descripciones recurrentes hacen de esta una carga de trabajo útil para probar la aceptación de candidatos. El beneficio es una espera más corta para el informe escrito; el control y la protección en tiempo real siguen siendo independientes.
Asistentes de programación locales
Los scripts de Python, comandos de shell y archivos de configuración de dispositivos suelen producir respuestas relativamente largas con sintaxis regular. El ejemplo de Fibonacci en la Introducción muestra el potencial en este dispositivo. El código generado sigue necesitando ser revisado y probado.
Asistentes de voz y robots sin conexión
Un asistente de voz pasa el habla reconocida al LLM local y luego envía su respuesta a la síntesis de voz.
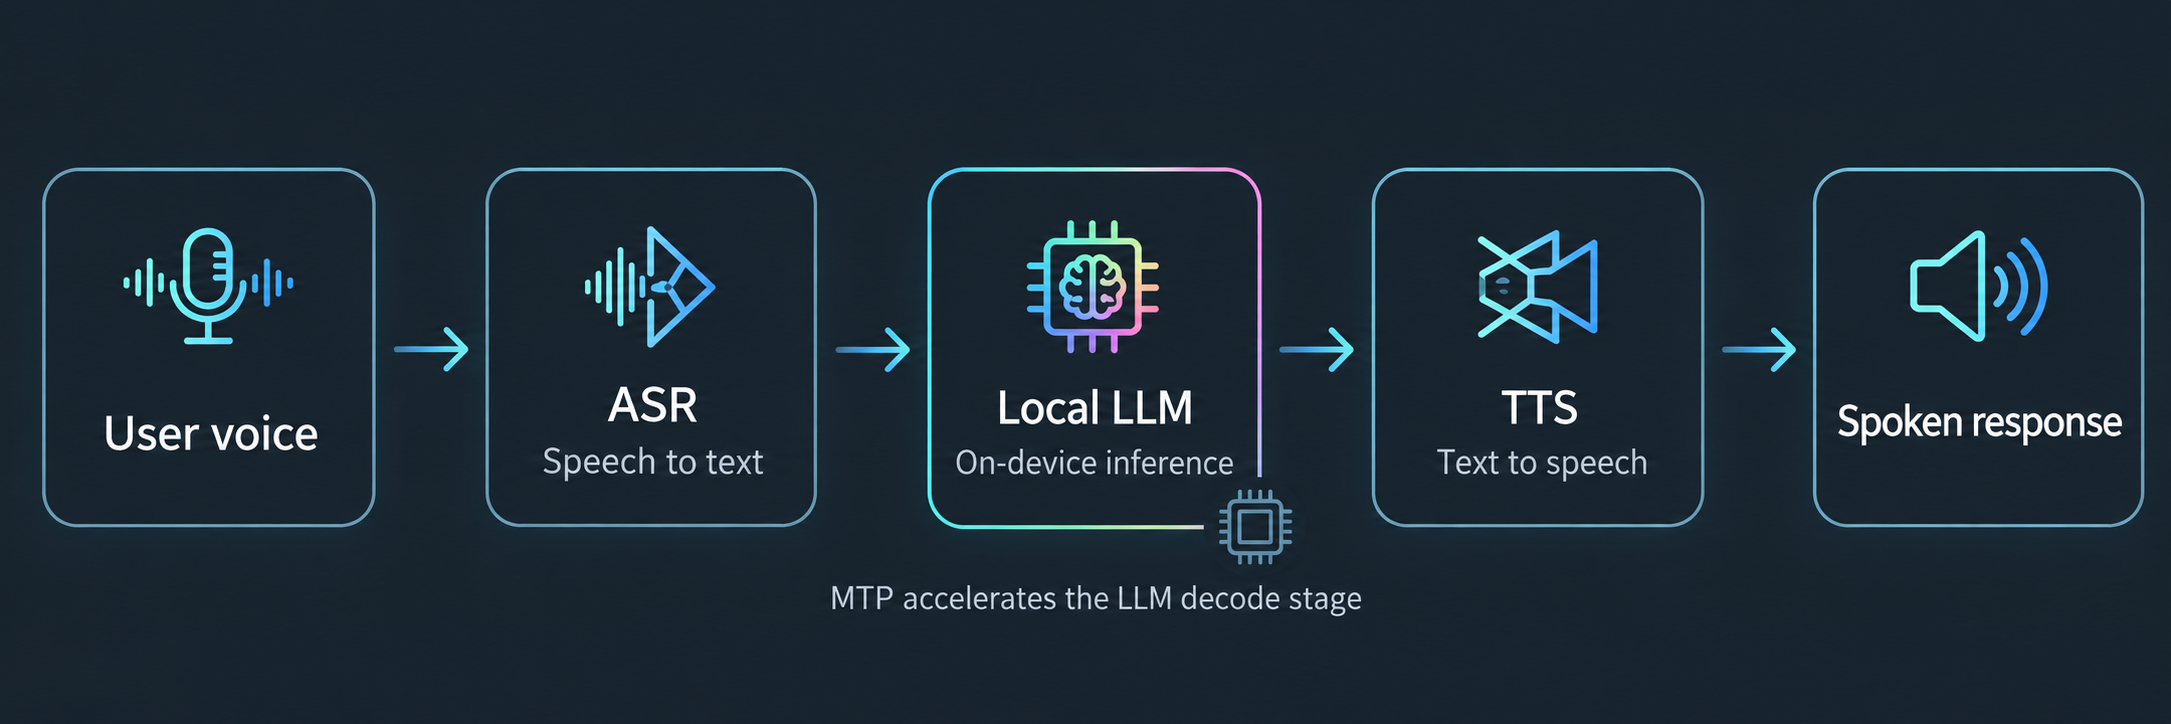
MTP puede acortar la etapa de decodificación del LLM para respuestas más largas. El reconocimiento de voz, la síntesis y el streaming determinan cuándo el usuario realmente oye una respuesta, así que mide el tiempo hasta la primera voz utilizable, además del tiempo de respuesta completo.
Conocimiento local y explicaciones técnicas
Las instrucciones de resolución de problemas y las respuestas largas basadas en registros del dispositivo pueden dedicar bastante tiempo a generar salida. Merece la pena probarlas. Para un documento largo que solo necesita una respuesta de una línea, el procesamiento del prompt puede dominar y dejar poco tiempo de decodificación que ahorrar.
¿Cuándo merece la pena activar MTP?
El primer requisito es un modelo compatible. El runtime debe admitir sus componentes de predicción, y el trabajo adicional de redacción debe compensarse en tu hardware y con tus prompts. Una mayor aceptación y salidas más largas suelen ayudar, mientras que una aceptación baja o respuestas muy cortas pueden hacer que MTP sea más lento.
Compara el tiempo que tu aplicación realmente necesita. Una decodificación más rápida no acorta el procesamiento de imágenes, la ejecución de herramientas ni la carga de modelos en el mismo factor. Mantén constantes el modelo, los límites de entrada y salida, y la configuración de muestreo, y luego decide a partir del resultado medido.
Prueba la demo de monitorización de multitudes
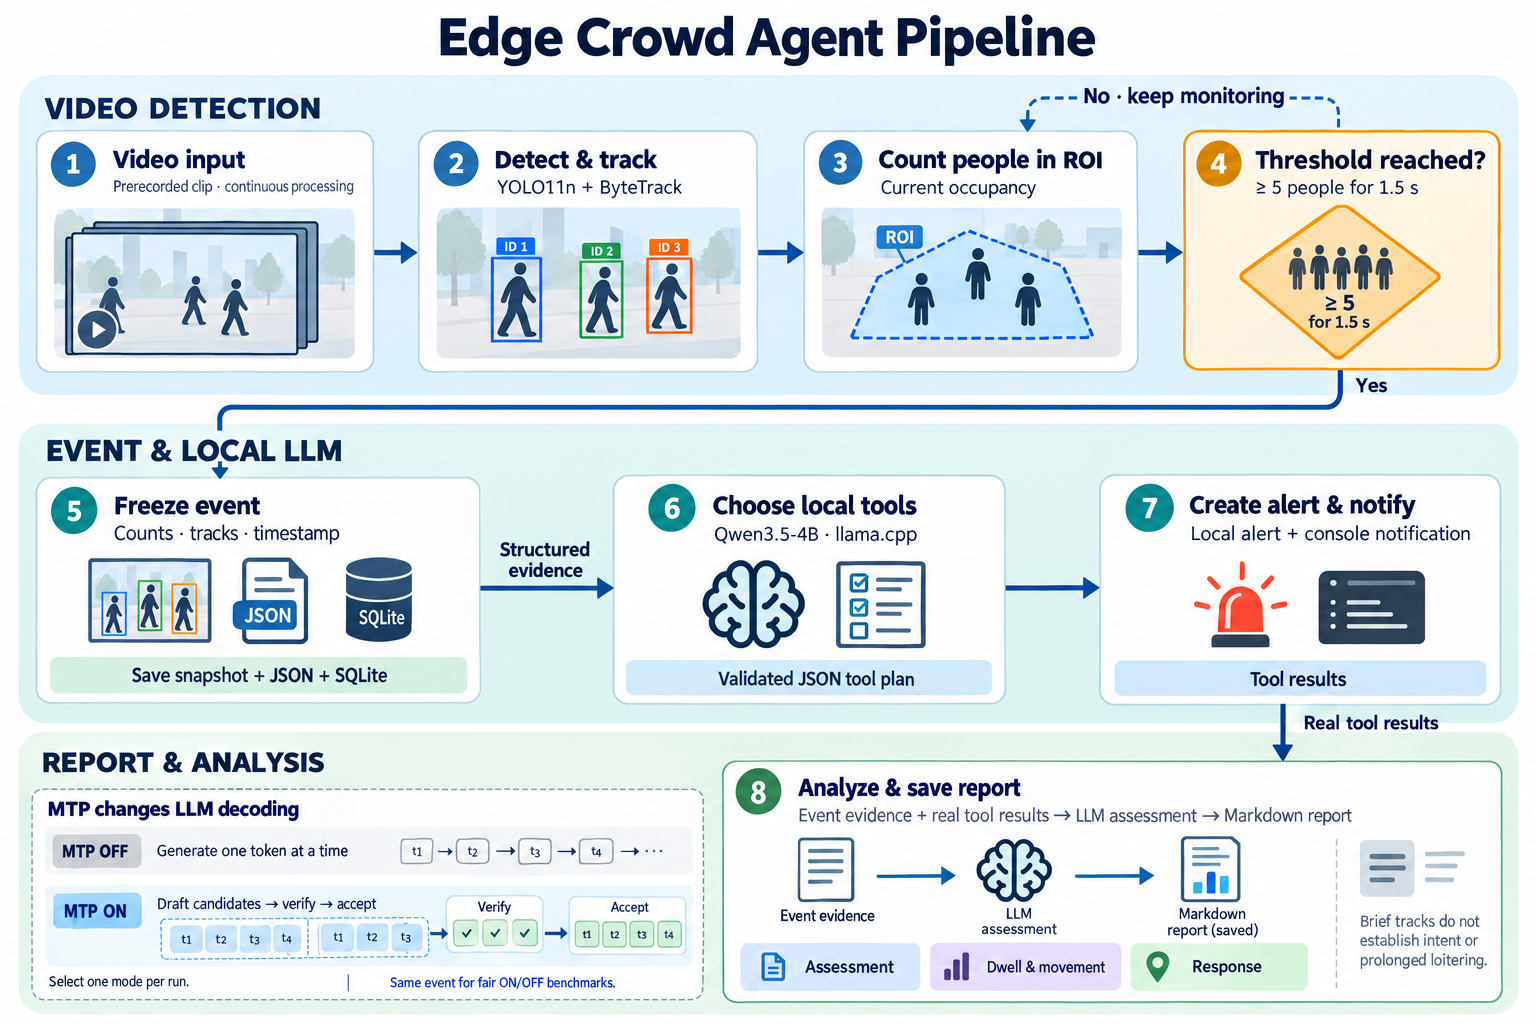
La fuente de la demostración inicial es Edge Crowd Agent. YOLO11n y ByteTrack miden la ocupación actual del ROI, y un LLM local explica el conteo guardado y la evidencia de movimiento cuando se dispara un evento.
Sigue Start on Jetson in the README para dependencias, rutas de modelos y vídeos, comprobaciones del entorno e inicio. El proyecto usa uv con Python 3.10 del sistema para conservar el acceso a los bindings TensorRT de JetPack.
Después de iniciar, elige MTP OFF u ON y selecciona Start demo. La detección de vídeo permanece a la izquierda, con el análisis y el progreso de las herramientas a la derecha. La guía de grabación explica cómo ejecutar ambas demostraciones.
La condición de evento predeterminada es al menos 5 personas en el ROI durante 1,5 segundos de tiempo de vídeo continuo. El LLM recibe evidencia estructurada en lugar de píxeles de vídeo; las trayectorias breves permiten una evaluación de ocupación, pero no pueden establecer intención ni merodeo prolongado.
Para una comparación controlada, usa el mismo evento congelado en lugar de dos grabaciones separadas. La sección de benchmark del README proporciona el método de prueba y los resultados medidos, con la carga del modelo listada por separado.
Referencias
- Código fuente y uso de Edge Crowd Agent
- Registros de benchmark de Edge Crowd Agent
- Tutorial de decodificación especulativa de Jetson AI Lab
- Documentación de decodificación especulativa de llama.cpp
- SPEED-Bench de llama.cpp
- Modelo Qwen3.5-4B MTP GGUF
- Modelos de lenguaje grandes mejores y más rápidos mediante predicción multi-token
Soporte técnico y debate sobre productos
Gracias por elegir nuestros productos. Estamos aquí para ofrecerte diferentes tipos de soporte y garantizar que tu experiencia con nuestros productos sea lo más fluida posible. Ofrecemos varios canales de comunicación para adaptarnos a distintas preferencias y necesidades.