15. Modelo ACT y Troceado de Acciones
Capítulo 15 del Curso de Introducción a la IA Física de Seeed: entrada y salida de ACT, la estructura ResNet y Transformer, intuición sobre la atención, CVAE, action chunk vs action horizon, defensas contra la acumulación de errores y los límites de capacidad de ACT.
15.1 Del Clonado de Comportamiento a ACT
15.1 Del Clonado de Comportamiento a ACT: Solo Necesitas un "Buen Modelo"
El Capítulo 9 cubrió el clonando de comportamiento: registrar demostraciones de teleoperación como un conjunto de datos y dejar que el modelo aprenda a "hacer lo que ves". Eso dejó una pregunta: ¿qué modelo merece estos datos? Un modelo de política desplegable debe superar al menos tres obstáculos:
- Entender imágenes.
- Pensar de forma coherente.
- Resistir la acumulación de errores.
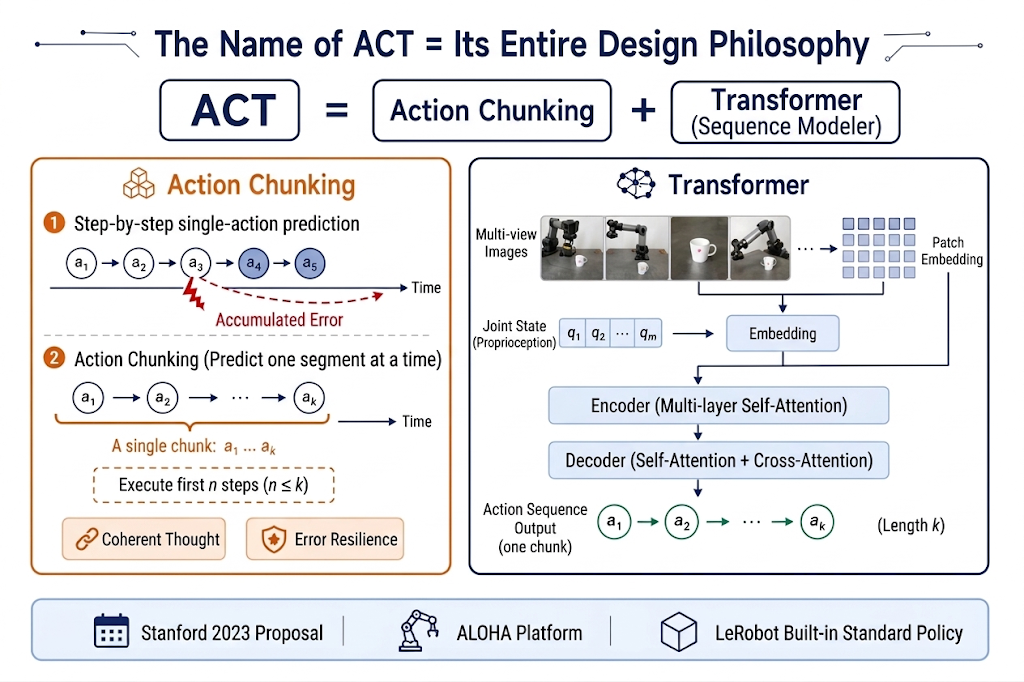
ACT (Action Chunking with Transformers) es el modelo de política construido para superar estos tres obstáculos. Propuesto por un equipo de Stanford en 2023, primero ganó fama en la plataforma de bajo costo de doble brazo ALOHA realizando tareas delicadas como abrir tapas de tazas y sellar bolsas; más tarde, Mobile ALOHA demostró tareas complejas como cocinar camarones. Hoy está integrado en LeRobot como una de las políticas estándar, y es el modelo que entrenarás y desplegarás con tus propias manos en esta etapa.
El nombre de ACT ES toda su filosofía de diseño: Action Chunking + Transformer (modelador de secuencias). El resto de este capítulo desglosa estos dos términos.
15.2 Entrada y Salida de ACT
15.2 Entrada y Salida de ACT: Ver Primero Ambos Extremos
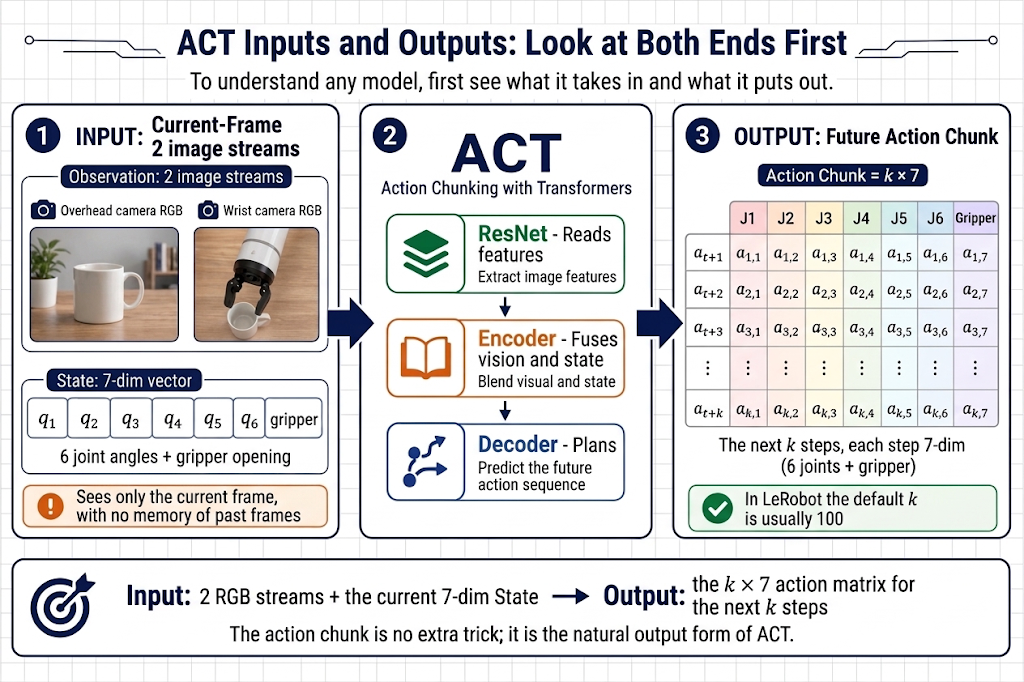
La forma más fiable de entender cualquier modelo es mirar primero su "interfaz": qué recibe y qué produce.
Entrada: Observación Actual
Durante la inferencia, ACT recibe un fotograma de observación que contiene dos tipos de información:
| Entrada | En el reBot Arm | Dimensionalidad |
|---|---|---|
| Imágenes (Observación) | Flujo dual RGB cenital + muñeca | 2 × imágenes |
| Estado articular (Estado) | 6 ángulos articulares + apertura del gripper | Vector de 7 dimensiones |
Ten en cuenta que ACT es solo por fotogramas: no recuerda fotogramas pasados; cada decisión se basa en "lo que ve ahora + dónde están las articulaciones ahora".
Salida: Action Chunk para una Ventana Corta de Futuro
La salida de ACT no es la siguiente acción, sino todo un bloque de secuencia de acciones (Action Chunk):
Input: 2 image streams + 7-dim joint state (current frame)
Output: action sequence for next k steps, each step 7-dim (6 joints + gripper)
      i.e., a k × 7 action matrix
En la configuración predeterminada de ACT en LeRobot, k (tamaño del chunk) suele ser 100: una inferencia da un plan de acción completo para unos 100 pasos de tiempo futuros. Esto responde a la anticipación del Capítulo 9: Action Chunk no es un truco de optimización abstracto; es la forma natural de salida de ACT.
15.3 Estructura Interna de ACT
15.3 Estructura Interna de ACT: Tres Talleres en Una Misma Línea de Ensamblaje
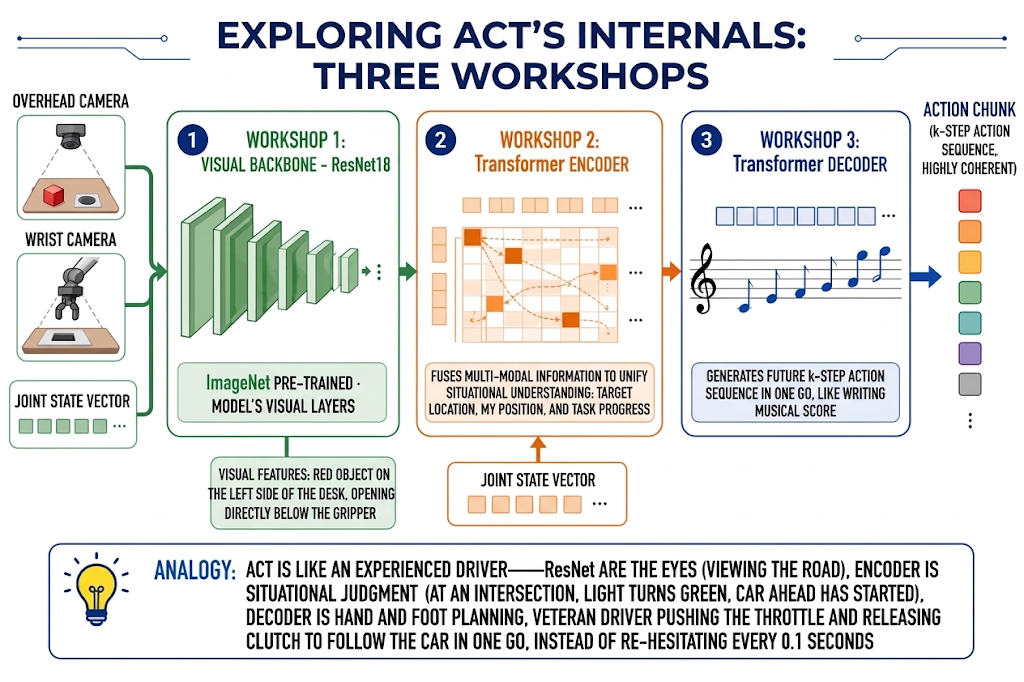
Taller 1: Espina Dorsal Visual (ResNet): de Píxeles a Características
Las imágenes de la cámara cenital y de muñeca pasan cada una por una ResNet18 (una CNN preentrenada en ImageNet), comprimidas en un conjunto de características visuales. Piensa en ResNet como la "corteza visual" del modelo: los píxeles en bruto no significan nada para él; extrae información estructurada como "hay un objeto rojo a la izquierda de la mesa" o "hay una abertura justo debajo del gripper".
Taller 2: Codificador Transformer: Entender "el Presente"
Las características visuales + el vector de estado articular se combinan y entran en el codificador Transformer. El trabajo del codificador es fusionar múltiples flujos en una comprensión unificada de la situación actual: "dónde está el objetivo, dónde estoy yo, cuánto se ha avanzado en la tarea".
Taller 3: Decodificador Transformer: Planificar "el Futuro"
El decodificador toma la comprensión del codificador y genera la secuencia de acciones para los próximos k pasos de una sola vez. No escupe acciones una por una; como escribir una partitura, compone todo el "movimiento futuro" de un solo aliento: esta es la razón fundamental por la que los action chunks son internamente tan coherentes.
15.4 Qué es un Transformer
15.4 Qué es un Transformer: Intuición Detrás de la Atención
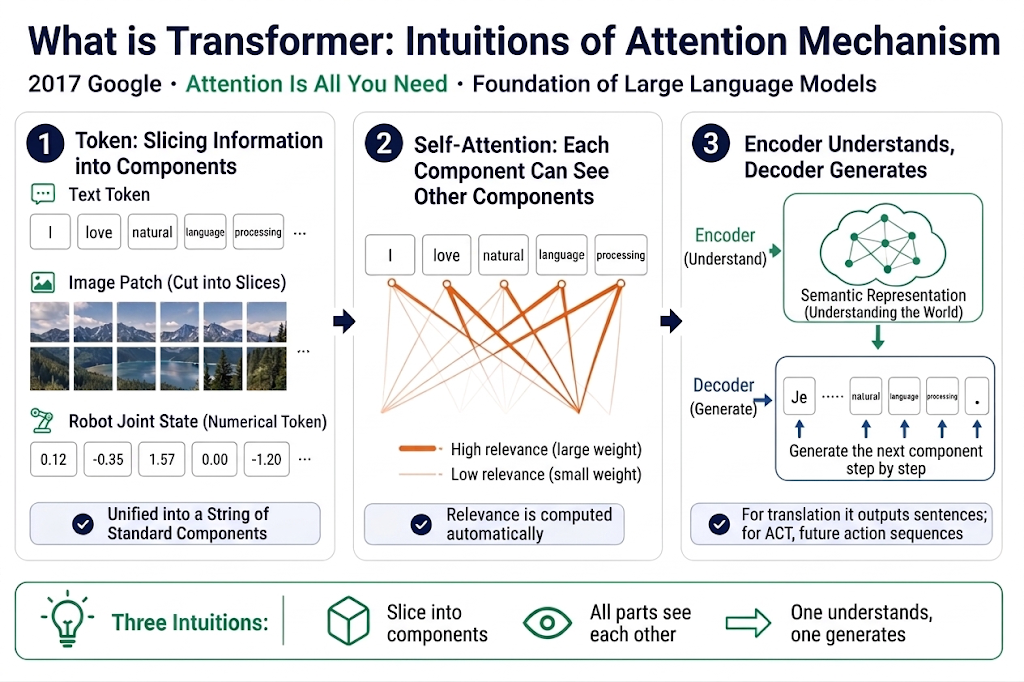
Los talleres 2 y 3 de ACT son ambos Transformers, pero ¿qué ES un Transformer?
Fue propuesto por Google en 2017 para traducción automática; el artículo se titula "Attention Is All You Need", y más tarde se convirtió en la arquitectura fundamental de los grandes modelos de lenguaje. No hacen falta fórmulas: bastan tres intuiciones:
- Token: cortar la información en "partes". Los Transformers no procesan directamente frases o píxeles en bruto; primero cortan la entrada en partes estandarizadas (tokens): una frase en palabras, una imagen en parches, un vector de estado articular también puede ser un token. Una vez que toda la información se unifica en "una secuencia de partes", el mismo mecanismo las procesa todas.
- Autoatención: cada parte puede "ver" todas las demás partes. Este es el núcleo del Transformer. Al procesar cada parte, calcula su relevancia con cada otra parte y se centra en absorber información de las más relevantes: "qué mirar" no lo prescribe el humano; el modelo lo aprende.
- Codificador y Decodificador: uno entiende, otro genera. El Codificador fusiona una secuencia de entrada de partes en "una comprensión de la situación actual"; el Decodificador toma esta comprensión y genera una nueva secuencia de partes de salida: en traducción, es la frase en el idioma de destino; en ACT, es la secuencia de acciones futuras.
15.5 Cómo se Usa Transformer en ACT
15.5 Cómo se Usa Transformer en ACT
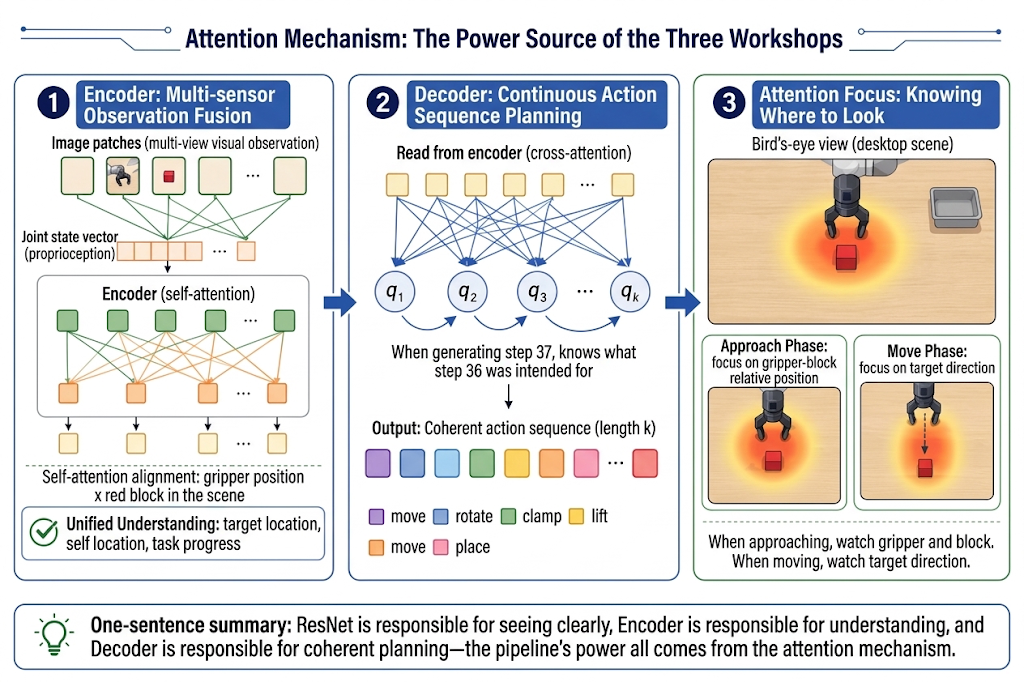
- En el codificador: fusionar múltiples observaciones. Los parches de características visuales de ambas imágenes (a través de ResNet) más el vector de estado articular se convierten todos en tokens que se introducen en el codificador. La autoatención los alinea: "la posición actual del gripper" y "ese bloque rojo en la imagen" se vinculan en una comprensión unificada: dónde está el objetivo, dónde estoy yo, cuánto se ha avanzado en la tarea.
- En el decodificador: planificar toda la secuencia de acciones de una vez. El decodificador usa k vectores de consulta correspondientes a k pasos de acción futuros; estas consultas extraen información de la comprensión del codificador mientras también se coordinan entre sí mediante autoatención: la acción en el paso 37 "sabe" lo que el paso 36 pretende hacer. Por lo tanto, todo el bloque de acciones es un todo coherente, no 100 decisiones aisladas.
- En el enfoque de la atención: saber a qué "mirar". Al generar cada acción, el modelo se centra automáticamente en las regiones de la imagen más relevantes para la acción actual: al acercarse al objetivo, se centra en la posición relativa gripper-bloque; mientras se mueve, se centra en la dirección del objetivo, en lugar de tratar todas las regiones por igual.
Resumen en una frase: ResNet "ve con claridad", el codificador Transformer "entiende", el decodificador Transformer "planifica con coherencia", todo impulsado por la atención.
15.6 Qué es CVAE
15.6 Qué es CVAE
CVAE (Conditional Variational Autoencoder). El ACT de LeRobot en realidad se entrena con esto, solo que no lo ves en la línea de comandos lerobot-train --policy.type=act.
Qué Foso Evita: El Promedio Falla
El trabajo de CVAE no es "reducir al humano a una única respuesta correcta", sino reconocer que, dada la observación actual, las acciones pueden tener múltiples estilos; durante el entrenamiento, primero identifica de qué estilo se trata y luego reproduce esa secuencia de acciones.
El artículo hizo comparaciones (en tareas simuladas):
- Si las demostraciones están guionizadas (solo una forma), eliminar CVAE apenas afecta la tasa de éxito.
- Con datos humanos, eliminarlo reduce el éxito de ~35% a 2%.
Así que CVAE no está para hacer que las fórmulas se vean más elegantes; está para permitir que el modelo maneje datos donde "los humanos cambian de enfoque y tienen manos temblorosas".
"Condicional" significa: las acciones generadas deben estar ancladas en lo que se ve actualmente; ya sea un cangrejo de río o un bloque en la mesa, no puede inventar cosas. CVAE es "dado lo que ves, compón cómo moverte a continuación".
15.7 Action Chunk vs. Action Horizon
15.7 Action Chunk vs. Action Horizon
Estos son los dos conceptos que se distinguen con mayor precisión en este capítulo; son dos parámetros que se pueden ajustar de forma independiente:
- Action Chunk: la longitud de la secuencia de acciones que el modelo predice en una sola pasada hacia adelante, es decir, el número de filas k en la matriz de salida. En LeRobot, ACT usa por defecto un tamaño de chunk de 100.
- Action Horizon: después de predecir estos 100 pasos, cuántos se ejecutan realmente en lazo abierto, antes de volver a observar y volver a predecir.
La relación es: el chunk predicho puede ser largo, pero cada vez solo se confía en el primer segmento pequeño.
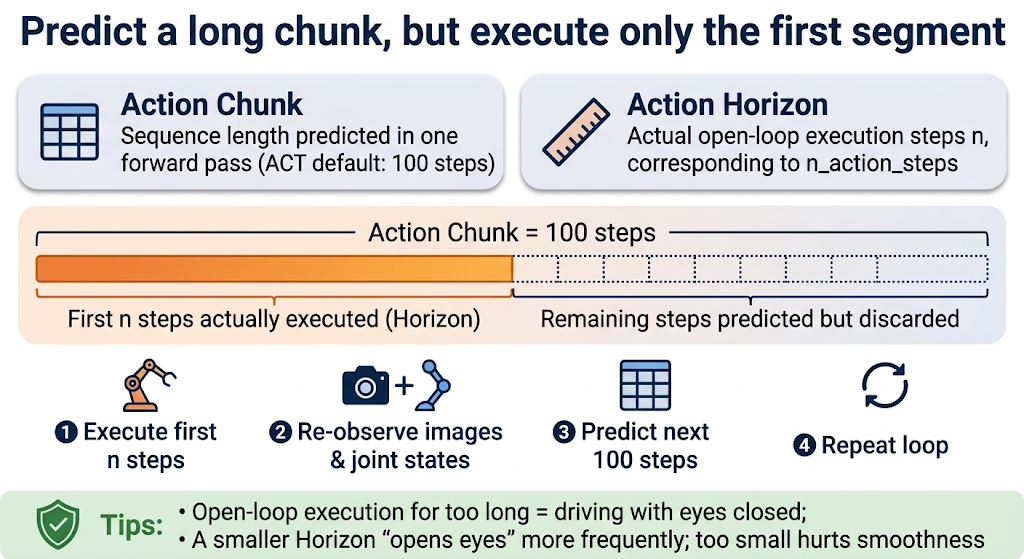
¿Por qué no ejecutar los 100 pasos? Porque las predicciones se vuelven menos fiables cuanto más lejos miran: el entorno cambia, los objetos pueden moverse, y para la segunda mitad la "situación asumida" por el modelo ya se ha desviado de la realidad. Ejecutar en lazo abierto durante demasiado tiempo = conducir con los ojos cerrados. Cuanto más pequeño es el Horizon, con más frecuencia el modelo "abre los ojos para volver a comprobar", lo que lo hace más robusto frente a perturbaciones; pero si es demasiado pequeño se pierde la suavidad que aporta el chunking.
Es como usar la navegación del teléfono mientras conduces. La navegación (el modelo) calcula toda la ruta (chunk) de una vez, pero no bloqueas el volante: cada pocos kilómetros echas un vistazo al tráfico en tiempo real (re-observar) y la navegación vuelve a planificar en consecuencia (re-predecir). La distancia durante la cual "confías en la ruta antigua y sigues conduciendo" es el Horizon.
15.8 Continuidad de la Acción y Acumulación de Error
15.8 Continuidad de la Acción y Acumulación de Error: Dos Líneas de Defensa de ACT
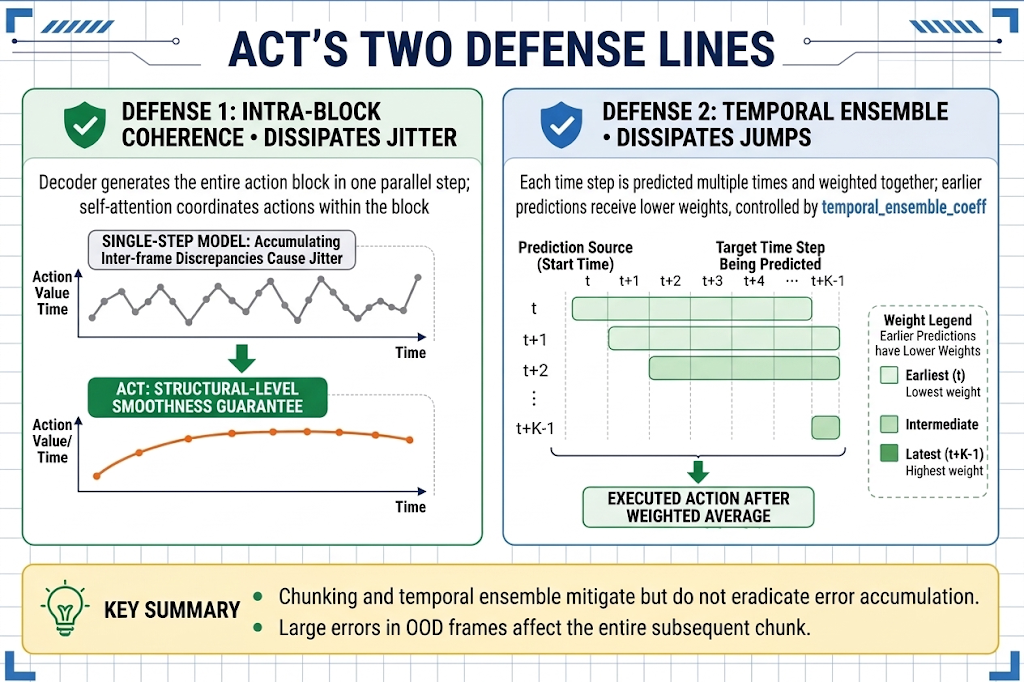
El Capítulo 9 dejó dos amenazas para la estabilidad de robots reales: el jitter de acción y la acumulación de error. Ahora veamos cómo ACT las aborda con métodos estructurados.
- Defensa 1: la coherencia intra-chunk corrige el jitter.
- Defensa 2: el ensamblado temporal corrige las discontinuidades.
15.9 ¿Para Qué Tareas es Adecuado ACT?
15.9 ¿Para Qué Tareas es Adecuado ACT?
Dadas las características de diseño de ACT, su "zona de confort" es bastante clara:
| Adecuado para | Motivo |
|---|---|
| Manipulación sobre mesa (agarrar, colocar, organizar, enchufar/desenchufar) | ACT se originó en estas tareas; las necesidades de datos y el tamaño del modelo encajan |
| Tareas únicas o pocas tareas | El behavioral cloning aprende mapeos específicos de tarea; más tareas = se necesitan más datos |
| Tareas cortas (segundos hasta ~1 minuto) | El error se acumula con el tiempo; las tareas más cortas son más estables |
| Tareas con información visual suficiente | Escenas donde las cámaras duales cenital + de muñeca cubren la información clave |
| Hardware con recursos limitados | ACT tiene relativamente pocos parámetros; las GPU de consumo pueden entrenar e inferir; la CPU también puede inferir |
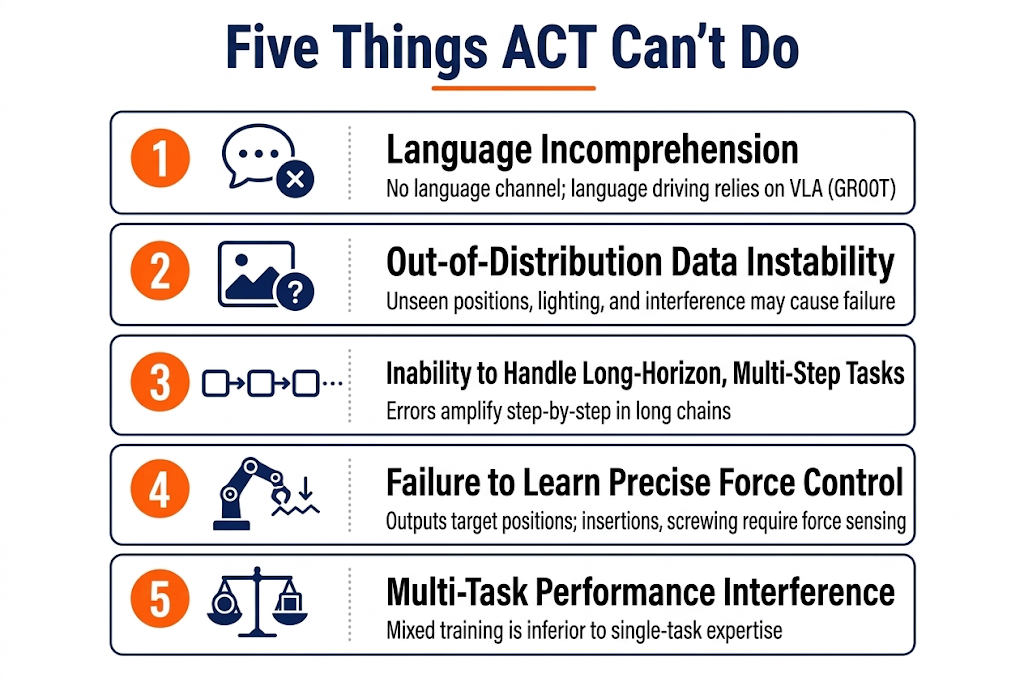
15.10 Límites de Capacidad de ACT
15.10 Límites de Capacidad de ACT
Igualmente importante es saber lo que no puede hacer: