18. Aprendizaje multimodal y fundamentos de VLA
Capítulo 18 del Curso de Introducción a la IA Física de Seeed — visión/lenguaje/acción, VLM vs VLA, ACT vs VLA, tareas condicionadas por lenguaje, tarea única vs multitarea vs generalización, acciones continuas vs tokens de acción, y capacidades y limitaciones de VLA.
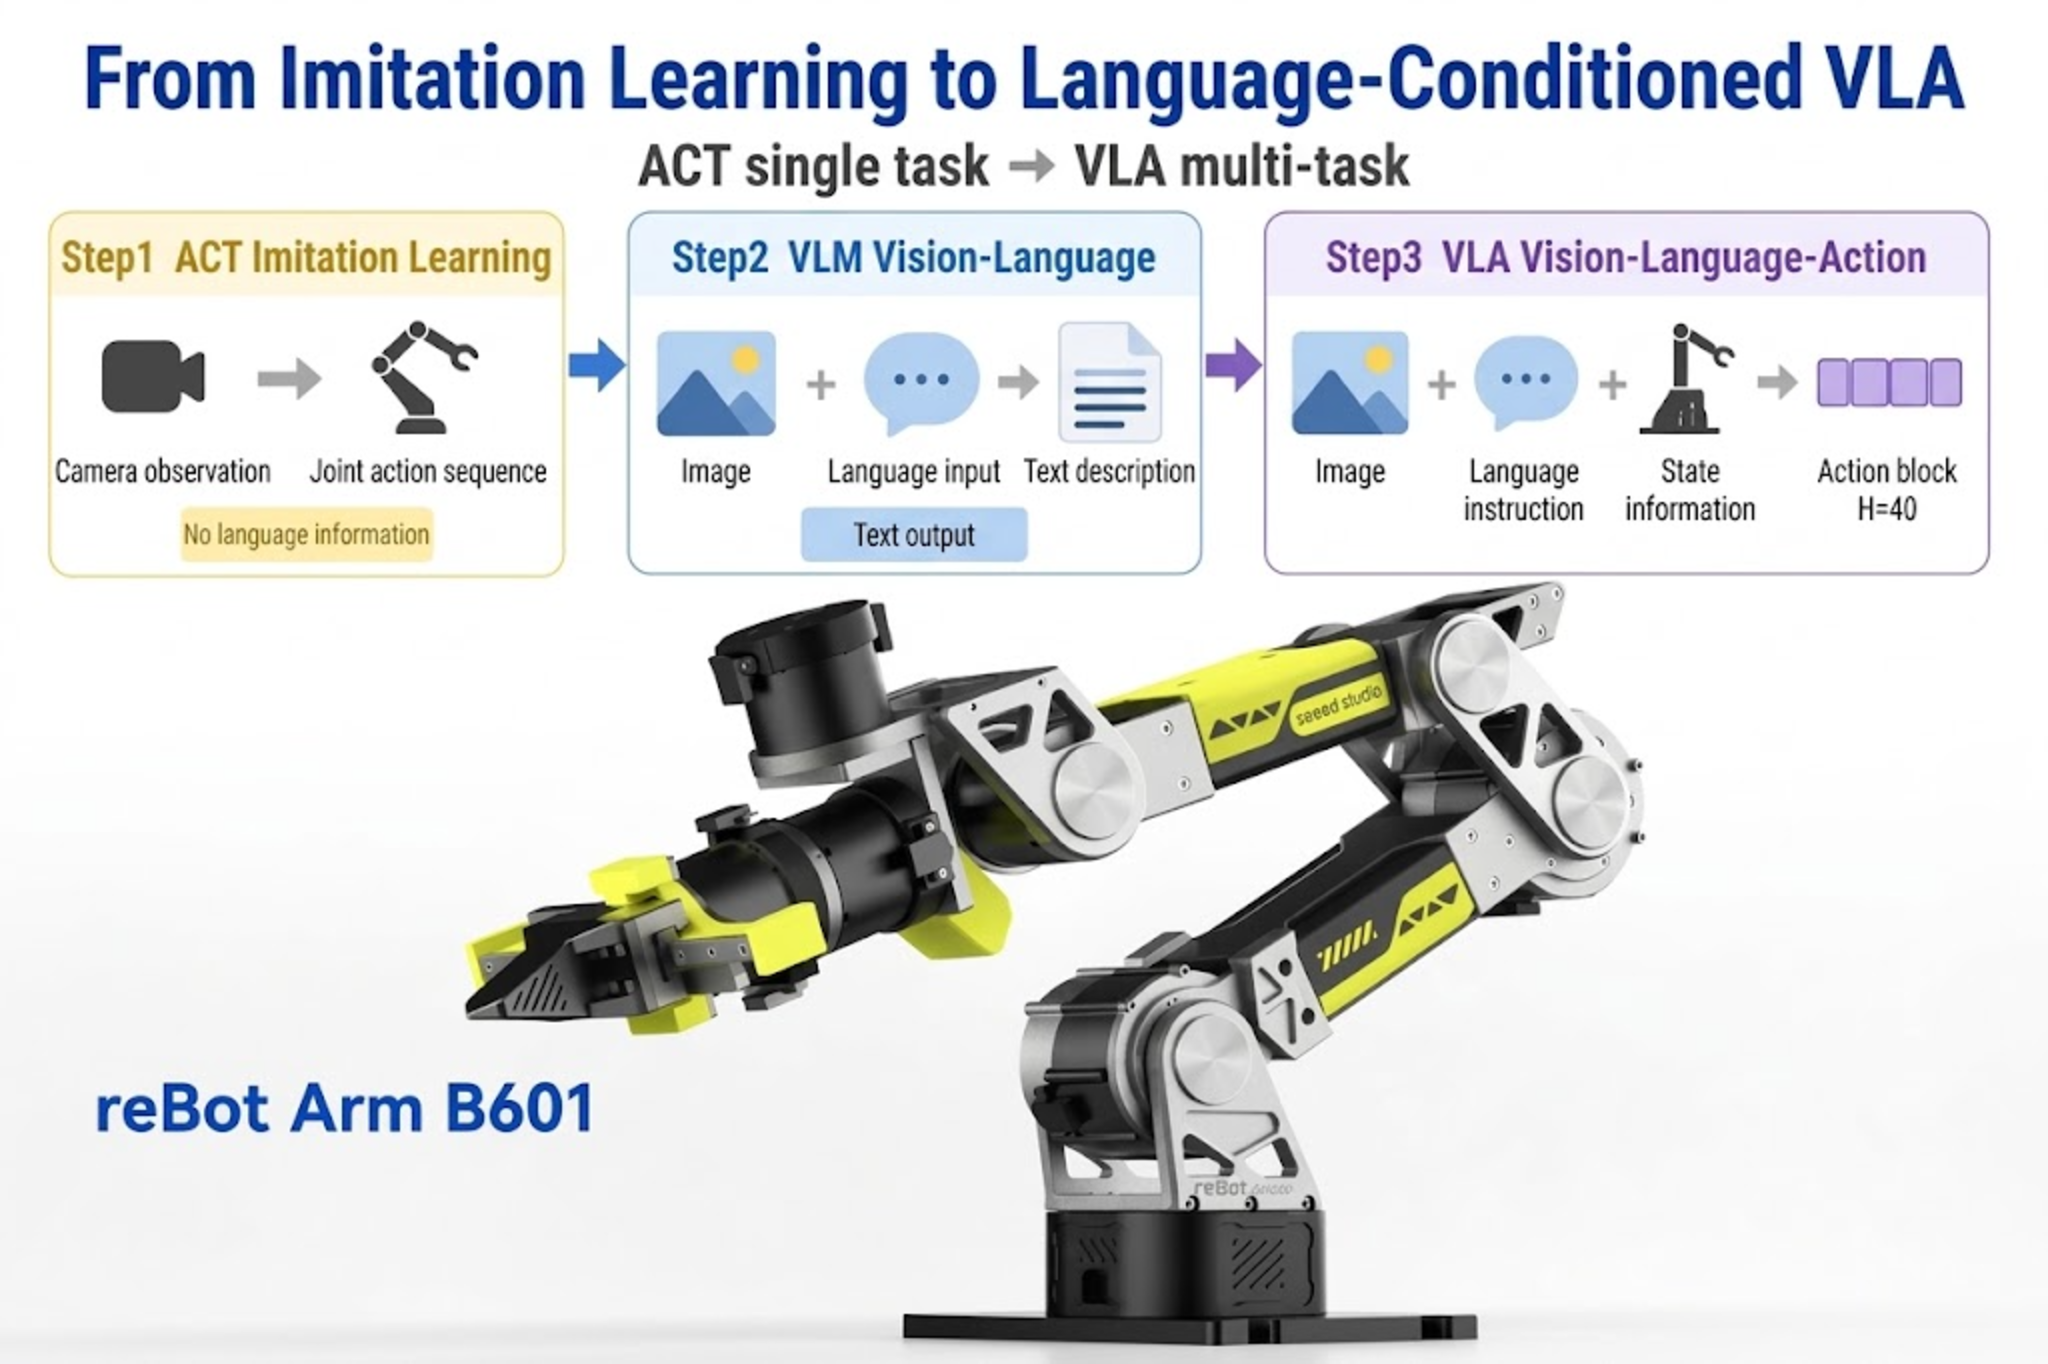
En los capítulos anteriores, has utilizado políticas como ACT (Action Chunking with Transformers) en el reBot Arm para completar aprendizaje por imitación que "mira una imagen y produce acciones de las articulaciones". Estos métodos suelen entrenarse para una tarea única: el modelo solo aprende el comportamiento de "poner el cubo rojo en la caja", y cambiar de tarea requiere volver a recopilar datos y reentrenar.
Este capítulo presenta la idea central de VLA (Vision-Language-Action): permitir que el robot no solo "vea", sino que también "entienda" instrucciones en lenguaje natural, y que comparta una única red de política entre múltiples tareas.
18.1 Modelos multimodales
18.1 ¿Qué es un modelo multimodal?
Un modelo multimodal fusiona más de un tipo de información — imágenes, texto y estado del robot — en una única decisión unificada. En el contexto de VLA, las tres modalidades siguientes se combinan y se decodifican en acciones del robot.
18.2 Visión, lenguaje y acción
18.2 Visión, lenguaje y acción
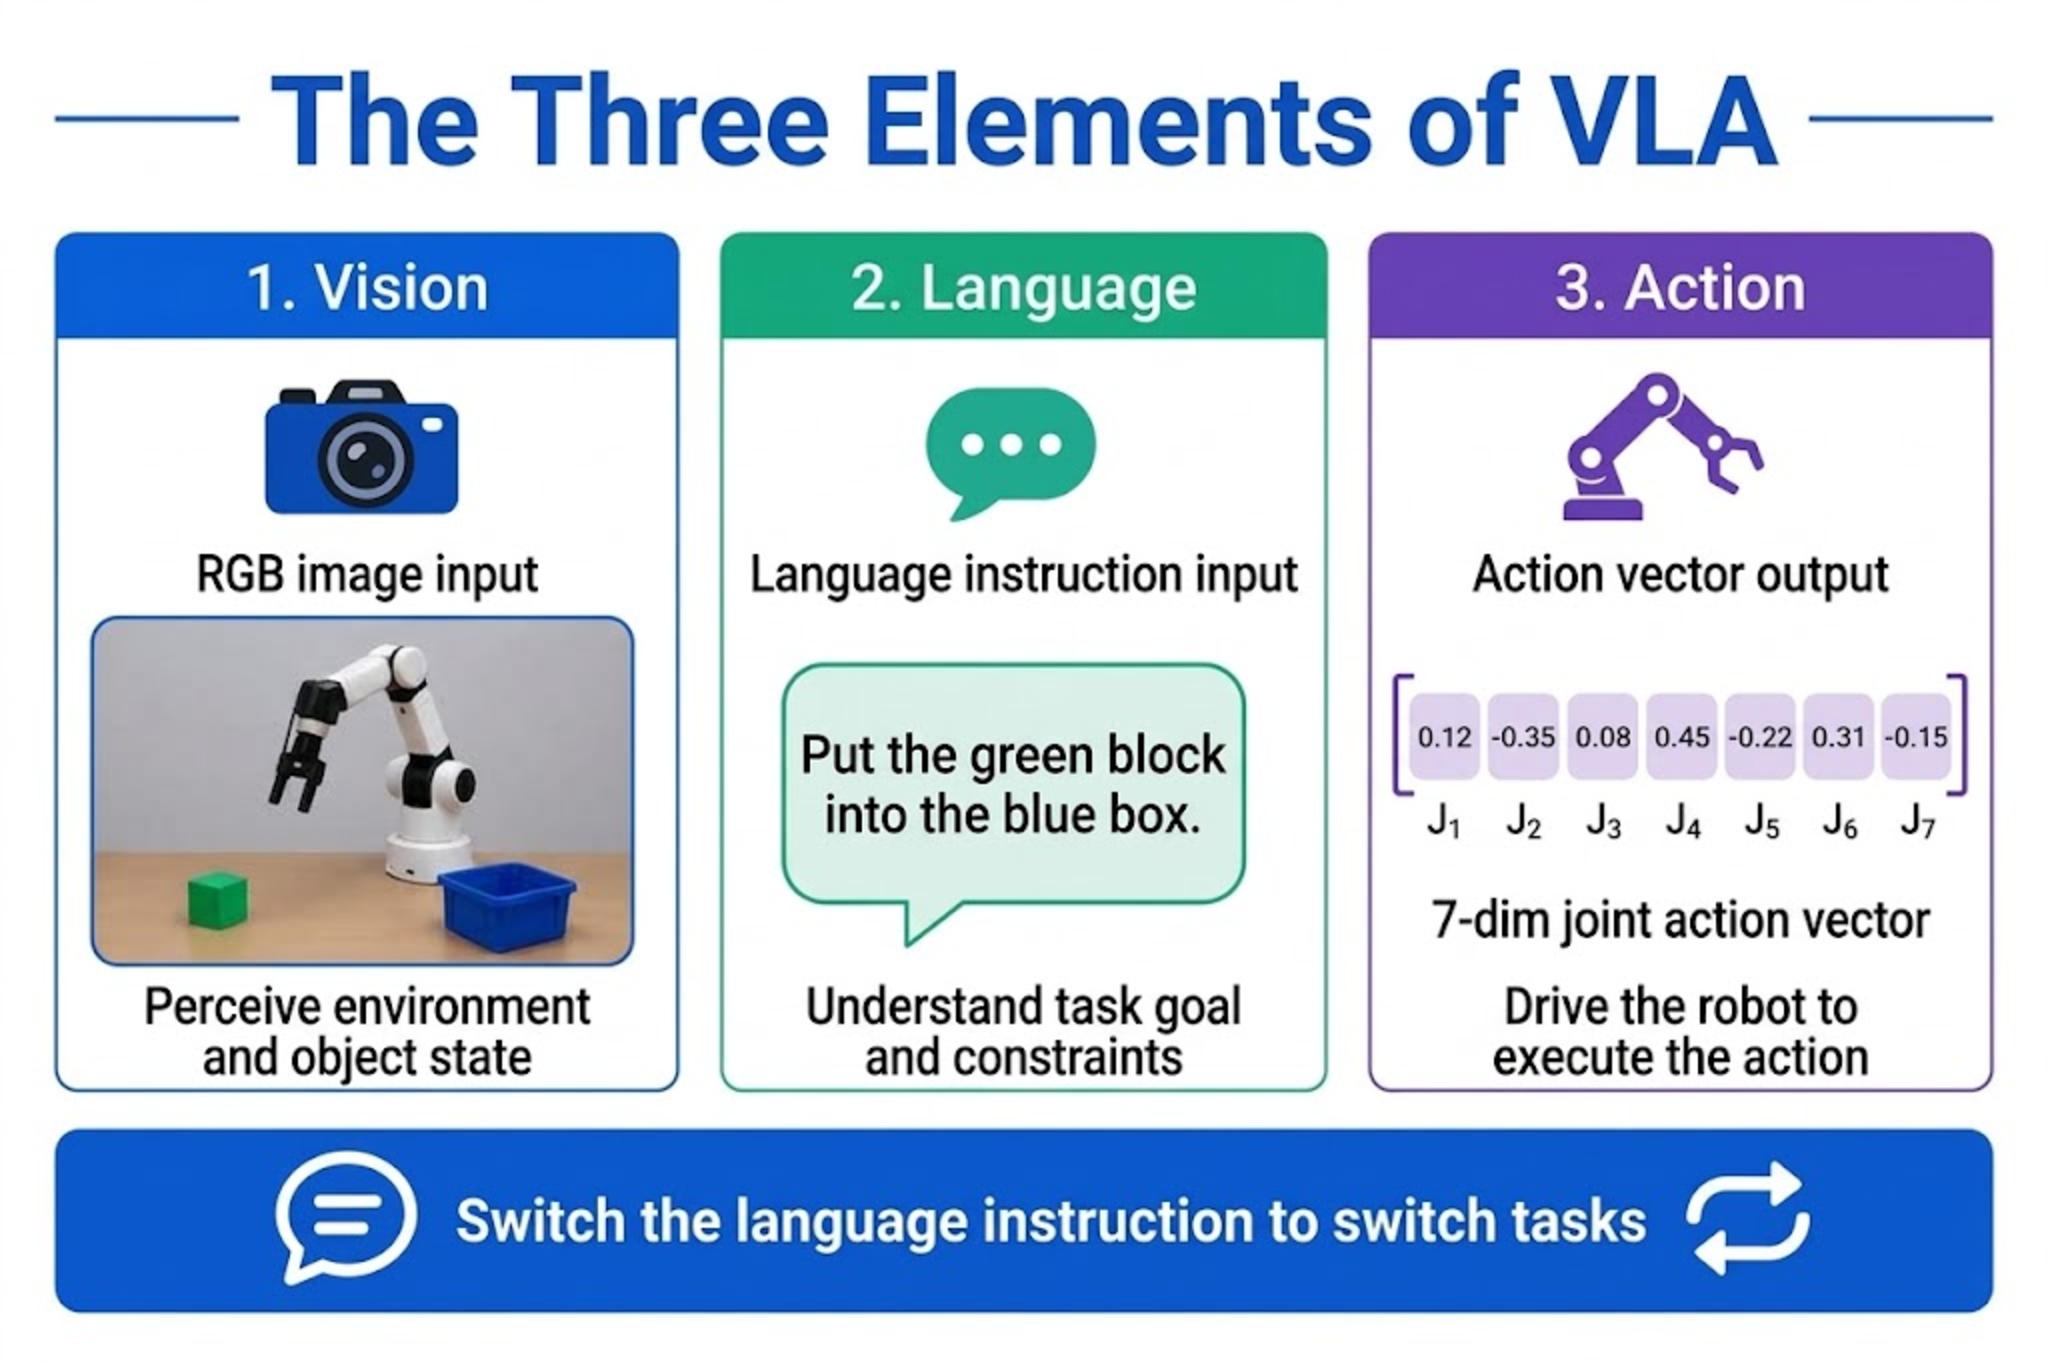
En el marco VLA, las tres modalidades tienen cada una una clara división de trabajo:
| Modalidad | Significado | Fuente típica en reBot Arm |
|---|---|---|
| Visión | Imágenes RGB capturadas por cámaras externas y cámaras de muñeca | Cámara frontal, cámara de muñeca RealSense / USB |
| Lenguaje | Descripción en lenguaje natural de la tarea | "Pon el destornillador en la caja de herramientas" |
| Acción | Los comandos de control que el robot debe ejecutar | Ángulos objetivo de cada articulación, anchura de apertura/cierre de la pinza |
El estado suele aparecer emparejado con la Acción: el Estado describe "dónde está ahora el robot", y la Acción describe "adónde ir después". En los conjuntos de datos de LeRobot, se almacenan en los campos observation.state y action; en GR00T se dividen además mediante meta/modality.json en subclaves como single_arm y gripper.
La diferencia clave entre VLA y las políticas de visión pura: el lenguaje se convierte en una variable de condicionamiento. Durante el entrenamiento, cada trayectoria de demostración se vincula a una descripción de tarea; en la inferencia, el usuario solo necesita cambiar el texto de la instrucción, sin cambiar los pesos del modelo (dentro de la cobertura de datos).
18.3 Diferencia entre VLM y VLA
18.3 Diferencia entre VLM y VLA
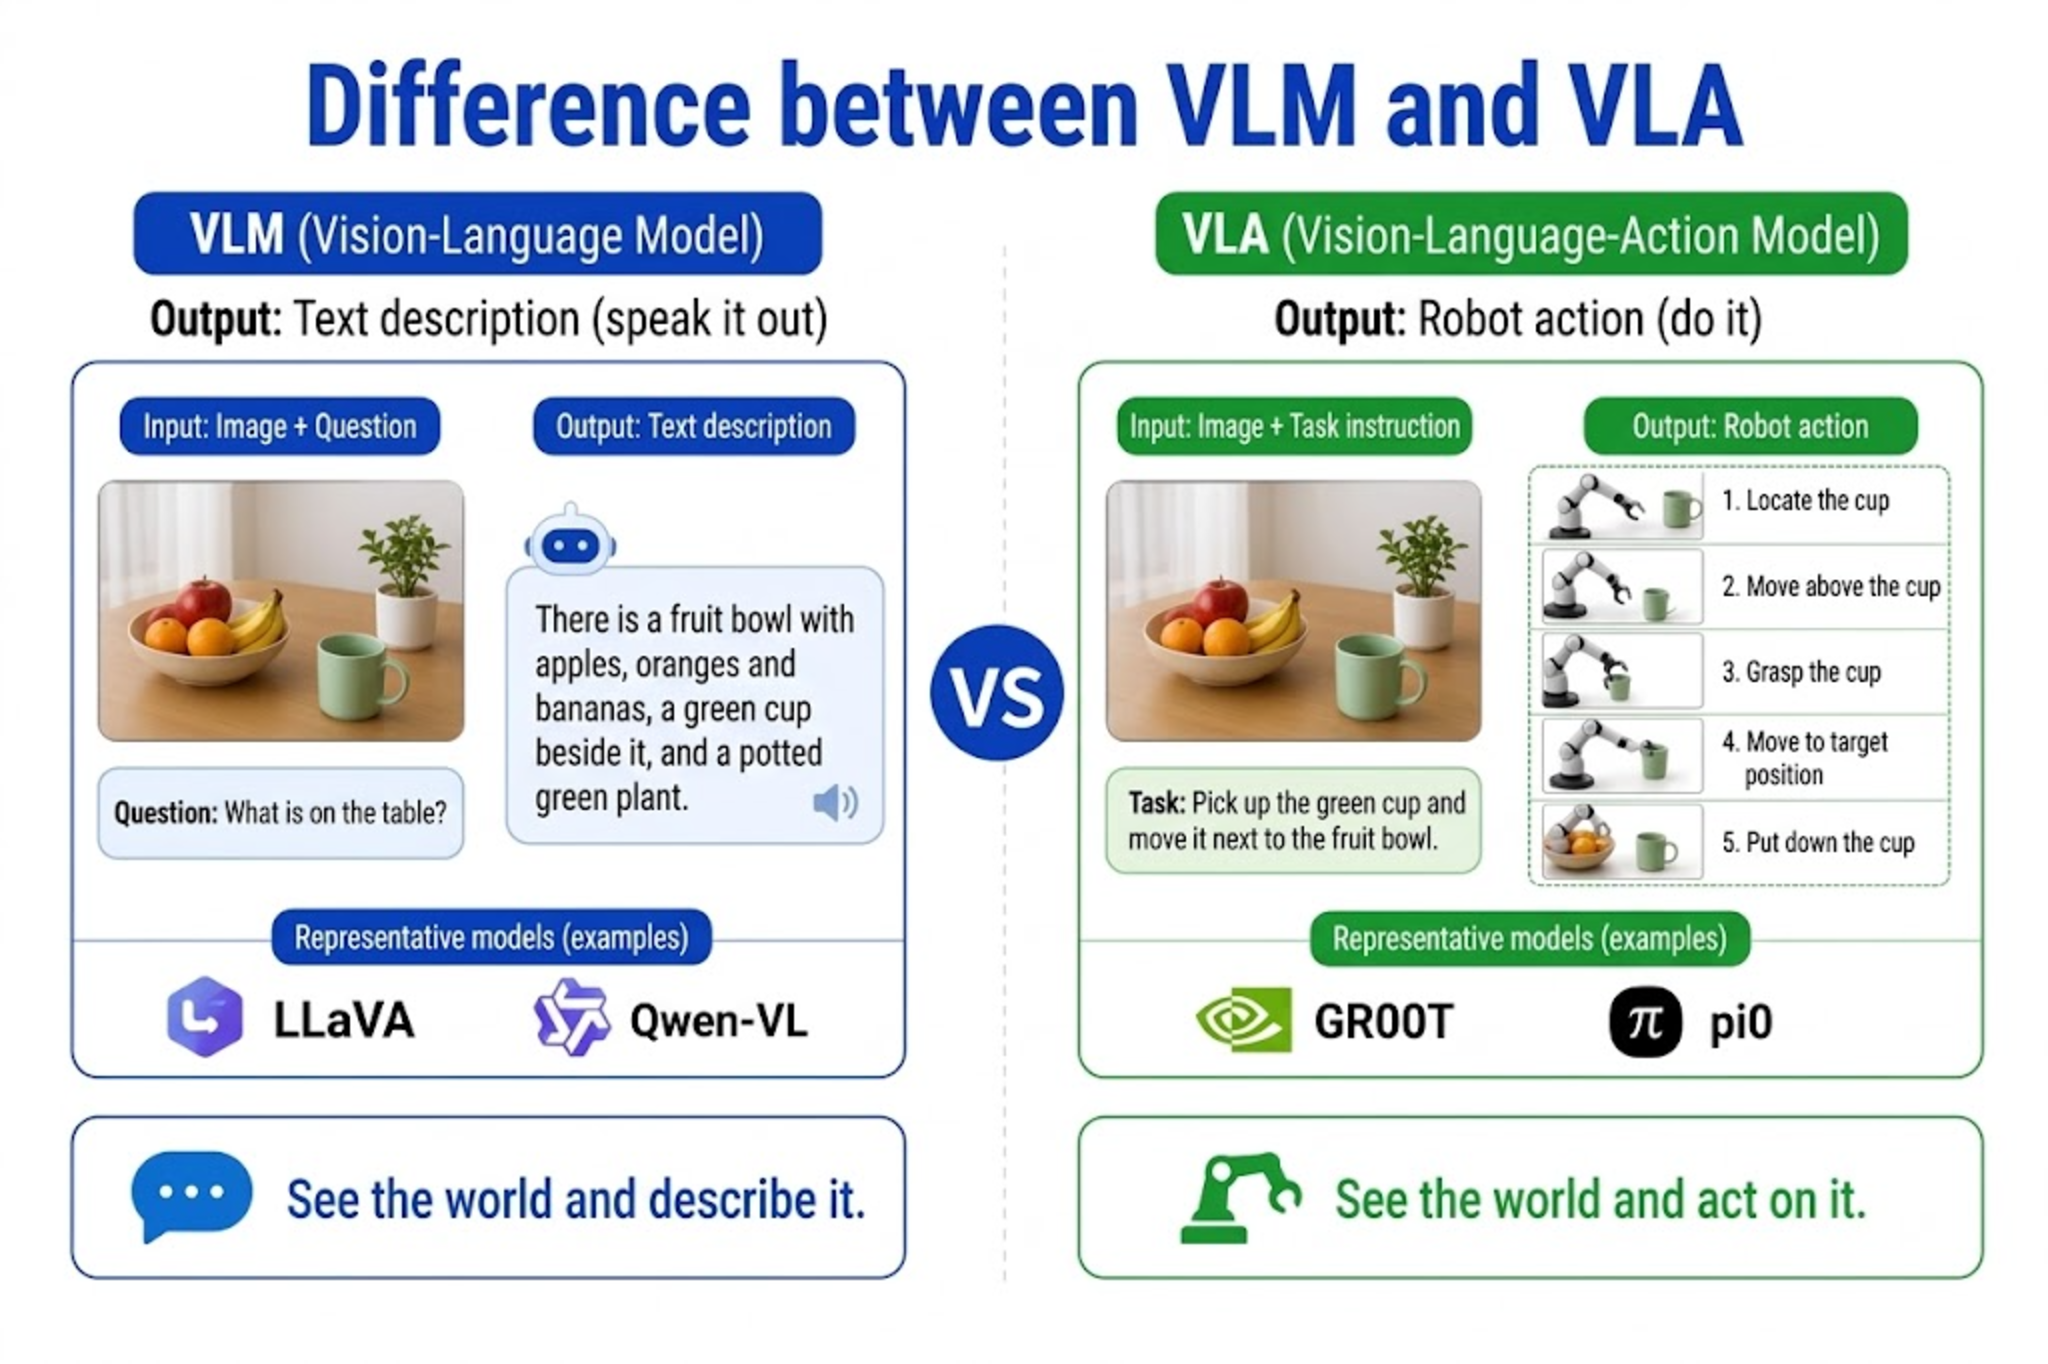
| Aspecto | VLM (Vision-Language Model) | VLA (Vision-Language-Action) |
|---|---|---|
| Salida | Texto, descripciones, resultados de razonamiento | Secuencia de acciones del robot |
| Uso típico | Preguntas y respuestas sobre imágenes, comprensión de escenas, generación de descripciones | Agarre, colocación, abrir/cerrar puertas y otras manipulaciones |
| Modelos representativos | LLaVA, Qwen-VL, Cosmos-Reason2 | GR00T, pi0, OpenVLA |
| Relación con el robot | Puede ayudar en la planificación, no acciona directamente los motores | Produce comandos de control de extremo a extremo |
Se puede entender de forma sencilla como: VLM se encarga de "entender el mundo y hablar de él", mientras que VLA se encarga de "entender el mundo y actuar".
Isaac GR00T N1.7 reutiliza arquitectónicamente las capacidades de VLM: su backbone es Cosmos-Reason2-2B (basado en la arquitectura Qwen3-VL, sustituyendo al backbone Eagle de N1.6), responsable de codificar imágenes y lenguaje, seguido de una cabeza de acción Diffusion Transformer (DiT) que decodifica representaciones semánticas en fragmentos de acción continuos. Por lo tanto, GR00T es tanto un VLA como un modelo que incorpora fuertes capacidades de representación VLM.
18.4 Diferencia entre ACT y VLA
18.4 Diferencia entre ACT y VLA
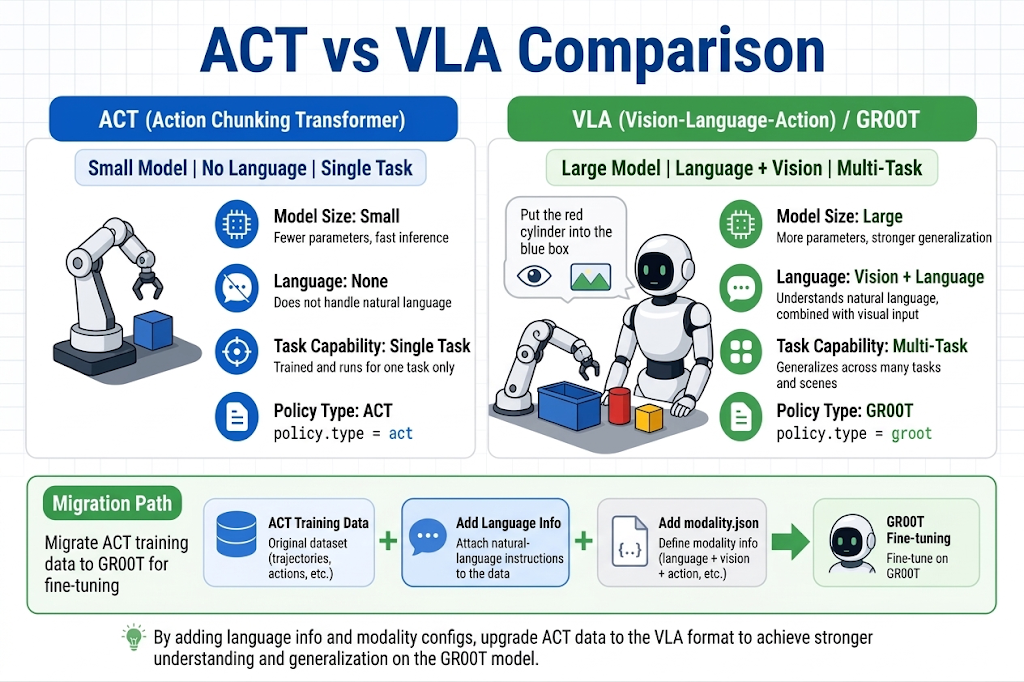
El ACT que encontraste en capítulos anteriores y el VLA de este capítulo pertenecen ambos a la familia del aprendizaje por imitación (Behavior Cloning), pero sus objetivos de diseño son diferentes:
| Aspecto | ACT | VLA (GR00T como ejemplo) |
|---|---|---|
| Condición de tarea | Normalmente sin lenguaje, tarea única implícita | Lenguaje + visión, multitarea explícita |
| Tamaño del modelo | Más pequeño (decenas de millones de parámetros) | Más grande (modelo base de miles de millones de parámetros) |
| Método de entrenamiento | Entrenar desde cero o ajuste fino ligero | Preentrenamiento de modelo base + ajuste fino en tareas posteriores |
| Representación de la acción | Fragmento de acción | Fragmento de acción + denoising con Flow Matching |
| Generalización | Buen rendimiento dentro de la distribución; reentrenar al cambiar de tarea | El condicionamiento por lenguaje admite transferencia zero/few-shot |
| Tipo de política en LeRobot | act | groot |
La técnica central de ACT es el Action Chunking: predecir de una vez múltiples pasos de acción futuros para reducir el error acumulado de la inferencia paso a paso. GR00T también predice fragmentos de acción, pero la longitud de la ventana varía según la versión:
- N1.5 / N1.6:
action_horizon = 16 - N1.7:
action_horizonse amplía de 16 a 40, y la dimensión máxima del espacio general de estado/acción preentrenado se amplía en consecuencia (reBot en realidad solo usa 7 dimensiones; las dimensiones restantes se rellenan automáticamente con ceros) - Política
grootde LeRobot: el código fuente usa por defectochunk_size=50,n_action_steps=50
Este tutorial sigue el ejemplo oficial de ajuste fino de N1.7, utilizando chunk_size=40 durante el entrenamiento para alinearse con la ventana de acción preentrenada. No te quedes con 16: una ventana desajustada degrada los resultados del ajuste fino. action_horizon se escribe en la cabeza de difusión durante el entrenamiento y no puede ampliarse arbitrariamente en la inferencia.
Ruta de migración: si ya tienes un conjunto de datos ACT para el reBot Arm (formato LeRobot v2), en el Capítulo 20 solo necesitas añadir anotaciones de lenguaje y la configuración de Modalidad para poder usarlo en el ajuste fino de GR00T, sin volver a recopilar todas las demostraciones.
18.5 Tareas de robot condicionadas por lenguaje
18.5 Tareas de robot condicionadas por lenguaje
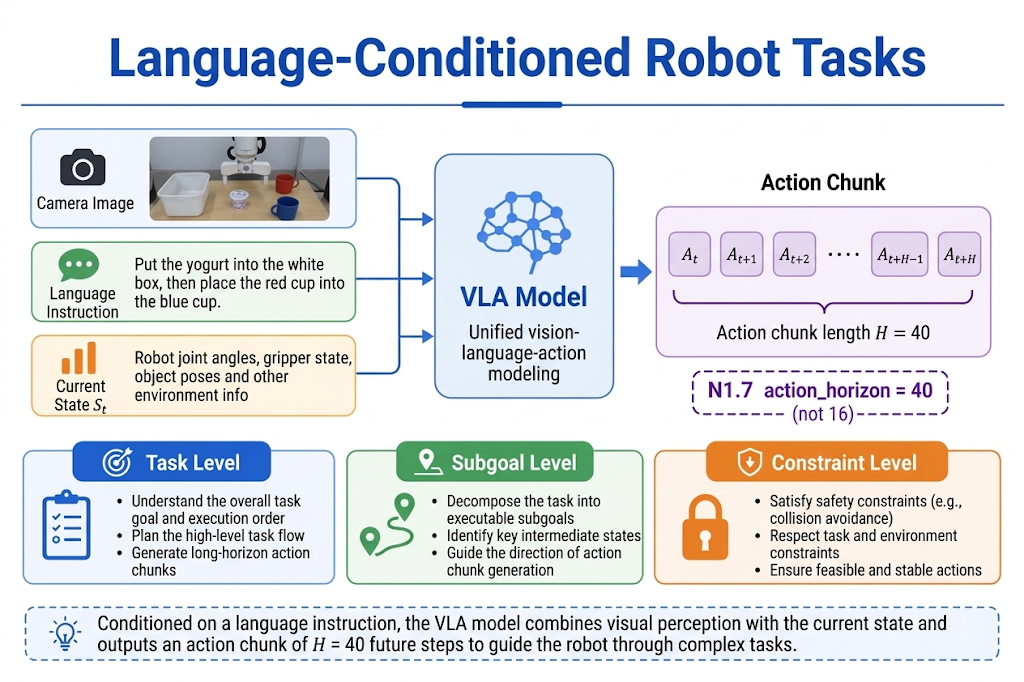
La forma estándar de una tarea condicionada por lenguaje es:
Input: image I_t + language instruction L + current state S_t
Output: actions A_{t:t+H} (action chunk for the next H steps)
La granularidad de la instrucción puede variar:
- A nivel de tarea: "pon el cubo rojo en la caja azul" (una frase compartida por toda la trayectoria)
- A nivel de subobjetivo: "primero acércate al objeto" -> "luego cierra la pinza" (anotación segmentada, escenarios avanzados)
- A nivel de restricción: "coloca suavemente", "evita obstáculos" (modifica cómo se ejecuta la acción)
En los conjuntos de datos de LeRobot, el lenguaje suele escribirse en el campo meta/tasks.jsonl o annotation. GR00T lo lee a través de la clave annotation en modality.json; dos formas comunes son:
| Nombre de la clave | Conjuntos de datos típicos | Recomendación para reBot |
|---|---|---|
human.task_description | SO-100, cube_to_bowl y otras tareas sencillas de sobremesa | Recomendado: coherente con el ejemplo del Capítulo 20 |
human.action.task_description | LIBERO, SimplerEnv y otros benchmarks de simulación | Úsalo solo si tus datos provienen de estos benchmarks |
Ambas claves son válidas, pero deben coincidir con los campos reales del conjunto de datos; no las mezcles entre entrenamiento e inferencia.
Consejos prácticos (reBot Arm):
- Al grabar cada demostración, describe la tarea en una frase corta, con el verbo al principio en chino o en inglés.
- Mantén la redacción coherente para tareas similares, por ejemplo usa de forma uniforme "put X on Y".
- Evita que un único dato corresponda a múltiples redacciones; cuanto más coherente, mejor durante las primeras fases de ajuste fino.
18.6 Tarea única, multitarea y generalización
18.6 Tarea única, multitarea y generalización
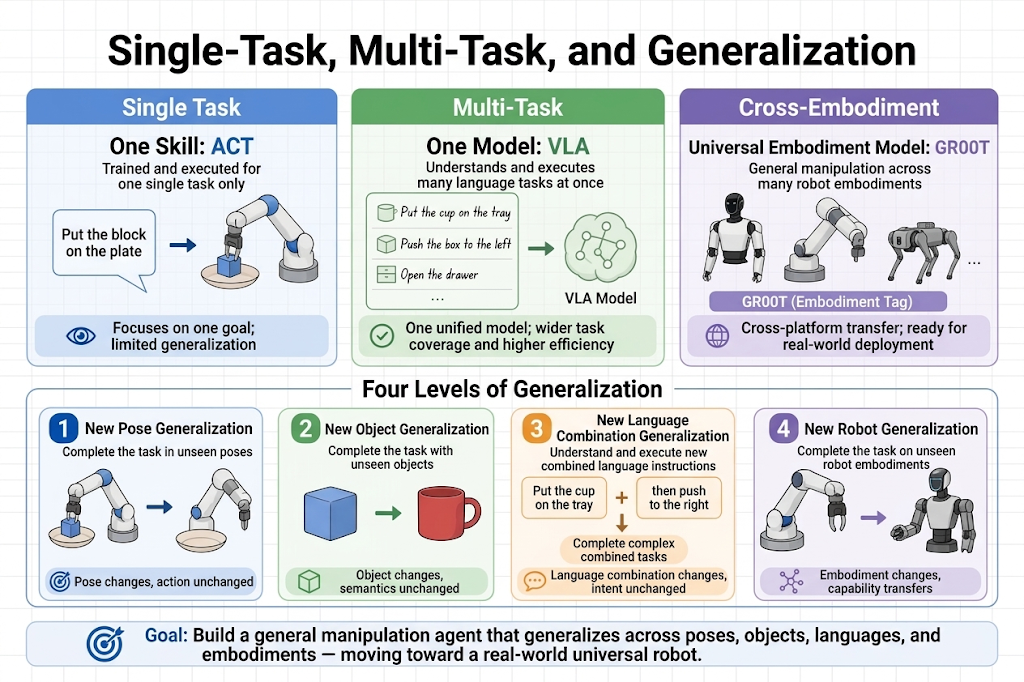
| Paradigma de entrenamiento | Descripción | Escenarios adecuados |
|---|---|---|
| Tarea única | Aprende solo una habilidad | Predeterminado de ACT; pocos datos, objetivo claro |
| Multitarea | El mismo modelo aprende múltiples habilidades, diferenciadas por el idioma | Fine-tuning de VLA; ordenado de escritorio, clasificación, etc. |
| Generalización entre encarnaciones | Diferentes robots comparten un modelo base | Preentrenamiento de GR00T; adaptado mediante embodiment_tag |
"Generalización" en las VLA tiene varios niveles — no los confundas:
- Misma tarea, nueva pose inicial: aún puede agarrar cuando cambia la posición del cubo — ACT normalmente también puede hacer esto.
- Nuevos objetos, nuevos contenedores: se basa en la generalización visual — requiere suficiente diversidad en los datos de entrenamiento.
- Nuevas combinaciones de instrucciones en lenguaje: "pon A sobre B" nunca visto antes pero el patrón de la frase es familiar — la ventaja de condicionamiento por lenguaje de la VLA.
- Nueva encarnación de robot: sigue siendo utilizable al cambiar de brazo — requiere la capa de proyección de encarnación de GR00T más una pequeña cantidad de datos de fine-tuning.
Para los usuarios de reBot Arm, la expectativa realista es: después del fine-tuning, puedes cambiar entre las múltiples tareas en lenguaje ya recopiladas; para objetos completamente nuevos o patrones de frases completamente nuevos, aún se necesitan datos de demostración adicionales.
18.7 Acciones continuas y tokens de acción
18.7 Acciones continuas y tokens de acción
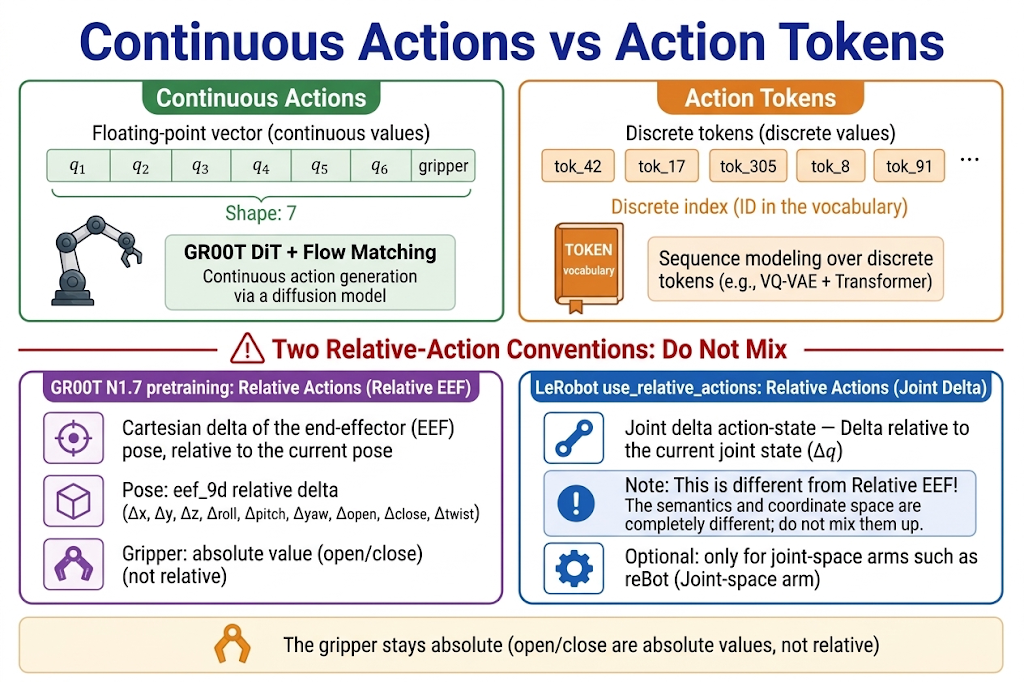
Hay dos representaciones principales para los comandos de control de robots:
Acciones continuas
Produce directamente un vector de coma flotante, p. ej. 6 ángulos de articulación + 1 valor de apertura/cierre del efector final:
action = [q1, q2, q3, q4, q5, q6, gripper] # shape: (7,)
- Ventaja: alta precisión, coherente con la interfaz real del motor.
- Desventaja: la regresión en un espacio de alta dimensión es difícil.
- GR00T usa: DiT + Flow Matching para eliminar ruido en el espacio continuo, produciendo fragmentos de acción.
Tokens de acción (acciones discretizadas)
Cuantiza valores continuos en símbolos discretos, como un modelo de lenguaje que predice el siguiente token:
action_tokens = [tok_42, tok_17, tok_89, ...]
- Ventaja: puede reutilizar arquitecturas LLM autoregresivas; adoptado por algunas VLA como pi0-FAST.
- Desventaja: pérdida por cuantización, diseño complejo del vocabulario.
Acciones relativas vs. absolutas:
- El núcleo del preentrenamiento de GR00T N1.7 es el espacio de acción Relative EEF (efector final relativo): las acciones se representan como incrementos cartesianos relativos a la pose actual del efector final, en lugar de incrementos de ángulo de articulación. Los incrementos del efector final tienen una semántica más coherente entre diferentes robots (incluso vídeo humano), lo cual es clave para la generalización entre encarnaciones de N1.7. El código oficial configura esto por grupo de acciones:
eef_9dusa efector final relativo,joint_positionusa articulación relativa, ygripper_positionse mantiene absoluto. --policy.use_relative_actions=truede LeRobot es un interruptor a nivel de framework: aplica una transformación relativa deaction - statea las dimensiones de articulación. Esto no es lo mismo que el Relative EEF del artículo, ni es "la recomendación predeterminada de N1.7". Cuando el reBot Arm se ejecuta en espacio de articulaciones (NON_EEF), este interruptor es solo un paso de preprocesamiento opcional de LeRobot; no lo describas como "coherente con el diseño de preentrenamiento de GR00T".- Cantidades que no son de articulación, como el gripper, suelen usar
relative_exclude_jointspara mantener el control absoluto. Las trayectorias relativas de articulaciones son más suaves, pero la ejecución a largo plazo puede derivar.
18.8 Capacidades y limitaciones de VLA
18.8 Capacidades y limitaciones de VLA
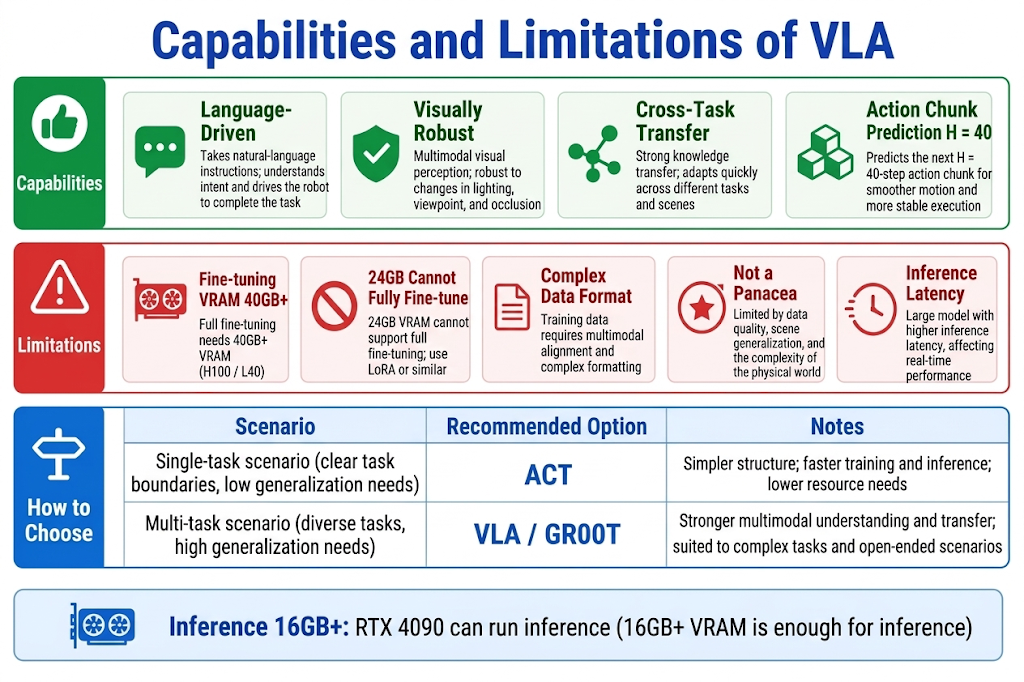
Capacidades
- Impulsado por lenguaje: un modelo, muchas tareas; cambia el comportamiento cambiando la instrucción.
- Robustez visual: el preentrenamiento a gran escala aporta una mejor comprensión de la escena que un ACT pequeño.
- Transferencia entre tareas: las representaciones pueden compartirse entre patrones de frases similares y objetos similares.
- Predicción de fragmentos de acción: una inferencia produce múltiples pasos, adecuado para control en tiempo real (con la política de inferencia RTC).
Limitaciones
- Alta demanda de cómputo: N1.7-3B recomienda más de 40 GB de VRAM para el fine-tuning (H100 / L40; entrenar solo el proyector + la cabeza DiT alcanza un pico de alrededor de 35 GB; el tutorial oficial de fine-tuning en simulación requiere ≥ 48 GB). La inferencia solo necesita 16 GB+ (una RTX 4090 puede ejecutar la inferencia). El fine-tuning completo en una tarjeta de 24 GB es básicamente inviable a menos que se use fine-tuning eficiente como LoRA / PEFT.
- Formato de datos más complejo: además de los campos estándar de LeRobot, se requieren un
modality.jsony una etiqueta de encarnación. - No es una panacea: objetos, instrucciones y disposiciones de estaciones de trabajo no cubiertos por el conjunto de entrenamiento aún pueden fallar.
- Latencia: la inferencia de modelos grandes es más lenta que ACT; configura
n_action_stepsy los parámetros de RTC adecuadamente. - Brecha sim-to-real: los datos de preentrenamiento están dominados por plataformas humanoides/específicas; los brazos de escritorio requieren suficiente fine-tuning.
¿Cuándo elegir ACT y cuándo elegir VLA?
| Escenario | Recomendación |
|---|---|
| Tarea repetitiva única, dispositivo perimetral, baja latencia | ACT |
| Multitarea, interacción por lenguaje, dispuesto a invertir en GPU y anotación | VLA / GR00T |
| Ya tienes datos de ACT, quieres ampliar a multitarea | Añade lenguaje a los datos existentes de LeRobot -> fine-tuning de GR00T |
18.9 Resumen del capítulo
18.9 Resumen del capítulo
- Los modelos multimodales fusionan visión, lenguaje y estado en decisiones unificadas.
- VLA añade salida de acción sobre VLM, admitiendo manipulación condicionada por lenguaje.
- ACT es una solución ligera de tarea única; GR00T es una solución VLA de preentrenamiento a gran escala + fine-tuning.
- El preentrenamiento N1.7 usa Relative EEF y
action_horizon=40; las acciones relativas de articulaciones en LeRobot son un paso de preprocesamiento opcional separado — no confundas ambos. - El siguiente capítulo presenta cómo aterrizar la VLA general en esta encarnación específica, el reBot Arm.