19. Encarnación del Robot y Arquitectura del Sistema GR00T
Capítulo 19 del Curso de Introducción a la IA Física de Seeed: qué es una encarnación, definiciones de articulaciones/estado/acción, modalidades de cámara y lenguaje, las ventanas de observación y acción, el ajuste fino del modelo fundacional, la pila de LeRobot y la posición del reBot Arm en GR00T.
GR00T es un modelo fundacional multi-encarnación: se preentrena con múltiples conjuntos de datos de robots y distingue diferentes hardware mediante Etiquetas de Encarnación y configuración de Modalidad. Este capítulo explica dónde se sitúa el reBot Arm en la pila LeRobot + GR00T y cómo colaboran los componentes en tiempo de inferencia.
19.1 ¿Qué es la Encarnación de un Robot?
19.1 ¿Qué es la Encarnación de un Robot?
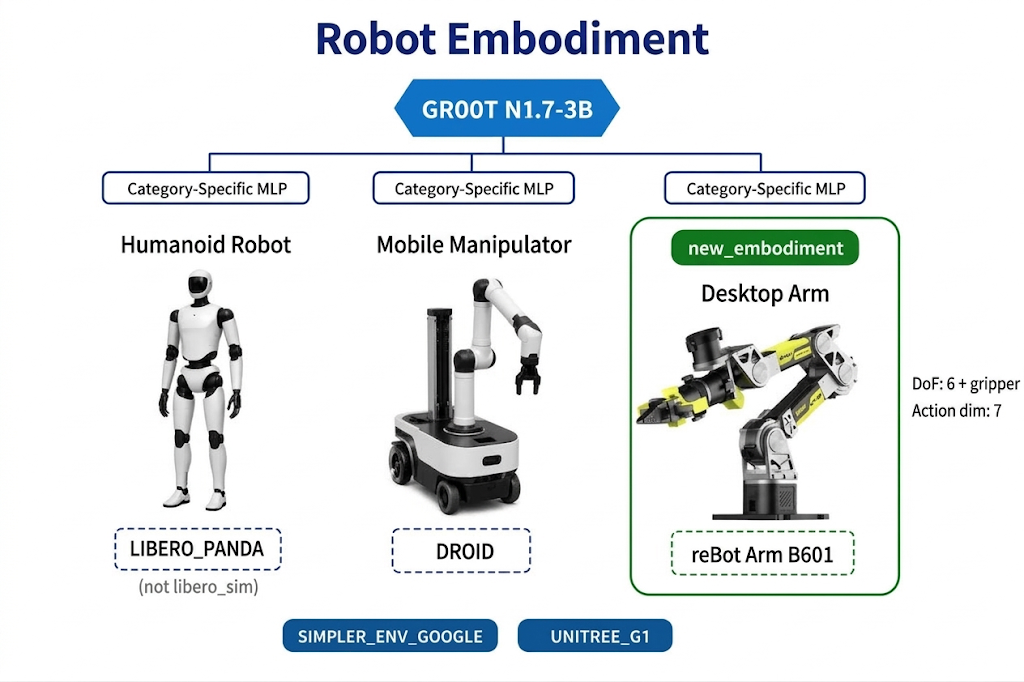
Encarnación describe la "identidad física y de control" de un robot, incluyendo:
- Número de grados de libertad (DoF) y orden de las articulaciones
- Límites de las articulaciones, relaciones de engranajes, modo de control (posición/par)
- Número de cámaras, posiciones de montaje y resolución
- Definición del espacio de acción (espacio articular vs. espacio cartesiano del efector final)
- Tipo de pinza y rango de apertura/cierre
El mismo modelo fundacional GR00T no puede aplicar directamente el vector articular de 6 dimensiones del SO-101 al reBot Arm. Internamente, el modelo utiliza un MLP específico por categoría (capa de proyección por encarnación) para mapear estados/acciones de diferentes dimensiones a un espacio latente compartido y luego volver a mapear a las dimensiones de acción de cada encarnación.
En LeRobot / GR00T, la encarnación se especifica mediante embodiment_tag. Las etiquetas oficiales de preentrenamiento (EmbodimentTag) incluyen:
LIBERO_PANDA,DROID,SIMPLER_ENV_GOOGLE,UNITREE_G1,OXE_WIDOWX, etc.- Nuevo hardware:
new_embodiment/NEW_EMBODIMENT(usado al ajustar finamente el reBot Arm).
No existe una etiqueta oficial llamada libero_sim. No apliques etiquetas de preentrenamiento a datos de reBot.
--policy.embodiment_tag=new_embodiment
Esto le indica a GR00T: los datos actuales provienen de un nuevo robot no visto durante el entrenamiento; por favor, usa la capa de proyección de nueva encarnación para el ajuste fino.
19.2 Definiciones de Articulaciones, Estado y Acción del Robot
19.2 Definiciones de Articulaciones, Estado y Acción del Robot
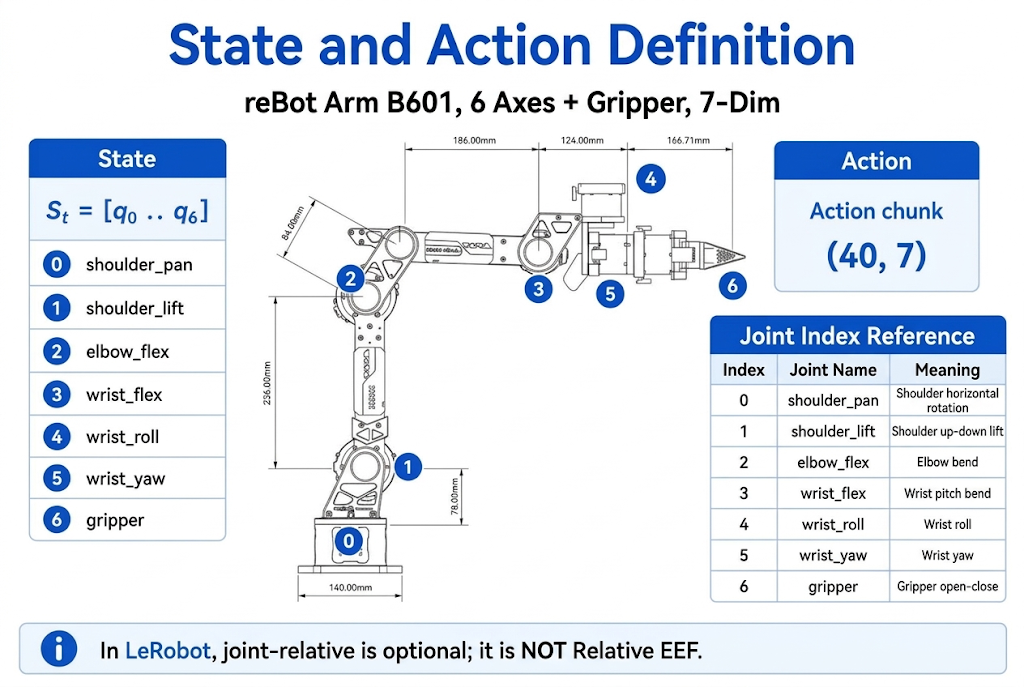
Tomando como ejemplo el reBot Arm B601 (6 ejes + pinza):
Articulaciones y Estado
El Estado (estado de observación) es una de las entradas de la política y representa la configuración actual del robot:
observation.state = [q1, q2, q3, q4, q5, q6, gripper_pos]
                     └──────── 6 joint angles ─────┘  └ gripper ┘
- Unidad: los ángulos articulares suelen ser radianes (rad) o grados (deg); deben ser consistentes dentro del conjunto de datos.
- Orden: debe ser exactamente consistente con el script de grabación,
modality.jsony el cliente de inferencia. - En
meta/modality.json, se puede dividir en:state.single_arm-> índices 0-5state.gripper-> índice 6
Acción
La Acción es la salida de la política, ejecutada por el controlador de bajo nivel:
action = [target_q1, ..., target_q6, target_gripper]
GR00T N1.7 genera un bloque de acción de H pasos cada vez (preentrenado con action_horizon=40; LeRobot groot usa por defecto chunk_size=50). Este tutorial alinea el entrenamiento con N1.7, usando H=40:
action_chunk.shape = (40, 7) # 40 steps x 7 dimensions
El bucle de control normalmente toma una fila del bloque y la envía al motor en cada paso o cada k pasos; el rollout de LeRobot usa n_action_steps para controlar cuántos pasos se ejecutan por inferencia.
19.3 Modalidad de Cámara
19.3 Modalidad de Cámara
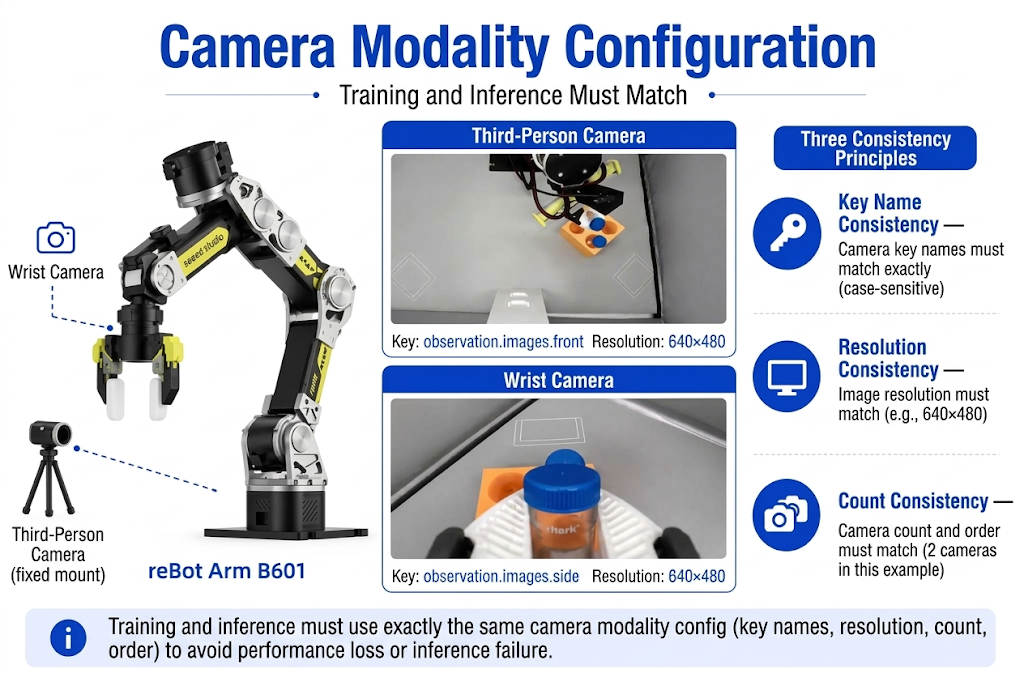
GR00T usa visión como principal, lenguaje como auxiliar y estado como complementario. La configuración de la cámara debe estar estrictamente alineada con los datos de entrenamiento.
Disposiciones de cámara comunes (reBot Arm)
| Nombre de clave (ejemplo) | Posición | Propósito |
|---|---|---|
front | Cámara de gran angular montada en el soporte | Escena global, localización del objeto objetivo |
side / wrist | Cámara de muñeca | Apuntado de cerca, escenas ocluidas |
En los conjuntos de datos de LeRobot, los vídeos se almacenan como observation.images.<camera_name>; en el campo video de meta/modality.json se declaran la resolución y el índice de cada cámara.
Notas
- Los nombres de clave de cámara, la cantidad y la resolución deben ser idénticos entre entrenamiento e inferencia.
- El backbone de GR00T admite relaciones de aspecto nativas, pero se recomienda unificar a 640x480 o a la resolución acordada del conjunto de datos.
- Durante el ajuste fino, habilita
dataset.image_transforms(variaciones de brillo y contraste) para mejorar la robustez. - Encuentra el índice de cámara local con
lerobot-find-cameras opencv.
19.4 Modalidad de Lenguaje
19.4 Modalidad de Lenguaje
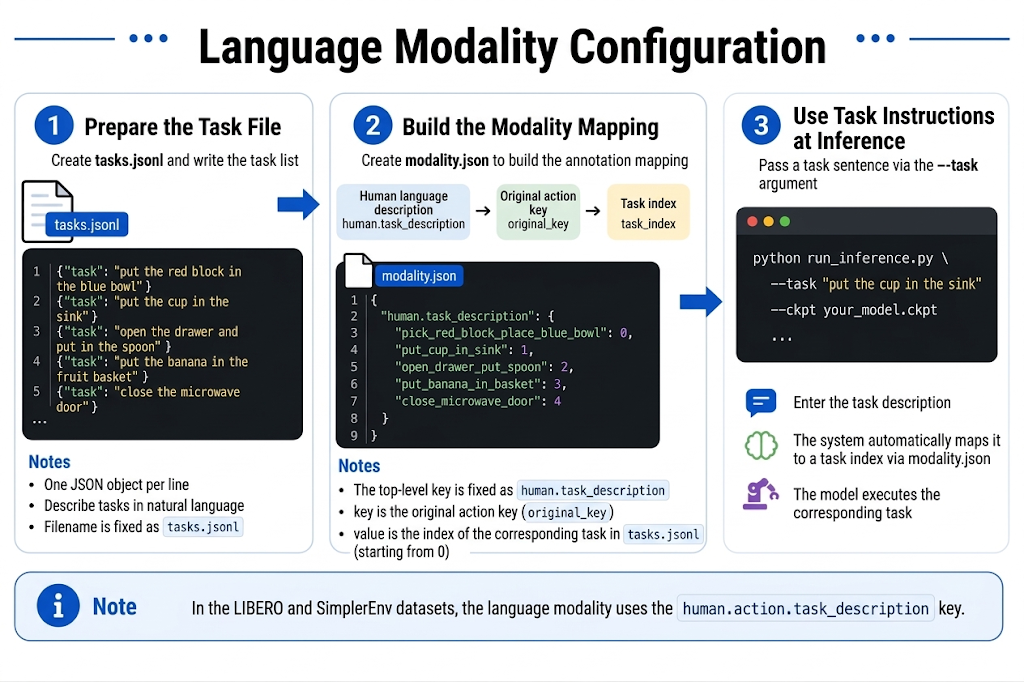
En la canalización de GR00T, el lenguaje actúa como una entrada de condicionamiento, que se introduce en el backbone VLM junto con los tokens de imagen.
Lado de los datos
- LeRobot:
meta/tasks.jsonlo anotación a nivel de episodio - Extensión de GR00T:
meta/modality.json-> campoannotation
Ejemplo de fragmento de modality.json (las tareas de escritorio de reBot usan human.task_description):
{
  "annotation": {
    "human.task_description": {
      "original_key": "task_index"
    }
  }
}
Si los datos provienen de LIBERO / SimplerEnv, usa human.action.task_description en su lugar. El nombre de la clave debe coincidir con el modality.json completo del Capítulo 20.
Lado de la inferencia
Al ejecutar lerobot-rollout, pásalo mediante --task:
--task="place the red cube on the blue tray"
Esta cadena se codifica y se introduce en el modelo junto con la imagen y el estado actuales. Por favor, usa un estilo de lenguaje y un patrón de frases similares a los de los datos de entrenamiento.
19.5 Ventana de Observación y Ventana de Acción
19.5 Ventana de Observación y Ventana de Acción
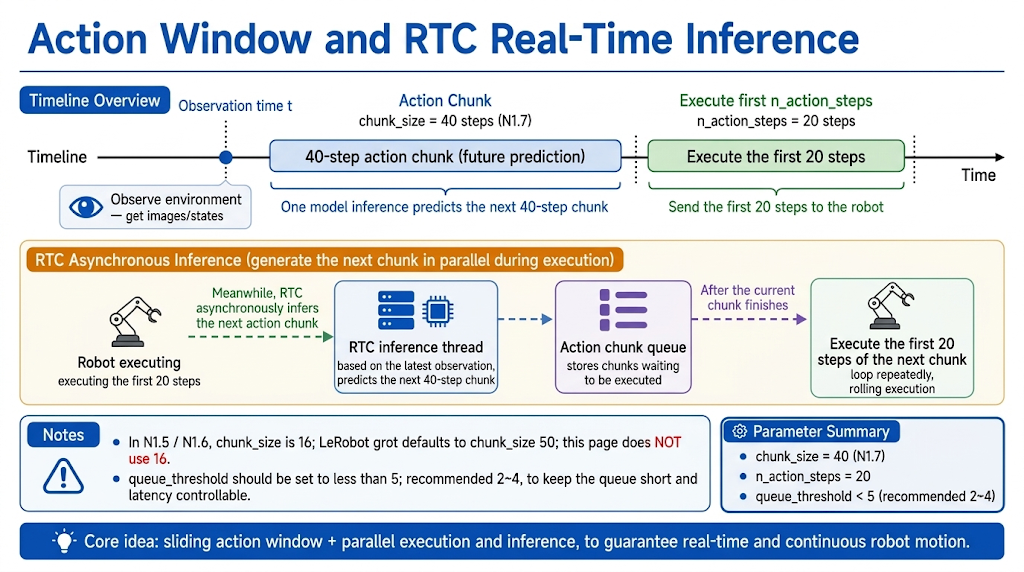
La inferencia VLA no es “mirar un fotograma y generar una acción”; implica un diseño de muestreo en la dimensión temporal:
Time axis ─────────────────────────────────────────────►

Observation window:  [t-k ... t-1, t]     ← historical image frames (optional)
State:              S_t
Language:           L
Action prediction window:    [A_t, A_{t+1}, ... A_{t+H-1}]
                              └── H = chunk_size / action_horizon
| Parámetro | Valor típico (N1.7) | Significado |
|---|---|---|
chunk_size / action_horizon | 40 (alineado con N1.7; el código fuente de LeRobot groot usa por defecto 50; N1.5/N1.6 es 16) | Número de pasos de acción predichos por inferencia |
n_action_steps | 8-40 | Pasos realmente ejecutados por inferencia, debe ser ≤ chunk_size |
n_obs_steps | 1 | Cuántos fotogramas de imagen históricos se usan |
RTC (Real-Time Chunking): cuando el tiempo de inferencia se aproxima al período de control, LeRobot admite la política RTC, que calcula de forma asíncrona el siguiente bloque mientras ejecuta el actual, reduciendo las pausas. En el rollout, actívalo mediante --inference.type=rtc; queue_threshold indica cuántos pasos quedan en la cola de acciones antes de disparar una nueva inferencia, recomendado en 2-5; establecerlo en 0 provoca una nueva inferencia cada vez, lo que tiende a aumentar las oscilaciones.
19.6 Modelo Fundacional y Ajuste Fino
19.6 Modelo Fundacional y Ajuste Fino
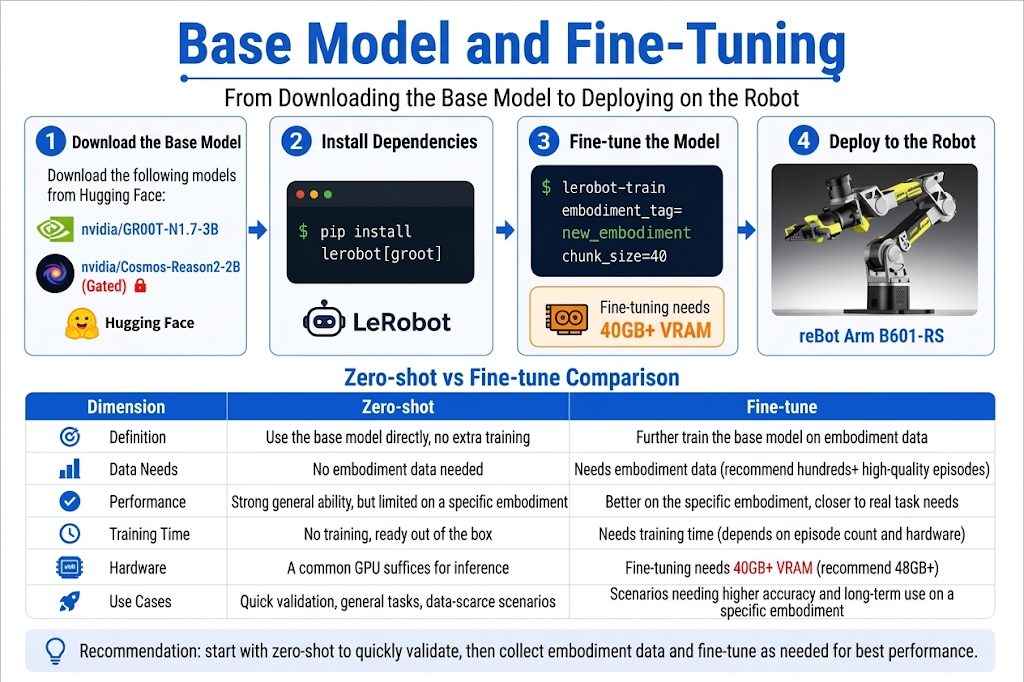
Modelo Fundacional
NVIDIA GR00T N1.7-3B está preentrenado con datos multi-encarnación a gran escala y posee capacidades generales de visión-lenguaje-acción. Se puede obtener a través de Hugging Face:
nvidia/GR00T-N1.7-3B
LeRobot instala la compatibilidad con GR00T:
pip install "lerobot[groot]"
# or from source:
pip install -e ".[groot]"
Consulta la documentación de instalación de LeRobot para más detalles.
Fine-Tuning
El flujo de trabajo típico en el reBot Arm:
- Prepara el dataset LeRobot v2 +
meta/modality.json(Capítulo 20). - Especifica
embodiment_tag=new_embodiment. - Inicia el entrenamiento con
lerobot-train --policy.type=groot(Capítulo 21). - Sube el checkpoint a Hugging Face Hub o guárdalo localmente en
outputs/.
Durante el fine-tuning:
- El backbone VLM es Cosmos-Reason2-2B; el fine-tuning por defecto a menudo congela el LLM y se centra en entrenar el proyector + la cabeza DiT (pico alrededor de 35 GB).
- La cabeza de acción DiT y la capa de proyección de embodiment se adaptan a las dimensiones de estado/acción de reBot.
- Recomendación de volumen de datos: al menos 50 demostraciones exitosas por tarea, y más para multi-tarea.
- VRAM: 40 GB o más para fine-tuning; para tarjetas de 24 GB usa LoRA/PEFT, o ejecuta solo inferencia.
Zero-Shot vs. Fine-Tuning
| Método | Descripción |
|---|---|
| Zero-shot | Usa GR00T-N1.7-3B directamente; puede funcionar solo cuando la tarea es extremadamente similar a un embodiment preentrenado |
| Fine-tuning | La ruta recomendada para el reBot Arm; una pequeña cantidad de datos de manipulación de escritorio mejora significativamente la tasa de éxito |
19.7 Arquitectura del sistema GR00T (pila LeRobot)
19.7 Arquitectura del sistema GR00T (pila LeRobot)
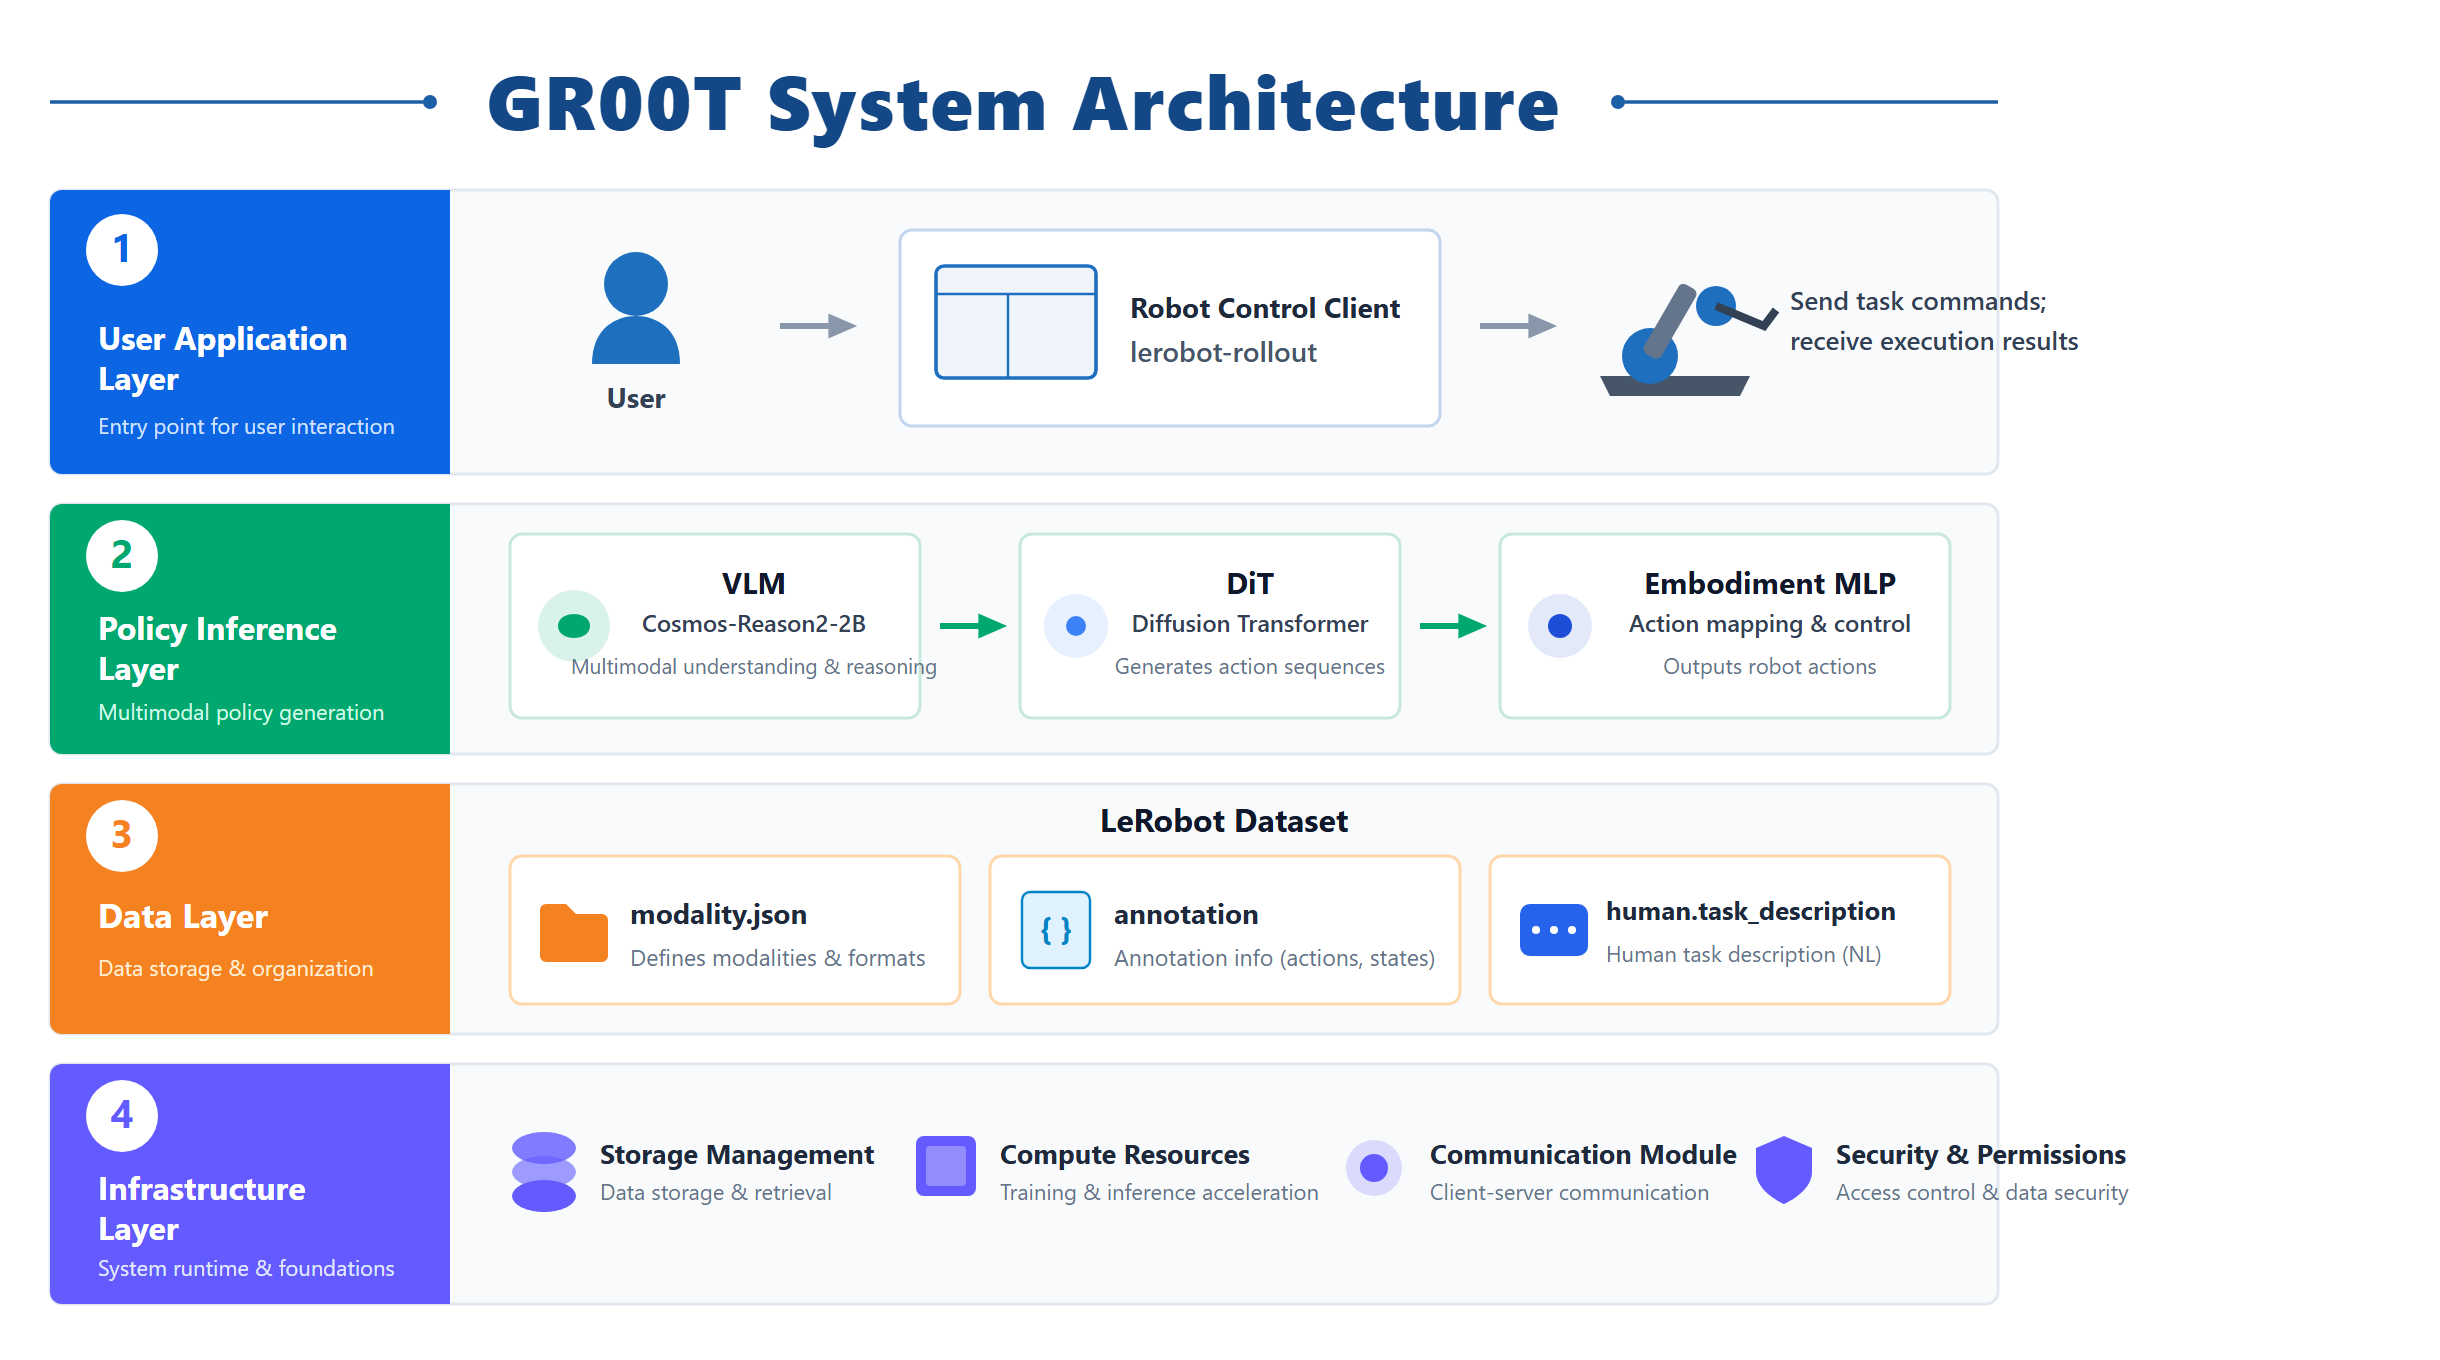
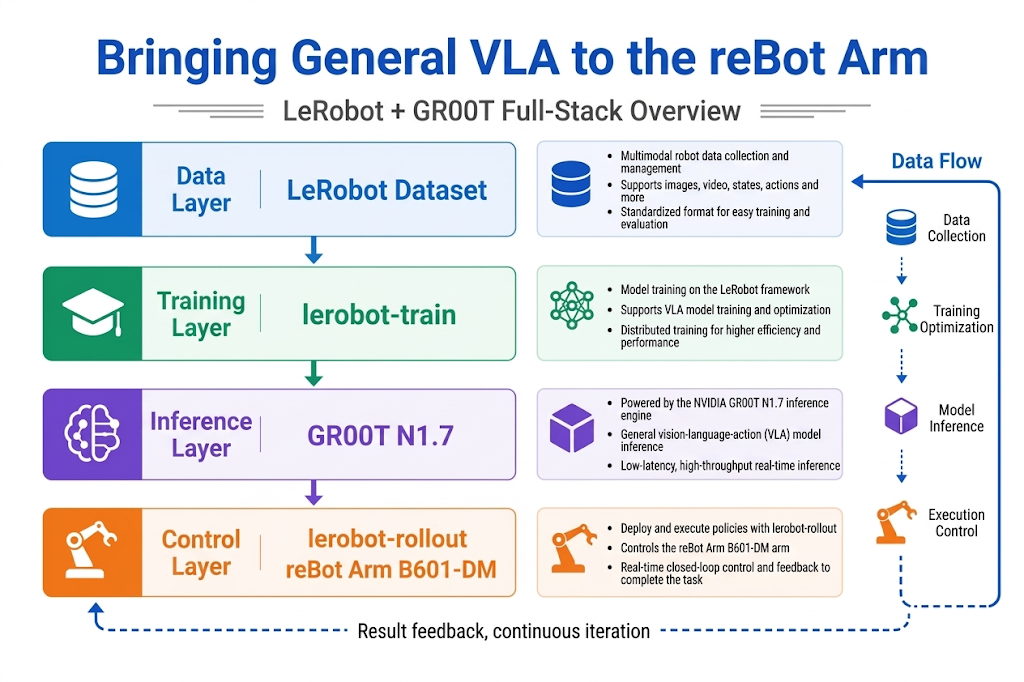
El sistema reBot GR00T basado en LeRobot se puede dividir en cuatro capas:
┌────────────────────────────────────────────────────────────┐
│                    User / Application Layer                 │
│         Natural language task  +  start rollout / teach UI  │
└────────────────────────────┬───────────────────────────────┘
                             │
┌────────────────────────────▼───────────────────────────────┐
│              Robot Control Client (LeRobot Rollout)         │
│  - Capture camera images, read joint state                  │
│  - Send observation to policy, receive action chunk        │
│  - Execute actions via reBot driver (serial/CAN)            │
│  lerobot-rollout --policy.type=groot --robot.type=...      │
└────────────────────────────┬───────────────────────────────┘
                             │ observation / action
┌────────────────────────────▼───────────────────────────────┐
│              Policy Inference (GR00T N1.7)                 │
│  ┌──────────────┐  ┌─────────────┐  ┌──────────────────┐ │
│  │ VLM Backbone │→ │  DiT Head   │→ │ Embodiment MLP   │ │
│  │ Cosmos-Reason2-2B │  │ Flow Match  │  │ decode to 7-DoF  │ │
│  └──────────────┘  └─────────────┘  └──────────────────┘ │
│  Can be in the same process as rollout, or split into a     │
│  separate GPU inference service (advanced deployment)       │
└────────────────────────────┬───────────────────────────────┘
                             │
┌────────────────────────────▼───────────────────────────────┐
│              Data and Training Layer (LeRobot Dataset v2)   │
│  episodes / videos / meta/modality.json / tasks.jsonl      │
│  lerobot-train / lerobot-record / lerobot-replay           │
└────────────────────────────────────────────────────────────┘
Flujo de datos interno del modelo (simplificado)
- Imagen -> codificador visual VLM -> tokens visuales
- Instrucción en lenguaje -> tokenizador de texto -> tokens de lenguaje
- Estado -> MLP de codificación de embodiment -> tokens de estado
- Fusión de tokens multimodales -> DiT des-ruido iterativo -> variables latentes de acción
- MLP de decodificación de embodiment ->
action_chunk (H x action_dim)
19.8 Servidor de inferencia GR00T y cliente de control del robot
19.8 Servidor de inferencia GR00T y cliente de control del robot
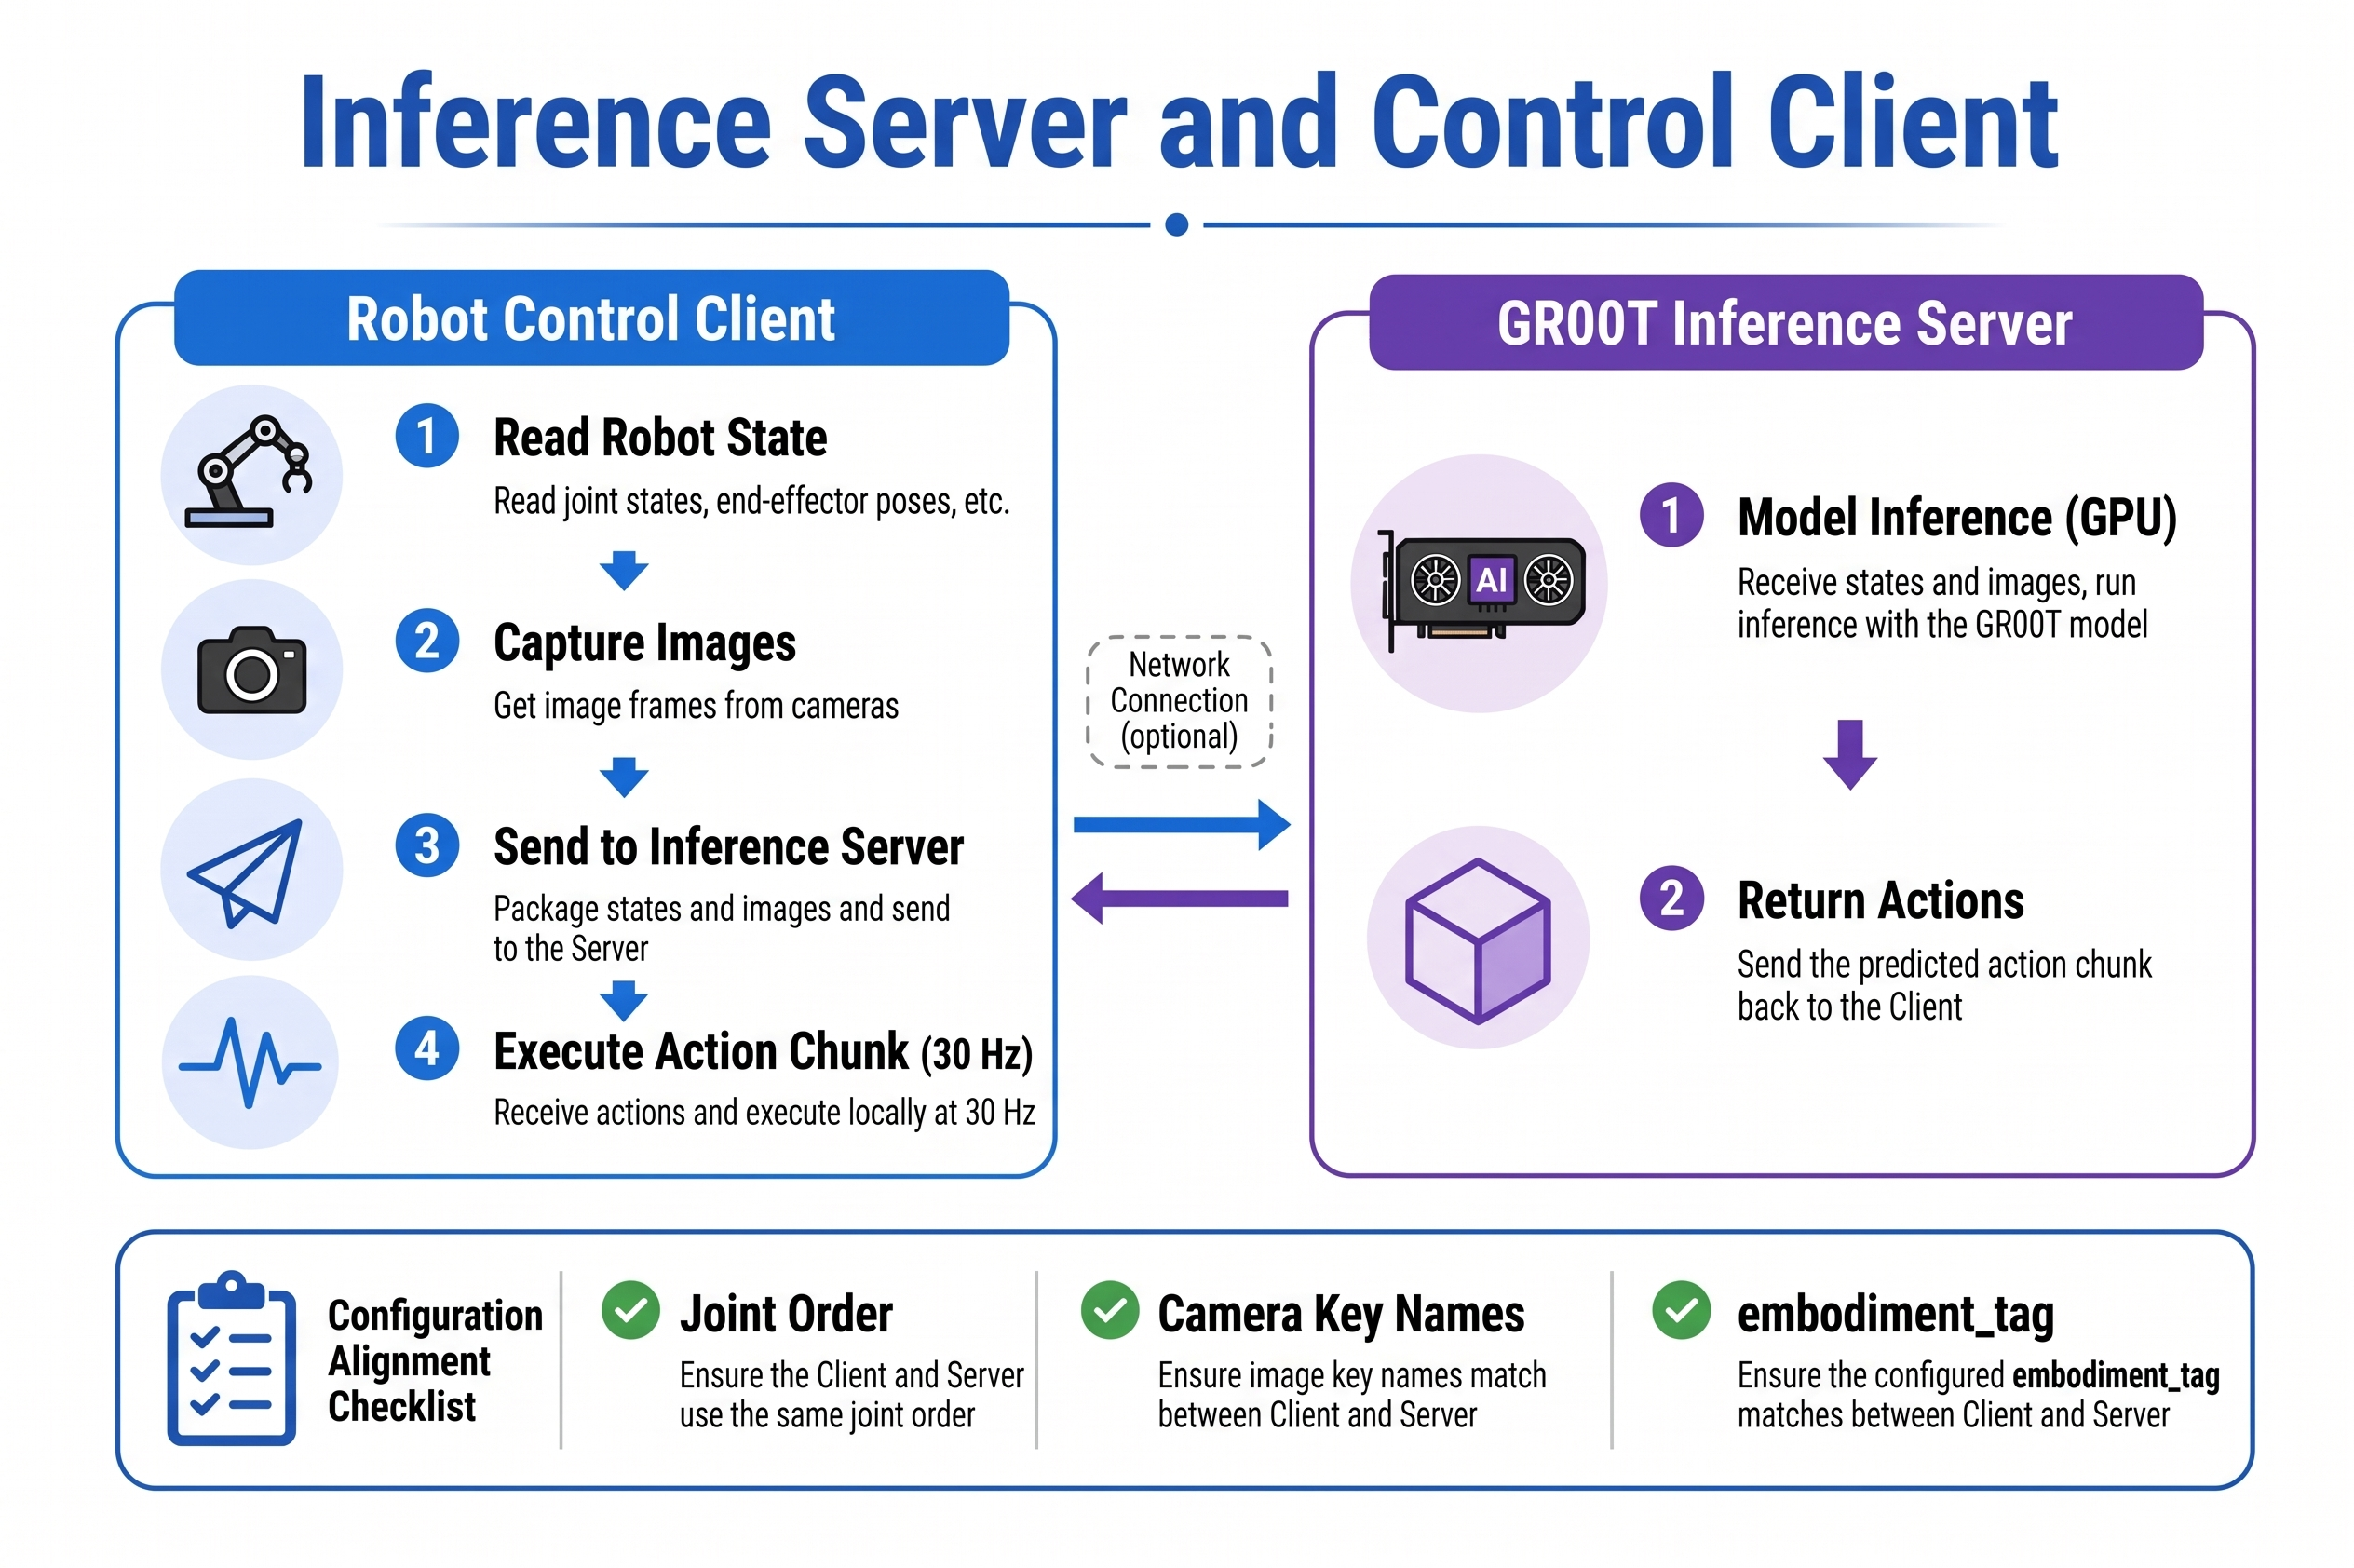
Al poner todo en marcha en una placa de desarrollo, es común separar el cálculo pesado del control en tiempo real:
Cliente de control del robot
Responsabilidades:
- Leer el estado de las articulaciones del reBot Arm a una frecuencia fija (p. ej., 30 Hz)
- Capturar la imagen más reciente de la cámara
- Enviar
{images, state, task}al lado de inferencia - Recibir
action_chunky desglosar las acciones hacia el motor segúnn_action_steps - Supervisar los límites de seguridad y el paro de emergencia
En LeRobot esto corresponde a lerobot-rollout, configurado con el robot.type, port, can_adapter de reBot y el diccionario de cámara cameras. RS usa can0 + socketcan; DM usa /dev/ttyACM0 + damiao.
Servidor de inferencia GR00T (opcional)
Cuando la GPU está en una máquina de escritorio y el brazo está in situ, la política se puede desplegar como un servicio independiente:
- El cliente envía JSON de observación / tensores a través de la red
- El servidor carga
policy.pathybase_model_pathy devuelve fragmentos de acción - Reduce la presión de cómputo en el lado del brazo
LeRobot coloca la inferencia y el rollout en el mismo proceso por defecto (--device=cuda), adecuado para depuración en una sola máquina. Para producción, consulta los ejemplos de despliegue en el repositorio Isaac GR00T y encapsula la inferencia como un servicio HTTP/gRPC; la interfaz principal del modelo es coherente con la política groot de LeRobot.
Lista de comprobación de integración
| Elemento a comprobar | Descripción |
|---|---|
| Orden de las articulaciones | dataset = modality.json = controlador de rollout |
| Unidad de ángulo | no se deben mezclar rad y deg |
| Nombres de clave de cámara | front, wrist, etc. coinciden con el entrenamiento |
embodiment_tag | Tanto el fine-tuning como la inferencia usan new_embodiment |
base_model_path | En inferencia, normalmente aún se necesita nvidia/GR00T-N1.7-3B como base de configuración |
| Fragmento y RTC | n_action_steps ≤ chunk_size; umbral de cola RTC ≤ 5 |
19.9 La posición del reBot Arm en GR00T
19.9 La posición del reBot Arm en GR00T
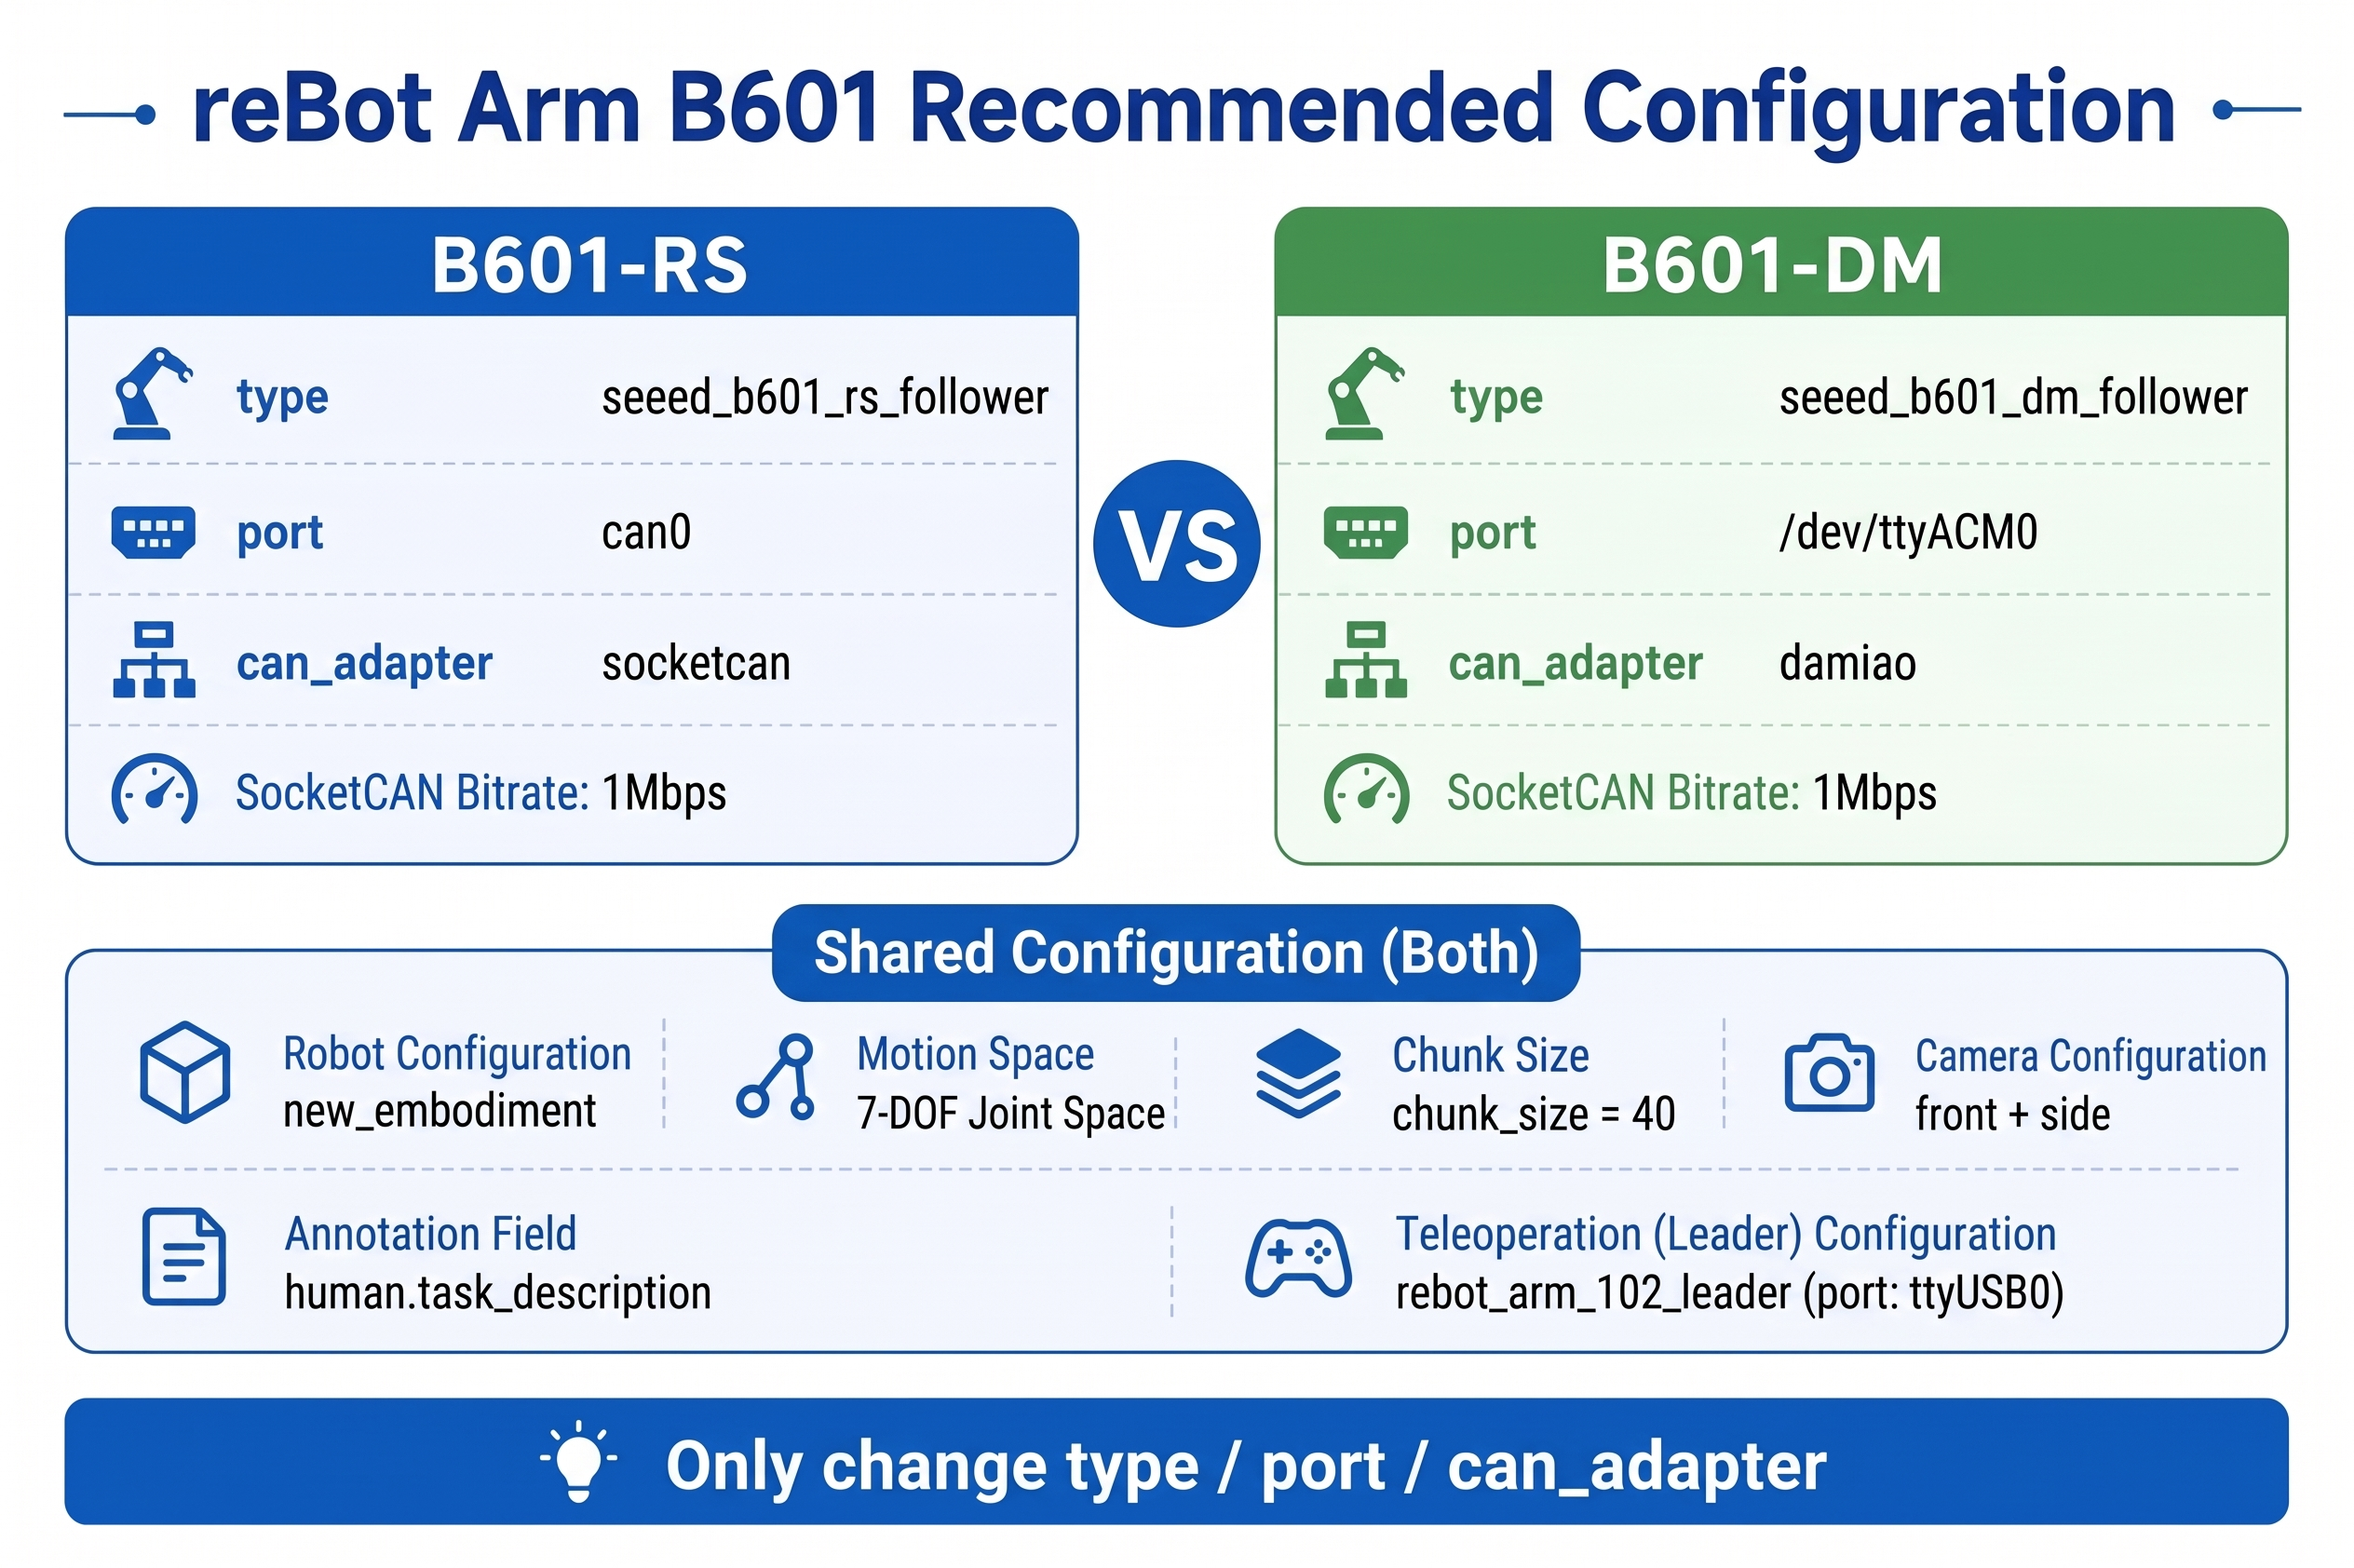
| Elemento | Configuración recomendada del reBot Arm B601 |
|---|---|
embodiment_tag | new_embodiment |
| claves de estado | single_arm (6) + gripper (1) |
| claves de acción | Alineadas con el estado, 7 dimensiones |
| tipo de acción | Espacio articular NON_EEF. En LeRobot, opcional use_relative_actions=true (relativo a la articulación, no EEF relativo) |
| Ventana de acción | Entrenamiento chunk_size=40 (alineado con N1.7 action_horizon) |
| Cámaras | Al menos 1 flujo; se recomienda frontal + muñeca / lateral |
| Lenguaje | Una descripción de tarea por episodio; la anotación usa human.task_description |
| Interfaz de control | Ver la tabla siguiente: RS usa SocketCAN; DM usa serie Damiao |
Diferencias de driver entre B601-RS y B601-DM (solo cambia estos tres en los comandos de LeRobot):
| Versión | robot.type | robot.port | robot.can_adapter | Referencia |
|---|---|---|---|---|
| B601-RS | seeed_b601_rs_follower | can0 | socketcan | B601-RS LeRobot Wiki |
| B601-DM | seeed_b601_dm_follower | /dev/ttyACM0 | damiao | B601-DM LeRobot Wiki |
Ambos son de 6 ejes + pinza, estado/acción de 7 dimensiones; el lado de teleoperación es siempre --teleop.type=rebot_arm_102_leader --teleop.port=/dev/ttyUSB0. Antes de usar RS, configura CAN: sudo ip link set can0 type can bitrate 1000000 && sudo ip link set can0 up.
El Capítulo 20 explicará paso a paso cómo organizar los datos existentes de aprendizaje por imitación en el formato anterior; el Capítulo 21 se basa en esto para completar el fine-tuning con lerobot-train.
19.10 Resumen del capítulo
19.10 Resumen del capítulo
- Embodiment define la interfaz física y de control del robot; el reBot Arm se une a GR00T como
new_embodiment(no uses etiquetas de preentrenamiento comoLIBERO_PANDA/DROID). - Estado / Acción deben ser estrictamente coherentes en todo el dataset, la configuración de modalidades y el cliente de inferencia.
- Visión y lenguaje son las dos modalidades de condicionamiento de un VLA; la anotación de reBot usa
human.task_description. - Ventana de acción:
action_horizon=40de N1.7, junto con el RTC, determina el rendimiento en tiempo real. - Variante de modelo: B601-RS (SocketCAN) y B601-DM (Damiao serial) difieren solo en
type/port/can_adapter. - LeRobot proporciona una cadena de herramientas unificada para datos, entrenamiento y despliegue; GR00T proporciona capacidades VLA preentrenadas.
- El siguiente capítulo entra en la práctica: preparar el conjunto de datos VLA de reBot.