20. Preparación del conjunto de datos reBot VLA
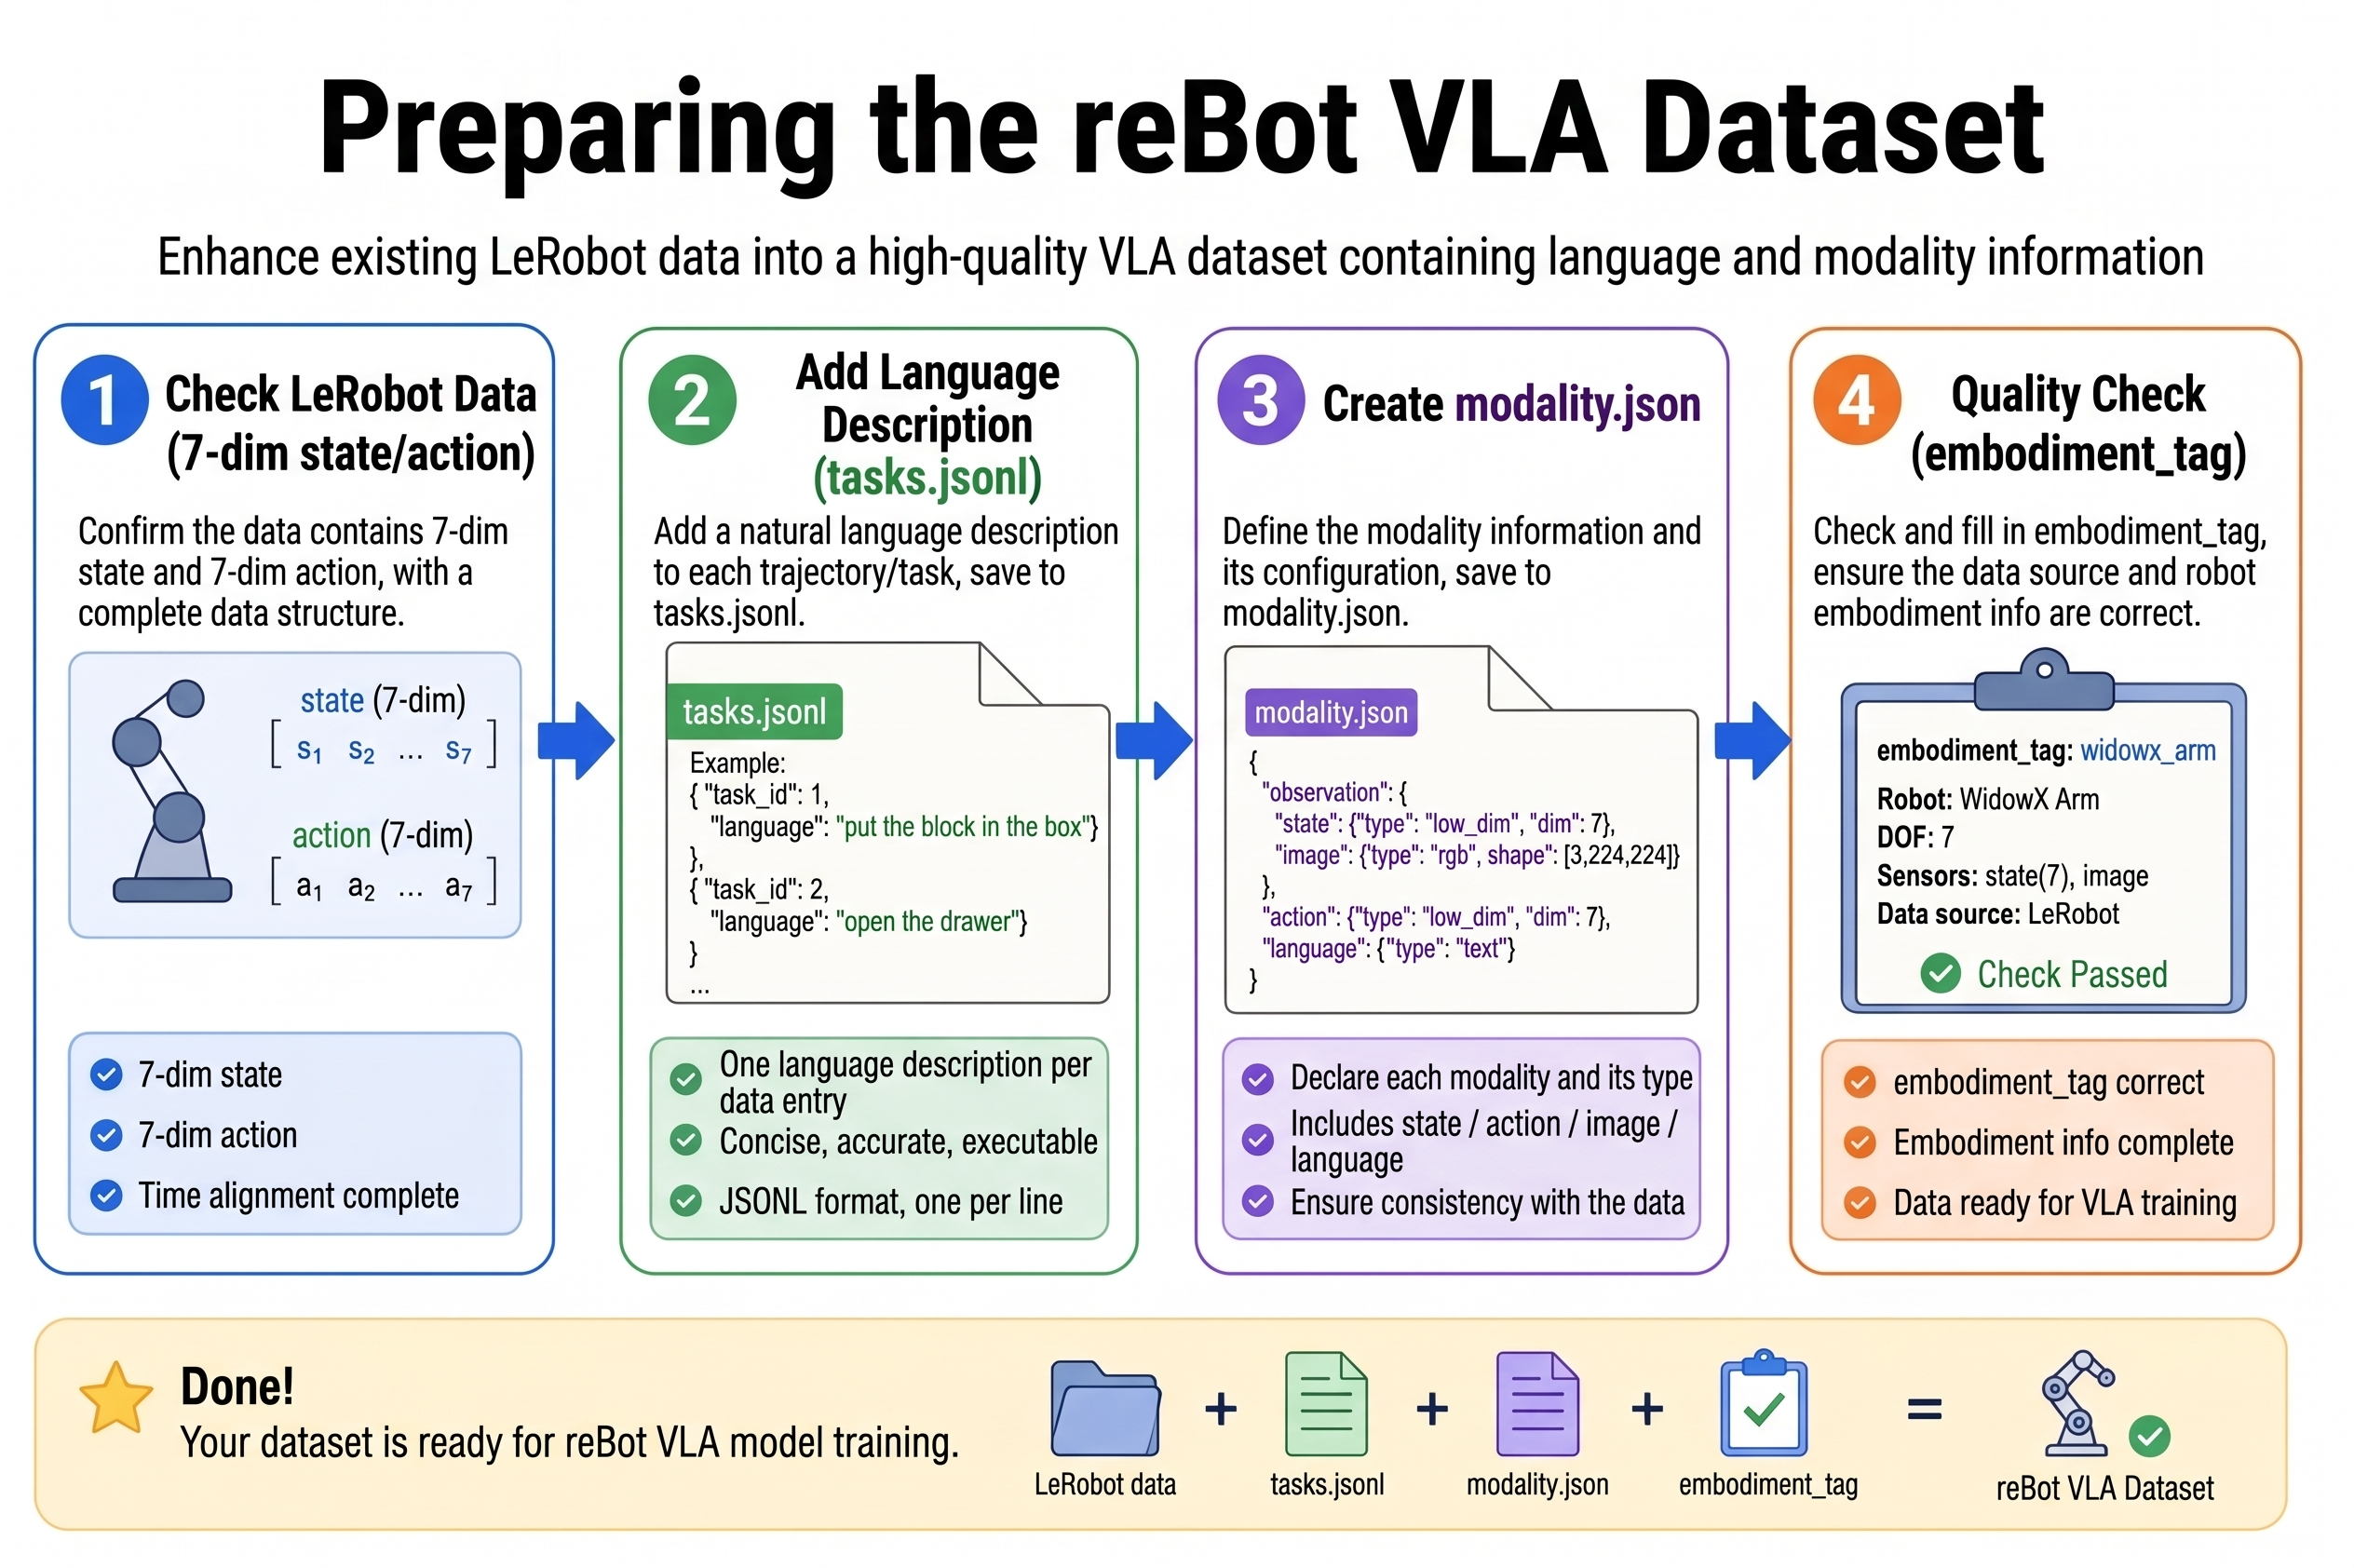
Capítulo 20 del Curso de Introducción a la IA Física de Seeed: requisitos previos, comprobación del conjunto de datos de LeRobot, añadido de descripciones de tareas en lenguaje natural, configuración de las claves de estado/acción/cámara, creación de meta/modality.json, establecimiento de la etiqueta de embodiment, verificación del orden de las articulaciones y las dimensiones, y organización multi‑tarea.
GR00T utiliza el formato LeRobotDataset v2/v3 en LeRobot y, además, requiere meta/modality.json para describir la división semántica de estado, acción, vídeo y anotación. Este capítulo asume que ya has recopilado datos ACT en el reBot Arm mediante lerobot-record; a continuación lo actualizaremos a datos de entrenamiento VLA.
20.1 Requisitos previos
20.1 Requisitos previos
| Elemento | Requisito |
|---|---|
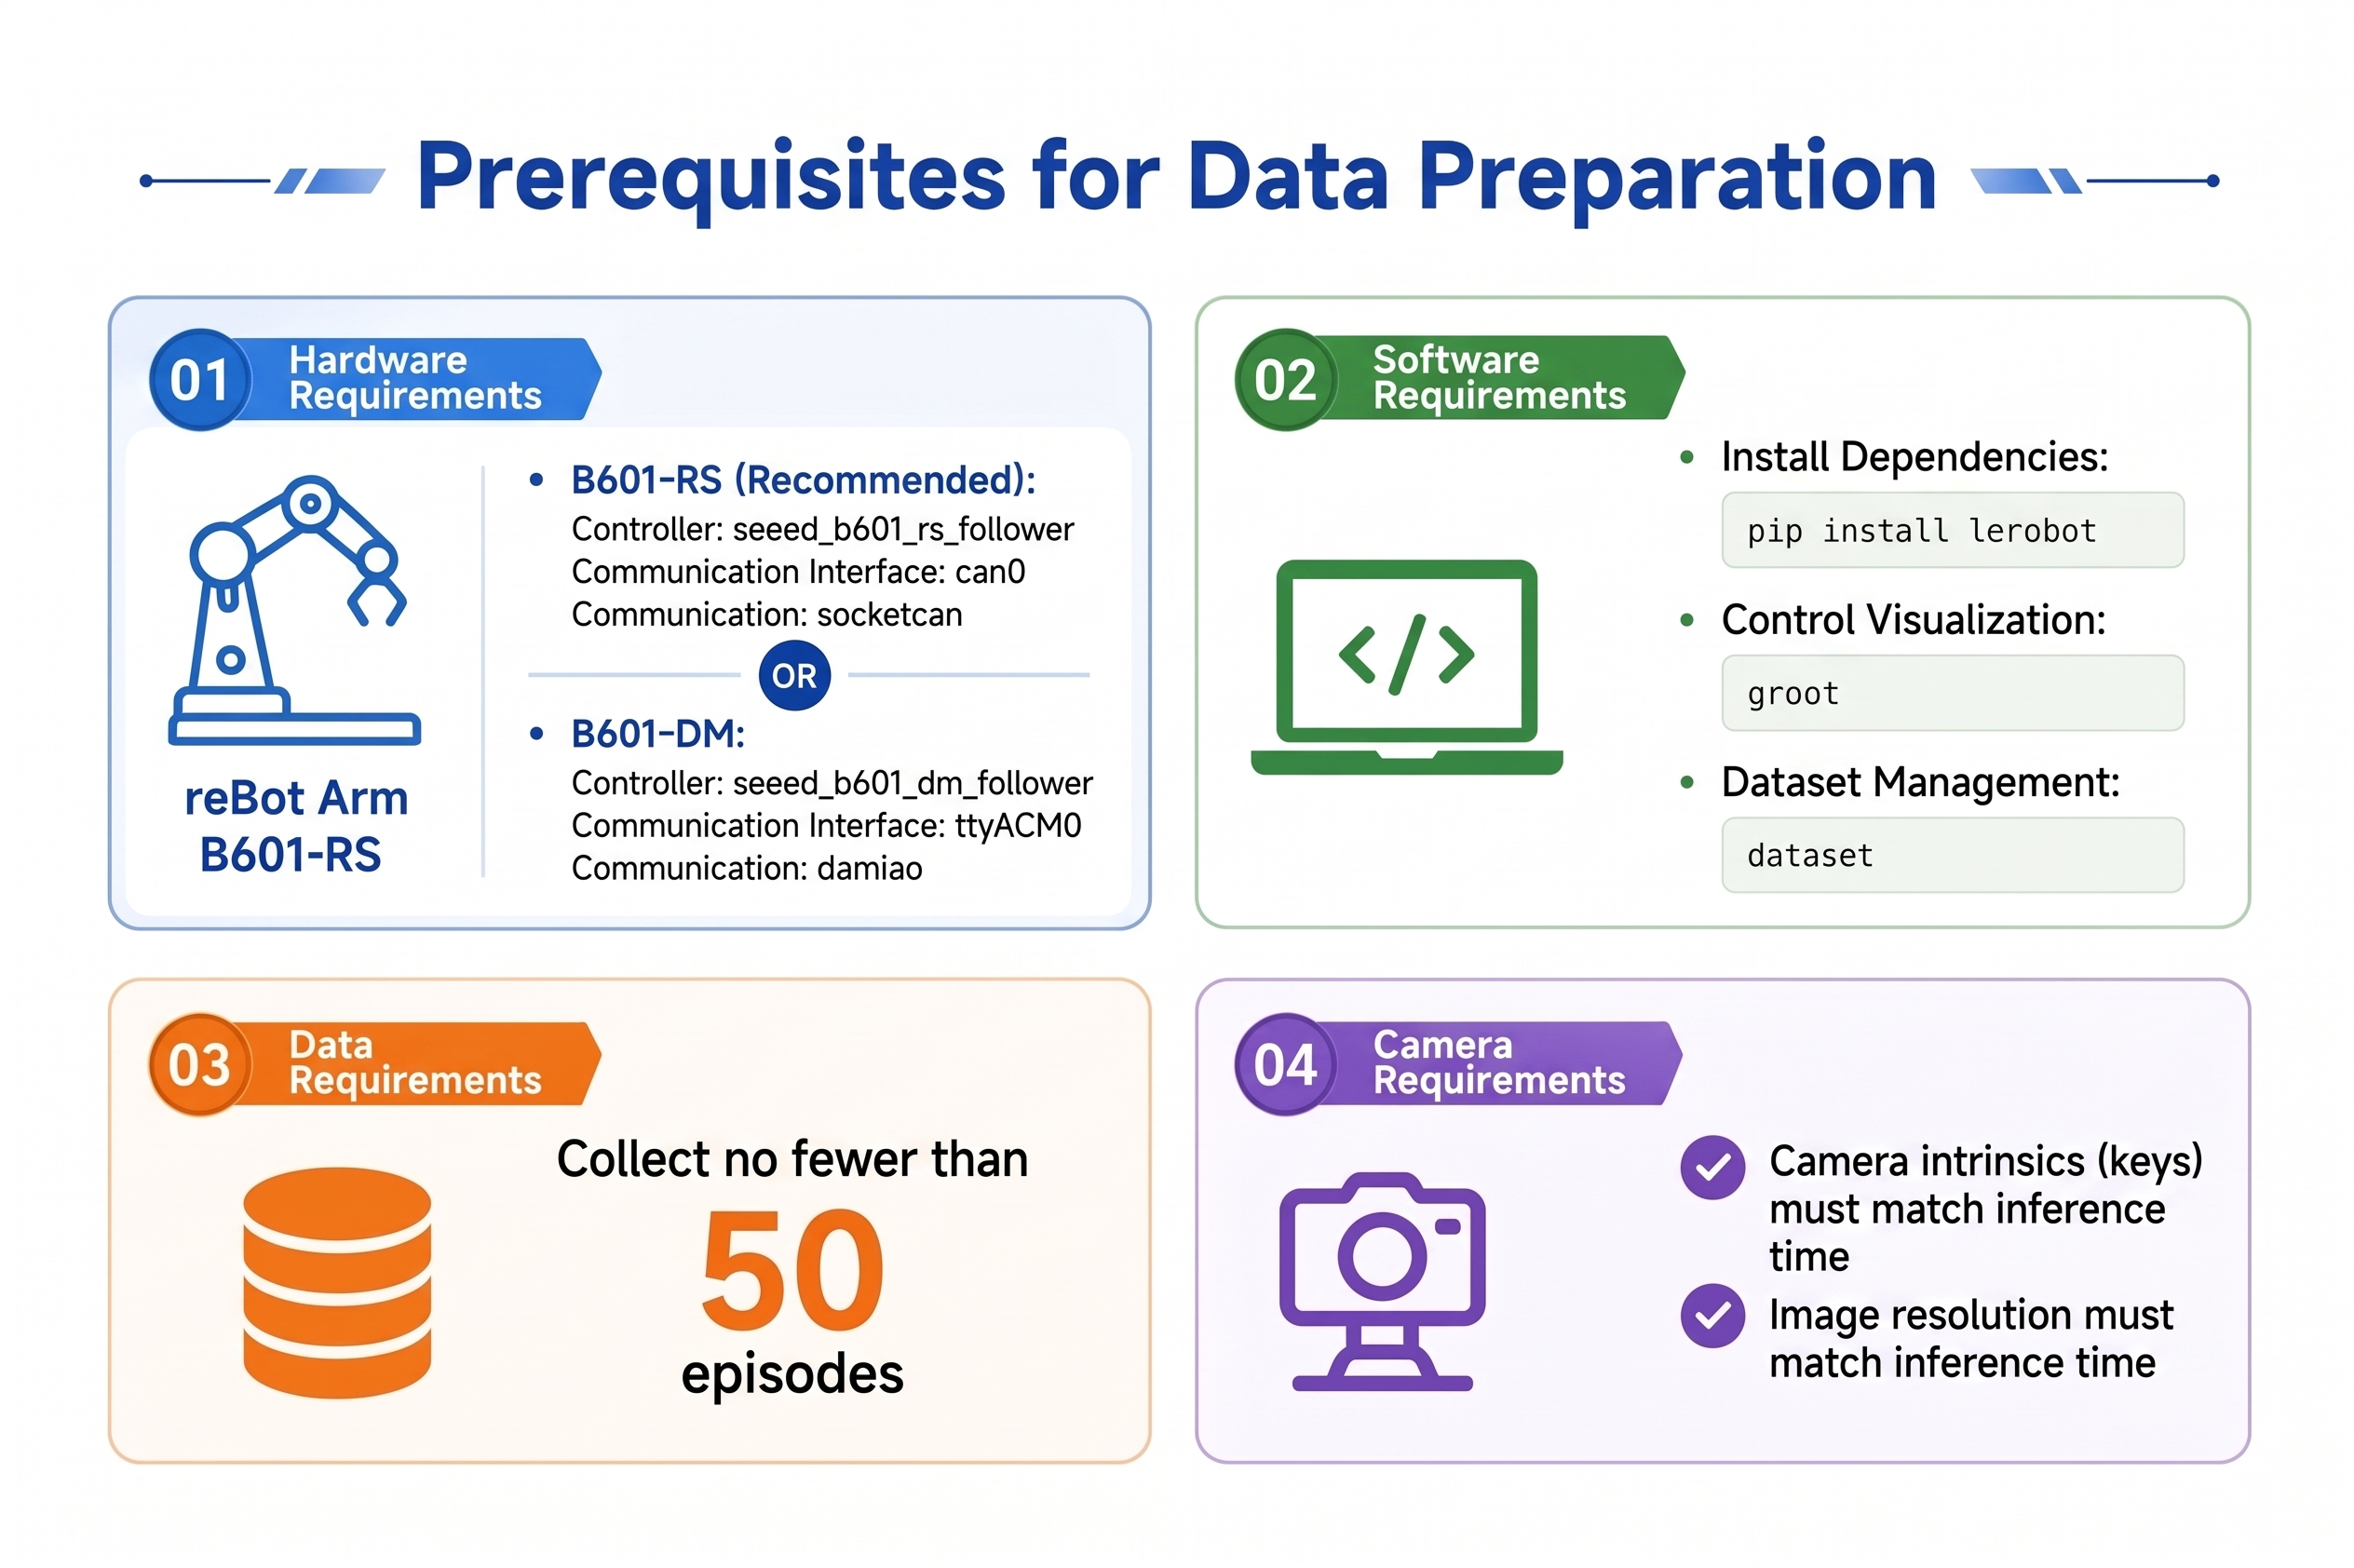
| Hardware | reBot Arm B601-RS o B601-DM calibrado (ver tabla inferior) |
| Software | LeRobot instalado; se recomienda pip install "lerobot[groot,training]" |
| Datos | Al menos 50 demostraciones satisfactorias para una tarea; para multi‑tarea, ≥ 30 por tarea |
| Cámara | Entrenamiento e inferencia usan los mismos nombres de clave, resolución y número de cámaras |
Referencia de variantes de modelo (solo cambia estos tres en todos los lerobot-record / lerobot-rollout posteriores):
| Versión | robot.type | robot.port | robot.can_adapter | Wiki |
|---|---|---|---|---|
| B601-RS | seeed_b601_rs_follower | can0 | socketcan | Primeros pasos con LeRobot |
| B601-DM | seeed_b601_dm_follower | /dev/ttyACM0 | damiao | Primeros pasos con LeRobot |
Antes de usar RS, configura CAN: sudo ip link set can0 type can bitrate 1000000 && sudo ip link set can0 up. El lado de teleoperación es siempre rebot_arm_102_leader, normalmente en el puerto /dev/ttyUSB0.
Documentos de referencia:
20.2 Comprobación del conjunto de datos de LeRobot
20.2 Comprobación del conjunto de datos de LeRobot
Estructura del directorio del conjunto de datos
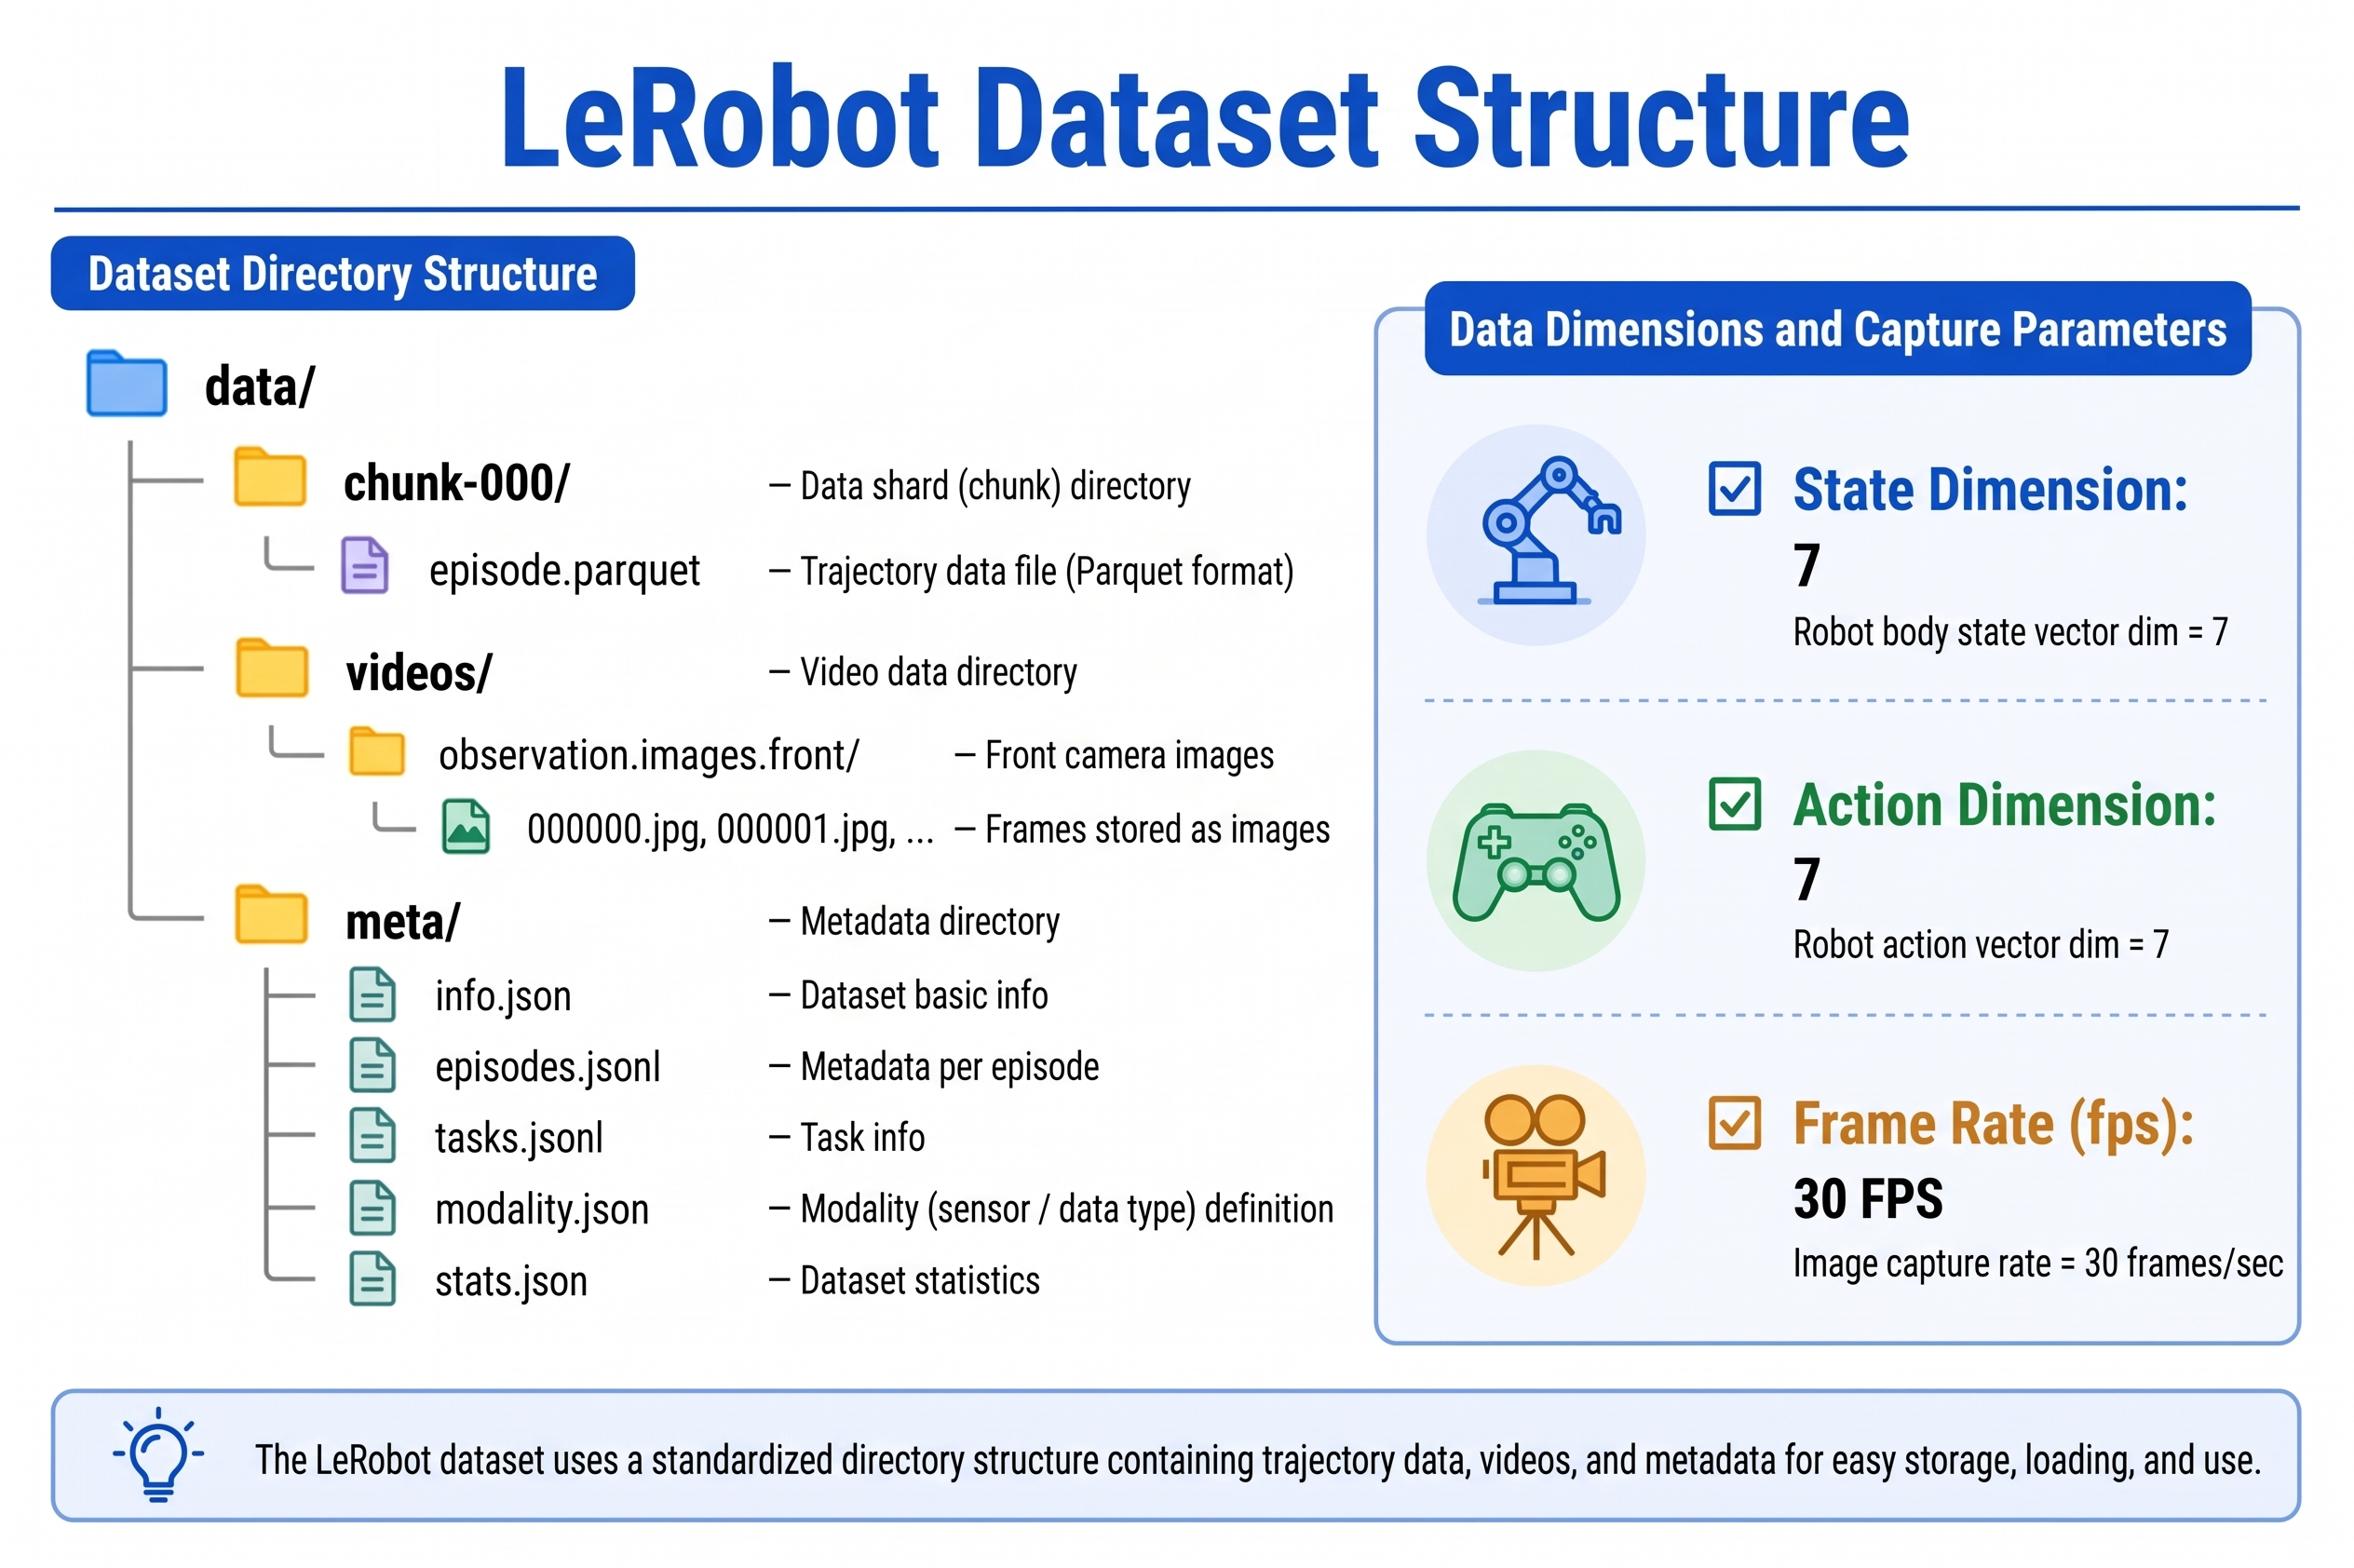
Los conjuntos de datos locales se encuentran por defecto en:
~/.cache/huggingface/lerobot/<repo_id>/
├── data/
│   └── chunk-000/
│       └── episode_*.parquet
├── videos/
│   └── chunk-000/
│       └── observation.images.<camera_name>/
├── meta/
│   ├── info.json
│   ├── episodes.jsonl
│   ├── tasks.jsonl          ← language task descriptions
│   ├── stats.json
│   └── modality.json        ← required by GR00T, create or verify manually
Comprobación rápida con Python
from lerobot.datasets.lerobot_dataset import LeRobotDataset

dataset = LeRobotDataset("seeed_rebot_b601_rs/pick_cube")  # RS example; for DM use seeed_rebot_b601_dm/pick_cube
print(dataset)
print("Feature keys:", dataset.features.keys())
print("Frame 0 state shape:", dataset[0]["observation.state"].shape)
print("Frame 0 action shape:", dataset[0]["action"].shape)
Lista de comprobación requerida
| Elemento a comprobar | Valor esperado (reBot B601-RS / B601-DM brazo único) |
|---|---|
Dimensión de observation.state | (7,) - 6 articulaciones + 1 pinza |
Dimensión de action | (7,) - alineada con el estado |
| Claves de vídeo | p. ej. observation.images.front, observation.images.side |
| FPS | Normalmente 30 |
tasks.jsonl | Cada task_index tiene una descripción en lenguaje natural correspondiente |
| Episodios fallidos | Eliminados o marcados para evitar contaminar el entrenamiento |
Si el estado/acción no es de 7 dimensiones, la configuración del robot durante la grabación era incorrecta; vuelve a lerobot-record para depurar. No fuerces la edición de modality.json para rellenar dimensiones.
20.3 Añadir descripciones de tareas en lenguaje natural
20.3 Añadir descripciones de tareas en lenguaje natural
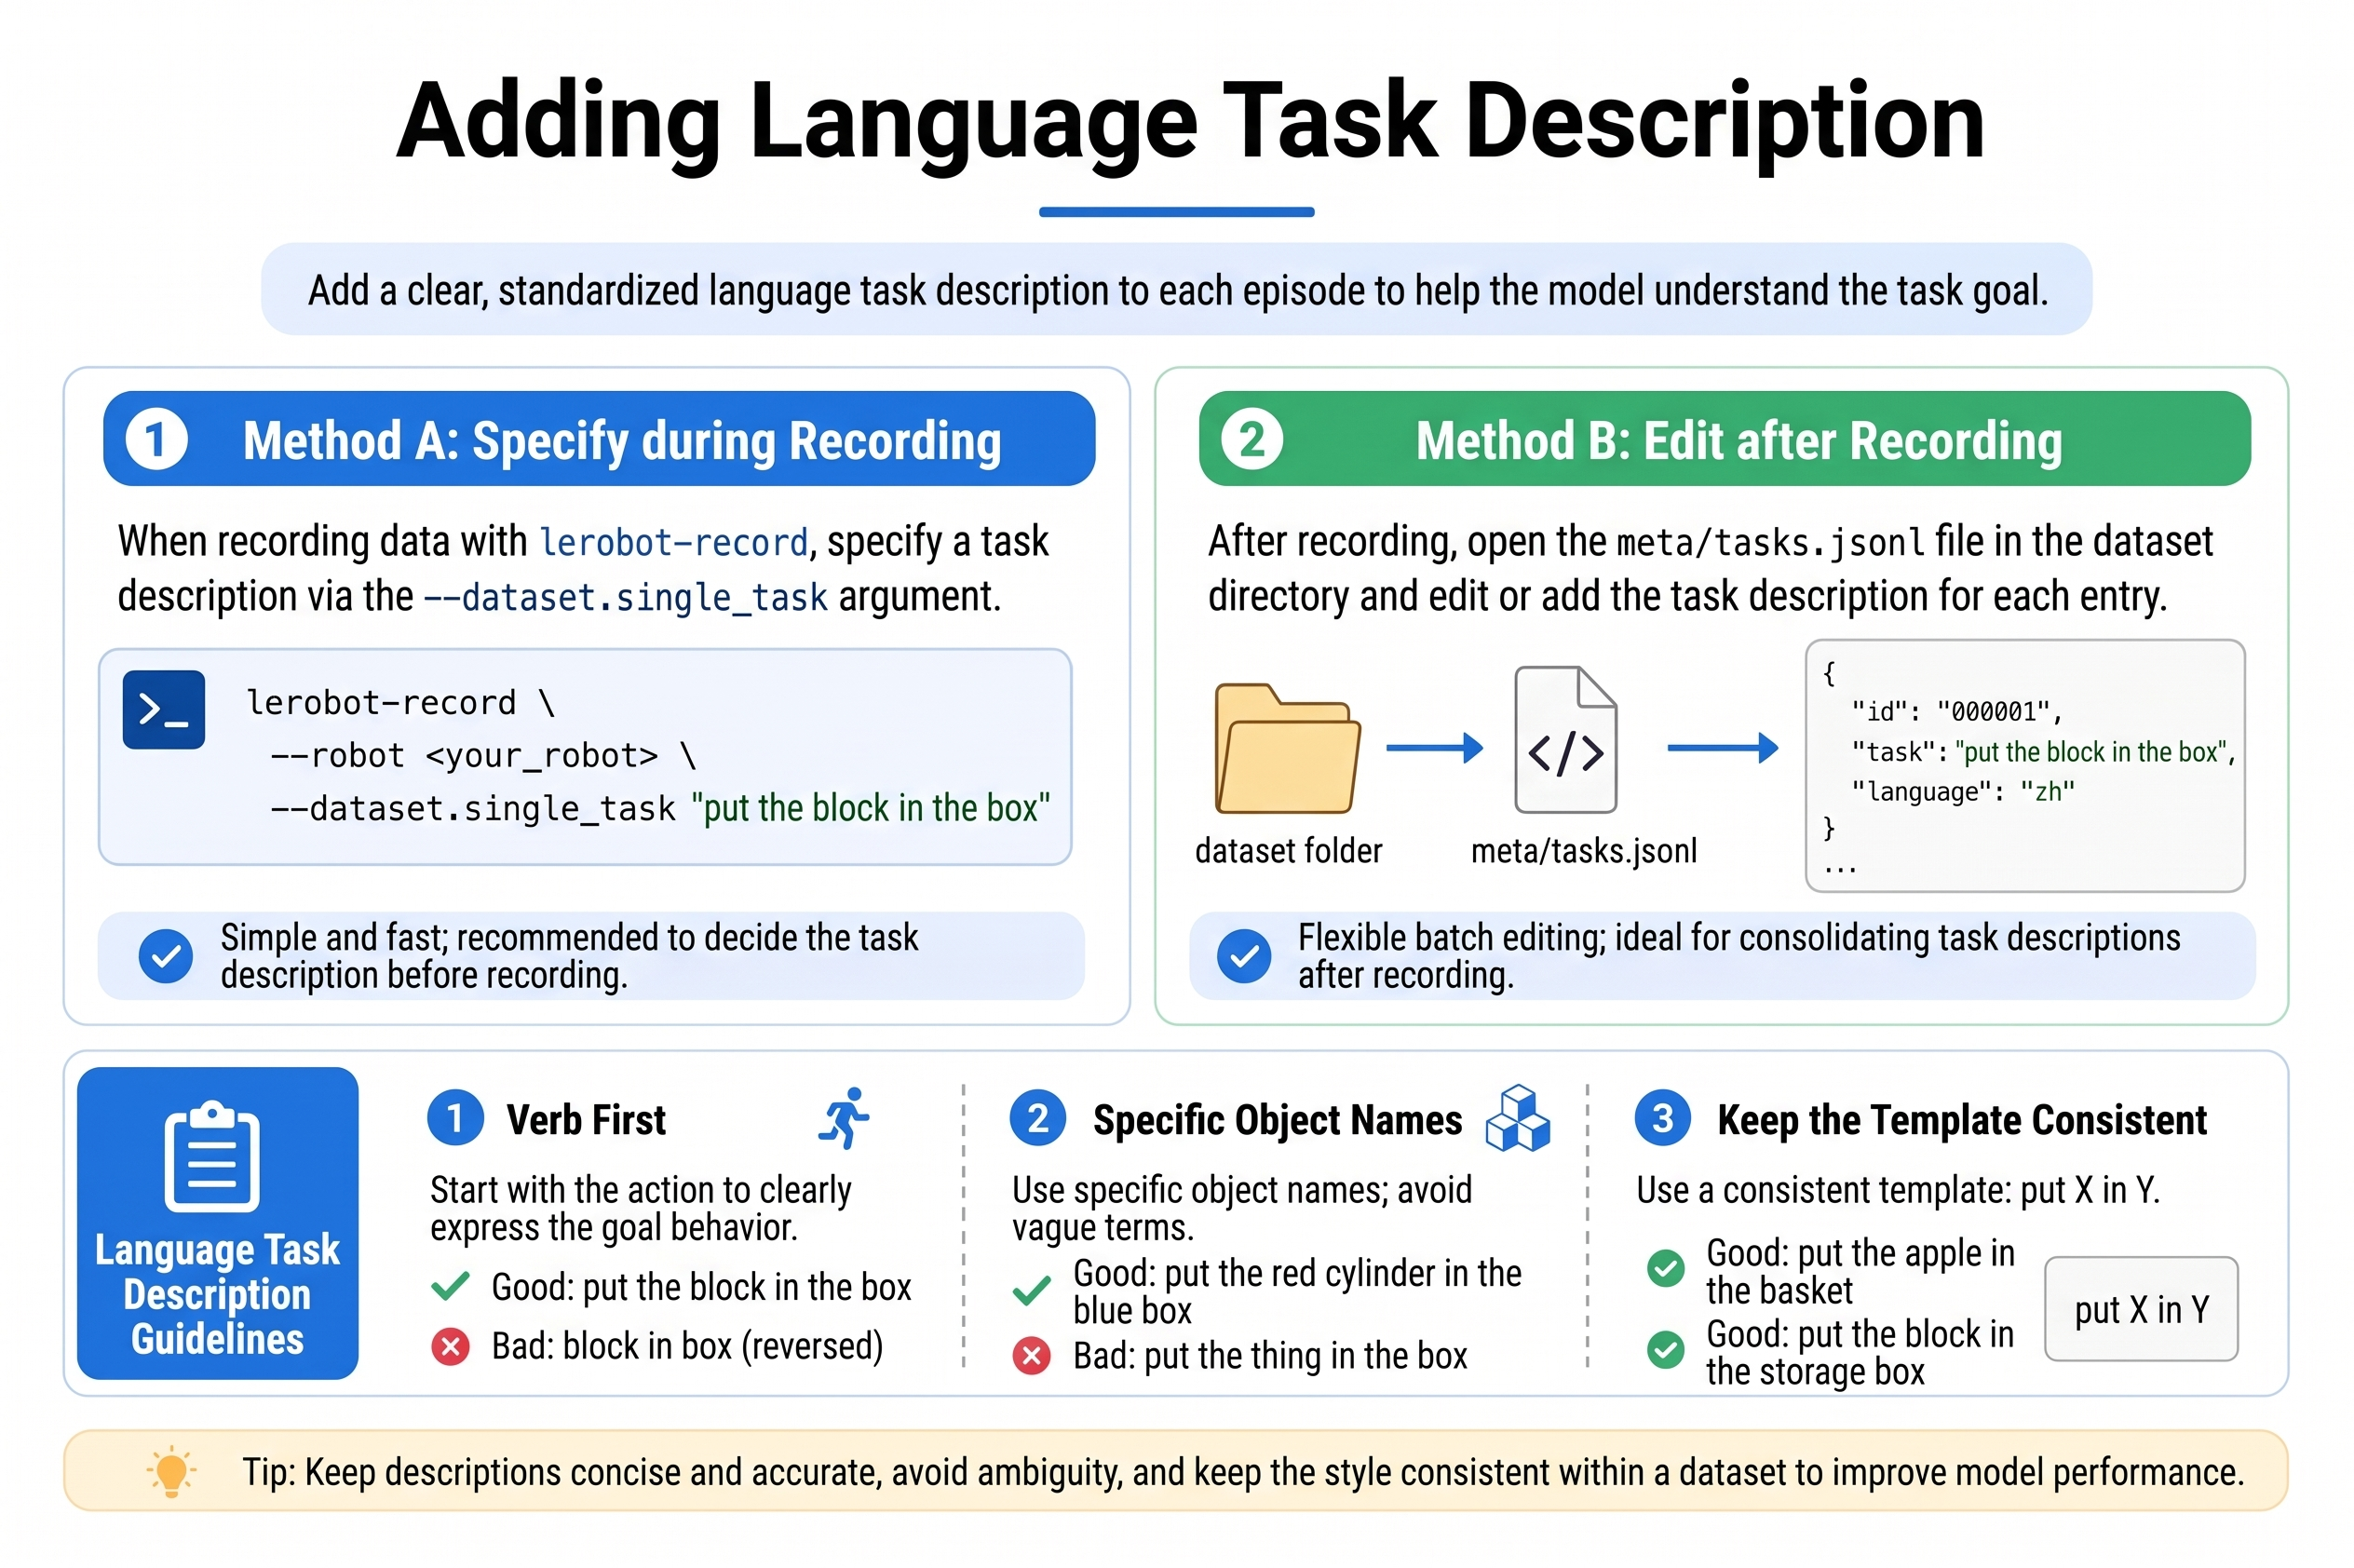
El entrenamiento VLA requiere condicionamiento por lenguaje. Hay dos formas:
Método A: Escribir directamente durante la grabación (recomendado)
Cada episodio se graba con --dataset.single_task. A continuación se usa B601-RS como ejemplo (Wiki); los usuarios de DM sustituyen type / port / can_adapter por seeed_b601_dm_follower, /dev/ttyACM0, damiao.
# RS: bring up CAN first
sudo ip link set can0 down 2>/dev/null
sudo ip link set can0 type can bitrate 1000000
sudo ip link set can0 up

lerobot-record \
  --robot.type=seeed_b601_rs_follower \
  --robot.port=can0 \
  --robot.id=follower1 \
  --robot.can_adapter=socketcan \
  --robot.cameras="{ front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30, fourcc: "MJPG"}, side: {type: opencv, index_or_path: 2, width: 640, height: 480, fps: 30, fourcc: "MJPG"}}" \
  --teleop.type=rebot_arm_102_leader \
  --teleop.port=/dev/ttyUSB0 \
  --teleop.id=rebot_arm_102_leader \
  --display_data=true \
  --dataset.repo_id=${HF_USER}/rebot_vla_pick_cube \
  --dataset.num_episodes=50 \
  --dataset.single_task="put the black cube on the blue tray" \
  --dataset.push_to_hub=false \
  --dataset.episode_time_s=30 \
  --dataset.reset_time_s=20
Método B: Rellenar a posteriori meta/tasks.jsonl
Si los datos ACT existentes carecen de lenguaje, edita meta/tasks.jsonl:
{"task_index": 0, "task": "put the black cube on the blue tray"}
{"task_index": 1, "task": "put the screwdriver into the toolbox"}
En un conjunto de datos multi‑tarea, distintos episodios se asocian a diferentes descripciones mediante el campo task_index. Todos los episodios de la misma tarea deben compartir el mismo task_index.
Directrices para la anotación en lenguaje natural
- Verbo al principio, describiendo la acción objetivo: «agarrar...», «colocar...», «empujar...».
- Sé específico con los nombres de los objetos: «cubo negro» es mejor que «objeto».
- Mantén los patrones de frase consistentes: para multi‑tarea, usa la misma plantilla, por ejemplo siempre «poner X sobre Y».
- Tanto chino como inglés funcionan, pero el idioma debe ser coherente entre entrenamiento e inferencia.
- Evita múltiples formulaciones para un mismo punto de datos (especialmente en las primeras fases de fine‑tuning).
20.4 Configuración de claves de estado y de acción
20.4 Configuración de claves de estado y de acción
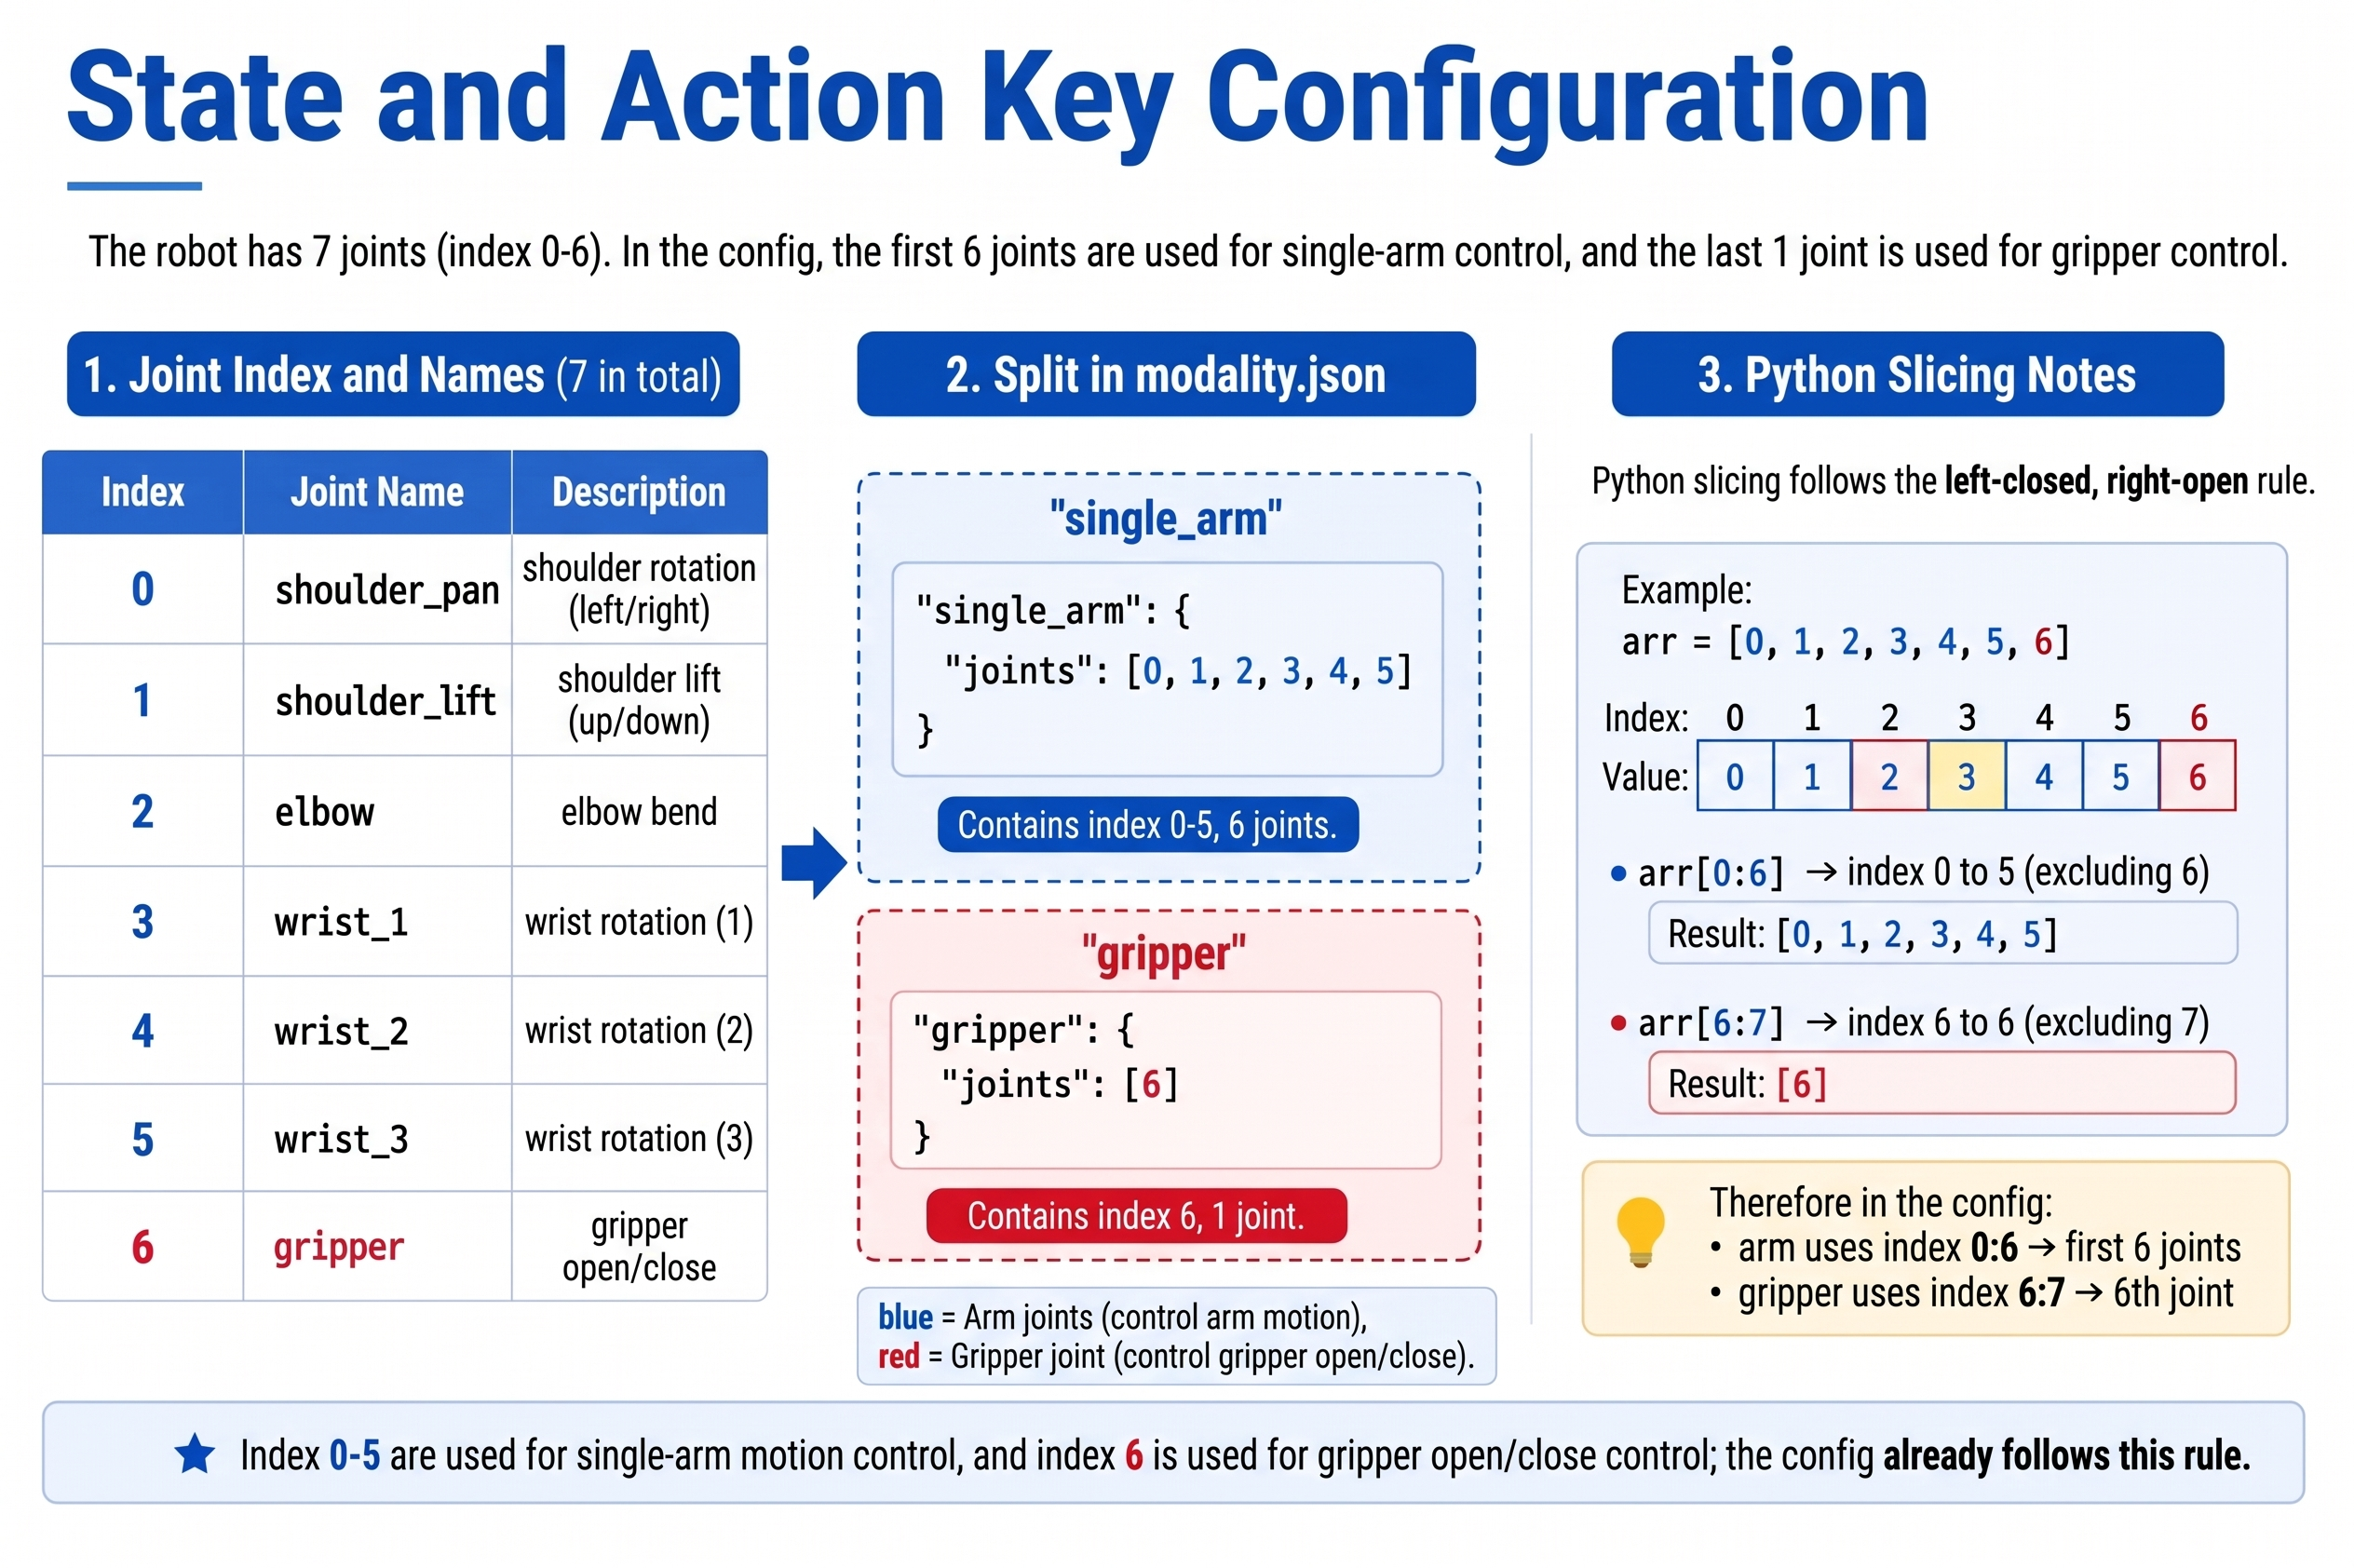
El vector de 7 dimensiones del reBot Arm B601-RS / B601-DM se concatena en el siguiente orden de articulaciones (coherente con el driver de LeRobot):
| Índice | Nombre de clave (semántica) | Significado |
|---|---|---|
| 0 | shoulder_pan | Rotación del hombro |
| 1 | shoulder_lift | Elevación del hombro |
| 2 | elbow_flex | Flexión del codo |
| 3 | wrist_flex | Flexión de la muñeca |
| 4 | wrist_yaw | Guiñada de la muñeca |
| 5 | wrist_roll | Giro de la muñeca |
| 6 | gripper | Apertura/cierre de la pinza |
En el modality.json de GR00T, las 7 dimensiones anteriores se dividen en dos claves semánticas:
single_arm: índices 0-5 (6 articulaciones)gripper: índice 6 (pinza)
El corte (slicing) en Python es semiabierto: "end": 6 significa hasta el índice 5, y "start": 6, "end": 7 significa el índice 6.
20.5 Configuración de claves de cámara
20.5 Configuración de claves de cámara
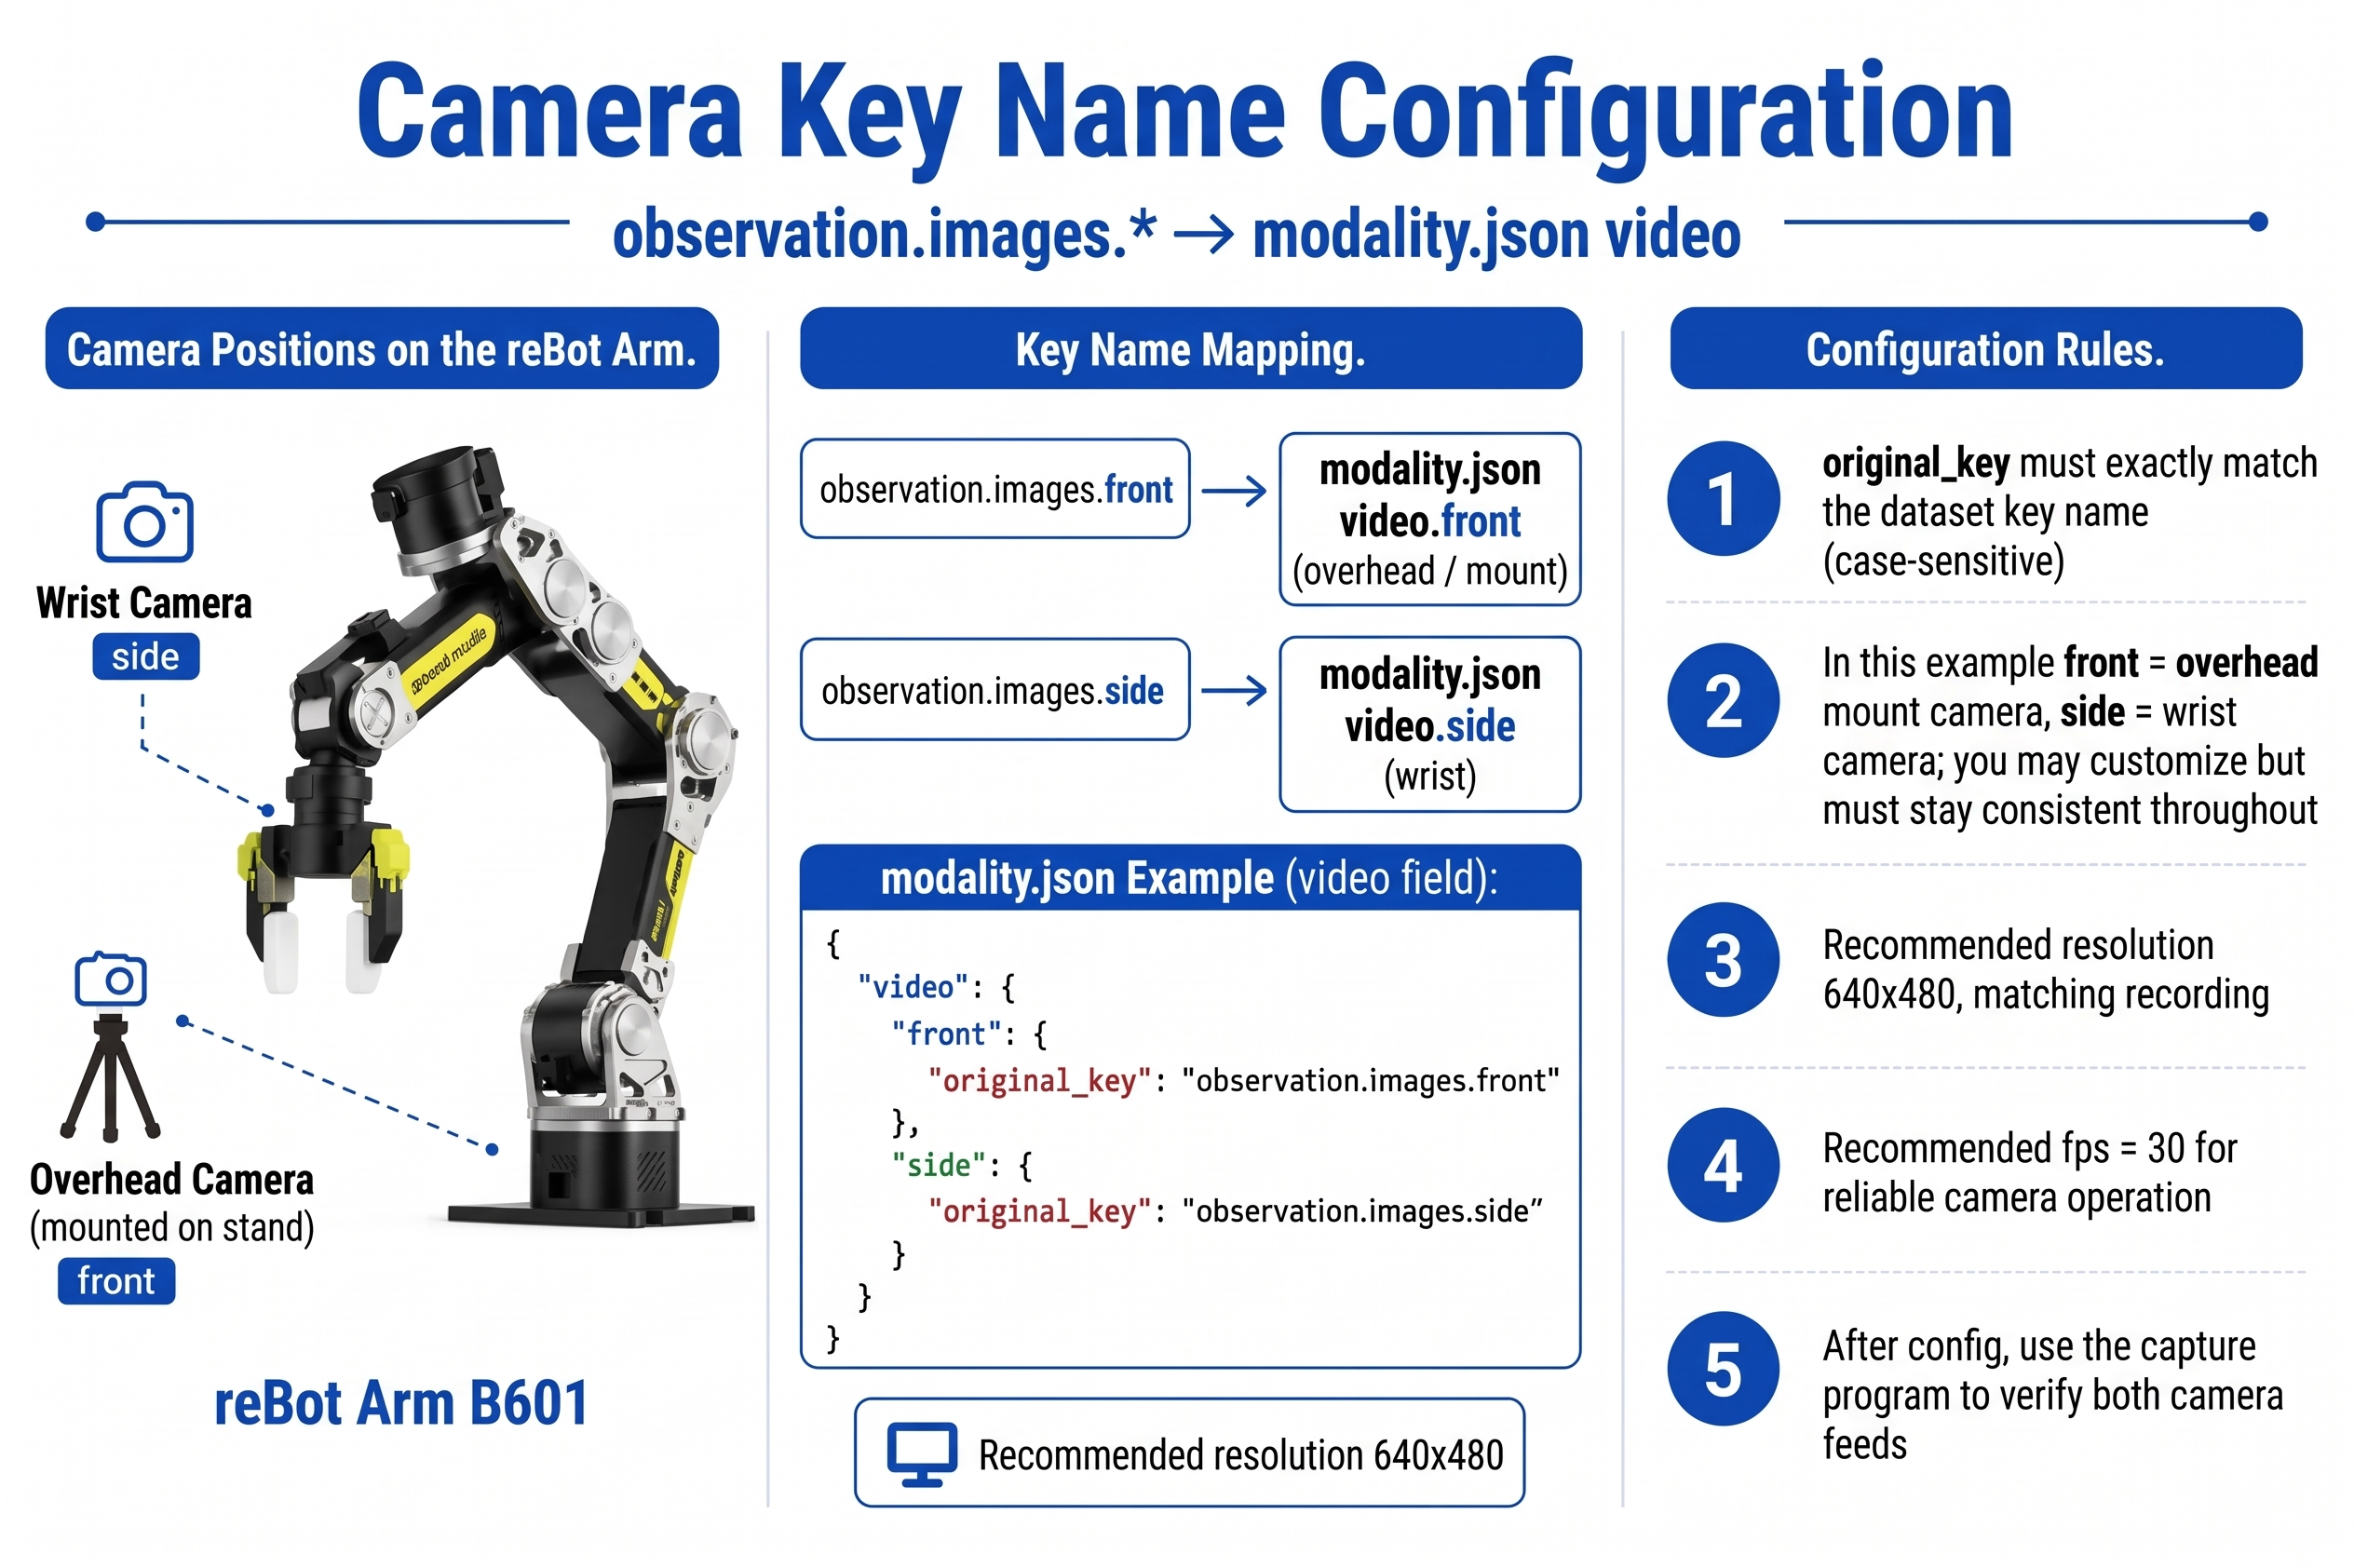
GR00T asigna las claves de cámara originales del conjunto de datos a nombres de clave estándar mediante el campo video de modality.json.
Disposiciones de cámara reBot habituales
Clave del conjunto de datos (original_key) | Clave estándar de modality | Uso recomendado |
|---|---|---|
observation.images.front | front | Vista amplia montada en el soporte |
observation.images.side | side | Primer plano de la muñeca |
Ejemplo: si las claves de cámara durante la grabación son front y side:
"video": {
  "front": {
    "original_key": "observation.images.front"
  },
  "side": {
    "original_key": "observation.images.side"
  }
}
Principios clave:
original_keydebe coincidir exactamente con la clave real en el conjunto de datos.- Las claves estándar en el lado izquierdo de la modalidad (
front,side) se usarán de forma uniforme durante el entrenamiento y la inferencia. - Se puede entrenar con una sola cámara, pero dos cámaras suelen funcionar mejor.
- La resolución recomendada es uniformemente 640x480, consistente con los parámetros de grabación.
Encuentra el índice de la cámara local:
lerobot-find-cameras opencv
20.6 Creación de meta/modality.json
20.6 Creación de meta/modality.json
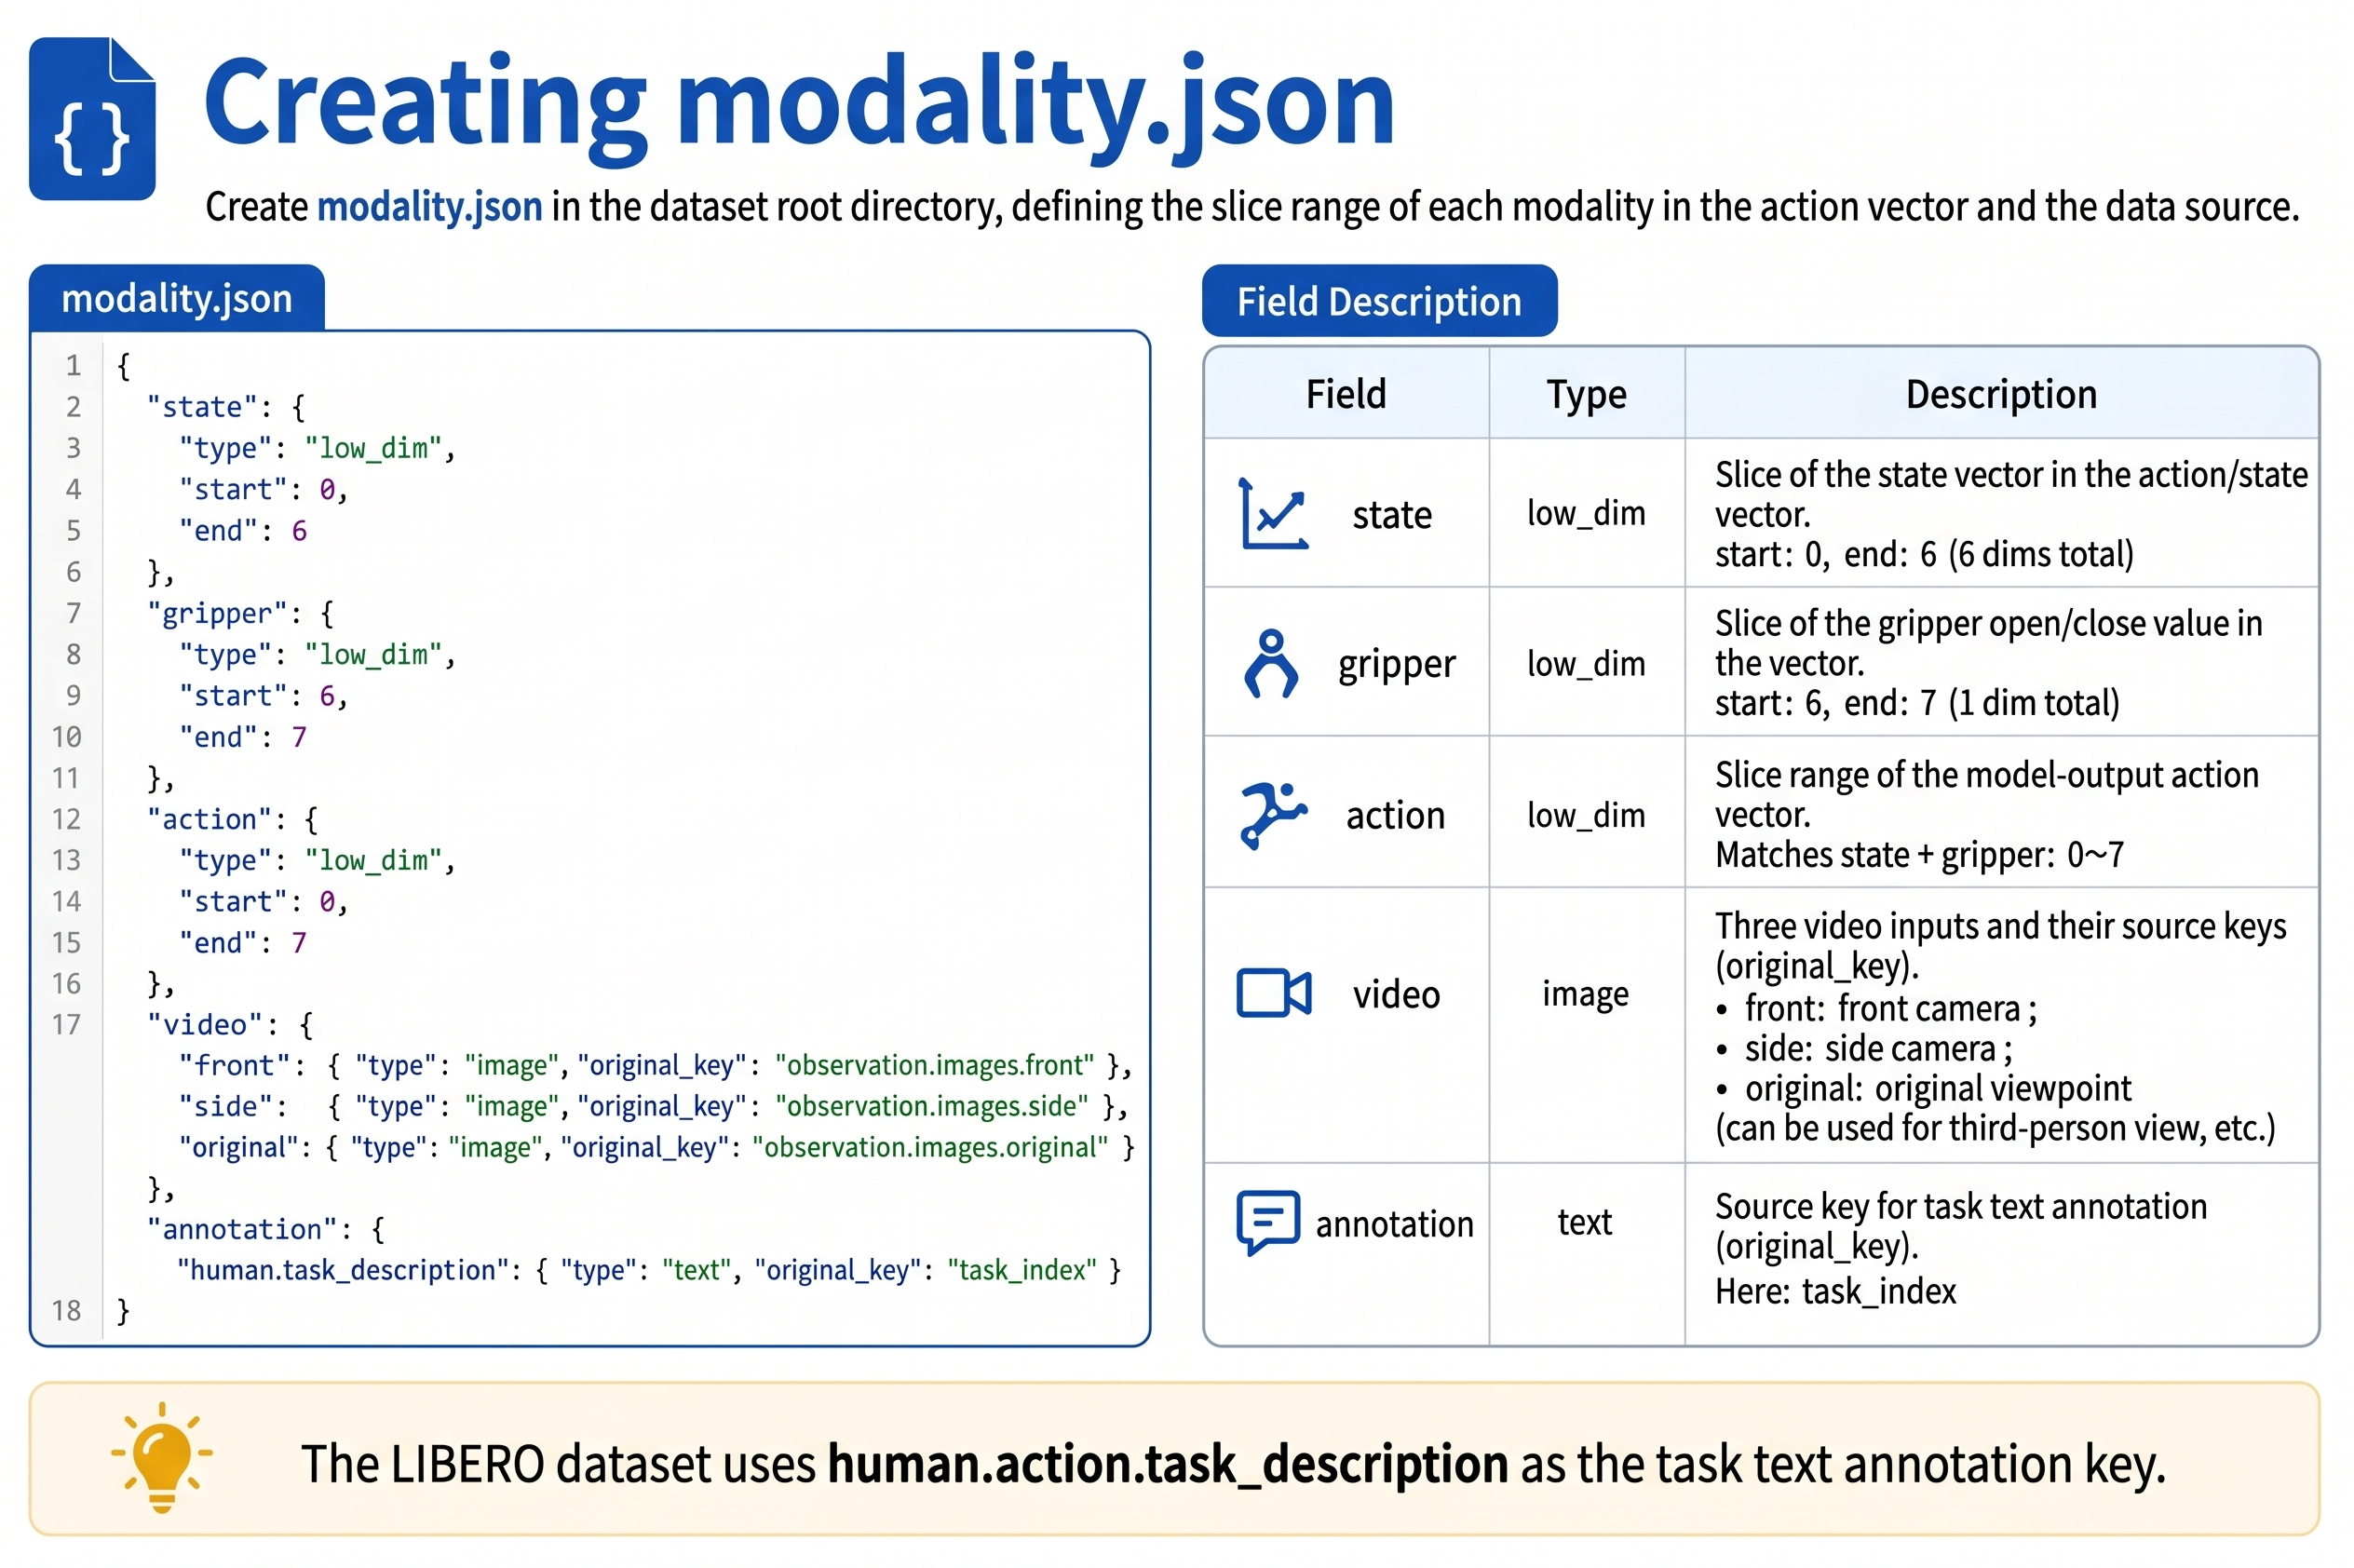
Crea modality.json en el directorio meta/ del conjunto de datos. A continuación se muestra el ejemplo completo para el espacio articular de 7 dimensiones de un solo brazo reBot Arm B601 (idéntico para RS / DM):
{
  "state": {
    "single_arm": {
      "start": 0,
      "end": 6
    },
    "gripper": {
      "start": 6,
      "end": 7
    }
  },
  "action": {
    "single_arm": {
      "start": 0,
      "end": 6
    },
    "gripper": {
      "start": 6,
      "end": 7
    }
  },
  "video": {
    "front": {
      "original_key": "observation.images.front"
    },
    "side": {
      "original_key": "observation.images.side"
    }
  },
  "annotation": {
    "human.task_description": {
      "original_key": "task_index"
    }
  }
}
Descripción de campos
| Campo | Propósito |
|---|---|
state / action | Definir el rango de índice de cada segmento en el vector concatenado |
video | Mapear las claves de vídeo de LeRobot a los nombres estándar de cámara de GR00T |
annotation | Asociar task_index con tasks.jsonl. reBot usa human.task_description; LIBERO / SimplerEnv usan human.action.task_description |
Si el conjunto de datos solo tiene una tarea y no tiene el campo task_index, primero asegúrate de que lerobot-record haya escrito tasks.jsonl, de lo contrario GR00T no puede leer la condición de lenguaje.
20.7 Configuración de la etiqueta de embodiment
20.7 Configuración de la etiqueta de embodiment
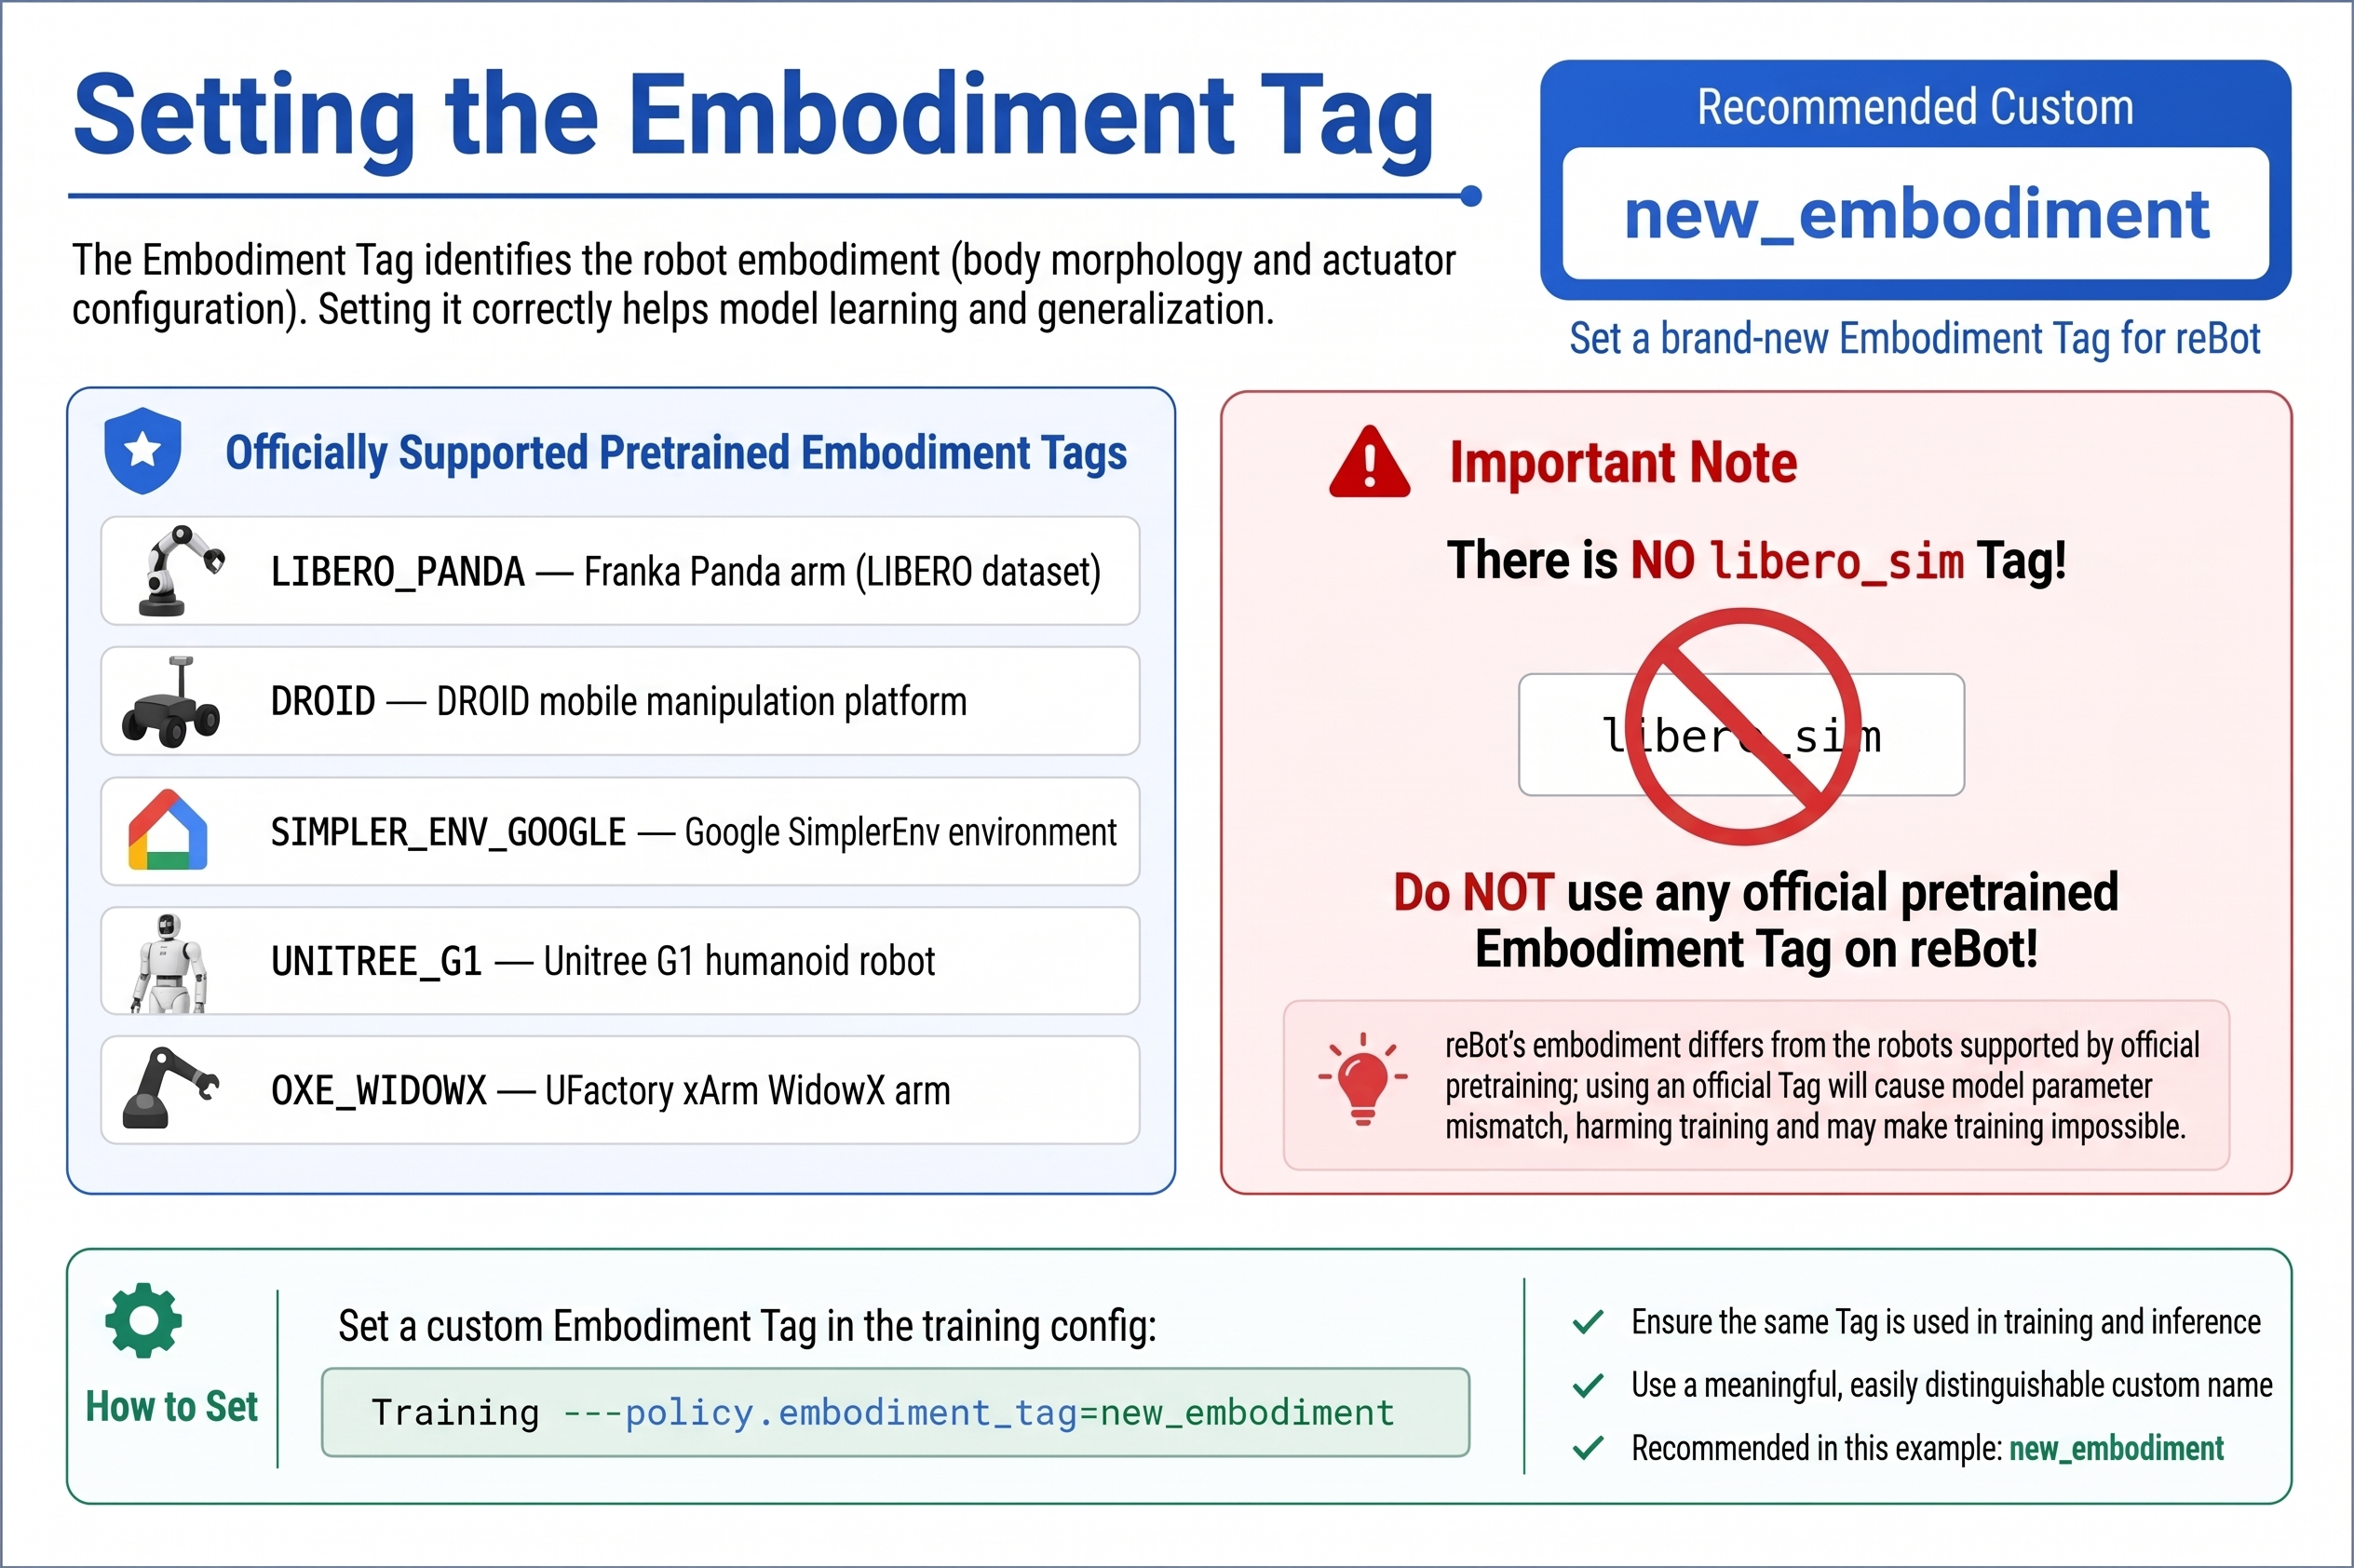
Para robots personalizados como el reBot Arm, usa la misma configuración tanto para entrenamiento como para inferencia:
embodiment_tag = new_embodiment
Significado:
- Indica a GR00T que use la capa de proyección new-embodiment, sin reutilizar las dimensiones de estado/acción preentrenadas del humanoide.
- Parámetro de entrenamiento de LeRobot:
--policy.embodiment_tag=new_embodiment. - El checkpoint ajustado guarda la configuración de modalidad correspondiente, que se carga automáticamente en tiempo de inferencia.
No uses etiquetas de preentrenamiento como LIBERO_PANDA, DROID, SIMPLER_ENV_GOOGLE en datos de reBot: sus dimensiones y semántica de estado/acción no coinciden con reBot. Tampoco existe una etiqueta oficial llamada libero_sim.
20.8 Comprobación del orden de las articulaciones y dimensiones de datos
20.8 Comprobación del orden de las articulaciones y dimensiones de datos
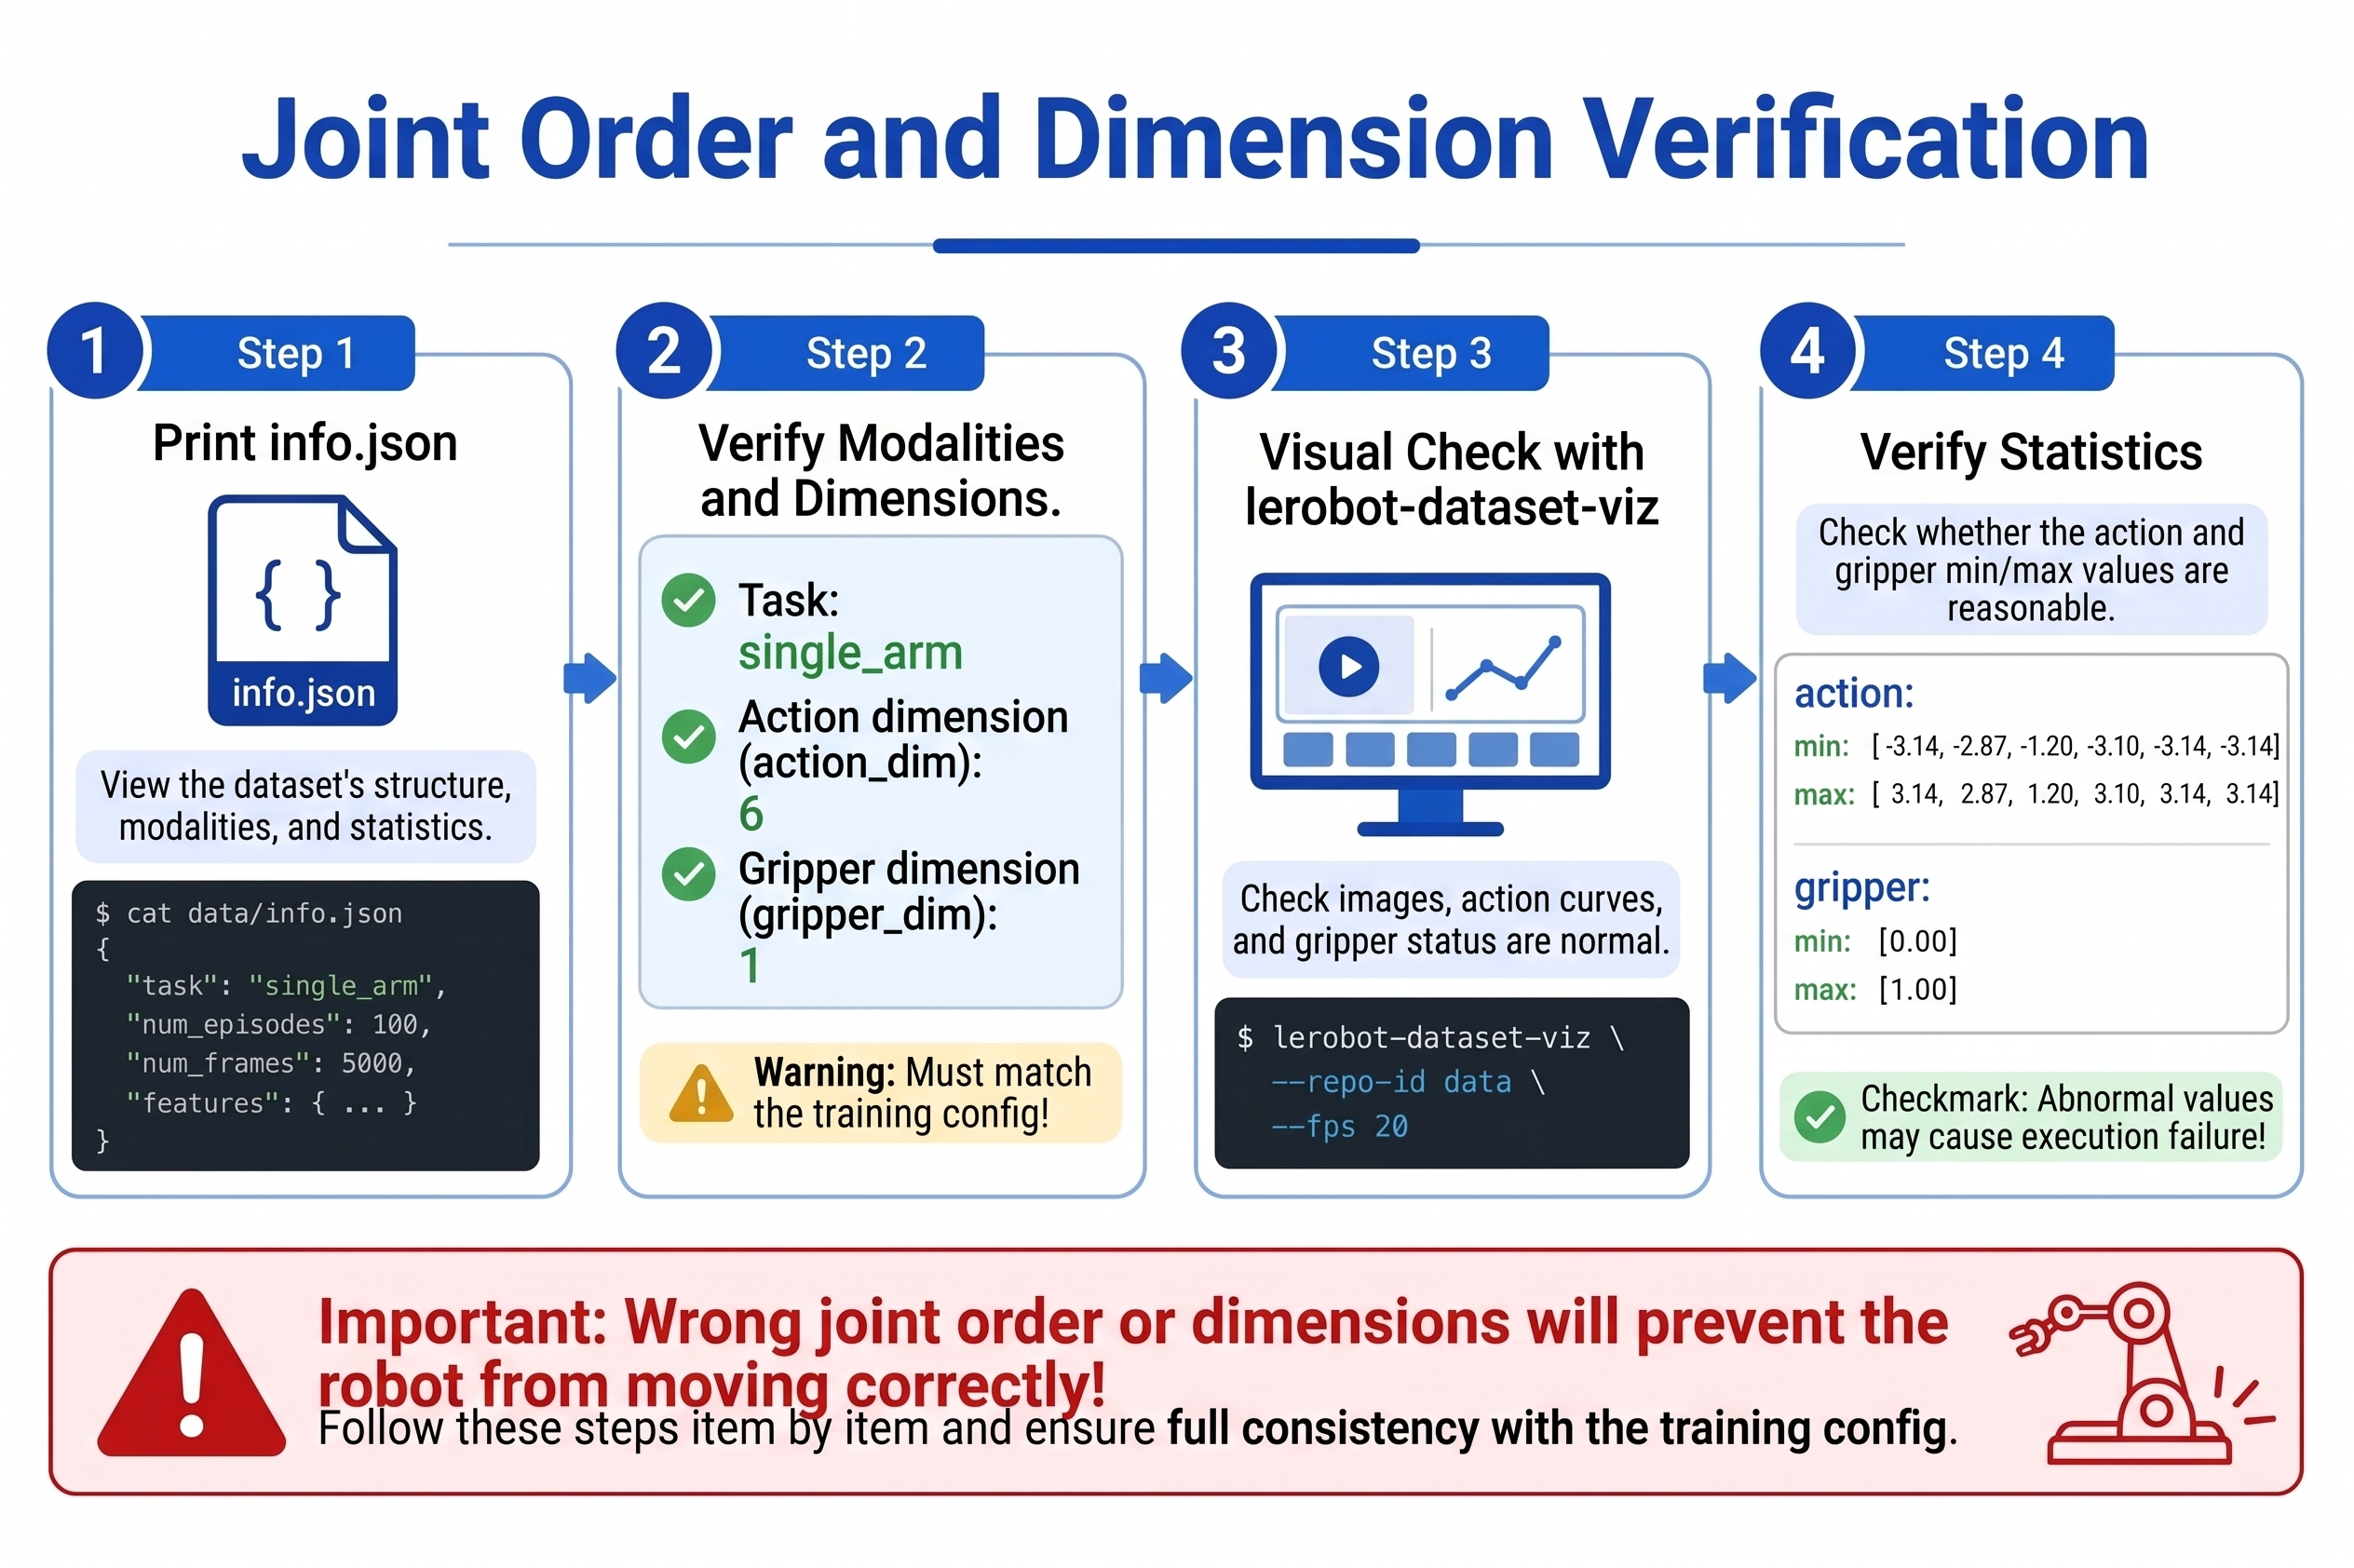
Esta es la causa más común de que "la pérdida de entrenamiento disminuye pero el robot real no se mueve en absoluto". Verifica punto por punto:
Paso 1: Imprimir meta del conjunto de datos
import json
from pathlib import Path

meta_dir = Path.home() / ".cache/huggingface/lerobot/seeed_rebot_b601_rs/pick_cube/meta"
print(json.dumps(json.loads((meta_dir / "info.json").read_text()), indent=2))
print((meta_dir / "modality.json").read_text())
Paso 2: Verificar el corte de modalidades
import numpy as np
from lerobot.datasets.lerobot_dataset import LeRobotDataset

ds = LeRobotDataset("seeed_rebot_b601_rs/pick_cube")
s = ds[0]["observation.state"].numpy()
mod = json.loads((meta_dir / "modality.json").read_text())

arm = s[mod["state"]["single_arm"]["start"]:mod["state"]["single_arm"]["end"]]
grip = s[mod["state"]["gripper"]["start"]:mod["state"]["gripper"]["end"]]
print("single_arm:", arm.shape)  # expect (6,)
print("gripper:", grip.shape)    # expect (1,)
Paso 3: Visualizar los datos
lerobot-dataset-viz --repo_id=seeed_rebot_b601_rs/pick_cube --episode-index=0
Observa:
- ¿Las imágenes están sincronizadas con el movimiento de las articulaciones?
- ¿La dimensión
grippercambia cuando el gripper se abre/cierra? - ¿La descripción en lenguaje coincide con el contenido visual?
Paso 4: Comprobaciones estadísticas
print(ds.meta.stats["observation.state"])
print(ds.meta.stats["action"])
Si alguna dimensión tiene min == max (sin variación), esa articulación no se movió en los datos; considera excluirla del entrenamiento o volver a recolectar.
20.9 Organización de conjuntos de datos multi-tarea
20.9 Organización de conjuntos de datos multi-tarea
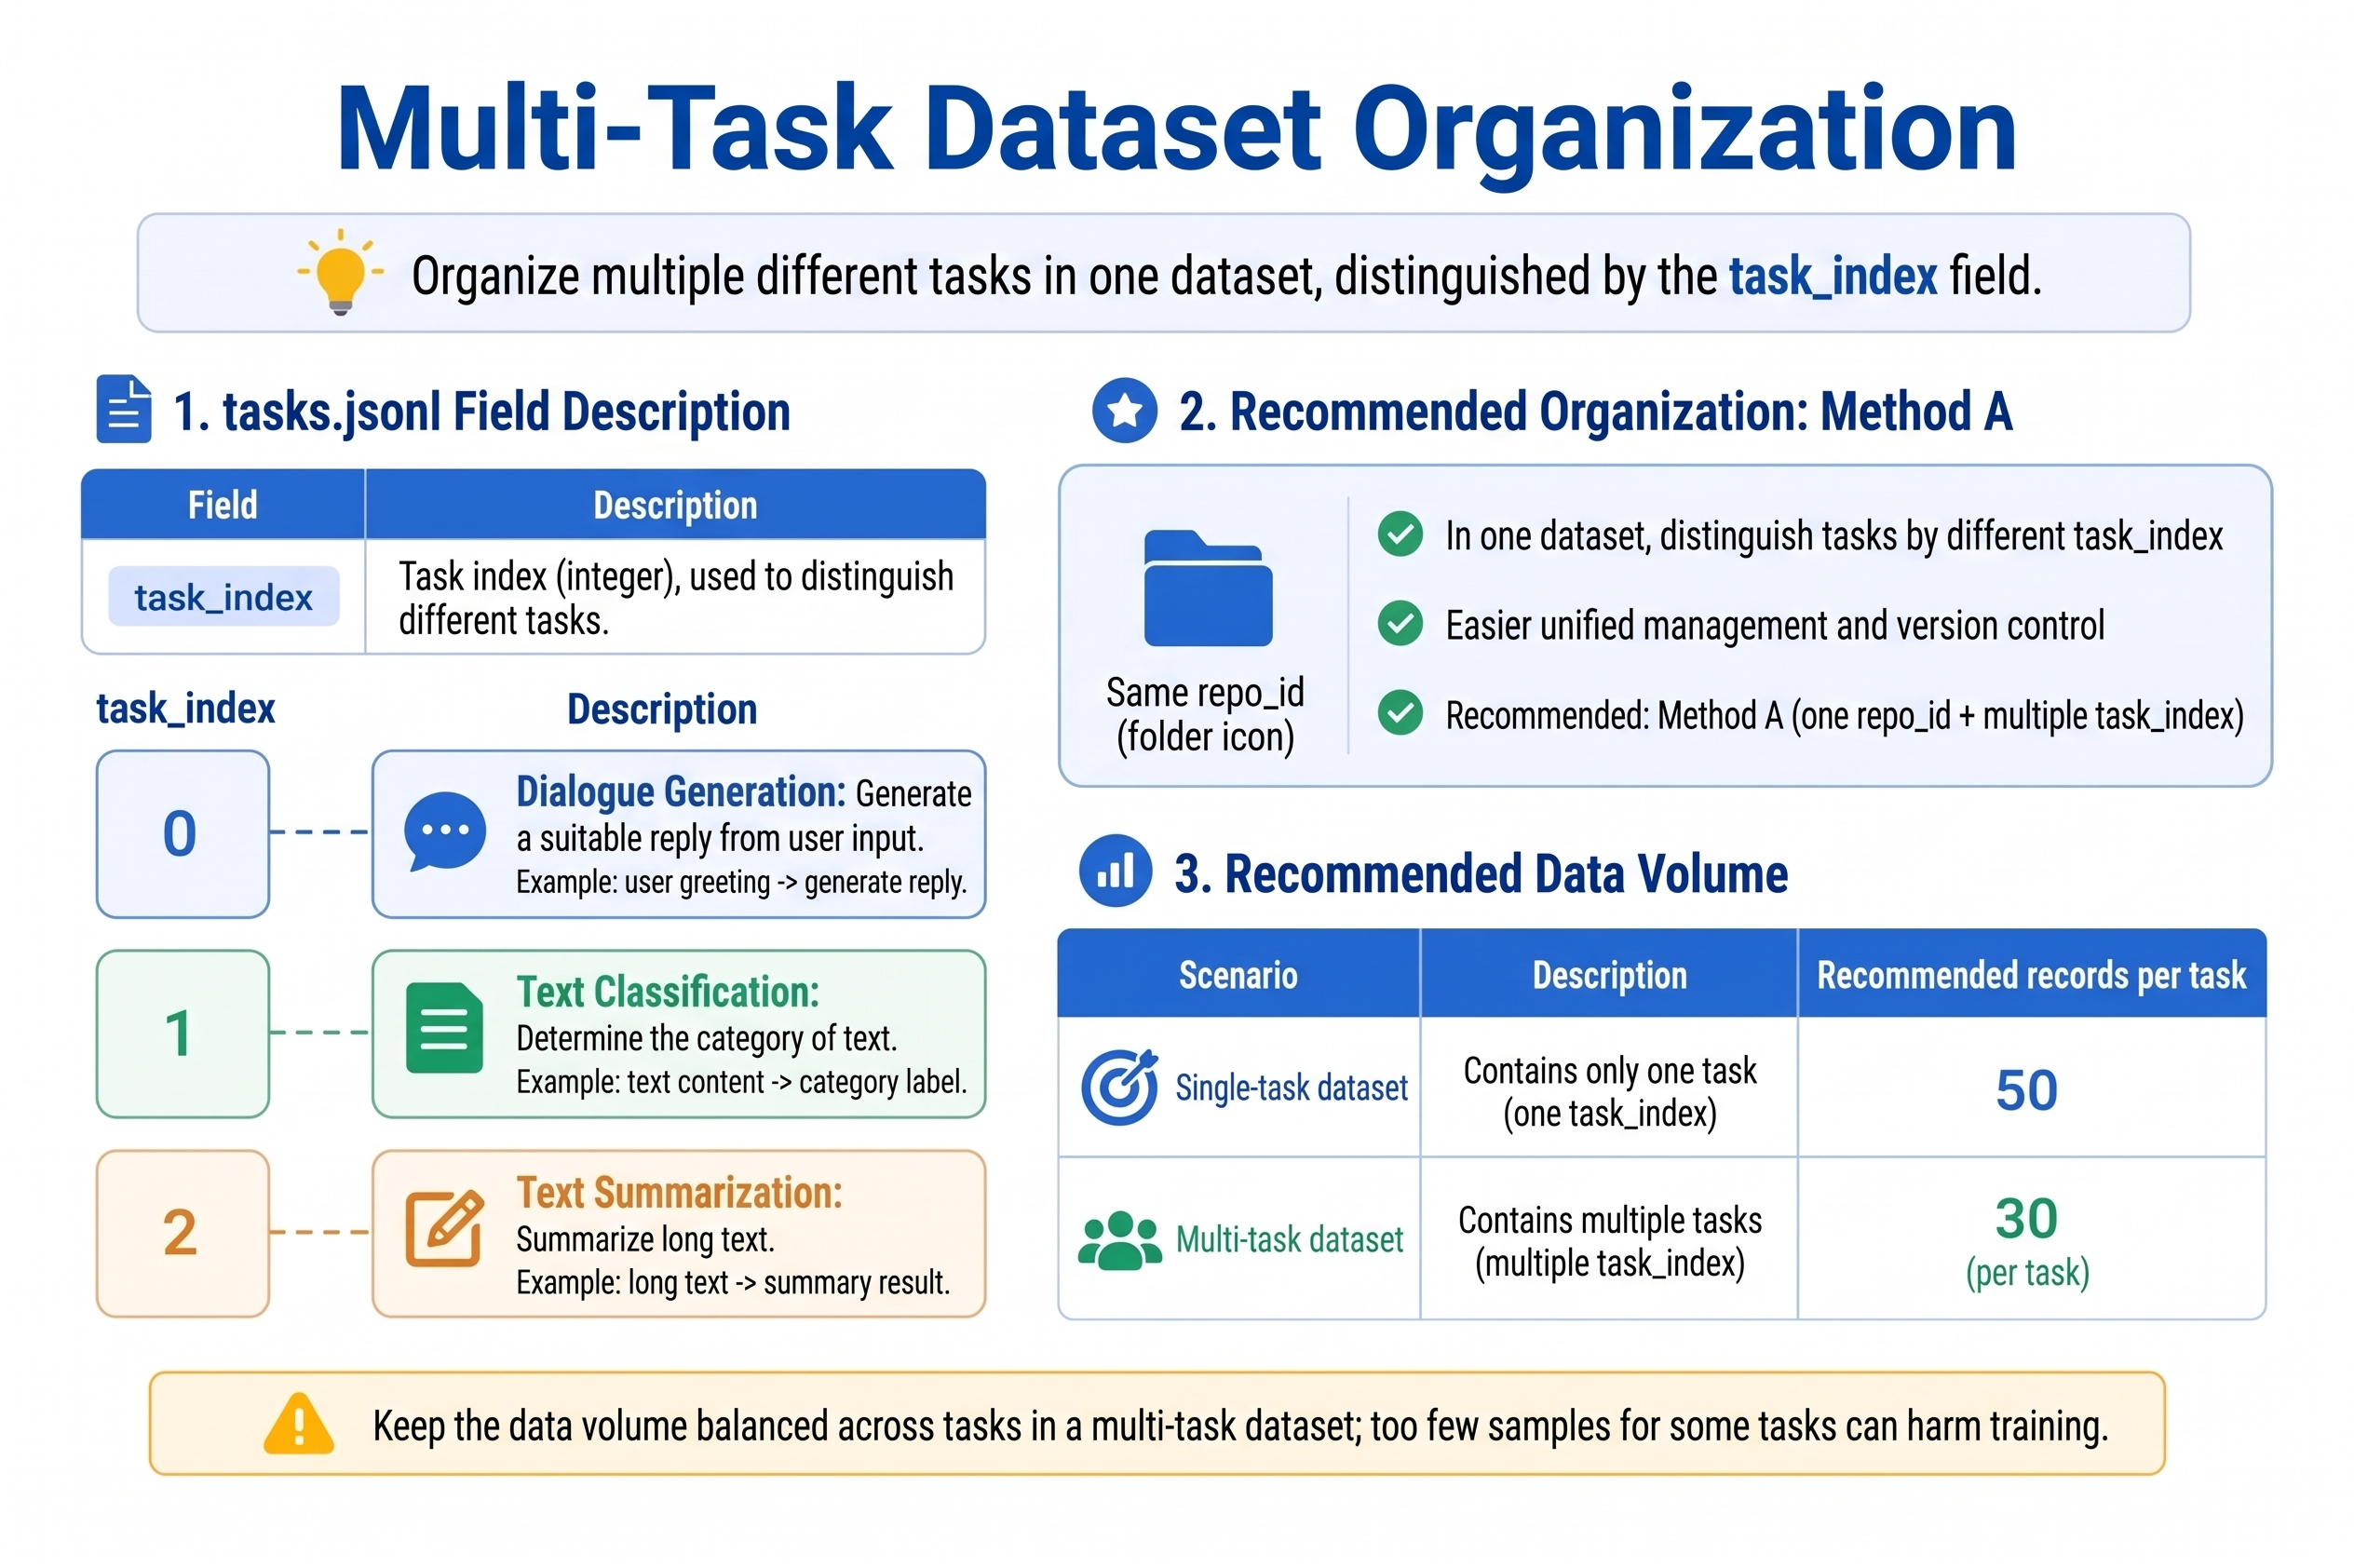
Para entrenar "un modelo, múltiples tareas de lenguaje", se recomiendan dos enfoques:
Método A: Mismo repo_id, múltiples task_index (recomendado)
{"task_index": 0, "task": "put the black cube on the blue tray"}
{"task_index": 1, "task": "put the screwdriver into the toolbox"}
{"task_index": 2, "task": "push the red cup to the left side of the table"}
Cicla a través de --dataset.single_task mientras grabas, o graba por lotes y fusiona en el mismo conjunto de datos.
Método B: Fusión de múltiples conjuntos de datos
LeRobot admite entrenamiento con múltiples conjuntos de datos (dependiendo de la versión); el enfoque más simple es usar un solo repo_id durante la grabación y distinguir tareas mediante task_index.
Recomendaciones de volumen de datos
| Escenario | Recomendación |
|---|---|
| Inicio de una sola tarea | 50 episodios |
| Una sola tarea estable | 100-200 episodios |
| Multi-tarea (3 tareas) | ≥ 30 episodios cada una |
| Generalización de posición | ≥ 10 episodios por variante de posición |
20.10 Lista de comprobación de calidad de datos
20.10 Lista de comprobación de calidad de datos
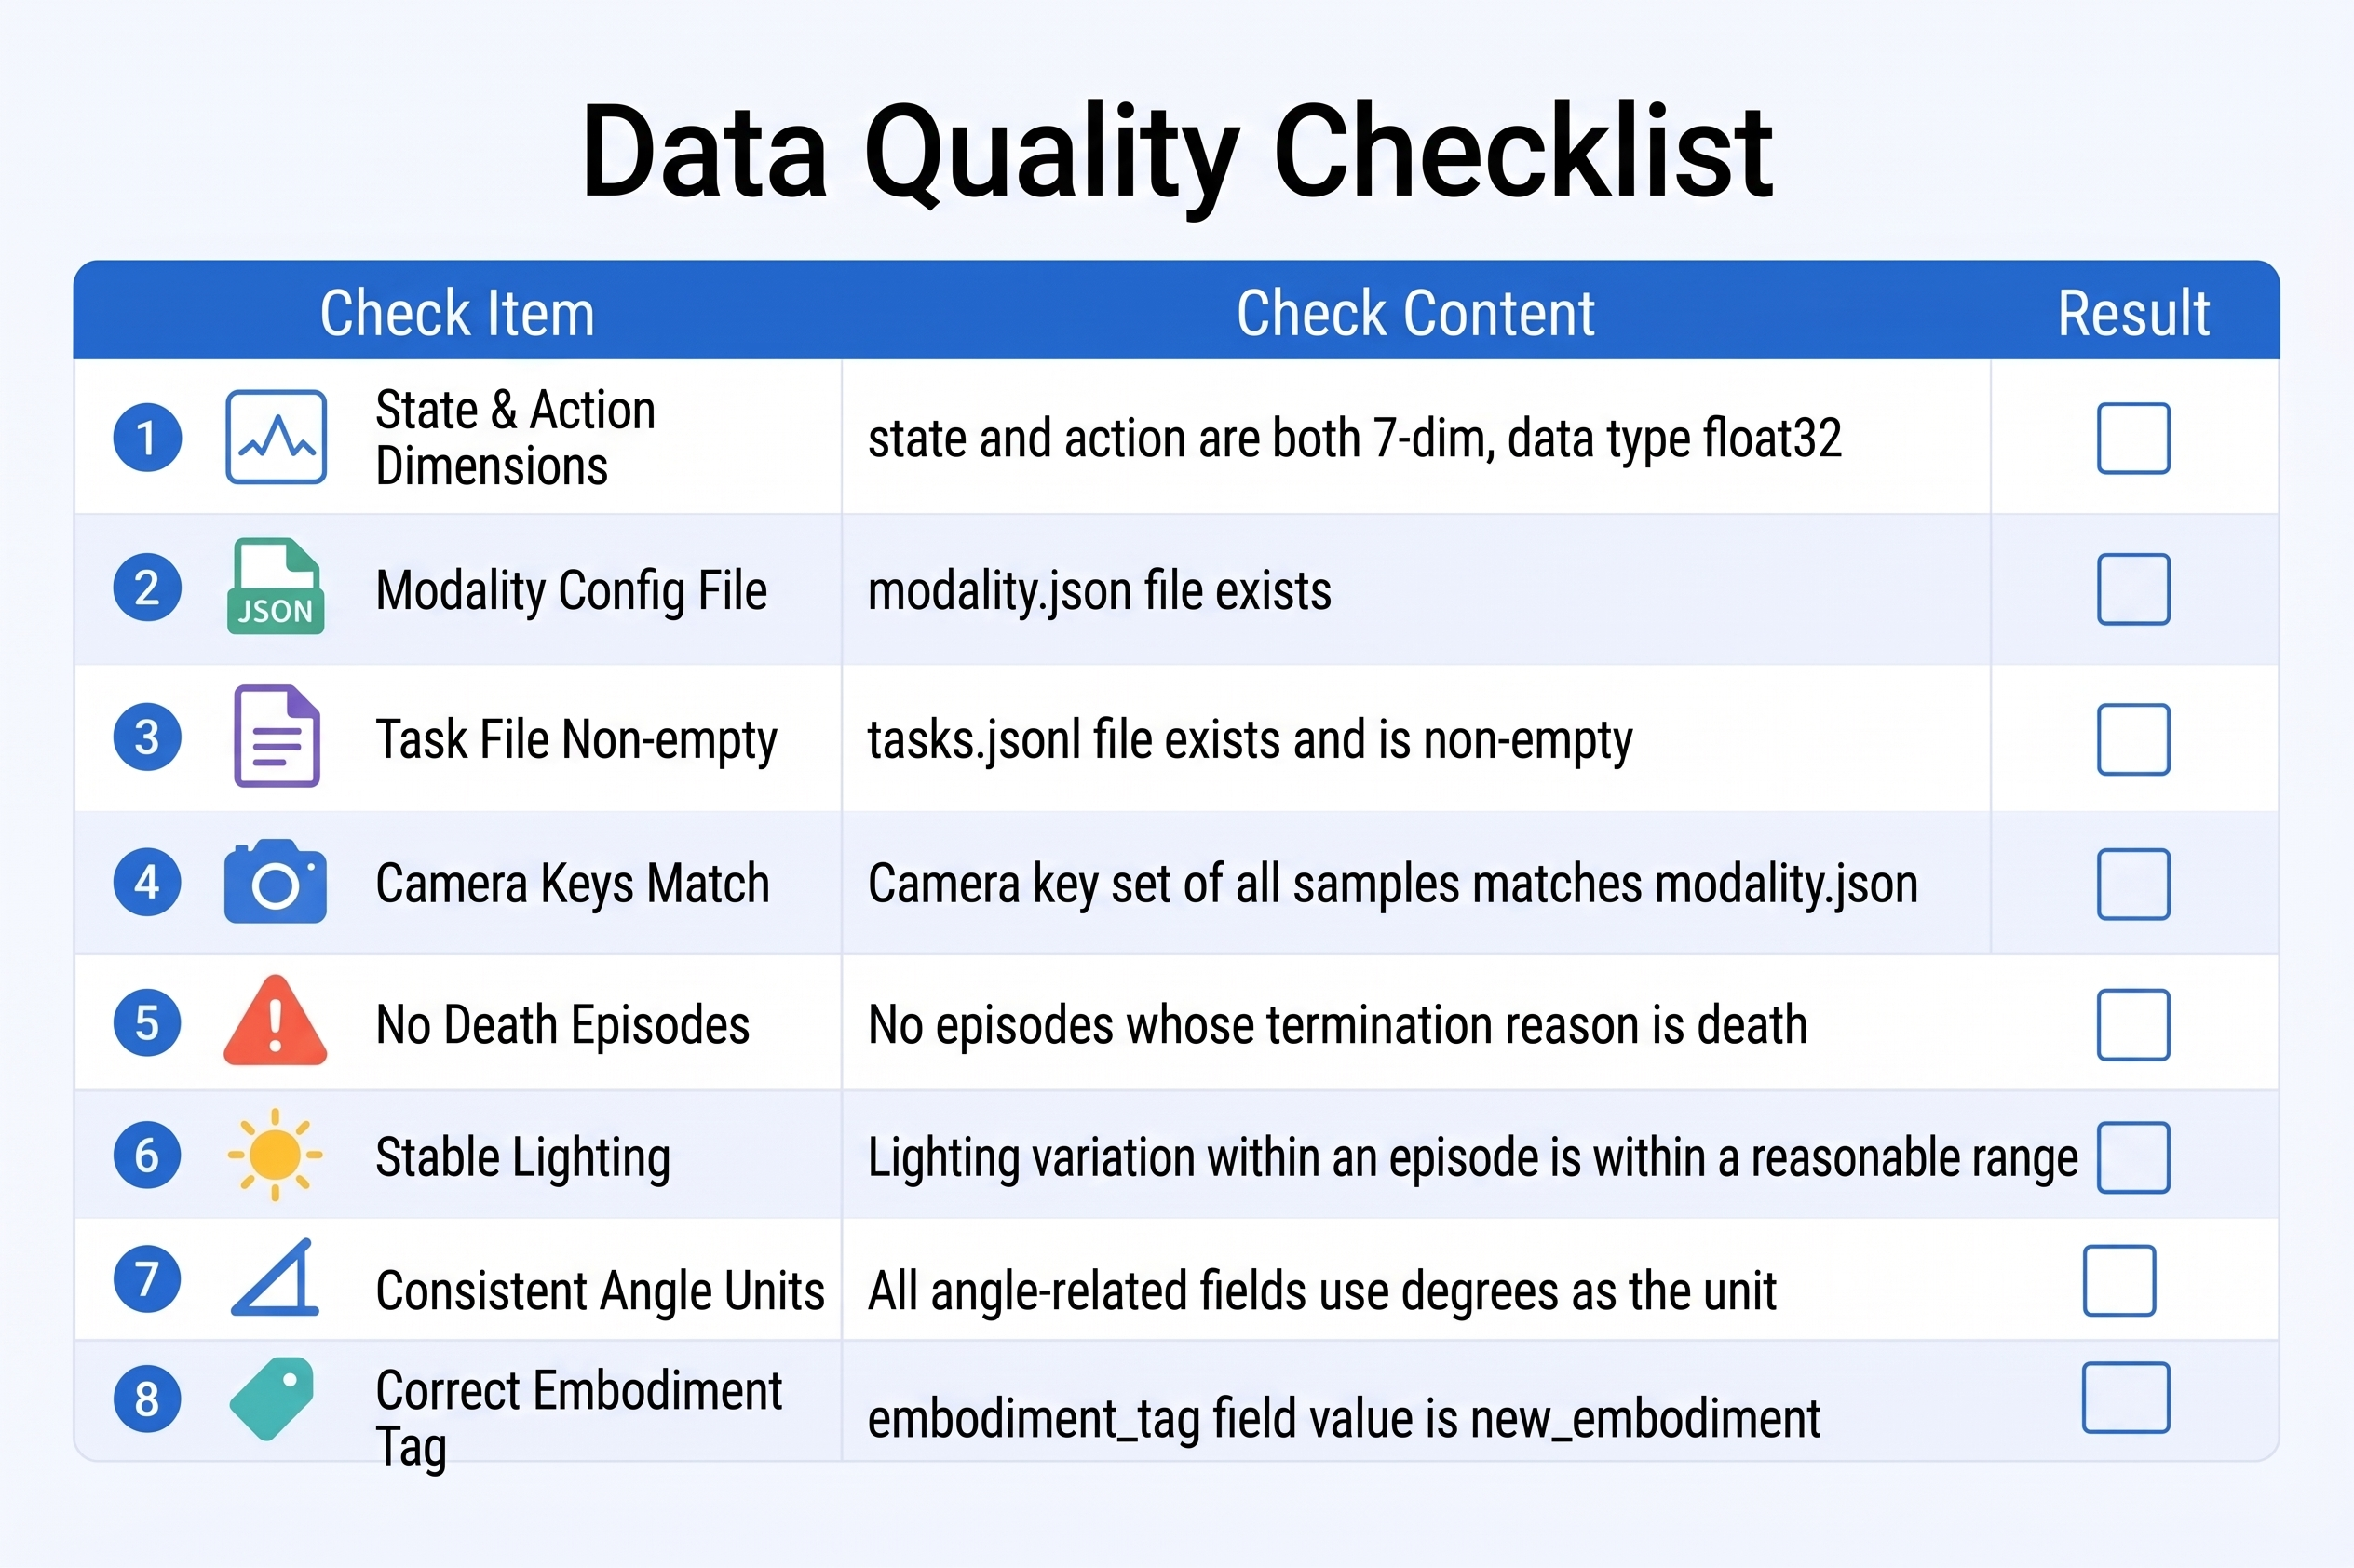
Antes de subir al Hub o iniciar el entrenamiento, confirma:
-
observation.stateyactionson ambos float32 de 7 dimensiones -
meta/modality.jsonexiste y el corte de índices es correcto - Cada
task_indexenmeta/tasks.jsonltiene una descripción no vacía - Los nombres de las claves de cámara coinciden entre
modality.jsony el conjunto de datos - No hay episodios de desperdicio totalmente en cero / inactivos
- Cámaras fijas, objetos en vista, iluminación estable
- Unidades de ángulo unificadas (la API de motor de bajo nivel de reBot usa grados; el driver de LeRobot convierte internamente a radianes; el conjunto de datos y el entrenamiento/inferencia deben mantenerse consistentes)
- Plan para usar
new_embodimentparaembodiment_tag
Subir a Hugging Face Hub (opcional)
huggingface-cli login
lerobot-record ... --dataset.push_to_hub=true
# or upload manually
huggingface-cli upload ${HF_USER}/rebot_vla_pick_cube ~/.cache/huggingface/lerobot/seeed_rebot_b601_rs/pick_cube
20.11 Resumen del capítulo
20.11 Resumen del capítulo
- GR00T necesita datos estándar de LeRobot +
meta/modality.json. - El vector de 7 dimensiones de reBot se divide en
single_arm(6) +gripper(1); RS / DM tienen las mismas dimensiones, solo difieren los parámetros del driver. - El lenguaje se conecta mediante
tasks.jsonl+annotation.human.task_description. - Los nombres de las claves de cámara deben alinearse entre grabación, modalidad e inferencia.
- El siguiente capítulo usa los datos preparados para iniciar
lerobot-train --policy.type=groot.