22. Inferencia de GR00T y Despliegue en Robots Reales
Capítulo 22 del Curso de Introducción a la IA Física de Seeed — el bucle de extremo a extremo, el desacoplamiento entre inferencia y control, máquina única vs distribuido, entradas de cámara/estado/lenguaje, salida de fragmentos de acción, latencia, almacenamiento en búfer de acciones y RTC, límites de seguridad, evaluación y el proyecto de etapa.
El Capítulo 21 cubrió el fine-tuning y los comandos básicos para robots reales; este capítulo se centra en el despliegue de inferencia: cómo se desacoplan el lado de inferencia y el lado de control, cómo elegir entre máquina única y distribuido, cómo se alinean las entradas/salidas, y la latencia, el almacenamiento asíncrono en búfer, los límites de seguridad y la evaluación de tareas. Finalmente, el proyecto de etapa "colocar el tubo de ensayo en el estante izquierdo" recorre toda la canalización.
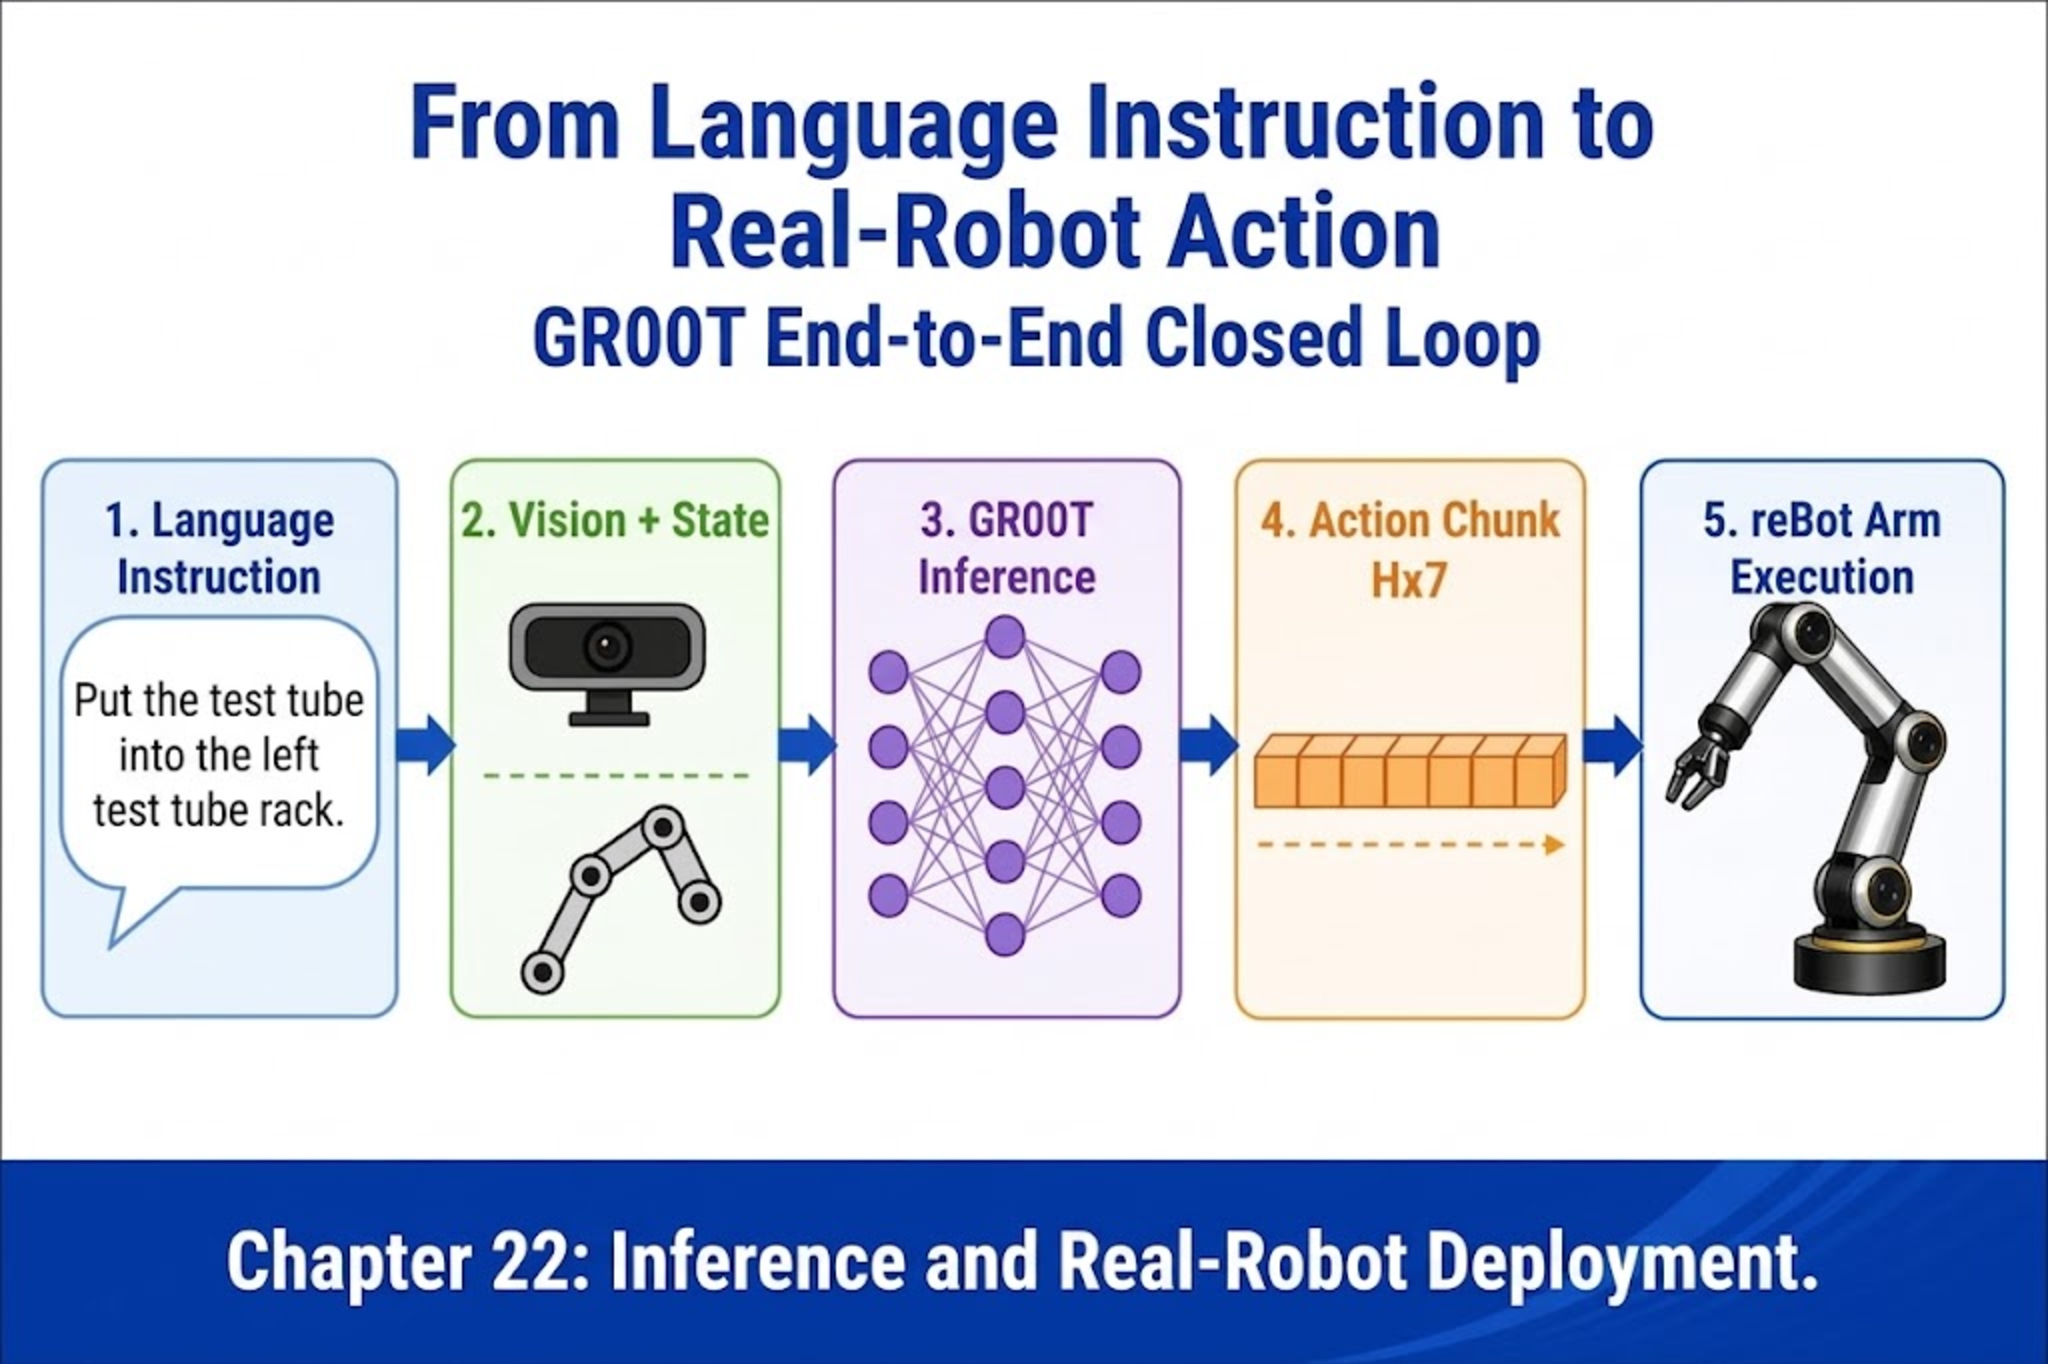
22.1 ¿Cómo es el Bucle de Extremo a Extremo?
22.1 ¿Cómo es el Bucle de Extremo a Extremo?
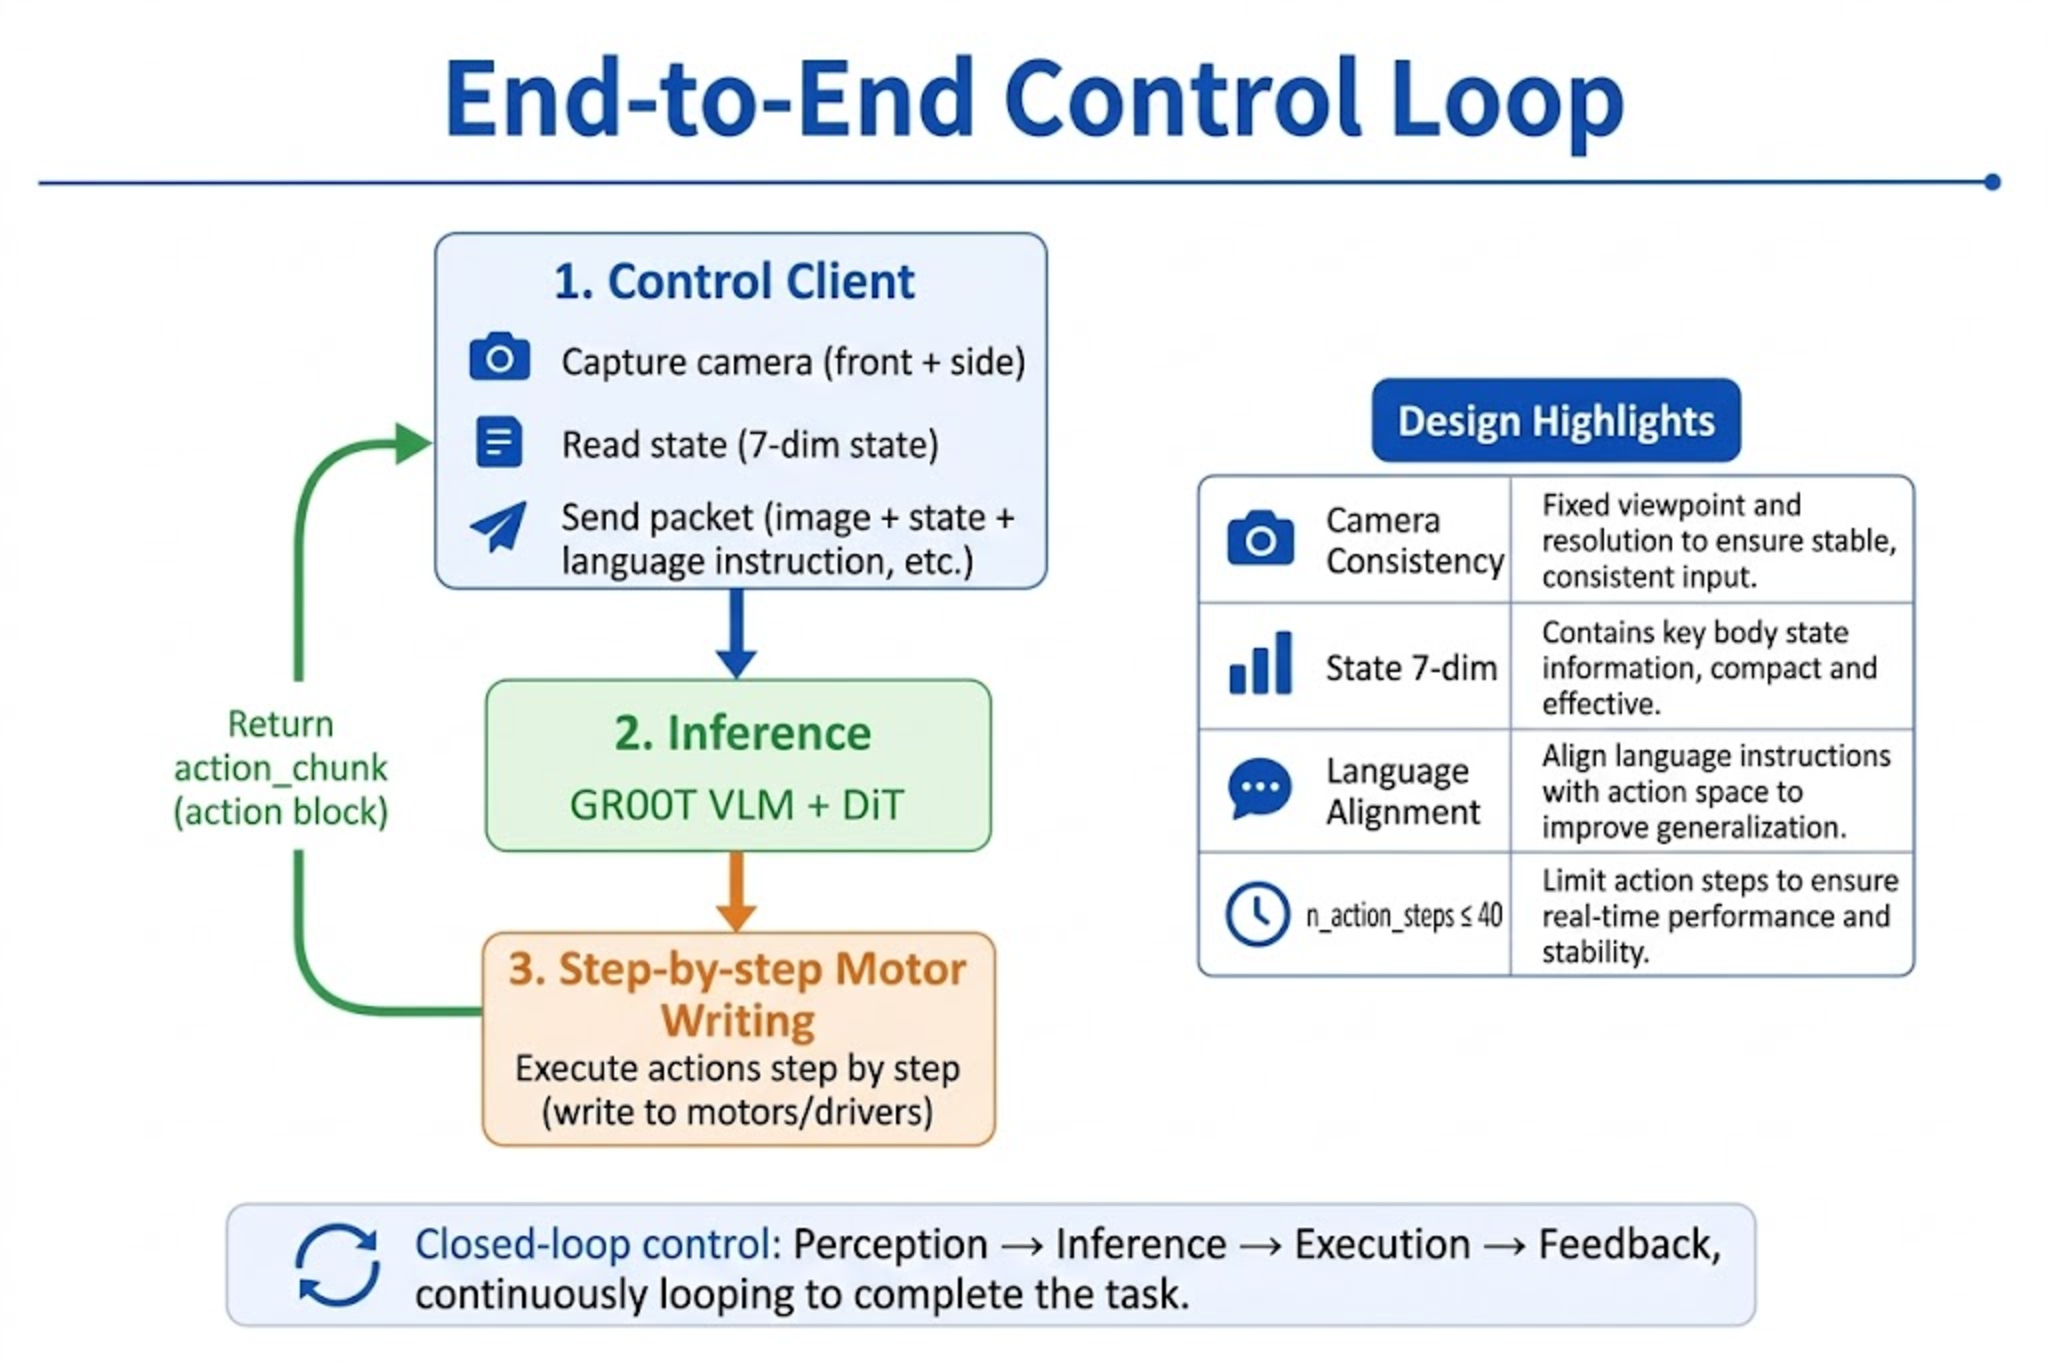
Un episodio exitoso de robot real con VLA puede abstraerse como un bucle de control de frecuencia fija:
User language instruction L (e.g. place the test tube into the left rack)
        |
        v
+---------------------------------------+
|  Control Client (Robot Control)        |
|  1. Capture cameras: front + side      |
|  2. Read joint state (7-dim)          |
|  3. Pack observation -> send to infer |
+-------------------+-------------------+
                    |  images + state + task
                    v
+---------------------------------------+
|  Inference side (GR00T Policy/Server)|
|  VLM + DiT -> action_chunk (H x 7)    |
+-------------------+-------------------+
                    |  action chunk
                    v
+---------------------------------------+
|  Control side executes                |
|  Write motors step by n_action_steps  |
|  (optional RTC: async prefetch next)  |
+---------------------------------------+
| Etapa | Restricción clave |
|---|---|
| Cámara | Los nombres de las claves, la resolución y la cantidad coinciden con el entrenamiento (front soporte vista amplia / side muñeca) |
| Estado | El orden de las 7 dimensiones coincide con modality.json; la unidad de ángulo es coherente entre entrenamiento e inferencia |
| Lenguaje | El patrón de la frase de --task es cercano a las anotaciones de entrenamiento |
| Acción | n_action_steps ≤ chunk_size de entrenamiento (N1.7 comúnmente 40) |
22.2 Desacoplar el Lado de Inferencia y el Lado de Control
22.2 Desacoplar el Lado de Inferencia y el Lado de Control
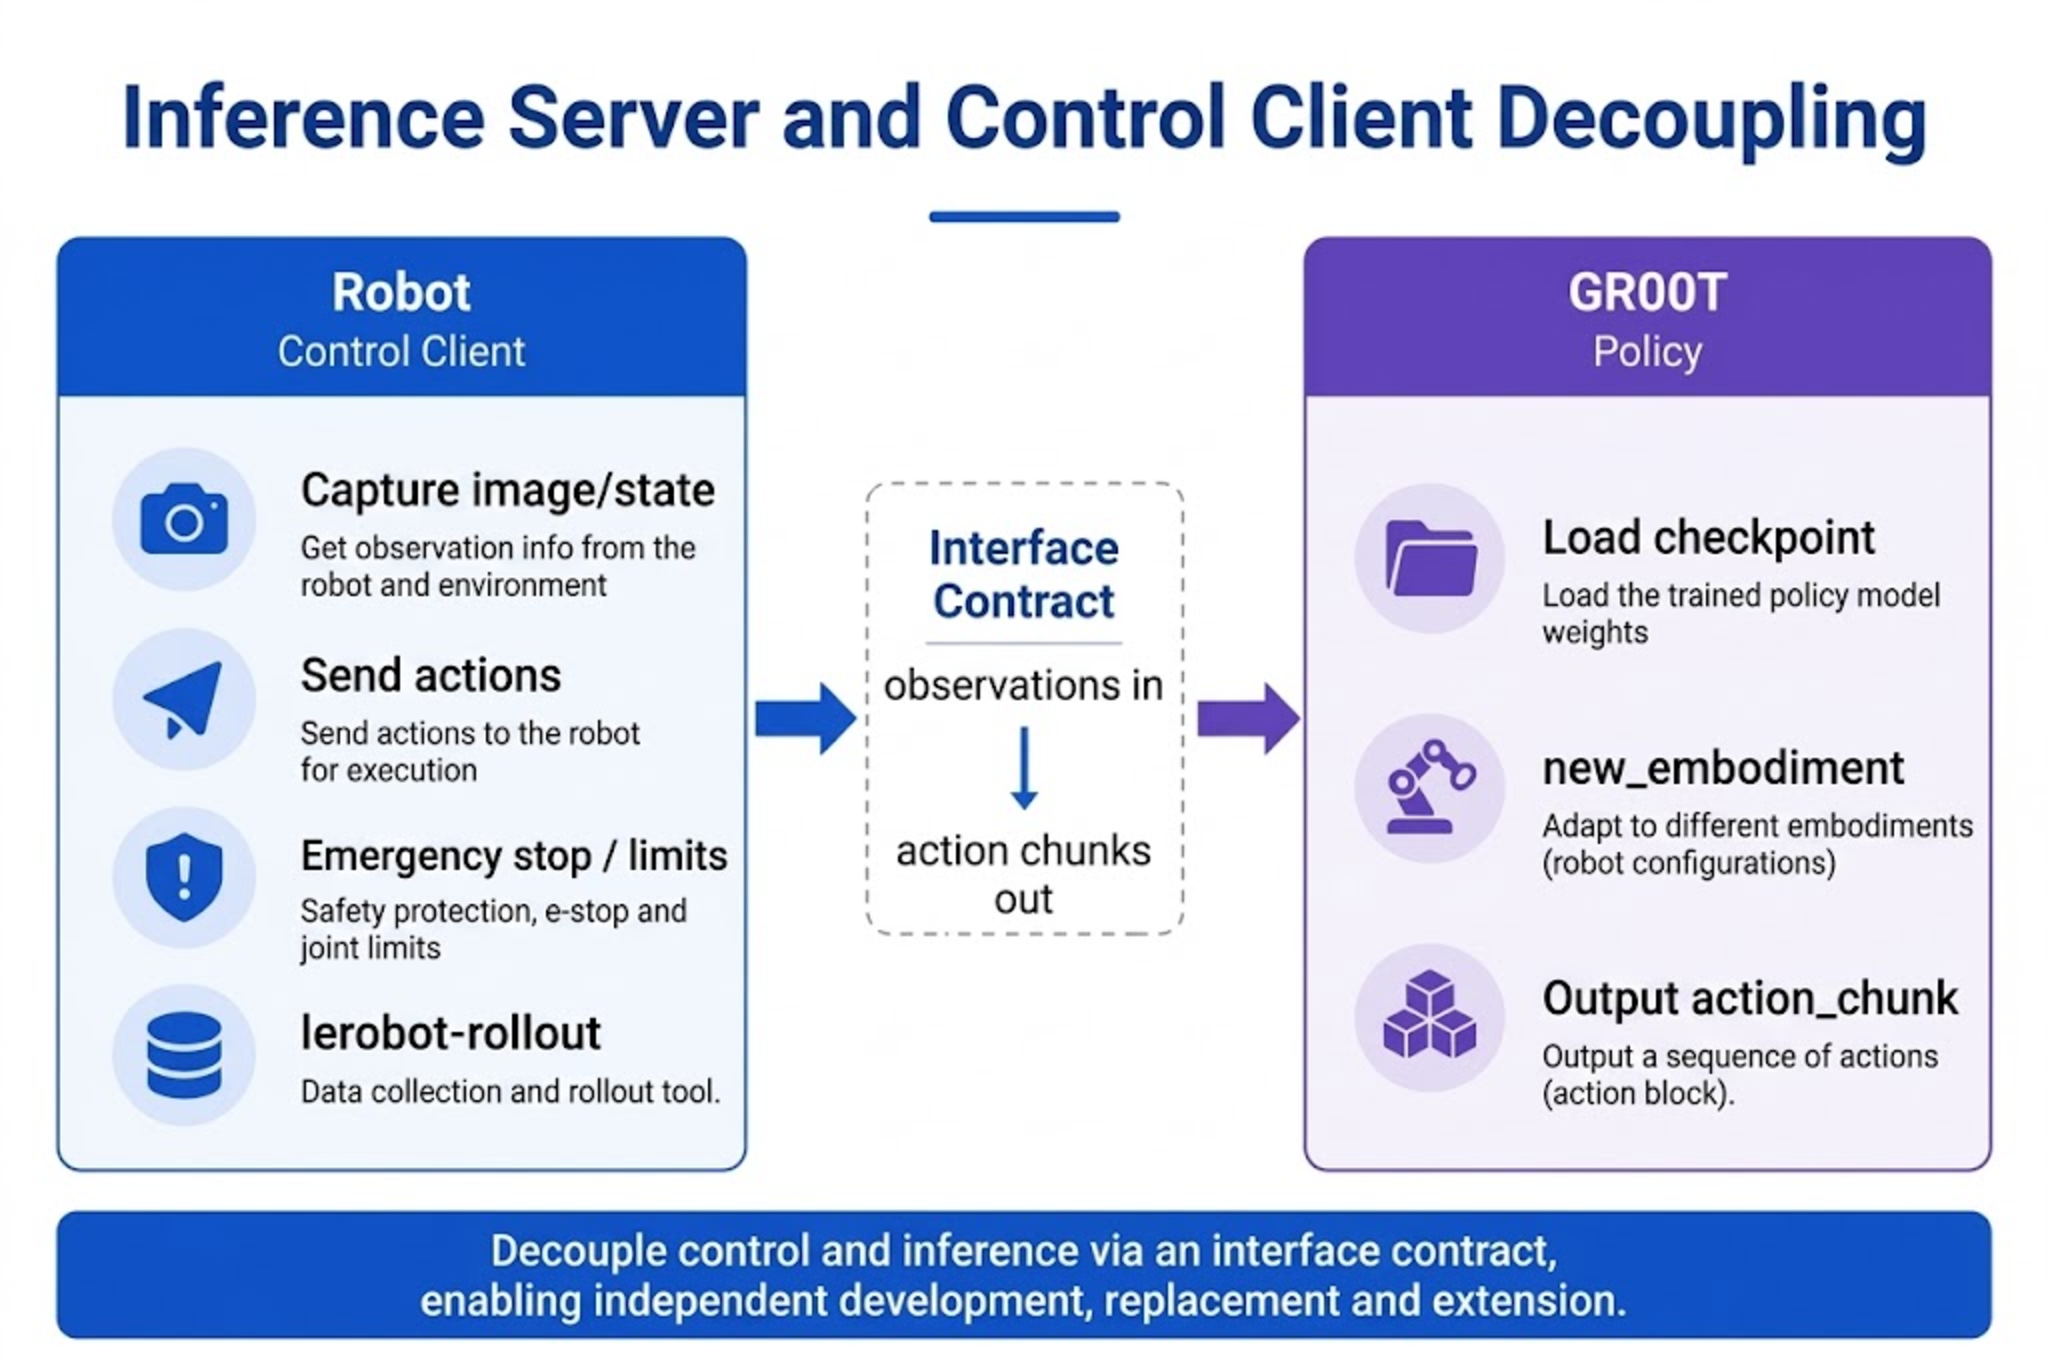
Dividir el sistema en dos lados evita que el control en tiempo real y el cómputo pesado se ralenticen mutuamente:
Responsabilidades del lado de control
- Capturar imágenes y estado de las articulaciones a una frecuencia fija (p. ej., 30 Hz)
- Ensamblar el paquete de observación
{images, state, task} - Recibir
action_chunky despacharlo paso a paso al driver de reBot - Ejecutar parada de emergencia, límites suaves y protección por tiempo de espera
Herramientas correspondientes: lerobot-rollout / lerobot-record (con --policy.path).
Responsabilidades del lado de inferencia
- Cargar
policy.path(checkpoint ajustado) ybase_model_path=nvidia/GR00T-N1.7-3B - Decodificar el espacio de acción de reBot con
embodiment_tag=new_embodiment - Devolver un fragmento de acción de forma aproximada
(H, 7)(H determinado por elchunk_sizede entrenamiento)
Forma correspondiente: por defecto la política groot en proceso; para uso avanzado puede ser un servicio HTTP/gRPC independiente (consulta los ejemplos de despliegue en el repositorio de Isaac GR00T).
Principio de desacoplamiento: el lado de control no conoce la estructura interna del modelo; el lado de inferencia no opera directamente los motores. El contrato de la interfaz es solo "observación de entrada, fragmento de acción de salida".
22.3 Despliegue en Máquina Única vs Distribuido
22.3 Despliegue en Máquina Única vs Distribuido
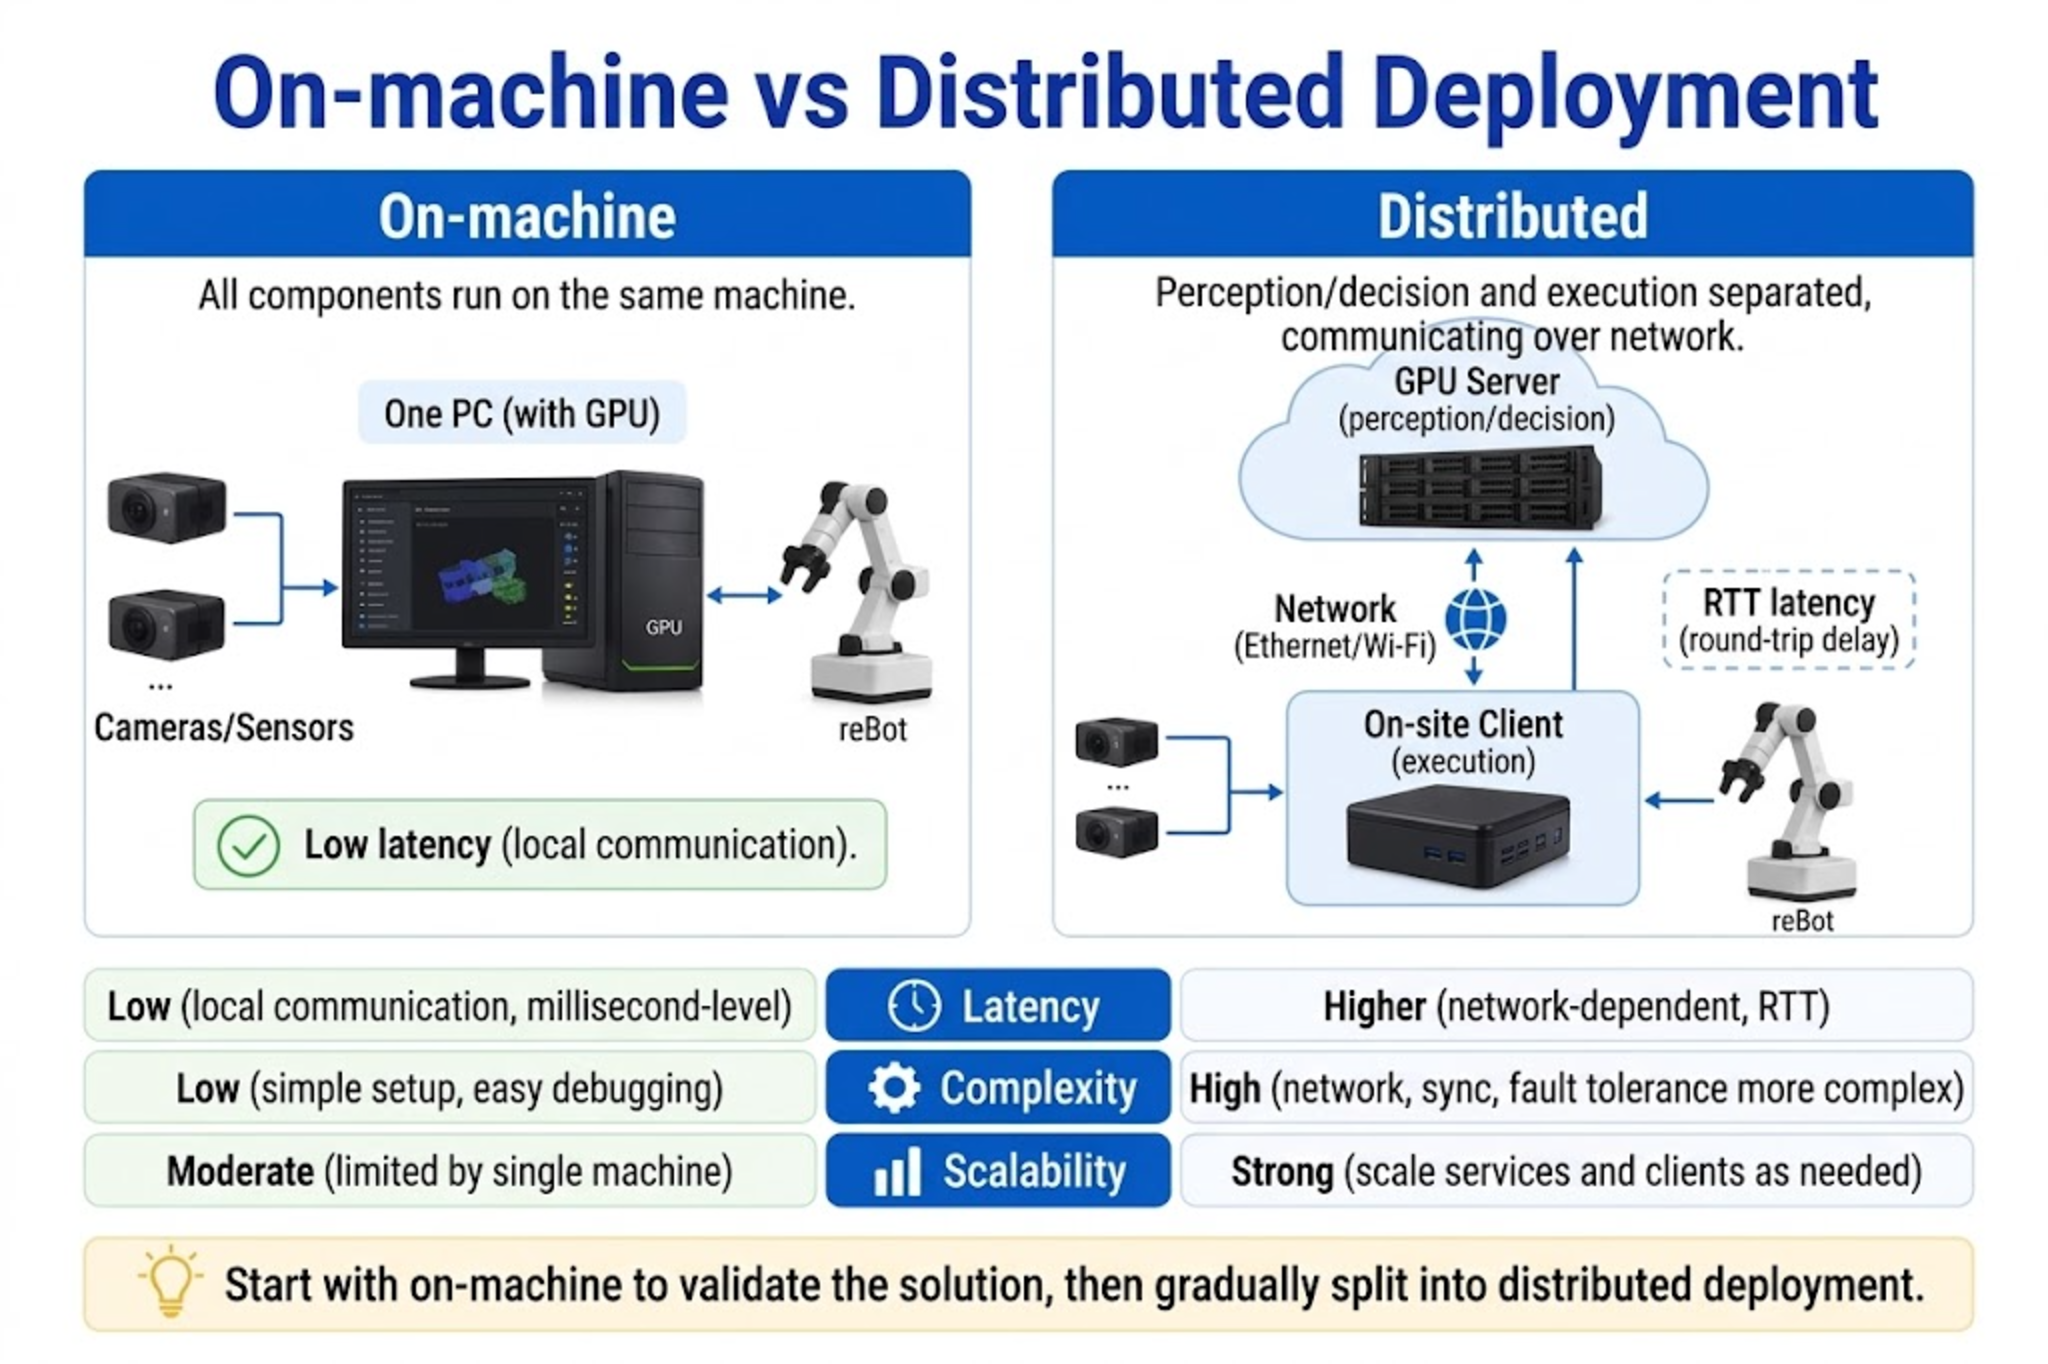
Despliegue en máquina única (recomendado para principiantes)
La estación de trabajo con GPU conecta cámaras, CAN/serie y el brazo al mismo tiempo:
lerobot-rollout \
  --policy.path=${MODEL_PATH} \
  --policy.base_model_path=nvidia/GR00T-N1.7-3B \
  --policy.embodiment_tag=new_embodiment \
  --device=cuda \
  --robot.type=seeed_b601_rs_follower \
  ...
Ventajas: sin ida y vuelta de red, depuración conjunta sencilla. Desventajas: se necesita un host con GPU in situ.
Despliegue distribuido (avanzado)
| Nodo | Ubicación |
|---|---|
| Máquina con GPU | Servidor de Inferencia (carga GR00T) |
| In situ / IPC | Cliente de Control (cámaras + driver de reBot) |
Escenarios adecuados: GPU de laboratorio separada del brazo en producción, múltiples brazos compartiendo un mismo pool de inferencia.
| Comparación | Máquina única | Distribuido |
|---|---|---|
| Latencia | Principalmente tiempo de inferencia | Inferencia + RTT de red |
| Complejidad | Baja | Se necesitan convenciones de serialización, tiempo de espera y reconexión |
| Escalabilidad | Una máquina, un brazo | Un servicio, múltiples clientes |
Consejo de selección: primero haz que el proyecto de etapa funcione en una sola máquina; tras confirmar la tasa de éxito, divídelo a distribuido.
22.4 Entradas de Cámara, Estado y Lenguaje
22.4 Entradas de Cámara, Estado y Lenguaje
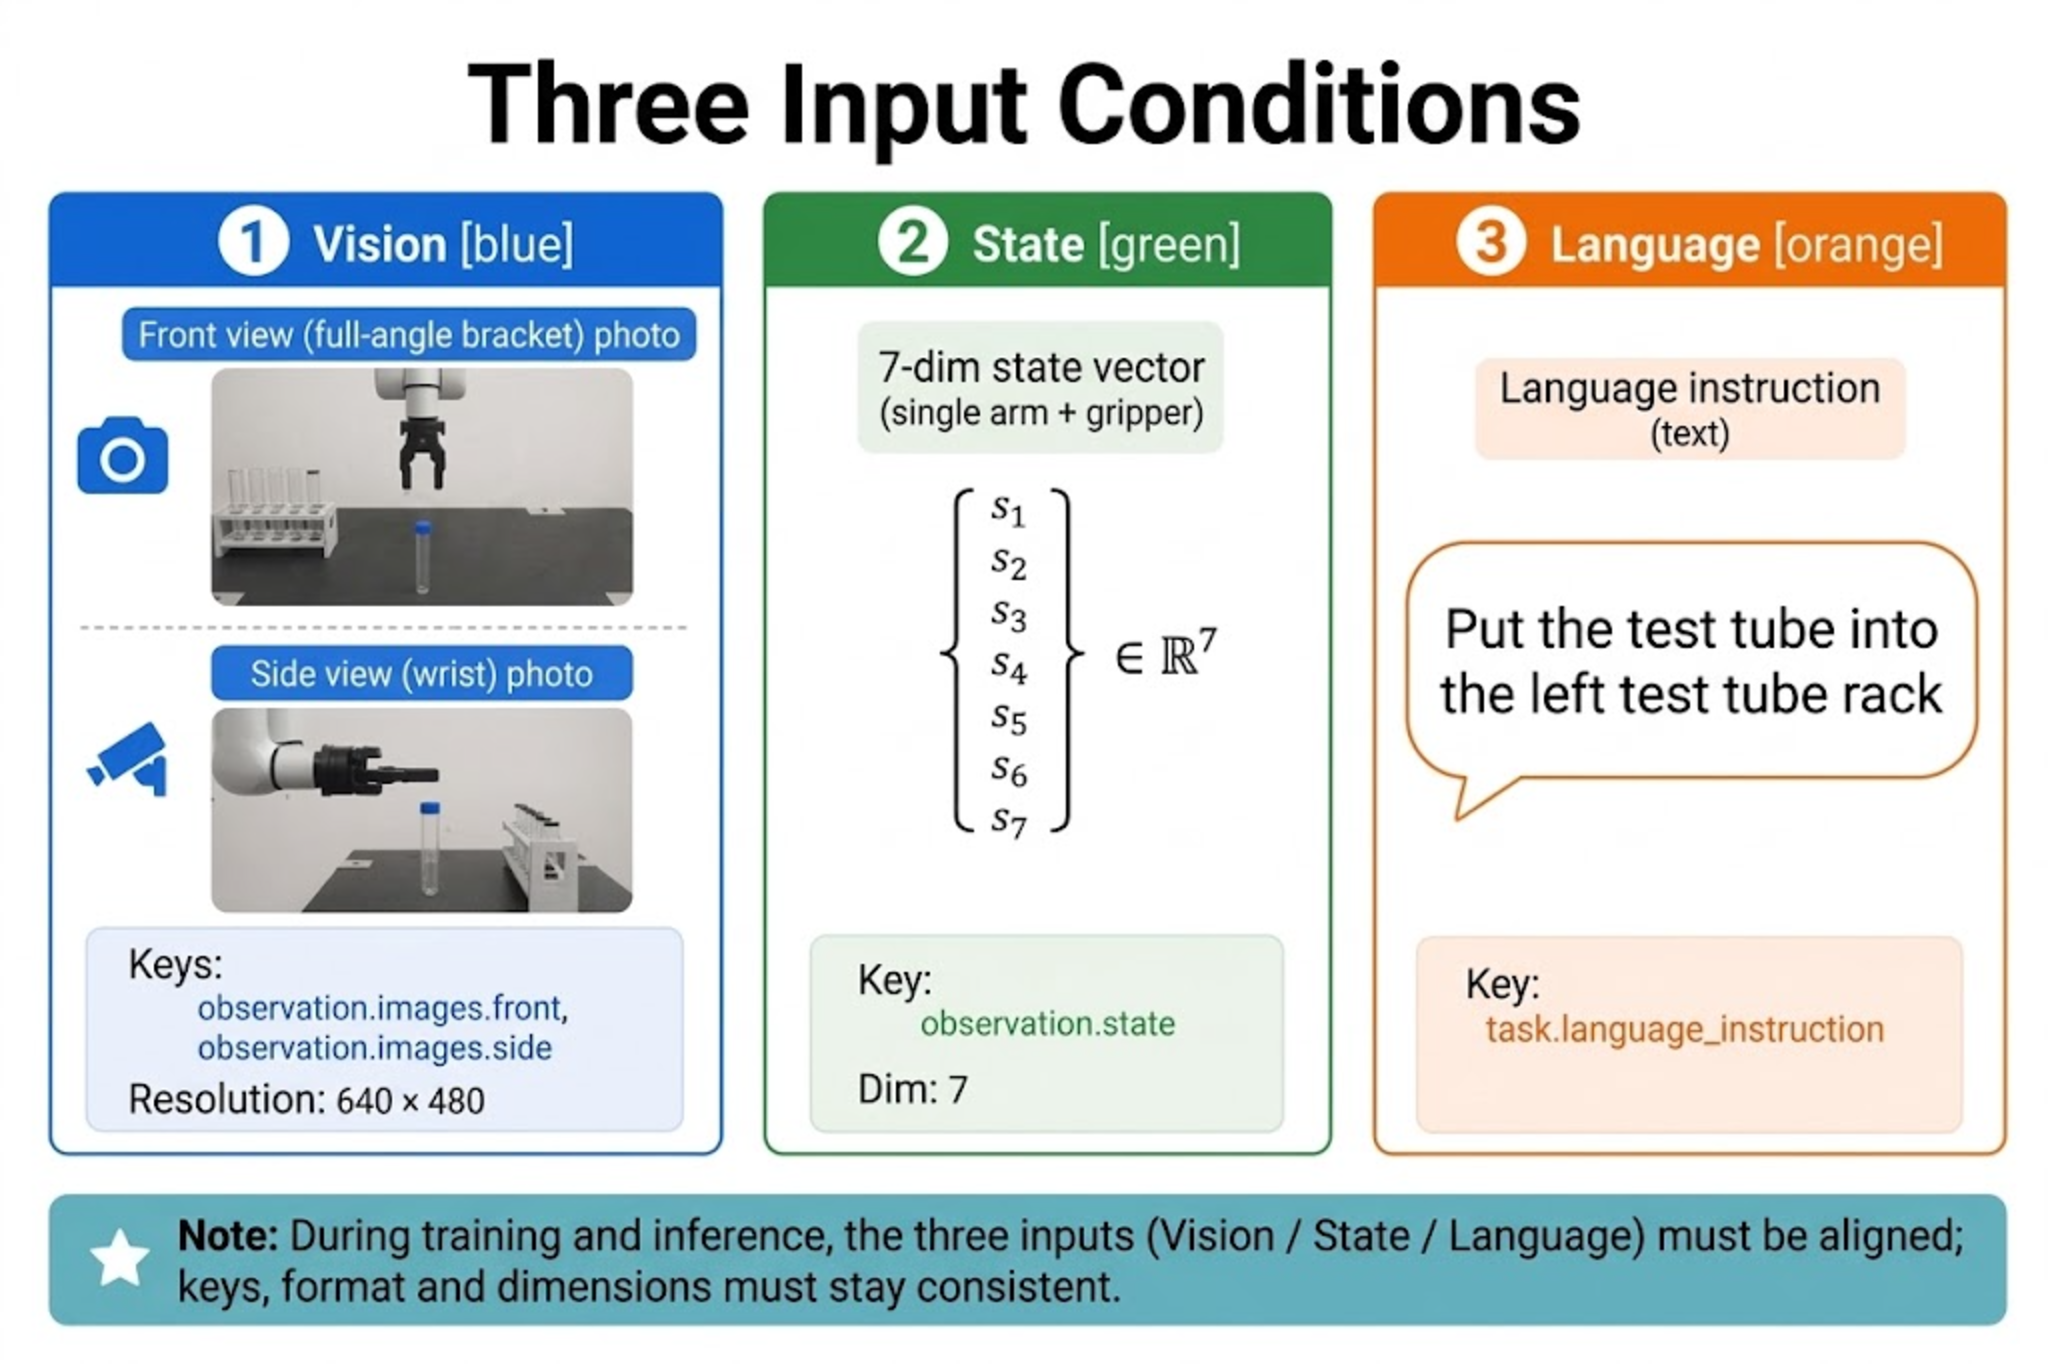
Cada llamada de inferencia requiere tres entradas condicionales, todas esenciales (o coherentes con lo declarado durante el entrenamiento):
1. Cámara (Visión)
| Nombre de clave | Montaje | Propósito |
|---|---|---|
observation.images.front -> front | Soporte vista amplia | Localización de la escena y del objetivo |
observation.images.side -> side | Muñeca | Apuntado en primer plano, agarre/colocación |
Resolución recomendada 640x480; el entrenamiento y la inferencia deben coincidir.
2. Estado
reBot Arm: single_arm 6 dimensiones + gripper 1 dimensión = 7 dimensiones, orden coherente con los Capítulos 19/20. El lado de control lee los ángulos articulares más recientes en cada ciclo de control antes de enviarlos a inferencia.
3. Lenguaje
Inyectado mediante --task / dataset.single_task. Ejemplo:
Place the test tube into the left rack.
Requisitos:
- Mismo idioma y estilo de frase que en
tasks.jsonl/human.task_descriptionde entrenamiento. - Referencia de objeto clara ("estante izquierdo" debe ser visualmente distinguible).
- No cambies de repente a una instrucción compuesta compleja nunca vista en el entrenamiento.
22.5 Salida de Fragmentos de Acción
22.5 Salida de Fragmentos de Acción
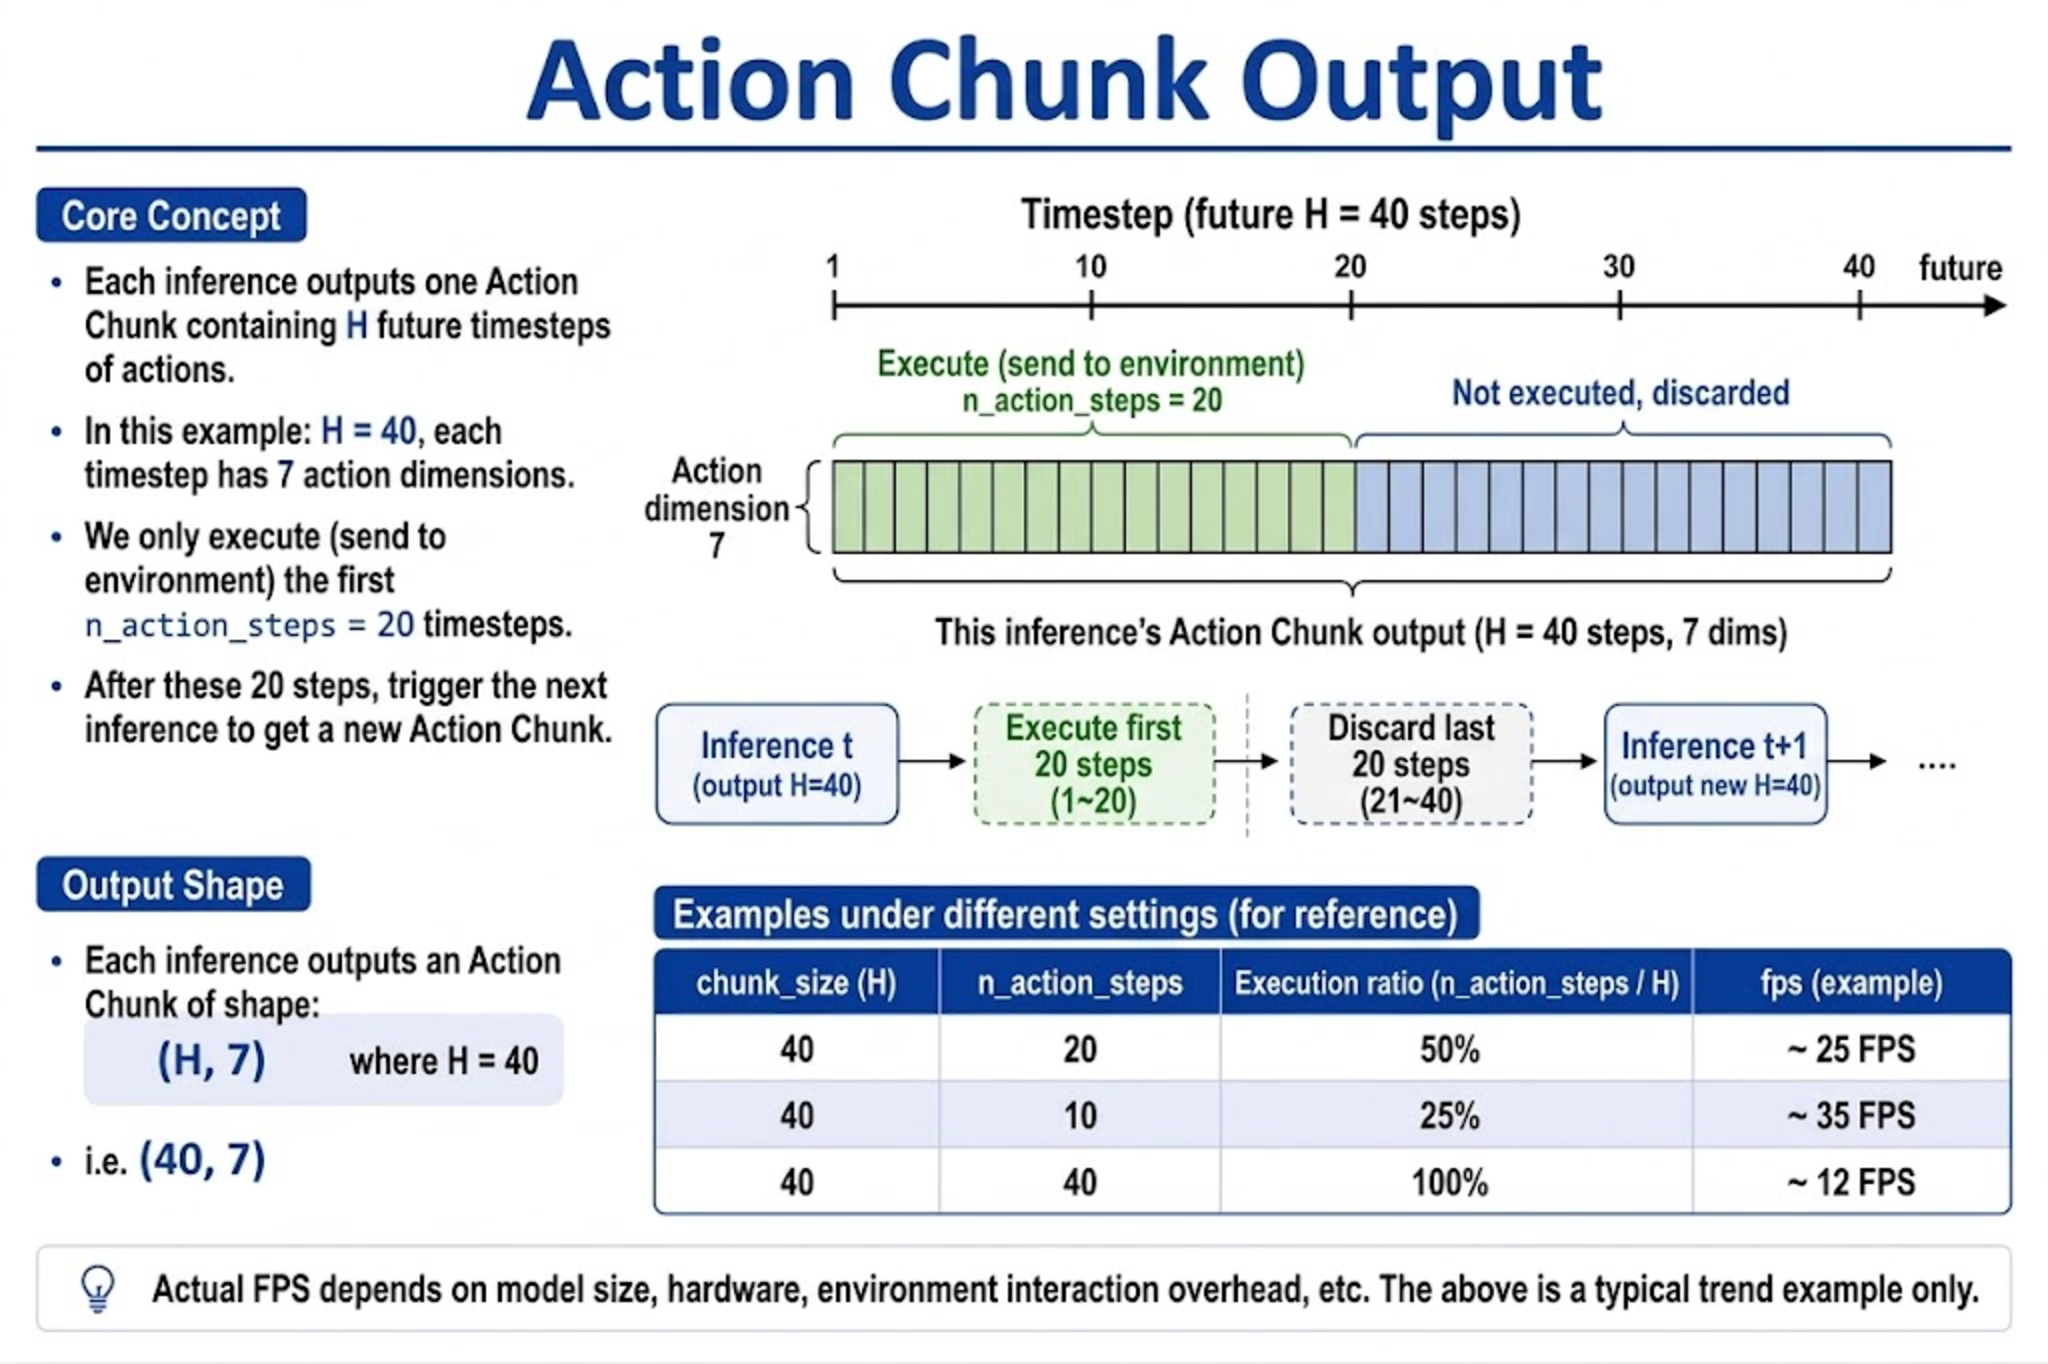
Una sola inferencia de GR00T no produce un comando articular instantáneo, sino un fragmento de acción:
action_chunk.shape ~= (H, 7)
H = chunk_size / action_horizon   # N1.7 fine-tuning commonly 40
each row 7-dim = 6 joints + gripper
Estrategia de ejecución en el lado de control:
| Parámetro | Sugerencia | Descripción |
|---|---|---|
chunk_size | 40 en entrenamiento | Determina cuán lejos puede predecir el modelo; no lo aumentes arbitrariamente en inferencia |
n_action_steps | Comienza con 20 | Pasos realmente ejecutados en esta ronda, deben ser ≤ chunk_size |
| Frecuencia de ejecución | Cercana a los fps de grabación (p. ej., 30 Hz) | Demasiado rápida o demasiado lenta se desvía de la distribución de entrenamiento |
Si se habilitan acciones relativas (use_relative_actions), el lado de control debe restaurarlas a comandos articulares absolutos usando las mismas reglas que en el entrenamiento; normalmente se excluye el gripper de las relativas.
22.6 Latencia de Red e Inferencia
22.6 Latencia de Red e Inferencia
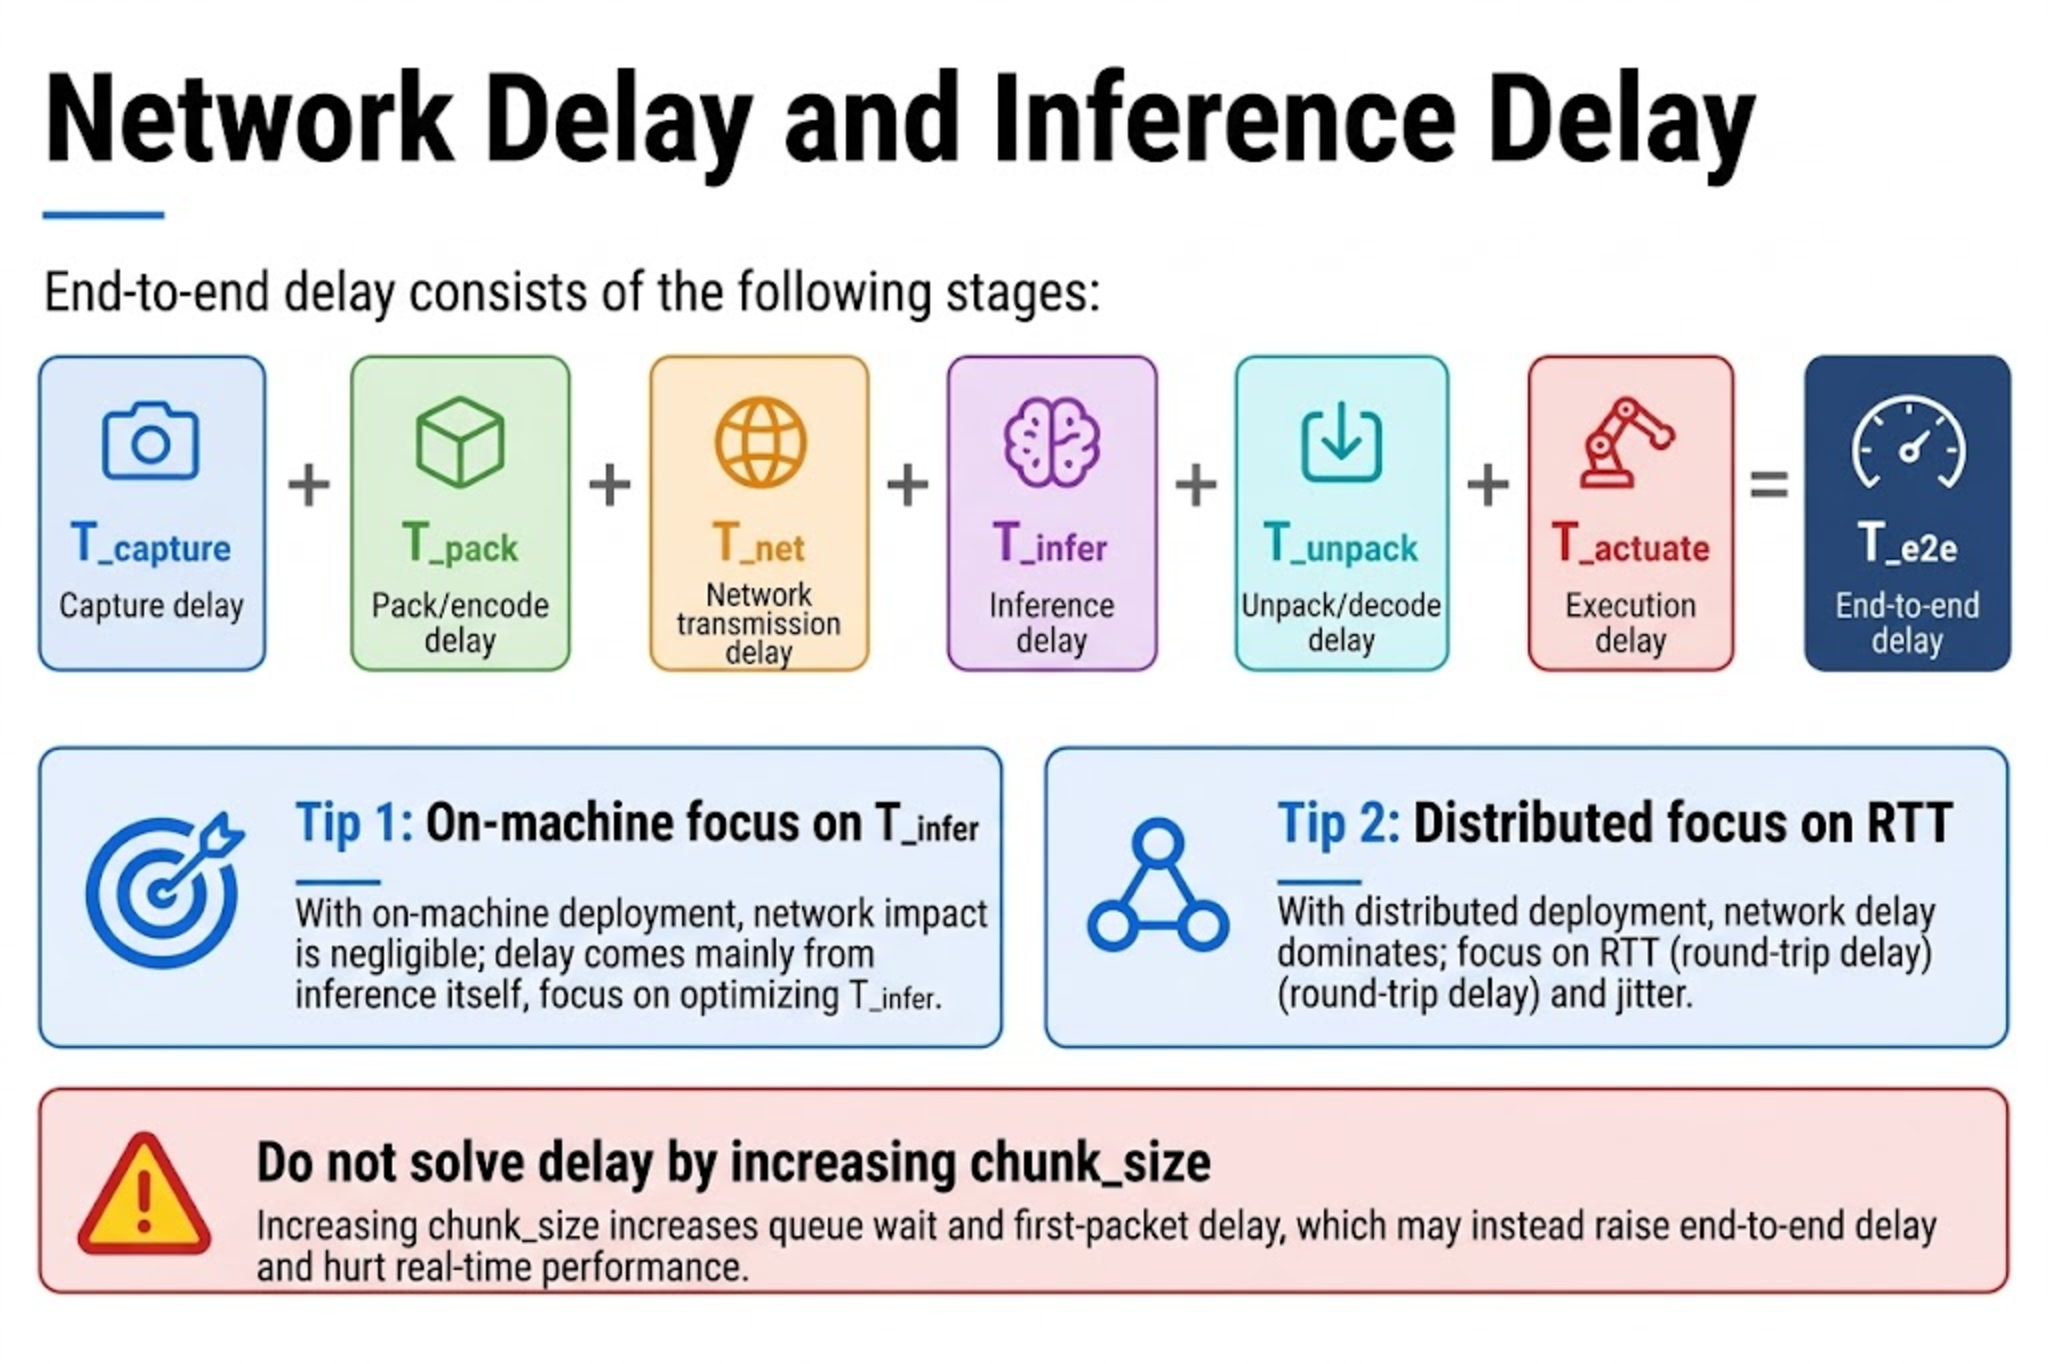
La latencia de extremo a extremo es aproximadamente:
T_e2e ~= T_capture + T_pack + T_net + T_infer + T_unpack + T_actuate
| Componente | Fuente típica | Mitigación |
|---|---|---|
T_capture | Exposición de la cámara/USB | MJPG, resolución fija, evitar preprocesamiento extra |
T_infer | VLM + DiT | bf16, batch=1, Flash Attention |
T_net | RTT distribuido | Gigabit, mismo centro de datos, comprimir observaciones |
T_actuate | Ciclo de escritura CAN/serie | Mantener la frecuencia de control cercana al entrenamiento |
Reglas generales:
- Máquina única: el cuello de botella suele ser
T_infer; usa unn_action_stepsmás pequeño + RTC para enmascarar las pausas. - Distribuido: si el RTT es inestable, primero desactiva RTC para depuración sincrónica y luego habilita gradualmente el modo asíncrono.
- No resuelvas la latencia "aumentando
chunk_size": la ventana está fijada por el entrenamiento.
22.7 Almacenamiento en búfer de acciones e inferencia asíncrona
22.7 Almacenamiento en búfer de acciones e inferencia asíncrona
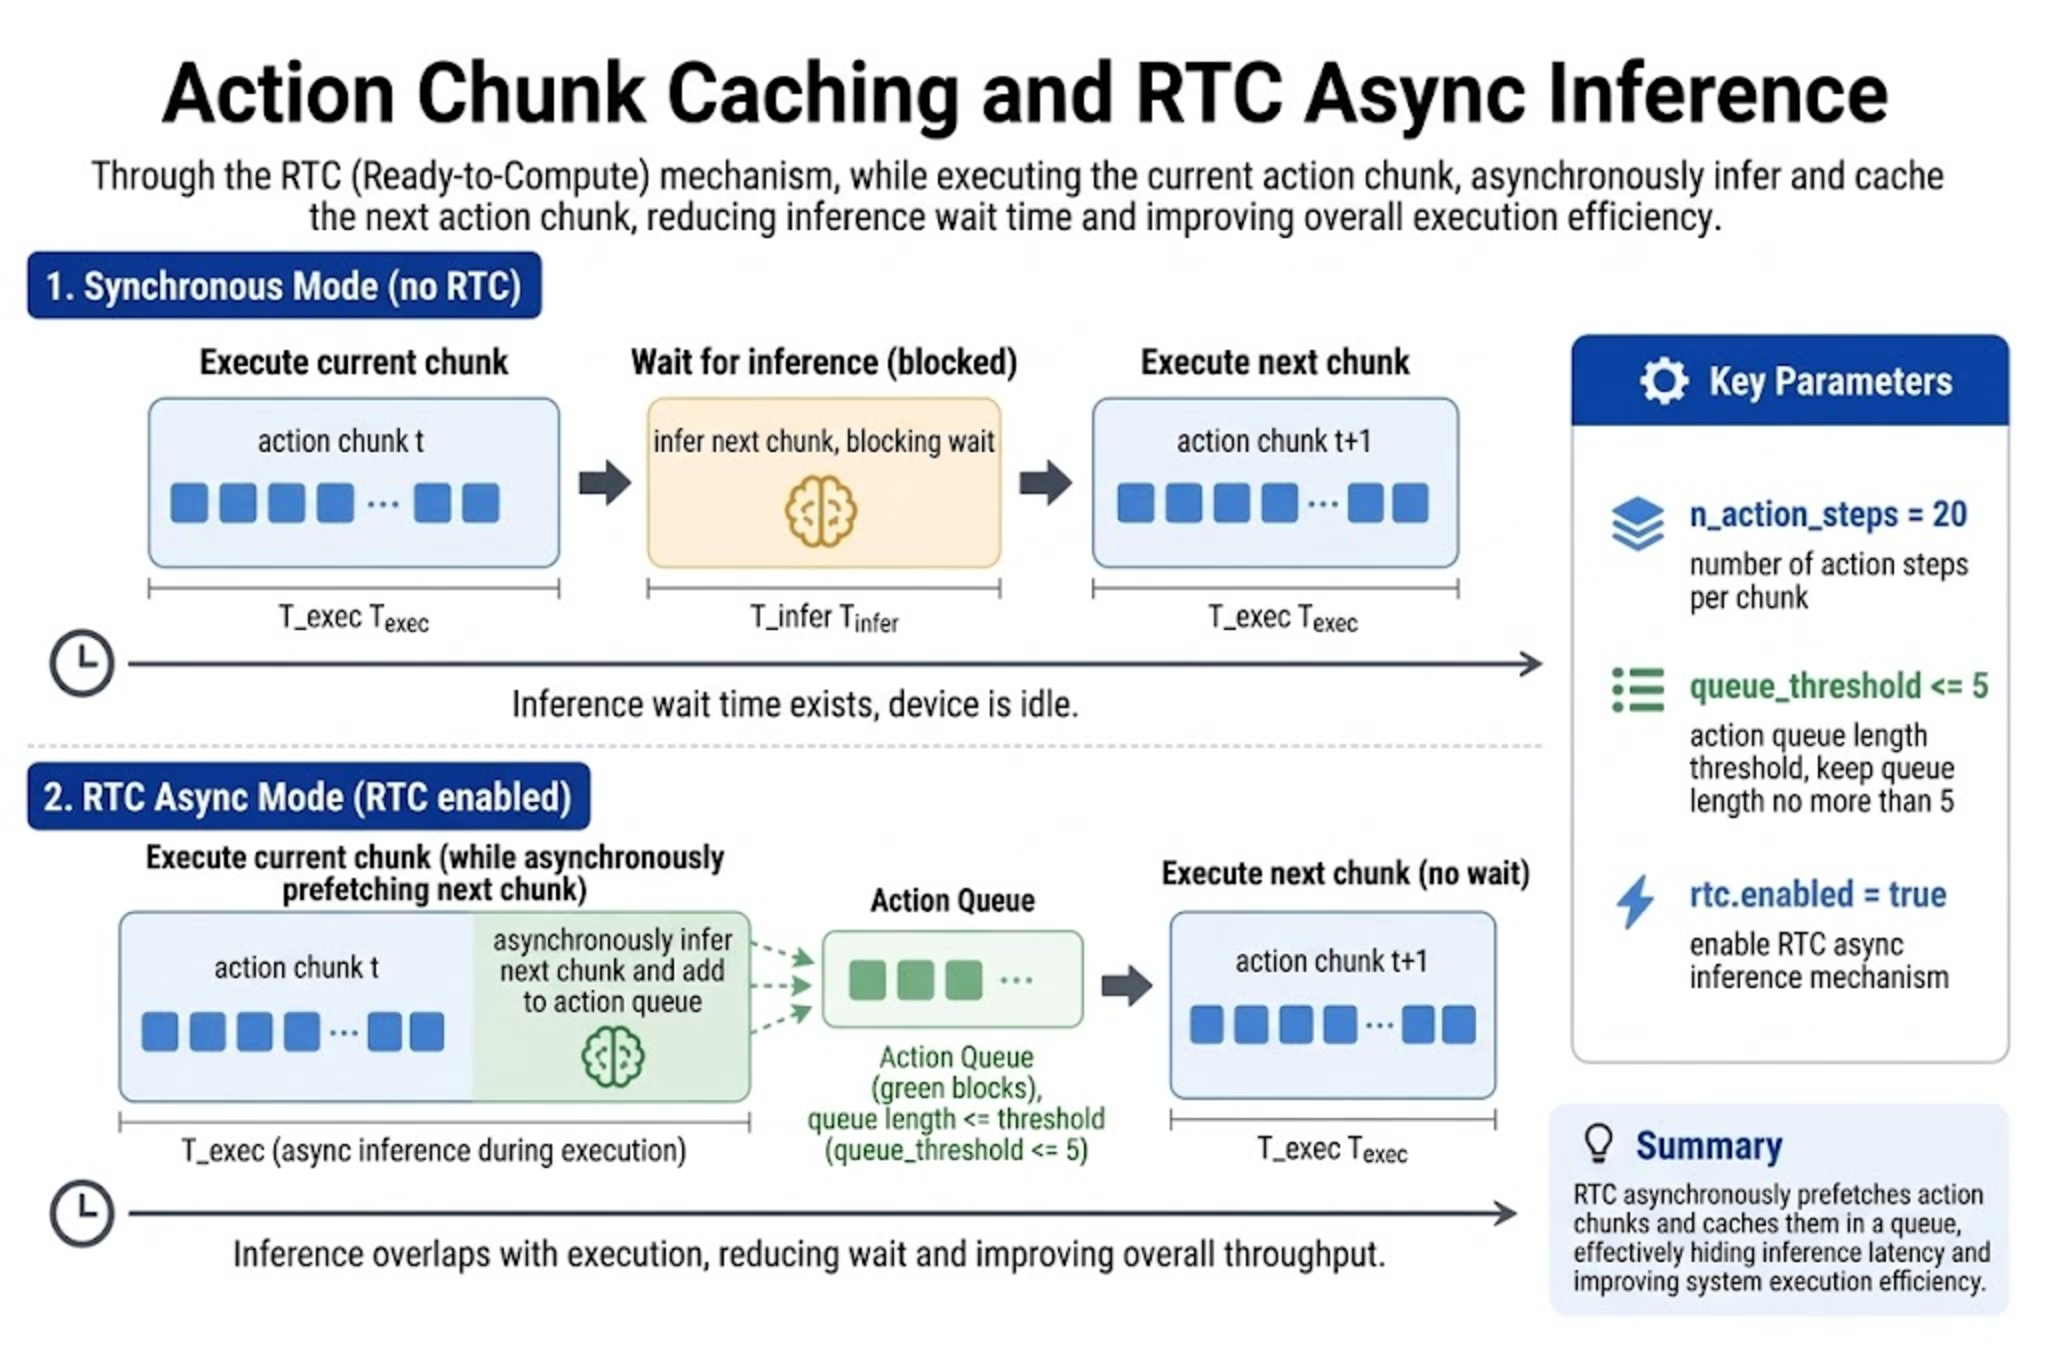
Cola de acciones
El lado de control escribe el action_chunk recibido en una cola y lo extrae en cada ciclo de control. Si el siguiente bloque no ha llegado antes de que la cola se vacíe, el brazo se detendrá o reutilizará la última acción, que es precisamente lo que evita la inferencia asíncrona.
RTC (Real-Time Chunking)
Mientras ejecuta el bloque actual, el backend solicita el siguiente bloque con la observación más reciente:
lerobot-rollout \
  ... \
  --policy.n_action_steps=20 \
  --inference.type=rtc \
  --inference.rtc.enabled=true \
  --inference.rtc.execution_horizon=20 \
  --inference.queue_threshold=0
| Parámetro | Sugerencia |
|---|---|
n_action_steps / execution_horizon | Comienza en 20 y luego ajusta para el jitter |
queue_threshold | Recomendado ≤ 5; demasiado grande acumula acciones obsoletas |
Si aparece jitter/temblor, primero establece --inference.rtc.enabled=false, confirma que la ruta sincrónica está sana y luego habilita RTC.
22.8 Límites de seguridad en robots reales
22.8 Límites de seguridad en robots reales
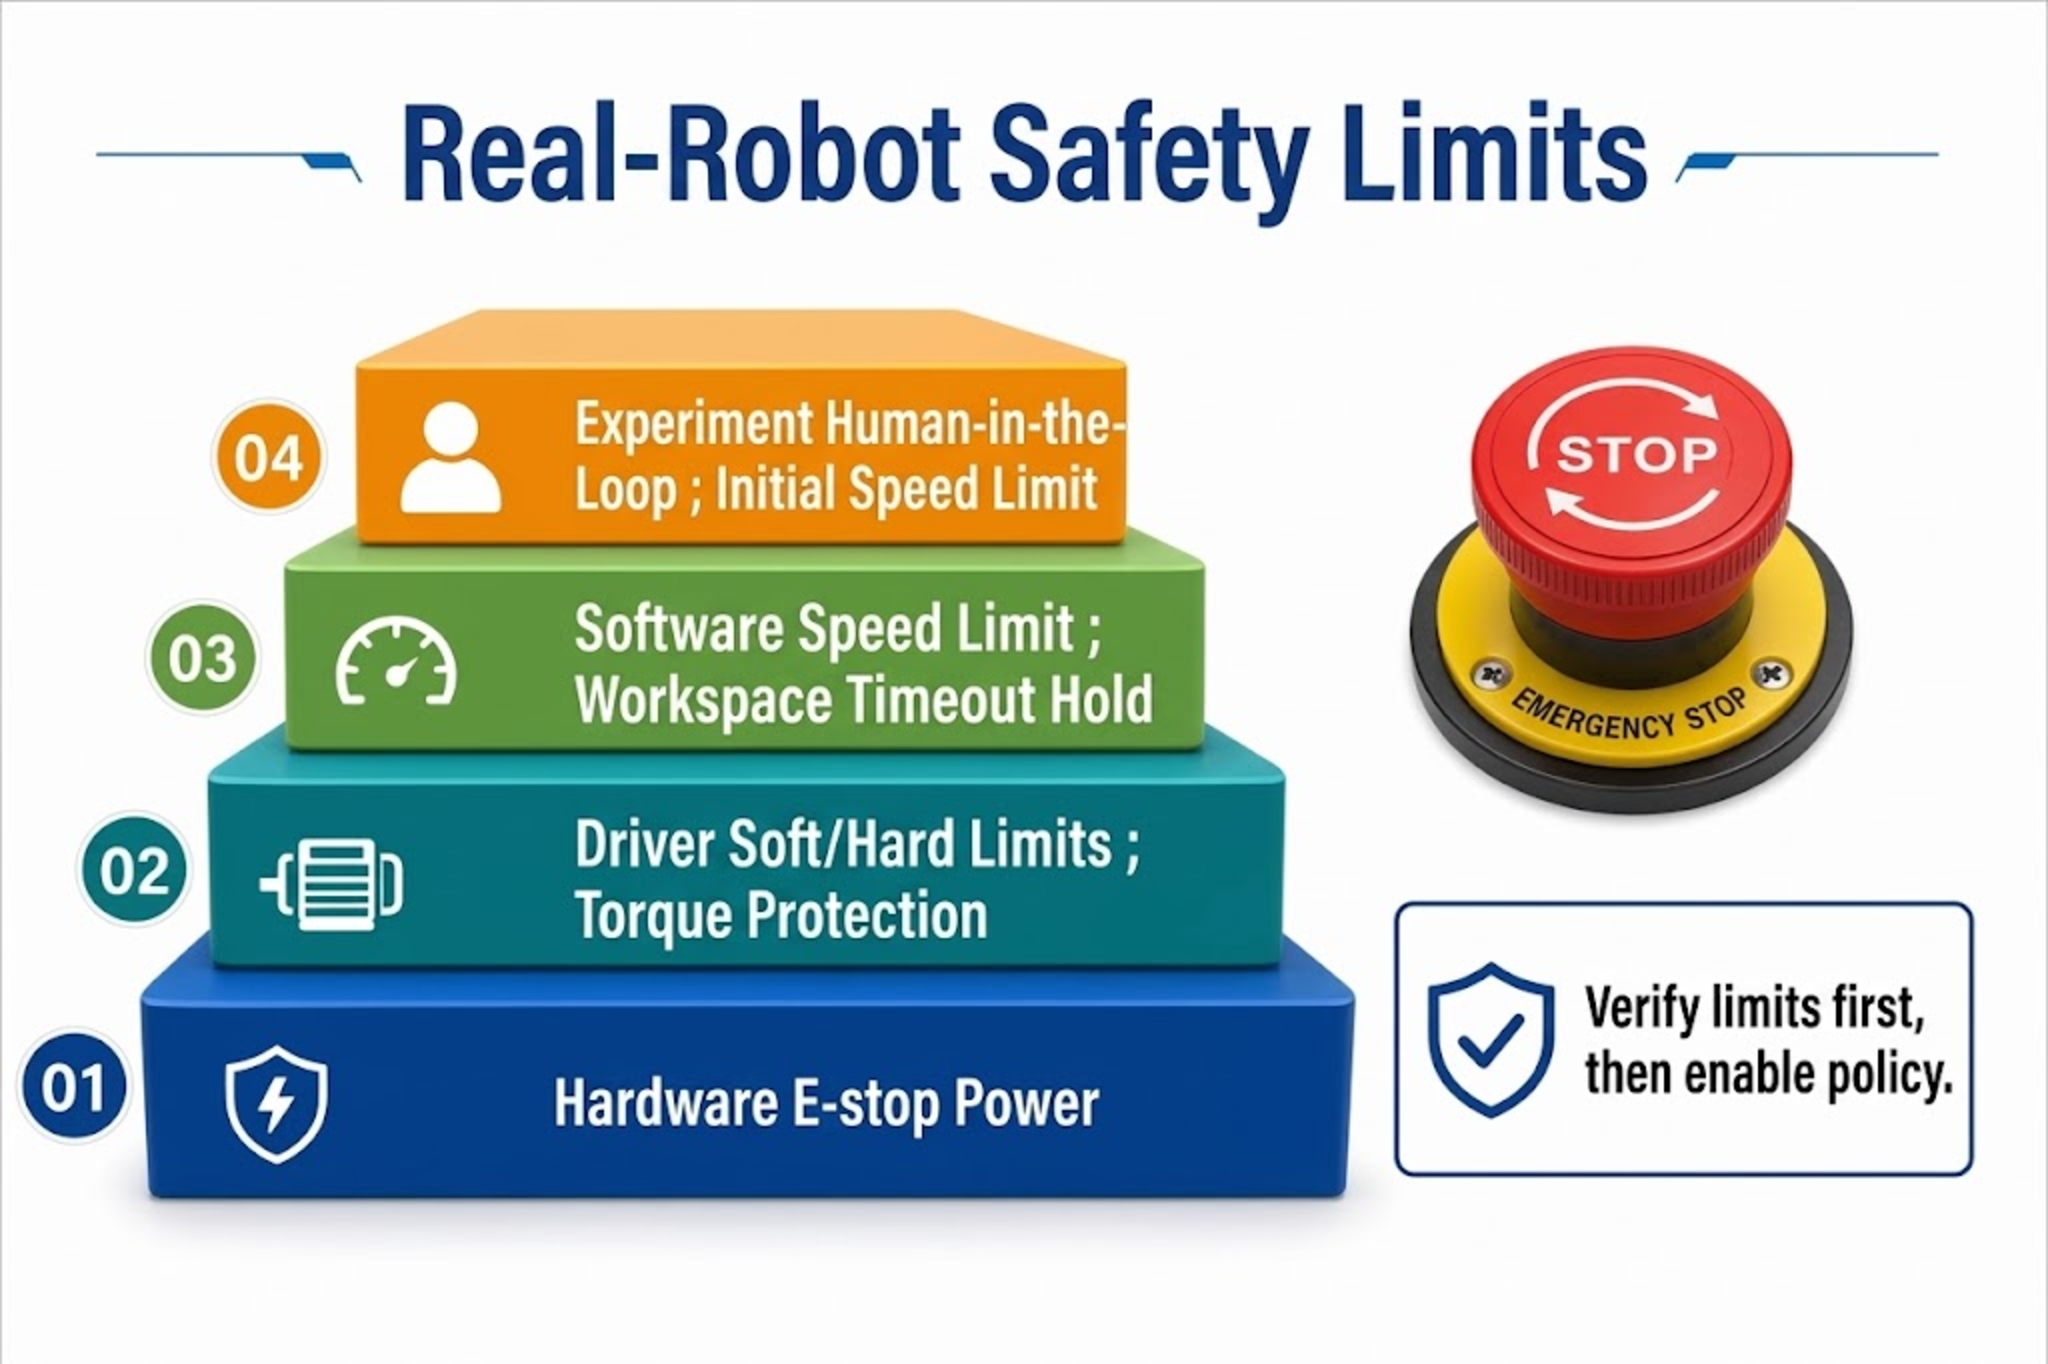
La salida de VLA no ofrece garantías físicas, por lo que la seguridad debe ser aplicada por la capa de control:
| Capa | Medida |
|---|---|
| Hardware | Botón de parada de emergencia, corte de alimentación, gestión de cables para evitar enredos |
| Controlador / firmware | Límites suaves/duros de las articulaciones, protección de corriente/par |
| Control por software | Recorte de velocidad/aceleración, caja de espacio de trabajo, mantener o mover a una postura segura en caso de timeout |
| Flujo experimental | Reducir ganancia/velocidad en la primera inferencia; humano en el bucle; despejar de la mesa los obstáculos no relacionados |
Lista de comprobación de depuración:
- Antes de cargar la política, usa control manual/teleoperado para confirmar que los límites son efectivos.
- Al desplegar la política, primero usa un
--durationcorto para confirmar que no hay descontrol. - Ante un movimiento anómalo, pulsa la parada de emergencia inmediatamente, registra la
taskactual, los fotogramas de la cámara y el estado, y luego revisa los datos y la modalidad.
22.9 Evaluación de tareas VLA
22.9 Evaluación de tareas VLA
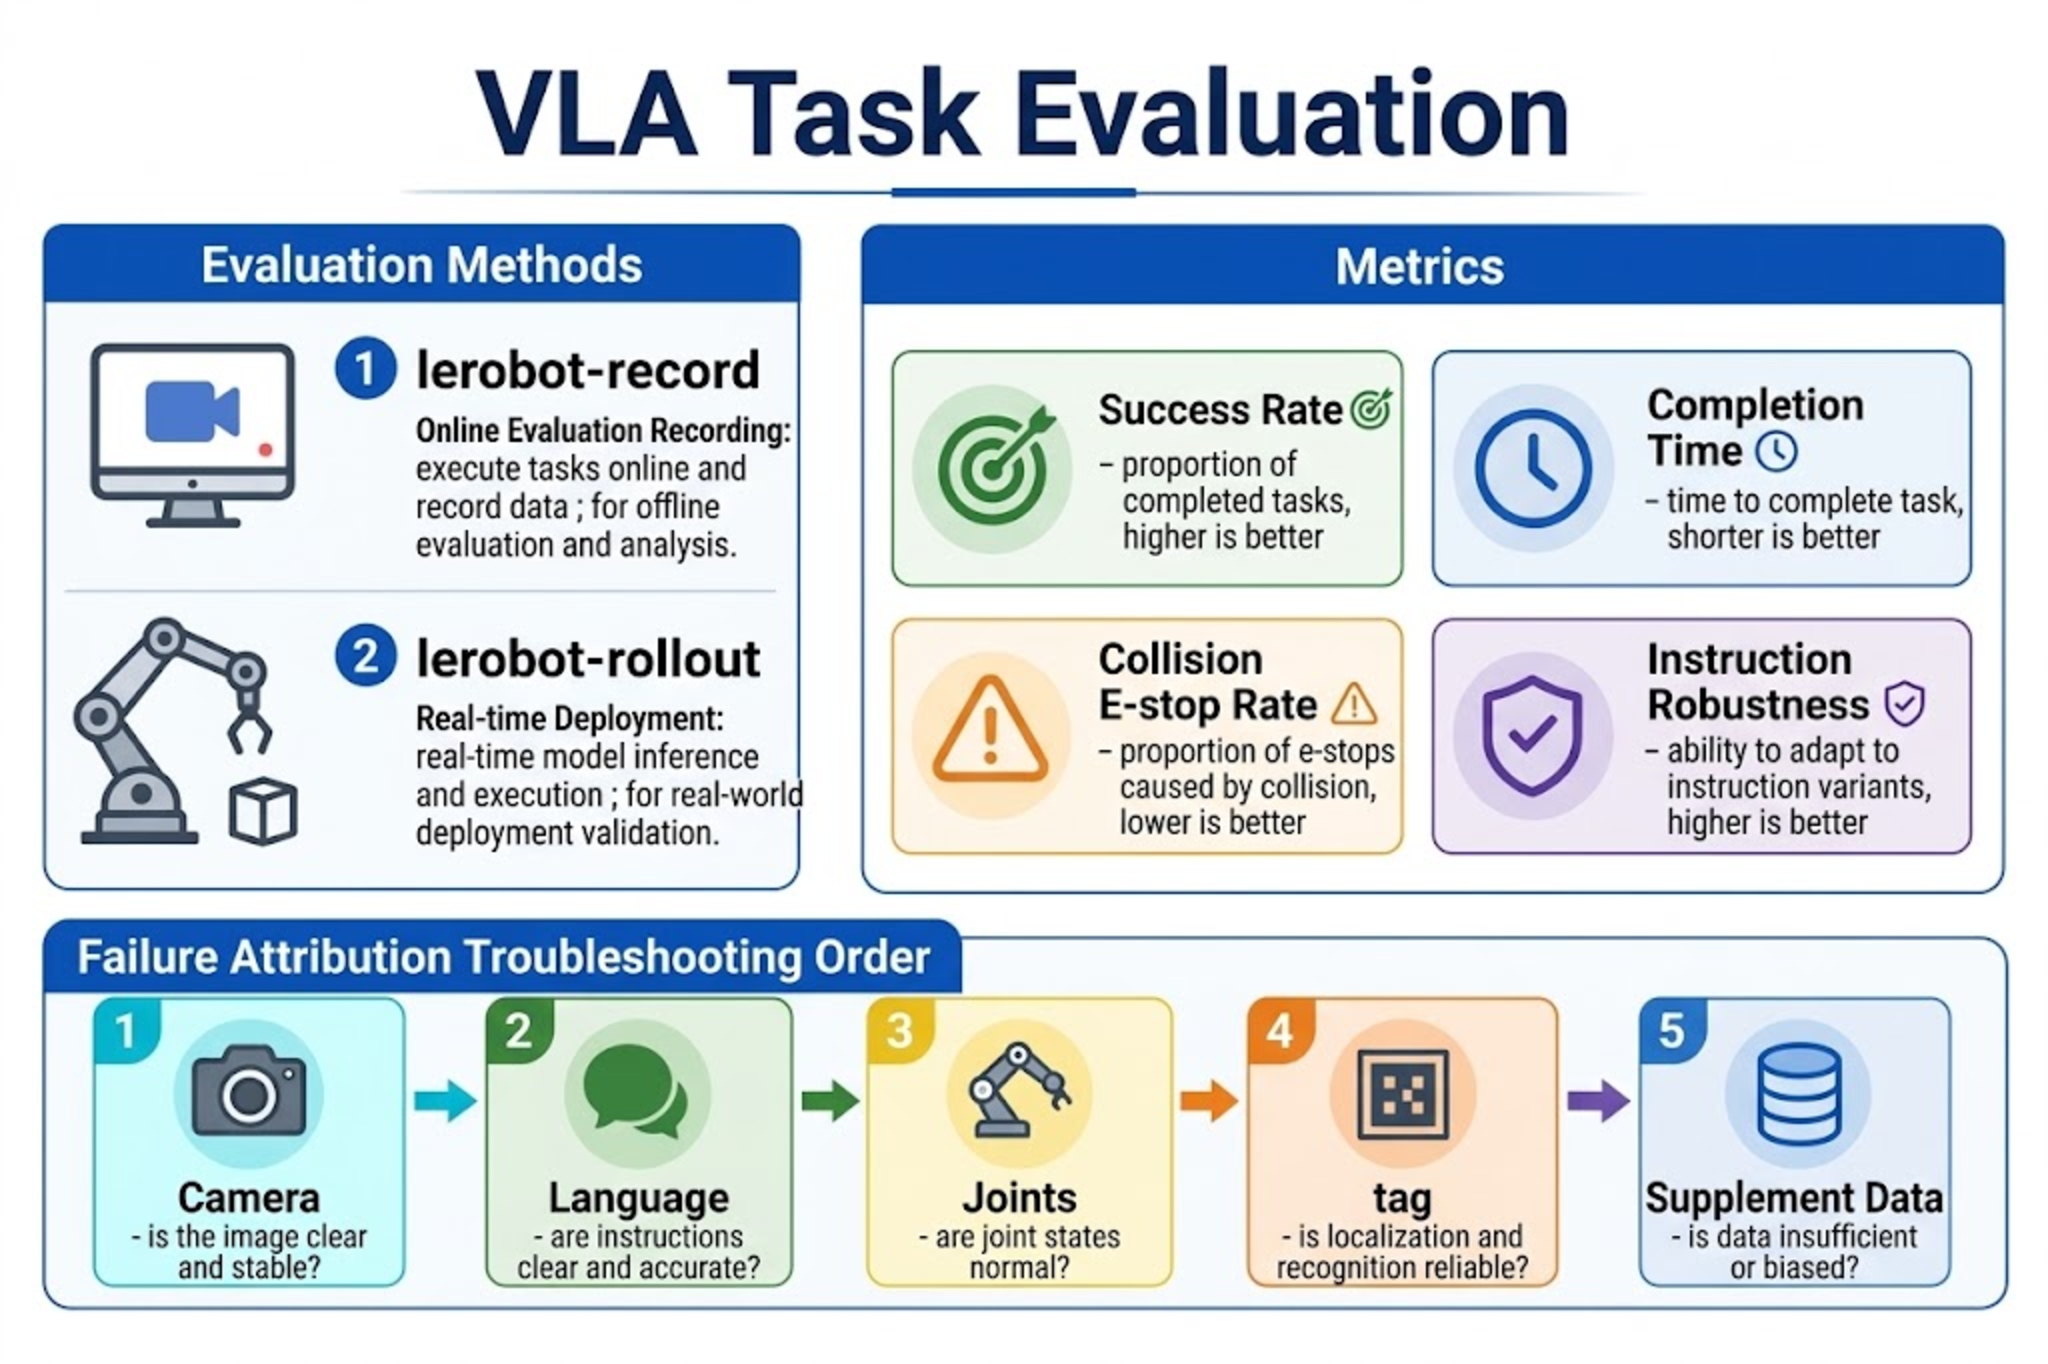
Métodos de evaluación
| Método | Herramienta | Propósito |
|---|---|---|
| Grabación de evaluación en línea | lerobot-record + --policy.path | Guardar episodios de fallo/éxito para su reproducción |
| Despliegue en tiempo real | lerobot-rollout | Probar latencia, RTC y estabilidad en horizontes largos |
Métricas sugeridas
| Métrica | Descripción |
|---|---|
| Tasa de éxito | Bajo condiciones iniciales e instrucciones fijas, éxitos / total (se recomiendan ≥ 20 ejecuciones) |
| Tiempo de finalización | Segundos desde el inicio hasta que se completa la colocación |
| Tasa de colisión / parada de emergencia | Proporción de colisiones ajenas a la tarea o intervenciones manuales |
| Robustez a las instrucciones | Si una instrucción ligeramente reformulada para la misma tarea sigue teniendo éxito (solo dentro de la distribución de entrenamiento) |
Orden de atribución de fallos
- ¿Los nombres de las claves de cámara / la resolución son coherentes con el entrenamiento?
- ¿El patrón de la frase en lenguaje se desvía de las anotaciones?
- Orden de las articulaciones y unidades.
embodiment_tag, conmutador de acción relativa.- Cobertura de datos insuficiente -> vuelve al Capítulo 20 para recopilar más.
22.10 Proyecto de etapa: coloca el tubo de ensayo en el estante izquierdo
22.10 Proyecto de etapa: coloca el tubo de ensayo en el estante izquierdo
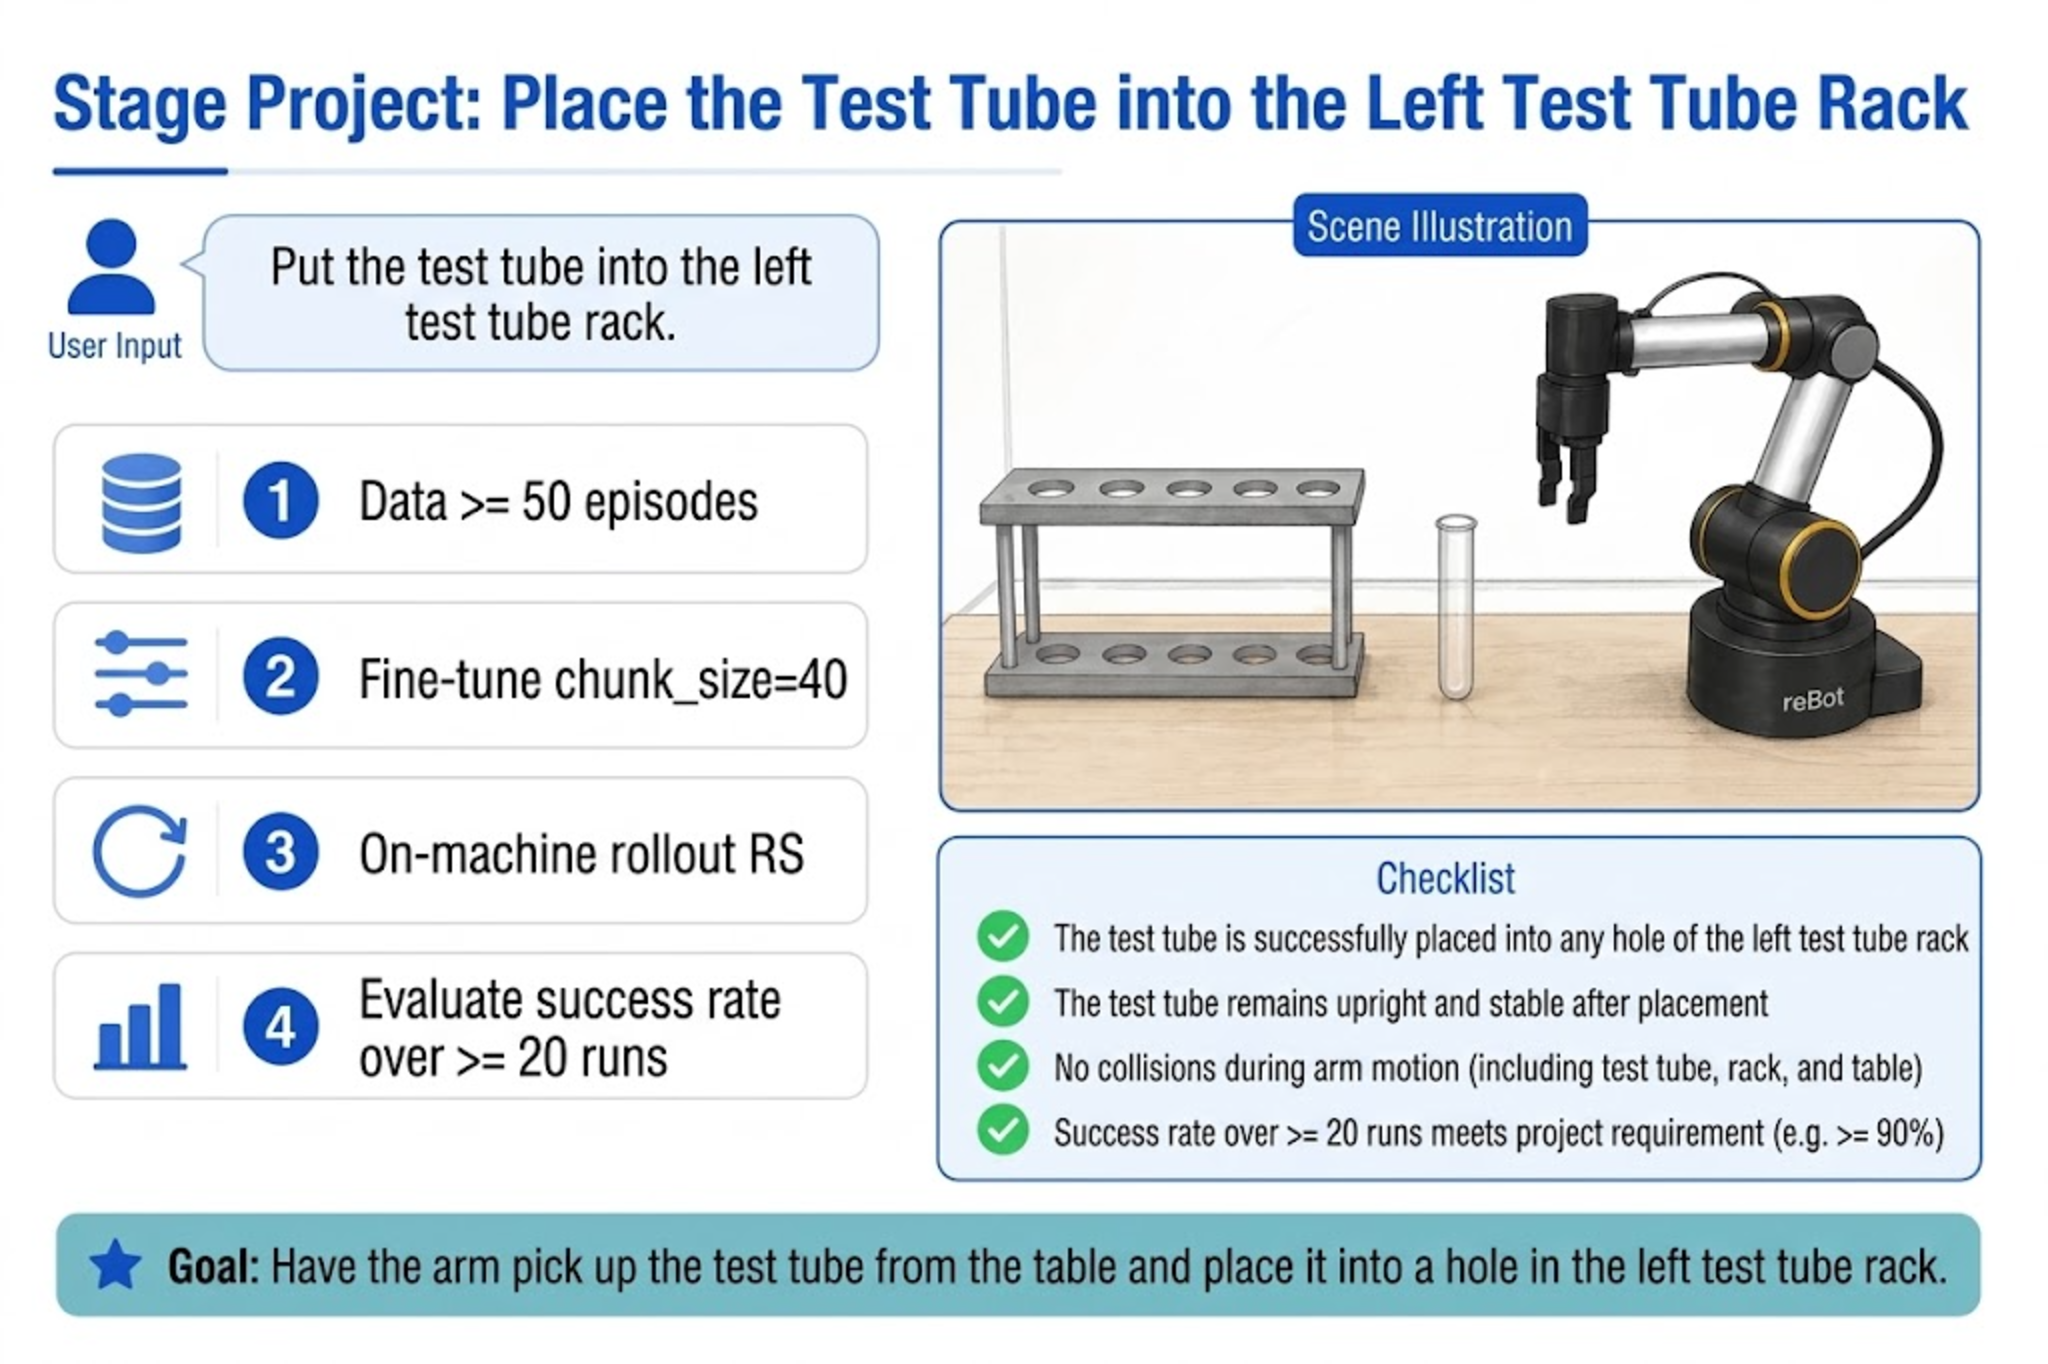
Objetivo del proyecto
| Elemento | Contenido |
|---|---|
| Entrada del usuario | Place the test tube into the left rack. |
| Entrada del sistema | Vista amplia front + muñeca side + estado actual de 7 dimensiones |
| Salida esperada | El brazo completa tomar el tubo -> moverse al estante izquierdo -> colocar -> soltar el efector final |
Pasos de implementación
-
Datos (si aún no cubren esta tarea)
- Recopila ≥ 50 demostraciones exitosas; anótalas de forma uniforme usando el patrón de frase anterior.
- Escribe
meta/modality.json(front/side,single_arm+gripper,human.task_description).
-
Ajuste fino (Capítulo 21)
embodiment_tag=new_embodiment,chunk_size=40.- Obtén
checkpoints/last/pretrained_model.
-
Inferencia de despliegue en máquina única (ejemplo B601-RS; para DM cambia
type/port/can_adapter)
export MODEL_PATH="outputs/train/${REPO_ID}/checkpoints/last/pretrained_model"

# RS CAN
sudo ip link set can0 down 2>/dev/null
sudo ip link set can0 type can bitrate 1000000
sudo ip link set can0 up

lerobot-rollout \
  --strategy.type=base \
  --policy.path=${MODEL_PATH} \
  --policy.base_model_path=nvidia/GR00T-N1.7-3B \
  --policy.embodiment_tag=new_embodiment \
  --policy.n_action_steps=20 \
  --robot.type=seeed_b601_rs_follower \
  --robot.port=can0 \
  --robot.id=follower1 \
  --robot.can_adapter=socketcan \
  --robot.cameras="{ front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30, fourcc: "MJPG"}, side: {type: opencv, index_or_path: 2, width: 640, height: 480, fps: 30, fourcc: "MJPG"}}" \
  --task="Place the test tube into the left rack." \
  --duration=90 \
  --device=cuda \
  --display_data=true \
  --inference.type=rtc \
  --inference.rtc.enabled=true \
  --inference.rtc.execution_horizon=20 \
  --inference.queue_threshold=0
- Evaluación
- Fija la disposición de la mesa, repite ≥ 20 veces y registra la tasa de éxito.
- Archiva los episodios fallidos con
lerobot-record; analiza si el error está en la localización, el agarre o la colocación.
Criterios de aceptación
- Dada la instrucción "Place the test tube into the left rack.", la tarea puede ejecutarse de extremo a extremo.
-
front/sidecoinciden con el entrenamiento, sin errores de claves del tipomean is infinity. - La parada de emergencia y los límites suaves funcionan; el movimiento puede interrumpirse manualmente ante un comportamiento anómalo.
- Registra la tasa de éxito y decide si el siguiente paso es más datos o ajustar
n_action_steps/ RTC.
22.11 Resumen del capítulo
22.11 Resumen del capítulo
- Desacoplamiento: el lado de control se encarga de la captura y la ejecución, el lado de inferencia se encarga del paso hacia delante de VLA; la interfaz es observación -> Action Chunk.
- Despliegue: comienza en máquina única y luego pasa a distribuido según sea necesario; el modo distribuido requiere especial atención a la latencia de red.
- Entradas: cámaras + estado + lenguaje deben alinearse estrictamente con el entrenamiento.
- Salida: consumir el bloque de acciones mediante
n_action_steps; RTC usa una cola para enmascarar el tiempo de inferencia. - Seguridad: los límites, la parada de emergencia y el recorte de velocidad se aplican en la capa de control.
- Evaluación: tasa de éxito + atribución de fallos; el proyecto de etapa valida el bucle cerrado "lenguaje -> acción de robot real".
Ahora has completado todo el recorrido desde la teoría de VLA, datos y ajuste fino hasta el despliegue de GR00T en robot real. Para futuras iteraciones, prioriza recopilar datos de escenarios de fallo en lugar de alargar ciegamente los pasos de entrenamiento.