9. Fundamentos del Aprendizaje de Robots y del Aprendizaje por Imitación
Capítulo 9 del Curso de Introducción a la IA Física de Seeed: por qué el brazo necesita aprendizaje, control basado en reglas vs. basado en aprendizaje, observación/estado/acción, fragmentos de acción, distribución de datos y las tres fases de entrenamiento, inferencia y evaluación.
9.1 ¿Por Qué los Brazos Robóticos Necesitan Aprendizaje?
9.1 ¿Por Qué los Brazos Robóticos Necesitan Aprendizaje?
En la Etapa 2, ya puedes controlar el brazo robótico con el SDK de Python: leer ángulos de las articulaciones, enviar posiciones objetivo, abrir y cerrar la pinza. Así que es natural pensar: solo hay que escribir un programa que haga que el brazo coja automáticamente los bloques de la mesa, ¿verdad?
Entonces escribes ese programa. Durante la primera demostración en el laboratorio, el programa funcionó muy bien. Pero al día siguiente, las cosas cambiaron, y descubrirás que, para manejar esos cambios, se van añadiendo cada vez más sentencias "if" al programa, hasta que acaba convirtiéndose en un enorme catálogo de casos especiales que nadie puede mantener.
Este es el dilema fundamental del control programático tradicional: el mundo real cambia de forma continua, mientras que if-else es discreto. No puedes enumerar todos los posibles estados del mundo.
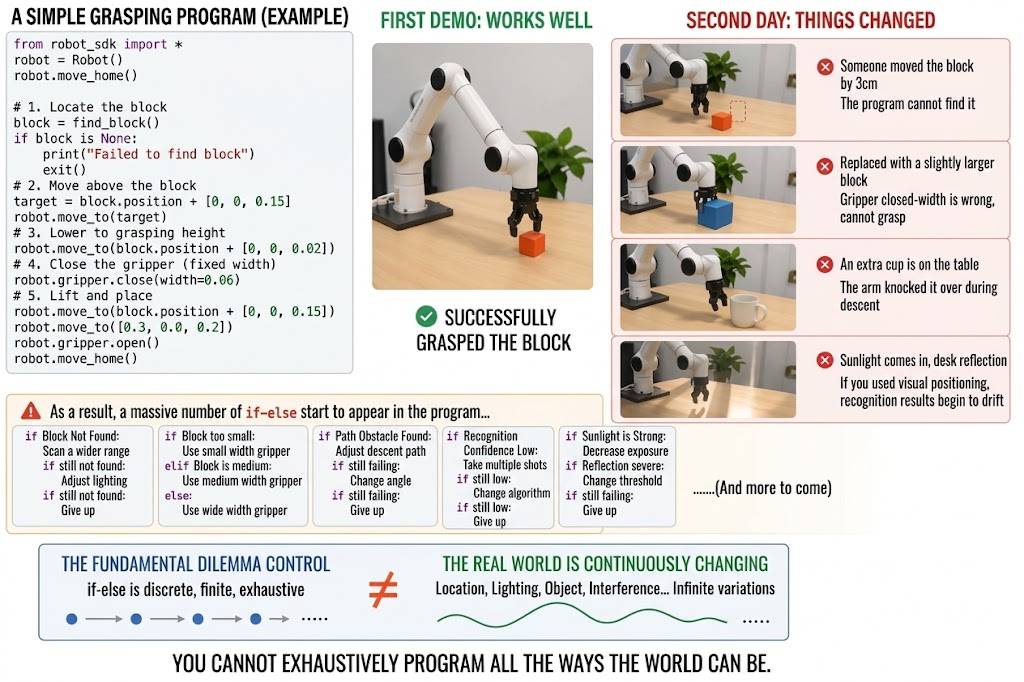
Permitir que los brazos robóticos adquieran habilidades de esta manera es precisamente lo que el Aprendizaje de Robots pretende resolver. Y el aprendizaje por imitación que se trata en esta etapa es el enfoque más maduro y más fácil de desplegar en hardware real.
9.2 Control Basado en Reglas vs. Control Basado en Aprendizaje
9.2 Control Basado en Reglas vs. Control Basado en Aprendizaje
Antes de continuar, pongamos los dos enfoques de control uno al lado del otro para verlos con claridad.
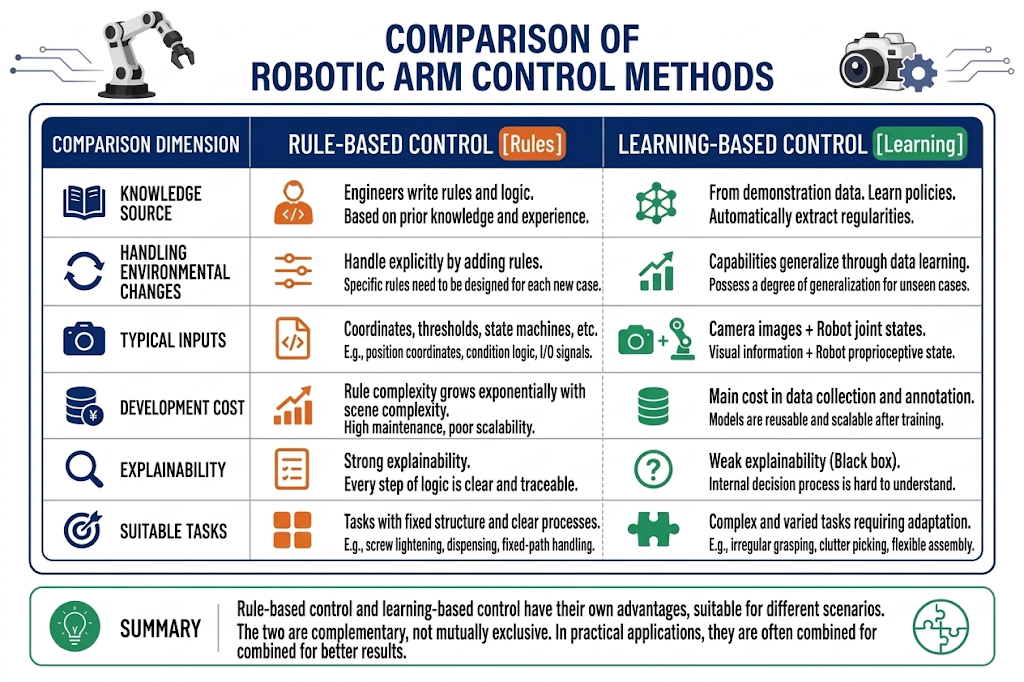
Las Etapas 3 y 4 de este curso siguen la vía del "control basado en aprendizaje". Pero recuerda: incluso en el futuro, tus sistemas de aprendizaje seguirán conservando una gran cantidad de reglas, como límites de articulaciones y restricciones de velocidad segura. El aprendizaje y las reglas son complementarios.
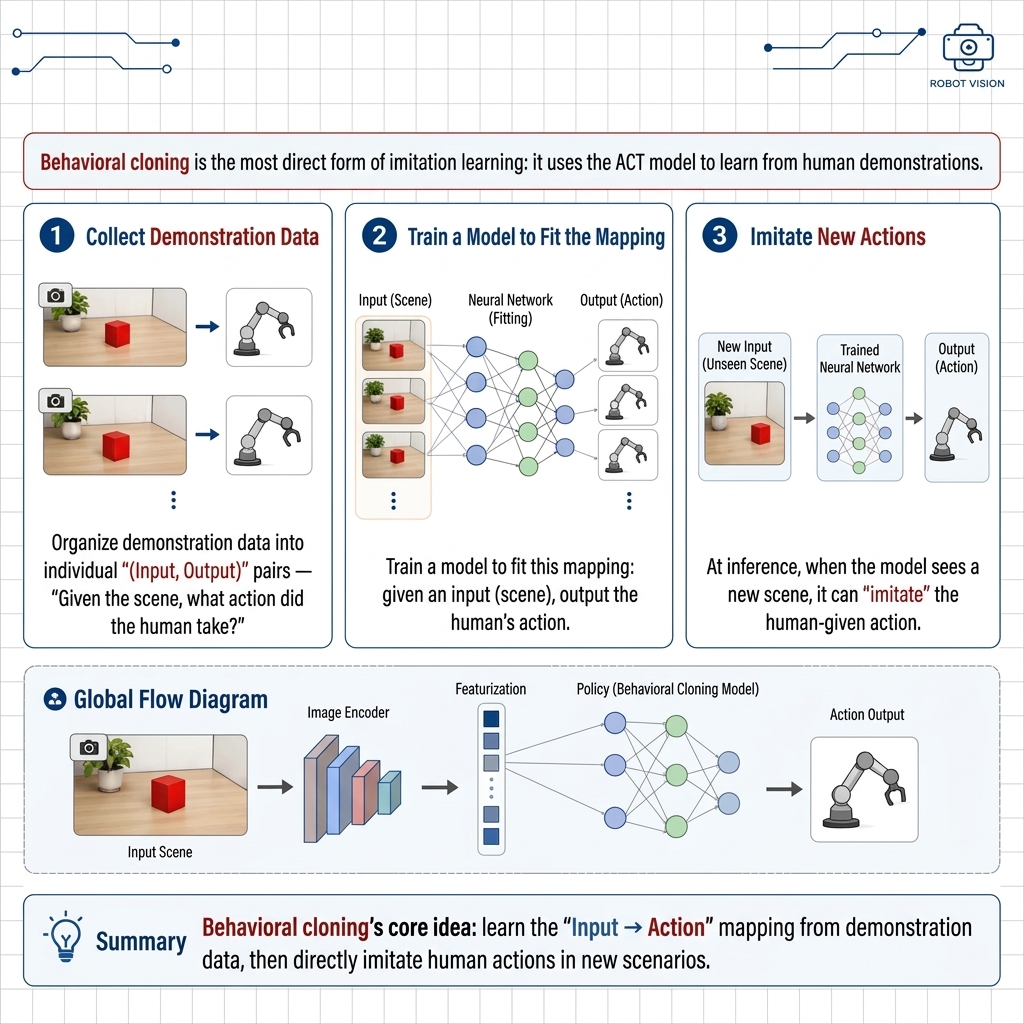
9.3 Aprendizaje por Imitación y Behavioral Cloning
9.3 Aprendizaje por Imitación y Behavioral Cloning
Qué es el Aprendizaje por Imitación
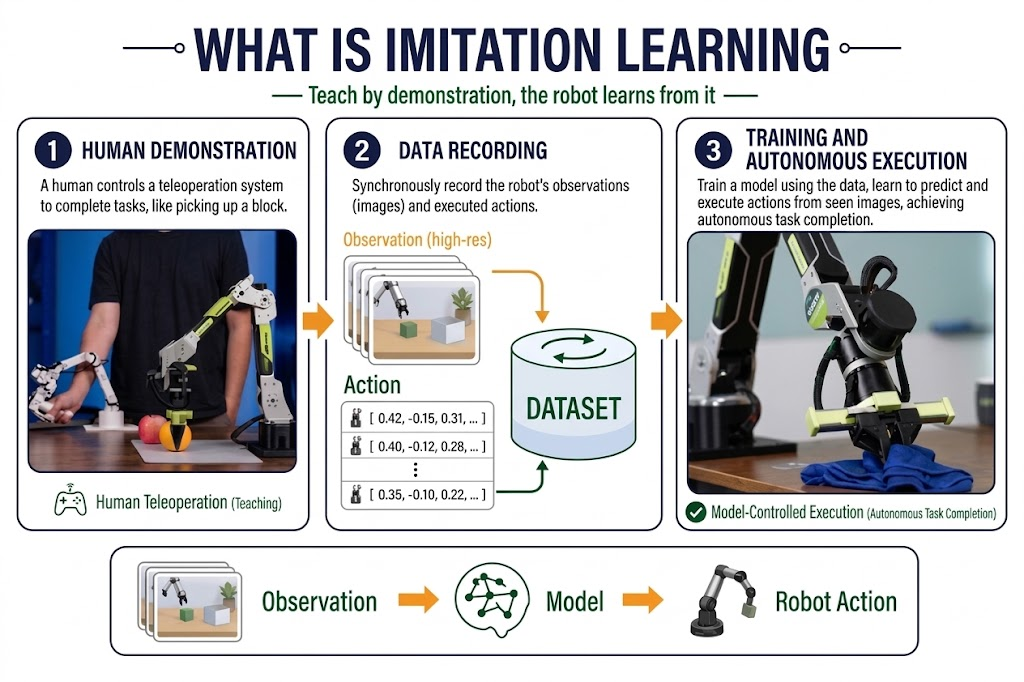
Qué es el Behavioral Cloning
9.4 Observación, Estado y Acción
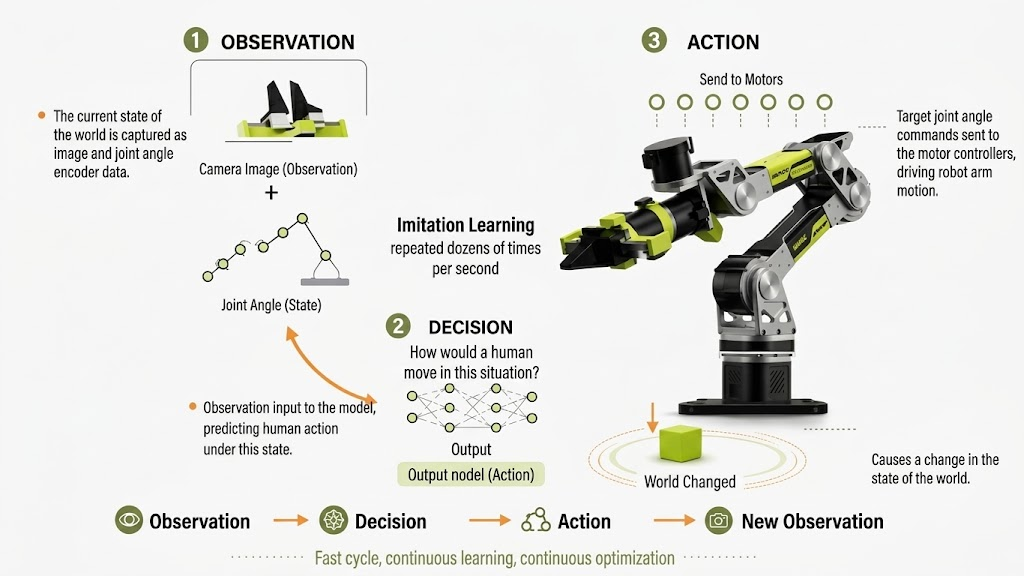
9.4 Observación, Estado y Acción
Todos los datos en el aprendizaje por imitación pueden clasificarse en tres conceptos. Estos tres términos aparecerán repetidamente en todos los capítulos siguientes, así que forma aquí una intuición precisa.
- Observación: el mundo que el robot "ve".
- Estado: la condición "propia" del robot.
- Acción: lo que el robot "va a hacer".
9.5 Acciones de un Solo Paso vs. Fragmentos de Acción
9.5 Acciones de un Solo Paso vs. Fragmentos de Acción
- Acción de un solo paso: una decisión por fotograma.
- Fragmento de acción: predecir una secuencia de acciones de una vez.
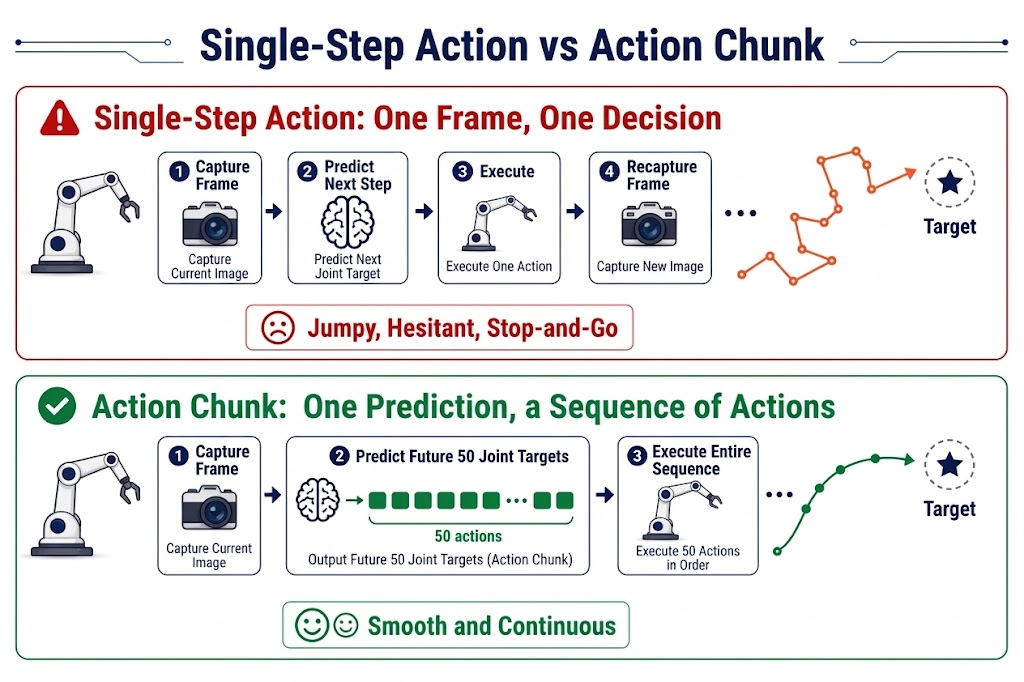
Por supuesto, los fragmentos de acción más largos no siempre son mejores. Predecir demasiado hacia adelante significa que el entorno puede cambiar a mitad de la ejecución (por ejemplo, un objeto se golpea), mientras el brazo sigue ejecutando acciones "desactualizadas". Los sistemas reales usan un compromiso: ejecutar en lazo abierto durante un segmento corto, luego volver a observar y volver a predecir.
9.6 Distribución de Datos y Generalización del Modelo
9.6 Distribución de Datos y Generalización del Modelo
Esta es la sección más importante de este capítulo, y la que los principiantes pasan por alto con más facilidad, pero que determina el éxito o el fracaso en la práctica. Recuerda primero esta frase:
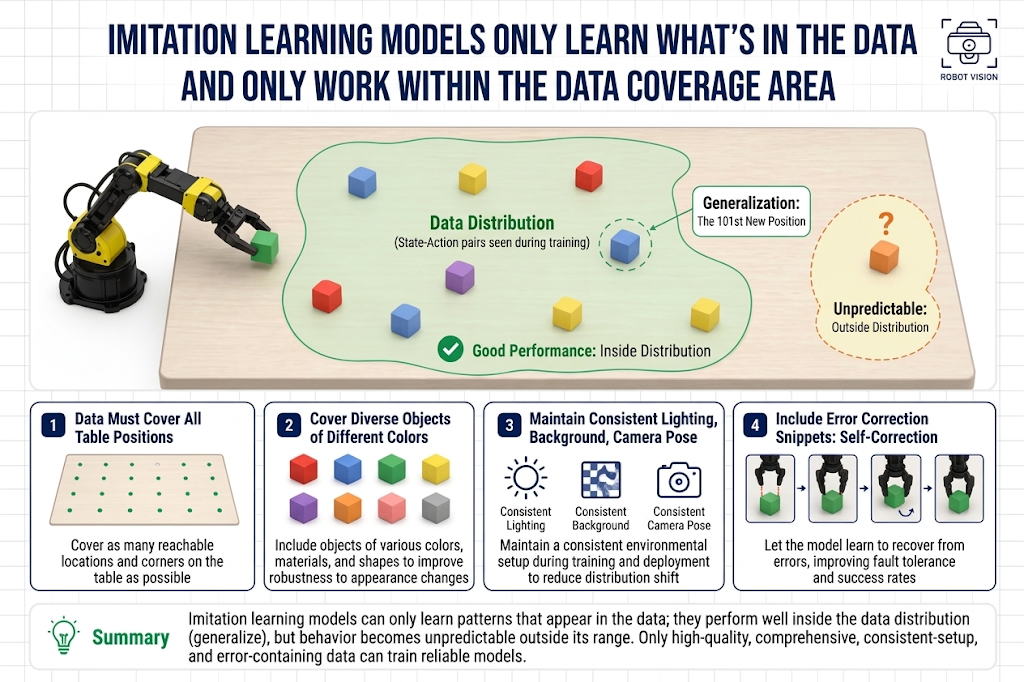
Un modelo de aprendizaje por imitación solo puede aprender lo que está en los datos y solo puede funcionar dentro del rango cubierto por los datos.
- Todos los pares (observación, acción) que el modelo vio durante el entrenamiento constituyen una Distribución de Datos. Durante la inferencia, si las imágenes y estados que encuentra el brazo caen dentro de esta distribución, el modelo generalmente se comporta bien; una vez que salen de la distribución, la salida del modelo pierde su base y el comportamiento se vuelve impredecible.
Esto conduce a varias implicaciones muy prácticas:
- Si quieres que agarre bloques en cualquier posición de la mesa, los datos deben cubrir todas las posiciones de la mesa; si solo recoges datos en el centro de la mesa, el modelo solo agarrará en el centro.
- Si quieres que agarre objetos de diferentes colores, los datos deben contener diferentes colores; de lo contrario, un color nuevo es un mundo desconocido para él.
- La iluminación, el fondo y la posición de la cámara deben mantenerse lo más consistentes posible con la recogida de datos; un modelo entrenado con datos recogidos por la tarde puede fallar por completo bajo la iluminación interior de la noche.
Y la generalización es la capacidad del modelo para aplicar patrones aprendidos de los datos a nuevas situaciones dentro de la distribución que no ha visto individualmente. Por ejemplo, si durante el entrenamiento vio bloques en 100 posiciones diferentes, y durante la inferencia aparece un bloque en la posición 101 (todavía sobre la mesa), el modelo aún puede agarrarlo: eso es generalización. La generalización no es magia; proviene de la diversidad de los datos: cuanto más rica y continua sea la cobertura de datos, más pequeños serán los "huecos" dentro de la distribución y mejor será la generalización.
El límite superior del aprendizaje por imitación se determina esencialmente en el momento en que se recogen los datos. El entrenamiento solo materializa ese límite superior.
9.7 Entrenamiento, Inferencia y Evaluación
9.7 Entrenamiento, Inferencia y Evaluación
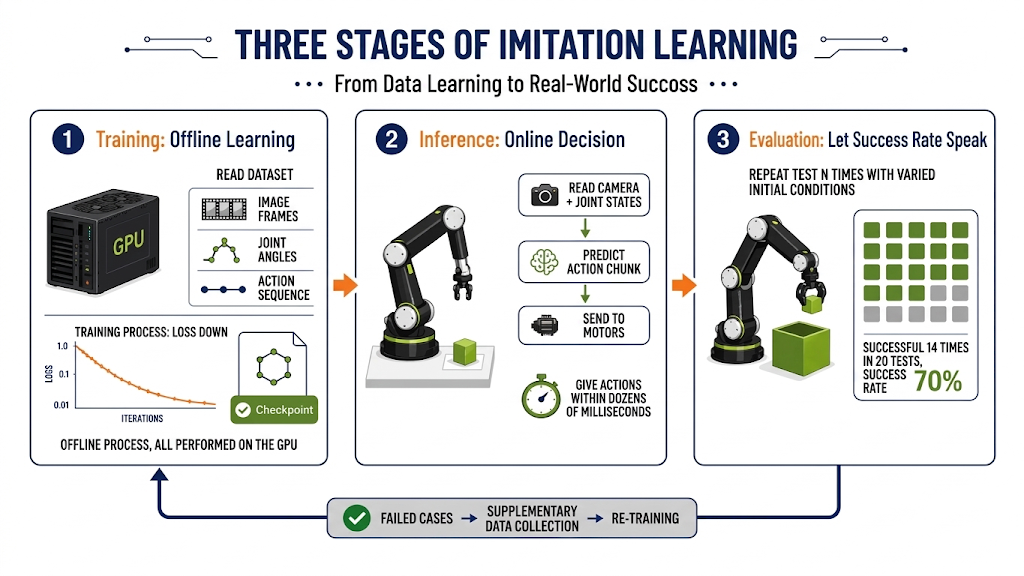
Entrenamiento: Aprendizaje Offline
El entrenamiento ocurre después de que la recogida de datos se ha completado; es un proceso offline: el brazo puede estar apagado y apartado; todo el trabajo se realiza en la GPU.
- Entrada: conjunto de datos recogido (series temporales de imágenes, Estado y Acción);
- Proceso: el modelo lee repetidamente los datos, ajustando continuamente sus parámetros internos para que sus Acciones predichas se parezcan cada vez más a las demostraciones humanas;
- Salida: un archivo de modelo entrenado.
La calidad del entrenamiento se observa principalmente a través de la Pérdida (Loss): a medida que la Pérdida disminuye, las acciones predichas por el modelo se parecen cada vez más a las demostraciones humanas.
Inferencia: Toma de Decisiones Online
La inferencia es el proceso en el que el modelo se despliega en el robot real y trabaja en tiempo real: leer la cámara y los estados de las articulaciones → el modelo predice un Fragmento de Acción → se envía a los motores para su ejecución. La inferencia tiene requisitos de tiempo real: el modelo debe producir acciones en decenas de milisegundos, de lo contrario el brazo se moverá a trompicones.
Evaluación: Juzgada por la Tasa de Éxito
El modelo está entrenado, la Pérdida es baja: ¿puede realmente hacer el trabajo? No necesariamente.
Una Pérdida baja solo significa que el modelo es "similar a un humano", no que "puede completar la tarea". El único método de evaluación fiable es la prueba con el robot real:
- Establecer criterios claros de éxito de la tarea (por ejemplo, "el bloque termina dentro de la caja");
- Variar las condiciones iniciales (posición del bloque, iluminación), repetir la prueba N veces;
- Calcular la tasa de éxito de la tarea; por ejemplo, 14 éxitos de 20 pruebas = 70% de tasa de éxito.
Los casos de fallo encontrados durante la evaluación no son puntos finales; son la entrada para la siguiente ronda de recogida de datos: dondequiera que se produzcan fallos, recoge datos adicionales allí y vuelve a entrenar. Este es el bucle de iteración de datos, y es la rutina diaria de los proyectos reales de aprendizaje de robots.
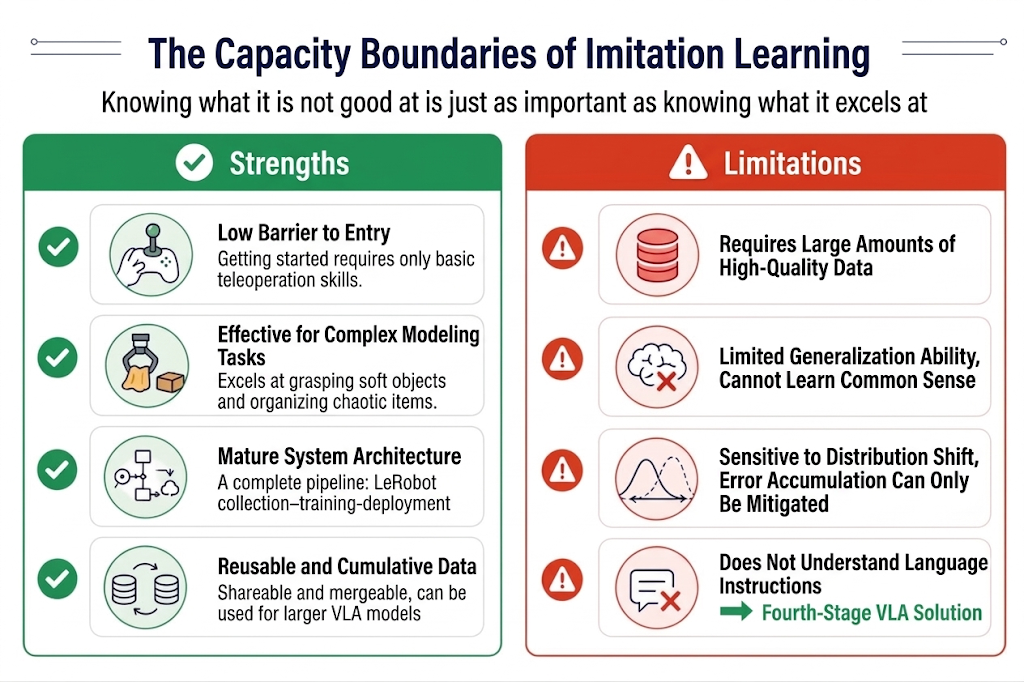
9.8 Ventajas y Limitaciones del Aprendizaje por Imitación
9.8 Ventajas y limitaciones del aprendizaje por imitación