Arquitectura del sistema de chat con IA de reSpeaker Clip
Una guía en lenguaje sencillo sobre cómo funciona el sistema de chat del Agente de IA de reSpeaker Clip. Todo lo que aparece aquí se deriva del README y del código real en backend/.
1. Descripción general
El sistema es un asistente de IA centrado en la voz, construido sobre Flask + LangGraph + Groq. Hablas o escribes un mensaje, el agente decide cómo manejarlo, opcionalmente llama a herramientas, produce una respuesta y te la devuelve hablada.
La canalización, a grandes rasgos:
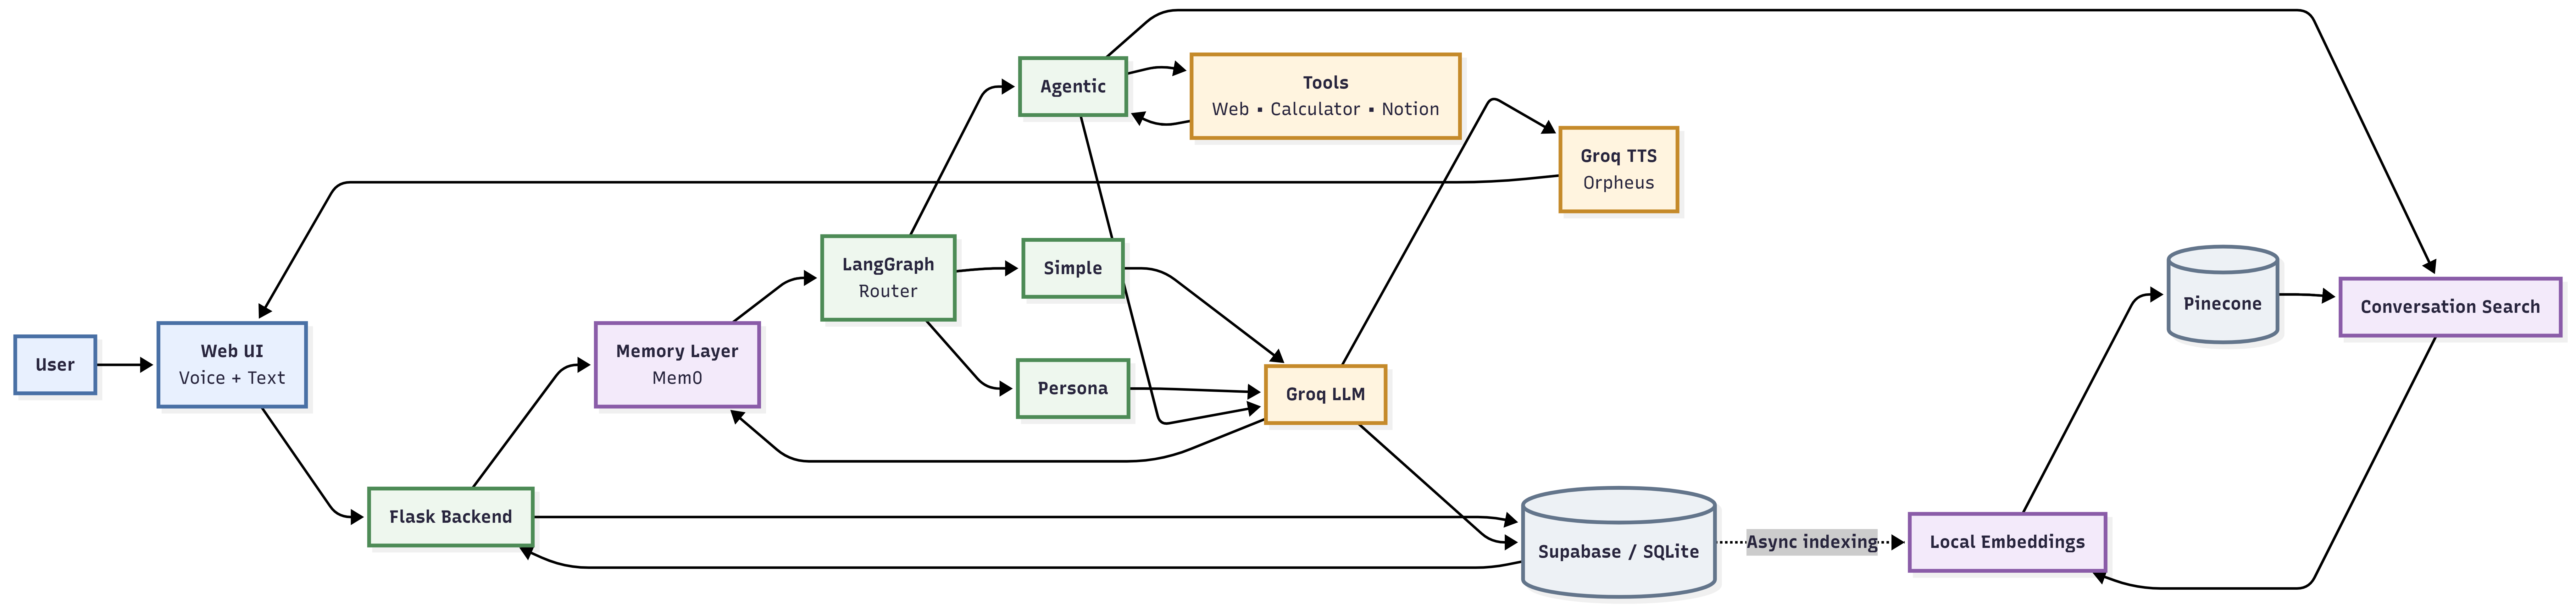
Tres ideas hacen que esto funcione:
- Un enrutador clasifica cada solicitud en una de tres rutas.
- Un agente en una de esas rutas puede llamar a herramientas (búsqueda web, calculadora, Notion, búsqueda en conversaciones pasadas).
- Un almacén vectorial + una capa de memoria permiten que el agente recuerde tus conversaciones pasadas y hechos a largo plazo.
2. Diagrama de arquitectura del sistema
Las piezas encajan así:
- Flask es la superficie del API (chat, streaming, voz, TTS).
- LangGraph es la máquina de estados que enruta la solicitud y ejecuta el nodo elegido.
- Groq proporciona el LLM, speech-to-text (Whisper) y text-to-speech (Orpheus).
- Mem0 suministra la memoria a largo plazo; Pinecone + embeddings locales proporcionan la búsqueda en conversaciones pasadas.
- Supabase (con un respaldo en SQLite) almacena conversaciones, mensajes y resúmenes.
3. Las tres rutas de enrutamiento
Cada solicitud se enruta exactamente a uno de tres nodos. El código asigna la cadena de ruta a un nodo en backend/graph/graph.py:
simple — Chat sin contexto
- Una respuesta simple de LLM. Sin herramientas, sin personalidad especial.
- Se usa para preguntas generales, explicaciones y conversación normal.
- Nodo:
simple_node(backend/graph/nodes/simple.py), LLM = el modelo principal de Groq.
context — Agente (con herramientas)
- La solicitud puede necesitar información externa o una herramienta (web, matemáticas, Notion, conversaciones pasadas).
- Este nodo construye un agente de LangChain con
create_agenty permite que el modelo llame a herramientas en un bucle. - Nodo:
agentic_node(backend/graph/nodes/agentic.py), LLM = un modelo dedicado a llamadas de herramientas (gpt-oss-20b).
persona — Con estilo
- El usuario pide explícitamente un estilo, personalidad, rol o estilo de enseñanza.
- Misma mecánica que
simple, pero con un prompt de sistema diferente que indica al modelo que adapte su tono. - Nodo:
persona_node(backend/graph/nodes/persona.py), LLM = el modelo principal de Groq.
4. Lógica de clasificación
El enrutamiento ocurre en router_node (backend/graph/router.py) usando una precomprobación de palabras clave seguida de una clasificación con LLM.
-
Precomprobación de palabras clave (ruta rápida). La transcripción se escanea en busca de palabras clave de herramientas. Si alguna coincide, la ruta se fuerza a
contexty el LLM se omite por completo:notion, to-do, todo, task list, to do list, calendar,
schedule, reminder, note down, create a task, add a taskEjemplo: "add a task to my to-do list" ni siquiera llega al clasificador.
-
Clasificación con LLM. De lo contrario, la solicitud se envía al modelo principal de Groq con el
ROUTER_PROMPT, que es un prompt de clasificación que devuelve exactamente una palabra:Ruta Entrada que la dispara simplePreguntas generales, explicaciones, conversación normal, sin necesidad de herramientas/persona contextPuede necesitar información/herramientas externas, gestión de datos (Notion/calendario), preguntas sobre el dispositivo/archivos/información almacenada del usuario personaEl usuario pide explícitamente un estilo, personalidad, estilo de enseñanza, rol o comportamiento -
Fallback. La salida se pasa a minúsculas y se recortan espacios. Cualquier cosa que no esté en
{simple, context, persona}recae ensimple.
5. Sistema de herramientas del agente
Cómo funciona la llamada a herramientas
La ruta context usa create_agent de LangChain (backend/graph/nodes/agentic.py). El bucle se ve así:
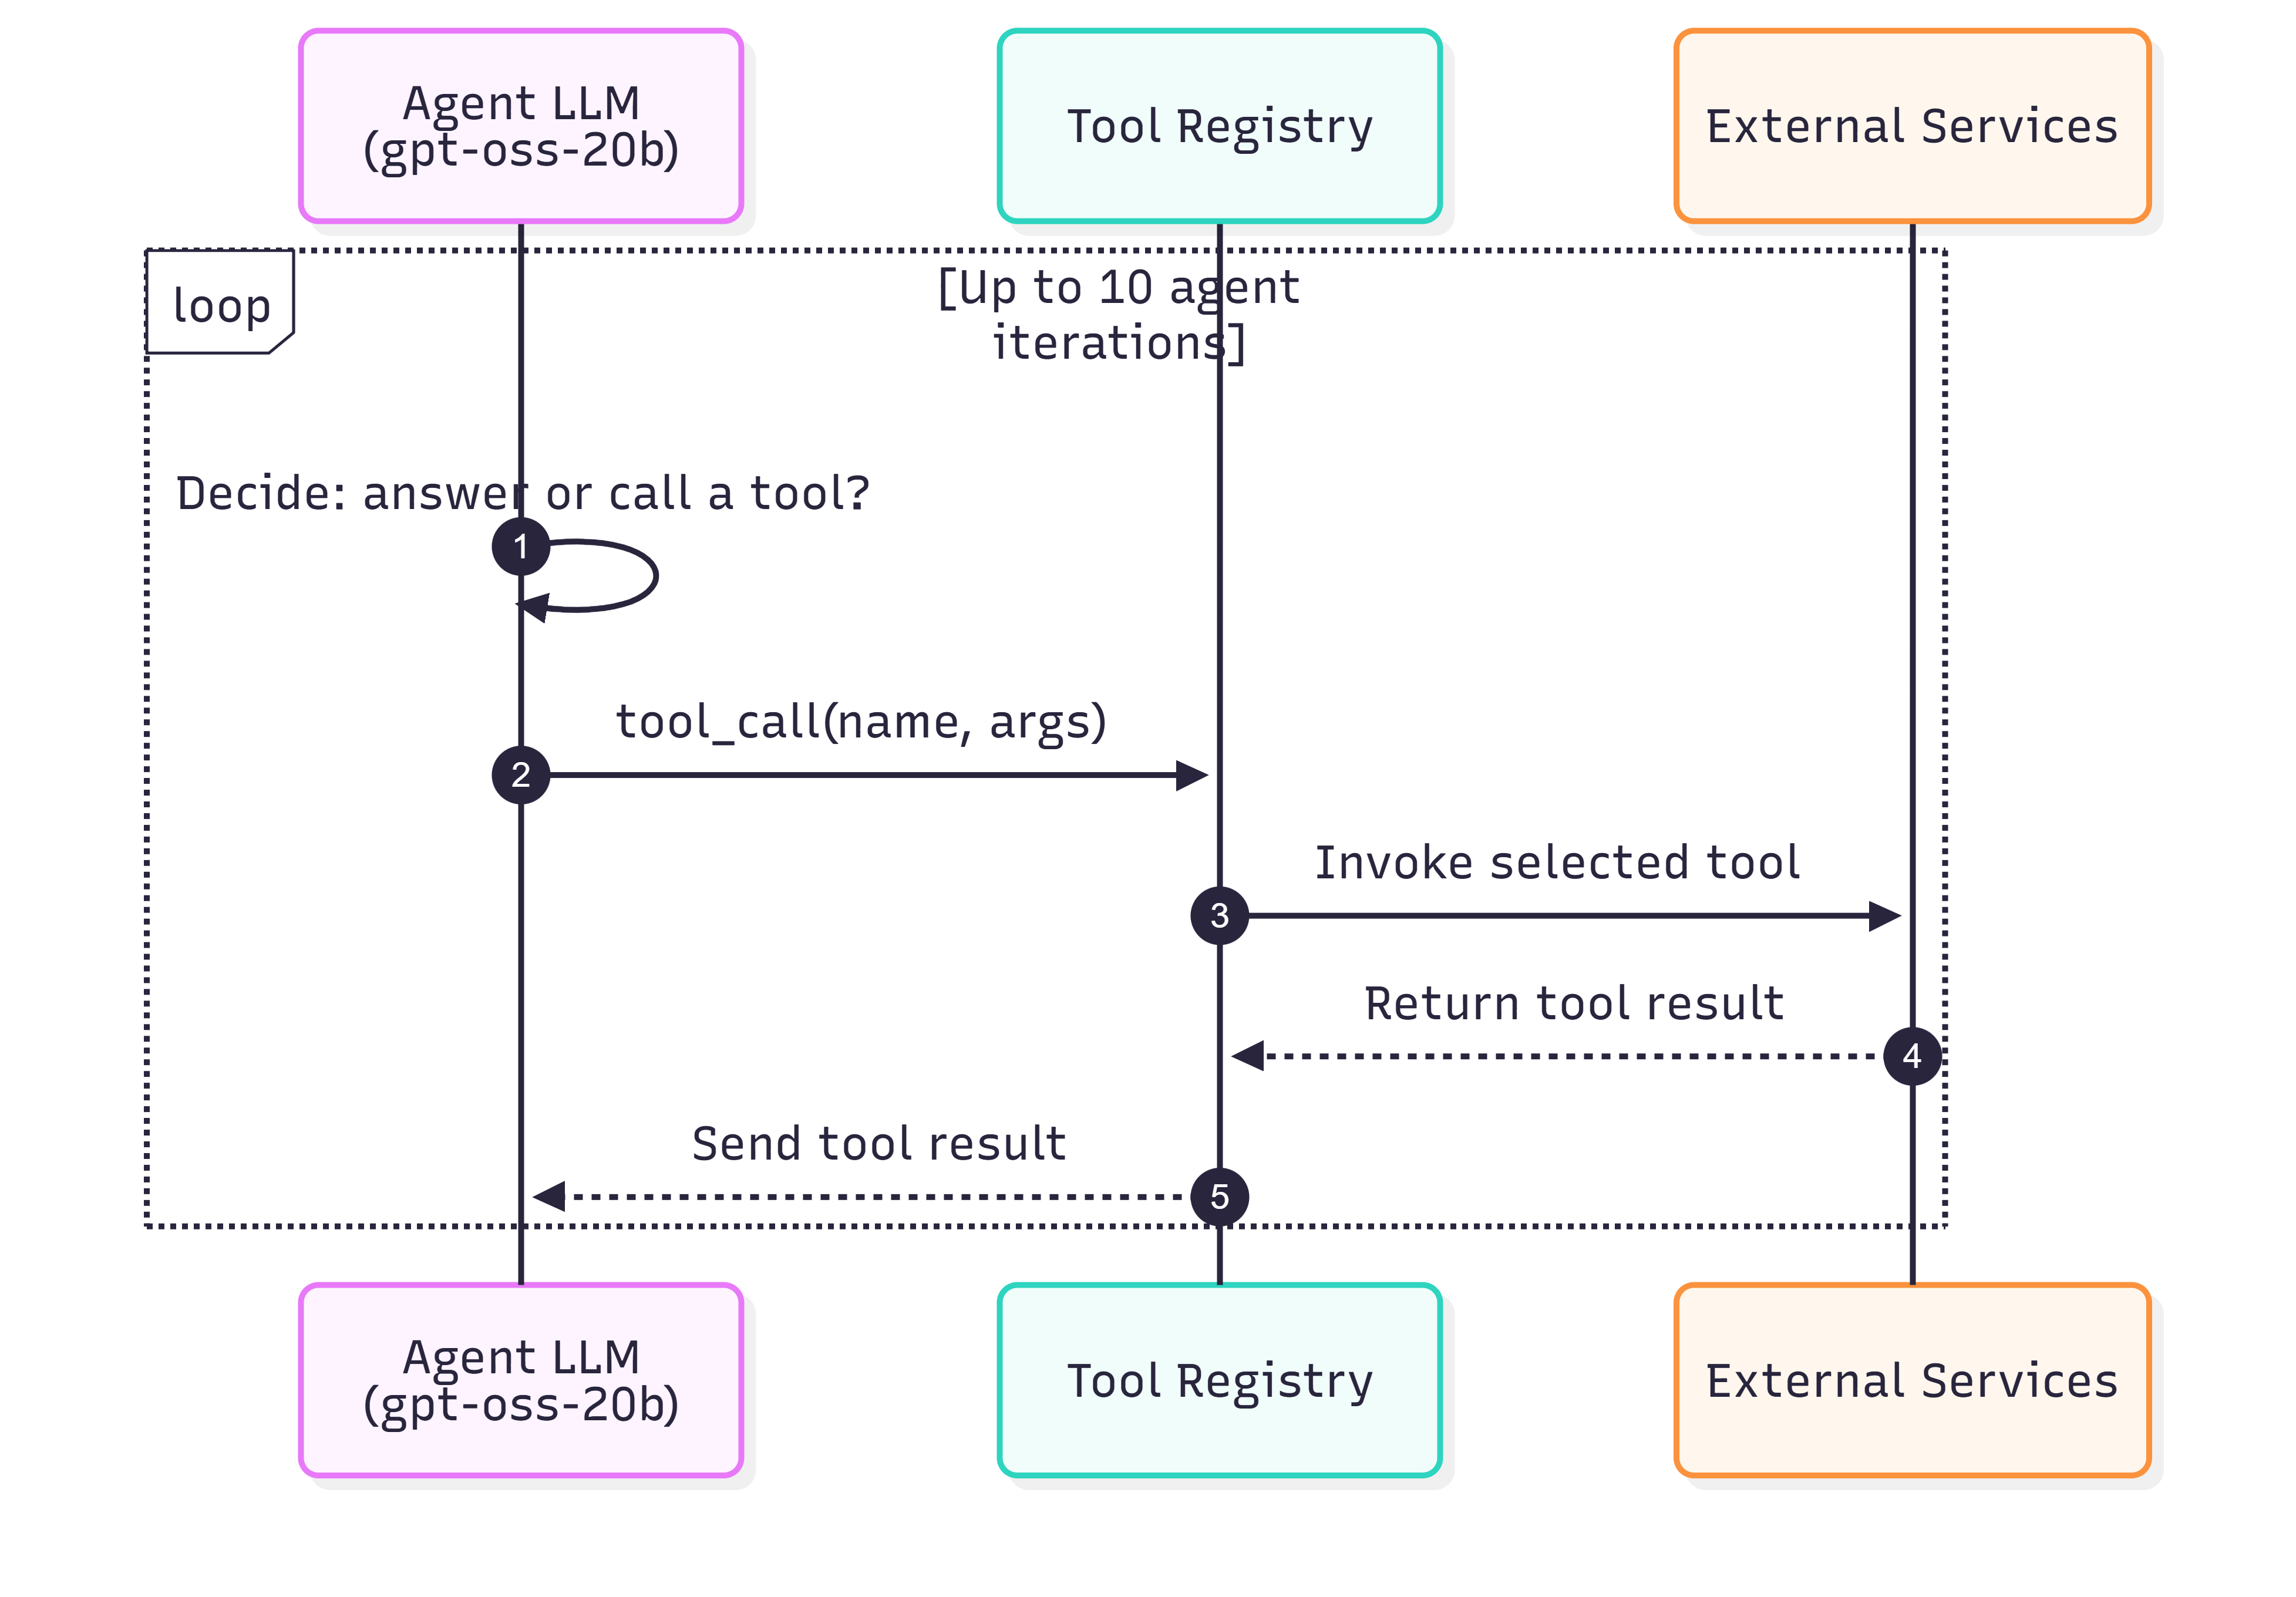
Detalles a tener en cuenta:
- El agente se almacena en caché y solo se reconstruye si cambia la firma de las herramientas (
_get_agent). - Lógica de reintento: hasta
MAX_RETRIES = 3intentos; los errores transitoriostool_use_failedse reintentan con una espera de 1 s. - Barandilla de seguridad: la recursión se limita a
MAX_AGENT_ITERATIONS = 10. Si se alcanza el límite, el agente devuelve un mensaje fijo de "I hit my limit…" en lugar de fallar. - El prompt de sistema indica al modelo que use el número mínimo de llamadas a herramientas y responda tan pronto como tenga suficiente información.
- Durante el streaming SSE, cada llamada a herramienta se muestra en la interfaz como un evento
thinking({"tool": "web_search"}).
Herramientas disponibles
get_available_tools() (backend/tools/registry.py) devuelve todo lo que el agente puede llamar:
| Herramienta | Servicio de respaldo | Propósito | Clave(s) de configuración |
|---|---|---|---|
calculator | local, evaluación AST segura | Matemáticas mediante un evaluador con lista blanca de + - * / ** % | — (siempre disponible) |
search_conversations | Pinecone + embeddings locales | Encontrar las propias conversaciones pasadas del usuario por relevancia | PINECONE_API_KEY |
composio_search | Composio | Buscar herramientas de apps de Composio que coincidan con una solicitud en lenguaje natural | COMPOSIO_API_KEY |
composio_execute | Composio | Ejecutar una herramienta encontrada por slug con argumentos JSON | igual |
composio_connect | Composio | Autorizar un conjunto de herramientas (por ejemplo, github) mediante un Connect Link | igual |
web_search | Tavily | Información web en vivo/actual (noticias, firmware, detalles de productos) | TAVILY_API_KEY |
add_todo | Notion | Añadir una tarea a la lista de pendientes | NOTION_API_KEY / NOTION_DATABASE_ID |
list_todos | Notion | Listar tareas con su estado | igual |
complete_todo | Notion | Marcar una tarea como hecha (coincide por nombre/palabra clave) | igual |
delete_todo | Notion | Eliminar una tarea (coincide por nombre/palabra clave) | igual |
- Las herramientas de Notion solo se añaden si Notion está configurado.
- Las herramientas que no están configuradas devuelven un mensaje amigable (por ejemplo, "Web search is unavailable…"), de modo que el sistema se degrada de forma elegante.
Herramientas configuradas
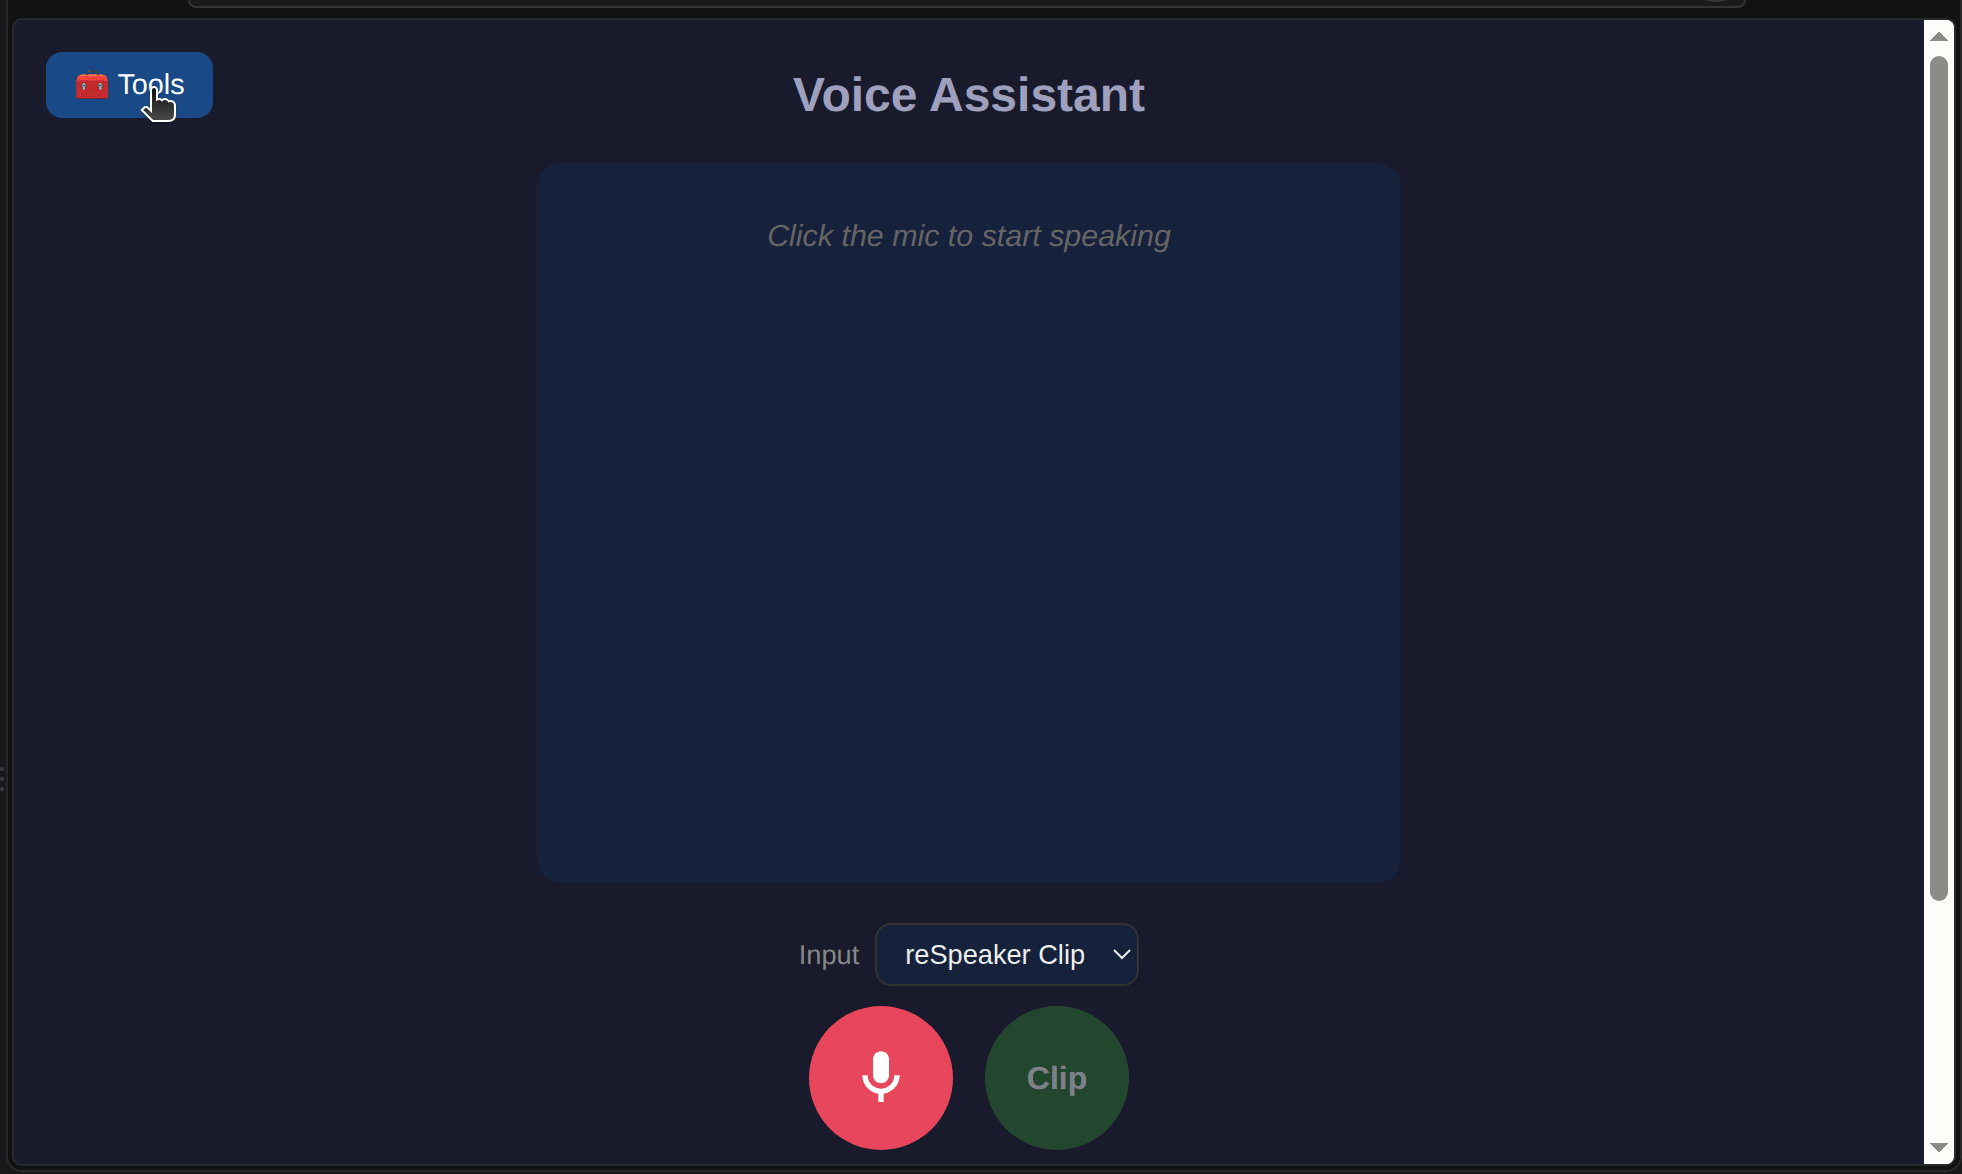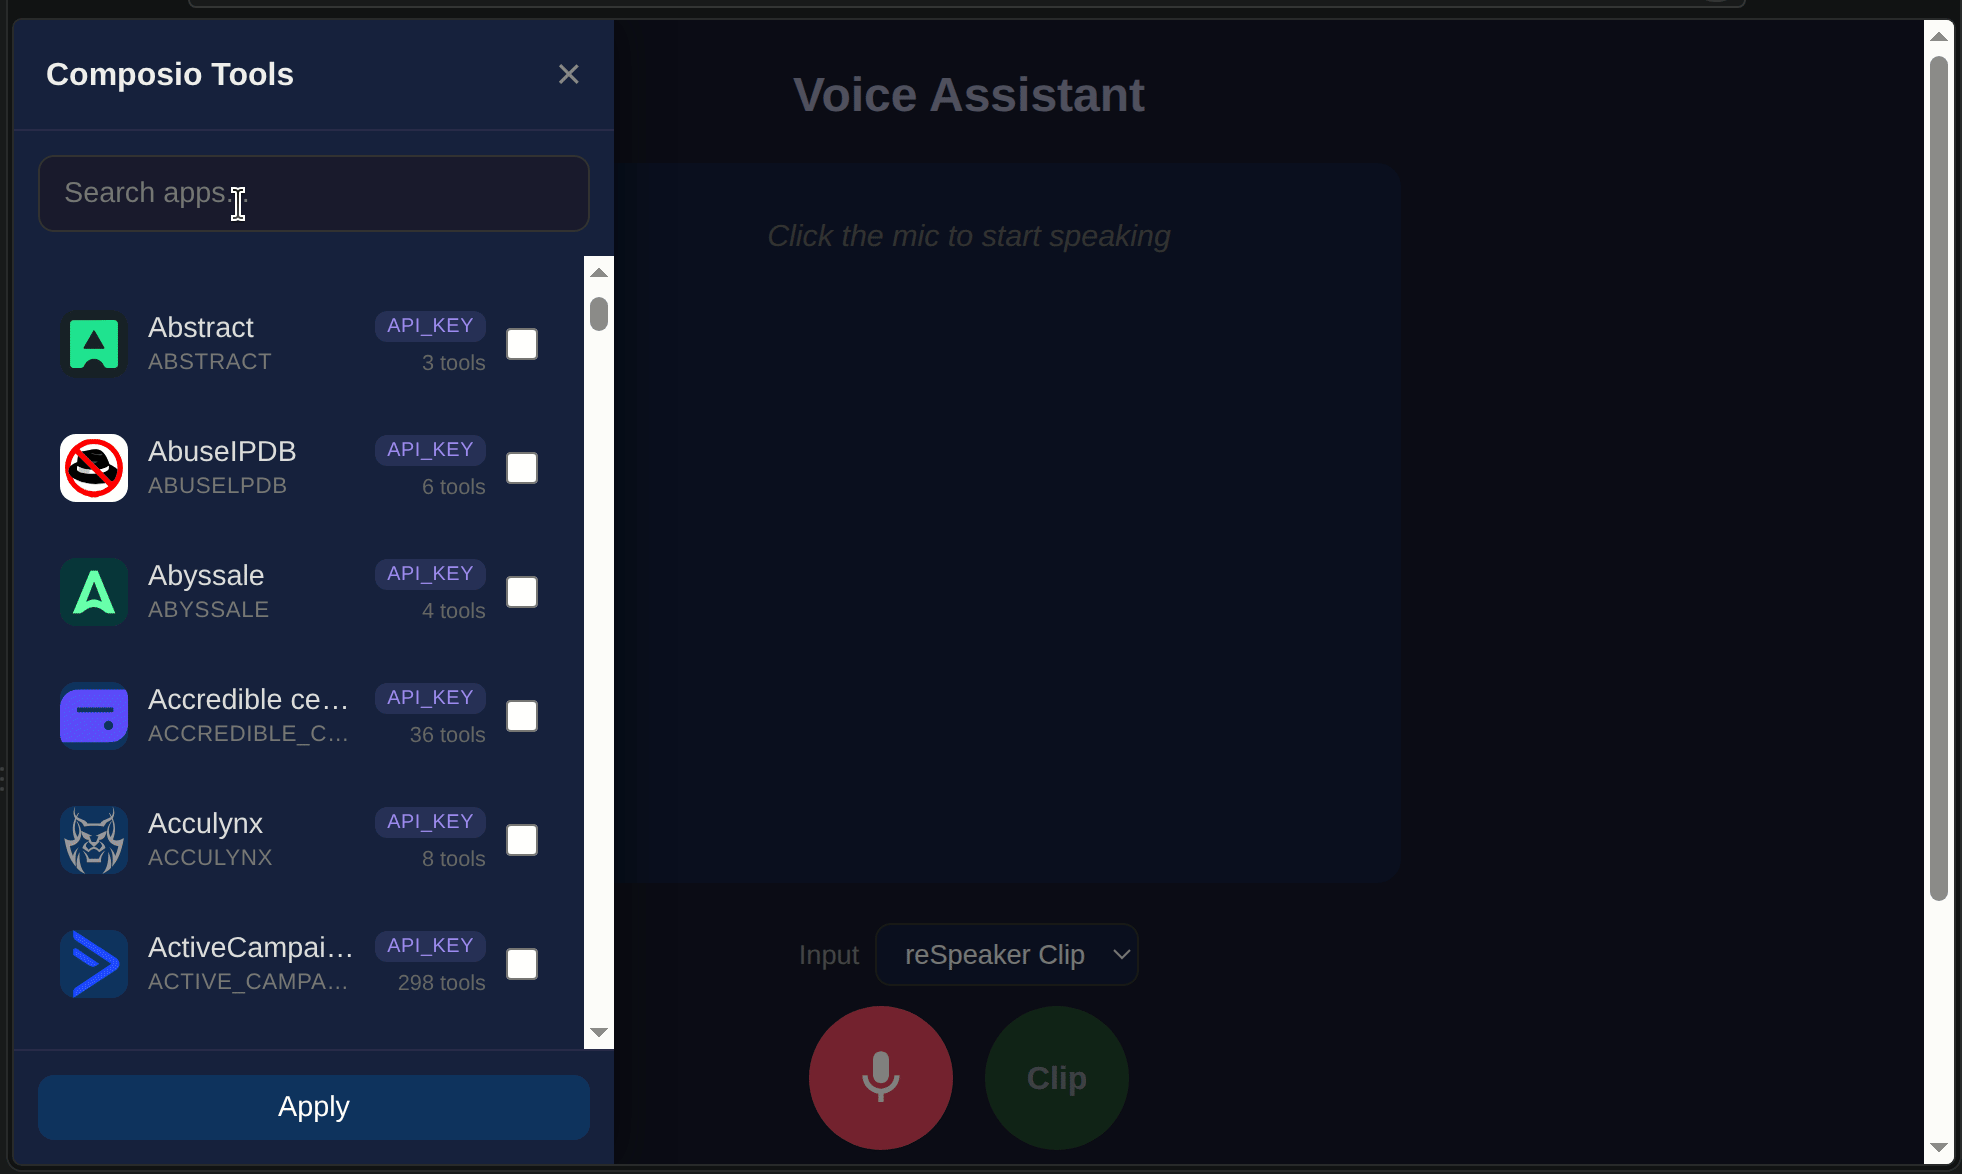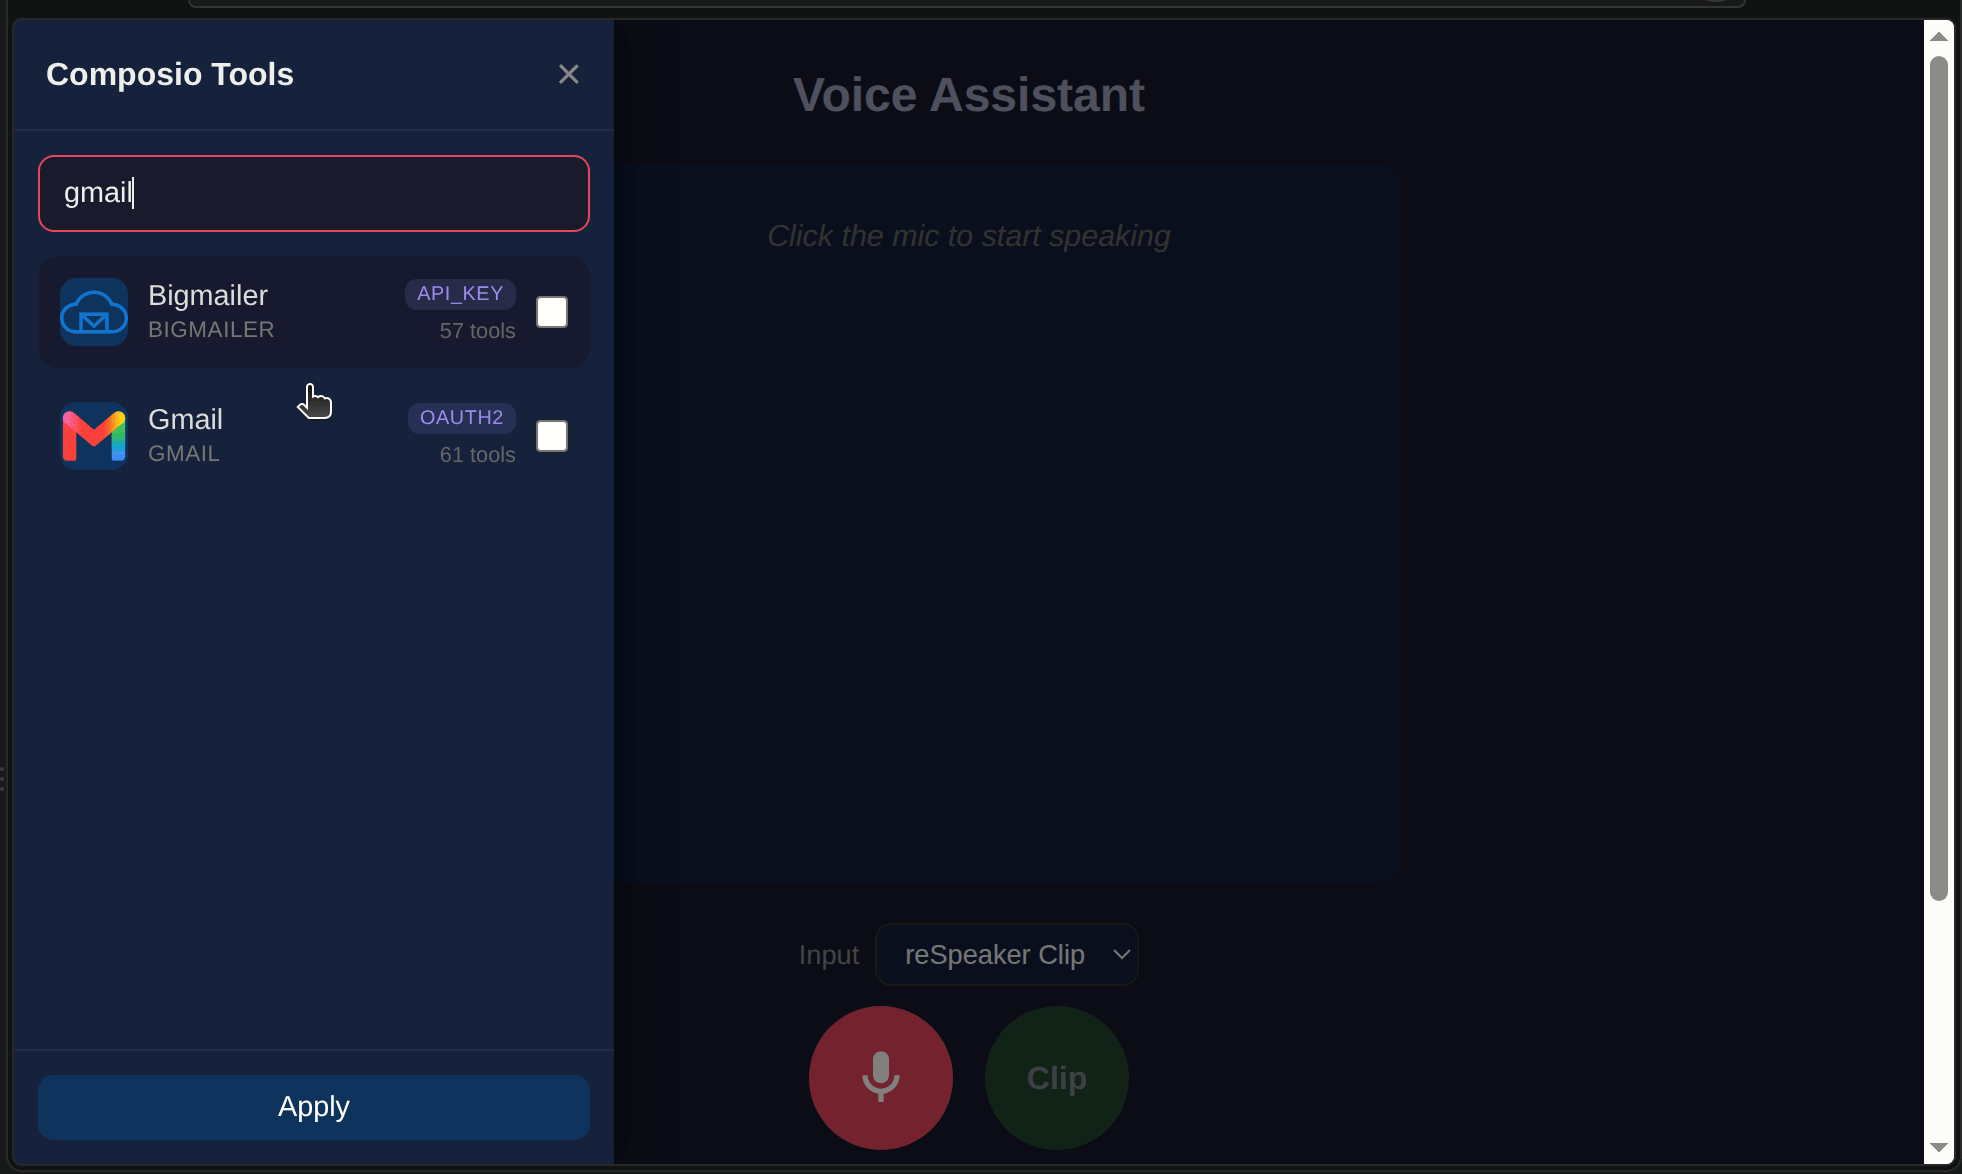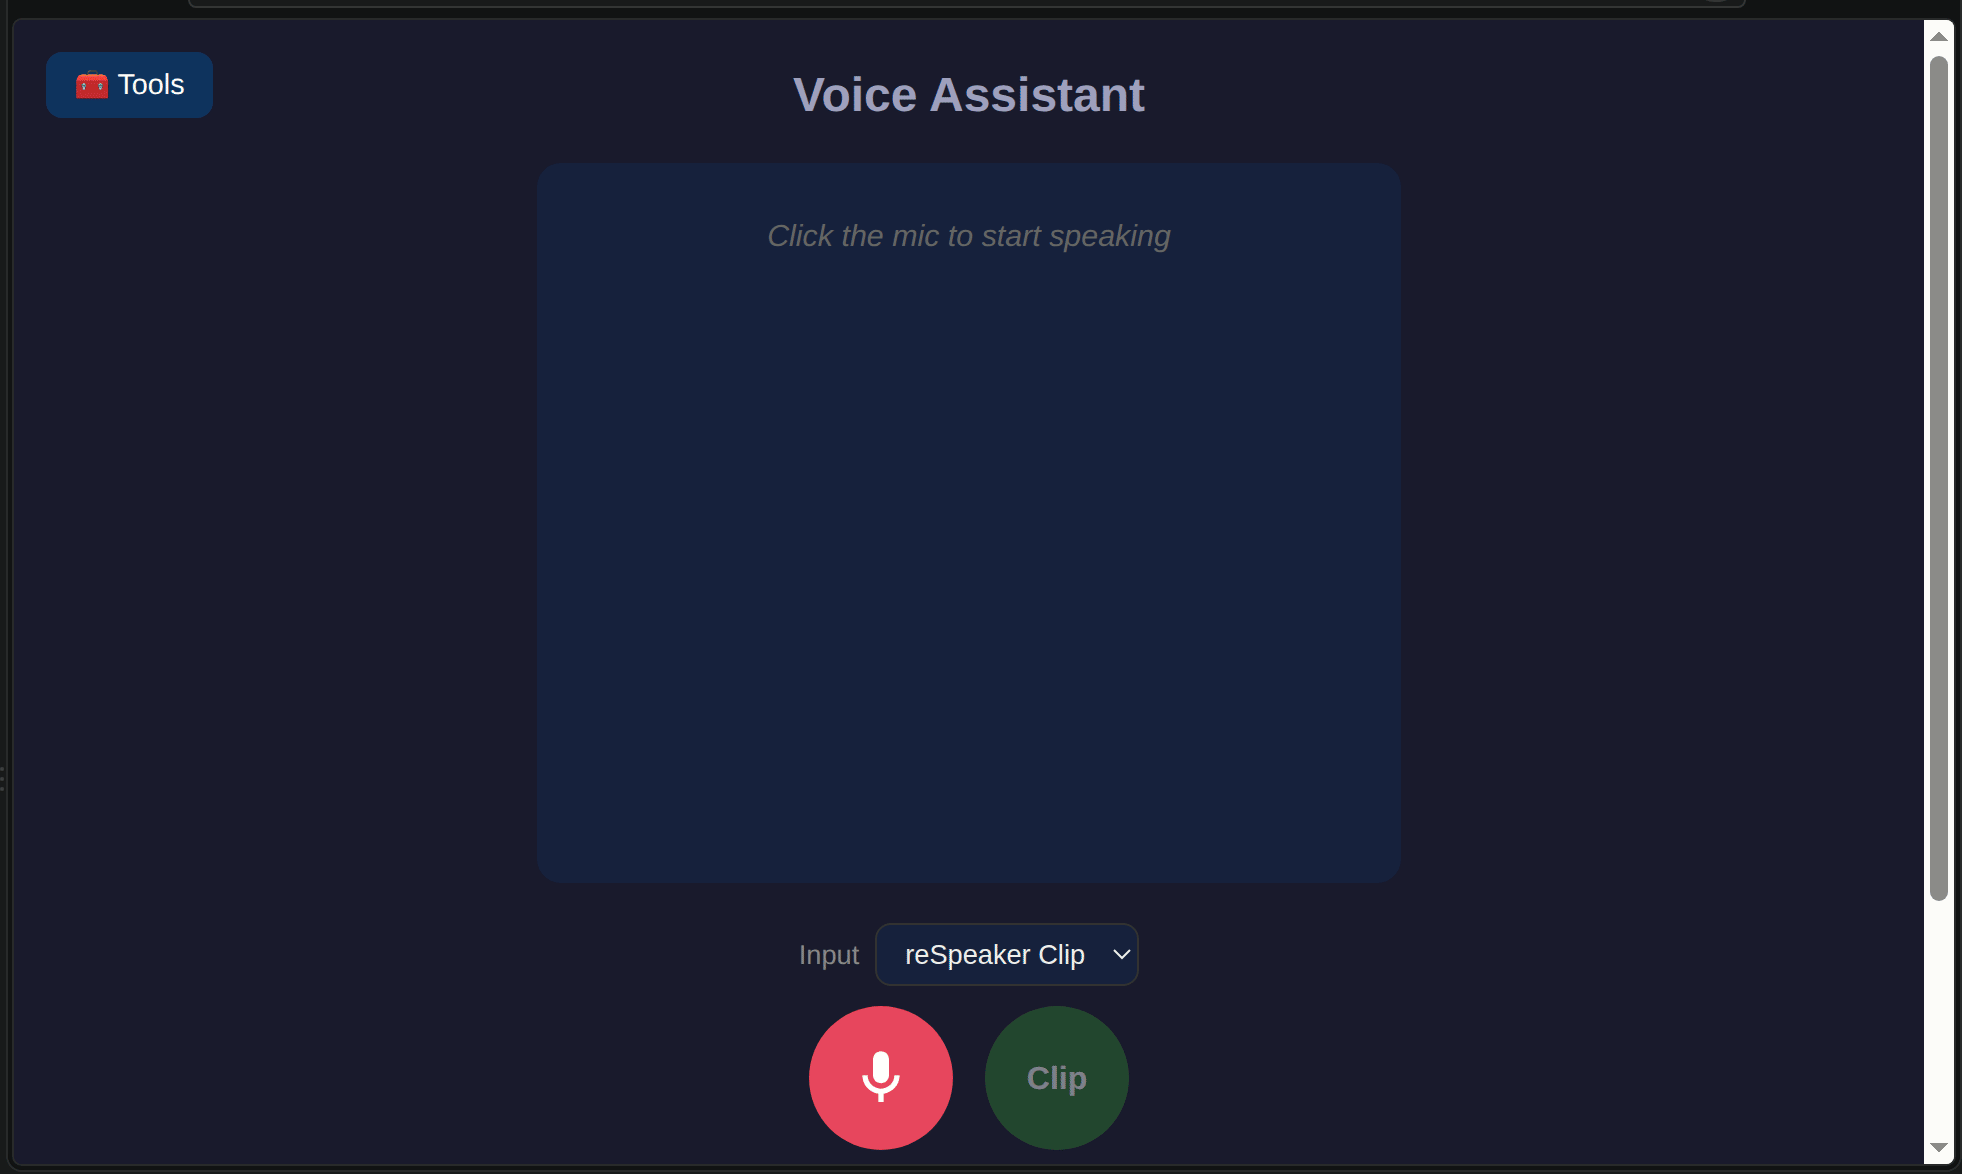
6. Análisis detallado de la búsqueda vectorial
Configuración
Todos los ajustes de vectores viven en config.py / .env:
| Ajuste | Valor por defecto | Significado |
|---|---|---|
PINECONE_API_KEY | — | Habilita la búsqueda vectorial |
PINECONE_INDEX_NAME | conversations | Nombre del índice de Pinecone |
PINECONE_CLOUD | aws | Proveedor serverless |
PINECONE_REGION | us-east-1 | Región serverless |
EMBEDDING_MODEL | all-MiniLM-L6-v2 | Modelo local de sentence-transformers |
EMBEDDING_DIM | 384 | Dimensión del vector (debe coincidir con el índice) |
Al iniciar, init_index() crea automáticamente el índice de Pinecone si no existe (dimensión 384, métrica cosine, serverless).
Qué se incrusta frente a lo que se almacena como metadatos
El diseño mantiene los vectores pequeños y pone todo lo demás en metadatos:
- Incrustado (vector):
"<title>\n\n<overview>"— un breve resumen semántico de la conversación. - Metadatos:
user_id,conversation_id,title,created_at. - No está en el almacén vectorial en absoluto: la transcripción completa. Los turnos reales de la conversación viven en Supabase/SQLite y se obtienen por id después de una coincidencia.
El id del vector es "{user_id}-{conversation_id}", por lo que es estable por usuario y por conversación.
Creación de vectores (ruta de escritura)
Después de cada turno de chat/voz, el sistema lanza un hilo en segundo plano (index_conversation_async → summarize_and_index en backend/services/conversation_service.py):
Detalles:
- Las conversaciones con menos de
MIN_TURNS = 2turnos se omiten. - El título/resumen se genera con el LLM principal de Groq usando un prompt de dos líneas (
Title:/Overview:). - Las incrustaciones se normalizan (compatibles con coseno).
- Todo esto es asíncrono (un hilo daemon), por lo que la respuesta al usuario nunca se bloquea por la indexación.
Consulta de vectores (ruta de lectura)
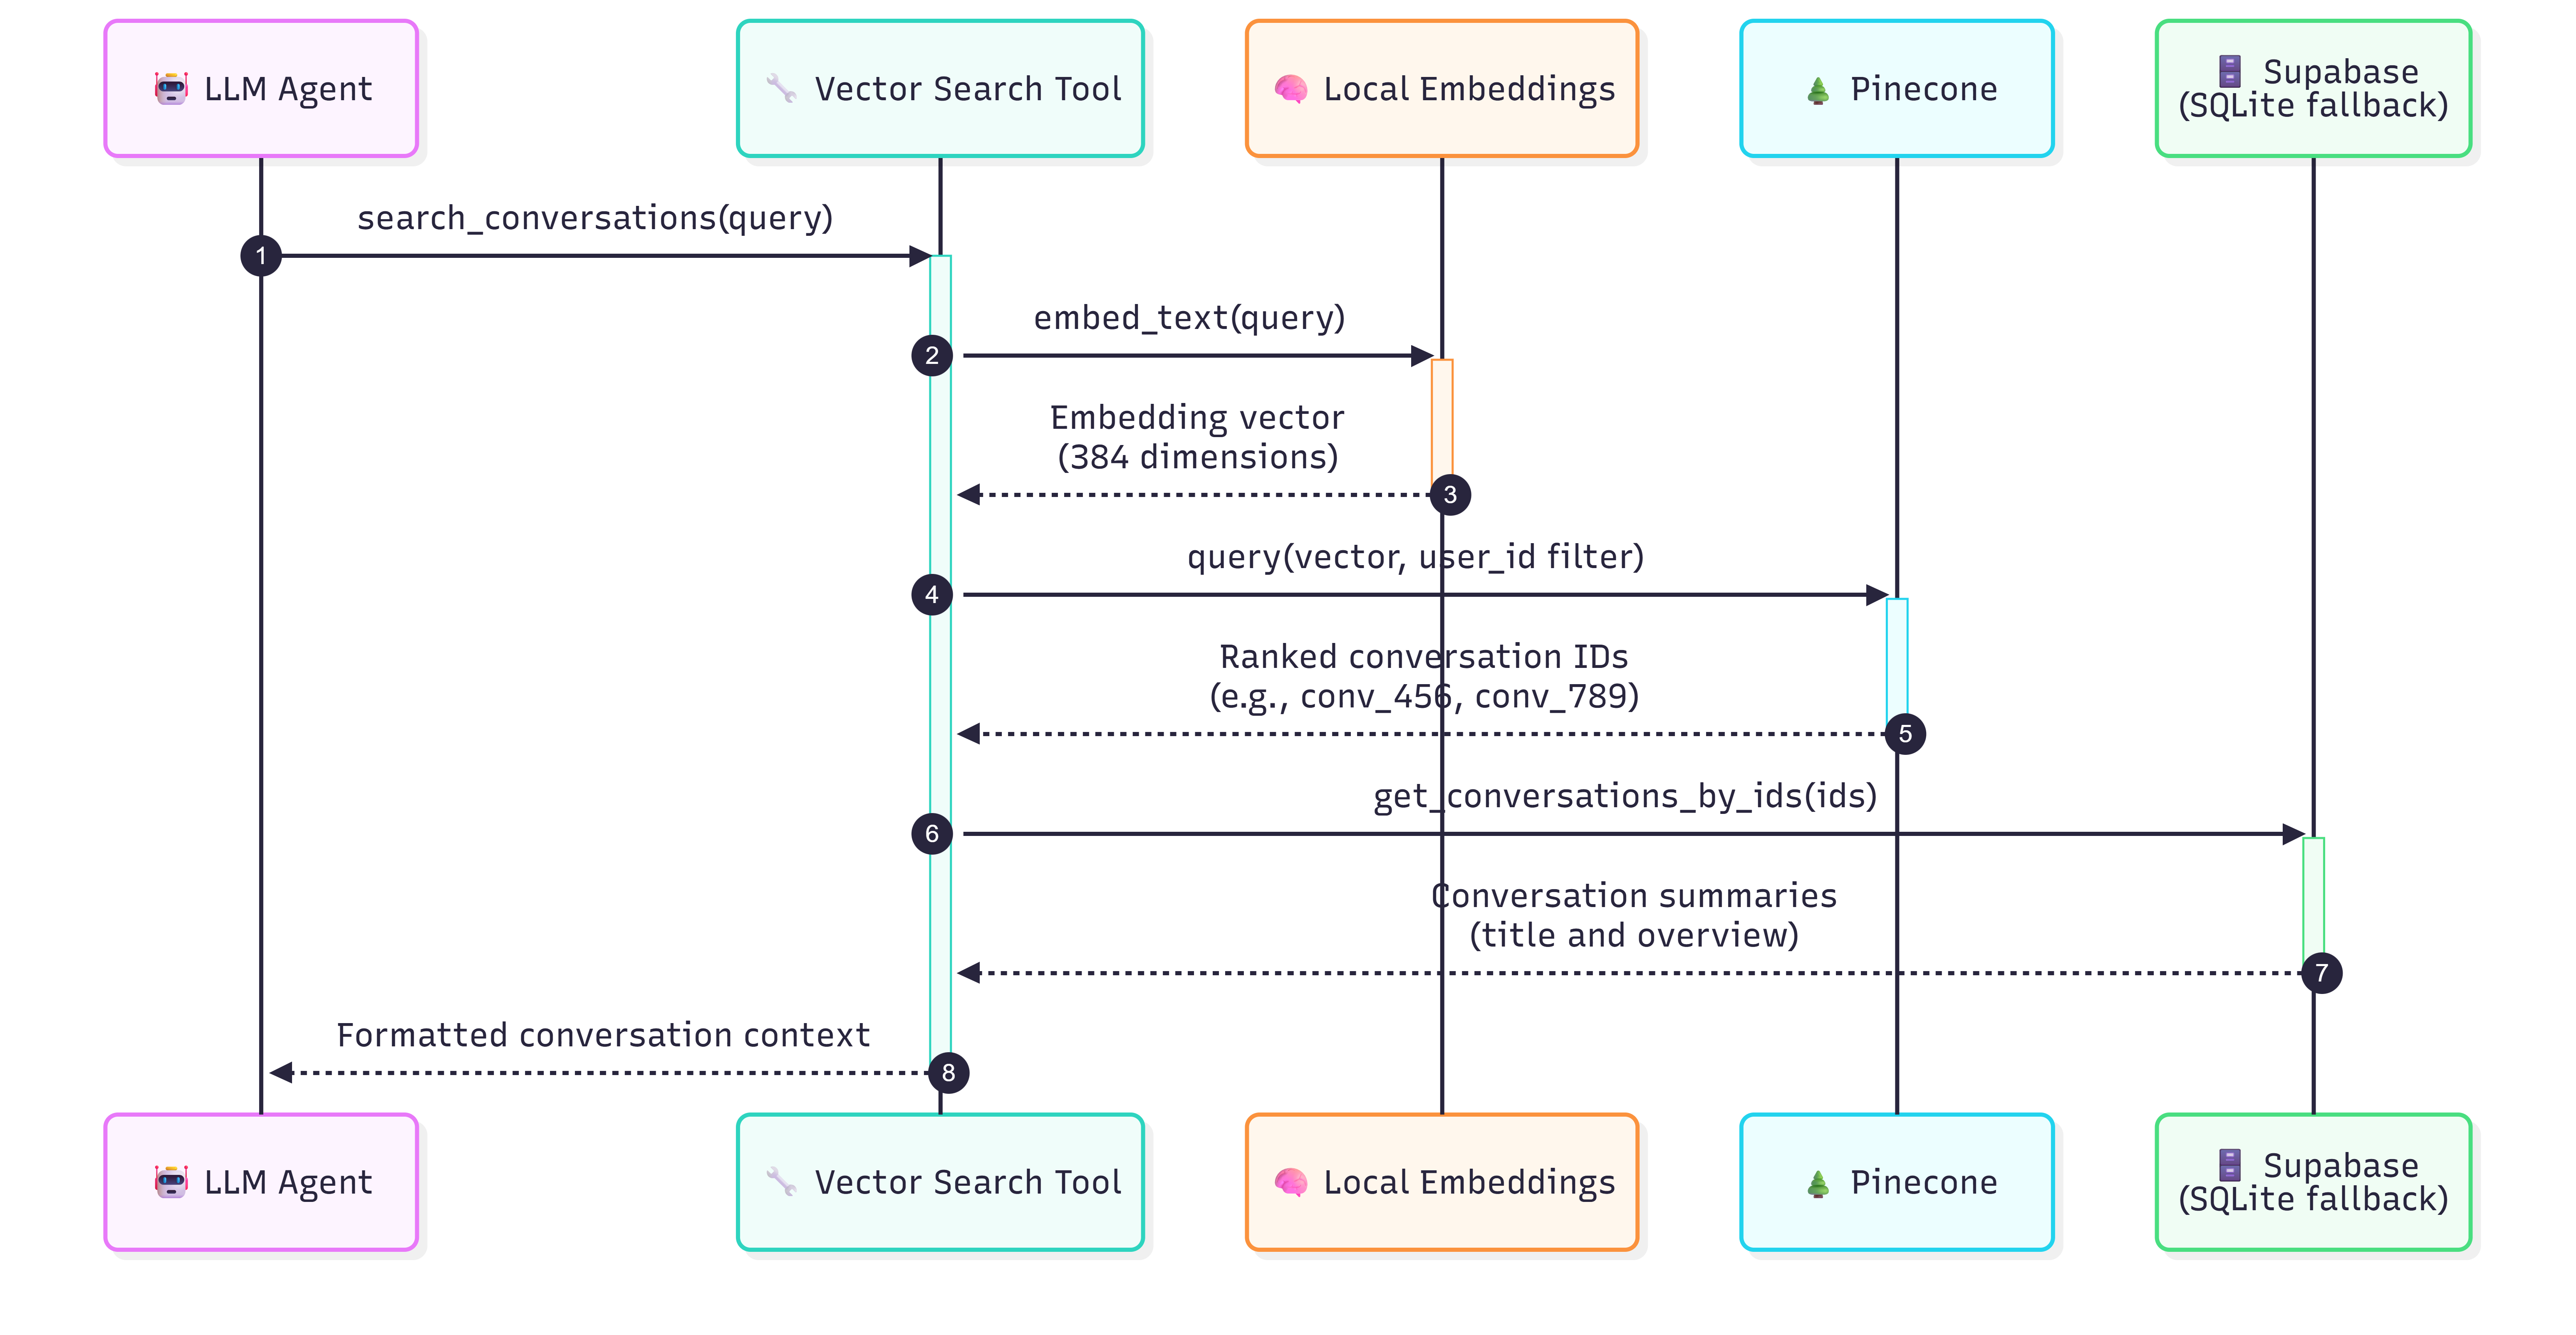
Cuando el agente llama a search_conversations, el flujo es:
Puntos clave:
- La consulta se incrusta con el mismo modelo local y luego se busca con un filtro
user_idpara que los usuarios solo vean sus propias conversaciones. - La coincidencia devuelve id + puntuación + metadatos; los resúmenes completos se obtienen del almacén relacional por id.
- Las coincidencias se formatean con su puntuación de similitud para que el agente pueda juzgar la relevancia.
7. Sistema de memorias
La memoria a largo plazo usa Mem0, limitada a un solo usuario (MEM0_USER_ID, por defecto user-1).
Categorías de memoria
No hay compartimentos codificados en el código; en su lugar, MEM0_CUSTOM_INSTRUCTIONS indica a Mem0 qué hechos duraderos extraer, en orden de prioridad:
- Restricciones de salud y alergias, especialmente cualquier cosa que un médico haya aconsejado (interpretado como aplicable al usuario).
- Agenda: reuniones, citas, recordatorios.
- Preferencias y detalles personales.
Excluidos explícitamente: las propias respuestas/recetas/explicaciones del asistente y las solicitudes puntuales y transitorias.
Recuperación de memoria en el chat
La recuperación proactiva ocurre en cada solicitud, antes del enrutamiento (recall(text) en backend/routes/chat.py):
-
El mensaje entrante se envía a la búsqueda semántica de Mem0 (
top_k = 5). -
Los resultados se filtran mediante una comprobación de relevancia de dos niveles sobre el desglose de puntuaciones:
semantic ≥ 0.28→ se mantiene, Osemantic ≥ 0.24ybm25 > 0.01(un acierto reforzado por palabras clave) → se mantiene.
-
Las memorias que sobreviven se ordenan por
created_at(las más recientes primero) y se formatean como:Relevant context from your past conversations:
- <memory text> (created 2026-08-30) -
Ese bloque se antepone al mensaje del usuario antes de que llegue a cualquier nodo, por lo que el LLM lo ve como contexto pero se le indica que lo use solo cuando sea directamente relevante para el tema.
La escritura ocurre después de cada intercambio (save_exchange): el par usuario/asistente se envía a Mem0 con las instrucciones personalizadas. Tanto el guardado como la recuperación de memoria fallan de forma controlada (se registran y se ignoran) si falta la clave de Mem0.
8. Sesión de chat y contexto
Estructura de la sesión
Una "sesión" es una conversación almacenada de forma relacional (Supabase PostgreSQL, o SQLite como alternativa). El esquema:
users—id,email(un solo usuario,user-1, precargado).conversations—id,user_id,title,overview,action_items, marcas de tiempo.messages/turns—conversation_id,role(user/assistant),content, marca de tiempo.
Flujo para un turno:
- Crear (o reutilizar) una conversación →
conversation_id. - Cargar contexto: recuerdos de
recall()+ historial deget_recent_messages(conversation_id, 10). - Construir el
AgentStatey ejecutarlo a través de LangGraph. - Después de la respuesta: guardar ambos turnos, guardar el intercambio en Mem0 e iniciar el indexado vectorial asíncrono.
Ventana de contexto
El contexto ensamblado para el LLM es intencionalmente pequeño y por capas:
| Componente | Origen | Tamaño |
|---|---|---|
| System prompt | constante por ruta (simple/persona/agent SYSTEM_PROMPT) | fijo |
| Historial de conversación | get_recent_messages(conversation_id, 10) | últimos 10 turnos (10 mensajes de usuario + 10 del asistente), en orden cronológico |
| Recuerdos recuperados | Mem0 recall(), top-5, filtrados | hasta 5 recuerdos |
| Mensaje actual del usuario | format_memories(...) + transcript | la solicitud |
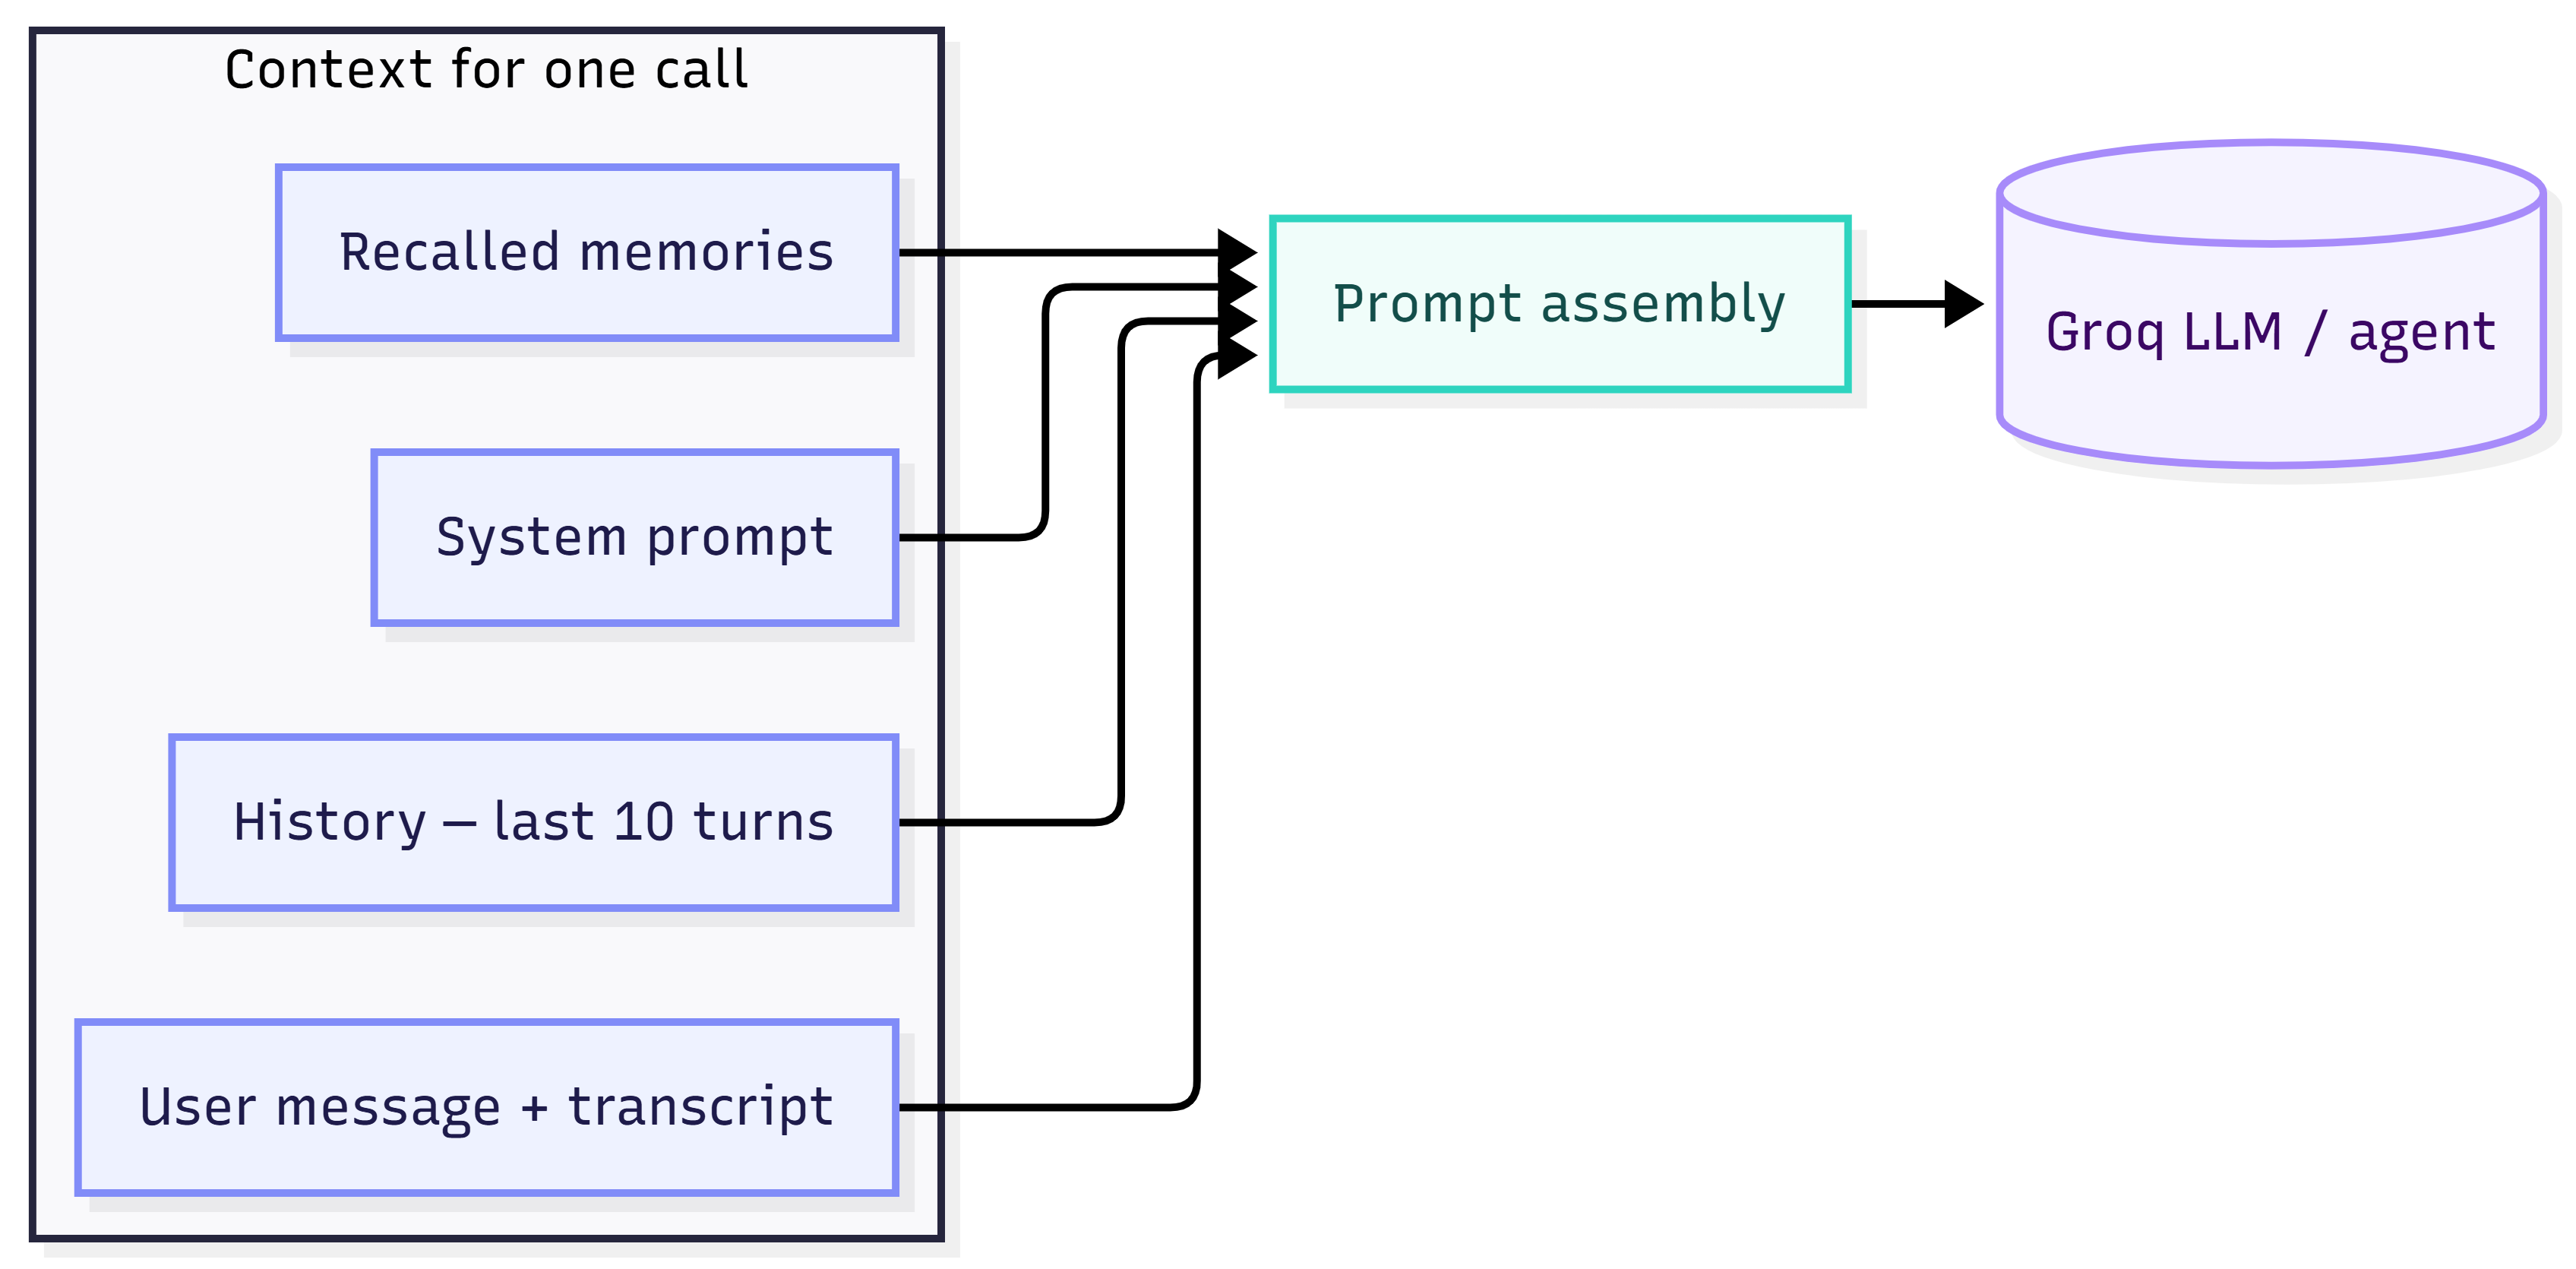
Notas:
- El historial proviene del almacén relacional, no del almacén vectorial (el almacén vectorial contiene resúmenes, no turnos).
- Los recuerdos se inyectan en línea con el mensaje del usuario, por lo que el modelo los trata como "contexto relevante de tus conversaciones pasadas".
- La ruta del agente construye los mensajes como
[history..., ("user", memories + transcript)]y permite que el agente itere con herramientas.
9. Estructura del System Prompt
Hay cuatro system prompts:
| Prompt | Dónde | Usado por | Trabajo |
|---|---|---|---|
ROUTER_PROMPT | backend/graph/router.py | clasificación del router | Devuelve una sola palabra: simple / context / persona |
SIMPLE_PROMPT (simple.py) | backend/graph/nodes/simple.py | simple_node | Asistente de voz útil, chat sencillo |
PERSONA_PROMPT (persona.py) | backend/graph/nodes/persona.py | persona_node | Igual que simple pero adapta el estilo/la enseñanza a la solicitud del usuario |
SYSTEM_PROMPT (agentic) | backend/graph/nodes/agentic.py | agent | Asistente habilitado con herramientas; explica cada herramienta y cuándo usarla |
Los prompts simple, persona y agentic comparten un remate de estilo común:
- Responde en un máximo de 2–3 oraciones cortas.
- Solo texto plano: sin markdown, sin asteriscos, sin emojis.
- Los recuerdos recuperados se usan solo cuando son directamente relevantes para el tema (la separación entre agenda y comida se aplica explícitamente).
- En caso de conflicto, confía en el recuerdo creado más recientemente.
- Cuando el usuario declara un hecho nuevo, reconoce solo ese hecho; no repitas recuerdos no relacionados.
El prompt agentic además:
- Nombra las herramientas (
web_search,calculator,search_conversations, herramientas de Notion). - Indica hacer llamadas mínimas a herramientas: detente una vez que se haya reunido suficiente información.
- Mantiene el formato de respuesta corta y en texto plano.
10. Modelos LLM utilizados
Todos los modelos se ejecutan en Groq. Definidos en backend/llm/client.py, config.py y groq_client.py:
| Rol | Variable de entorno | Modelo predeterminado | Temperatura | Notas |
|---|---|---|---|---|
| LLM principal (router, simple, persona, resúmenes) | GROQ_LLM_MODEL | qwen/qwen3.6-27b | 0.7 | Instancia de ChatGroq llm |
| LLM de agente/llamadas a herramientas | GROQ_AGENT_MODEL | openai/gpt-oss-20b | 0.0 | Instancia de ChatGroq agent_llm, usada por create_agent |
| Speech-to-text | GROQ_STT_MODEL | whisper-large-v3 | 0.0 | Transcripción con Whisper |
| Text-to-speech | GROQ_TTS_MODEL | canopylabs/orpheus-v1-english | — | Voz = TTS_VOICE (autumn) |
| Embeddings (local, no Groq) | EMBEDDING_MODEL | all-MiniLM-L6-v2 | — | sentence-transformers, 384 dimensiones, normalizado |
Valores predeterminados de inferencia LLM (a través de groq_client.chat): max_completion_tokens = 2048, top_p = 1.0, temperatura sobrescribible.
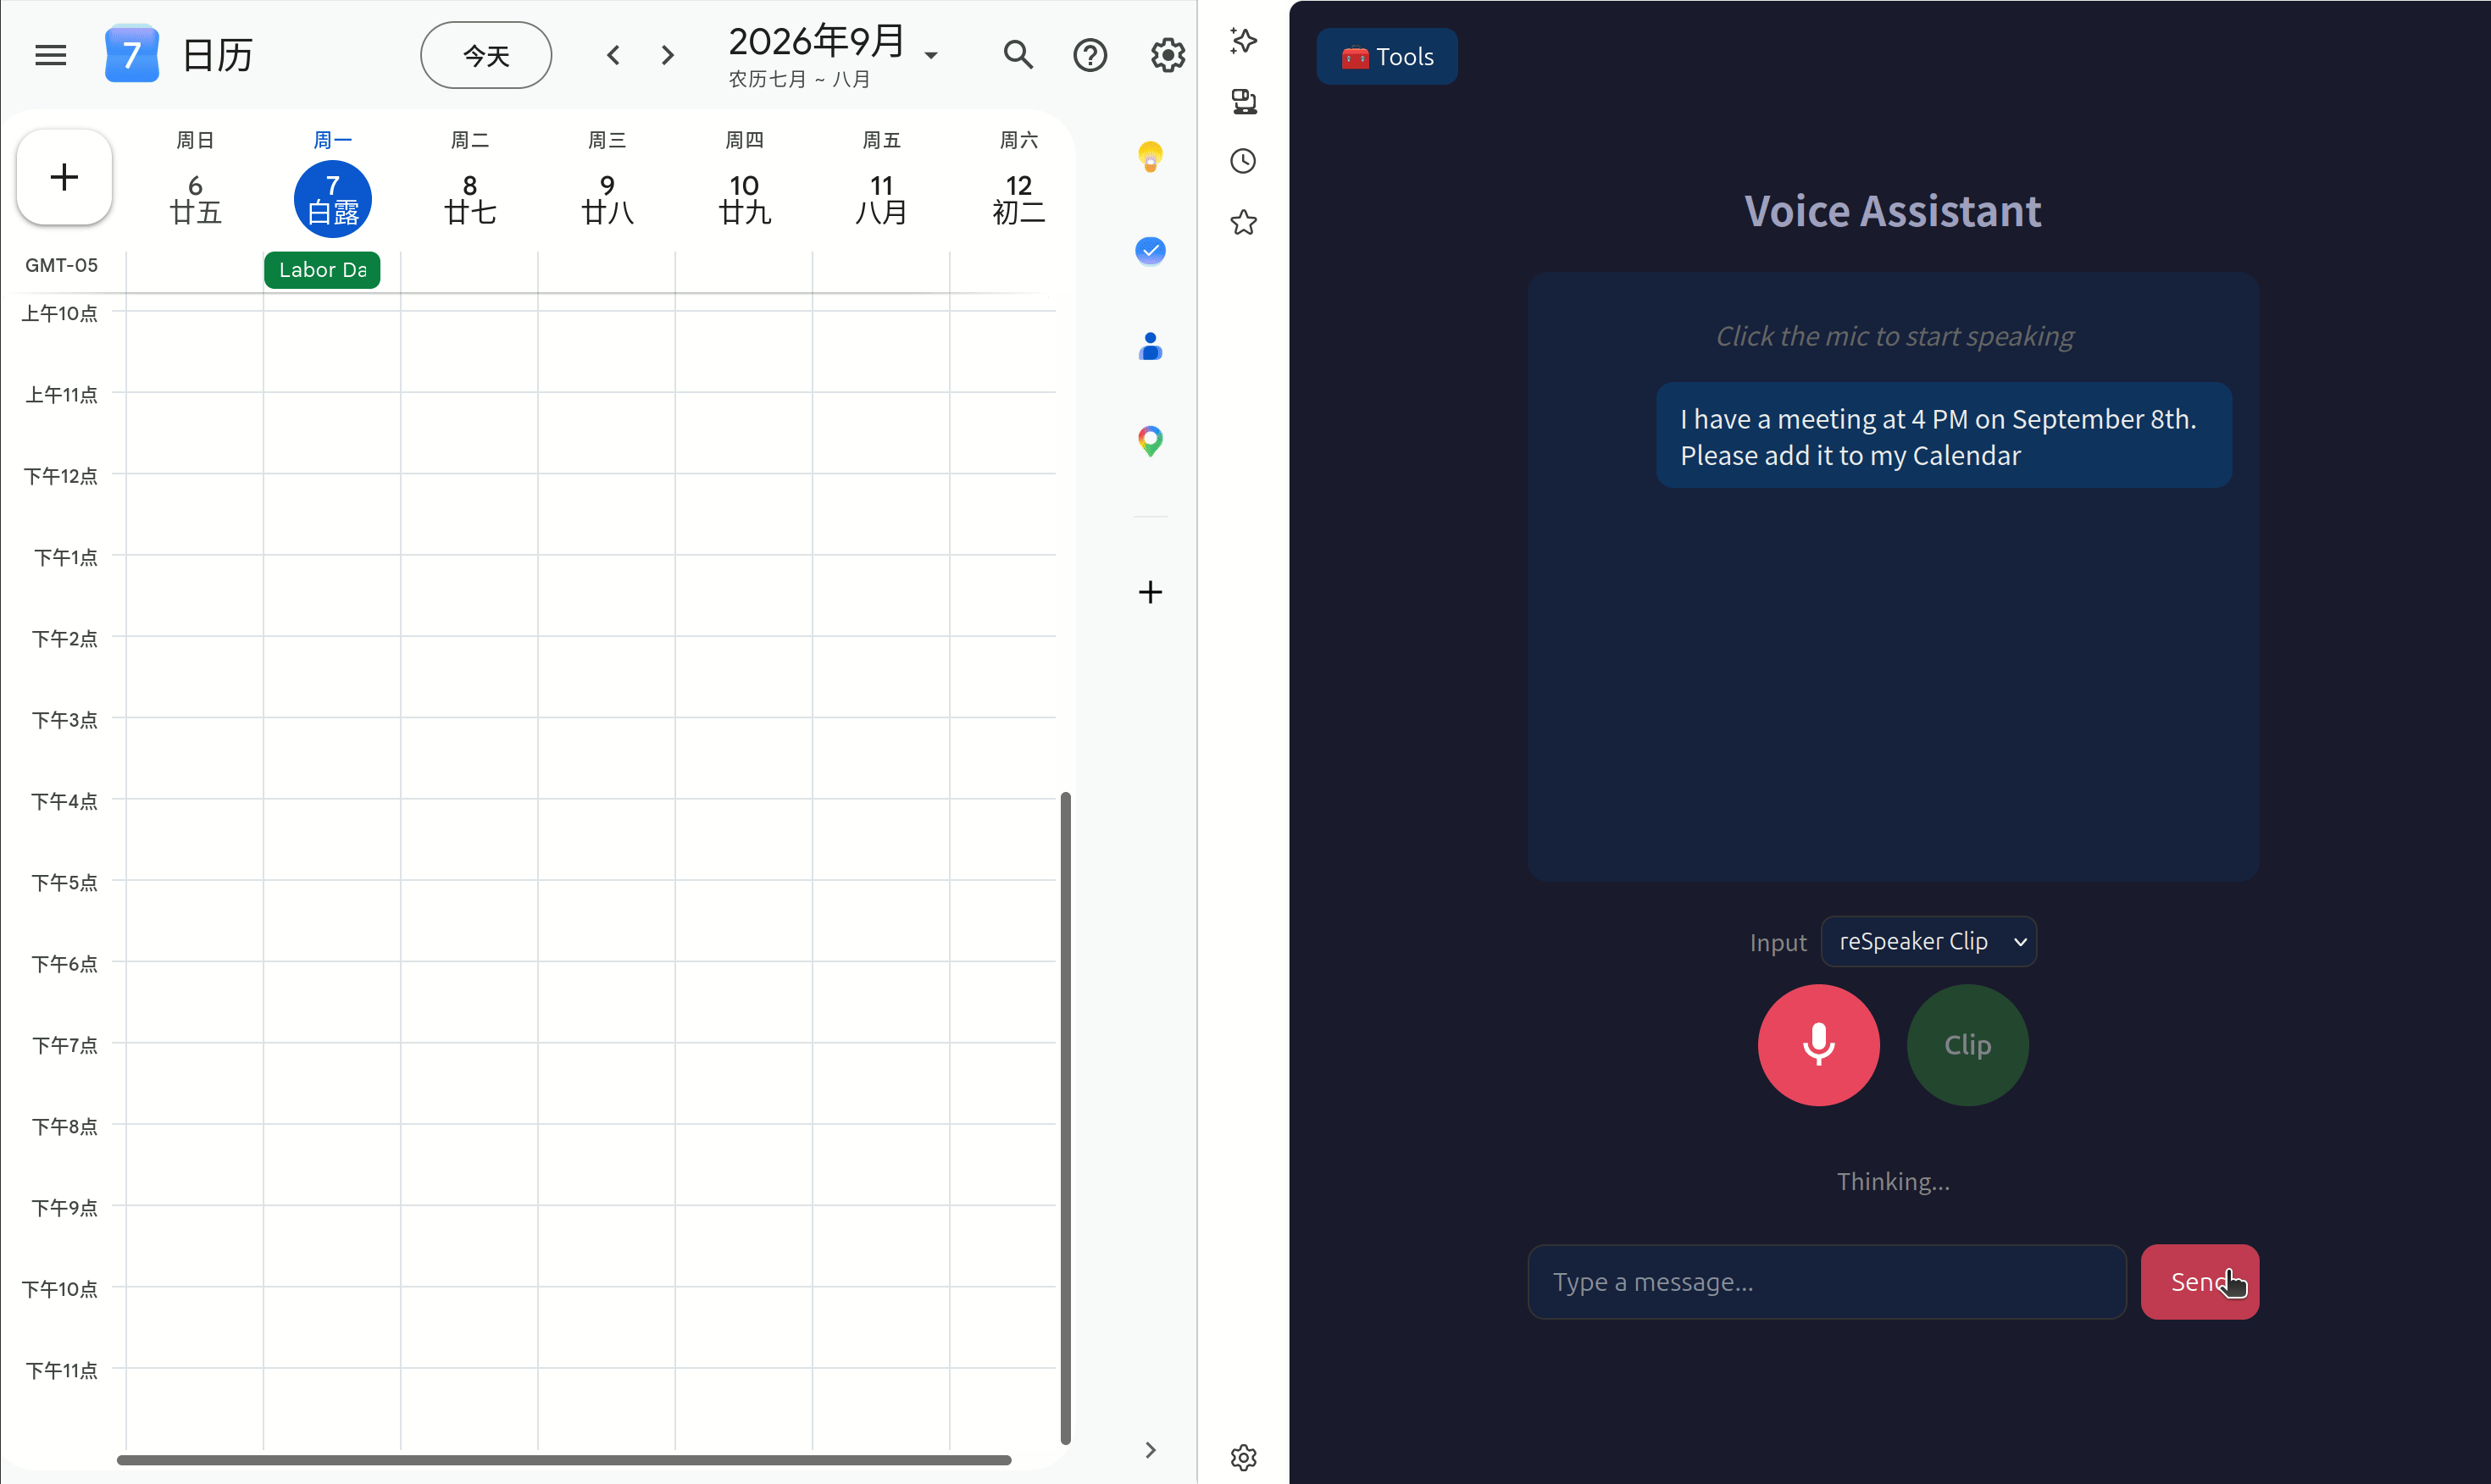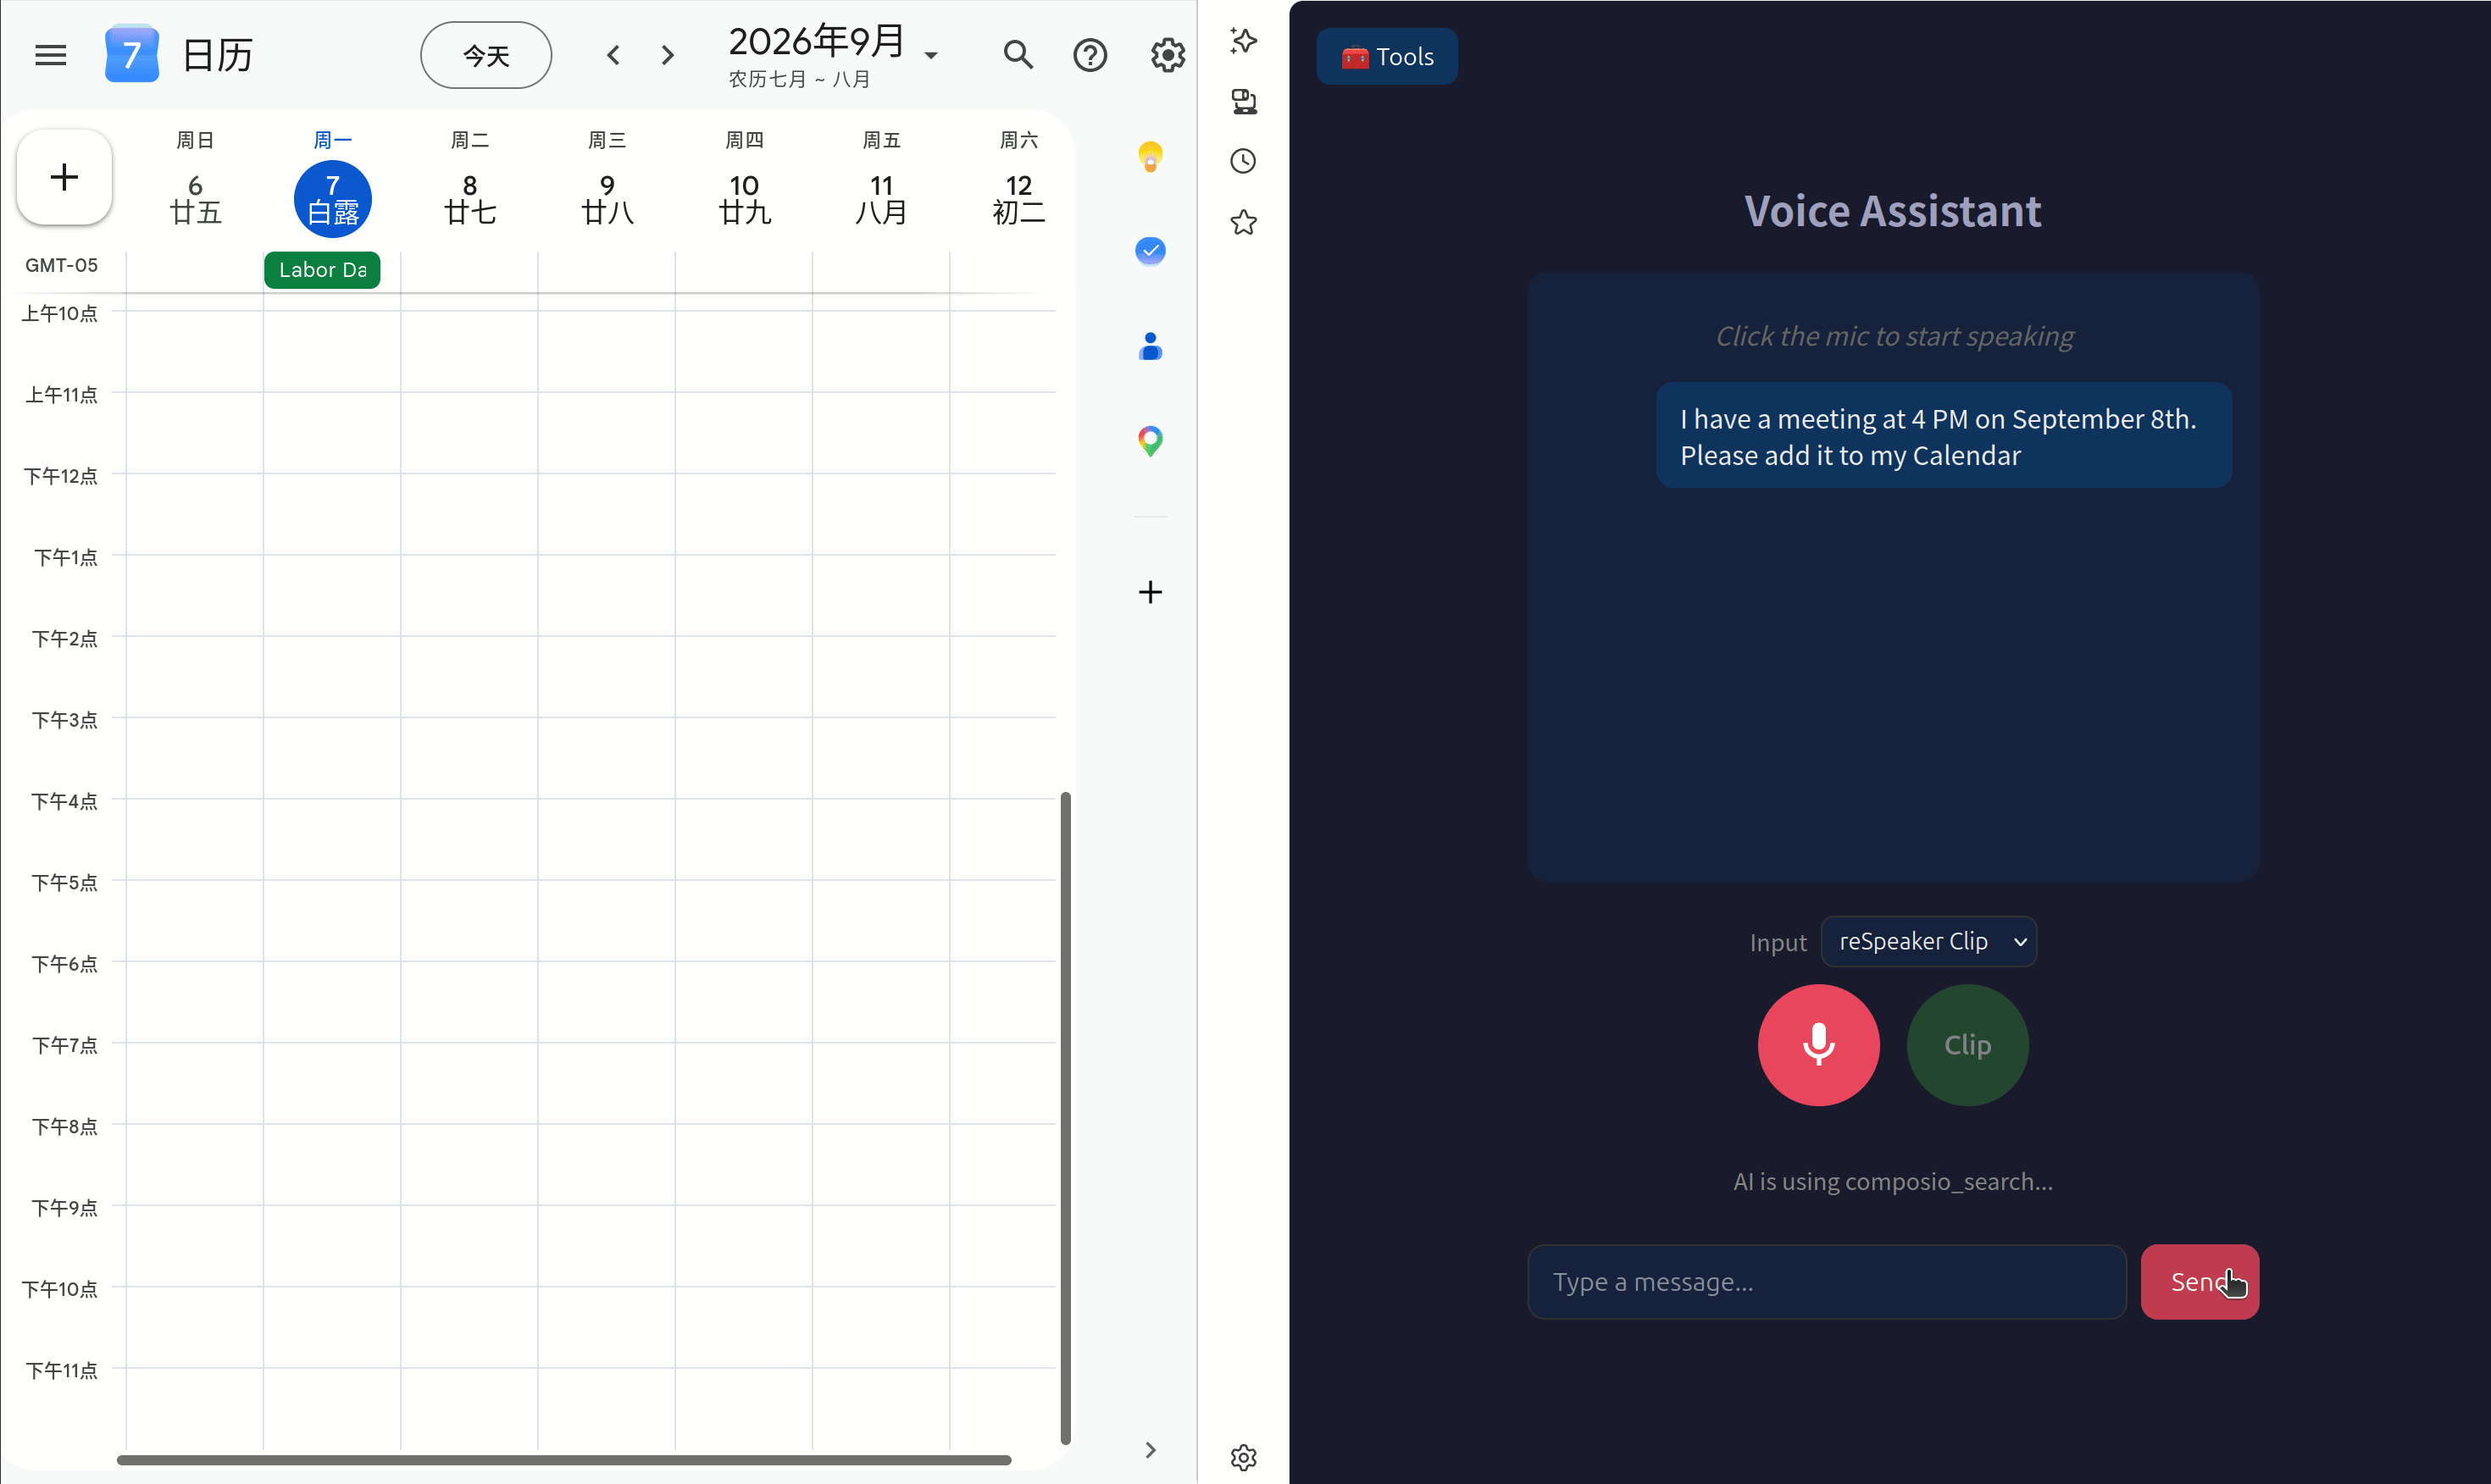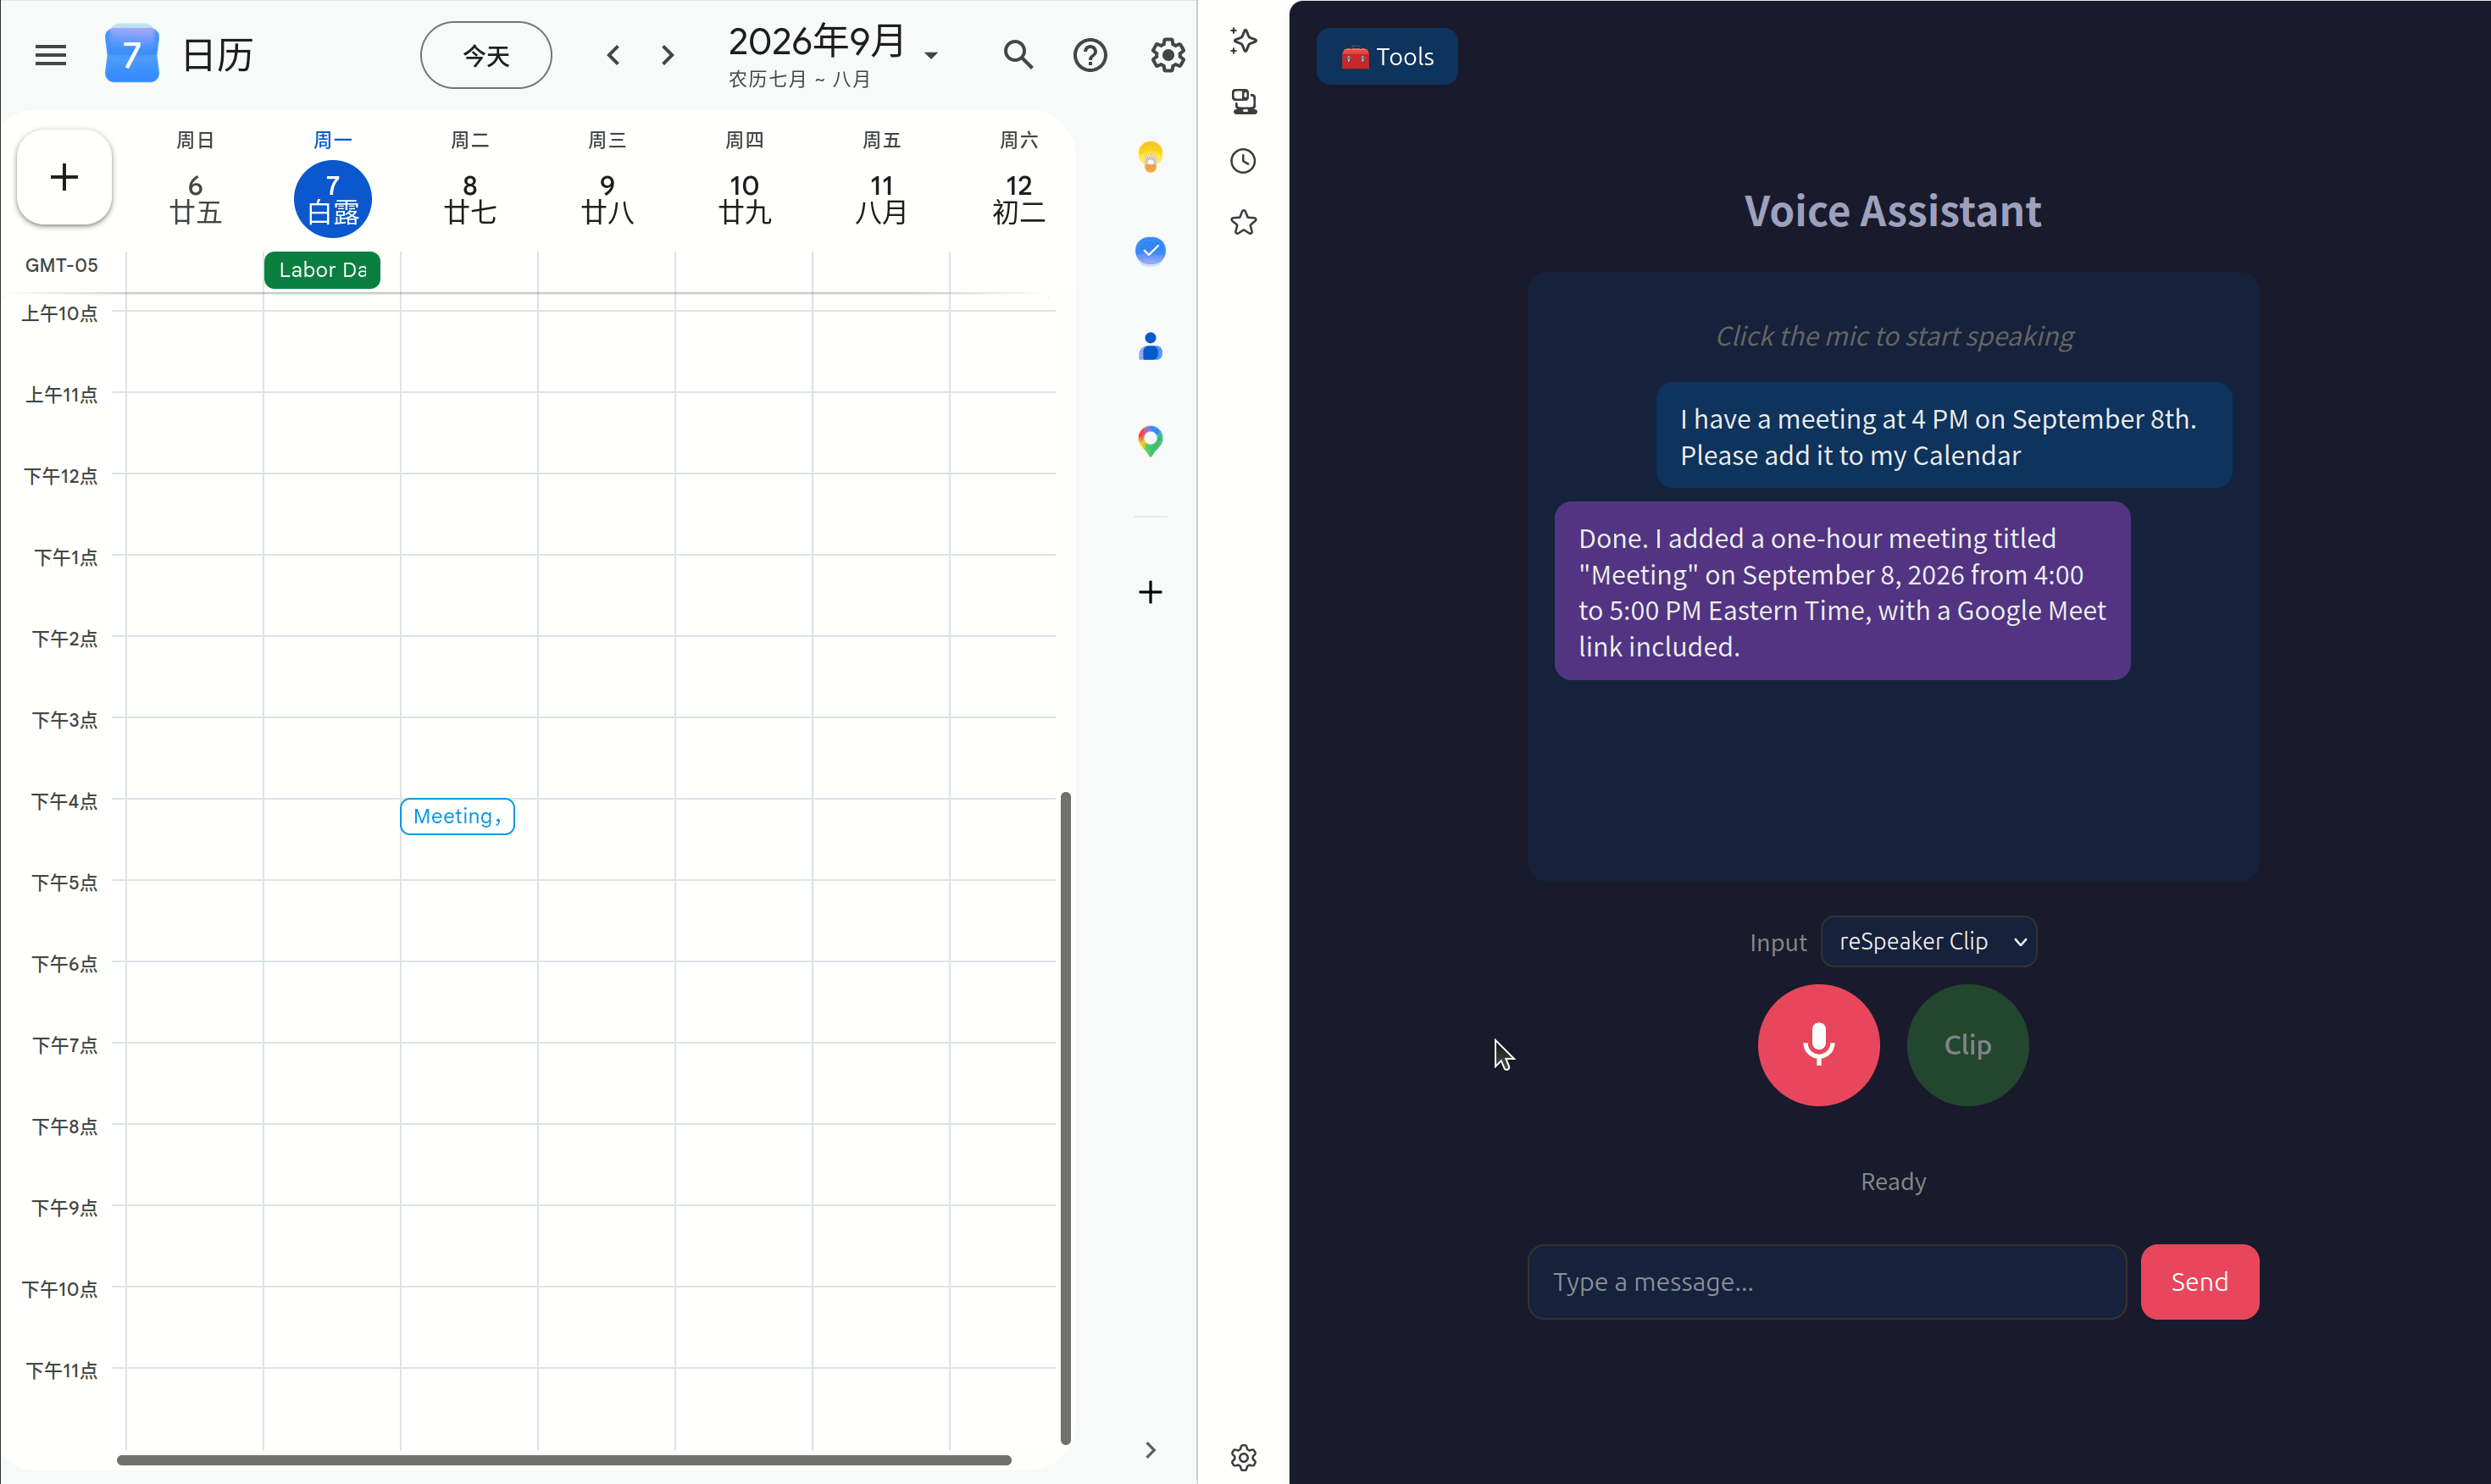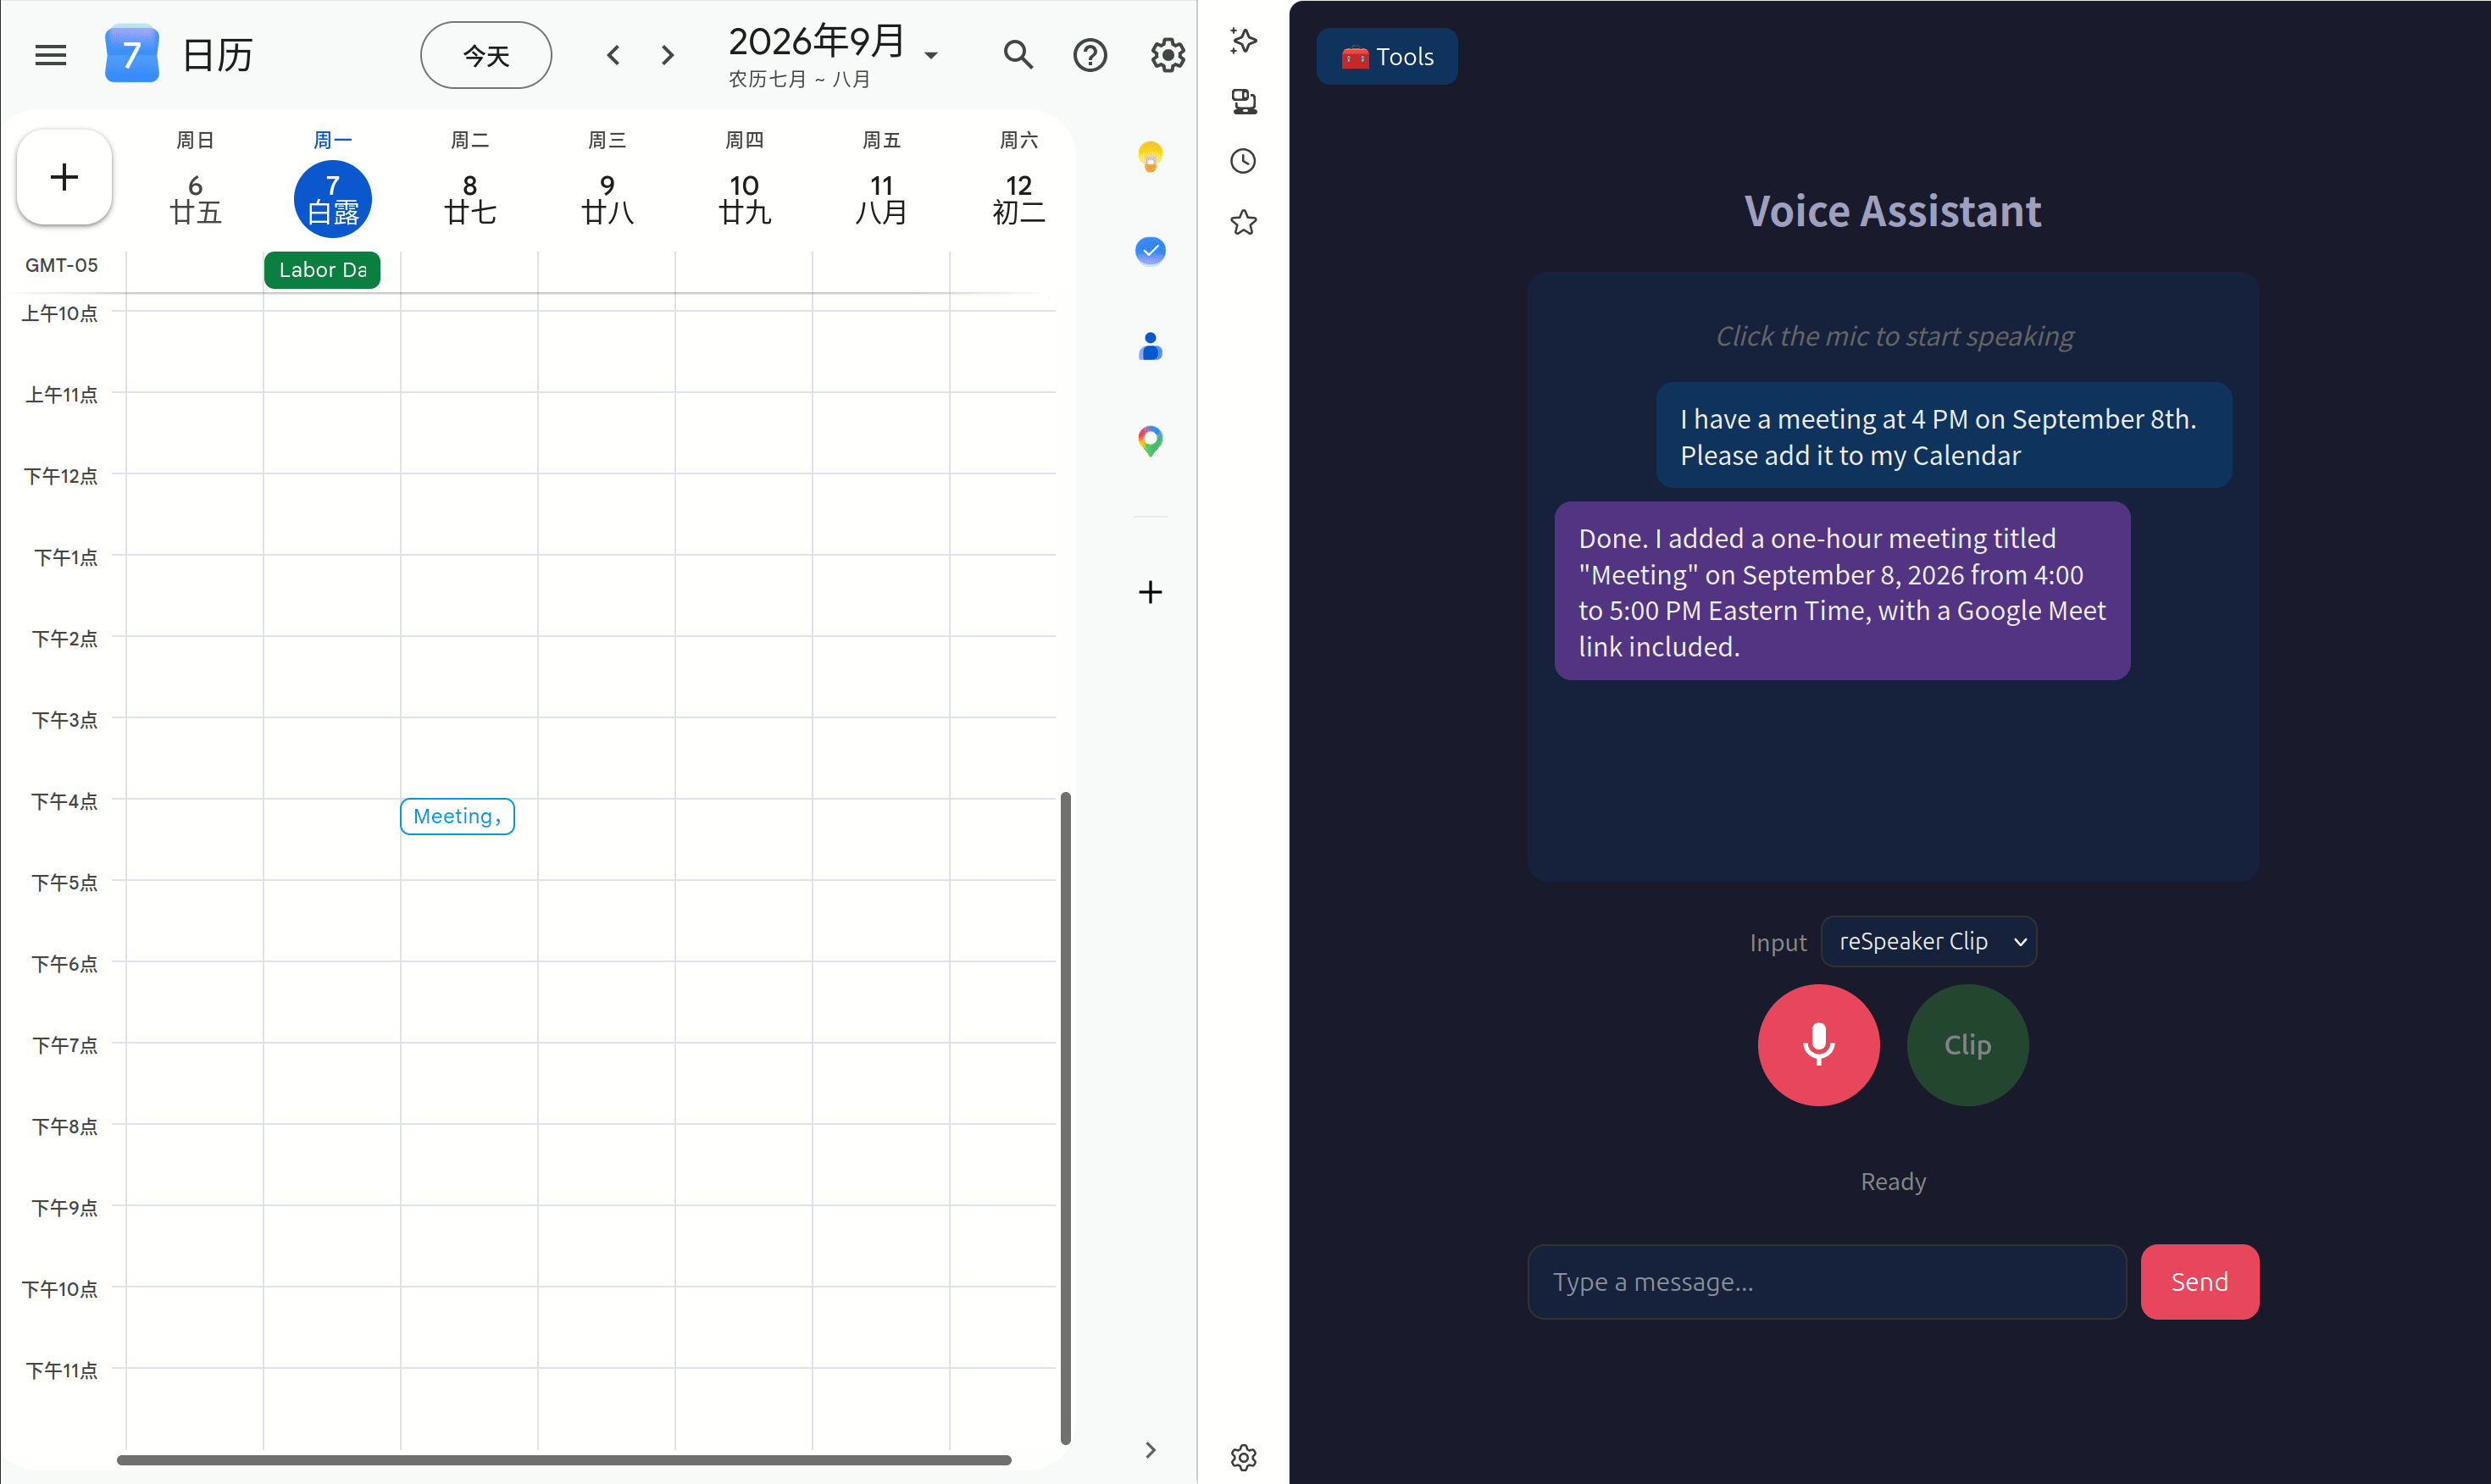
11. Demostración de llamada de agente
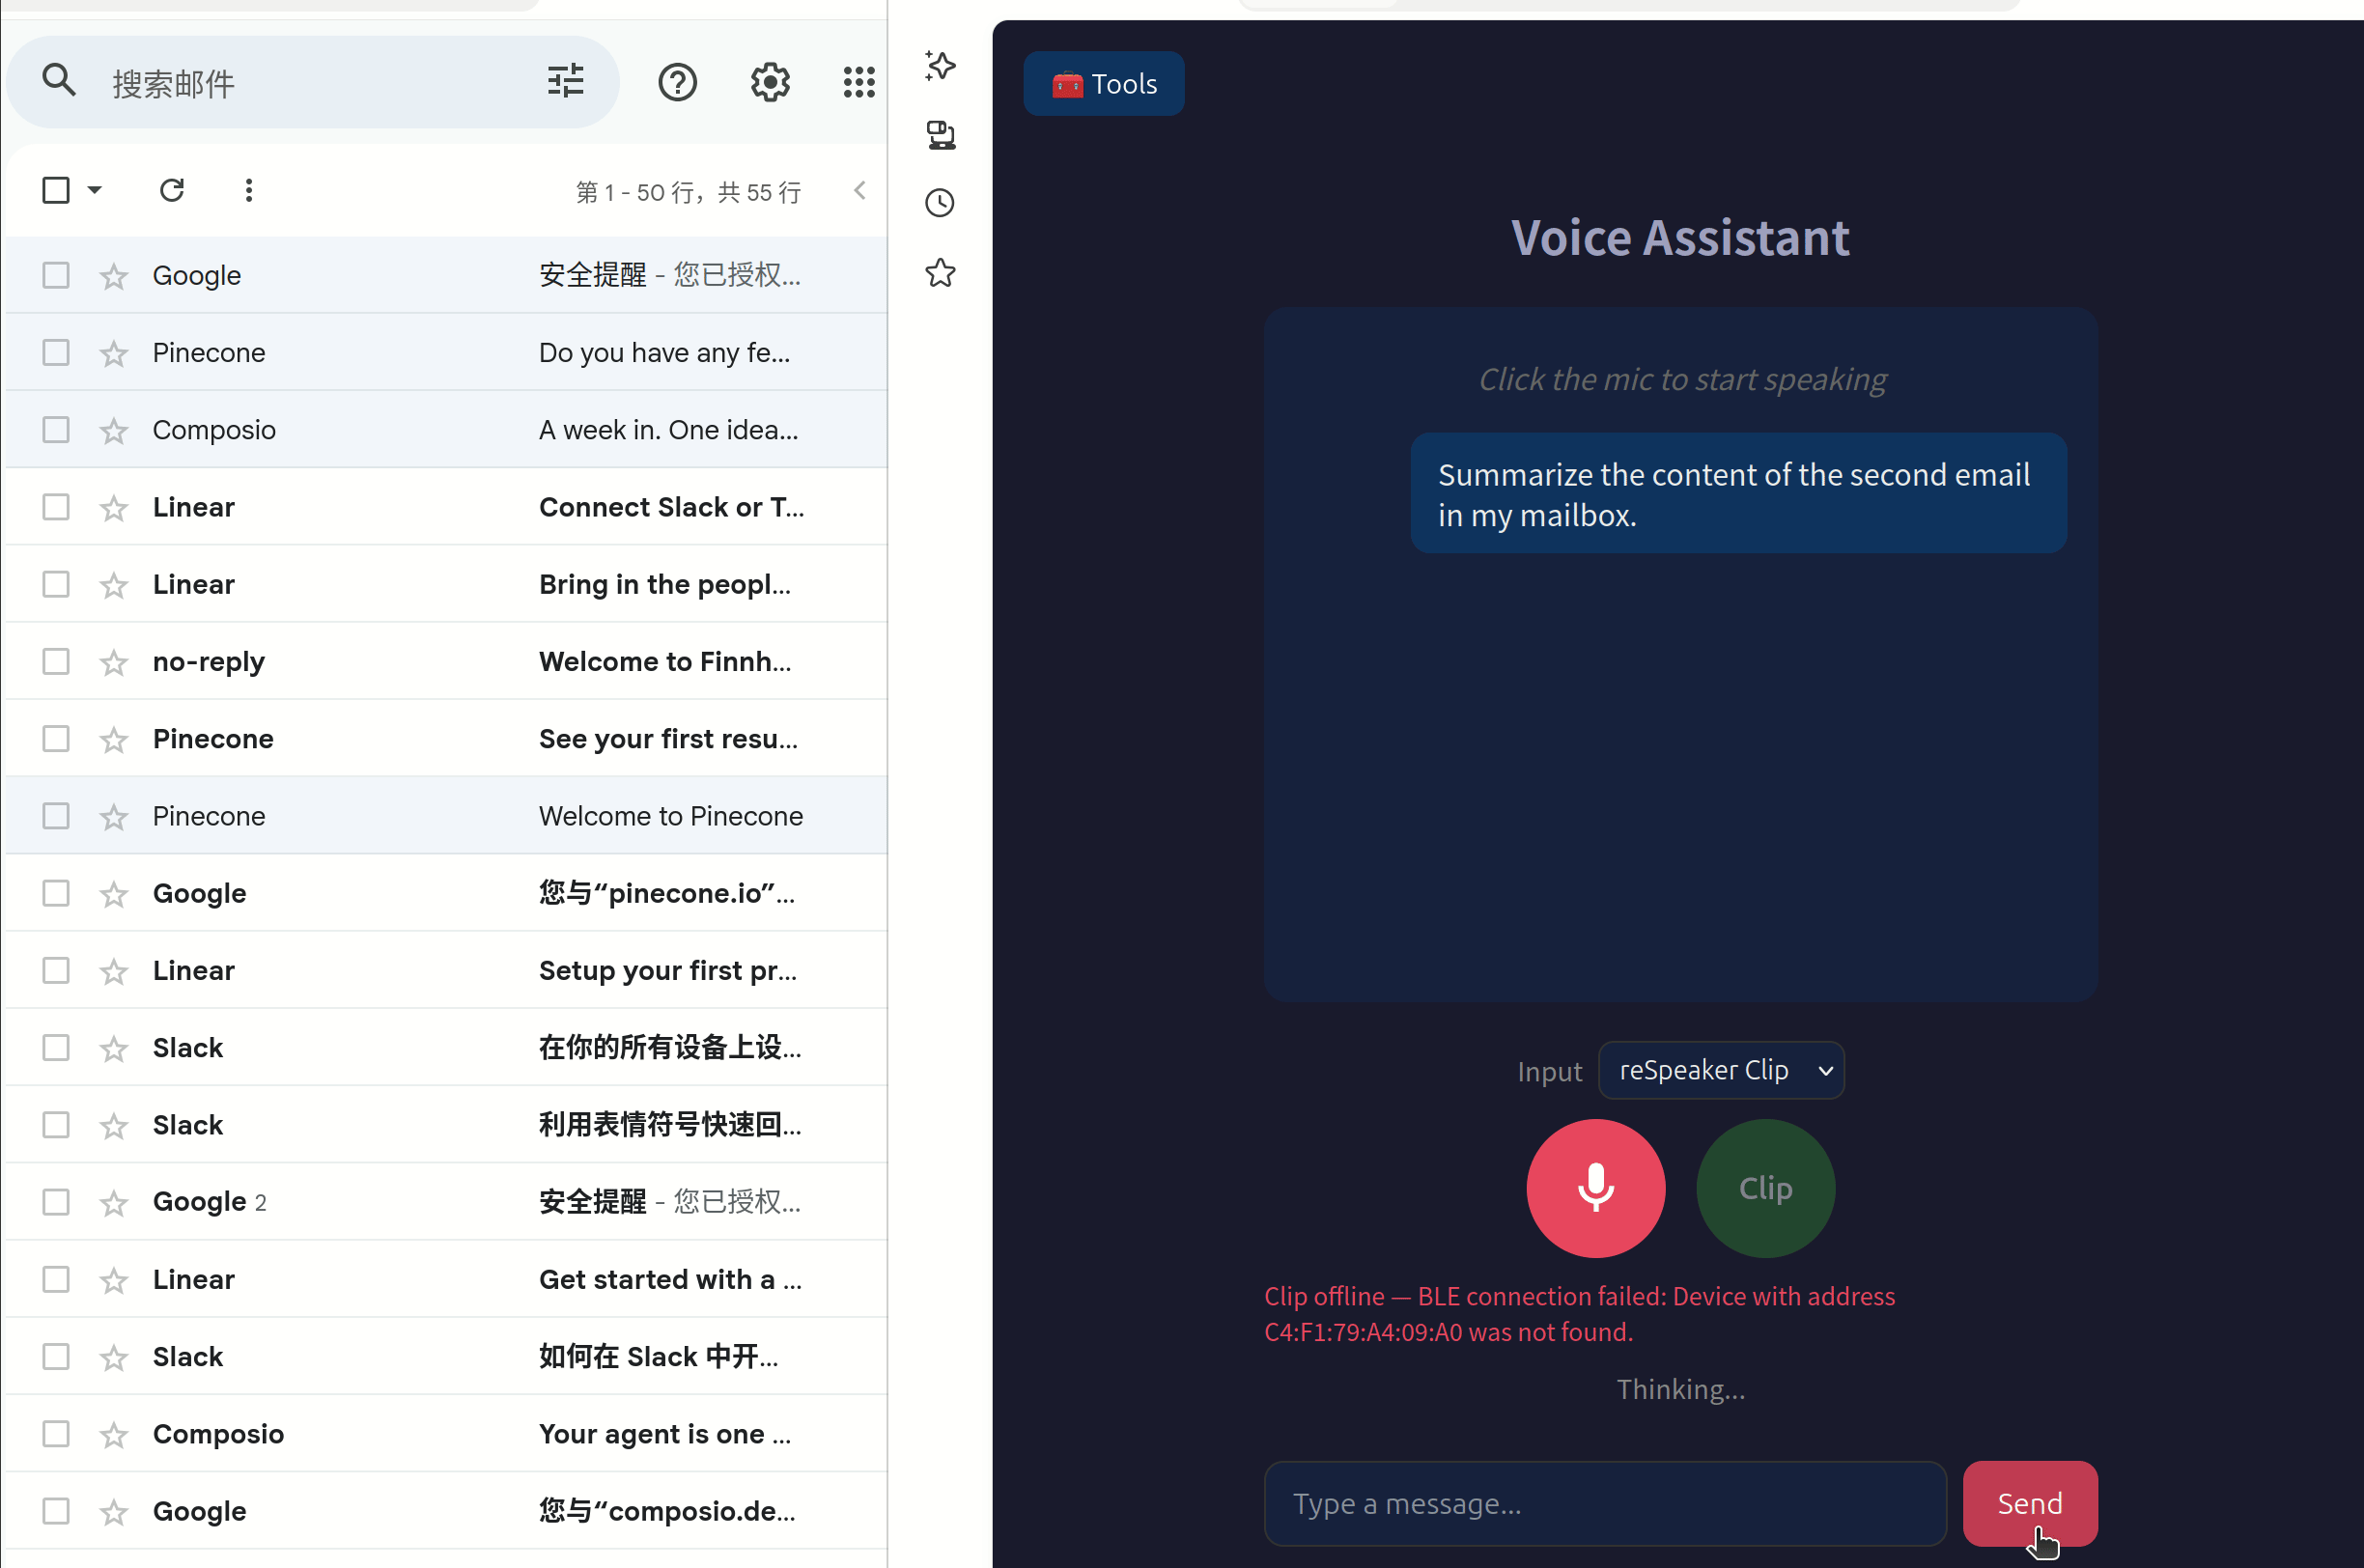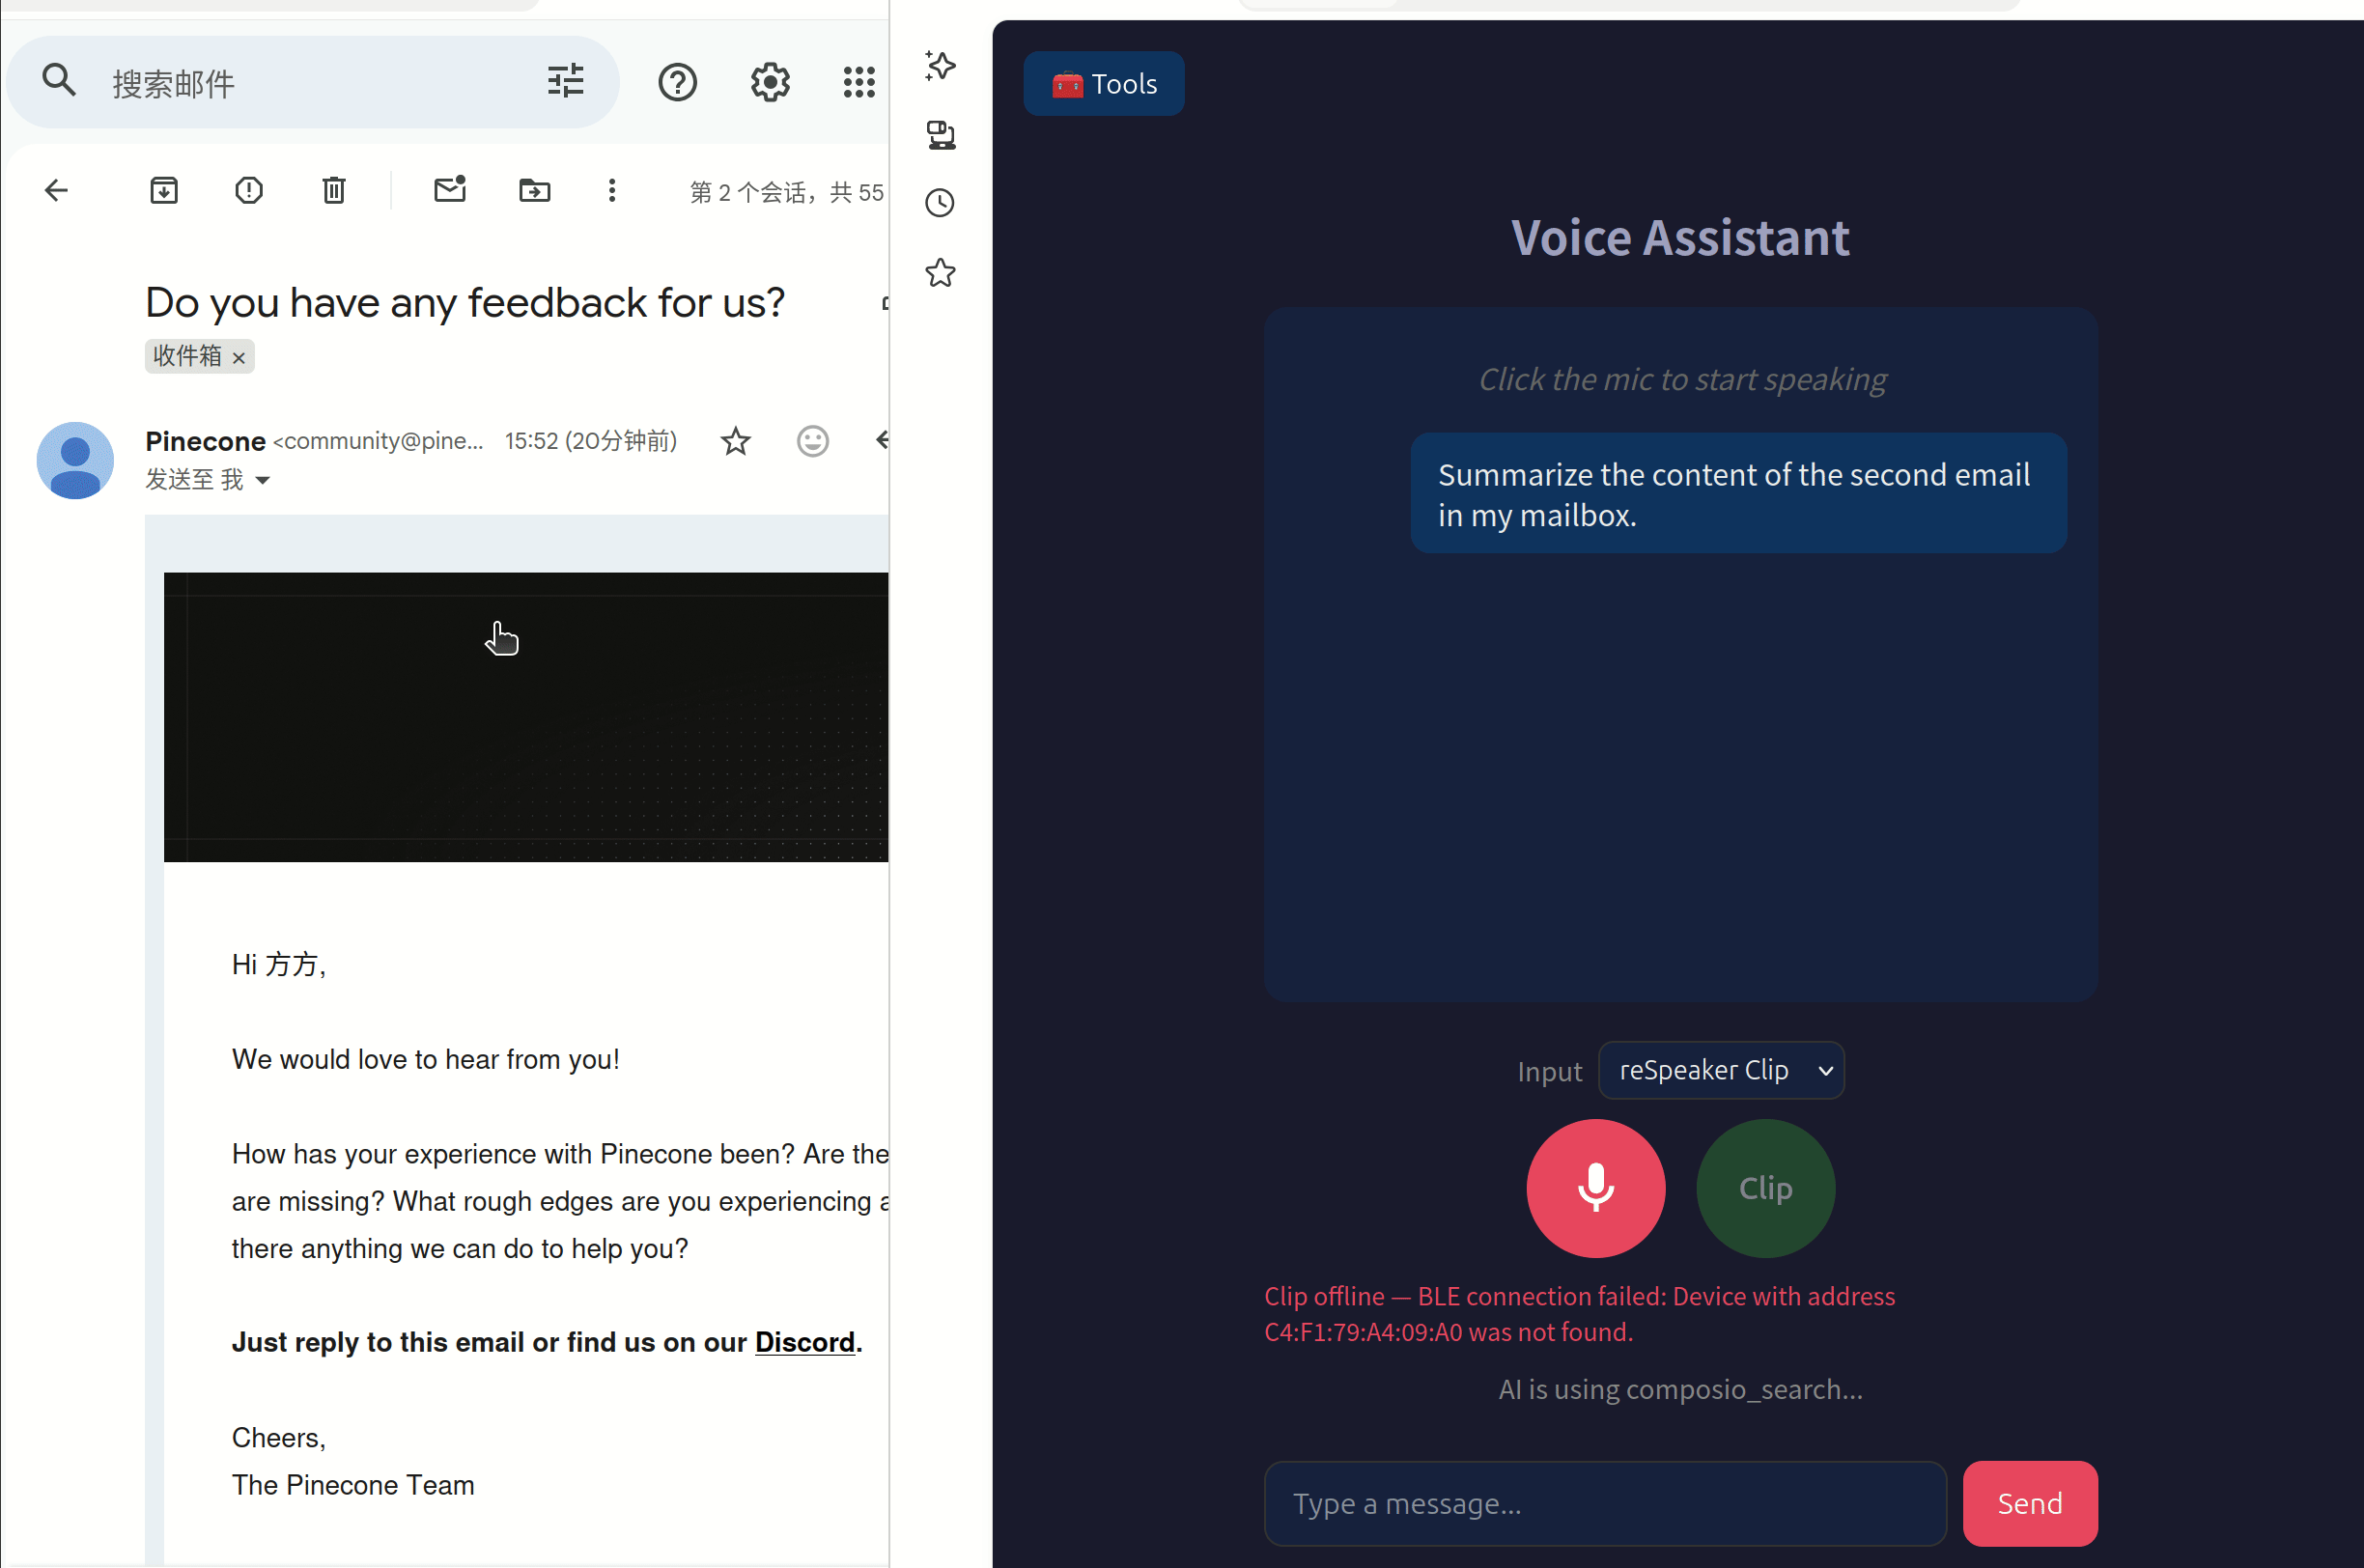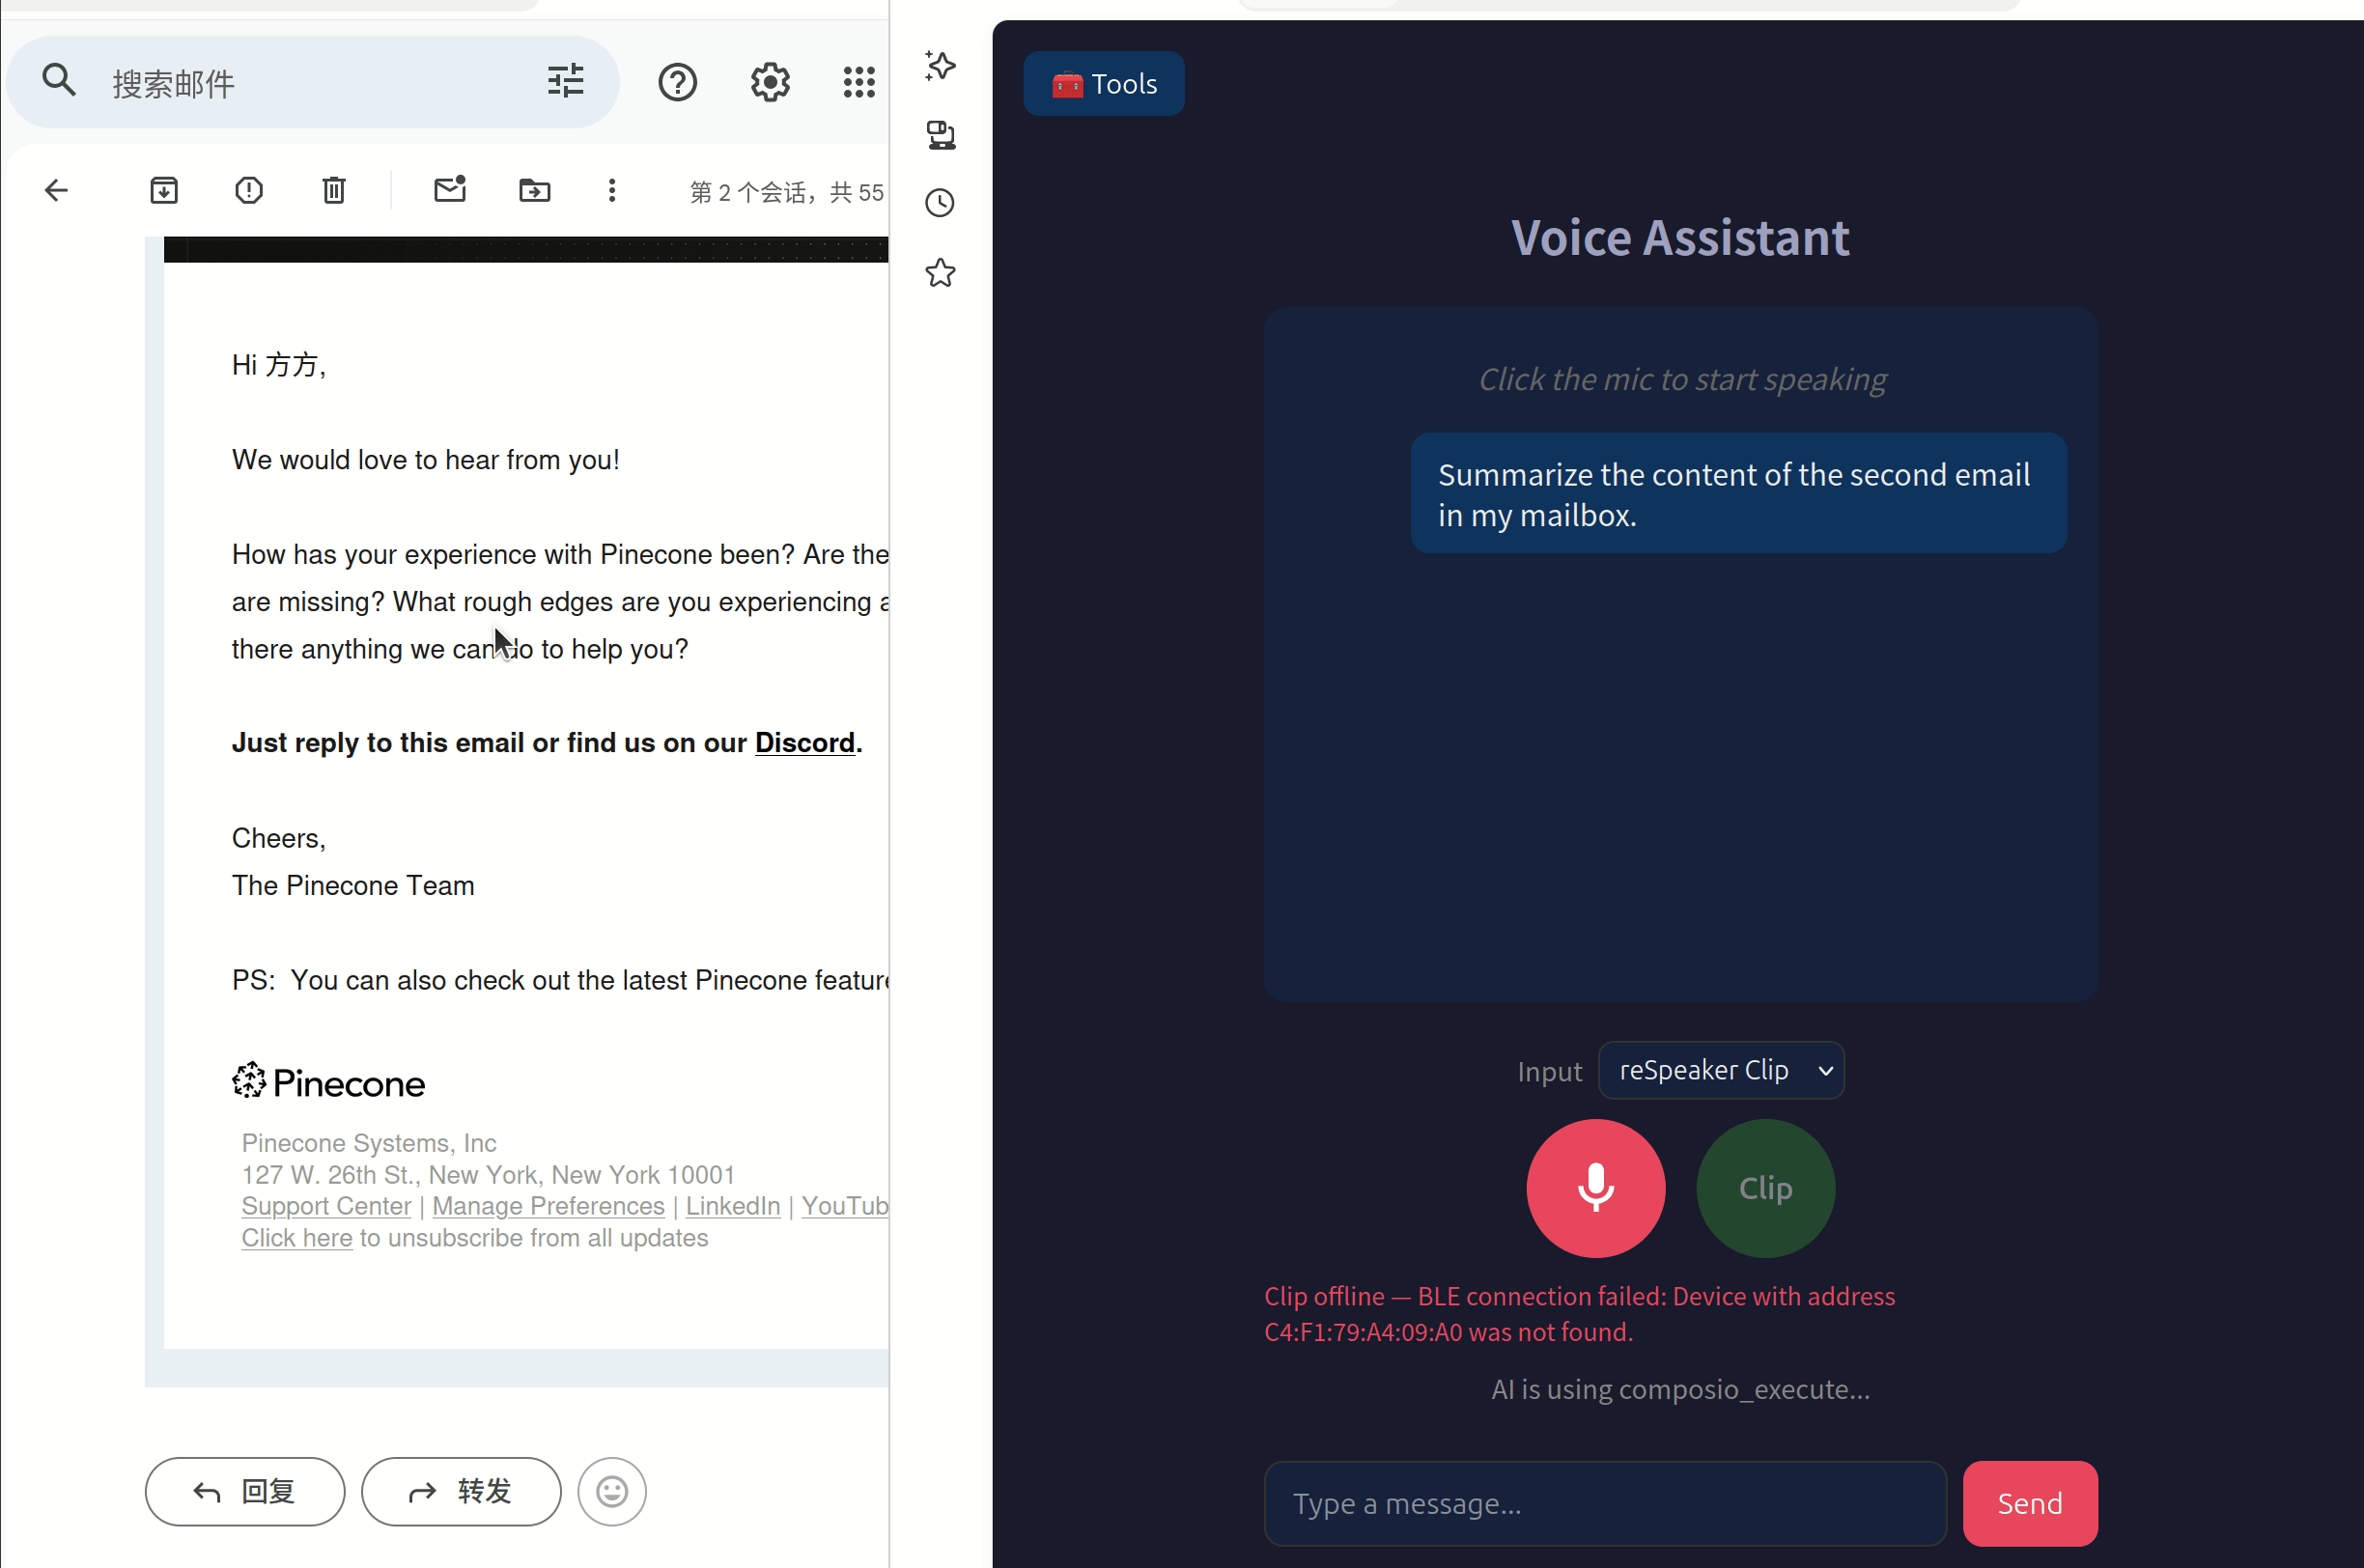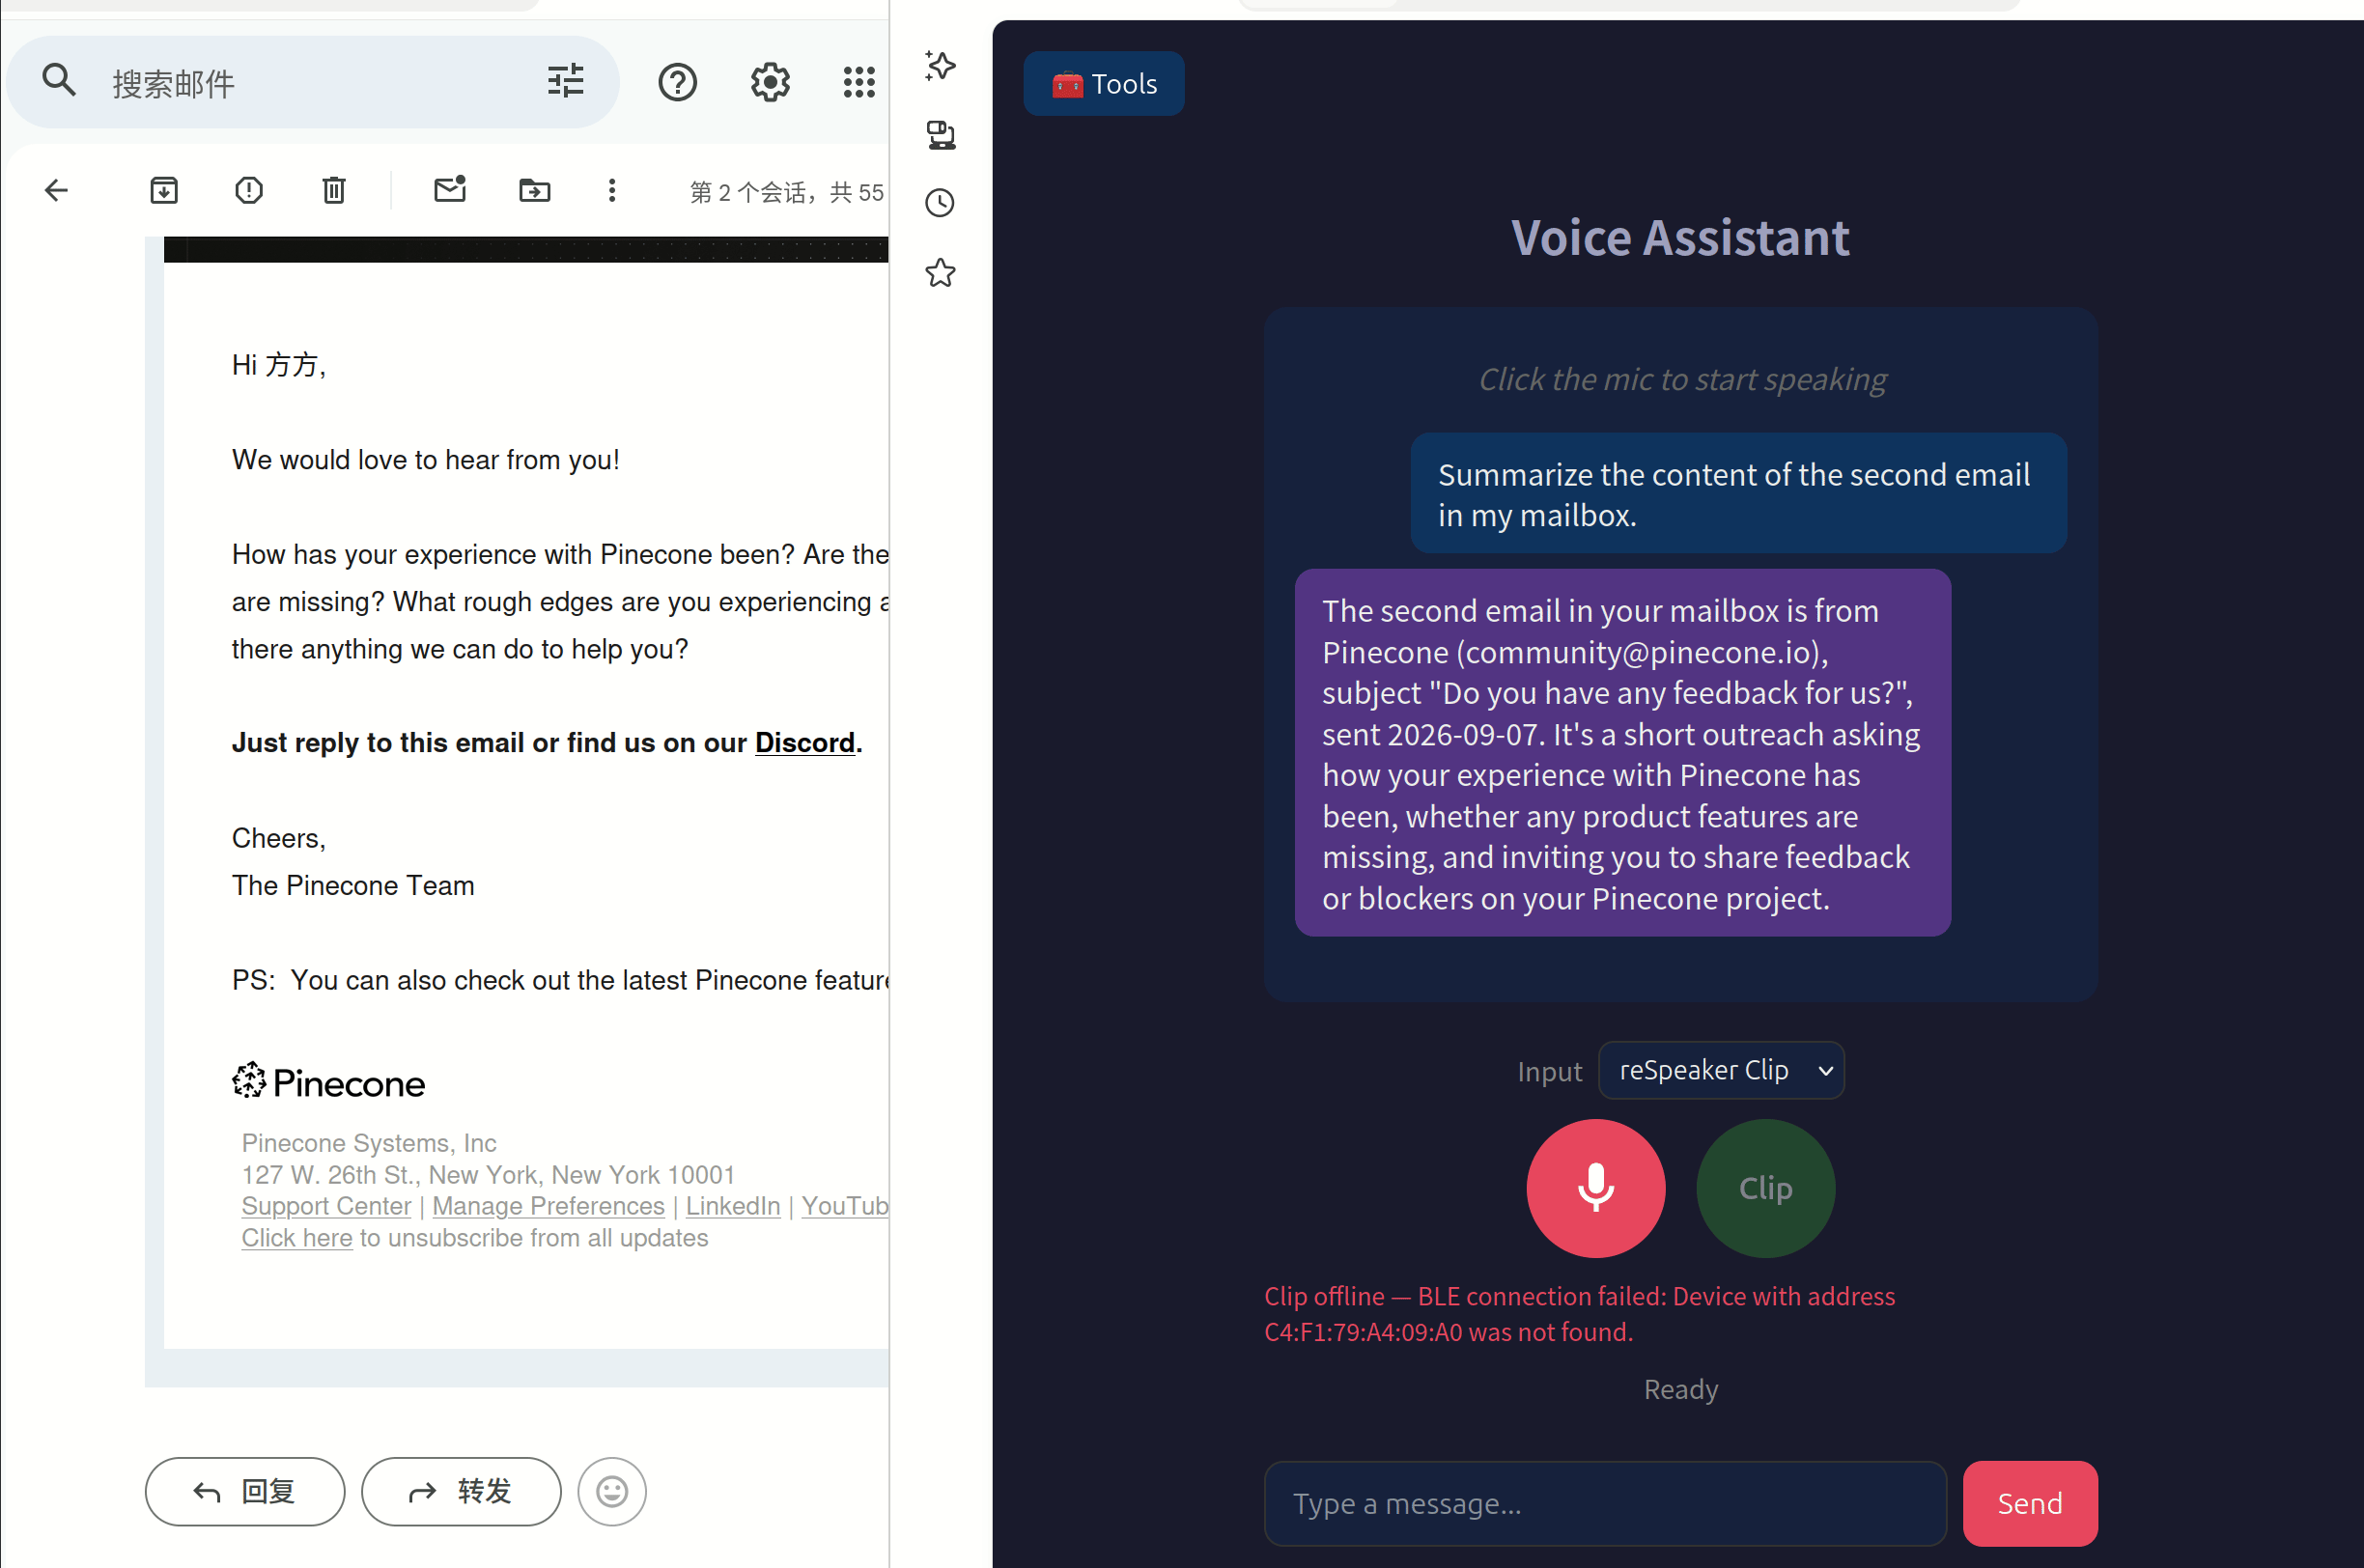
Leer correo electrónico
Añadir calendario
Soporte técnico y debate sobre el producto
Gracias por elegir nuestros productos. Estamos aquí para ofrecerte diferentes tipos de soporte y garantizar que tu experiencia con nuestros productos sea lo más fluida posible. Ofrecemos varios canales de comunicación para adaptarnos a diferentes preferencias y necesidades.