reSpeaker USB 4-Mic Array XVF3000 v3.0

Nos complace presentar formalmente el reSpeaker XVF3800, una actualización integral del reSpeaker XVF 3000. Basado en los cimientos de su predecesor con una arquitectura de matriz de 4 micrófonos, compatibilidad universal (Windows / macOS / Linux) y la comodidad plug-and-play de doble firmware (I2S / USB), el XVF3800 ofrece un salto significativo tanto en fidelidad de audio como en rendimiento algorítmico.
Aspectos destacados de la actualización
- Algoritmos de audio impulsados por IA: Conjunto integrado que incluye AEC (Acoustic Echo Cancellation), AGC (Automatic Gain Control), detección DoA (Direction of Arrival), formación de haz, VAD (Voice Activity Detection), supresión de ruido y desreverberación, lo que sienta una base sólida para aplicaciones avanzadas de voz.
- Captura de voz de campo lejano de 360°: Captura de voz precisa dentro de un radio de 5 metros, que se adapta fácilmente a sistemas de conferencias, interacción inteligente y escenarios controlados por voz.
- Modos de funcionamiento duales: Conmutación flexible de firmware USB/I2S para satisfacer diversos requisitos de desarrollo y despliegue.
- Detalles y especificaciones del producto: ReSpeaker XVF3800 4-Mic Array Store Page
- Guía de inicio rápido y Wiki: reSpeaker XVF3800 Getting Started Guide | Seeed Studio Wiki
ReSpeaker Mic Array v3.0 es la siguiente evolución de las matrices de micrófonos USB de Seeed Studio, después de la ReSpeaker Mic Array v2.0. Mientras que la v2.0 se basó en el chipset XVF-3000 de XMOS y fue diseñada como una actualización importante de la v1.0, la v3.0 se centra en perfeccionar la calidad de audio y el rendimiento de los algoritmos, incluso con un menor número físico de micrófonos.
En comparación con la matriz de 4 micrófonos de la v2.0, la v3.0 también utiliza 4 micrófonos pero integra algoritmos de procesamiento de audio integrados mejorados, ofreciendo una captura de voz de campo lejano más clara y un mejor manejo del ruido que su predecesora. La v3.0 sustituye el códec WM8960 de la v2.0 por un códec TLV320AIC3104, lo que contribuye a una captura de sonido de mayor fidelidad.
Mientras que la v2.0 se utilizaba a menudo junto con la ReSpeaker Core o como placa de desarrollo, la v3.0 es más un dispositivo USB plug-and-play —similar a la v2.0 en cuanto a compatibilidad total con Windows, macOS y Linux gracias al soporte de USB Audio Class 1.0— pero ajustada para ofrecer un rendimiento de interfaz de voz listo para usar sin necesidad de hardware adicional.
En cuanto a funcionalidades, ambas admiten captura de voz de campo lejano y algoritmos de mejora del habla como AEC (Acoustic Echo Cancellation), VAD (Voice Activity Detection), DOA (Direction of Arrival), formación de haz y supresión de ruido, pero las optimizaciones de algoritmos de la v3.0 proporcionan un audio más limpio en entornos ruidosos del mundo real.
El sistema de LED se mantiene en 12 LED RGB programables en ambas versiones, pero la v3.0 está modelada según el diseño más reciente de USB 4 Mic Array, lo que la hace más pequeña y sencilla que el factor de forma orientado a desarrolladores de la v2.0, sin dejar de conservar las principales funciones profesionales de interfaz de voz.

Versión
| Versión del producto | Cambios | Fecha de lanzamiento |
|---|---|---|
| ReSpeaker Mic Array v1.0 | Inicial | 15 Ago, 2016 |
| ReSpeaker Mic Array v2.0 | XVSM-2000 está EOL, se cambia el MCU a XVF-3000 y se reducen los micrófonos de 7 a 4. | 25 Ene, 2018 |
| ReSpeaker Mic Array v3.0 | Códec cambiado a TLV320AIC3104 | 19 Ene, 2021 |
Características
- Captura de voz de campo lejano
- Compatible con USB Audio Class 1.0 (UAC 1.0)
- Matriz de cuatro micrófonos
- 12 indicadores LED RGB programables
- Algoritmos y funciones de voz
- Detección de actividad de voz
- Dirección de llegada
- Formación de haz
- Supresión de ruido
- Desreverberación
- Cancelación de eco acústico
Especificación
- XVF-3000 de XMOS
- 4 micrófonos digitales de alto rendimiento
- Admite captura de voz de campo lejano
- Algoritmo de voz en el chip
- 12 indicadores LED RGB programables
- Micrófonos: ST MP34DT01TR-M
- Sensibilidad: -26 dBFS (Omnidireccional)
- Punto de sobrecarga acústica: 120 dBSPL
- SNR: 61 dB
- Fuente de alimentación: 5V DC desde Micro USB o cabecera de expansión
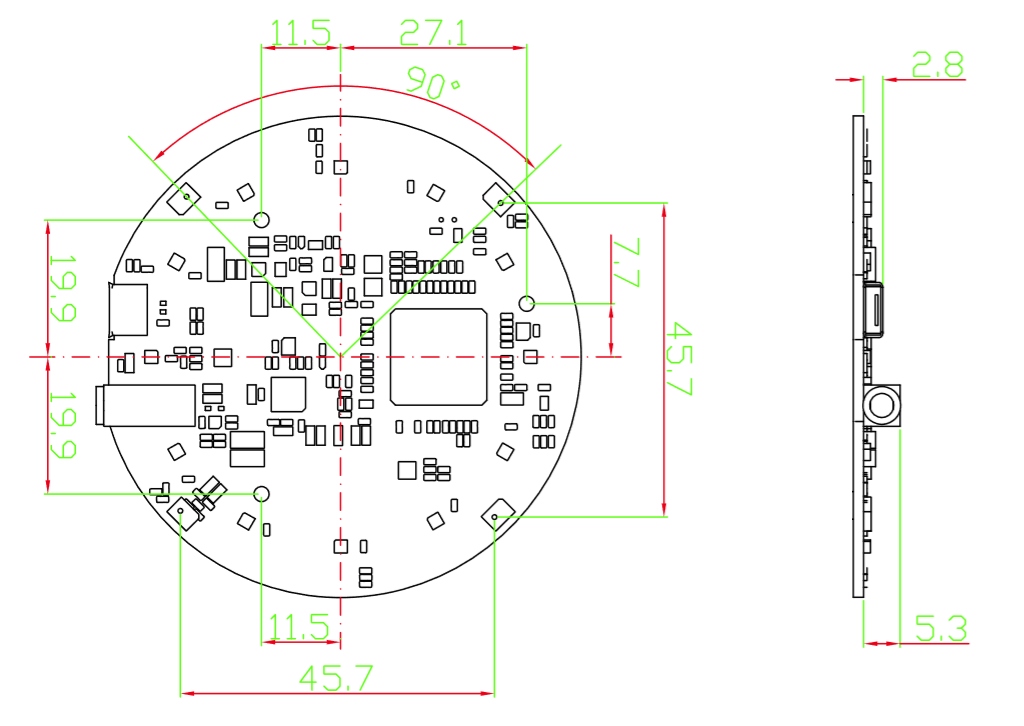
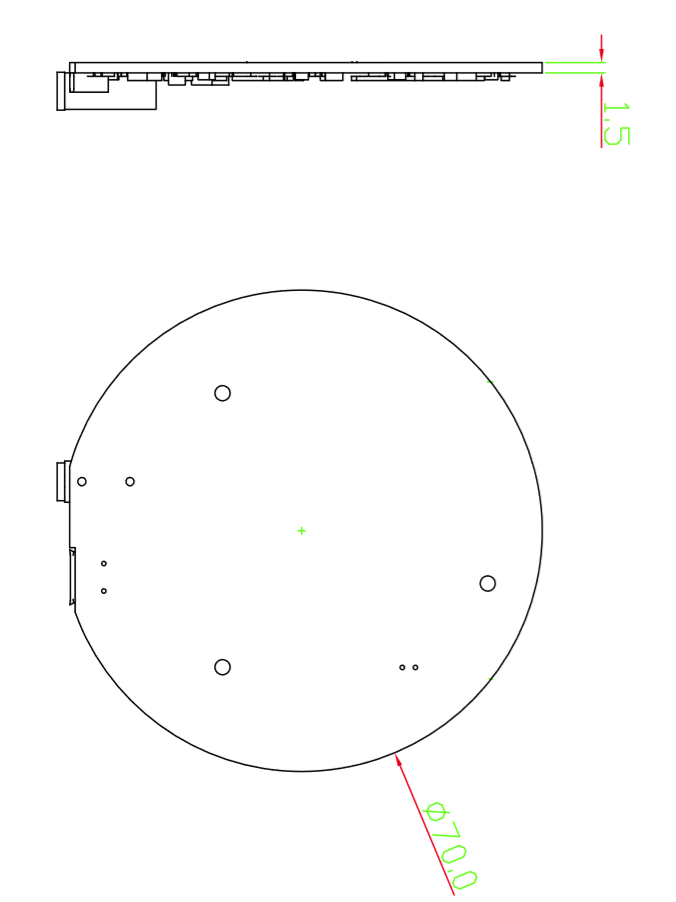
- Dimensiones: 70mm (diámetro)
- Toma de salida de audio de 3,5mm
- Consumo de energía: 5V, 180mA con LED encendido y 170mA con LED apagado
- Frecuencia de muestreo máxima: 16Khz
Descripción general del hardware

-
① XMOS XVF-3000: Integra algoritmos DSP avanzados que incluyen Acoustic Echo Cancellation (AEC), formación de haz, desreverberación, supresión de ruido y control de ganancia.
-
② Micrófono digital: El MP34DT01-M es un micrófono digital MEMS omnidireccional, de muy bajo consumo y ultra compacto, construido con un elemento de detección capacitivo y una interfaz IC.
-
③ LED RGB: LED RGB de tres colores.
-
④ Puerto USB: Proporciona la alimentación y controla la matriz de micrófonos.
-
⑤ Toma de auriculares de 3,5mm: Salida de audio. Podemos conectar altavoces activos o auriculares a este puerto.
-
⑥ TLV320AIC3104: El TLV320AIC3104 es un códec estéreo de bajo consumo que incorpora controladores de altavoz de Clase D para proporcionar 1 W por canal en cargas de 8 W.
Diagrama del sistema
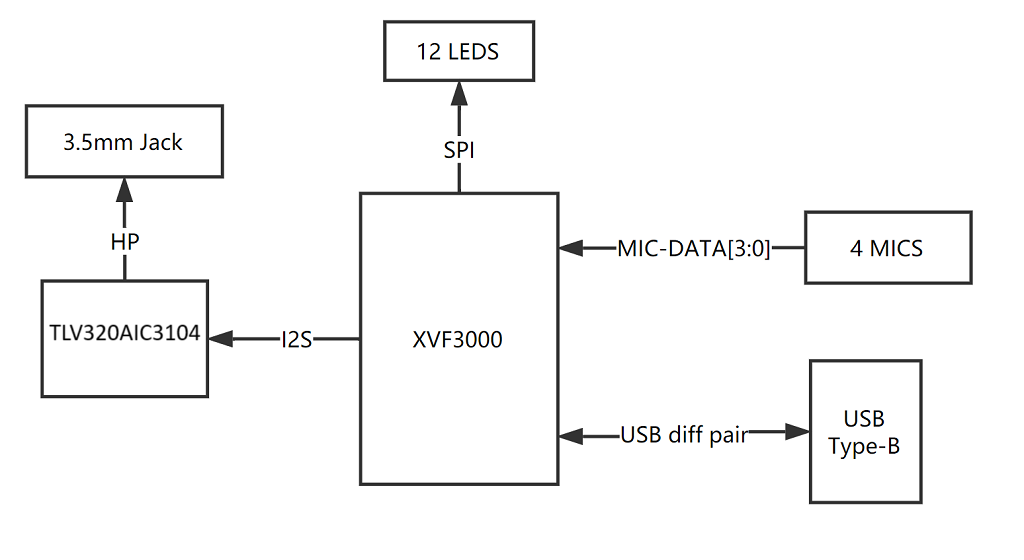
Mapa de pines

Dimensiones
Aplicaciones
- Captura de voz por USB
- Altavoz inteligente
- Sistemas inteligentes de asistente de voz
- Grabadoras de voz
- Sistema de conferencias de voz
- Equipos de comunicación para reuniones
- Robot de interacción por voz
- Asistente de voz para automóvil
- Otros escenarios de interfaz de voz
Primeros pasos
ReSpeaker Mic Array v3.0 es compatible con sistemas Windows, Mac, Linux y andriod. Los siguientes scripts se han probado en Python2.7.
Para andriod, lo probamos con emteria.OS(andriod 7.1) en Raspberry. Conectamos la mic array v3.0 al puerto USB de la Raspberry Pi y seleccionamos la ReSpeaker mic array v3.0 como dispositivo de audio. Aquí está la pantalla de grabación de audio.

Aquí está la pantalla de reproducción de audio. Conectamos un altavoz a la ReSpeaker mic array v3.0 mediante la toma de audio de 3,5mm y escuchamos lo que grabamos.

Actualizar firmware
Hay 2 firmwares. Uno incluye datos de 1 canal, mientras que el otro incluye datos de 6 canales (firmware de fábrica). Aquí está la tabla con las diferencias.
| Firmware | Canales | Nota |
|---|---|---|
| 1_channel_firmware.bin | 1 | Audio procesado para ASR |
| 6_channels_firmware.bin | 6 | Channel 0: processed audio for ASR Channel 1: mic1 raw data Channel 2: mic2 raw data Channel 3: mic3 raw data Channel 4: mic4 raw data Channel 5: merged playback |
Para Linux: La Mic array es compatible con USB DFU. Hemos desarrollado un script en Python dfu.py para actualizar el firmware a través de USB.
sudo apt-get update
sudo pip install pyusb click
git clone https://github.com/respeaker/usb_4_mic_array.git
cd usb_4_mic_array
sudo python dfu.py --download MicArrayV3_firmware/6_channels_dfu_4.0.0_firmware.bin # The 6 channels version

# if you want to use 1 channel,then the command should be like:

sudo python dfu.py --download MicArrayV3_firmware/1_channel_dfu_4.0.0_firmware.bin
Para Windows/Mac: No recomendamos usar una máquina virtual Windows/Mac y Linux para actualizar el firmware.
Demostración lista para usar
Aquí está el ejemplo de Acoustic Echo Cancellation con el firmware de 6 canales.
- Paso 1. Conecta el cable USB al PC y la toma de audio al altavoz.

- Paso 2. Selecciona la mic array v3.0 como dispositivo de salida en el PC.
- Paso 3. Inicia Audacity para grabar.
- Paso 4. Reproduce música primero en el PC y luego habla.
- Paso 5. Veremos la pantalla de Audacity como se muestra a continuación. Haz clic en Solo para escuchar el audio de cada canal.

Canal 0 Audio (procesado por algoritmos):
Canal1 Audio(Datos sin procesar de Mic1):
Canal5 Audio(Datos de reproducción):
Aquí está el video sobre DOA y AEC.
Instalar el controlador de DFU y control de LED
- Windows: La grabación y reproducción de audio funciona bien de forma predeterminada. El controlador Libusb-win32 solo se requiere para controlar los LED y los parámetros DSP en Windows. Usamos una herramienta práctica - Zadig para instalar el controlador libusb-win32 tanto para
SEEED DFUcomo paraSEEED Control(ReSpeaker Mic Array tiene 2 dispositivos en el Administrador de dispositivos de Windows).

Asegúrate de que esté seleccionado libusb-win32, no WinUSB ni libusbK.
- MAC: No se requiere controlador.
- Linux: No se requiere controlador.
Ajuste
Para Linux/Mac/Windows: Podemos configurar algunos parámetros de los algoritmos integrados.
- Obtén la lista completa de parámetros; para más información, consulta las Preguntas frecuentes.
git clone https://github.com/respeaker/usb_4_mic_array.git
cd usb_4_mic_array
python tuning.py -p
- Ejemplo#1, podemos desactivar el Control Automático de Ganancia (AGC):
python tuning.py AGCONOFF 0
- Ejemplo#2, podemos comprobar el ángulo de DOA.
pi@raspberrypi:~/usb_4_mic_array $ sudo python tuning.py DOAANGLE
DOAANGLE: 180
Controlar los LED
Podemos controlar los LED del ReSpeaker Mic Array V2 a través de USB. El dispositivo USB tiene una interfaz de clase específica del proveedor que se puede usar para enviar datos mediante USB Control Transfer. Nos basamos en la biblioteca de Python pyusb y desarrollamos la biblioteca de Python usb_pixel_ring.
El comando de control de LED se envía mediante usb.core.Device.ctrl_transfer() de pyusb; sus parámetros son los siguientes:
ctrl_transfer(usb.util.CTRL_OUT | usb.util.CTRL_TYPE_VENDOR | usb.util.CTRL_RECIPIENT_DEVICE, 0, command, 0x1C, data, TIMEOUT)
Aquí están las API de usb_pixel_ring.
| Comando | Datos | API | Nota |
|---|---|---|---|
| 0 | [0] | pixel_ring.trace() | modo trace, los LED cambian dependiendo de VADy DOA |
| 1 | [red, green, blue, 0] | pixel_ring.mono() | modo mono, establece todos los LED RGB en un solo color, por ejemplo Red(0xFF0000), Green(0x00FF00), Blue(0x0000FF) |
| 2 | [0] | pixel_ring.listen() | modo listen, similar al modo trace, pero no apaga los LED |
| 3 | [0] | pixel_ring.speak() | modo de espera |
| 4 | [0] | pixel_ring.think() | modo speak |
| 5 | [0] | pixel_ring.spin() | modo spin |
| 6 | [r, g, b, 0] * 12 | pixel_ring.custimize() | modo personalizado, establece cada LED en su propio color |
| 0x20 | [brightness] | pixel_ring.set_brightness() | establece el brillo, rango: 0x00~0x1F |
| 0x21 | [r1, g1, b1, 0, r2, g2, b2, 0] | pixel_ring.set_color_palette() | establece la paleta de colores, por ejemplo, pixel_ring.set_color_palette(0xff0000, 0x00ff00) junto con pixel_ring.think() |
| 0x22 | [vad_led] | pixel_ring.set_vad_led() | establece el LED central: 0 - apagado, 1 - encendido, otro - depende de VAD |
| 0x23 | [volume] | pixel_ring.set_volume() | muestra el volumen, rango: 0 ~ 12 |
| 0x24 | [pattern] | pixel_ring.change_pattern() | establece el patrón, 0 - patrón de Google Home, otros - patrón de Echo |
Para Linux: Aquí está el ejemplo para controlar los LED. Sigue los siguientes comandos para ejecutar la demostración.
git clone https://github.com/respeaker/pixel_ring.git
cd pixel_ring
sudo python setup.py install
sudo python examples/usb_mic_array.py
Aquí está el código de usb_mic_array.py.
import time
from pixel_ring import pixel_ring


if __name__ == '__main__':
    pixel_ring.change_pattern('echo')
    while True:

        try:
            pixel_ring.wakeup()
            time.sleep(3)
            pixel_ring.think()
            time.sleep(3)
            pixel_ring.speak()
            time.sleep(6)
            pixel_ring.off()
            time.sleep(3)
        except KeyboardInterrupt:
            break


    pixel_ring.off()
    time.sleep(1)
Para Windows/Mac: Aquí está el ejemplo para controlar los LED.
- Paso 1. Descarga pixel_ring.
git clone https://github.com/respeaker/pixel_ring.git
cd pixel_ring/pixel_ring
- Paso 2. Crea un led_control.py con el siguiente código y ejecuta 'python led_control.py'
from usb_pixel_ring_v2 import PixelRing
import usb.core
import usb.util
import time

dev = usb.core.find(idVendor=0x2886, idProduct=0x0018)
print dev
if dev:
    pixel_ring = PixelRing(dev)

    while True:
        try:
            pixel_ring.wakeup(180)
            time.sleep(3)
            pixel_ring.listen()
            time.sleep(3)
            pixel_ring.think()
            time.sleep(3)
            pixel_ring.set_volume(8)
            time.sleep(3)
            pixel_ring.off()
            time.sleep(3)
        except KeyboardInterrupt:
            break

    pixel_ring.off()
Si ves "None" impreso en la pantalla, vuelve a instalar el controlador libusb-win32.
DOA (Direction of Arrival)
Para Windows/Mac/Linux: Aquí está el ejemplo para ver el DOA. El LED verde es el indicador de la dirección de la voz. Para el ángulo, consulta la descripción general del hardware.
- Paso 1. Descarga usb_4_mic_array.
git clone https://github.com/respeaker/usb_4_mic_array.git
cd usb_4_mic_array
- Paso 2. Crea un DOA.py con el siguiente código en la carpeta usb_4_mic_array y ejecuta 'python DOA.py'
from tuning import Tuning
import usb.core
import usb.util
import time

dev = usb.core.find(idVendor=0x2886, idProduct=0x0018)

if dev:
    Mic_tuning = Tuning(dev)
    print Mic_tuning.direction
    while True:
        try:
            print Mic_tuning.direction
            time.sleep(1)
        except KeyboardInterrupt:
            break
- Paso 3. Veremos el DOA como se muestra a continuación.
pi@raspberrypi:~/usb_4_mic_array $ sudo python doa.py
184
183
175
105
104
104
103
VAD (Voice Activity Detection)
Para Windows/Mac/Linux: Aquí está el ejemplo para ver el VAD. El LED rojo es el indicador del VAD.
- Paso 1. Descarga usb_4_mic_array.
git clone https://github.com/respeaker/usb_4_mic_array.git
cd usb_4_mic_array
- Paso 2. Crea un VAD.py con el siguiente código en la carpeta usb_4_mic_array y ejecuta 'python VAD.py'
from tuning import Tuning
import usb.core
import usb.util
import time

dev = usb.core.find(idVendor=0x2886, idProduct=0x0018)
#print dev
if dev:
    Mic_tuning = Tuning(dev)
    print Mic_tuning.is_voice()
    while True:
        try:
            print Mic_tuning.is_voice()
            time.sleep(1)
        except KeyboardInterrupt:
            break
- Paso 3. Veremos el DOA como se muestra a continuación.
pi@raspberrypi:~/usb_4_mic_array $ sudo python VAD.py
0
0
0
1
0
1
0
Para el umbral de VAD, también podemos usar GAMMAVAD_SR para configurarlo. Consulta Tuning para más detalles.
Extraer voz
Usamos la biblioteca de Python PyAudio para extraer voz a través de USB.
Para Linux: Podemos usar los siguientes comandos para grabar o reproducir la voz.
arecord -D plughw:1,0 -f cd test.wav # record, please use the arecord -l to check the card and hardware first
aplay -D plughw:1,0 -f cd test.wav # play, please use the aplay -l to check the card and hardware first
arecord -D plughw:1,0 -f cd |aplay -D plughw:1,0 -f cd # record and play at the same time
También podemos usar un script de Python para extraer la voz.
- Paso 1, necesitamos ejecutar el siguiente script para obtener el número de índice de dispositivo de Mic Array:
sudo pip install pyaudio
cd ~
nano get_index.py
- Paso 2, copia el siguiente código y pégalo en get_index.py.
Si estás usando Python 3, este archivo es adecuado para usar get_index.py
import pyaudio

p = pyaudio.PyAudio()
info = p.get_host_api_info_by_index(0)
numdevices = info.get('deviceCount')

for i in range(0, numdevices):
        if (p.get_device_info_by_host_api_device_index(0, i).get('maxInputChannels')) > 0:
            print "Input Device id ", i, " - ", p.get_device_info_by_host_api_device_index(0, i).get('name')
-
Paso 3, presiona
Ctrl+Xpara salir y presiona Y para guardar. -
Paso 4, ejecuta 'sudo python get_index.py' y veremos el ID del dispositivo como se muestra a continuación.
Input Device id 2 - ReSpeaker 4 Mic Array (UAC1.0): USB Audio (hw:1,0)
- Paso 5, cambia
RESPEAKER_INDEX = 2al número de índice. Ejecuta el script de Python record.py para grabar un discurso.
import pyaudio
import wave

RESPEAKER_RATE = 16000
RESPEAKER_CHANNELS = 6 # change base on firmwares, 1_channel_firmware.bin as 1 or 6_channels_firmware.bin as 6
RESPEAKER_WIDTH = 2
# run getDeviceInfo.py to get index
RESPEAKER_INDEX = 2  # refer to input device id
CHUNK = 1024
RECORD_SECONDS = 5
WAVE_OUTPUT_FILENAME = "output.wav"

p = pyaudio.PyAudio()

stream = p.open(
            rate=RESPEAKER_RATE,
            format=p.get_format_from_width(RESPEAKER_WIDTH),
            channels=RESPEAKER_CHANNELS,
            input=True,
            input_device_index=RESPEAKER_INDEX,)

print("* recording")

frames = []

for i in range(0, int(RESPEAKER_RATE / CHUNK * RECORD_SECONDS)):
    data = stream.read(CHUNK)
    frames.append(data)

print("* done recording")

stream.stop_stream()
stream.close()
p.terminate()

wf = wave.open(WAVE_OUTPUT_FILENAME, 'wb')
wf.setnchannels(RESPEAKER_CHANNELS)
wf.setsampwidth(p.get_sample_size(p.get_format_from_width(RESPEAKER_WIDTH)))
wf.setframerate(RESPEAKER_RATE)
wf.writeframes(b''.join(frames))
wf.close()
- Paso 6. Si quieres extraer los datos del canal 0 de 6 canales, sigue el siguiente código. Para otro canal X, cambia [0::6] a [X::6].
import pyaudio
import wave
import numpy as np

RESPEAKER_RATE = 16000
RESPEAKER_CHANNELS = 6 # change base on firmwares, 1_channel_firmware.bin as 1 or 6_channels_firmware.bin as 6
RESPEAKER_WIDTH = 2
# run getDeviceInfo.py to get index
RESPEAKER_INDEX = 3  # refer to input device id
CHUNK = 1024
RECORD_SECONDS = 3
WAVE_OUTPUT_FILENAME = "output.wav"

p = pyaudio.PyAudio()

stream = p.open(
            rate=RESPEAKER_RATE,
            format=p.get_format_from_width(RESPEAKER_WIDTH),
            channels=RESPEAKER_CHANNELS,
            input=True,
            input_device_index=RESPEAKER_INDEX,)

print("* recording")

frames = []

for i in range(0, int(RESPEAKER_RATE / CHUNK * RECORD_SECONDS)):
    data = stream.read(CHUNK)
    # extract channel 0 data from 6 channels, if you want to extract channel 1, please change to [1::6]
    a = np.fromstring(data,dtype=np.int16)[0::6]
    frames.append(a.tostring())

print("* done recording")

stream.stop_stream()
stream.close()
p.terminate()

wf = wave.open(WAVE_OUTPUT_FILENAME, 'wb')
wf.setnchannels(1)
wf.setsampwidth(p.get_sample_size(p.get_format_from_width(RESPEAKER_WIDTH)))
wf.setframerate(RESPEAKER_RATE)
wf.writeframes(b''.join(frames))
wf.close()
Para Windows:
- Paso 1. Ejecutamos el siguiente comando para instalar pyaudio.
pip install pyaudio
- Paso 2. Usa get_index.py para obtener el índice del dispositivo.
C:\Users\XXX\Desktop>python get_index.py
Input Device id  0  -  Microsoft Sound Mapper - Input
Input Device id  1  -  ReSpeaker 4 Mic Array (UAC1.0)
Input Device id  2  -  Internal Microphone (Conexant I)
- Paso 3. Modifica el índice del dispositivo y los canales de record.py y luego extrae la voz.
C:\Users\XXX\Desktop>python record.py
* recording
* done recording
Si vemos "Error: %1 is not a valid Win32 application.", instala la versión Win32 de Python.
Para MAC:
- Paso 1. Ejecutamos el siguiente comando para instalar pyaudio.
pip install pyaudio
- Paso 2. Usa get_index.py para obtener el índice del dispositivo.
MacBook-Air:Desktop XXX$ python get_index.py
Input Device id  0  -  Built-in Microphone
Input Device id  2  -  ReSpeaker 4 Mic Array (UAC1.0)
- Paso 3. Modifica el índice del dispositivo y los canales de record.py y luego extrae la voz.
MacBook-Air:Desktop XXX$ python record.py
2018-03-24 14:53:02.400 Python[2360:16629] 14:53:02.399 WARNING:  140: This application, or a library it uses, is using the deprecated Carbon Component Manager for hosting Audio Units. Support for this will be removed in a future release. Also, this makes the host incompatible with version 3 audio units. Please transition to the API's in AudioComponent.h.
* recording
* done recording
Preguntas frecuentes
P1: Parámetros de los algoritmos integrados
pi@raspberrypi:~/usb_4_mic_array $ python tuning.py -p
name   type max min r/w info
-------------------------------
AECFREEZEONOFF   int 1 0 rw Adaptive Echo Canceler updates inhibit.
                                                            0 = Adaptation enabled
                                                            1 = Freeze adaptation, filter only
AECNORM          float 16 0.25 rw Limit on norm of AEC filter coefficients
AECPATHCHANGE    int 1 0 ro AEC Path Change Detection.
                                                            0 = false (no path change detected)
                                                            1 = true (path change detected)
AECSILENCELEVEL  float 1 1e-09 rw Threshold for signal detection in AEC [-inf .. 0] dBov (Default: -80dBov = 10log10(1x10⁻⁸))
AECSILENCEMODE   int 1 0 ro AEC far-end silence detection status.
                                                            0 = false (signal detected)
                                                            1 = true (silence detected)
AGCDESIREDLEVEL  float 0.99 1e-08 rw Target power level of the output signal.
                                                            [−inf .. 0] dBov (default: −23dBov = 10log10(0.005))
AGCGAIN          float 1000 1 rw Current AGC gain factor.
                                                            [0 .. 60] dB (default: 0.0dB = 20log10(1.0))
AGCMAXGAIN       float 1000 1 rw Maximum AGC gain factor.
                                                            [0 .. 60] dB (default 30dB = 20log10(31.6))
AGCONOFF         int 1 0 rw Automatic Gain Control.
                                                            0 = OFF
                                                            1 = ON
AGCTIME          float 1 0.1 rw Ramps-up / down time-constant in seconds.
CNIONOFF         int 1 0 rw Comfort Noise Insertion.
                                                            0 = OFF
                                                            1 = ON
DOAANGLE         int 359 0 ro DOA angle. Current value. Orientation depends on build configuration.
ECHOONOFF        int 1 0 rw Echo suppression.
                                                            0 = OFF
                                                            1 = ON
FREEZEONOFF      int 1 0 rw Adaptive beamformer updates.
                                                            0 = Adaptation enabled
                                                            1 = Freeze adaptation, filter only
FSBPATHCHANGE    int 1 0 ro FSB Path Change Detection.
                                                            0 = false (no path change detected)
                                                            1 = true (path change detected)
FSBUPDATED       int 1 0 ro FSB Update Decision.
                                                            0 = false (FSB was not updated)
                                                            1 = true (FSB was updated)
GAMMAVAD_SR      float 1000 0 rw Set the threshold for voice activity detection.
                                                            [−inf .. 60] dB (default: 3.5dB 20log10(1.5))
GAMMA_E          float 3 0 rw Over-subtraction factor of echo (direct and early components). min .. max attenuation
GAMMA_ENL        float 5 0 rw Over-subtraction factor of non-linear echo. min .. max attenuation
GAMMA_ETAIL      float 3 0 rw Over-subtraction factor of echo (tail components). min .. max attenuation
GAMMA_NN         float 3 0 rw Over-subtraction factor of non- stationary noise. min .. max attenuation
GAMMA_NN_SR      float 3 0 rw Over-subtraction factor of non-stationary noise for ASR.
                                                            [0.0 .. 3.0] (default: 1.1)
GAMMA_NS         float 3 0 rw Over-subtraction factor of stationary noise. min .. max attenuation
GAMMA_NS_SR      float 3 0 rw Over-subtraction factor of stationary noise for ASR.
                                                            [0.0 .. 3.0] (default: 1.0)
HPFONOFF         int 3 0 rw High-pass Filter on microphone signals.
                                                            0 = OFF
                                                            1 = ON - 70 Hz cut-off
                                                            2 = ON - 125 Hz cut-off
                                                            3 = ON - 180 Hz cut-off
MIN_NN           float 1 0 rw Gain-floor for non-stationary noise suppression.
                                                            [−inf .. 0] dB (default: −10dB = 20log10(0.3))
MIN_NN_SR        float 1 0 rw Gain-floor for non-stationary noise suppression for ASR.
                                                            [−inf .. 0] dB (default: −10dB = 20log10(0.3))
MIN_NS           float 1 0 rw Gain-floor for stationary noise suppression.
                                                            [−inf .. 0] dB (default: −16dB = 20log10(0.15))
MIN_NS_SR        float 1 0 rw Gain-floor for stationary noise suppression for ASR.
                                                            [−inf .. 0] dB (default: −16dB = 20log10(0.15))
NLAEC_MODE       int 2 0 rw Non-Linear AEC training mode.
                                                            0 = OFF
                                                            1 = ON - phase 1
                                                            2 = ON - phase 2
NLATTENONOFF     int 1 0 rw Non-Linear echo attenuation.
                                                            0 = OFF
                                                            1 = ON
NONSTATNOISEONOFF int 1 0 rw Non-stationary noise suppression.
                                                            0 = OFF
                                                            1 = ON
NONSTATNOISEONOFF_SR int 1 0 rw Non-stationary noise suppression for ASR.
                                                            0 = OFF
                                                            1 = ON
RT60             float 0.9 0.25 ro Current RT60 estimate in seconds
RT60ONOFF        int 1 0 rw RT60 Estimation for AES. 0 = OFF 1 = ON
SPEECHDETECTED   int 1 0 ro Speech detection status.
                                                            0 = false (no speech detected)
                                                            1 = true (speech detected)
STATNOISEONOFF   int 1 0 rw Stationary noise suppression.
                                                            0 = OFF
                                                            1 = ON
STATNOISEONOFF_SR int 1 0 rw Stationary noise suppression for ASR.
                                                            0 = OFF
                                                            1 = ON
TRANSIENTONOFF   int 1 0 rw Transient echo suppression.
                                                            0 = OFF
                                                            1 = ON
VOICEACTIVITY    int 1 0 ro VAD voice activity status.
                                                            0 = false (no voice activity)
                                                            1 = true (voice activity)
P2: ImportError: No module named usb.core
R2: Ejecuta sudo pip install pyusb para instalar pyusb.
pi@raspberrypi:~/usb_4_mic_array $ sudo python tuning.py DOAANGLE
Traceback (most recent call last):
  File "tuning.py", line 5, in <module>
    import usb.core
ImportError: No module named usb.core
pi@raspberrypi:~/usb_4_mic_array $ sudo pip install pyusb
Collecting pyusb
  Downloading pyusb-1.0.2.tar.gz (54kB)
    100% |████████████████████████████████| 61kB 101kB/s
Building wheels for collected packages: pyusb
  Running setup.py bdist_wheel for pyusb ... done
  Stored in directory: /root/.cache/pip/wheels/8b/7f/fe/baf08bc0dac02ba17f3c9120f5dd1cf74aec4c54463bc85cf9
Successfully built pyusb
Installing collected packages: pyusb
Successfully installed pyusb-1.0.2
pi@raspberrypi:~/usb_4_mic_array $ sudo python tuning.py DOAANGLE
DOAANGLE: 180
P3: ¿Tienen el ejemplo para la aplicación de Raspberry alexa?
R3: Sí, podemos conectar el mic array v3.0 al puerto usb de la Raspberry y seguir Raspberry Pi Quick Start Guide with Script para realizar la interacción por voz con alexa.
P4: ¿Tienen el ejemplo para Mic array v3.0 con sistema ROS?
R4: Sí, gracias a Yuki por compartir el paquete para integrar ReSpeaker Mic Array v2 con ROS (Robot Operating System) Middleware.
P5: ¿Cómo habilitar el puerto de audio de 3,5 mm para recibir la señal así como el puerto usb?
R5: Descarga el nuevo firmware y graba el XMOS siguiendo How to update firmware.
Recursos
- [PDF] ReSpeaker MicArray v3.0 Esquemático
- [PDF] ReSpeaker MicArray v3.0 Descripción del Producto
- [PDF] ReSpeaker MicArray v3.0 Modelo 3D
- [SKP] ReSpeaker MicArray v3.0 Modelo 3D
- [STP] ReSpeaker MicArray v3.0 Modelo 3D
- [PDF] XVF3000 Descripción del Producto
- [PDF] XVF3000 Hoja de Datos
- [Github] ReSpeaker Mic Array v2 con ROS (Robot Operating System) Middleware
Soporte Técnico y Debate sobre el Producto
Gracias por elegir nuestros productos. Estamos aquí para ofrecerte diferentes tipos de soporte y garantizar que tu experiencia con nuestros productos sea lo más fluida posible. Ofrecemos varios canales de comunicación para adaptarnos a diferentes preferencias y necesidades.