Cómo desplegar y evaluar ACT en reBot Arm
Ejecuta ACT en un robot real, comprende el preprocesamiento y la ejecución de fragmentos de acciones, mide el éxito y mejora los datos analizando los fallos.
- Inferencia en robot
- Ejecución de fragmentos de acciones
- Evaluación
- Iteración de datos
Flujo de Datos de Inferencia de un Vistazo
Preprocesamiento y Desnormalización
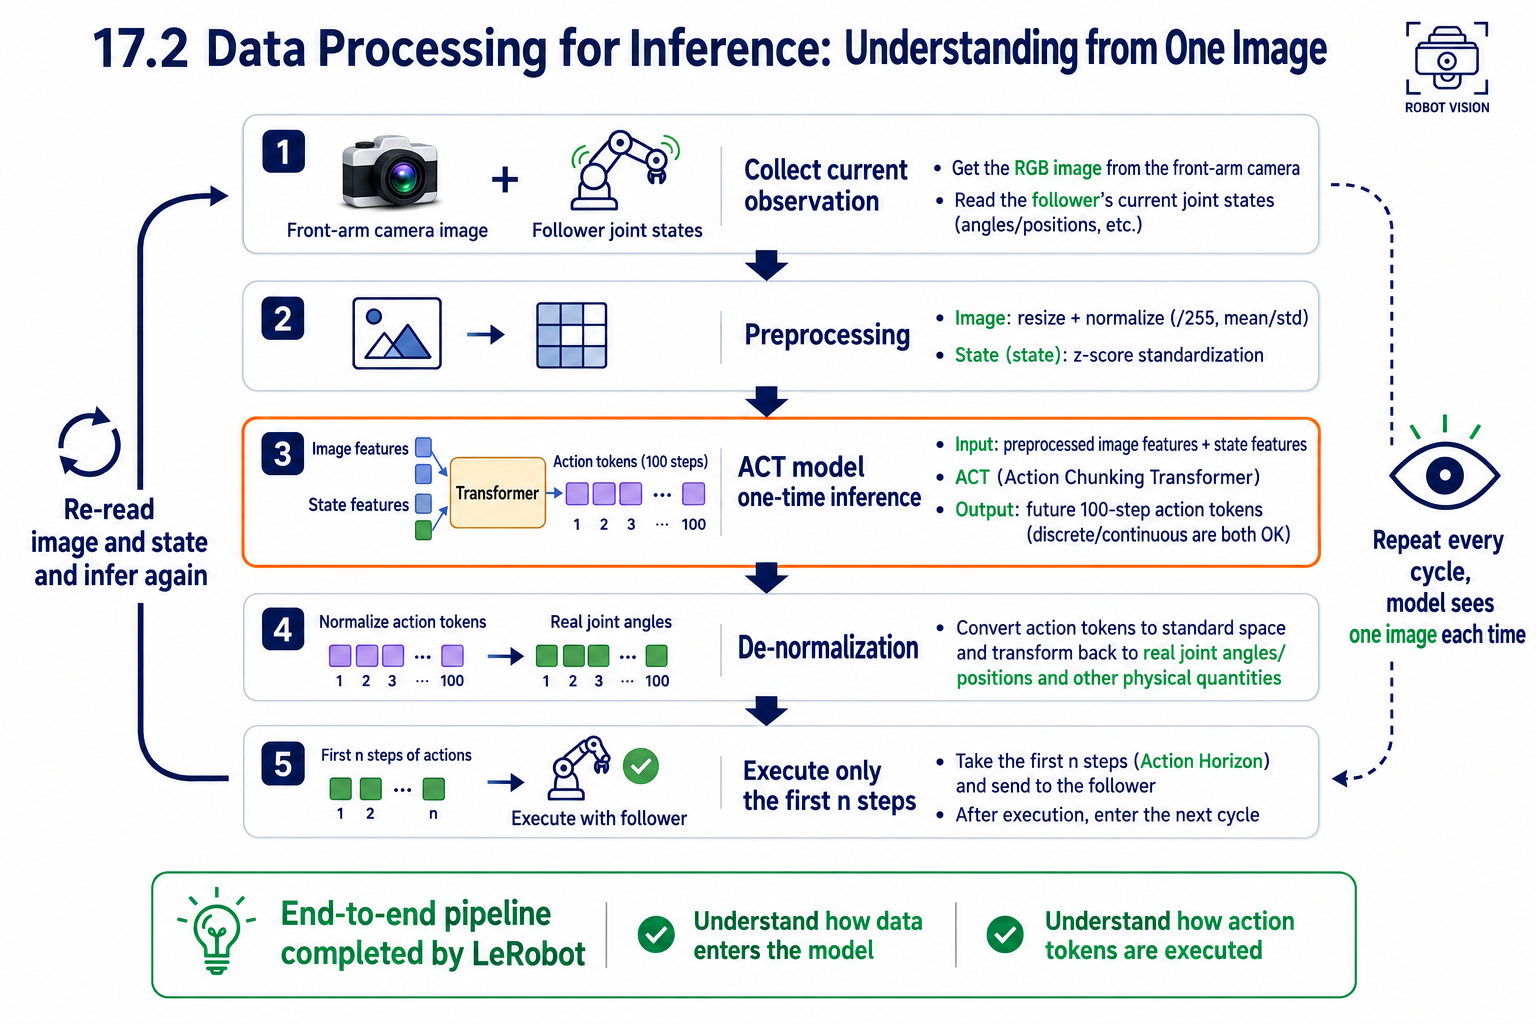
El modelo se entrenó con datos normalizados, por lo que la inferencia debe aplicar las mismas reglas de entrada y salida:
| Dirección | Procesamiento | Estadísticas |
|---|---|---|
| Hacia el modelo | Redimensionar imágenes y aplicar normalización de ImageNet; restar las medias de estado y dividir por las desviaciones estándar (z-score). | Conjunto de datos de entrenamiento meta/stats.json |
| Fuera del modelo | Multiplicar las acciones por las desviaciones estándar y sumar las medias para recuperar los ángulos físicos de las articulaciones. | Las mismas estadísticas |
Iniciar la Inferencia en Robot e Iterar sobre los Datos
Carga la política con lerobot-record. Usa exactamente los mismos parámetros de robot y cámara que durante la recolección:
Versión RS:
lerobot-record \
  --robot.type=seeed_b601_rs_follower \
  --robot.port=can0 \
  --robot.can_adapter=socketcan \
  --robot.cameras='{ front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30, fourcc: "MJPG"}, side: {type: opencv, index_or_path: 2, width: 640, height: 480, fps: 30, fourcc: "MJPG"} }' \
  --robot.id=follower1 \
  --display_data=false \
  --dataset.repo_id=seeed/eval_test18 \
  --dataset.single_task="Grab the crayfish into the box" \
  --dataset.num_episodes=10 \
  --dataset.episode_time_s=60 \
  --dataset.reset_time_s=10 \
  --policy.path=outputs/train/act_rebot_test/checkpoints/last/pretrained_model \
  --policy.push_to_hub=false
Versión DM:
lerobot-record \
  --robot.type=seeed_b601_dm_follower \
  --robot.port=/dev/ttyACM0 \
  --robot.can_adapter=damiao \
  --robot.cameras='{ front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30, fourcc: "MJPG"}, side: {type: opencv, index_or_path: 2, width: 640, height: 480, fps: 30, fourcc: "MJPG"} }' \
  --robot.id=follower1 \
  --display_data=false \
  --dataset.repo_id=seeed/eval_test18 \
  --dataset.single_task="Grab the crayfish into the box" \
  --dataset.num_episodes=10 \
  --dataset.episode_time_s=60 \
  --dataset.reset_time_s=10 \
  --policy.path=outputs/train/act_rebot_test/checkpoints/last/pretrained_model \
  --policy.push_to_hub=false
-
--dataset.num_episodes=10: registra 10 episodios de evaluación. -
--dataset.episode_time_s=60: permite como máximo 60 segundos por episodio. Ajusta esto a la duración de la tarea: si poner el cangrejo de río en la caja lleva 20–30 segundos, permite 30–40 segundos. Para observación prolongada sin esperar entre episodios, puedes usar una duración mayor, como 300 segundos. -
--dataset.reset_time_s=10: permite 10 segundos entre episodios para restaurar las posiciones de los objetos. Mantén las condiciones iniciales lo más consistentes posible durante la evaluación.
Ejecución de un Fragmento de Acción
-
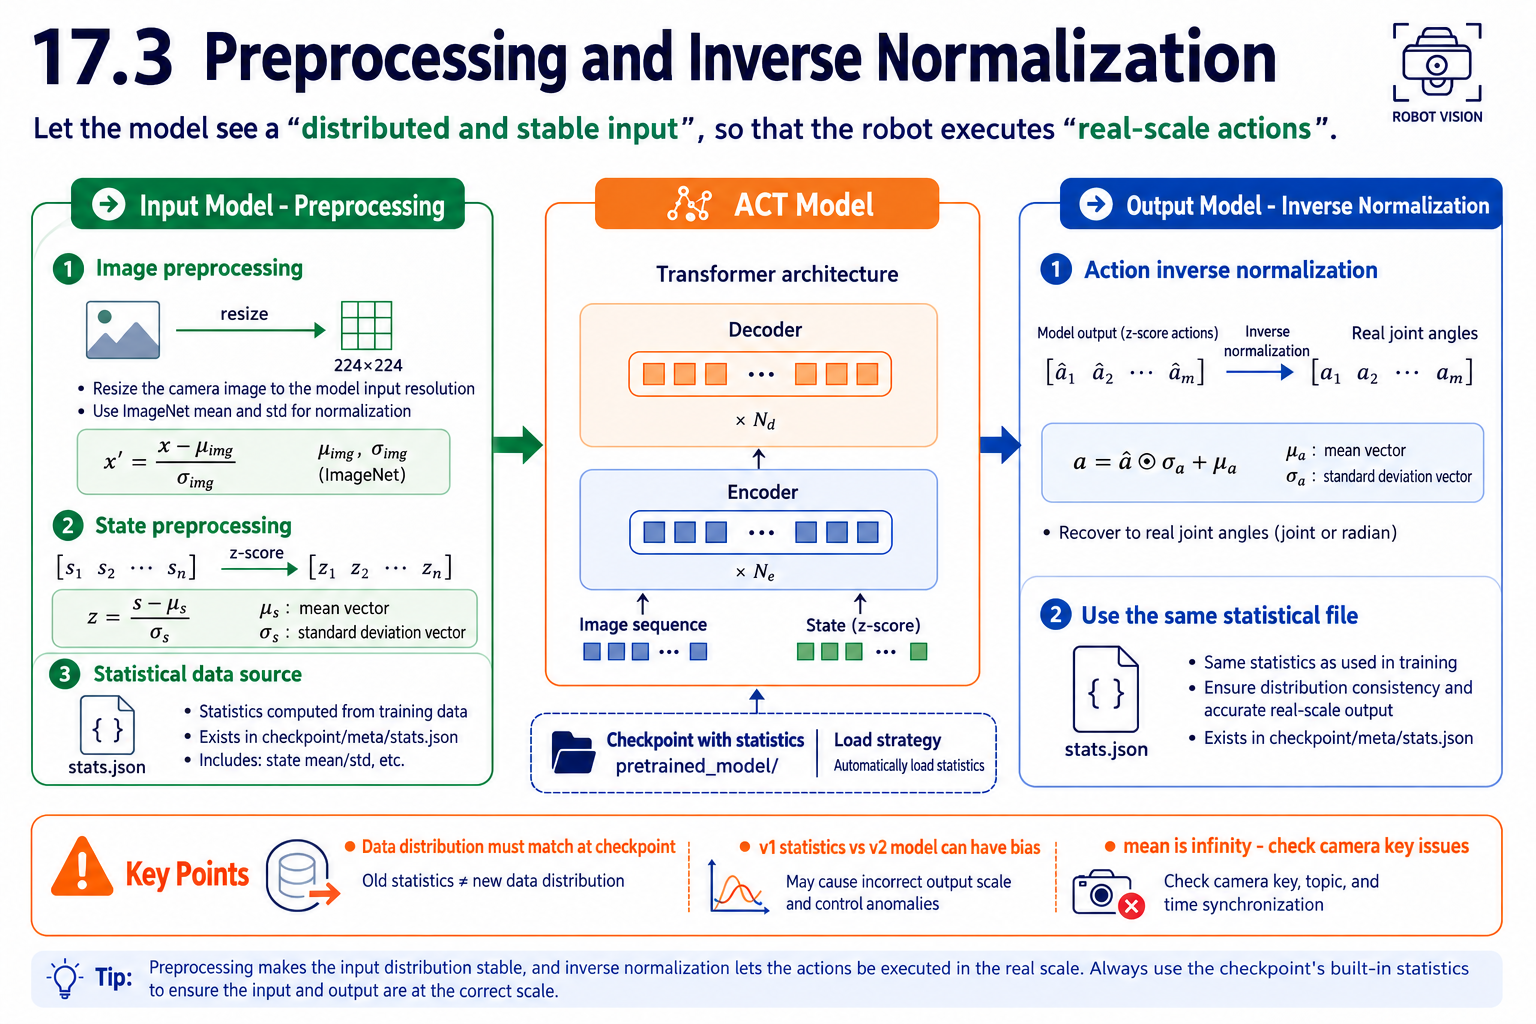
Una inferencia predice un fragmento de acción de 100 pasos. Ejecuta solo los primeros n pasos en lazo abierto (
n_action_steps), luego observa de nuevo: las predicciones se vuelven menos fiables cuanto más se proyectan en el futuro. -
Con el ensamblado temporal (
temporal_ensemble_coeff), la acción en cada instante de tiempo es un promedio ponderado de predicciones superpuestas, produciendo trayectorias más suaves. -
A menudo se observan pausas visibles cuando un fragmento termina antes de que la siguiente inferencia esté lista. Aumentar
n_action_stepspuede reducir estas pausas, a costa de respuestas más lentas ante perturbaciones.
Seguridad: Límites, Velocidad y Paradas de Emergencia
-
Usa ESC para terminar la sesión; no uses Ctrl+C. Antes de detener, deja que el brazo termine su fragmento de acción actual o devuélvelo manualmente a una postura segura (aunque Ctrl+C actualmente también devuelve el robot a cero), para evitar dejarlo suspendido bajo carga.
-
Estate preparado para desconectar la alimentación inmediatamente si el brazo se comporta de forma anómala.
Evaluar la Tasa de Éxito y el Tiempo de Finalización
Fija las condiciones iniciales y ejecuta 20 pruebas, registrando cada resultado.
-
Tasa de éxito = pruebas exitosas ÷ 20. Para el primer modelo entrenado, por encima del 50% es un punto de partida normal y por encima del 80% es excelente.
-
El tiempo de finalización indica consistencia. Las pruebas exitosas deberían tardar tiempos similares; grandes variaciones sugieren vacilación.
-
Para los fallos, registra el modo de fallo, en lugar de solo marcar una cruz.
Probar la Generalización
Después de probar las condiciones estándar, cambia una condición a la vez y mide la caída en la tasa de éxito. Un modelo ACT entrenado con 50 episodios tiene una generalización limitada; una cobertura más amplia requiere más demostraciones.
| Prueba | Método | Comportamiento esperado |
|---|---|---|
| Generalización de posición | Coloca el bloque lejos de los cinco puntos marcados, pero dentro de la región demostrada. | Poca degradación; una caída sugiere diversidad de posiciones insuficiente. |
| Distracción leve | Añade objetos no relacionados a la mesa. | Un modelo con comprensión visual limpia no debería verse afectado. |
| Cambio de distribución claro | Usa un objeto completamente nuevo o una superficie de mesa reflectante. | Se espera fallo fuera de la distribución de entrenamiento. |
El propósito es mapear el límite de capacidad del modelo y luego ampliarlo gradualmente con más datos.
Analizar los Tipos de Fallo
| Fallo | Causa más probable | Respuesta |
|---|---|---|
| Se dirige hacia la posición equivocada | Cobertura de datos insuficiente en esa posición; cambio de distribución. | Recoge más demostraciones en esa región. |
| Contacta con el objeto pero no puede sujetarlo, o lo suelta | Momento de cierre mal aprendido o muy pocos ejemplos de agarre. | Añade demostraciones de alta calidad del momento de agarre. |
| Se mueve de forma errática en todo momento | El entrenamiento no ha convergido, o la escena y la iluminación han cambiado sustancialmente. | Comprueba que la escena y la iluminación durante la recolección coincidan con las de la inferencia. |
Descarta problemas de configuración antes de culpar a los datos. El movimiento errático a menudo requiere comprobaciones de configuración; el alcance impreciso a menudo requiere mejor cobertura.
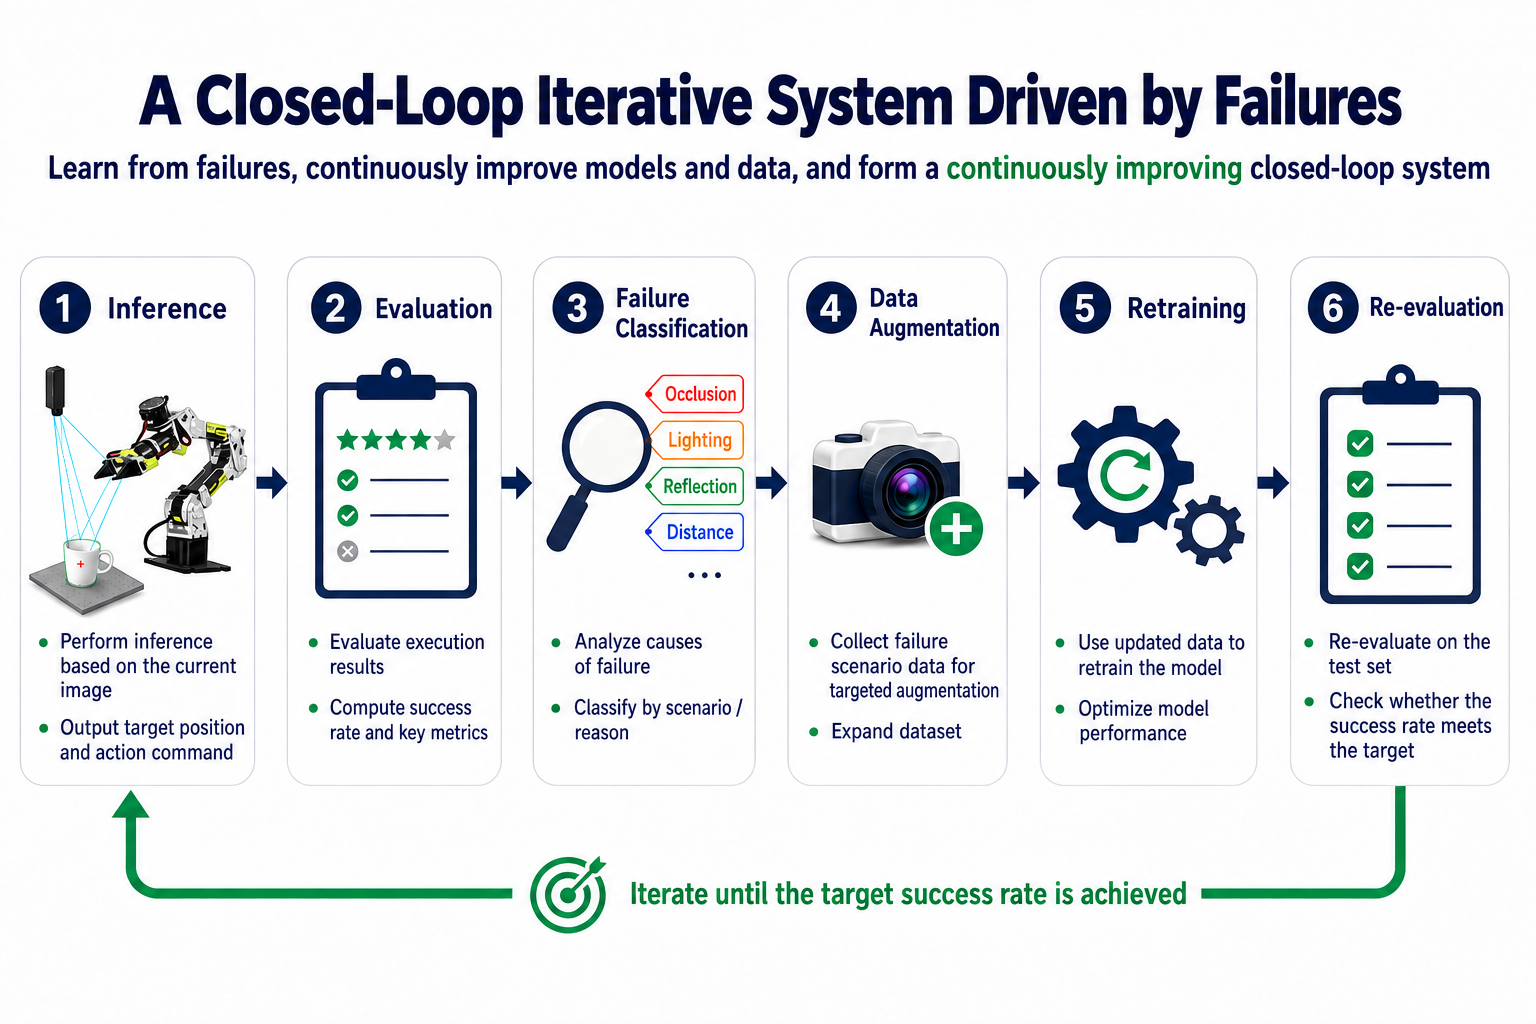
Iteración de Datos: Recopilar para Casos de Fallo
Cierra el ciclo convirtiendo los fallos en datos:
-
Clasifica el fallo y la escena en la que ocurre.
-
Recopila de 10 a 20 demostraciones nuevas dirigidas a ese caso. Para alcances fallidos, registra la ubicación problemática; para agarres inestables, enfatiza el movimiento de cierre. Amplía la región cubierta gradualmente, por ejemplo con nuevos puntos espaciados 5–10 cm alrededor de la cruz original.
-
Reentrena usando el conjunto de datos actualizado.