Cómo entrenar ACT en reBot Arm
Configura el entrenamiento de ACT, inicia una ejecución, supervisa la pérdida y el uso de la GPU, reanuda entrenamientos interrumpidos y gestiona los checkpoints.
- Configuración de entrenamiento
- Pérdida y uso de la GPU
- Reanudar entrenamiento
- Checkpoint
Tres ajustes clave: tamaño de lote, tasa de aprendizaje y pasos
Ejecuta nvidia-smi para comprobar tu GPU y VRAM. Las GPU de consumo, incluida una RTX 3050, también pueden entrenar el modelo.
Tamaño de lote: auméntalo cuando la memoria lo permita, pero no superes la VRAM disponible.
| Configuración | Guía |
|---|---|
| 8 GB de VRAM o menos | Usa un lote pequeño: por ejemplo, 4 con 8 GB o 2 con 4 GB. |
| Más de 12 GB de VRAM | Un rango más cómodo para el tamaño de lote predeterminado; usa 16 si la memoria lo permite. |
| Solo gráficos integrados / sin GPU NVIDIA | Entrena en un servidor en la nube. |
Tasa de aprendizaje:
Este es el tamaño de cada actualización. ACT proporciona valores predefinidos: el optimizador AdamW, tasa de aprendizaje 1e-5, decaimiento de peso 1e-4 y una tasa de aprendizaje separada de 1e-5 para el backbone de visión. lerobot-train habilita por defecto los valores predefinidos de entrenamiento de la política (use_policy_training_preset), por lo que estos valores se aplican automáticamente sin ajustes adicionales. Una actualización demasiado grande hace que la pérdida oscile o diverja; una demasiado pequeña puede hacer que el entrenamiento tarde el doble. Mantén el valor predefinido en tu primera ejecución: estos valores provienen del artículo y de una amplia práctica.
-
Al cambiar el tamaño de lote o los pasos de entrenamiento, la recomendación es mantener sin cambios la tasa de aprendizaje.
-
Al ajustar finamente un checkpoint existente, considera
1e-6a3e-6, alrededor de 3–10 veces menor. -
Si la pérdida de entrenamiento apenas disminuye y se mantiene plana, no aumentes primero la tasa de aprendizaje. Incrementa los pasos o añade datos; si aún así no se mueve, prueba con
2e-5.Añade conjuntamente los siguientes ajustes y usa el mismo valor para ambos:
--policy.optimizer_lr=1e-6 \
--policy.optimizer_lr_backbone=1e-6
Pasos de entrenamiento:
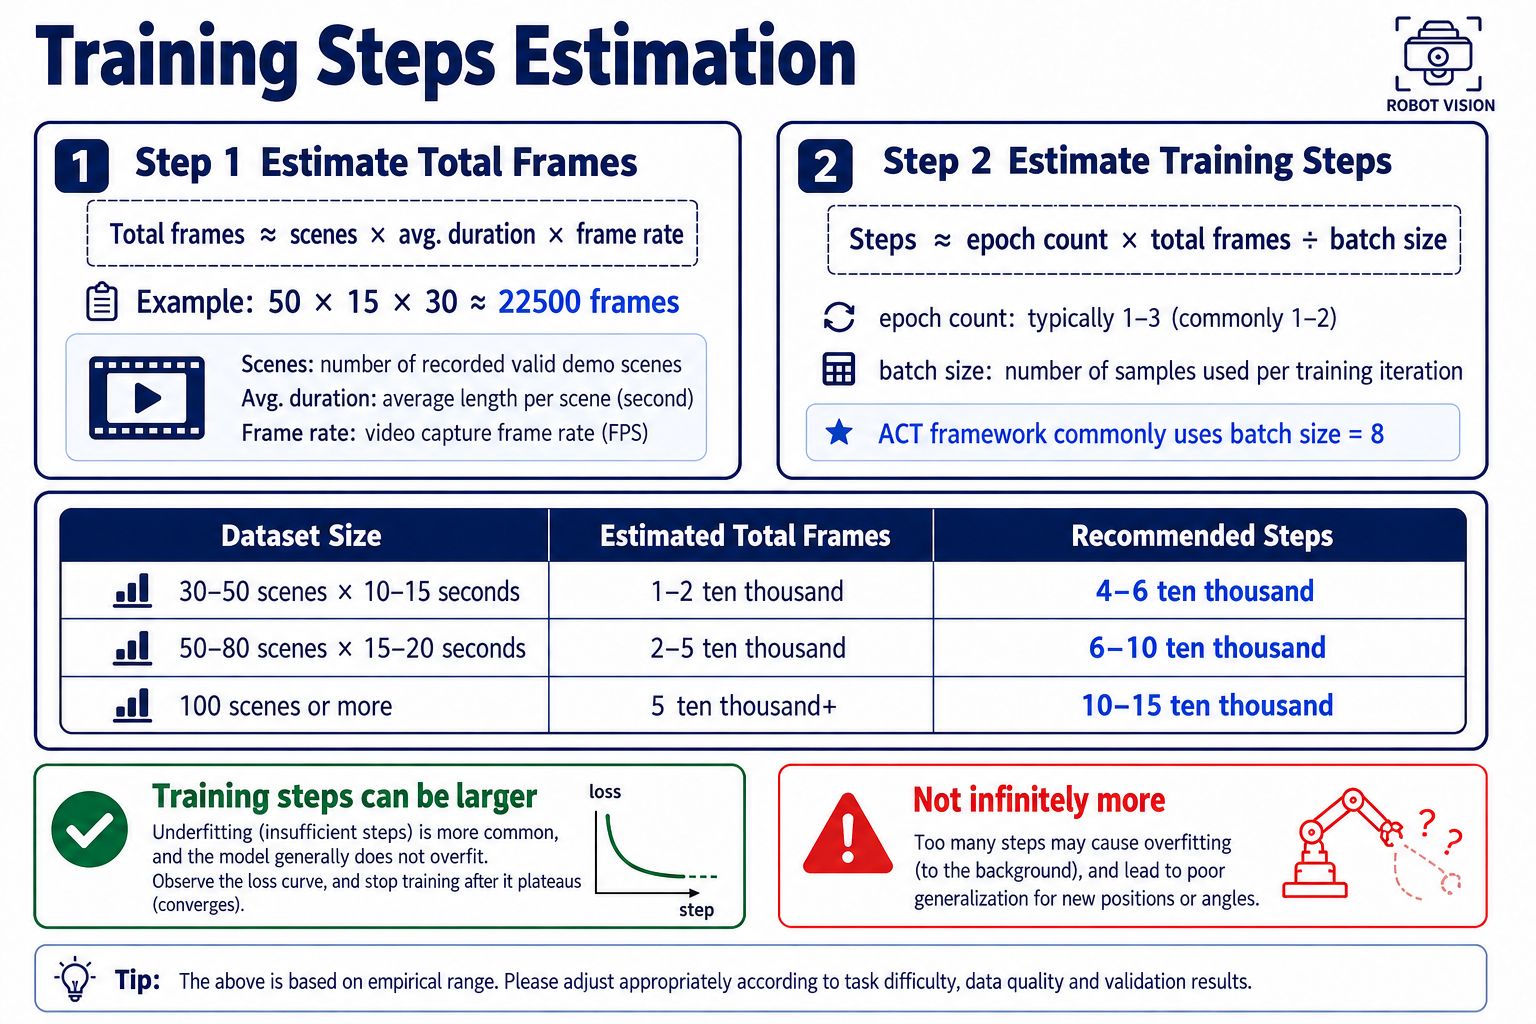
Para 50 episodios, un punto de partida sencillo son 80 000 pasos.
Escala los pasos con el tamaño de lote:
Reducir a la mitad el tamaño de lote reduce a la mitad las muestras vistas por actualización. Duplica los pasos para conservar aproximadamente el mismo número de épocas. Partiendo de batch_size=8 y steps=80000, usa 160000 pasos para un lote de 4, cuatro veces más pasos para un lote de 2, o la mitad de pasos para un lote de 16.
También puedes establecer más pasos de entrenamiento. Durante el entrenamiento, usa Ctrl+C para interrumpir en función de la pérdida y otras métricas; los modelos correspondientes ya generados se guardan automáticamente.
-
Total de frames se corresponde aproximadamente con la duración total grabada.
-
Una época significa ver el conjunto de datos grabado completo una vez.
-
Pasos cuentan el número de actualizaciones de minibatch.
Iniciar el entrenamiento
Después de que todas las comprobaciones se superen, ejecuta lo siguiente en el entorno conda lerobot:
lerobot-train \
    --dataset.repo_id=rebot_b601/grab_cube_v1 \
    --policy.type=act \
    --output_dir=outputs/train/act_grab_cube_v1 \
    --job_name=act_grab_cube_v1 \
    --policy.device=cuda \
    --wandb.enable=false \
    --policy.push_to_hub=false \
    --steps=100000
Para las GPU RTX serie 50, añade --dataset.video_backend=pyav para evitar la API que falta en la versión preliminar de torchvision usada por esta configuración.
Si la VRAM es insuficiente o quieres procesar más muestras a la vez, añade --batch_size para establecer el tamaño de lote.
Referencia de parámetros:
| Parámetro | Significado |
|---|---|
--dataset.repo_id | Nombre del conjunto de datos del Capítulo 13; introduce directamente el nombre local, o ${HF_USER}/xxx para un conjunto de datos del Hub. |
--policy.type=act | Tipo de política; otras opciones incluyen diffusion y smolvla. Usa ACT aquí. |
--output_dir | Directorio para todas las salidas de esta ejecución. |
--job_name | Nombre de la ejecución usado para distinguir los registros. |
--policy.device=cuda | Entrenar en la GPU. |
--wandb.enable=false | Desactiva el panel en línea opcional de W&B. |
--policy.push_to_hub=false | Mantén el modelo fuera del Hub hasta que estés satisfecho con la evaluación del Capítulo 17. |
--steps | Número de pasos de entrenamiento. |
--batch_size | Establece el tamaño de lote. |
Como guía aproximada, 100 000 pasos suelen tardar varias horas en una GPU de consumo, dependiendo de la GPU y del tamaño de lote.
Supervisar la pérdida y el uso de la GPU
Los registros de entrenamiento aparecen después de iniciar. LeRobot imprime un resumen periódicamente, por defecto cada 200 pasos, controlado por --log_freq. Por ejemplo:
step: 10000 smpl: 80K ep: 35.6 loss: 1.832 grdn: 12.4 lr: 1.0e-05 updt_s: 0.21 data_s: 0.003 eta: 3:42:10
Lee los campos de la siguiente manera; los nombres pueden variar ligeramente entre versiones:
| Campo | Significado | Qué comprobar |
|---|---|---|
step | Paso de entrenamiento actual | Compáralo con --steps para seguir el progreso. |
ep | Épocas completadas | Cuántas veces el modelo ha visto la grabación, como se comenta en la Sección 16.5. |
loss | Pérdida de entrenamiento | Una disminución rápida inicial, una disminución más lenta posterior y pequeñas fluctuaciones son normales. |
grdn | Norma del gradiente | Saltos repentinos a cientos o miles pueden indicar inestabilidad. |
lr | Tasa de aprendizaje actual | Confirma el valor esperado. |
updt_s / data_s | Tiempo de actualización / carga de datos por paso | Un data_s grande sugiere un cuello de botella en la carga de datos. |
eta | Tiempo restante estimado | Úsalo para planificar la ejecución. |
Las tendencias esperadas se agrupan en tres categorías:
-
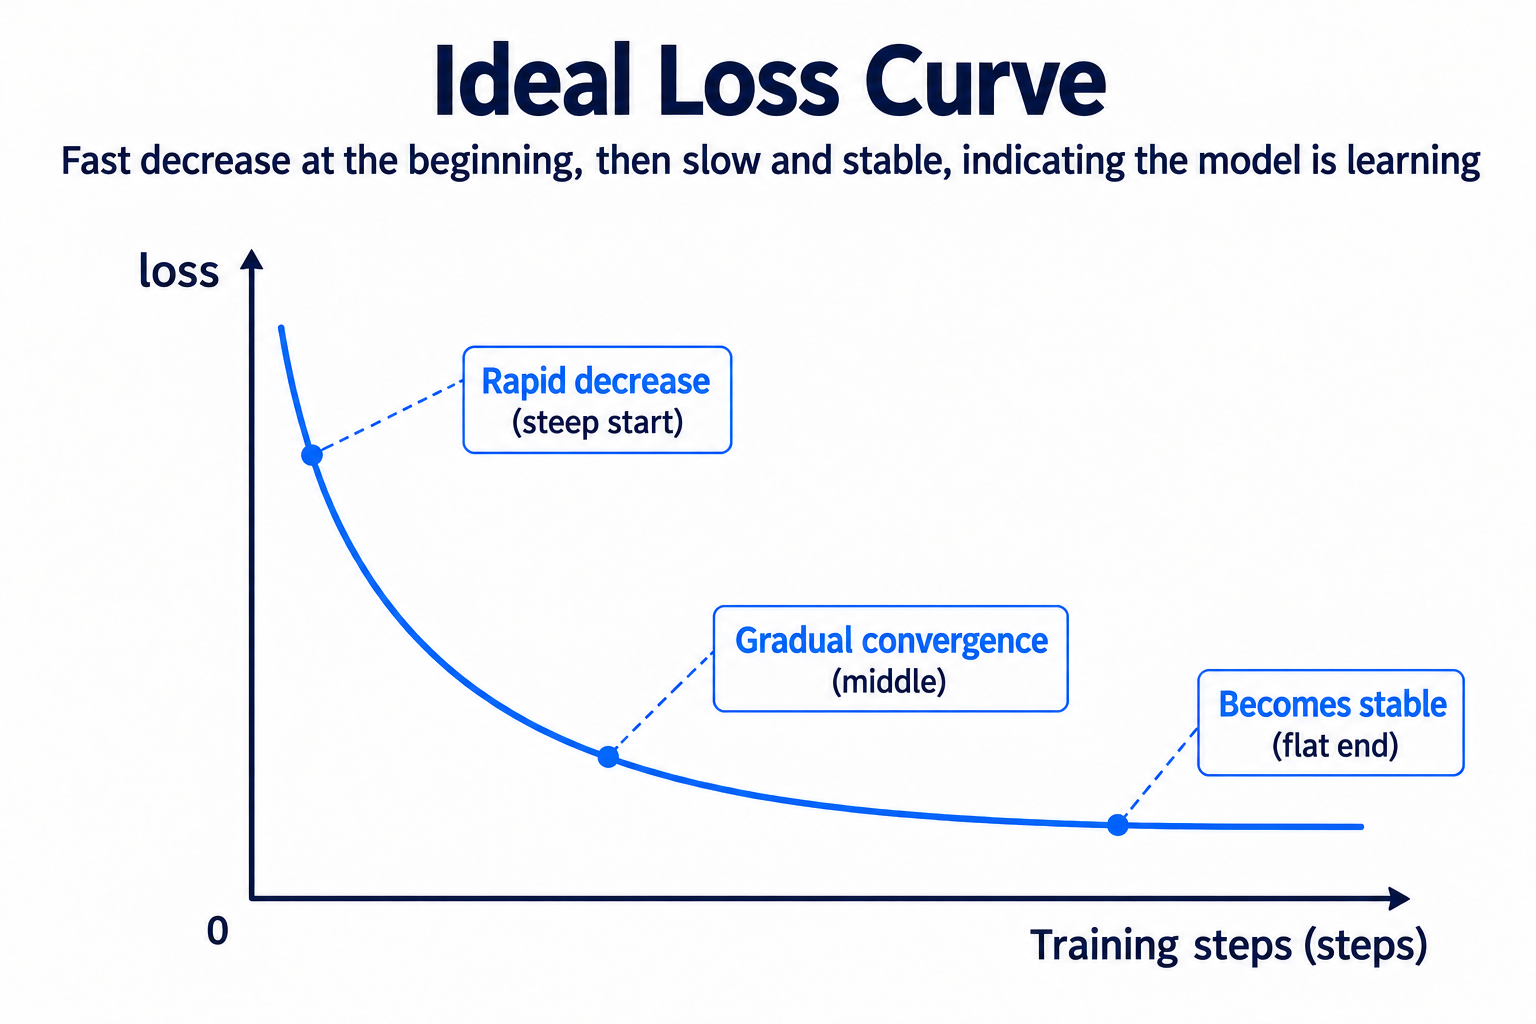
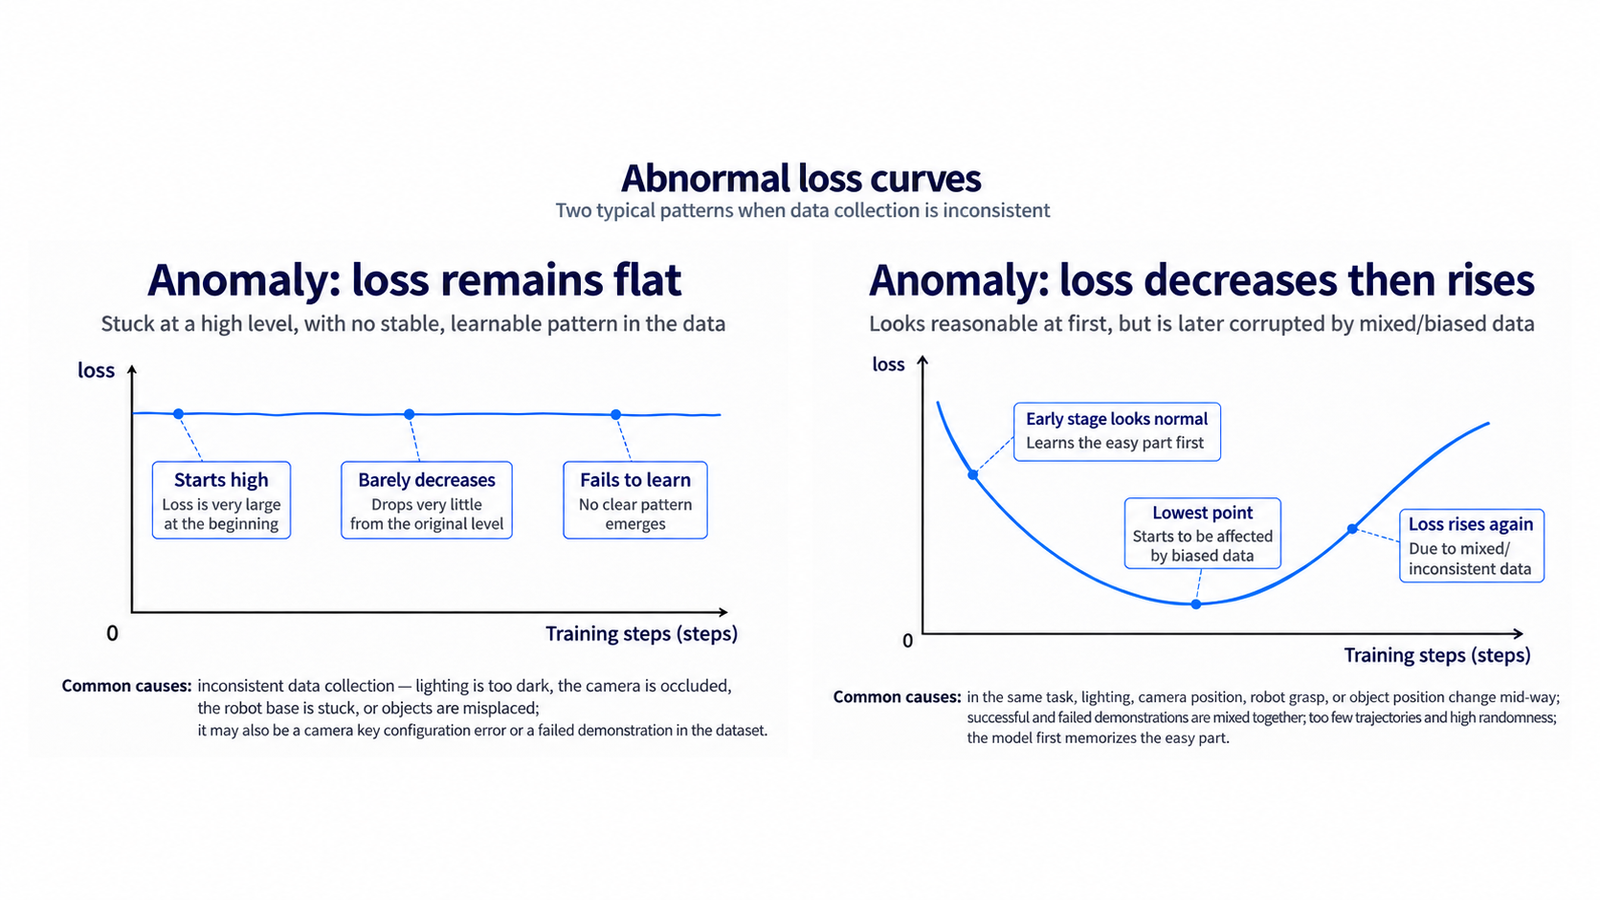
lossdebería disminuir a lo largo del tiempo. Una convergencia saludable tiene tres fases: una caída inicial pronunciada, un descenso gradual intermedio y pequeñas fluctuaciones en un nivel bajo y ampliamente plano. Vigila dos patrones anómalos: que no haya ninguna disminución (un problema de datos o configuración; vuelve a la Sección 14.6 para inspeccionar las curvas y las claves de la cámara), o una disminución seguida de un repunte (divergencia del entrenamiento; reduce a la mitad la tasa de aprendizaje y vuelve a entrenar). -
grdndebería estabilizarse en términos generales, permitiéndose picos ocasionales. A menudo cae junto con la pérdida. Un pico aislado que se recupera suele ser menos preocupante que una serie de picos en crecimiento constante, que puede preceder a la divergencia; reduce la tasa de aprendizaje en ese caso. -
lr,updt_s,data_sy la utilización de la GPU deberían mantenerse en gran medida estables en esta configuración. Comprueba quelrcoincida con la configuración. Son deseables tiempos de paso y utilización de GPU estables enwatch -n 1 nvidia-smi. Una utilización persistentemente baja o errática puede significar que la GPU está esperando datos.
Reanudar un entrenamiento interrumpido
Tras un corte de energía, una interrupción de red o cerrar accidentalmente la terminal en medio del entrenamiento, no necesitas empezar de cero, siempre que se haya guardado al menos un checkpoint, es decir, después de 20 000 pasos de entrenamiento:
lerobot-train \
    --config_path=outputs/train/act_grab_cube_v1/train_config.json \
    --resume=true
-
La configuración guardada rige la reanudación. La reanudación usa
train_config.json; se ignoran los parámetros adicionales de la línea de comandos. Para cambiar los pasos o el tamaño de lote, inicia una nueva ejecución en lugar de usar la reanudación. -
Continúa desde el último checkpoint. Se restauran el estado del optimizador y el contador de pasos, lo que permite que la curva de pérdida continúe.
Guardar y gestionar checkpoints
Los checkpoints se guardan automáticamente cada 20 000 pasos (save_freq) y al final del entrenamiento. Por tanto, un presupuesto de pasos mayor es manejable: evalúa un checkpoint anterior si los posteriores rinden peor o sobreajustan, en lugar de usar solo el modelo final.
outputs/train/act_grab_cube_v1/
├── train_config.json              ← Full configuration used for resuming
└── checkpoints/
    ├── 0020000/pretrained_model/  ← Model saved at this step
    ├── 0040000/pretrained_model/
    ├── ...
    └── last/pretrained_model/     ← Final checkpoint, used in Chapter 17
-
Uso de disco: cada checkpoint contiene un conjunto completo de pesos del modelo, por lo que muchos checkpoints pueden consumir un espacio considerable. Una vez que el entrenamiento sea estable, elimina los checkpoints iniciales que no necesites y conserva
lastmás uno o dos checkpoints recientes. -
Durante la inferencia, apunta
--policy.pathacheckpoints/last/pretrained_model.