Cómo cambiar de política en reBot Arm
Reutiliza una plataforma ACT funcional y su conjunto de datos para entrenar y desplegar una nueva política, y luego compara el rendimiento en el robot. Se proporcionan comandos para reBot-RS, reBot-DM y SO-ARM 101.
- Diffusion
- SmolVLA
- Políticas π
- Evaluación en el robot
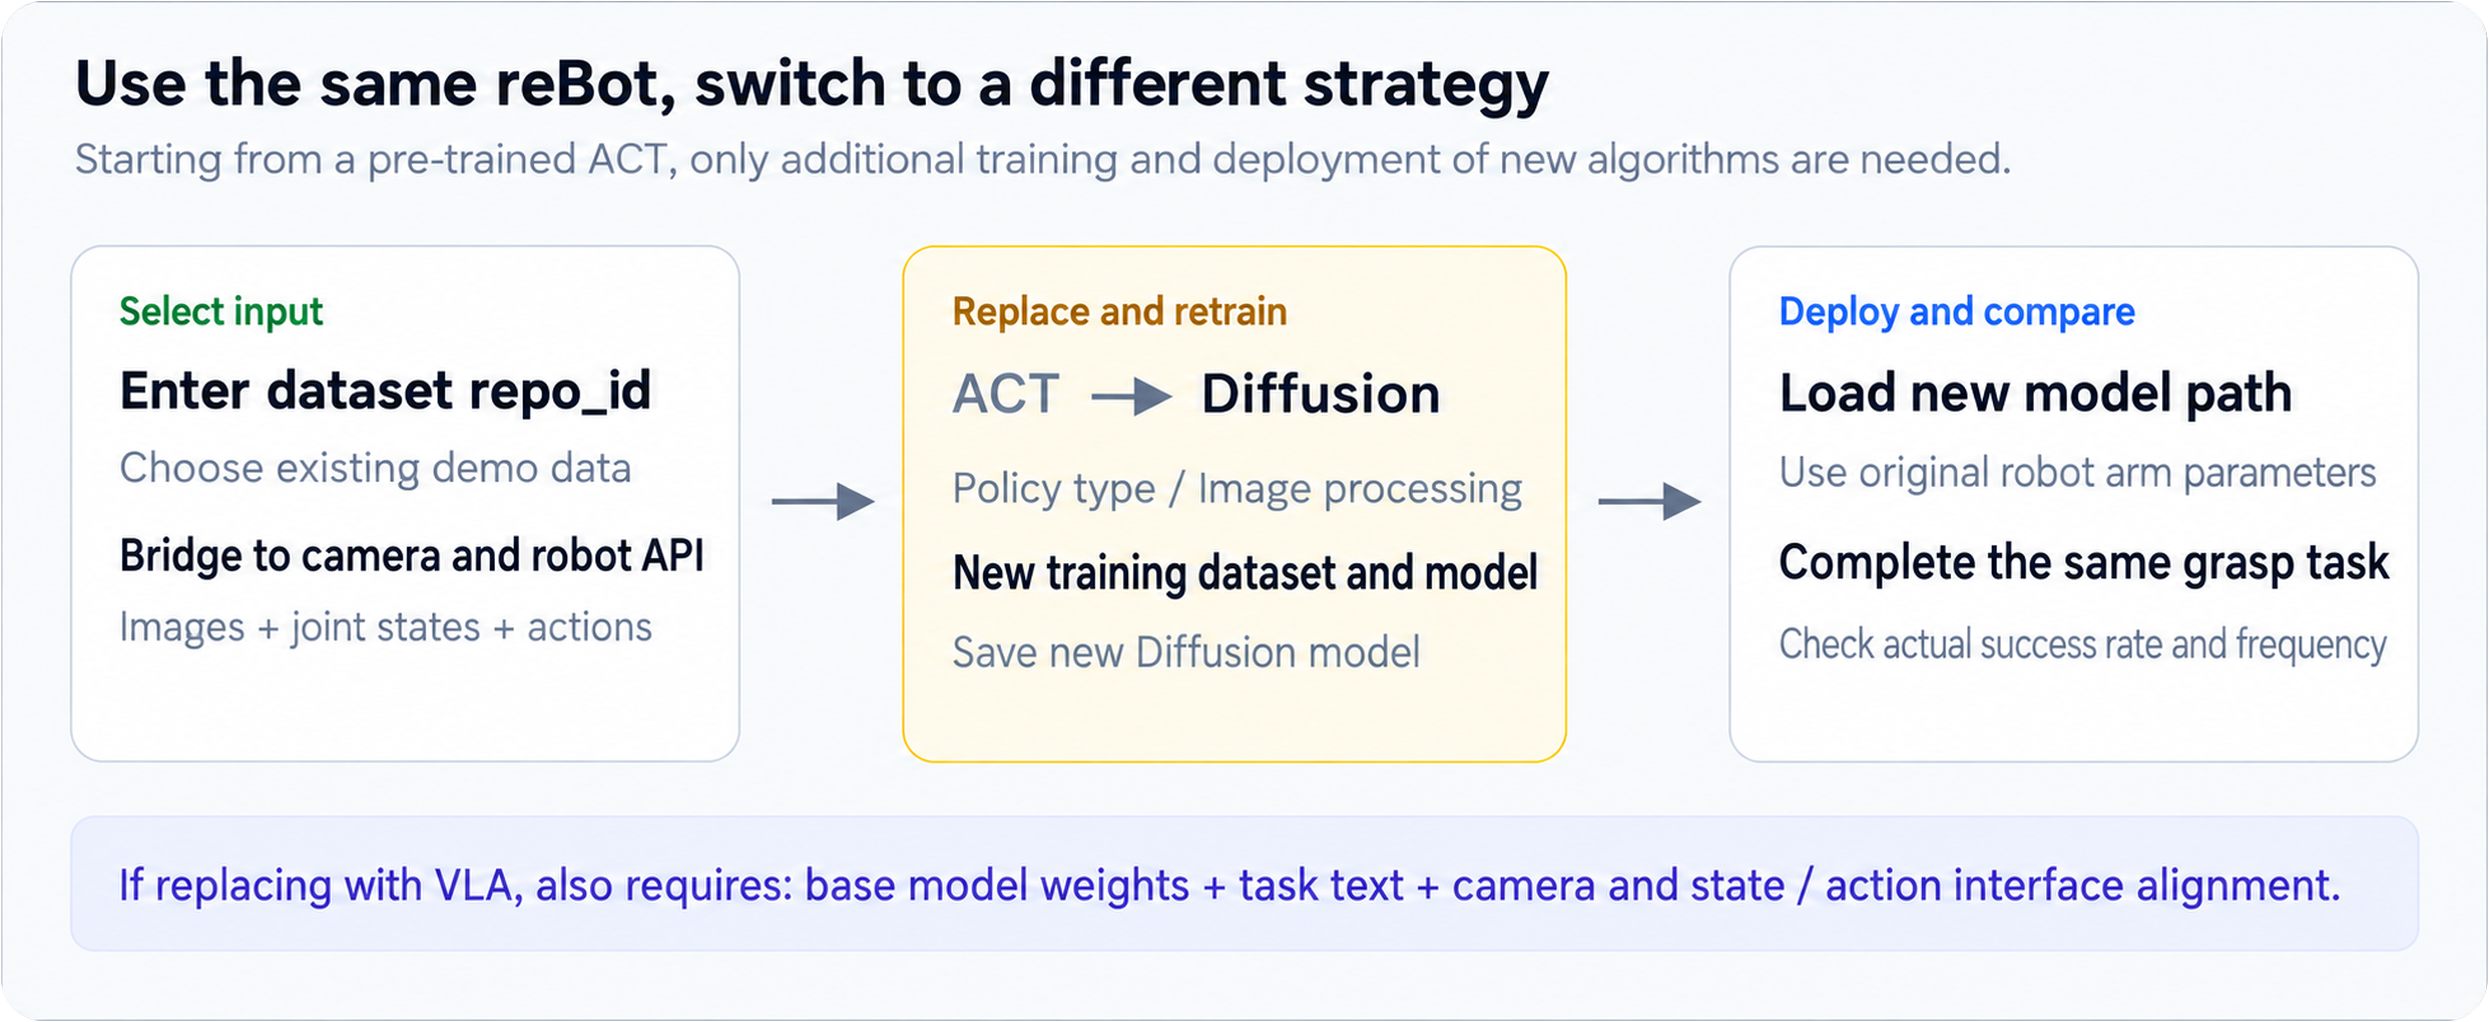
Elige una política → Configura y entrena → Carga el nuevo modelo → Evalúa en el robot.
Esta guía usa ACT → Diffusion para agarrar un bloque negro como ejemplo. Completa primero el montaje, la calibración, la teleoperación y el entrenamiento y despliegue de ACT. Mantén la configuración de hardware funcional y entrena la nueva política en el conjunto de datos de la misma plataforma.
Entorno y Plataforma
Selecciona la pestaña de tu brazo. Los comandos de entrenamiento y despliegue de abajo cambian juntos.
- reBot-RS
- reBot-DM
- SO101
Reutiliza el entorno Seeed LeRobot funcional y la configuración del plugin B601-RS de ACT. Los comandos están dirigidos a la serie Seeed LeRobot 0.4.4. Para la configuración de hardware, consulta reBot-RS con LeRobot.
Reutiliza el entorno Seeed LeRobot funcional y la configuración del plugin B601-DM de ACT. Los comandos están dirigidos a la serie Seeed LeRobot 0.4.4. Para la configuración de hardware, consulta reBot-DM con LeRobot.
Reutiliza el entorno LeRobot v0.4.4 que ya ejecuta ACT. Si el soporte para motores Feetech no está instalado, ejecuta lo siguiente desde el directorio fuente de LeRobot:
pip install -e ".[feetech]"
Para la preparación de hardware, consulta la documentación oficial de SO-ARM 101.
Lo que requiere cada política
| Política objetivo | Trabajo requerido |
|---|---|
| Diffusion | Establece policy.type=diffusion y las opciones de recorte de imagen; entrena un nuevo modelo; actualiza la ruta de despliegue. |
| SmolVLA | Instala .[smolvla]; ajusta finamente lerobot/smolvla_base; alinea el texto de la tarea, los nombres de las cámaras y las dimensiones de estado/acción. |
| π₀ / π₀.₅ | Instala .[pi]; ajusta finamente el modelo base apropiado; alinea el texto de la tarea, las imágenes, las acciones y las estadísticas de normalización; ajusta el tamaño de lote para la VRAM. |
Los datos VLA necesitan descripciones de tarea precisas. Si los nombres o el número de cámaras difieren del modelo base, configura los mapeos de nombres de entrada y las vistas faltantes. SmolVLA · π₀ · Mapeos de entrada
Entrenar Diffusion en el conjunto de datos existente
Ejecuta estos comandos en el entorno ACT existente desde el directorio fuente de LeRobot. Sustituye dataset.repo_id por tu conjunto de datos. Para una ubicación de datos personalizada, conserva --dataset.root y los ajustes de decodificación del comando de entrenamiento original. El ejemplo usa una cámara front, imágenes de 640×480 y datos a 30 FPS.
- reBot-RS
- reBot-DM
- SO101
lerobot-train \
  --dataset.repo_id=your_username/rebot_rs_cube \
  --policy.type=diffusion \
  --policy.crop_shape=null \
  --policy.device=cuda \
  --policy.push_to_hub=false \
  --output_dir=outputs/train/diffusion_rebot_rs_cube \
  --job_name=diffusion_rebot_rs_cube \
  --batch_size=8 \
  --steps=100000 \
  --wandb.enable=false
lerobot-train \
  --dataset.repo_id=your_username/rebot_dm_cube \
  --policy.type=diffusion \
  --policy.crop_shape=null \
  --policy.device=cuda \
  --policy.push_to_hub=false \
  --output_dir=outputs/train/diffusion_rebot_dm_cube \
  --job_name=diffusion_rebot_dm_cube \
  --batch_size=8 \
  --steps=100000 \
  --wandb.enable=false
lerobot-train \
  --dataset.repo_id=your_username/so101_cube \
  --policy.type=diffusion \
  --policy.crop_shape=null \
  --policy.device=cuda \
  --policy.push_to_hub=false \
  --output_dir=outputs/train/diffusion_so101_cube \
  --job_name=diffusion_so101_cube \
  --batch_size=8 \
  --steps=100000 \
  --wandb.enable=false
| Parámetro | Configuración requerida |
|---|---|
policy.type | Usa diffusion para crear y entrenar la nueva política. |
policy.crop_shape | null conserva la imagen completa; procesar la vista completa incrementa los costes de memoria e inferencia. |
output_dir / job_name | Usa nombres nuevos; la ruta de despliegue policy.path debe apuntar a la salida correspondiente. |
batch_size / steps | Comienza con 8 / 100000 y luego ajusta según la VRAM y el rendimiento en el robot. |
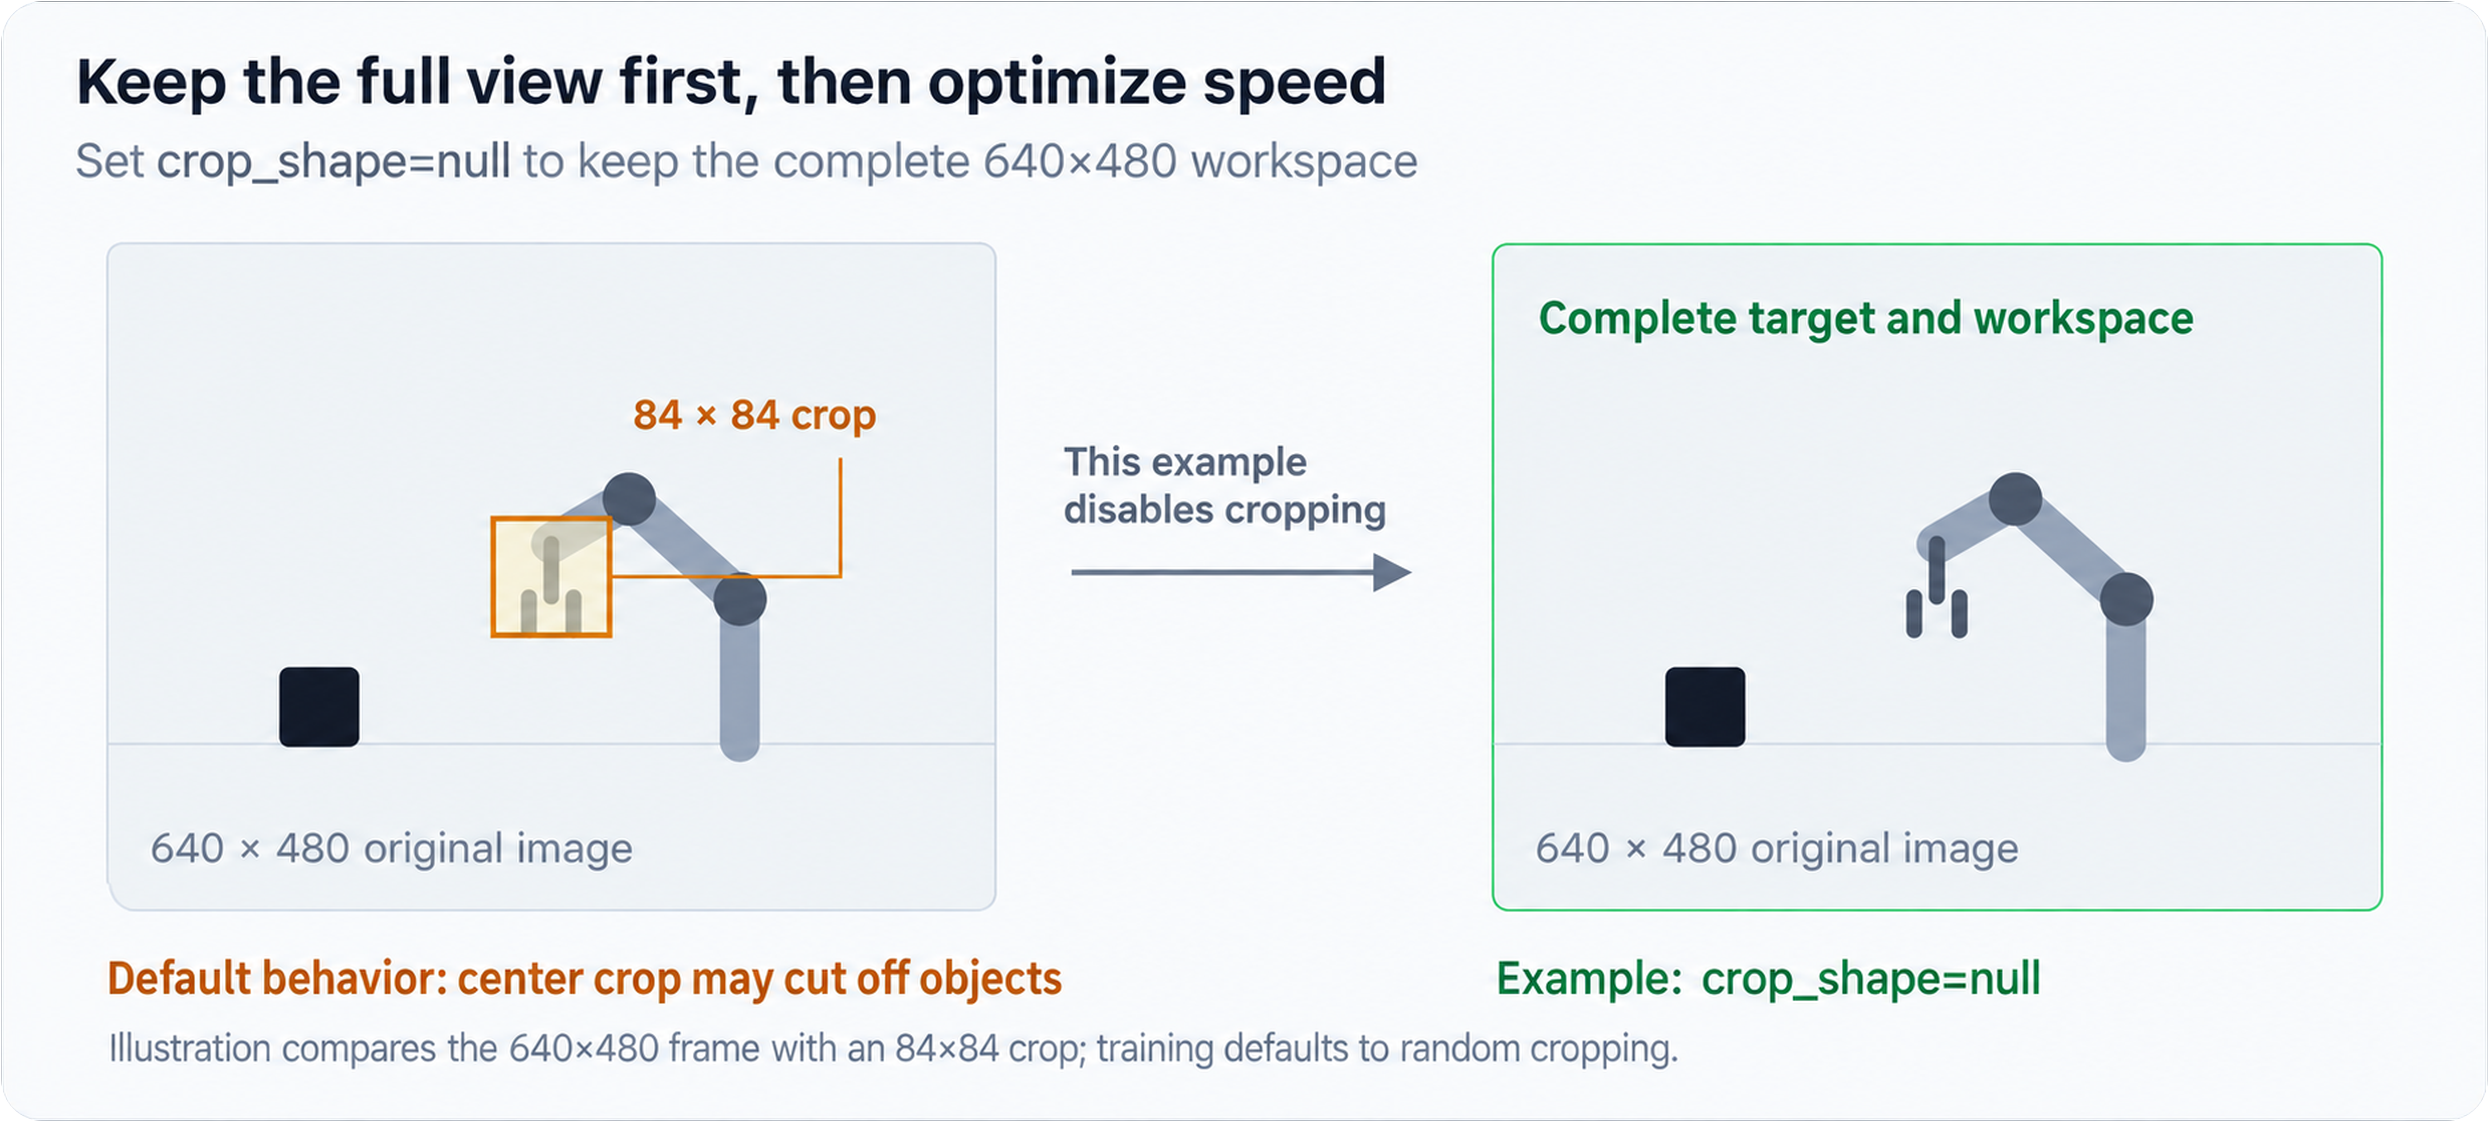
Al optimizar el recorte o el cambio de tamaño, mantén el procesamiento de imágenes coherente entre el entrenamiento y el despliegue. Referencias de configuración: Diffusion de Seeed · Diffusion de LeRobot v0.4.4.
Ejecutar el nuevo modelo
Apunta policy.path al modelo Diffusion recién entrenado y elige un nuevo nombre de conjunto de datos de evaluación. Los puertos, robot.id, ajustes de cámara y descripciones de tareas de abajo son ejemplos: sustitúyelos por tu configuración ACT funcional. Mantén el robot.id usado durante la calibración.
- reBot-RS
- reBot-DM
- SO101
lerobot-record \
  --robot.type=seeed_b601_rs_follower \
  --robot.port=can0 \
  --robot.id=follower1 \
  --robot.can_adapter=socketcan \
  --robot.cameras='{"front":{"type":"opencv","index_or_path":0,"width":640,"height":480,"fps":30,"fourcc":"MJPG"}}' \
  --policy.path=outputs/train/diffusion_rebot_rs_cube/checkpoints/last/pretrained_model \
  --policy.device=cuda \
  --dataset.repo_id=local/eval_diffusion_rebot_rs_cube_01 \
  --dataset.single_task="Grab the black cube" \
  --dataset.fps=30 \
  --dataset.num_episodes=1 \
  --dataset.episode_time_s=30 \
  --dataset.reset_time_s=10 \
  --dataset.push_to_hub=false \
  --display_data=true
lerobot-record \
  --robot.type=seeed_b601_dm_follower \
  --robot.port=/dev/ttyACM0 \
  --robot.id=follower1 \
  --robot.can_adapter=damiao \
  --robot.cameras='{"front":{"type":"opencv","index_or_path":0,"width":640,"height":480,"fps":30,"fourcc":"MJPG"}}' \
  --policy.path=outputs/train/diffusion_rebot_dm_cube/checkpoints/last/pretrained_model \
  --policy.device=cuda \
  --dataset.repo_id=local/eval_diffusion_rebot_dm_cube_01 \
  --dataset.single_task="Grab the black cube" \
  --dataset.fps=30 \
  --dataset.num_episodes=1 \
  --dataset.episode_time_s=30 \
  --dataset.reset_time_s=10 \
  --dataset.push_to_hub=false \
  --display_data=true
lerobot-record \
  --robot.type=so101_follower \
  --robot.port=/dev/ttyACM0 \
  --robot.id=my_awesome_follower_arm \
  --robot.cameras='{"front":{"type":"opencv","index_or_path":0,"width":640,"height":480,"fps":30}}' \
  --policy.path=outputs/train/diffusion_so101_cube/checkpoints/last/pretrained_model \
  --policy.device=cuda \
  --dataset.repo_id=local/eval_diffusion_so101_cube_01 \
  --dataset.single_task="Grab the black cube" \
  --dataset.fps=30 \
  --dataset.num_episodes=1 \
  --dataset.episode_time_s=30 \
  --dataset.reset_time_s=10 \
  --dataset.push_to_hub=false \
  --display_data=true
- reBot-RS: conserva la interfaz CAN verificada y los ajustes de
socketcan. - reBot-DM: conserva el puerto serie verificado y los ajustes del adaptador
damiao. - SO-ARM 101: conserva la configuración serie verificada, incluido el valor
--robot.use_degreesanterior si se utilizó.
Mantén coherentes los nombres de las cámaras, la colocación, las dimensiones de imagen, las unidades de acción y la frecuencia de fotogramas con el entrenamiento. Usa un nuevo nombre de conjunto de datos eval_… para cada evaluación.
Referencias de configuración: Configuración del plugin de Seeed · Flujo de trabajo de evaluación de LeRobot v0.4.4.
Evaluación en el robot y comparación de políticas
Asegura el brazo y despeja su espacio de trabajo. Ejecuta primero un episodio para comprobar la dirección del movimiento, el rango y la frecuencia de control real. Una vez que esto sea correcto, evalúa Diffusion usando la misma tarea, posiciones de objetos y número de pruebas que ACT, registrando los éxitos y los tiempos de finalización.
Para cambiar después a SmolVLA o políticas π, instala las dependencias documentadas, ajusta finamente el modelo base, alinea el texto de la tarea, las entradas de cámara, las dimensiones de estado/acción y las estadísticas de normalización, y actualiza policy.path.