ACT: Cómo el Action Chunking habilita la manipulación bimanual de bajo costo
Aprendizaje de manipulación bimanual de alta precisión con hardware de bajo costo
- Aprendizaje por imitación
- ALOHA
- Action chunking
- Temporal ensembling
Requisitos previos
¿Qué es el aprendizaje por imitación?
-
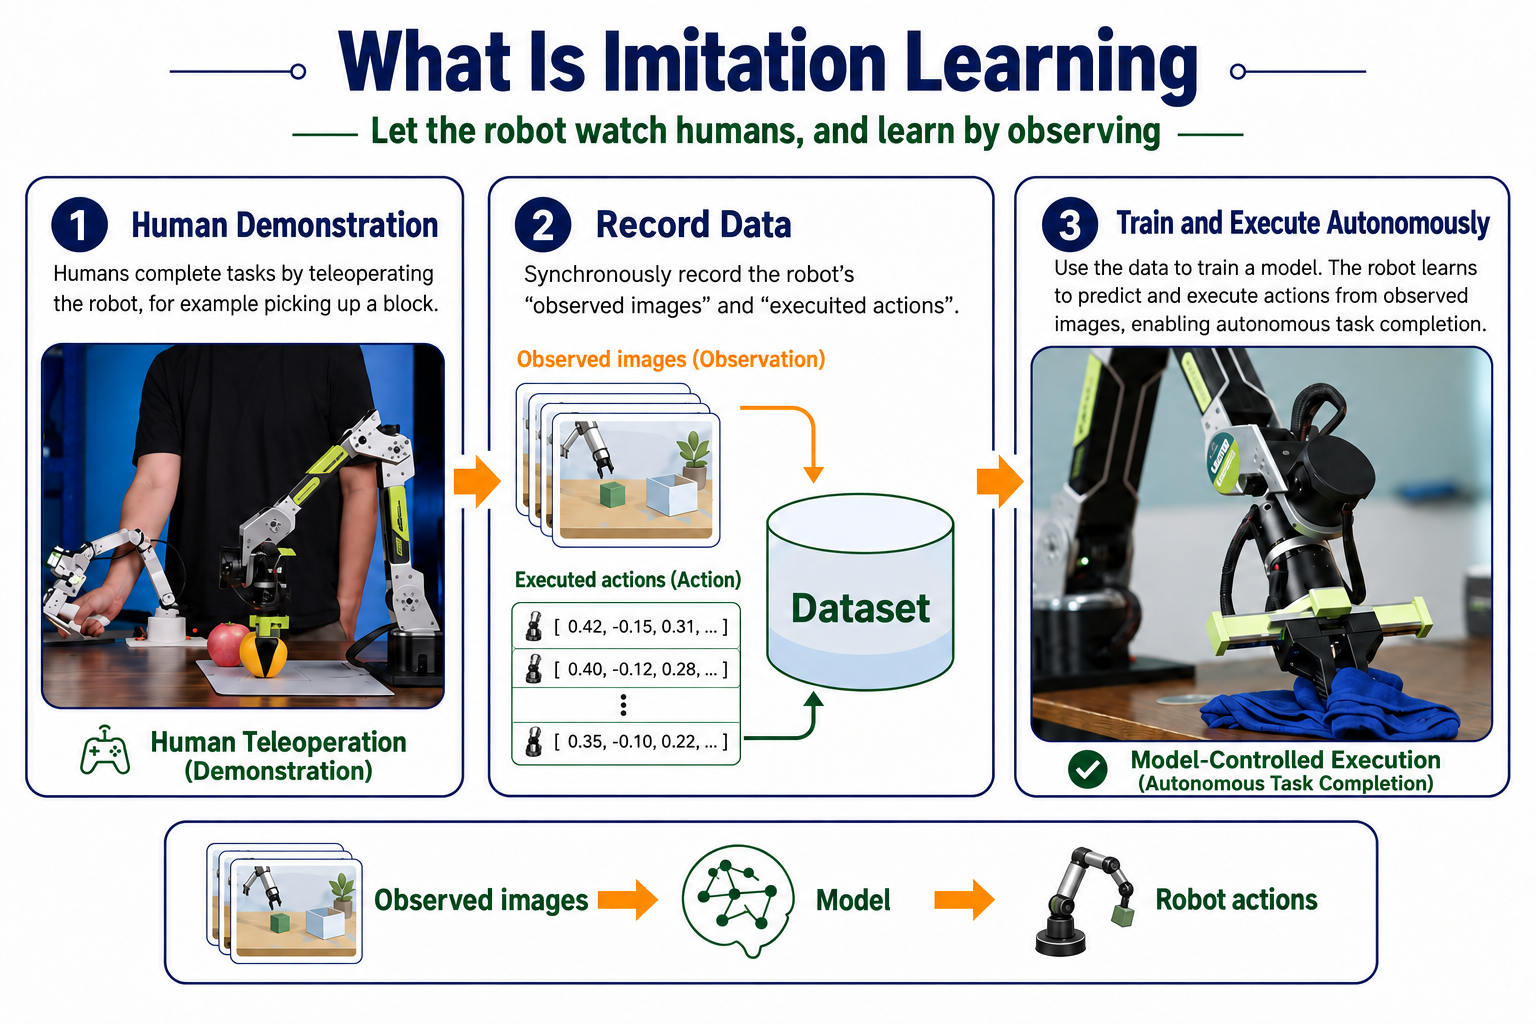
El aprendizaje por imitación parte de una idea sencilla: demostrar la tarea y luego dejar que el robot aprenda a imitarla.
- Una persona teleopera el brazo mientras el sistema registra las observaciones de las cámaras y las acciones ejecutadas. Estas demostraciones entrenan un modelo que después puede actuar a partir de imágenes sin un operador humano.
Observación: el mundo que ve el robot
-
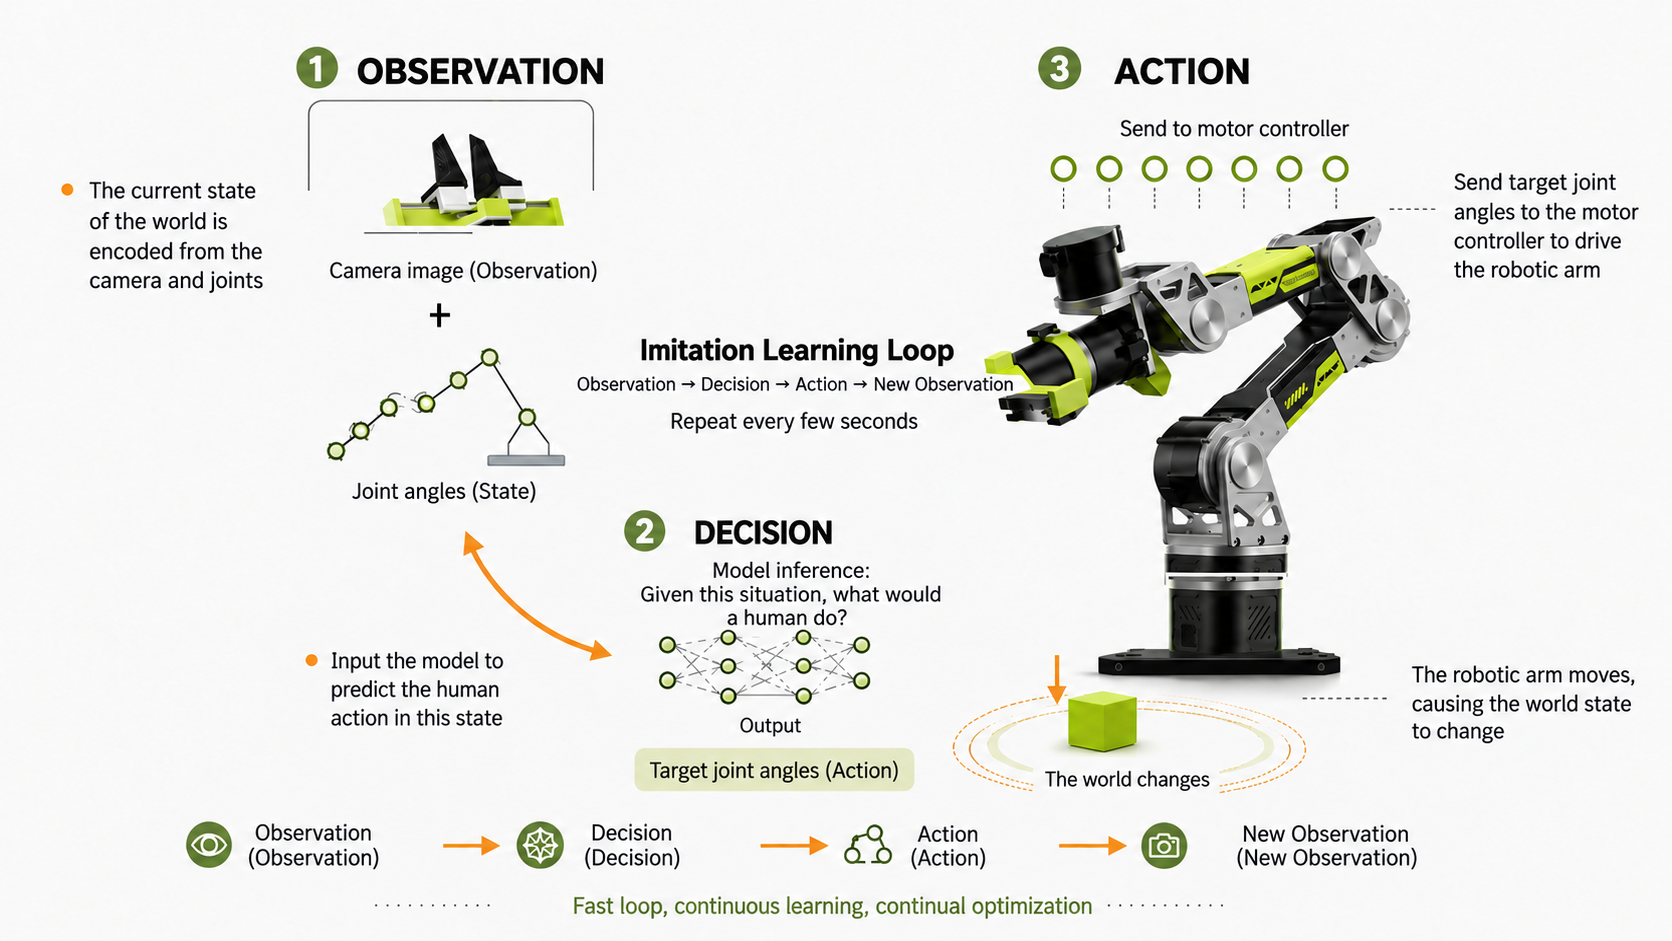
Una observación es información sobre el entorno obtenida a través de sensores: los ojos del robot. Para reBot Arm, esto incluye:
-
La vista global de la cámara frontal / cenital de los objetos y sus posiciones sobre la mesa.
-
La vista en primer plano de la cámara de muñeca de la relación entre la garra y su objetivo.
-
Estado: la configuración propia del robot
-
El estado describe al propio robot en lugar de su entorno. Es análogo a la propiocepción: saber dónde está tu mano o cuánto está doblado tu codo con los ojos cerrados. Para reBot Arm, el estado incluye:
-
Ángulos actuales de las seis articulaciones.
-
La apertura actual de la garra.
-
Acción: lo que se ordena hacer al robot
-
Una acción es la orden de salida del modelo hacia el brazo. En reBot Arm, estado y acción tienen la misma dimensionalidad: seis articulaciones más una garra. El estado describe la configuración actual; la acción especifica la configuración objetivo:
-
Ángulos objetivo para las seis articulaciones.
-
Apertura objetivo de la garra.
-
Acciones de un solo paso y action chunks
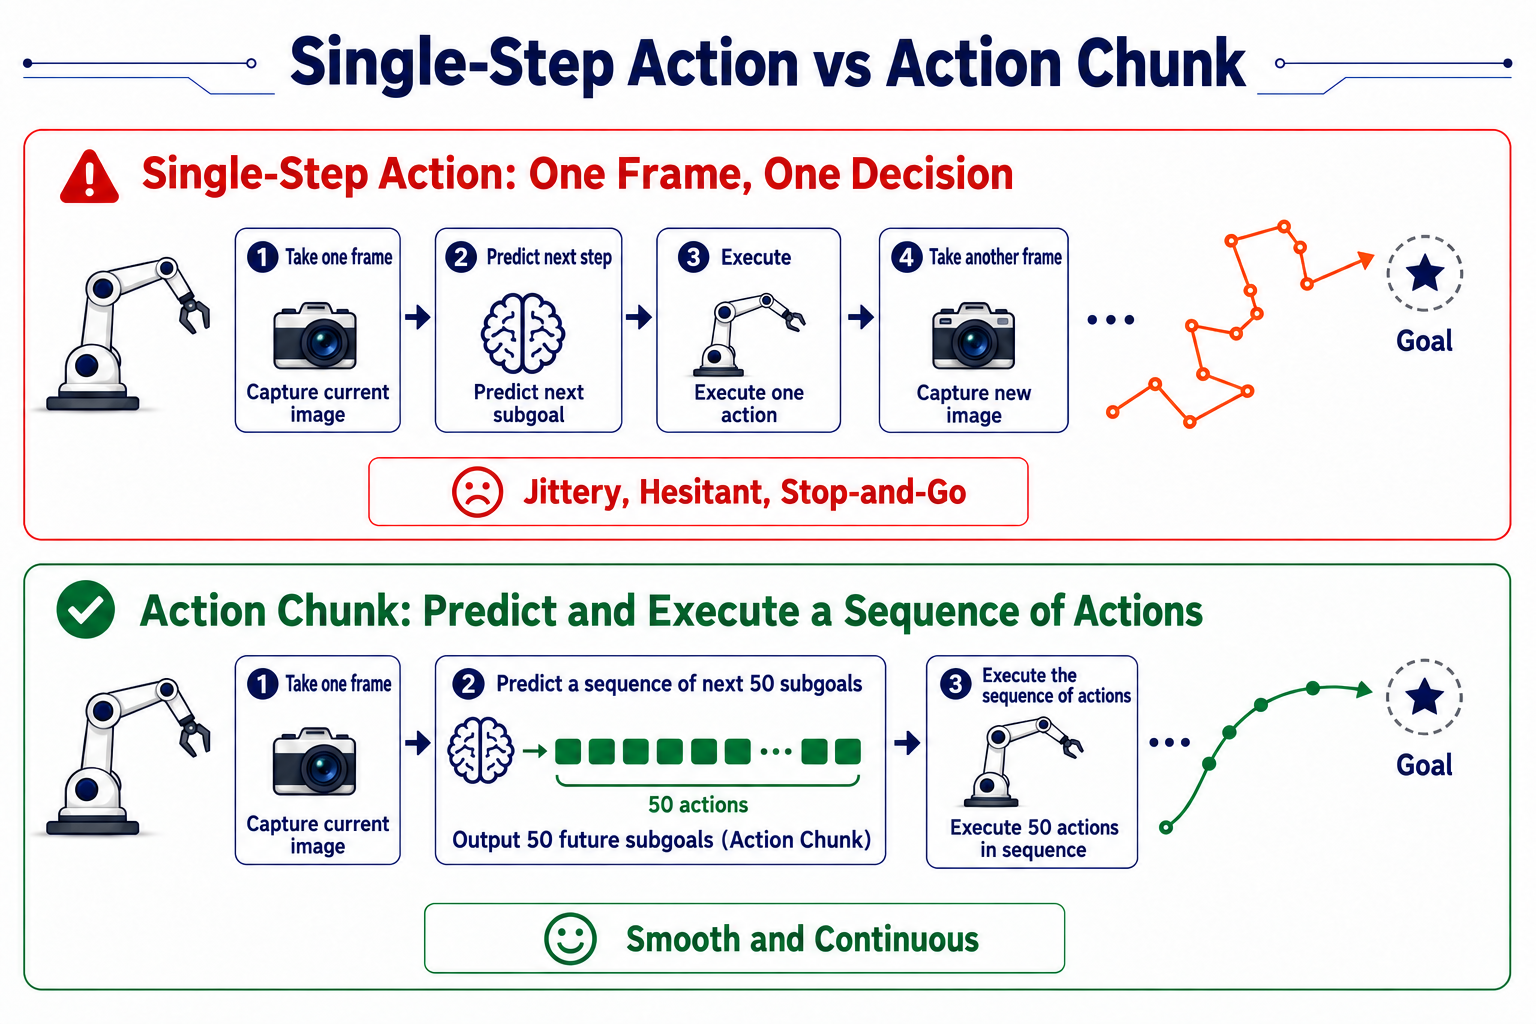
Acciones de un solo paso: una decisión por fotograma
-
Para cada imagen, predecir los siguientes objetivos de articulaciones, ejecutarlos y obtener otra imagen para la siguiente predicción.
- Pequeños errores de predicción cambian la posición del brazo y pueden alejar las observaciones posteriores de la distribución de entrenamiento. Entonces los errores posteriores crecen. En el robot, esto aparece como vibraciones, vacilaciones y paradas repetidas, como si reconsideraras tu siguiente paso a mitad de cada zancada.
Action chunks: predecir una secuencia de una vez
-
Predecir una breve secuencia futura, como 50 objetivos de articulaciones durante el siguiente segundo, en lugar de solo la siguiente acción.
-
Menores requisitos de frecuencia de inferencia. Una predicción cubre un intervalo corto, lo que permite un movimiento más suave incluso cuando la inferencia es relativamente lenta, algo importante para el despliegue en hardware modesto.
-
Más estructura temporal. Predecir varias acciones futuras anima al modelo a representar la secuencia prevista, haciendo menos probable que distracciones momentáneas lo descarrilen.
-
Movimiento más suave y coherente.
-
Los chunks más largos no siempre son mejores. Si un objeto se mueve durante la ejecución, las predicciones lejanas pueden quedar desactualizadas. Los sistemas prácticos equilibran esto ejecutando parte de un chunk en lazo abierto, luego observando y volviendo a predecir.
Entrenamiento, inferencia y evaluación
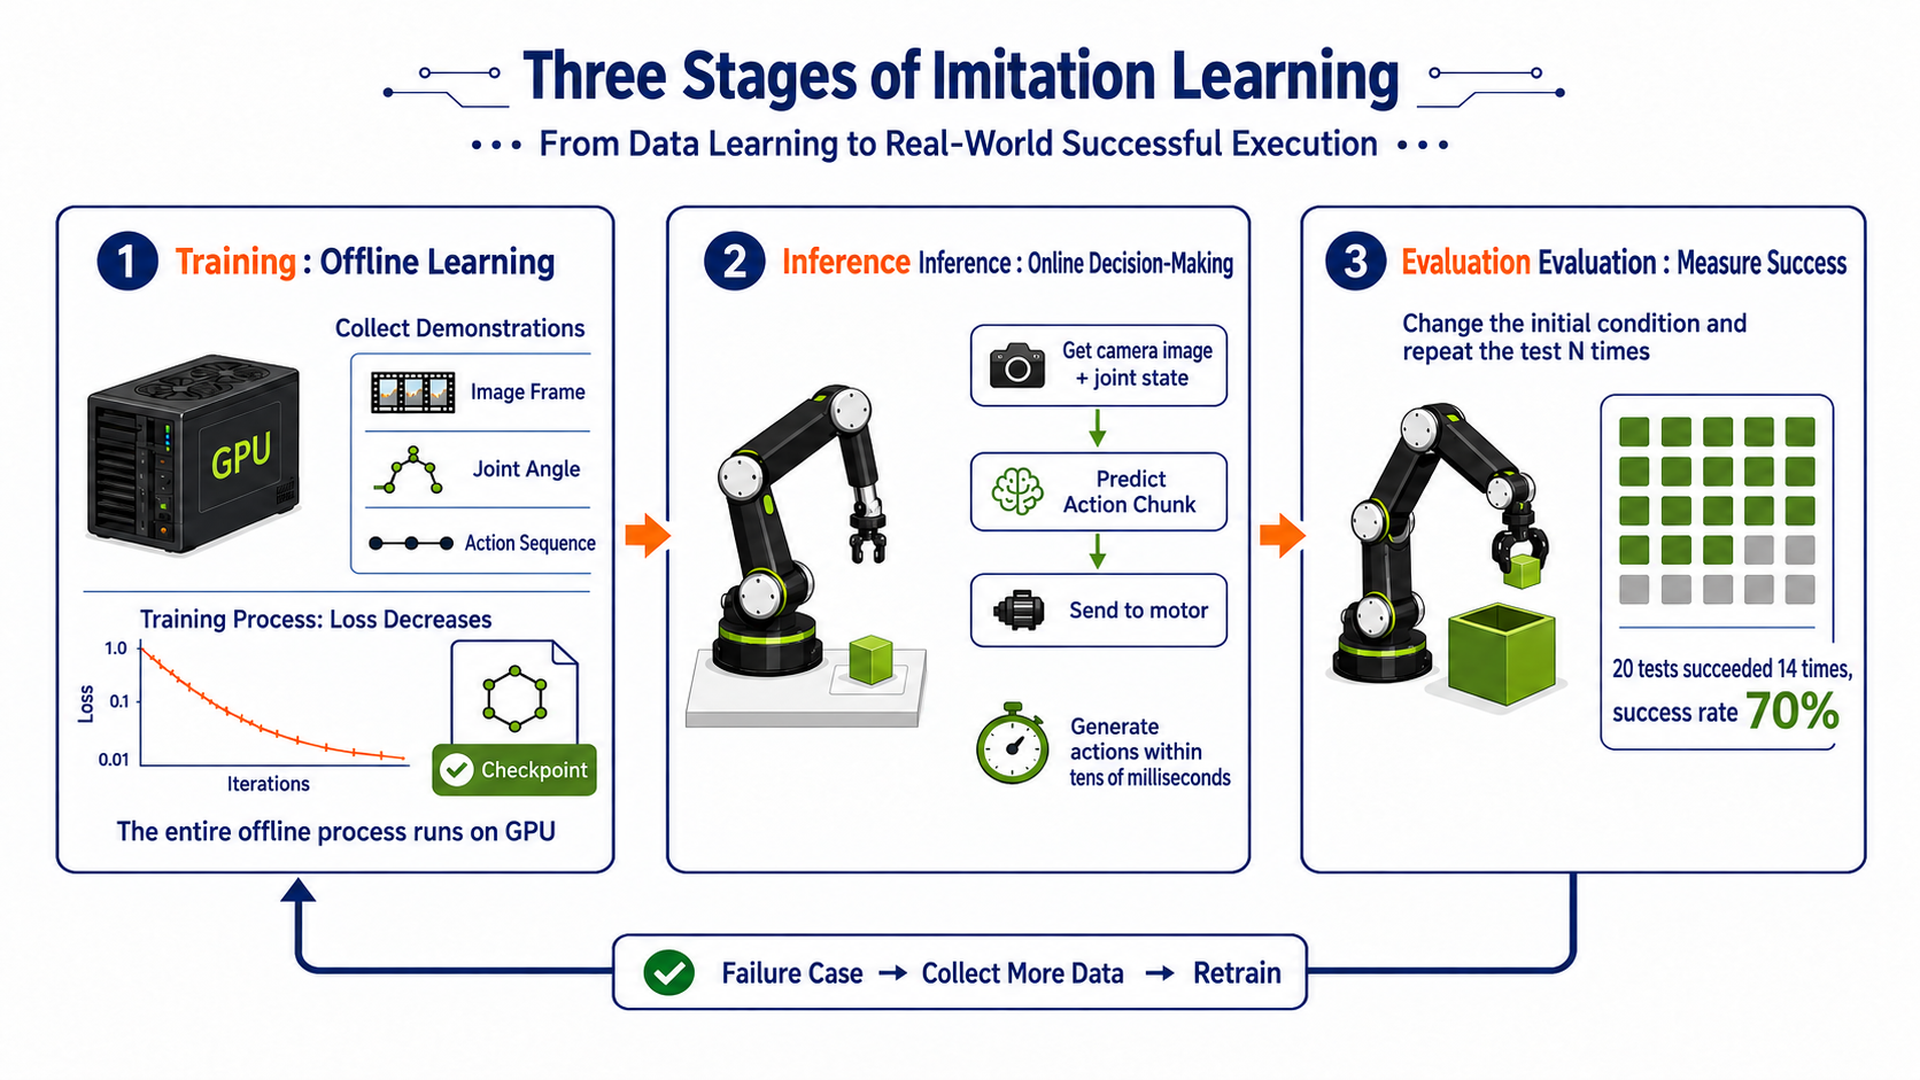
Entrenamiento: aprendizaje offline
El entrenamiento es un proceso offline posterior a la recolección. El brazo puede estar apagado mientras la GPU hace el trabajo.
-
Entrada: secuencias grabadas de imágenes, estados y acciones.
-
Proceso: ajustar repetidamente los parámetros del modelo para acercar las acciones predichas a las demostraciones humanas.
-
Salida: pesos del modelo entrenado.
La pérdida (loss) sigue el ajuste del entrenamiento: una pérdida decreciente significa que las predicciones se vuelven más similares a las demostraciones.
Inferencia: decisiones online
- La inferencia es desplegar el modelo en el robot real para trabajar en tiempo real: leer imágenes de cámara y estados articulares → predecir un action chunk → enviarlo a los motores. Las predicciones deben llegar en decenas de milisegundos, o el brazo se entrecortará.
Evaluación: medir el éxito de la tarea
Un modelo entrenado con baja pérdida aún puede fallar la tarea. Una pérdida baja mide la precisión de la imitación, no la finalización de la tarea. Evalúa en el robot real:
-
Define criterios de éxito claros, como que el bloque termine dentro de la caja.
-
Varía las condiciones iniciales, incluida la posición del objeto y la iluminación, a lo largo de N pruebas.
-
Mide la tasa de éxito: 14 éxitos en 20 pruebas dan un 70%.
Los fallos se convierten en entrada para la siguiente ronda de recolección. Añade demostraciones para las situaciones que fallan y vuelve a entrenar. Esto cierra el ciclo de datos–entrenamiento–evaluación usado en el aprendizaje robótico práctico.
Contexto del artículo
Autores: Tony Z. Zhao¹, Vikash Kumar³, Sergey Levine², Chelsea Finn¹. Afiliaciones: ¹ Universidad de Stanford; ² UC Berkeley; ³ Meta.
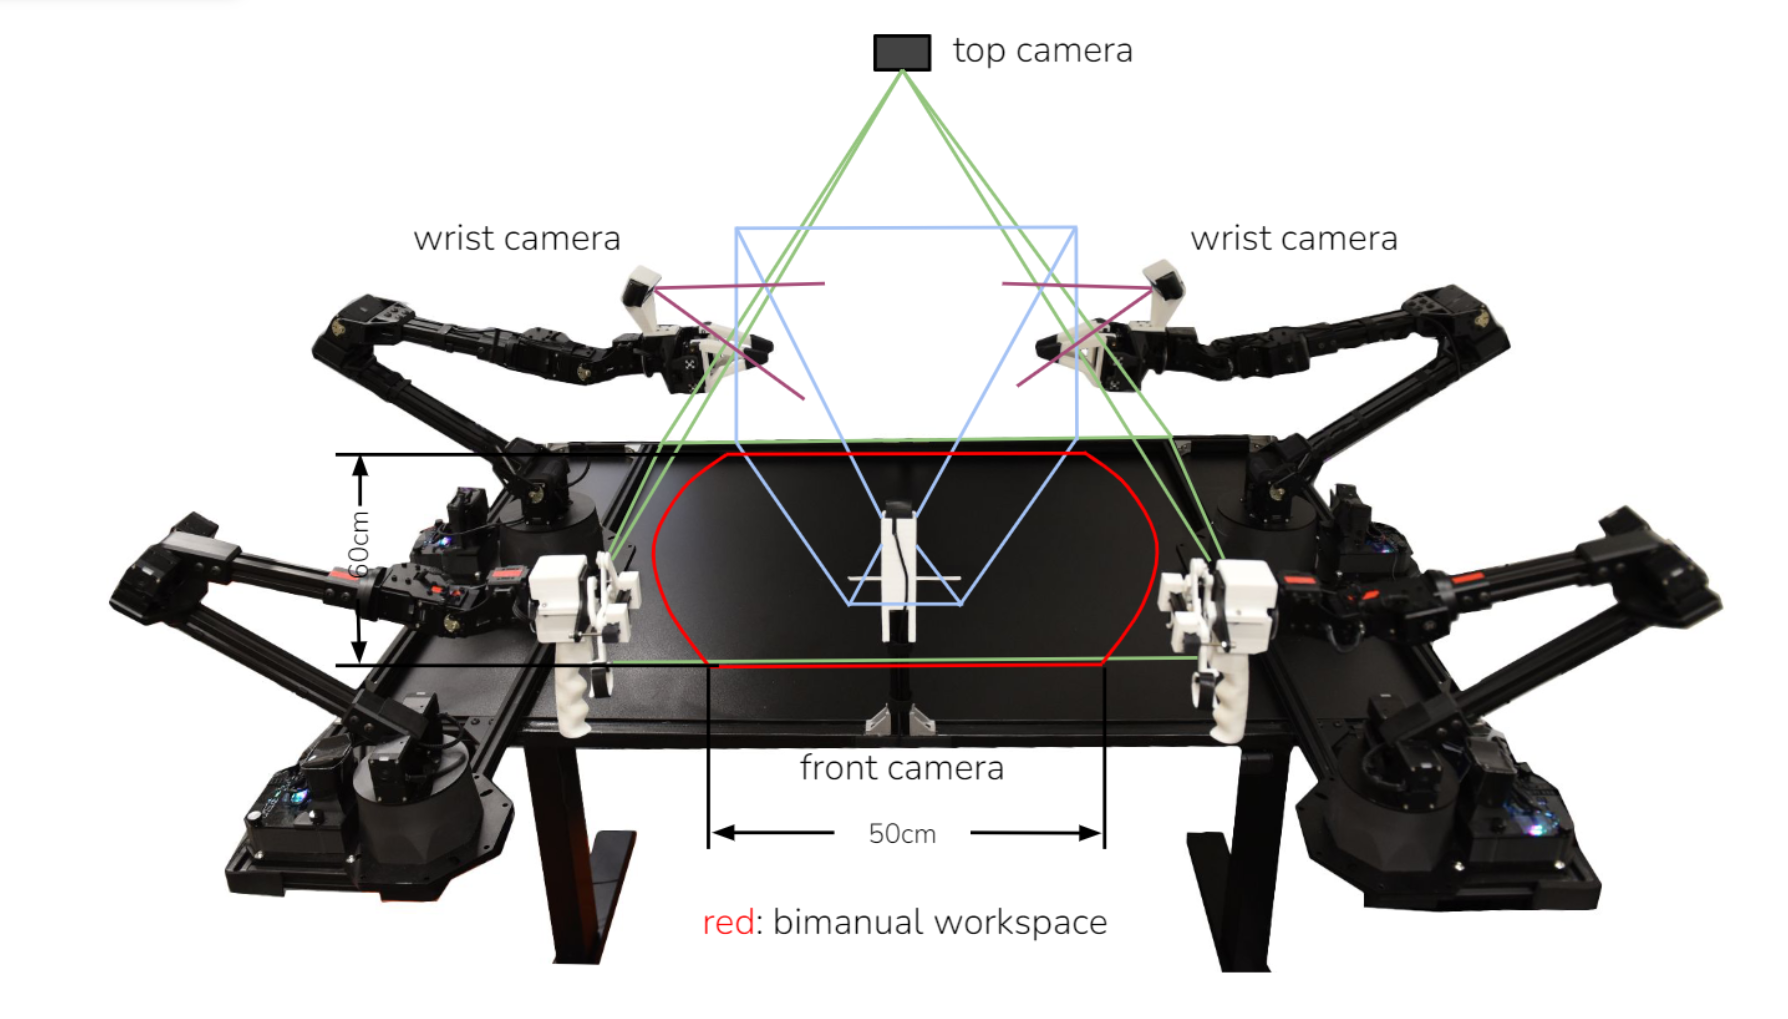
Contexto del artículo: Publicado en 2023 por un equipo conjunto de Stanford y Berkeley, este algoritmo ligero de aprendizaje por imitación combina redes convolucionales y Transformers. La plataforma experimental es el sistema de teleoperación bimanual ALOHA de seis GDL, con cámaras monoculares en las dos garras y una cámara monocular cenital global.
Resumen
- Explicación:
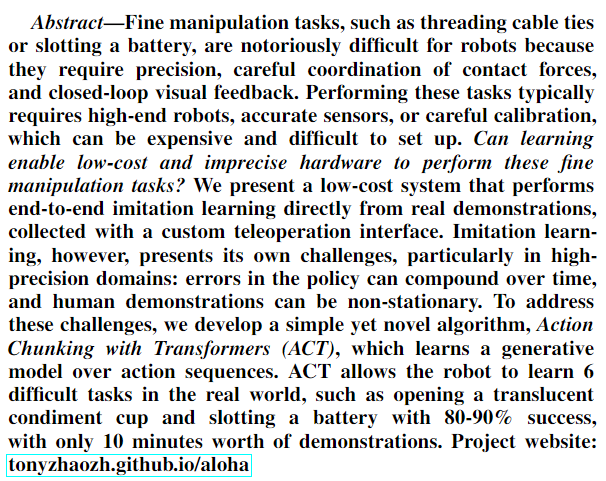
La manipulación fina, como pasar un cable por una brida o insertar una batería, es difícil para los robots. Requiere precisión, fuerzas de contacto coordinadas y retroalimentación visual en lazo cerrado. Las soluciones convencionales a menudo dependen de robots costosos, sensores precisos o una calibración cuidadosa. ¿Puede el aprendizaje permitir que hardware económico y menos preciso realice estas tareas?
El artículo presenta un sistema de bajo costo que recopila demostraciones reales mediante una interfaz de teleoperación personalizada para aprendizaje por imitación directo de extremo a extremo. Los desafíos incluyen la acumulación de errores de la política y las demostraciones humanas no estacionarias, especialmente en tareas de alta precisión. El algoritmo propuesto, Action Chunking with Transformers (ACT), aprende un modelo generativo de secuencias de acciones. Con solo 10 minutos de demostraciones, el robot puede realizar seis tareas desafiantes del mundo real, como abrir vasos translúcidos de condimentos e insertar baterías, con tasas de éxito que alcanzan el 80–90%.
- Comentario:
El aprendizaje por imitación convencional a menudo repite “observar → predecir una acción → ejecutar → observar de nuevo”. En tareas de precisión, incluso un pequeño error puede llevar al robot a un estado ausente de las demostraciones, haciendo que las predicciones posteriores se desvíen aún más. Esto es error acumulativo.
La idea central de ACT es el action chunking: generar una secuencia futura continua en lugar de una acción cada vez. Esto favorece la continuidad temporal y reduce el horizonte efectivo de decisión sobre el que se acumulan los errores.
Los Transformers se adaptan bien a las relaciones de secuencia: pueden aprender cómo se relacionan las acciones a lo largo del tiempo, en lugar de considerar solo lo que el robot debe hacer en el instante actual.
ACT permite que el robot prediga de una vez una breve secuencia de acciones.
Introducción
-
Párrafo 1: el problema. Las tareas delicadas que implican pellizcar, hacer palanca o rasgar, como abrir un vaso o insertar una batería, requieren retroalimentación visual precisa y coordinación mano–ojo para que las acciones puedan ajustarse a medida que el entorno cambia.
-
Párrafo 2: limitaciones anteriores y el enfoque propuesto. Trabajos como Grasping with Chopsticks y Goal-conditioned dual-action imitation learning dependen de hardware costoso o de una calibración cuidadosa. Los autores, en cambio, buscan un sistema asequible, accesible y reproducible: imágenes RGB ordinarias → red neuronal → acciones del robot.
-
Párrafo 3: la plataforma. El hardware experimental cuesta menos de 20.000 US$.
-
Párrafo 4: ACT aborda los errores acumulativos en el aprendizaje por imitación.
Incluso con buenas demostraciones, las predicciones de acciones pueden contener pequeños errores. En tareas de precisión, un error puede llevar al robot a un estado distinto de los vistos en el entrenamiento, haciendo que las predicciones posteriores sean progresivamente menos fiables.
Los autores se inspiran en el action chunking en psicología: las personas organizan los movimientos continuos en unidades coherentes en lugar de tratar cada instante como una acción independiente.
Aprendizaje por imitación convencional: observación actual → siguiente acción.
ACT: observación actual → acciones para los próximos k pasos de tiempo.
Predecir una secuencia corta acorta efectivamente el horizonte de decisión por un factor de k, reduciendo el efecto de los errores que se acumulan a lo largo de decisiones individuales.
El chunking también ayuda a explicar irregularidades en las demostraciones humanas, como las pausas. Un modelo secuencial puede interpretar una pausa en el contexto de los movimientos antes y después de ella, en lugar de tratar una observación instantánea como suficiente para explicarla.
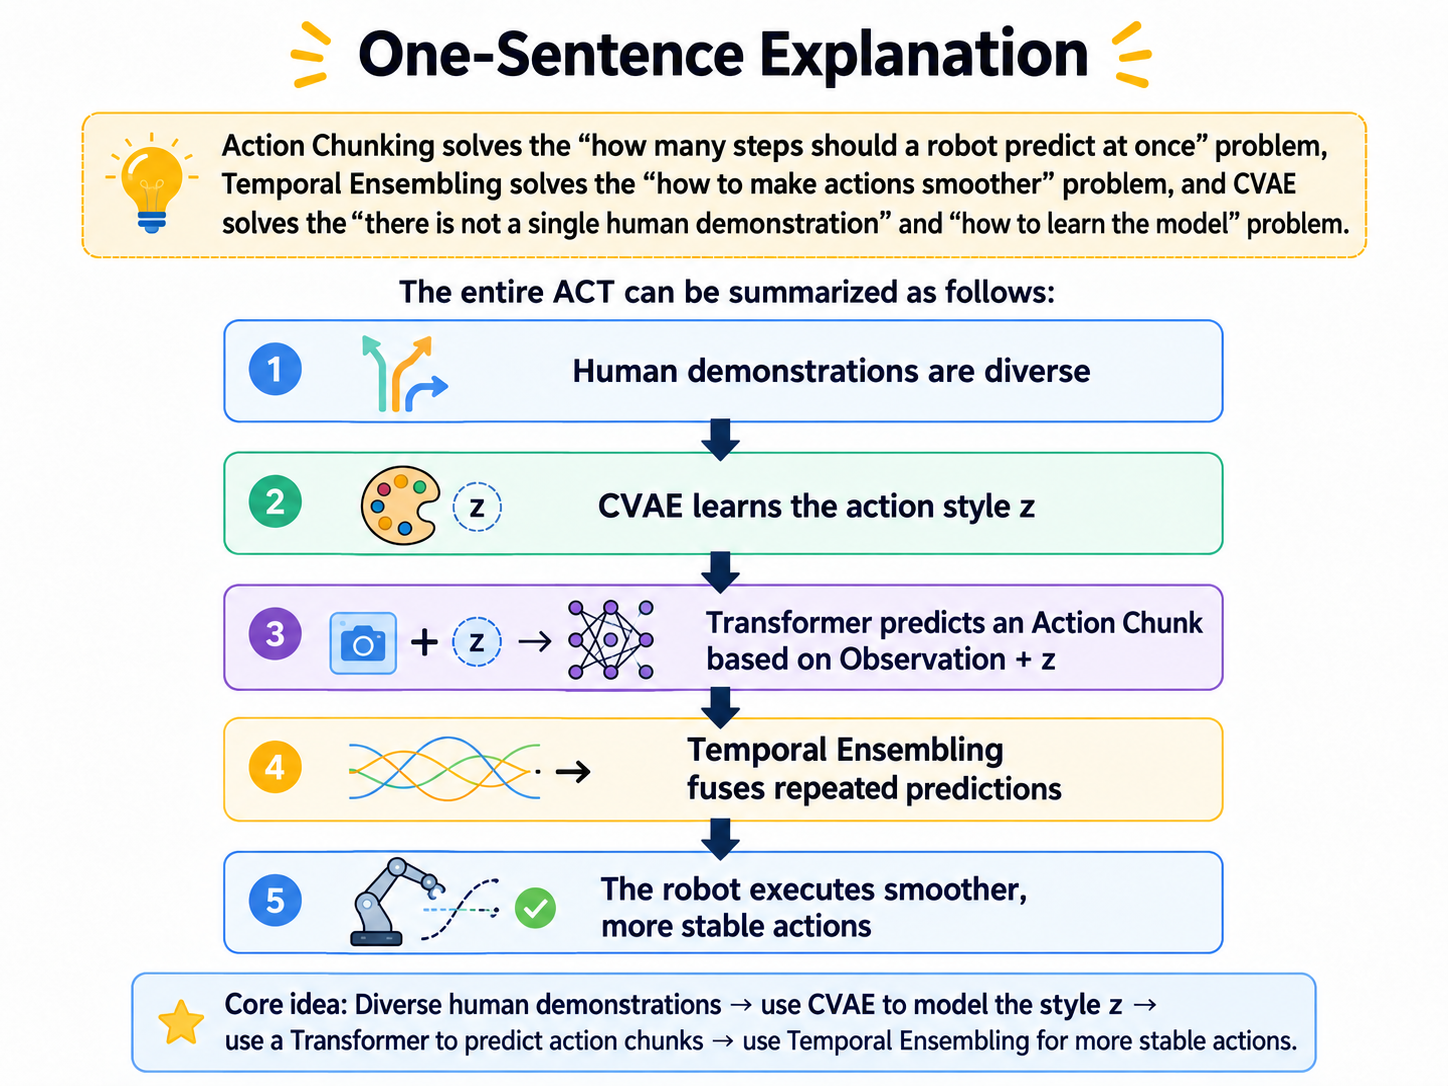
Para una ejecución más suave, el temporal ensembling combina chunks solapados predichos en distintos momentos. En lugar de elegir solo una predicción para el instante actual, ACT las mezcla con pesos, reduciendo el jitter.
La arquitectura usa un Transformer para las secuencias de acciones y un VAE condicional (CVAE) para la variabilidad de las demostraciones. Una tarea puede tener varias trayectorias, velocidades u órdenes de acciones válidos; el CVAE modela esta distribución en lugar de asumir una única secuencia correcta.
Action Chunking with Transformers: ACT.
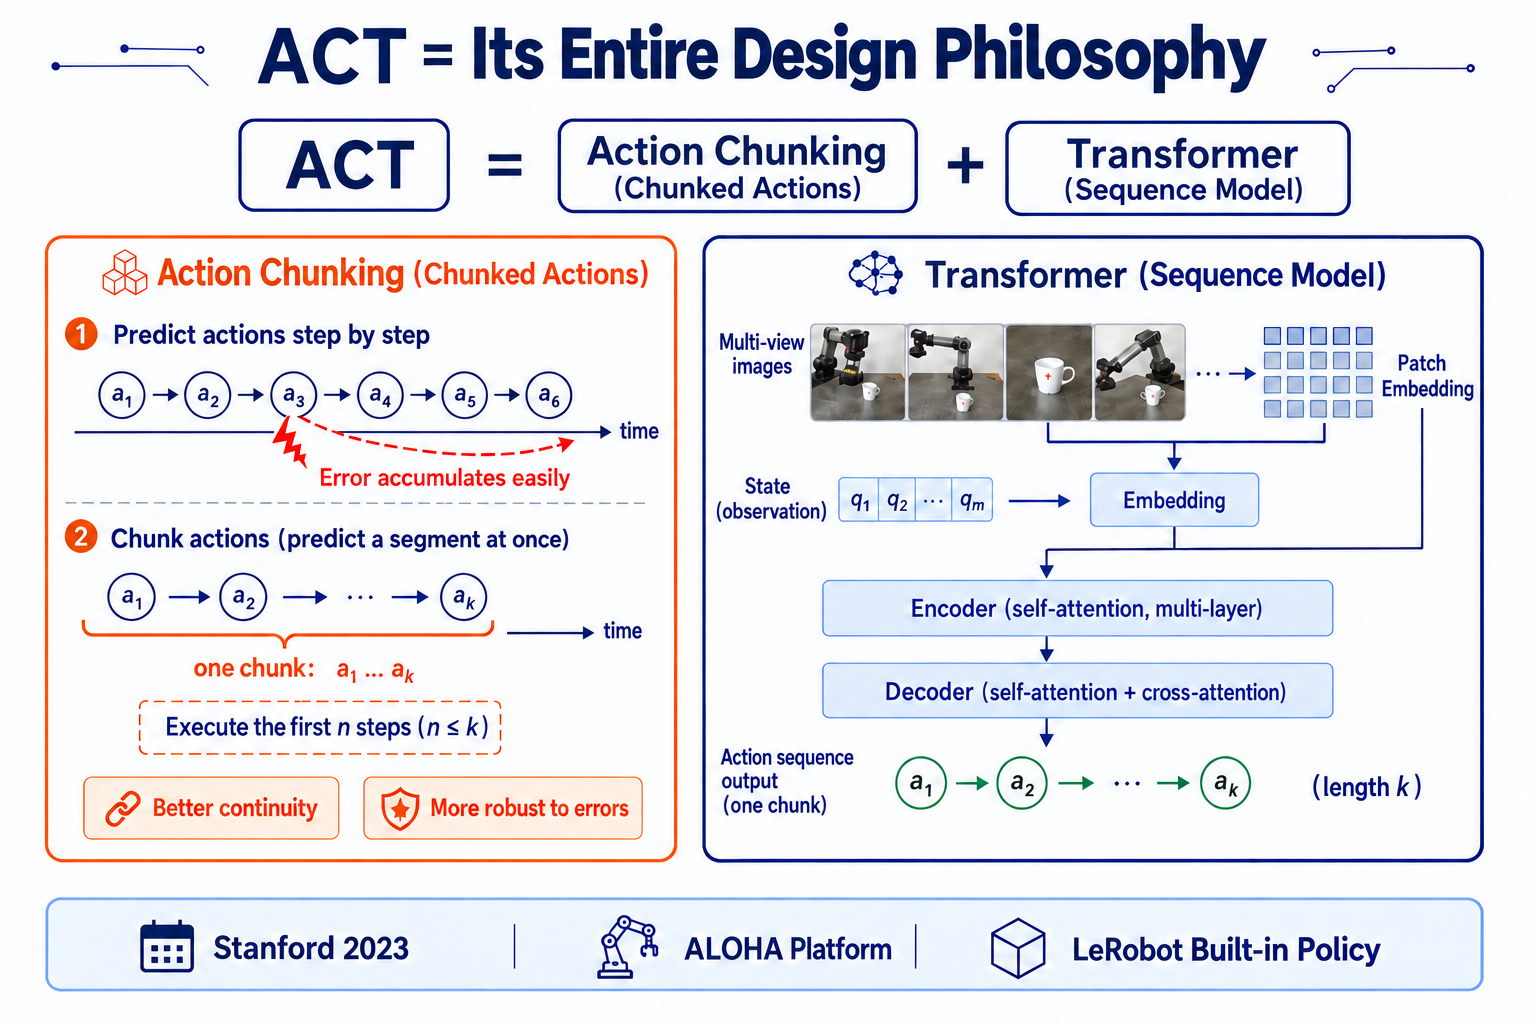
- Párrafo 5: las dos contribuciones son una plataforma de teleoperación de bajo coste y el algoritmo ACT.
El artículo aborda dos problemas conectados de aprendizaje robótico:
1. ¿De dónde vienen las demostraciones?
Un sistema de teleoperación de bajo coste permite a las personas realizar manipulación fina directamente y recopilar demostraciones de alta calidad de forma eficiente.
2. ¿Cómo aprende el robot a partir de ellas?
ACT combina chunks de acciones, Transformers, un CVAE y temporal ensembling para aprender manipulación fina con retroalimentación visual. La contribución es la combinación de hardware y aprendizaje: teleoperación humana → demostraciones → entrenamiento de ACT → ejecución autónoma del robot.
Con aproximadamente diez minutos, o unas 50 trayectorias humanas, el sistema aprende seis tareas de manipulación fina en el mundo real, incluyendo abrir recipientes de condimentos e insertar baterías. Algunas tareas alcanzan un éxito del 80–90%.
Trabajos Relacionados
Esta sección repasa enfoques anteriores de clonación de comportamiento y sus limitaciones. Léela para obtener contexto; es opcional para los objetivos prácticos de aprendizaje de esta guía.
ALOHA: Un Sistema de Teleoperación Bimanual de Bajo Coste
Objetivos de Diseño y Hardware
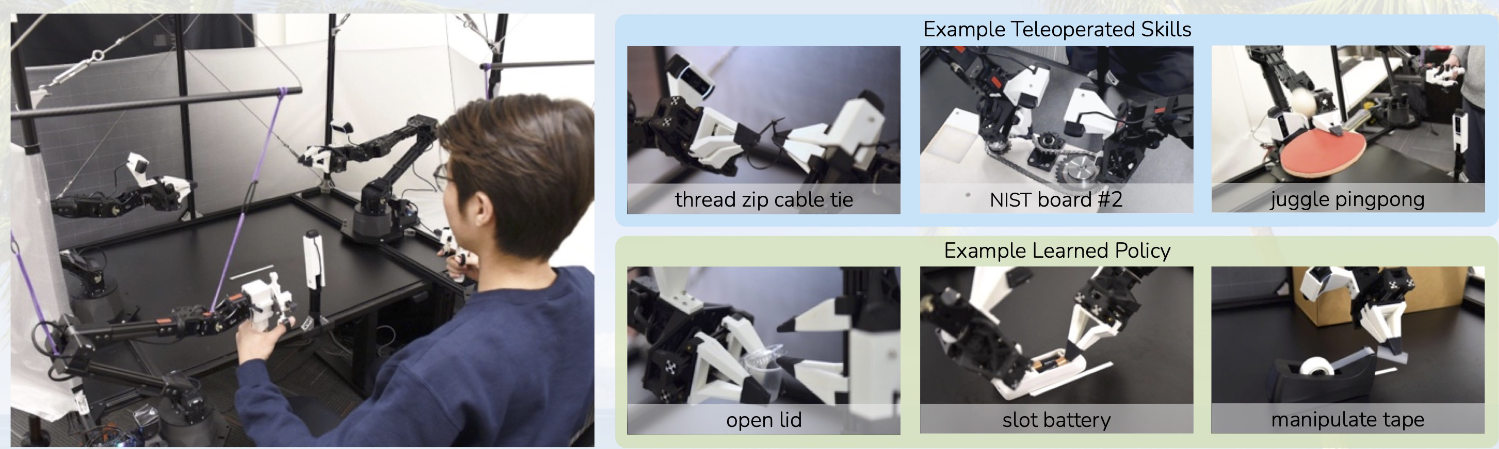
Los autores definen cinco principios de diseño para soportar la manipulación fina mientras reducen la barrera de reproducción en laboratorios ordinarios.
ALOHA usa dos brazos ViperX de 6 GDL como robots seguidores, en lugar de brazos industriales caros. Cada ViperX cuesta alrededor de 5.600 US$ y tiene una precisión de posicionamiento de aproximadamente 5–8 mm.
Teleoperación Líder–Seguidor
Una decisión de diseño central es la teleoperación líder–seguidor. El operador mueve el líder a mano, mientras que el seguidor ViperX sigue su movimiento articular.
Mover el líder → Leer sus ángulos articulares → Mover el seguidor de forma síncrona → Realizar la tarea.
Esto es un mapeo en el espacio articular, con varias ventajas:
-
No requiere un cálculo frecuente de cinemática inversa.
-
Comportamiento más estable cerca de singularidades cinemáticas.
-
Menor latencia de control.
-
Un mapeo directo del movimiento del operador al robot.
Cámaras, Recopilación de Datos y Capacidades
ALOHA registra las demostraciones usando cuatro cámaras RGB ordinarias:
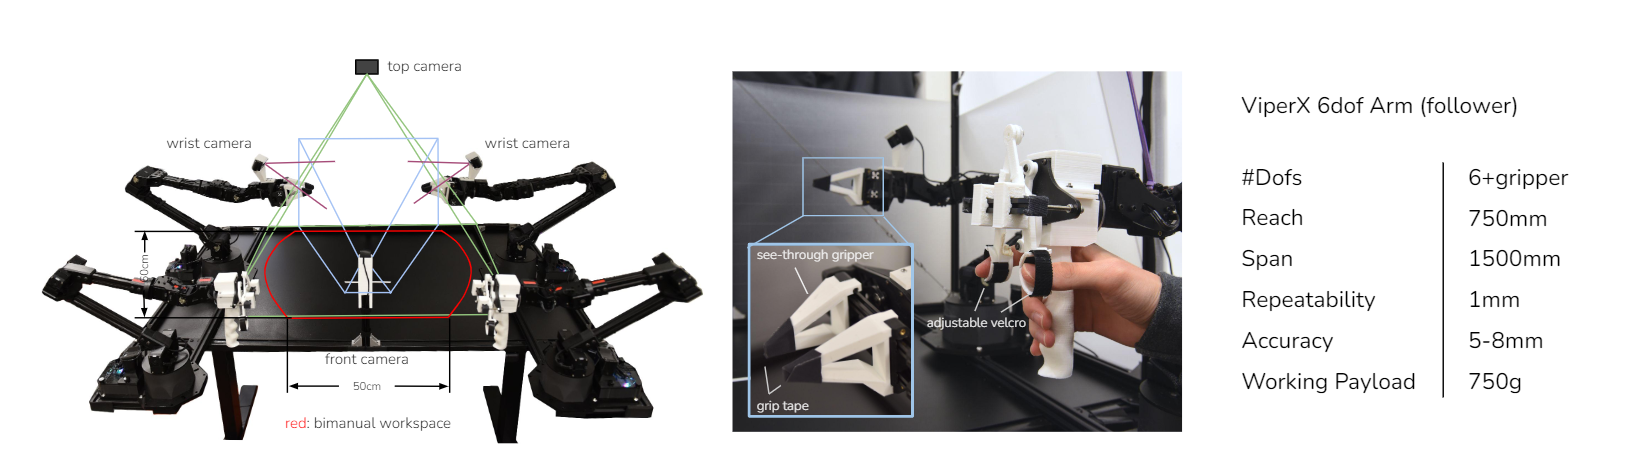
Los autores agrupan ampliamente las tareas en tres categorías:
Action Chunking y Temporal Ensembling
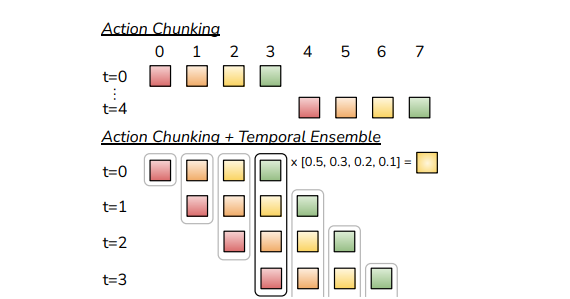
Action Chunking: Predecir una Secuencia Corta
El aprendizaje por imitación convencional predice una siguiente acción a partir del estado actual: avanzar un poco, luego bajar un poco. Un pequeño error puede cambiar la siguiente observación y acumularse hasta que la tarea falle. El action chunking es la respuesta central de ACT a este problema.
Predecir una secuencia futura continua en lugar de una sola acción. Con chunk_size = 4, una política de un solo paso toma decisiones en t=0→a0, t=1→a1, t=2→a2, t=3→a3; ACT predice [a0,a1,a2,a3] en t=0. Esta secuencia es un action chunk. La política cambia de πθ(at|st) a πθ(at:t+k|st), donde k es la longitud del chunk.
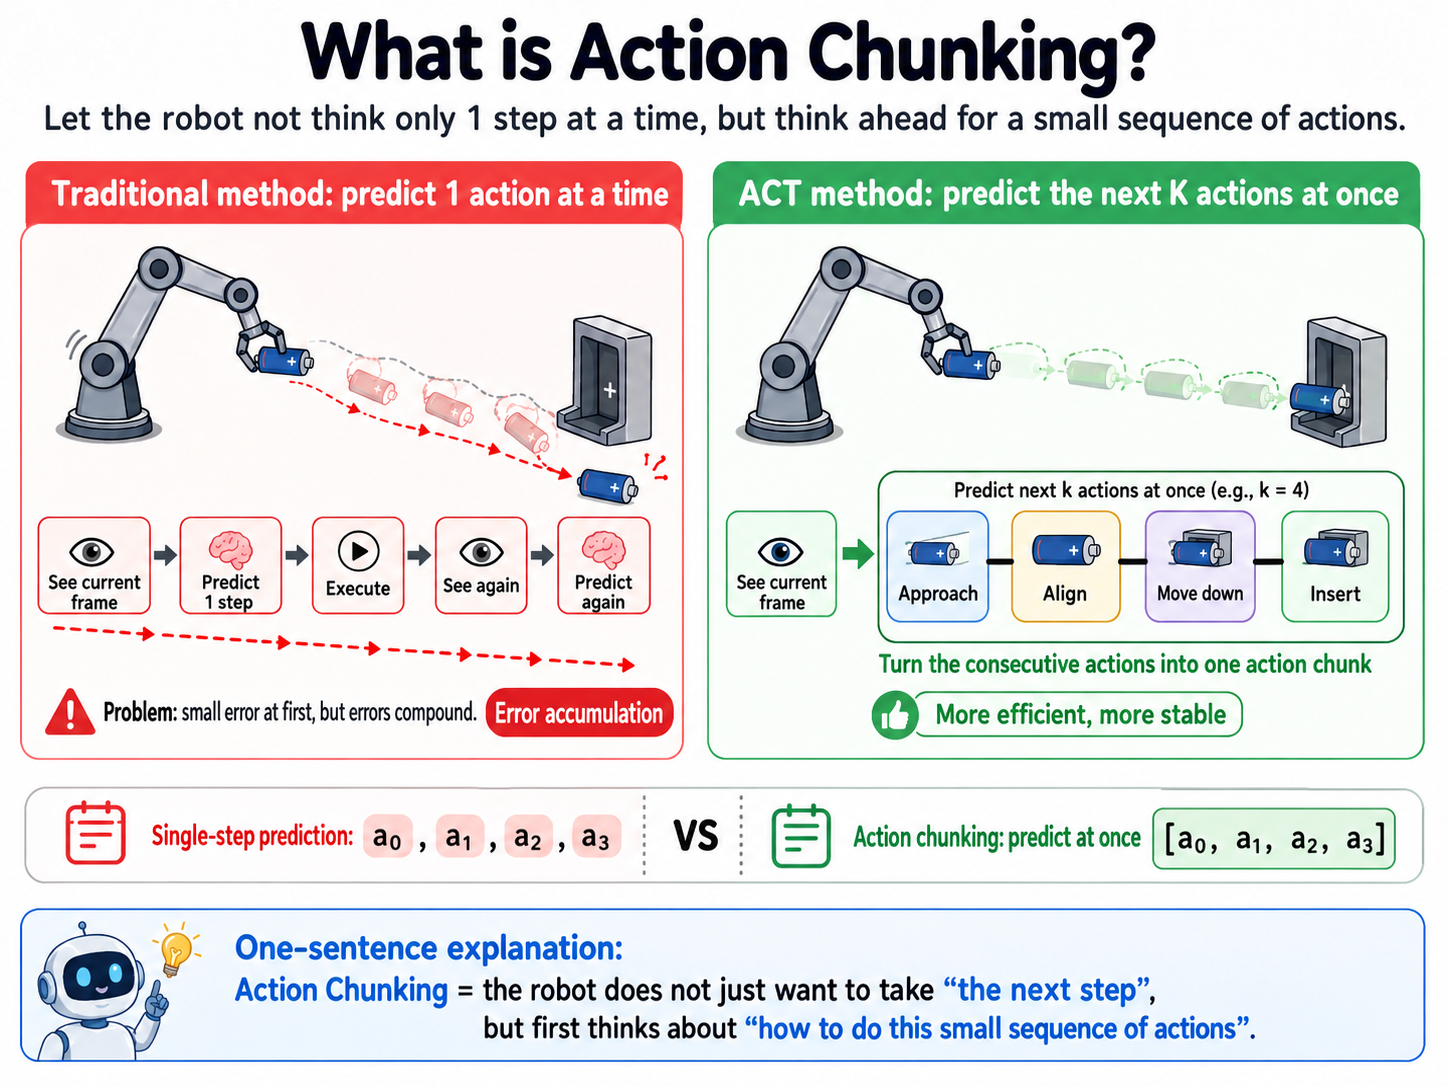
La intuición es considerar una secuencia corta en lugar de improvisar en cada instante. Al insertar una batería, las personas organizan de forma natural “acercarse → alinear → insertar” como un movimiento coherente en lugar de una larga lista de correcciones de un milímetro. El chunking enseña esa estructura al robot.
También reduce el horizonte efectivo por un factor de k. Una tarea de 100 pasos de tiempo requiere 100 decisiones de un solo paso; con chunk_size=10, puede considerarse como menos segmentos continuos. Mirar varios pasos hacia adelante hace que un pequeño error aislado sea menos probable que descarrile inmediatamente el resto de la secuencia.
Las demostraciones humanas también incluyen pausas, dudas y cambios de velocidad. Aprender “acercarse → pausar → ajustar → insertar” como una secuencia hace que estas relaciones sean más fáciles de representar que aprender instantes aislados.
https://github\.com/huggingface/lerobot/blob/main/src/lerobot/policies/act/modeling\_act\.py
Temporal Ensembling
ACT predice una secuencia futura corta, pero ¿qué ocurre si el entorno cambia mientras se está ejecutando?
Con temporal ensembling, ACT observa y predice un nuevo chunk en cada paso de tiempo, en lugar de ejecutar a ciegas un chunk completo. Para chunk_size = 4, las predicciones podrían verse así:
t=0 → [a0, a1, a2, a3]
t=1 → [a1', a2', a3', a4']
t=2 → [a2'', a3'', a4'', a5'']
El mismo instante futuro por lo tanto recibe múltiples predicciones. En t=2, por ejemplo:
a2, predicha en t=0.
a2', predicha en t=1.
a2'', predicha en t=2.
En lugar de seleccionar solo una, ACT toma una combinación ponderada de predicciones para el mismo paso de tiempo para obtener la acción ejecutada. Esto es temporal ensembling.
El modelo revisita la misma acción futura en distintos momentos usando diferentes observaciones, y luego combina esas estimaciones.
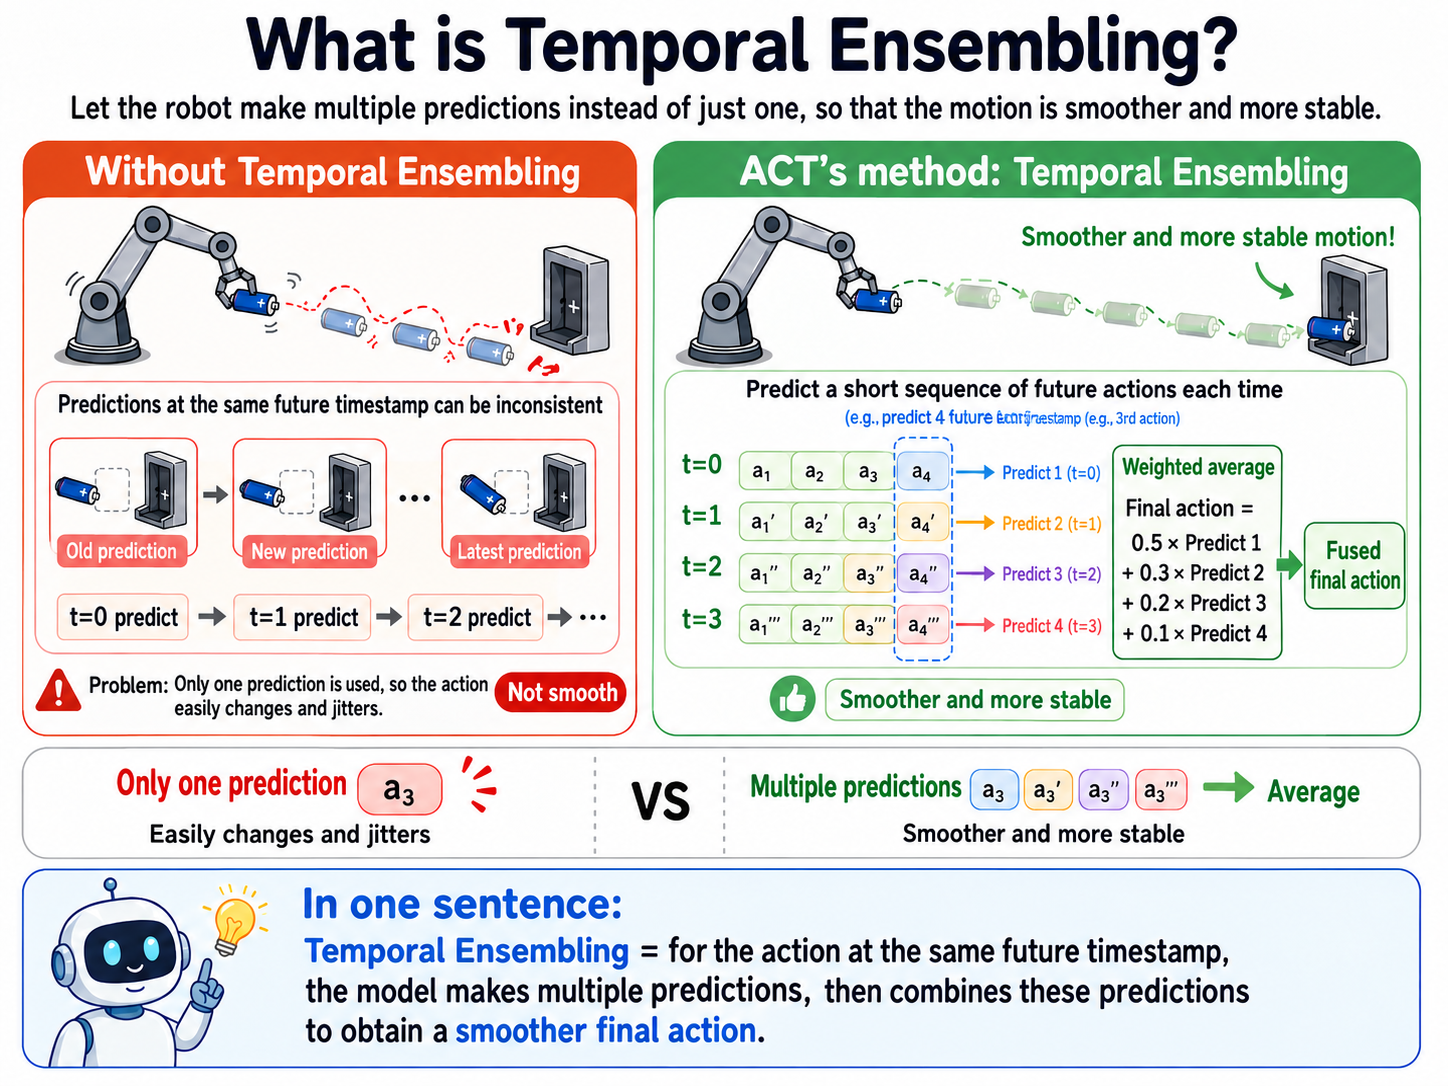
Seguir solo la predicción más reciente puede causar saltos bruscos. El promedio ponderado suaviza la ejecución. Principalmente aborda dos problemas:
El artículo usa pesos exponenciales:
El action chunking mira varios pasos hacia adelante. El temporal ensembling observa y predice repetidamente, y luego combina suavemente estimaciones solapadas.
Modelar Demostraciones Humanas con un CVAE
El action chunking predice una secuencia y el temporal ensembling suaviza la ejecución, pero queda otro problema: las demostraciones humanas no son idénticas.
Al insertar una batería, distintos operadores pueden:
-
Acercarse desde distintos ángulos.
-
Moverse a distintas velocidades.
-
Ajustar hacia la izquierda antes de insertar.
-
Alinear directamente e insertar.
Incluso la misma persona produce trayectorias diferentes en intentos repetidos. Por lo tanto, una observación dada no tiene solo una secuencia de acciones correcta. Asumir que
“Esta imagen debe producir exactamente una trayectoria de acción”
puede fomentar el promedio entre estrategias distintas. Considera dos demostraciones:
Demonstration A: go around the left → insert
Demonstration B: go around the right → insert
Un promedio simple podría convertirse en:
Go straight through the middle
Pero puede haber un obstáculo en el medio.
El objetivo es aprender:
Qué secuencias de acciones razonables podría usar una persona en el estado actual.
Esto motiva el autoencoder variacional condicional (CVAE).
Cómo Funciona el CVAE en ACT
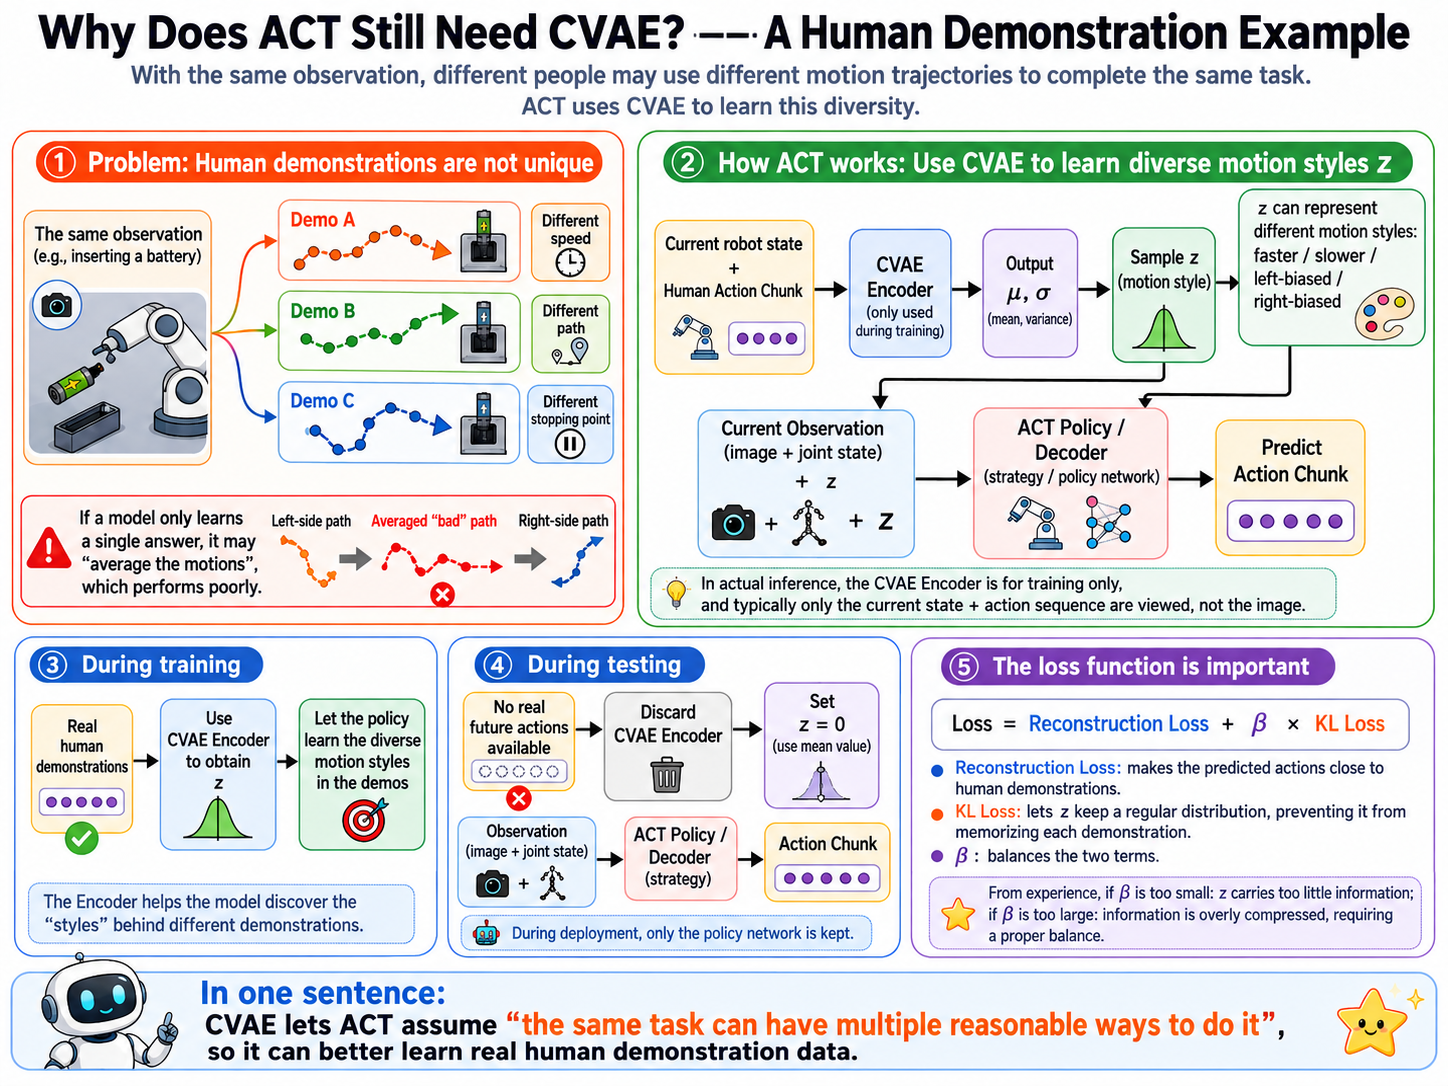
El CVAE tiene dos componentes principales:
El codificador usa:
-
El estado actual del robot.
-
La secuencia de acciones demostrada.
Infiere un “estilo de movimiento” latente. En lugar de producir un único fijo, predice parámetros de una distribución gaussiana :
-
Una media.
-
Varianza.
Muestrear de esa distribución permite que el modelo represente la incertidumbre sobre el estilo de la demostración en lugar de asignar un valor rígido. Esta es una idea central de los VAE.
En principio, el codificador del CVAE en tiempo de entrenamiento podría recibir:
Image + Robot State + Action Sequence
Para un entrenamiento más rápido, los autores omiten las imágenes del codificador del CVAE.
Sus entradas reales son:
Robot State + Action Sequence
        ↓
   CVAE Encoder
Las imágenes siguen entrando en la política ACT que predice acciones. Así:
El codificador del CVAE extrae el estilo de la demostración; la política de predicción de acciones sigue usando imágenes de cámara para decidir qué debe hacer el robot.
La Red ACT Completa
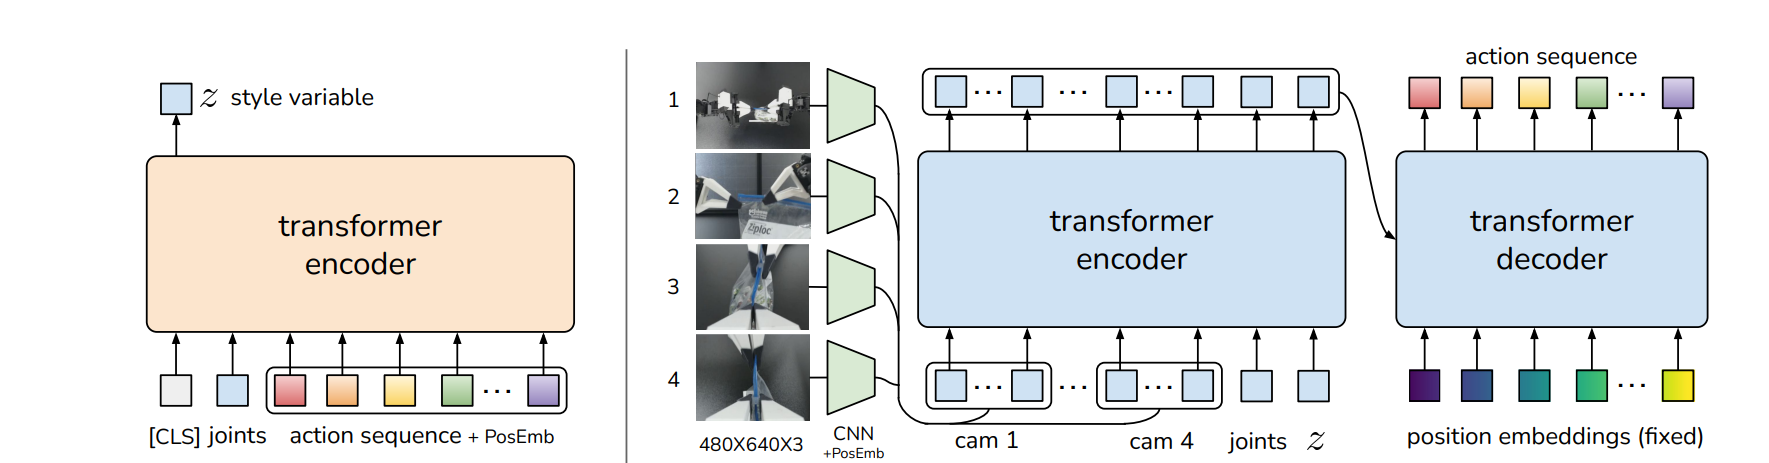
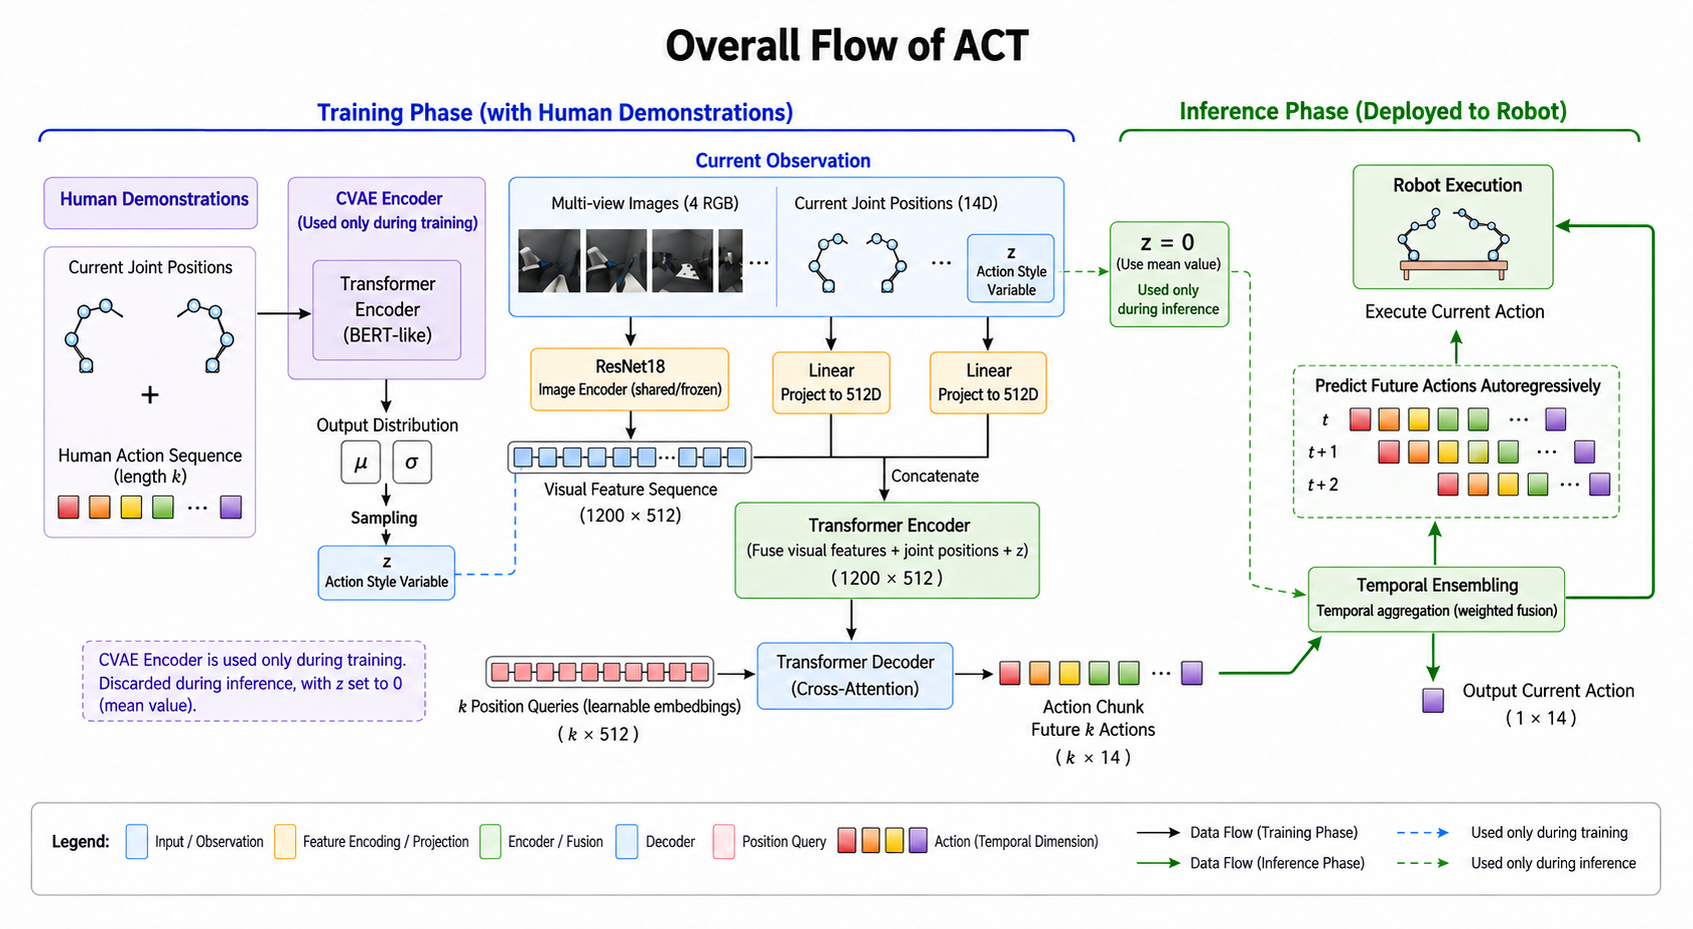
Las posiciones articulares y el fragmento de acción demostrado primero entran en el codificador CVAE para representar las diferencias en el estilo de demostración, produciendo los parámetros gaussianos y una variable latente de estilo . Este codificador procesa estados articulares y secuencias de acciones en lugar de imágenes de cámara.
Introducir imágenes RGB crudas de en un Transformer sería costoso. ResNet18 primero convierte cada imagen de cámara en un mapa de características de , aplanado en una secuencia de características de . Las cuatro cámaras de ALOHA por lo tanto generan tokens visuales.
El modelo proyecta por separado la posición articular de 14 dimensiones y el estilo latente en 512 dimensiones y las concatena con las características visuales. El codificador Transformer recibe:
1200+1+1=1202
Esto da una secuencia de . El codificador fusiona tres tipos de información: lo que el robot ve, su configuración actual y el estilo de movimiento de la demostración.
Luego, un decodificador Transformer utiliza consultas posicionales, una para cada instante futuro. La atención cruzada recupera información del entorno desde la salida del codificador y predice todas las acciones juntas. Los dos brazos de ALOHA tienen en total 14 dimensiones controladas de articulaciones/pinza, dando:
Para chunk_size = 100, una inferencia predice 100 instantes de tiempo × 14 posiciones articulares: el fragmento de acción completo.
El entrenamiento compara los fragmentos predichos con las demostraciones humanas usando una pérdida de reconstrucción L1, más una pérdida KL del CVAE que regulariza la distribución latente.
En el despliegue no hay un fragmento futuro de acción demostrada, por lo que se elimina el codificador CVAE y se fija . Las imágenes y las posiciones articulares actuales generan nuevos fragmentos; el ensamblado temporal combina predicciones solapadas, y la acción actual se envía al robot.
El flujo completo es:
Entrenamiento: demostración → el CVAE aprende → imágenes + articulaciones + → Transformer → fragmento de acción
Inferencia: imágenes + articulaciones + → Transformer → fragmento de acción → ensamblado temporal → robot
Recuerda los roles por separado:
La segmentación en fragmentos de acción determina cuántas acciones futuras se predicen juntas; el ensamblado temporal suaviza la ejecución; el CVAE modela el hecho de que varias demostraciones pueden ser válidas para la misma tarea.
Ahora el flujo de trabajo de ACT encaja en conjunto: