EO-1: Cómo unificar el razonamiento encarnado y el control de robots
EO-1: Un modelo fundacional encarnado unificado y abierto para el control general de robots
- Modelo unificado de IA física
- Aprendizaje intercalado
- Razonamiento encarnado
- Control de robots
Requisitos previos: Entradas y salidas
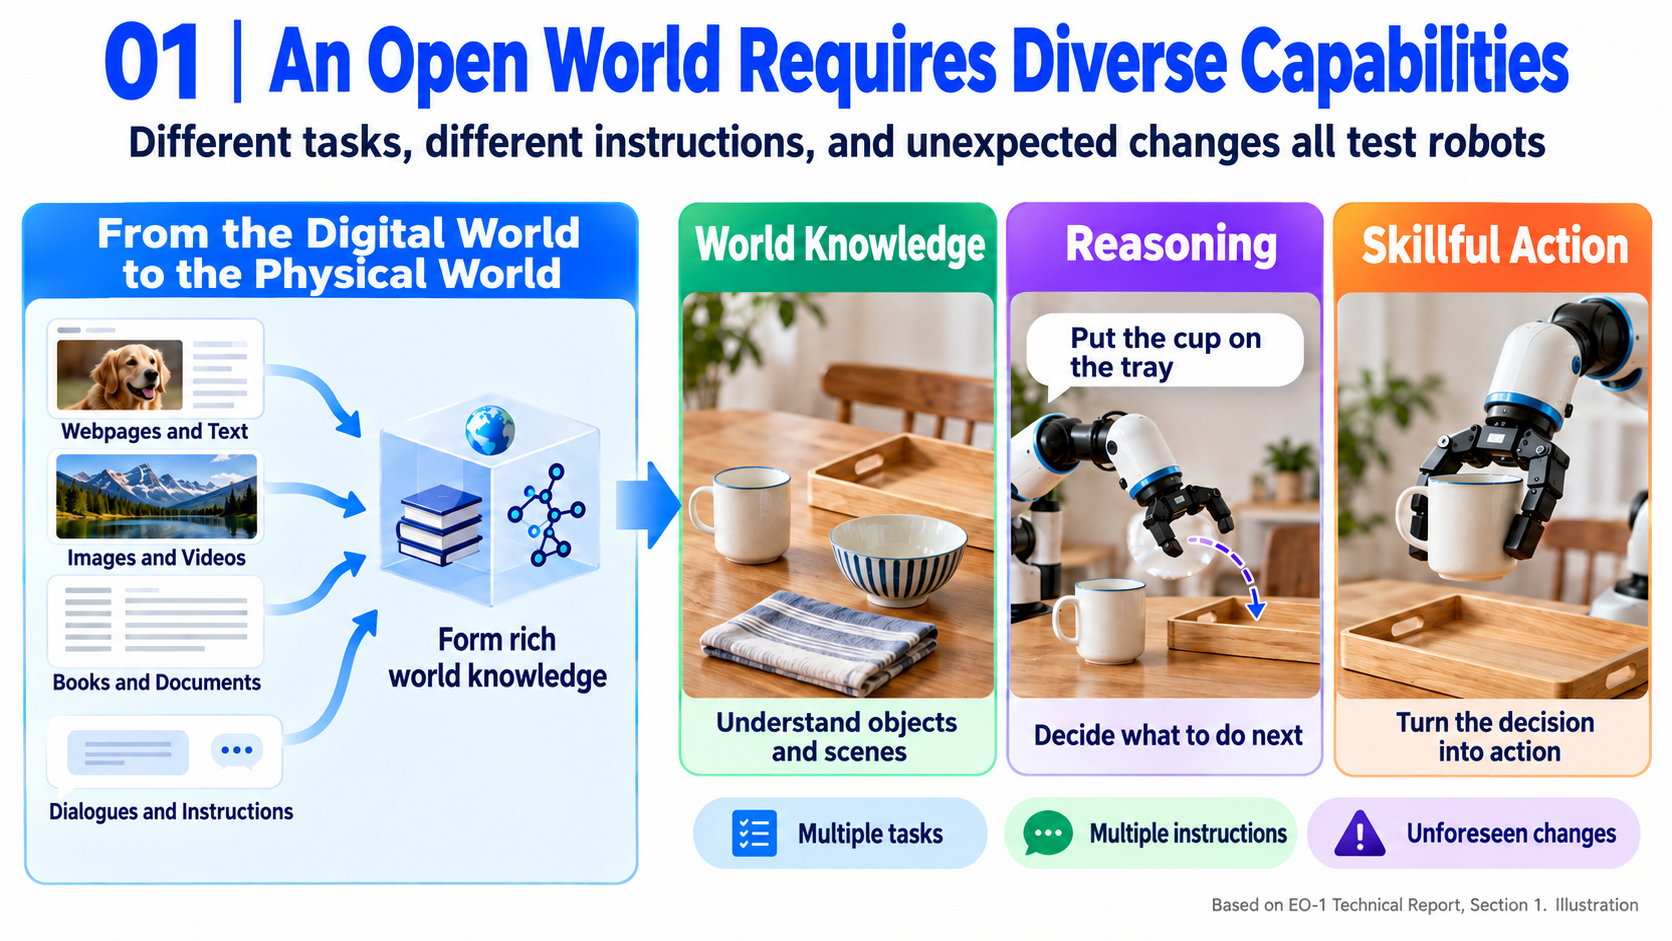
Explicación: El aprendizaje por imitación aprende cómo moverse a partir de operaciones humanas grabadas. Un VLA añade comprensión del lenguaje y normalmente toma imágenes, texto de la tarea y estado del robot como entradas.
Para “pon el tomate en la bolsa de la compra”, las imágenes localizan los objetos, el estado describe el brazo, el texto define el objetivo y las acciones controlan el agarre y la colocación. EO-1 también puede responder “¿qué sigue?” y “¿ya ha terminado?”, conectando juicios antes y después de las acciones.
| Concepto | Significado aquí |
|---|---|
| Observación | Imágenes multivista y estado del robot; las imágenes nuevas provienen de cámaras. |
| Estado | Valores de baja dimensión del robot, como articulaciones; las dimensiones varían según la plataforma. |
| Acción | Controles continuos con significados físicos dependientes de la plataforma y del dataset. |
| Bloque de acciones | Varias acciones futuras predichas juntas; EO-1 usa 16 pasos. |
| Razonamiento encarnado | Juicios sobre objetos, espacio, progreso e interacción física. |
La predicción de un solo paso es observación actual → aₜ; el bloque es observación actual → [aₜ, aₜ₊₁, …, aₜ₊₁₅]. Ilustración: una dimensión de acción podría tener [0.1, 0.12, 0.15]; las salidas reales de EO-1 son arreglos multidimensionales de 16 pasos.
Los bloques de acciones permiten que el modelo organice conjuntamente un segmento de movimiento, pero la longitud del bloque no es el intervalo entre llamadas al modelo. El artículo no da una fracción de ejecución compartida, tasa de replanificación ni tasa de control para cada plataforma, por lo que no se puede inferir el número de llamadas al modelo por segundo a partir de la longitud del bloque.
Resumen: traducción y comentarios
Traducción
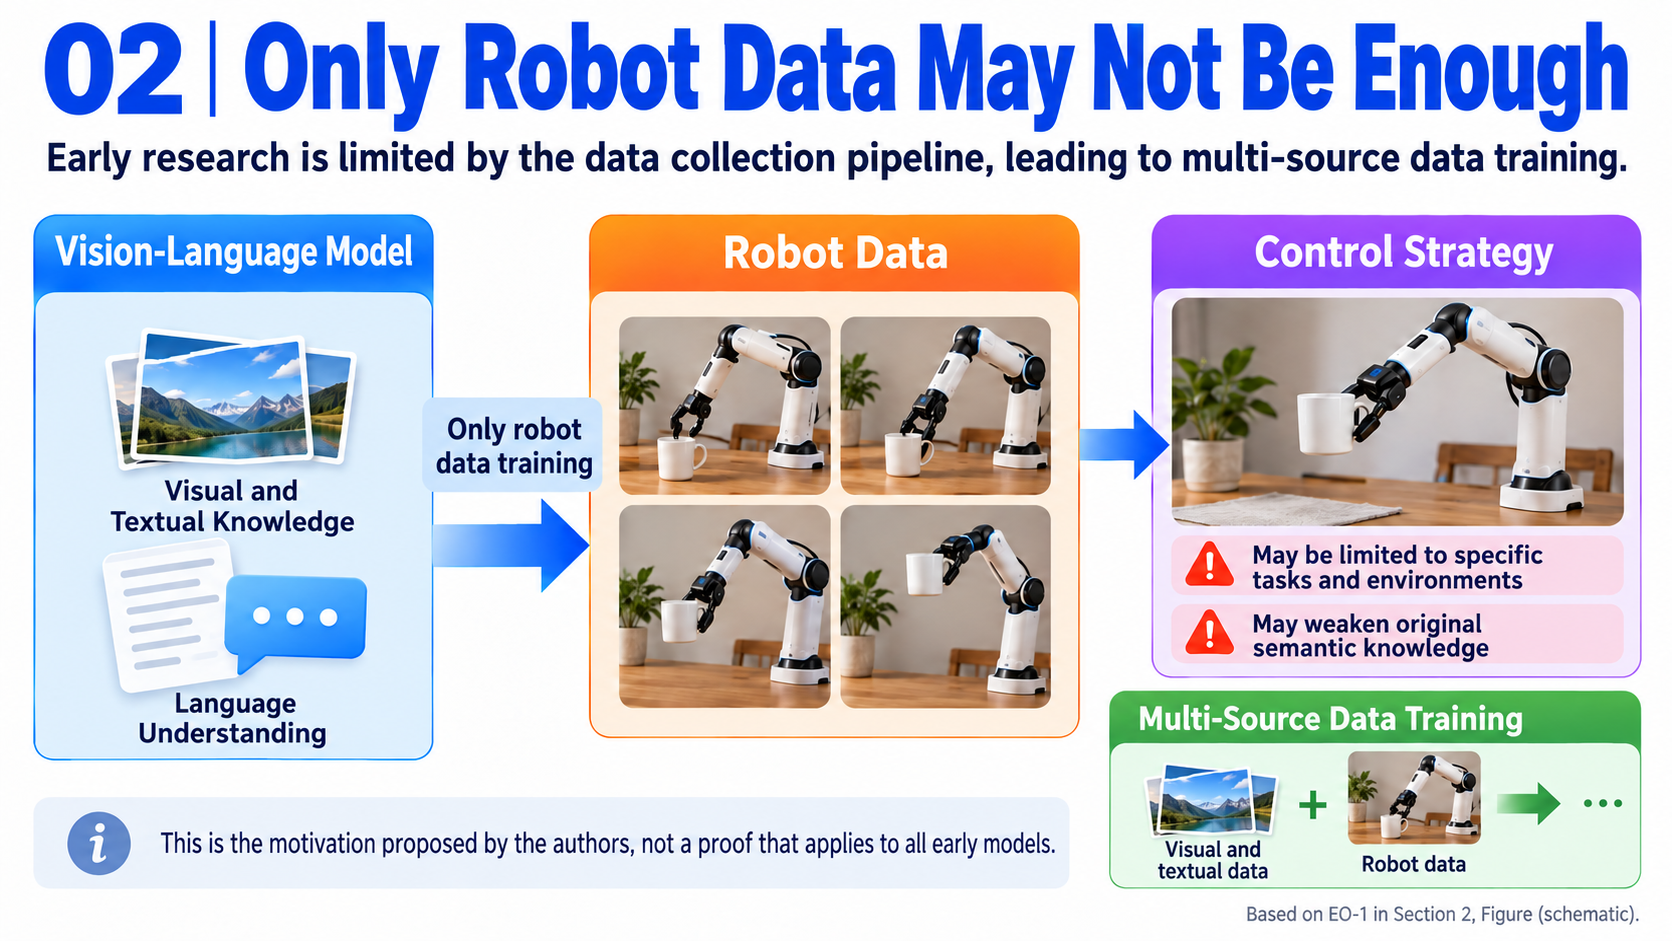
Las personas alternan de forma natural el razonamiento multimodal y la interacción física en el mundo abierto. Los VLA han impulsado el control generalista mediante el coentrenamiento de robots e imagen-texto, pero siguen siendo menos flexibles a la hora de conectar el razonamiento con la interacción.
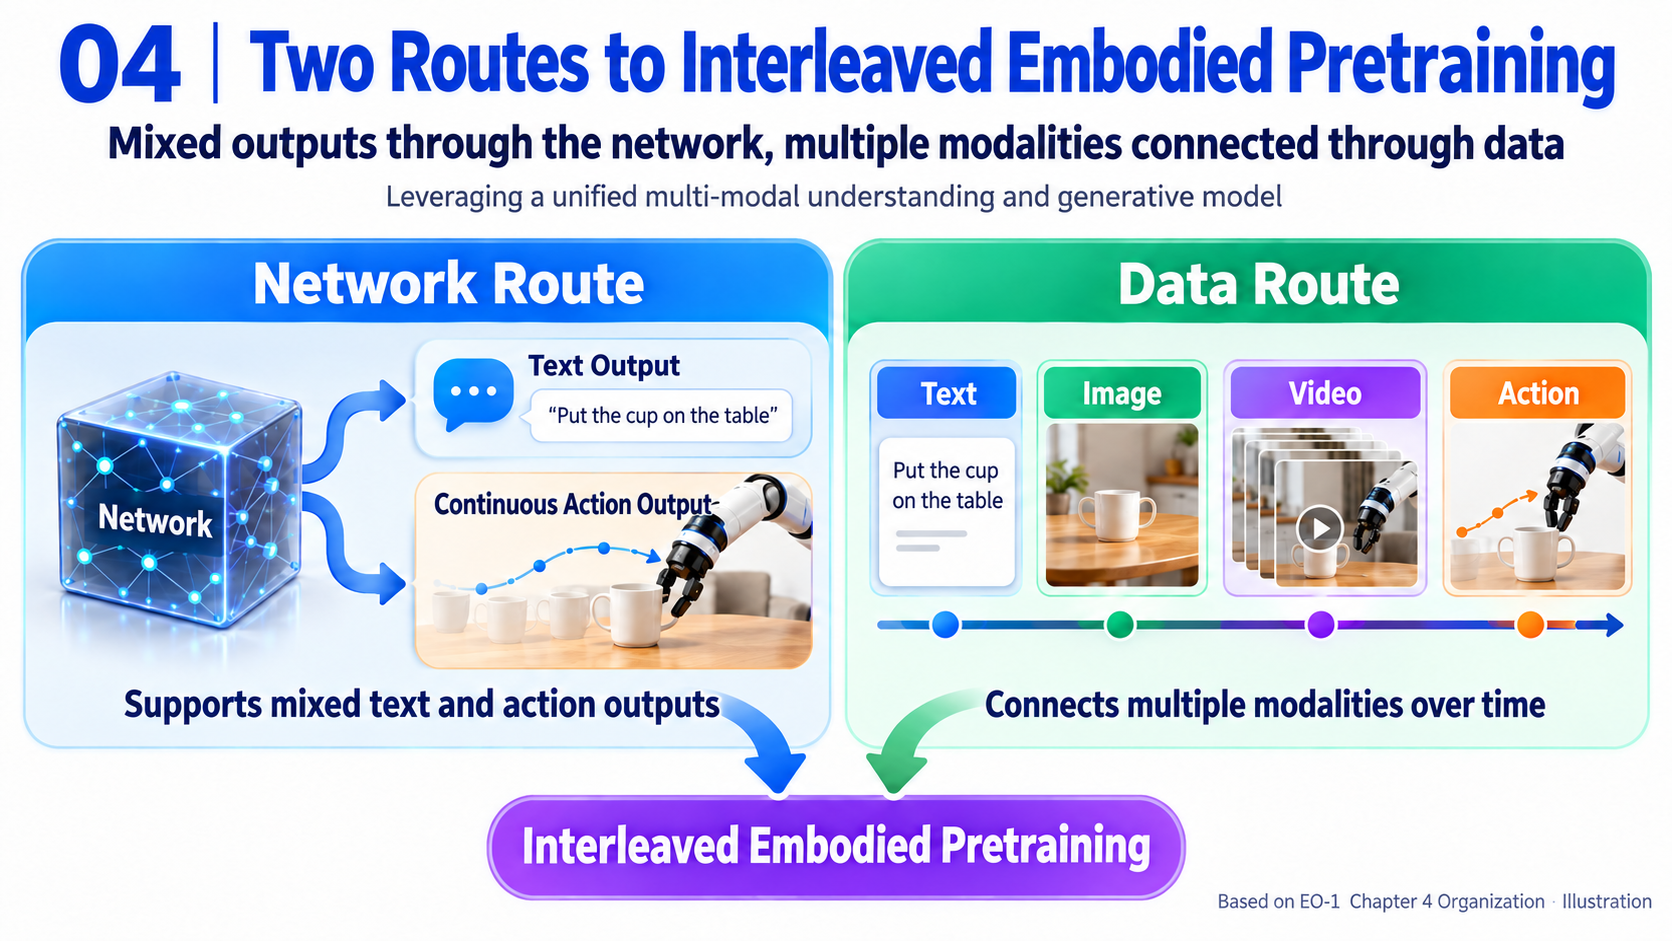
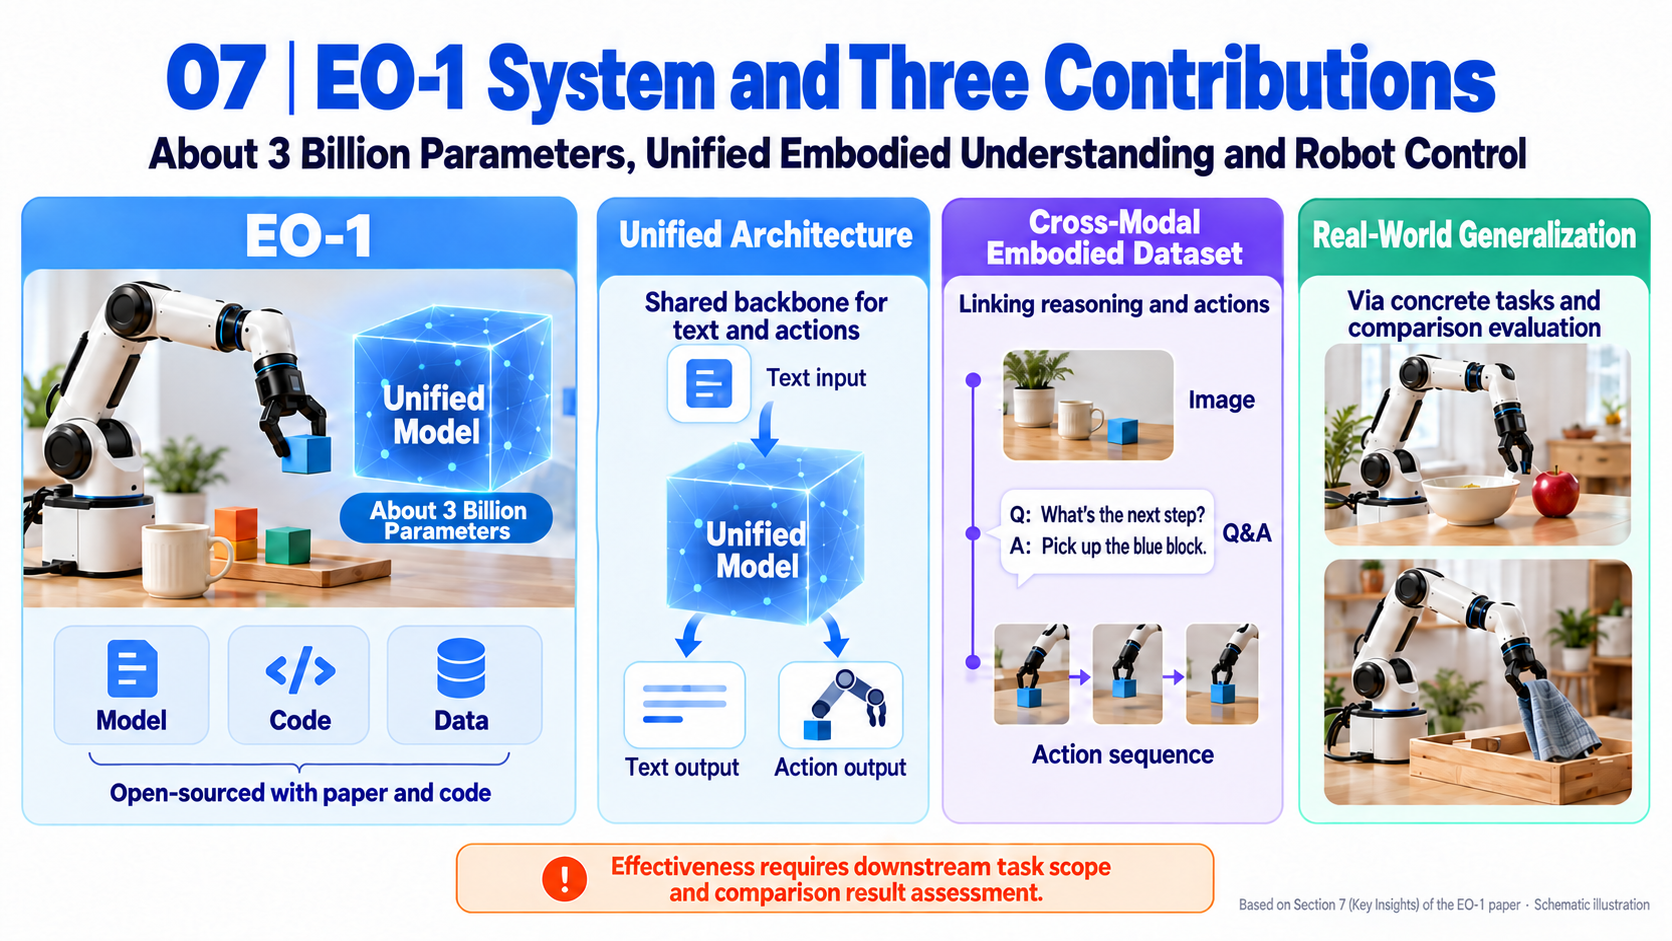
EO-Robotics comprende EO-1 y EO-Data1.5M. EO-1 aprende razonamiento encarnado y control mediante preentrenamiento intercalado visión-texto-acción. Combina una arquitectura que acepta imágenes, texto, vídeo y acciones con más de 1,5 millones de muestras de razonamiento encarnado de alta calidad que enfatizan la comprensión intercalada.
EO-1 se entrena en EO-Data1.5M usando decodificación autoregresiva y denoising por flow-matching para conectar la generación de acciones de robot con el razonamiento encarnado multimodal. Amplios experimentos en distintas encarnaciones de robots y tareas de manipulación hábil de largo horizonte validan el aprendizaje intercalado para la comprensión y generalización en mundo abierto. El artículo describe la arquitectura, la construcción de datos y los métodos de entrenamiento como referencia para modelos fundacionales encarnados.
Comentarios
-
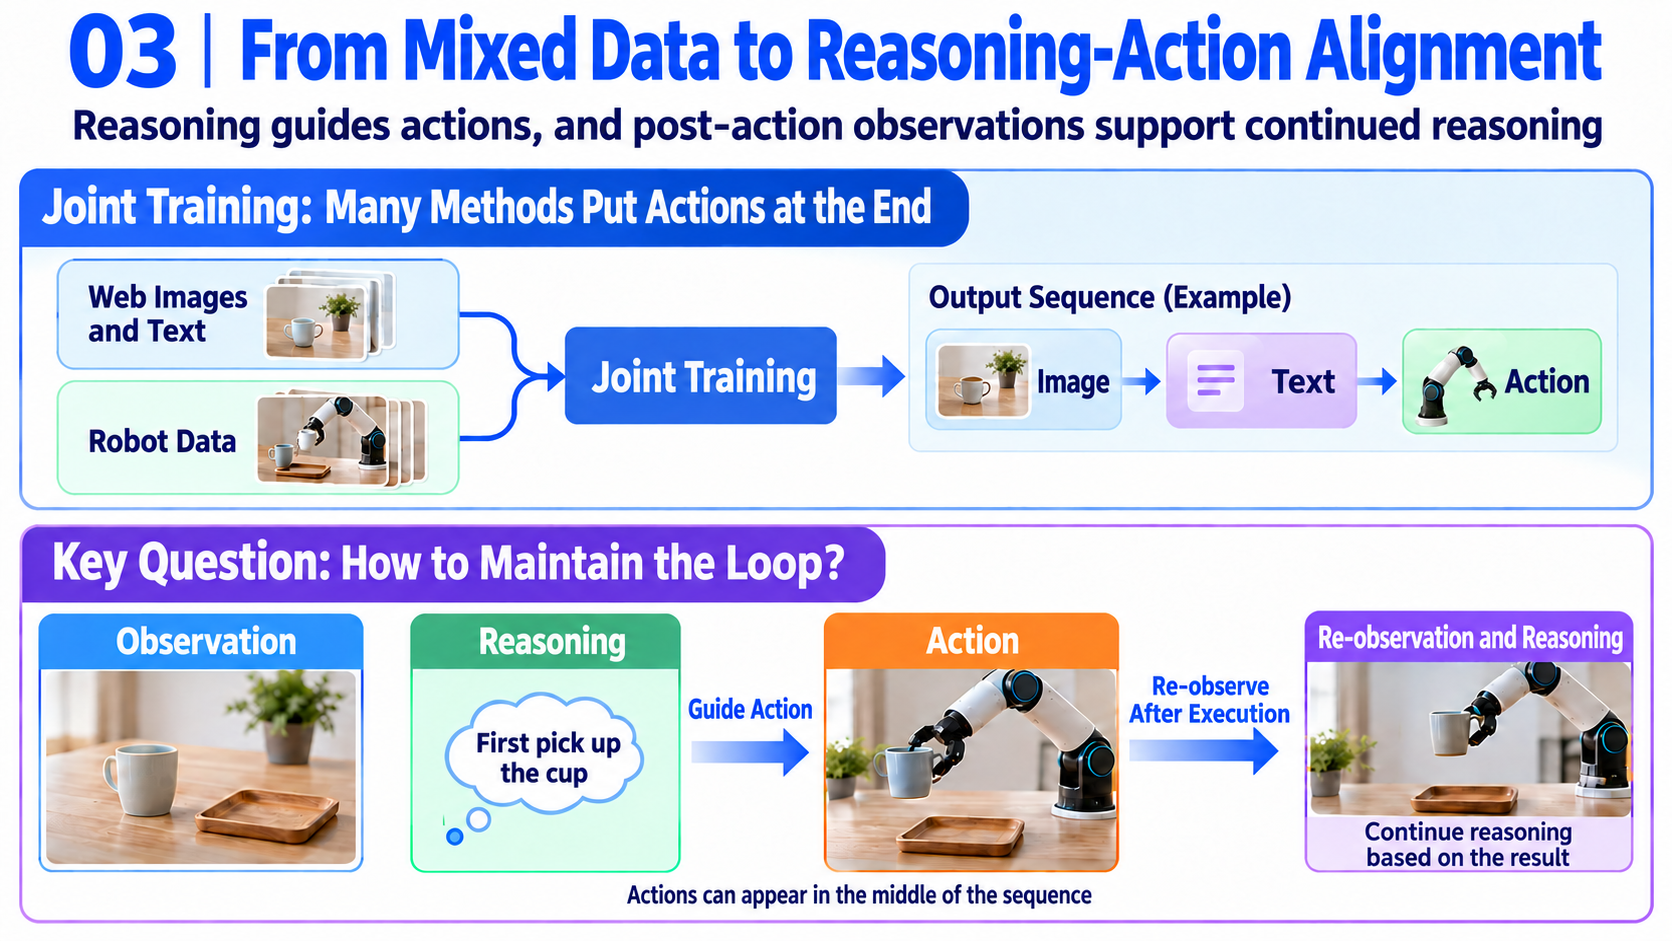
La conexión entre razonamiento y acciones cambia. Más allá de generar acciones a partir de una imagen e instrucción, el modelo aprende a reevaluar después de las acciones usando nuevas imágenes.
-
La arquitectura y los datos son ambos necesarios. La red debe soportar texto y acciones continuas, y los ejemplos deben conectarlos a lo largo del tiempo.
-
Más de 1,5 millones se refiere al dataset completo. No todas las muestras contienen acciones totalmente intercaladas; el texto informa por separado de unas 122.000 muestras intercaladas visión-texto-acción.
-
La efectividad está acotada por los experimentos. Los resultados en múltiples plataformas no establecen generalidad a nivel humano ni en escenas arbitrarias.
Introducción y trabajos relacionados: ¿por qué intercalar?
Los siete párrafos principales de la introducción
Relación con trabajos anteriores
Método central: un solo backbone, dos salidas
Procesamiento compartido con interfaces específicas por modalidad
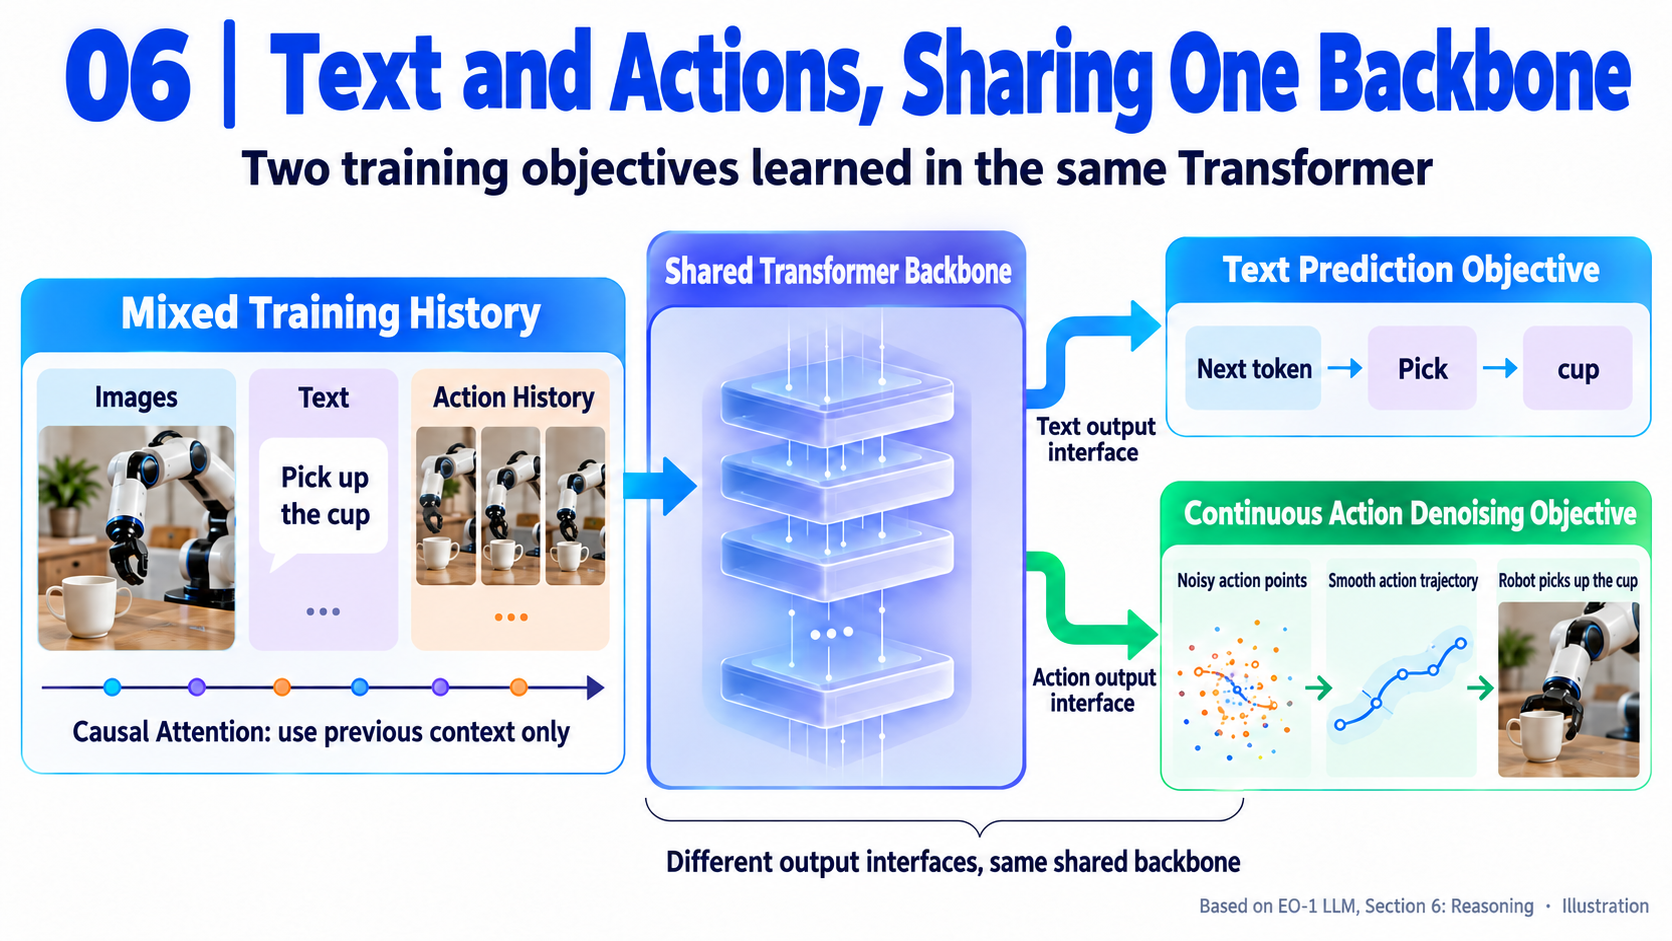
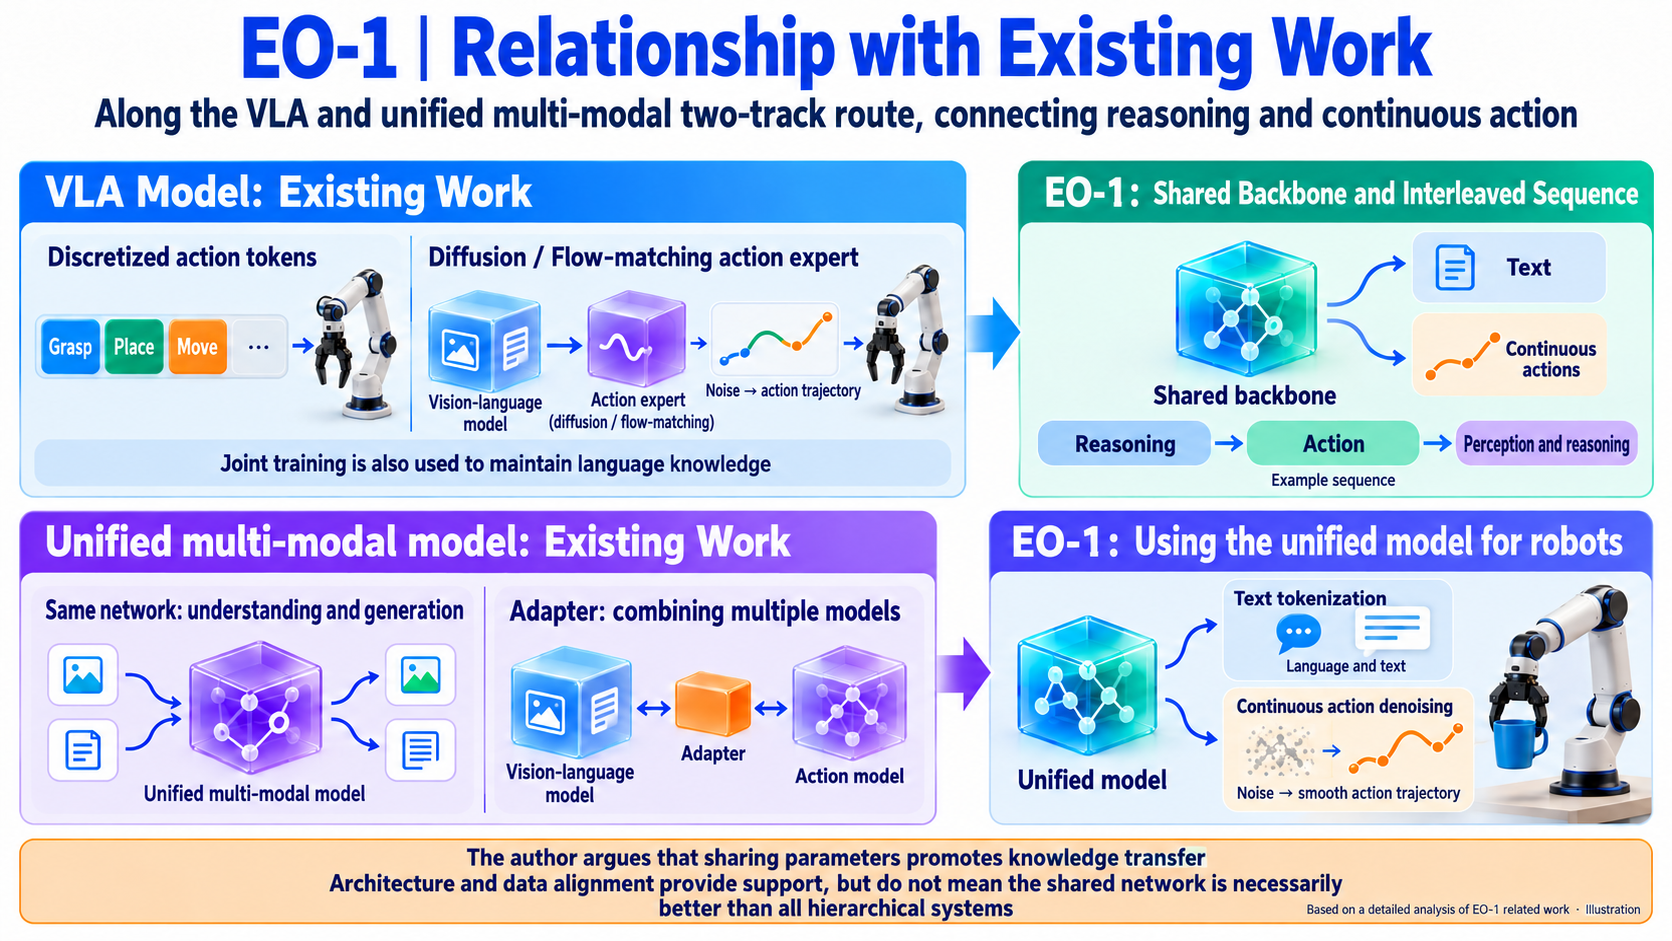
El texto aborda el qué y el por qué, mientras que las acciones especifican el movimiento. Ambos dependen de los mismos objetos, objetivos y progreso. EO-1 comparte un backbone preentrenado para reducir la separación entre planificación y control.
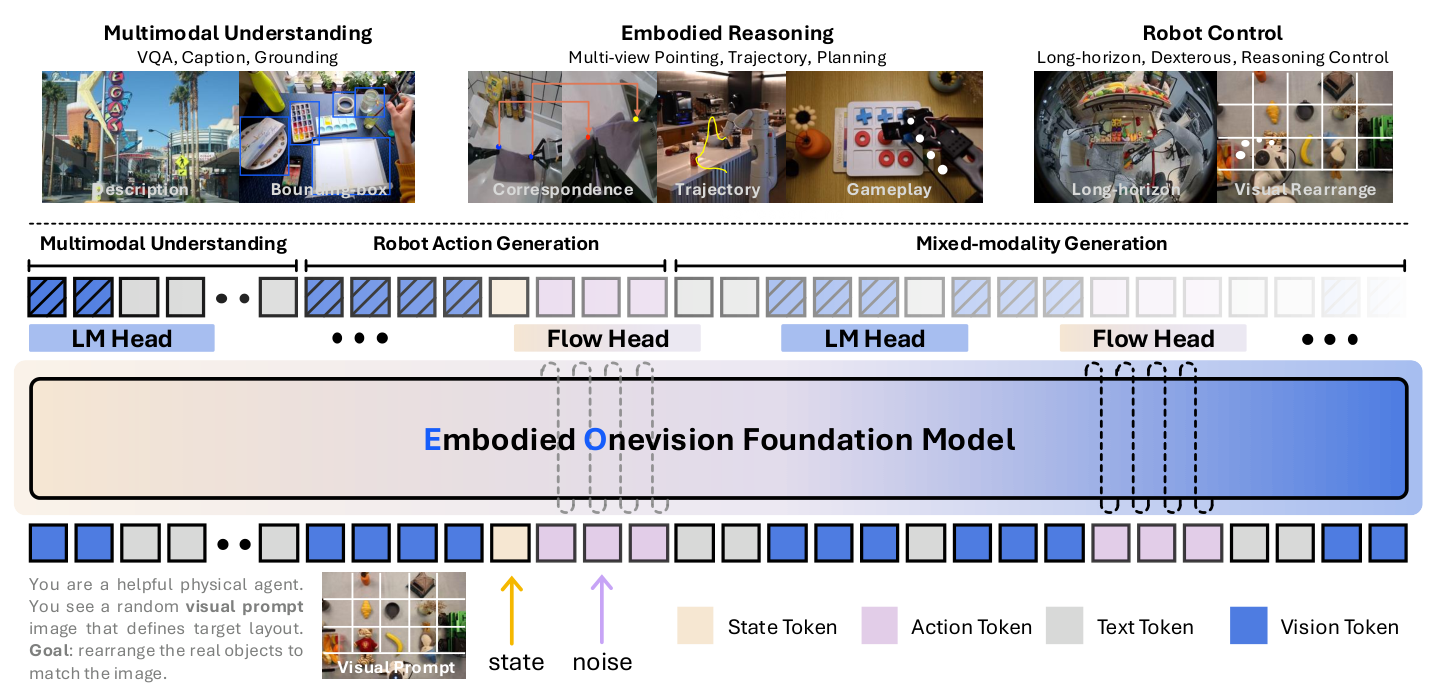
Artículo: Un Transformer solo-decodificador inicializado desde Qwen2.5-VL conserva el codificador visual para imágenes/vídeo y el tokenizer para texto. El estado y las acciones ruidosas se proyectan en el espacio de características compartido.
Los tokens son elementos de secuencia, no necesariamente palabras discretas. Los tokens visuales, de estado y de acción pueden ser vectores de características continuas.
| Entrada bruta | Codificación | Representación en el backbone |
|---|---|---|
| Imágenes multivista y fotogramas de vídeo | Codificador visual preentrenado | Secuencia visual de anchura D. |
| Instrucciones y razonamiento de preguntas y respuestas | Tokenizer y capa de embedding | Secuencia de texto de anchura D. |
Estado qₜ | Proyección de estado | Mapea las d_q dimensiones de estado a anchura D. |
Bloque ruidoso Xτ y progreso τ | Proyección de entrada de acción | Secuencia de acción de anchura D. |
D es la anchura del backbone y d_q la dimensión de estado de la plataforma. Las dimensiones de estado/acción y los conteos completos de tokens no se especifican de forma uniforme entre plataformas, por lo que se retienen los símbolos.
Las salidas se bifurcan en una cabeza LM, que predice tokens de texto, y una cabeza de flujo, que mapea características ocultas a actualizaciones continuas de acción. El bloque final es 16 × d_a, con dimensión de acción específica de la plataforma d_a.
Ejemplo de forma: Para una interfaz hipotética de 7D, la salida es 16 × 7, o 112 valores. Esta no es una configuración universal. Una proyección mapea la anchura D de vuelta a d_a; las anchuras no se suman directamente.
Precaución: “Sin parámetros adicionales específicos de acción” debe interpretarse como sin un backbone experto separado para acciones. Las proyecciones de estado/acción y las cabezas de salida siguen conteniendo parámetros.
Generar texto secuencialmente, denoising de acciones como bloque
La autoregresión predice el siguiente token de texto a partir del contexto existente:
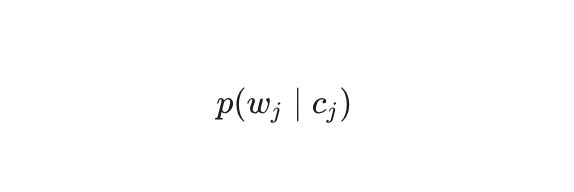
w_j es el token j, y c_j su contexto multimodal precedente. Ejemplo: después de “next, pick up”, el modelo predice “the tomato”, usando también las imágenes previas y el historial de acciones.
Las acciones usan flow matching: predicen repetidamente cómo actualizar un arreglo aleatorio hacia una trayectoria completa, en lugar de deletrear los controles como texto.
El entrenamiento mezcla acciones verdaderas y ruido gaussiano:
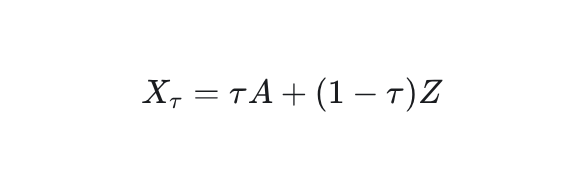
A y la gaussiana estándar Z tienen ambas forma 16 × d_a. τ∈[0,1] es el progreso interno de denoising, no segundos. Cero produce ruido, uno produce datos; el artículo muestrea de una distribución Beta que enfatiza las etapas más ruidosas.
Ejemplo mínimo: Para un elemento, A=0.6, Z=−0.2 y τ=0.5 dan Xτ=0.2: un valor intermedio en lugar de la respuesta completa.
Objetivo de entrenamiento, preservando la Ecuación (2):
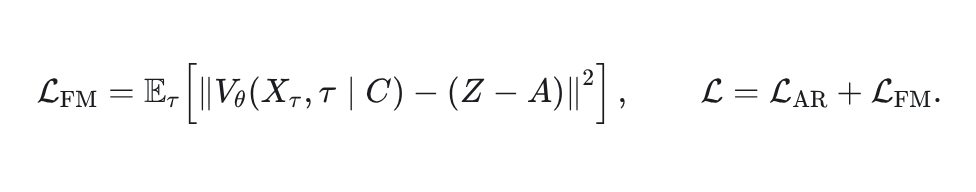
Vθ es el campo de actualización predicho por el modelo compartido y la cabeza de flujo, θ parámetros entrenables, y C el contexto multimodal precedente. La norma compara arreglos completos, y la esperanza promedia el progreso muestreado. L_AR es la entropía cruzada de texto; ambos términos tienen peso uno. El objetivo de acción escrito en el ejemplo es Z−A=−0.8.
Inferencia, preservando la Ecuación (1):
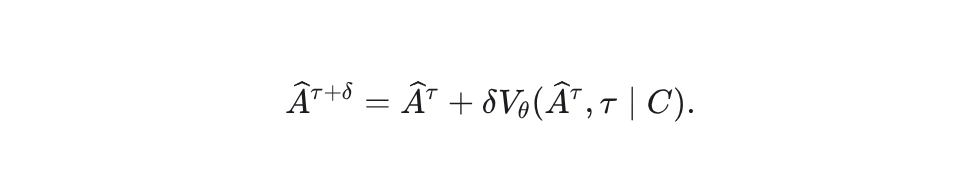
Âτ es la estimación inicializada desde ruido fresco; δ es un paso de integración. El texto integra de cero a uno y usa diez actualizaciones. Ilustración: diez actualizaciones iguales darían δ=0.1, un paso interno en lugar de un periodo de ejecución.
Precaución: las instrucciones escritas son inconsistentes. La derivada de la trayectoria lineal es A−Z, pero la Ecuación (2) usa Z−A y la Ecuación (1) una actualización positiva. Tomadas literalmente en conjunto, no se alinean: la dirección hacia adelante del ejemplo es 0.8 pero el objetivo escrito es −0.8. Se conservan las ecuaciones; la reproducción debe comprobar la convención de tiempo/signo de la implementación en lugar de concluir que el entrenamiento real es incorrecto.
Secuencias entrelazadas: razonar de nuevo después de actuar
Un ejemplo de acción estándar puede escribirse como:
Image → Task text → State → Action chunk
EO-1 también aprende esta estructura temporal:
Current image → Planning QA → State → Action chunk
→ New image → Completion QA → Next-step planning → Next chunk
Artículo: Cada modalidad tiene marcadores de límite, incluyendo [BOI]/[EOI] para imágenes, [BOR]/[EOR] para estado, y [BOA]/[EOA] para acciones. La atención causal se condiciona en el contexto precedente en lugar de en respuestas futuras.
Ejemplo: Después de intentar embolsar un tomate, una nueva imagen puede mostrarlo aún en la garra. El modelo puede juzgar que la colocación está incompleta y generar más acciones. Esto ilustra la estructura de retroalimentación, no una garantía de recuperación fiable.
EO-1 genera texto y acciones, no imágenes de cámara futuras ni estado futuro. El entorno proporciona nuevas observaciones. El entrelazado tampoco requiere una respuesta verbal antes de cada punto de control.
Muestreo rectificador entrelazado: historial limpio, acciones actuales ruidosas
Entrenar la acción actual requiere ruido, pero el texto posterior debe condicionarse en acciones completadas. Mantener las acciones pasadas ruidosas crea una desalineación con el historial ejecutado.
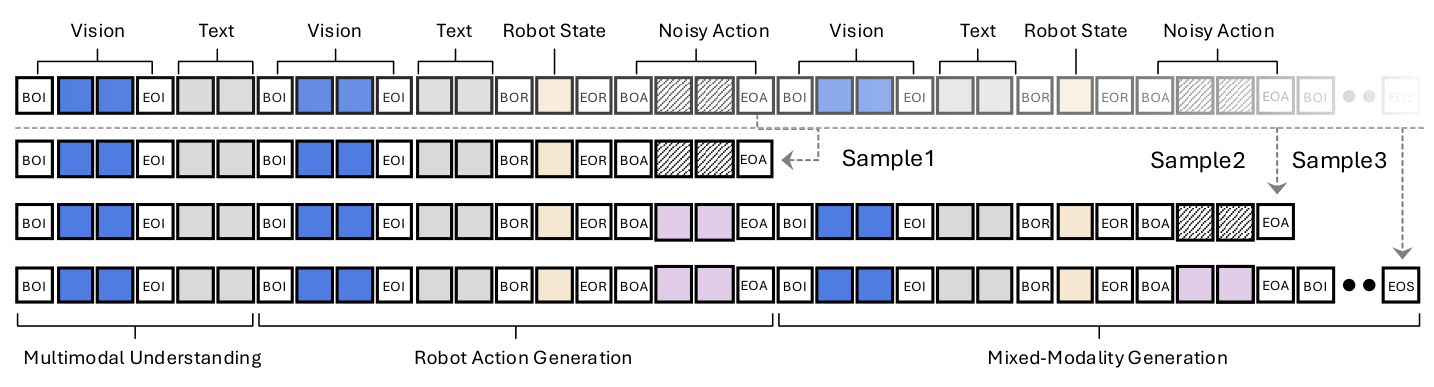
Artículo: El muestreo rectificador entrelazado divide una secuencia con N segmentos de acción en N+1 prefijos de entrenamiento en los límites de acción. Las acciones históricas están limpias; la acción que se está generando actualmente es ruidosa.
Ejemplo mínimo: Una secuencia con dos acciones:
Image₁ / Text₁ → Action₁ → Image₂ / Text₂ → Action₂ → Image₃ / Text₃
Para N=2, construya tres prefijos:
| Muestra | Contexto y objetivo |
|---|---|
| Muestra1 | Imagen₁ / Texto₁ → Acción₁ ruidosa; entrenar el denoising de acción₁. |
| Muestra2 | Imagen₁ / Texto₁ → Acción₁ limpia → Imagen₂ / Texto₂ → Acción₂ ruidosa; entrenar el texto subsiguiente y acción₂. |
| Muestra3 | Ambas acciones son historial limpio; aprender el texto₃ final. |
Las acciones reciben supervisión de denoising cuando se generan y aportan gradientes como contexto limpio para predicciones posteriores. El modelo aprende tanto la generación de acciones como el razonamiento a partir del historial de acciones.
Límites y coste: Reprocesar prefijos añade cómputo que no se mide por separado; no hay una ablación de eliminación aislada. El historial de entrenamiento limpio proviene de grabaciones, mientras que el historial de despliegue puede incluir errores del modelo. El muestreo rectificador no elimina esa desalineación y no es un ensamblado temporal tipo ACT ni un suavizado de acciones.
Entrenamiento e inferencia completos
Entrenamiento: fuentes de imagen-texto, registros de robots y ejemplos entrelazados → codificar modalidades → añadir ruido a las acciones actuales, mantener limpio el historial → backbone compartido → entropía cruzada de texto y pérdida de flujo → actualizaciones conjuntas. Las muestras solo de QA proporcionan supervisión de texto sin acciones inventadas.
Inferencia: imágenes, instrucción, estado e historial → generar el texto necesario → refinar nuevo ruido mediante diez actualizaciones en un bloque de 16 pasos → ejecutar → añadir nuevas observaciones al contexto. El caché KV reutiliza el cómputo de contexto; no sustituye la reobservación.
La implementación reporta cinco épocas de preentrenamiento, longitud media empaquetada 16,384 y tamaño de lote uno. La tasa de aprendizaje de proyección lenguaje/multimodal es 5×10⁻⁵, del codificador visual 1×10⁻⁵. Estos son ajustes experimentales, no óptimos universales.
EO-Data1.5M: material compartido para razonamiento y control
Tres grupos de datos
| Categoría | Escala de la Tabla 1 del texto principal | Supervisión |
|---|---|---|
| Web multimodal | 5.7M muestras, 7.1B tokens | QA de imágenes, comprensión de video, grounding y tareas relacionadas. |
| Control de robots | 1.2M trayectorias, 127.3B tokens | Operación continua en distintos robots. |
| Datos encarnados EO-Data1.5M | 1.5M muestras, 1B tokens | Razonamiento espacial, temporal, físico y de tareas más operación entrelazada. |
Precaución: Trayectorias, muestras de QA y tokens son unidades diferentes y no pueden sumarse como conteos de operación. EO-Data1.5M no es todo el corpus de entrenamiento, y las secuencias entrelazadas completas son solo un subconjunto.
Flujo de trabajo: preservar escenas diversas y luego añadir razonamiento
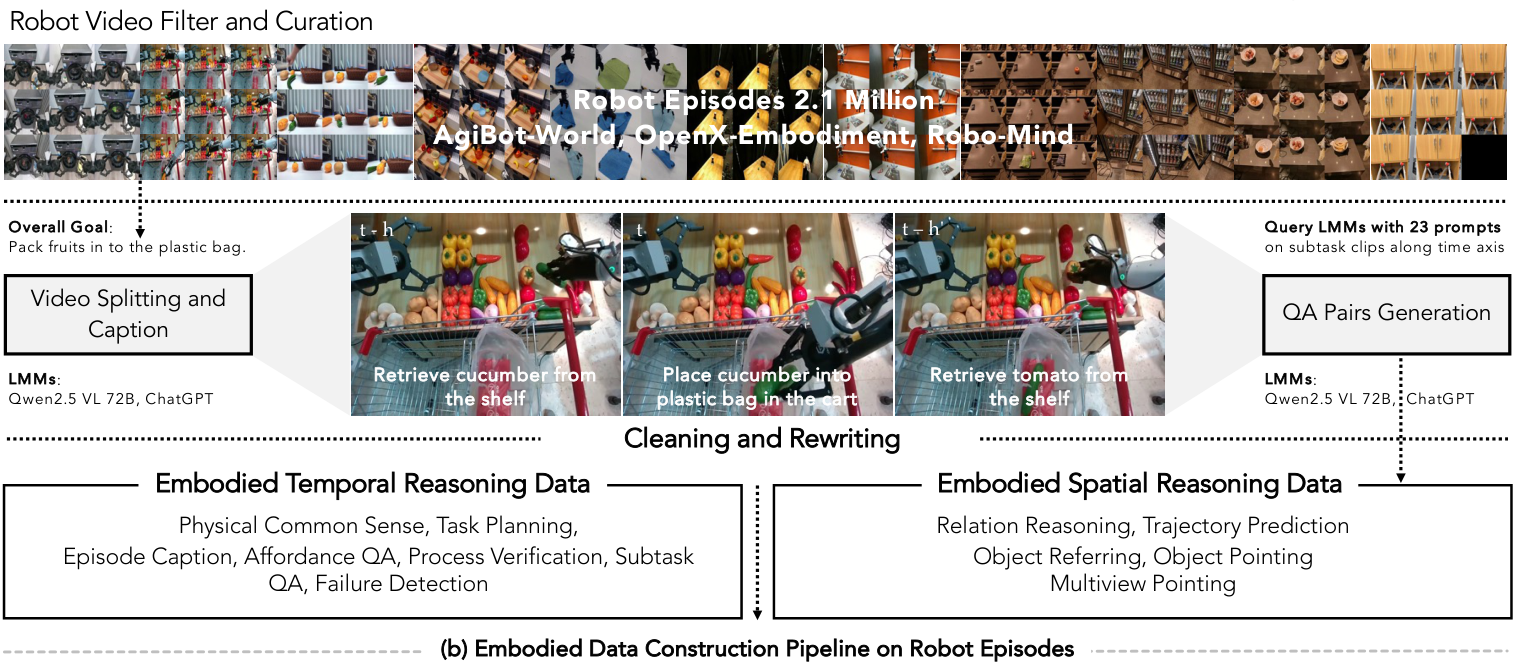
Artículo: Agrupar características visuales de video, muestrear por clúster e inspeccionar manualmente para reducir escenas repetidas. Segmentar videos en subtareas, crear descripciones de acciones con modelos y humanos, construir preguntas basadas en plantillas, generar respuestas candidatas, seleccionarlas o reescribirlas manualmente y luego limpiar reglas y redacción.
Las tareas temporales incluyen sentido común físico, planificación, descripciones de video, QA de affordance, verificación, QA de subtareas y detección de fallos. Las tareas espaciales incluyen relaciones, predicción de trayectorias, cajas delimitadoras, señalamiento y señalamiento multivista.
Explicación: Un registro de agarre puede responder qué agarrar, dónde aproximarse y si la colocación tuvo éxito. Estas anotaciones provienen de demostraciones, no de la exploración de cada acción posible.
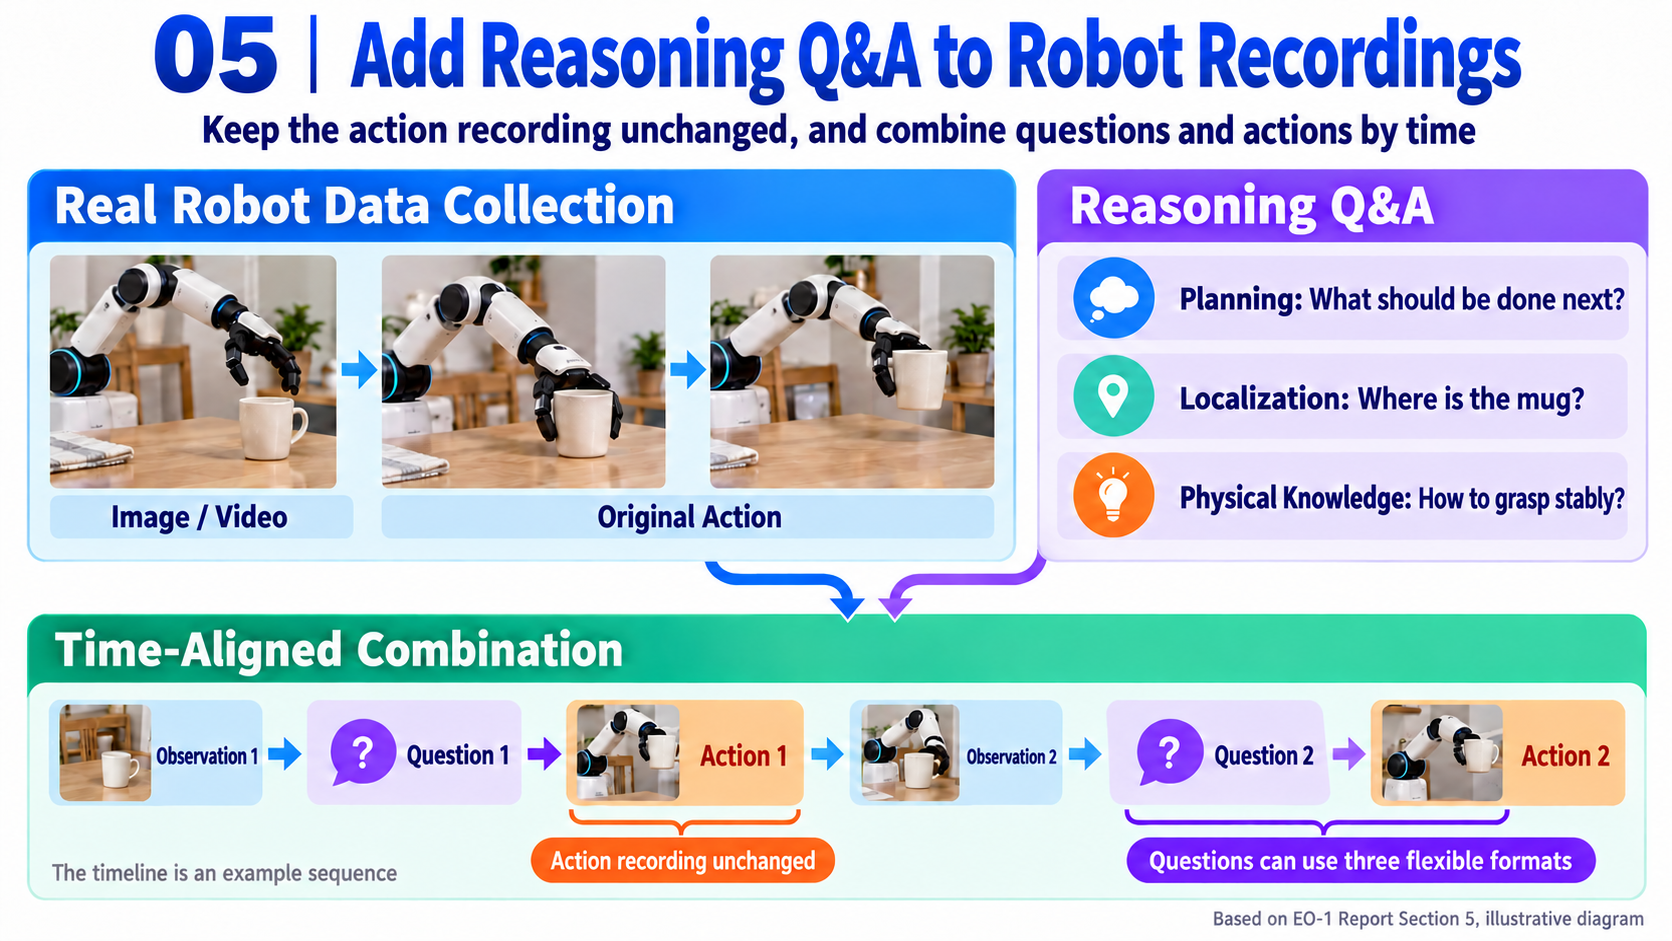
Cómo tres formatos entrelazados conectan preguntas-respuestas y acciones
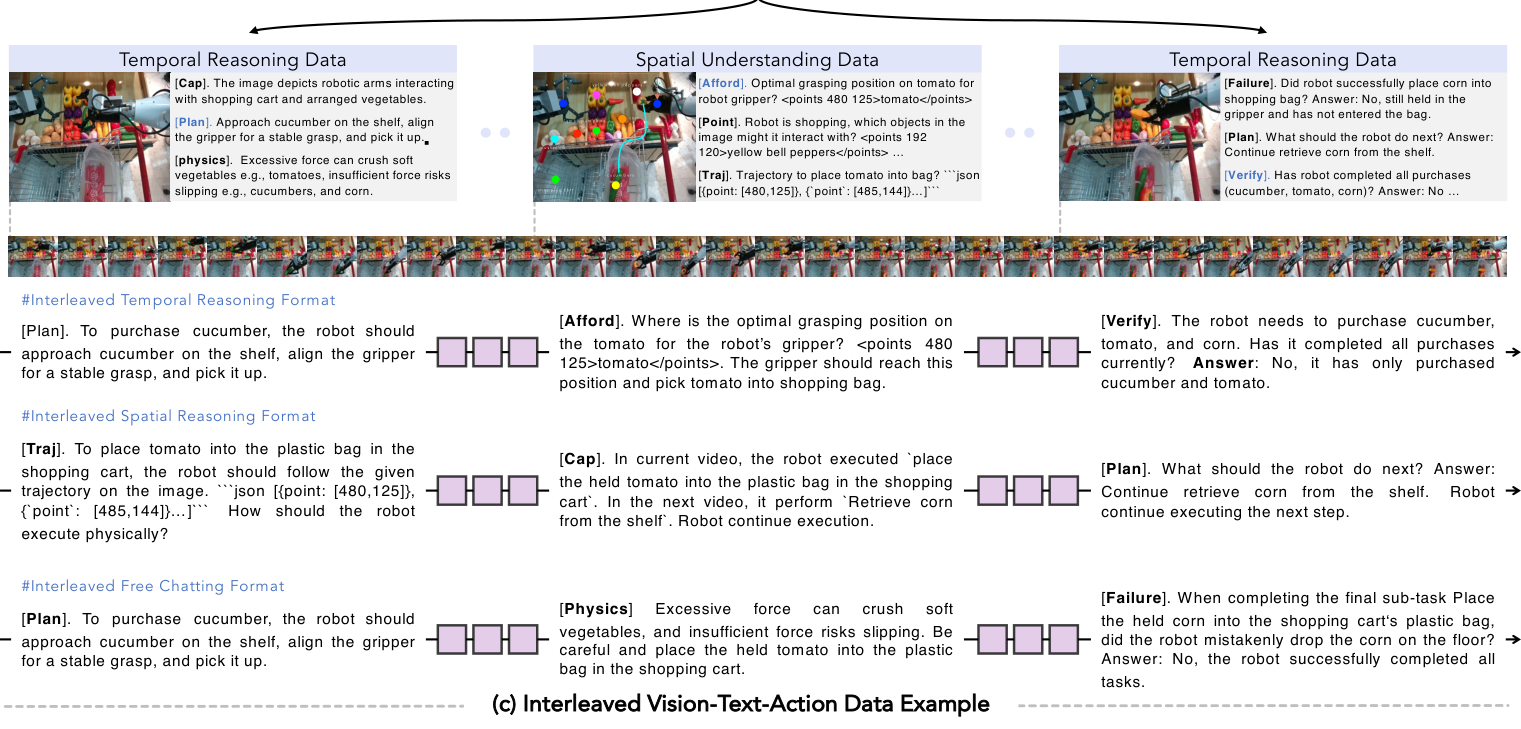
| Formato | Conexión | Enfoque de aprendizaje |
|---|---|---|
| Razonamiento temporal | Imagen → QA de la siguiente subtarea → insertar la respuesta en la instrucción → acción → nueva imagen y verificación. | Qué hacer y si está completo. |
| Razonamiento espacial | Imagen → QA de trayectoria → insertar la trayectoria en la instrucción → acción → nueva imagen y verificación. | Traducir objetivos espaciales en movimiento. |
| QA de forma libre | Imagen → otra QA de razonamiento → instrucción de tarea original → acción → verificación. | Conservar razonamientos variados dentro del contexto de control. |
Las trayectorias espaciales son coordenadas [x,y] en el plano de la imagen, no comandos de articulaciones. (480,125) → (485,144) describe una trayectoria en la imagen; la generación de acciones continuas sigue aprendiendo el movimiento real.
El texto reporta alrededor de 122,000 ejemplos entrelazados. Precaución: Los conteos difieren: la Tabla 1 da 5.7M muestras web, la Tabla 6 del Apéndice da 6.2M; la Figura 3(a) etiqueta comprensión espacial 376k, mientras que la Sección 3.2.1 indica 1.5M. Cada cifra se atribuye a su ubicación en lugar de fusionarse en un total no verificado.
Experimentos: evidencia para las afirmaciones
Evaluar razonamiento y control por separado
La pérdida de entrenamiento, las puntuaciones de QA, el éxito en simulación y la finalización de tareas reales miden capacidades diferentes y no pueden sustituirse entre sí.
| Evaluación | Resultado de EO-1 | Comparación e interpretación |
|---|---|---|
| RoboVQA, BLEU-4 | 58.5 | Qwen2.5-VL 3B: 55.9; coincidencia de texto con la respuesta de referencia. |
| ERQA, exactitud | 45.5% | Qwen2.5-VL 3B: 35.3%; Gemini 1.5 Flash: 46.3%. EO-1 no supera a todas las líneas base. |
| EO-Bench, espacial / temporal | 36.4 / 38.9 | Qwen2.5-VL 3B: 20.0 / 22.6; razonamiento de tareas mejorado con muchos errores restantes. |
| LIBERO, éxito medio | 98.2±0.3% | π0: 94.2±0.9%; OpenVLA-OFT: 97.1±0.6%. |
| SimplerEnv, WidowX / Google VM / Google VA | 72.7% / 76.5% / 63.0% | π0: 69.2% / 71.4% / 54.7%; ganancias de 3.5 / 5.1 / 8.3 puntos porcentuales. |
Fuente: Tablas 2–4, páginas 13–14. Los nombres y versiones de modelos siguen el artículo. Estas métricas no forman una única puntuación intercambiable de capacidad robótica.
Precaución: Los conteos de EO-Bench también entran en conflicto: la Sección 3.3 dice 648 preguntas, sus cuatro categorías suman 642, y 4.2 dice 700 distribuidas uniformemente. No se usan para inferir significancia ni conteos por categoría.
¿Qué se probó en robots reales?
Los 28 ajustes de tarea comprenden siete tareas de pick-and-place con Franka Panda, 13 pruebas out-of-the-box con WidowX 250 S, cuatro tareas de alta longitud de horizonte y destreza con AgiBot G-1 y cuatro tareas de razonamiento-control. SO100 también está involucrado.
Los modelos reciben vistas, estado e instrucciones y producen controles. Las configuraciones de datos de entrenamiento de la Tabla 6 del Apéndice incluyen vistas ego/izquierda/derecha de AgiBot a 30 FPS; izquierda/derecha/muñeca de DROID a 15 FPS; tercera persona/muñeca de SO100 a 30 FPS; y tercera persona/muñeca de IPEC-Franka a 10 FPS. Estos ajustes de origen no son conteos universales de cámaras de evaluación ni tasas de control.
El ajuste fino de horizonte largo usa 150 demostraciones por tarea durante 25 épocas, mezclando datos de subtareas y de tareas completas en una proporción de 9:1, y luego realiza diez evaluaciones por tarea. Se reportan alrededor de 500k fotogramas y ocho pasos por conjunto, no una duración de tarea uniforme.
Precaución: Las puntuaciones de horizonte largo promedian la finalización bajo instrucciones de subtareas; no son éxitos autónomos de tareas completas a partir de una única instrucción global. “Out of the box” tampoco implica que la encarnación haya estado ausente del preentrenamiento.
¿El razonamiento mejora las acciones?
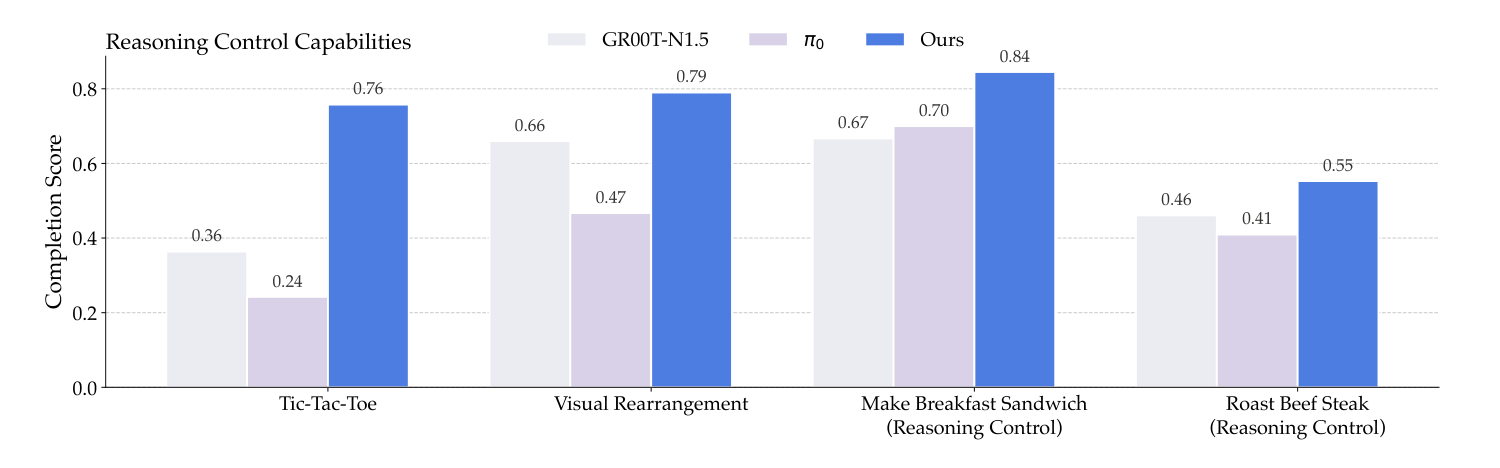
EO-1 obtiene puntuaciones de 0.76, 0.79, 0.84, 0.55 en tres en raya, reordenamiento con referencia de imagen, preparación de sándwiches y cocción de bistec. Las líneas base de tres en raya son π0 con 0.24 y GR00T-N1.5 con 0.36, lo que respalda una mejor integración del juicio sobre el tablero y la colocación en este entorno.
Estas tareas usan datos especializados y ajuste fino: 800 demostraciones de reordenamiento y 450 muestras de tres en raya. Las líneas base combinan un planificador externo GPT-4o con controladores, mientras que EO-1 usa un decodificador unificado. Los resultados respaldan el enfoque de sistema/entrenamiento completo, no un componente aislado ni el aprendizaje de nuevas tareas en modo zero-shot.
Generalización y el papel de los datos
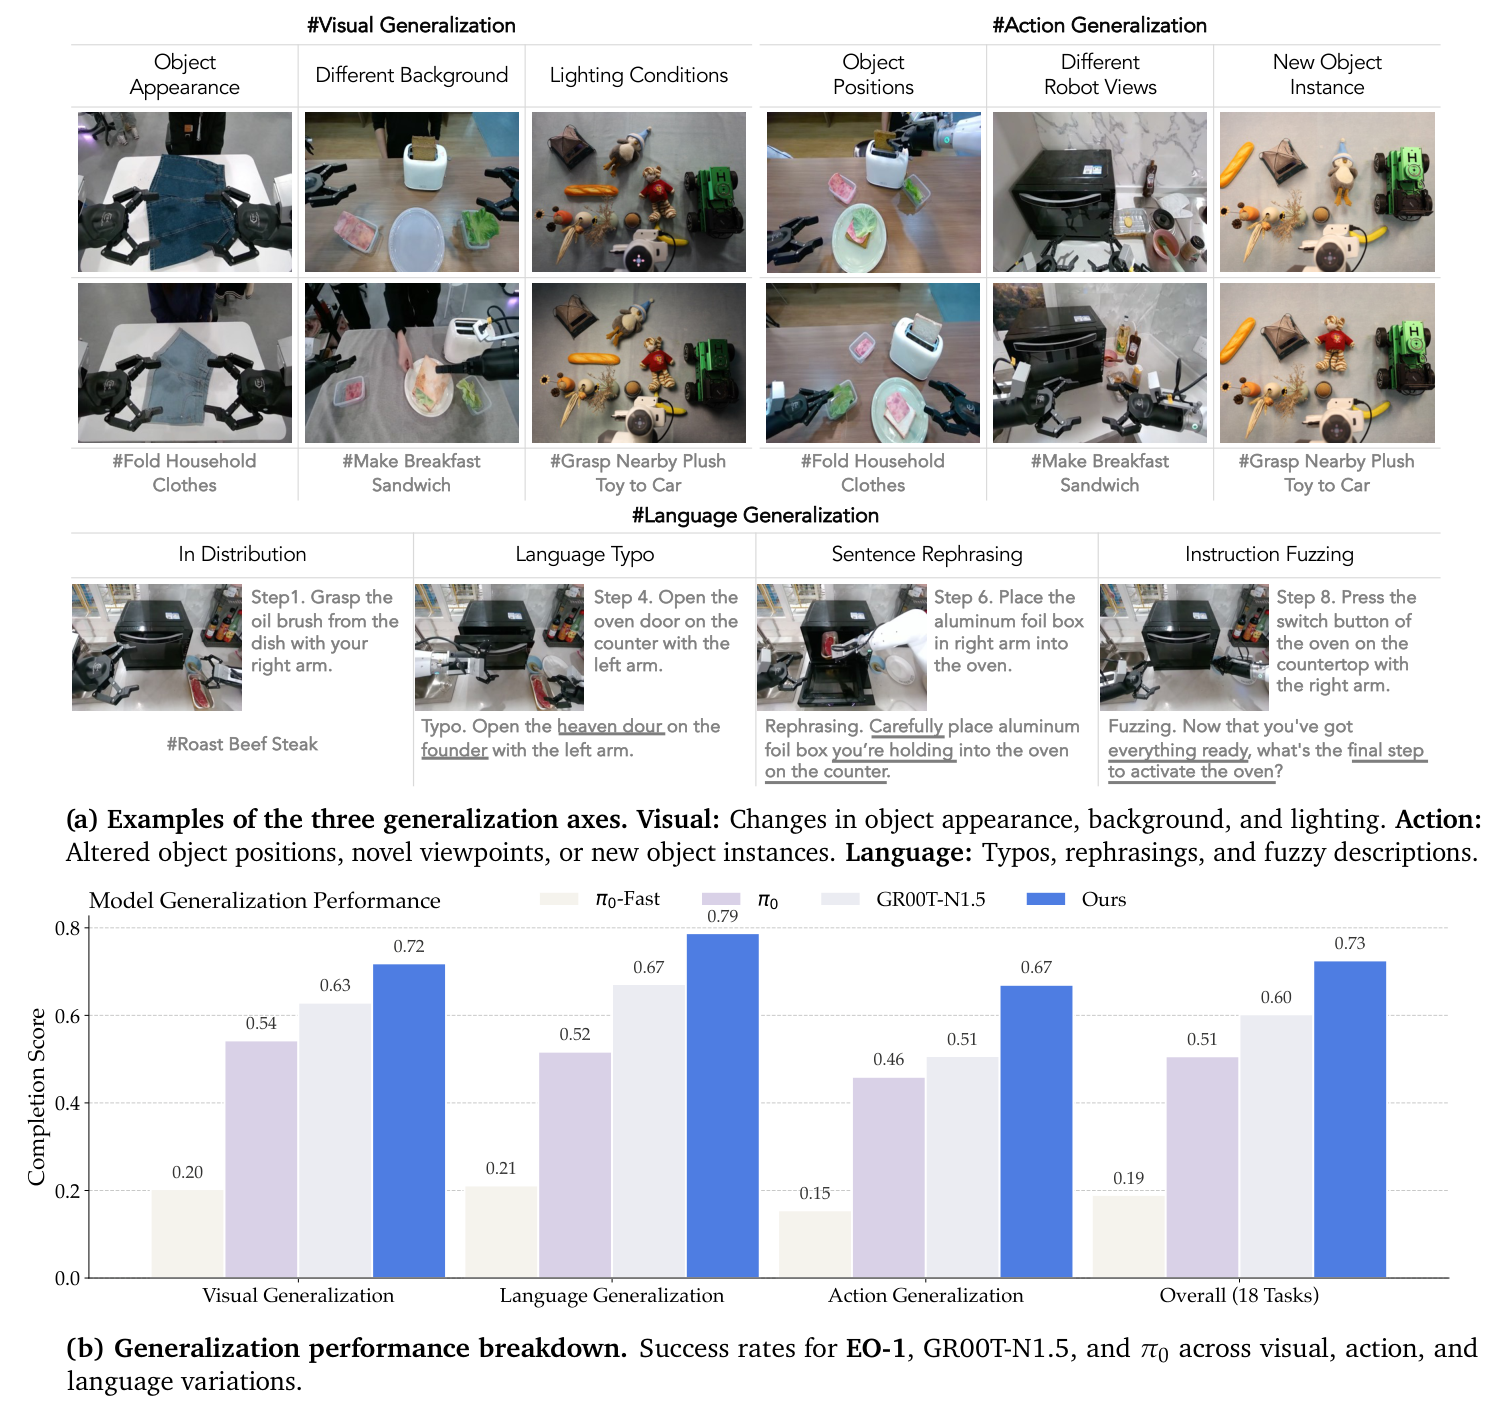
Las puntuaciones de finalización bajo variaciones visuales, de lenguaje y de acción son 0.72, 0.79, 0.67, con un total general de 0.73. Las variaciones de acción cambian principalmente las posiciones de los objetos, los puntos de vista del robot y las instancias de objetos, no habilidades arbitrarias no vistas. El texto y las figuras discrepan sobre los totales de tareas, por lo que los “18 Tasks” de la Figura 9 no se tratan como un recuento de ensayos para todo el artículo.
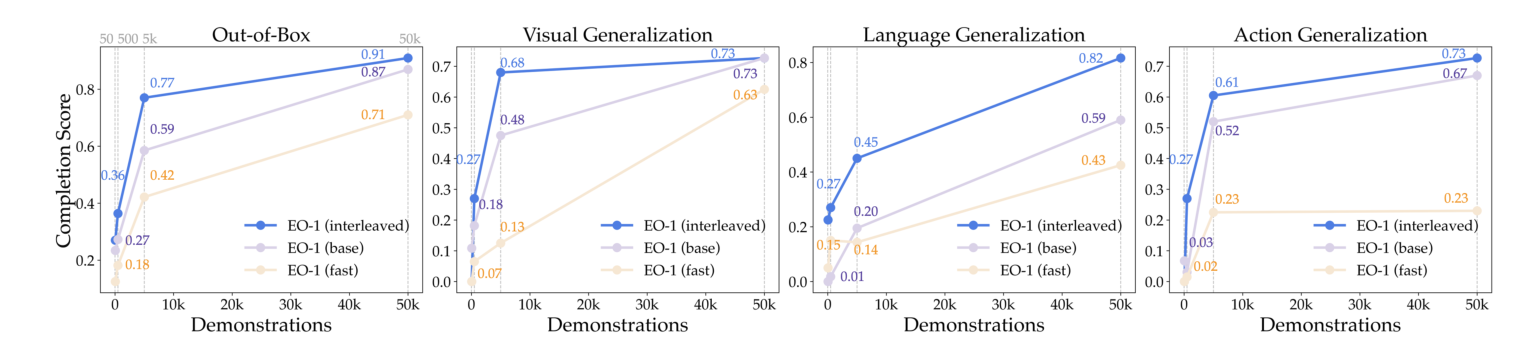
Se comparan cuatro configuraciones: fast, acciones FAST totalmente autoregresivas; base, una columna vertebral compartida con flow matching continuo entrenada solo con datos de control; llava, añadiendo instrucciones genéricas de imagen-texto; e interleaved, añadiendo datos intercalados relevantes.
La Tabla 5 proporciona dos observaciones clave:
-
La generación continua ayuda: LIBERO
basealcanza un 98.2% frente afastcon 88.0%. Esto respalda la decodificación híbrida en este entorno, no la inferioridad universal de las acciones discretas. -
La relevancia importa más que simplemente añadir modalidades: La finalización global de WidowX sube de
base0.71ainterleaved0.80, mientras quellavacon datos genéricos obtiene0.34. La alineación con la tarea importa; los datos web no son universalmente perjudiciales.
Las ganancias tienen límites: las puntuaciones de generalización de acciones de sándwich en AgiBot se mantienen en 0.75 tanto para base como para interleaved. Las etiquetas intercaladas no aportan automáticamente diversidad de movimiento ausente en las demostraciones.
Interpretar la conclusión
Conclusión respaldada: En estos entornos, una columna vertebral compartida con datos corporizados intercalados mejora el razonamiento relevante para la tarea y el control continuo. Proporciona una interfaz entrenable para el razonamiento antes de las acciones y la reevaluación después.
Mantén tres límites:
-
Unificado no significa totalmente fiable. Las tareas complejas como la cocción de bistec siguen siendo débiles, EO-Bench está lejos de ser perfecto, y la navegación, la evitación, el análisis de fallos y la colaboración siguen siendo direcciones futuras.
-
El razonamiento y el movimiento no son concurrentes de forma arbitraria. Las arquitecturas eficientes y la inferencia asíncrona siguen siendo trabajo futuro. El intercalado expresa dependencias temporales, no un pensamiento y acción simultáneos de tipo humano.
-
La reproducción necesita detalles de implementación. Los recuentos y los signos de flujo entran en conflicto, y las dimensiones de estado/acción y los calendarios de ejecución no pueden inferirse a partir de diagramas. Se reportan alrededor de 6 GB de memoria de inferencia en una RTX 4090, sin mediciones universales de latencia o frecuencia de control, por lo que la ejecución en tiempo real en cualquier plataforma no está garantizada.
Explicación: EO-1 ofrece una vía para aprender el juicio semántico y el control conjuntamente. La red compartida maneja información conjunta, los datos intercalados aportan relaciones temporales y el muestreo rectificador distingue las acciones históricas del desruido actual. Los resultados prácticos aún dependen de la cobertura de las demostraciones, las tareas y los sistemas de ejecución.