Evo-1: Cómo los modelos VLA ligeros preservan la alineación semántica
Evo-1: Modelo ligero de Visión-Lenguaje-Acción con alineación semántica preservada
- VLA ligero
- Alineación semántica
- Cross-attention
- Entrenamiento en dos etapas
Requisitos previos: De instrucciones a acciones
¿Qué aprende un VLA?
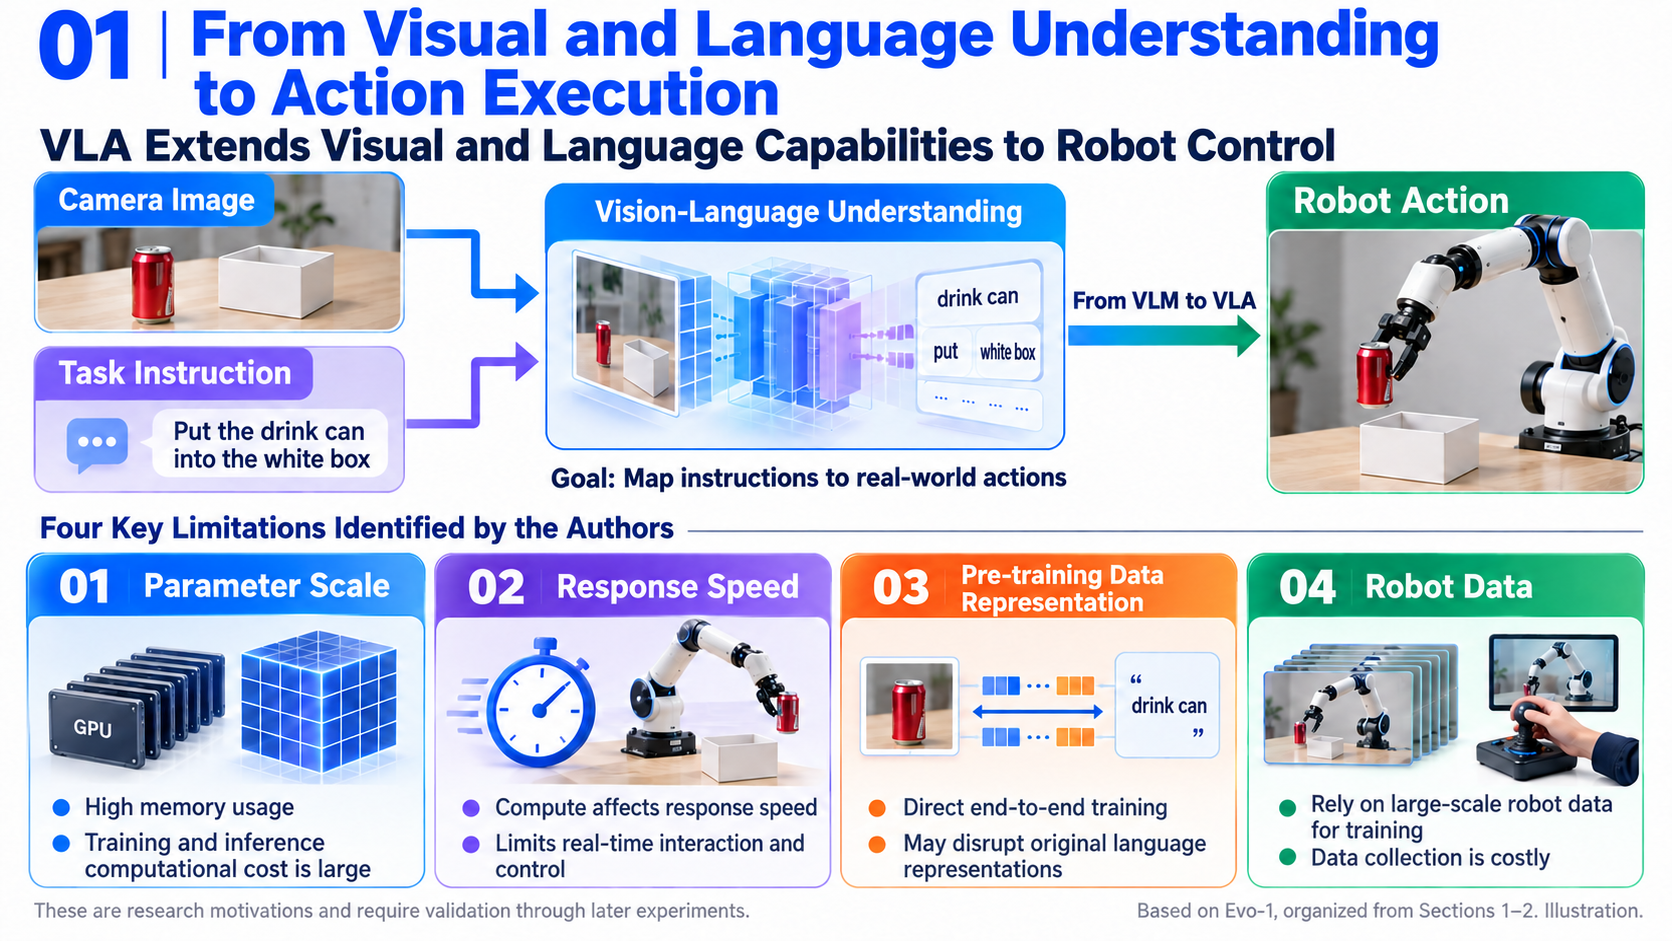
Explicación: El aprendizaje por imitación enseña al robot cómo moverse en una situación demostrada. Un modelo de visión-lenguaje-acción añade texto de tarea, aprendiendo acciones de control condicionadas tanto por imágenes como por instrucciones.
Para la tarea del paper “poner la lata de bebida en la caja blanca”, la teleoperación proporciona imágenes de cámara, configuraciones del robot y acciones correspondientes. El modelo aprende su relación con el texto de la tarea. En despliegue, las imágenes actuales, una instrucción y el estado producen acciones futuras, en lugar de solo una instrucción verbal para recoger la lata.
| Concepto | Significado | Ejemplo en Evo-1 |
|---|---|---|
| Observación | Información usada para evaluar el entorno | Imágenes RGB multivista; el xArm6 real usa cámaras fijas y de muñeca. |
| Estado propioceptivo | Descripción numérica del propio robot | Ángulos articulares absolutos en el dataset de robot real. |
| Acción | Comandos numéricos para la interfaz de control | Registrados como ángulos articulares absolutos en el sistema real; otras plataformas usan sus propias interfaces de acción. |
| Modelo de visión-lenguaje (VLM) | Convierte imágenes y texto en características procesadas conjuntamente | El backbone InternVL3-1B. |
| Alineación semántica | Preservar la correspondencia entre el contenido de la imagen y el significado del lenguaje | “Lata de bebida” debería relacionarse con la lata visible en lugar de con el fondo irrelevante. |
Precaución: Preservar la alineación es un objetivo de diseño respaldado por visualizaciones de atención y resultados de tareas. No es una evaluación exhaustiva de todo el conocimiento lingüístico.
Acciones de un solo paso y chunks
La predicción de un solo paso produce solo la acción actual. El agrupamiento de acciones (chunking) predice varias acciones futuras conjuntamente. El horizonte predeterminado de Evo-1 es de 50 pasos.
Single-step: current images, instruction, state → aₜ
Action chunking: current images, instruction, state → [aₜ, aₜ₊₁, …, aₜ₊₄₉]
Ejemplo ilustrativo: Para una articulación, tres ángulos objetivo podrían ser [0.10, 0.12, 0.15] radianes. La predicción de un solo paso los produce por separado; el chunking predice la secuencia en conjunto. Las salidas reales de Evo-1 son chunks multidimensionales de 50 pasos.
Los chunks modelan trayectorias continuas, pero el entorno puede cambiar durante la ejecución. El paper no especifica completamente cuántos pasos se ejecutan antes de volver a observar, la mezcla de solapamientos o la replanificación en cada plataforma. Por lo tanto, predecir 50 pasos no implica ejecutar los 50 en lazo abierto, y la longitud del chunk no determina la frecuencia de control final.
Distinguir tres etapas
| Etapa | Entradas y operaciones | Resultado o criterio |
|---|---|---|
| Entrenamiento | Imágenes de demostración, instrucciones, estados y acciones; se añade ruido a las acciones para aprender una dirección de generación. | Parámetros del modelo; la pérdida mide el error de predicción de la dirección. |
| Inferencia | Imágenes actuales, instrucción, estado y un nuevo chunk de acción ruidoso muestreado. | Generar acciones futuras continuas para su ejecución. |
| Evaluación | Ejecutar bajo tareas y condiciones iniciales especificadas. | Éxito en la tarea, más mediciones de VRAM y tasa de inferencia en una GPU especificada. |
Una pérdida de entrenamiento baja no implica directamente un alto éxito en tareas reales. El mecanismo de entrenamiento y la evidencia de evaluación se analizan por separado más abajo.
Resumen: traducción y comentarios
Traducción
Los VLA unifican percepción, lenguaje y control, permitiendo tareas diversas mediante comprensión multimodal. Sin embargo, muchos tienen un gran número de parámetros y dependen en gran medida del preentrenamiento con datos de robots a gran escala, lo que incrementa los costes de entrenamiento y limita el despliegue en tiempo real. Algunos enfoques de entrenamiento también pueden debilitar las representaciones perceptivas del backbone, llevando al sobreajuste y a una mala generalización en tareas posteriores.
Evo-1 es un VLA ligero que mejora la eficiencia de despliegue sin preentrenamiento con datos de robots. Se basa en un VLM nativamente multimodal con un Transformer de difusión cross-modulated y un módulo de integración optimizado. Un proceso de entrenamiento en dos etapas alinea progresivamente las acciones con la percepción mientras conserva representaciones útiles del VLM.
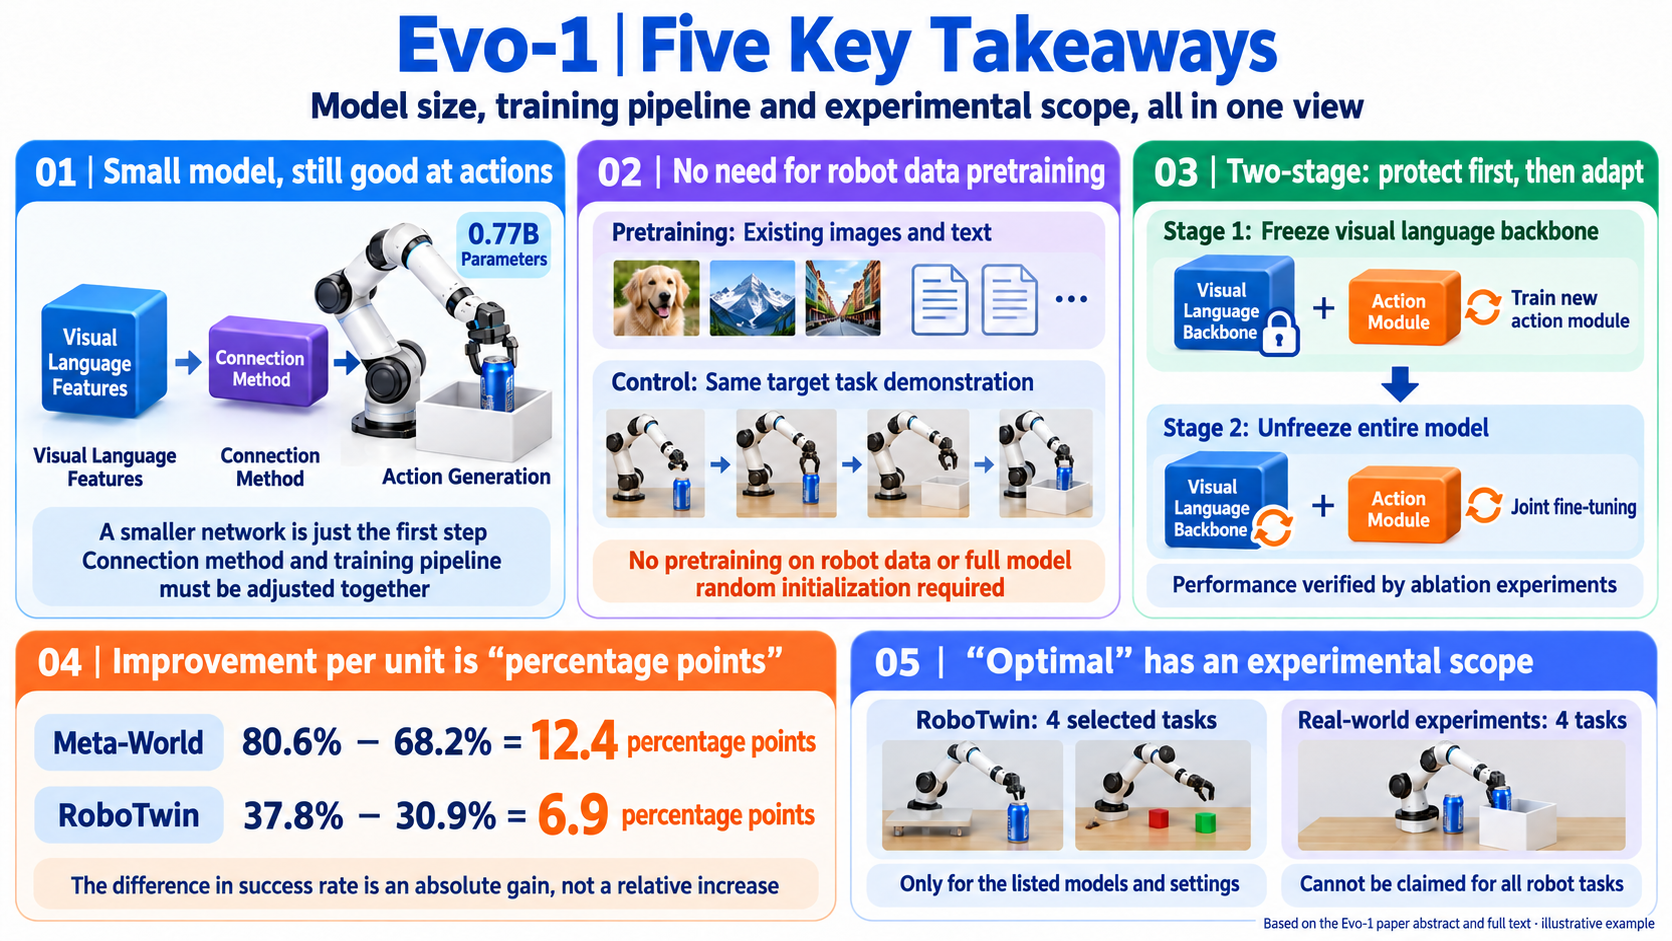
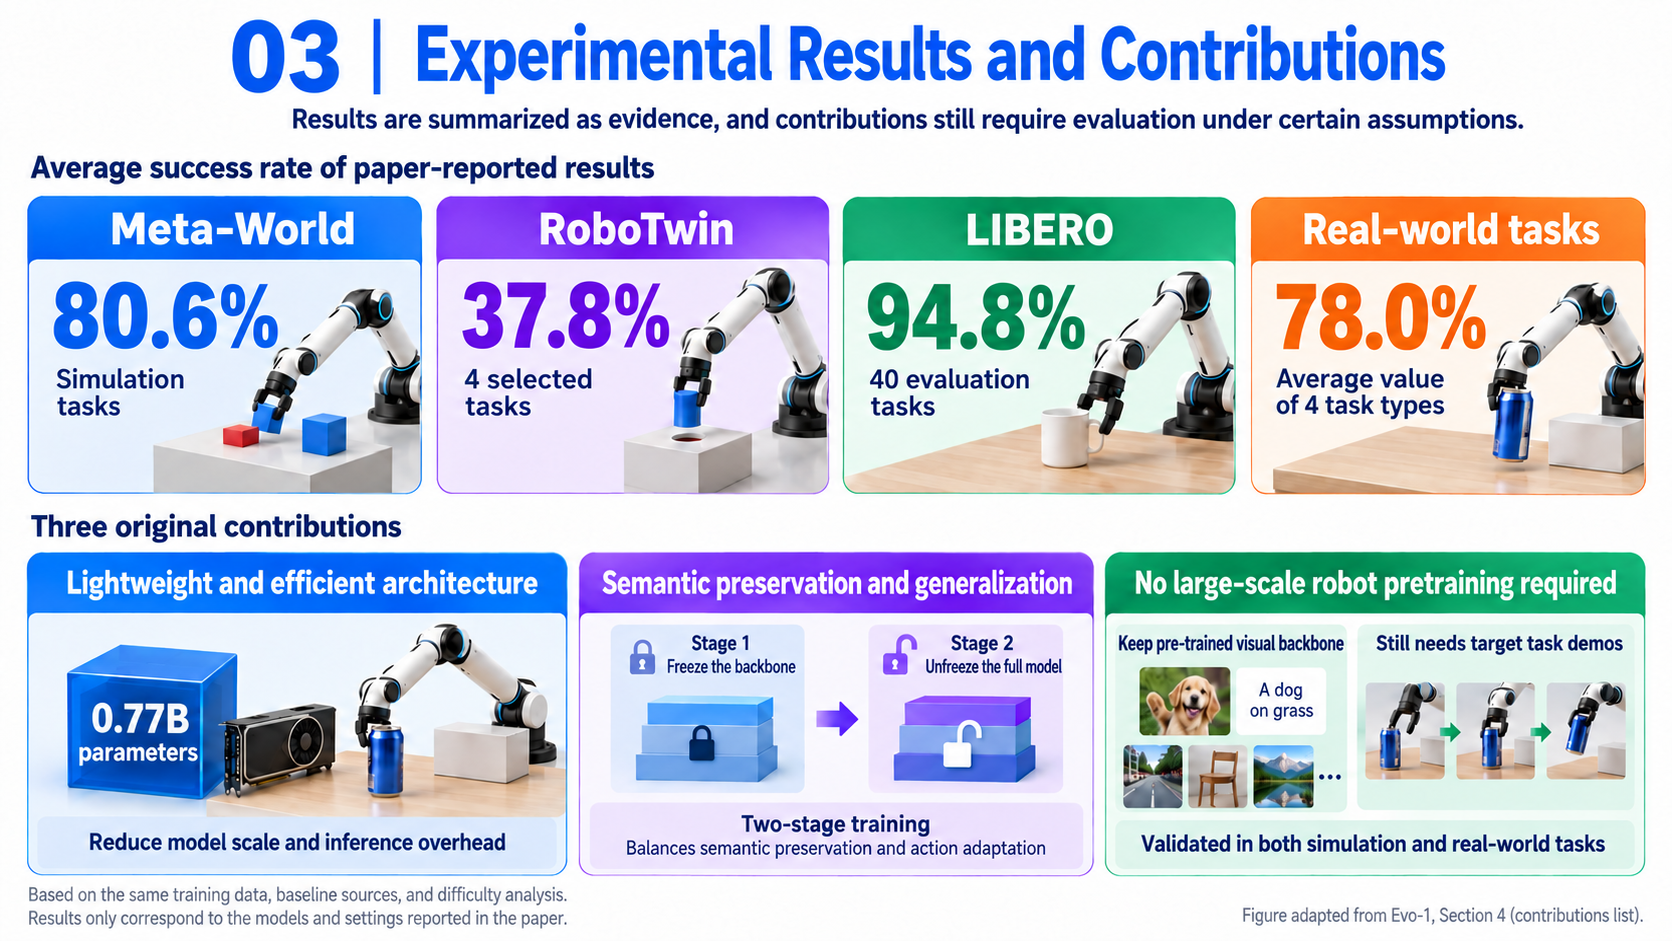
Con 770 millones de parámetros, Evo-1 reporta resultados de última generación en el momento de la publicación en Meta-World y RoboTwin, superando los mejores resultados comparados en 12.4 y 6.9 puntos porcentuales, y un competitivo 94.8% en LIBERO. La evaluación en el mundo real reporta un 78% de éxito medio con inferencia rápida y bajo uso de memoria, superando a las líneas base comparadas. Se publican el código, los datos y los pesos.
Comentarios
Introducción y trabajos relacionados: ¿Por qué cambiar la arquitectura y el entrenamiento?
Los cuatro párrafos principales de la introducción
Relación con trabajos anteriores
-
VLAs a gran escala: OpenVLA modela acciones discretas, π0 usa un experto de acciones continuas y Hi-Robot explora el razonamiento jerárquico. Estos enfoques suelen usar backbones con miles de millones de parámetros. Evo-1 en cambio comprime el backbone de visión-lenguaje y usa un diseño de integración y entrenamiento distinto para las acciones posteriores.
-
VLAs ligeros y eficientes: TinyVLA combina un VLM pequeño con un decodificador de acciones por difusión. SmolVLA usa un experto compacto de flow-matching, reducción de capas, reducción de tokens e inferencia asíncrona. Evo-1 persigue objetivos de eficiencia similares con InternVL3, cross-attention apilada y una secuencia de entrenamiento de congelar y luego descongelar.
Precaución: Estos son los dos grupos de trabajos relacionados del paper original. No establecen que cada modelo grande requiera preentrenamiento con robots ni que los diseños compactos ganen en cada tarea.
Método central: contexto estable para acciones continuas
Arquitectura, entradas y salidas
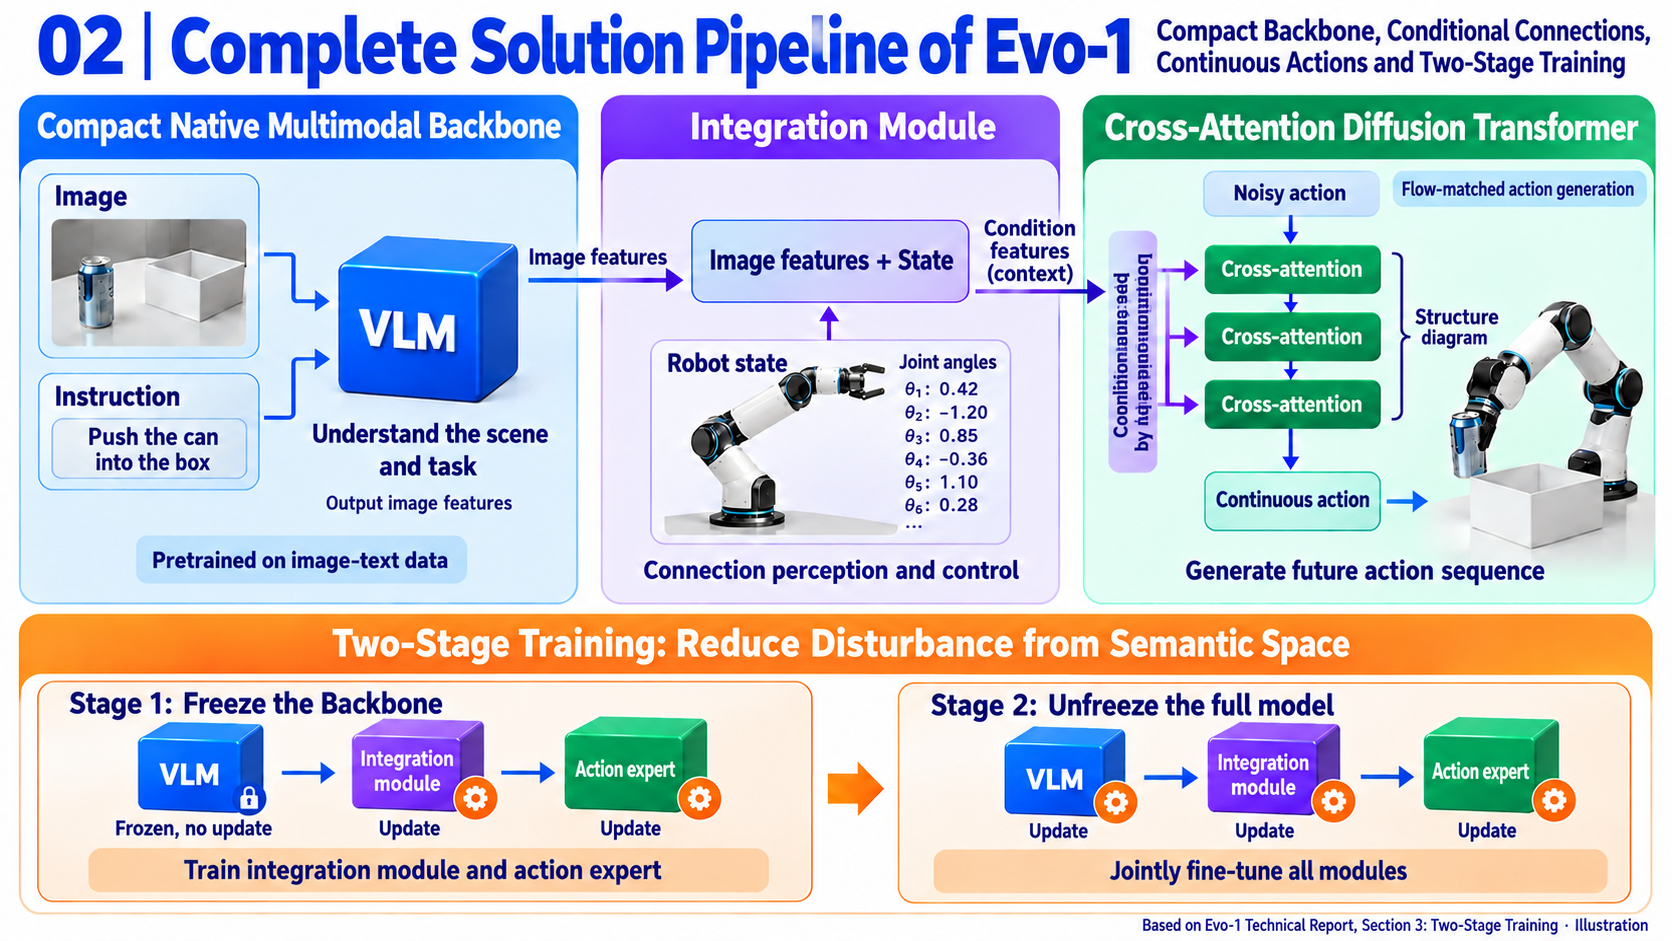
El modelo codifica lo que ve y lo que debería hacer, combina esto con el estado actual del robot y genera acciones futuras a partir de ruido.
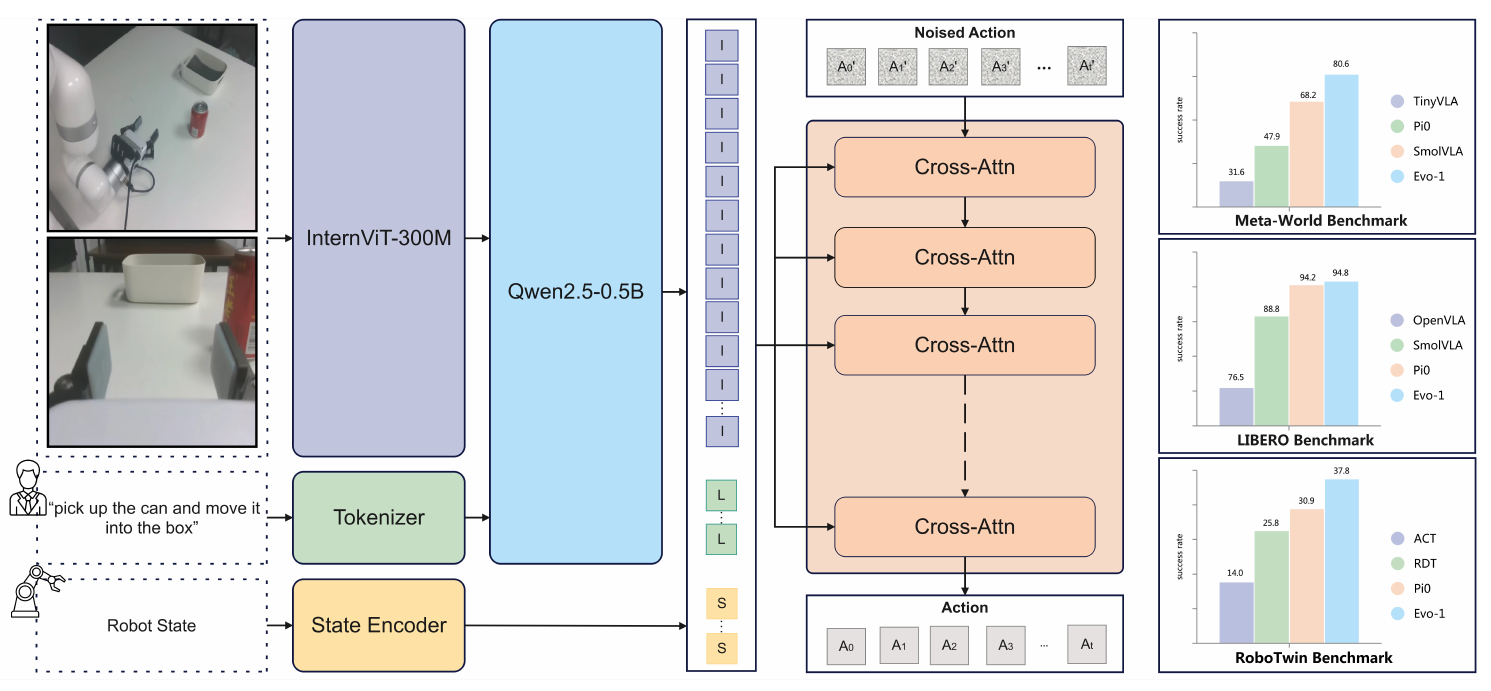
Paper: Los tres componentes son el backbone VLM, el módulo de integración y el Transformer de difusión cross-modulated. El modelo completo tiene 0.77B parámetros; no añadas el “1B” del nombre InternVL3-1B al total después del truncado.
| Ruta | Entrada en bruto | Codificación y procesamiento | Salida o función |
|---|---|---|---|
| Visión | N vistas RGB actuales | Redimensionar cada una a 448 × 448 × 3; extraer características InternViT-300M; el pixel-unshuffle reduce el número de tokens visuales a un cuarto. | Las incrustaciones visuales entran en la secuencia imagen-texto. |
| Lenguaje | Instrucción en lenguaje natural | Tokenizar y procesar con las primeras 14 capas de la rama Qwen2.5-0.5B. | Características imagen-texto fusionadas en la capa 14. |
| Estado | Propiocepción del robot | Rellenar hasta 24 dimensiones por defecto; la Figura 1 incluye un codificador de estado. | Contexto de condicionamiento para el experto de acción. |
| Acción | Chunk de acción futura ruidosa | Forma predeterminada 50 × 24; procesado por un Transformer experto de ocho capas. | Actualizaciones de generación con la misma forma y finalmente un chunk de acción continua. |
N es el número de cámaras y varía según la plataforma; el xArm6 real usa dos. Los tokens son elementos de secuencia; los tokens visuales son características continuas, no palabras. Reducir el número de tokens mediante pixel-unshuffle no significa reducir el ancho y la altura de la imagen cada uno a un cuarto.
Artículo: InternVL3 aprende conjuntamente representaciones de imagen-texto y de texto durante el preentrenamiento multimodal nativo. InternViT-300M se destila a partir de InternViT-6B. Las incrustaciones visuales reemplazan los marcadores de posición <img> designados antes del procesamiento conjunto con texto en un decodificador compartido. Evo-1 lee las características de la capa 14 y elimina las capas de lenguaje posteriores.
Formas ilustrativas: Un bloque de acción contiene 50 × 24 = 1,200 números; un lote de 16 tiene forma 16 × 50 × 24. La interfaz de 24 dimensiones incluye relleno y no significa que xArm6 tenga 24 articulaciones. Interpreta las dimensiones efectivas y las unidades según la interfaz de datos de cada plataforma.
Precaución: El artículo no especifica completamente el número de tokens visuales, el ancho oculto de imagen-texto, el ancho oculto del experto de acción ni los detalles de codificación del estado. Estos límites de implementación se mantienen sin inferir valores a partir de los nombres de los componentes. El codificador de estado de la Figura 1 no debe omitirse alegando que un vector bruto de 24D se suma directamente a todas las características de imagen-texto.
Integración: Leer el mismo contexto en cada capa
Problema: Las características de imagen-texto describen la escena y la tarea, mientras que el estado describe la configuración actual. La generación de acciones debe mantener acceso a estas condiciones para seguir dirigida por la tarea.
Intuición: Tratar las características multimodales y el estado como una fuente de información compartida que cada capa de acción lee usando su representación de acción actual. El diseño final es atención cruzada en capas intermedias, Módulo A en el artículo.
En la atención cruzada, la consulta Q representa lo que una acción necesita saber; las claves K coinciden con esa consulta y los valores V proporcionan el contenido recuperado. Artículo: concatenar las características de imagen-texto de la capa 14 y el estado como K y V, con representaciones de acción ruidosas como Q. Todas las capas de acción leen la misma fuente de condicionamiento.
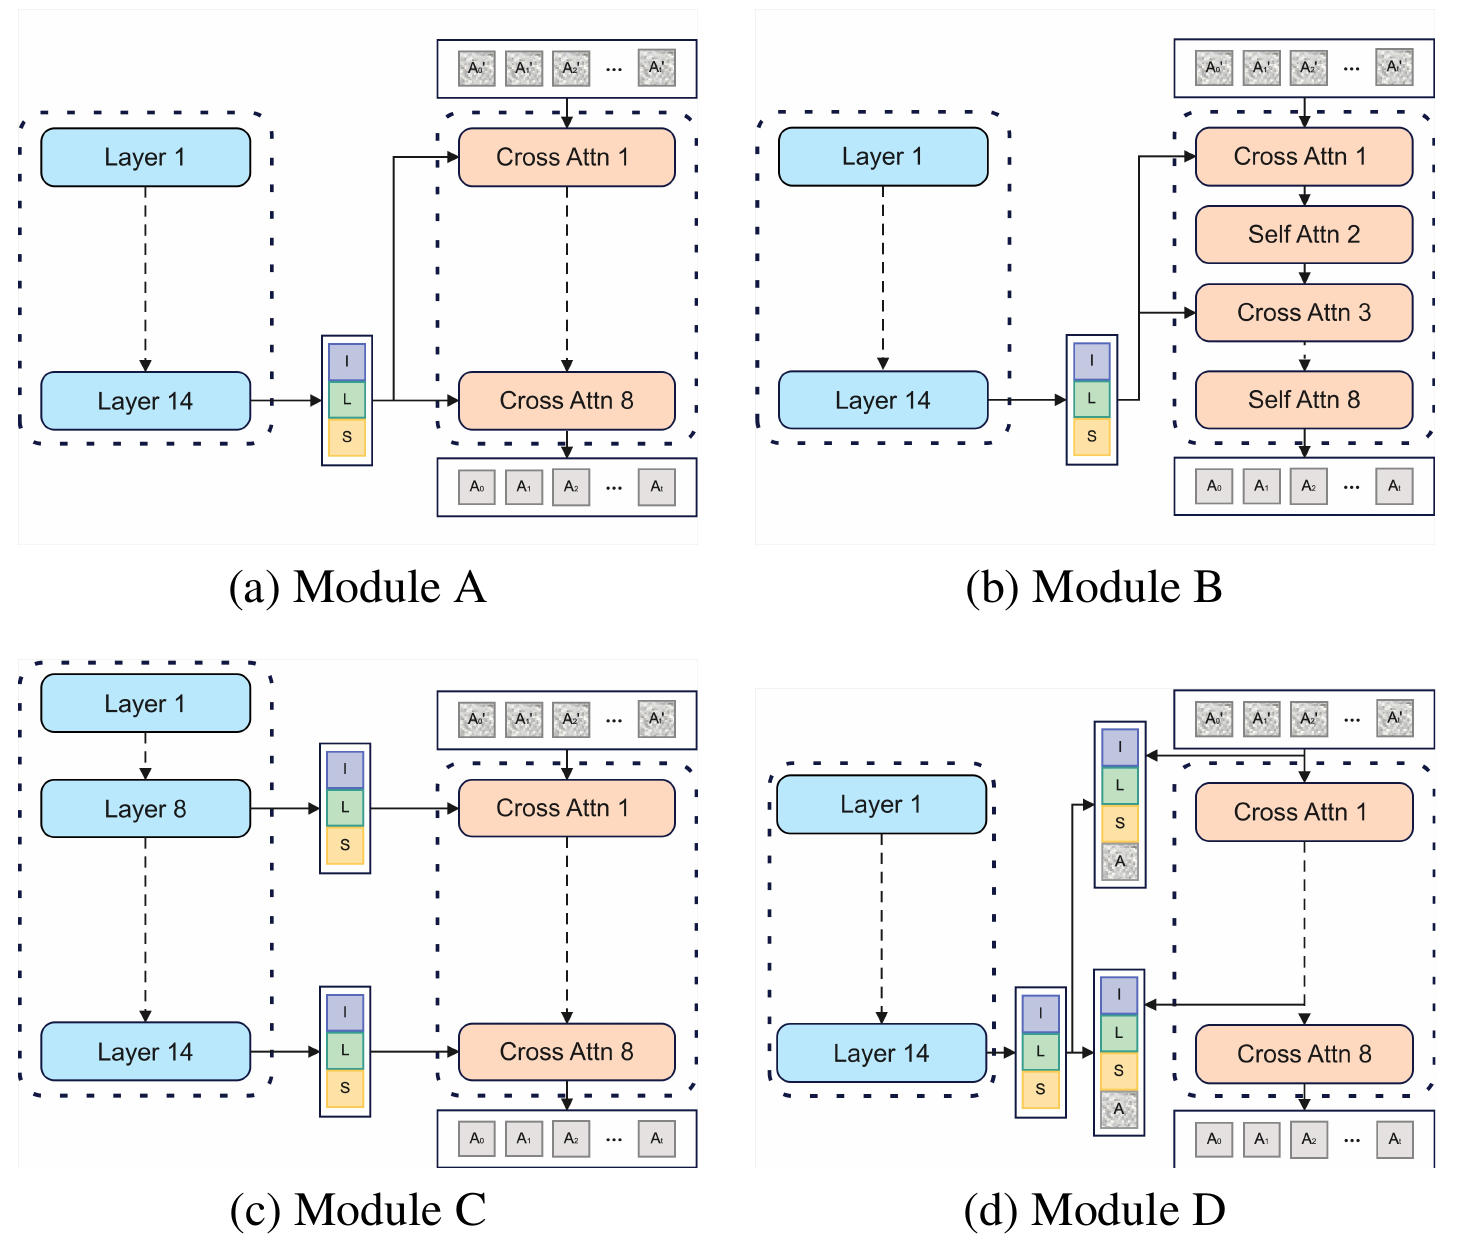
| Diseño | Conexión | Diferencia con el diseño final |
|---|---|---|
| A: Atención cruzada en capas intermedias | Las características de imagen-texto de la capa 14 y el estado suministran K y V a cada capa de acción. | Diseño elegido; condiciones consistentes entre capas. |
| B: Atención cruzada/propia intercalada en capas intermedias | Añadir atención propia después de leer las condiciones. | Más interacciones dentro de la secuencia de acción. |
| C: Atención cruzada por capa | Diferentes capas de acción leen características del VLM desde distintas profundidades más el estado. | Las condiciones varían con la profundidad de la capa de acción. |
| D: Atención cruzada con KV conjunto | Imagen-texto, estado y acciones ruidosas entran todas en K y V. | Las acciones también se convierten en contexto recuperado. |
Ecuación de atención estándar para explicación, no una pérdida adicional propuesta por el artículo:
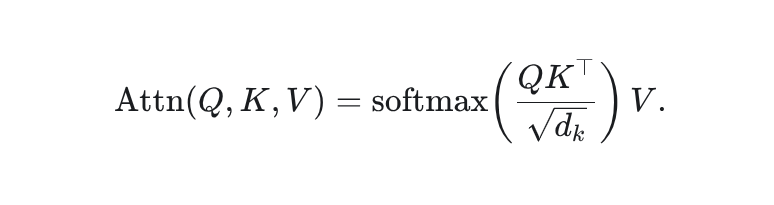
Con 50 posiciones de acción y M tokens de condicionamiento, una cabeza tiene Q: 50 × d_k, K: M × d_k y V: M × d_v; su salida es 50 × d_v. d_k y d_v son anchos de cabeza. Softmax normaliza las M coincidencias para cada consulta. Estos son símbolos explicativos; el artículo no informa completamente sus valores concretos.
Ejemplo mínimo: Supón que una posición de acción asigna pesos [0.75, 0.25] a dos tokens, cuyo valor seleccionado en una dimensión es [6, 2]. La recuperación da 0.75 × 6 + 0.25 × 2 = 5. Esta es una característica interna, no un ángulo ordenado. La siguiente capa puede leer el contexto de nuevo con su representación de acción actualizada.
Precaución: El texto enfatiza la concatenación en lugar de la proyección en un espacio de incrustación compartido, mientras que la Figura 1 incluye un codificador de estado. Interpreta esto como preservar condicionamientos separados antes de la concatenación, no como evidencia de que toda la red carece de proyecciones o codificadores. El eje exacto de concatenación y los anchos de codificación requieren detalles de implementación.
Experto de acción: Generar un bloque con Flow Matching
Problema: Las características de imagen-texto no pueden usarse directamente como ángulos articulares. Las trayectorias futuras contienen muchos valores continuos que deben generarse bajo las condiciones de la tarea.
Intuición: Empezar con un bloque de ruido aleatorio y aprender en qué dirección mover sus valores hacia las acciones demostradas. “Diffusion Transformer” (DiT) describe la arquitectura de la red; flow matching describe el objetivo de entrenamiento. Los nombres son compatibles.
Ecuación (3) del artículo:
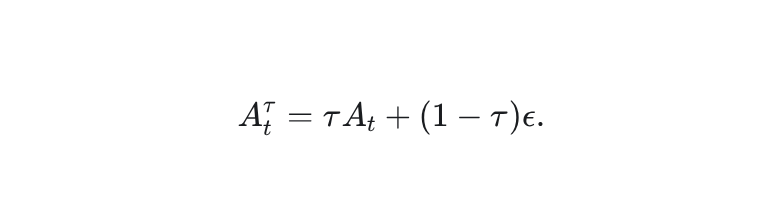
t es el tiempo de observación; A_t es el bloque demostrado que comienza entonces; ε es ruido de la misma forma; τ es el progreso interno de generación, distinto del tiempo del robot. Ambos arreglos tienen por defecto 50 × 24. El τ adimensional se muestrea de una distribución Beta y se restringe a [0.02, 0.98]; los parámetros Beta no se especifican.
Ejemplo mínimo: Para un elemento, toma acción 0.6, ruido −0.2 y τ=0.5; el valor interpolado es 0.2. En este camino lineal, τ=0 es ruido y τ=1 son datos, aunque el entrenamiento solo muestrea el intervalo truncado.
Ecuación (4), con fuentes de muestreo abreviadas:
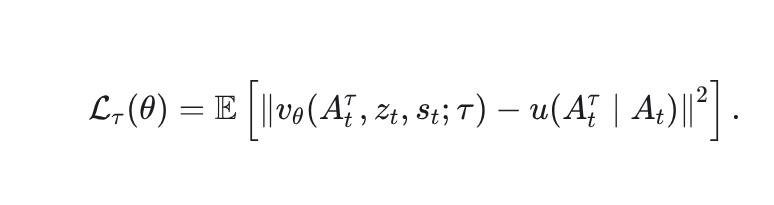
θ denota parámetros entrenables; z_t características de imagen-texto; y s_t estado propioceptivo. v_θ es el campo de velocidad condicionado en el tiempo predicho, y u la dirección objetivo de generación, ambos con la forma del bloque de acción. La norma al cuadrado compara errores direccionales en cada elemento, con esperanza sobre acciones de demostración y muestras ruidosas. La ecuación original omite la condición de tiempo de los argumentos de la red; aquí se muestra τ para coincidir con la descripción del texto de un campo de velocidad condicionado en el tiempo.
Explicación: Diferenciar el camino lineal en la Ecuación (3) da A_t−ε; esta es una interpretación de la ecuación, no una expansión explícita de u en el artículo. En el ejemplo, la dirección objetivo es 0.8; predecir 0.7 da un error cuadrático de 0.01. El modelo aprende cómo mover la estimación, en lugar de ajustar directamente valores ruidosos a respuestas finales.
La inferencia predice repetidamente direcciones y actualiza ruido fresco bajo condicionamiento de imagen-texto y estado, produciendo [âₜ, âₜ₊₁, …, âₜ₊₄₉]. El experto usa ocho capas Transformer con atención cruzada apilada, en lugar de atención propia alternada.
Actualización discreta ilustrativa:
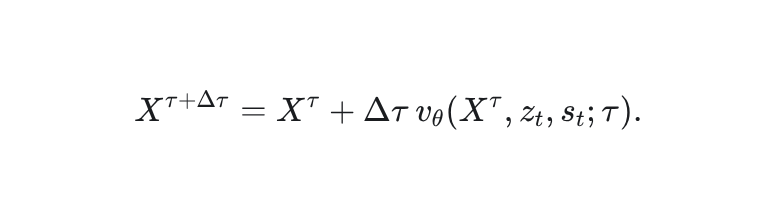
X^τ es la estimación actual y Δτ un tamaño de paso interno adimensional. Esta actualización de Euler explica el campo de velocidad; no es un algoritmo de inferencia completamente especificado en el artículo. Ejemplo: un valor de 0.2, dirección predicha 0.8 y paso 0.1 se actualiza a 0.28.
Precaución: El número de actualizaciones internas, el solucionador numérico y el calendario de ejecución no se informan completamente. Ocho capas Transformer no significan ocho pasos de eliminación de ruido, y τ no es el tiempo de movimiento del robot. Generar conjuntamente un bloque tampoco implica acciones independientes.
Entrenamiento e inferencia de extremo a extremo
Problema: La columna vertebral ya tiene capacidades de imagen-texto, pero el experto de acción se inicializa de nuevo. Entrenar todo inmediatamente puede permitir que los gradientes de los nuevos módulos distorsionen representaciones útiles hacia un conjunto limitado de demostraciones.
Intuición: Primero enseñar a los módulos de acción a usar características existentes y luego permitir la adaptación conjunta. El mecanismo concreto es controlar qué parámetros reciben actualizaciones.
| Etapa | Backbone VLM | Módulo de integración y experto de acción | Propósito |
|---|---|---|---|
| 1: Alineación del experto de acción | Totalmente congelado | Entrenable | Conectar características perceptuales fijas con acciones. |
| 2: Ajuste fino de todo el modelo | Descongelado y entrenable | Continuar el entrenamiento | Adaptar conjuntamente el control posterior a partir del punto de control de la etapa 1. |
Artículo: Todos los experimentos usan entrenamiento distribuido en ocho GPU NVIDIA A100. Meta-World usa 10,000 pasos en la etapa 1 y 65,000 en la etapa 2; ambas usan tasa de aprendizaje 1×10⁻⁵, tamaño de lote 16, 1,000 pasos de calentamiento, recorte de gradiente 1.0 y decaimiento de peso 0.001. El dropout del experto tiene por defecto 0.2 y la augmentación permanece habilitada. Otros benchmarks usan el mismo enfoque de dos etapas con pasos ajustados al tamaño del conjunto de datos (página 11, Tablas 4 y 5).
Ejemplo: Un error de predicción actualiza solo los nuevos módulos en la etapa 1, pero también puede cambiar el backbone en la etapa 2. Las etapas no son dos tipos de robot, ni preentrenamiento con datos de robot seguido de entrenamiento de tareas.
No se añade una pérdida explícita de preservación semántica; el objetivo de acción reportado es flow matching. La retención semántica depende principalmente de la inicialización y el orden de entrenamiento, mientras que la etapa 2 aún cambia el backbone. El artículo no da el tiempo de reloj de pared ni el costo completo de entrenamiento, por lo que el bajo costo no debe interpretarse como completar todo el entrenamiento en una sola GPU de consumo.
Entrenamiento e inferencia de extremo a extremo
Training: demonstration images + instruction → VLM layer-14 image-text features
          demonstrated state → state encoding / integration context
          action chunk + random noise + generation progress → noisy chunk
          context + noisy chunk → action expert → direction prediction → flow-matching loss
          update new modules in stage 1; update the full model in stage 2

Inference: current images + instruction → image-text features
           current state → conditioning context
           fresh noisy chunk → repeated time-conditioned expert updates
           → 50-step continuous prediction → platform control interface → later observations
Resumen en una frase: Un backbone compacto interpreta la escena y el objetivo; la integración aporta contexto persistente; el flow matching convierte ruido en trayectorias; el entrenamiento en dos etapas controla cómo se adaptan percepción y acción.
Experimentos: Dónde se aplican las mejoras
Simulación: Promedios sólidos con resultados individuales desiguales
| Benchmark y alcance | Entrenamiento y evaluación | Éxito medio de Evo-1 | Comparación principal |
|---|---|---|---|
| Meta-World, 50 tareas | 50 demostraciones por tarea, 2,500 en total; 10 evaluaciones por tarea, promediadas sobre cinco ejecuciones independientes. | 80.6% | SmolVLA 68.2%; +12.4 puntos porcentuales. |
| LIBERO, 40 tareas en cuatro suites | Spatial / Object / Goal / Long; 10 evaluaciones por tarea, promediadas sobre cinco ejecuciones. | 94.8% | π0 94.2%; +0.6 puntos porcentuales. |
| Cuatro tareas seleccionadas de RoboTwin 2.0 | 50 demostraciones por tarea; configuraciones fácil y difícil; el texto indica 100 pruebas de evaluación. | 37.8% | π0 30.9%; +6.9 puntos porcentuales. |
Fuente: página 5 del PDF, Tabla 1; configuraciones experimentales en las páginas 5–6; suplementos en las páginas 12–13. La distribución de los “100 trials” de RoboTwin entre niveles de dificultad no está clara, por lo que no se infiere ningún total adicional. Esta versión no indica claramente las demostraciones por tarea de LIBERO.
Artículo: Los grupos de dificultad de Meta-World obtienen 89.2%, 76.8%, 77.2% y 79.2%, todos por encima de las líneas base indicadas. Los grupos de LIBERO obtienen 92.7%, 97.7%, 96.3% y 92.3%. Object, Goal y Long lideran, pero Spatial queda por debajo del 96.8% de π0. Una ventaja promedio no implica ganar en todas las categorías.
Las ganancias en RoboTwin se concentran en Click Alarmclock: 77% / 58% para fácil / difícil, comparado con el 63% / 11% de π0. Persisten fallos difíciles: Place Can Basket difícil alcanza solo 1%, por debajo del 5% de π0. Estos resultados respaldan la efectividad en tareas bimanuales seleccionadas, no una solución integral para escenas difíciles.
Precaución: Las líneas base de Meta-World y LIBERO provienen de artículos o reproducciones existentes, y las de RoboTwin de su artículo oficial; no todos los métodos se reentrenaron de forma uniforme aquí. La Tabla 1 etiqueta SmolVLA como 2.25B, mientras que la Tabla 2 de eficiencia usa 0.45B. La discrepancia no se explica completamente, así que no deben tratarse como una configuración idéntica.
Sistema real: dos vistas RGB y ángulos articulares absolutos
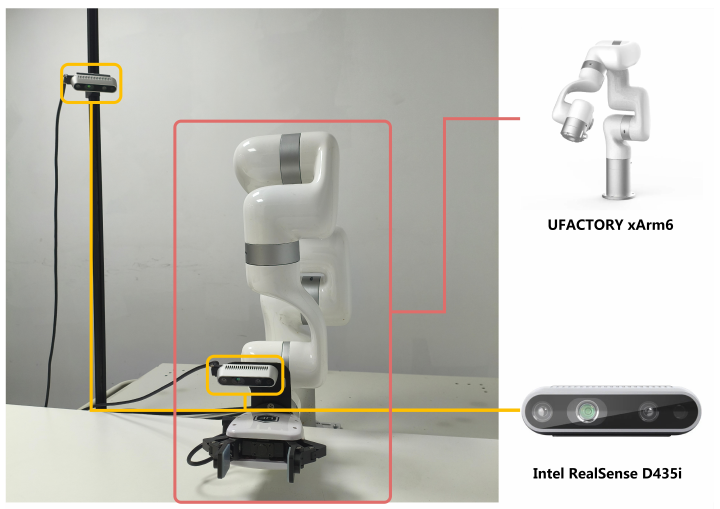
| Elemento | Configuración en el artículo |
|---|---|
| Robot | xArm6 de seis GDL con una pinza paralela, controlado por la xArmAPI oficial. |
| Visión | Cámaras RGB fijas en el entorno y en la muñeca; la capacidad de profundidad del dispositivo no se trata como entrada. |
| Registro | Formato LeRobot v2.1; observaciones sincronizadas registradas a 30 Hz. |
| Estado y acción | Ángulos articulares absolutos, coherentes con la supervisión y la reproducción; la interfaz acolchada del modelo tiene 24 dimensiones. |
| Demostraciones y evaluación | 100 demostraciones teleoperadas para cada una de cuatro tareas, 400 en total; 20 pruebas por tarea, 80 en total. |
Fuente: página 6 y páginas 14–15. La resolución bruta de la cámara, las duraciones de las demostraciones y el mapeo completo del campo de la pinza no se indican explícitamente. 448 × 448 es el tamaño de entrada del modelo.
Rendimiento en el mundo real y eficiencia de inferencia
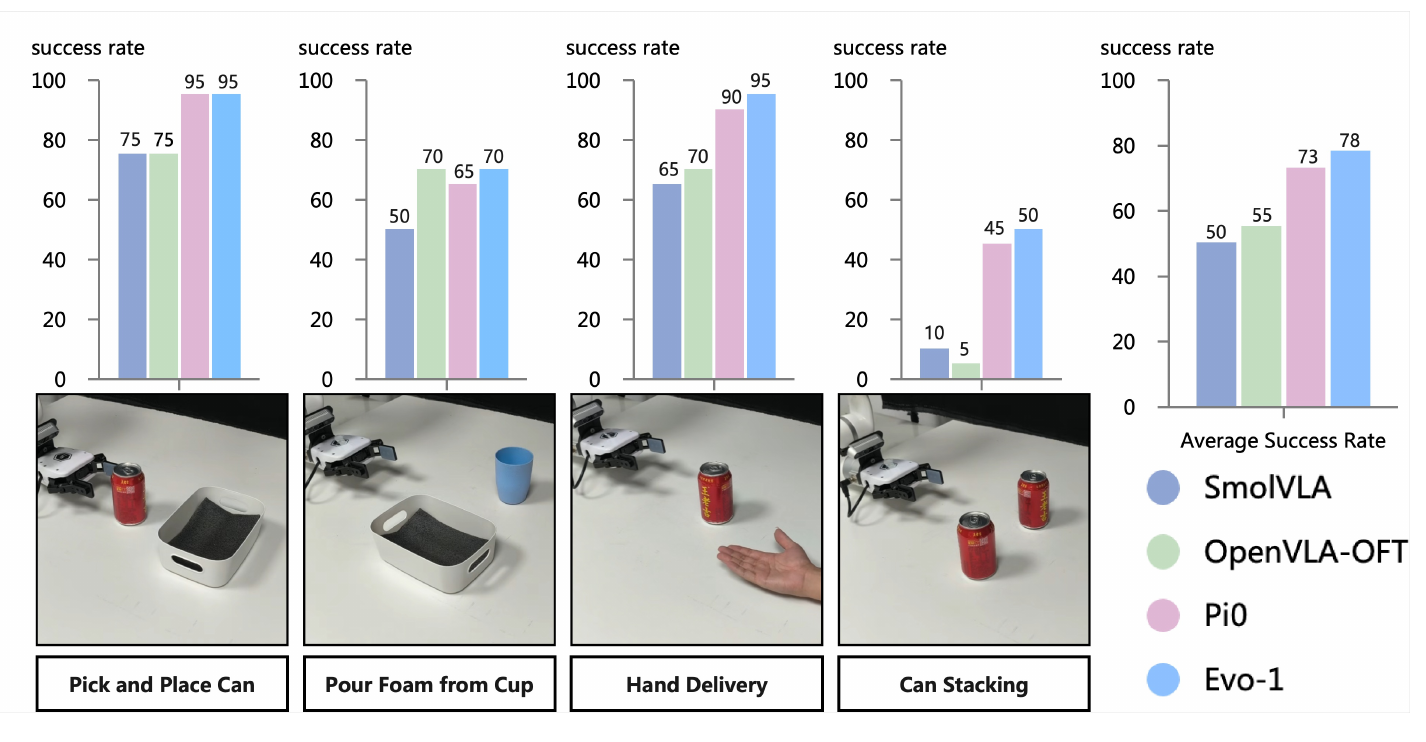
| Tarea | Criterio de éxito en el artículo | Éxito de Evo-1 |
|---|---|---|
| Recoger y colocar una lata | Totalmente dentro de la caja blanca, estable y sin rodar hacia fuera. | 95% |
| Verter espuma de un vaso | La mayor parte de la espuma entra en la caja blanca, con acumulación visible y poco derrame. | 70% |
| Entregar una lata a una persona | Colocada de forma segura en la mano sin que la persona tenga que perseguirla o ajustarse para atraparla. | 95% |
| Apilar latas | La lata superior permanece estable al menos dos segundos sin deslizarse ni caer. | 50% |
Fuente: Figura 4 y criterios de éxito en la página 15. La media de las cuatro tareas es 77.5%, reportada como 78%; esto no significa un 78% de puntuación en cada tarea. Apilar sigue siendo una debilidad.
Tabla 2: mediciones en la GPU RTX 4090d especificada.
| Modelo | Parámetros | VRAM media de inferencia | Frecuencia media de inferencia | Éxito medio en tareas reales |
|---|---|---|---|---|
| SmolVLA | 0.45B | 2.0 GB | 12.7 Hz | 50.0% |
| OpenVLA | 7.0B | 15.1 GB | 7.9 Hz | 55.0% |
| π0 | 3.5B | 17.9 GB | 11.5 Hz | 73.0% |
| Evo-1 | 0.77B | 2.3 GB | 16.4 Hz | 78.0% |
Fuente: página 7, Tabla 2. La Figura 4 y el texto de resultados llaman a una línea base OpenVLA-OFT, mientras que la Tabla 2 la llama OpenVLA. Se mantienen los nombres sin asumir configuraciones de implementación idénticas.
Evo-1 tiene la inferencia más rápida y el mayor éxito promedio en esta comparación, pero un uso de VRAM ligeramente superior al de SmolVLA. El valor de 2.3 GB es memoria media de inferencia, no memoria de entrenamiento ni una garantía de esa tasa en cualquier dispositivo de 2.3 GB.
Precaución: 30 Hz es la frecuencia de registro de demostraciones; 16.4 Hz es la frecuencia de inferencia en GPU; 50 es el horizonte de predicción. Describen etapas diferentes. La latencia completa percepción–comunicación–ejecución no se reporta, por lo que 16.4 Hz no debe describirse como la frecuencia final de control del robot.
Generalización: distractores y cambios de posición en una tarea
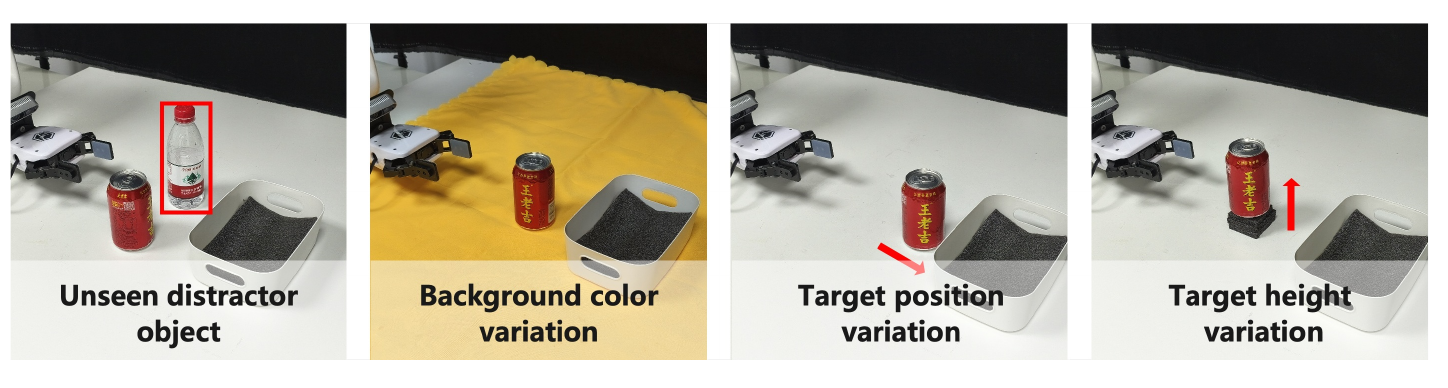
La prueba de generalización usa colocación de lata en caja con 20 pruebas por perturbación. Los autores definen estos cambios como fuera de la distribución de entrenamiento.
| Condición | SmolVLA | Evo-1 |
|---|---|---|
| Escena base | 75% | 95% |
| Botella no vista añadida | 65% | 80% |
| Mantel amarillo añadido | 60% | 75% |
| Objetivo movido hacia atrás 10 / 20 / 30 mm | 75% / 60% / 60% | 95% / 85% / 80% |
| Objetivo elevado 10 / 20 / 30 mm | 75% / 65% / 60% | 100% / 90% / 70% |
Fuente: página 7, Tabla 3. El desplazamiento y la altura se miden en milímetros.
Interpretación: Los resultados respaldan la adaptación a estos cambios locales, con Evo-1 por encima del SmolVLA comparado en cada condición. Elevar el objetivo 30 mm reduce el éxito al 70%. Con 20 pruebas, un solo acierto cambia la puntuación en cinco puntos porcentuales; las diferencias pequeñas no deben tratarse como leyes universales. Esto no evalúa generalización zero-shot a objetos, tareas o robots arbitrarios.
El suplemento también muestra un SO-100 recogiendo un bloque pequeño y colocándolo en un contenedor fijo (páginas 15 y 19). Sin mediciones comparables de éxito, número de demostraciones o eficiencia, esto es una demostración de despliegue más que una prueba cuantificada de transferencia entre robots sin adaptación.
Ablaciones y límites de la evidencia
¿Ayuda el condicionamiento persistente?
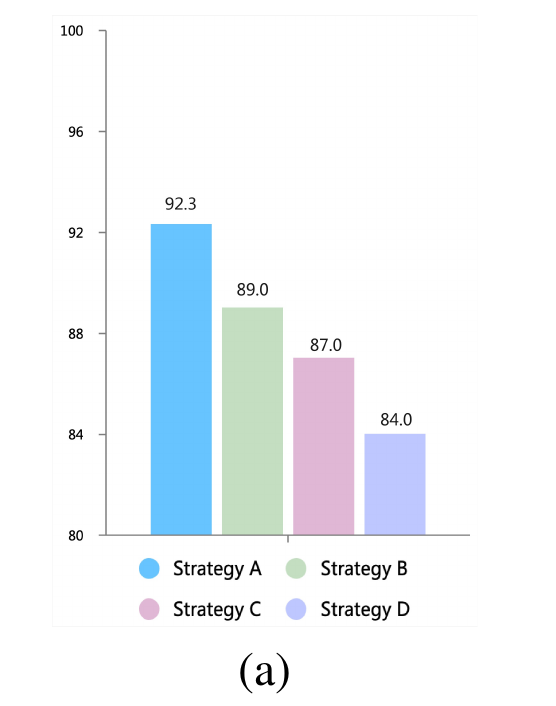
Artículo: Los módulos A, B, C y D alcanzan 92.3%, 89.0%, 87.0% y 84.0%. A supera a B en 3.3 puntos porcentuales y se elige para el modelo final.
Interpretación: Esto respalda leer repetidamente las mismas características intermedias imagen-texto y de estado. Los autores atribuyen la ganancia a un condicionamiento más continuo, pero el experimento compara cuatro diseños completos en lugar de aislar cada factor. No muestra que la self-attention sea generalmente perjudicial ni que la fusión de características en múltiples capas sea siempre inferior.
¿Ayuda el entrenamiento en dos etapas?
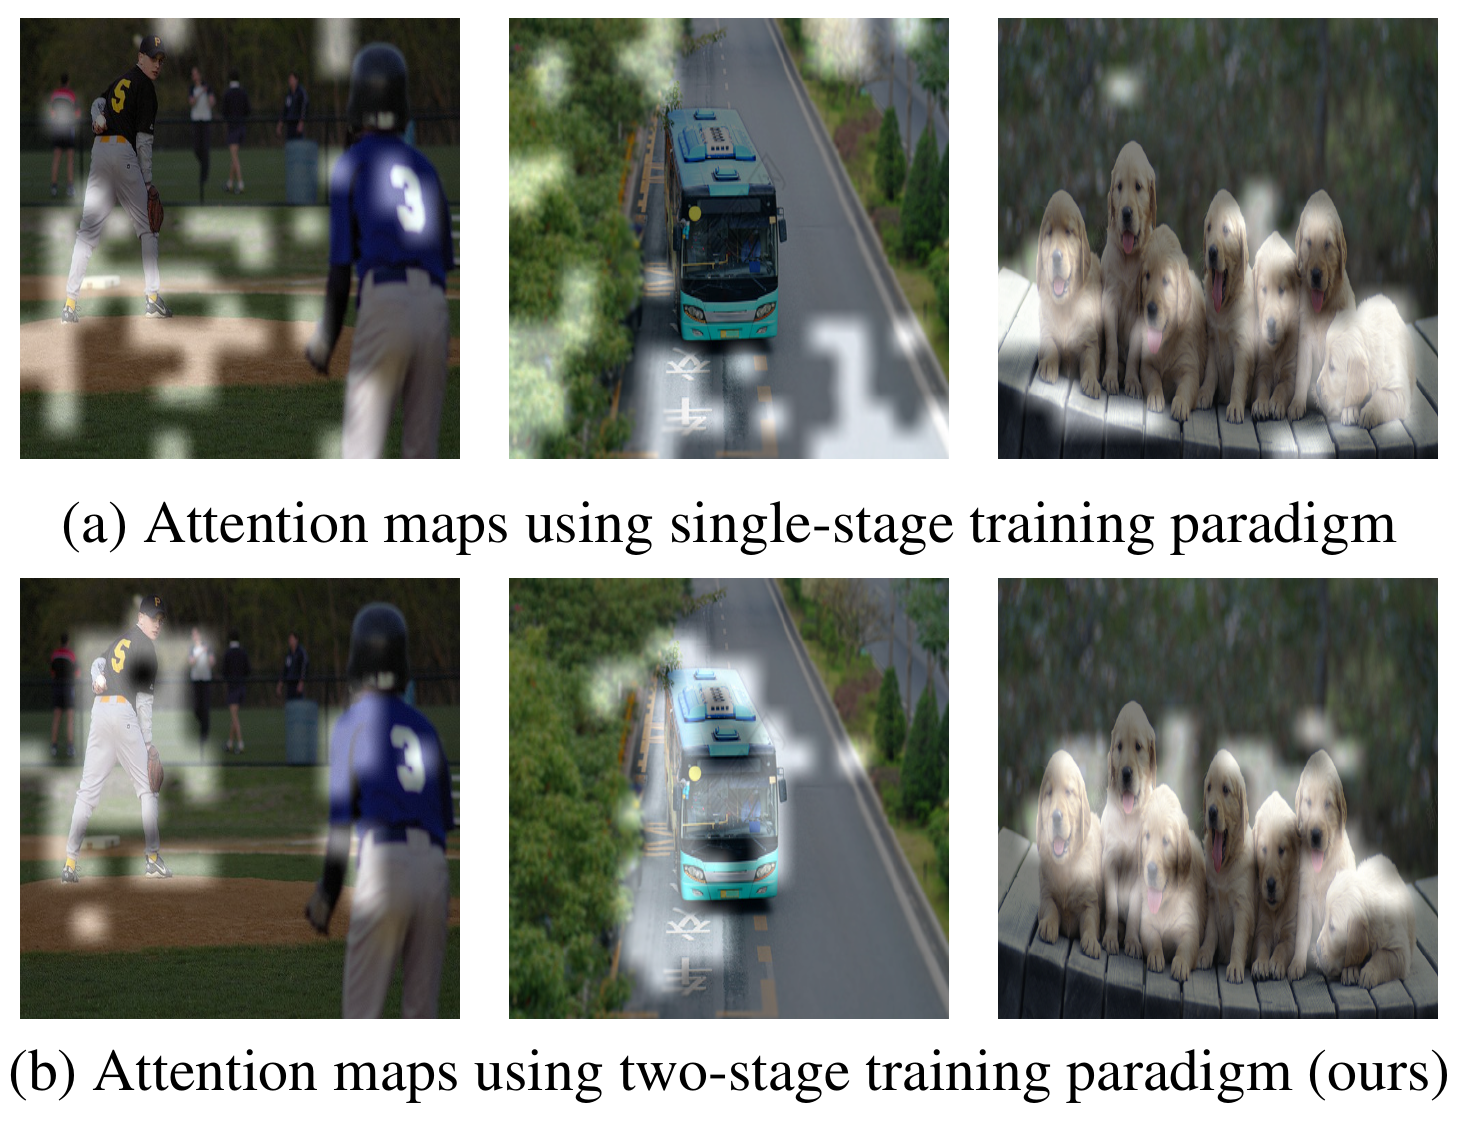
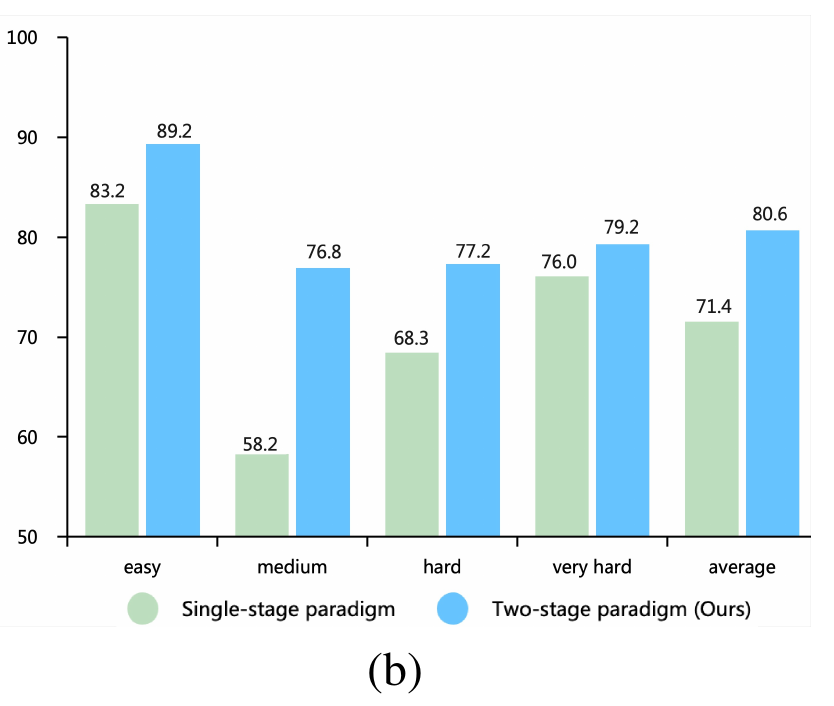
Artículo: El entrenamiento en dos etapas gana en los cuatro grupos de dificultad, con un promedio de 80.6% frente a 71.4%, una ganancia de 9.2 puntos. El entrenamiento en una etapa actualiza todos los módulos inmediatamente; el entrenamiento en dos etapas congela primero el backbone y luego ajusta conjuntamente.
Interpretación: La comparación controlada de tasas de éxito respalda el orden de entrenamiento. Los mapas de atención sugieren un enfoque imagen-texto más claro. La Figura 2 también compara Evo-1 y OpenVLA, pero los diferentes backbones y tamaños impiden usar solo esa comparación para establecer el efecto causal del entrenamiento en dos etapas; la ablación con la misma arquitectura es más directa.
Precaución: No hay una evaluación cuantitativa exhaustiva de respuesta visual general a preguntas, comprensión del lenguaje u olvido semántico. La retención semántica cuenta con visualización local y evidencia en tareas, no con prueba de que se preserve todo el conocimiento preentrenado.
Qué debes extraer
Evo-1 combina un backbone multimodal nativo compacto y truncado, un condicionamiento estable mediante cross-attention y alineamiento antes del ajuste fino conjunto. Esta combinación de 0.77B funciona bien en las tareas simuladas y reales reportadas. El experto de acción basado en flow matching sigue requiriendo demostraciones de la tarea objetivo.
Mantén la conclusión dentro de la evidencia: RoboTwin cubre cuatro tareas seleccionadas, el apilado real de latas tiene éxito el 50% de las veces y la generalización cubre unos pocos cambios en una tarea. La eficiencia depende de mediciones en una RTX 4090d, mientras que el entrenamiento usa ocho A100. El artículo muestra el valor del diseño de arquitectura y entrenamiento para VLAs pequeños, no un reemplazo universal de modelos más grandes ni un despliegue directo en robots arbitrarios.