GR00T N1: Cómo una arquitectura de doble sistema soporta el control humanoide generalista
GR00T N1: Un modelo fundacional abierto para robots humanoides generalistas
- Robots humanoides
- Arquitectura de doble sistema
- Pirámide de datos
- Coincidencia de flujo
GR00T N1.7: Adaptación y Fine-Tuning
Esta lectura cubre el artículo original de GR00T N1. Para trabajo práctico con GR00T N1.7 (nvidia/GR00T-N1.7-3B), sigue el curso reBot existente:
- Encarnación del robot y arquitectura de GR00T
- Preparar un conjunto de datos VLA de reBot
- Fine-tuning de GR00T N1.7 para el brazo reBot
- Desplegar el modelo ajustado en el robot
Los ajustes experimentales de N1 discutidos a continuación pertenecen al artículo original. Usa los tutoriales de N1.7 para la configuración específica de entrenamiento y despliegue de esa versión.
Requisitos previos
De ACT a GR00T N1: el bucle de aprendizaje es el mismo
Si has usado LeRobot + ACT, este flujo de trabajo te resultará familiar:
Human teleoperation
    ↓
Collect camera / state / action data
    ↓
Organize an episode dataset
    ↓
Train a policy
    ↓
Observation → Action chunk → On-robot execution
GR00T N1 sigue respondiendo a la misma pregunta:
Dado lo que el robot ve, su estado actual y la petición del usuario, ¿cómo debería moverse a continuación?
ACT normalmente aprende un robot y una familia de tareas a partir de demostraciones. GR00T N1 busca priors generales a partir de múltiples robots, vídeos humanos y datos sintéticos antes de adaptarse a un robot real concreto.
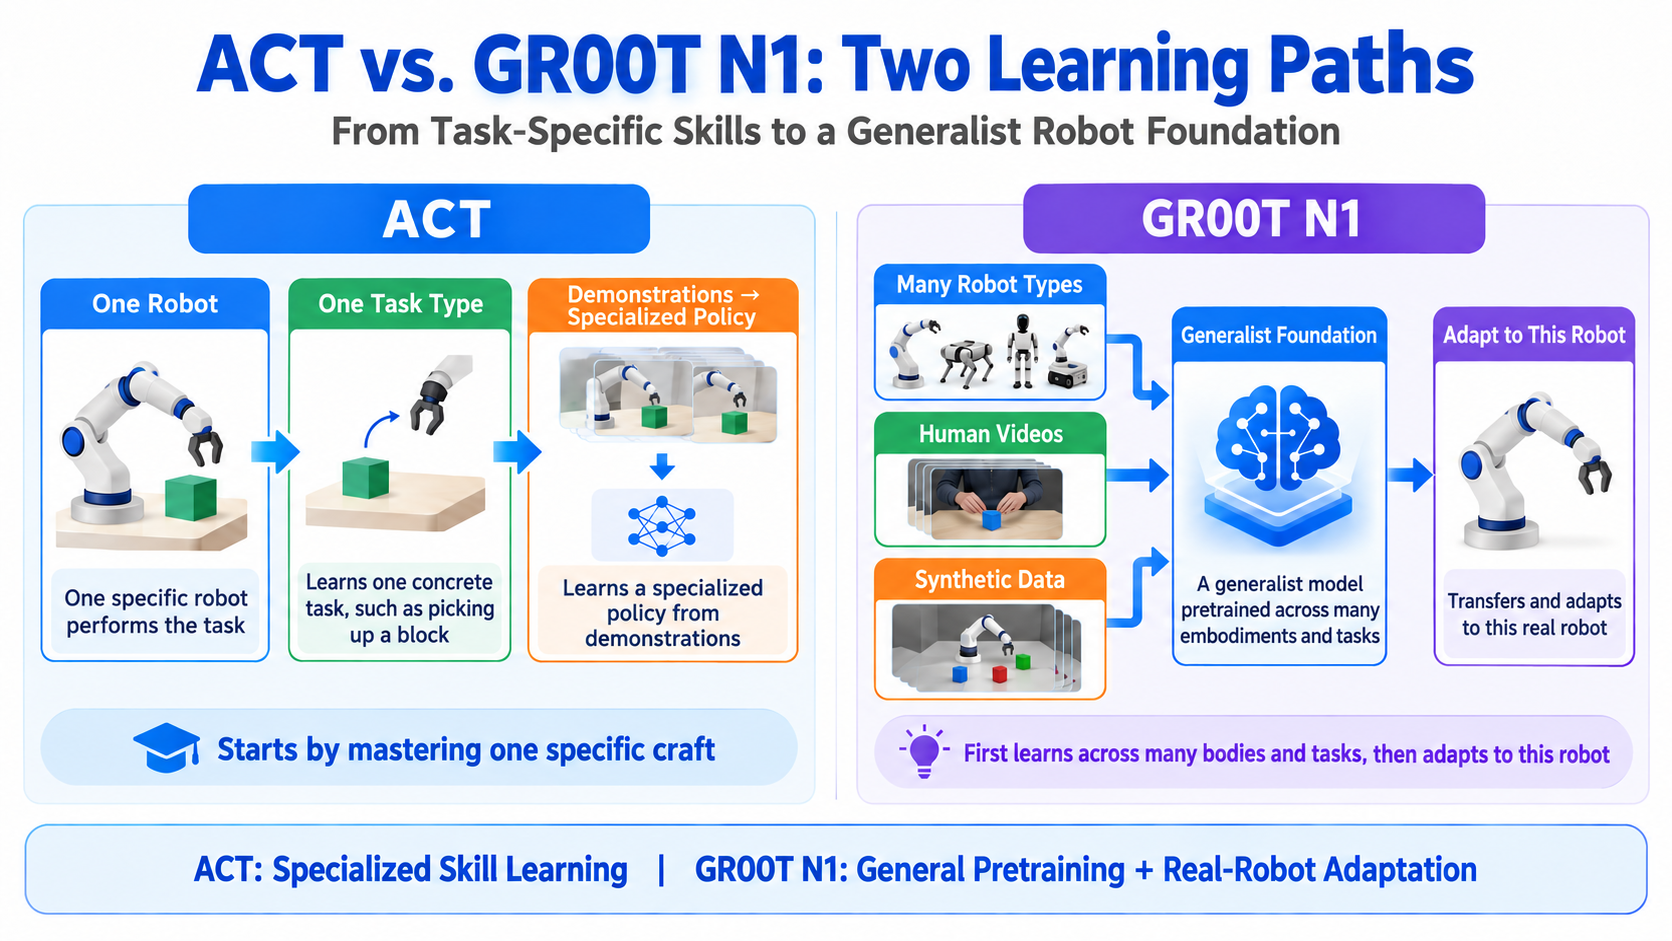
ACT comienza con una habilidad concreta; GR00T N1 primero aprende una base común entre cuerpos y tareas, y luego aprende a usar el robot actual.
Observación, estado, acción y encarnación
Los tres términos introducidos con ACT mantienen su significado:
-
Observación: información de sensores externos, como imágenes RGB de cabeza, muñeca y multivista.
-
Estado: la configuración del robot, incluyendo ángulos articulares, apertura de la pinza, pose del efector final, estado de la cintura o del cuello.
-
Acción: controles solicitados, potencialmente objetivos articulares, incrementos, poses del efector final o comandos de la pinza.
La encarnación incluye más que la apariencia. Combina definiciones de cuerpo y control:
Robot structure
+ Sensors
+ State definition
+ Action definition
+ Control frequency and mode
= One embodiment
Un solo Franka, un sistema bimanual y un humanoide GR-1 tienen dimensiones de estado/acción diferentes. Compartir un modelo entre estos cuerpos es un desafío central.
VLA, fragmentación de acciones y coincidencia de flujo
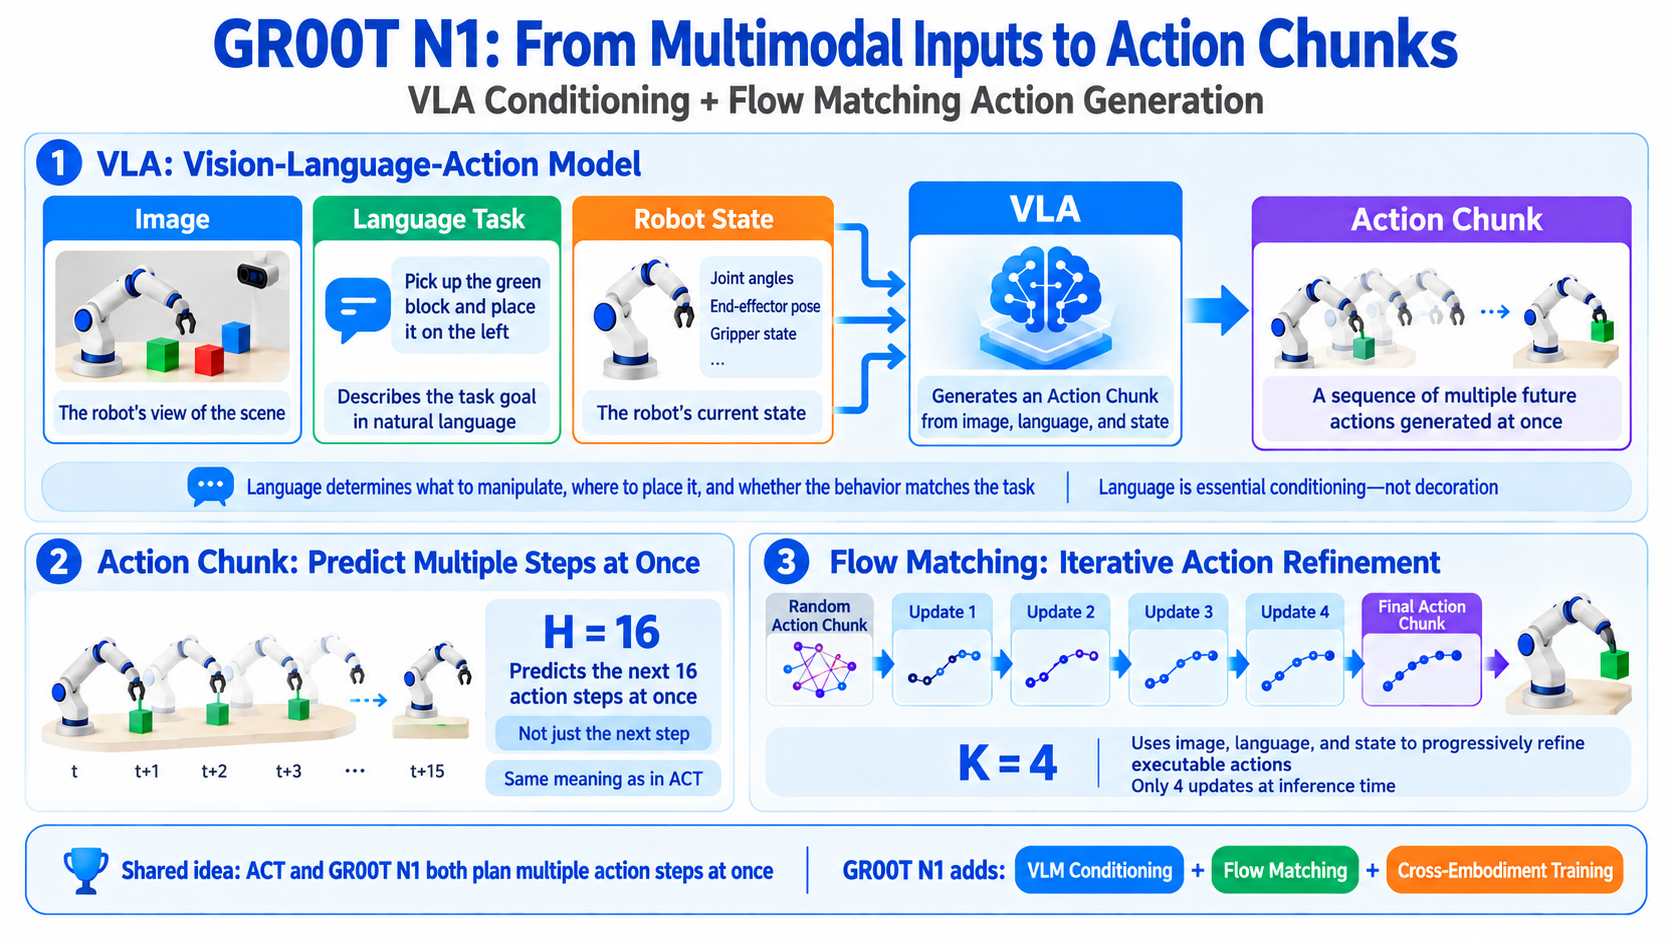
Una VLA añade lenguaje de tarea a las entradas visuales de la política. El lenguaje identifica qué objeto manipular, adónde debe ir y si el comportamiento coincide con la petición; no es contexto decorativo.
Un fragmento de acción, como en ACT, predice una secuencia corta futura en lugar de una sola acción. GR00T N1 fija H = 16.
La coincidencia de flujo puede entenderse como refinar acciones aleatorias en un fragmento ejecutable bajo el condicionamiento de imágenes, lenguaje y estado. El artículo usa solo K = 4 actualizaciones de inferencia.
Resumen
Los robots de propósito general necesitan cuerpos capaces y modelos inteligentes. Los humanoides son prometedores para entornos humanos, pero comprender nuevas situaciones, manejar la variación del mundo real y aprender rápidamente nuevas tareas requiere modelos fundacionales entrenados con datos grandes y diversos.
GR00T N1 es un modelo fundacional abierto para humanoides con una arquitectura VLA de doble sistema. Un módulo de visión-lenguaje, Sistema 2, interpreta imágenes e instrucciones; un Transformer de difusión, Sistema 1, genera acciones suaves en tiempo real. Los módulos están estrechamente conectados y se entrenan conjuntamente de extremo a extremo.
El entrenamiento mezcla trayectorias reales, vídeos humanos y datos sintéticos. GR00T N1 supera a las líneas base de aprendizaje por imitación comparadas en benchmarks de simulación a través de encarnaciones y aprende tareas bimanuales condicionadas por lenguaje de forma eficiente en el humanoide Fourier GR-1.
Tres ideas organizan el artículo:
-
VLA de doble sistema: un componente interpreta, otro actúa.
-
Datos heterogéneos: usar vídeos humanos, simulación y vídeos generados junto con demostraciones de robots.
-
Compartición entre encarnaciones: distintos cuerpos comparten capacidades centrales en lugar de recibir modelos completamente independientes.
Introducción y trabajos relacionados
Hardware, modelos, datos e islas de datos
La introducción identifica tres elementos necesarios:
-
Hardware determina la capacidad física. Los humanoides son atractivos porque los entornos humanos están diseñados para cuerpos humanos.
-
Modelos deben manejar tareas abiertas, no un comportamiento fijo.
-
Datos determinan la exposición a entornos, objetos, tareas y cuerpos.
Los modelos de lenguaje y visión pueden aprender de internet, pero la robótica carece de un internet equivalente de acciones. Los datos reales son costosos y lentos de recopilar, y los robots difieren en articulaciones, sensores y controles.
Juntar conjuntos de datos aún puede dejar islas de datos: los archivos comparten una base de datos pero no espacios de acción ni semántica.
Por lo tanto, el artículo no solo pregunta cómo diseñar una política, sino también cómo unificar su corpus de entrenamiento.
La pirámide de datos
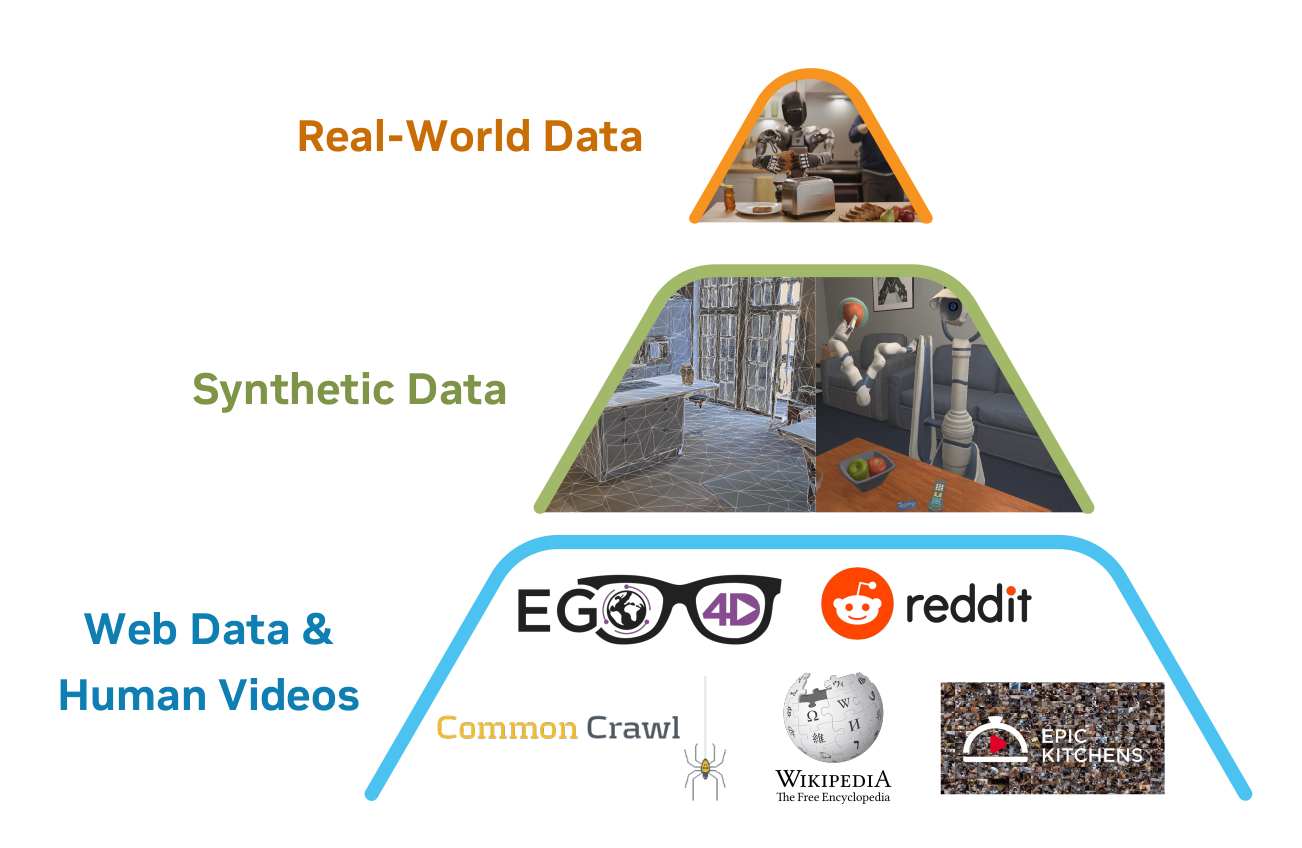
| Nivel | Datos | Cantidad relativa | Relación con el robot |
|---|---|---|---|
| Inferior | Datos web + vídeos humanos | Mayor | Conceptos de acción ricos sin comandos directos de robot. |
| Medio | Simulación + trayectorias neuronales | Grande | Escalable y controlable, pero con sesgo de simulación o generación. |
| Superior | Datos de robots en el mundo real | Menor | Más cercano a la ejecución, más costoso de recopilar. |
Al subir se reduce la cantidad pero aumenta la especificidad a la encarnación objetivo.
Vídeos humanos: qué acciones y tareas existen Simulación / generación: cómo pueden variar esas tareas Datos de robots reales: cómo debería ejecutarlas este cuerpo
Arquitectura de GR00T N1
El Sistema 2 entiende; el Sistema 1 actúa
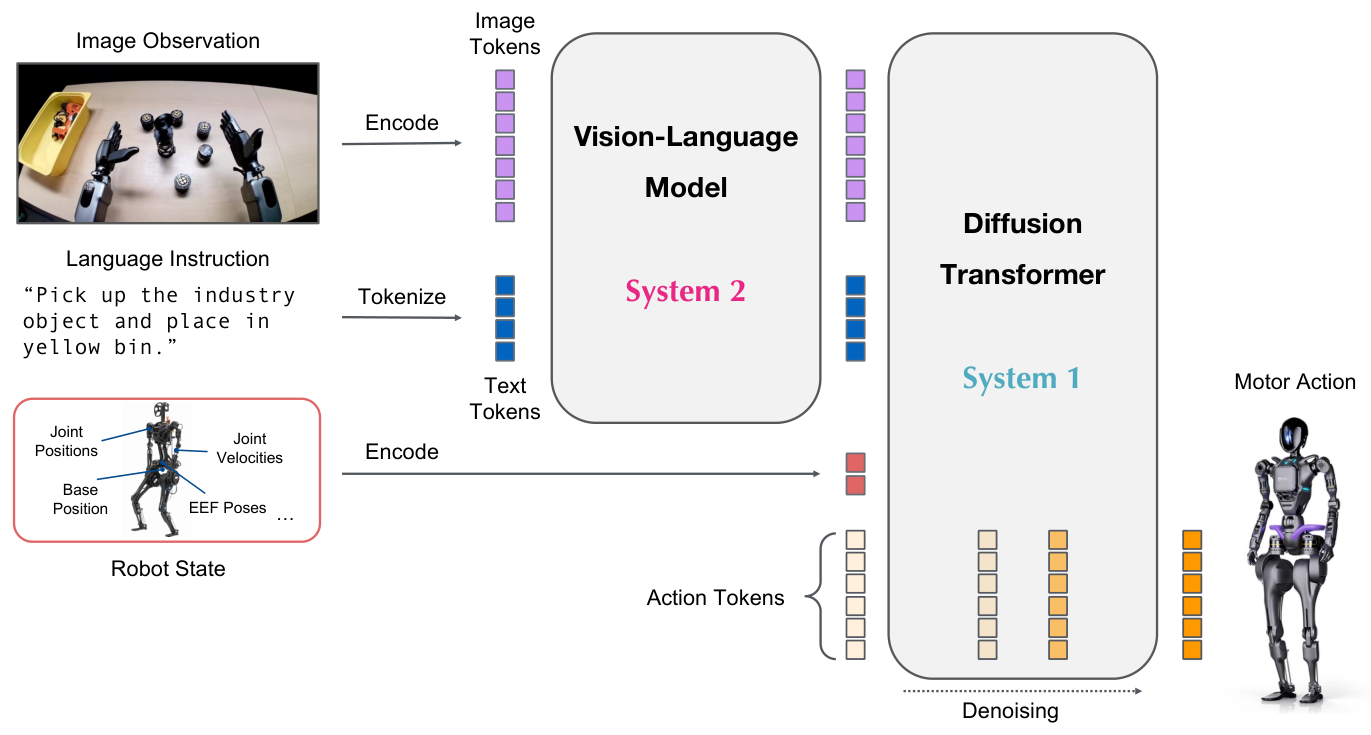
La arquitectura toma prestada una analogía de doble sistema de la cognición:
-
Sistema 2: Eagle-2 VLM, que interpreta imágenes, lenguaje y tareas.
-
Sistema 1: Transformer de difusión (DiT), que genera acciones continuas rápidamente.
No son programas independientes: la atención cruzada los conecta estrechamente y el entrenamiento los optimiza conjuntamente.
Eagle-2 contiene un modelo de lenguaje y un codificador de imágenes. Las imágenes entran a 224 × 224, produciendo 64 tokens por fotograma. Los autores usan características VLM de la capa intermedia 12 en lugar de las finales, lo que mejora la velocidad y el éxito posterior en sus experimentos.
El Sistema 2 opera a unas 10 Hz en una NVIDIA L40, mientras que el sistema de acción puede producir controles en lazo cerrado a una frecuencia mayor. La interpretación de alto nivel no necesita recalcularse cada milisegundo, mientras que el movimiento debe seguir siendo continuo.
Conectar distintos robots a un único DiT
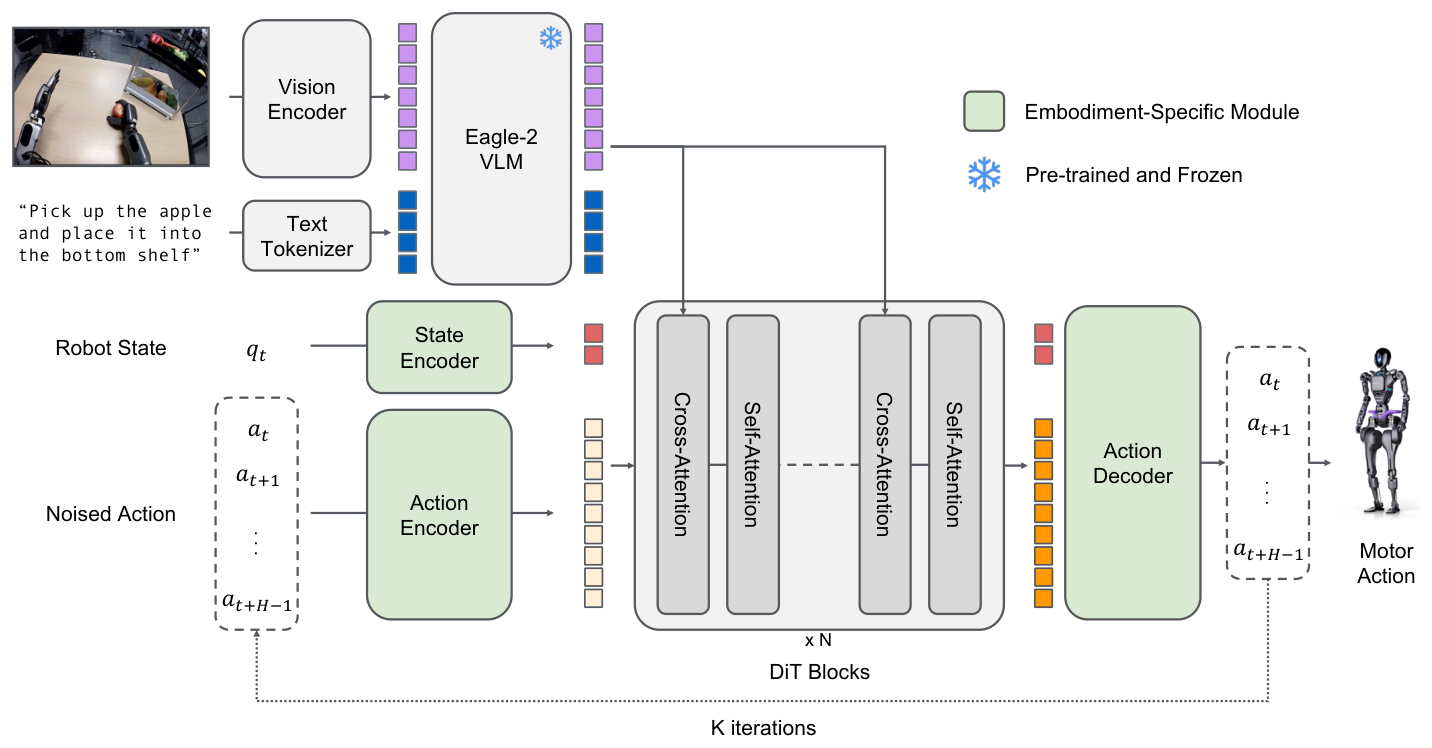
Hay dos tipos de módulos:
-
Núcleo compartido: VLM y DiT comparten conocimiento visual, lingüístico y de comportamiento entre robots.
-
Interfaces específicas de encarnación: codificador de estado, codificador de acción y decodificador de acción traducen las dimensiones de la plataforma y la semántica de control hacia y desde características compartidas.
| Módulo | Función | ¿Por qué específico de la encarnación? |
|---|---|---|
| Codificador de estado | Codificar el estado actual como tokens. | Los campos y dimensiones del estado difieren. |
| Codificador de acción | Codificar acciones ruidosas y el tiempo de generación. | Las dimensiones de acción difieren. |
| Decodificador de acción | Convertir características de DiT en controles. | Los modos de control de articulaciones, efector final y pinza difieren. |
Comentario: El aprendizaje entre robots no consiste simplemente en rellenar con ceros los vectores hasta igualar su longitud. Las dimensiones iguales no significan nada si no se sabe qué articulación, pose o comando representa cada valor.
Fragmentos de acciones con Flow-Matching
En el tiempo t, se predice una secuencia en lugar de una sola acción:
A_t = [a_t, a_(t+1), ..., a_(t+H-1)]
H = 16
El entrenamiento comienza con el fragmento real A_t, ruido gaussiano ε y tiempo de flujo τ, construyendo:
A_t^τ = τ A_t + (1 - τ) ε
-
Cerca de
τ=0, el fragmento se parece al ruido. -
Cerca de
τ=1, se parece a acciones reales.
El DiT lee características visual-lingüísticas, características de estado y acciones ruidosas para aprender una dirección de actualización. El artículo escribe la pérdida como:
L_fm(θ)
= E_τ [ || V_θ(φ_t, A_t^τ, q_t) - (ε - A_t) ||² ]
Aquí φ_t denota características del VLM y q_t características del estado del robot.
En inferencia no hay acciones futuras reales, así que se comienza desde ruido y se realizan cuatro actualizaciones de Euler hacia adelante:
A_t^0 ~ N(0, I)

A_t^(τ+1/K)
= A_t^τ + (1/K) V_θ(φ_t, A_t^τ, q_t)

K = 4
GR00T-N1-2B tiene 2,2B de parámetros totales, incluyendo alrededor de 1,34B en el VLM. En una L40, generar un fragmento de 16 pasos tarda unos 63,9 ms.
Datos y entrenamiento
Uso de videos sin acciones de robot
Las trayectorias de robot supervisan directamente imágenes, estados y acciones. Los videos humanos y generados contienen imágenes pero no comandos de articulaciones del robot.
GR00T N1 añade supervisión tipo acción de dos maneras.
Las acciones latentes aprenden códigos de comportamiento discretos a partir de cambios visuales, en lugar de ángulos articulares exactos: conceptos como moverse a la izquierda, agarrar o empujar.
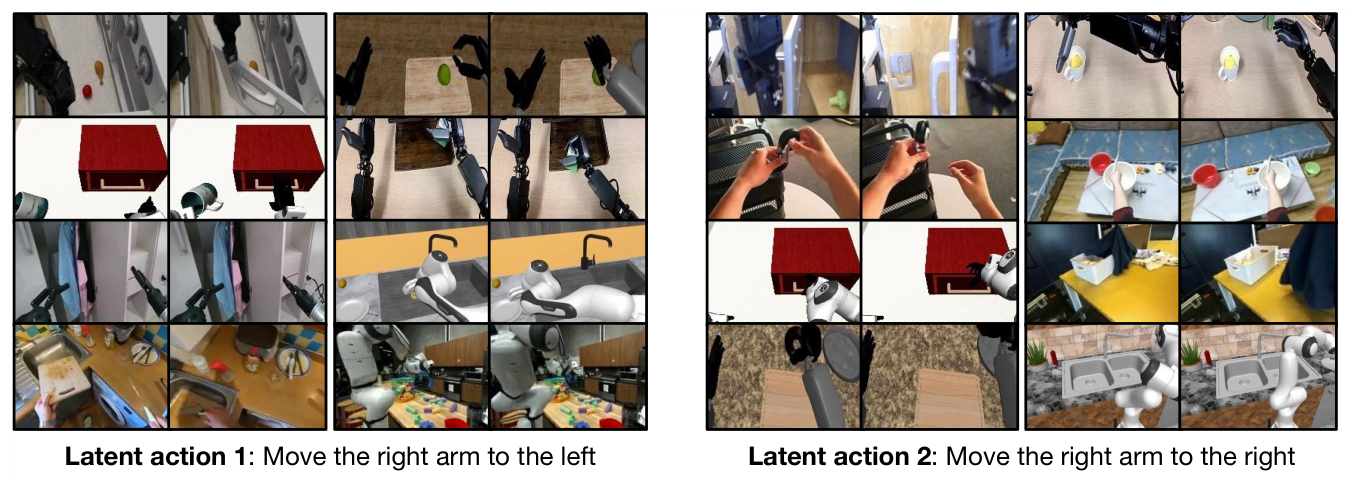
Estas pueden abarcar distintas morfologías: las manos humanas y las pinzas de robots tienen articulaciones diferentes pero ambas pueden mover un objeto hacia la izquierda en la imagen.
Un modelo de dinámica inversa (IDM) infiere acciones entre observaciones:
Observation_t + Observation_(t+1)
                  ↓
                 IDM
                  ↓
          Pseudo Action Label
Las acciones latentes se parecen a un vocabulario de comportamiento sin unidades; las salidas del IDM se parecen a pseudo-etiquetas de acción. Ninguna de las dos convierte los videos en demostraciones físicas perfectas. Hacen que los datos solo de imagen sean utilizables para el pre-entrenamiento.
Trayectorias neuronales y simulación: más variación a partir de menos demostraciones
La generación de video parte de imágenes reales de robots y varía los prompts de lenguaje para sintetizar tareas, posiciones de objetos y trayectorias. Estas son trayectorias neuronales.
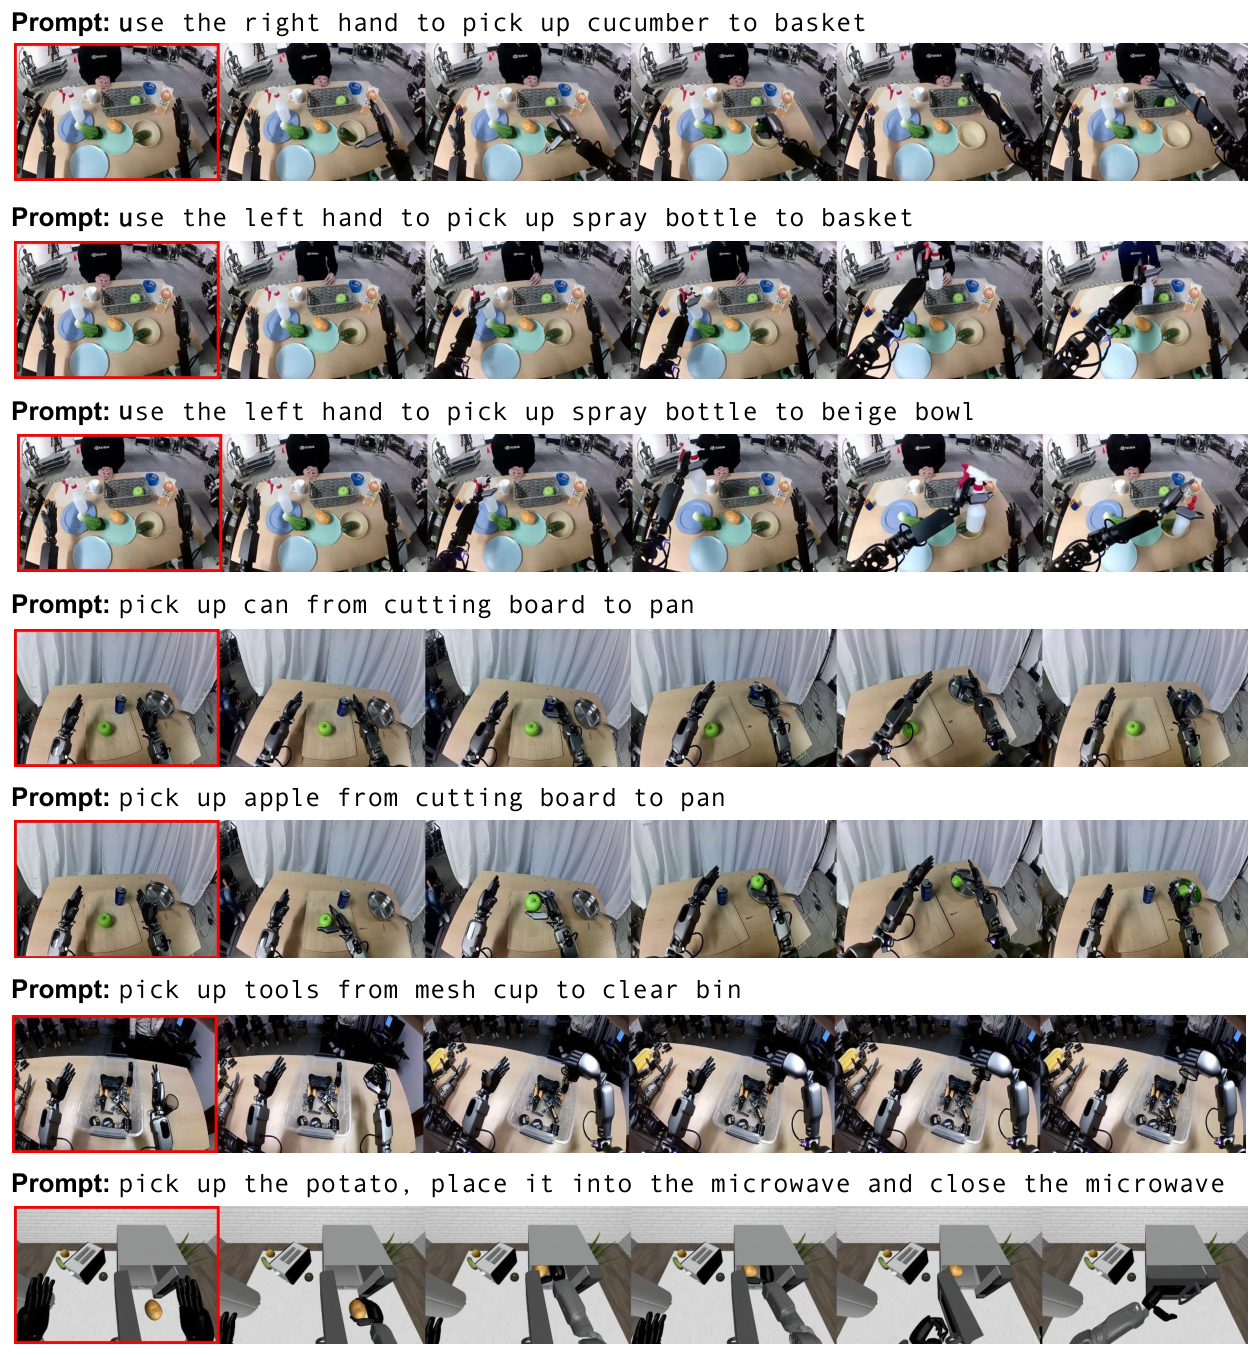
Los autores expanden 88,4 horas de teleoperación interna a 827,3 horas de video generado, casi diez veces más. La generación puede mover objetos de forma imposible, distorsionar contactos o deformar el robot, por lo que filtros basados en modelos de lenguaje y reglas eliminan muestras de baja calidad antes de que las acciones latentes o el IDM proporcionen supervisión.
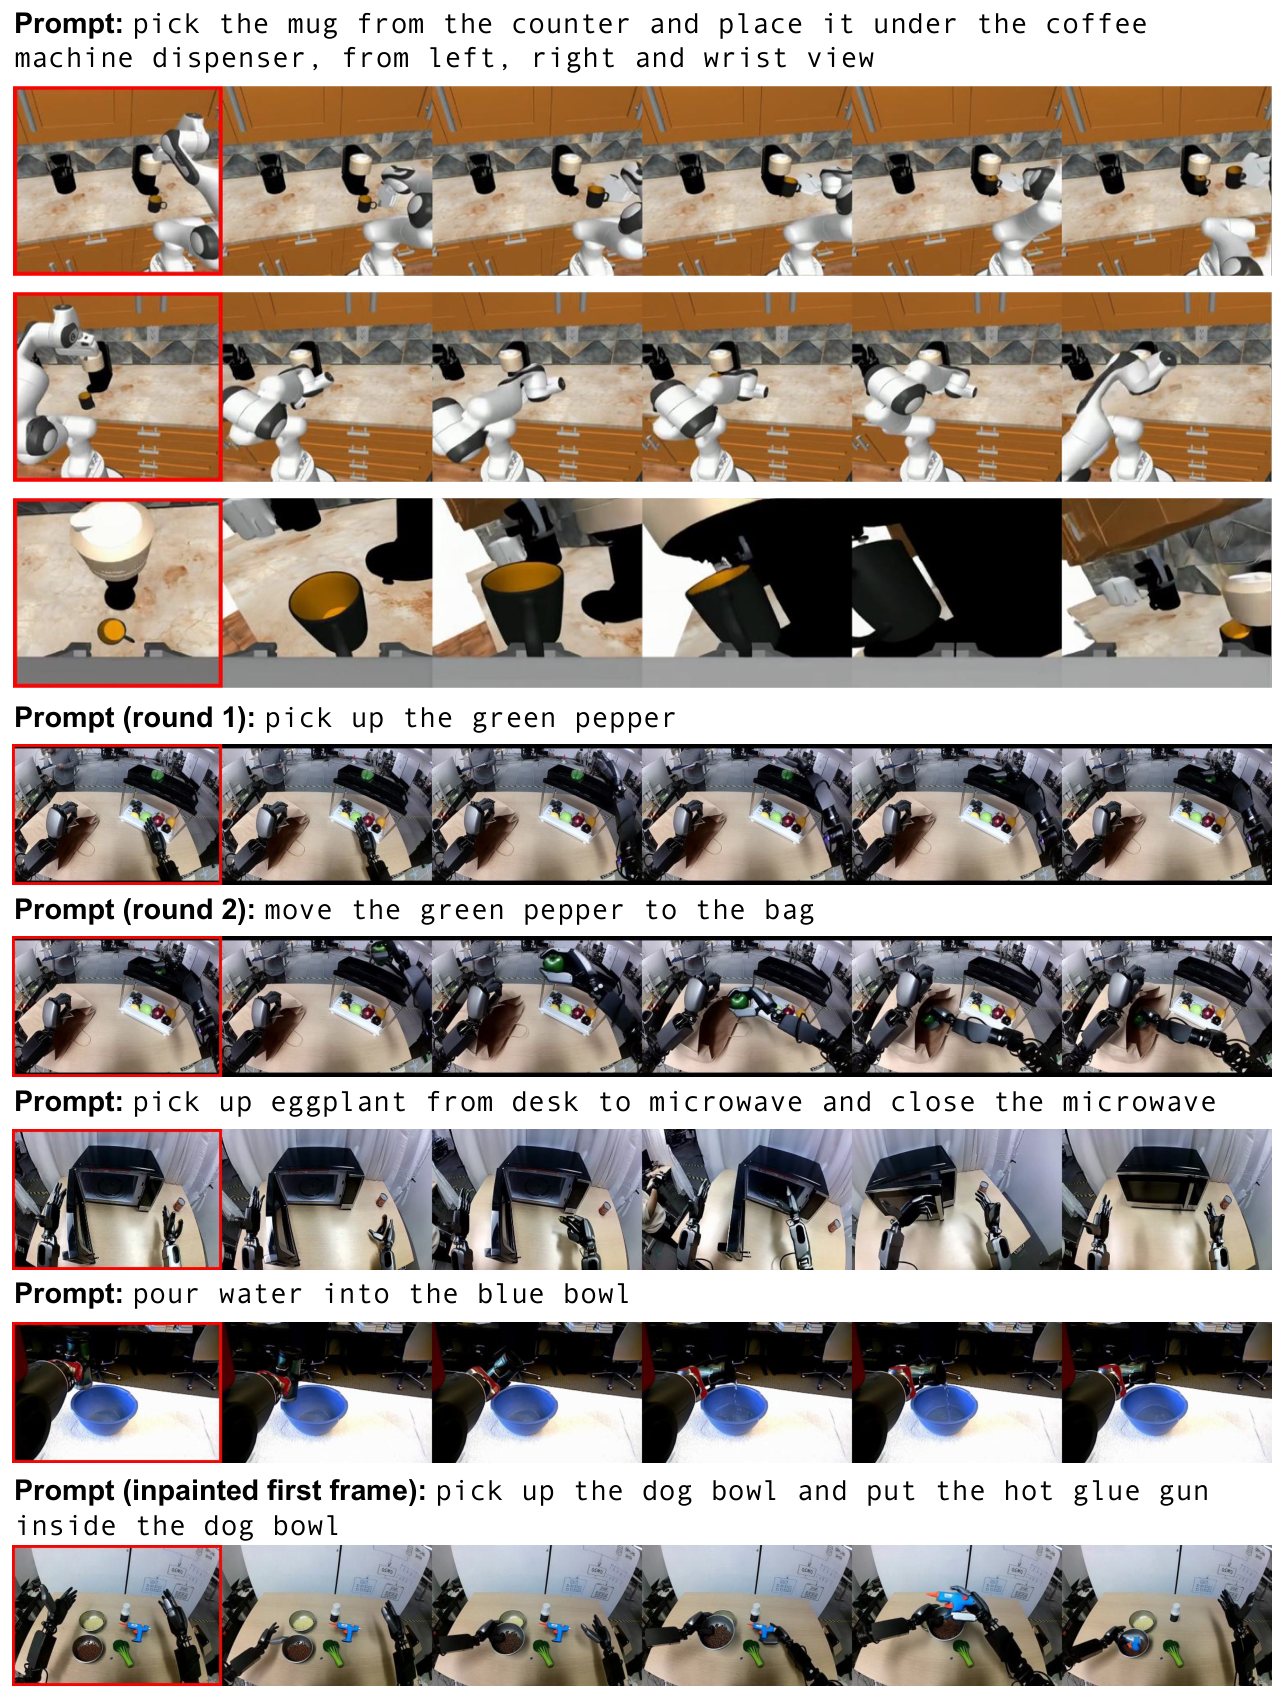
La simulación, en cambio, se ejecuta en un motor físico. Métodos como DexMimicGen reorientan demostraciones centradas en objetos a nuevas escenas, produciendo unas 780.000 trayectorias simuladas, aproximadamente 6.500 horas.
Diferencia:
-
Las trayectorias neuronales proporcionan variación visual y semántica pero una fiabilidad física limitada.
-
La simulación proporciona acciones exactas e interacciones físicas, pero mantiene una brecha sim-to-real.
Pre-entrenamiento y post-entrenamiento
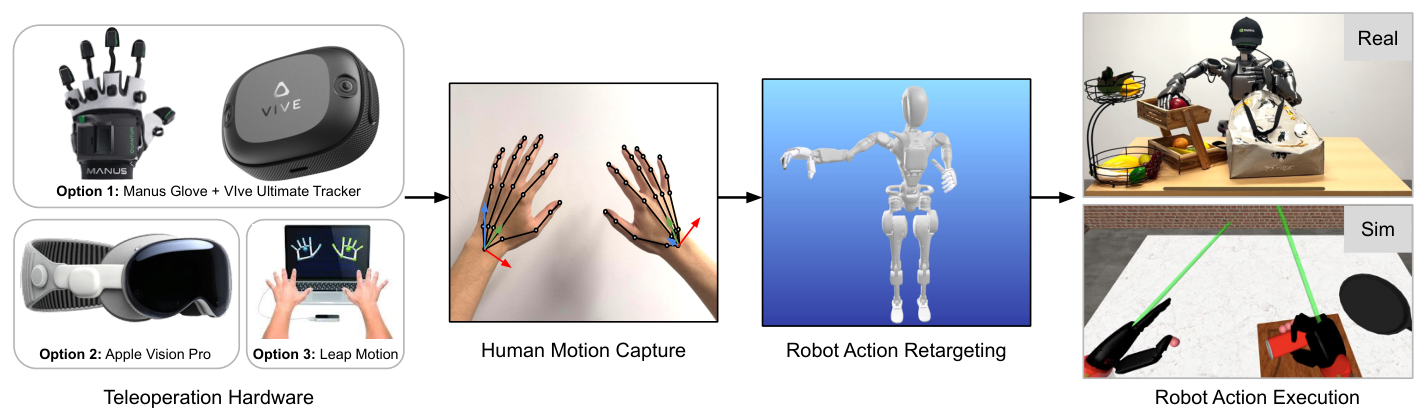
Los datos de teleoperación provienen de Manus, VIVE, Apple Vision Pro, Leap Motion y otros dispositivos, reorientados a los robots.
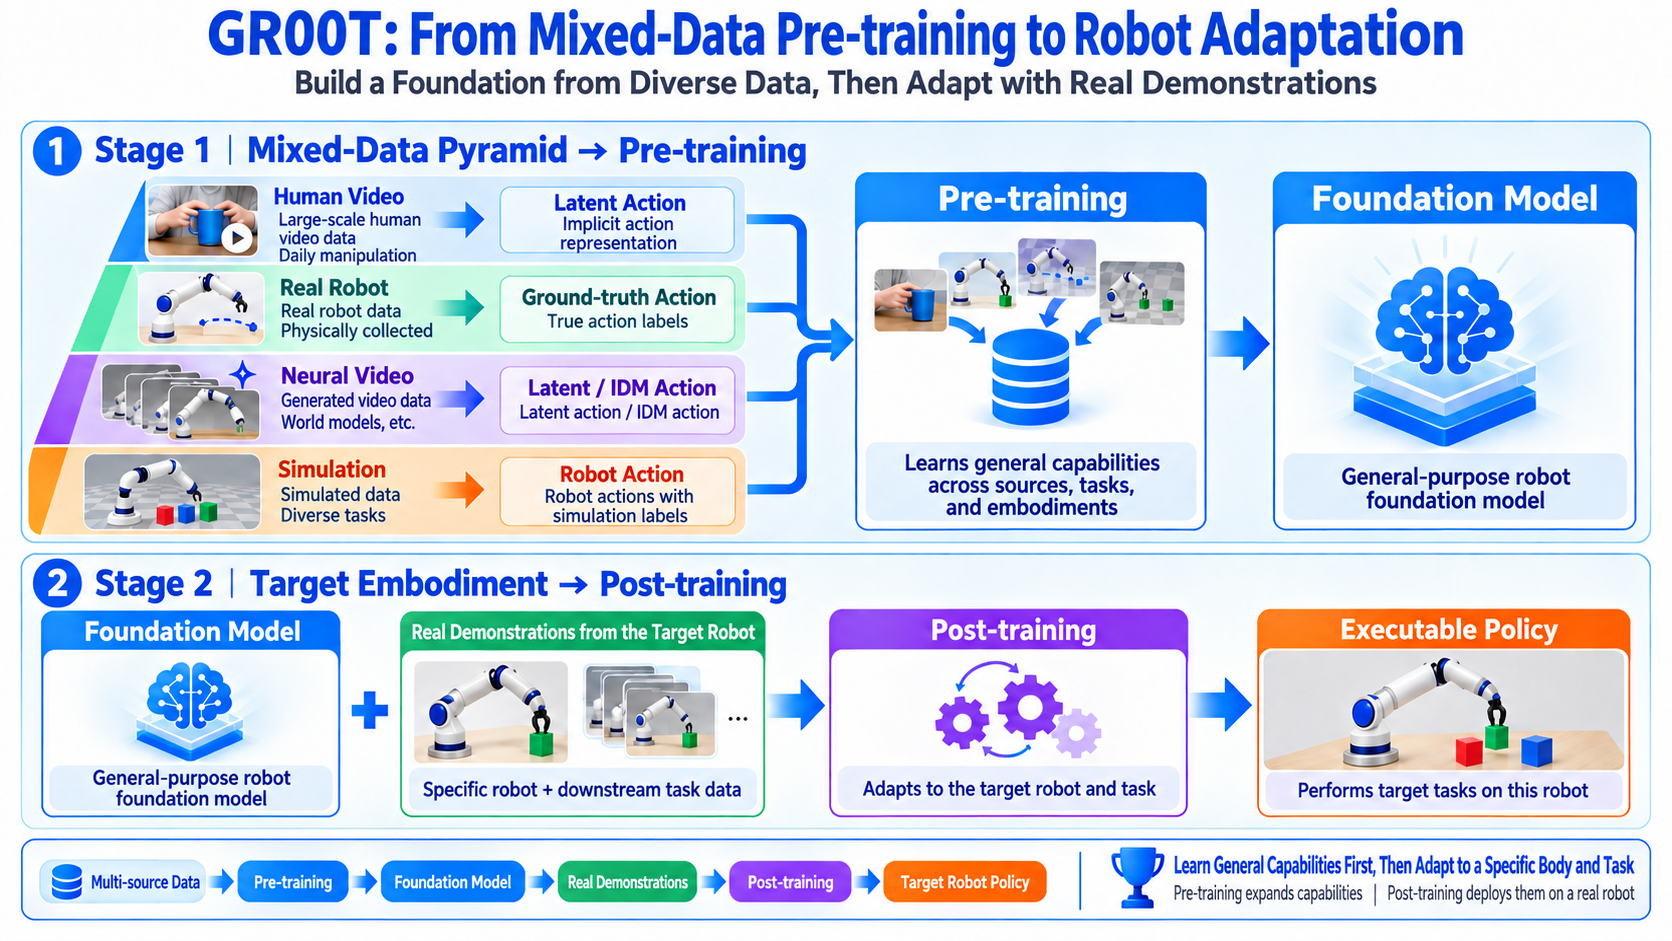
El post-entrenamiento no es ni entrenar desde cero ni control cero-shot inmediato de robots arbitrarios. Adapta la base a una configuración de cámara objetivo, estado, interfaz de acción y tarea.
| Configuración | Pre-entrenamiento | Post-entrenamiento |
|---|---|---|
| Tamaño de lote | 16.384 | 128 o 1.024 |
| Pasos de gradiente | 200.000 | 20.000-60.000 |
| Datos principales | Múltiples morfologías | Una morfología / tarea |
| Propósito | Priors generales | Adaptación a un cuerpo y tarea específicos |
El pre-entrenamiento de GR00T-N1-2B utiliza unas 50.000 horas de GPU H100. El conjunto de datos suma 8.375,7 horas y 592,9M de fotogramas.
Resumen en una frase: El pre-entrenamiento aporta experiencia amplia de mundos y cuerpos; el post-entrenamiento enseña al modelo a usar este robot en particular.
Experimentos y resultados
¿Cómo se evalúa la efectividad?
Las pruebas en simulación y en el mundo físico examinan los priors de pre-entrenamiento y la adaptación con datos limitados, en lugar de solo ajustar tareas de entrenamiento.
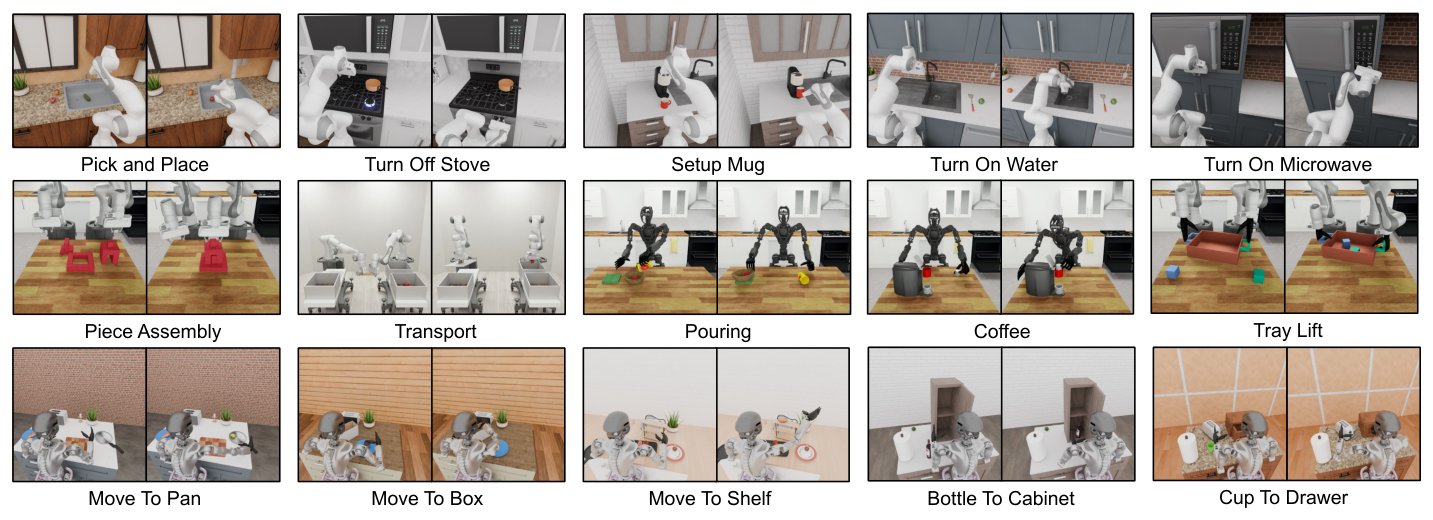
Los benchmarks de simulación incluyen:
-
RoboCasa Kitchen: 24 tareas de cocina.
-
DexMimicGen Cross-Embodiment Suite: nueve tareas de manipulación entre robots.
-
GR-1 Tabletop: 24 tareas humanoides de sobremesa.
Las pruebas reales con GR-1 incluyen pick-and-place, objetos articulados, manipulación industrial y cooperación multi-robot.
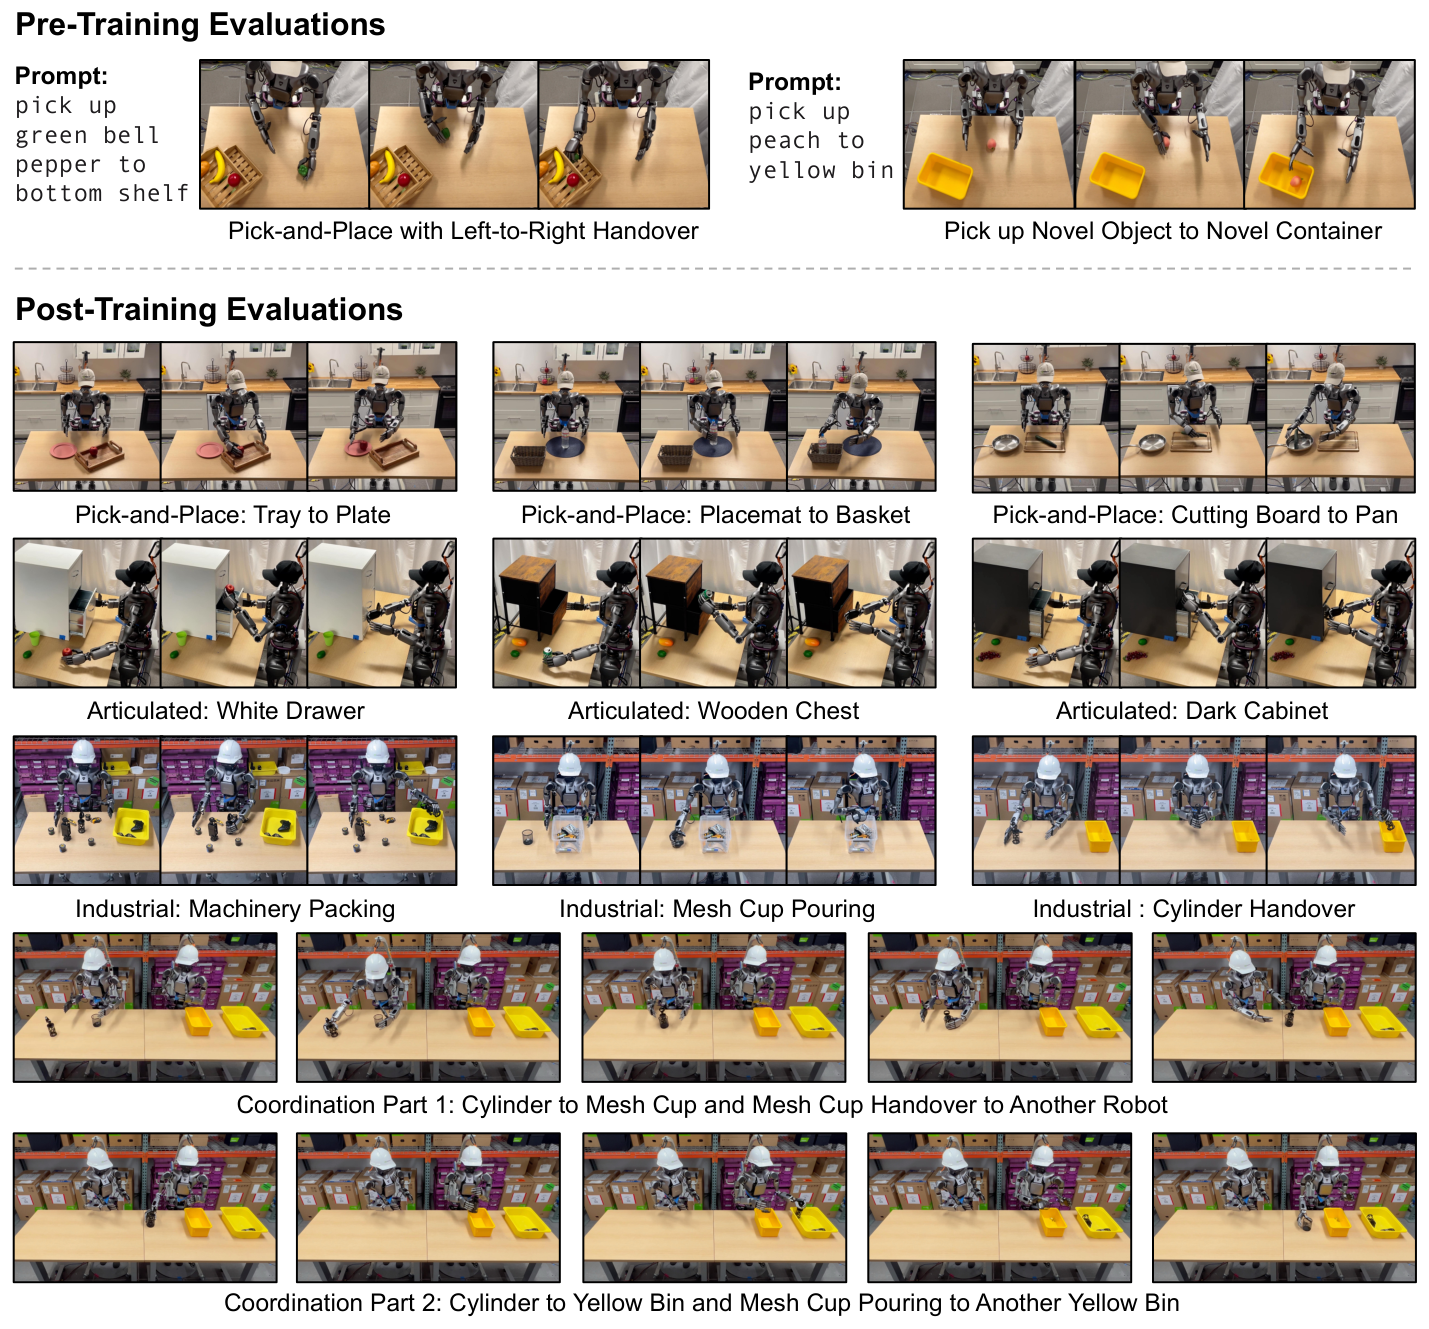
Las principales comparaciones son BC-Transformer y Diffusion Policy. GR00T N1 difiere no solo en tamaño y arquitectura sino en el pre-entrenamiento heterogéneo entre morfologías, por lo que los resultados reflejan también los datos y el entrenamiento.
¿Ayudan los priors con pocos datos?
El post-entrenamiento en simulación utiliza 30, 100 o 300 demostraciones por tarea. Las tendencias principales son:
-
Los priors ayudan más cuando los datos de la tarea son escasos.
-
Con más datos, una Diffusion Policy dedicada reduce la diferencia, pero GR00T N1 mantiene una fuerte eficiencia de datos.
-
En algunos escenarios, alrededor del 10% de los datos de la tarea se aproxima a una Diffusion Policy entrenada con todos los datos.
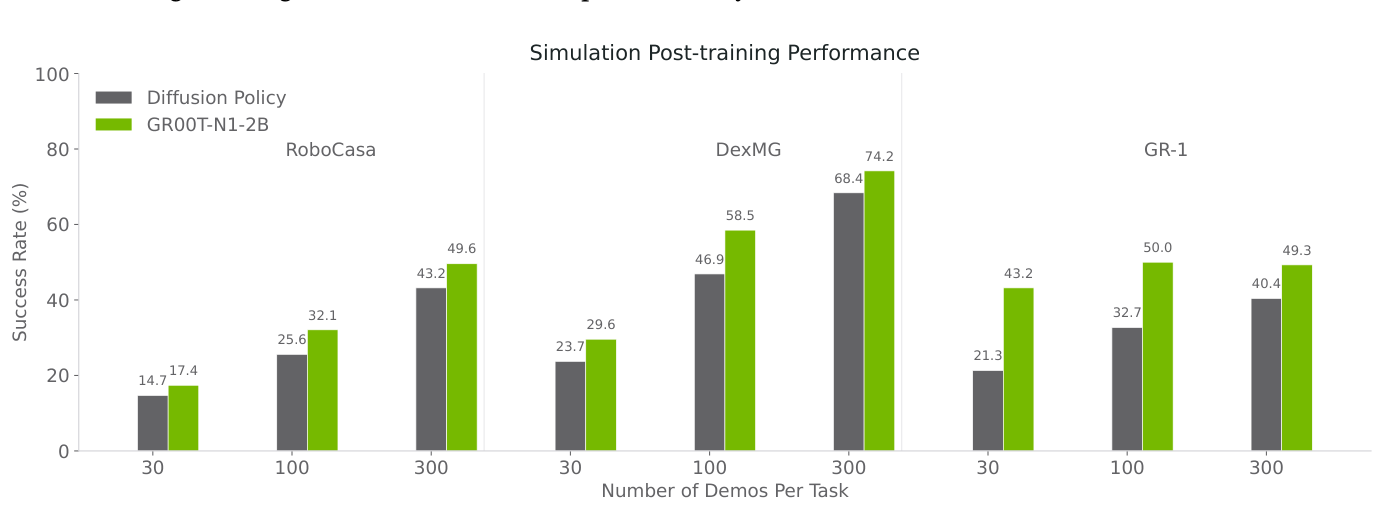
La implicación práctica es:
El valor de un modelo fundacional no es no necesitar datos; es aprender eficazmente desde un punto de partida pre-entrenado cuando tus datos son limitados.
¿Mejoran las trayectorias neuronales el comportamiento real?
Las ablaciones comparan solo datos reales, videos generados etiquetados con acciones latentes y videos generados con pseudo-acciones de IDM.
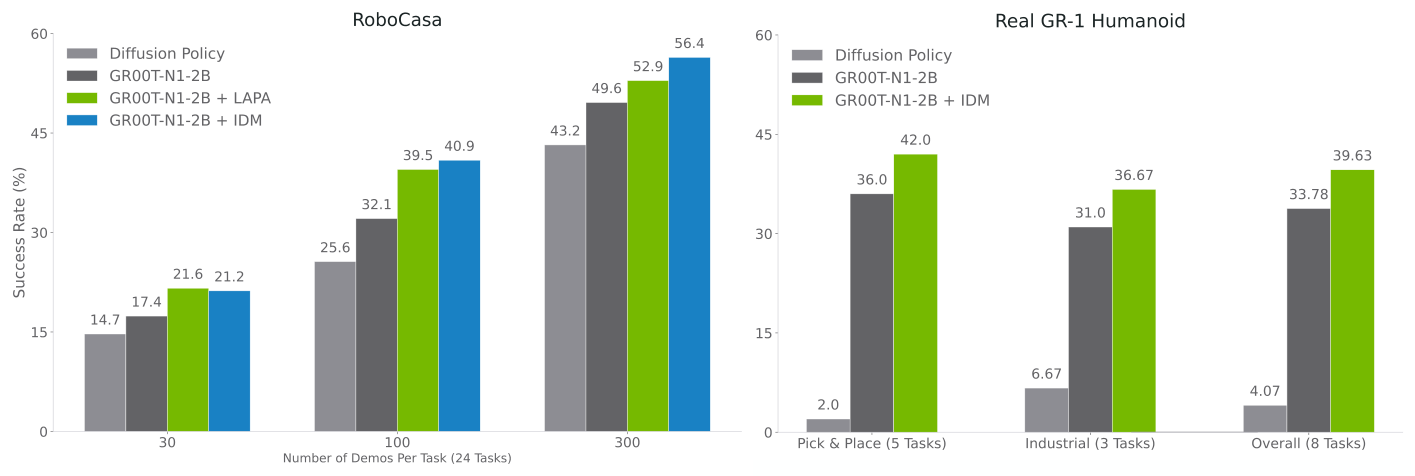
Las trayectorias sintéticas mejoran algunas tareas, y el IDM a menudo se conecta de forma más directa a los espacios de acción reales que los códigos latentes. Más generación no es automáticamente mejor: los errores físicos y el sesgo de pseudo-etiquetas también entran en el entrenamiento.
Los autores también observan transferencias espontáneas de mano izquierda a derecha en un modelo pre-entrenado que pueden desaparecer tras un post-entrenamiento en tareas estrechas.
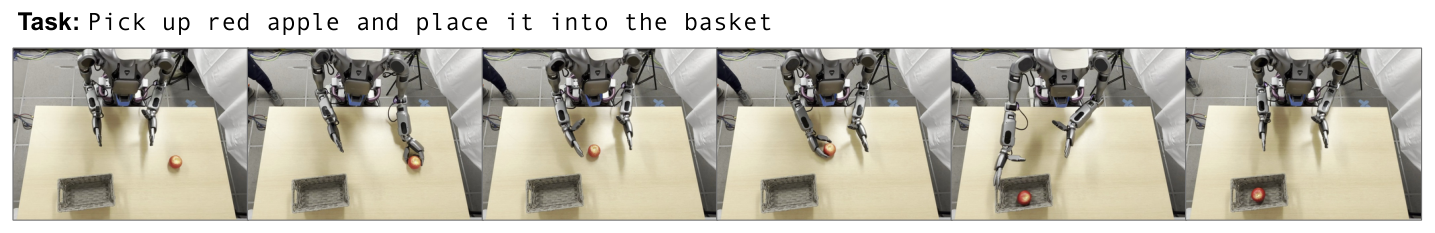
Esto ilustra el olvido catastrófico: un ajuste fino enfocado puede aumentar la puntuación objetivo mientras sobrescribe capacidades amplias pre-entrenadas.
Limitaciones, implicaciones prácticas y resumen
¿Qué sigue sin resolverse?
-
Principalmente tareas cortas de sobremesa. La navegación de larga duración, el movimiento de cuerpo completo y la planificación conjunta siguen siendo trabajo futuro.
-
Razonamiento espacial limitado. Reconocer un objeto no implica una comprensión precisa en 3D, de contacto o de fuerzas.
-
Inconsistencias físicas sintéticas. Un video que parece plausible no garantiza un movimiento ejecutable.
-
Olvido durante el post-entrenamiento. La adaptación debe evaluarse tanto por la retención de la generalización como por el éxito en el objetivo.
Conexión con la práctica de LeRobot
El apéndice de ingeniería amplía el formato de conjunto de datos de LeRobot. Almacenar números es insuficiente; sus significados deben definirse.
| Contenido | Información a especificar |
|---|---|
| Video | Nombres de cámaras, vistas, resolución, frecuencia de fotogramas y alineación temporal. |
| Estado | La articulación o pose representada por cada dimensión. |
| Acción | Objetivos absolutos o incrementales; controles de articulaciones o del efector final. |
| Lenguaje | Instrucciones asociadas con cada episodio. |
| Rotación | Matriz de rotación, ángulos de Euler, cuaternión o representación 6D. |
modality.json añade estas semánticas, abordando si el modelo entiende el séptimo número, no solo si puede abrir el archivo.
Para lectores con conjuntos de datos ACT, las consideraciones adicionales son:
| Etapa | Práctica ACT | Consideraciones adicionales para VLA fundacional |
|---|---|---|
| Recopilación | Alinear cámaras, estado y acciones. | Anotaciones de lenguaje estables. |
| Datos | Consistencia dentro de un robot. | Consistencia semántica entre morfologías. |
| Entrenamiento | Aprender una política a partir de demostraciones. | Post-entrenar un checkpoint fundacional. |
| Inferencia | Imagen + estado → fragmento de acción | Imagen + lenguaje + estado → fragmento de acción |
| Evaluación | Éxito en el robot | Éxito, generalización y retención de capacidades pre-entrenadas |