LingBot-VA: A Causal World Model from Future Images to Robot Actions
Modelado causal del mundo para el control de robots
- Generación de video-acción
- Historial causal
- Retroalimentación real
- Corrección asíncrona
Un robot necesita abrir una caja de entrega. Su cámara ve la caja y un cúter, pero una sola imagen no puede decirle si el precinto ha sido cortado, si la hoja está extendida o qué paso debe reintentar tras un fallo. Si un modelo solo produce el siguiente segmento de movimiento del brazo, la relación entre los cambios visuales y las consecuencias de las acciones debe permanecer implícita dentro de su política.
LingBot-VA hace explícita esta relación en la generación: predice posibles estados futuros en un espacio de video comprimido, genera acciones a partir de ellos y luego actualiza el contexto con imágenes reales tras la ejecución. Esto introduce desafíos: las imágenes imaginadas pueden ser inexactas, la generación de video lleva tiempo y el robot no puede seguir deteniéndose para esperar. Esta guía sigue cómo el futuro afecta a las acciones, cómo la retroalimentación real corrige las predicciones y cómo el cómputo encaja alrededor de la ejecución.
Requisitos previos: predecir imágenes y elegir acciones
Un modelo del mundo aprende cómo cambia el entorno. Cuando una pinza se eleva, por ejemplo, la tapa de una caja puede elevarse con ella o quedarse quieta si el agarre falló. Aquí, el mundo es la escena de manipulación visible para las cámaras; el término no implica un simulador físico completo y preciso.
La dinámica inversa infiere acciones a partir de un cambio de estado: si la pinza está actualmente fuera de la tapa y debería agarrarla a continuación, ¿cómo debe moverse y cerrarse? La dinámica directa predice las consecuencias a partir del estado actual y una acción dada. Responden, respectivamente, cómo lograr un cambio y qué causará una acción concreta.
Un latente de video es la representación producida cuando un VAE de video comprime imágenes. La mayor parte de la predicción ocurre en esta representación, sin requerir un video RGB reproducible antes de cada paso de control. Autoregresivo (AR) significa que la generación posterior depende del historial existente. Este modelo genera variables continuas en bloques, con múltiples actualizaciones de flow-matching dentro de cada bloque, en lugar de elegir una palabra discreta a la vez como hace un modelo de lenguaje.
Mantén separados tres escalas temporales: el tiempo real de ejecución del robot, los índices de bloques de video/acción y el tiempo de generación que convierte gradualmente ruido en datos. Una actualización de desruidoso adicional no ejecuta automáticamente otra acción del robot.
Resumen: paráfrasis y notas de lectura
Paráfrasis: Los autores sostienen que el modelado del mundo mediante video puede proporcionar una base para el aprendizaje de robots junto con el preentrenamiento visión-lenguaje. LingBot-VA es un marco de difusión autoregresivo que aprende conjuntamente la predicción de fotogramas futuros y la ejecución de políticas. Sus tres diseños principales integran tokens visuales y de acción en un espacio latente compartido mediante un Mixture-of-Transformers, actualizan continuamente los despliegues en lazo cerrado con observaciones reales y coordinan la predicción de acciones de forma asíncrona con la ejecución del robot. Experimentos en simulación y hardware examinan la manipulación de horizonte largo, la eficiencia de datos tras el entrenamiento y la generalización a nuevas configuraciones. Se publican el código y los modelos.
Nota de lectura: El primer diseño se refiere al intercambio de información, el segundo al contacto con el entorno real y el tercero a la latencia de generación en el bucle de control. Los tres deben funcionar juntos: una mejor predicción de imágenes no implica necesariamente mejores acciones, el historial almacenado no garantiza el manejo de perturbaciones y la operación asíncrona no justifica usar indefinidamente predicciones obsoletas. Las secciones siguientes evalúan estas afirmaciones mediante mecanismos y experimentos.
Introducción y trabajos relacionados: llevar la generación de video al control
El primer párrafo de la introducción identifica una carga de aprendizaje: cuando las acciones se predicen directamente a partir de observaciones, la semántica de la escena, los cambios físicos y el control motor se vinculan principalmente a través de la misma supervisión de demostraciones. Los autores llaman a esto entrelazamiento de representaciones y sugieren que aprender explícitamente la evolución del entorno puede mejorar la eficiencia de muestras y la generalización. La cuestión es si la supervisión de la dinámica entra explícitamente en el objetivo; los VLA con historial de observaciones también pueden usar información temporal.
El argumento se dirige entonces a los modelos del mundo existentes. Los simuladores neuronales interactivos predicen las consecuencias de las acciones, la difusión conjunta video-acción usa ambos tipos de supervisión y los enfoques que primero generan imágenes objetivo proporcionan metas visuales a una política. Sin embargo, predicciones largas sin retroalimentación real posterior se desvían de la ejecución, mientras que bloques sin contexto persistente pueden perder el estado de manipulación anterior. Por lo tanto, los autores predicen bloque a bloque a partir del historial e incorporan observaciones reales mediante una caché.
La Sección 5 divide el trabajo relacionado en políticas visión-lenguaje y modelos del mundo para robots. Estos últimos pueden predecir estados latentes de baja dimensión, nubes de puntos 3D o imágenes 2D. LingBot-VA sigue la generación de video, con cómputo en el espacio latente del VAE. Su contribución va más allá de una pérdida de video auxiliar: las representaciones futuras predichas participan en la generación de acciones en tiempo de inferencia.
Aquí, causal describe principalmente dependencias temporales y visibilidad de la atención. Organiza la generación en torno a la información disponible; no establece causalidad en el mundo real mediante intervenciones ni garantiza corrección física. La Sección 3.2 permite explícitamente atención bidireccional dentro de un bloque de generación. El límite causal separa principalmente los bloques históricos y futuros.
Proceso general: predecir el futuro y luego inferir acciones a partir del cambio
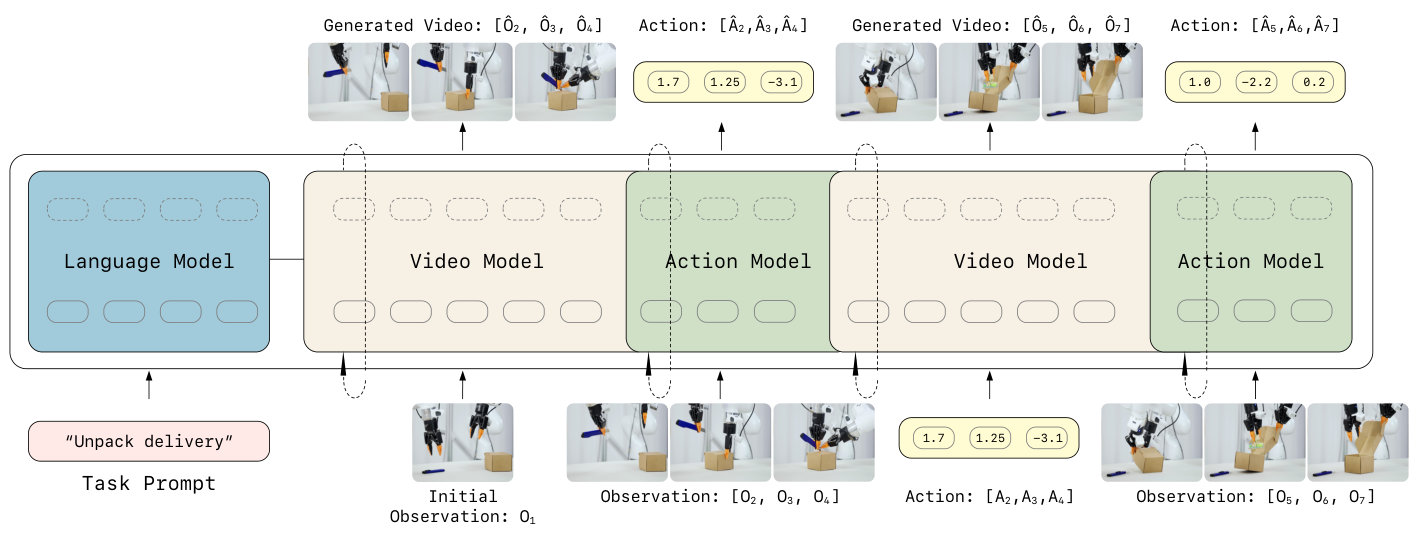
En la Figura 2, distingue primero las dos filas. La fila superior contiene imágenes y acciones predichas; la inferior aporta observaciones reales y acciones ejecutadas entre bloques. La generación a la derecha lee el contexto actualizado, de modo que una tapa imaginada como abierta no se convierte automáticamente en un hecho en el entorno.
Sea una observación, el estado latente del codificador de video causal, una acción y la instrucción en lenguaje. Las relaciones de condicionamiento en la Sección 3.2, Ecuaciones (8)–(9), pueden organizarse como:
La primera expresión predice latentes futuros; la segunda genera acciones condicionadas en ellos. Los sombreros indican predicciones. Siguiendo el indexado simplificado del artículo, cada estado futuro corresponde a un segmento de control; el sistema real empareja video más disperso con acciones más densas. El condicionamiento por lenguaje, omitido en algunas expresiones abreviadas del artículo, se escribe aquí explícitamente para dejar claro que las instrucciones son entradas.
Para abrir la tapa de una caja, las representaciones actual y futura predicha conjuntamente indican a la rama de acción adónde debe ir la garra y cómo debe cambiar la tapa. Las acciones y observaciones pasadas también ayudan a determinar si ya se ha agarrado. Una interfaz de control de bajo nivel ejecuta las acciones, y el resultado real se codifica de nuevo en el historial. Esta ruta genera acciones directamente a partir de estados predichos; no enumera trayectorias candidatas ni selecciona una usando una función de costo explícita.
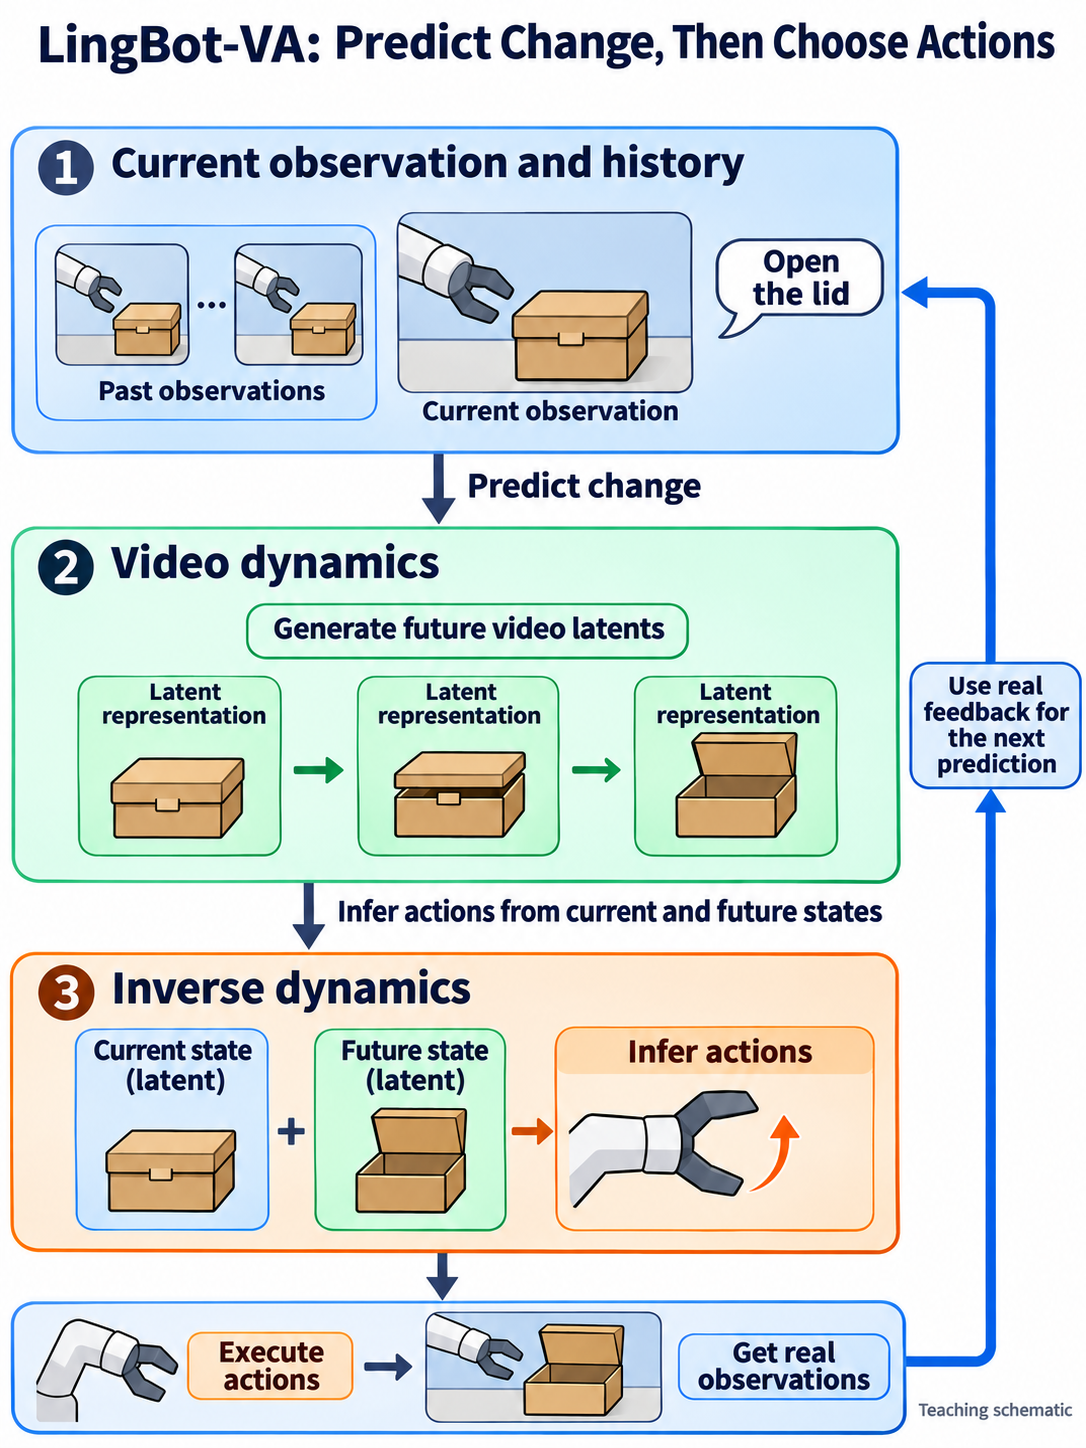
Ilustración didáctica: las cajas verdes son representaciones latentes predichas; la caja azul en la parte inferior proviene de la cámara real. Sigue la flecha de retroalimentación a la derecha para ver cómo la ejecución real actualiza la base para la siguiente predicción.
Cómo entran el video y las acciones en un solo modelo
Comprimir imágenes preservando diferentes tasas de muestreo
El artículo usa el VAE causal Wan2.2 para comprimir video aproximadamente 4 × 16 × 16 en tiempo, altura y anchura, y luego aplica una fragmentación espacial 2 × 2 para reducir tokens. Las codificaciones de múltiples cámaras se concatenan a lo largo de la anchura. La Sección 4.2 informa de 192 tokens espaciales por fotograma para su configuración. Esto depende de la resolución y la disposición de las cámaras y no es fijo en todas las configuraciones de LeRobot.
Los cambios visuales suelen ser más lentos que los cambios en los comandos de control. La Sección 3.3 usa : cada punto de tiempo de video retenido se asocia con 4 acciones. Generar de estos puntos de tiempo visuales corresponde por tanto a posiciones de acción. El muestreo disperso de video y la compresión temporal del VAE son operaciones separadas; no significan conjuntamente que el robot solo necesite mirar cada 16 pasos.
Ejemplo de forma: Con los valores predeterminados de LeRobot frame_chunk_size=4, action_per_frame=4 y action_dim=30, el ruido interno del flujo de acciones puede tener forma [1,30,4,4,1]: 16 posiciones temporales con 30 canales cada una. Los canales de acción válidos se seleccionan de la salida y se convierten a [batch,action_steps,robot_action_dimensions]. Este es un ejemplo de interfaz de la implementación fijada, más que una forma de tensor universal para todas las plataformas del artículo.
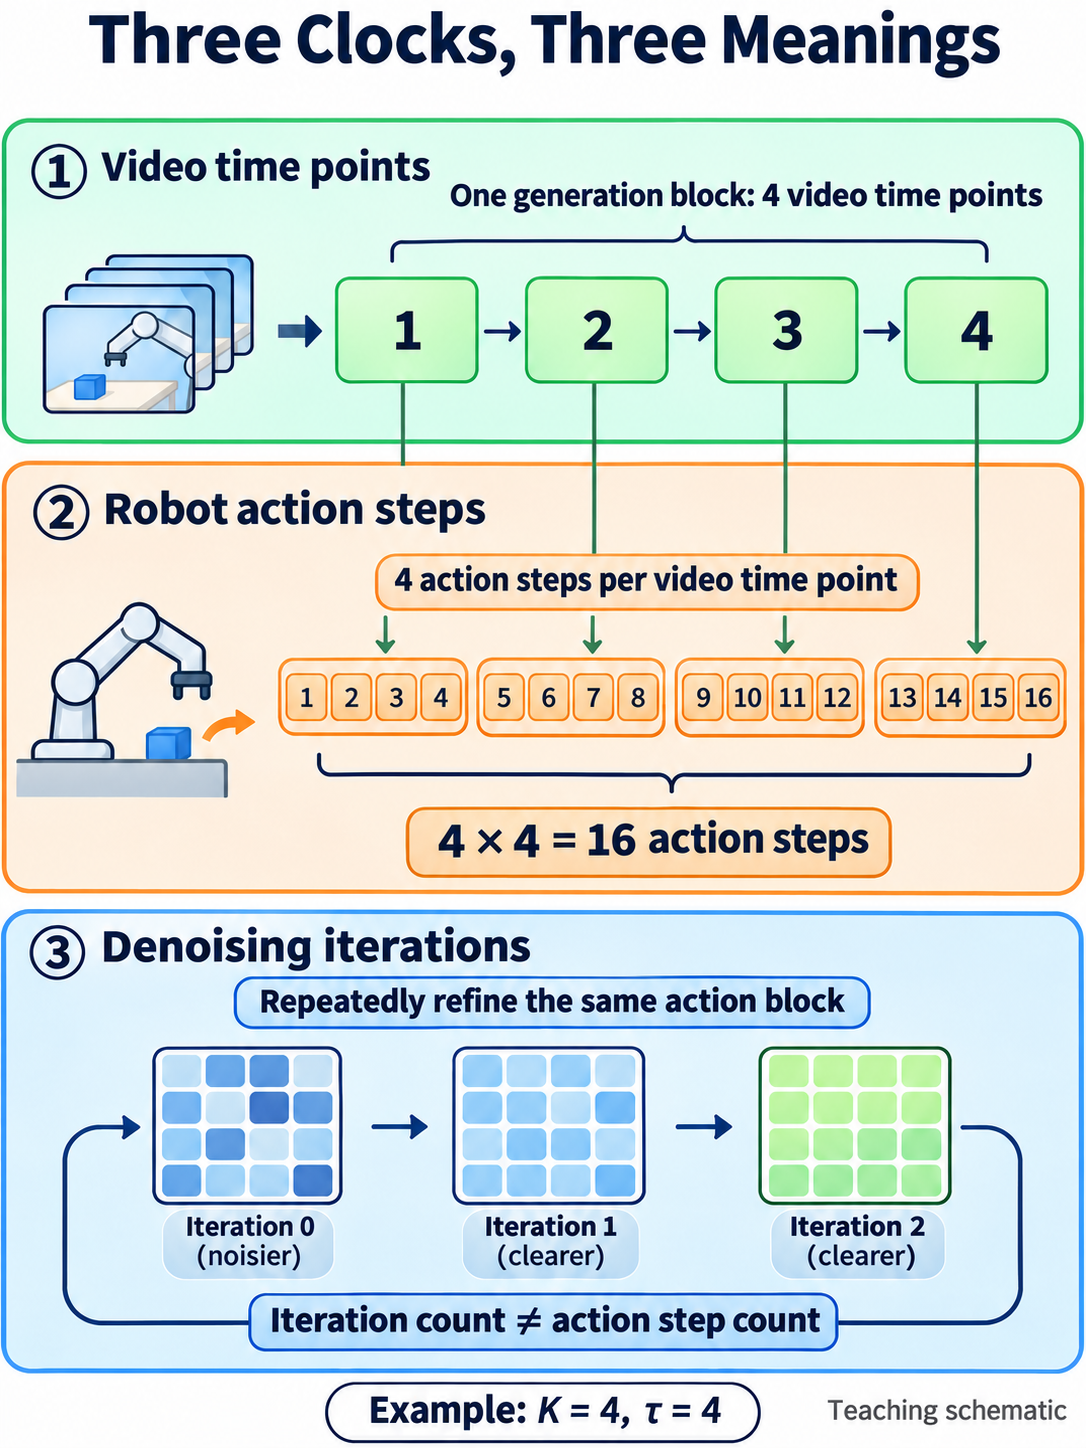
Ilustración didáctica: las dos filas superiores siguen el tiempo del robot; la fila inferior sigue el progreso de la generación. Cada actualización de desruido modifica el mismo fragmento de acciones sin añadir un punto de tiempo de ejecución.
MoT: procesamiento separado con intercambio basado en atención
El Mixture-of-Transformers (MoT) del artículo tiene dos ramas parametrizadas. La rama de video parte de Wan2.2-5B, con anchura oculta 3072 y 30 capas. La rama de acción tiene la misma profundidad pero anchura 768, añadiendo aproximadamente 350M de parámetros para un total de unos 5.3B. Los cambios visuales de alta dimensión reciben más capacidad, mientras que el control de baja dimensión usa una rama de acción más pequeña (Sección 4.2).
En cada capa, video y acciones forman consultas, claves y valores mediante sus propias proyecciones. Las características de acción se proyectan luego a un espacio para atención conjunta, intercambian información con las características visuales y regresan a la rama de acción. Una última cabeza lineal las mapea de vuelta a vectores de control. Un codificador T5 congelado aporta condicionamiento de texto mediante atención cruzada.
MoT aborda cómo las modalidades conservan su propio procesamiento mientras comparten información. El MoE de LingBot-VLA 2.0, en cambio, permite que los tokens seleccionen unos pocos expertos de feed-forward para distribuir capacidad y cómputo activo. Los nombres son similares, pero los mecanismos difieren.
Los autores también interpolan los pesos de video a la anchura de acción y escalan la inicialización por . Sustituyendo 3072/768=4 se obtiene $\alpha=2`. Esto estabiliza las distribuciones de salida tempranas entre ramas de diferentes anchuras. La Figura 7 compara la pérdida de entrenamiento, las normas de gradiente y la pérdida de validación, apoyando una mayor estabilidad que la inicialización aleatoria; estas curvas no son tasas de éxito del robot.
La arquitectura publicada y la arquitectura del artículo
El checkpoint publicado usa un backbone compartido, también integrado en LeRobot. Trata video y acciones como dos flujos de generación, con mapeos de entrada/salida separados pero bloques Transformer principales compartidos. Las ramas asimétricas 3072/768 del artículo y el total aproximado de 5.3B describen una organización de parámetros diferente y no pueden estimar directamente el tamaño o el cómputo del checkpoint con backbone compartido.
Entrenamiento: dos objetivos de flow matching y supervisión del historial
Del ruido al video y del ruido a las acciones
Siguiendo la dirección temporal de la Sección 2, sea latentes de video limpios y datos de acción, con ruido gaussiano independiente de las formas correspondientes:
Las redes aprenden objetivos de velocidad y , respectivamente. La Sección 3.3, Ecuaciones (11)–(12), define mediante el error de generación de latentes de video y mediante el error de generación de acciones condicionado en las representaciones visuales actuales y futuras. El objetivo total es:
El preentrenamiento usa $\lambda=1`. Ambos términos son errores cuadrados del campo de velocidades, en lugar de una suma directa de errores de píxeles y articulaciones. LeRobot además pondera por el tiempo de ruido y reduce el error de acción usando una máscara de canales válidos, por lo que los valores numéricos de la pérdida no pueden inferirse solo a partir de este coeficiente.
Cálculo didáctico: Simplifica un latente a un número, con valor de datos 0.2 y ruido 1.0. En , la entrada es 0.6 y la velocidad objetivo es 0.2−1.0=−0.8. Con un modelo preciso, una actualización de Euler de da 0.6+0.1×(−0.8)=0.52; integrando hasta 1 se llega a 0.2. El flujo de acciones aprende su propia dirección bajo su condicionamiento y ruido. Aquí, es el progreso de generación, no el tiempo de ejecución transcurrido del robot.
Teacher forcing: ¿qué historial es visible durante el entrenamiento?
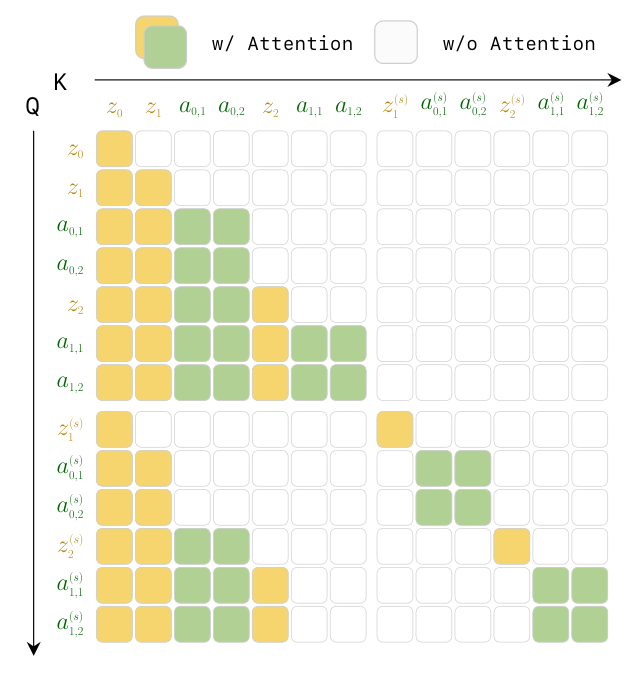
El teacher forcing condiciona el entrenamiento en el historial real de los datos, en lugar de desplegar primero una trayectoria completa predicha por el modelo. En la Figura 3, las filas son tokens que consultan y las columnas son claves legibles. El amarillo denota visión, el verde acciones y las entradas en blanco bloquean el acceso. La mitad superior organiza la caché de historial; la mitad inferior organiza los objetivos ruidosos. Esto no es una simple máscara triangular inferior que restrinja cada token individualmente: la generación de acciones debe leer las condiciones visuales futuras correspondientes, y se permite la generación conjunta dentro de un bloque.
Las acciones futuras reales no deben condicionar directamente la predicción actual. Los límites entre bloques de historial y de predicción permiten que el entrenamiento procese múltiples puntos de tiempo en paralelo en una sola pasada hacia adelante. Durante la ejecución, la retroalimentación de la cámara real vuelve a entrar en el historial, haciendo que algunas condiciones de entrenamiento se parezcan al despliegue. Los latentes futuros predichos, los errores de control y la latencia de la retroalimentación aún pueden causar desplazamiento de distribución.
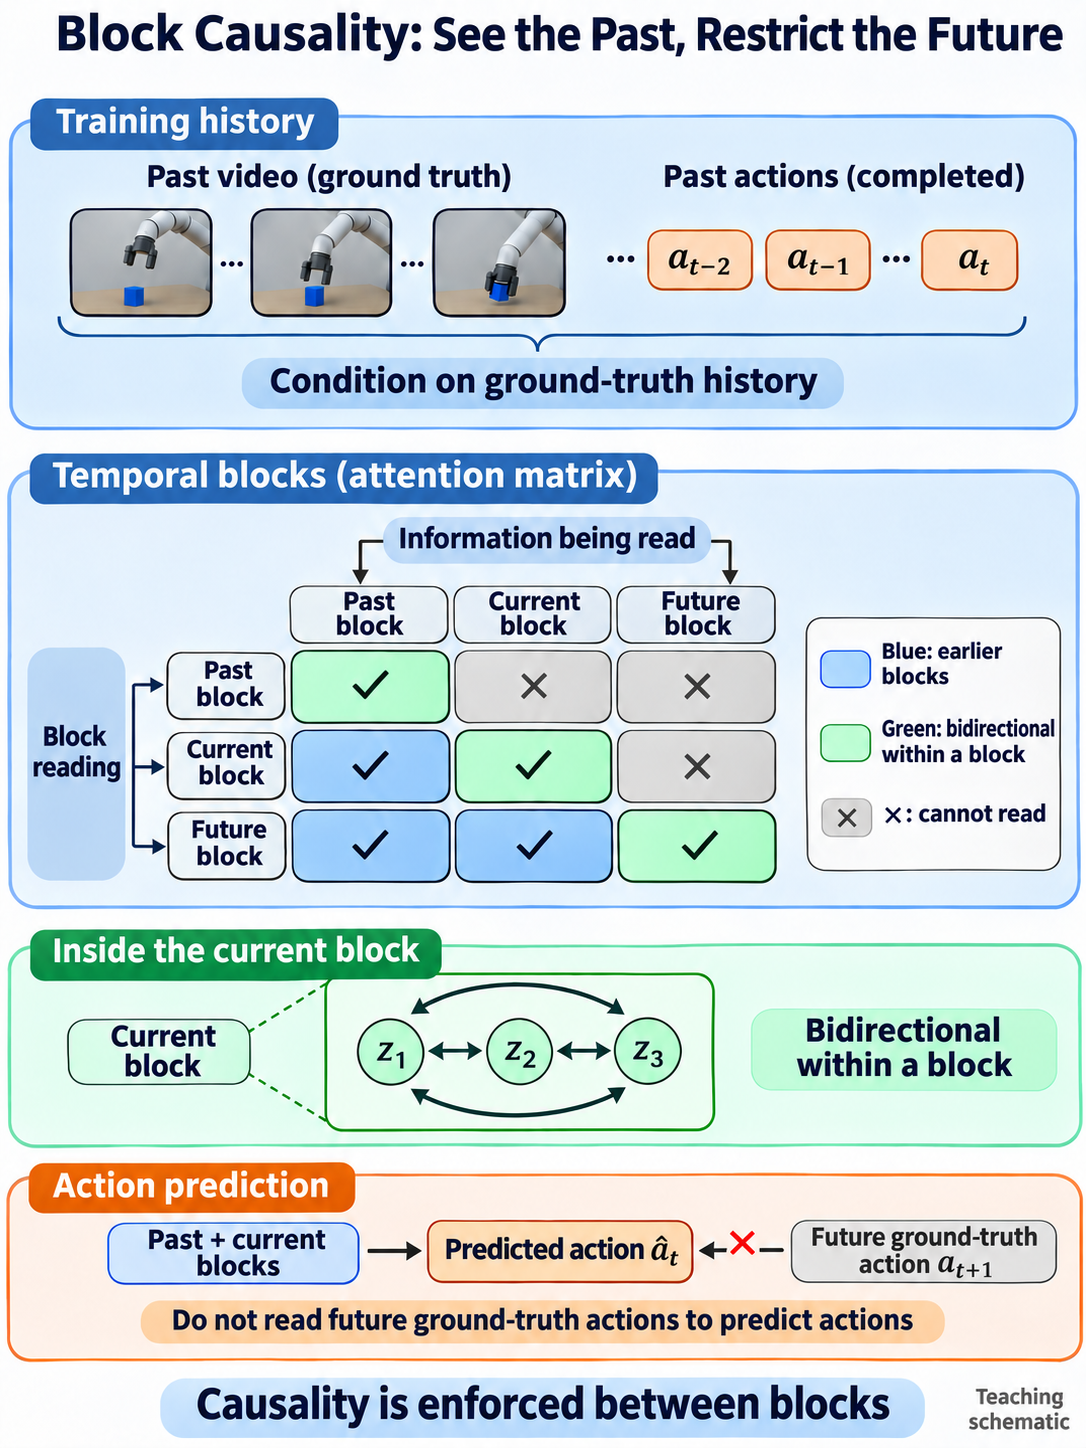
Ilustración didáctica: lee las filas para identificar quién está leyendo y luego las columnas para identificar qué se está leyendo. Esta matriz solo resume las relaciones temporales entre bloques. La Figura 3 del artículo define la visibilidad detallada entre los flujos de video y de acciones, en particular las conexiones de dinámica inversa con las condiciones visuales futuras correspondientes.
Historial ruidoso: generar acciones antes de que el video esté completamente desruido
La Ecuación (10) añade ruido al historial de video con probabilidad 0.5: , con muestreado de [0.5,1]; de lo contrario, el historial se mantiene limpio. Así, el flujo de acciones aprende a inferir acciones a partir de representaciones visuales que siguen siendo ruidosas pero contienen la estructura de la tarea.
Esto permite un desruido parcial del video en inferencia, reservando cómputo para las acciones. El Algoritmo 1 ilustra la integración hasta 0.5; la Sección 4.2 en realidad reporta 3 pasos de video hasta 0.6 y 10 pasos de acción hasta 1.0. Estos son, respectivamente, un algoritmo conceptual y una configuración experimental. En cambio, los valores predeterminados actuales de LeRobot usan 20 pasos de video y 50 pasos de acción, con video_exec_step=-1 desactivando el truncado temprano. Estos tres ajustes no son intercambiables, y la configuración de 3 pasos del artículo no puede estimar la velocidad del código predeterminado actual.
Ejecución en bucle cerrado: qué almacenar en caché y qué corregir
Actualizar la caché KV con retroalimentación real
La caché KV de un Transformer almacena las claves y valores formados por los tokens históricos en cada capa, evitando el recálculo de todo el historial. El Algoritmo 1 comienza con una observación inicial, predice latentes y acciones futuras, ejecuta las acciones actuales, recopila observaciones reales y añade latentes reales y acciones ejecutadas a la caché.
La caché almacena características internas del modelo. Pone el historial a disposición, mientras que el uso efectivo de ese historial sigue dependiendo del aprendizaje. El contexto también es finito. El LeRobot actual usa attn_window=30 y llama a reset para un nuevo episodio, vaciando la cola de acciones, la caché del Transformer y la caché de VAE en streaming. Esto no es ni memoria ilimitada ni retención automática de memoria entre tareas.
La asincronía requiere más que iniciar dos hilos
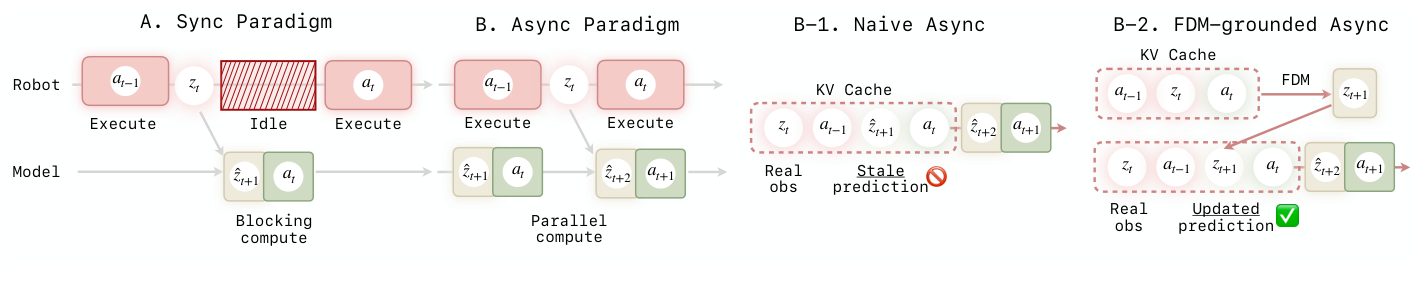
La secuencia sincrónica de la Figura 4A es ejecutar, observar, esperar a la generación y luego continuar la ejecución. El sombreado rojo marca la espera por cómputo. La Figura 4B predice el siguiente bloque mientras el robot ejecuta el actual, solapando ejecución y generación.
El coste es información obsoleta: el bloque actual no ha terminado cuando se predice el siguiente. Si el modelo solo reutiliza imágenes imaginadas, aún puede creer que la tapa está agarrada a pesar de que observaciones reales recientes muestran un deslizamiento. La Figura 4B-1 ilustra cómo estas predicciones antiguas siguen ocupando el contexto.
El artículo llama a esto anclaje mediante Modelo de Dinámica Directa (FDM): un cálculo de dinámica directa que corrige predicciones obsoletas. Partiendo de la última observación real y de las acciones que se están ejecutando actualmente, vuelve a predecir su resultado y luego usa este estado futuro realineado para predecir el video y las acciones posteriores. Usa la capacidad de predicción hacia adelante del modelo; el artículo no requiere un simulador completamente separado. El post-entrenamiento añade la pérdida de predicción hacia adelante en la Ecuación (13), mientras que el Algoritmo 2 describe la coordinación entre las ramas de ejecución e inferencia.
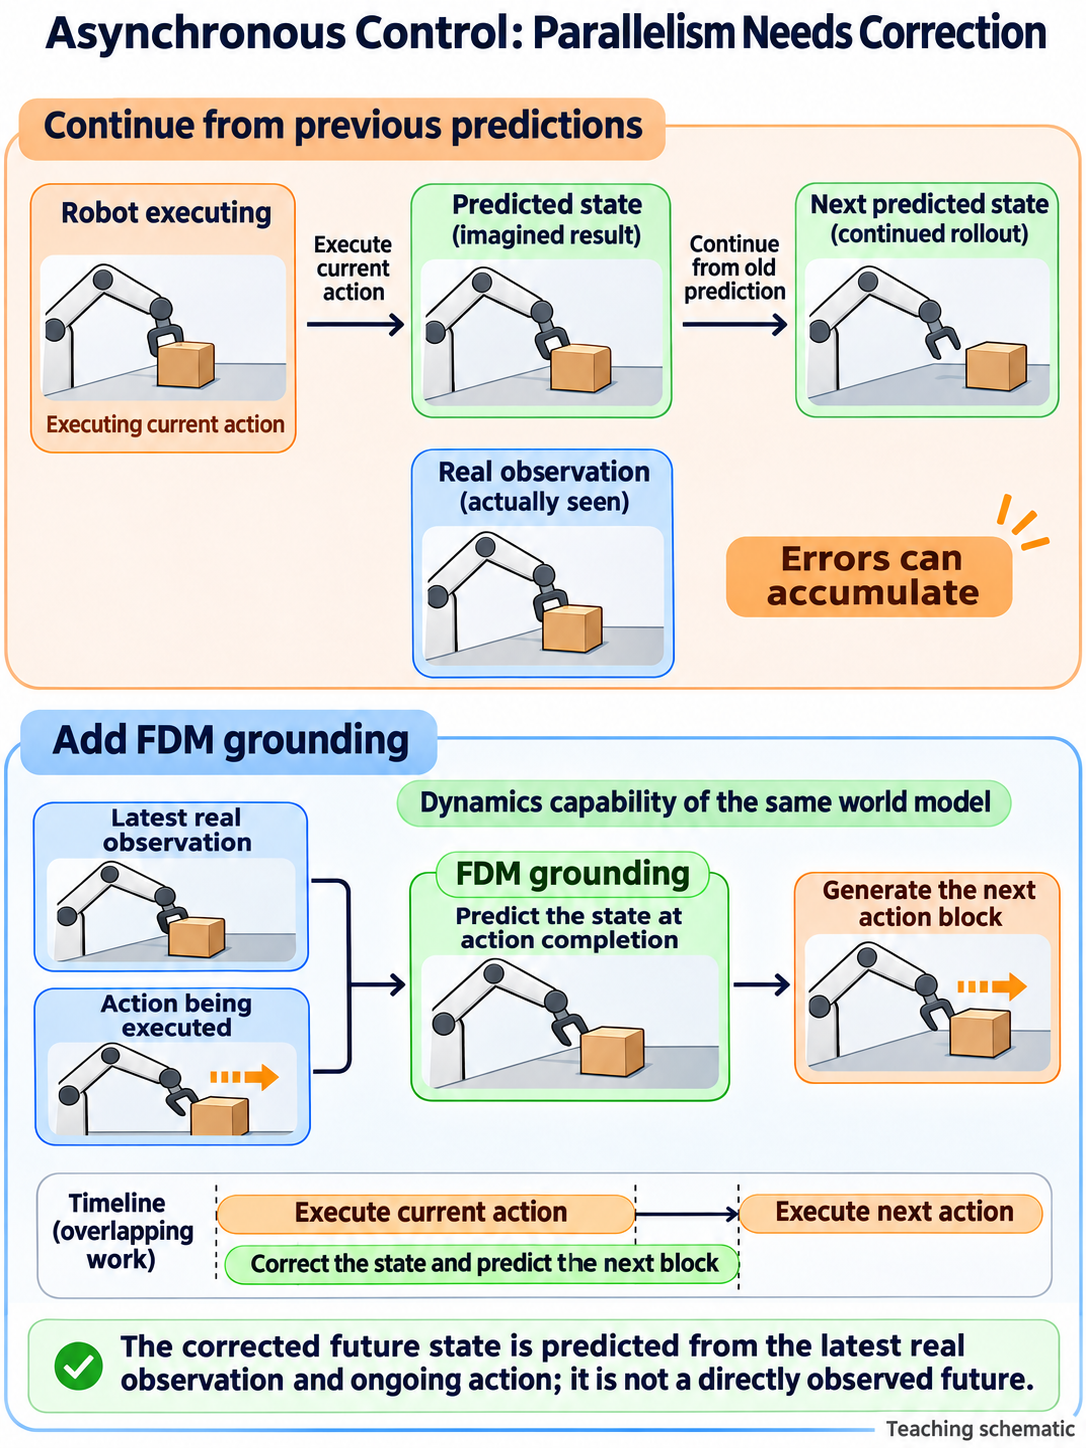
Ilustración didáctica: las dos rutas difieren en si la última retroalimentación se usa para predecir de nuevo las consecuencias de las acciones actuales. La línea de tiempo inferior muestra cómputo y ejecución solapados, no observación directa del futuro ni proporciones de tiempo fijas.
Ejemplo de temporización: Supón que ejecutar el fragmento actual toma 320 ms y generar el siguiente toma 180 ms. Un ciclo sincrónico toma aproximadamente 320+180=500 ms. Si la ejecución cubre completamente la generación, el ciclo ideal en pipeline es de unos 320 ms, una relación de velocidad de 500/320=1.56. Este ejemplo didáctico ignora comunicación, arranques en frío y esperas de retroalimentación; no es una medición del artículo. La asincronía reduce la espera pero no convierte observaciones obsoletas en actuales.
El select_action actual de LeRobot espera hasta que la cola de acciones esté vacía, actualiza la caché con fotogramas clave reales en búfer y el bloque de acción precedente, y luego genera video y acciones en serie. Implementa retroalimentación real entre bloques. El Algoritmo 2 además requiere ejecución y predicción en paralelo, más el anclaje FDM de predicciones obsoletas.
Datos, representación de acciones y etapas de entrenamiento
La Sección 4.1 enumera seis fuentes—AgiBot, RoboMind, InternData-A1, el subconjunto OpenVLA de OXE, la familia UMI excluyendo DexUMI y RoboCOIN—más trayectorias recopiladas internamente, sumando aproximadamente 16,000 horas de datos de manipulación robótica. Cada conjunto de datos se divide 90%/10% para entrenamiento y validación. El conocimiento de video de Internet entra principalmente a través de la inicialización Wan; estas 16,000 horas no deben describirse como video humano completamente sin etiquetas de acción.
El espacio de acción canónico asigna a cada brazo 7 dimensiones de pose del efector final, hasta 7 dimensiones articulares y 1 dimensión de pinza: 2×(7+7+1)=30 para dos brazos. Las articulaciones faltantes se rellenan. Las poses del efector final y las posiciones articulares son representaciones de control diferentes; las casillas no representan 30 grados de libertad físicos independientes.
En las interfaces publicadas, LIBERO usa 7 canales para los deltas del efector final y la pinza. RoboTwin usa 16 canales para XYZ+cuaternión+pinza de dos brazos, y luego los convierte en trayectorias articulares con cinemática inversa de CuRobo. Aunque la estructura de 30 dimensiones reserva casillas articulares, estos dos checkpoints publicados no predicen directamente posiciones articulares. Solo el relleno no completa la adaptación a un conjunto de datos personalizado en espacio articular.
| Etapa | Información aprendida o utilizada | Ajustes para distinguir |
|---|---|---|
| Inicialización | Prior de generación de video Wan2.2; VAE de video y codificador de texto congelados | Las ramas asimétricas del artículo difieren de la versión actual con backbone compartido |
| Preentrenamiento video-acción | Video de robot, acciones y lenguaje; objetivos de dinámica y dinámica inversa | El artículo reporta 1.4T tokens, tasa de aprendizaje máxima 1e-4, BF16 y |
| Post-entrenamiento downstream | Demostraciones de la plataforma y tareas objetivo | Ejemplo de adaptación general: 1e-5, 3K pasos; seis tareas de hardware: 50 demostraciones por tarea, 1e-4, 500 pasos |
| Despliegue | Instrucción, imágenes iniciales, retroalimentación real posterior e historial de acciones | Acciones de salida; la decodificación de video puede inspeccionar predicciones y no necesita ejecutarse en cada paso de control |
La sección de método usa [1,8] para ilustrar longitudes de fragmento variables; la Sección 4.2 reporta entrenamiento real con [1,4]. Las tasas de aprendizaje y los conteos de pasos de post-entrenamiento también varían según la plataforma objetivo y el experimento.
Experimentos: evidencias y condiciones
Simulación: comparar dentro de la misma evaluación
El entrenamiento de RoboTwin 2.0 usa 2,500 demostraciones limpias y 25,000 aleatorizadas en 50 tareas, o 50 y 500 por tarea. El video se submuestrea de 50 Hz a 12.5 Hz mientras que las acciones permanecen a 50 Hz. Easy fija configuraciones iniciales; Hard aleatoriza poses de objetos y disposiciones de escena (Sección 4.3.2).
| Método | RoboTwin Easy | RoboTwin Hard |
|---|---|---|
| π0.5 | 82.7% | 76.8% |
| Motus | 88.7% | 87.0% |
| LingBot-VA | 92.93% | 91.55% |
La Tabla 1 reporta el éxito medio en 50 tareas. Los márgenes sobre Motus son de aproximadamente 4.2/4.6 puntos porcentuales, u 8.2/9.1 puntos en el grupo Horizon=3. Aquí, el horizonte agrupa pasos de tarea; no es la longitud del fragmento de generación . La Tabla S1 del apéndice también conserva debilidades: Hanging Mug alcanza solo 40%/28% y Turn Switch 44%/45%, lo cual no debería quedar oculto por las medias globales.
Cada uno de los cuatro conjuntos LIBERO contiene 10 tareas con 50 demostraciones por tarea. El artículo reporta 3 semillas aleatorias por conjunto y 500 evaluaciones por semilla, sumando 1,500 por conjunto. La Tabla 2 da:
| Método | Spatial | Object | Goal | Long | Promedio |
|---|---|---|---|---|---|
| X-VLA | 98.2 | 98.6 | 97.8 | 97.6 | 98.1 |
| LingBot-VA | 98.5 ± 0.3 | 99.6 ± 0.3 | 97.2 ± 0.2 | 98.5 ± 0.5 | 98.5 |
Los valores son tasas de éxito en %. LingBot-VA no supera a X-VLA en Goal. Los valores de referencia provienen del artículo de X-VLA, sin condiciones de entrenamiento e implementación totalmente igualadas. Se conservan los valores ± originales; el artículo no especifica si son desviaciones estándar, errores estándar o intervalos de confianza. Las altas tasas de éxito se aplican a estas tareas y protocolos de simulación.
Hardware: el éxito y el progreso pueden contar historias diferentes
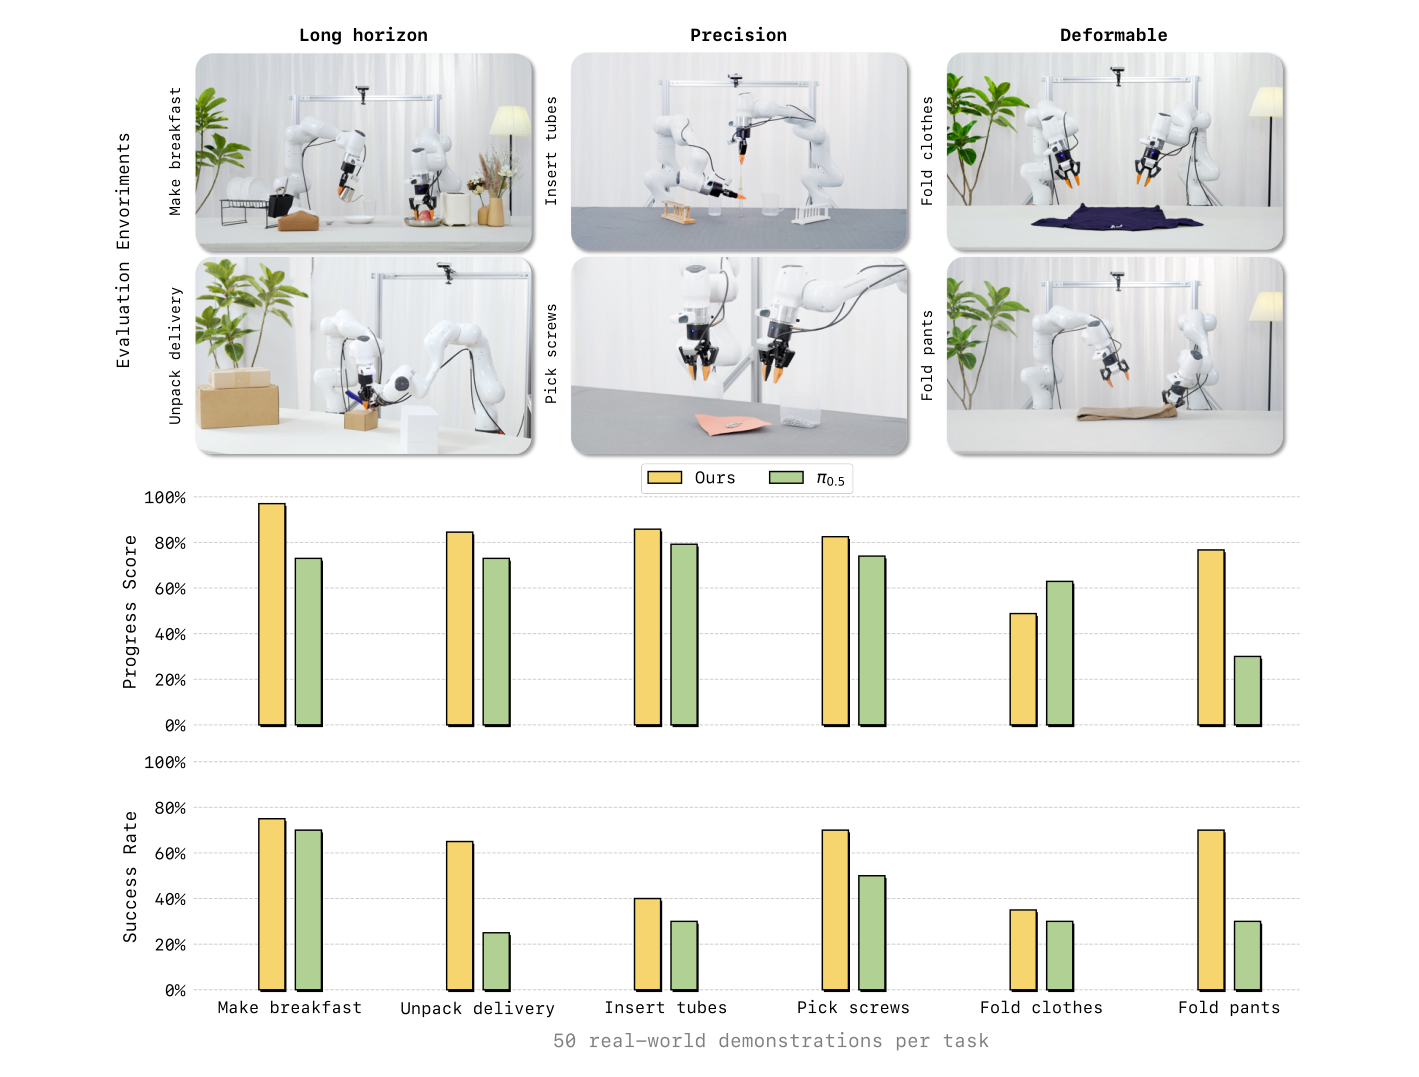
La parte superior de la Figura 5 muestra seis tareas: Make Breakfast, Unpack Delivery, Insert Tubes, Pick Screws, Fold Clothes y Fold Pants. Cada tarea usa 50 demostraciones con robot real para el post-entrenamiento. Las Tablas S2–S7 del apéndice enumeran cada una 20 evaluaciones. La puntuación de progreso es la puntuación de subpaso dividida por la puntuación máxima; la tasa de éxito se calcula a partir de las etiquetas de Success de los ensayos y no puede inferirse simplemente de si el progreso alcanza su máximo.
| Tarea | Puntuación de progreso / tasa de éxito de LingBot-VA | Puntuación de progreso / tasa de éxito de π0.5 |
|---|---|---|
| Make Breakfast | 97.0 / 75.0 | 73.0 / 70.0 |
| Unpack Delivery | 84.5 / 65.0 | 73.0 / 25.0 |
| Insert Tubes | 85.8 / 40.0 | 79.2 / 30.0 |
| Pick Screws | 82.5 / 70.0 | 74.0 / 50.0 |
| Fold Clothes | 48.8 / 35.0 | 62.9 / 30.0 |
| Fold Pants | 76.7 / 70.0 | 30.0 / 30.0 |
Todos los valores son porcentajes, tomados de las tablas del apéndice. El éxito en el desayuno es 15/20=75%: incluso con un progreso medio del 97%, una cuarta parte de los ensayos carecen de etiqueta de éxito. El doblado de ropa tiene un ensayo exitoso más pero una puntuación media de progreso 14.1 puntos menor. Esto difiere de la afirmación general del texto principal de liderar en ambas métricas para las seis tareas; la Figura 5 en sí muestra el contraejemplo.
La tabla arroja tasas medias de éxito de aproximadamente 59.2% y 39.2%, pero un ensayo en hardware corresponde a 5 puntos porcentuales. Los resultados respaldan una mejora general en este conjunto de tareas, sin aislar la contribución causal de cada componente. Tampoco significan 50 demostraciones de la tarea objetivo que el modelo se entrenó desde cero solo con 50 muestras.
Ablaciones de asincronía y preentrenamiento: beneficios con costes
La Tabla 3 informa lo siguiente en RoboTwin Easy:
| Configuración | Éxito medio en todas las tareas | Horizon=3 |
|---|---|---|
| Fila de referencia de LingBot-VA | 92.9% | 93.2% |
| Asíncrono con FDM grounding | 90.4% | 85.6% |
| Asíncrono ingenuo | 74.3% | 32.9% |
| Post-entrenamiento desde inicialización WAN | 80.6% | 67.6% |
FDM grounding mejora sobre la asincronía ingenua en 16.1 puntos porcentuales en general y 52.7 en el grupo de tareas largas, lo que respalda la realineación de predicciones obsoletas con la retroalimentación. Aun así queda por detrás de la fila de referencia en 2.5 puntos en general y 7.6 en tareas largas. Los autores informan aproximadamente 2× de velocidad para la ejecución asíncrona, pero la tabla no indica tiempos ni hardware de prueba. Las tasas de éxito muestran un coste de rendimiento al reducir la espera. El resultado de velocidad tampoco se aplica directamente a la ruta de generación en serie actual de LeRobot.
La diferencia entre la inicialización WAN y el preentrenamiento completo respalda el valor del preentrenamiento de video-acción de robot. Esta comparación cambia la experiencia de preentrenamiento, por lo que toda la brecha no puede atribuirse a un solo módulo de atención. La Tabla 3 no compara directamente AR y modelado del mundo bidireccional y, por lo tanto, no cuantifica por separado el beneficio de la estructura autoregresiva.
Lo que muestran las pruebas de few-shot, memoria y generalización
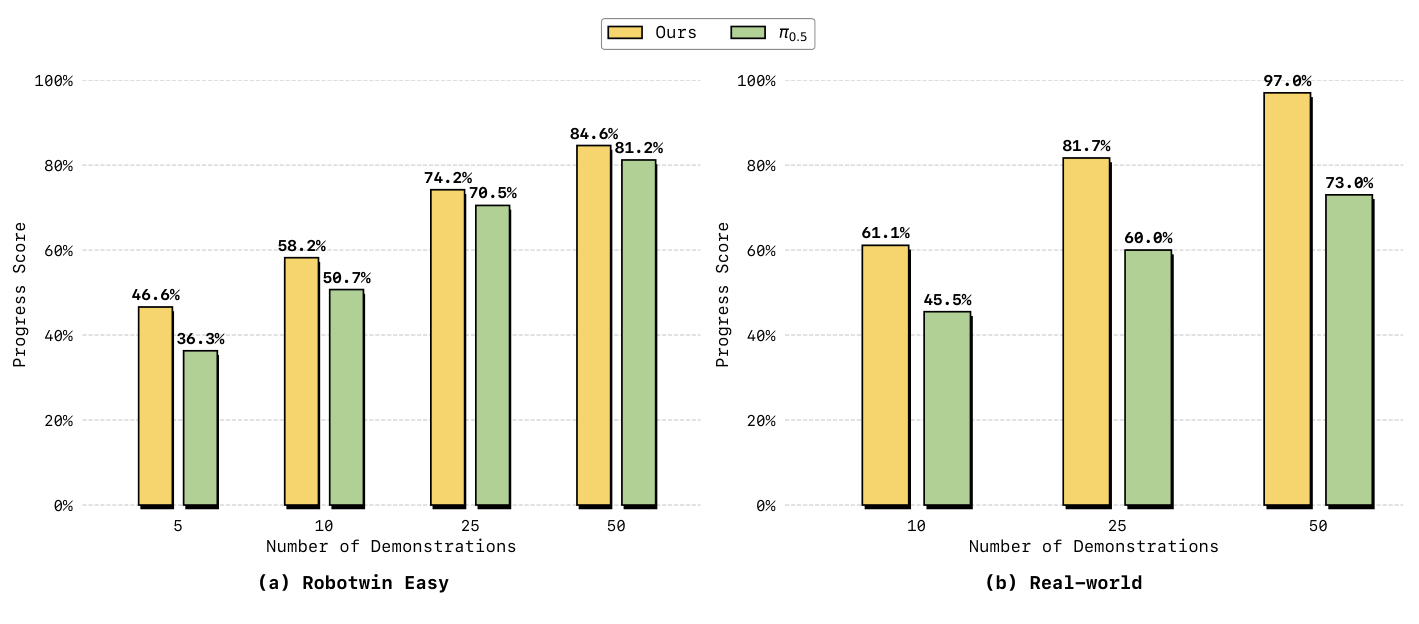
La Figura 8 representa el número de demostraciones de la tarea objetivo frente a la puntuación de progreso. Para el desayuno a la derecha, 10 demostraciones producen 61.1% frente a 45.5%, una brecha de 15.6 puntos; 50 producen 97.0% frente a 73.0%. Para RoboTwin Easy a la izquierda, 10 demostraciones producen 58.2% frente a 50.7%, una brecha de 7.5 puntos. El texto indica 10.3, pero la figura asocia 46.6−36.3=10.3 con 5 demostraciones. Esta guía sigue la correspondencia de la figura. Estos resultados indican menos demostraciones necesarias bajo las condiciones de post-entrenamiento probadas, no menores costes de datos o cómputo de preentrenamiento.
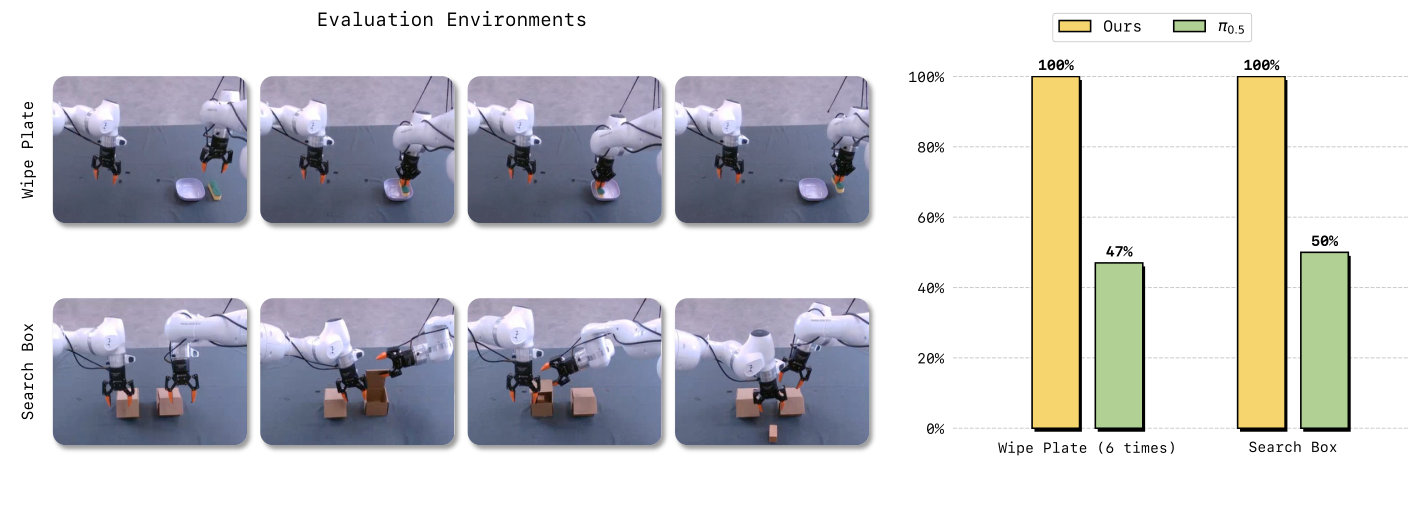
La limpieza de plato requiere exactamente seis repeticiones; la búsqueda en cajas requiere recordar que la caja derecha estaba vacía y luego buscar en la izquierda. Las barras de la derecha de la Figura 9 informan 100% para LingBot-VA en ambas, frente a 47% y 50% para π0.5. Estas pruebas exploran el uso del estado temporal de forma más directa que el agarre en un solo fotograma. Sin embargo, el artículo no da recuentos de ensayos para estas barras y no elimina de forma independiente la caché KV aquí, por lo que no establecen fiabilidad en tareas arbitrarias de historial largo.
La Figura 10 visualiza reemplazos de objetos y rangos más amplios de posición de objetos, lo que sugiere generalización. Sin una tabla completa de éxito fuera de distribución o recuentos de muestras, unas pocas demostraciones exitosas no pueden establecer una robustez general. La continuidad visual, la finalización de la tarea y la corrección física siguen siendo niveles de evaluación diferentes.
Integración con LeRobot: conectar los mecanismos con la interfaz actual
LeRobot proporciona un modelo base y checkpoints post-entrenados de LIBERO-Long y RoboTwin. Los checkpoints almacenan los pesos principales del Transformer entrenable; el VAE congelado, el codificador de texto y el tokenizador se obtienen por separado durante la carga, por lo que la carga práctica también requiere estos componentes.
El orden de las cámaras forma parte de la definición de entrada. LIBERO coloca la vista externa antes de la vista de muñeca, concatenando latentes a lo largo del ancho. RoboTwin usa vistas de cabeza, muñeca izquierda y muñeca derecha en el diseño robotwin_tshape. Intercambiar nombres de cámaras sin ajustar el diseño cambia el significado espacial. Los canales de acción válidos, las convenciones de pose del efector final y las estadísticas de normalización también deben coincidir con el checkpoint.
El valor predeterminado 4×4=16 describe un fragmento de acción ordinario. En el código fijado, el primer fragmento incluye el fotograma de condicionamiento inicial y descarta sus acciones correspondientes, por lo que devuelve (4−1)×4=12 pasos; los fragmentos posteriores devuelven 16. La interfaz actual vuelve a predecir después de que la cola se vacía. Sus actualizaciones de generación 20/50 no deben llamarse frecuencias de control.
El forward de entrenamiento codifica ventanas temporales de cámara y calcula tanto las pérdidas de flow matching de video como de acción. attn_mode=flex es necesario para la ruta de entrenamiento de bloque causal. save_predicted_video añade decodificación VAE para inspeccionar los cambios ambientales predichos; la evaluación debe comparar ese video imaginado con las grabaciones reales de ejecución.
Conclusión
La idea central de LingBot-VA es que las representaciones futuras pueden condicionar la generación de acciones, pero deben corregirse continuamente mediante el entorno real. La rama de video aprende cambios, la rama de acción infiere control a partir de ellos y la caché de historial preserva el contexto de interacción. El desruido parcial y la ejecución asíncrona abordan el coste de tiempo de llevar la generación al control.
Los experimentos respaldan este enfoque en los entornos de simulación, hardware y few-shot probados, a la vez que mantienen límites claros: menor progreso en el doblado de ropa, degradación sustancial con asincronía ingenua y un coste en la tasa de éxito incluso con FDM grounding. El backbone compartido publicado y la interfaz de LeRobot también difieren del sistema completo del artículo. Estas condiciones ayudan a determinar experimentos de seguimiento adecuados más que una tasa media de éxito por sí sola.
Referencias
- Paper, PDF: Sección 3, Ecuaciones (7)–(13), Algoritmos 1–2; Sección 4, Tablas 1–3 y Figuras 5–10; Tablas de Apéndice S1–S7.
- Implementación de los autores, commit fijado 7c6ffa9: README y notas de la versión del backbone compartido, configuración de LIBERO.
- Documentación de LeRobot y código fuente fijado d490e472: configuración e índices de muestreo, ruta de entrenamiento y ejecución en caché.