LingBot-VLA 2.0: Acciones entre Distintos Cuerpos y Percepción del Futuro
De la base a la aplicación: Mejorar los modelos VLA en la práctica
- Datos entre distintos cuerpos
- Espacio de acción de 55 dimensiones
- MoE disperso
- Predicción del futuro
Para meter fruta en un refrigerador, un robot debe identificar objetos, alcanzar y agarrar, mover su base, abrir el refrigerador y colocar la fruta. Cambiar de robot cambia el número de articulaciones, las posiciones de las cámaras y las acciones disponibles. LingBot-VLA 2.0 pregunta cómo un único modelo fundacional puede aprender experiencia de manipulación compartida mientras se adapta a los requisitos de control de distintos cuerpos y anticipa cambios posteriores en la escena.
Requisitos previos: Experiencia compartida e interfaces de control compartidas
Un modelo Visión-Lenguaje-Acción (VLA) recibe imágenes, texto de la tarea y el estado actual del robot, y luego produce valores numéricos de control. Debe aprender cómo moverse en una escena, en lugar de simplemente describirla.
Encarnación significa el cuerpo físico de un robot y sus condiciones de control. Pinzas bimanuales, manos humanoides diestras y brazos sobre bases móviles no pueden reutilizar valores articulares idénticos incluso para la misma instrucción. Un formato de datos unificado proporciona una interfaz común, mientras que el modelo aún debe aprender los patrones de movimiento de cada encarnación.
Un fragmento de acción es una secuencia de acciones de varios pasos predicha de una vez. La implementación publicada usa por defecto 50 pasos, cada uno usando un vector canónico de 55 dimensiones, con forma 50 × 55. Esto incluye relleno y no significa que el robot tenga 55 articulaciones. Generar un fragmento tampoco significa que el controlador solo pueda ejecutarse una vez por segundo.
Resumen y guía de lectura
Paráfrasis: A pesar del progreso en los modelos fundacionales VLA, sigue existiendo una brecha entre los resultados de laboratorio y las aplicaciones prácticas. LingBot-VLA 2.0 mejora a su predecesor en tres direcciones funcionales: una canalización de datos rediseñada y preentrenamiento en unas 60.000 horas, que comprenden 50.000 horas de trayectorias en 20 configuraciones de robots y 10.000 horas de vídeo humano egocéntrico; un espacio de control ampliado para cabezas, cinturas, bases móviles y manos diestras; y la predicción del futuro como tarea proxy para el modelado de dinámica predictiva, usando un modelo de representación de vídeo para priors semánticos y un modelo de profundidad para pistas geométricas. Los autores evalúan estas mejoras en configuraciones de políticas generalistas GM-100 y en manipulación móvil de largo horizonte en dos plataformas.
Nota de lectura: Estas tres direcciones constituyen conjuntamente la contribución del sistema. MoE amplía la capacidad de modelado de acciones mediante la arquitectura; la destilación de doble consulta entrena representaciones espaciales y temporales. Las tablas principales de resultados evalúan el sistema completo y no pueden atribuir toda la mejora media a un solo módulo.
Introducción y trabajos relacionados: ¿Por qué cambiar tres cosas a la vez?
El primer párrafo de la introducción reconoce dos fundamentos: los modelos visión-lenguaje proporcionan semántica imagen-texto, y conjuntos de datos de robots más grandes proporcionan experiencia de manipulación. El segundo identifica demandas prácticas más fuertes: los datos provienen de distintos cuerpos, las acciones implican más partes del cuerpo y los entornos cambiantes requieren entender los resultados posteriores.
El tercer párrafo repasa el escalado de datos, arquitecturas para diferencias de encarnación y acciones latentes o modelado predictivo. El cuarto organiza esto en tres mejoras: datos más amplios y limpios, más partes del cuerpo controlables y aprendizaje de percepción orientado hacia el futuro. Experimentos de manipulación bimanual y móvil ponen a prueba este enfoque (páginas 1–2 del PDF).
Los trabajos relacionados tienen dos grupos (Sección 2):
- Políticas de manipulación generalistas: El escalado de datos, la experiencia humana egocéntrica, las representaciones de acción unificadas, la supervisión geométrica y los objetivos predictivos aportan capacidades diferentes. Este trabajo las reúne en un único marco de preentrenamiento y control.
- VLAs con mezcla de expertos (Mixture-of-Experts): Algunos enfoques organizan expertos por sensado de fuerza, parte del cuerpo o habilidad atómica. Aquí, cada token de acción selecciona expertos a partir de sus propias características, sin preasignar expertos a robots o habilidades particulares.
Comparación con LingBot-VA: Cómo entra la información futura en la generación de acciones
LingBot-VA y LingBot-VLA 2.0 buscan ambos usar los cambios del entorno para la acción. La diferencia es que LingBot-VA genera latentes de vídeo futuros en inferencia e infiere acciones a partir de cambios visuales; LingBot-VLA 2.0 entrena consultas con supervisión de características futuras y luego deja que los expertos de acción lean esas consultas en inferencia.
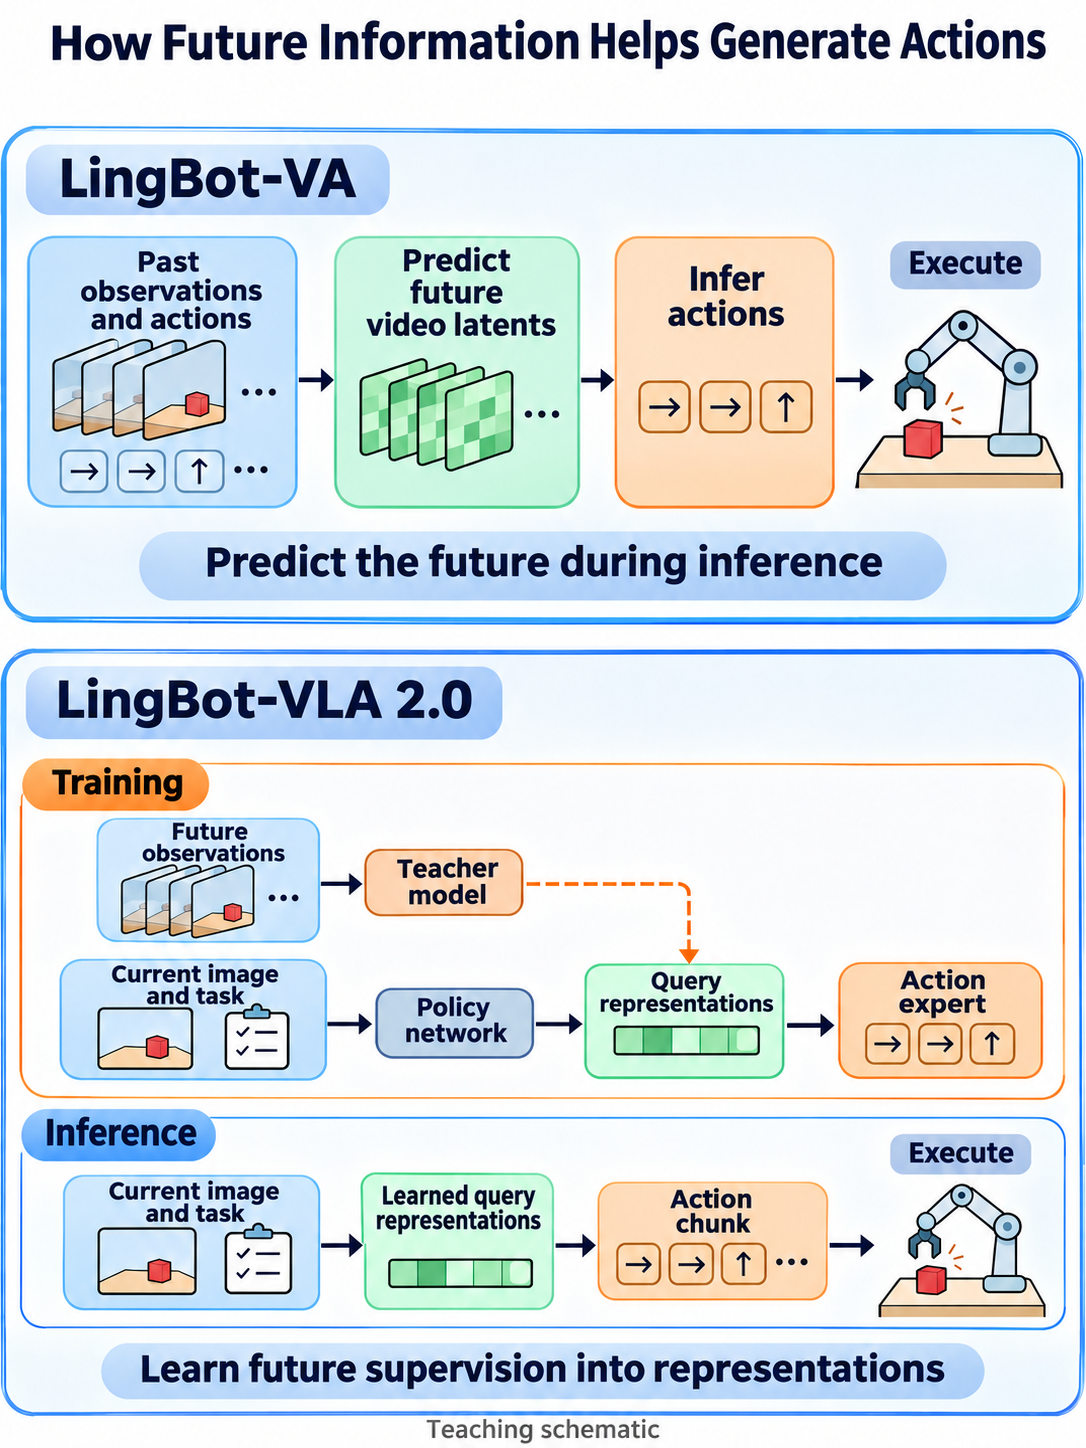
Ilustración didáctica: las flechas sólidas siguen la generación de acciones; las flechas discontinuas naranjas siguen la supervisión del entrenamiento. Los objetivos del profesor de VLA 2.0 se alinean con las representaciones de consulta que realmente leen los expertos de acción, y la fila de inferencia conserva la ruta de consulta aprendida. Se omiten condiciones compartidas como el estado del robot.
| Aspecto | LingBot-VA | LingBot-VLA 2.0 |
|---|---|---|
| Base principal | Prior Wan2.2 de generación de video y condicionamiento de texto | Backbone de comprensión visión-lenguaje Qwen3-VL |
| Representación del futuro | Los latentes VAE de video predichos condicionan las acciones; las imágenes pueden decodificarse cuando sea necesario | Las consultas predicen profundidad y características DINO-Video; no es un generador de video RGB |
| Aprendizaje de acciones | Emparejamiento de flujo de dos corrientes para dinámica de video y dinámica inversa | Emparejamiento de flujo de acción más alineación de características de profesor presente/futuro |
| Organización de capacidad | MoT asimétrico de dos ramas en el artículo; backbone compartido en la versión actual | Expertos de acción MoE dispersos; la configuración publicada tiene 32 expertos enrutados, top-4 |
| Cobertura de datos y cuerpos | Unas 16.000 horas de trayectorias de robots; espacio canónico de doble brazo de 30 dimensiones | Unas 50.000 horas de robot y 10.000 horas de trayectorias humanas egocéntricas; 55 dimensiones cubren cabeza, cintura, base y manos diestras |
| Historial y retroalimentación | Generación por bloques con observaciones reales e historial de acciones en una caché KV | Observaciones actuales, lenguaje, estado y consultas condicionan las acciones; el LeRobot actual por defecto usa un paso de observación |
| Cómputo adicional de inferencia | La generación de latentes de video permanece en la ruta de control; el desruido parcial y la asincronía reducen el coste en el artículo | Los profesores futuros son solo para entrenamiento; la inferencia conserva las consultas sin ejecutar los profesores de profundidad/video |
Considera un agarre fallido en la tapa de una caja. LingBot-VA necesita retroalimentación real para reemplazar o corregir su predicción visual anterior de un agarre exitoso; de lo contrario, el siguiente bloque puede continuar desde un estado imaginado falso. El esquema asíncrono del artículo usa FDM grounding para realinear su predicción del resultado visual de las acciones en curso con la retroalimentación real. El LeRobot actual solo actualiza la retroalimentación después de que la cola se vacía y no implementa completamente ese algoritmo asíncrono. VLA 2.0 genera otro fragmento a partir de observaciones y estado reales en la siguiente ronda; sus consultas futuras proporcionan características predictivas aprendidas en lugar de un despliegue explícito de video imaginado.
Los recuentos de generación por defecto tampoco comparan directamente la velocidad. En el código fijado de LeRobot, un fragmento VA ordinario tiene 4×4=16 posiciones de acción, con 20/50 actualizaciones de video/acción; VLA 2.0 usa fragmentos de 50 pasos y 10 actualizaciones de generación de acciones. La arquitectura, la precisión, la resolución y la planificación difieren, por lo que los recuentos de actualizaciones por sí solos no determinan la velocidad. El primer fragmento de VA devuelve solo 12 pasos debido a su fotograma de condicionamiento inicial; consulta su sección de integración.
Las conclusiones experimentales requieren el mismo cuidado. La tabla principal de RoboTwin de VA informa medias Fácil/Difícil de 92.93%/91.55%; los 93.52%/92.80% en la documentación de integración de esta guía provienen de una versión posterior del checkpoint de VLA 2.0. Ninguno de los artículos proporciona una comparación directa con modelos, entrenamiento y condiciones de ejecución totalmente igualados. Estos cuatro números no pueden establecer que VLA 2.0 sea mejor en todos los aspectos. Los enfoques enfatizan, respectivamente, la predicción ambiental explícita durante la inferencia y la supervisión de percepción futura para el modelado de acciones entre cuerpos distintos.
Datos: hacer que las trayectorias valgan la pena aprenderlas y sean compatibles entre fuentes
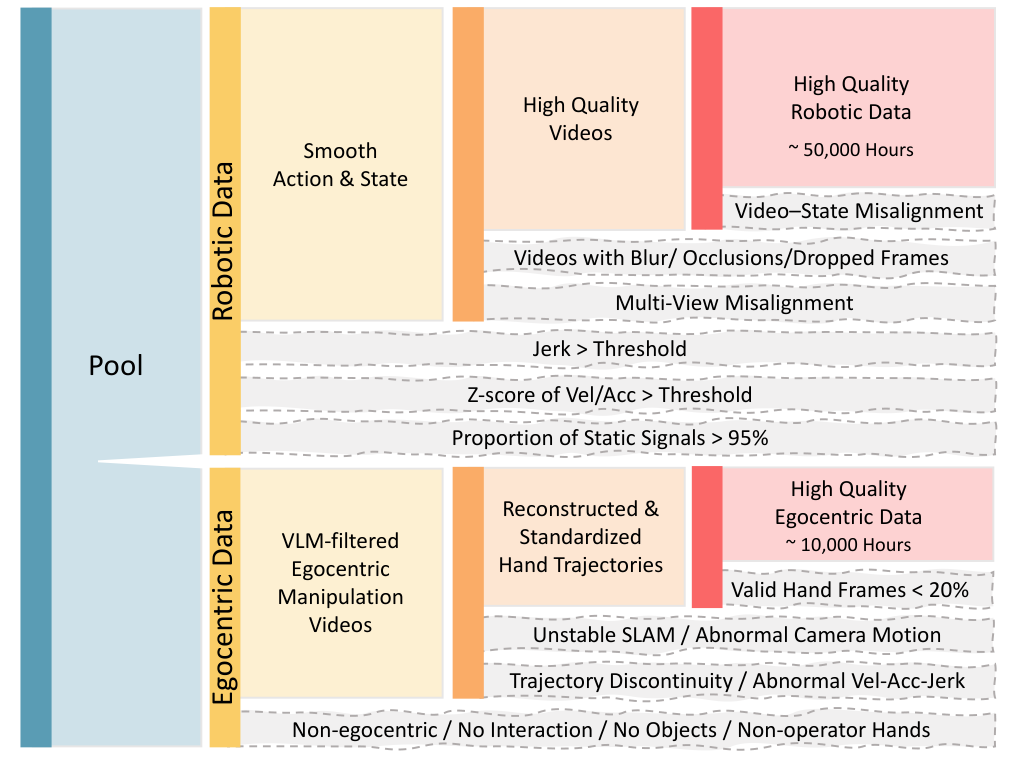
Los dos caminos de la Figura 3 conservan unas 50.000 y 10.000 horas. Las 60.000 horas describen datos de entrenamiento filtrados, no la colección original. El conjunto bruto de robots contiene unas 90.000 horas, y el conjunto egocéntrico unas 20.000 (Sección 3.1).
Primero se comprueban las trayectorias de robot en cuanto a velocidad, aceleración y tirón—la tasa de cambio de la aceleración—para eliminar movimientos bruscos. También se descartan las trayectorias que están casi estacionarias durante más del 95% de su duración. Los umbrales son específicos de cada cuerpo. Luego, las descripciones URDF de los robots y los estados registrados se proyectan en imágenes para comprobaciones de alineación humana, eliminando desenfoque, oclusión fuerte, fotogramas perdidos y cámaras desalineadas.
Un VLM primero excluye clips egocéntricos que contienen solo caminar, sin interacción mano-objeto, observación en tercera persona o manos dominadas por alguien que no sea el operador. Las trayectorias de mano existentes se alinean en tiempo y coordenadas. Para videos sin trayectorias, SLAM estima el movimiento de la cámara y la estimación de pose de mano MANO recupera trayectorias de mano en coordenadas del mundo. Los clips se filtran si los fotogramas de mano válidos caen por debajo del 20%, las estimaciones de cámara son inestables o el movimiento de la mano viola restricciones anatómicas. Estos videos deben producir supervisión de trayectorias antes del entrenamiento; el video humano arbitrario no se trata directamente como acciones de articulaciones de robot.
Para evitar confundir la rotación de la cabeza con el movimiento de la mano, las trayectorias se almacenan en coordenadas del mundo. Después de muestrear el fotograma actual, las trayectorias de mano posteriores se transforman al mismo sistema de referencia de la cámara en ese instante. La Ecuación (1) es:
Aquí, es el tiempo de trayectoria, el tiempo de observación actual, y el sistema de referencia del mundo. incluye rotación y traslación y actúa sobre posiciones en coordenadas homogéneas. Ejemplo didáctico: Si la cámara está en x=1 m del mundo con ejes alineados con el mundo, y la mano está en x=1.3 m del mundo, su coordenada en la cámara actual es x=0.3 m. Los puntos posteriores usan el mismo , en lugar de sus sistemas de referencia de cámara que cambian individualmente.
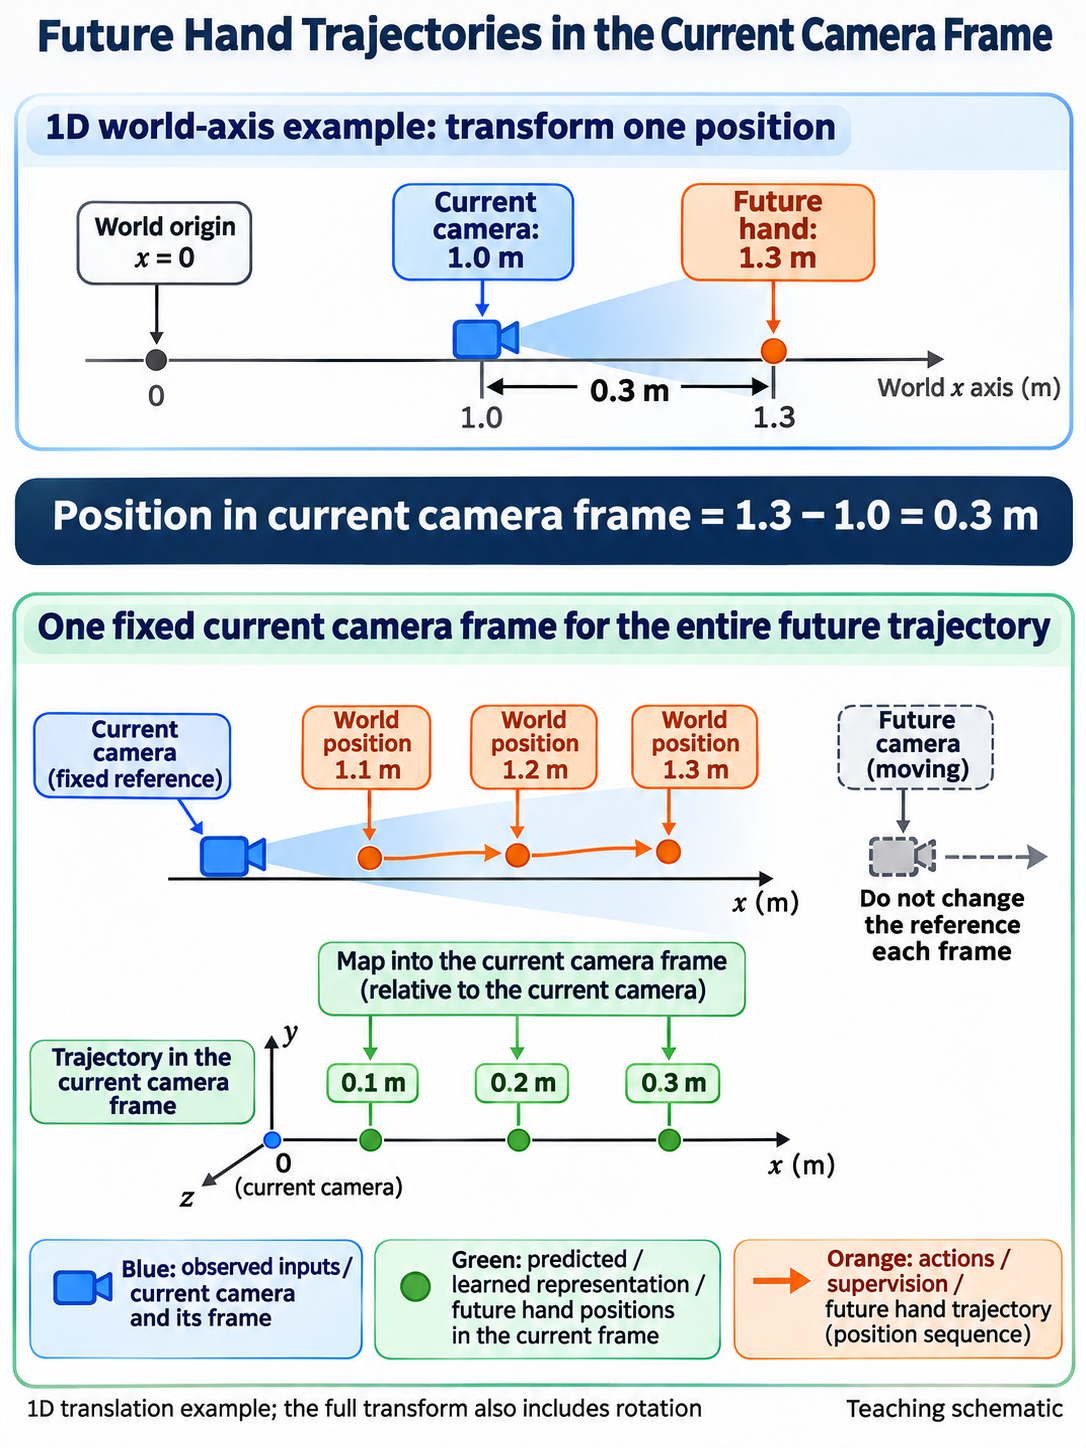
Ilustración didáctica: resta la posición actual de la cámara de las coordenadas del mundo y luego expresa los puntos posteriores en el mismo sistema de referencia. Los valores 0.1, 0.2 y 0.3 m ilustran una traslación unidimensional con ejes alineados; la transformación completa también incluye rotación.
Qwen3.6-27B anota automáticamente la supervisión de lenguaje, incluidas instrucciones de tarea completa e instrucciones de subtareas temporalmente continuas. Las etiquetas de acción contienen 15 clases de manipulación más transit, idle y other; los nombres de objetos son de vocabulario abierto. Agarrar, transportar y soltar dentro de una interacción forman una subtarea para evitar una fragmentación excesiva. La Figura 5 muestra que move y transit juntas representan alrededor del 88,7% de las subtareas, mientras que idle se excluye del entrenamiento. Un conjunto de datos grande no implica habilidades equilibradas.
Un espacio de acción unificado de 55 dimensiones
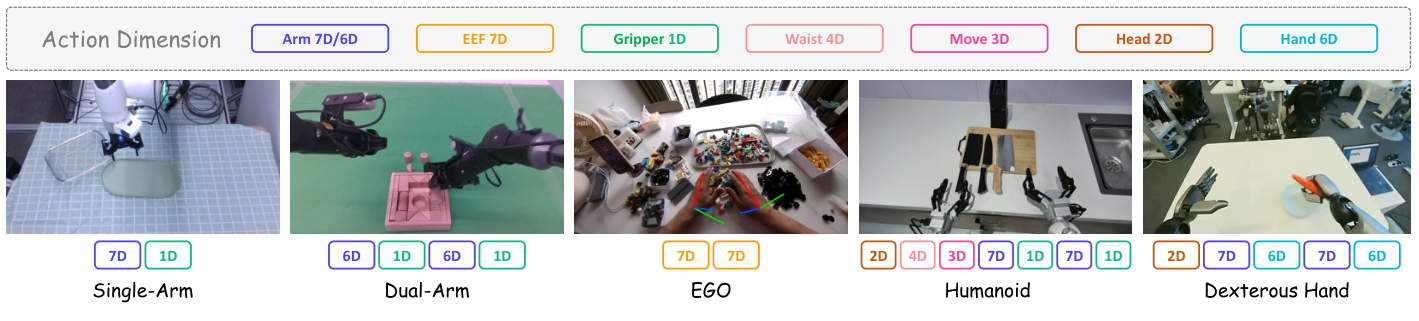
La Figura 4 usa colores para colocar los valores de control de diferentes robots en ranuras comunes de partes del cuerpo. La Sección 3.1.3 define el siguiente vector canónico tanto para estados como para acciones:
| Parte | Dimensiones | Significado |
|---|---|---|
| Articulaciones de doble brazo | 14 | Hasta 7 posiciones de articulación por brazo |
| Poses de los efectores finales de doble brazo | 14 | Posición XYZ y cuaternión, 7 dimensiones por brazo |
| Pinzas | 2 | Posiciones de las pinzas en ambos lados |
| Manos diestras | 12 | Posiciones de articulaciones para ambas manos |
| Cintura / cabeza | 4 + 2 | Articulaciones corporales correspondientes |
| Señales de movilidad | 3 | Movimiento de la base; la ranura de LeRobot se llama base.velocity |
| Reservado | 4 | Espacio para ampliación |
El total es 14 + 14 + 2 + 12 + 4 + 2 + 3 + 4 = 55. Las partes del cuerpo o dimensiones que faltan se rellenan. Las posiciones de articulaciones y las poses de efectores finales son representaciones diferentes; reservar ambas no crea 28 grados de libertad físicos independientes.
Ejemplo didáctico: Un conjunto de datos de un solo brazo con 5 articulaciones y 1 pinza podría usar [q₁,…,q₅,g]. LeRobot coloca los primeros 5 valores al inicio de arm.position, coloca g en effector.position, rellena con ceros el resto y excluye las dimensiones no válidas de la pérdida de acción con una máscara. Las salidas se mapean de vuelta a las 6 dimensiones originales. Mapeos correspondientes se aplican por separado a estados y acciones y deben coincidir con los mapeos de cámara y las estadísticas de normalización.
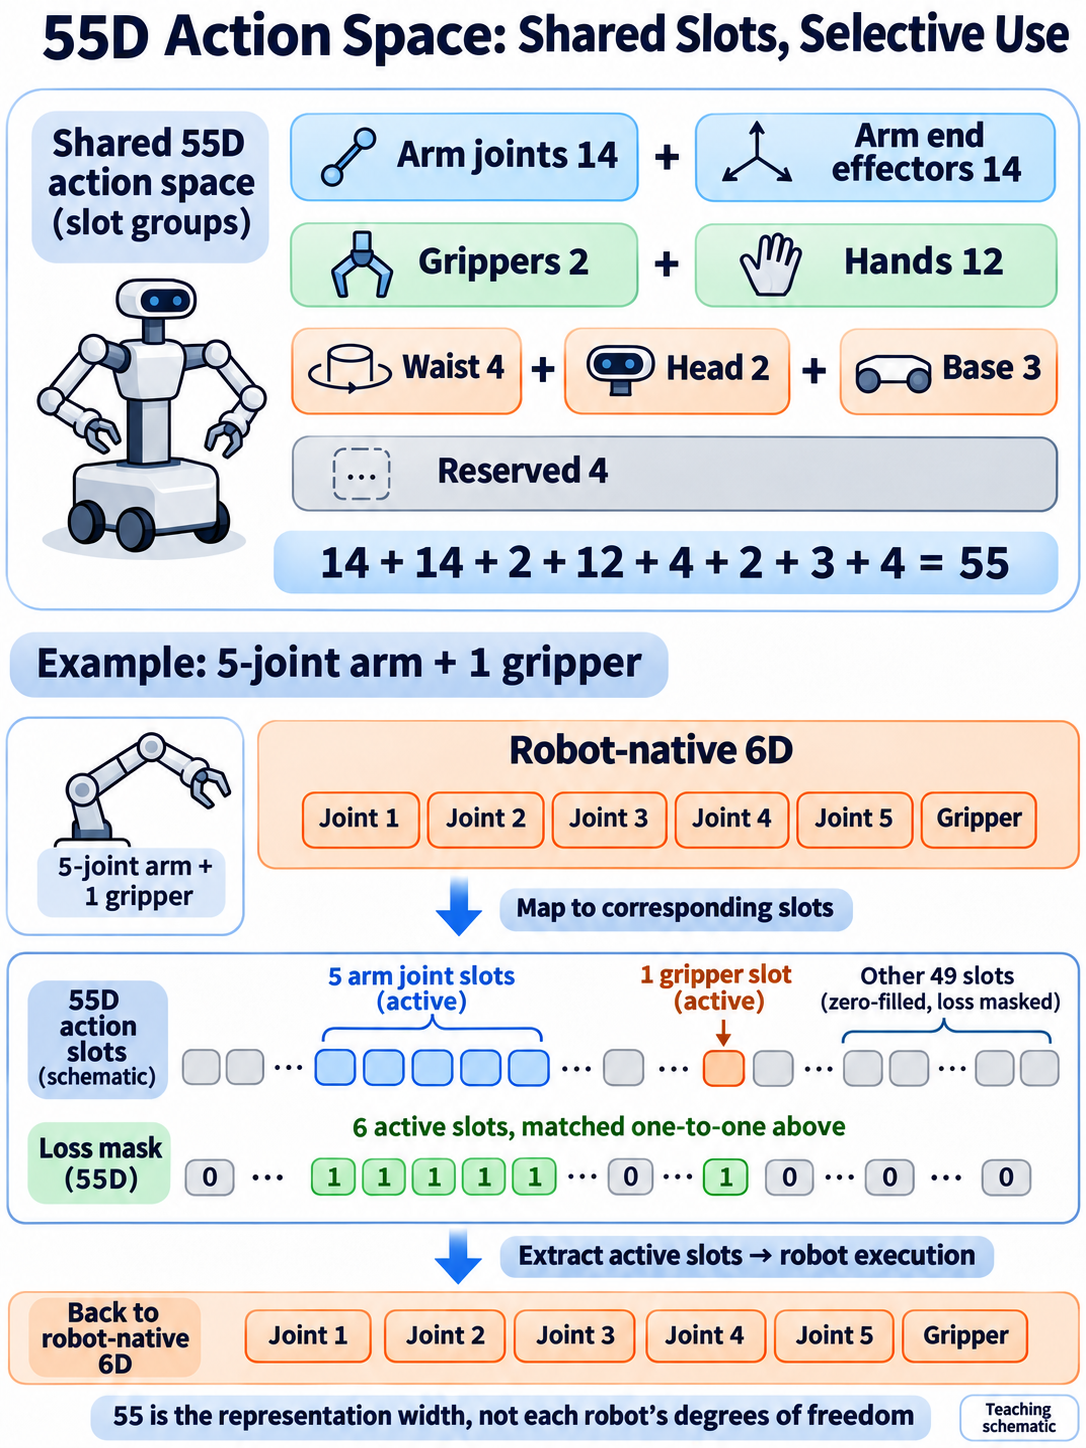
Ilustración didáctica: cinco articulaciones y una pinza ocupan sus respectivas ranuras, que pueden estar separadas por dimensiones no usadas. Las ranuras grises se enmascaran de la pérdida de acción. Las salidas aún deben reducirse a dimensiones válidas y restaurarse a la interfaz de control del robot.
Las ranuras unificadas permiten agrupar datos en lotes, pero las coordenadas, unidades y significados de las articulaciones aún requieren una configuración correcta. Proporcionan una interfaz para el aprendizaje entre cuerpos distintos; la longitud del vector por sí sola no puede garantizar el uso sin adaptación de un nuevo robot.
Red central: comprender escenas, enrutar expertos, generar acciones
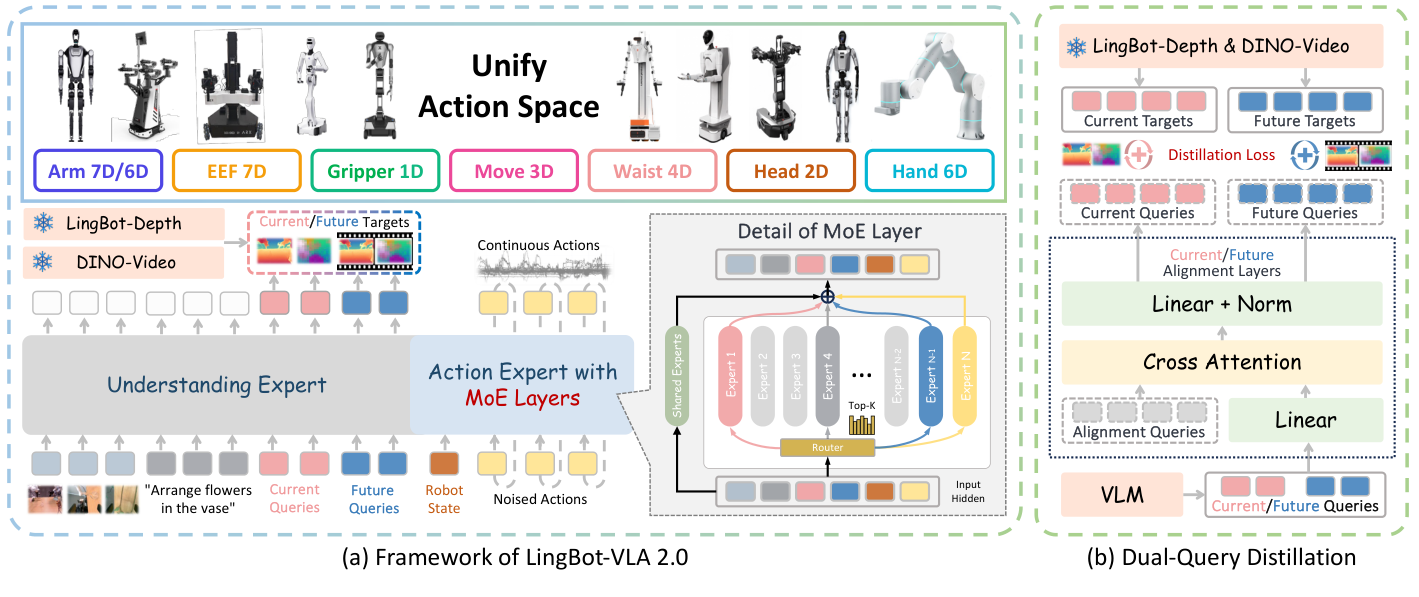
Empieza en la parte izquierda de la Figura 1. Las imágenes e instrucciones entran en la rama de comprensión, con consultas presentes y futuras colocadas después de los tokens de imagen-texto. La rama de acción recibe el estado actual del robot y acciones ruidosas, lee el contexto multimodal incluidas las consultas y produce acciones continuas. La parte derecha explica la supervisión de profesores para las consultas.
Suplemento de implementación: La versión publicada usa un backbone visión-lenguaje Qwen3-VL-4B y un experto de acción con arquitectura Qwen2. Los estados y las acciones tienen proyecciones separadas, y la generación de acciones también recibe codificación de tiempo de ruido. La atención intercambia información de condicionamiento entre las ramas. La formulación de emparejamiento de flujo y el valor por defecto de 50 pasos a continuación provienen del código fijado, en lugar de una receta de entrenamiento completa en la Sección 4.
MoE: cada token selecciona unos pocos expertos
Una capa de Mixture-of-Experts (MoE) sustituye a una red feed-forward (FFN) dentro del Transformer de expertos de acción por un experto compartido y un conjunto de expertos enrutados. El experto compartido maneja patrones reutilizables; un router selecciona unos pocos expertos a partir de las características actuales de cada token, aumentando la capacidad sin calcular todos los expertos cada vez. La configuración publicada tiene 32 expertos enrutados, activa 4 por token y mantiene un experto compartido.
Omitiendo subíndices de capa y token, las Ecuaciones (2), (6) y (7) pueden combinarse como:
es una característica interna de un token de acción, un vector de enrutamiento, una puntuación de afinidad token‑experto y un sesgo de corrección de enrutamiento para el balanceo de carga; escala la rama enrutada. El experto compartido y los expertos seleccionados son MLPs. La selección usa puntuaciones ajustadas por sesgo, mientras que los pesos de mezcla usan las puntuaciones originales.
Ejemplo didáctico: Simplificar a seleccionar 2 de 3 expertos. Las puntuaciones originales [0.8, 0.6, 0.2] y los sesgos [−0.4, 0, 0.3] dan puntuaciones de selección [0.4, 0.6, 0.5], eligiendo los expertos 2 y 3. Sus pesos de mezcla son 0.6/0.8=0.75 y 0.2/0.8=0.25. Esto aumenta las probabilidades de selección de los expertos menos usados manteniendo sus fuerzas de ajuste originales.
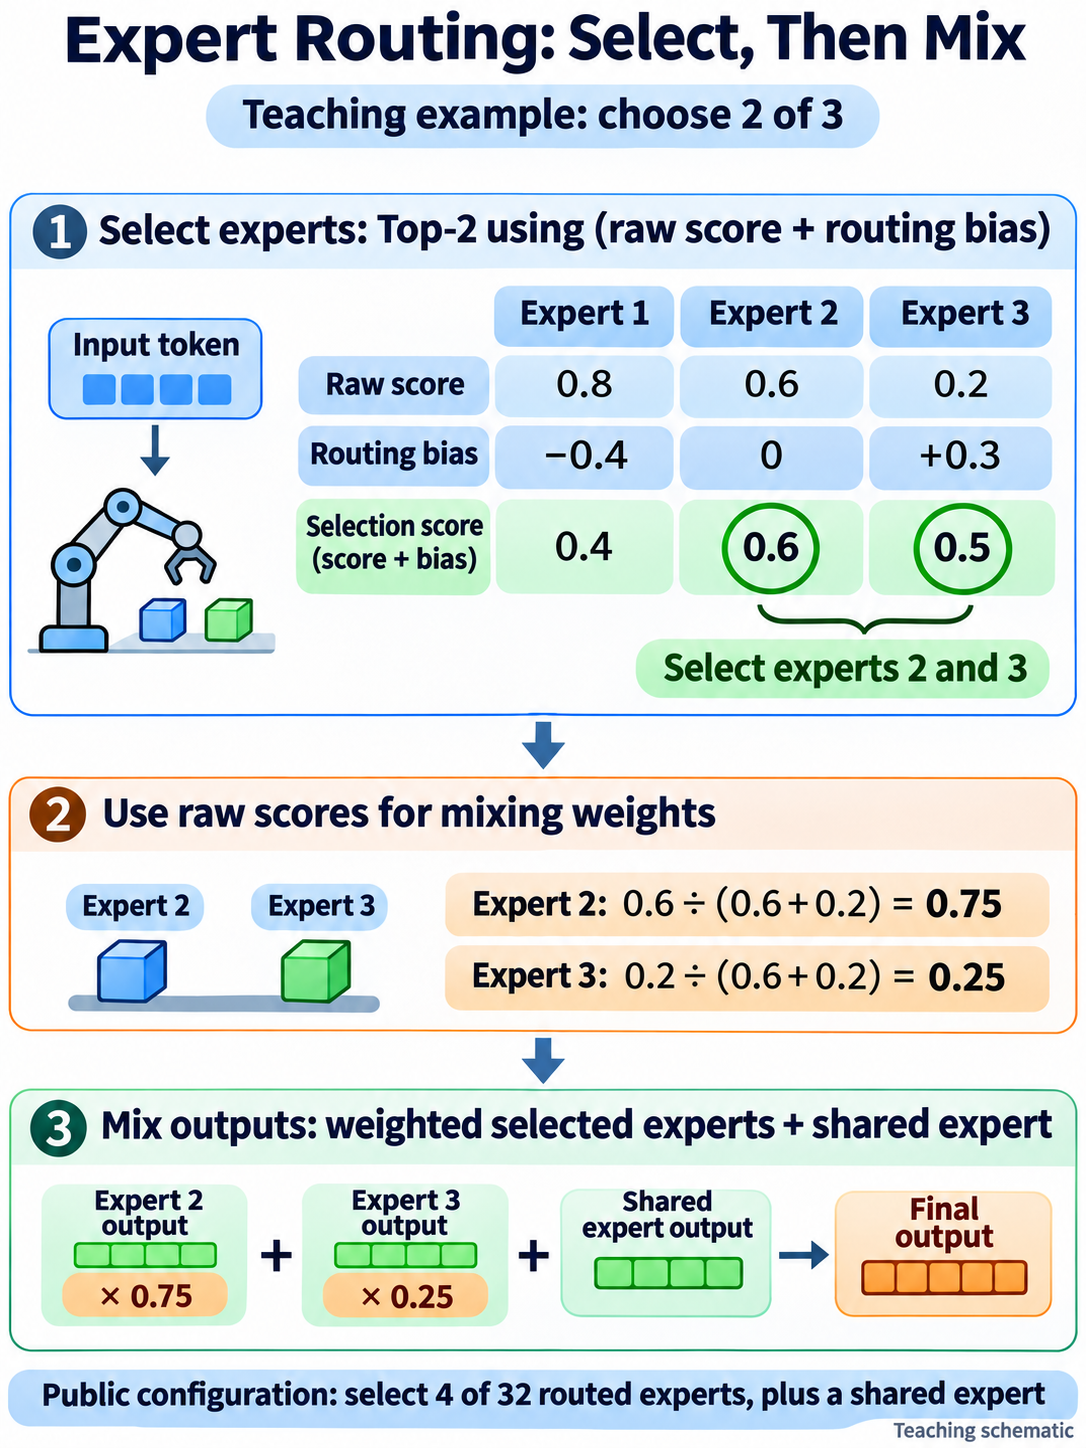
Ilustración didáctica: sigue la selección, el ponderado y la fusión de arriba abajo. Seleccionar 2 de 3 expertos y fijar la escala de la rama enrutada a 1 son simplificaciones didácticas. El experto compartido tiene una ruta separada; la configuración publicada sigue seleccionando 4 de 32.
El preentrenamiento del artículo usa balanceo de carga sin pérdida auxiliar: disminuir el sesgo de un experto cuando su carga excede la media y aumentarlo cuando está por debajo (Ecuación 8). Sin pérdida se refiere solo al balanceo de carga, no a la ausencia de una pérdida de acción. La configuración de post-entrenamiento publicada además habilita la pérdida de balanceo de secuencia y la router z-loss, y debe distinguirse del mecanismo de preentrenamiento del artículo.
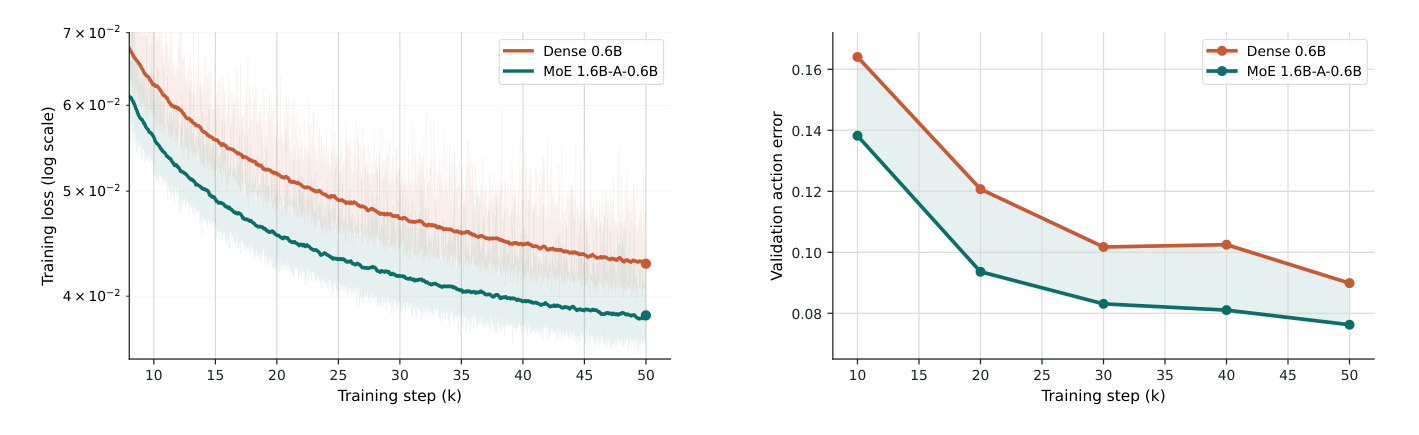
La Figura 7 compara un modelo denso 0.6B con un MoE que tiene 1.6B parámetros totales y 0.6B parámetros activos. A medida que avanza el entrenamiento, el MoE tiene menor pérdida de entrenamiento y menor error de acción GM-100 de validación. Esto respalda la asignación dispersa de capacidad. El eje horizontal son pasos de entrenamiento, no latencia de inferencia medida, y 0.6B no describe el modelo completo.
Destilación de doble consulta: representaciones futuras como condiciones de acción
Un token de consulta es un token interno aprendible. Tras el procesamiento por el modelo visión‑lenguaje, su estado de consulta contextualizado transporta la información que el modelo extrae o predice. Las consultas forman grupos de presente y futuro, y ; esto no significa que solo haya dos tokens en la implementación. Los grupos aprenden el estado actual y el posible estado después del horizonte de acción, respectivamente.
Los profesores se complementan: LingBot-Depth, el profesor de profundidad, aporta supervisión geométrica, mientras que DINO-Video, el profesor causal de vídeo, aporta representaciones visuales sensibles al movimiento. El estudiante ve observaciones e instrucciones actuales; durante el entrenamiento, los profesores también pueden ver imágenes futuras para proporcionar objetivos. Las imágenes futuras no son entradas del estudiante en inferencia.
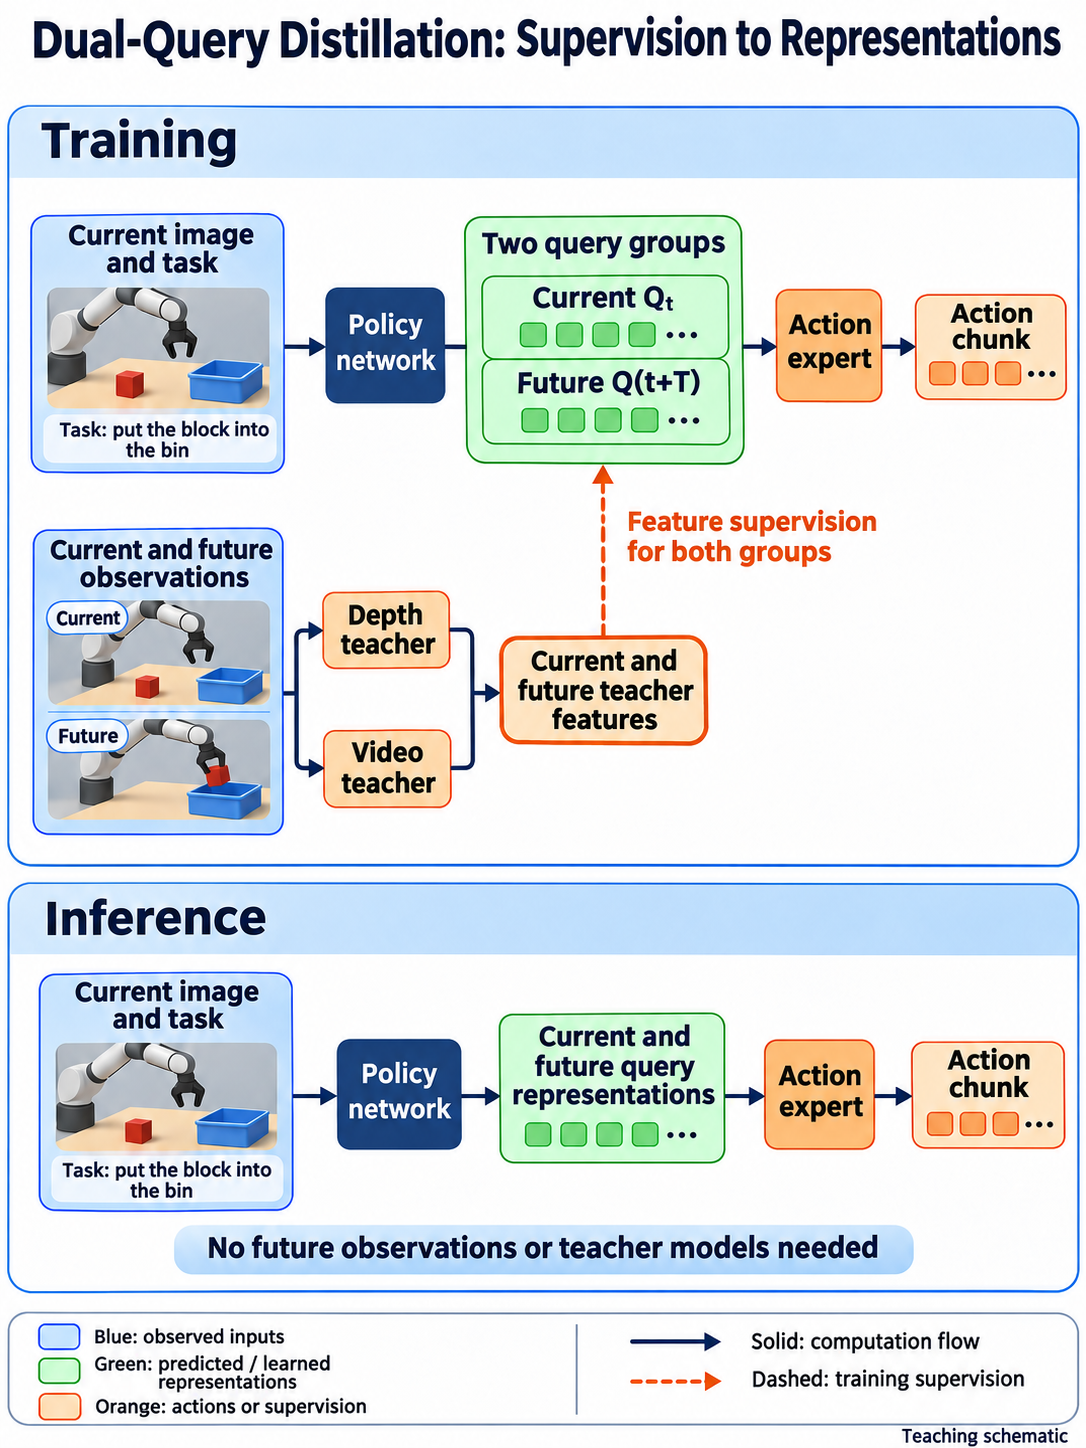
Ilustración didáctica: el gran recuadro verde contiene los grupos de consulta presente y futuro. Durante el entrenamiento, los profesores de profundidad y vídeo suministran conjuntamente objetivos para ambos tiempos. Las líneas discontinuas naranjas denotan alineación de características; las proyecciones y pérdidas se detallan más abajo. La inferencia sigue solo la ruta continua de la fila inferior.
Las Ecuaciones (9) y (10) alinean tanto las representaciones actuales como las futuras. Con , pueden escribirse de forma equivalente como:
y son características de profundidad y vídeo de los profesores. Los módulos de proyección reconfiguran las consultas del estudiante para que coincidan con las características de los profesores; la proyección de profundidad incluye cross‑attention. El primer término suma errores absolutos, el segundo errores cuadrados. Cálculo didáctico: Para una predicción simplificada [0.2,0.7] y un objetivo [0.3,0.5], la L1 es 0.1+0.2=0.3 y el error cuadrático sumado es 0.01+0.04=0.05, antes de la agregación a través de objetivos presente/futuro y muestras. Las características reales tienen una dimensión mucho mayor; las reducciones, pesos y términos adicionales de alineación siguen la configuración del código.
DINO-Video parte de DINOv3, añade atención causal temporal y embeddings posicionales rotatorios 3D, y se entrena con 5 millones de clips de vídeo con 16 fotogramas muestreados por ejemplo (Sección 4.2). Las características del fotograma actual dependen solo de fotogramas actuales y pasados; las características futuras usan fotogramas hasta ese instante futuro. Los 16 fotogramas son un ajuste de muestreo del preentrenamiento del profesor, no un requisito de 16 fotogramas de entrada en la inferencia del robot.
Tras la supervisión, las consultas siguen siendo contexto para los expertos de acción. Aprender geometría y cambios futuros puede por tanto afectar a la generación de acciones. Esto no requiere producir una imagen futura completa antes de planificar, y el artículo no define un planificador que busque explícitamente múltiples futuros.
Flow Matching: convertir un bloque de acciones ruidoso en una trayectoria ejecutable
Flow matching entrena una red para predecir direcciones de actualización para la generación continua de acciones. Siguiendo la dirección temporal en el código fijado de los autores, sea un bloque de acciones demostradas, ruido gaussiano de la misma forma y el tiempo de ruido:
Condicionado en imágenes actuales, lenguaje, estado, consultas y , el modelo predice y lo alinea con usando L1 o L2. Velocidad aquí significa una dirección de generación en el espacio de acciones, no la velocidad física de la base; también difiere del tiempo de ejecución del robot . La inferencia comienza desde ruido en y disminuye usando actualizaciones de Euler:
Ejemplo didáctico: Para un objetivo de acción normalizado 0.2 y ruido 1.0, la dirección ideal es 1.0−0.2=0.8. Con N=10, el primer paso da 1.0−0.1×0.8=0.92; diez pasos alcanzan 0.2 en este camino ideal unidimensional en línea recta. El modelo real reestima la dirección en cada paso y genera todo el bloque 50 × 55 junto. 10 actualizaciones de generación y 50 instantes temporales de acción son cantidades diferentes.
Conectar el entrenamiento con el uso práctico
| Etapa | Información disponible y aprendizaje | Salida o uso |
|---|---|---|
| Preparación de profesores | El modelo de profundidad aporta geometría; DINO-Video aprende características temporales mediante auto‑destilación de vídeo | Profesores congelados durante el entrenamiento VLA |
| Preentrenamiento VLA | Trayectorias filtradas de robot/humano, lenguaje, imágenes actuales y objetivos futuros de los profesores | Condicionamiento imagen‑texto compartido, modelado de acciones y representaciones presente/futuro |
| Post-entrenamiento downstream | Estados/acciones de la plataforma objetivo, mapeos de cámara y demostraciones de tareas | Política de la tarea objetivo y estadísticas de normalización |
| Inferencia y ejecución | Imágenes actuales, instrucción, estado actual y ruido recién muestreado | Generar bloques, desnormalizar, remapear inversamente y enviar a la interfaz de control del robot |
Las imágenes futuras y los profesores proporcionan supervisión adicional solo durante el entrenamiento. La inferencia conserva las consultas aprendidas sin ejecutar a los profesores. LeRobot toma la supervisión futura del último fotograma del bloque de acciones, usando el desplazamiento de índice chunk_size−1; el artículo expresa el horizonte como . Estos son, respectivamente, un horizonte conceptual y un índice de código, y no deberían introducir mecánicamente un fotograma extra.
El artículo no proporciona hiperparámetros completos de preentrenamiento ni calendarios de ejecución para todas las plataformas. Los ejemplos de entrenamiento en el código publicado son recetas de post-entrenamiento. El número de GPUs de preentrenamiento, la duración y el alcance completo de congelación siguen sin revelarse. La longitud del bloque, los pasos ejecutados y la cadencia de observación dependen del checkpoint y de la estrategia de control.
Experimentos: dónde aparece la mejora y qué sigue siendo difícil
Manipulación bimanual: mejores medias, resultados de tarea desiguales
El artículo selecciona 9 tareas de GM-100 y entrena conjuntamente una política por embodiment. No evalúa todo GM-100 ni usa la misma política post-entrenada en ambos robots. La Tabla 5 informa tanto la puntuación de progreso como la tasa de éxito. El progreso da crédito parcial por pasos completados; el éxito requiere completar toda la tarea.
| Plataforma | GR00T N1.7 | π0.5 | LingBot-VLA 1.0 | LingBot-VLA 2.0 |
|---|---|---|---|---|
| AgileX Cobot Magic | 36.3 / 17.8 | 59.1 / 32.2 | 58.2 / 30.0 | 66.2 / 34.4 |
| Galaxea R1 Pro | 16.4 / 5.6 | 27.4 / 8.9 | 32.7 / 15.6 | 34.6 / 15.6 |
Los valores son puntuación de progreso / tasa de éxito (%) promediados sobre nueve tareas. En Cobot Magic, 2.0 gana 8.0 / 4.4 puntos porcentuales sobre 1.0. En Galaxea, el progreso mejora mientras que el éxito se mantiene en 15.6%. Esta sección no da explícitamente recuentos de ensayos por tarea ni intervalos de confianza, por lo que márgenes pequeños no pueden calificarse directamente como estadísticamente significativos.
Los resultados a nivel de tarea muestran los límites con mayor claridad. Cobot Magic alcanza 100 / 100 para recoger un llavero pero solo 56.8 / 0 para clasificar bloques, frente al 90.4 / 60 de π0.5. La recuperación del bol del microondas de Galaxea cae de los 97.5 / 100 de 1.0 a 65 / 30. El anclaje visual, el agarre y la finalización precisa conservan cuellos de botella distintos; una mejor media no significa que todas las tareas mejoren.
Manipulación móvil de horizonte largo: ganancias relativas con una degradación OOD considerable
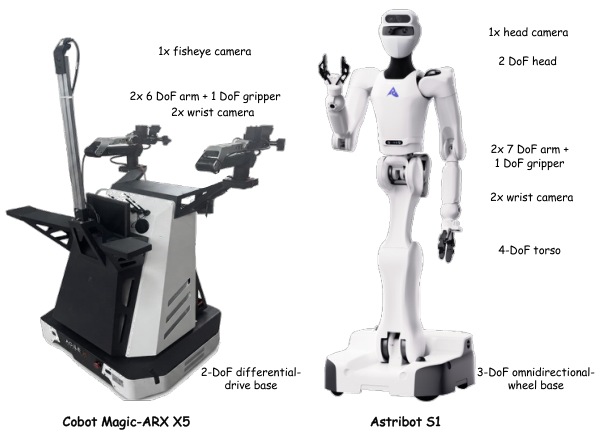
La Figura 9 muestra diferentes combinaciones de bases, torsos, brazos y cámaras. Las tareas móviles por tanto ponen a prueba la coordinación corporal y la finalización en varios pasos: la organización del refrigerador tiene 11 subtareas y la limpieza de la estufa 7. Cada modelo recibe 15 ejecuciones independientes por cada par tarea–configuración (Sección 5.3, Tablas 6–7).
| Plataforma y tarea | Configuración | LingBot-VLA 2.0 | π0.5 |
|---|---|---|---|
| Astribot S1: clasificar objetos en el refrigerador | En dominio (ID) | 77.1 / 60.0 | 65.3 / 46.7 |
| Astribot S1: clasificar objetos en el refrigerador | Fuera de distribución (OOD) | 37.0 / 13.3 | 30.3 / 6.7 |
| Cobot Magic-ARX X5: limpieza de la estufa | ID | 84.3 / 66.7 | 79.9 / 60.0 |
| Cobot Magic-ARX X5: limpieza de la estufa | OOD | 67.5 / 40.0 | 62.5 / 33.3 |
Los valores siguen siendo puntuación de progreso / tasa de éxito (%). OOD perturba la posición inicial del robot aproximadamente ±10 cm hacia adelante, atrás, izquierda y derecha respecto a las posiciones nominales. Las tareas de refrigerador además sustituyen categorías de fruta y botellas de agua no vistas; las tareas de estufa no usan la misma sustitución de objetos. Por tanto, las dos dificultades OOD no son directamente equivalentes.
Aunque 2.0 supera a π0.5 en las cuatro condiciones, el éxito en el refrigerador cae del 60.0% ID al 13.3% OOD, aproximadamente de 9/15 → 2/15. Una ejecución corresponde a unos 6.7 puntos porcentuales. Esto respalda la mejora relativa bajo las condiciones probadas, a la vez que muestra que la finalización de horizonte largo y la generalización siguen siendo limitadas.
Ablaciones: los objetivos, los espacios de acción y la normalización importan
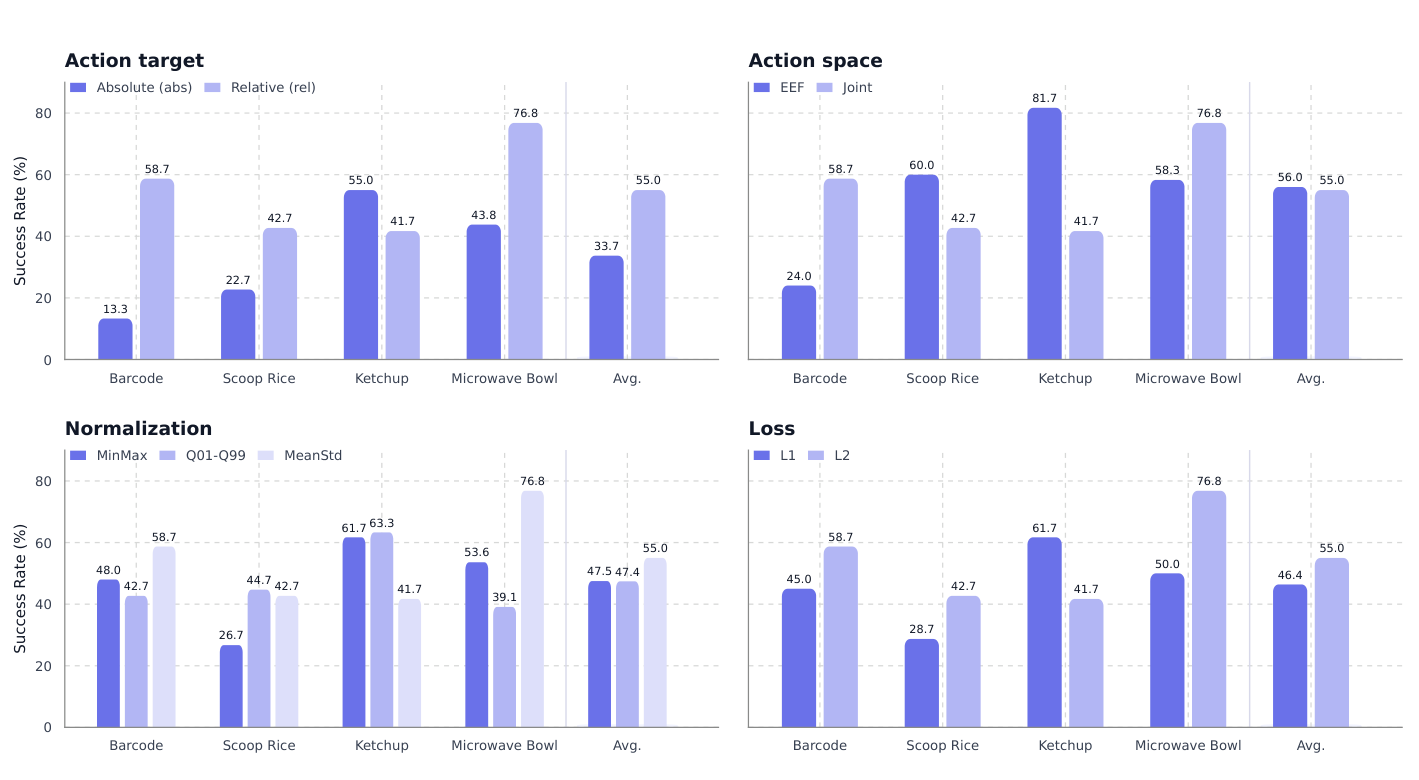
La Figura 10 abarca el escaneo de códigos de barras, servir arroz con cuchara, exprimir kétchup y recuperar un bol del microondas. El Avg. más a la derecha de cada grupo es el éxito medio sobre estas cuatro tareas, distinto de la media de nueve tareas de la Tabla 5 (Sección 6.1).
- Objetivos articulares relativos / absolutos: Los objetivos relativos promedian un 55.0%, frente al 33.7% de los objetivos absolutos. Los autores sugieren que los cambios de movimiento local están más concentrados y tienen menor varianza, lo que los hace más fáciles de aprender. En la implementación actual, las acciones relativas hacen referencia al estado actual, en lugar de tomar diferencias paso a paso entre acciones futuras adyacentes.
- Espacio del efector final (EEF) / espacio articular: Las medias son 56.0% y 55.0%, pero las preferencias por tarea difieren sustancialmente. Exprimir kétchup alcanza un 81.7% en el espacio del efector final frente a un 41.7% en el espacio articular; el escaneo de códigos de barras da 24.0% frente a 58.7%. Ningún espacio de acción gana en todas las tareas.
- Normalización: MeanStd alcanza 55.0%, MinMax 47.5% y Q01–Q99 47.4%. Los autores relacionan las diferencias con el rango dinámico efectivo de las distribuciones objetivo. Esta configuración Q01–Q99 no recorta valores, por lo que los fallos no pueden explicarse como que el recorte elimine acciones grandes.
- Función de pérdida: L2 alcanza 55.0% y L1 46.4%, aunque L1 es mejor para exprimir kétchup. Los valores predeterminados actuales de LeRobot y el ejemplo oficial de post-entrenamiento de RoboTwin usan
L1_fm, bajo configuraciones diferentes de esta ablación de hardware de cuatro tareas.
Estas ablaciones muestran que la representación de acciones, la normalización y la función de pérdida afectan de forma diferente a las tareas. Más allá de la arquitectura del modelo, la definición de los valores de control es una condición importante para el rendimiento.
Lo que respalda la evidencia de predicción futura
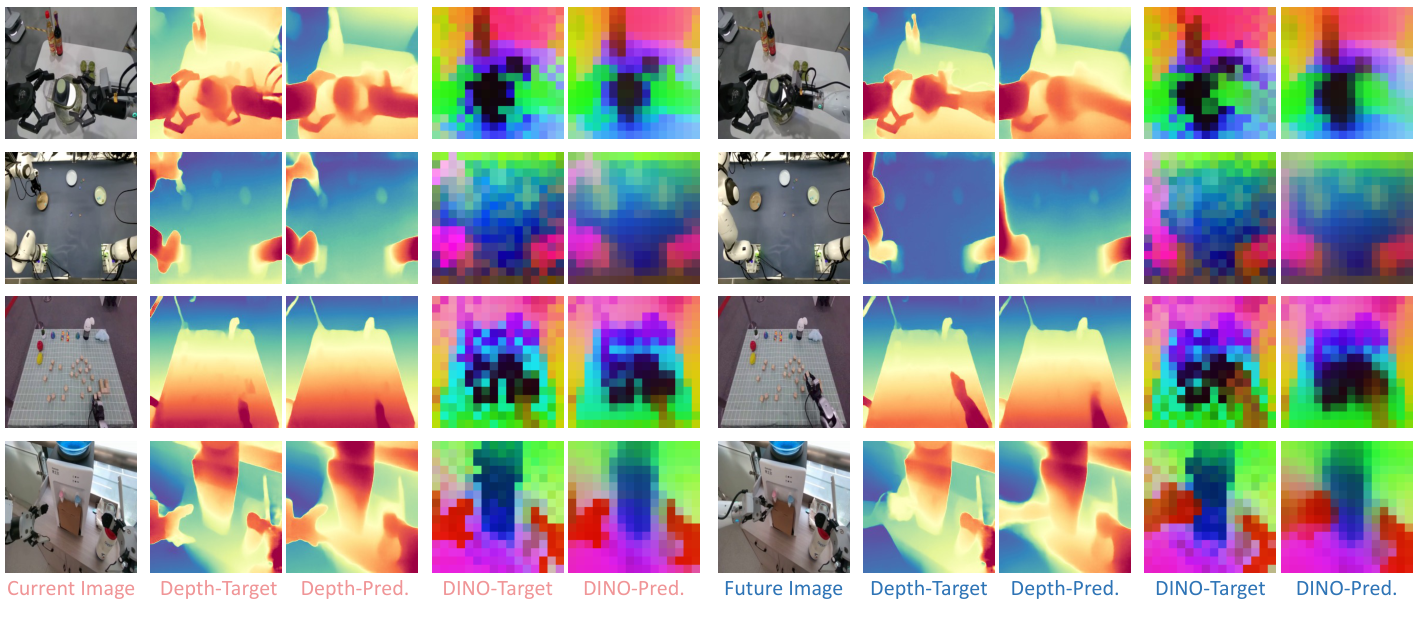
La mitad izquierda de la Figura 13 compara las características del profesor y las predicciones para imágenes actuales; la mitad derecha muestra resultados de imágenes futuras. Las salidas de DINO coloreadas visualizan el PCA de características. Formas y distribuciones espaciales similares sugieren señales geométricas y temporales aprendidas. Los colores no son ni valores físicos de profundidad ni vídeo RGB generado.
La Tabla 3 evalúa por separado al profesor. DINO-Video lidera en tres de cuatro métricas de LARYBench, pero obtiene 80.21 en el benchmark de clasificación Composite Human, ligeramente por debajo de los 80.35 de V-JEPA 2. La capacidad del profesor y los resultados cualitativos de la Figura 13 respaldan el aprendizaje de representaciones. El artículo no elimina de forma independiente las consultas actuales/futuras ni la supervisión de profundidad/vídeo para cuantificar sus beneficios de control, por lo que estas figuras por sí solas no pueden establecer cuánto aumento de la tasa de éxito causa la destilación.
Integración con LeRobot y los límites de los resultados del artículo
El lerobot/lingbot_vla_v2_base de LeRobot admite ajuste fino desde el espacio canónico; lerobot/lingbot_vla_v2_robotwin es un checkpoint de RoboTwin con una interfaz bimanual de 14 dimensiones. Adaptar un nuevo robot requiere definir ranuras de estado/acción, nombres de cámaras, dimensiones válidas y estadísticas de datos antes de hacer el mapeo inverso de las salidas.
El 93.52% Clean y el 92.80% Randomized de la documentación de RoboTwin provienen de la evaluación upstream de un checkpoint posterior publicado por los autores: 50 tareas, 100 episodios por tarea, post-entrenamiento conjunto en datos limpios y aleatorizados, e inferencia en FP32. Estas tareas y protocolos difieren de los experimentos GM-100 y de manipulación móvil anteriores.
El uso práctico requiere distinguir dos configuraciones. El artículo describe un enrutamiento sin pérdidas auxiliares durante el preentrenamiento, mientras que los ejemplos de post-entrenamiento publicados añaden términos de balanceo. El estudio de cuatro tareas del artículo favorece objetivos relativos y L2, mientras que los valores predeterminados de LeRobot deshabilitan las acciones relativas y usan L1_fm. Interpreta estas diferencias para el checkpoint y la tarea objetivo; ningún valor predeterminado es una receta universalmente óptima derivada del artículo.
Conclusión
La conexión más útil de LingBot-VLA 2.0 es que el filtrado y la reconstrucción producen trayectorias fiables, las ranuras canónicas conectan cuerpos heterogéneos, los expertos dispersos acomodan patrones compartidos y diferencias, y las consultas actuales/futuras llevan la supervisión de percepción a la generación de acciones. Desplaza las capacidades de los modelos fundacionales hacia una interfaz de control robótico más completa.
Los resultados de hardware respaldan una mejora media del sistema global bajo las condiciones probadas, a la vez que mantienen un bajo éxito de tareas completas, regresiones en algunas tareas y una degradación OOD considerable. Las representaciones unificadas no convierten encarnaciones arbitrarias en plug-and-play, y características futuras similares no establecen una planificación general fiable. La efectividad sigue dependiendo de la alineación de datos, las definiciones de acciones y la evaluación de la tarea objetivo.
Referencias
- Paper v1, PDF: datos en la Sección 3; MoE y consultas duales en la Sección 4, Ecuaciones 1–10; comparaciones de hardware en las Tablas 5–7; ablaciones de acciones y resultados de percepción en la Sección 6, Figuras 10–13.
- Implementación de los autores, commit fijado be969b8: modelo de generación de acciones, configuración de hardware, configuración de RoboTwin.
- Documentación de LeRobot y código fuente fijado 9e5ee98: configuración e indexación de frames futuros, mapeo de ranuras y normalización.
- Fuentes de comparación: artículo LingBot-VA, Secciones 3–4, Algoritmos 1–2, Tabla 1; implementación VA en LeRobot, commit fijado d490e472.