LBM y MultiTask DiT: Cómo el preentrenamiento multitarea ayuda a los robots a aprender
Un examen cuidadoso de los Large Behavior Models para manipulación hábil multitarea
- Diffusion Transformer
- Preentrenamiento multitarea
- Eficiencia de datos
- Evaluación rigurosa
¿Pueden las demostraciones de múltiples tareas ayudar a los robots a aprender nuevas tareas con menos datos y manejar cambios en el entorno? Este artículo mantiene fija la arquitectura de la política y utiliza experimentos controlados para medir los beneficios del preentrenamiento.
El artículo de LBM de TRI estudia el preentrenamiento multitarea con un objetivo de diffusion. LeRobot MultiTask DiT es una implementación de código abierto inspirada en este enfoque y también admite flow matching. El blog de Atlas de Boston Dynamics describe una aplicación al control de todo el cuerpo. Sus plataformas, datasets y recetas de entrenamiento difieren; los tamaños de modelo, espacios de acción y resultados deben interpretarse dentro de cada fuente.
Requisitos previos: de demostraciones a segmentos de acción
Entrenamiento e inferencia
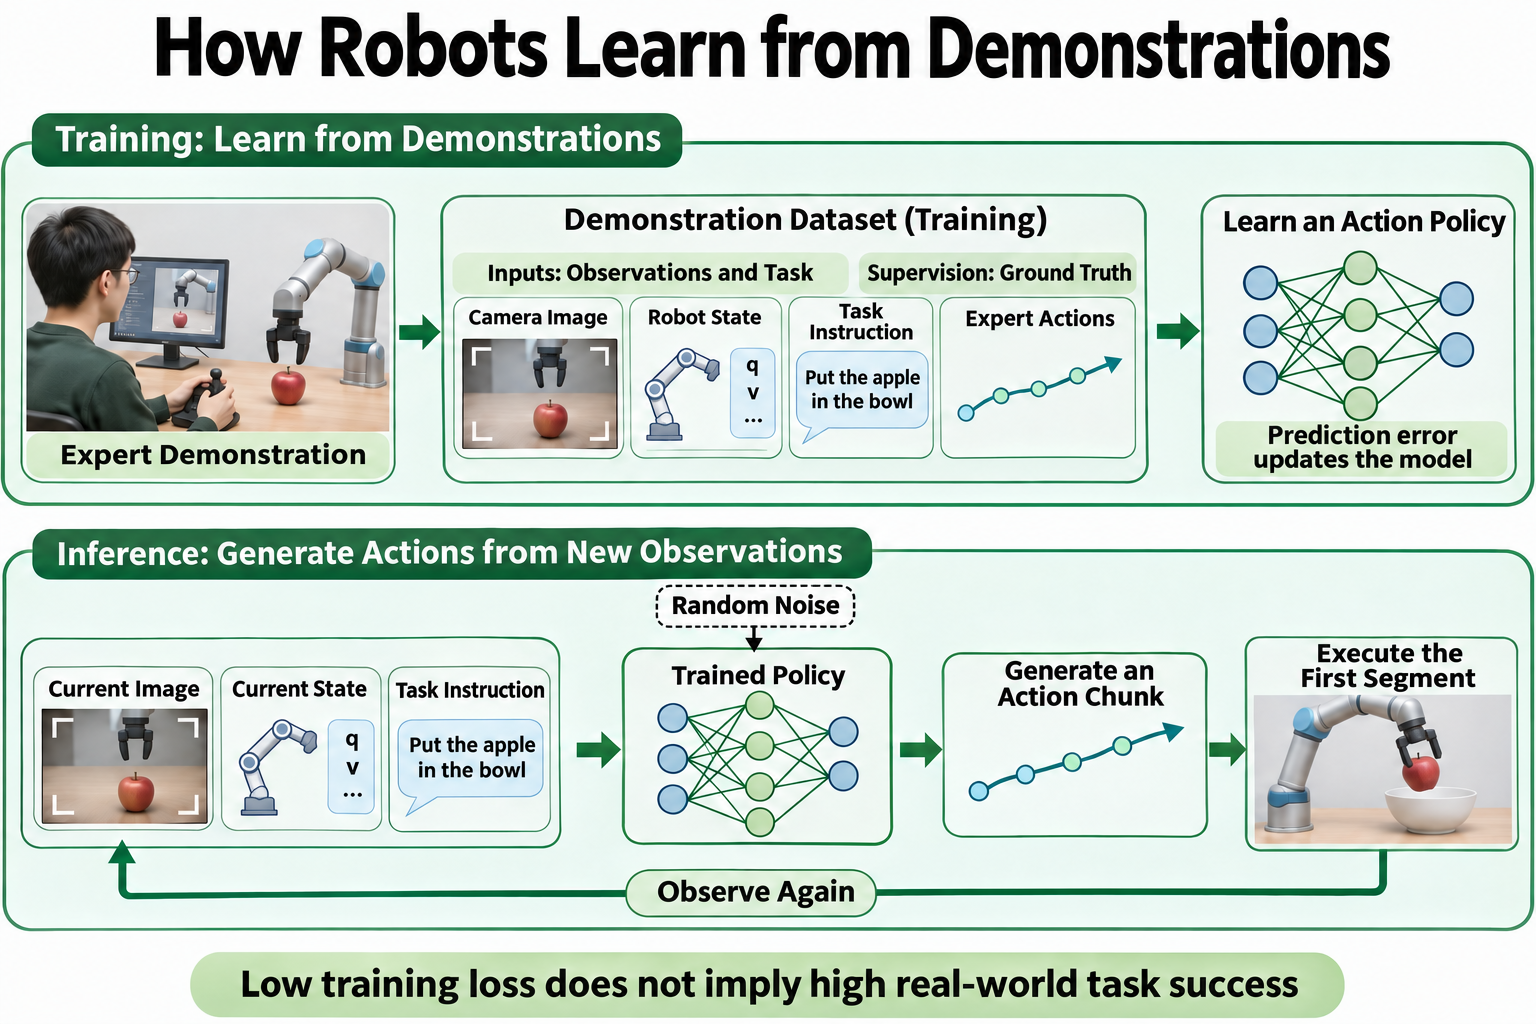
Ilustración de enseñanza basada en el artículo y la implementación de LeRobot. El ejemplo explica el flujo de trabajo de aprendizaje.
Behavior cloning usa acciones de expertos como supervisión para aprender acciones condicionadas a imágenes, estado propioceptivo e instrucciones de tarea. El entrenamiento proporciona acciones futuras de expertos; la inferencia genera un segmento de acción a partir de observaciones y una instrucción.
Un Large Behavior Model (LBM) aquí es una política visuo-motora entrenada con demostraciones multitarea. Los codificadores de imagen y texto de Contrastive Language–Image Pre-training (CLIP) convierten imágenes e instrucciones en características de condicionamiento, lo que permite que el lenguaje de la tarea guíe la generación de acciones.
Segmentos de acción y modelos generativos
Segmentación de acciones predice varios pasos de control conjuntamente. Tras ejecutar un segmento, la política vuelve a observar y predice otro segmento. De forma predeterminada, LeRobot genera un nuevo segmento cuando su cola de acciones está vacía, ejecutando el segmento en cola en lazo abierto. Esto difiere de las predicciones solapadas y el ensamblado temporal de ACT. Consulta Ventana de acción y segmento de ejecución.
Una escena puede admitir varias trayectorias válidas, cuyo promedio puede no ser adecuado. El modelo generativo de diffusion aprende una distribución condicional sobre trayectorias, generando acciones a partir de ruido aleatorio bajo el condicionamiento de las observaciones.
El tiempo de diffusion describe el progreso del desruido, no el movimiento físico del robot. A continuación, denota el tiempo físico y un paso discreto de desruido.
Resumen: el valor del preentrenamiento
Resumen del abstract
El aprendizaje por imitación puede resolver tareas de manipulación complejas, pero los beneficios prácticos de los modelos de robots grandes siguen siendo difíciles de evaluar de forma fiable. Los autores amplían Diffusion Policy a datos multitarea y lo comparan con políticas de tarea única usando semillas aleatorias emparejadas y puntuación automatizada en simulación, y pruebas a ciegas con orden de políticas aleatorizado en el mundo real.
El preentrenamiento multitarea seguido de ajuste fino mejora el éxito y la robustez mientras reduce las demostraciones necesarias para nuevas tareas. Dentro de los entornos evaluados, datasets de preentrenamiento más grandes y diversos generalmente producen mayores beneficios.
Comentario
- Una arquitectura central fija ayuda a separar los beneficios del preentrenamiento de los efectos del tamaño del modelo.
- Los hallazgos sobre eficiencia de datos se refieren al ajuste fino específico de la tarea, en lugar del aprendizaje zero-shot.
- Las condiciones iniciales, el orden de los ensayos y la puntuación están controlados, con análisis estadístico de los resultados.
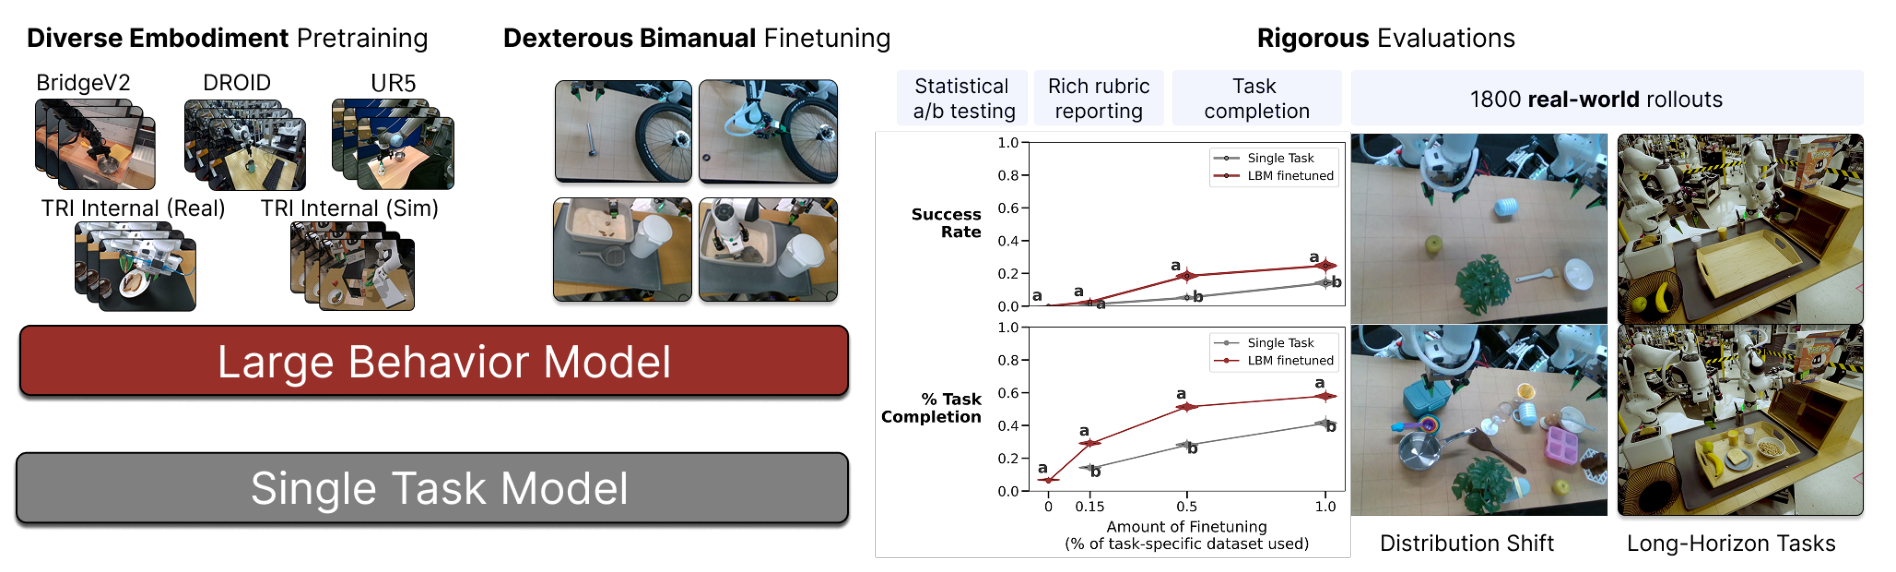
Figura 1 original (PDF p. 2). Izquierda: preentrenamiento seguido de ajuste fino frente a entrenamiento de tarea única. Derecha: ensayos en el mundo real y comparaciones estadísticas.
Introducción y trabajos relacionados
Los tres párrafos de la introducción
Párrafo 1: La brecha entre las capacidades del hardware y la autonomía motiva el aprendizaje a partir de demostraciones. El hardware robótico admite comportamientos diversos, pero la autonomía fiable a menudo sigue limitada a tareas simples o entornos estructurados. El behavior cloning sustituye la programación específica de tareas por demostraciones. Su progreso en manipulación rica en contacto, objetos deformables y coordinación bimanual motiva el estudio de la manipulación de propósito general.
Párrafo 2: Las políticas frágiles de tarea única plantean una pregunta sobre el preentrenamiento. El behavior cloning de tarea única tiene dificultades fuera de su distribución de entrenamiento. Los LBM usan demostraciones multitarea para ampliar la experiencia, pero sigue sin estar claro cuánto de su éxito observado proviene del preentrenamiento multitarea. Esta pregunta motiva una evaluación controlada.
Párrafo 3: Los autores establecen la escala experimental y exponen tres hallazgos. Los modelos se entrenan con aproximadamente 1.700 horas de demostraciones y se evalúan en simulación y en aproximadamente 1.800 ensayos controlados en el mundo real. Los tres hallazgos son: el ajuste fino requiere menos demostraciones de la tarea objetivo para alcanzar un rendimiento comparable; con la misma cantidad de datos de la tarea objetivo, los modelos ajustados finamente se desempeñan mejor cuando se agregan a través de tareas; y estos beneficios aumentan cuando las condiciones de despliegue difieren del entrenamiento. Las secciones siguientes examinan la evidencia y su alcance.
Trabajos relacionados
| Área | Trabajos previos | Enfoque de este artículo |
|---|---|---|
| Políticas de robots generalistas y VLA | Ampliar capacidades mediante datos multitarea, representaciones preentrenadas y generación de acciones | Cuantificar los beneficios del preentrenamiento con una arquitectura fija |
| Datasets de robots a gran escala | Ampliar datos mediante teleoperación, datasets públicos, simulación y dispositivos de mano | Estandarizar observaciones y acciones; estudiar la escala y diversidad de datos |
| Evaluación de robots | Benchmarks de simulación, conjuntos de objetos físicos, robots remotos y métricas de éxito | Comparar políticas usando ensayos a ciegas, orden aleatorizado, reinicios de escena y puntuación por hitos |
El artículo no proporciona una comparación sistemática entre arquitecturas VLA ni establece que DiT siempre supere a las VLA.
Método central: Diffusion Transformer condicional
Arquitectura
Intuición: Las imágenes localizan objetos, las instrucciones especifican la tarea y la propiocepción describe la configuración actual del robot. La red codifica este contexto y refina iterativamente un segmento de acción ruidoso en una trayectoria adecuada para la escena.
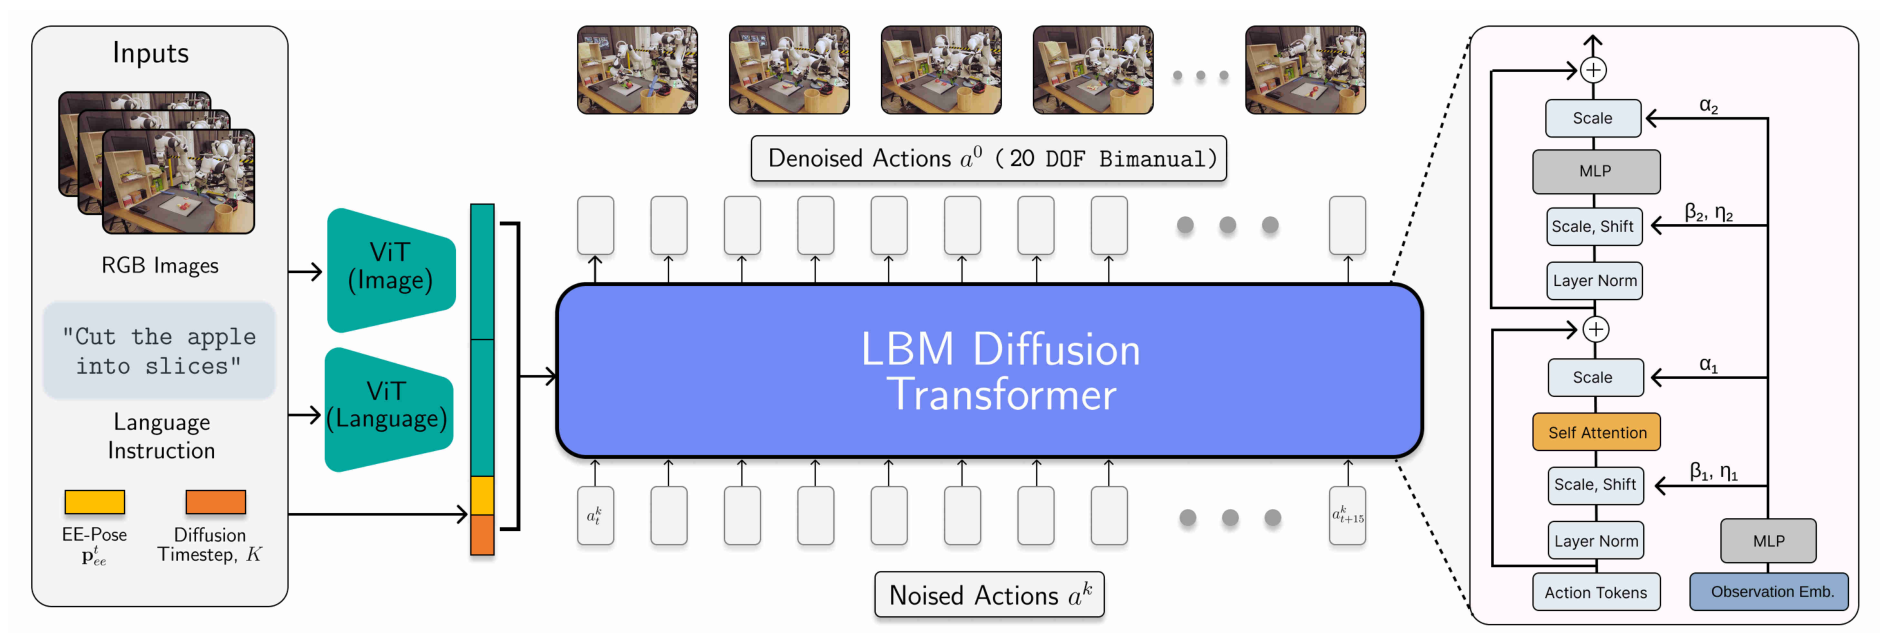
Figura 9 original (PDF p. 12). Codificación de observaciones a la izquierda, desruido de acciones en el centro y módulos de condicionamiento del Transformer a la derecha.
El codificador de visión resume cada imagen con su token de clasificación (CLS). Sus pesos se actualizan durante el entrenamiento y se comparten entre cámaras. El codificador de texto produce una representación de instrucción de longitud fija; su backbone está congelado, mientras que la proyección posterior es entrenable. El Diffusion Transformer (DiT) aplica self-attention a lo largo de la secuencia de acciones y predice ruido para todo el segmento. Aquí los tokens son unidades de características y pueden ser vectores continuos.
Dimensiones de observación y acción
El artículo usa dos marcos de observación con hasta seis vistas RGB, rellenando con ceros las cámaras que faltan. La propiocepción incluye poses del efector final relativas a la base y al otro efector final, además de las aperturas de la pinza, en lugar de un vector de ángulos articulares.
Las trayectorias de acción se representan en relación con la observación actual (Secciones IV-D1 y IV-D2 del artículo). La acción de cada mano contiene tres componentes de traslación, una representación de rotación de seis dimensiones y un valor de apertura de pinza. Por lo tanto, la dimensión de la acción bimanual es:
es la dimensión de la acción por paso de control. La red produce 16 pasos, dando una muestra de con 320 valores. La representación de rotación 6D usa las dos primeras filas de una matriz de rotación; no denota seis articulaciones rotacionales. Estas salidas de 20 dimensiones no pueden accionar directamente un controlador articular de un solo brazo.
El artículo concatena 6.732 características de observación a través de los dos fotogramas y usa ocho bloques DiT con dimensión oculta 768. LeRobot calcula la dimensión de condicionamiento a partir de su número de cámaras, dimensión de estado y configuración.
Entrenamiento de difusión: predicción de ruido
Sea un fragmento de acción limpio y el contexto visual, de lenguaje y de estado. Durante el entrenamiento se muestrean un nivel de ruido y ruido gaussiano . La formulación estándar del modelo probabilístico de difusión de eliminación de ruido (DDPM) que sigue explica el objetivo: mezclar acciones con ruido según el nivel de ruido y luego predecir el ruido añadido.
Aquí, es la longitud del fragmento, la dimensión de la acción, el factor acumulado de retención de señal en el calendario de ruido, y la predicción de ruido de DiT. La esperanza abarca muestras, ruido y niveles de eliminación de ruido. La Ecuación (2) del artículo da la pérdida de predicción de ruido y escribe el añadido de ruido como . Aquí, la formulación estándar de DDPM explica la ruta add_noise de LeRobot; no es una expansión término a término de la expresión del artículo.
Ejemplo ilustrativo: Para un valor de acción normalizado de , y ruido , la entrada ruidosa es . La red recibe y el contexto de observación; su objetivo es el ruido . Este ejemplo escalar ilustra un elemento; el modelo predice el ruido para todo el fragmento de forma conjunta.
Cómo usa DiT el condicionamiento por observación
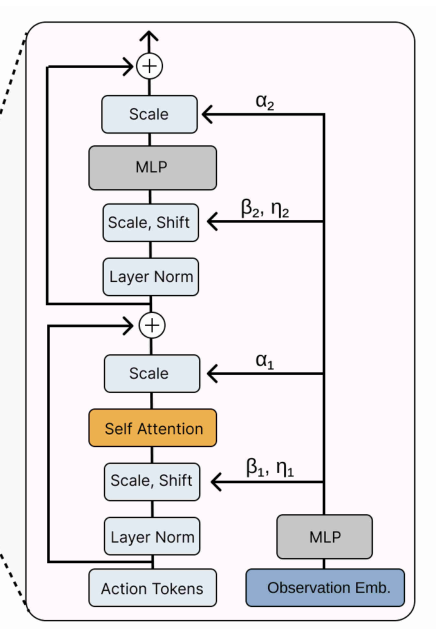
Los vectores de acción proyectados forman una secuencia de tokens. La autoatención conecta los pasos de control, mientras que la normalización de capa adaptativa (adaLN) condiciona las características de acción generando escalas y desplazamientos por característica a partir de la escena y la tarea. Esta modulación puede escribirse como:
denota características de acción ocultas; combina el condicionamiento de visión, texto, estado y paso de eliminación de ruido. es la normalización de capa, y son el ajuste de escala y el desplazamiento predichos, y denota multiplicación elemento a elemento. Estos parámetros se difunden a lo largo de la secuencia de acción, mientras que la atención modela las relaciones entre acciones. LeRobot también predice compuertas para las ramas residuales de atención y perceptrón multicapa (MLP).
Ejemplo ilustrativo: Una característica normalizada de , un ajuste de escala de y un desplazamiento de producen . Diferentes condiciones pueden producir diferentes escalas y desplazamientos. Estos son parámetros internos de características, en lugar de comandos enviados directamente al robot.
Arquitectura: Las observaciones codificadas se concatenan en un vector de condicionamiento de longitud fija que modula las características de acción mediante adaLN. Interpretación de los autores: El rendimiento inconsistente sin ajuste fino puede reflejar en parte una guía de lenguaje débil por parte del pequeño codificador de lenguaje. El artículo no aísla la compresión del condicionamiento en un estudio de ablación, por lo que no establece que la compresión en sí limite las capacidades de lenguaje. Detalle de la parte derecha de la Figura 9 original (PDF p. 12). Las incrustaciones de condicionamiento generan escalas, desplazamientos y compuertas para las ramas de atención y MLP.Figura 9: módulo de condicionamiento ampliado
Inferencia: eliminación de ruido y ejecución
En inferencia, la política codifica las observaciones actuales y aplica repetidamente el mismo DiT para eliminar el ruido de un fragmento de acción aleatorio. El artículo usa muestreo de modelo implícito de difusión de eliminación de ruido (DDIM): el predictor de ruido entrenado actualiza el fragmento de forma iterativa. Tras ejecutar un prefijo seleccionado, la política genera otro fragmento a partir de nuevas observaciones.
La frecuencia de control, la longitud del fragmento y los pasos de muestreo son distintos. El artículo genera 16 pasos de acción y vuelve a planificar tras ejecutar ocho. Generar un fragmento requiere múltiples evaluaciones de DiT. El bucle de política reportado de 10 Hz no implica diez fragmentos nuevos por segundo ni garantiza la latencia en otro hardware.
Entrenamiento: preentrenamiento y ajuste fino
Robots y datos de demostración
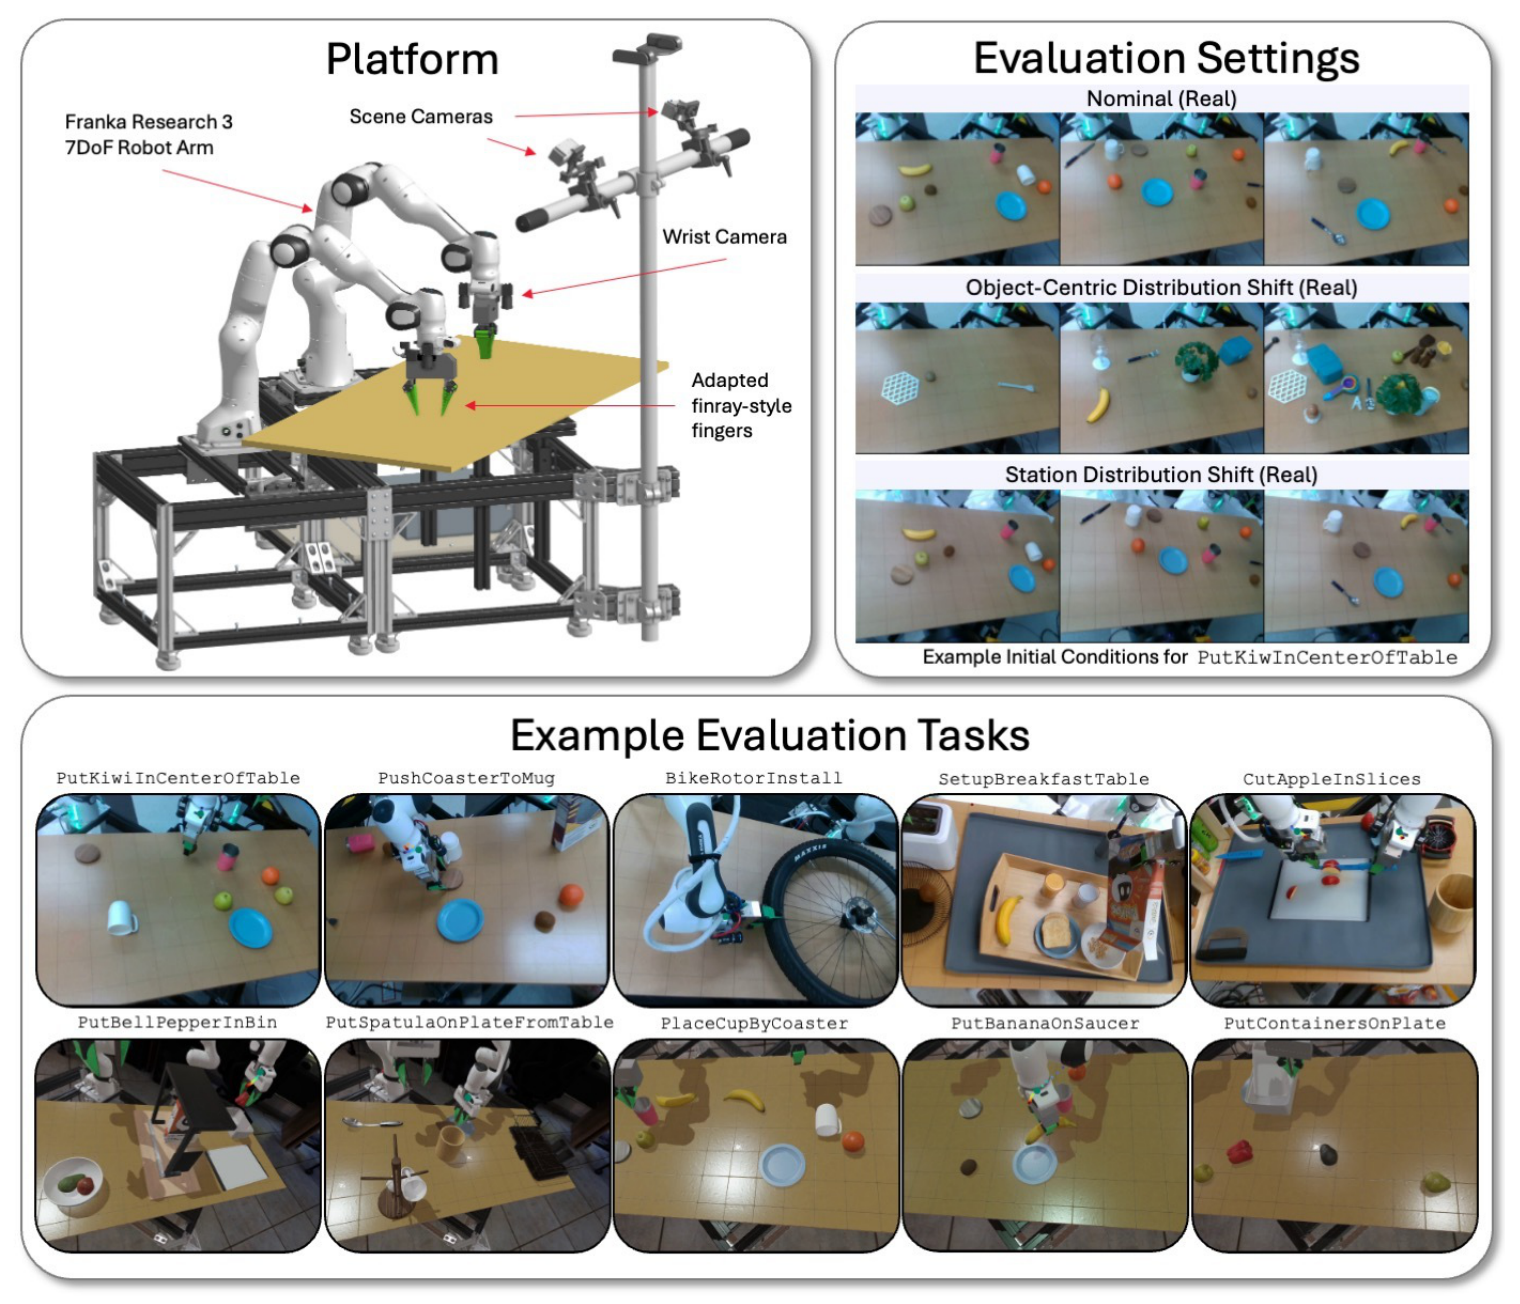
Figura 10 original (PDF p. 14). Arriba a la izquierda: brazos y cámaras. Arriba a la derecha: cambios en el entorno. Abajo: tareas de colocación y manipulación diestra de varios pasos.
El artículo usa dos brazos Franka FR3 con pinzas paralelas y dedos personalizados de estilo finray. La plataforma más reciente tiene dos cámaras de escena y dos cámaras por muñeca, proporcionando seis vistas RGB. Los datos abarcan generaciones de hardware; la evaluación en el mundo real usa la plataforma más reciente. Cinemática inversa diferencial y control de impedancia articular siguen los objetivos del efector final, con la evitación de colisiones gestionada por el controlador de nivel inferior. El aprendizaje de extremo a extremo sigue dependiendo de estas interfaces de ejecución.
| Fuente de datos | Escala reportada | Función |
|---|---|---|
| TRI-Ramen-Real | 468 horas; 362 tareas; 46.063 demostraciones | Datos internos de robot bimanual en el mundo real |
| TRI-Ramen-Sim | 45 horas; 41 tareas; 7.348 demostraciones | Datos de simulación correspondientes a la plataforma real |
| TRI-Ramen-UMI | 32 horas; 129 tareas; 10.851 demostraciones | Manipulación recopilada fuera del laboratorio con dispositivos de mano |
| OXE-Ramen | Aproximadamente 1.150 horas | Subconjunto curado y estandarizado de datos públicos de Open X-Embodiment |
Las tres primeras fuentes suman aproximadamente 545 horas, 532 tareas y 64.262 demostraciones. Incluir OXE-Ramen da aproximadamente 1.695 horas. El recuento de 532 tareas cubre solo los datos recopilados internamente.
Alineación y normalización de datos
Las fuentes de datos requieren marcos de coordenadas, unidades de pose, aperturas de pinza y procesamiento de imágenes coherentes. El artículo convierte datos de un solo brazo a un formato bimanual rellenando con ceros el brazo que falta e intercambiando lados aleatoriamente. Un muestreo ponderado evita que las fuentes más grandes dominen los lotes.
Las acciones más lejanas en el futuro suelen abarcar rangos más amplios. El artículo calcula cuantiles por separado según dimensión de característica, paso temporal relativo y fuente de datos. Mapea el intervalo de percentiles 2–98 a y recorta a ; la representación de rotación 6D se excluye de este escalado.
Diferencia de LeRobot: La versión fijada usa por defecto MIN_MAX para estados y acciones y MEAN_STD para imágenes. No reproduce automáticamente la normalización por cuantiles específica de fuente y paso temporal del artículo. Estas diferencias de preprocesamiento también afectan a los resultados.
Configuración de entrenamiento
| Fase | Inicialización y datos | Tasa de aprendizaje | Tamaño de lote global | Pasos de entrenamiento |
|---|---|---|---|---|
| Preentrenamiento multitarea | Mezcla completa de datos; codificadores de visión y texto preentrenados con CLIP | 3e-4 | 2.560 | 48.000 |
| Ajuste fino de tareas en el mundo real | Pesos LBM más demostraciones de la tarea objetivo | 2e-5 | 320 | 30.000 |
| Ajuste fino de tareas en simulación | Pesos LBM más demostraciones de la tarea objetivo | 2e-5 | 320 | 10.000 |
| Línea base de tarea única en el mundo real | Sin preentrenamiento multitarea de robot; misma inicialización CLIP | 2e-5 | 320 | 100.000 |
| Línea base de tarea única en simulación | Misma inicialización; solo demostraciones de la tarea objetivo | 2e-5 | 320 | 25.000 |
El codificador de visión usa una décima parte de la tasa de aprendizaje de los otros componentes entrenables. Las imágenes de entrenamiento se redimensionan a 256×342 (alto × ancho), se recortan aleatoriamente a 224×224 y se someten a aumentos de color. La inferencia usa un recorte centrado.
Entrenar “desde cero” significa sin preentrenamiento multitarea de robot; se mantiene la inicialización CLIP. Las líneas base de tarea única reciben más pasos de entrenamiento en la tarea objetivo.
Metodología de evaluación
Divisiones de tareas y puntuación
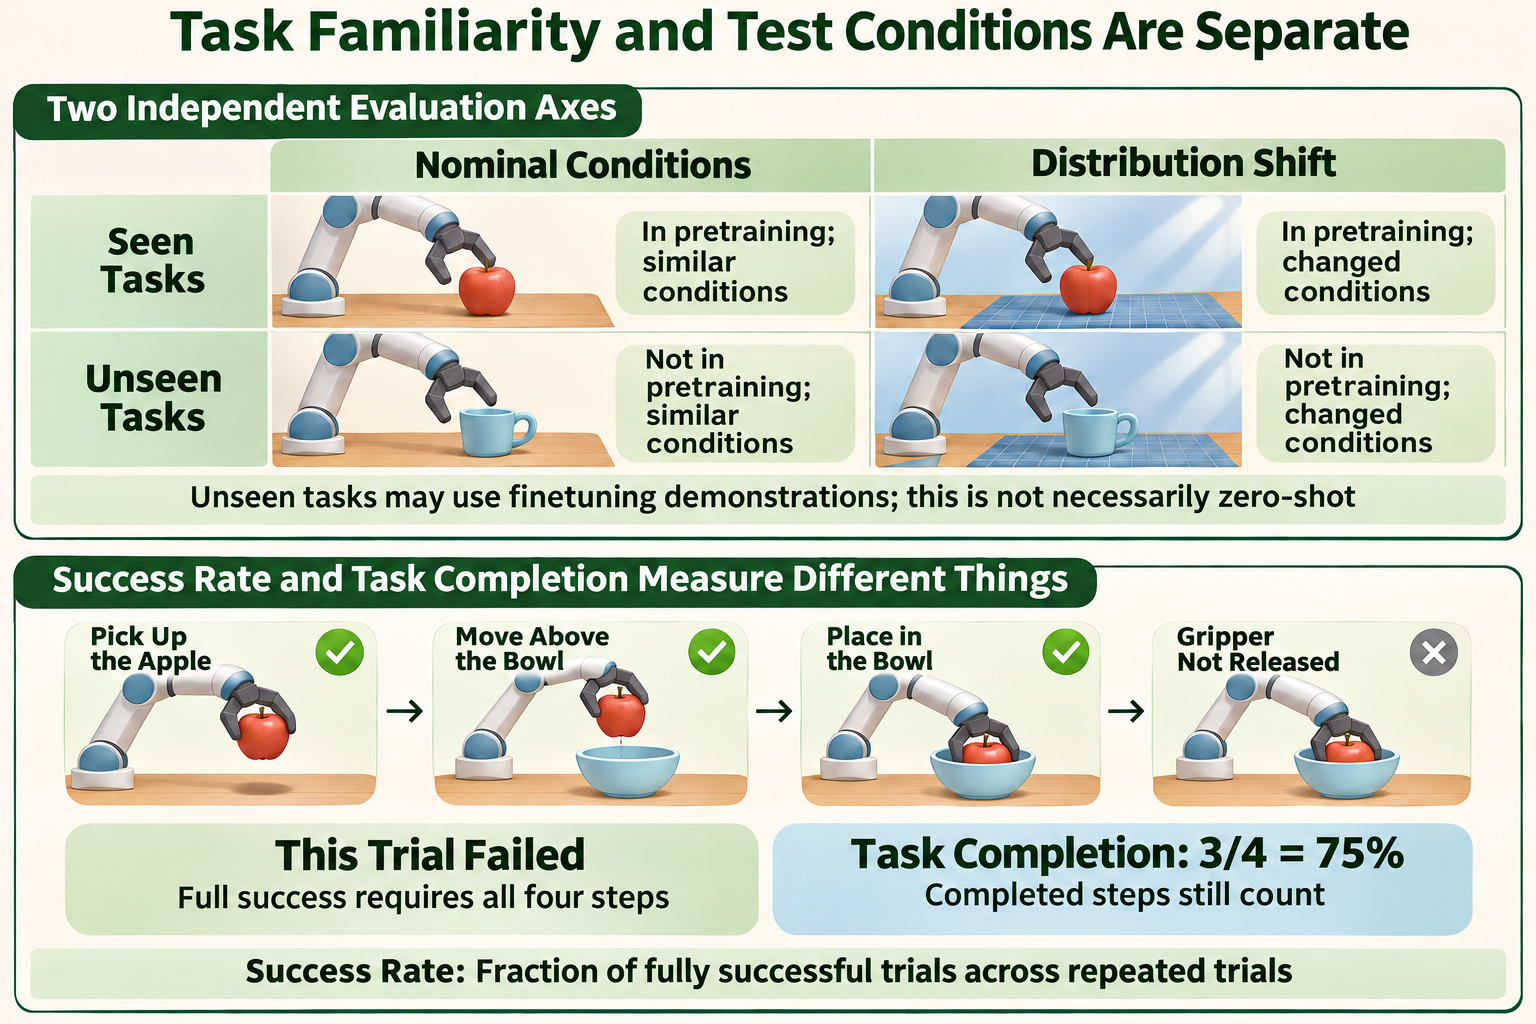
Ilustración didáctica basada en el artículo. La rúbrica de cuatro pasos para colocar la manzana explica las métricas y no es un registro de una tarea evaluada.
El panel superior separa tareas vistas/no vistas de cambio de distribución. Las tareas no vistas aún pueden proporcionar demostraciones de ajuste fino. El cambio de distribución se refiere a cambios en las condiciones de prueba, como distractores, combinaciones de objetos o estaciones de robot.
El panel inferior usa cuatro hitos para distinguir la tasa de éxito (SR) de la finalización de la tarea (TC). Si la manzana llega al cuenco pero la pinza no la ha soltado, tres de los cuatro hitos están completos: TC es 75%, pero el intento no tiene éxito. Este es un ejemplo ilustrativo de puntuación.
cuenta los ensayos y cuenta los ensayos completamente exitosos. es el número de hitos; indica si el ensayo completa el hito .
Enmascaramiento, aleatorización y reinicios
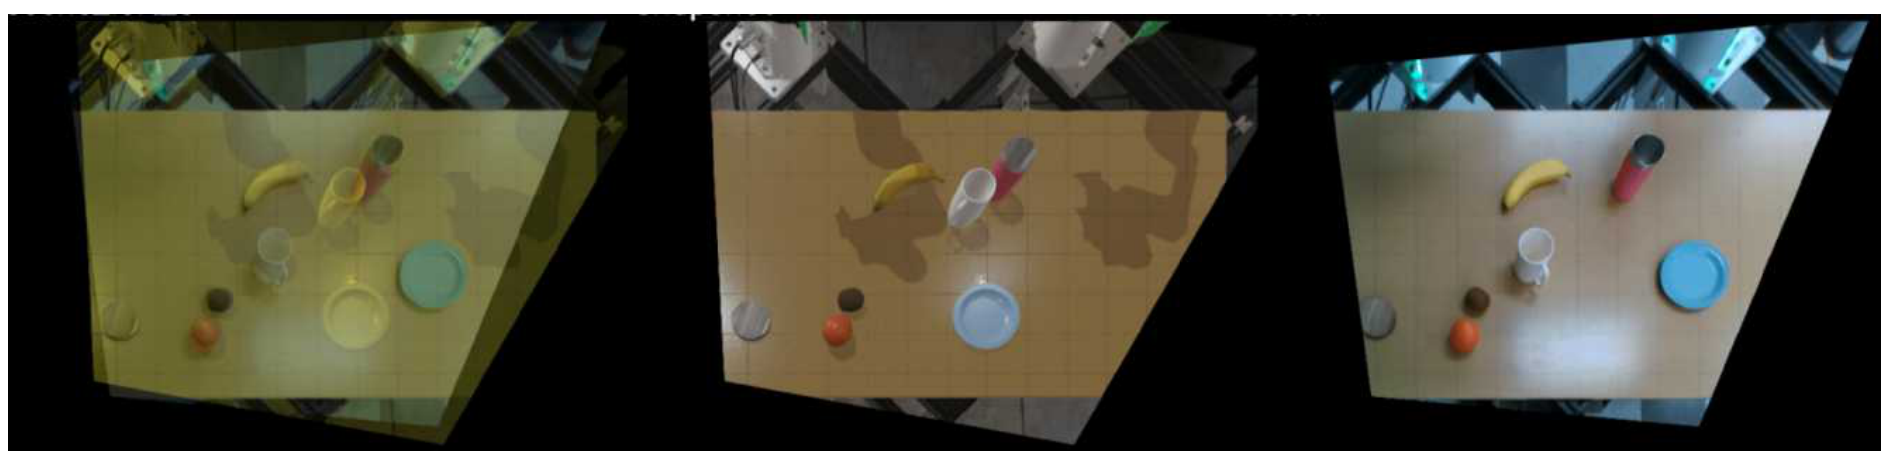
Figura 8 original (PDF p. 11). Izquierda: una superposición de la escena objetivo y la escena actual ayuda con los reinicios. Centro: escena objetivo. Derecha: escena actual.
Quienes evalúan desconocen la identidad de la política. Las políticas se ejecutan en orden aleatorio desde condiciones iniciales emparejadas, con reinicios después de cada rollout para reducir sesgos de orden, iluminación y colocación. La simulación usa semillas aleatorias emparejadas; los reinicios en el mundo real usan superposiciones de imágenes. Los estados iniciales de prueba no simplemente reproducen demostraciones individuales de entrenamiento.
La evaluación en el mundo real incluye tres tareas vistas y cinco no vistas; la simulación incluye 16 tareas vistas y ocho no vistas. Cada combinación tarea–política–condición se programa para 50 rollouts en el mundo real o 200 rollouts en simulación. Algunas combinaciones en simulación tienen menos de 200 debido a datos faltantes. El análisis cubre aproximadamente 1.800 rollouts en el mundo real y más de 47.000 rollouts en simulación.
Diagramas de violín y comparaciones estadísticas
Los violines de SR muestran posteriores bayesianos sobre la verdadera probabilidad de éxito, estimados a partir de resultados de éxito/fracaso. Los gráficos de TC por tarea individual muestran principalmente distribuciones empíricas de finalización; algunos gráficos agregados y de eficiencia de datos muestran en cambio posteriores sobre la finalización media. Estos representan cantidades diferentes.
El artículo usa Compact Letter Display (CLD) para resumir comparaciones estadísticas. Los grupos sin ninguna letra compartida difieren de forma significativa. Una letra compartida significa que no se detectó una diferencia significativa, más que un rendimiento equivalente. Interpreta las letras junto con el pie de figura, la prueba estadística y el alcance de la comparación.
Resultados y limitaciones
Finalización en tareas no vistas
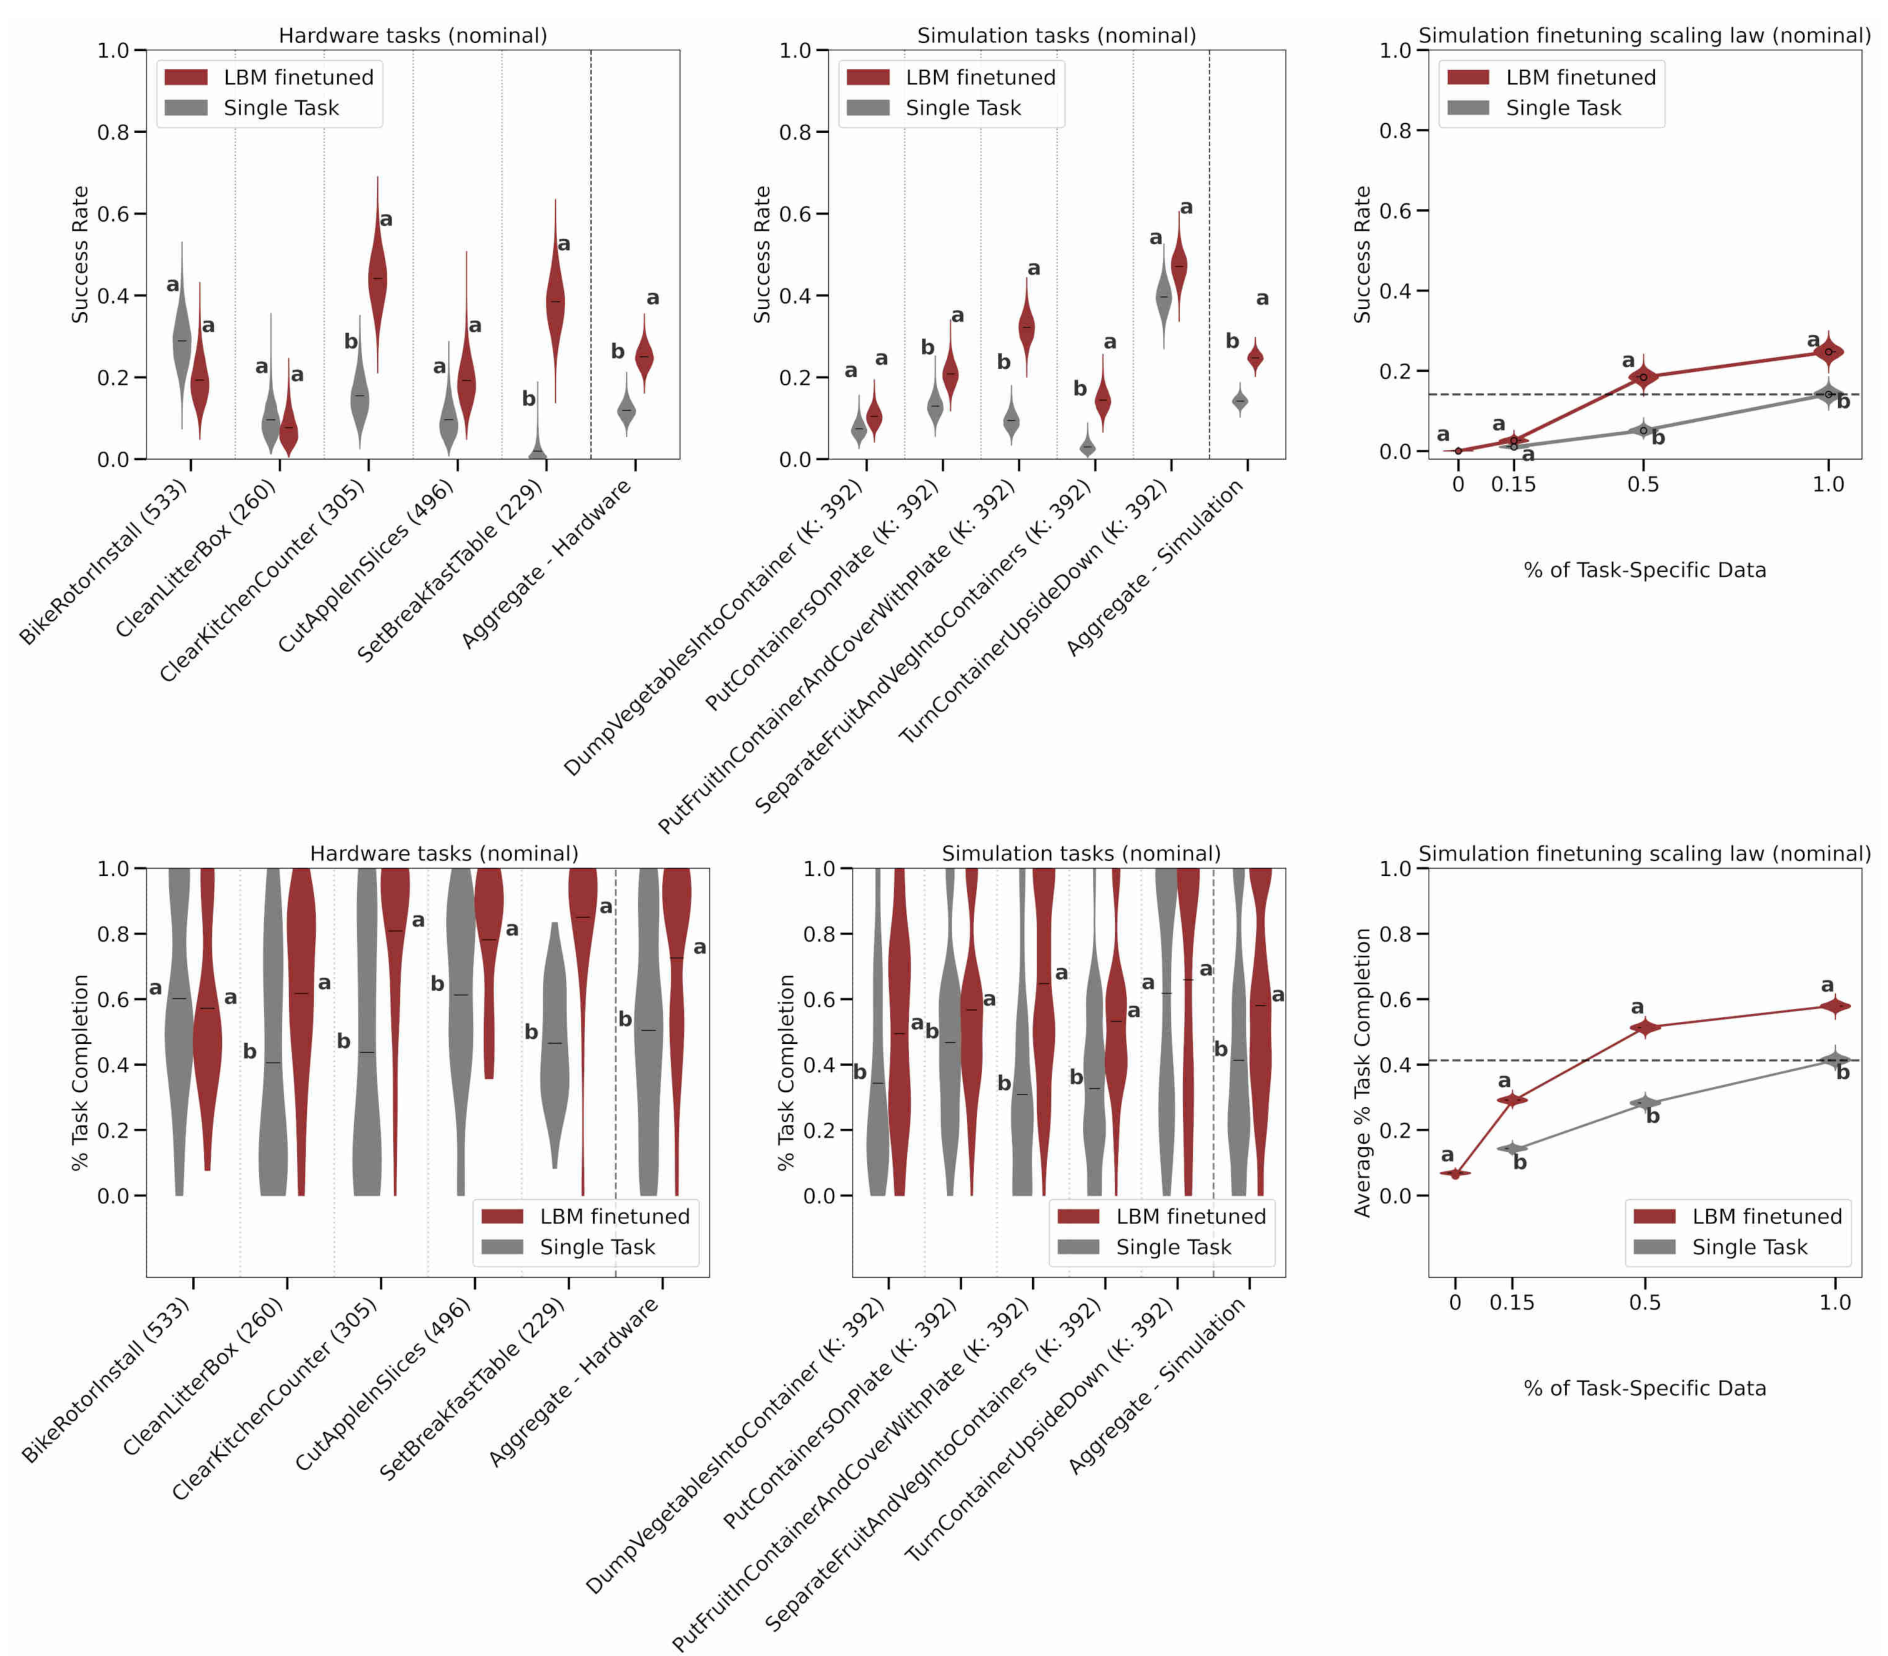
Figura 4 original (PDF p. 7). Tareas no vistas bajo condiciones nominales. Arriba: SR. Abajo: TC. Columnas: tareas en el mundo real, tareas en simulación y eficiencia de datos en simulación. Rojo: LBM preentrenado y afinado. Gris: baseline de tarea única.
El éxito completo sigue siendo difícil en tareas complejas, pero los LBM afinados generalmente completan más hitos. Entre cinco tareas complejas no vistas en el mundo real, TC es significativamente mayor que el baseline de tarea única en cuatro, mientras que SR es significativamente mayor solo en dos.
Las ganancias agregadas son más consistentes, pero algunas diferencias individuales no son significativas o favorecen al baseline. Las políticas pueden permanecer inactivas al inicio o intentar la tarea equivocada, por lo que los resultados individuales y los casos de fallo importan.
Robustez: ¿se mantienen las ganancias cuando cambian las condiciones de prueba?
Los cambios de distribución en simulación alteran principalmente la apariencia: mapas de iluminación de entorno no vistos, diferentes parámetros de luces y cámara, y texturas o colores cambiados de objetos y mesa. Algunas escenas también incluyen distractores. Los autores comparan LBM afinados con baselines de tarea única bajo estos cambios para comprobar si las ganancias del preentrenamiento se mantienen.
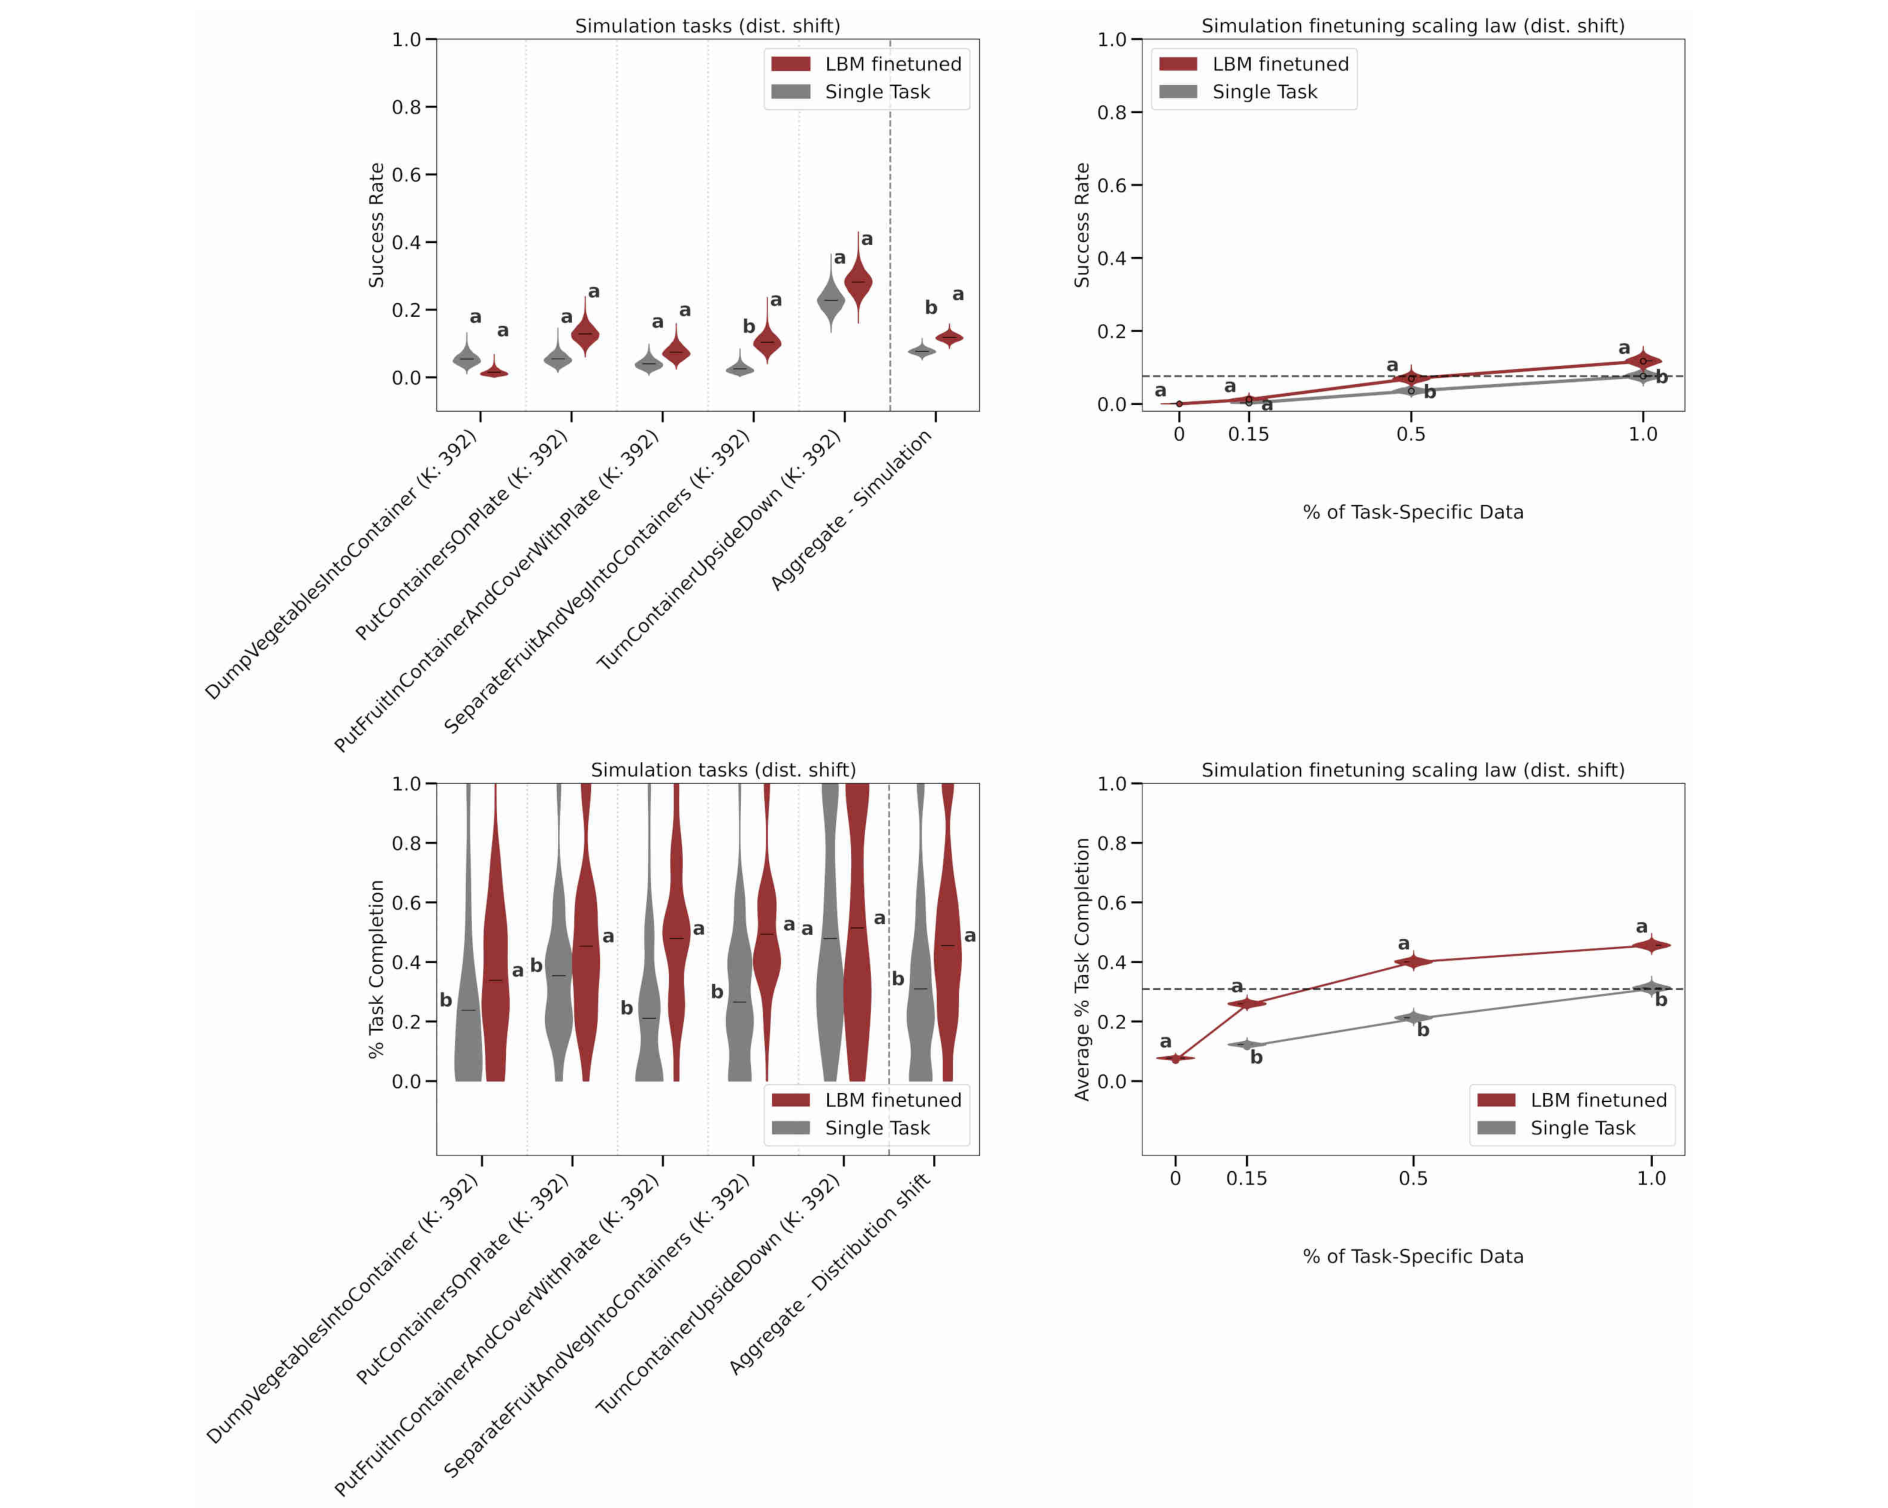
Figura 6 original (PDF p. 9). Arriba: SR. Abajo: TC. Izquierda: tareas individuales y resultados agregados. Derecha: fracciones variables de datos de la tarea objetivo. Rojo: LBM preentrenado y afinado. Gris: baseline de tarea única. Compárese con los paneles de simulación de la Figura 4; la Figura 6 no contiene resultados del mundo real.
Para cinco tareas complejas no vistas en simulación bajo cambio de distribución, TC es significativamente mayor que el baseline en cuatro tareas, pero SR es significativamente mayor solo en una. En tareas vistas de simulación, el número con SR significativamente mayor aumenta de 3/16 bajo condiciones nominales a 10/16 bajo cambio de distribución; la brecha agregada de tasa de éxito también se amplía (Sección III-A y Figura 2).
Estos hallazgos respaldan una mayor robustez de los LBM afinados bajo los cambios probados, aunque el rendimiento absoluto disminuye en la mayoría de las tareas después de los cambios. Completar más hitos puede seguir dejando que el éxito completo sea poco frecuente. Los cambios de apariencia simulados también difieren de los cambios reales en la estación y los objetos.
Eficiencia de datos en nuevas tareas
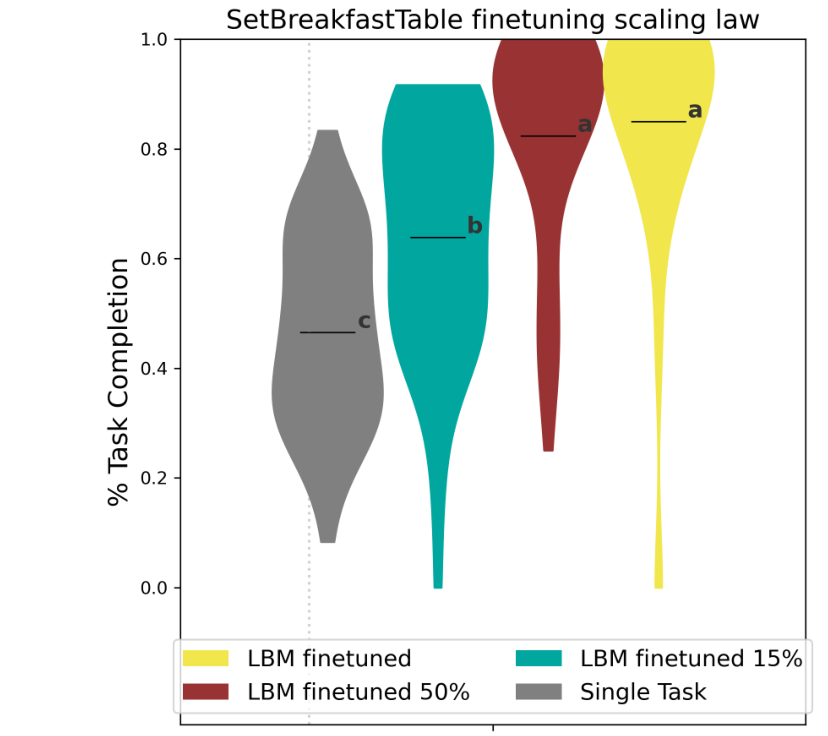
Figura 5 original (PDF p. 8). Eficiencia de datos en el mundo real: el eje vertical es TC. Cada grupo compara LBM afinados con diferentes fracciones de datos con un baseline de tarea única entrenado con todos los datos de la tarea objetivo.
En la tarea del mundo real SetBreakfastTable, un LBM afinado con el 15% de los datos de la tarea objetivo logra un TC significativamente mayor que el baseline de tarea única entrenado con todos ellos. Este resultado se refiere a la finalización, no a la tasa de éxito.
La interpolación de curvas agregadas para tareas complejas en simulación sugiere que un rendimiento comparable puede requerir menos del 30% de los datos necesarios para entrenar desde cero. Este resultado y el 15% en el mundo real provienen de experimentos diferentes; ninguno establece una proporción fija de ahorro de datos para cada tarea.
Escala y diversidad de los datos de preentrenamiento
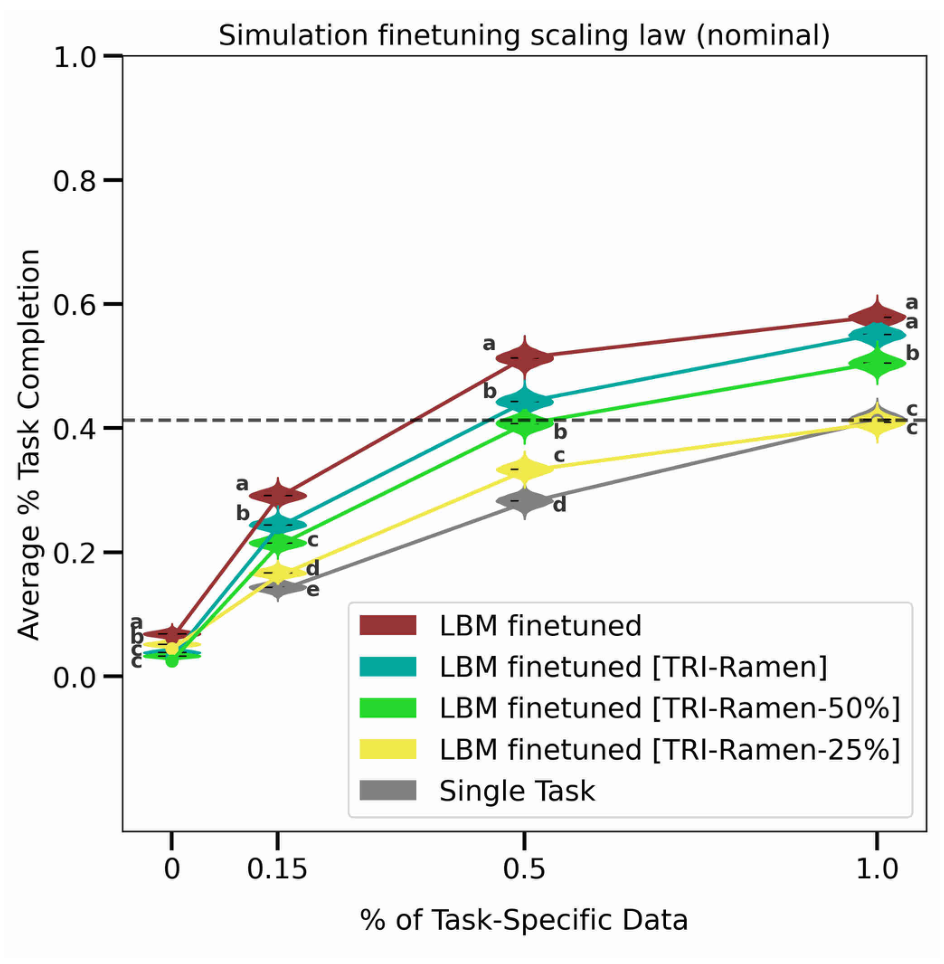
Figura 7 original (PDF p. 10). Eje horizontal: fracción de datos de fine-tuning. Eje vertical: TC medio en cinco tareas de simulación no vistas. Las curvas corresponden a diferentes mezclas de preentrenamiento.
A la misma fracción de datos de fine-tuning, datos de preentrenamiento más diversos generalmente producen mejor rendimiento, especialmente cuando los datos de la tarea objetivo son escasos. El eje horizontal varía los datos de fine-tuning. Estos experimentos limitados con subconjuntos no establecen ni una ley de escalado universal ni beneficios por aumentar el número de parámetros del modelo.
Limitaciones
- Las ganancias sin fine-tuning son inconsistentes. Los LBM preentrenados no superan de forma consistente a las políticas de tarea única; los autores sugieren que esto puede reflejar en parte limitaciones en la guía por lenguaje del pequeño codificador de lenguaje.
- El alcance experimental es limitado. Los resultados en una plataforma bimanual concreta no se generalizan directamente a robots de un solo brazo o a hogares arbitrarios.
- No se evalúa completamente la aleatoriedad del entrenamiento. Los diagramas de violín capturan principalmente la incertidumbre de evaluación para checkpoints fijos, más que la variación entre ejecuciones de entrenamiento independientes.
- El preentrenamiento contenía un error de normalización. Algunos datos usaron parámetros de otra fuente, y no se repitieron todos los experimentos principales. Tras la corrección, experimentos suplementarios mejoraron el rendimiento bajo los cambios de distribución en simulación probados.
- Filtrar fotogramas estacionarios tiene efectos mixtos. Eliminar segmentos iniciales de bajo movimiento mejoró algunas políticas de simulación de tarea única pero hizo que algunos modelos preentrenados eligieran la tarea equivocada con más frecuencia. Por lo tanto, no se aplicó de forma uniforme.
Implementación y aplicación en LeRobot
La siguiente comparación usa el commit f5c9bc0 (enlaces a la fuente más abajo). LeRobot MultiTask DiT sigue el enfoque DiT condicional de LBM, pero su configuración, preprocesamiento y resultados de entrenamiento deben interpretarse por separado.
Comparación de configuración
| Componente | Artículo de TRI | Valores predeterminados fijados de LeRobot |
|---|---|---|
| Objetivo | Predicción de ruido de difusión; muestreo DDIM | diffusion; también admite flow_matching |
| Backbones de imagen y texto | CLIP; visión entrenable, texto congelado | Mismo enfoque; por defecto openai/clip-vit-base-patch16 |
| Tamaño de DiT | 8 capas; dimensión oculta 768 | 6 capas; dimensión oculta 512; 8 cabezas de atención |
| Historial de observación | 2 fotogramas | n_obs_steps=2 |
| Salida de acción | 16 pasos, cada uno de 20 dimensiones | horizon=32; dimensión de acción desde el dataset |
| Segmento de ejecución | Ejecutar 8 pasos antes de replanificar | n_action_steps=24; segmentar usando el desplazamiento de observación y luego encolar |
| Cámaras | Estandarizado a 6 vistas; vistas faltantes con padding de ceros | Recuento inferido a partir de las características de entrada; codificador de visión compartido por defecto |
| Normalización | Cuantiles por fuente, timestep relativo y dimensión de característica | Estados y acciones: MIN_MAX; imágenes: MEAN_STD |
De forma predeterminada, num_inference_steps=None recurre a num_train_timesteps=100, dando 100 pasos de eliminación de ruido. Las incrustaciones de posición rotatorias (RoPE) están activadas por defecto. También se admiten incrustaciones de posición absolutas aprendibles; esta versión permite ambas simultáneamente.
El número de parámetros depende del número de cámaras, el número de capas y la dimensión oculta. Los 450M de parámetros, el horizonte de predicción de 48 pasos y el segmento de ejecución de 24 pasos del blog de Boston Dynamics describen la configuración de Atlas y no se aplican a todas las configuraciones de LeRobot.
Ventana de acción y segmento de ejecución
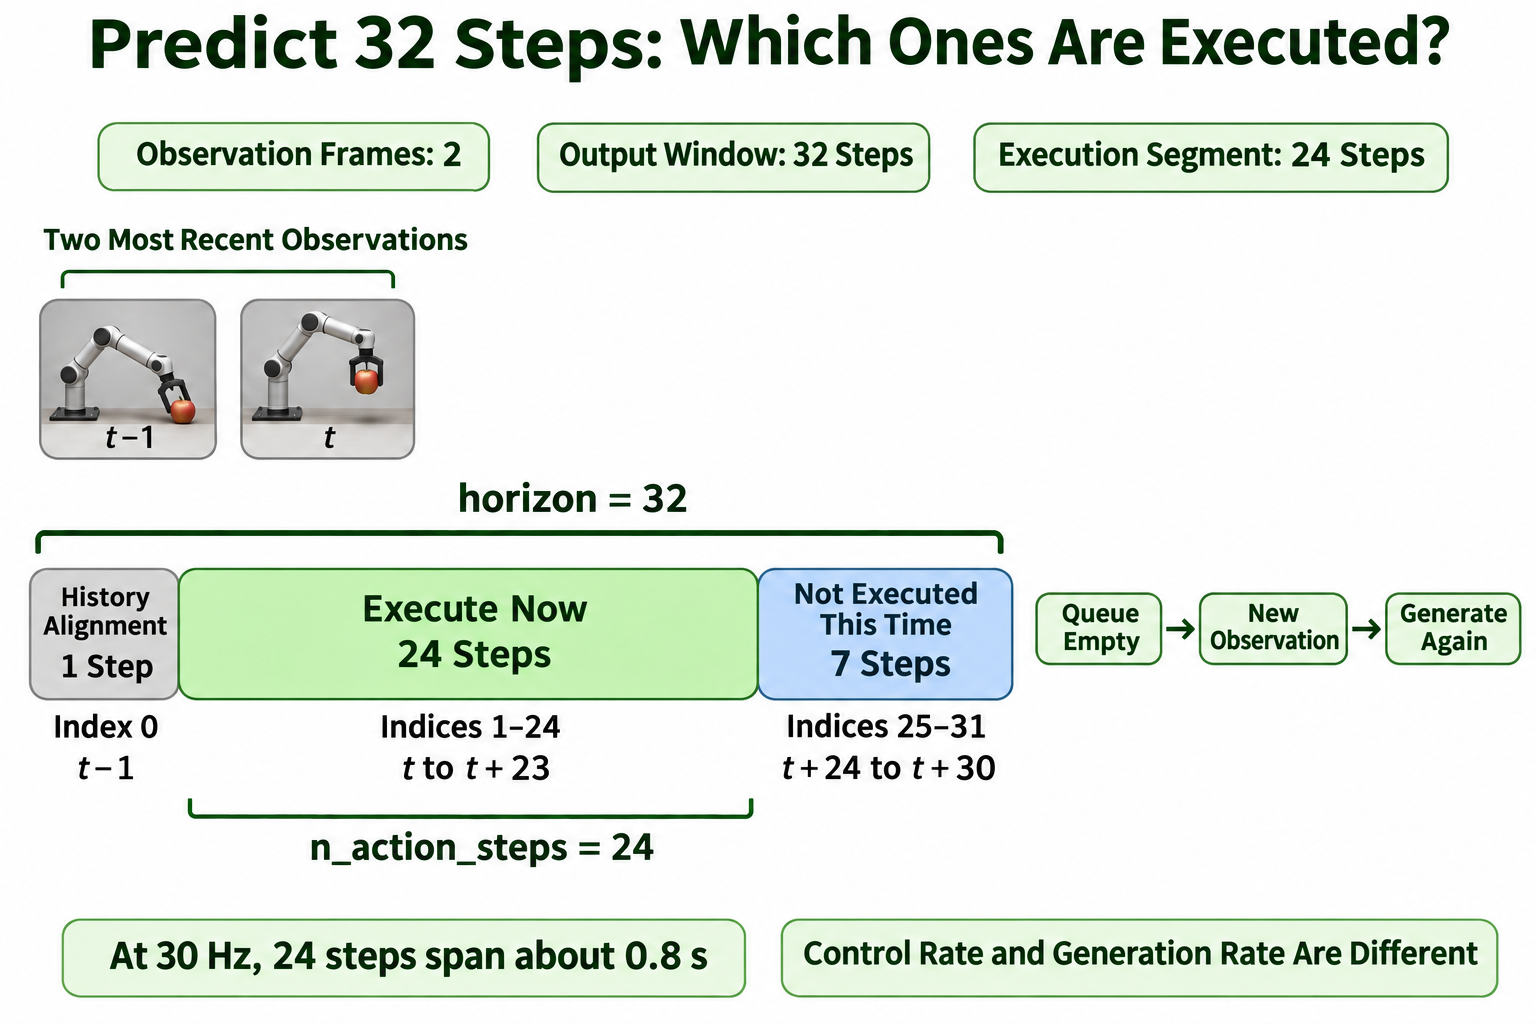
Ilustración didáctica basada en el recorte de acciones en la implementación fijada de LeRobot. La ventana de 32 pasos y el segmento de ejecución de 24 pasos son los valores predeterminados de esta versión.
Con dos fotogramas de observación, la ventana de acción comienza en . _generate_actions toma los índices 1:25, colocando 24 acciones desde hasta en la cola de ejecución. La longitud de ventana , el número de observaciones y la longitud de ejecución deben satisfacer:
Para , y , esto da .
Cuando el muestreo de demostraciones y la ejecución de acciones se ejecutan ambos a 30 Hz, 24 pasos corresponden a los 0,8 segundos ilustrados; a 10 Hz, abarcan aproximadamente 2,4 segundos. Los segmentos de ejecución más cortos incorporan nuevas observaciones antes, pero requieren una generación más frecuente. El tiempo real también depende de la latencia de inferencia y comunicación; los parámetros de la ventana no establecen la frecuencia de control.
Inicialización del entrenamiento y conclusiones del artículo
LeRobot puede inicializar sus codificadores de imagen y texto a partir de pesos CLIP preentrenados y entrenar una política de acción con tus propias demostraciones de robot. Esto no proporciona la experiencia de preentrenamiento multitarea de robots de TRI. Probar los beneficios de transferencia del artículo requiere comparar el entrenamiento de una sola tarea con el preentrenamiento multitarea seguido de ajuste fino, controlando al mismo tiempo los datos de la tarea objetivo, las interfaces de acción y las condiciones de prueba.
Para la adaptación a reBot o SO-ARM101, primero comprueba los estados del conjunto de datos, las acciones, las cámaras, las marcas de tiempo y las instrucciones de la tarea, y luego valida la canalización de control de una sola tarea.
Interpretación de las conclusiones
El artículo utiliza una arquitectura de política fija y una evaluación controlada para probar los beneficios del preentrenamiento multitarea. En las tareas evaluadas, el preentrenamiento seguido de ajuste fino mejora el rendimiento agregado y reduce las demostraciones de la tarea objetivo necesarias para un rendimiento comparable. Algunas ventajas se vuelven más pronunciadas cuando cambian las condiciones de prueba.
Los resultados respaldan el preentrenamiento en demostraciones diversas dentro de límites claros: las ganancias dependen de la tarea y de las condiciones de ajuste fino; un mejor grado de finalización no implica necesariamente un éxito completo; y los modelos sin ajuste fino no superan de forma consistente a las políticas de una sola tarea. Comprender la contribución requiere conectar la generación de acciones, las comparaciones experimentales y el alcance de la evidencia.
Referencias
- TRI LBM Team. A Careful Examination of Large Behavior Models for Multitask Dexterous Manipulation, 2025.
- TRI. LBM project page.
- Hugging Face. Multitask DiT Policy.
- Hugging Face / Bryson Jones. configuration, model y processor fijados.
- Boston Dynamics. Large Behavior Models and Atlas Find New Footing. DiT y flow matching para Atlas.
- Bryson Jones. Dissecting and Open-Sourcing Multitask Diffusion Transformer Policy. Notas de arquitectura e implementación del autor de la implementación de código abierto.