π0: Cómo el Flow Matching conecta la visión y el lenguaje con las acciones del robot
π0: Un modelo de flujo Visión-Lenguaje-Acción para control robótico general
- Modelos fundacionales para robots
- Experto en acciones
- Flow matching
- Entrenamiento entre diferentes morfologías
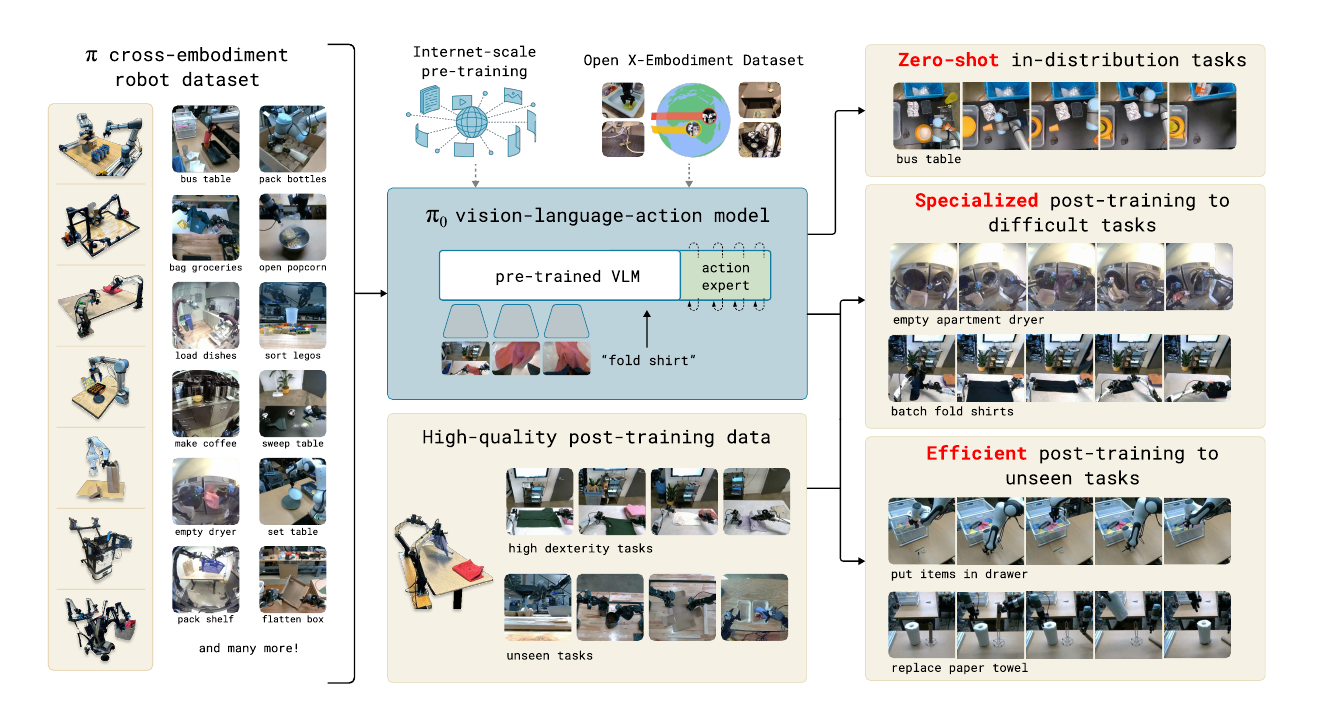
π0 utiliza el modelo visión-lenguaje PaliGemma preentrenado como backbone semántico y añade un experto en acciones de aproximadamente 300M parámetros. El flow matching condicional genera fragmentos de acción continuos, mientras que el pre-entrenamiento a gran escala entre diferentes robots y el post-entrenamiento de alta calidad en tareas adaptan el mismo modelo a sistemas de un solo brazo, bimanuales y móviles.
Requisitos previos
¿Qué es un modelo Visión-Lenguaje-Acción?
Acciones discretas autoregresivas y fragmentos continuos
Entrenamiento, inferencia y evaluación
Resumen
Traducción
El aprendizaje de robots promete sistemas flexibles, de propósito general y diestros, además de ofrecer información sobre cuestiones fundamentales de la IA. Alcanzar la generalidad necesaria para sistemas reales aún se enfrenta a obstáculos importantes en datos, generalización y robustez.
El artículo pregunta cómo las políticas robóticas generalistas, o modelos fundacionales para robots, pueden abordar estos desafíos en tareas complejas y diestras. Introduce una arquitectura de flow matching construida sobre un VLM preentrenado, que hereda conocimiento semántico de datos a escala de internet, y luego la entrena en diversas plataformas de un solo brazo, bimanuales y de manipulación móvil.
La evaluación cubre tres configuraciones: prompting directo, seguimiento de instrucciones en lenguaje natural de una persona o de una política VLM de alto nivel, y fine-tuning para nuevas habilidades. Las tareas incluyen doblar ropa, limpiar mesas y ensamblar cajas de cartón.
Comentario
-
La arquitectura es solo una parte del problema. El artículo identifica tres cuellos de botella: escala de datos suficiente, una arquitectura para acciones continuas de alta frecuencia y recetas adecuadas de pre-/post-entrenamiento.
-
El VLM aporta comprensión; el experto en acciones aporta control. PaliGemma gestiona la semántica imagen-lenguaje, mientras que el experto procesa el estado del robot, acciones ruidosas y salidas continuas.
-
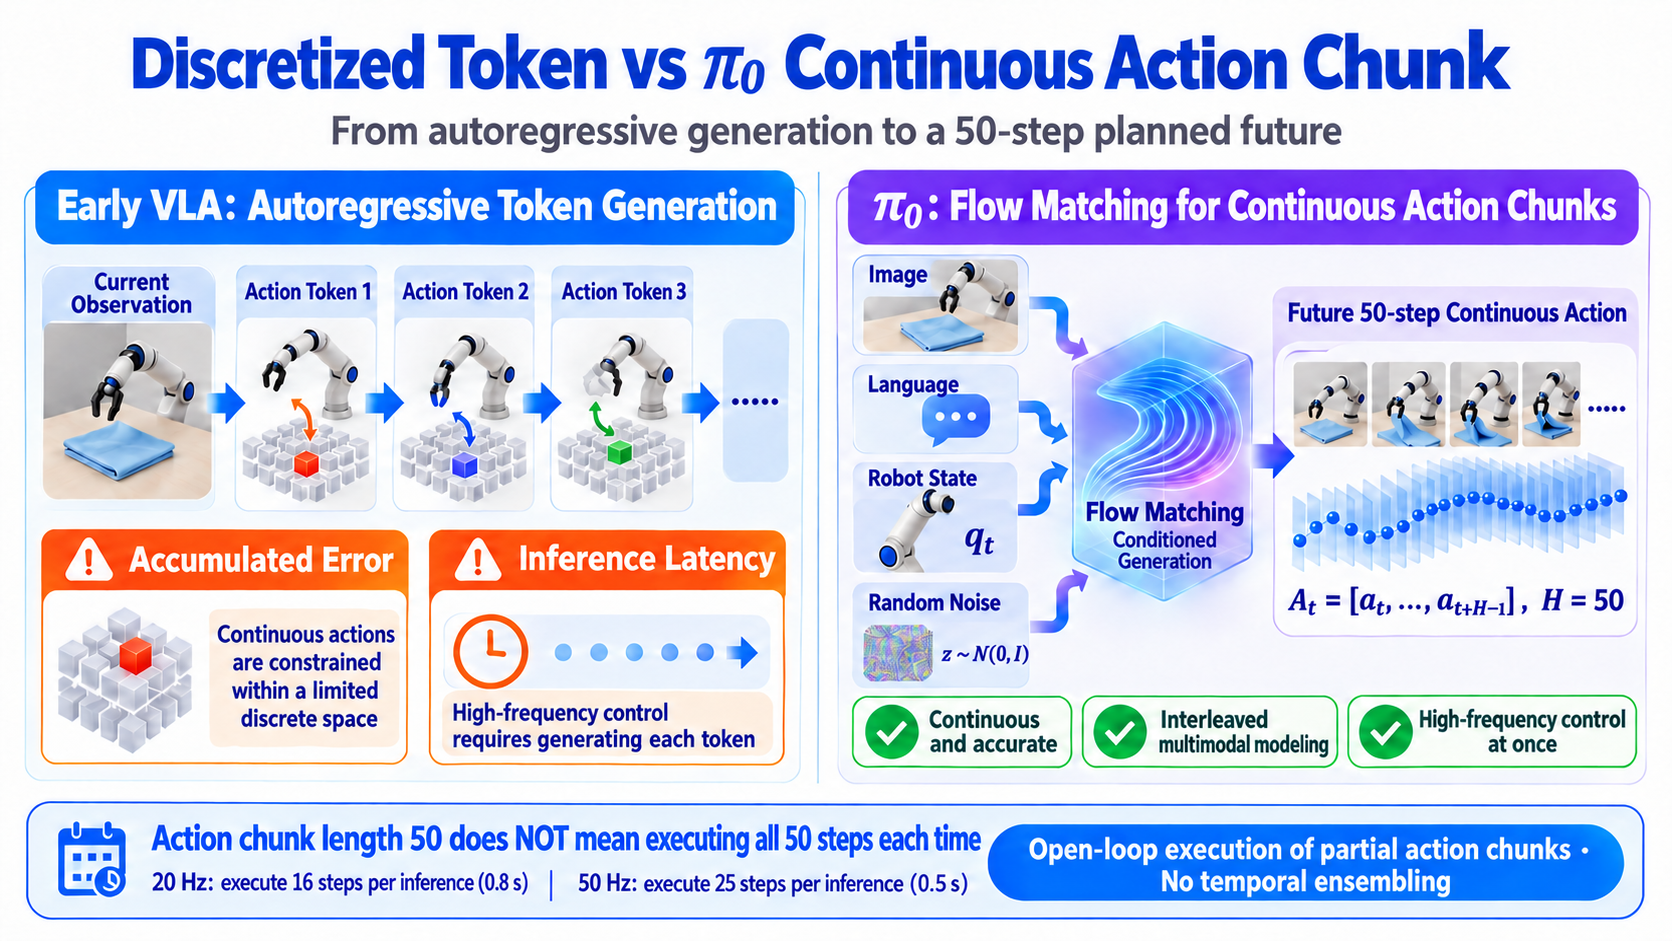
El flow matching sustituye la generación autoregresiva de tokens de acción. El modelo genera en paralelo el fragmento continuo completo a partir de ruido.
-
Los datos entre diferentes morfologías son centrales. Los brazos y las bases móviles tienen espacios de estado y acción distintos. El relleno (padding) y las ranuras de imagen enmascaradas proporcionan una interfaz de entrenamiento compartida.
-
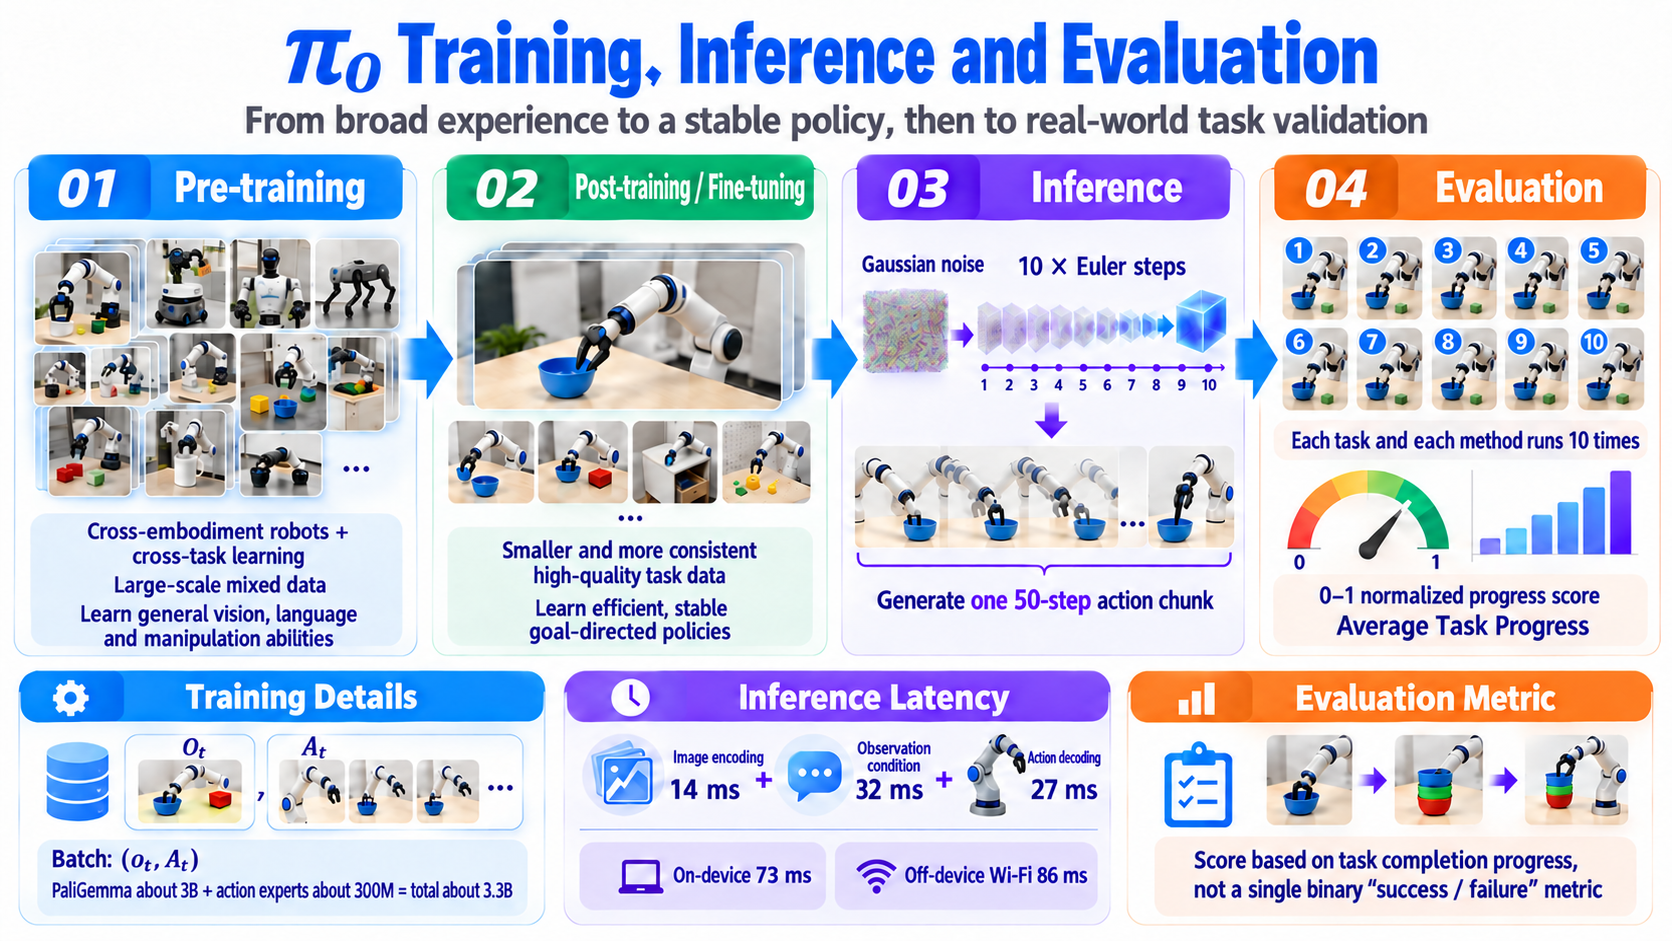
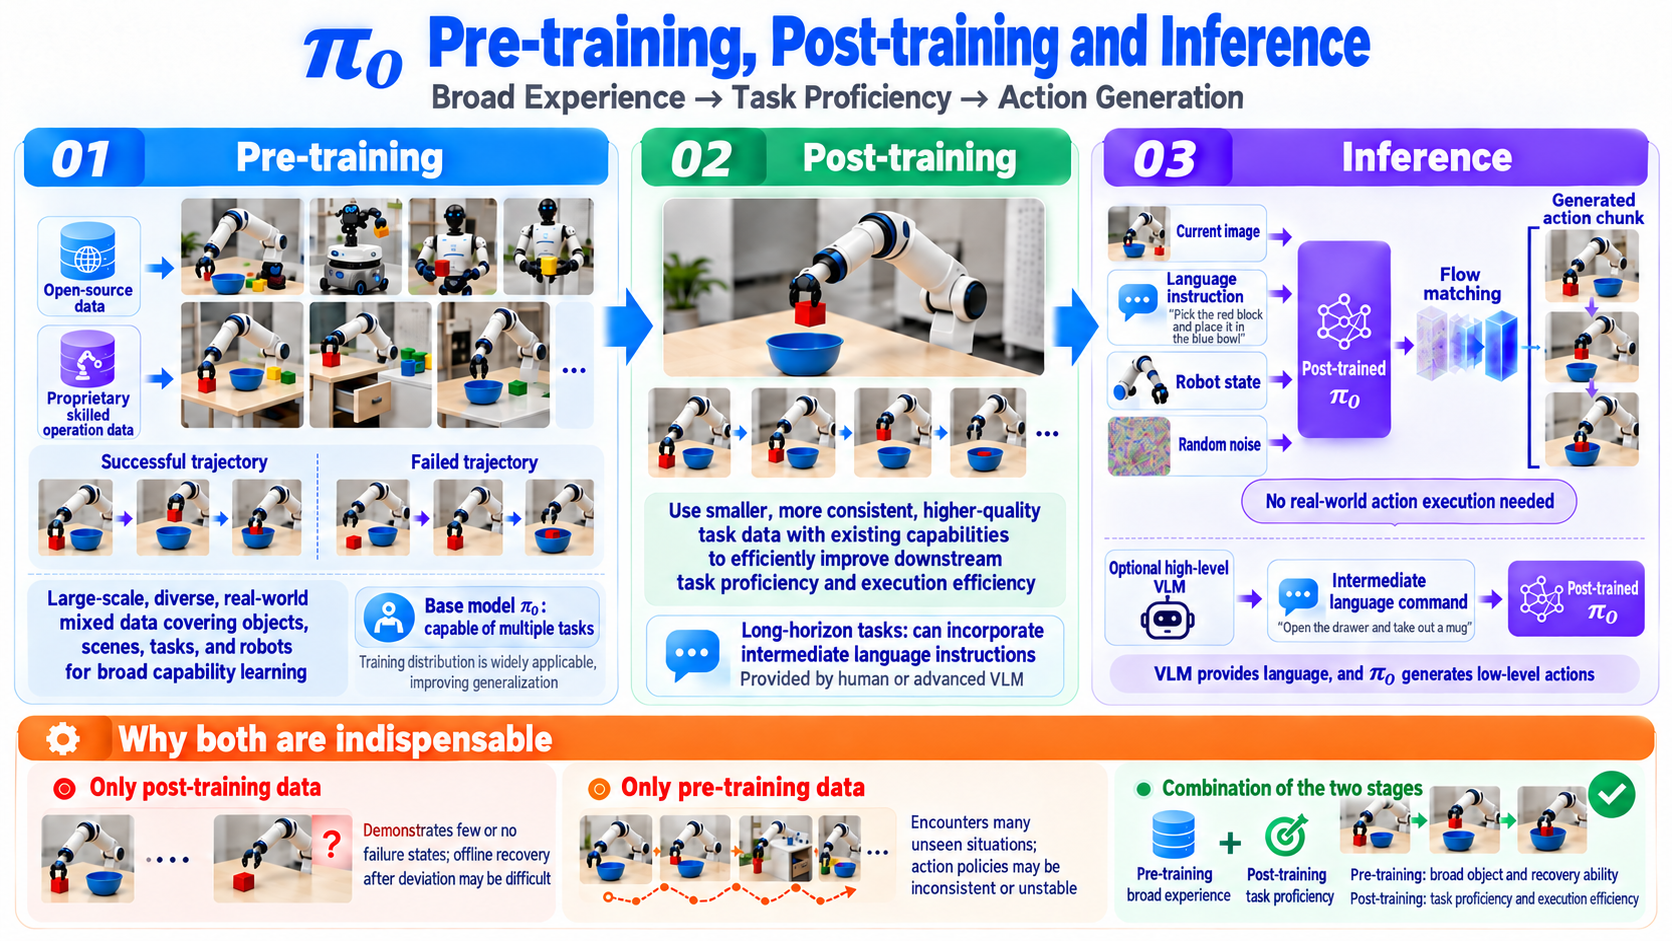
El pre-entrenamiento y el post-entrenamiento tienen funciones distintas. El pre-entrenamiento amplio incluye estados inusuales y comportamientos de recuperación; el post-entrenamiento enfatiza el éxito consistente y fluido. Juntos sustentan la capacidad de adaptación y la calidad de ejecución.
Introducción
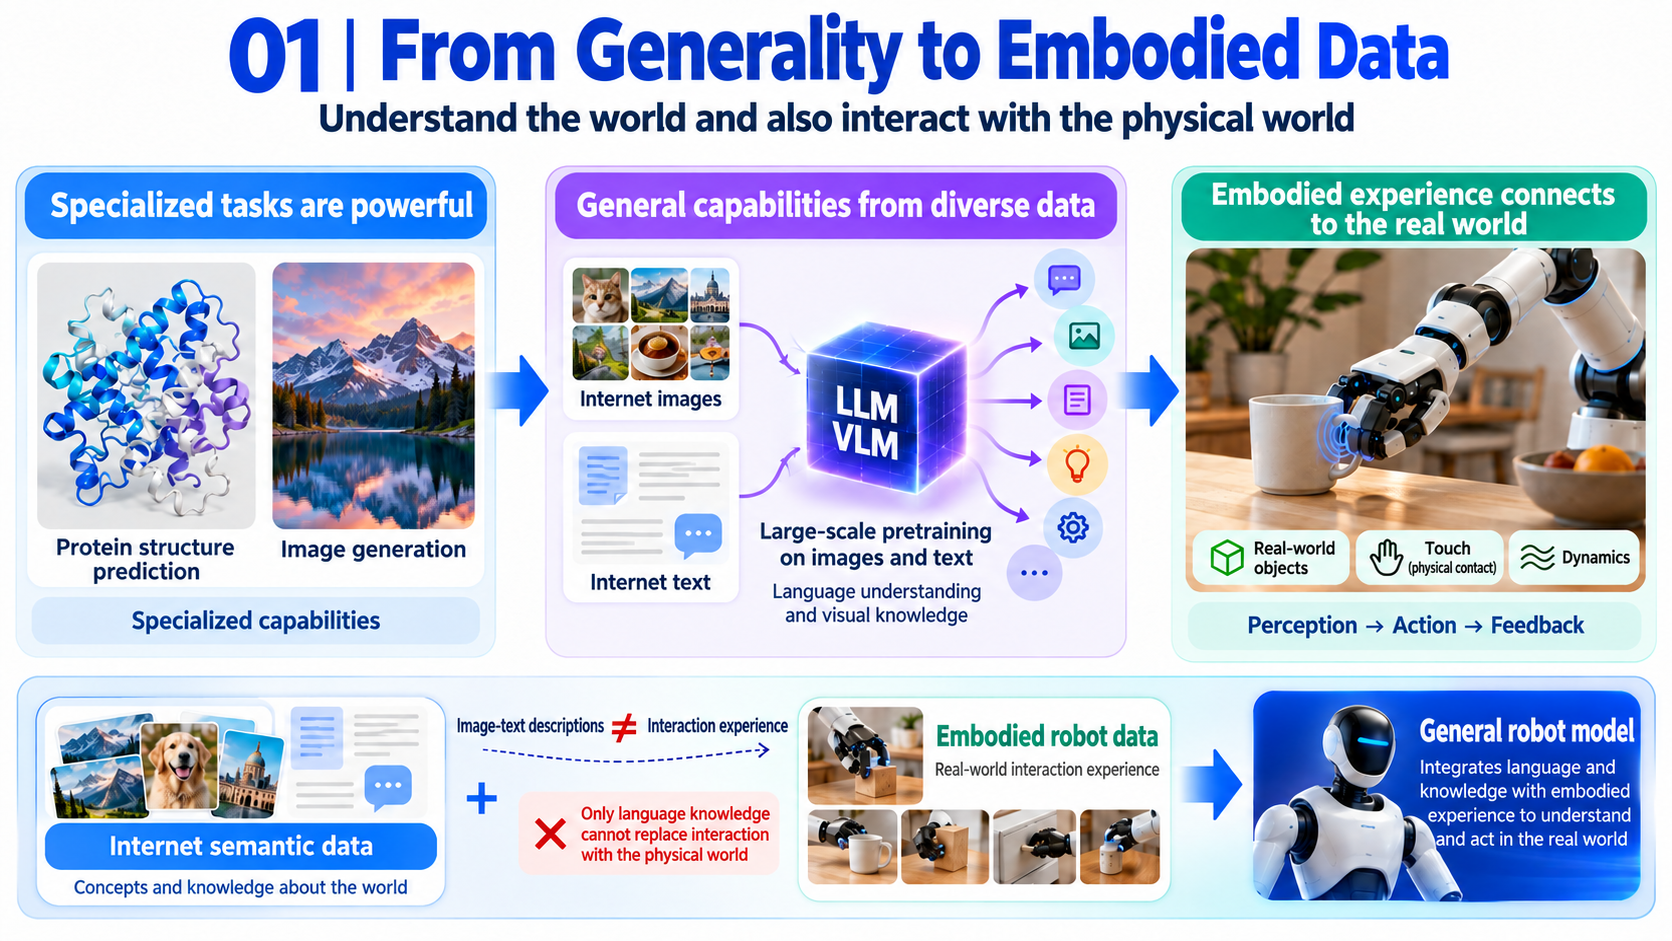
Párrafo 1: La generalidad requiere experiencia física
-
Idea principal: La IA sobresale en tareas especializadas como la predicción de estructuras de proteínas y la generación de imágenes, pero las personas siguen siendo mucho más generales a través de entornos, restricciones, lenguaje y eventos inesperados. Los LLM y VLM se benefician de un pre-entrenamiento diverso, pero no adquieren por sí mismos experiencia de interacción física.
-
Problema que se arrastra: Las descripciones imagen-texto no pueden sustituir el contacto con objetos ni la experiencia de las dinámicas.
-
Preparación para el método: Los modelos robóticos generalistas necesitan tanto semántica de internet como datos físicos de robots.
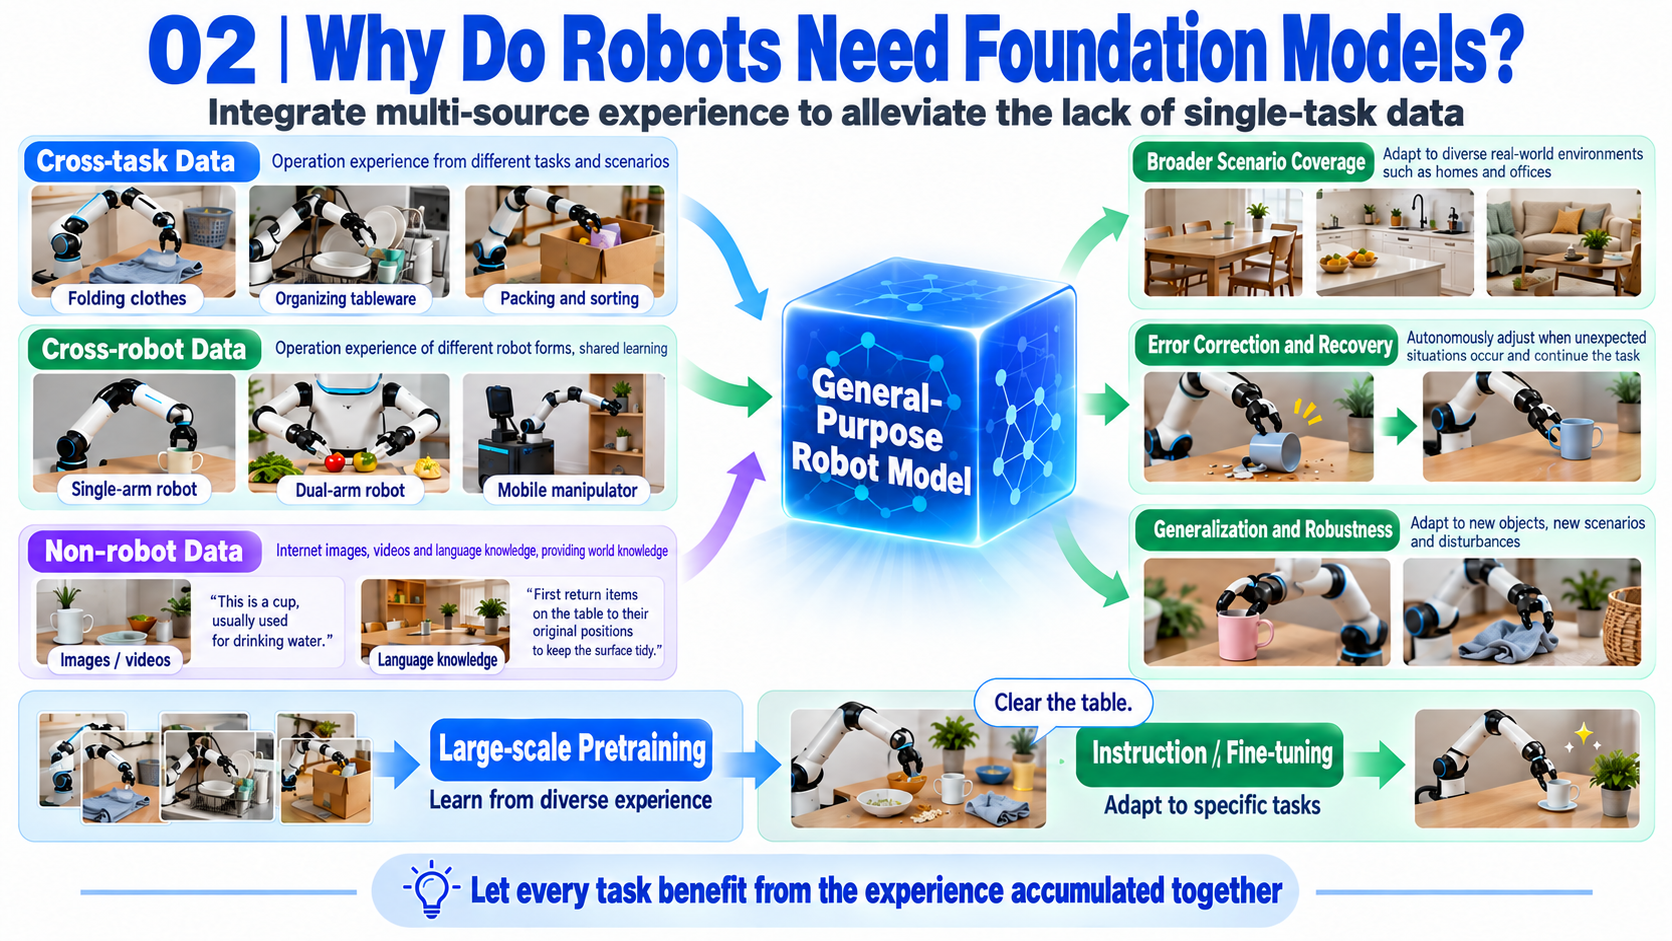
Párrafo 2: Por qué los modelos fundacionales encajan con la robótica
-
Idea principal: Los modelos generalistas agrupan datos de otras tareas, robots e incluso fuentes no robóticas, reduciendo la escasez de datos de una sola tarea. La diversidad también puede cubrir más escenas, errores y recuperaciones, mejorando la robustez.
-
Problema que se arrastra: Un solo robot y una sola tarea rara vez aportan suficientes datos para cubrir los estados de fallo.
-
Preparación para el método: Pre-entrenar de forma amplia y luego usar prompting o fine-tuning en lugar de entrenar cada tarea desde cero.
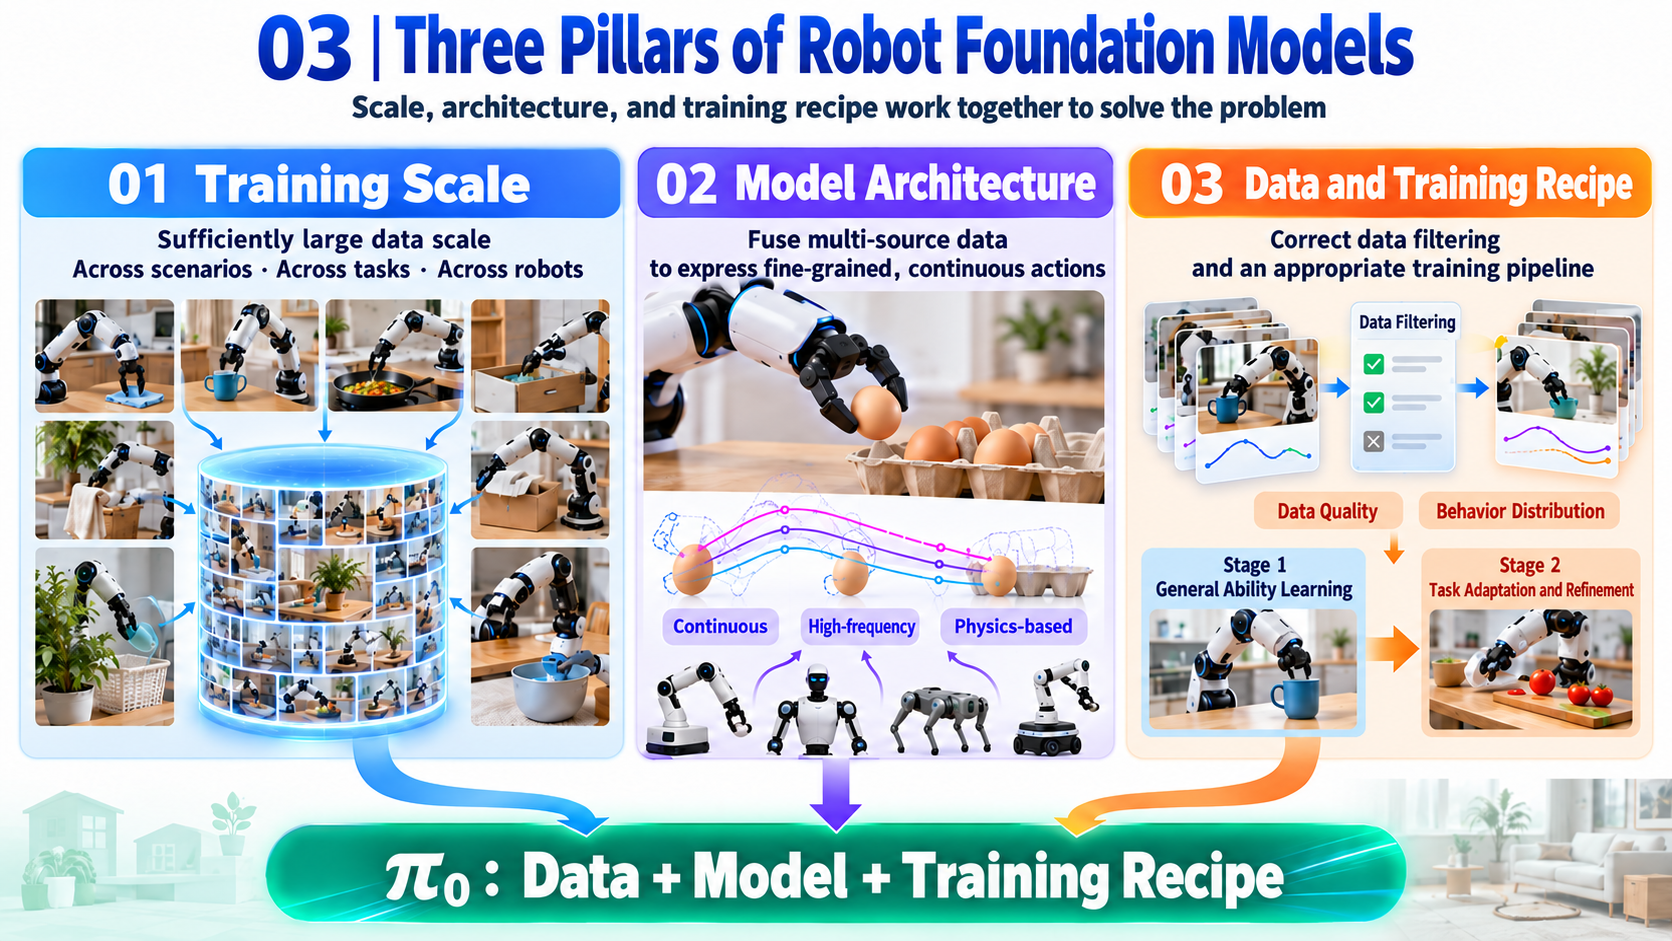
Párrafo 3: Tres cuellos de botella
-
Idea principal: Las políticas generalistas necesitan suficiente escala, una arquitectura que fusione datos heterogéneos y exprese acciones precisas, y una selección de datos y recetas de entrenamiento adecuadas.
-
Problema que se arrastra: Los métodos de modelos de lenguaje no pueden copiarse directamente al control continuo, de alta frecuencia y dependiente de la plataforma.
-
Preparación para el método: π0 aborda por separado los datos, la arquitectura y el entrenamiento.
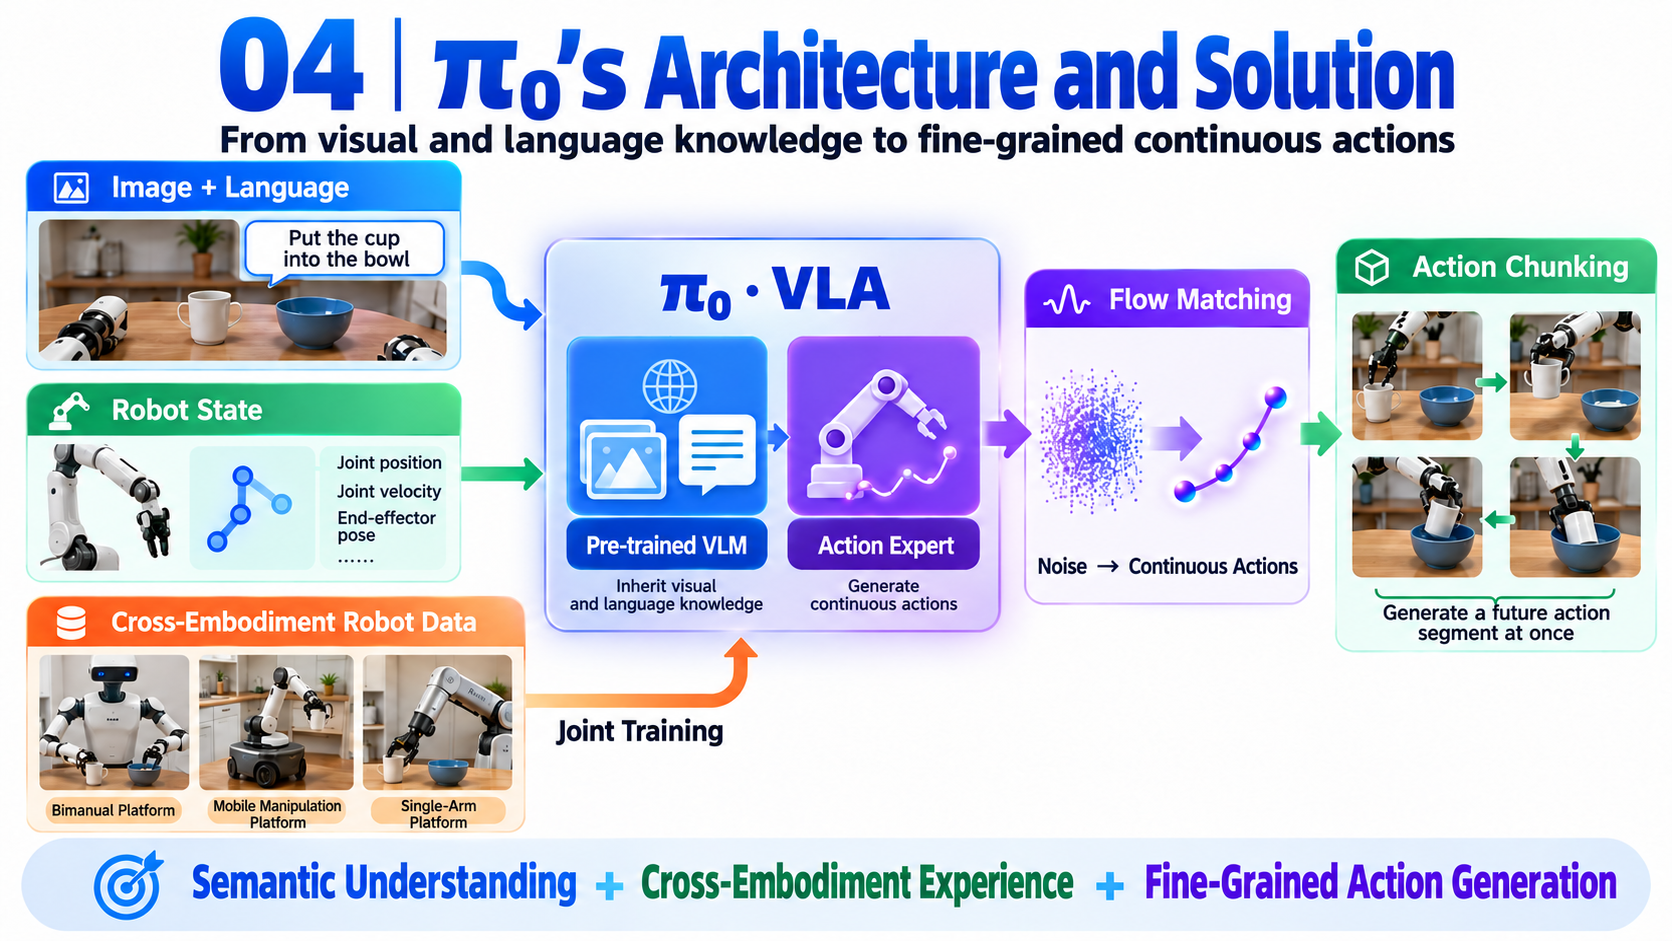
Párrafo 4: La respuesta arquitectónica
-
Idea principal: Inicializar desde un VLM, entrenar conjuntamente entre diferentes morfologías, usar fragmentos de acción y flow matching para control continuo, y añadir un experto en acciones para extender el backbone hacia un generador de acciones.
-
Problema que se arrastra: Diferentes robots tienen espacios de acción distintos, mientras que la autoregresión discreta tiene dificultades para combinar velocidad y precisión.
-
Preparación para el método: Las secciones 5 y 6 desarrollan el dataset entre diferentes morfologías y el experto en acciones.
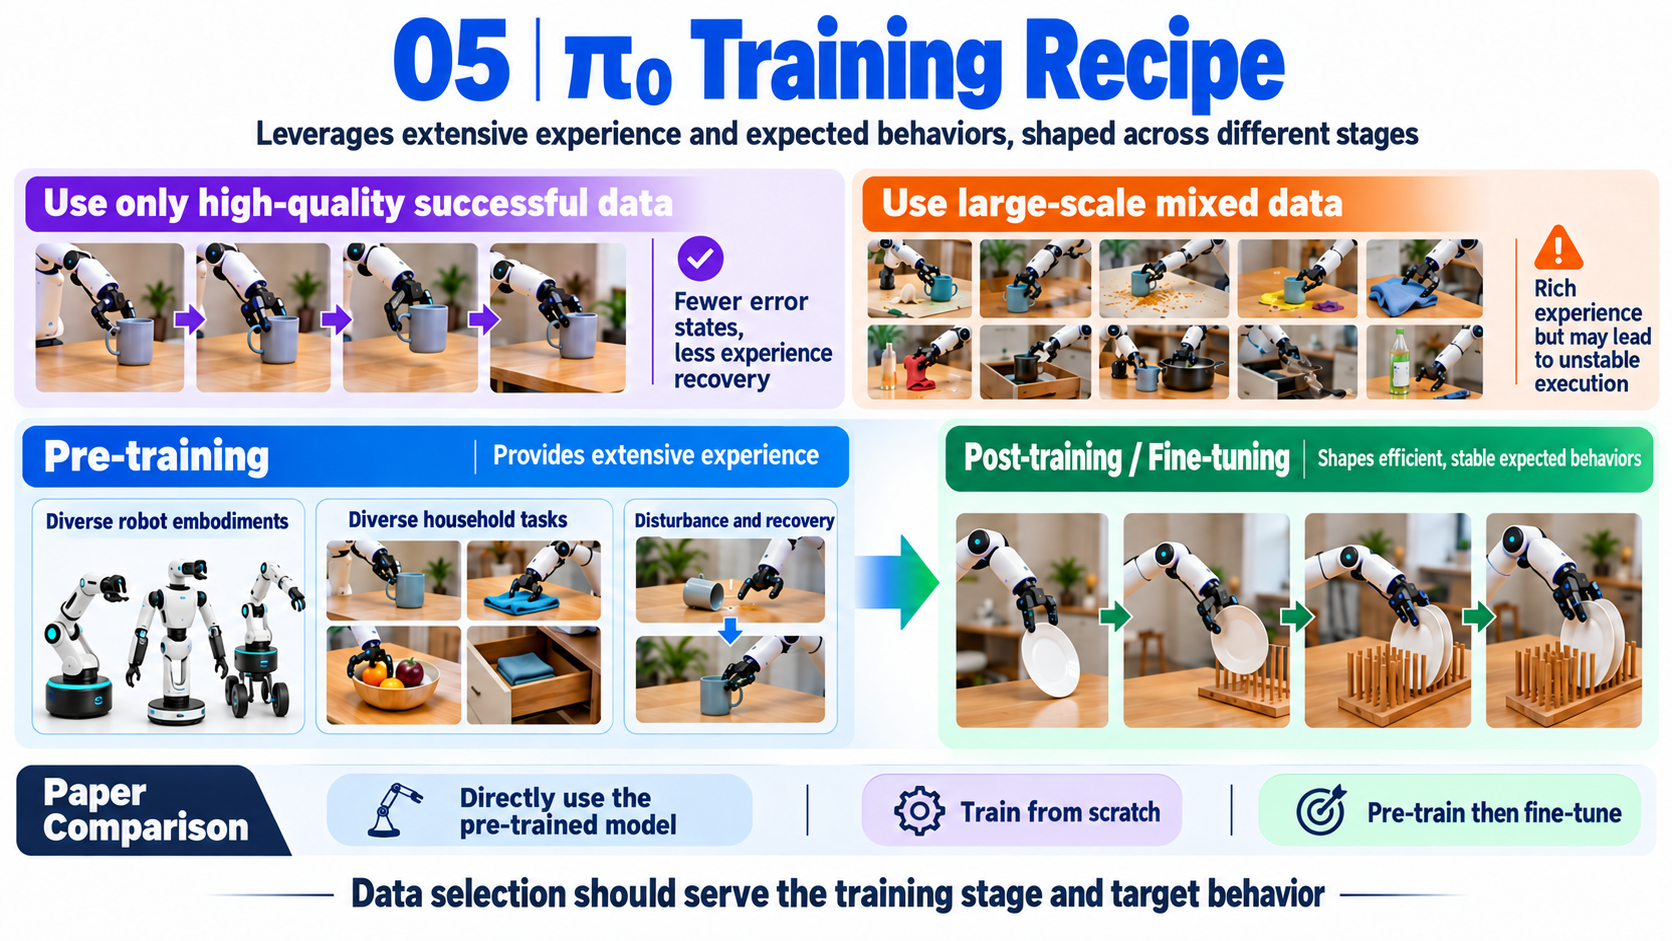
Párrafo 5: La receta de entrenamiento
-
Idea principal: El pre-/post-entrenamiento se reparten el trabajo. Entrenar solo con éxitos pulidos aporta poca experiencia de errores o recuperación; usar solo datos amplios pero de menor calidad puede no producir una ejecución eficiente. El pre-entrenamiento amplía la experiencia y el post-entrenamiento moldea el comportamiento preferido.
-
Problema que se arrastra: “Datos más limpios siempre son mejores” no es una regla universal en todas las etapas del aprendizaje de robots.
-
Preparación para los experimentos: Comparar el uso directo del modelo preentrenado, el entrenamiento desde cero y el fine-tuning después del pre-entrenamiento.
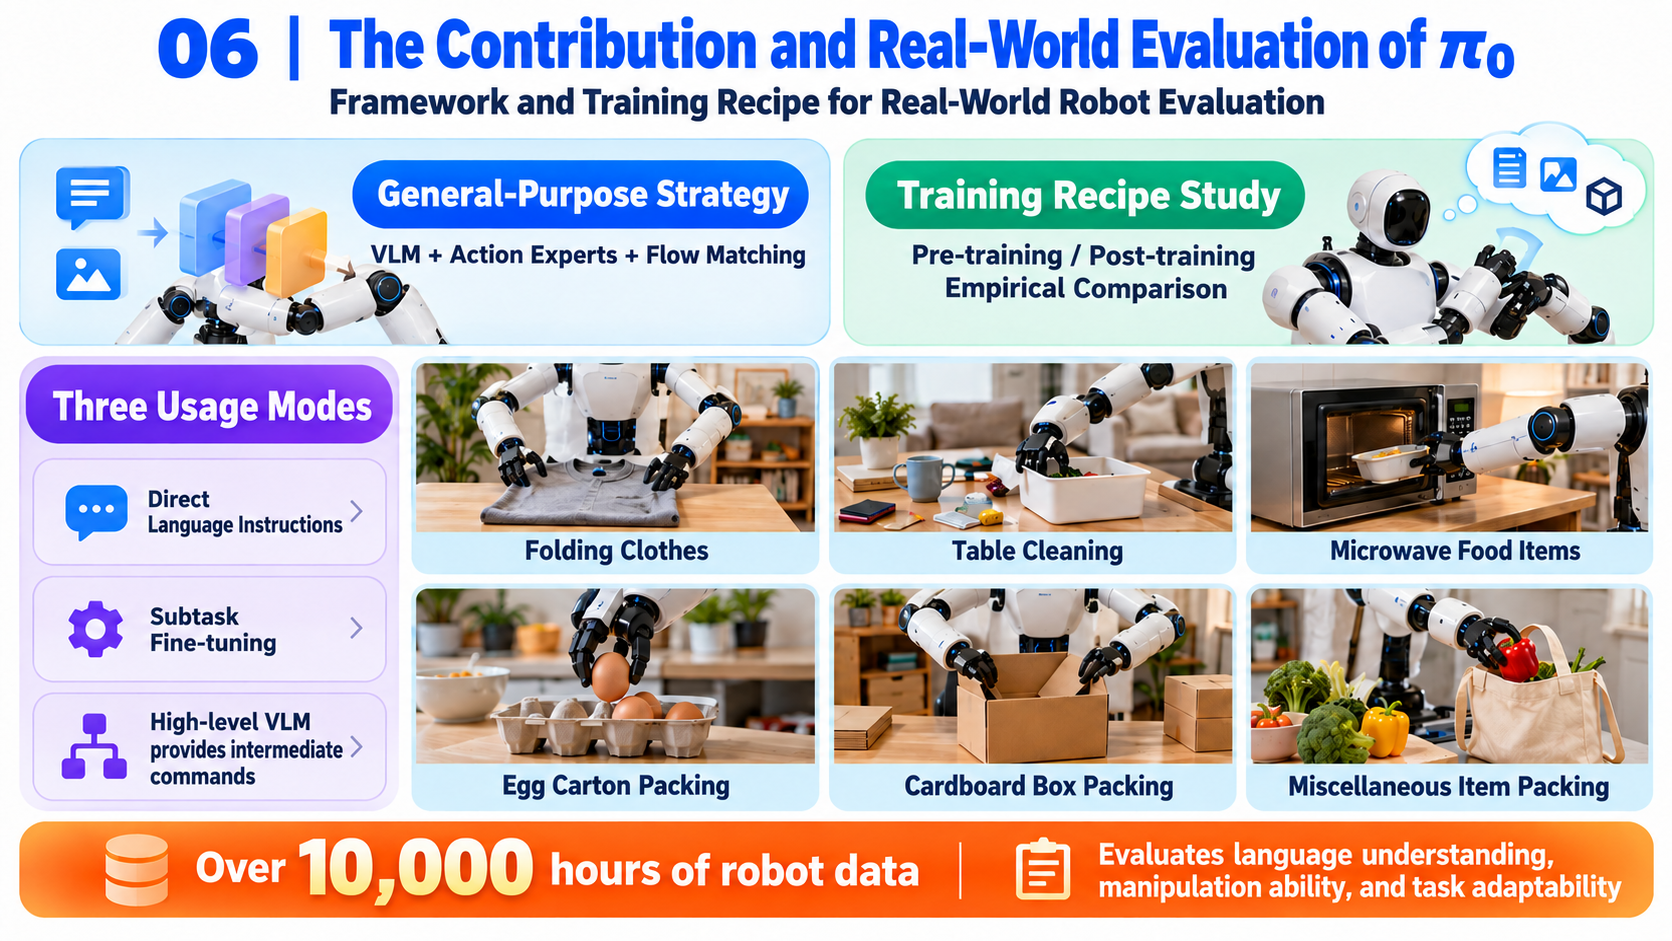
Párrafo 6: Alcance de las contribuciones y la evaluación
-
Idea principal: Las contribuciones incluyen una arquitectura generalista basada en VLM con flow matching y un estudio empírico de recetas de pre-/post-entrenamiento. La política admite prompting en lenguaje natural, fine-tuning para tareas posteriores e instrucciones intermedias de un VLM de alto nivel.
-
Problema que se arrastra: Tanto la arquitectura como el entrenamiento necesitan evidencia en robots reales.
-
Preparación para los experimentos: Más de 10.000 horas de datos de robots sustentan evaluaciones que incluyen doblar ropa, limpiar mesas, cargar microondas, empaquetar cartones de huevos, ensamblar cajas y embolsar compras.
Trabajo relacionado
-
VLAs: RT-2, OpenVLA y Octo transfieren representaciones visión-lenguaje al control de robots. Muchos usan tokens de acción discretos autoregresivos. π0 conserva un VLM preentrenado mientras genera fragmentos continuos de alta frecuencia mediante flow matching condicional.
-
Modelos de difusión/flow y Transformers multimodales: Diffusion Policy modela acciones continuas multimodales, mientras que Transfusion combina tokens discretos y objetivos generativos continuos. π0 aplica ideas relacionadas a los VLA, con pesos imagen-lenguaje y estado-acción que interactúan mediante atención.
-
Aprendizaje robótico a gran escala: Los primeros datasets a menudo se centraban en tareas más simples de agarre y empuje. OXE, Bridge y DROID amplían la cobertura de tareas y robots. π0 añade más de 10.000 horas de datos internos, en gran parte comportamiento bimanual diestro, y una receta de pre-/post-entrenamiento en dos etapas.
-
Manipulación diestra: ACT y Diffusion Policy aprenden tareas precisas a partir de conjuntos de datos más pequeños, pero suelen ser específicas de la tarea y del robot. π0, en cambio, se preentrena a través de múltiples encarnaciones y luego usa prompting o post-entrenamiento de alta calidad en diferentes escalas de datos.
Sistemas y Datos Multi-Plataforma
Objetivos de Diseño y Componentes
π0 es un sistema de modelo y datos multi-plataforma en lugar de un controlador ligado a un solo brazo. Sus objetivos son:
-
Compartir datos entre robots de un solo brazo, bimanuales y de manipulación móvil.
-
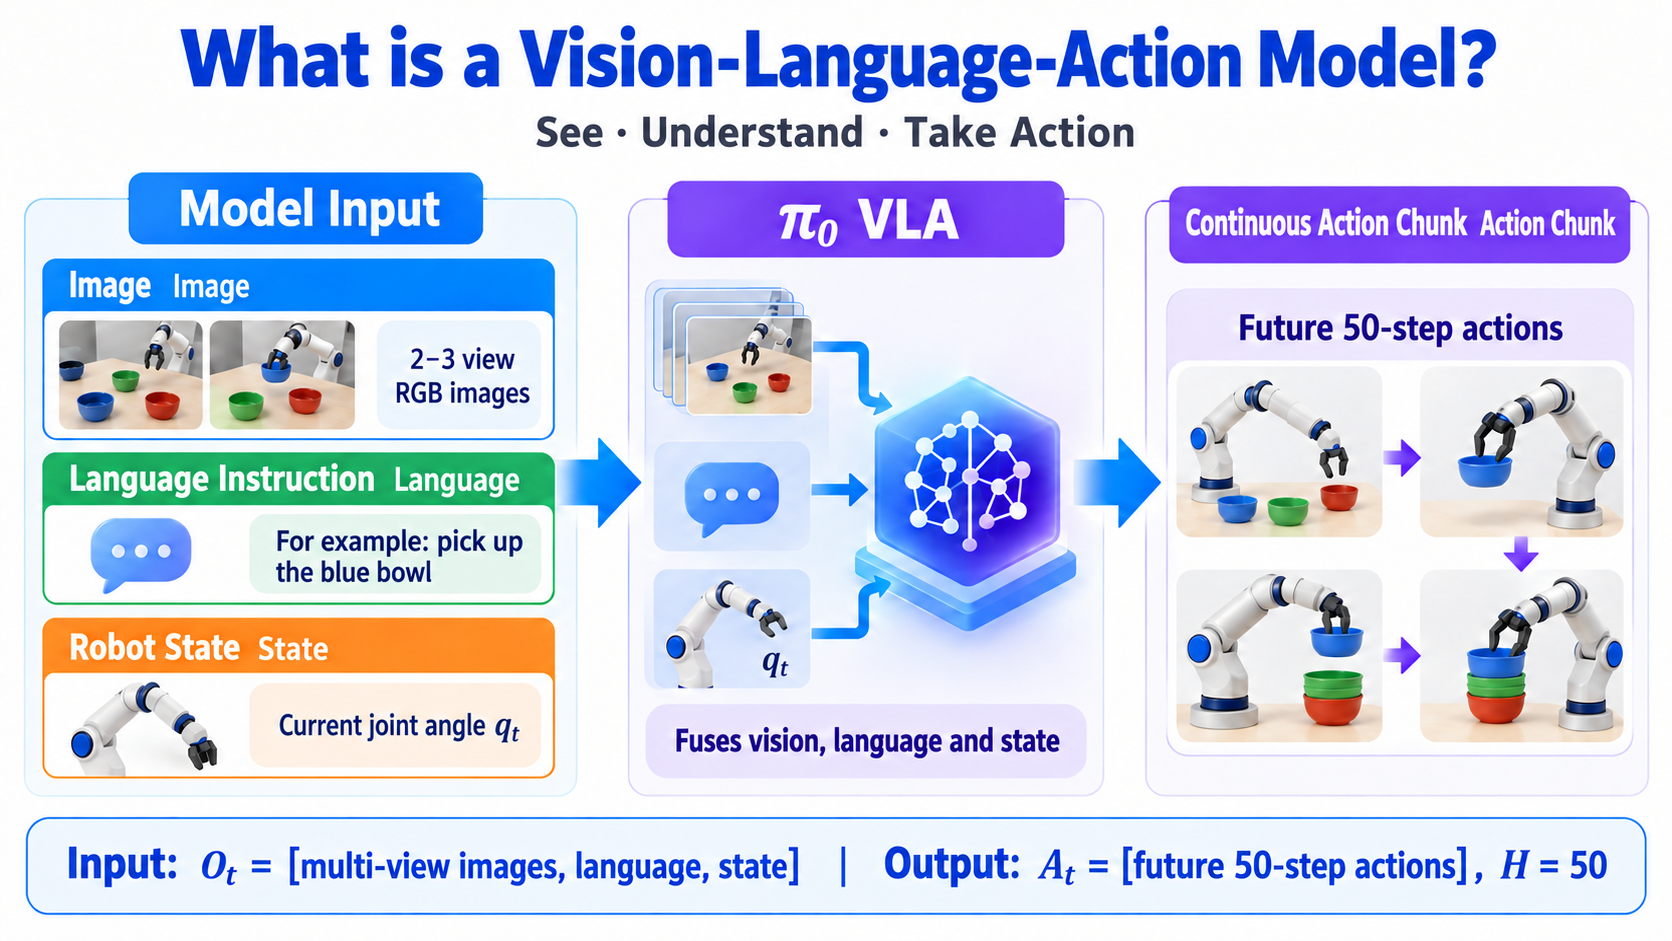
Procesar conjuntamente lenguaje, observaciones visuales, estado del robot y acciones continuas.
-
Ejecutar directamente las tareas cubiertas o aprender tareas difíciles/nuevas mediante post-entrenamiento.
-
Soportar control diestro de hasta 50 Hz.
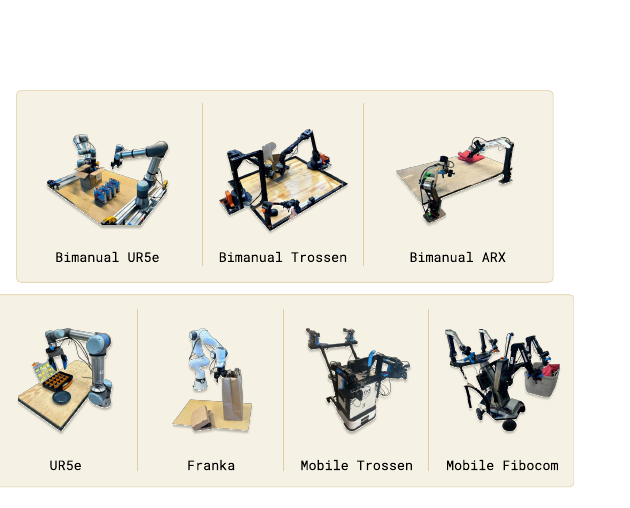
| Categoría de plataforma | Entradas de imagen | Espacio de estado / acción |
|---|---|---|
| UR5e simple | Muñeca + hombro, dos vistas | Estado 7D, acción 7D |
| UR5e bimanual | Tres vistas | Estado 14D, acción 14D |
| Franka simple | Dos vistas | Estado 8D, acción 8D |
| Trossen bimanual | Dos muñecas + base, tres vistas | Estado 14D, acción 14D |
| ARX / AgileX bimanual | Dos muñecas + base, tres vistas | Estado 14D, acción 14D |
| Trossen móvil / ARX móvil | Dos muñecas + base, tres vistas | Estado 14D, acción 16D; dos controles adicionales de base no holonómica |
| Fibocom móvil | Dos brazos + base omnidireccional | Estado 14D, acción 17D; dos controles de traslación y uno de rotación para la base |
Precaución: Las plataformas cinemáticamente similares se agrupan en categorías de configuración. Siete configuraciones no significan siete robots físicos, ni solo siete tipos de robots en OXE. Los datos internos de manipulación diestra cubren siete configuraciones; los datos adicionales de OXE cubren 22 tipos de robots.
Entrenamiento y Control Multi-Plataforma
El flujo de trabajo general es:
Multi-platform teleoperation + open robot data + internet image-text pre-training
                         ↓
          Weighted cross-embodiment data mixture
                         ↓
      Joint training of PaliGemma + π0 action expert
                         ↓
             Generalist π0 base policy
                  ↙                 ↘
        Direct language prompting        High-quality task post-training
                  ↘                 ↙
           Continuous action chunks across platforms
Dos alineamientos encajan distintos robots en un solo modelo:
-
Alineamiento de estado/acción: se rellena hasta un máximo de 18 dimensiones. Los robots más pequeños usan ceros al final; 18 dimensiones permiten dos brazos de seis GDL, dos pinzas, una base móvil y un torso elevable.
-
Alineamiento de imágenes: se reservan tres ranuras de imagen y se enmascaran las vistas ausentes para robots con solo una o dos cámaras.
Las etiquetas de lenguaje incluyen tareas completas y segmentos cortos, normalmente de unos dos segundos. Instrucciones de segmento como “recoge la servilleta” y “tírala a la basura” permiten que un VLM de alto nivel descomponga tareas largas como limpiar una mesa mientras π0 se encarga de la ejecución física.
Artículo: Un grupo tarea–robot con muestras recibe un peso de . El exponente sublineal reduce el dominio de grupos muy grandes, como las tareas de lavandería muestreadas extensamente.
Sensores, Recopilación y Capacidades
Composición de Datos
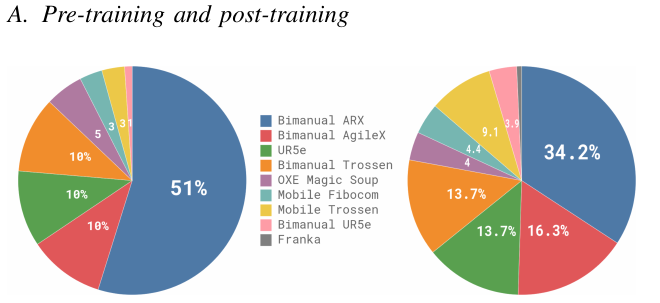
-
Los datos internos contienen 903M pasos de tiempo: 106M de robots de un solo brazo y 797M de robots bimanuales.
-
Cubre 68 tareas amplias y siete configuraciones de robot.
-
Los datos abiertos constituyen el 9,1% de la mezcla, incluyendo OXE, Bridge v2 y DROID.
-
Los conjuntos de datos abiertos suelen tener una o dos cámaras y control de 2–10 Hz, pero gran diversidad de objetos y entornos.
-
El artículo resume las demostraciones totales de robots como más de 10.000 horas.
-
El post-entrenamiento de tareas va desde unas cinco horas para tareas simples hasta 100 horas o más para las tareas más difíciles.
Prompting Directo
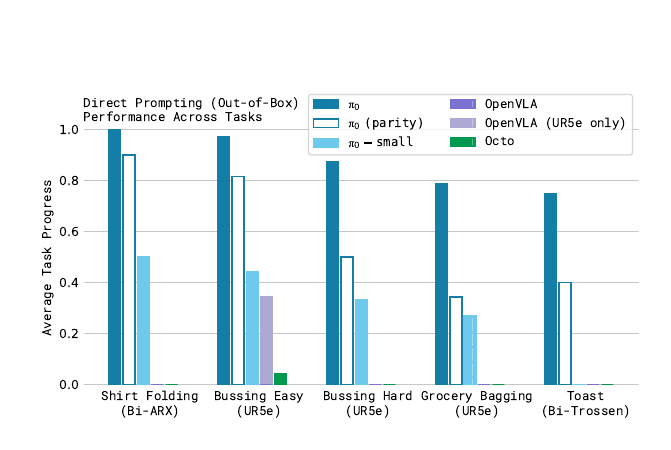
El artículo compara π0, OpenVLA, Octo y π0-small sin inicialización VLM en doblar una camisa, limpieza de mesa fácil y difícil, embolsado de compras y sacar tostadas de una tostadora:
-
El π0 completo entrenado durante 700k pasos logra el mayor progreso medio en las cinco tareas.
-
Un modelo de paridad π0 de 160k pasos, con actualizaciones comparables a las líneas base, aún las supera.
-
π0-small suele superar a OpenVLA y Octo, lo que respalda el valor de la propia arquitectura de fragmentos continuos.
-
El π0 completo supera sustancialmente a π0-small, lo que respalda los beneficios del pre-entrenamiento VLM para la semántica y el control entre tareas.
Precaución: OpenVLA y Octo no se entrenan durante el mismo número de épocas que el π0 completo. La comparación de paridad aborda parcialmente la equidad computacional, pero la comparación de modelos completos no está estrictamente igualada en cómputo.
Post-Entrenamiento en Nuevas Tareas
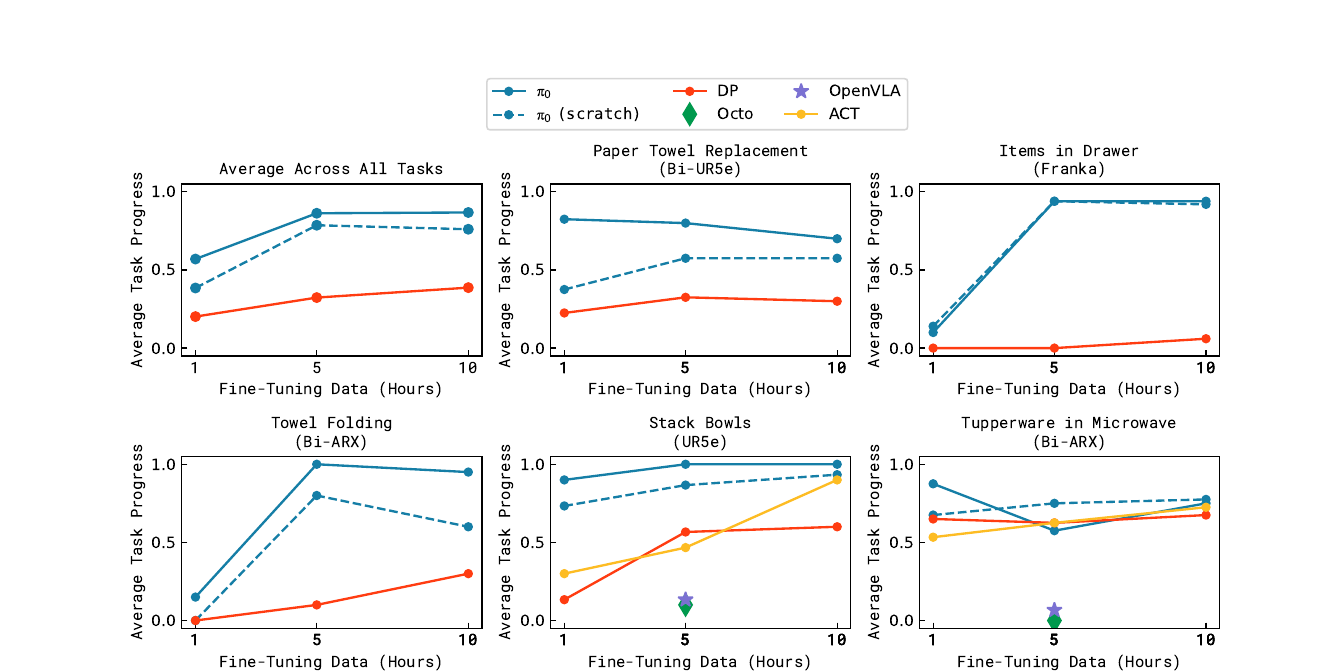
Las nuevas tareas incluyen apilar cuencos, doblar toallas, meter un recipiente de comida en un microondas, reemplazar un rollo de toallas de papel y cargar cajones con Franka. Cada método se promedia en diez ensayos por tarea:
-
π0 supera al entrenamiento desde cero y a otros métodos en general y en la mayoría de las tareas individuales.
-
Doblar toallas y apilar cuencos, que se parecen a las tareas de pre-entrenamiento, alcanzan un progreso sustancial con menos datos.
-
En algunas tareas, el pre-entrenamiento casi duplica el rendimiento en comparación con el entrenamiento desde cero.
-
Las ganancias no son monótonas en todas las escalas de datos. Para cargar el microondas, la configuración de cinco horas está cerca de la línea base, mientras que la configuración de una hora muestra una ventaja mayor.
Tareas Complejas de Largo Horizonte
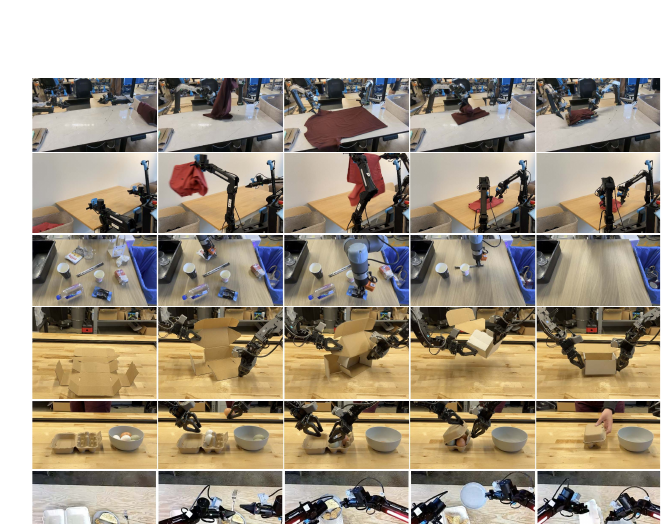
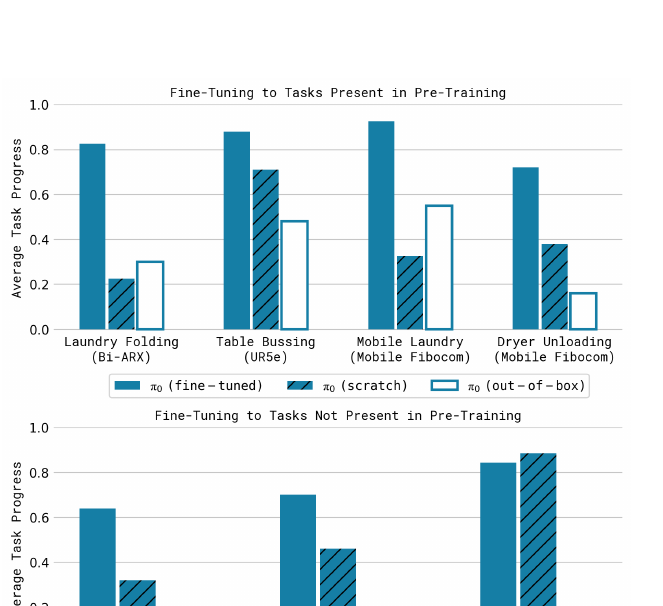
Estas tareas duran unos 5–20 minutos y combinan docenas de agarres, apilados, extendidos y comportamientos de plegado. El pre-entrenamiento más el post-entrenamiento supera la mitad de la puntuación máxima en todas las tareas ilustradas y generalmente vence al entrenamiento desde cero o al uso directo de la política pre-entrenada. Los beneficios son especialmente evidentes en tareas difíciles.
Límite de la evidencia: No todas las tareas se resuelven de forma fiable. Los autores aún no saben cuál es la mezcla de pre-entrenamiento ideal ni cuánta y qué tipo de datos necesita una nueva tarea. La transferencia a dominios más lejanos como conducción, navegación o movimiento con patas no está verificada. “Generalista” se refiere a las tareas estudiadas y a las plataformas de manipulación, no a robots y entornos arbitrarios.
π0: Un VLA con un Experto en Acciones y Conditional Flow Matching
Fragmentación de Acciones: Generar 50 Pasos Futuros
π0 modela un fragmento de acción en lugar de solo :
La fragmentación aborda dos necesidades:
-
Eficiencia de salida de alta frecuencia: una inferencia produce 50 puntos de control sin decodificar autoregresivamente un token para cada dimensión de acción.
-
Coherencia de trayectoria: el modelado conjunto del fragmento representa dependencias entre acciones continuas.
Con , esto se reduce a la predicción de un solo paso. Un grande ejecutado completamente en lazo abierto reacciona lentamente a nuevas observaciones. π0 predice pero ejecuta 16 o 25 pasos antes de observar de nuevo, equilibrando la sobrecarga de inferencia y la frecuencia de retroalimentación.
El relleno hasta 18 dimensiones es una interfaz de entrenamiento. Solo las dimensiones válidas de un robot específico se envían a su controlador.
Conditional Flow Matching: Del Ruido a Acciones Continuas
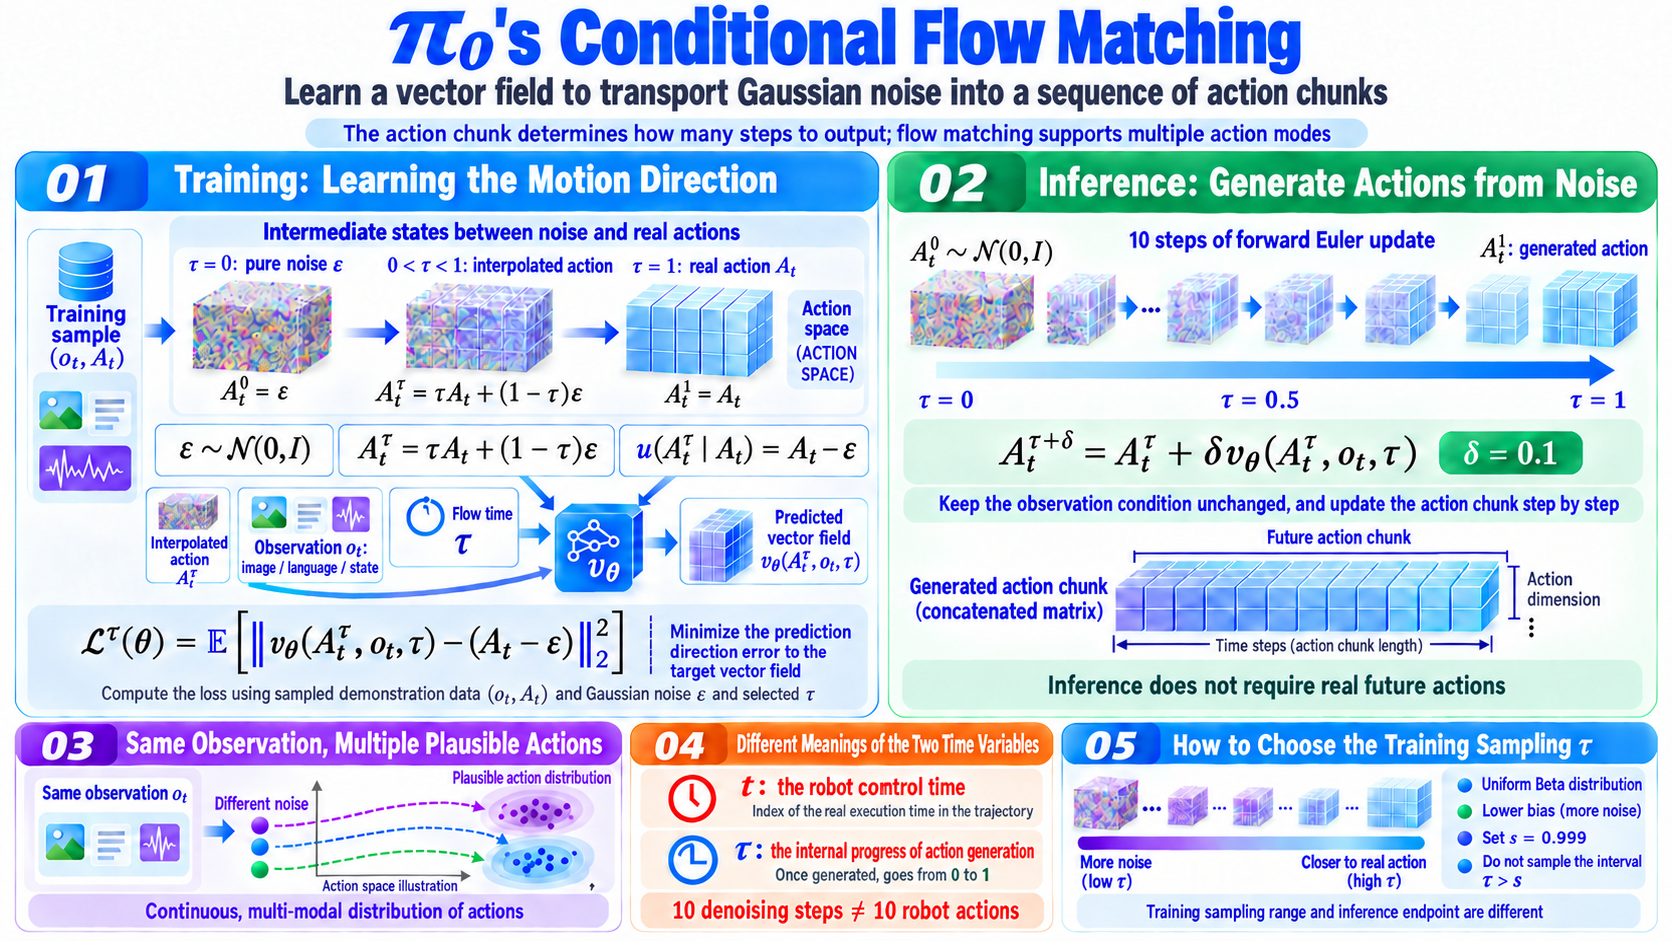
Una Interfaz Compartida sin Borrar las Diferencias entre Plataformas
Los robots difieren en el número de cámaras, dimensiones de estado y dimensiones y significados de las acciones. π0 usa ranuras de tamaño fijo:
-
Hasta tres imágenes, con las vistas faltantes enmascaradas.
-
Estado y acción rellenados hasta 18 dimensiones.
-
Un Transformer condicionado en imágenes, lenguaje, estado y acciones demostradas aprende relaciones entre combinaciones de robot–tarea.
Esto no obliga a que la dimensión de acción signifique la misma cantidad física en cada robot. Proporciona una interfaz fija mientras el modelo aprende el comportamiento específico de la plataforma a partir de observaciones, distribuciones de estado y datos.
Dos expertos procesan diferentes modalidades:
-
Backbone VLM: tokens de imagen y lenguaje, heredando el pre-entrenamiento a escala de internet de PaliGemma.
-
Experto en acciones: estado del robot y fragmentos ruidosos , especializado en control continuo.
Los pesos son separados pero intercambian información mediante self-attention del Transformer. Por lo tanto, las acciones pueden depender del lenguaje y de las imágenes sin convertir todo el VLM en una red solo de acciones.
Combinando Pre-Entrenamiento y Post-Entrenamiento
La Red Completa π0
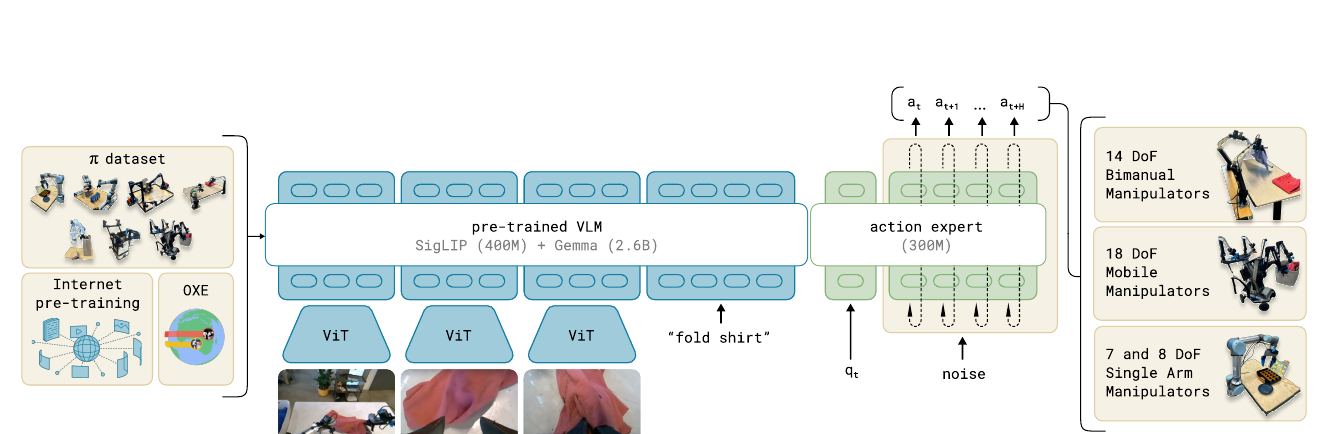
Entradas de Imagen y Lenguaje
El codificador SigLIP de PaliGemma convierte cada imagen RGB en tokens visuales, y las instrucciones tokenizadas entran junto con ellas en el experto VLM más grande. La figura de la arquitectura resume aproximadamente 400M de parámetros de SigLIP y 2,6B de parámetros de Gemma.
Precaución: El PDF no indica una resolución de imagen de entrada unificada ni el recuento exacto de tokens visuales por imagen. Estas dimensiones no se infieren aquí a partir de configuraciones comunes de PaliGemma.
Estado del robot
El estado se proyecta linealmente al ancho de incrustación del Transformer y se suministra al experto de acciones como un bloque de estado separado.
Acciones ruidosas y tiempo de flujo
El fragmento tiene tokens de acción. Cada acción ruidosa se combina con la codificación sinusoidal del tiempo de flujo mediante una MLP:
Estas incrustaciones entran en el experto de acciones. La red lee las 50 salidas de posición de acción y las proyecta linealmente al campo vectorial .
El tensor de acción máximo es . Solo se usan las dimensiones válidas de cada robot; el relleno no se envía a los actuadores.
Transformer de doble experto
-
Backbone PaliGemma: alrededor de 3B de parámetros.
-
Experto de acciones adicional: alrededor de 300M.
-
Total: alrededor de 3.3B.
-
Experto VLM: ancho 2048, 18 capas, ancho de MLP 16,384.
-
Experto de acciones: ancho 1024 y ancho de MLP 4096, reduciendo el coste de diez pasadas hacia adelante de flow matching.
Los expertos usan pesos separados, mientras que sus tokens interactúan en la auto-atención de cada capa. Esto se asemeja a una mezcla de expertos de dos ramas: los tokens de imagen/lenguaje se enrutan a los pesos VLM y los tokens de estado/acción a los pesos del experto de acciones.
Máscara de atención por bloques
La secuencia de entrada tiene tres bloques:
[Images, language] → [Robot state] → [Noisy action chunk]
La atención es bidireccional dentro de cada bloque. Los bloques anteriores no pueden leer los posteriores; los bloques posteriores pueden leer el contexto anterior. Esto limita los cambios respecto a la distribución de preentrenamiento de PaliGemma y permite que las claves/valores fijos de imagen, lenguaje y estado se almacenen en caché a lo largo de diez pasos de integración, recomputando solo el sufijo de acciones.
Pérdida de entrenamiento
El flow matching condicional minimiza el error cuadrático medio entre los campos vectoriales predichos y objetivo construidos a partir de acciones demostradas y ruido. Aprende un transporte condicional desde el ruido hacia una distribución de acciones continuas plausibles en lugar de ajustar por regresión una única acción.
Flujo completo de datos
Training:
Multi-view images + language + robot state + demonstrated 50-step actions
→ Sample ε and τ; construct a noisy chunk
→ Images/language enter the VLM; state/actions enter the action expert
→ Predict the action vector field
→ Compute flow-matching loss against the target field

Inference:
Multi-view images + language + robot state + random action noise
→ Cache the observation prefix
→ Run ten Euler integration steps with the action expert
→ Obtain a 50-step continuous chunk
→ Execute 16 or 25 steps, depending on platform
→ Observe again and generate the next chunk

In one sentence:
PaliGemma interprets what is visible and what the user wants; the expert turns that understanding into continuous high-frequency control.
Chunking provides efficient, coherent trajectories; flow matching models continuous multimodal actions.
Cross-embodiment pre-training supplies broad experience, and high-quality post-training shapes skilled, stable task execution.